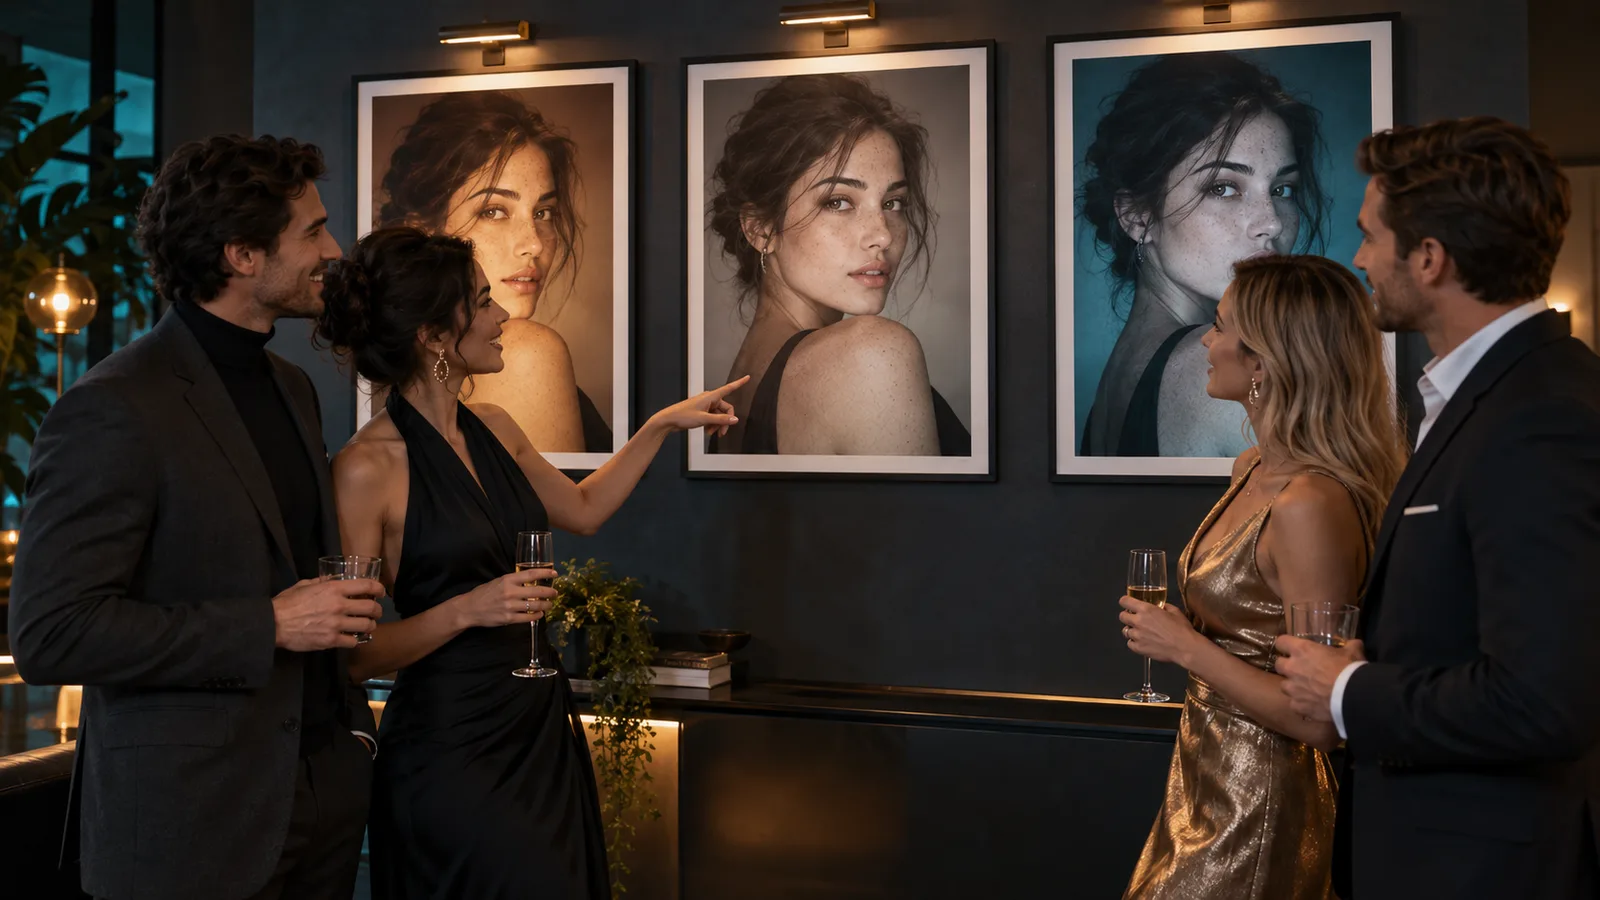
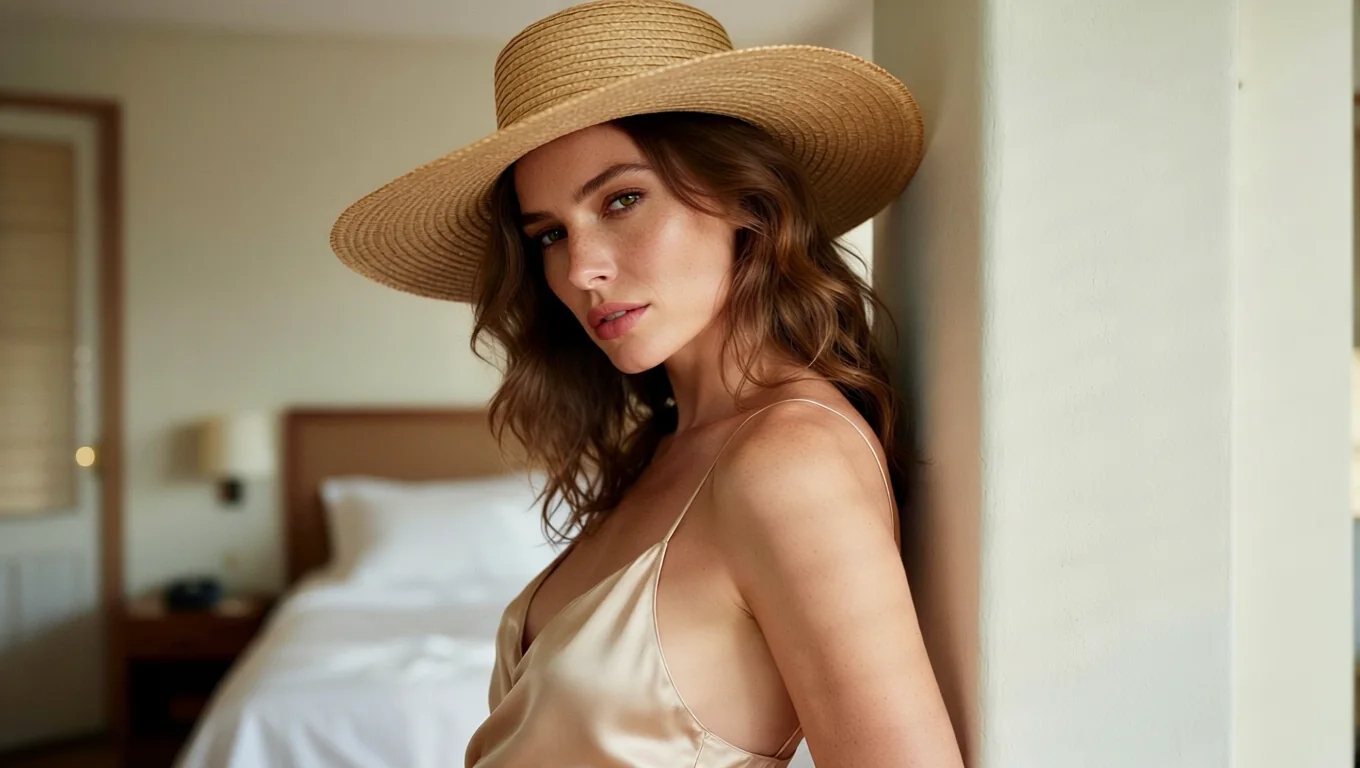
Z-Image Base LoRA では、Z-Image Base で学習された LoRA を使ってください。2026年10月5日のテストで、Z-Image Turbo 用に学習された LoRA を Base に読み込むと、画像がノイズと疑似テキストに崩れました。 Base はコミュニティが学習に使う、蒸留されていない低速なモデルで、36回の実行でテキストから画像の中央値は 32.8 秒でした。編集では既定の strength が 0.7 で、スタイル LoRA と組み合わせて 0.6 前後にすると、構図をそのまま保ったまま画面全体のスタイルが変わりました。
Z-Image Base LoRA は、Alibaba の Tongyi-MAI による Z-Image Base を動かします。60億パラメータのシングルストリーム拡散トランスフォーマーで、テキストから画像と画像から画像のどちらでも、自前の LoRA を最大3つまで読み込めます。モデルカードでは Base を Z-Image ファミリーの土台と位置づけ、開発向けで、コミュニティにとって理想的な出発点だとしています。蒸留されていないため LoRA の学習に対応しています。エンドポイントは規制なしで、プラットフォームはコンテンツフィルターを一切かけません。最初に正直な限界を一つ。ベースモデル単体では、最も親密なシーンの描写が苦手です。アダプター LoRA の出番はまさにそこです。このガイドのプロンプトはすべて、服を着た大人の日常的なシーンです。
ひと目でわかる要点
| 質問 | 答え(2026年10月5日テスト) |
|---|---|
| モデル | Tongyi-MAI(Alibaba)の Z-Image Base、60億パラメータ |
| API モデル名 | alibaba/z-image-base-lora/text-to-image と alibaba/z-image-base-lora/edit |
| LoRA フィールド | loras:最大3件、各 {path, scale}、scale は 0〜4 |
| 適した LoRA | Z-Image Base で学習されたファイル |
| 適さない LoRA | Turbo で学習したもの:画像が崩れた。Pony や保存形式の違うファイル:エラーなし、変化なし |
| 編集の strength | 0〜1、既定は 0.7 |
| テキストから画像のサイズ | 9種類のアスペクト比、各辺は最大 1536 |
| 編集のサイズ | resolution の 1k または 1.5k が長辺を決め、元画像のアスペクト比は保たれる |
| テストでの速度 | テキストから画像 9.8〜56.7 秒、中央値 32.8(36回)。編集 4.9〜41.7 秒、中央値 16.8(28回) |
| 非公開 | ステップ数、guidance、ネガティブプロンプト |
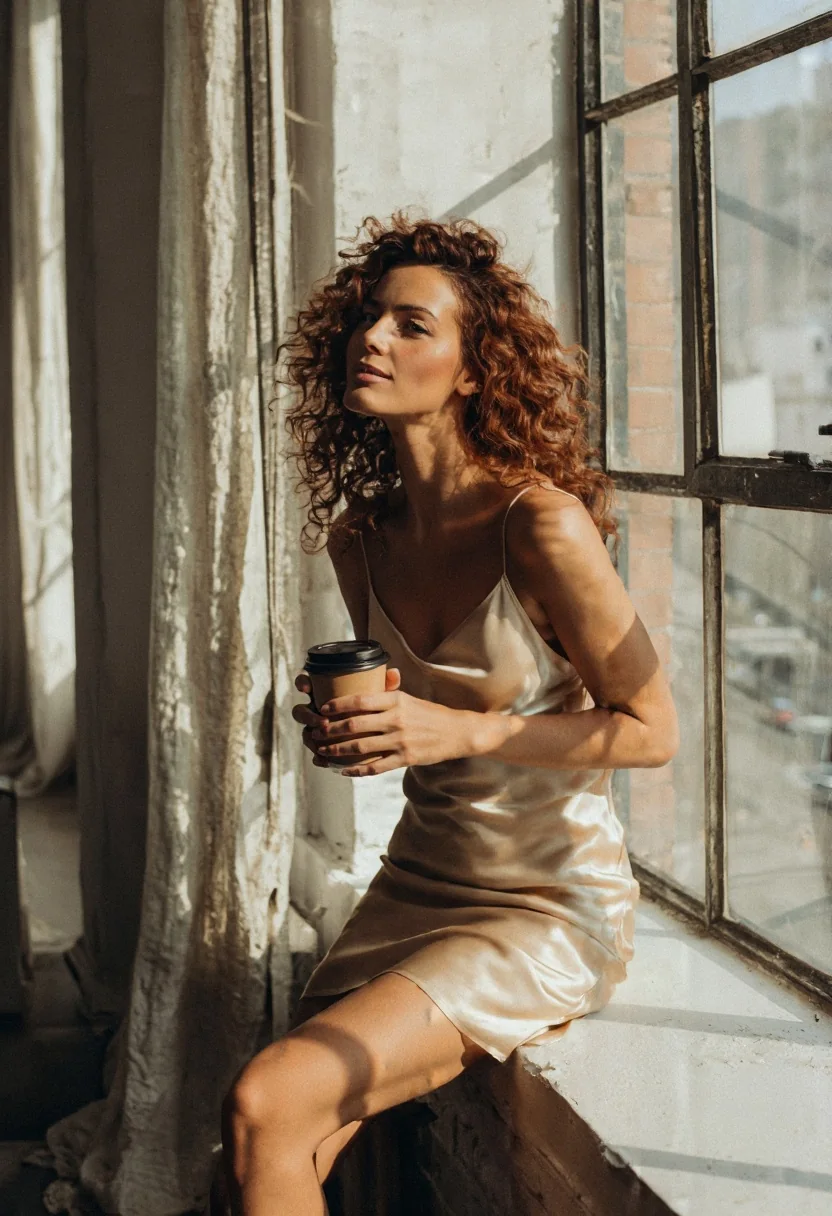
Z-Image Base LoRA、テキストから画像、2:3(832×1216)、seed 41、LoRA なし。プロンプトは次のセクションに掲載しています。
プロンプト:普通の文章で、よく従う
当社のテストでは、Base のプロンプトへの追従は強力でした。カメラマンに依頼を伝えるように書いてください。被写体、服、場所、光、粒状感です。上のロフトのポートレートは、次の1文から生まれました。
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.被写体だけを入れ替えた同じ文の形で、古いジムのボクサーも描けました。
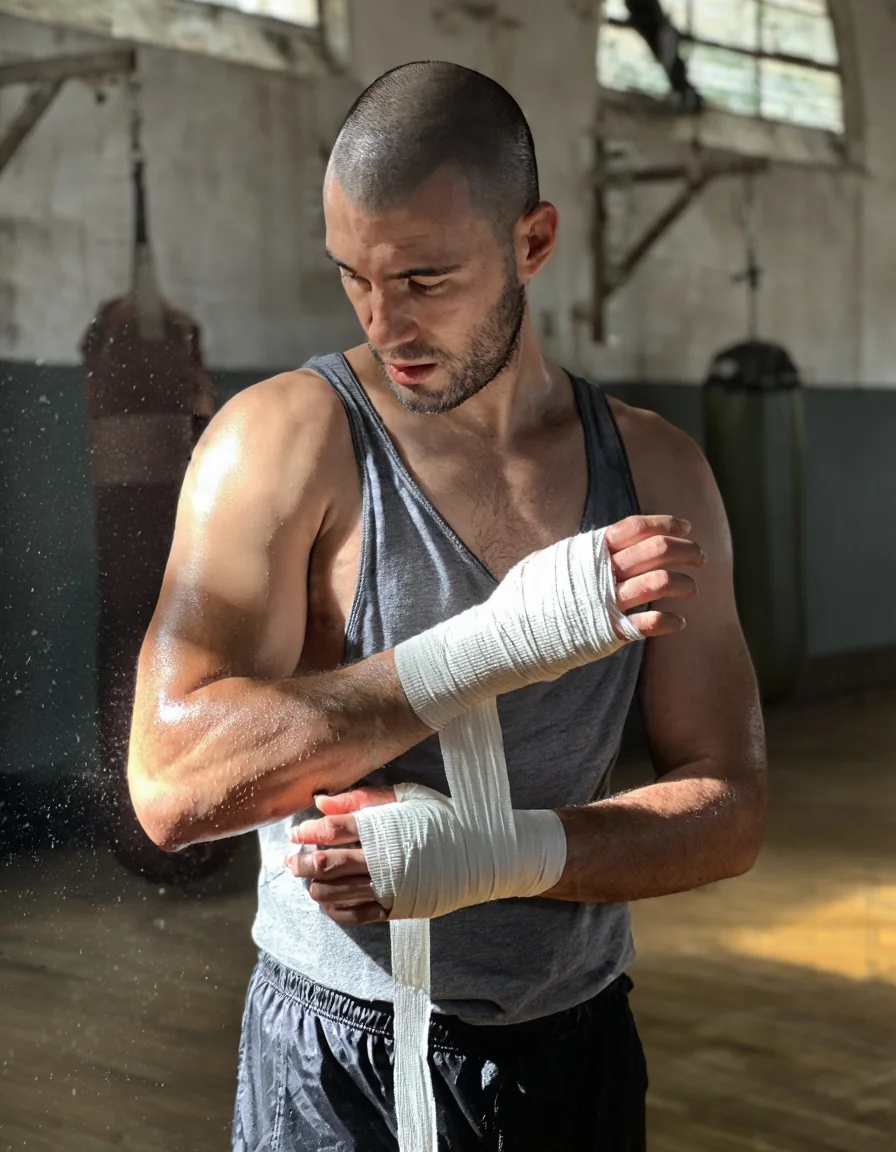
Z-Image Base LoRA、テキストから画像、3:4(896×1152)、seed 42、LoRA なし。
ネガティブプロンプト、guidance、ステップ数のフィールドはありません。提供元はモデル自体について guidance 3.0〜5.0、28〜50 ステップを推奨していますが、このエンドポイントはそのどれも公開していないため、トーンとスタイルはプロンプトと LoRA で決まります。
Base で使える LoRA はどれか
このファミリーが答えるべき問いはこれなので、4種類のファイルを試しました。
| LoRA | 学習対象 | 結果 |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | 0.5 でも 1 でも動作した |
| Z-Image Turbo の LoRA | Z-Image Turbo | エラーなしで読み込まれ、画像が崩れた(ノイズと疑似テキスト) |
furaidosu/flat-cartoon-zimage(Z-Image 向けと表記) | 異なるキー形式 | エラーなしで読み込まれ、出力はピクセル単位で同一:変化なし |
| Pony の LoRA | Pony SDXL | エラーなしで読み込まれ、出力はピクセル単位で同一:変化なし |
無音の失敗が2つ、派手に見える失敗が1つです。表記が誤っているファイルや別のベースモデル用のファイルは何も変えないため、プロンプトのせいだと思って1時間悩むことになりかねません。Base に Turbo のファイルを読み込むと画像がめちゃくちゃになりますが、少なくとも何かおかしいことは伝わります。アダプターを前提に何かを作る前に、同じ seed でファイルありとなしを1組ずつ実行してください。 一致したなら、そのファイルはここでは何もしていません。結果がノイズなら、Turbo 用に学習されたものです。
Hugging Face には、ベースモデルが Tongyi-MAI/Z-Image のアダプターが並んでいます。当社が取得したのはダウンロード数の上位40件だけで、実在の人物に似せる LoRA が大半で、スタイル LoRA も少し含まれていました。全件を数えたわけではないので、件数は示しません。
LoRA を選ぶ前のチェックリスト:
- ベースモデル: カードに Z-Image Base または Tongyi-MAI/Z-Image と書かれていること。Turbo、Pony、FLUX ではないこと。
- リンクできるファイル: リポジトリに
.safetensorsファイルがあり、resolve/main/のリンクを組み立てられること。 - 公開アクセス: ゲート付きのファイルは HTTP 401 のメッセージで失敗します。
- トリガーフレーズ: カードからそのままコピーしてください。
- ライセンス: LoRA 自体のカードにあるものを確認してください。
mikkoani LoRA:1つのフレーズで見た目が変わる
mikkoani LoRA は、プロンプトの先頭に置いたフレーズ mature illustration with muted color and complex linework で有効になります。LoRA を強度 1 で使った舞踏室のシーンはこちらです。
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}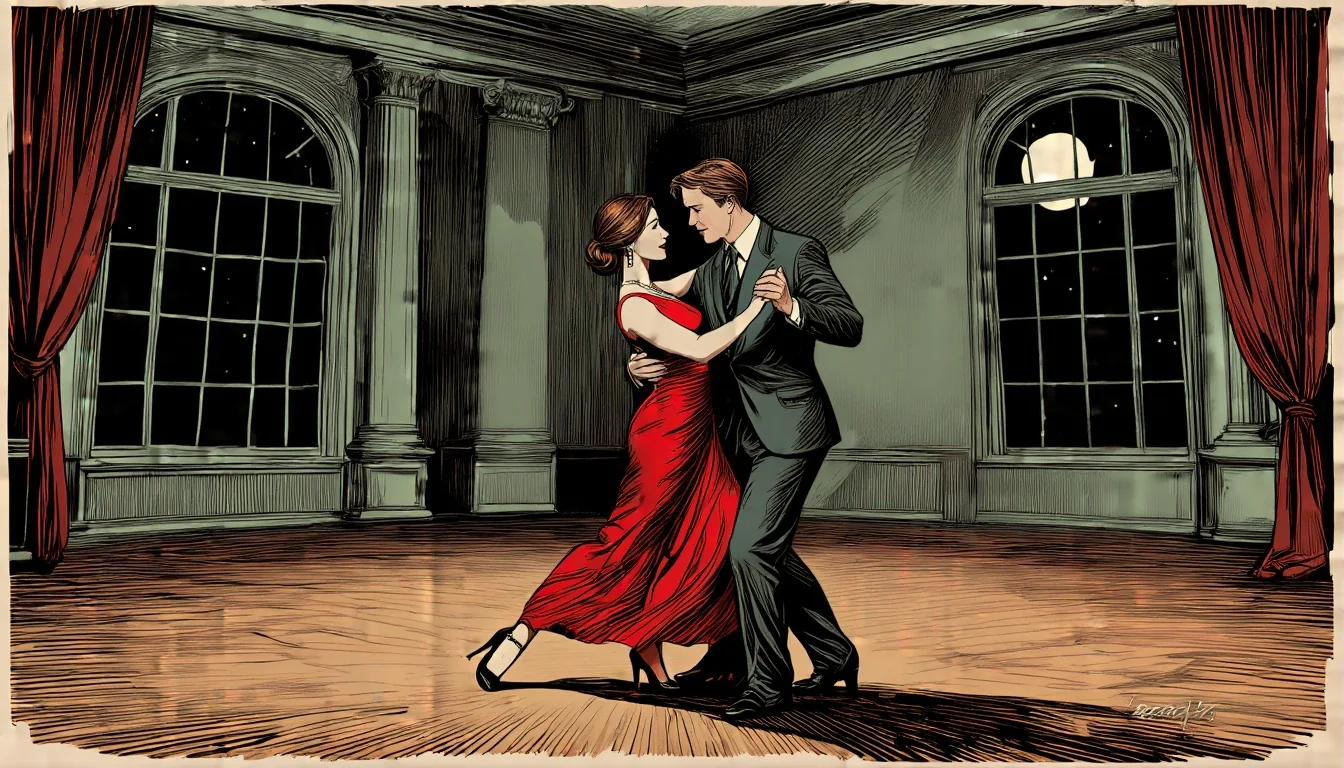
Z-Image Base LoRA、テキストから画像、16:9(1344×768)、seed 43、mikkoani LoRA を強度 1 で使用。
もう一つ知っておきたい発見があります。LoRA なしでフレーズだけでも、写真のプロンプトがイラスト寄りになりました。 Base は言葉に強く従うため、ファイルの読み込みに失敗してもトリガーフレーズがスタイルの一部を担うことがあります。そのせいで、ありとなしの比較は少しわかりにくくなります。ジャンルだけでなく、線の質とパレットを比べてください。
編集の strength:段階表
編集エンドポイントは、元画像1枚、0〜1 の strength、そして同じ loras フィールドを受け取ります。当社の公開既定値は 0.7 で、上流の既定値は 0.6 です。LoRA なしで写真に対して段階を試しました。
| Strength | 見えたもの |
|---|---|
| 0.3 と 0.5 | ほぼ変化なし |
| 0.6 | わずかな変化 |
| 0.7 | 内容が変わり始める。構図は保たれる |
| 0.75 | シーンのポーズと配置が組み直される。光とパレットは保たれる |
| 0.85 | 別の絵になる |
スタイル LoRA を使うと絵が変わります。0.6 では構図をそのまま保ったまま、画面全体のスタイルが変わりました。写真をイラストに変えるにはここが最適な設定です。
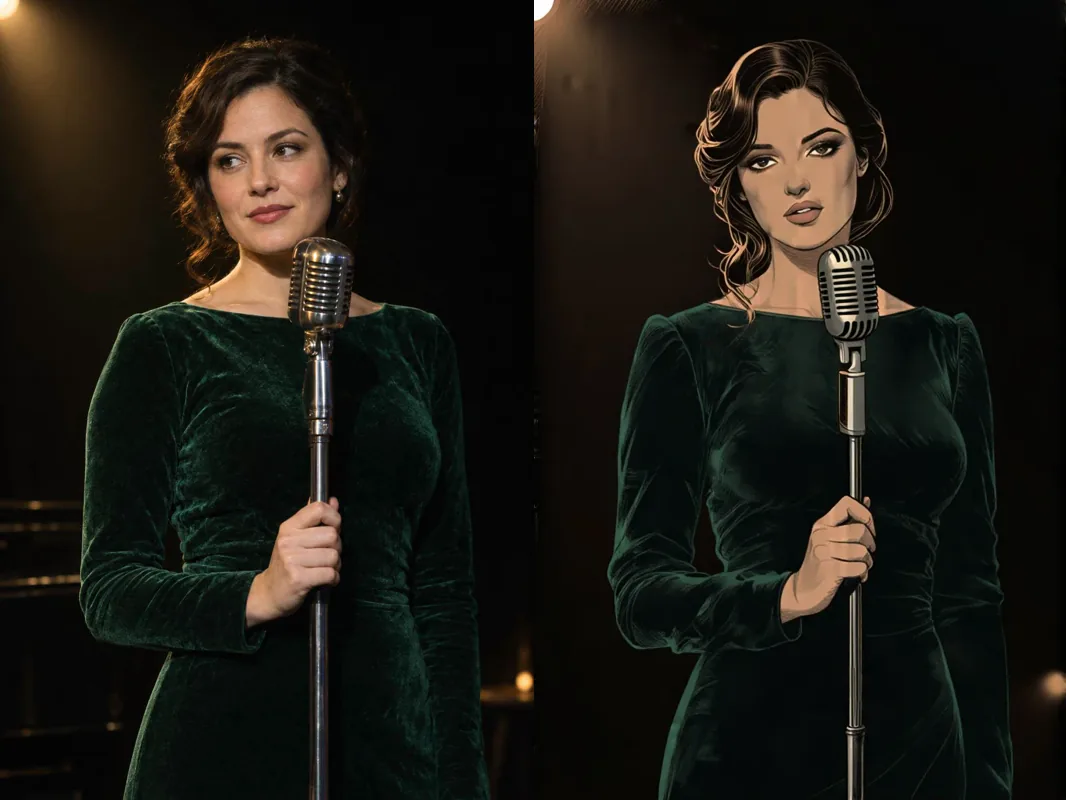
左:当社で生成した元写真。右:Z-Image Base LoRA、画像から画像、1k、seed 51、mikkoani LoRA を強度 1、strength 0.6 で使用。
編集のプロンプトには、変更点だけでなく、欲しい絵全体を書きます。
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.2つ目の元画像は、夕暮れの屋上で白いリネンシャツの前を開けた男性で、同じ strength です。
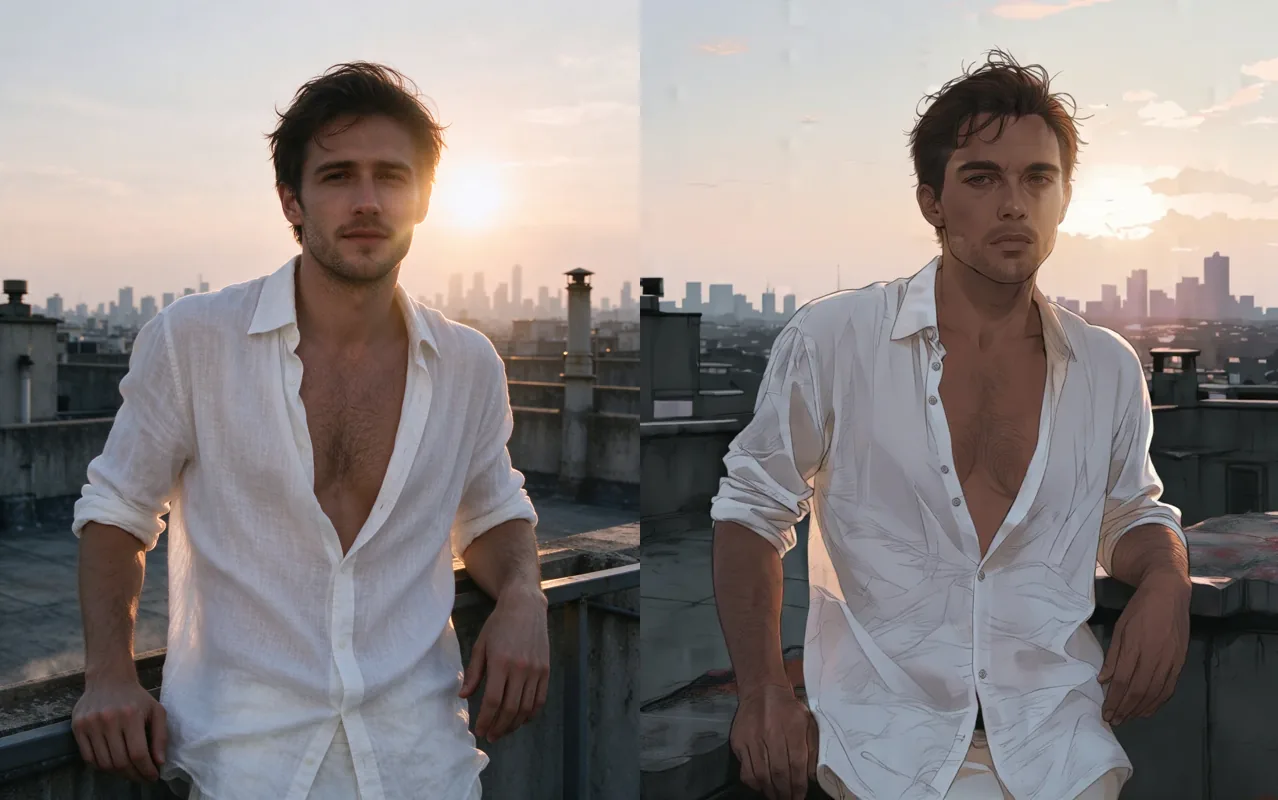
左:当社で生成した元写真。右:Z-Image Base LoRA、画像から画像、1k、seed 54、mikkoani LoRA を強度 1、strength 0.6 で使用。
そして、横長の元画像を 1.5k、strength 0.65 で試したものです。
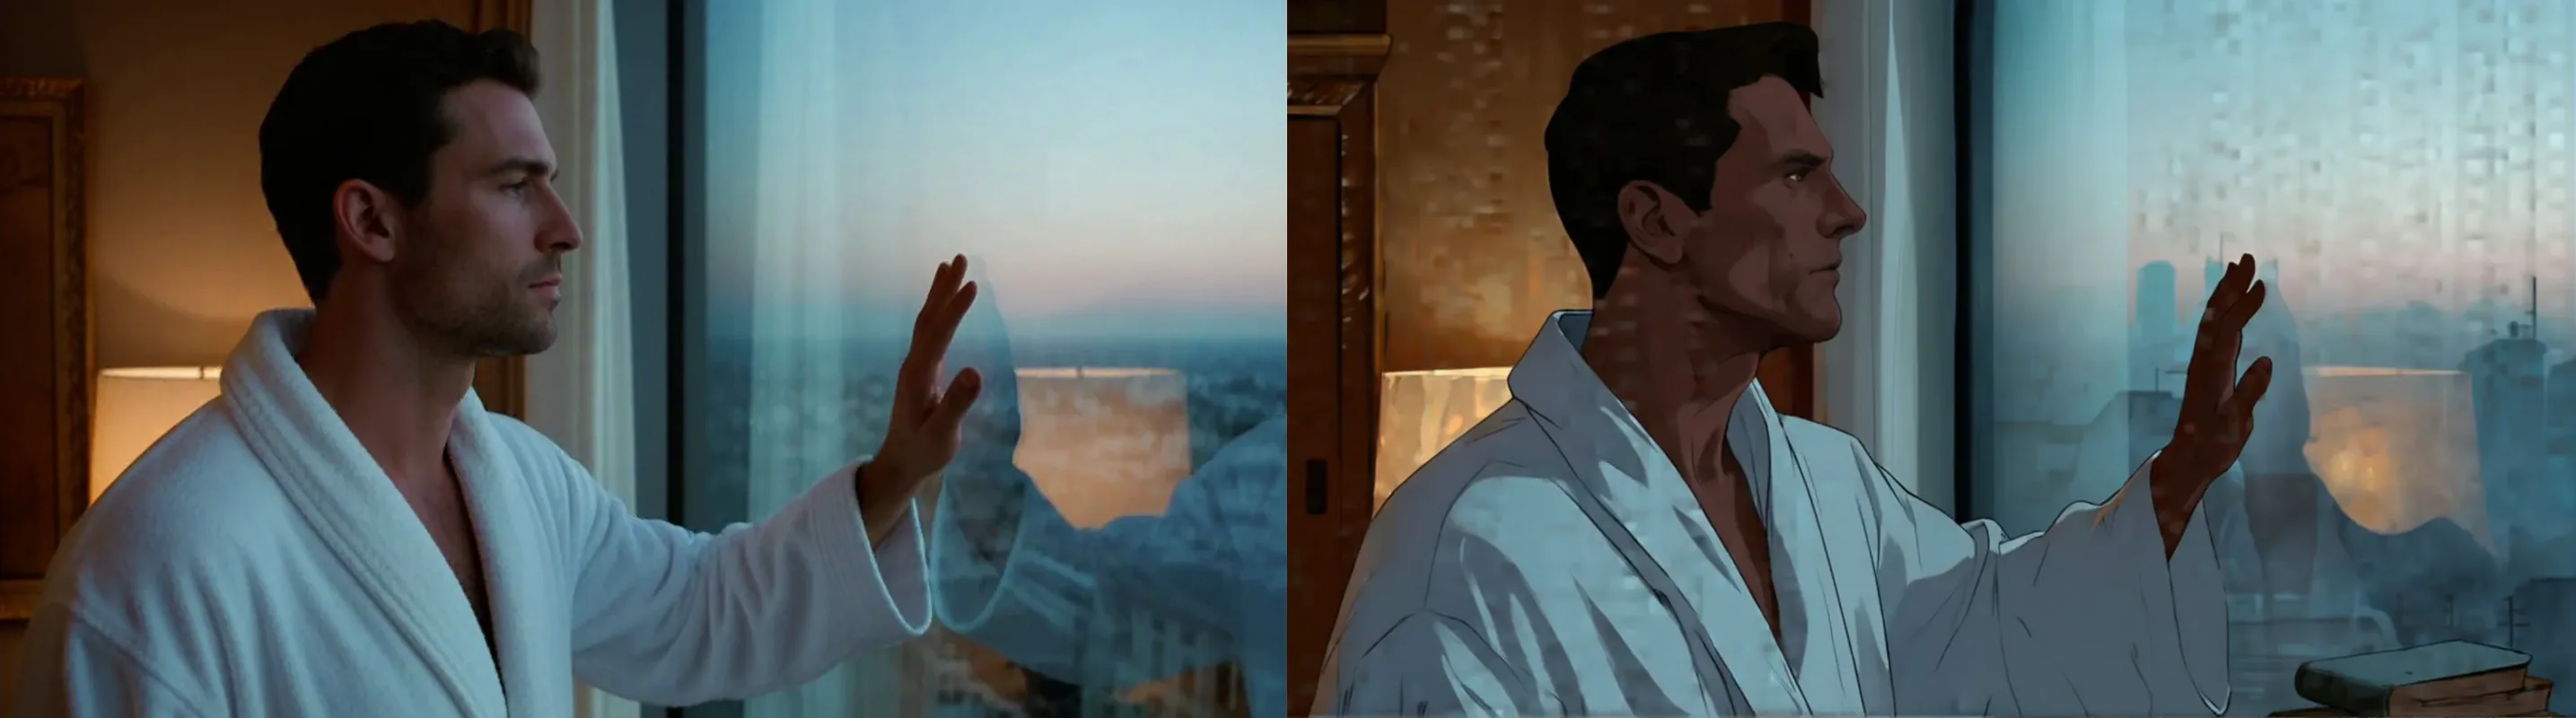
左:当社で生成した元写真。右:Z-Image Base LoRA、画像から画像、1.5k、seed 55、mikkoani LoRA を強度 1、strength 0.65 で使用。
スタイルを変えるもので、指示には従わない
LoRA なしでは、「白黒にして」は strength 0.65 と 0.8 でもカラーのままで、「タキシードを着せて」も 0.7 と 0.8 ではほとんど変わりませんでした。モデルは、あなたの説明をもとにフレームを描き直します。媒体を変えたいならスタイル LoRA を使い、別のシーンにしたいなら十分に説明して strength を上げてください。詳細は編集ページにあります。
サイズ
テキストから画像は SDXL ネイティブサイズの9種類のアスペクト比を提供し、9つすべてが要求どおりのサイズで完了しました。
| 比率 | サイズ | 比率 | サイズ |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
上流は1辺 256〜1536 を受け付けます。1536×1536 と 256×256 は完了し、1600×896、2048×2048、200×200 はサイズ制約のエラーで失敗しました。編集では、resolution が決めるのは長辺だけで、元画像の比率は保たれます。2:3 の写真を 1k にすると 680×1024、16:9 の写真を 1.5k にすると 1536×856 で返ってきました。
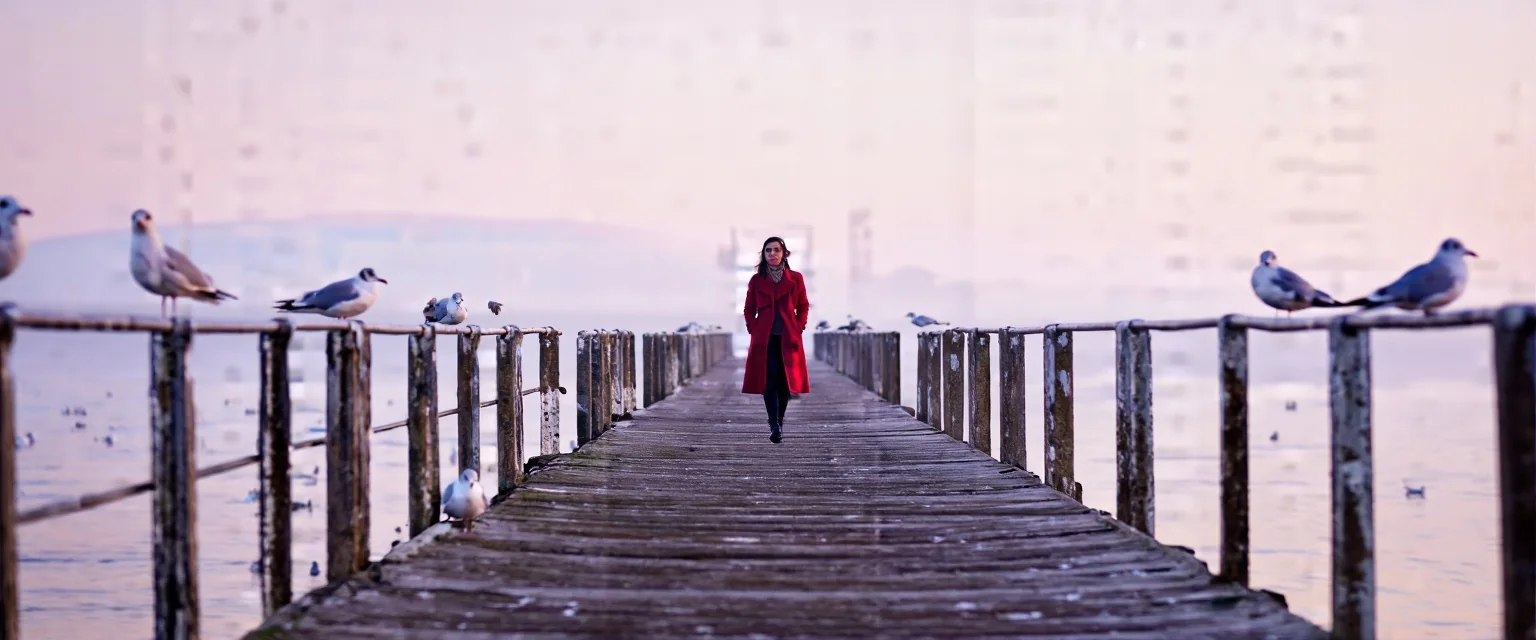
Z-Image Base LoRA、テキストから画像、21:9(1536×640)、seed 45、LoRA なし。
同じ横長の形は、街のシーンにも向いています。
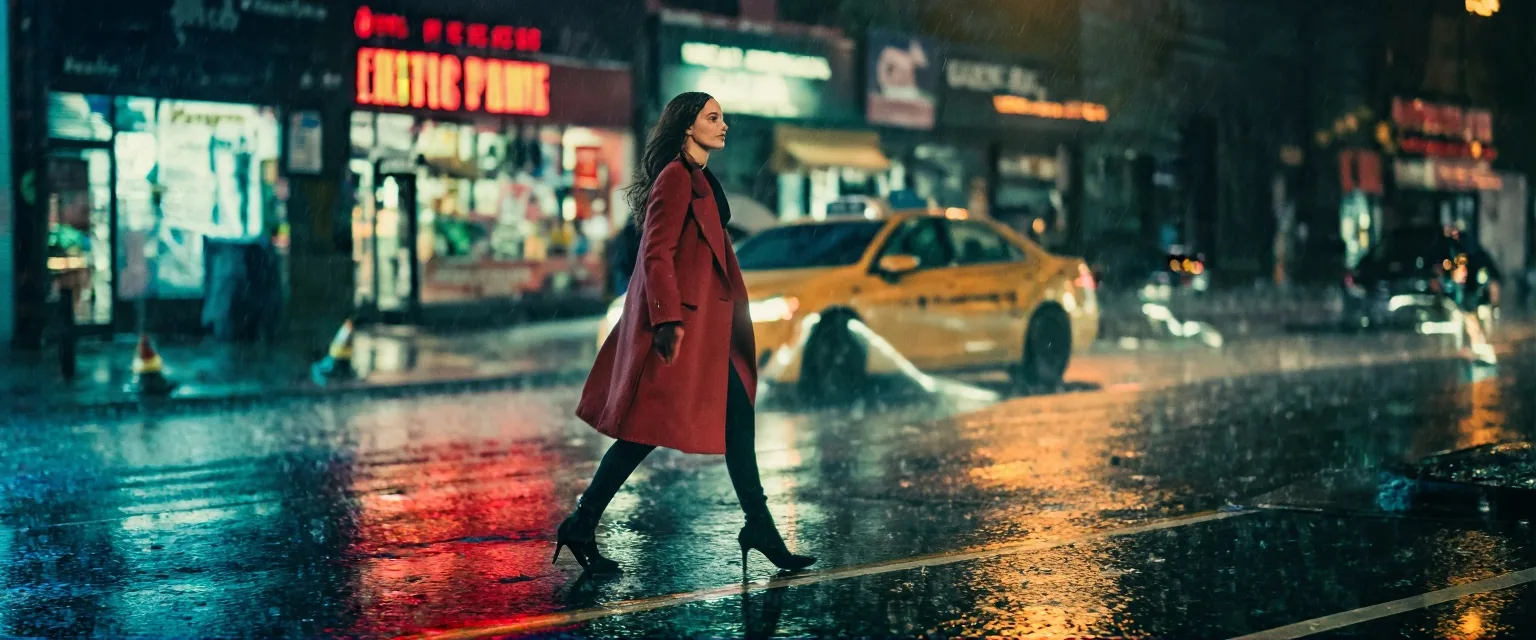
Z-Image Base LoRA、テキストから画像、21:9、LoRA なし。
和らげられるもの
モデルの手前にコンテンツフィルターはありません。当社の段階テストでは、すべてのプロンプトで大人であることを明記したうえで、テキストから画像は L1 ほのめかし(下着、ずり落ちる肩紐)、L2 成熟したテーマ、L3 強め、L5 極限(成人同士の同意に基づく拘束、または映画的なゴア表現)、そして L3 の男性版を書いたとおりに返しました。L4 高強度(成人同士の親密なシーン)は和らげられて返ってきました。 3回試して、seed によっては人物と多少の接触は出ましたが、まとまったシーンにはなりませんでした。服を着た元画像での画像から画像も同様で、低い段階は返り、L3 は strength 0.8 以上から(0.7 は部分的)、L4 は和らげられました。
正直にまとめると、Base 単体ではその最上位の段階を苦手としています。それ用に学習された LoRA が想定された道筋で、守るべき条件は上と同じ、Base 用に限る、です。3つの LoRA を使った画像から画像と、Civitai のリンクの LoRA はテストしていません。
Z-Image Base LoRA か Z-Image Turbo LoRA か
提供元自身による2つのモデルの比較です。
| Z-Image(Base) | Z-Image Turbo | |
|---|---|---|
| ステップ数 | 28〜50 | 8 |
| CFG | あり | なし |
| ファインチューニング | 可能 | 不可 |
| ネガティブプロンプト | あり(このエンドポイントでは非公開) | なし |
| 多様性 | 高い | 低い |
| 画質 | 高い | 非常に高い |
Z-Image Turbo LoRA は、蒸留された8ステップのモデルで、Turbo 用に学習された LoRA を最大3つまで使え、約1メガピクセル、9種類の比率に対応し、画像から画像の既定 strength は 0.8 です。Turbo のアダプターがどう振る舞うかは、同一 seed での Turbo LoRA テストをご覧ください。2つのファミリーで LoRA は共有できません。 Base に Turbo のファイルを読み込むと、当社のテストでは画像が崩れました。逆はテストしていないため、Base のファイルが Turbo で安全だとは考えないでください。
| やりたいこと | 選ぶもの |
|---|---|
| Z-Image Base で学習された LoRA | Z-Image Base LoRA |
| Z-Image Turbo で学習された LoRA | Z-Image Turbo LoRA |
| 数秒で返ってくる最速の応答 | Turbo。Base はテキストから画像で中央値 32.8 秒かかった |
| スタイル LoRA で写真をイラストに | Base の編集で strength を約 0.6、Base で学習されたスタイル LoRA と組み合わせる |
| LoRA なしで、プロンプトによく従う普通の生成 | どちらでも可。当社のテストでは Base は言葉に細かく従った |
| ステップ数、guidance、ネガティブプロンプトの制御 | どちらのエンドポイントも公開していない |
Z-Image Base LoRA、テキストから画像、LoRA なし。当社のカバー用セットからの、映画的なポートレートのプロンプト。
FAQ
Z-Image Turbo の LoRA を Base で使えますか?
いいえ。当社のテストでは、Turbo で学習された LoRA は Base にエラーなしで読み込まれ、画像をノイズと疑似テキストに崩しました。Z-Image Base で学習されたファイルを使ってください。
Z-Image の LoRA を読み込んだのに何も変わらなかったのはなぜですか?
おそらく別のキー形式で保存されているか、別のモデル向けに学習されたものです。Z-Image 向けと表記されながら異なる形式で保存されたファイルと Pony の LoRA は、どちらも読み込まれ、ピクセル単位で同一の出力になりました。ありとなしを1組実行してみてください。
編集の strength はいくつにすべきですか?
既定の 0.7 から始めるか、構図を保ちたいスタイル LoRA では 0.6 前後にします。当社の段階テストでは、0.3 と 0.5 は写真をほとんど変えず、0.75 はシーンを組み直し、0.85 は別の絵になりました。
「白黒にして」のような指示に従えますか?
いいえ。LoRA なしでは、白黒は 0.65 と 0.8 でもカラーのままで、タキシードの依頼もほとんど変化しませんでした。説明から描き直すので、見た目の指定にはスタイル LoRA を使ってください。
どのサイズが使えますか?
テキストから画像は9種類のアスペクト比で、1辺は最大 1536 です。編集は長辺に 1k または 1.5k を指定します。200×200 や 2048×2048 のリクエストは、当社のテストで失敗しました。
Base はどれくらい遅いですか?
テキストから画像は 9.8〜56.7 秒、36回の実行で中央値は 32.8 秒でした。編集は 4.9〜41.7 秒、28回の実行で中央値は 16.8 秒でした。
Base は最も親密なシーンを描けますか?
単体では説得力のある描写になりません。3回の試行でその段階は和らげられて返り、それより下の段階は書いたとおりにレンダリングされました。さらに先へ進むには、それ用に学習された LoRA が手段です。
ステップ数、guidance、ネガティブプロンプトは指定できますか?
できません。提供元はモデル自体について 28〜50 ステップを推奨していますが、このエンドポイントにそのようなフィールドはありません。