На Z-Image Base LoRA используйте LoRA, обученные на Z-Image Base: LoRA, обученная под Z-Image Turbo, разрушила изображение до шума и псевдотекста, когда мы загрузили её на Base 5 октября 2026 года. Base — более медленная недистиллированная модель, на которой учится сообщество, поэтому медиана её времени для текста в изображение в наших 36 прогонах составила 32,8 секунды. Для правки strength по умолчанию равен 0.7, а около 0.6 со стилевой LoRA перерисовывало весь кадр, в точности сохраняя композицию.
Z-Image Base LoRA запускает Z-Image Base от Tongyi-MAI из Alibaba — однопоточный диффузионный трансформер на 6 миллиардов параметров — с до тремя вашими LoRA как в режиме «текст в изображение», так и в режиме «изображение в изображение». В карточке модели Base названа основой семейства Z-Image, предназначенной для разработки и идеальной отправной точкой для сообщества; она поддерживает обучение LoRA, потому что не дистиллирована. Эндпоинты работают без цензуры: платформа не добавляет никакого фильтра контента. Сначала честное ограничение: сама по себе базовая модель плохо рисует самые интимные сцены — именно для этого и существуют взрослые LoRA. Каждый промпт в этом руководстве — обычная сцена с одетыми взрослыми.
Коротко
| Вопрос | Ответ (проверено 5 октября 2026) |
|---|---|
| Модель | Z-Image Base от Tongyi-MAI (Alibaba), 6 миллиардов параметров |
| Имена моделей в API | alibaba/z-image-base-lora/text-to-image и alibaba/z-image-base-lora/edit |
| Поле LoRA | loras: до 3 элементов, каждый {path, scale}, scale от 0 до 4 |
| Подходящие LoRA | Файлы, обученные на Z-Image Base |
| Неподходящие LoRA | Обученные под Turbo: сломали картинку. Для Pony или сохранённые иначе: без ошибки, без изменений |
| Strength при правке | От 0 до 1, по умолчанию 0.7 |
| Размеры для текста в изображение | Девять соотношений сторон, каждая сторона до 1536 |
| Размеры при правке | resolution 1k или 1.5k задаёт длинную сторону; соотношение сторон исходника сохраняется |
| Скорость в наших тестах | Текст в изображение 9,8–56,7 с, медиана 32,8 (36 прогонов); правка 4,9–41,7 с, медиана 16,8 (28 прогонов) |
| Не открыты | Шаги, guidance и негативный промпт |
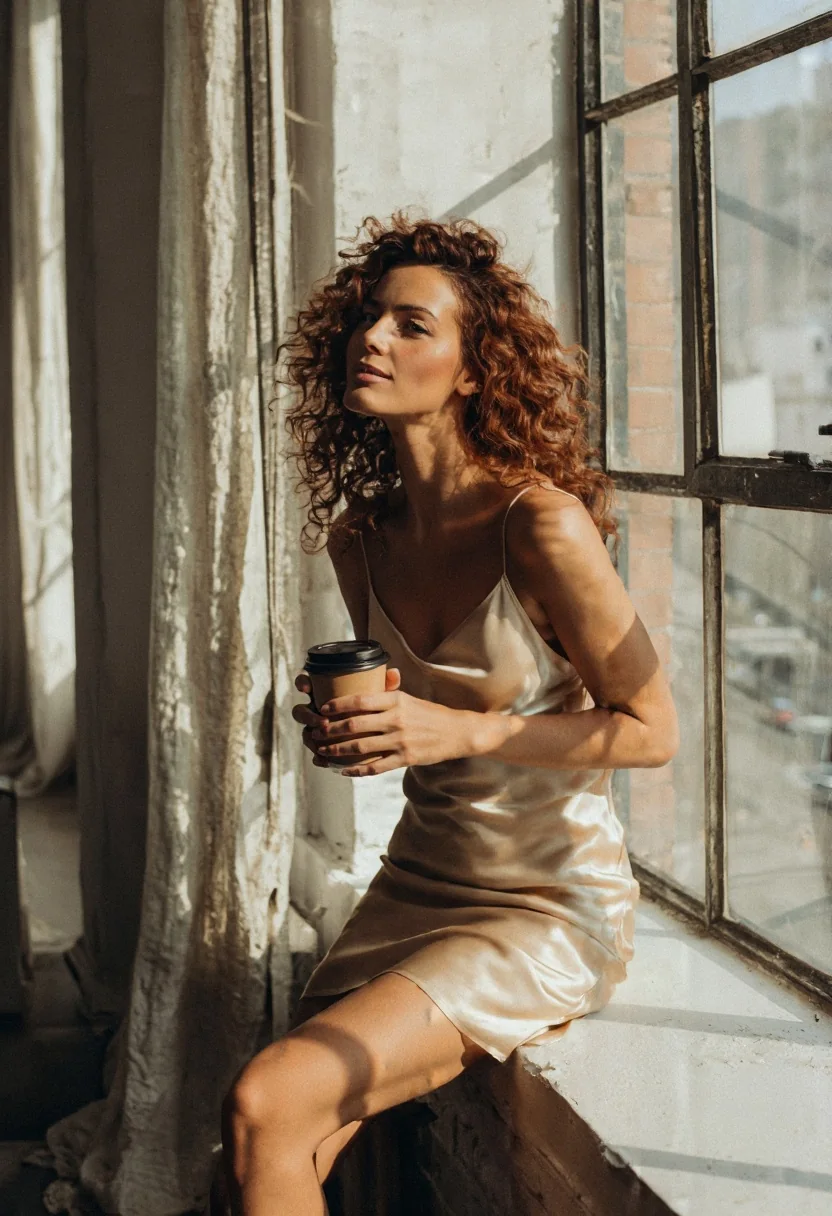
Z-Image Base LoRA, текст в изображение, 2:3 (832×1216), seed 41, без LoRA. Промпт приведён в следующем разделе.
Промпты: простые предложения, точное следование
В наших тестах Base очень точно следовала промпту. Пишите так, как поставили бы задачу фотографу: герой, одежда, место, свет, зерно. Портрет в лофте выше получился из одного предложения:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.Тот же шаблон предложения, где заменён только герой, дал боксёра в старом зале:
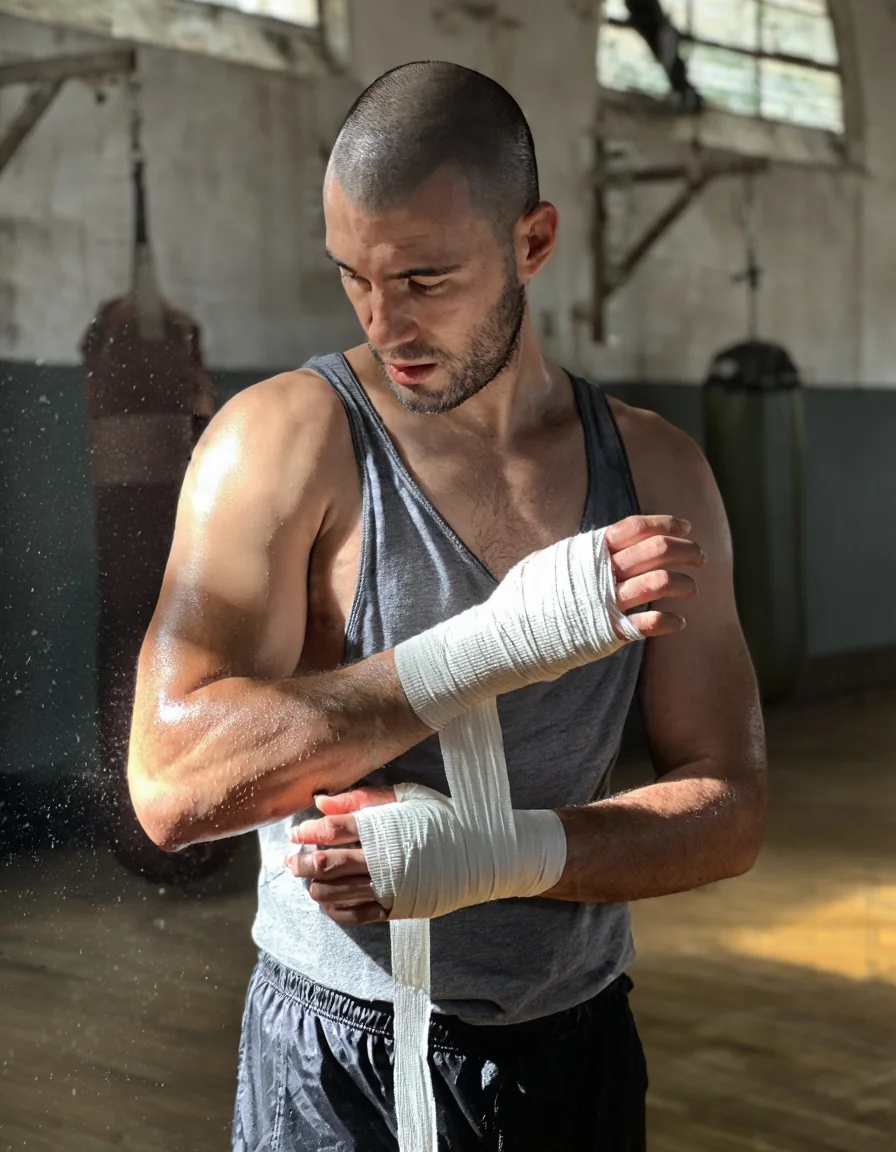
Z-Image Base LoRA, текст в изображение, 3:4 (896×1152), seed 42, без LoRA.
Полей для негативного промпта, guidance и шагов нет. Издатель рекомендует для самой модели guidance от 3.0 до 5.0 и от 28 до 50 шагов, но этот эндпоинт не открывает ни одного из них, поэтому тон и стиль задают промпт и LoRA.
Какие LoRA работают на Base
Именно на этот вопрос и отвечает это семейство, поэтому мы попробовали четыре вида файлов:
| LoRA | Обучена под | Что произошло |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Работала при 0.5 и при 1 |
| LoRA для Z-Image Turbo | Z-Image Turbo | Загрузилась без ошибки и сломала картинку (шум и псевдотекст) |
furaidosu/flat-cartoon-zimage, помечена как для Z-Image | Другой формат ключей | Загрузилась без ошибки, результат пиксель в пиксель тот же: без изменений |
| LoRA для Pony | Pony SDXL | Загрузилась без ошибки, результат пиксель в пиксель тот же: без изменений |
Два сбоя тихие, а один выглядит громко. Неверно помеченный файл или файл от другой базовой модели ничего не меняет, и вы можете час винить свой промпт; файл для Turbo на Base устраивает кашу, что хотя бы подсказывает: что-то не так. Прежде чем строить что-то на адаптере, сделайте одну пару прогонов с файлом и без него, с одним и тем же seed. Если они совпадают, файл здесь ничего не делает; если получился шум, он обучен под Turbo.
Hugging Face перечисляет адаптеры, у которых базовая модель — Tongyi-MAI/Z-Image. Мы взяли только первые 40 по числу загрузок: в основном LoRA с сходством с реальными людьми, плюс несколько стилевых. Весь список мы не считали, поэтому числа не называем.
Что проверить, прежде чем брать LoRA:
- Базовая модель: в карточке указано Z-Image Base или Tongyi-MAI/Z-Image, а не Turbo, Pony или FLUX.
- Файл, на который можно сослаться: в репозитории лежит файл
.safetensors, и вы можете собрать его ссылку видаresolve/main/. - Публичный доступ: закрытый файл отвечает сообщением с HTTP 401.
- Триггерная фраза: копируйте её из карточки точно.
- Лицензия: прочитайте лицензию в карточке самой LoRA.
LoRA mikkoani: одна фраза, другой вид
LoRA mikkoani включается своей фразой, mature illustration with muted color and complex linework, в начале промпта. Вот сцена в бальном зале с LoRA при scale 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}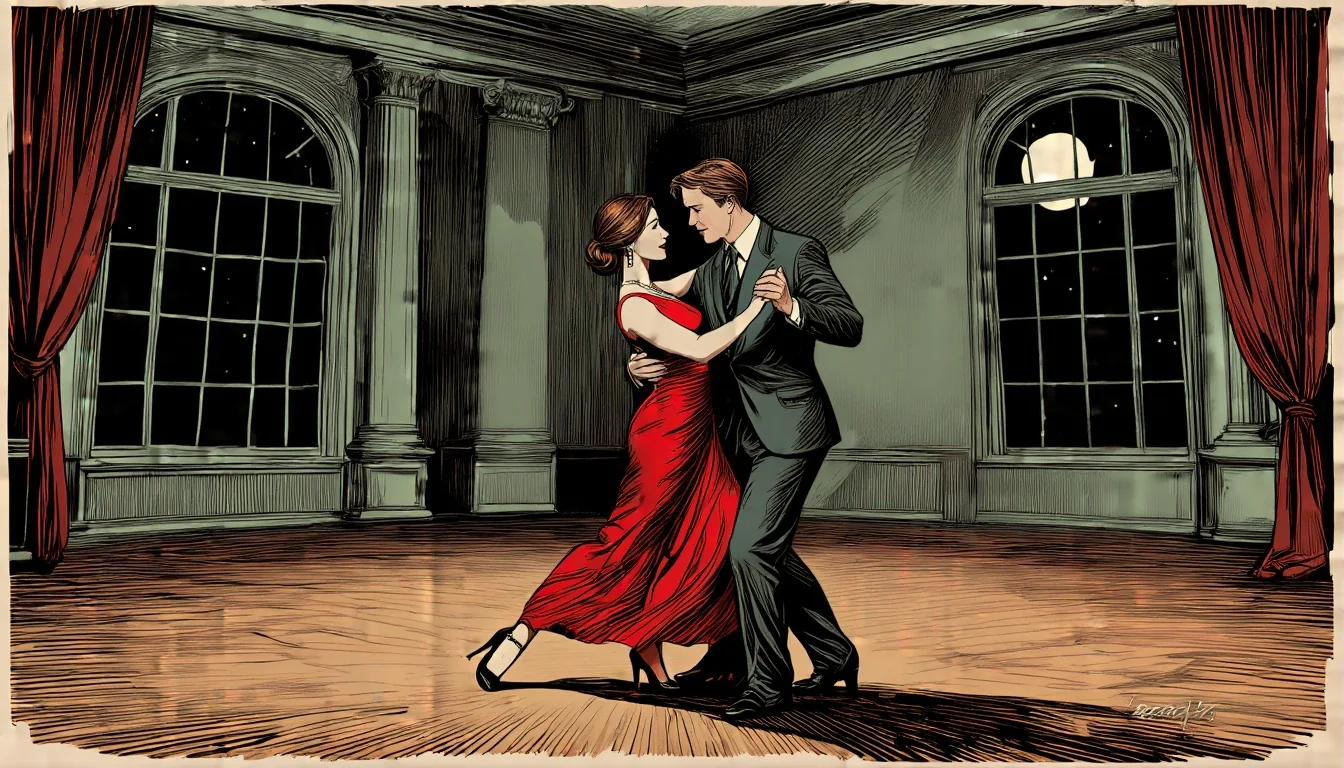
Z-Image Base LoRA, текст в изображение, 16:9 (1344×768), seed 43, LoRA mikkoani со scale 1.
Ещё одно наблюдение, о котором стоит знать: одна эта фраза, без LoRA, уже сдвигала фотографический промпт в сторону иллюстрации. Base сильно следует формулировке, поэтому триггерная фраза может нести часть стиля, даже если файл не загрузился. Из-за этого пара с файлом и без него становится чуть менее очевидной: сравнивайте качество линий и палитру, а не только жанр.
Strength при правке: лестница
Эндпоинт правки принимает одно исходное изображение, strength от 0 до 1 и то же поле loras. Наше публичное значение по умолчанию — 0.7; у исходного сервиса по умолчанию 0.6. Мы прогнали лестницу значений на фотографии без LoRA:
| Strength | Что мы увидели |
|---|---|
| 0.3 и 0.5 | Почти без изменений |
| 0.6 | Небольшое изменение |
| 0.7 | Содержание начинает меняться; композиция сохранена |
| 0.75 | Сцена заново поставлена и обставлена, свет и палитра сохранены |
| 0.85 | Новая картинка |
Со стилевой LoRA картинка меняется: при 0.6 она перерисовала весь кадр и в точности сохранила композицию. Это золотая середина для превращения фото в иллюстрацию.
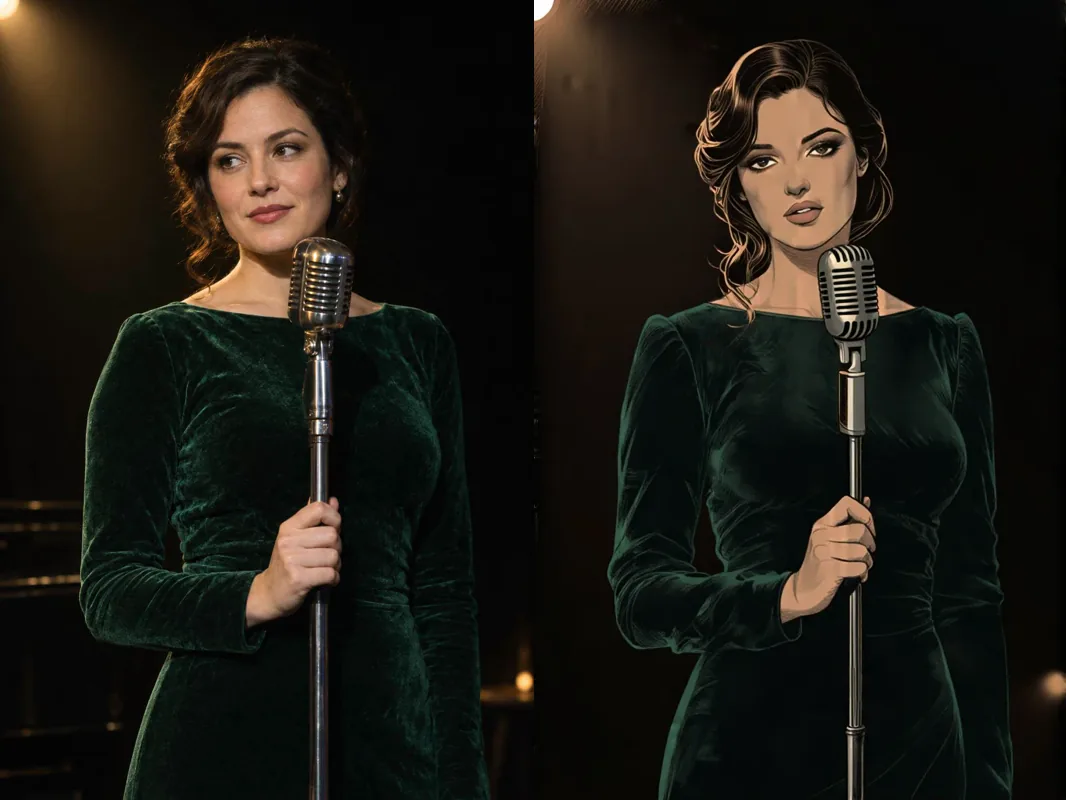
Слева: наше сгенерированное исходное фото. Справа: Z-Image Base LoRA, изображение в изображение, 1k, seed 51, LoRA mikkoani со scale 1, strength 0.6.
Промпт для правки описывает всю картинку, которую вы хотите получить, а не только изменение:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Второй исходник — мужчина на крыше на закате в расстёгнутой белой льняной рубашке — при той же силе:
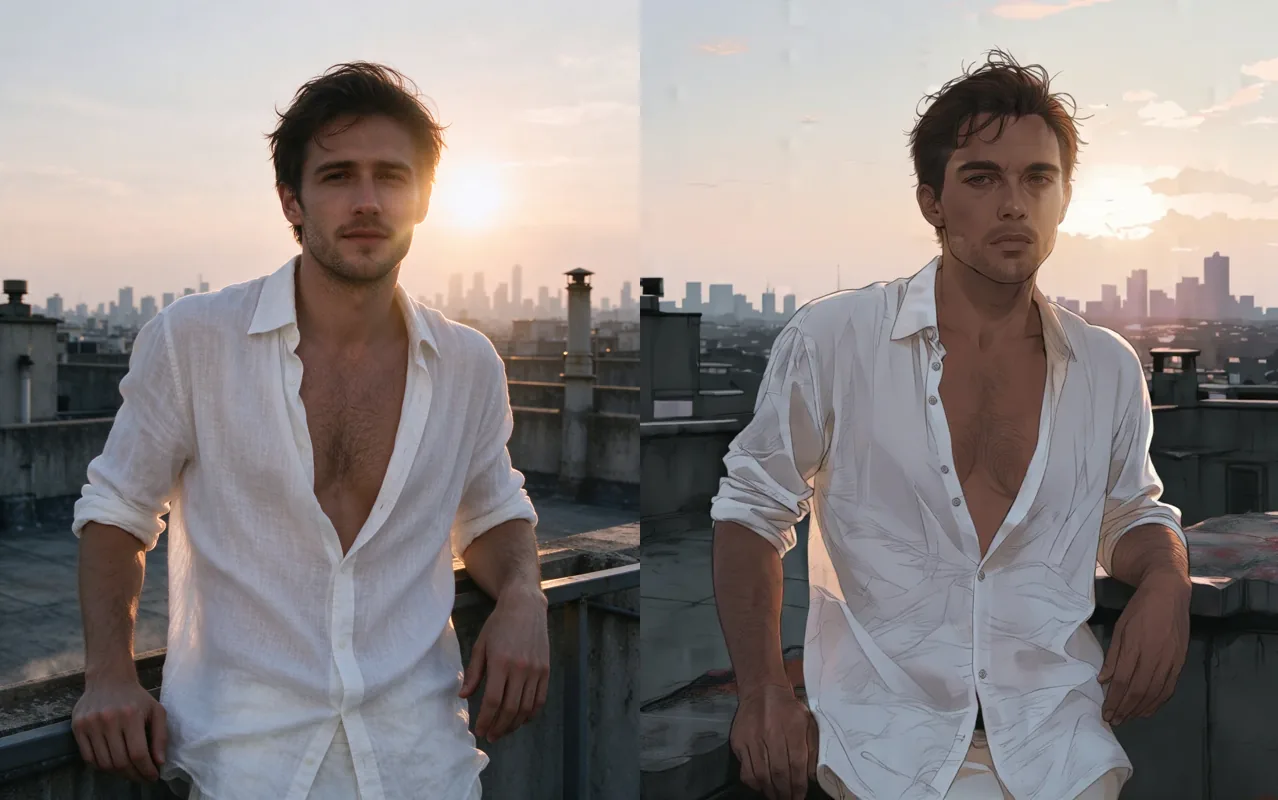
Слева: наше сгенерированное исходное фото. Справа: Z-Image Base LoRA, изображение в изображение, 1k, seed 54, LoRA mikkoani со scale 1, strength 0.6.
И широкий исходник при 1.5k и strength 0.65:
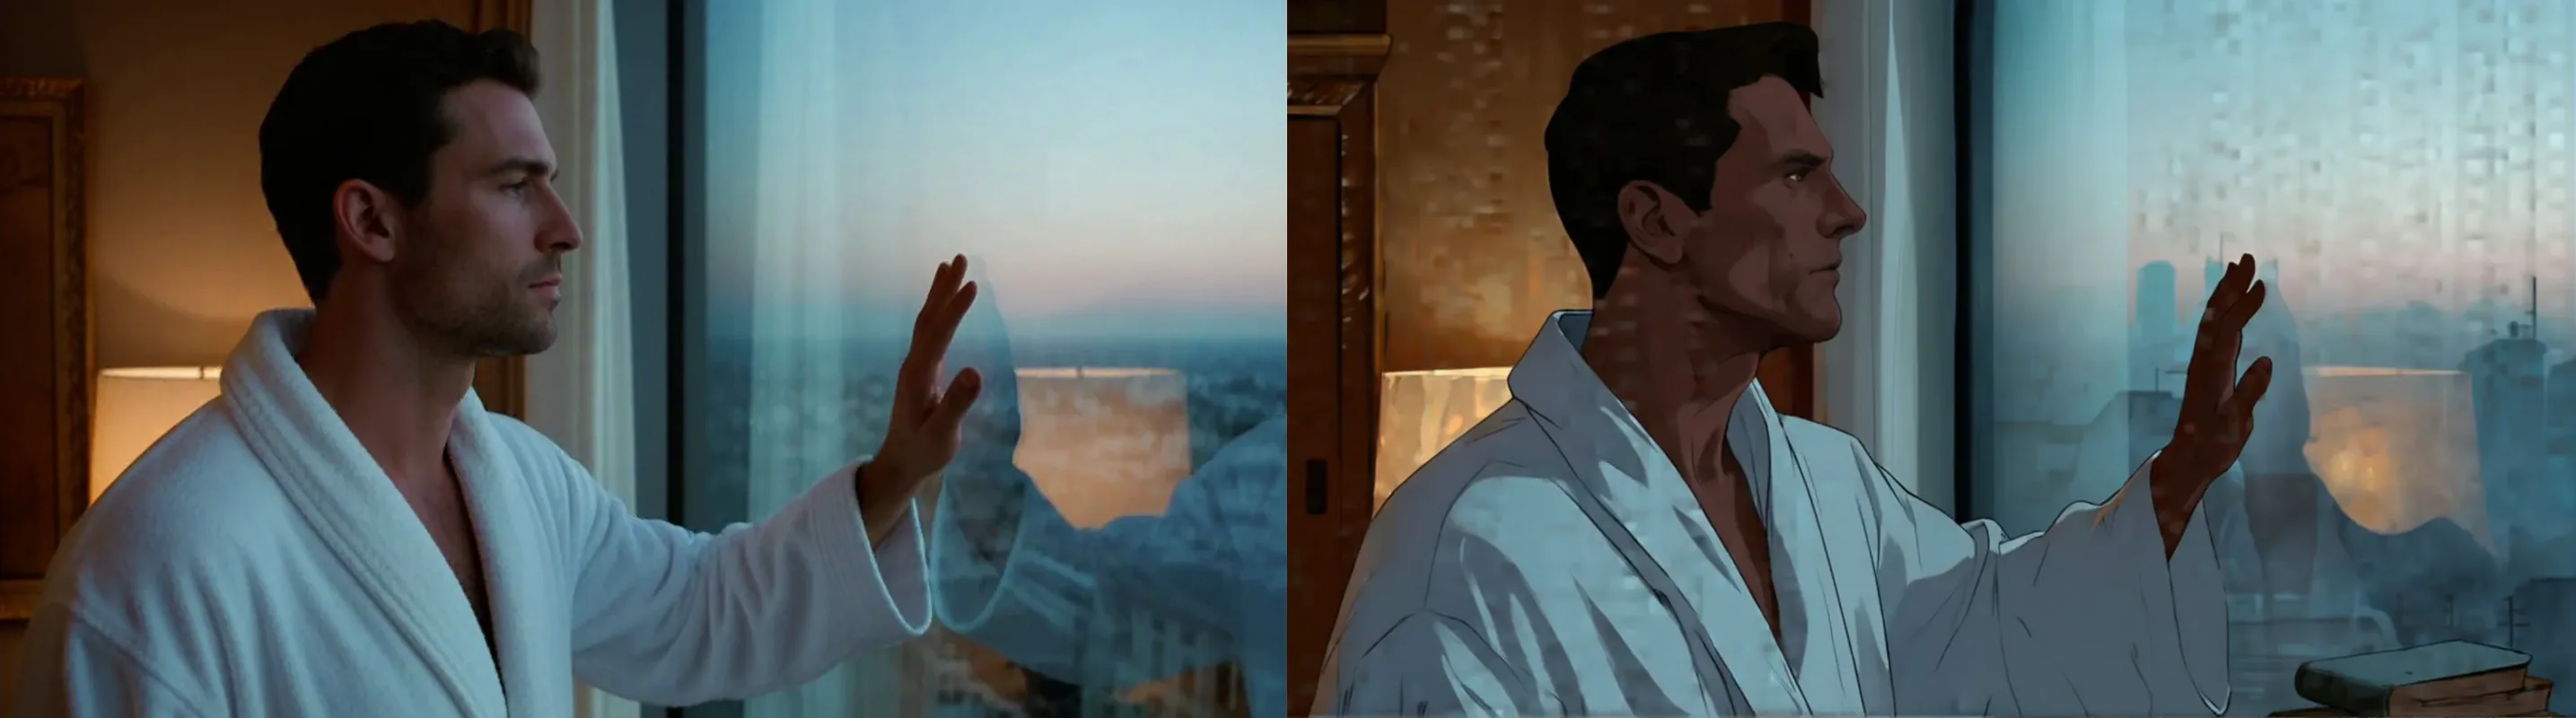
Слева: наше сгенерированное исходное фото. Справа: Z-Image Base LoRA, изображение в изображение, 1.5k, seed 55, LoRA mikkoani со scale 1, strength 0.65.
Она перерисовывает стиль, а не выполняет инструкции
Без LoRA просьба «сделай чёрно-белым» оставалась цветной при strength 0.65 и 0.8, а «одень его в смокинг» мало что меняла при 0.7 и 0.8. Модель перерисовывает кадр по вашему описанию. Для смены техники возьмите стилевую LoRA; для другой сцены опишите её полностью и поднимите strength. Подробности — на странице правки.
Размеры
Текст в изображение предлагает девять соотношений сторон на родных размерах SDXL, и все девять завершились ровно в запрошенном размере:
| Соотношение | Размер | Соотношение | Размер |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
Исходный сервис принимает от 256 до 1536 по стороне: 1536×1536 и 256×256 завершились, а 1600×896, 2048×2048 и 200×200 завершились ошибкой ограничения размера. При правке resolution задаёт только длинную сторону, а соотношение исходника сохраняется: фото 2:3 при 1k вернулось размером 680×1024, а фото 16:9 при 1.5k вернулось размером 1536×856.
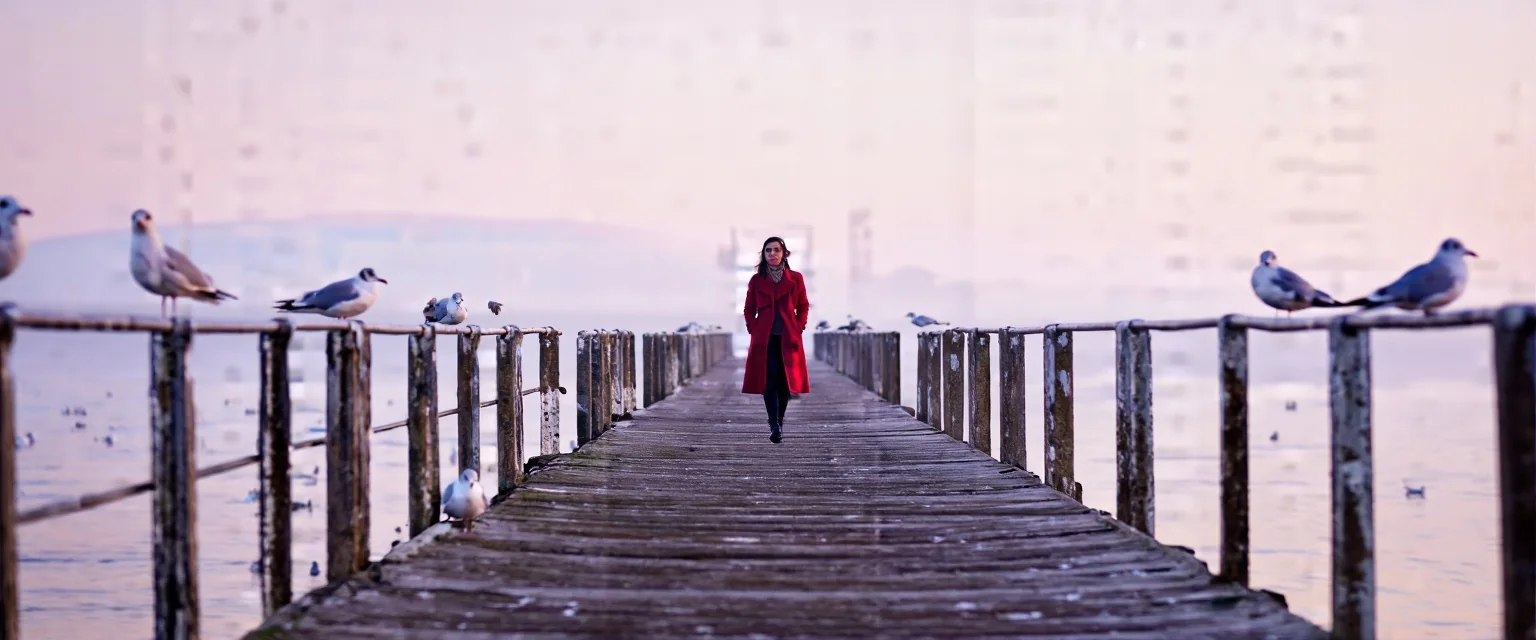
Z-Image Base LoRA, текст в изображение, 21:9 (1536×640), seed 45, без LoRA.
Та же широкая форма подходит для уличных сцен:
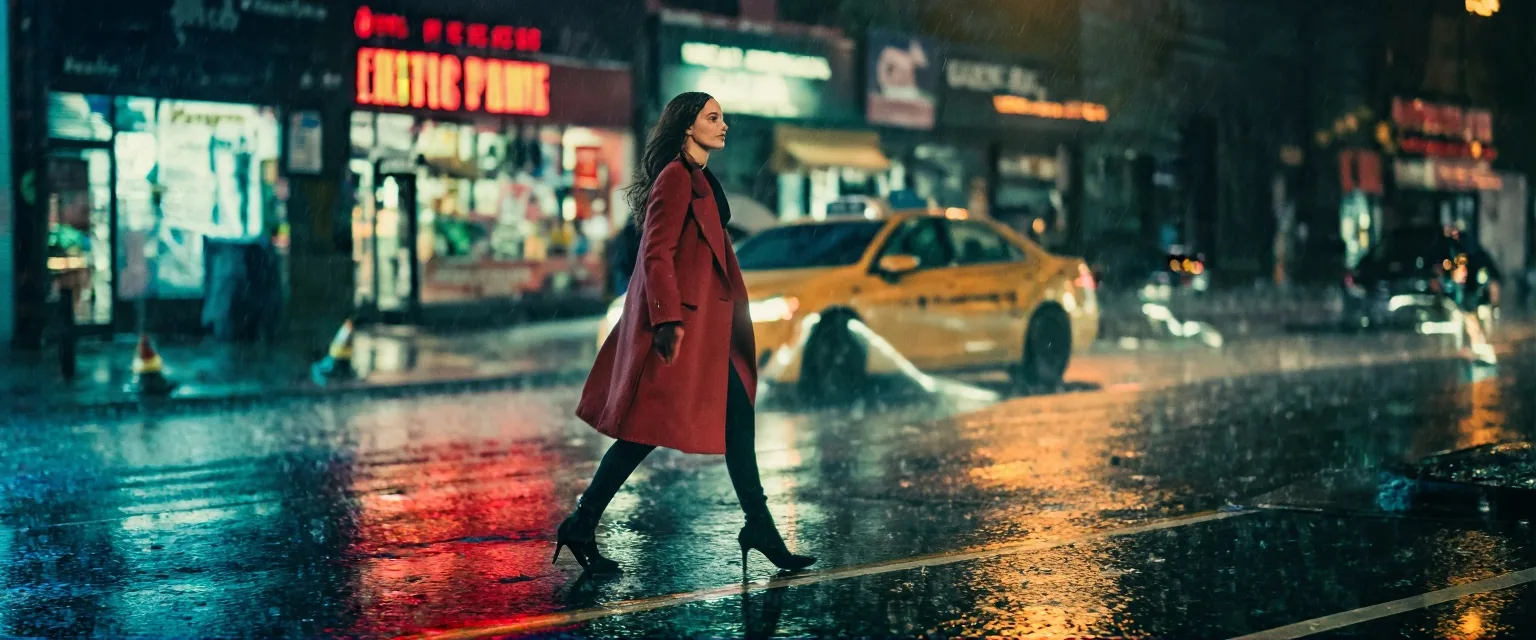
Z-Image Base LoRA, текст в изображение, 21:9, без LoRA.
Что смягчается
Перед моделью нет фильтра контента. В нашей шкале, где в каждом промпте указано, что персонажи взрослые, текст в изображение выдал как написано L1 Намёк (бельё, соскальзывающая бретелька), L2 Взрослые темы, L3 Сильный, L5 Экстрим (согласованное связывание между взрослыми или кинематографичный гор) и мужской вариант L3. L4 Интенсивный (сцена близости между двумя взрослыми) вернулся смягчённым в трёх попытках: seed давали фигуры и некоторый контакт, но не цельную сцену. Изображение в изображение на одетом исходнике вело себя так же: нижние ступени выдавались, L3 — начиная со strength 0.8 (при 0.7 — частично), а L4 смягчался.
Так что честный итог таков: сама Base плохо рисует эту высшую ступень. Предназначенный путь — обученные под неё LoRA с тем же правилом «только для Base», что и выше. Изображение в изображение с тремя LoRA и LoRA по ссылкам Civitai мы не проверяли.
Z-Image Base LoRA или Z-Image Turbo LoRA
Сравнение двух моделей от самого издателя:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Шаги | от 28 до 50 | 8 |
| CFG | да | нет |
| Можно дообучать | да | нет |
| Негативный промпт | да (этот эндпоинт его не открывает) | нет |
| Разнообразие | Высокое | Низкое |
| Визуальное качество | Высокое | Очень высокое |
Z-Image Turbo LoRA — дистиллированная 8-шаговая модель с до тремя LoRA, обученными под Turbo, около одного мегапикселя в девяти соотношениях; её strength по умолчанию для изображения в изображение — 0.8. О том, как ведёт себя адаптер для Turbo, читайте в нашем тесте Turbo LoRA с одним seed. Два семейства не делят LoRA. Файл для Turbo на Base сломал картинку в нашем тесте; обратное мы не проверяли, поэтому не считайте, что файл для Base безопасен на Turbo.
| Что вам нужно | Что выбрать |
|---|---|
| LoRA, обученная на Z-Image Base | Z-Image Base LoRA |
| LoRA, обученная на Z-Image Turbo | Z-Image Turbo LoRA |
| Самый быстрый ответ, за секунды | Turbo; Base в среднем (по медиане) тратила 32,8 с на текст в изображение |
| Фото в иллюстрацию со стилевой LoRA | Правка на Base со strength около 0.6 и стилевой LoRA, обученной на Base |
| Простые промпты с точным следованием, без LoRA | Любая; в наших тестах Base близко следовала формулировке |
| Управление шагами, guidance или негативным промптом | Ни один эндпоинт их не открывает |
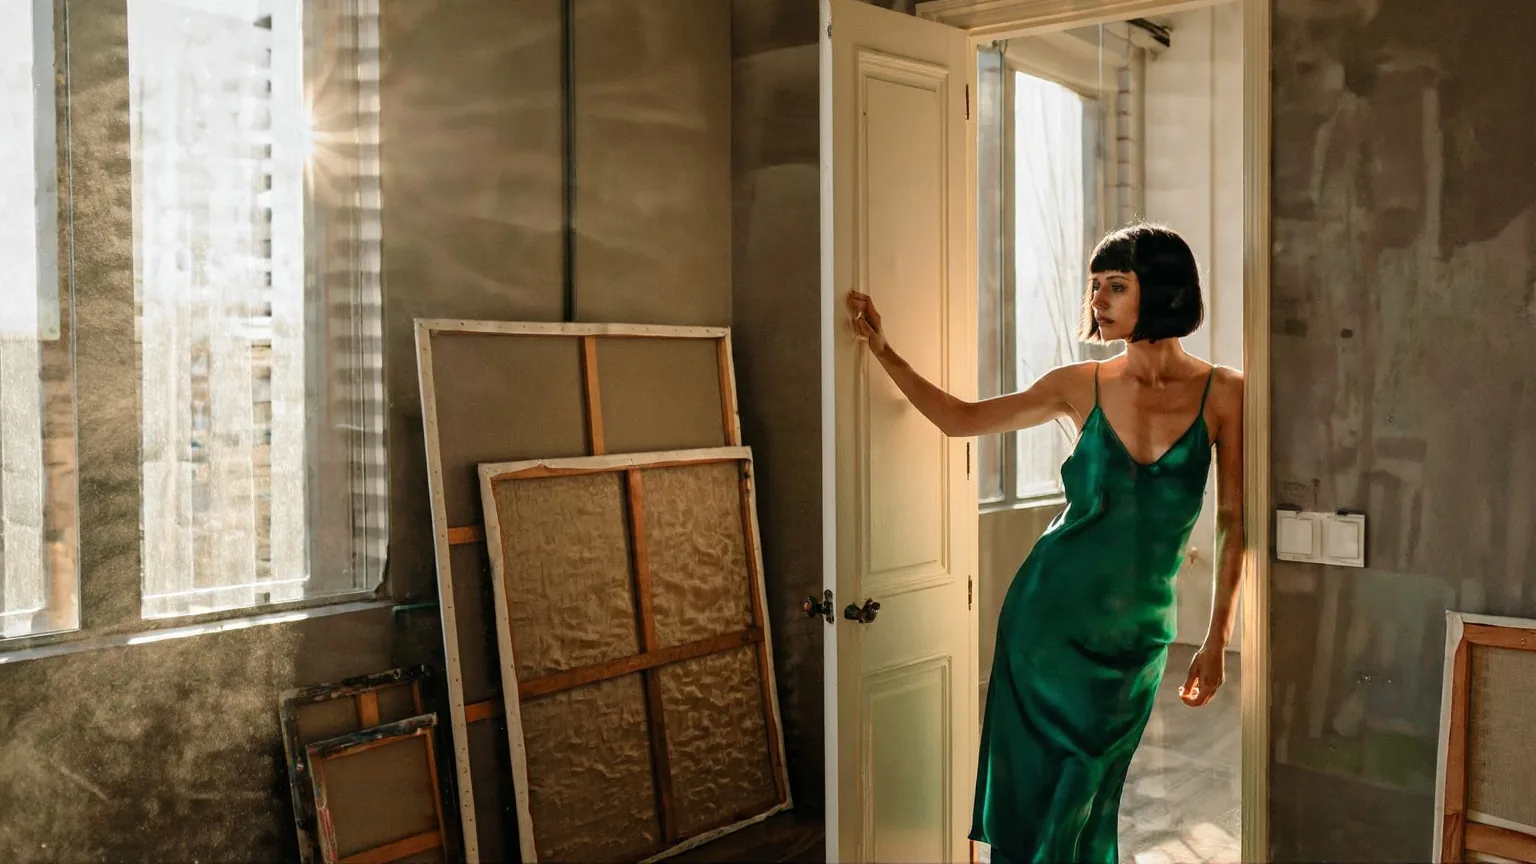
Z-Image Base LoRA, текст в изображение, без LoRA, кинематографичный портретный промпт из нашего набора обложек.
FAQ
Можно ли использовать LoRA для Z-Image Turbo на Base?
Нет. В нашем тесте LoRA, обученная под Turbo, загрузилась на Base без ошибки и разрушила картинку до шума и псевдотекста. Используйте файлы, обученные на Z-Image Base.
Почему моя LoRA для Z-Image ничего не изменила?
Скорее всего, она сохранена в другом формате ключей или обучена под другую модель. Файл, помеченный как для Z-Image, но сохранённый иначе, и LoRA для Pony загрузились и дали результат пиксель в пиксель тот же. Сделайте пару прогонов с файлом и без него.
Какой strength использовать при правке?
Начните со значения по умолчанию 0.7 или около 0.6 со стилевой LoRA, чтобы сохранить композицию. В нашей лестнице 0.3 и 0.5 почти не меняли фото, 0.75 заново ставило сцену, а 0.85 давало новую картинку.
Выполняет ли она инструкции вроде «сделай чёрно-белым»?
Нет. Без LoRA чёрно-белое оставалось цветным при 0.65 и 0.8, а просьба о смокинге мало что меняла. Модель перерисовывает по вашему описанию, поэтому для нужного вида берите стилевую LoRA.
Какие размеры можно использовать?
Девять соотношений сторон для текста в изображение, до 1536 по стороне, и 1k или 1.5k по длинной стороне при правке. Запрос 200×200 или 2048×2048 в наших тестах завершился ошибкой.
Насколько медленна Base?
Текст в изображение занимал от 9,8 до 56,7 секунды, медиана 32,8 по 36 прогонам. Правка занимала от 4,9 до 41,7 секунды, медиана 16,8 по 28 прогонам.
Рисует ли Base самые интимные сцены?
Сама по себе — неубедительно. В трёх попытках эта ступень вернулась смягчённой, а ступени ниже отрисовывались как написано. Чтобы пойти дальше, нужны обученные под неё LoRA.
Можно ли задать шаги, guidance или негативный промпт?
Нет. У эндпоинта нет таких полей, хотя издатель рекомендует для модели от 28 до 50 шагов.