Z-Image Base LoRA에서는 Z-Image Base로 학습된 LoRA를 쓰십시오. 2026년 10월 5일 테스트에서 Z-Image Turbo용으로 학습된 LoRA를 Base에 불러오자 이미지가 노이즈와 가짜 글자로 망가졌습니다. Base는 커뮤니티가 학습에 쓰는, 증류하지 않은 더 느린 모델이라서 36회 실행에서 텍스트 투 이미지 중앙값이 32.8초였습니다. 편집에서는 기본 strength가 0.7이며, 스타일 LoRA와 함께 0.6 부근으로 돌리면 구도는 정확히 유지한 채 프레임 전체의 스타일이 바뀌었습니다.
Z-Image Base LoRA는 알리바바 Tongyi-MAI의 Z-Image Base, 즉 60억 파라미터 싱글 스트림 디퓨전 트랜스포머를 돌리며, 텍스트 투 이미지와 이미지 투 이미지 모두에서 직접 만든 LoRA를 최대 3개까지 쓸 수 있습니다. 모델 카드는 Base를 Z-Image 계열의 토대로, 개발용이며 커뮤니티의 이상적인 출발점이라고 설명합니다. 증류되지 않았기 때문에 LoRA 학습을 지원합니다. 엔드포인트는 무검열입니다. 플랫폼이 콘텐츠 필터를 추가하지 않습니다. 정직한 한계를 먼저 말씀드립니다. 베이스 모델만으로는 가장 친밀한 장면을 잘 그리지 못하며, 성인용 LoRA가 필요한 이유가 바로 그것입니다. 이 가이드의 프롬프트는 모두 옷을 입은 성인이 나오는 일상 장면입니다.
한눈에 보기
| 질문 | 답 (2026년 10월 5일 테스트) |
|---|---|
| 모델 | Tongyi-MAI(알리바바)의 Z-Image Base, 60억 파라미터 |
| API 모델명 | alibaba/z-image-base-lora/text-to-image, alibaba/z-image-base-lora/edit |
| LoRA 필드 | loras: 최대 3개 항목, 각각 {path, scale}, scale 0~4 |
| 맞는 LoRA | Z-Image Base로 학습된 파일 |
| 맞지 않는 LoRA | Turbo로 학습된 것: 이미지가 망가짐. Pony 또는 다르게 저장된 파일: 오류 없음, 변화 없음 |
| 편집 strength | 0~1, 기본값 0.7 |
| 텍스트 투 이미지 크기 | 화면비 9가지, 각 변 최대 1536 |
| 편집 크기 | resolution 1k 또는 1.5k가 긴 변을 정하며, 원본의 화면비가 유지됨 |
| 테스트 속도 | 텍스트 투 이미지 9.8~56.7초, 중앙값 32.8 (36회 실행); 편집 4.9~41.7초, 중앙값 16.8 (28회 실행) |
| 노출되지 않음 | 스텝, guidance, 네거티브 프롬프트 |
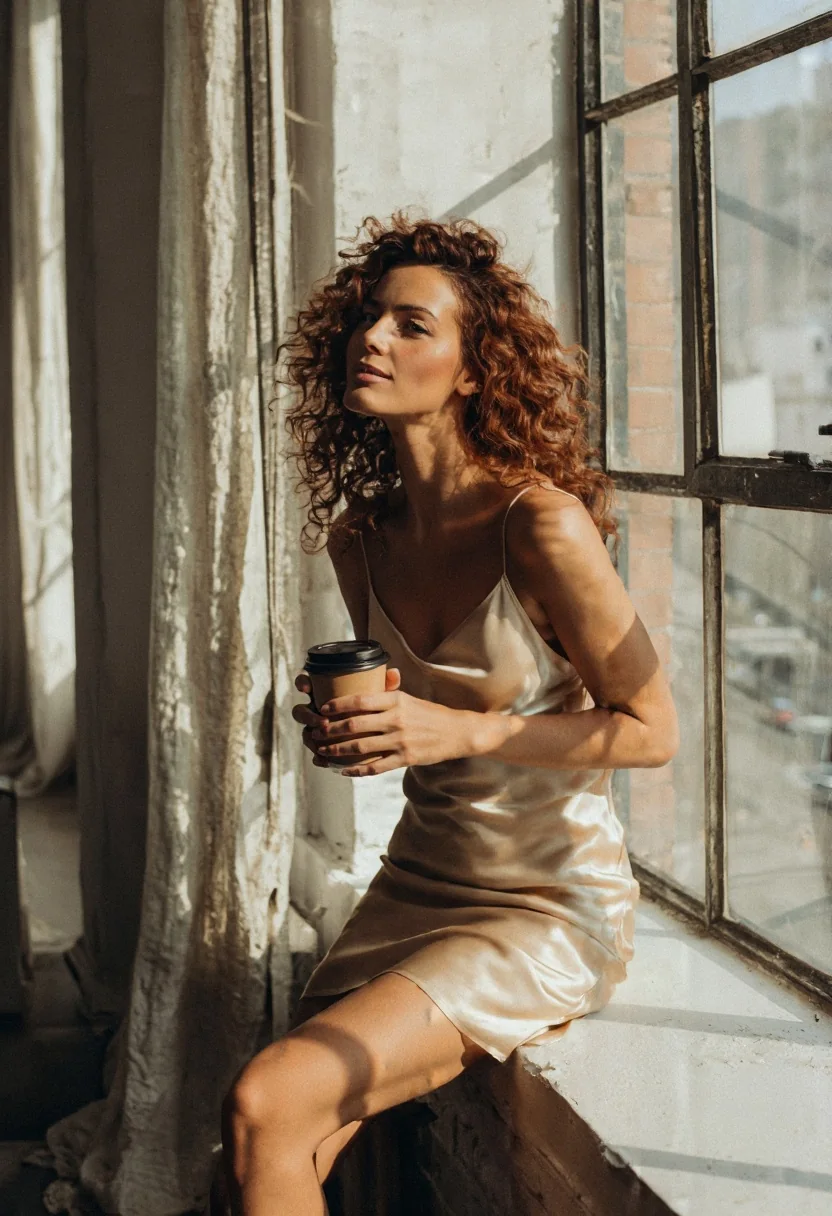
Z-Image Base LoRA, 텍스트 투 이미지, 2:3 (832×1216), seed 41, LoRA 없음. 프롬프트는 다음 섹션에 있습니다.
프롬프트: 평범한 문장, 강한 충실도
저희 테스트에서 Base의 프롬프트 충실도는 강했습니다. 사진가에게 브리핑하듯 쓰십시오: 피사체, 옷, 장소, 빛, 그레인. 위의 로프트 인물 사진은 한 문장에서 나왔습니다.
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.피사체만 바꾼 같은 문장 형태로 오래된 체육관의 복서도 만들어졌습니다.
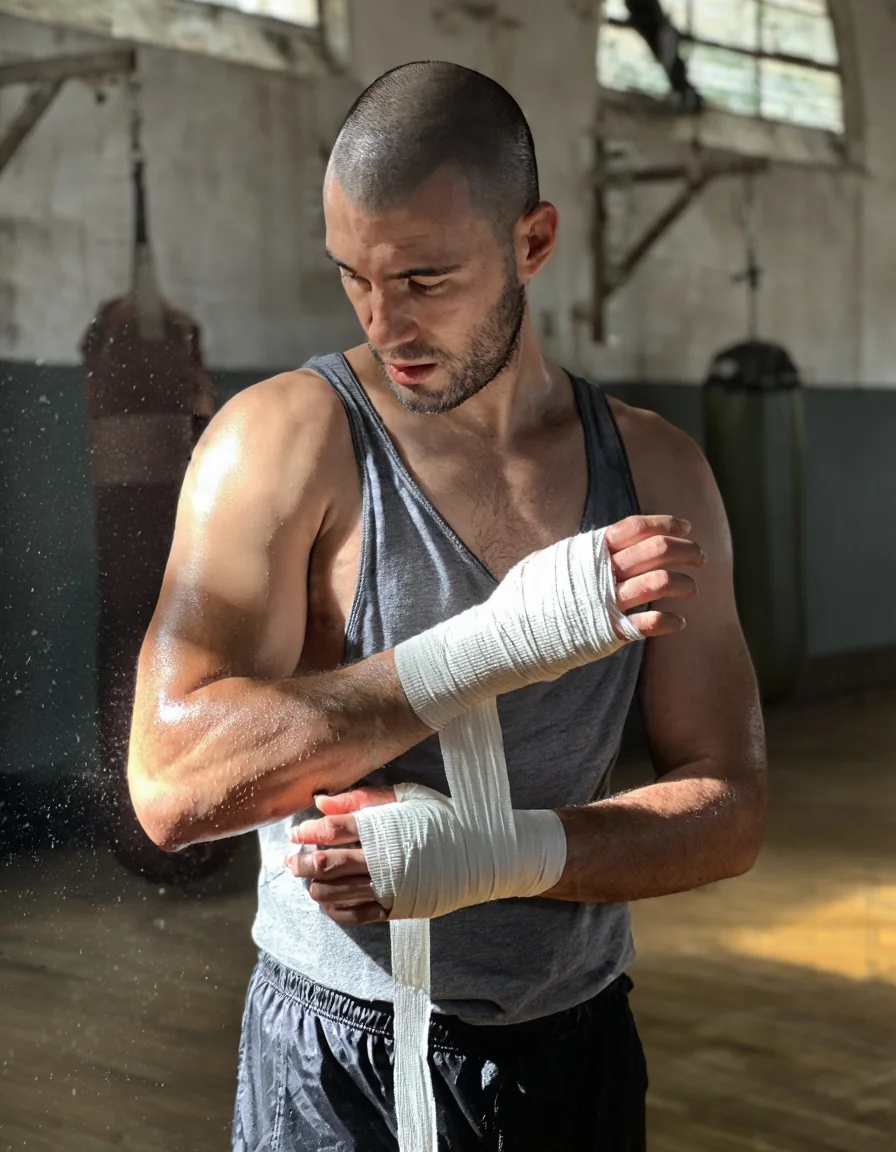
Z-Image Base LoRA, 텍스트 투 이미지, 3:4 (896×1152), seed 42, LoRA 없음.
네거티브 프롬프트, guidance, 스텝 필드는 없습니다. 제공처는 모델 자체에 대해 guidance 3.0~5.0과 28~50스텝을 권장하지만 이 엔드포인트는 그중 어느 것도 노출하지 않으므로, 톤과 스타일은 프롬프트와 LoRA에서 나옵니다.
Base에서 통하는 LoRA
이 계열이 답하려고 존재하는 질문이므로, 네 종류의 파일을 시도했습니다.
| LoRA | 학습 대상 | 결과 |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | 0.5와 1에서 모두 동작 |
| Z-Image Turbo LoRA | Z-Image Turbo | 오류 없이 로드되고 이미지를 망침 (노이즈와 가짜 글자) |
furaidosu/flat-cartoon-zimage, Z-Image용으로 표기됨 | 다른 키 형식 | 오류 없이 로드, 픽셀 단위로 같은 출력: 변화 없음 |
| Pony LoRA | Pony SDXL | 오류 없이 로드, 픽셀 단위로 같은 출력: 변화 없음 |
실패 두 가지는 조용하고 하나는 눈에 띄는 형태입니다. 잘못 표기된 파일이나 다른 베이스 모델의 파일은 아무것도 바꾸지 못하므로, 한 시간 동안 프롬프트를 탓하게 될 수 있습니다. Base에 올린 Turbo 파일은 엉망을 만들어서, 적어도 무언가 잘못됐다는 것은 알려 줍니다. 어댑터 위에 작업을 쌓기 전에, 파일을 넣은 것과 뺀 것 한 쌍을 같은 seed로 돌려 보십시오. 둘이 같다면 이 모델에서 그 파일은 아무 일도 하지 않는 것이고, 결과가 노이즈라면 Turbo용으로 학습된 것입니다.
Hugging Face는 베이스 모델이 Tongyi-MAI/Z-Image인 어댑터를 나열합니다. 저희는 다운로드 수 상위 40개만 살펴봤으며, 대부분 실존 인물 닮은꼴 LoRA이고 스타일 LoRA가 일부 있었습니다. 전체 목록은 세지 않았으므로 숫자는 제시하지 않습니다.
LoRA를 고르기 전 체크리스트:
- 베이스 모델: 카드에 Z-Image Base 또는 Tongyi-MAI/Z-Image라고 적혀 있고, Turbo, Pony, FLUX가 아닙니다.
- 링크할 수 있는 파일: 저장소에
.safetensors파일이 있고resolve/main/링크를 만들 수 있습니다. - 공개 접근: 게이트가 걸린 파일은 HTTP 401 메시지와 함께 실패합니다.
- 트리거 문구: 카드에서 그대로 복사하십시오.
- 라이선스: LoRA 자체 카드의 것을 읽으십시오.
mikkoani LoRA: 문구 하나로 달라지는 룩
mikkoani LoRA는 프롬프트 맨 앞에 문구 mature illustration with muted color and complex linework를 두면 작동합니다. scale 1로 이 LoRA를 쓴 무도회장 장면입니다.
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}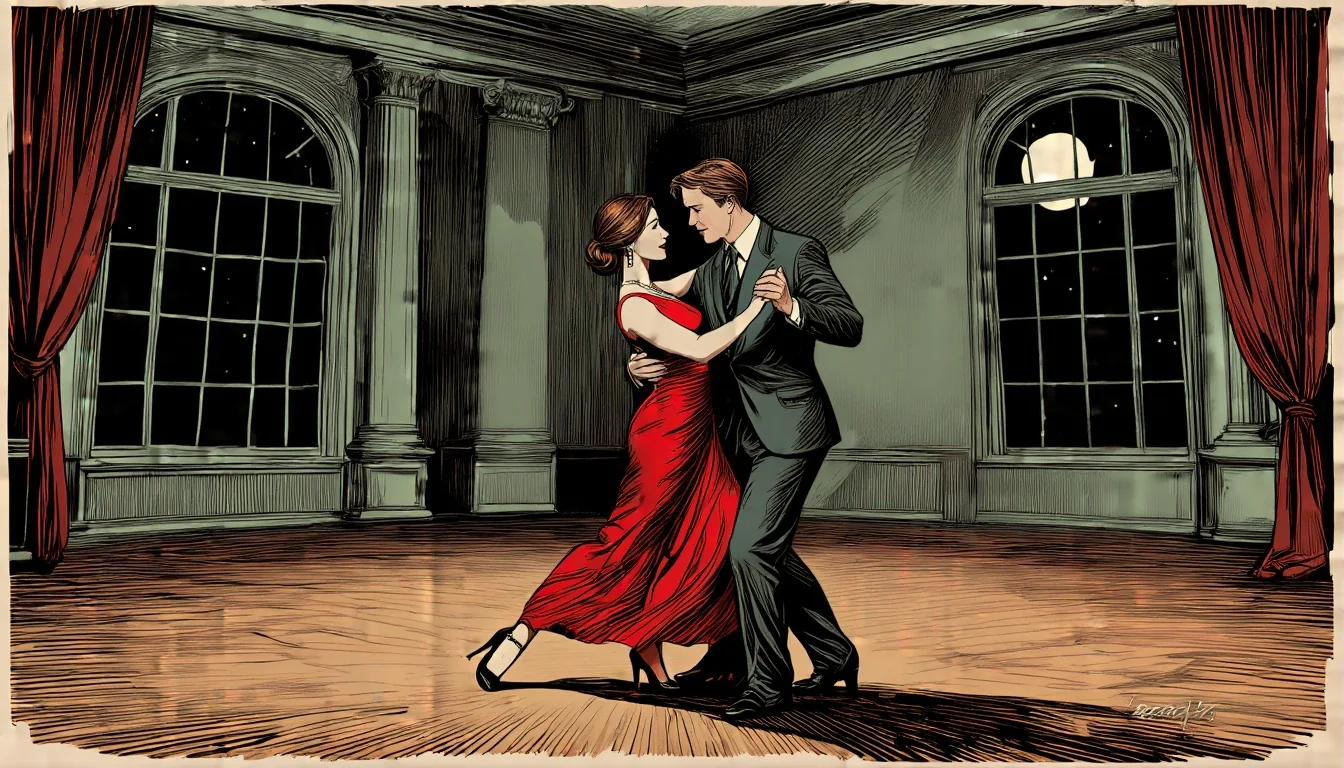
Z-Image Base LoRA, 텍스트 투 이미지, 16:9 (1344×768), seed 43, mikkoani LoRA scale 1.
알아 둘 만한 발견이 하나 더 있습니다. 이 문구 하나만으로도, LoRA 없이, 사진 프롬프트가 이미 일러스트 쪽으로 기울었습니다. Base는 문구를 강하게 따르므로, 파일 로드에 실패하더라도 트리거 문구가 스타일 일부를 실어 나를 수 있습니다. 그래서 넣은 것과 뺀 것의 비교가 조금 덜 명확해집니다. 장르만이 아니라 선의 품질과 팔레트를 비교하십시오.
편집 strength: 단계별 결과
편집 엔드포인트는 원본 이미지 한 장, 0에서 1까지의 strength, 그리고 같은 loras 필드를 받습니다. 저희 공개 기본값은 0.7이고, 업스트림 기본값은 0.6입니다. LoRA 없이 사진 한 장으로 단계별 테스트를 돌렸습니다.
| Strength | 관찰한 것 |
|---|---|
| 0.3과 0.5 | 거의 변화 없음 |
| 0.6 | 약간의 변화 |
| 0.7 | 내용이 바뀌기 시작; 구도 유지 |
| 0.75 | 장면의 포즈와 연출이 새로 짜이며, 빛과 팔레트는 유지 |
| 0.85 | 새로운 그림 |
스타일 LoRA를 쓰면 그림이 달라집니다. 0.6에서 프레임 전체의 스타일이 바뀌었고 구도는 정확히 유지되었습니다. 사진을 일러스트로 바꾸는 데 가장 좋은 지점입니다.
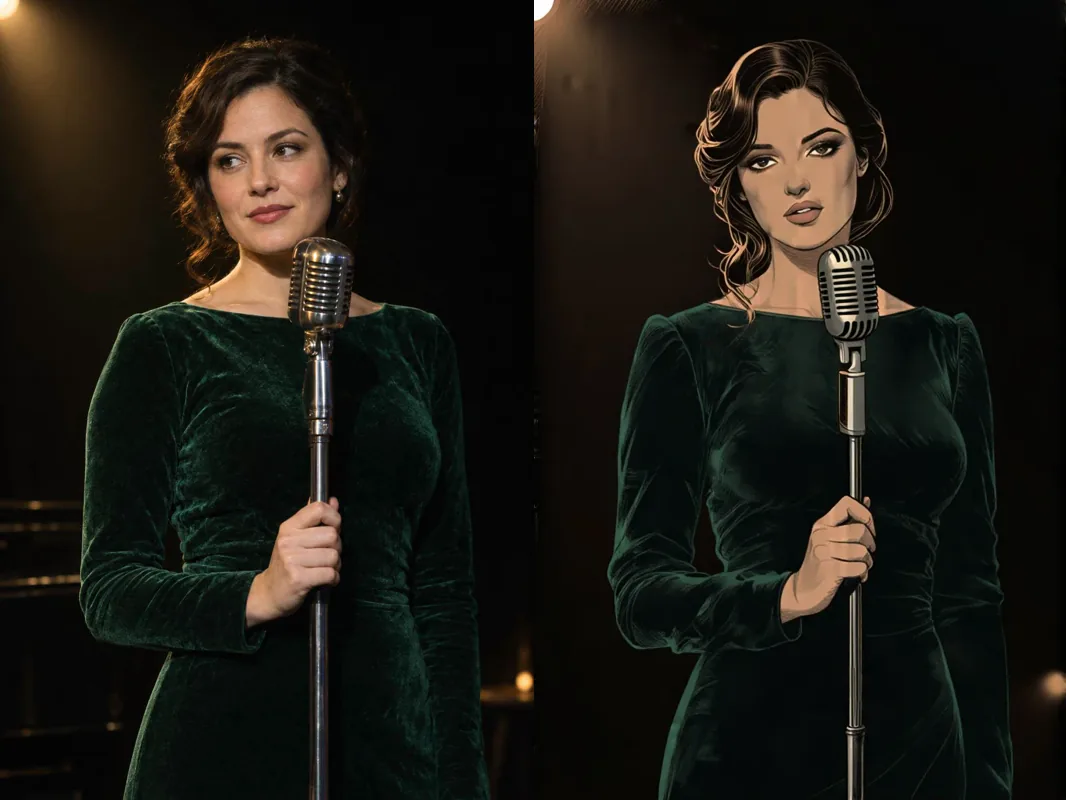
왼쪽: 저희가 생성한 원본 사진. 오른쪽: Z-Image Base LoRA, 이미지 투 이미지, 1k, seed 51, mikkoani LoRA scale 1, strength 0.6.
편집 프롬프트는 바꿀 부분만이 아니라 원하는 그림 전체를 서술합니다.
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.두 번째 원본, 해 질 녘 옥상에서 흰 리넨 셔츠를 풀어 입은 남자를 같은 strength로 돌렸습니다.
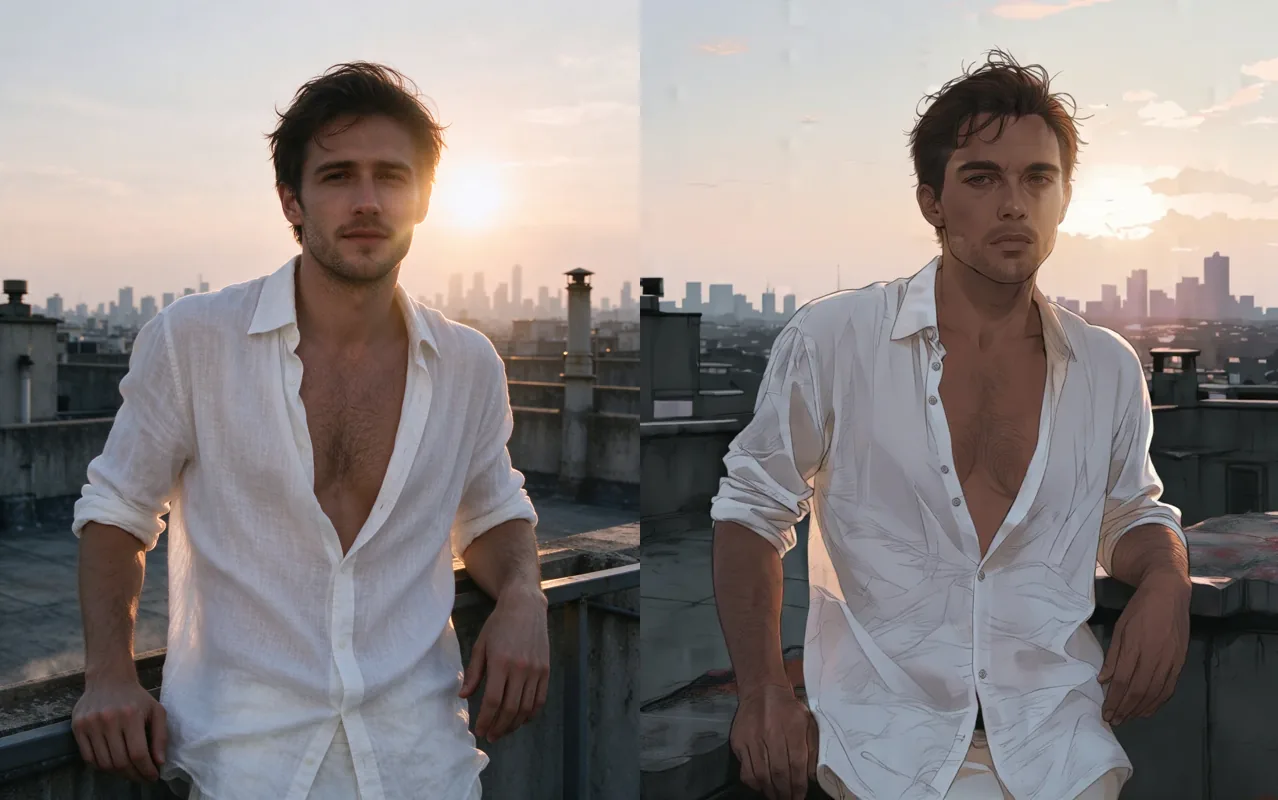
왼쪽: 저희가 생성한 원본 사진. 오른쪽: Z-Image Base LoRA, 이미지 투 이미지, 1k, seed 54, mikkoani LoRA scale 1, strength 0.6.
그리고 1.5k, strength 0.65의 와이드 원본입니다.
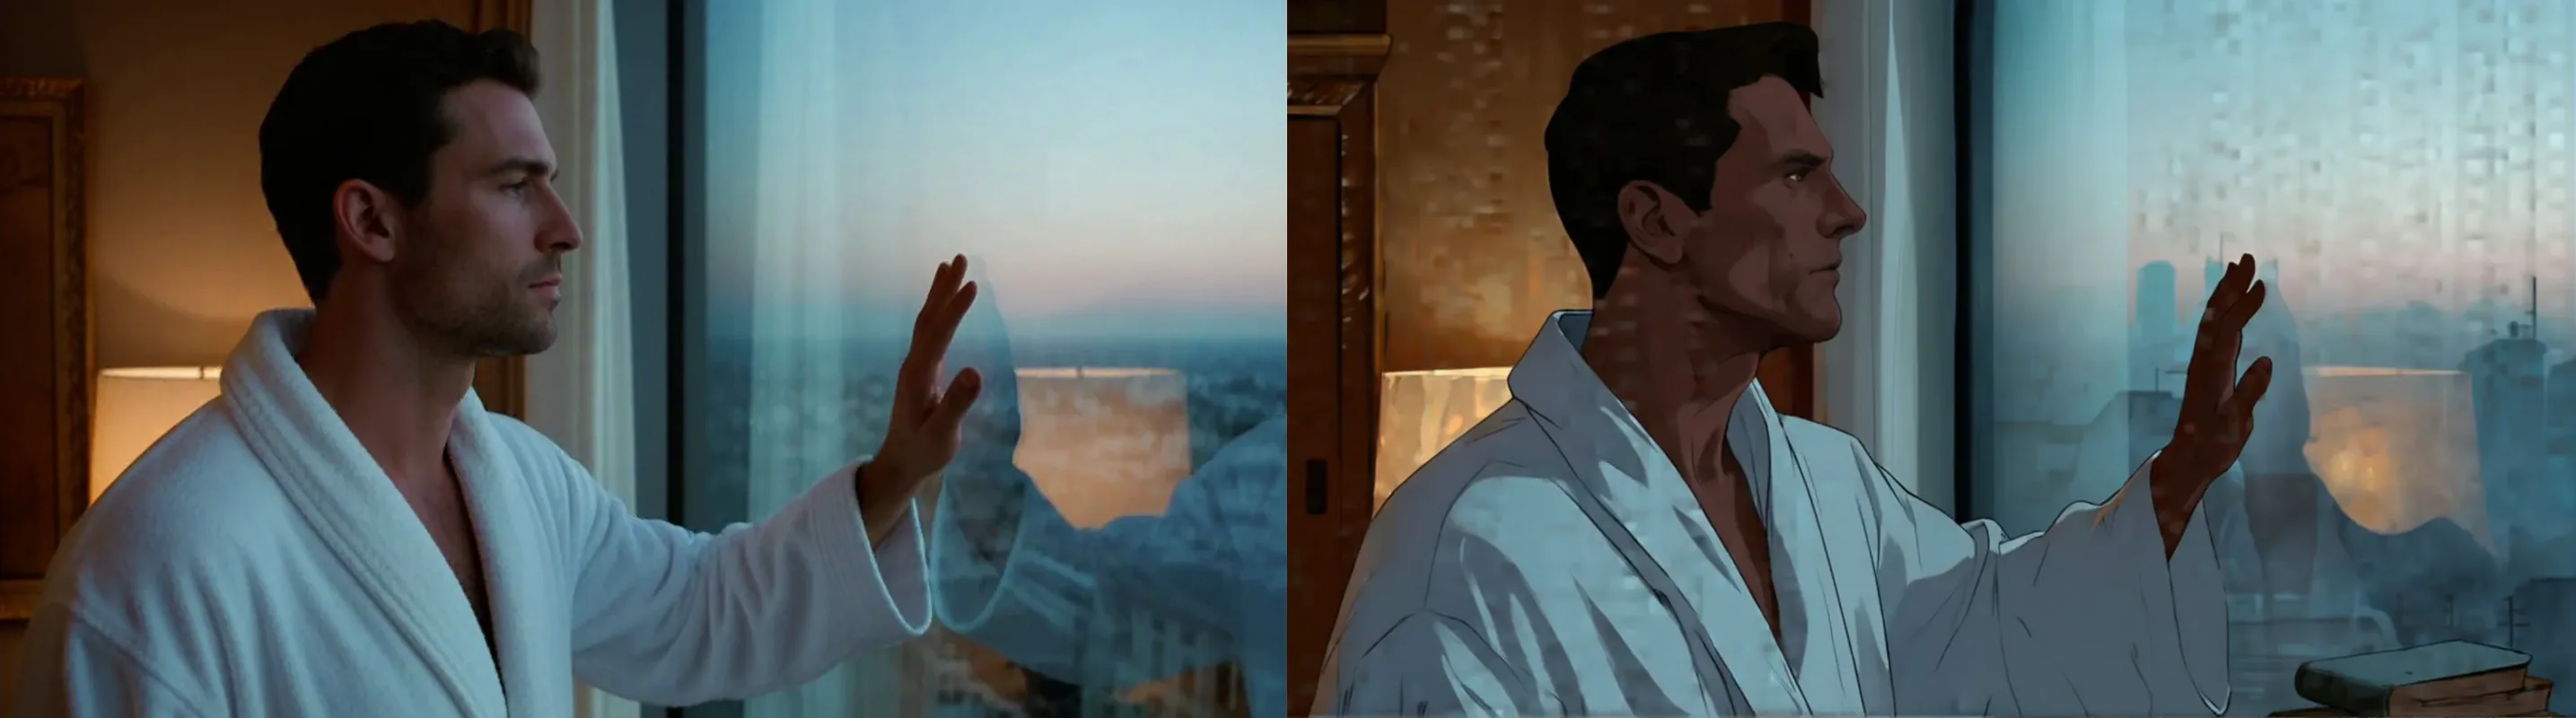
왼쪽: 저희가 생성한 원본 사진. 오른쪽: Z-Image Base LoRA, 이미지 투 이미지, 1.5k, seed 55, mikkoani LoRA scale 1, strength 0.65.
스타일을 다시 그릴 뿐, 지시를 따르지는 않는다
LoRA 없이 "흑백으로 만들어 줘"는 strength 0.65와 0.8에서 컬러 그대로였고, "턱시도를 입혀 줘"는 0.7과 0.8에서 거의 바뀌지 않았습니다. 이 모델은 사용자의 설명으로 프레임을 다시 그립니다. 매체를 바꾸려면 스타일 LoRA를 가져오고, 다른 장면을 원하면 전체를 자세히 서술하고 strength를 올리십시오. 자세한 내용은 편집 페이지에 있습니다.
크기
텍스트 투 이미지는 SDXL 기본 크기 위의 화면비 9가지를 제공하며, 9가지 모두 요청한 크기 그대로 완료되었습니다.
| 화면비 | 크기 | 화면비 | 크기 |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
업스트림은 한 변 256에서 1536까지 받습니다. 1536×1536과 256×256은 완료되었고, 1600×896, 2048×2048, 200×200은 크기 제약 오류로 실패했습니다. 편집에서는 resolution이 긴 변만 정하고 원본의 비율이 유지됩니다. 2:3 사진은 1k에서 680×1024로, 16:9 사진은 1.5k에서 1536×856으로 돌아왔습니다.
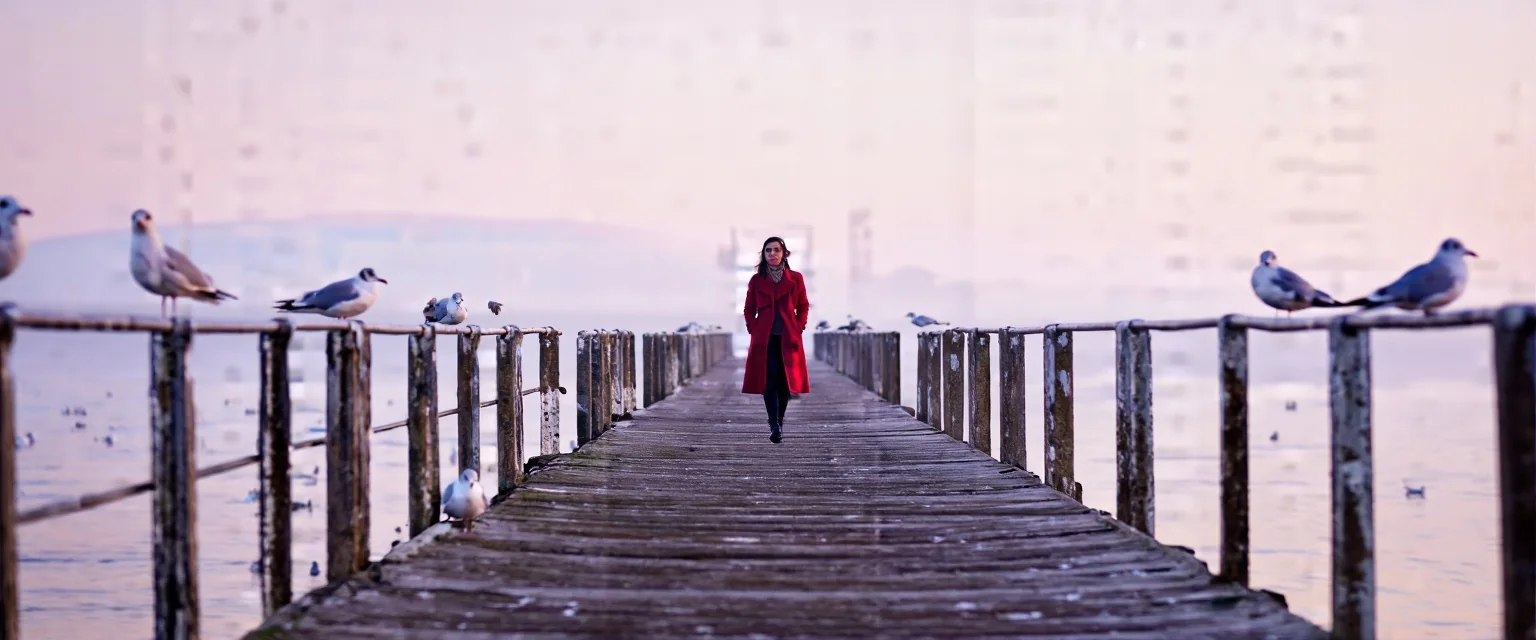
Z-Image Base LoRA, 텍스트 투 이미지, 21:9 (1536×640), seed 45, LoRA 없음.
같은 와이드 형태는 거리 장면에도 어울립니다.
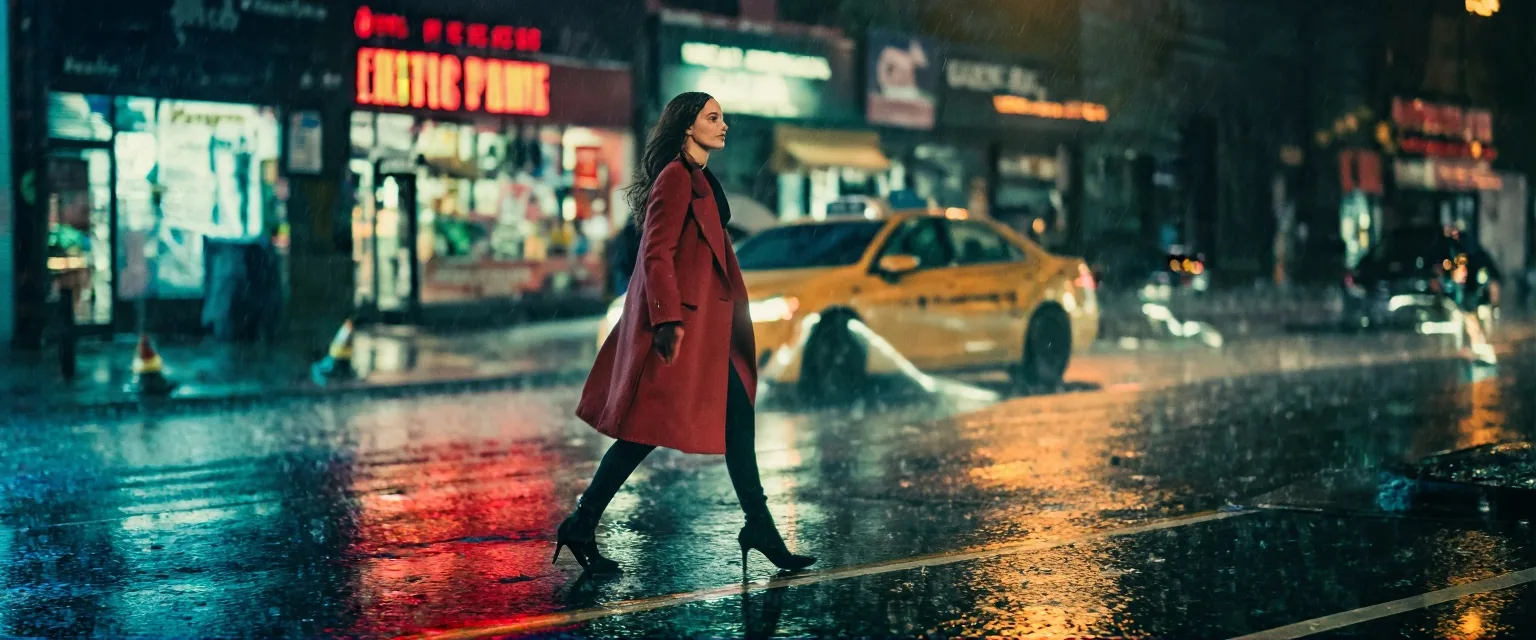
Z-Image Base LoRA, 텍스트 투 이미지, 21:9, LoRA 없음.
완화되는 구간
모델 앞에 콘텐츠 필터는 없습니다. 저희 사다리 테스트에서, 모든 프롬프트에 성인임을 명시했을 때 텍스트 투 이미지는 L1 암시(란제리, 흘러내리는 어깨끈), L2 성숙한 주제, L3 강함(전신 노출), L5 극한(성인 간 합의된 결박, 또는 영화적인 고어), 그리고 L3의 남성 버전을 적은 그대로 내놓았습니다. L4 고강도(성인 두 사람 사이의 친밀한 장면)는 세 번 모두 완화되어 돌아왔습니다: 시드마다 인물과 약간의 접촉은 나왔지만, 일관된 장면은 아니었습니다. 옷을 입은 원본의 이미지 투 이미지도 같은 양상이었습니다. 낮은 단계는 구현되었고, L3는 strength 0.8 이상부터(0.7은 부분적), L4는 완화되었습니다.
그래서 정직한 요약은 Base 자체는 그 최상위 단계를 잘 그리지 못한다는 것입니다. 그 단계용으로 학습된 LoRA가 의도된 경로이며, 위와 같은 Base 전용 규칙이 적용됩니다. LoRA 세 개를 쓴 이미지 투 이미지나 Civitai 링크의 LoRA는 테스트하지 않았습니다.
Z-Image Base LoRA인가, Z-Image Turbo LoRA인가
두 모델에 대한 제공처의 자체 비교입니다.
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| 스텝 | 28~50 | 8 |
| CFG | 있음 | 없음 |
| 파인튜닝 가능 | 예 | 아니요 |
| 네거티브 프롬프트 | 예 (이 엔드포인트는 노출하지 않음) | 아니요 |
| 다양성 | 높음 | 낮음 |
| 시각 품질 | 높음 | 매우 높음 |
Z-Image Turbo LoRA는 증류된 8스텝 모델로, Turbo용으로 학습된 LoRA를 최대 3개까지 쓰며, 약 1메가픽셀에 9가지 화면비를 지원하고, 이미지 투 이미지 기본 strength는 0.8입니다. Turbo 어댑터가 어떻게 동작하는지는 같은 seed Turbo LoRA 테스트를 참고하십시오. 두 계열은 LoRA를 공유하지 않습니다. 저희 테스트에서 Base에 올린 Turbo 파일은 이미지를 망가뜨렸습니다. 반대 방향은 테스트하지 않았으므로 Base 파일이 Turbo에서 안전하다고 가정하지 마십시오.
| 원하는 것 | 선택 |
|---|---|
| Z-Image Base로 학습된 LoRA | Z-Image Base LoRA |
| Z-Image Turbo로 학습된 LoRA | Z-Image Turbo LoRA |
| 몇 초 만에 나오는 가장 빠른 답 | Turbo; Base는 텍스트 투 이미지 중앙값이 32.8초였음 |
| 스타일 LoRA로 사진을 일러스트로 | Base 편집, strength 약 0.6, Base로 학습된 스타일 LoRA |
| LoRA 없이 강한 충실도의 평범한 프롬프트 | 둘 중 아무거나; 저희 테스트에서 Base는 문구를 면밀히 따랐음 |
| 스텝, guidance, 네거티브 프롬프트 제어 | 어느 엔드포인트도 노출하지 않음 |
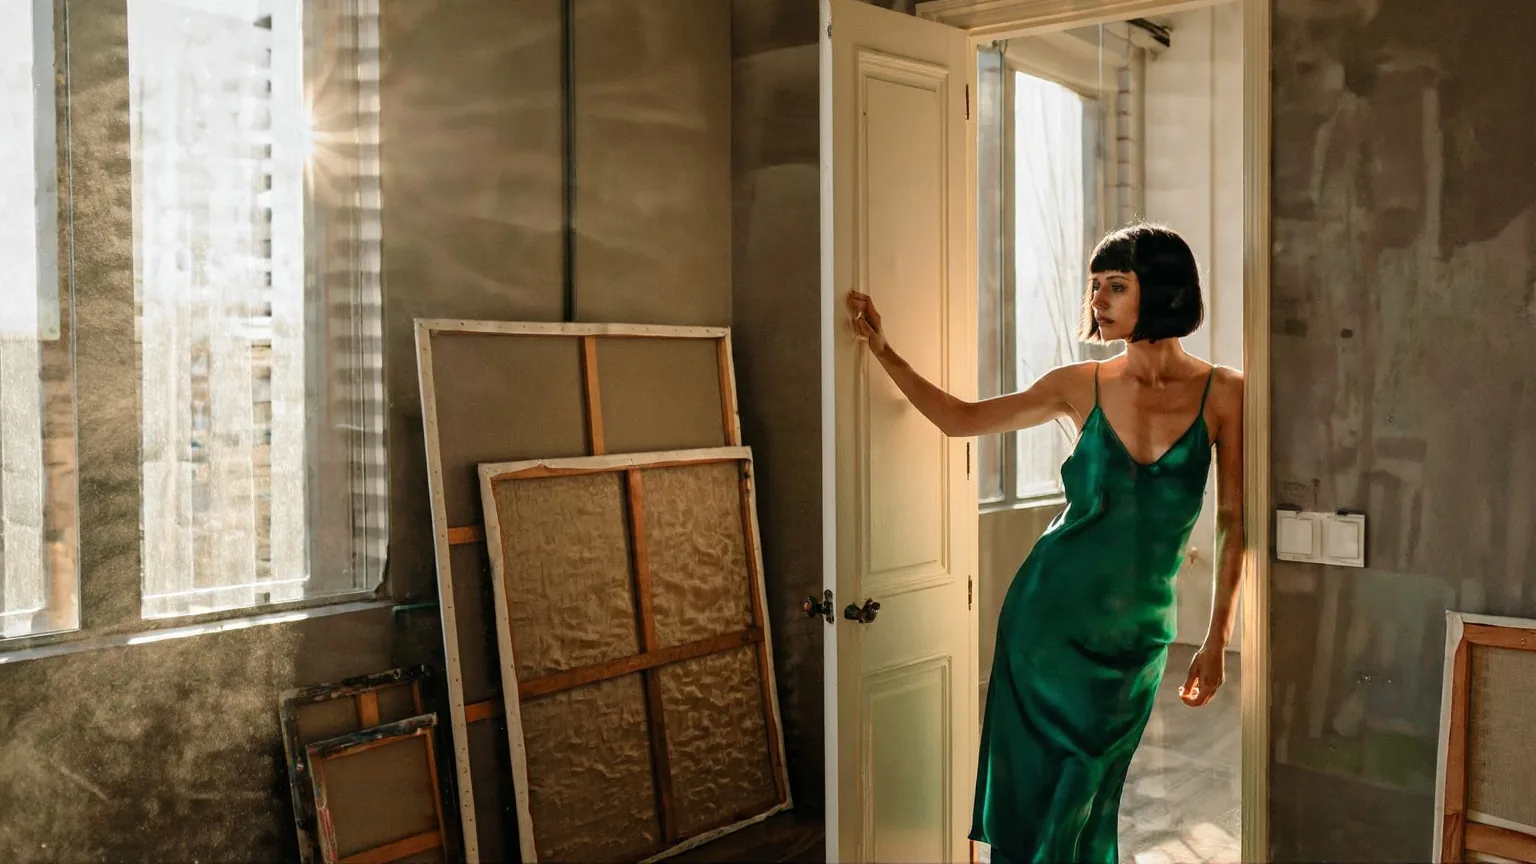
Z-Image Base LoRA, 텍스트 투 이미지, LoRA 없음, 저희 커버 세트의 시네마틱 인물 프롬프트.
FAQ
Z-Image Turbo LoRA를 Base에서 쓸 수 있나요?
아니요. 저희 테스트에서 Turbo로 학습된 LoRA는 Base에서 오류 없이 로드되었고 이미지를 노이즈와 가짜 글자로 망가뜨렸습니다. Z-Image Base로 학습된 파일을 쓰십시오.
Z-Image LoRA가 왜 아무것도 바꾸지 않았나요?
다른 키 형식으로 저장되었거나 다른 모델용으로 학습되었을 가능성이 높습니다. Z-Image용으로 표기되었지만 다르게 저장된 파일과 Pony LoRA 모두 로드되었고 픽셀 단위로 같은 출력을 냈습니다. 넣은 것과 뺀 것 한 쌍을 돌려 보십시오.
편집 strength는 얼마로 해야 하나요?
기본값 0.7로 시작하거나, 구도를 유지하려면 스타일 LoRA와 함께 0.6 부근으로 하십시오. 저희 단계별 테스트에서 0.3과 0.5는 사진이 거의 바뀌지 않았고, 0.75는 장면을 새로 연출했으며, 0.85는 새로운 그림을 냈습니다.
"흑백으로 만들어 줘" 같은 지시를 따르나요?
아니요. LoRA 없이는 흑백 요청이 0.65와 0.8에서 컬러 그대로였고, 턱시도 요청도 거의 바뀌지 않았습니다. 설명을 바탕으로 다시 그리므로, 룩에는 스타일 LoRA를 쓰십시오.
어떤 크기를 쓸 수 있나요?
텍스트 투 이미지는 화면비 9가지에 각 변 최대 1536이고, 편집은 긴 변에 1k 또는 1.5k입니다. 200×200이나 2048×2048 요청은 저희 테스트에서 실패했습니다.
Base는 얼마나 느린가요?
텍스트 투 이미지는 36회 실행에서 9.8~56.7초, 중앙값 32.8초였습니다. 편집은 28회 실행에서 4.9~41.7초, 중앙값 16.8초였습니다.
Base가 가장 친밀한 장면을 그리나요?
단독으로는 설득력 있게 그리지 못합니다. 세 번 시도했을 때 그 단계는 완화되어 돌아왔고, 그 아래 단계들은 적은 그대로 렌더링되었습니다. 더 나아가려면 그 단계용으로 학습된 LoRA가 방법입니다.
스텝, guidance, 네거티브 프롬프트를 설정할 수 있나요?
아니요. 제공처가 모델에 28~50스텝을 권장하더라도, 이 엔드포인트에는 그런 필드가 없습니다.