Wan 2.2 LoRA가 이제 글로 쓴 장면만으로 동작합니다. 프롬프트 하나로 480p 또는 720p, 가로 또는 세로의 5초 또는 8초 클립이 나오고, 슬롯 세 개에 각각 LoRA를 최대 3개까지 쓸 수 있습니다. 2026년 10월 5일 테스트에서 돌려 본 크기 조합 네 가지 모두 요청한 픽셀 크기 그대로 돌아왔고, 프롬프트 끝의 카메라 지시는 모든 클립에서 지켜졌으며, 엔드포인트는 무검열 그대로였습니다. 거부도 대체된 클립도 없었습니다. 한계도 분명합니다. 오디오 없음, 정사각형 없음, 720p 초과 없음, 그리고 저희 콘텐츠 사다리의 가장 높은 단계는 완화되었습니다.
오늘까지 Wan 2.2 LoRA 계열에는 이미지 투 비디오 엔드포인트 하나뿐이었고, 이는 사용자가 제공한 그림을 움직입니다. 새 텍스트 투 비디오 엔드포인트는 그림이 전혀 필요 없습니다. 이 글은 저희가 측정한 내용, LoRA 슬롯 세 개의 동작, 통한 프롬프트, 그리고 자매 엔드포인트 대신 이것을 골라야 할 때를 다룹니다. 싣는 프롬프트는 모두 옷을 입은 성인이 나오는 일상 또는 글래머 장면이며, 조작법을 익히기에는 그것으로 충분합니다.
한눈에 보기
| 질문 | 답 (2026년 10월 5일 테스트) |
|---|---|
| 모델 | 알리바바 Tongyi Wan 팀의 Wan2.2-T2V-A14B, 2025년 7월 28일 오픈 웨이트로 공개 |
| API 모델명 | alibaba/wan-2.2-lora/text-to-video |
| 필수 입력 | prompt뿐 |
| 형태 | aspect_ratio 16:9(기본값) 또는 9:16 |
| 해상도 | 480p(기본값) 또는 720p |
| 길이 | 5초(기본값) 또는 8초; 다른 값은 반올림 없이 거부됨 |
| LoRA 슬롯 | loras(두 전문가 모두), high_noise_loras, low_noise_loras: 각각 최대 3개 항목, scale 0~4 |
| 추가로 가능한 것 | negative_prompt, seed (같은 seed와 입력은 바이트까지 같은 파일을 줌) |
| 돌아오는 것 | MP4, H.264, 30fps, 오디오 트랙 없음, 요청당 클립 1개 |
| 테스트 속도 | 480p, 5초: 약 65~75초; 480p, 8초: 약 80초; 720p, 5초: 약 110~150초; LoRA는 5~15초를 더함 |
| 지원하지 않음 | 오디오, 정사각형이나 4:3 형태, 1080p, 프레임 레이트, 스텝, guidance, 프롬프트 확장 |
| 과금 | 선택한 해상도의 영상 초당 과금; 화면비는 영향 없음; LoRA 로드는 별도 요금 없음; 실패한 요청은 과금되지 않음 |
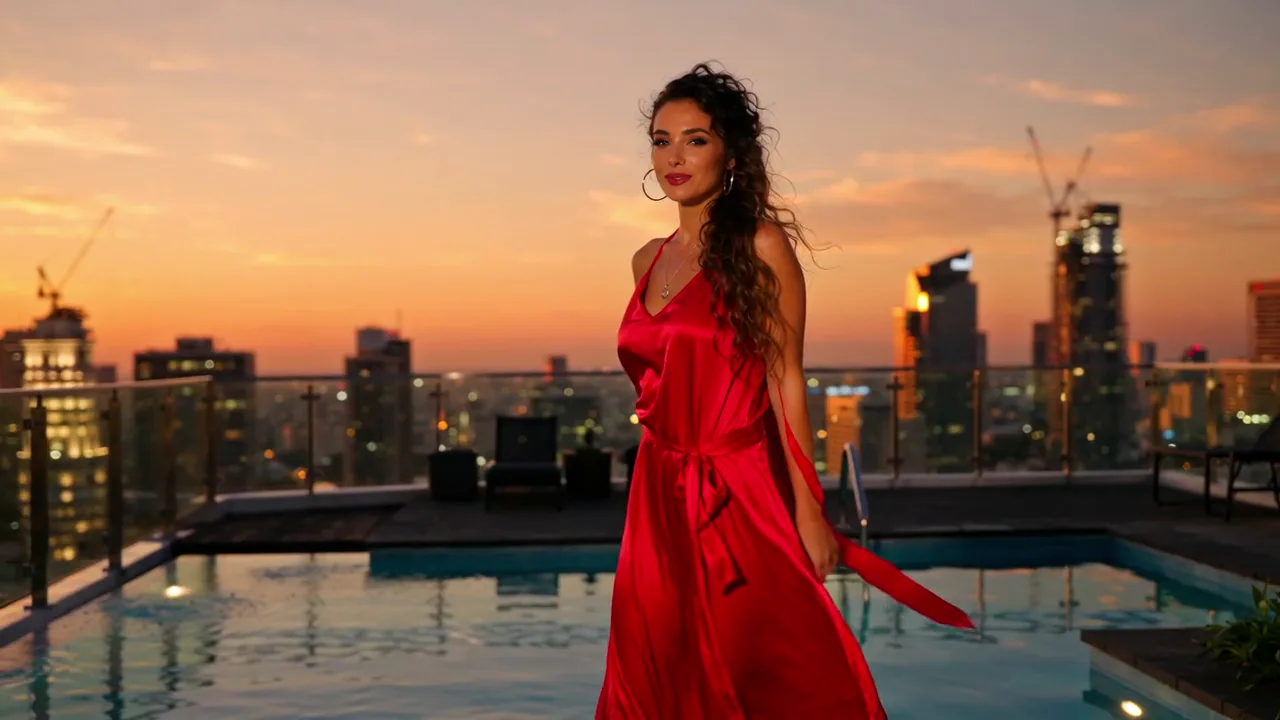
Wan 2.2 LoRA 텍스트 투 비디오, 720p, 16:9, 5초, seed 20261005, LoRA 없음, 네거티브 프롬프트 사용. 클립의 첫 프레임이며, 프롬프트는 아래에 있습니다.
모델의 정체
Wan 2.2는 알리바바 Tongyi Wan 팀의 영상 디퓨전 모델입니다. 텍스트 투 비디오 빌드는 각각 약 140억 파라미터인 전문가 둘을 가진 Mixture-of-Experts 구조입니다. 한 번에 하나만 동작합니다. 하이 노이즈 전문가가 초반 디노이징 단계를 맡아 레이아웃과 움직임을 정하고, 로우 노이즈 전문가가 후반 단계를 이어받아 디테일을 다듬습니다. 이 분리가 이 엔드포인트에 LoRA 슬롯이 하나가 아니라 세 개 있는 이유입니다.
제공처는 조명, 구도, 대비, 색조를 라벨링한 선별 데이터로 학습했고 Wan 2.1보다 훨씬 많은 자료(이미지 65.6%, 영상 83.2% 증가)를 썼으며 480P와 720P를 지원한다고 말합니다. 저희 실행에서는 그것이 사실적인 인물과 피부, 따뜻한 저조도 실내, 황금빛 시간대, 네온과 비, 느린 돌리·푸시인·오빗 카메라 무브로 나타났습니다. 평범한 영어 문장이 잘 통했습니다. 태그를 나열할 필요가 한 번도 없었습니다.
이미지 투 비디오와 비교해 달라지는 점
두 엔드포인트는 같은 LoRA 필드와 같은 5초 또는 8초 길이를 공유합니다. 어느 쪽을 쓸지는 차이가 결정합니다.
| 이미지 투 비디오 (기존) | 텍스트 투 비디오 (신규) | |
|---|---|---|
| 엔드포인트 페이지 | 이미지 투 비디오 | 텍스트 투 비디오 |
| 필수 입력 | prompt와 image_url | prompt |
| 룩을 정하는 것 | 시작 프레임: 피사체, 의상, 배경, 형태 | 프롬프트와 seed |
| 형태 | 시작 프레임을 따름 | 16:9 또는 9:16 |
| 네거티브 프롬프트 | 아니요 | 예 |
| 초당 가격 | 더 낮음 | 더 높음; 둘은 따로 가격이 책정되므로 각 페이지의 실시간 가격을 확인 |
실용적인 규칙은 이렇습니다. 얼굴, 의상, 제품이 이미 가진 무언가와 일치해야 한다면 이미지 투 비디오를 쓰십시오. 장면, 분위기, 카메라 무브를 탐색하는 중이고 어떤 성인이 나오든 상관없다면 텍스트 투 비디오를 쓰십시오. 좋은 워크플로는 텍스트 투 비디오로 탐색하고, 가장 좋은 프레임을 고른 뒤, 그 프레임에서 자매 엔드포인트로 이어 가는 것입니다.
크기, 길이, 실제로 돌아오는 것
크기 조합 네 가지와 두 길이를 모두 돌렸습니다. 모든 요청이 요청한 픽셀 크기 그대로 돌아왔습니다.
aspect_ratio와 resolution | 출력 크기 | 5초 요청 | 8초 요청 |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161프레임, 5.37초 | 247프레임, 8.23초 |
| 9:16, 480p | 480 x 832 | 5.37초 | 돌리지 않음 |
| 16:9, 720p | 1280 x 720 | 5.37초 | 돌리지 않음 |
| 9:16, 720p | 720 x 1280 | 5.37초 | 돌리지 않음 |
알아 둘 세부 사항이 둘 있습니다. 클립은 프레임 보간 때문에 요청보다 약간 길게 나옵니다. 5초 요청은 5.37초, 8초 요청은 8.23초가 나왔습니다. 그리고 출력은 무음입니다. 클립에 소리가 필요하다면 나중에 더하십시오.
테스트 클립이 아니라 모델 랜딩 아트의 일러스트: 두 길이, 왼쪽이 5초, 오른쪽이 8초.
해상도에 대한 저희 경험칙은 이렇습니다. 480p로 초안을 만드십시오. 기본값이고, 1분 안팎에 끝나며, 보이는 구도가 720p에서도 그대로 나오기 때문입니다. 최종 렌더링에서 720p로 올리십시오. 길이는 5초면 동작 하나와 카메라 무브 하나에 충분합니다. 동작에 시작, 중간, 끝이 있을 때만 8초를 고르십시오.
통한 프롬프트
저희를 한 번도 실망시키지 않은 구조는 한 단락에 네 부분이 들어갑니다. 누가, 무엇을 하는지, 빛, 그리고 마지막에 카메라 무브입니다. 아래는 모두 성인과 일상 또는 글래머 배경을 썼습니다.
해 질 녘 옥상 (16:9, 720p, 5초, seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
실크, 스카이라인 반사, 따뜻한 빛이 모두 나왔고, 여성은 클립 내내 같은 얼굴과 드레스를 유지했습니다. 아래 스트립은 5초에 걸친 프레임 네 장입니다.
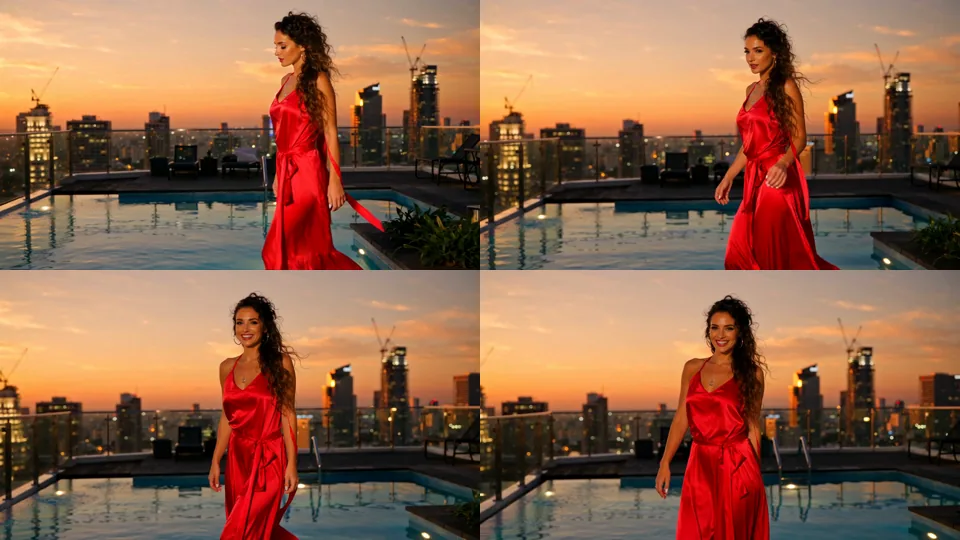
옥상 클립의 약 0.1, 1.8, 3.6, 5.2초 프레임. 걷기, 돌아서기, 트래킹 무브가 쓴 그대로 일어납니다.
네온 빗속 인물 (9:16, 720p, 5초, seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}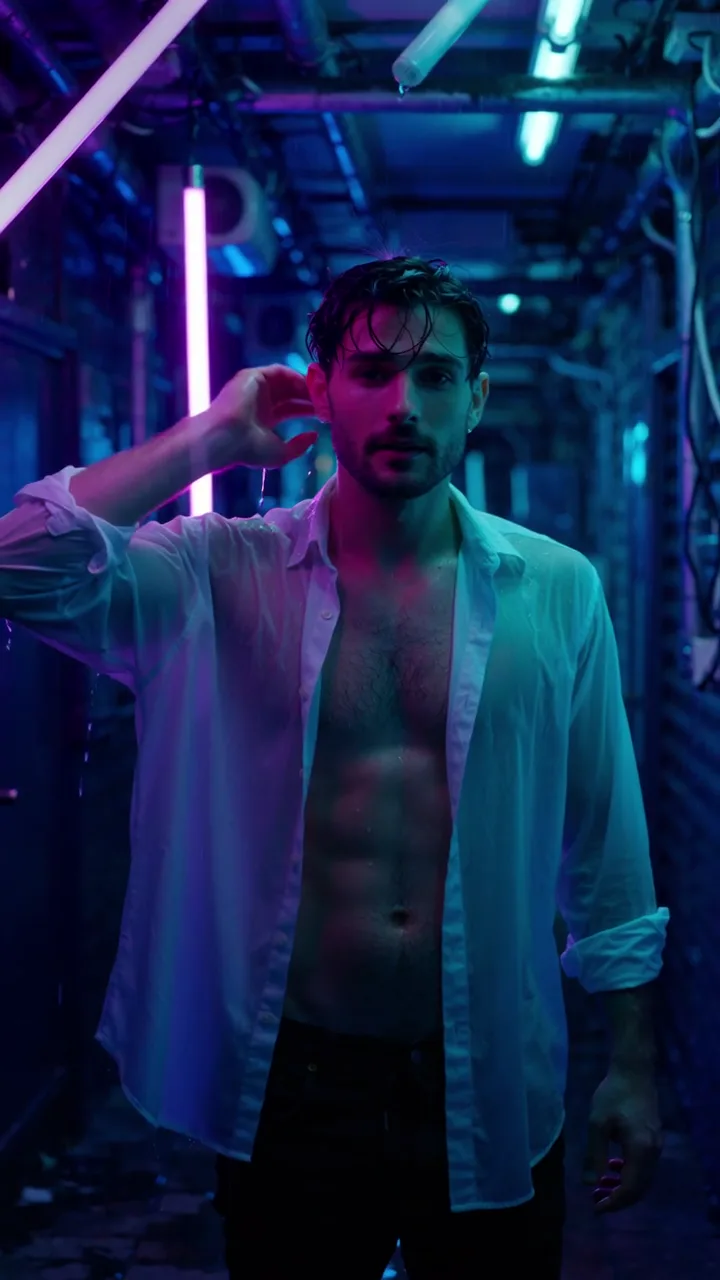
세로 720p, 5초, seed 32. 포스터 프레임이며, 머리 쓸어 넘기기와 느린 푸시인이 모두 화면에서 일어납니다.
"no signs or lettering anywhere"라는 문구에 주목하십시오. 이 프롬프트의 첫 버전은 배경에 네온 간판이 있었고, 모델이 거기에 뭉개진 글자를 그렸습니다. 장면을 드러난 조명 튜브 중심으로 다시 쓰자 문제가 사라졌습니다. Wan 2.2는 철자를 안정적으로 쓰지 못하므로, 철자할 것이 없는 장면을 주십시오.
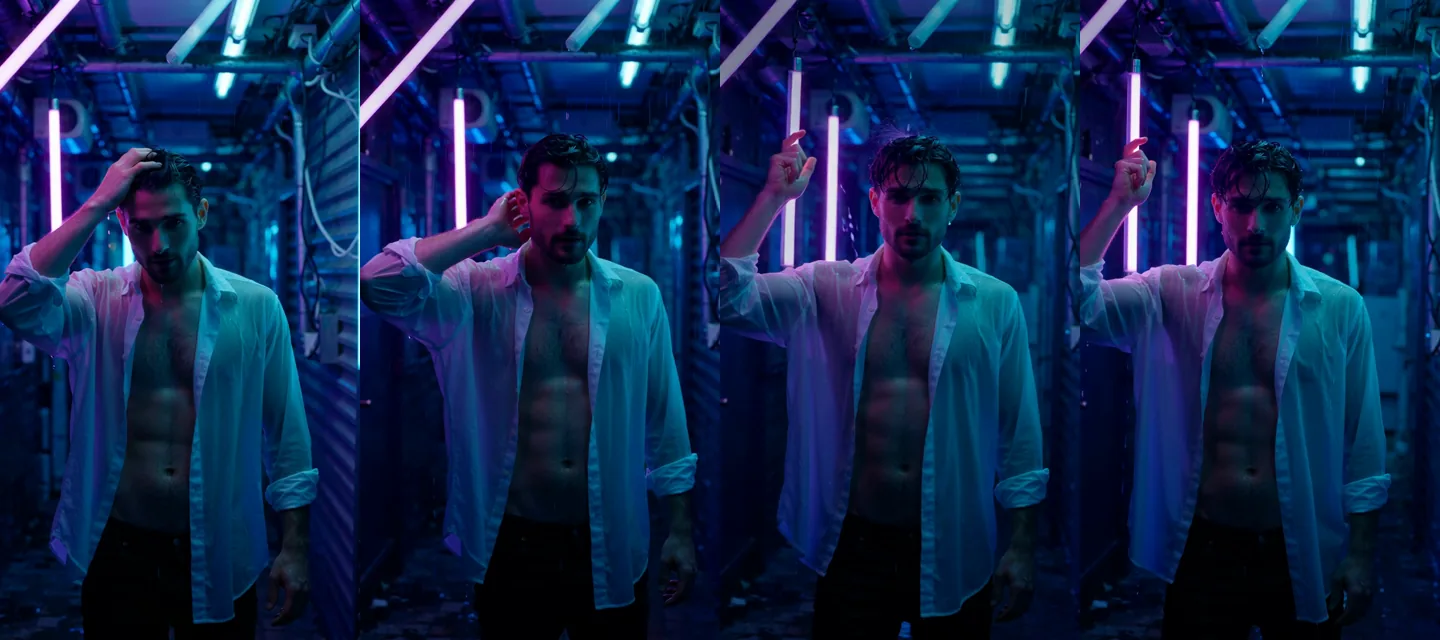
인물 클립의 약 0.1, 1.8, 3.6, 5.2초 프레임. 얼굴과 셔츠가 첫 프레임부터 마지막까지 일관됩니다.
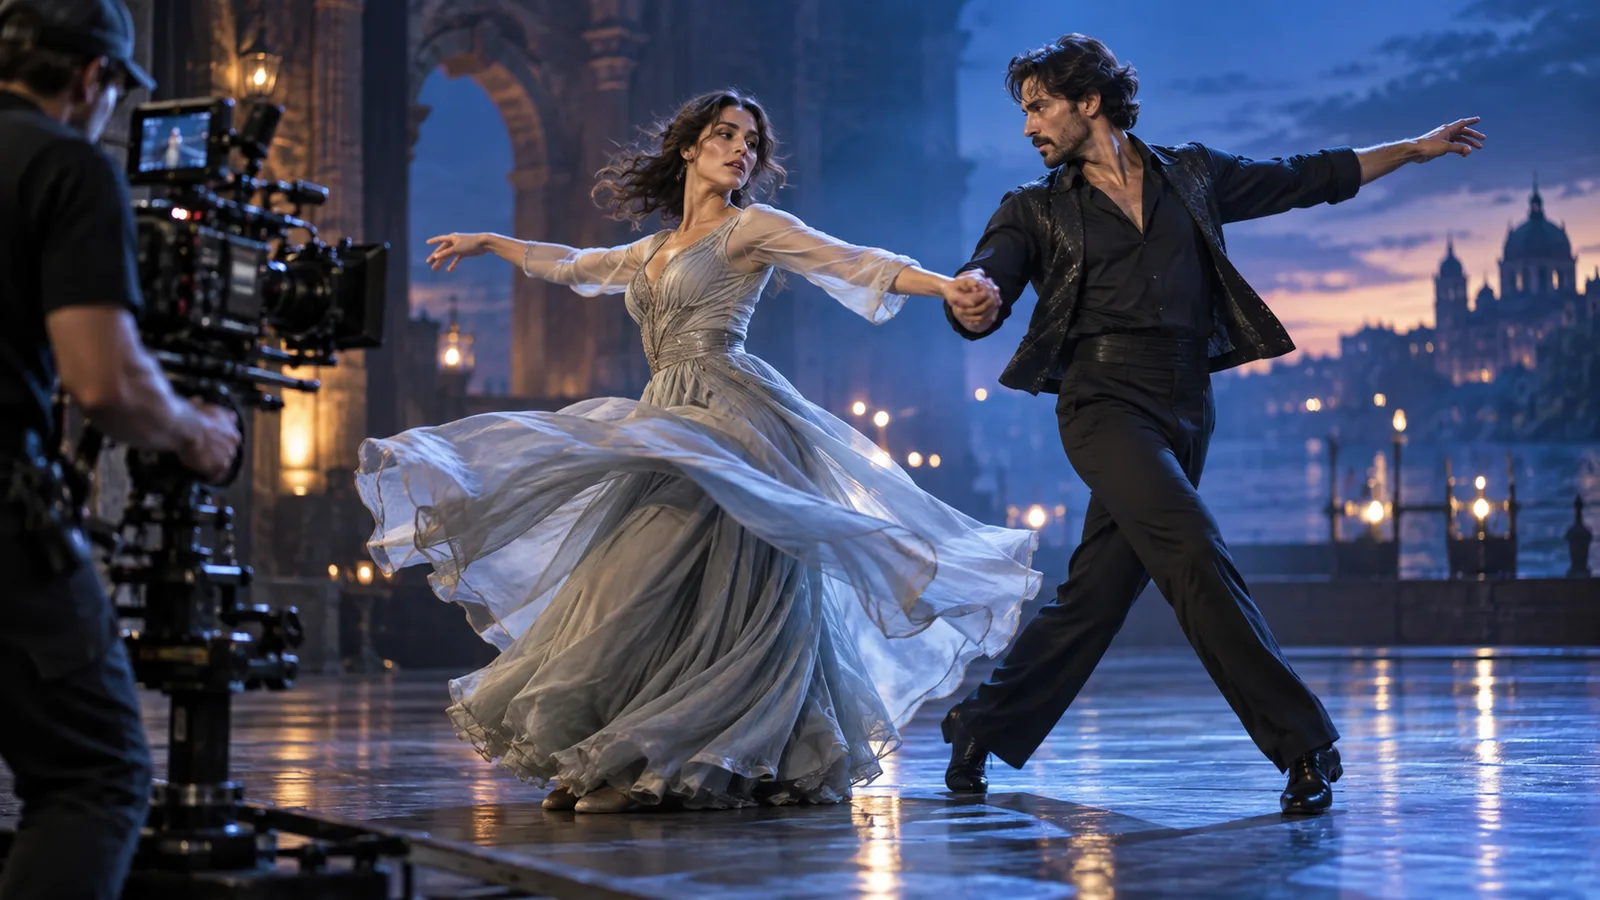
촛불 탱고 (16:9, 720p, 5초, seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
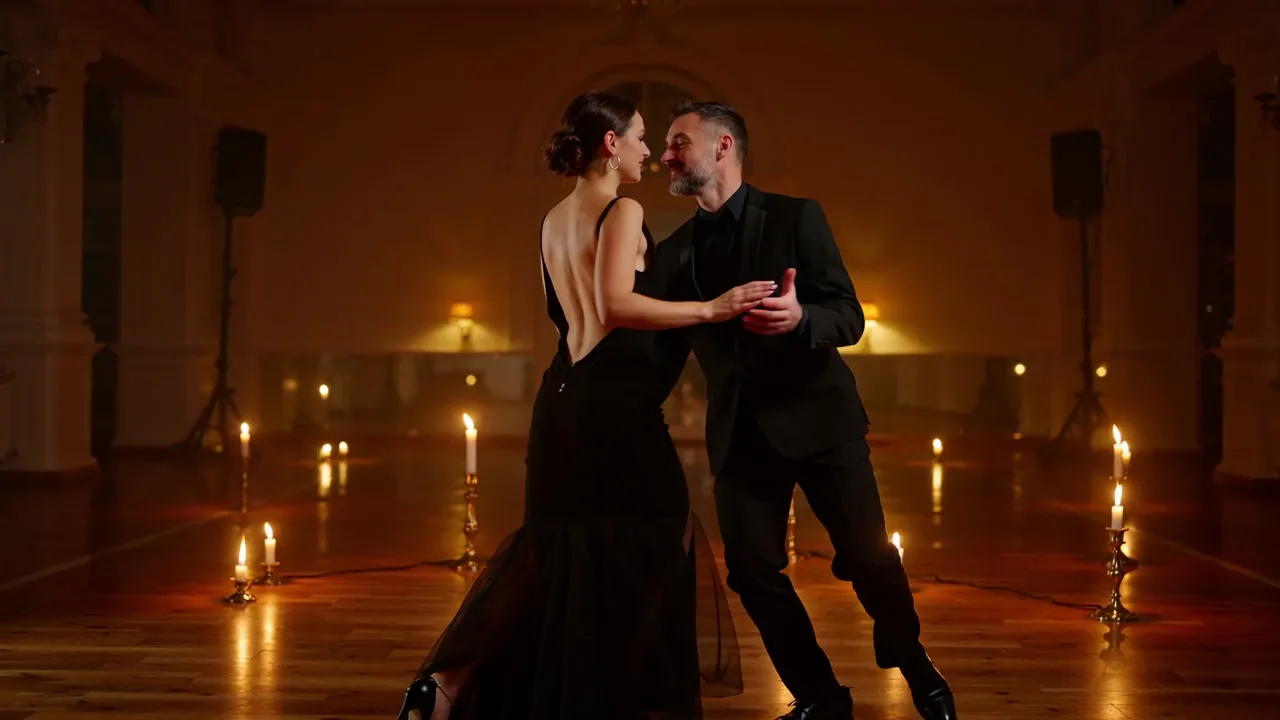
탱고 클립, 16:9, 720p, 5초, seed 47. 공개 예시의 포스터 프레임.
두 사람의 연출은 영상 모델이 보통 무너지는 지점인데, 이 모델은 예상보다 잘 버텼습니다. 아래 프레임은 두 사람이 점점 가까워지다 딥 동작으로 끝나는 모습을 보여 줍니다. 카메라가 도는 동안 바닥의 촛불 반사는 그 자리에 머뭅니다.
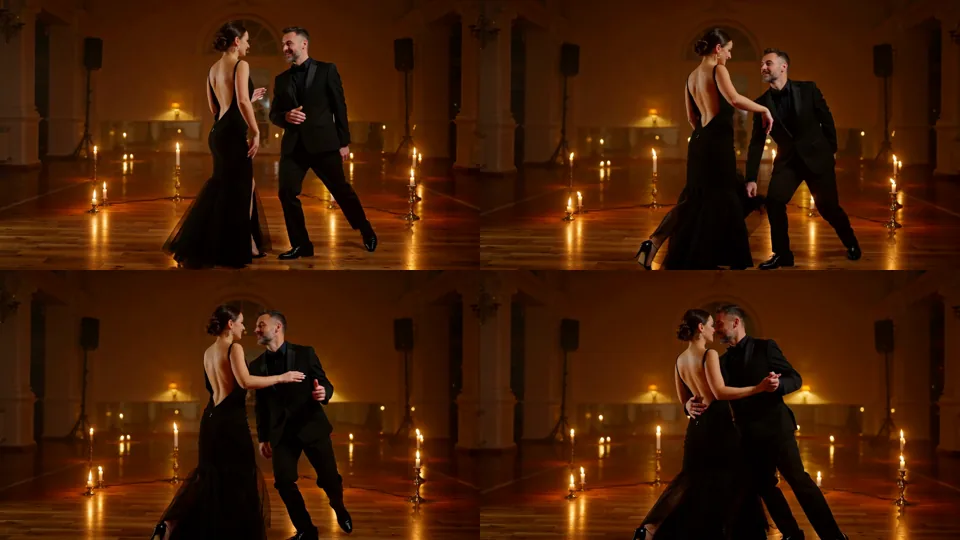
탱고 클립의 약 0.1, 1.8, 3.6, 5.2초 프레임.
저희 모든 실행에서 효과가 있었던 습관입니다.
- "adult"라고 쓰고 연령대를 주십시오. 캐스팅을 합리적으로 유지해 주며, 저희가 게시하는 모든 것의 원칙이기도 합니다.
- 카메라 지시를 마지막에 두십시오. "Slow dolly tracking shot", "slow push-in", "slow orbiting camera"는 등장한 클립마다 지켜졌습니다.
- 클립당 동작은 하나만 요청하십시오. 걷기와 돌아서기는 5초에 들어가지만, 이야기는 들어가지 않습니다.
- 네거티브 프롬프트는 취향이 아니라 아티팩트에 쓰십시오. "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo"는 무난한 기본값이며, 네온 클립은 이것 없이 돌렸습니다.
- 반복하는 동안 seed를 고정하십시오. 같은 seed와 같은 입력은 바이트까지 같은 파일을 줬으므로, 결과가 달라졌다면 그것은 사용자가 바꾼 것입니다.
LoRA 슬롯 세 개와 용도
여기가 이 엔드포인트가 일반 Wan 2.2 호출과 다른 지점입니다. 각 슬롯은 {path, scale} 형태의 항목을 최대 세 개 받으며, path는 .safetensors 파일로 가는 직접 HTTPS 링크이고 scale은 0에서 4까지(기본값 1)입니다.
테스트 클립이 아니라 모델 랜딩 아트의 일러스트: 열쇠 세 개, 구멍 세 개, 슬롯마다 하나씩.
| 슬롯 | 닿는 곳 | 용도 |
|---|---|---|
high_noise_loras | 하이 노이즈 전문가만 | 레이아웃과 움직임: 카메라 무브, 동작의 종류, 전체 구도 |
low_noise_loras | 로우 노이즈 전문가만 | 디테일과 질감: 피부, 천, 필름 그레인, 렌더링 스타일 |
loras | 두 전문가 모두 | 단일 파일 LoRA, 또는 파일 하나가 두 단계 모두에 작용하길 원할 때 |
Hugging Face와 Civitai의 대부분의 Wan 2.2 LoRA는 high_noise 파일과 low_noise 파일의 쌍으로 게시됩니다. 각각 자기 슬롯에 넣으십시오. 파일 하나로 나온 LoRA는 loras에 넣습니다. 카드에 파일이 어느 단계를 대상으로 하는지 적혀 있지 않다면 loras로 시작한 뒤, 파일을 각 전문 슬롯에서 단독으로 테스트하십시오. 그 선택의 근거와 이미지 투 비디오 엔드포인트로 만든 더 긴 테스트 루틴은 하이 노이즈와 로우 노이즈 슬롯 가이드를 읽으십시오. 이 글은 텍스트 투 비디오가 한 일만 보고합니다.
바로 이 베이스(Wan2.2-T2V-A14B)용으로 학습된 LoRA를 두 전문 슬롯에 로드하고 seed를 고정했을 때 본 결과입니다.
| 실행 (같은 프롬프트, 같은 seed 7, 480p, 16:9, 5초) | LoRA 없는 클립 대비 결과 |
|---|---|
| LoRA 없음 | 기준 |
| 맞는 쌍, scale 0.5 | 같은 구도, 얼굴 형태와 헤어스타일에 작은 변화 |
| 맞는 쌍, scale 1 | 더 큰 변화: 더 짧은 머리, 다른 얼굴 |
로우 노이즈 파일만, loras(두 전문가 모두), scale 1 | 인물도 바뀜 |
| 다른 베이스 모델용으로 학습된 LoRA | LoRA 없는 클립과 바이트까지 같음 |
마지막 줄이 기억할 것입니다. 다른 베이스 모델용으로 만든 LoRA는 LoRA가 아예 없는 것과 정확히 같은 파일을 만들었습니다. 오류도, 경고도, 효과도 없었습니다. 슬롯은 그것을 받아들였고 그저 아무 일도 일어나지 않았습니다. 그러므로 LoRA가 동작한다거나 scale이 너무 낮다고 결론 내리기 전에 항상 같은 seed의 LoRA 없는 실행과 비교하십시오. 저희가 쓴 외형 LoRA는 스타일보다 인물을 더 바꿨으며, 그래서 효과를 갤러리가 아니라 표로 보여 드립니다. 로드가 실제로 일어난다는 것, 그리고 scale에 따라 효과가 커진다는 것을 증명하지만 쇼케이스용 파일은 아닙니다.
로드는 별도 요금을 더하지 않으며, 저희 실행에서는 모델 시간을 5~15초 더했습니다.
LoRA 링크가 실패할 때
실수 두 가지가 각각 실행 한 번씩을 소모시켰으며, 둘 다 피하기 쉽습니다.
- 로그인이 필요한 링크. 게이트가 걸린 저장소는 서버가 HTTP 401을 반환했고 URL이 공개적으로 접근 가능한지 확인하라는 메시지와 함께 실패합니다. 공개 파일이나 서명된 링크를 쓰십시오.
- 파일이 아닌 저장소 페이지.
resolve/main/...safetensors링크 대신 모델 페이지를 붙여 넣으면 "the job failed unexpectedly"라는 일반적인 메시지가 나왔습니다. 그다지 설명적이지 않으므로, LoRA를 붙인 상태에서 이 메시지를 보면 링크부터 확인하십시오.
한도를 어기는 요청은 작업이 시작되지도 않습니다. 한 슬롯의 네 번째 항목, 4를 넘는 scale, 5나 8이 아닌 길이, 빈 프롬프트는 즉시 거부됩니다.
어디까지 가는가
플랫폼은 콘텐츠 필터를 추가하지 않으며, 모델이 무엇을 그리는지는 모델에 달려 있습니다. 2026년 10월 5일, 저희 콘텐츠 사다리의 단계마다 한 번씩 클립 하나를 돌렸고 모든 프레임 시트를 확인했습니다. 단계 이름은 다른 리뷰와 같습니다.
| 단계 | 요청한 것 | 결과 |
|---|---|---|
| L1 암시 | 란제리, 흘러내리는 어깨끈 | 구현됨 |
| L2 성숙한 주제 | 수위 높은, 부분 | 구현됨 |
| L3 강함 | 전신 노출, 여성과 남성 | 구현됨 |
| L4 고강도 | 성인 두 사람 사이의 친밀한 장면 | 완화됨: 장면은 그려지지만 전부는 아님 |
| L5 극한 | 성인 간 합의된 결박; 영화적인 고어 | 결박은 구현됨; 고어는 몇 군데의 베인 자국과 흔적으로 완화됨 |
거부된 실행도, 다른 클립으로 바뀐 것도 없었습니다. L4와 고어 행은 솔직하게 읽으십시오. 모델은 멀리까지 가다가 차분해집니다. 사용 사례가 사다리의 맨 위에 있다면 못 미칠 것을 계획하십시오. 단계당 한 번 돌린 결과이므로 표는 보장이 아니라 첫인상으로 받아들이십시오. 이전 날짜들에 걸친 더 긴 기록은 Wan 2.2 LoRA 리뷰에 있습니다.
부족한 점
- 무음 영상. 오디오 트랙도 오디오 옵션도 없습니다.
- 형태는 두 가지뿐. 16:9와 9:16. 정사각형 게시물은 나중에 자르십시오.
- 720p가 상한. 1080p 티어는 없습니다.
- 고정된 길이. 정확히 5초 또는 8초. 6초를 요청하자 거부되었는데, 조용히 반올림하는 것보다 낫습니다.
- 제어가 적음. 프레임 레이트, 스텝, guidance, 프롬프트 확장이 없습니다. 말, seed, 네거티브 프롬프트, LoRA로 조종합니다.
- 프레임 속 글자는 불안정. 위의 네온 예시를 보십시오.
- 정지 이미지보다 느림. 720p 5초 클립은 저희 실행에서 모델 시간 약 2분이 걸렸으므로, 그에 맞춰 배치를 계획하십시오.
- 얇은 테스트 기반. 사다리 단계당 클립 하나와 몇 건의 LoRA 비교를 돌렸습니다. seed 범위의 극단, 네거티브 프롬프트가 콘텐츠에 미치는 영향, LoRA 항목 아홉 개를 모두 로드한 실행은 테스트하지 않았습니다.
어느 엔드포인트를 써야 하나
| 원하는 것 | 사용 | 이유 |
|---|---|---|
| 장면, 분위기, 카메라 무브 탐색 | 텍스트 투 비디오 | 문장 하나로 시작, 원본 그림 불필요 |
| 특정 얼굴, 의상, 제품을 이어 가기 | 이미지 투 비디오 | 시작 프레임이 룩을 고정 |
| 휴대폰용 세로 클립 | 텍스트 투 비디오, 9:16 | 자르는 것이 아니라 파라미터로 형태를 정함 |
| 더 저렴한 첫 초안 | 텍스트 투 비디오, 480p, 5초 | 가장 낮은 티어로 초안을 만들고, 마음에 든 것을 720p로 다시 돌림 |
| 재현할 수 있는 고정 구도 | 둘 중 아무거나, seed 고정 | 같은 seed와 입력이 바이트까지 같은 파일을 줌 |
| 커뮤니티 LoRA의 효과 | 둘 중 아무거나, 올바른 슬롯으로 | 쌍 파일은 하이 노이즈와 로우 노이즈 슬롯에, 단일 파일은 loras에 |
FAQ
Wan 2.2 LoRA 텍스트 투 비디오는 오디오를 생성하나요?
아니요. 출력은 비디오 트랙만 있는 30fps MP4이며 소리가 없습니다. 클립을 만든 뒤 편집기에서 음악이나 음성을 더하십시오.
하이 노이즈와 로우 노이즈 LoRA 슬롯의 차이는 무엇인가요?
하이 노이즈 슬롯은 레이아웃과 움직임을 정하는 전문가에, 로우 노이즈 슬롯은 디테일과 질감을 다듬는 전문가에 닿습니다. 파일 하나를 양쪽에 적용하려면 loras를 쓰십시오. 대부분의 Wan 2.2 LoRA는 하이 노이즈와 로우 노이즈 쌍으로 게시되므로 각 파일을 자기 슬롯에 넣습니다.
내 LoRA가 왜 아무것도 바꾸지 않았나요?
다른 베이스 모델용으로 학습되었을 가능성이 가장 큽니다. 저희 테스트에서 다른 베이스용으로 만든 LoRA는 오류 없이, 넣지 않은 실행과 바이트까지 같은 파일을 만들었습니다. 카드에 Wan 2.2 텍스트 투 비디오라고 적혀 있는지 확인한 뒤, 같은 seed의 LoRA 없는 실행과 비교하십시오.
어떤 화면비, 해상도, 길이를 지원하나요?
16:9 또는 9:16, 480p 또는 720p, 그리고 정확히 5초 또는 8초입니다. 정사각형, 4:3, 1080p, 다른 길이는 제공되지 않으며, 목록 밖의 값은 반올림이 아니라 거부됩니다.
같은 클립을 두 번 얻을 수 있나요?
네. 같은 프롬프트, 같은 seed, 같은 입력으로 바이트까지 같은 파일을 얻었습니다. seed를 빼면 요청마다 무작위입니다.
LoRA는 추가 요금이 드나요?
아니요. 과금은 선택한 해상도의 영상 초당이며, LoRA 로드는 별도 요금을 더하지 않습니다. 화면비는 가격을 바꾸지 않고, 실패한 요청은 과금되지 않습니다. 실시간 가격은 모델 페이지에 있습니다.
무검열인가요?
플랫폼은 콘텐츠 필터를 추가하지 않습니다. 저희 사다리에서 L1~L3 단계와 성인 간 합의된 결박은 구현되었고, 가장 강한 단계는 완화되었습니다. 자세한 내용은 위의 표에 있습니다.
텍스트 투 비디오와 이미지 투 비디오 중 무엇을 써야 하나요?
탐색 중이고 적당한 성인이면 누구든 상관없다면 텍스트 투 비디오를, 얼굴, 의상, 배경이 이미 가진 그림과 일치해야 한다면 이미지 투 비디오를 쓰십시오. 흔한 루틴은 텍스트 투 비디오로 탐색하고 가장 좋은 프레임을 이미지 투 비디오로 가져가는 것입니다.