Wan 2.2 LoRA ahora acepta una escena escrita por sí sola: un prompt devuelve un clip de 5 u 8 segundos a 480p o 720p, en horizontal o vertical, con hasta tres LoRA en cada una de las tres ranuras. En nuestras pruebas del 5 de octubre de 2026, cada una de las cuatro combinaciones de tamaño que corrimos volvió exactamente con el tamaño en píxeles pedido, la instrucción de cámara al final del prompt se siguió en todos los clips, y el endpoint siguió sin censura: sin rechazos y sin clips sustituidos. Sus límites también son claros: sin audio, sin formato cuadrado, nada por encima de 720p, y el nivel más alto de nuestra escala de contenido se suavizó.
Hasta hoy, la familia Wan 2.2 LoRA tenía un solo endpoint, imagen a video, que anima una imagen que tú aportas. El nuevo endpoint de texto a video no necesita ninguna imagen. Este artículo cubre lo que medimos, cómo se comportan las tres ranuras de LoRA, los prompts que funcionaron y cuándo elegirlo en lugar de su hermano. Todos los prompts que publicamos son escenas cotidianas o de glamour con adultos vestidos; con eso basta para aprender los controles.
De un vistazo
| Pregunta | Respuesta (probado el 5 de octubre de 2026) |
|---|---|
| Modelo | Wan2.2-T2V-A14B del equipo Tongyi Wan de Alibaba, publicado con pesos abiertos el 28 de julio de 2025 |
| Nombre del modelo en la API | alibaba/wan-2.2-lora/text-to-video |
| Entrada obligatoria | Solo prompt |
| Formatos | aspect_ratio 16:9 (por defecto) o 9:16 |
| Resolución | 480p (por defecto) o 720p |
| Duración | 5 s (por defecto) u 8 s; cualquier otro valor se rechaza, nunca se redondea |
| Ranuras de LoRA | loras (ambos expertos), high_noise_loras, low_noise_loras: hasta 3 entradas cada una, scale de 0 a 4 |
| También disponibles | negative_prompt, seed (el mismo seed y las mismas entradas dieron un archivo idéntico byte a byte) |
| Qué devuelve | MP4, H.264, 30 fps, sin pista de audio, un clip por solicitud |
| Velocidad en nuestras pruebas | 480p, 5 s: unos 65 a 75 s; 480p, 8 s: unos 80 s; 720p, 5 s: unos 110 a 150 s; un LoRA agrega de 5 a 15 s |
| No disponible | Audio, formatos cuadrado o 4:3, 1080p, velocidad de fotogramas, pasos, guidance, expansión del prompt |
| Facturación | Por segundo de video a la resolución elegida; la relación de aspecto no la cambia; cargar LoRA no suma ningún cargo aparte; las solicitudes fallidas no se cobran |
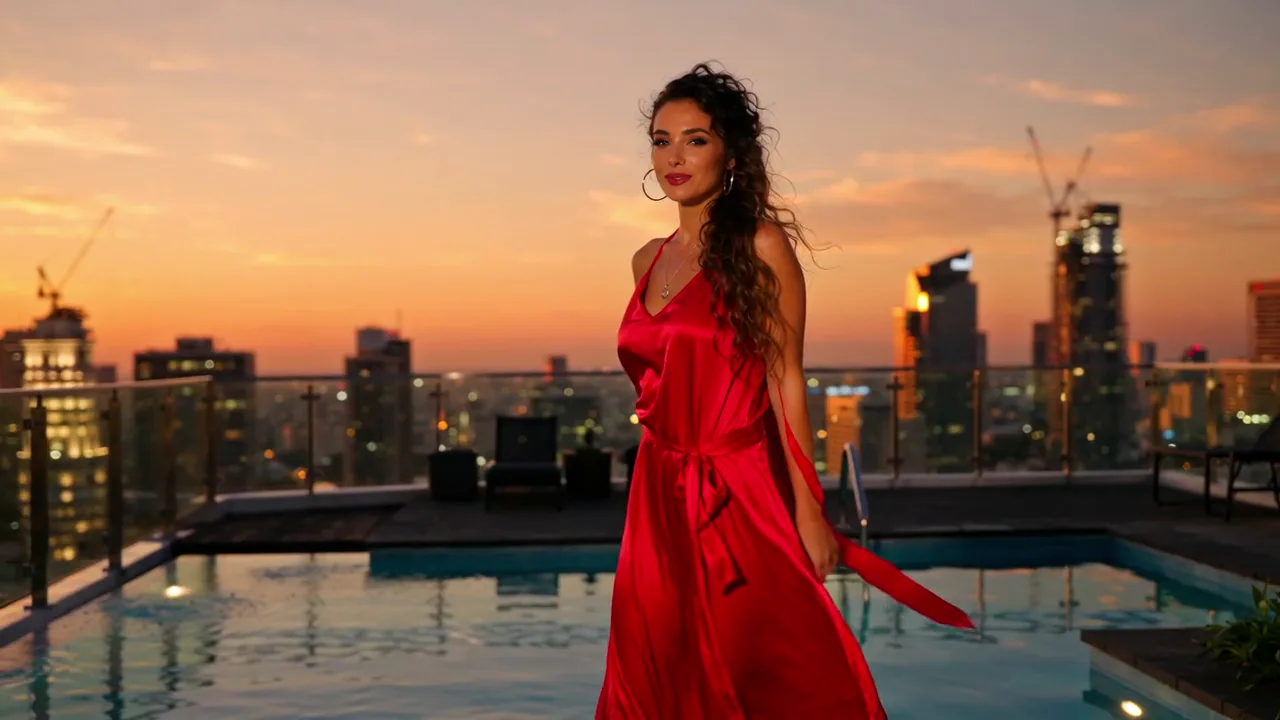
Wan 2.2 LoRA texto a video, 720p, 16:9, 5 s, seed 20261005, sin LoRA, con un prompt negativo. Primer fotograma del clip; el prompt se muestra más abajo.
Qué es el modelo
Wan 2.2 es un modelo de difusión de video del equipo Tongyi Wan de Alibaba. La versión de texto a video tiene un diseño de mezcla de expertos (Mixture-of-Experts) con dos expertos de unos 14 mil millones de parámetros cada uno. Solo uno corre a la vez: el experto de ruido alto se encarga de los primeros pasos de eliminación de ruido y fija la composición y el movimiento, y el experto de ruido bajo toma el relevo en los pasos finales y refina el detalle. Esa división es la razón de que este endpoint tenga tres ranuras de LoRA en lugar de una.
El publicador dice que lo entrenó con datos seleccionados y etiquetados por iluminación, composición, contraste y tono de color, con mucho más material que Wan 2.1 (65.6 % más imágenes y 83.2 % más videos), y que admite 480P y 720P. En nuestras ejecuciones eso se tradujo en personas y piel fotorrealistas, interiores cálidos con poca luz, hora dorada, neón y lluvia, y movimientos de cámara lentos de dolly, avance y órbita. Las frases sencillas en inglés funcionaron bien. Nunca necesitamos una sopa de etiquetas.
Qué cambia respecto a imagen a video
Ambos endpoints comparten los mismos campos de LoRA y las mismas duraciones de 5 u 8 segundos. Las diferencias deciden a cuál recurrir:
| Imagen a video (existente) | Texto a video (nuevo) | |
|---|---|---|
| Página del endpoint | Imagen a video | Texto a video |
| Entrada obligatoria | prompt y image_url | prompt |
| Quién define el aspecto | Tu fotograma inicial: sujeto, atuendo, escenario y formato | El prompt, más el seed |
| Formato | Sigue el fotograma inicial | 16:9 o 9:16 |
| Prompt negativo | No | Sí |
| Precio por segundo | Menor | Mayor; los dos se tarifican por separado, así que consulta el precio vigente en cada página |
La regla práctica: si un rostro, un atuendo o un producto debe coincidir con algo que ya tienes, usa imagen a video. Si estás explorando una escena, un ambiente o un movimiento de cámara y no te importa qué adulto aparezca, usa texto a video. Un buen flujo de trabajo es explorar con texto a video, elegir el mejor fotograma y luego continuar desde ese fotograma en el endpoint hermano.
Tamaños, duraciones y qué devuelve realmente
Corrimos las cuatro combinaciones de tamaño y ambas duraciones. Cada solicitud devolvió exactamente el tamaño en píxeles pedido:
aspect_ratio y resolution | Tamaño de salida | Solicitud de 5 s | Solicitud de 8 s |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161 fotogramas, 5.37 s | 247 fotogramas, 8.23 s |
| 9:16, 480p | 480 x 832 | 5.37 s | no se corrió |
| 16:9, 720p | 1280 x 720 | 5.37 s | no se corrió |
| 9:16, 720p | 720 x 1280 | 5.37 s | no se corrió |
Dos detalles que conviene saber. Los clips duran un poco más de lo pedido por la interpolación de fotogramas: una solicitud de 5 segundos dio 5.37 segundos y una de 8 segundos dio 8.23 segundos. Y la salida es silenciosa. Si el clip necesita sonido, agrégalo después.
Ilustración del arte de la página del modelo, no un clip de prueba: las dos duraciones, 5 segundos a la izquierda y 8 a la derecha.
Nuestra regla práctica para la resolución: haz borradores a 480p, porque es el valor por defecto, termina en cerca de un minuto y la composición que ves es la que obtendrás a 720p. Pasa a 720p para el render final. Para la duración: 5 segundos bastan para una acción y un movimiento de cámara; elige 8 solo cuando la acción tenga principio, desarrollo y final.
Prompts que funcionaron
La estructura que nunca nos falló tiene cuatro partes en un solo párrafo: quién, qué hace, la luz y, al final, el movimiento de cámara. Todo lo que sigue usó adultos y escenarios cotidianos o de glamour.
Azotea al anochecer (16:9, 720p, 5 s, seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
La seda, los reflejos del horizonte y la luz cálida llegaron, y la mujer mantuvo el mismo rostro y vestido durante todo el clip. La tira de abajo muestra cuatro fotogramas a lo largo de los cinco segundos:
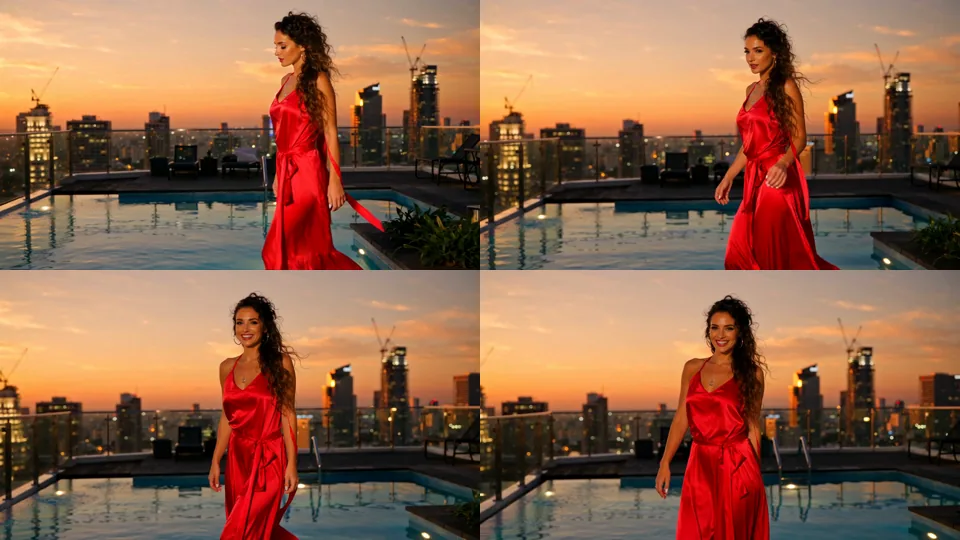
Fotogramas a los 0.1, 1.8, 3.6 y 5.2 segundos aproximadamente del clip de la azotea. La caminata, el giro y el movimiento de seguimiento ocurren tal como se escribió.
Retrato de neón bajo la lluvia (9:16, 720p, 5 s, seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}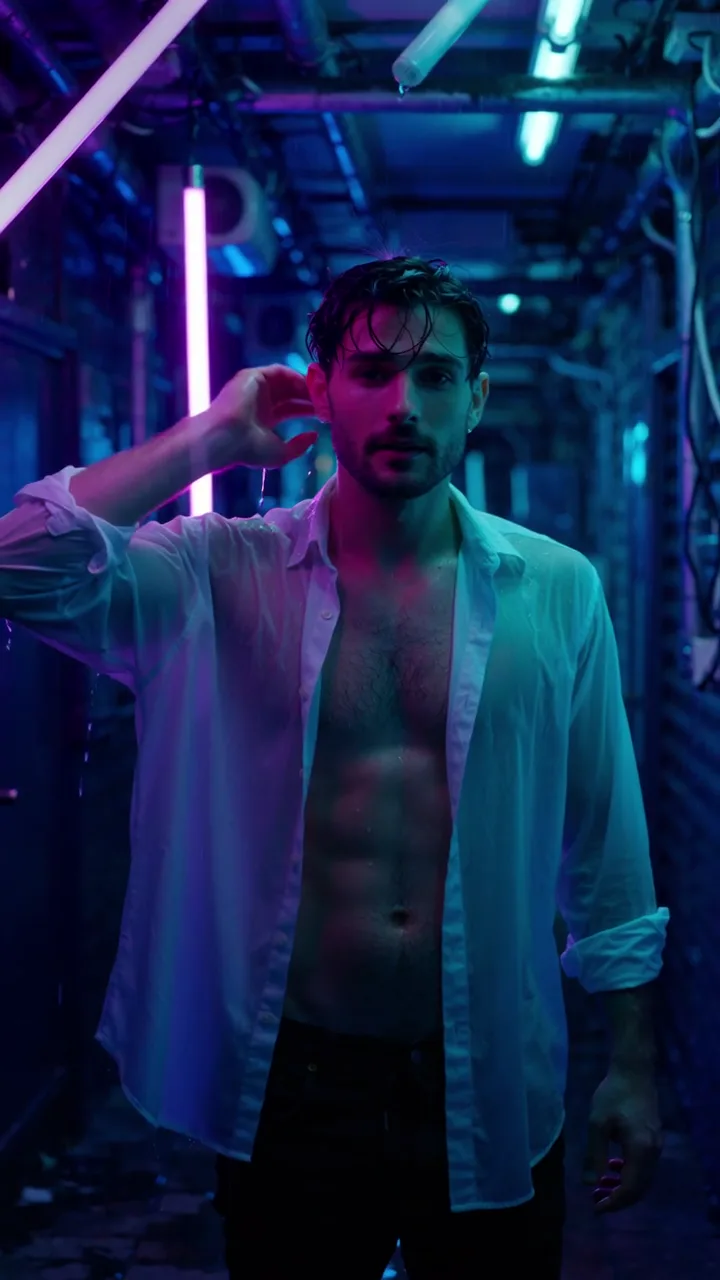
Retrato 720p, 5 s, seed 32. Fotograma de póster; el gesto de apartarse el pelo y el avance lento ocurren ambos en pantalla.
Fíjate en la frase "no signs or lettering anywhere". Nuestra primera versión de este prompt tenía un letrero de neón al fondo, y el modelo dibujó letras confusas en él. Reescribimos la escena en torno a tubos de luz sin letrero y el problema desapareció. Wan 2.2 no deletrea de forma fiable, así que dale una escena sin nada que deletrear.
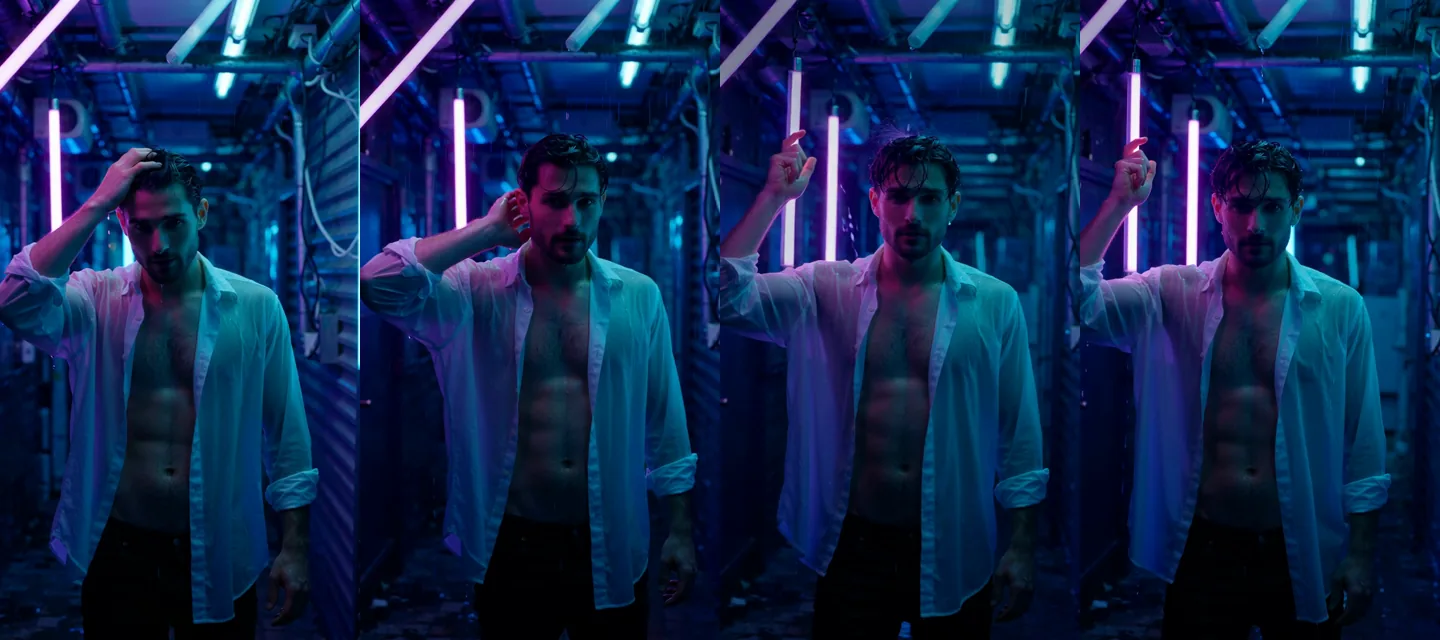
Fotogramas a los 0.1, 1.8, 3.6 y 5.2 segundos aproximadamente del clip vertical. El rostro y la camisa se mantienen coherentes del primer al último fotograma.
Tango a la luz de las velas (16:9, 720p, 5 s, seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
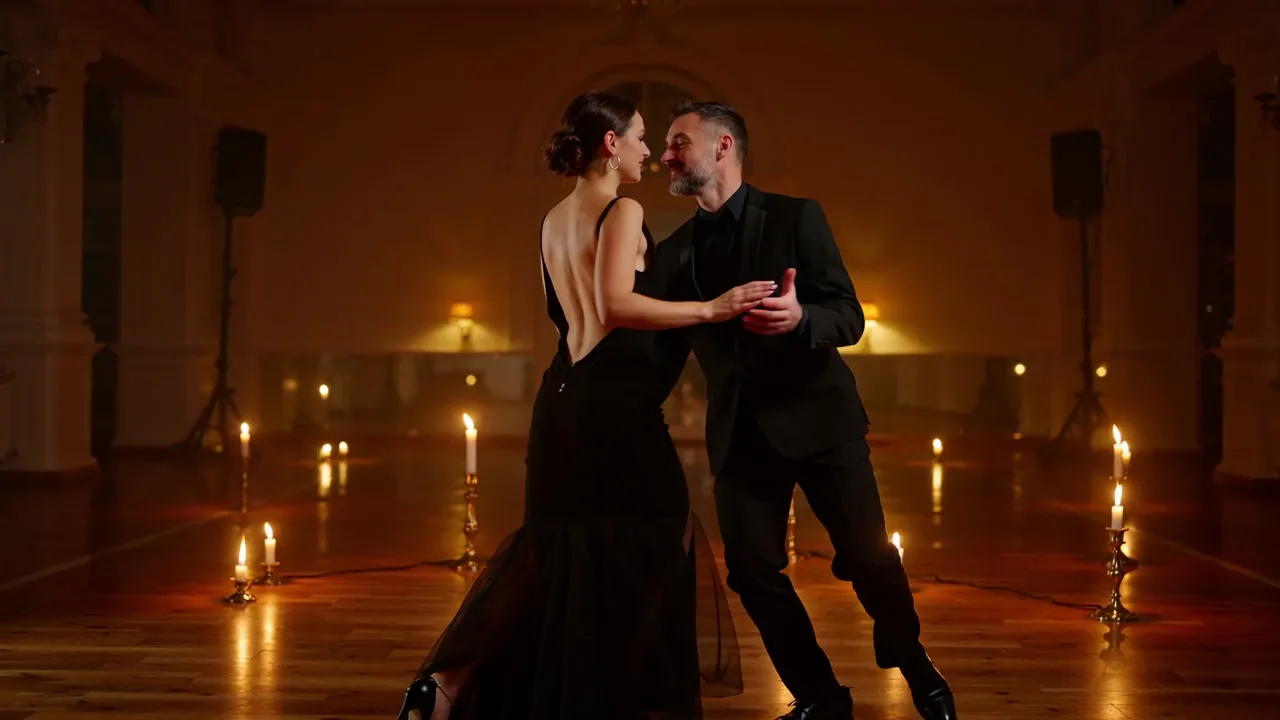
Clip de tango, 16:9, 720p, 5 s, seed 47. Fotograma de póster del ejemplo publicado.
La puesta en escena de dos personas es donde los modelos de video suelen desmoronarse, y este se mantuvo mejor de lo que esperábamos. Los fotogramas de abajo muestran a la pareja acercándose y terminando en la inclinación. Los reflejos de las velas en el suelo se mantienen en su sitio mientras la cámara orbita.
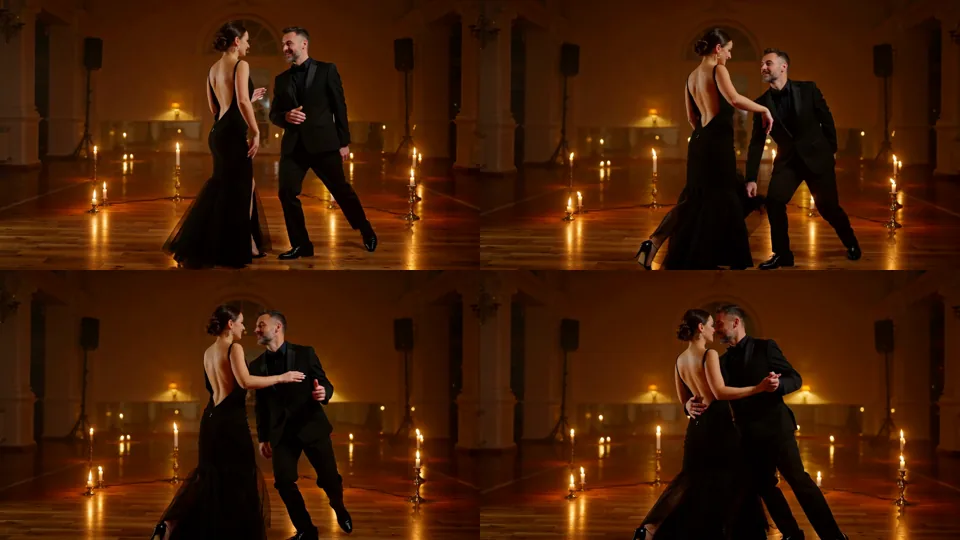
Fotogramas a los 0.1, 1.8, 3.6 y 5.2 segundos aproximadamente del clip de tango.
Hábitos que dieron resultado en todas nuestras ejecuciones:
- Escribe "adult" y da un rango de edad. Mantiene el casting razonable y es la regla de la casa para todo lo que publicamos.
- Pon la instrucción de cámara al final. "Slow dolly tracking shot", "slow push-in" y "slow orbiting camera" se siguieron cada una en el clip donde aparecían.
- Pide una acción por clip. Una caminata y un giro caben en cinco segundos; una historia no.
- Usa el prompt negativo para artefactos, no para gustos. "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo" es un valor por defecto razonable; el clip de neón corrió sin uno.
- Fija el seed mientras iteras. El mismo seed y las mismas entradas dieron un archivo idéntico byte a byte, así que un cambio en el resultado es un cambio que hiciste tú.
Las tres ranuras de LoRA y cuándo usar cada una
Aquí es donde el endpoint se diferencia de una llamada simple a Wan 2.2. Cada ranura admite hasta tres entradas con la forma {path, scale}, donde path es un enlace HTTPS directo a un archivo .safetensors y scale va de 0 a 4 (por defecto 1).
Ilustración del arte de la página del modelo, no un clip de prueba: tres llaves, tres aberturas, una para cada ranura.
| Ranura | A quién llega | Úsala para |
|---|---|---|
high_noise_loras | Solo al experto de ruido alto | Composición y movimiento: un movimiento de cámara, un tipo de acción, la composición general |
low_noise_loras | Solo al experto de ruido bajo | Detalle y textura: piel, tela, grano de película, estilo de render |
loras | A ambos expertos | Un LoRA de un solo archivo, o cuando quieres que un archivo actúe en ambas etapas |
La mayoría de los LoRA de Wan 2.2 en Hugging Face y Civitai se publican como un par: un archivo high_noise y un archivo low_noise. Pon cada uno en su propia ranura. Un LoRA publicado como un solo archivo va en loras. Si una ficha no dice a qué etapa apunta un archivo, empieza con loras y luego prueba el archivo solo en cada ranura especializada. Para el razonamiento detrás de esa elección, y una rutina de pruebas más larga construida sobre el endpoint de imagen a video, lee nuestra guía de las ranuras de ruido alto y ruido bajo; este artículo solo informa de lo que hizo texto a video.
Lo que vimos con un LoRA entrenado para esta misma base (Wan2.2-T2V-A14B), cargado en ambas ranuras especializadas con el seed fijo:
| Ejecución (mismo prompt, mismo seed 7, 480p, 16:9, 5 s) | Resultado frente al clip sin LoRA |
|---|---|
| Sin LoRA | Referencia |
| Par correspondiente, escala 0.5 | Misma composición, pequeño cambio en la forma del rostro y el peinado |
| Par correspondiente, escala 1 | Cambio mayor: pelo más corto, un rostro distinto |
Solo el archivo de ruido bajo, en loras (ambos expertos), escala 1 | También cambió a la persona |
| Un LoRA entrenado para otro modelo base | Idéntico byte a byte al clip sin LoRA |
La última fila es la que hay que recordar. Un LoRA creado para otro modelo base produjo exactamente el mismo archivo que ningún LoRA: sin error, sin advertencia, sin efecto. La ranura lo aceptó y simplemente no pasó nada. Por eso, compara siempre con una ejecución sin LoRA con el mismo seed antes de concluir que un LoRA funciona o que tu escala es demasiado baja. El LoRA de apariencia que usamos cambió más a la persona que el estilo, por eso mostramos el efecto en una tabla y no en una galería: demostró que la carga es real y que el efecto crece con la escala, pero no es un archivo de exhibición.
Cargar no suma ningún cargo aparte, y en nuestras ejecuciones agregó de 5 a 15 segundos de tiempo del modelo.
Cuando falla el enlace de un LoRA
Dos errores nos costaron una ejecución cada uno, y ambos son fáciles de evitar:
- Un enlace que exige iniciar sesión. Un repositorio restringido falla con un mensaje que dice que el servidor devolvió HTTP 401 y pide comprobar que la URL sea de acceso público. Usa un archivo público o un enlace firmado.
- La página de un repositorio en lugar del archivo. Pegar la página del modelo en lugar del enlace
resolve/main/...safetensorsdio un mensaje genérico de "the job failed unexpectedly". No es muy descriptivo, así que si lo ves con un LoRA adjunto, revisa primero el enlace.
Las solicitudes que rompen los límites nunca inician ningún trabajo: una cuarta entrada en una ranura, una escala superior a 4, una duración distinta de 5 u 8, o un prompt vacío se rechazan de entrada.
Hasta dónde llega
La plataforma no agrega ningún filtro de contenido, y lo que dibuja un modelo depende del modelo. Corrimos un clip en cada nivel de nuestra escala de contenido, el 5 de octubre de 2026, una ejecución por nivel, y revisamos cada hoja de fotogramas. Los niveles usan los mismos nombres que nuestras otras reseñas:
| Nivel | Qué pedimos | Resultado |
|---|---|---|
| L1 Sugerente | Lencería, un tirante que se desliza | Entregado |
| L2 Temas maduros | Atrevido, parcial | Entregado |
| L3 Fuerte | Nivel completo, una mujer y un hombre | Entregado |
| L4 Intenso | Una escena íntima entre dos adultos | Suavizado: la escena se dibuja, pero no por completo |
| L5 Extremo | Ataduras consentidas entre adultos; gore cinematográfico | Ataduras entregadas; el gore se suavizó a unos cortes y marcas |
Ninguna ejecución se rechazó y ningún clip se cambió por otro. Lee con honestidad las filas de L4 y del gore: el modelo llega muy lejos y luego se modera. Si tu caso de uso está en lo más alto de la escala, cuenta con que se quede corto. Es una ejecución por nivel, así que toma la tabla como una primera lectura, no como una garantía. Nuestra reseña de Wan 2.2 LoRA tiene el registro más largo de fechas anteriores.
Dónde se queda corto
- Video silencioso. No hay pista de audio ni opción de audio.
- Solo dos formatos. 16:9 y 9:16. Para una publicación cuadrada, recorta después.
- 720p es el techo. No hay nivel de 1080p.
- Duraciones fijas. Exactamente 5 u 8 segundos. Pedimos 6 y recibimos un rechazo, lo cual es mejor que un redondeo silencioso.
- Pocos controles. Sin velocidad de fotogramas, pasos, guidance ni expansión del prompt. Diriges con palabras, el seed, el prompt negativo y los LoRA.
- El texto dentro del cuadro no es fiable. Mira el ejemplo del neón más arriba.
- Más lento que una imagen fija. Un clip de 720p y 5 segundos tardó unos dos minutos de tiempo del modelo en nuestras ejecuciones, así que planifica los lotes con eso en mente.
- Una base de pruebas escasa. Corrimos un clip por nivel de la escala y un puñado de comparaciones de LoRA. No probamos los extremos del rango del seed, qué le hace un prompt negativo al contenido, ni una ejecución con las nueve entradas de LoRA cargadas.
Qué endpoint usar
| Quieres... | Usa | Por qué |
|---|---|---|
| Explorar una escena, un ambiente o un movimiento de cámara | Texto a video | Entra una frase, no hace falta imagen de origen |
| Que un rostro, atuendo o producto específico se mantenga | Imagen a video | El fotograma inicial fija el aspecto |
| Un clip vertical para el teléfono | Texto a video, 9:16 | El formato lo define un parámetro, no un recorte |
| Un primer borrador más barato | Texto a video, 480p, 5 s | Haz el borrador en el nivel más bajo y luego vuelve a correr el elegido a 720p |
| Una composición fija que puedas reproducir | Cualquiera, con un seed fijo | El mismo seed y las mismas entradas dieron un archivo idéntico byte a byte |
| Un efecto de un LoRA de la comunidad | Cualquiera, con la ranura correcta | Los archivos en par van en las ranuras de ruido alto y ruido bajo, los archivos únicos en loras |
Preguntas frecuentes
¿Wan 2.2 LoRA de texto a video genera audio?
No. La salida es un MP4 con solo pista de video, a 30 fps y sin sonido. Agrega música o voz en un editor una vez creado el clip.
¿Cuál es la diferencia entre las ranuras de LoRA de ruido alto y de ruido bajo?
La ranura de ruido alto llega al experto que define la composición y el movimiento, y la de ruido bajo llega al experto que refina el detalle y la textura. Usa loras para aplicar un archivo a ambos. La mayoría de los LoRA de Wan 2.2 se publican como un par de ruido alto y ruido bajo, así que cada archivo va en su propia ranura.
¿Por qué mi LoRA no cambió nada?
Lo más probable es que se haya entrenado para otro modelo base. En nuestra prueba, un LoRA creado para otra base produjo un archivo idéntico byte a byte al de la ejecución sin él, sin ningún error. Comprueba que la ficha nombre Wan 2.2 de texto a video y luego compara con una ejecución sin LoRA con el mismo seed.
¿Qué relaciones de aspecto, resoluciones y duraciones admite?
16:9 o 9:16, 480p o 720p, y exactamente 5 u 8 segundos. El formato cuadrado, 4:3, 1080p y otras duraciones no están disponibles, y un valor fuera de la lista se rechaza, no se redondea.
¿Puedo obtener el mismo clip dos veces?
En nuestras pruebas, sí: con el mismo prompt, el mismo seed y las mismas entradas obtuvimos un archivo idéntico byte a byte. Si omites el seed, cada solicitud es aleatoria.
¿Un LoRA cuesta extra?
No. La facturación es por segundo de video a la resolución elegida, y cargar LoRA no suma ningún cargo aparte. La relación de aspecto no cambia el precio, y las solicitudes fallidas no se cobran. El precio vigente está en la página del modelo.
¿No tiene censura?
La plataforma no agrega ningún filtro de contenido. En nuestra escala se entregaron los niveles L1 a L3 y las ataduras consentidas entre adultos, y los niveles más intensos se suavizaron. Los detalles están en la tabla de arriba.
¿Debo usar texto a video o imagen a video?
Usa texto a video cuando estés explorando y te sirva cualquier adulto adecuado, e imagen a video cuando el rostro, el atuendo o el escenario deban coincidir con una imagen que ya tienes. Una rutina común es explorar con texto a video y llevar el mejor fotograma a imagen a video.