O Wan 2.2 LoRA agora aceita uma cena escrita por conta própria: um prompt devolve um clipe de 5 ou 8 segundos em 480p ou 720p, em paisagem ou retrato, com até três LoRAs em cada um de três slots. Nos nossos testes de 5 de outubro de 2026, cada uma das quatro combinações de tamanho que rodamos voltou exatamente no tamanho de pixels pedido, a instrução de câmera no fim do prompt foi seguida em todos os clipes e o endpoint continuou sem censura: nenhuma recusa e nenhum clipe substituído. Os limites também são claros: sem áudio, sem formato quadrado, nada acima de 720p, e o nível mais intenso da nossa escada de conteúdo foi suavizado.
Até hoje, a família Wan 2.2 LoRA tinha um único endpoint, de imagem para vídeo, que anima uma imagem que você fornece. O novo endpoint de texto para vídeo não precisa de imagem nenhuma. Este artigo cobre o que medimos, como os três slots de LoRA se comportam, os prompts que funcionaram e quando escolhê-lo em vez do seu irmão. Todos os prompts que imprimimos são cenas do dia a dia ou de glamour com adultos vestidos; isso basta para aprender os controles.
Visão geral
| Pergunta | Resposta (testado em 5 de outubro de 2026) |
|---|---|
| Modelo | Wan2.2-T2V-A14B, da equipe Tongyi Wan da Alibaba, lançado com pesos abertos em 28 de julho de 2025 |
| Nome do modelo na API | alibaba/wan-2.2-lora/text-to-video |
| Entrada obrigatória | Somente prompt |
| Formatos | aspect_ratio 16:9 (padrão) ou 9:16 |
| Resolução | 480p (padrão) ou 720p |
| Duração | 5 s (padrão) ou 8 s; qualquer outro valor é rejeitado, nunca arredondado |
| Slots de LoRA | loras (os dois especialistas), high_noise_loras, low_noise_loras: até 3 entradas cada, scale de 0 a 4 |
| Também disponíveis | negative_prompt, seed (o mesmo seed e as mesmas entradas deram um arquivo idêntico byte a byte) |
| O que volta | MP4, H.264, 30 fps, sem trilha de áudio, um clipe por requisição |
| Velocidade nos nossos testes | 480p, 5 s: cerca de 65 a 75 s; 480p, 8 s: cerca de 80 s; 720p, 5 s: cerca de 110 a 150 s; uma LoRA acrescenta de 5 a 15 s |
| Indisponíveis | Áudio, formatos quadrado ou 4:3, 1080p, taxa de quadros, passos, guidance, expansão de prompt |
| Cobrança | Por segundo de vídeo na resolução escolhida; a proporção não a altera; carregar LoRAs não acrescenta cobrança separada; requisições que falham não são cobradas |
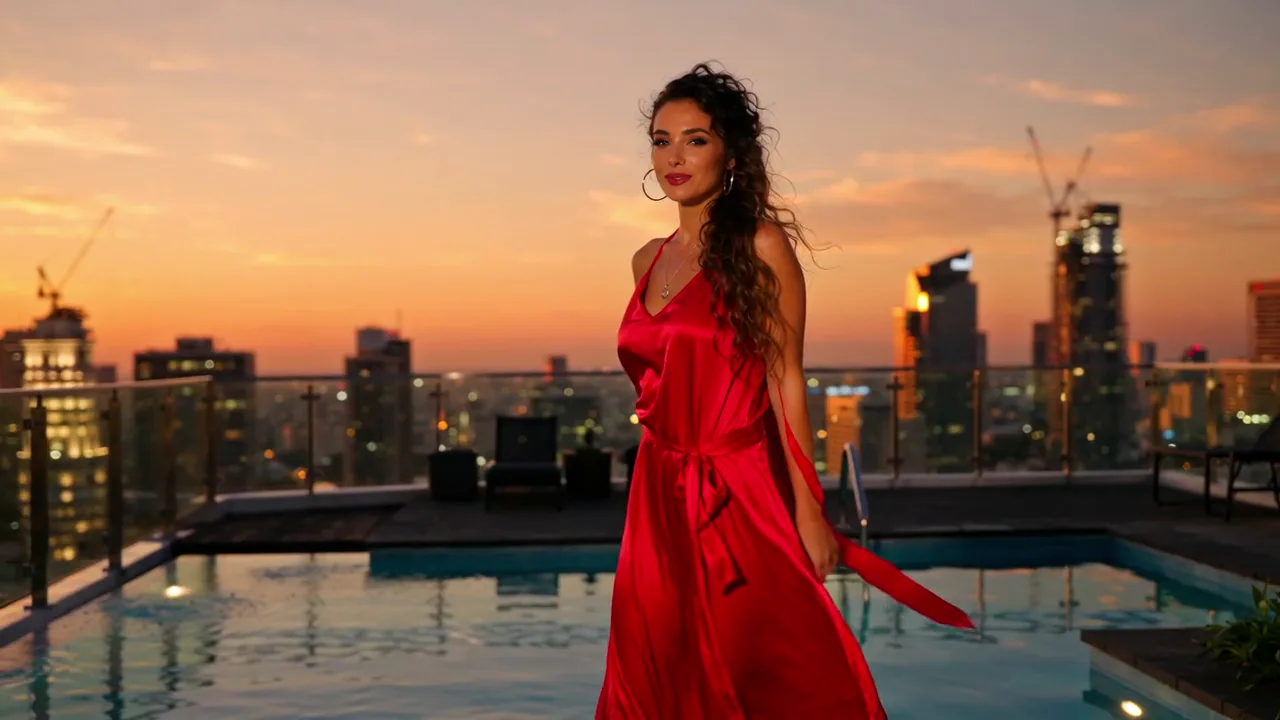
Wan 2.2 LoRA texto para vídeo, 720p, 16:9, 5 s, seed 20261005, sem LoRA, com prompt negativo. Primeiro quadro do clipe; o prompt está impresso abaixo.
O que é o modelo
O Wan 2.2 é um modelo de difusão de vídeo da equipe Tongyi Wan da Alibaba. A versão de texto para vídeo tem uma arquitetura de mistura de especialistas (Mixture-of-Experts), com dois especialistas de cerca de 14 bilhões de parâmetros cada. Só um roda por vez: o especialista de ruído alto cuida das primeiras etapas de remoção de ruído e define a disposição e o movimento, e o especialista de ruído baixo assume nas etapas finais e refina os detalhes. Essa divisão é o motivo de este endpoint ter três slots de LoRA em vez de um.
Quem publica diz que o modelo foi treinado com dados selecionados e rotulados por iluminação, composição, contraste e tom de cor, com muito mais material que o Wan 2.1 (65,6% mais imagens e 83,2% mais vídeos), e que suporta 480P e 720P. Nas nossas execuções isso apareceu como pessoas e pele fotorrealistas, interiores quentes com pouca luz, hora dourada, neon e chuva, e movimentos de câmera lentos de dolly, aproximação e órbita. Frases simples em inglês funcionaram bem. Nunca precisamos de uma sopa de tags.
O que muda em relação à imagem para vídeo
Os dois endpoints compartilham os mesmos campos de LoRA e as mesmas durações de 5 ou 8 segundos. As diferenças decidem qual você escolhe:
| Imagem para vídeo (existente) | Texto para vídeo (novo) | |
|---|---|---|
| Página do endpoint | Imagem para vídeo | Texto para vídeo |
| Entrada obrigatória | prompt e image_url | prompt |
| Quem define o visual | O seu quadro de abertura: sujeito, roupa, cenário e formato | O prompt, mais o seed |
| Formato | Segue o quadro de abertura | 16:9 ou 9:16 |
| Prompt negativo | Não | Sim |
| Preço por segundo | Menor | Maior; os dois têm preço separado, então confira o preço atual em cada página |
A regra prática: se um rosto, uma roupa ou um produto precisa combinar com algo que você já tem, use imagem para vídeo. Se você está explorando uma cena, um clima ou um movimento de câmera e não se importa com qual adulto aparece, use texto para vídeo. Um bom fluxo é explorar com texto para vídeo, escolher o melhor quadro e depois continuar a partir dele no endpoint irmão.
Tamanhos, durações e o que realmente volta
Rodamos as quatro combinações de tamanho e as duas durações. Todas as requisições devolveram exatamente o tamanho de pixels pedido:
aspect_ratio e resolution | Tamanho da saída | Pedido de 5 s | Pedido de 8 s |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161 quadros, 5,37 s | 247 quadros, 8,23 s |
| 9:16, 480p | 480 x 832 | 5,37 s | não rodado |
| 16:9, 720p | 1280 x 720 | 5,37 s | não rodado |
| 9:16, 720p | 720 x 1280 | 5,37 s | não rodado |
Dois detalhes que valem saber. Os clipes saem um pouco mais longos que o pedido por causa da interpolação de quadros: um pedido de 5 segundos deu 5,37 segundos e um de 8 segundos deu 8,23 segundos. E a saída é silenciosa. Se o clipe precisa de som, adicione-o depois.
Ilustração da arte da página do modelo, não um clipe de teste: as duas durações, 5 segundos à esquerda e 8 à direita.
Nossa regra prática para a resolução: faça o rascunho em 480p, porque é o padrão, termina em cerca de um minuto e a composição que você vê é a que terá em 720p. Passe para 720p na renderização final. Para a duração: 5 segundos bastam para uma ação e um movimento de câmera; escolha 8 apenas quando a ação tiver começo, meio e fim.
Prompts que funcionaram
A estrutura que nunca nos falhou tem quatro partes em um parágrafo: quem, o que faz, a luz e, por último, o movimento de câmera. Tudo abaixo usou adultos e cenários do dia a dia ou de glamour.
Terraço ao entardecer (16:9, 720p, 5 s, seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
A seda, os reflexos do horizonte e a luz quente chegaram, e a mulher manteve o mesmo rosto e o mesmo vestido durante o clipe inteiro. A tira abaixo mostra quatro quadros ao longo dos cinco segundos:
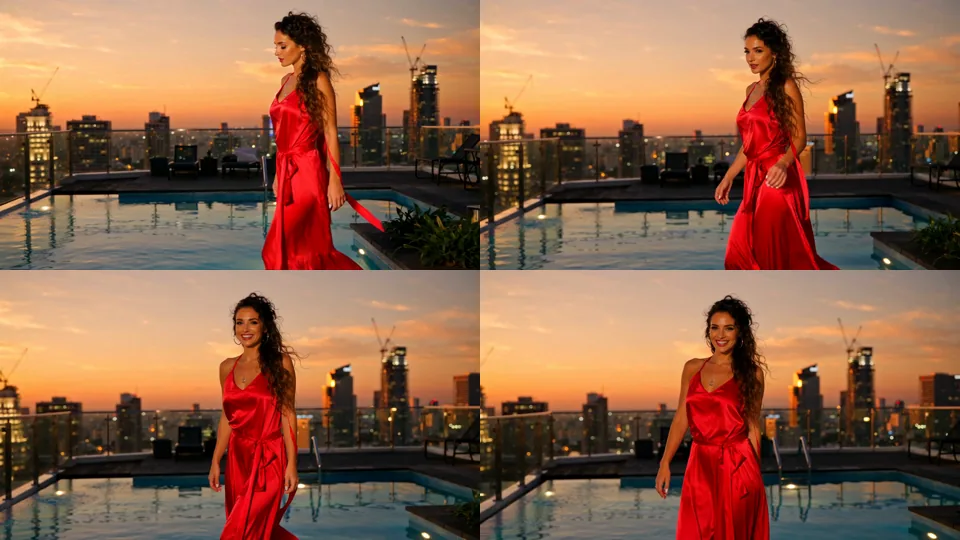
Quadros em cerca de 0,1, 1,8, 3,6 e 5,2 segundos do clipe do terraço. A caminhada, a virada e o movimento de acompanhamento acontecem como escritos.
Retrato com neon e chuva (9:16, 720p, 5 s, seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}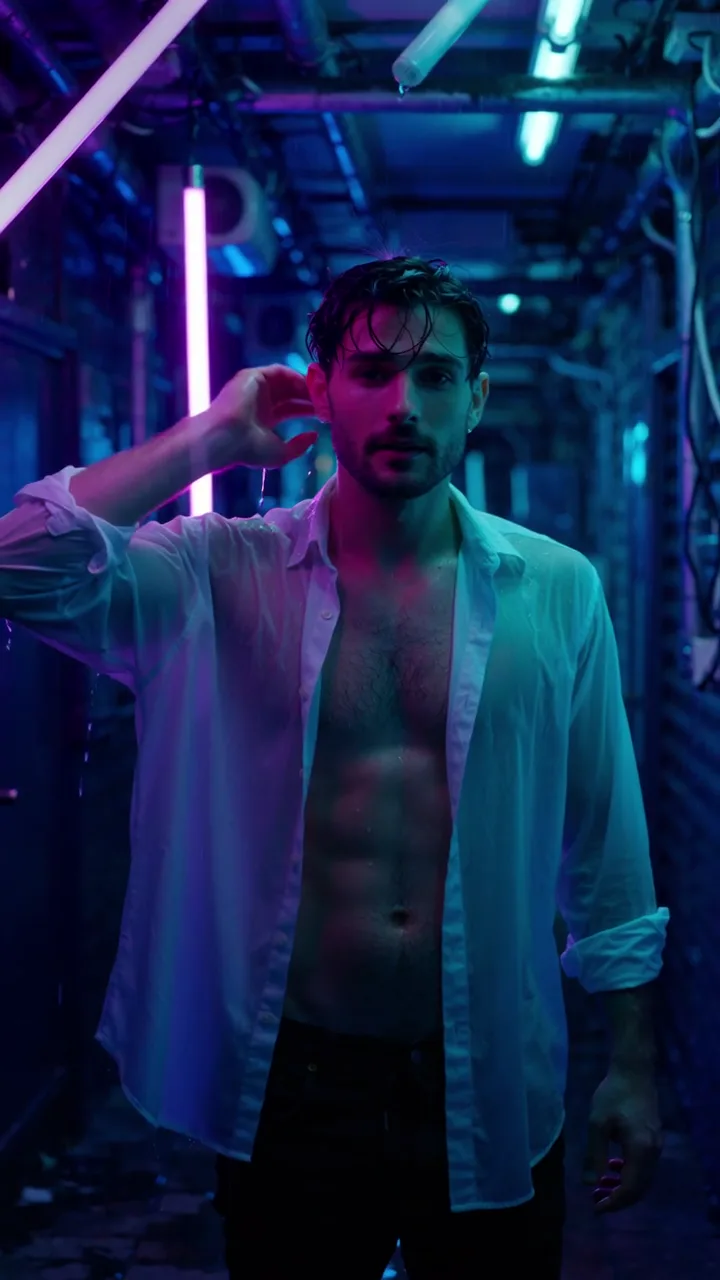
Retrato 720p, 5 s, seed 32. Quadro de pôster; o gesto de jogar o cabelo para trás e a aproximação lenta acontecem na tela.
Repare na frase "no signs or lettering anywhere". A primeira versão deste prompt tinha um letreiro de neon ao fundo, e o modelo desenhou letras embaralhadas nele. Reescrevemos a cena em torno de tubos de luz nus e o problema sumiu. O Wan 2.2 não soletra de forma confiável, então dê a ele uma cena sem nada para soletrar.
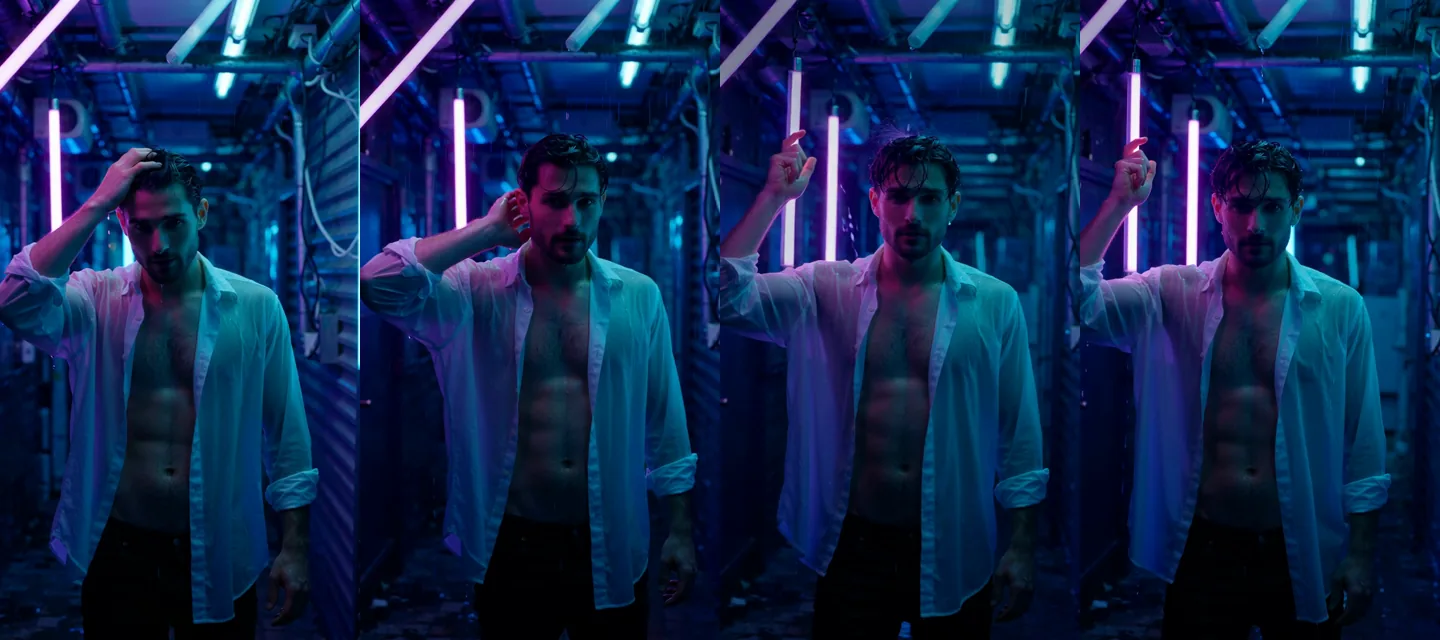
Quadros em cerca de 0,1, 1,8, 3,6 e 5,2 segundos do clipe em retrato. O rosto e a camisa se mantêm consistentes do primeiro quadro ao último.
Tango à luz de velas (16:9, 720p, 5 s, seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
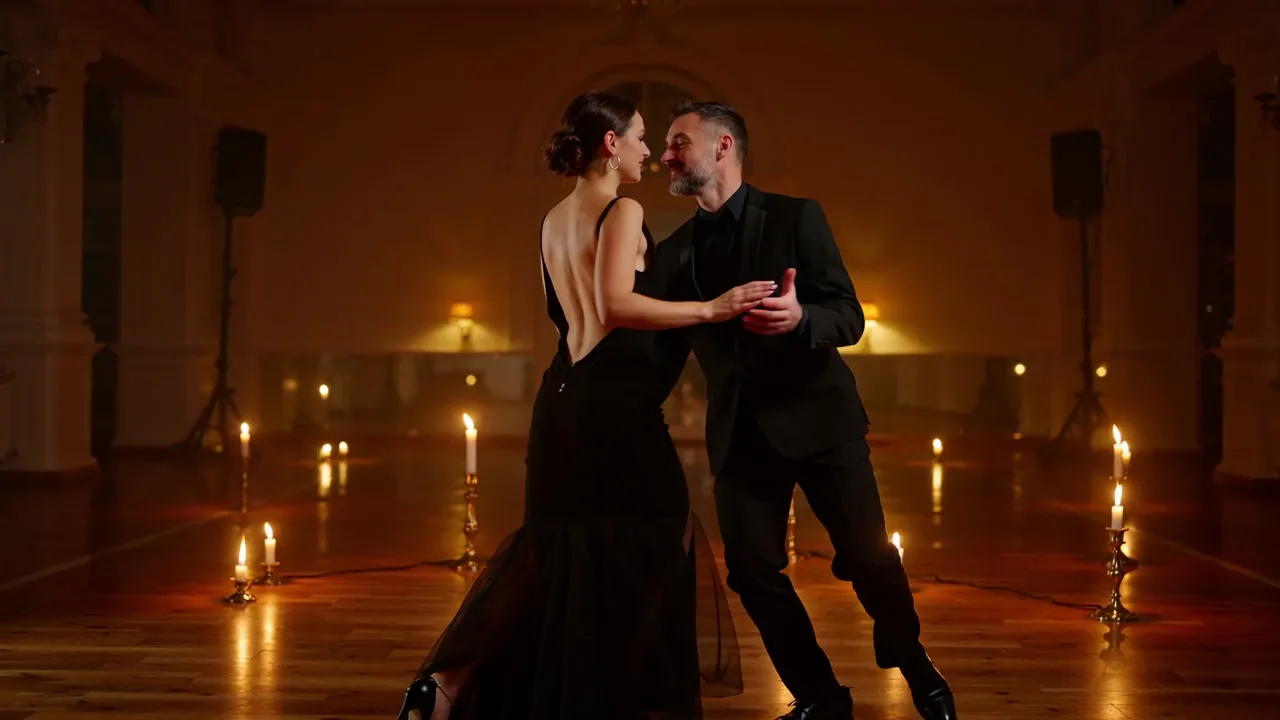
Clipe do tango, 16:9, 720p, 5 s, seed 47. Quadro de pôster do exemplo publicado.
A encenação com duas pessoas é onde os modelos de vídeo costumam se desfazer, e este se manteve melhor do que esperávamos. Os quadros abaixo mostram o casal se aproximando e terminando no mergulho. Os reflexos das velas no piso ficam no lugar enquanto a câmera orbita.
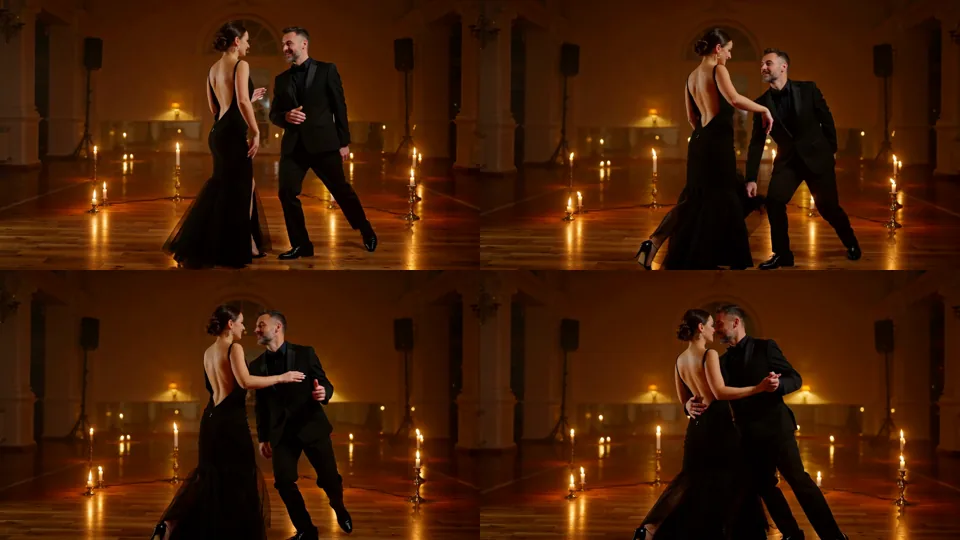
Quadros em cerca de 0,1, 1,8, 3,6 e 5,2 segundos do clipe do tango.
Hábitos que compensaram em todas as nossas execuções:
- Diga "adult" e dê uma faixa de idade. Mantém o elenco sensato e é a regra da casa para tudo o que publicamos.
- Coloque a instrução de câmera por último. "Slow dolly tracking shot", "slow push-in" e "slow orbiting camera" foram seguidos cada um no clipe em que apareceram.
- Peça uma ação por clipe. Uma caminhada e uma virada cabem em cinco segundos; uma história, não.
- Use o prompt negativo para artefatos, não para gosto. "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo" é um padrão sensato; o clipe de neon rodou sem um.
- Fixe o seed enquanto itera. O mesmo seed e as mesmas entradas deram um arquivo idêntico byte a byte, então uma mudança no resultado é uma mudança que você fez.
Os três slots de LoRA e quando usar cada um
Aqui o endpoint difere de uma chamada simples do Wan 2.2. Cada slot aceita até três entradas na forma {path, scale}, em que path é um link HTTPS direto para um arquivo .safetensors e scale vai de 0 a 4 (padrão 1).
Ilustração da arte da página do modelo, não um clipe de teste: três chaves, três aberturas, uma para cada slot.
| Slot | Alcança | Use para |
|---|---|---|
high_noise_loras | Só o especialista de ruído alto | Disposição e movimento: um movimento de câmera, um tipo de ação, a composição geral |
low_noise_loras | Só o especialista de ruído baixo | Detalhe e textura: pele, tecido, grão de filme, estilo de renderização |
loras | Os dois especialistas | Uma LoRA de arquivo único, ou quando você quer que um arquivo atue nas duas etapas |
A maioria das LoRAs de Wan 2.2 no Hugging Face e no Civitai é publicada como um par: um arquivo high_noise e um arquivo low_noise. Coloque cada um no seu slot. Uma LoRA lançada como um arquivo só vai em loras. Se o cartão não diz a qual etapa um arquivo se destina, comece com loras e depois teste o arquivo sozinho em cada slot especializado. Para o raciocínio por trás dessa escolha, e uma rotina de testes mais longa construída sobre o endpoint de imagem para vídeo, leia o nosso guia dos slots de ruído alto e ruído baixo; este artigo relata apenas o que o texto para vídeo fez.
O que vimos com uma LoRA treinada para exatamente esta base (Wan2.2-T2V-A14B), carregada nos dois slots especializados com o seed fixo:
| Execução (mesmo prompt, mesmo seed 7, 480p, 16:9, 5 s) | Resultado em relação ao clipe sem LoRA |
|---|---|
| Sem LoRA | Referência |
| Par correspondente, scale 0.5 | Mesma composição, pequena mudança no formato do rosto e no penteado |
| Par correspondente, scale 1 | Mudança maior: cabelo mais curto, outro rosto |
Só o arquivo de ruído baixo, em loras (os dois especialistas), scale 1 | Também mudou a pessoa |
| Uma LoRA treinada para outro modelo base | Idêntico byte a byte ao clipe sem LoRA |
A última linha é a que deve ficar na memória. Uma LoRA feita para outro modelo base produziu exatamente o mesmo arquivo que nenhuma LoRA: sem erro, sem aviso, sem efeito. O slot a aceitou e simplesmente nada aconteceu. Portanto, compare sempre com uma execução sem LoRA no mesmo seed antes de concluir que uma LoRA funciona, ou que o seu scale está baixo demais. A LoRA de aparência que usamos mudou mais a pessoa que o estilo, e é por isso que mostramos o efeito em uma tabela e não em uma galeria: ela provou que o carregamento é real e que o efeito cresce com o scale, mas não é um arquivo de vitrine.
Carregar não acrescenta cobrança separada e, nas nossas execuções, acrescentou de 5 a 15 segundos de tempo de modelo.
Quando um link de LoRA falha
Dois erros nos custaram uma execução cada, e os dois são fáceis de evitar:
- Um link que exige login. Um repositório restrito falha com uma mensagem dizendo que o servidor devolveu HTTP 401 e pedindo que você confira se a URL é acessível publicamente. Use um arquivo público ou um link assinado.
- Uma página de repositório em vez do arquivo. Colar a página do modelo em vez do link
resolve/main/...safetensorsdeu uma mensagem genérica "the job failed unexpectedly". Não é muito descritiva, então, se você a vir com uma LoRA anexada, confira o link primeiro.
Requisições que violam os limites nunca iniciam trabalho: uma quarta entrada em um slot, um scale acima de 4, uma duração diferente de 5 ou 8, ou um prompt vazio são rejeitados de imediato.
Até onde ele vai
A plataforma não adiciona nenhum filtro de conteúdo, e o que um modelo desenha cabe ao modelo. Rodamos um clipe em cada nível da nossa escada de conteúdo, em 5 de outubro de 2026, uma execução por nível, e olhamos todas as folhas de quadros. Os níveis usam os mesmos nomes das nossas outras análises:
| Nível | O que pedimos | Resultado |
|---|---|---|
| L1 Sugestivo | Lingerie, uma alcinha escorregando | Entregue |
| L2 Temas maduros | Ousado, parcial | Entregue |
| L3 Forte | Nível completo, uma mulher e um homem | Entregue |
| L4 Intenso | Uma cena íntima entre dois adultos | Suavizado: a cena é desenhada, mas não por inteiro |
| L5 Extremo | Contenção consensual entre adultos; gore cinematográfico | Contenção entregue; gore suavizado para alguns cortes e marcas |
Nenhuma execução foi recusada e nenhum clipe foi trocado por outro. Leia as linhas do L4 e do gore com honestidade: o modelo vai muito longe e depois se acalma. Se o seu caso de uso mora no topo da escada, planeje que ele fique aquém. É uma execução por nível, então trate a tabela como uma primeira leitura, não uma garantia. A nossa análise do Wan 2.2 LoRA traz o histórico mais longo de datas anteriores.
Onde ele fica devendo
- Vídeo silencioso. Não há trilha de áudio nem opção de áudio.
- Só dois formatos. 16:9 e 9:16. Para um post quadrado, corte depois.
- 720p é o teto. Não há faixa de 1080p.
- Durações fixas. Exatamente 5 ou 8 segundos. Pedimos 6 e recebemos uma rejeição, o que é melhor que um arredondamento silencioso.
- Poucos controles. Sem taxa de quadros, passos, guidance nem expansão de prompt. Você conduz com palavras, o seed, o prompt negativo e LoRAs.
- Texto no quadro é pouco confiável. Veja o exemplo do neon acima.
- Mais lento que uma imagem estática. Um clipe de 720p e 5 segundos levou cerca de dois minutos de tempo de modelo nas nossas execuções, então planeje os lotes com isso em mente.
- Uma base de teste enxuta. Rodamos um clipe por nível da escada e um punhado de comparações de LoRA. Não testamos os extremos da faixa de seed, o que um prompt negativo faz com o conteúdo, nem uma execução com as nove entradas de LoRA carregadas.
Qual endpoint usar
| Você quer... | Use | Por quê |
|---|---|---|
| Explorar uma cena, um clima ou um movimento de câmera | Texto para vídeo | Uma frase de entrada, sem imagem de origem |
| Um rosto, uma roupa ou um produto específico que se mantenha | Imagem para vídeo | O quadro de abertura fixa o visual |
| Um clipe em retrato para o celular | Texto para vídeo, 9:16 | O formato é definido por um parâmetro, não por corte |
| Um primeiro rascunho mais barato | Texto para vídeo, 480p, 5 s | Faça o rascunho na faixa mais baixa e depois rode de novo o escolhido em 720p |
| Uma composição fixa que você consiga reproduzir | Qualquer um, com seed fixo | O mesmo seed e as mesmas entradas deram um arquivo idêntico byte a byte |
| Um efeito de uma LoRA da comunidade | Qualquer um, com o slot certo | Arquivos de par vão nos slots de ruído alto e de ruído baixo, arquivos únicos em loras |
FAQ
O Wan 2.2 LoRA texto para vídeo gera áudio?
Não. A saída é um MP4 apenas com trilha de vídeo, a 30 fps e sem som. Adicione música ou fala em um editor depois que o clipe estiver pronto.
Qual é a diferença entre os slots de LoRA de ruído alto e de ruído baixo?
O slot de ruído alto alcança o especialista que define a disposição e o movimento, e o slot de ruído baixo alcança o especialista que refina detalhe e textura. Use loras para aplicar um arquivo aos dois. A maioria das LoRAs de Wan 2.2 é publicada como um par de ruído alto e ruído baixo, então cada arquivo vai no seu slot.
Por que a minha LoRA não mudou nada?
Muito provavelmente foi treinada para outro modelo base. No nosso teste, uma LoRA feita para outra base produziu um arquivo idêntico byte a byte ao da execução sem ela, sem erro. Confira se o cartão cita o Wan 2.2 texto para vídeo e depois compare com uma execução sem LoRA no mesmo seed.
Que proporções, resoluções e durações ele aceita?
16:9 ou 9:16, 480p ou 720p, e exatamente 5 ou 8 segundos. Quadrado, 4:3, 1080p e outras durações não estão disponíveis, e um valor fora da lista é rejeitado, não arredondado.
Posso obter o mesmo clipe duas vezes?
Sim. Com o mesmo prompt, o mesmo seed e as mesmas entradas, obtivemos um arquivo idêntico byte a byte. Deixe o seed de fora e cada requisição é aleatória.
Uma LoRA custa a mais?
Não. A cobrança é por segundo de vídeo na resolução escolhida, e carregar LoRAs não acrescenta cobrança separada. A proporção não altera o preço, e requisições que falham não são cobradas. O preço atual está na página do modelo.
Ele é sem censura?
A plataforma não adiciona nenhum filtro de conteúdo. Na nossa escada, os níveis L1 a L3 e a contenção consensual entre adultos foram entregues, e os níveis mais intensos foram suavizados. Os detalhes estão na tabela acima.
Devo usar texto para vídeo ou imagem para vídeo?
Use texto para vídeo quando estiver explorando e qualquer adulto adequado servir, e imagem para vídeo quando o rosto, a roupa ou o cenário precisar combinar com uma imagem que você já tem. Uma rotina comum é explorar com texto para vídeo e levar o melhor quadro para a imagem para vídeo.