Wan 2.2 LoRA nimmt jetzt eine geschriebene Szene ganz allein entgegen: Ein Prompt liefert einen Clip von 5 oder 8 Sekunden in 480p oder 720p, im Quer- oder Hochformat, mit bis zu drei LoRAs in jedem von drei Slots. In unseren Tests am 5. Oktober 2026 kam jede der vier getesteten Größenkombinationen in exakt der angeforderten Pixelgröße zurück, die Kameraanweisung am Ende des Prompts wurde in jedem Clip befolgt, und der Endpunkt blieb unzensiert: keine Ablehnungen und keine untergeschobenen Clips. Seine Grenzen sind ebenfalls klar: kein Audio, kein quadratisches Format, nichts über 720p, und die intensivste Stufe unserer Inhaltsleiter wurde abgeschwächt.
Bis heute hatte die Familie Wan 2.2 LoRA einen Endpunkt, Bild-zu-Video, der ein von Ihnen geliefertes Bild animiert. Der neue Text-zu-Video-Endpunkt braucht gar kein Bild. Dieser Artikel behandelt, was wir gemessen haben, wie sich die drei LoRA-Slots verhalten, welche Prompts funktionierten und wann Sie ihn dem Geschwister-Endpunkt vorziehen. Jeder Prompt, den wir abdrucken, ist eine Alltags- oder Glamour-Szene mit bekleideten Erwachsenen; das genügt, um die Regler kennenzulernen.
Auf einen Blick
| Frage | Antwort (getestet am 5. Oktober 2026) |
|---|---|
| Modell | Wan2.2-T2V-A14B vom Tongyi-Wan-Team von Alibaba, am 28. Juli 2025 als offene Gewichte veröffentlicht |
| API-Modellname | alibaba/wan-2.2-lora/text-to-video |
| Pflichteingabe | nur prompt |
| Formate | aspect_ratio 16:9 (Standard) oder 9:16 |
| Auflösung | 480p (Standard) oder 720p |
| Länge | 5 s (Standard) oder 8 s; jeder andere Wert wird abgelehnt, nie gerundet |
| LoRA-Slots | loras (beide Experten), high_noise_loras, low_noise_loras: je bis zu 3 Einträge, scale 0 bis 4 |
| Außerdem verfügbar | negative_prompt, seed (gleicher Seed und gleiche Eingaben ergaben eine byte-identische Datei) |
| Was zurückkommt | MP4, H.264, 30 fps, keine Tonspur, ein Clip pro Anfrage |
| Tempo in unseren Tests | 480p, 5 s: etwa 65 bis 75 s; 480p, 8 s: etwa 80 s; 720p, 5 s: etwa 110 bis 150 s; eine LoRA fügt 5 bis 15 s hinzu |
| Nicht verfügbar | Audio, quadratische oder 4:3-Formate, 1080p, Bildrate, Schritte, Guidance, Prompt-Erweiterung |
| Abrechnung | Pro Sekunde Video bei der gewählten Auflösung; das Seitenverhältnis ändert sie nicht; das Laden von LoRAs kostet nichts extra; fehlgeschlagene Anfragen werden nicht berechnet |
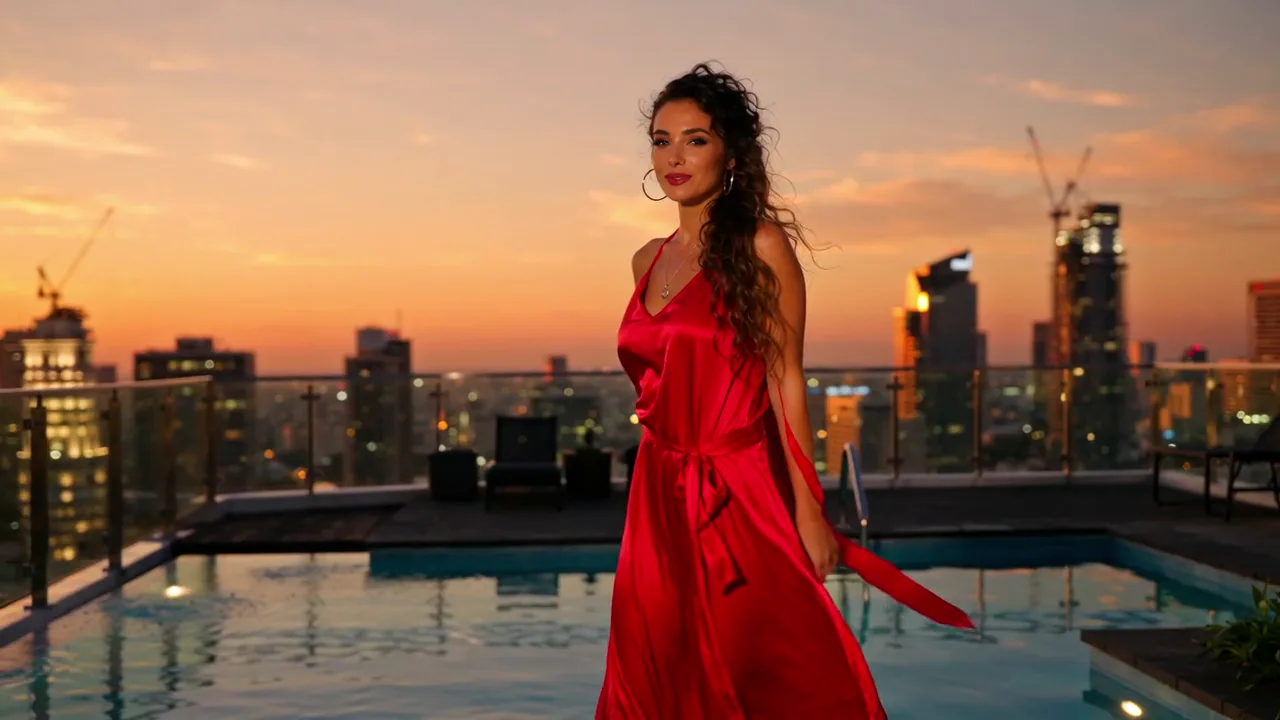
Wan 2.2 LoRA Text-zu-Video, 720p, 16:9, 5 s, Seed 20261005, keine LoRA, mit negativem Prompt. Erster Frame des Clips; der Prompt steht unten.
Was das Modell ist
Wan 2.2 ist ein Video-Diffusionsmodell vom Tongyi-Wan-Team von Alibaba. Der Text-zu-Video-Build ist ein Mixture-of-Experts-Design mit zwei Experten von je etwa 14 Milliarden Parametern. Es läuft immer nur einer: Der High-Noise-Experte übernimmt die frühen Entrauschungsschritte und legt Layout und Bewegung fest, und der Low-Noise-Experte übernimmt in den späteren Schritten und verfeinert Details. Diese Aufteilung ist der Grund, warum dieser Endpunkt drei LoRA-Slots statt einem hat.
Der Anbieter sagt, es sei mit kuratierten Daten trainiert worden, die nach Beleuchtung, Komposition, Kontrast und Farbton beschriftet sind, mit weit mehr Material als bei Wan 2.1 (65,6 % mehr Bilder und 83,2 % mehr Videos), und es unterstütze 480P und 720P. In unseren Läufen zeigte sich das als fotorealistische Menschen und Haut, warme Innenräume bei wenig Licht, goldene Stunde, Neon und Regen sowie langsame Dolly-, Annäherungs- und Orbit-Kamerafahrten. Schlichte englische Sätze funktionierten gut. Ein Tag-Wirrwarr brauchten wir nie.
Was sich gegenüber Bild-zu-Video ändert
Beide Endpunkte teilen dieselben LoRA-Felder und dieselben Längen von 5 oder 8 Sekunden. Die Unterschiede entscheiden, nach welchem Sie greifen:
| Bild-zu-Video (bestehend) | Text-zu-Video (neu) | |
|---|---|---|
| Endpunktseite | Bild-zu-Video | Text-zu-Video |
| Pflichteingabe | prompt und image_url | prompt |
| Wer den Look bestimmt | Ihr Startbild: Motiv, Outfit, Kulisse und Format | Der Prompt, dazu der Seed |
| Format | Folgt dem Startbild | 16:9 oder 9:16 |
| Negativer Prompt | Nein | Ja |
| Preis pro Sekunde | Niedriger | Höher; die beiden sind getrennt bepreist, prüfen Sie also den aktuellen Preis auf jeder Seite |
Die praktische Regel: Wenn ein Gesicht, ein Outfit oder ein Produkt zu etwas passen muss, das Sie bereits haben, nutzen Sie Bild-zu-Video. Wenn Sie eine Szene, eine Stimmung oder eine Kamerafahrt erkunden und es Ihnen egal ist, welche erwachsene Person erscheint, nutzen Sie Text-zu-Video. Ein guter Ablauf ist, mit Text-zu-Video zu erkunden, den besten Frame zu wählen und von diesem Frame auf dem Geschwister-Endpunkt weiterzumachen.
Größen, Längen und was tatsächlich zurückkommt
Wir haben alle vier Größenkombinationen und beide Längen gefahren. Jede Anfrage lieferte exakt die verlangte Pixelgröße:
aspect_ratio und resolution | Ausgabegröße | Anfrage mit 5 s | Anfrage mit 8 s |
|---|---|---|---|
| 16:9, 480p | 832 x 480 | 161 Frames, 5,37 s | 247 Frames, 8,23 s |
| 9:16, 480p | 480 x 832 | 5,37 s | nicht gefahren |
| 16:9, 720p | 1280 x 720 | 5,37 s | nicht gefahren |
| 9:16, 720p | 720 x 1280 | 5,37 s | nicht gefahren |
Zwei Details, die man wissen sollte. Die Clips laufen wegen der Frame-Interpolation etwas länger als verlangt: Eine Anfrage über 5 Sekunden ergab 5,37 Sekunden und eine über 8 Sekunden 8,23 Sekunden. Und die Ausgabe ist stumm. Wenn der Clip Ton braucht, fügen Sie ihn nachträglich hinzu.
Illustration aus der Landing-Art des Modells, kein Testclip: die beiden Längen, 5 Sekunden links und 8 rechts.
Unsere Faustregel für die Auflösung: Entwerfen Sie in 480p, denn es ist der Standard, es ist in etwa einer Minute fertig, und die Komposition, die Sie sehen, ist die Komposition, die Sie in 720p bekommen. Wechseln Sie für den finalen Render auf 720p. Für die Länge: 5 Sekunden reichen für eine Handlung und eine Kamerafahrt; wählen Sie 8 nur, wenn die Handlung Anfang, Mitte und Ende hat.
Prompts, die funktionierten
Die Struktur, die uns nie im Stich ließ, hat vier Teile in einem Absatz: wer, was die Person tut, das Licht und zuletzt die Kamerafahrt. Alles Folgende nutzte Erwachsene und Alltags- oder Glamour-Umgebungen.
Dach in der Dämmerung (16:9, 720p, 5 s, Seed 20261005):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult woman in her late twenties in a red silk slip dress walks slowly along the edge of a rooftop infinity pool at dusk, the city skyline glowing orange behind her; she stops, looks back over her bare shoulder at the camera and smiles. Warm golden-hour light, slow dolly tracking shot, cinematic, shallow depth of field.",
  "negative_prompt": "blurry, low quality, distorted hands, extra fingers, text, watermark, logo",
  "aspect_ratio": "16:9",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 20261005
}
Die Seide, die Spiegelungen der Skyline und das warme Licht kamen alle an, und die Frau behielt im ganzen Clip dasselbe Gesicht und dasselbe Kleid. Der Streifen unten zeigt vier Frames über die fünf Sekunden:
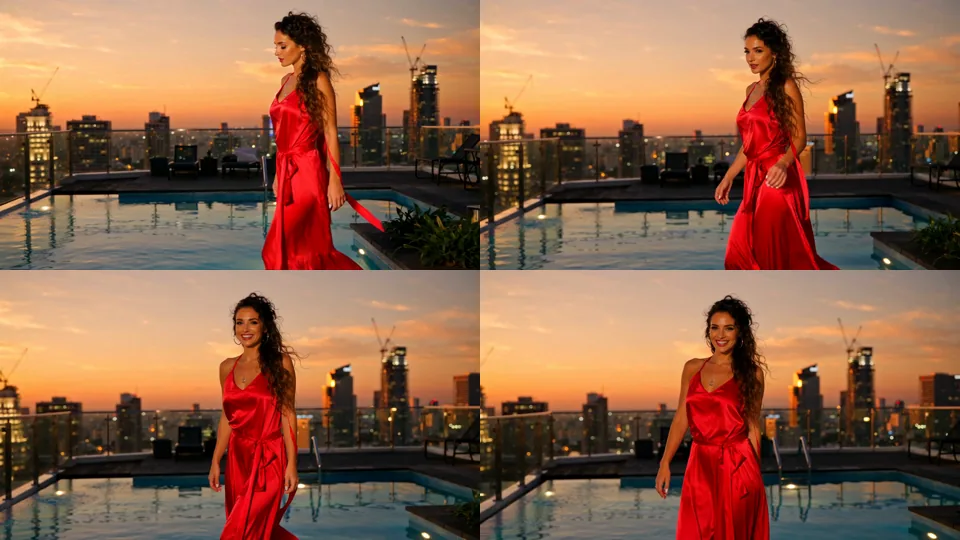
Frames bei etwa 0,1, 1,8, 3,6 und 5,2 Sekunden des Dach-Clips. Der Gang, die Drehung und die Kamerafahrt geschehen wie geschrieben.
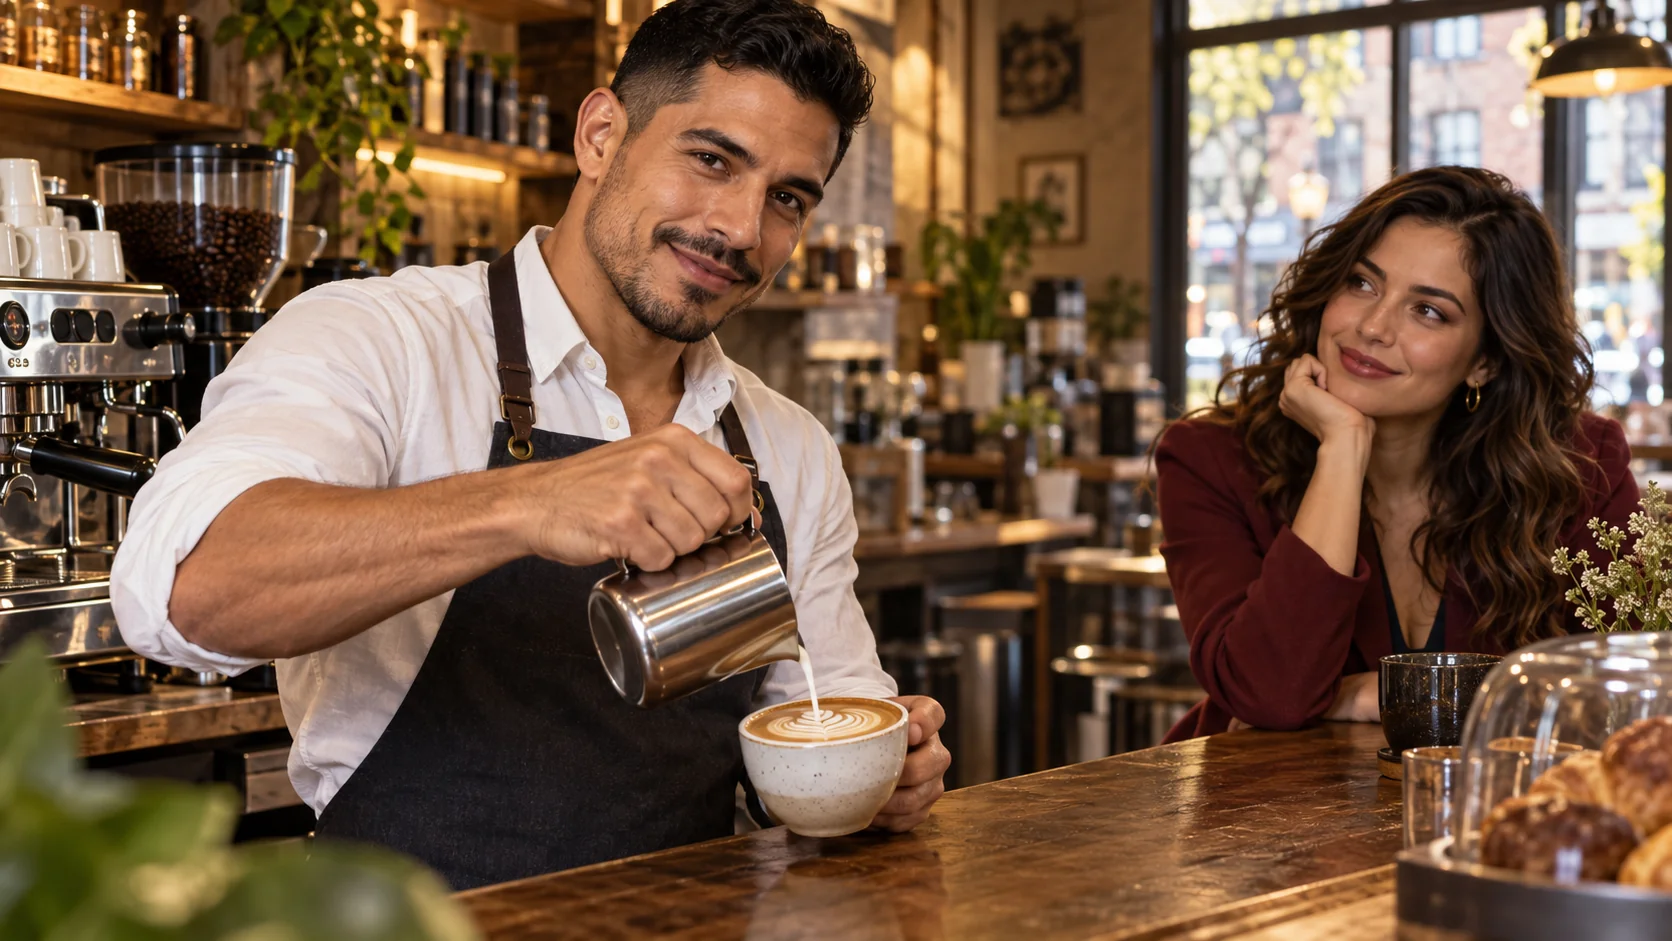
Neon-Regen-Porträt (9:16, 720p, 5 s, Seed 32):
{
  "model": "alibaba/wan-2.2-lora/text-to-video",
  "prompt": "An adult man in his thirties in an open white linen shirt, soaked by rain, stands beneath bare pink and teal neon light tubes in a narrow alley at night, no signs or lettering anywhere, pushes his wet hair back with one hand and looks straight into the camera. Raindrops glittering in the light, slow push-in, cinematic, shallow depth of field.",
  "aspect_ratio": "9:16",
  "resolution": "720p",
  "duration_seconds": 5,
  "seed": 32
}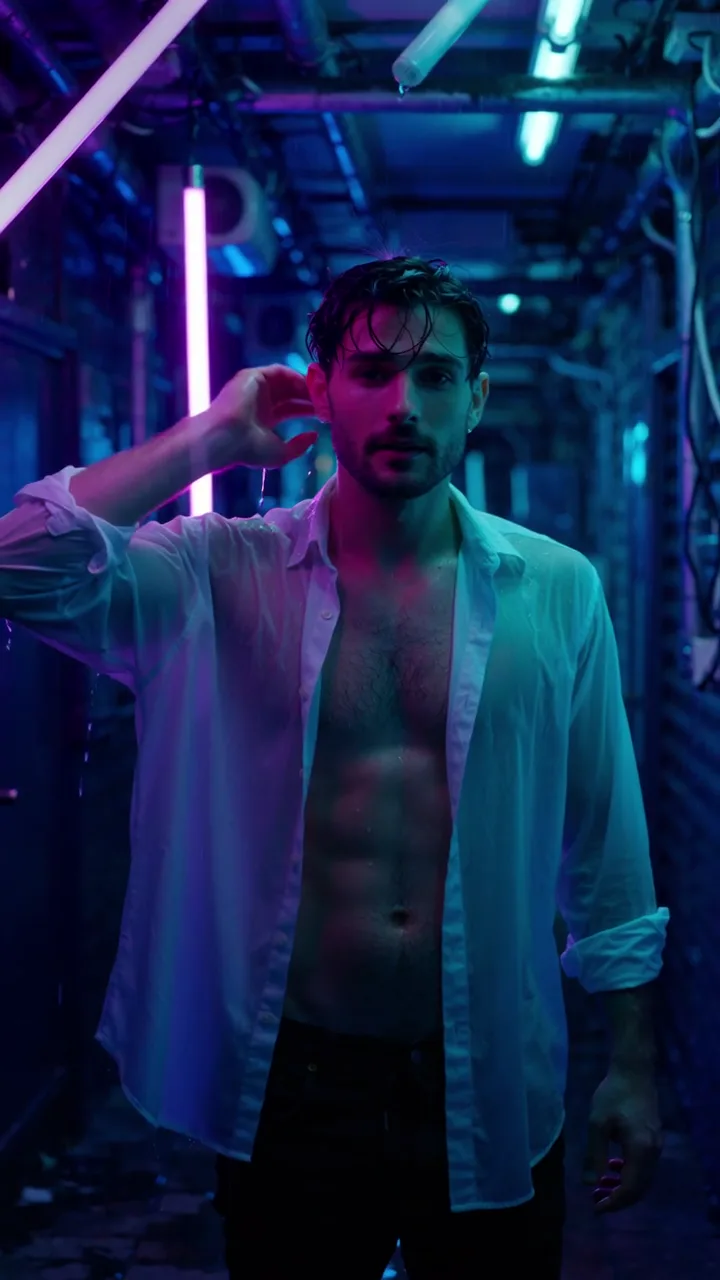
Hochformat 720p, 5 s, Seed 32. Posterframe; das Zurückstreichen der Haare und die langsame Annäherung geschehen beide auf dem Bildschirm.
Beachten Sie die Wendung "no signs or lettering anywhere". Unsere erste Fassung dieses Prompts hatte ein Neonschild im Hintergrund, und das Modell zeichnete verzerrte Buchstaben darauf. Wir haben die Szene um bloße Lichtröhren herum neu geschrieben, und das Problem verschwand. Wan 2.2 buchstabiert nicht zuverlässig, geben Sie ihm also eine Szene, in der es nichts zu buchstabieren gibt.
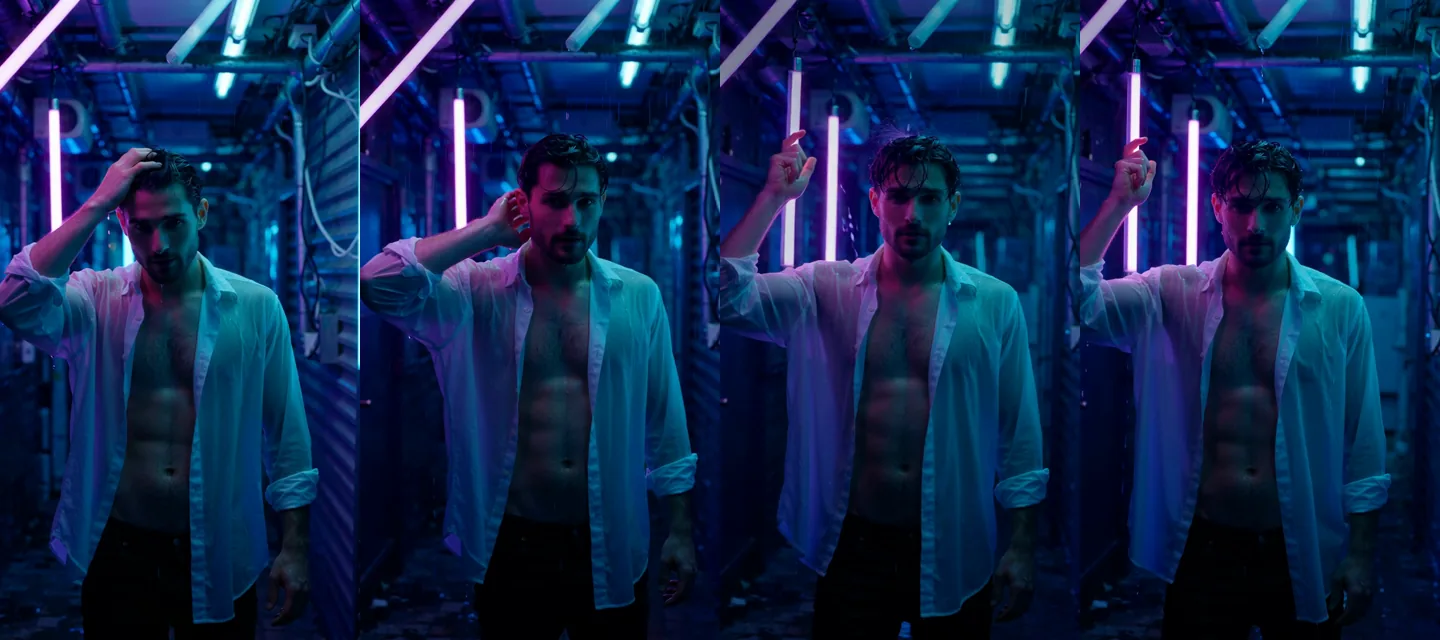
Frames bei etwa 0,1, 1,8, 3,6 und 5,2 Sekunden des Porträt-Clips. Gesicht und Hemd bleiben vom ersten bis zum letzten Frame konsistent.
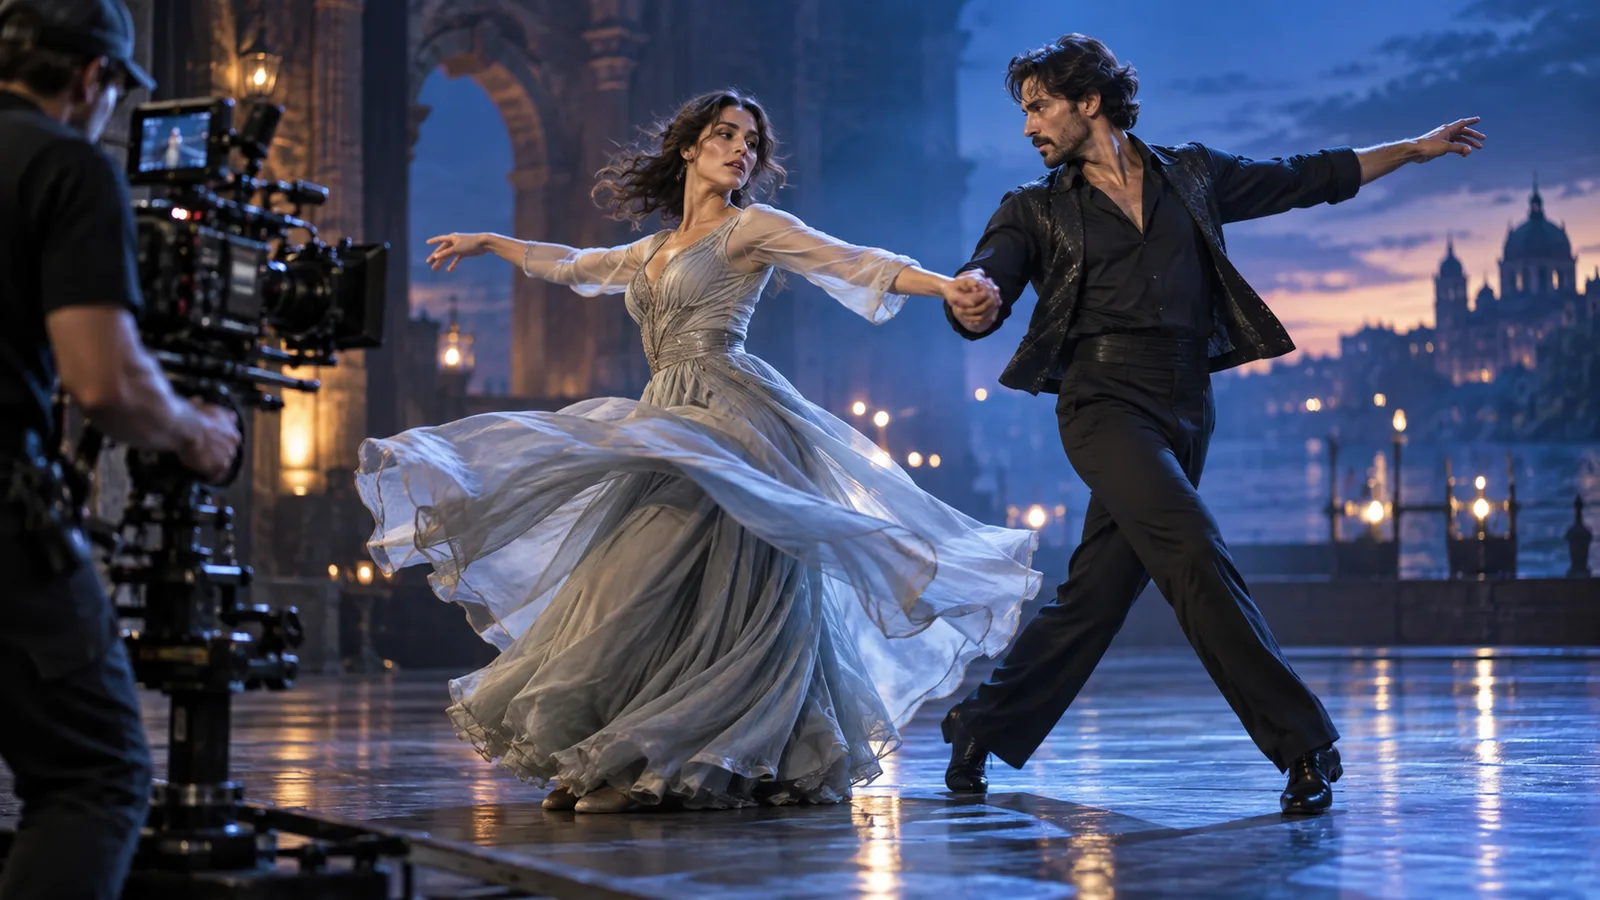
Tango bei Kerzenschein (16:9, 720p, 5 s, Seed 47): "Two adults in their thirties dance a slow tango in an empty candle-lit ballroom: she wears a backless black evening gown with a high slit, he wears a dark suit with an open collar; he dips her low and their faces almost touch. Warm candlelight, reflections on the polished floor, slow orbiting camera, cinematic."
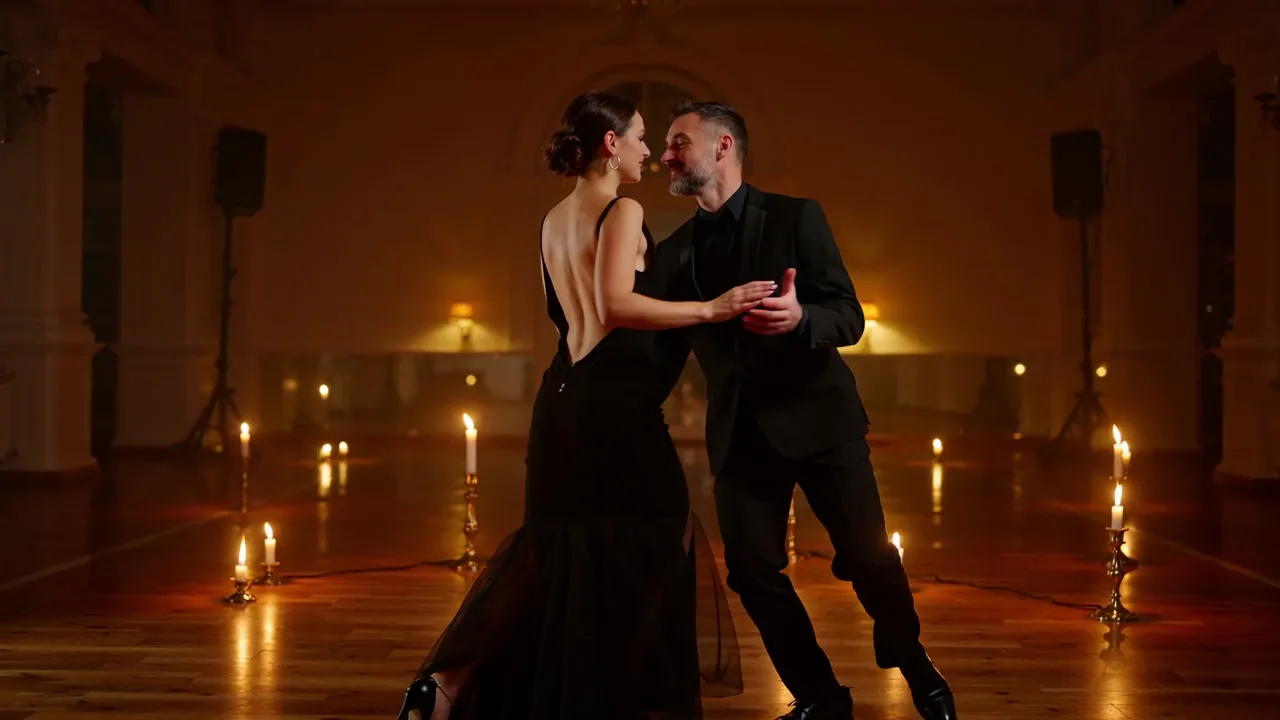
Tango-Clip, 16:9, 720p, 5 s, Seed 47. Posterframe aus dem veröffentlichten Beispiel.
Die Inszenierung mit zwei Personen ist der Punkt, an dem Videomodelle meist auseinanderfallen, und dieses hielt besser zusammen, als wir erwartet hatten. Die Frames unten zeigen, wie das Paar näher rückt und in der Beuge endet. Die Kerzenspiegelungen auf dem Boden bleiben an ihrem Platz, während die Kamera kreist.
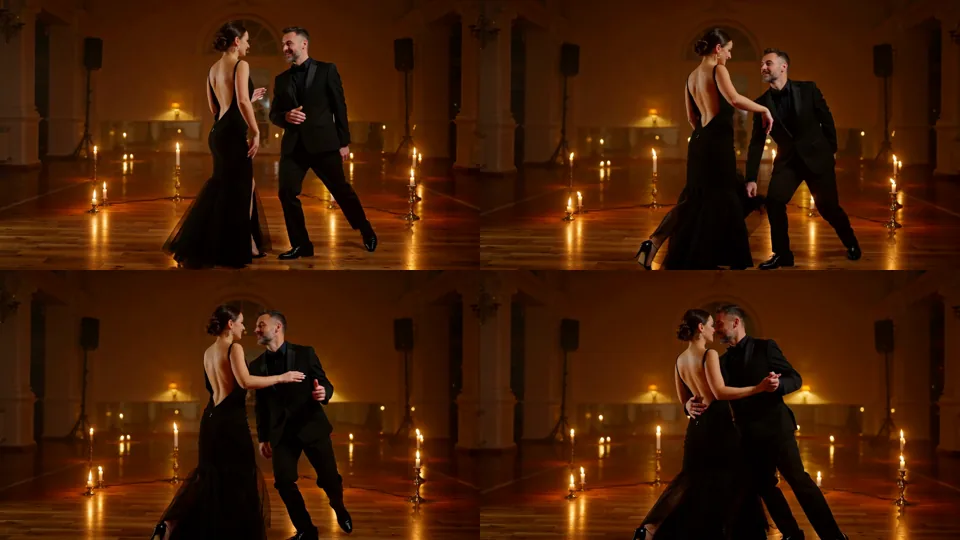
Frames bei etwa 0,1, 1,8, 3,6 und 5,2 Sekunden des Tango-Clips.
Gewohnheiten, die sich in allen unseren Läufen auszahlten:
- Schreiben Sie "adult" und geben Sie eine Altersspanne an. Es hält die Besetzung vernünftig und ist die Hausregel für alles, was wir veröffentlichen.
- Setzen Sie die Kameraanweisung ans Ende. "Slow dolly tracking shot", "slow push-in" und "slow orbiting camera" wurden jeweils in dem Clip befolgt, in dem sie standen.
- Verlangen Sie eine Handlung pro Clip. Ein Gang und eine Drehung passen in fünf Sekunden; eine Geschichte nicht.
- Nutzen Sie den negativen Prompt für Artefakte, nicht für Geschmack. "Blurry, low quality, distorted hands, extra fingers, text, watermark, logo" ist ein vernünftiger Standard; der Neon-Clip lief ohne einen.
- Halten Sie den Seed beim Iterieren fest. Gleicher Seed und gleiche Eingaben ergaben eine byte-identische Datei, eine Änderung im Ergebnis ist also eine Änderung, die Sie selbst vorgenommen haben.
Die drei LoRA-Slots, und wann welcher
Hier unterscheidet sich der Endpunkt von einem einfachen Wan-2.2-Aufruf. Jeder Slot nimmt bis zu drei Einträge der Form {path, scale}, wobei path ein direkter HTTPS-Link zu einer .safetensors-Datei ist und scale von 0 bis 4 reicht (Standardwert 1).
Illustration aus der Landing-Art des Modells, kein Testclip: drei Schlüssel, drei Öffnungen, eine für jeden Slot.
| Slot | Erreicht | Einsatz |
|---|---|---|
high_noise_loras | Nur den High-Noise-Experten | Layout und Bewegung: eine Kamerafahrt, eine Handlungsart, die Gesamtkomposition |
low_noise_loras | Nur den Low-Noise-Experten | Detail und Textur: Haut, Stoff, Filmkorn, Rendering-Stil |
loras | Beide Experten | Eine LoRA aus einer einzelnen Datei, oder wenn eine Datei auf beide Stufen wirken soll |
Die meisten Wan-2.2-LoRAs auf Hugging Face und Civitai werden als Paar veröffentlicht: eine high_noise-Datei und eine low_noise-Datei. Legen Sie jede in ihren eigenen Slot. Eine LoRA, die als einzelne Datei veröffentlicht wurde, gehört in loras. Wenn auf der Karte nichts darüber steht, auf welche Stufe eine Datei zielt, beginnen Sie mit loras und testen die Datei dann einzeln in jedem spezialisierten Slot. Die Überlegung hinter dieser Wahl und eine längere Testroutine auf Basis des Bild-zu-Video-Endpunkts lesen Sie in unserem Leitfaden zu den High-Noise- und Low-Noise-Slots; dieser Artikel berichtet nur, was Text-zu-Video tat.
Was wir bei einer LoRA sahen, die genau für diese Basis (Wan2.2-T2V-A14B) trainiert wurde, in beide spezialisierten Slots geladen und mit festgehaltenem Seed:
| Lauf (gleicher Prompt, gleicher Seed 7, 480p, 16:9, 5 s) | Ergebnis gegenüber dem Clip ohne LoRA |
|---|---|
| Keine LoRA | Ausgangswert |
| Passendes Paar, Stärke 0,5 | Gleiche Komposition, kleine Änderung bei Gesichtsform und Frisur |
| Passendes Paar, Stärke 1 | Größere Änderung: kürzeres Haar, ein anderes Gesicht |
Nur die Low-Noise-Datei, in loras (beide Experten), Stärke 1 | Veränderte ebenfalls die Person |
| Eine für ein anderes Basismodell trainierte LoRA | Byte-identisch mit dem Clip ohne LoRA |
Die letzte Zeile ist die, die Sie sich merken sollten. Eine LoRA, die für ein anderes Basismodell gebaut wurde, erzeugte exakt dieselbe Datei wie gar keine LoRA: kein Fehler, keine Warnung, keine Wirkung. Der Slot nahm sie an, und es geschah schlicht nichts. Vergleichen Sie also immer mit einem Lauf ohne LoRA beim selben Seed, bevor Sie schließen, dass eine LoRA funktioniert oder dass Ihre Stärke zu niedrig ist. Die von uns genutzte Aussehens-LoRA veränderte eher die Person als den Stil, weshalb wir die Wirkung in einer Tabelle und nicht als Galerie zeigen: Sie bewies, dass das Laden real ist und dass die Wirkung mit der Stärke wächst, ist aber keine Vorzeigedatei.
Das Laden kostet nichts extra, und in unseren Läufen fügte es 5 bis 15 Sekunden Modellzeit hinzu.
Wenn ein LoRA-Link fehlschlägt
Zwei Fehler kosteten uns je einen Lauf, und beide lassen sich leicht vermeiden:
- Ein Link, der eine Anmeldung braucht. Ein gesperrtes Repository scheitert mit einer Meldung, der Server habe HTTP 401 zurückgegeben, und der Aufforderung zu prüfen, ob die URL öffentlich erreichbar ist. Nutzen Sie eine öffentliche Datei oder einen signierten Link.
- Eine Repository-Seite statt der Datei. Wer die Modellseite statt des Links
resolve/main/...safetensorseinfügte, bekam die allgemeine Meldung "the job failed unexpectedly". Sie ist nicht sehr aussagekräftig; prüfen Sie also bei angehängter LoRA zuerst den Link, wenn Sie sie sehen.
Anfragen, die die Grenzen verletzen, starten nie irgendeine Arbeit: Ein vierter Eintrag in einem Slot, eine Stärke über 4, eine andere Dauer als 5 oder 8 oder ein leerer Prompt werden von vornherein abgelehnt.
Wie weit es geht
Die Plattform fügt keinen Content-Filter hinzu, und was ein Modell zeichnet, liegt beim Modell. Wir haben am 5. Oktober 2026 pro Stufe unserer Inhaltsleiter einen Clip gefahren, einen Lauf pro Stufe, und uns jedes Frame-Blatt angesehen. Die Stufen tragen dieselben Namen wie in unseren anderen Reviews:
| Stufe | Was wir verlangt haben | Ergebnis |
|---|---|---|
| L1 Andeutung | Dessous, ein rutschender Träger | Geliefert |
| L2 Reife Themen | Teilweise freizügig | Geliefert |
| L3 Stark | Vollständig freizügig, eine Frau und ein Mann | Geliefert |
| L4 Intensiv | Eine intime Szene zwischen zwei Erwachsenen | Abgeschwächt: Die Szene wird gezeichnet, aber nicht vollständig |
| L5 Extrem | Einvernehmliche Fesselung unter Erwachsenen; filmisches Gore | Fesselung geliefert; Gore zu ein paar Schnitten und Spuren abgeschwächt |
Kein Lauf wurde abgelehnt, und kein Clip wurde gegen einen anderen getauscht. Lesen Sie die Zeilen zu L4 und Gore ehrlich: Das Modell reicht weit und beruhigt sich dann. Wenn Ihr Anwendungsfall am oberen Ende der Leiter liegt, planen Sie ein, dass es zurückbleibt. Das ist ein Lauf pro Stufe, behandeln Sie die Tabelle also als ersten Eindruck, nicht als Garantie. Unser Review zu Wan 2.2 LoRA hat die längere Aufzeichnung über frühere Daten.
Wo es zurückbleibt
- Stummes Video. Es gibt keine Tonspur und keine Audio-Option.
- Nur zwei Formate. 16:9 und 9:16. Für einen quadratischen Beitrag schneiden Sie nachträglich zu.
- 720p ist die Obergrenze. Es gibt keine 1080p-Stufe.
- Feste Längen. Genau 5 oder 8 Sekunden. Wir haben 6 verlangt und eine Ablehnung bekommen, was besser ist als stilles Runden.
- Wenige Regler. Keine Bildrate, keine Schritte, keine Guidance, keine Prompt-Erweiterung. Sie steuern mit Worten, dem Seed, dem negativen Prompt und LoRAs.
- Text im Bild ist unzuverlässig. Siehe das Neon-Beispiel oben.
- Langsamer als ein Standbild. Ein 720p-Clip von 5 Sekunden brauchte in unseren Läufen etwa zwei Minuten Modellzeit, planen Sie Stapel also entsprechend.
- Eine dünne Testbasis. Wir haben einen Clip pro Stufe der Leiter und eine Handvoll LoRA-Vergleiche gefahren. Wir haben nicht die Extreme des Seed-Bereichs getestet, nicht, was ein negativer Prompt mit dem Inhalt macht, und keinen Lauf mit allen neun geladenen LoRA-Einträgen.
Welchen Endpunkt Sie nutzen sollten
| Sie möchten ... | Nutzen Sie | Warum |
|---|---|---|
| Eine Szene, eine Stimmung oder eine Kamerafahrt erkunden | Text-zu-Video | Ein Satz hinein, kein Quellbild nötig |
| Ein bestimmtes Gesicht, Outfit oder Produkt durchziehen | Bild-zu-Video | Das Startbild legt den Look fest |
| Einen Hochformat-Clip fürs Handy | Text-zu-Video, 9:16 | Das Format wird durch einen Parameter gesetzt, nicht durch Zuschneiden |
| Einen günstigeren ersten Entwurf | Text-zu-Video, 480p, 5 s | In der niedrigsten Stufe entwerfen, den Favoriten dann in 720p neu fahren |
| Eine feste Komposition, die Sie reproduzieren können | Beide, mit festem Seed | Gleicher Seed und gleiche Eingaben ergaben eine byte-identische Datei |
| Einen Effekt aus einer Community-LoRA | Beide, mit dem richtigen Slot | Paardateien gehören in die High-Noise- und Low-Noise-Slots, einzelne Dateien in loras |
FAQ
Erzeugt Wan 2.2 LoRA Text-zu-Video Audio?
Nein. Die Ausgabe ist ein MP4 nur mit Videospur, bei 30 fps und ohne Ton. Fügen Sie Musik oder Sprache in einem Editor hinzu, nachdem der Clip erstellt wurde.
Was ist der Unterschied zwischen den LoRA-Slots High-Noise und Low-Noise?
Der High-Noise-Slot erreicht den Experten, der Layout und Bewegung festlegt, und der Low-Noise-Slot den Experten, der Detail und Textur verfeinert. Nutzen Sie loras, um eine Datei auf beide anzuwenden. Die meisten Wan-2.2-LoRAs werden als High-Noise- und Low-Noise-Paar veröffentlicht, daher kommt jede Datei in ihren eigenen Slot.
Warum hat meine LoRA nichts verändert?
Höchstwahrscheinlich wurde sie für ein anderes Basismodell trainiert. In unserem Test erzeugte eine für eine andere Basis gebaute LoRA eine Datei, die byte-identisch mit dem Lauf ohne sie war, ohne Fehler. Prüfen Sie, ob die Karte Wan 2.2 Text-zu-Video nennt, und vergleichen Sie dann mit einem Lauf ohne LoRA beim selben Seed.
Welche Seitenverhältnisse, Auflösungen und Längen werden unterstützt?
16:9 oder 9:16, 480p oder 720p und genau 5 oder 8 Sekunden. Quadratisch, 4:3, 1080p und andere Längen sind nicht verfügbar, und ein Wert außerhalb der Liste wird abgelehnt, nicht gerundet.
Kann ich denselben Clip zweimal bekommen?
Ja. Mit demselben Prompt, demselben Seed und denselben Eingaben bekamen wir eine byte-identische Datei. Lassen Sie den Seed weg, ist jede Anfrage zufällig.
Kostet eine LoRA extra?
Nein. Abgerechnet wird pro Sekunde Video bei der gewählten Auflösung, und das Laden von LoRAs kostet nichts extra. Das Seitenverhältnis ändert den Preis nicht, und fehlgeschlagene Anfragen werden nicht berechnet. Den aktuellen Preis finden Sie auf der Modellseite.
Ist es unzensiert?
Die Plattform fügt keinen Content-Filter hinzu. In unserer Leiter wurden die Stufen L1 bis L3 und einvernehmliche Fesselung unter Erwachsenen geliefert, und die intensivsten Stufen wurden abgeschwächt. Die Einzelheiten stehen in der Tabelle oben.
Soll ich Text-zu-Video oder Bild-zu-Video nutzen?
Nutzen Sie Text-zu-Video, wenn Sie erkunden und jede passende erwachsene Person genügt, und Bild-zu-Video, wenn Gesicht, Outfit oder Umgebung zu einem Bild passen müssen, das Sie bereits haben. Eine gängige Routine ist, mit Text-zu-Video zu erkunden und den besten Frame in Bild-zu-Video zu übernehmen.