W Z-Image Base LoRA używaj LoRA wytrenowanych na Z-Image Base: LoRA wytrenowana pod Z-Image Turbo rozbiła obraz na szum i pseudotekst, gdy wczytaliśmy ją na Base 5 października 2026. Base to wolniejszy, niedestylowany model, na którym trenuje społeczność, więc mediana czasu dla tekstu na obraz wyniosła w naszych 36 przebiegach 32,8 sekundy. W edycji domyślny strength to 0.7, a około 0.6 ze stylową LoRA przestylizowało cały kadr, zachowując kompozycję co do joty.
Z-Image Base LoRA uruchamia Z-Image Base od Tongyi-MAI z Alibaby, jednostrumieniowy transformer dyfuzyjny o 6 miliardach parametrów, z maksymalnie trzema własnymi LoRA zarówno w tekście na obraz, jak i w obrazie na obraz. Karta modelu nazywa Base fundamentem rodziny Z-Image, zbudowanym pod rozwój i idealnym punktem wyjścia dla społeczności; obsługuje trenowanie LoRA, bo nie jest destylowany. Endpointy są bez cenzury: platforma nie dodaje żadnego filtra treści. Jedno uczciwe ograniczenie na początek: sam model bazowy słabo rysuje najbardziej intymne sceny, i właśnie do tego służą LoRA dla dorosłych. Każdy prompt w tym poradniku to codzienna scena z ubranymi dorosłymi.
W skrócie
| Pytanie | Odpowiedź (test z 5 października 2026) |
|---|---|
| Model | Z-Image Base od Tongyi-MAI (Alibaba), 6 miliardów parametrów |
| Nazwy modeli w API | alibaba/z-image-base-lora/text-to-image i alibaba/z-image-base-lora/edit |
| Pole LoRA | loras: do 3 wpisów, każdy {path, scale}, scale od 0 do 4 |
| Właściwe LoRA | Pliki wytrenowane na Z-Image Base |
| Niewłaściwe LoRA | Wytrenowane pod Turbo: zepsuły obraz. Pony lub inaczej zapisane pliki: bez błędu, bez zmian |
| Strength w edycji | Od 0 do 1, domyślnie 0.7 |
| Rozmiary tekst-na-obraz | Dziewięć proporcji obrazu, każdy bok do 1536 |
| Rozmiary edycji | resolution 1k lub 1.5k ustala dłuższy bok; proporcje źródła są zachowane |
| Szybkość w naszych testach | Tekst na obraz 9,8 do 56,7 s, mediana 32,8 (36 przebiegów); edycja 4,9 do 41,7 s, mediana 16,8 (28 przebiegów) |
| Niedostępne | Kroki, guidance i prompt negatywny |
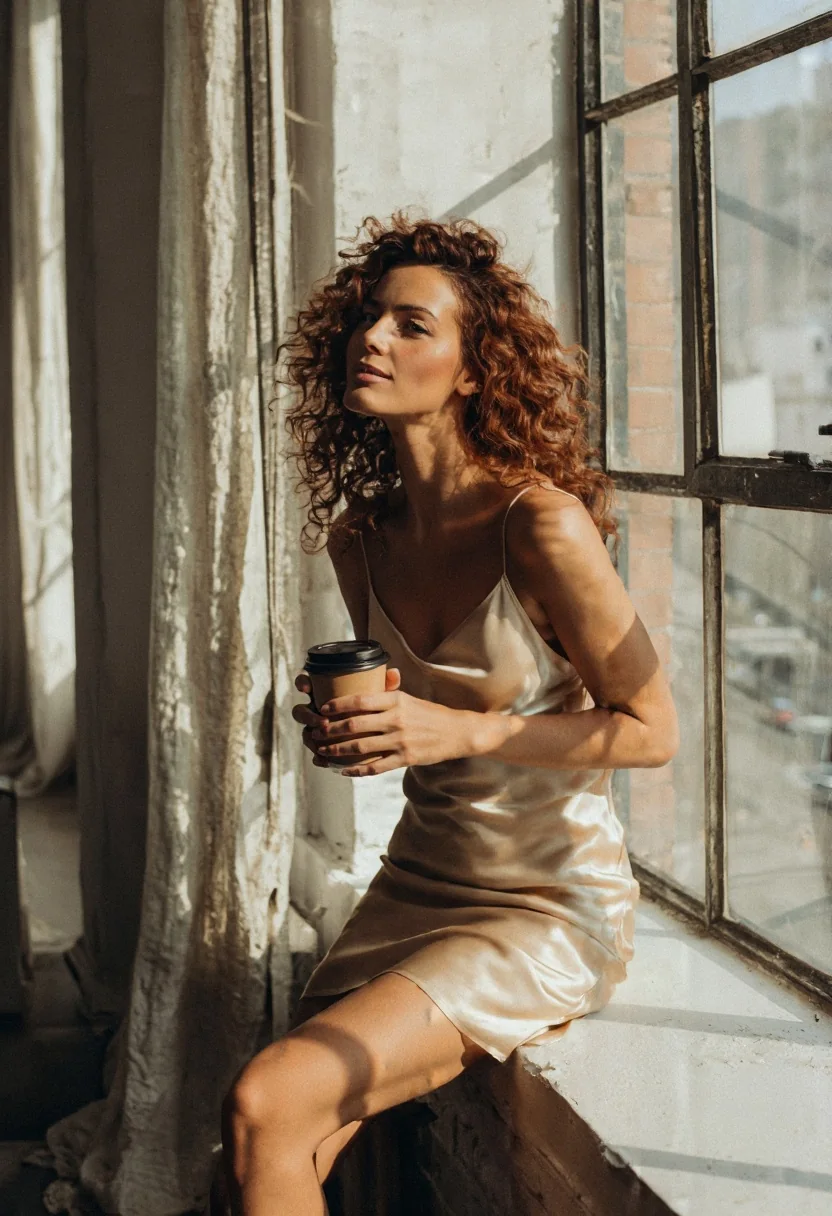
Z-Image Base LoRA, tekst na obraz, 2:3 (832×1216), seed 41, bez LoRA. Prompt jest podany w następnej sekcji.
Prompty: zwykłe zdania, silne trzymanie się opisu
Trzymanie się promptu na Base było w naszych testach mocne. Pisz tak, jak briefowałbyś fotografa: postać, ubranie, miejsce, światło, ziarno. Portret w lofcie powyżej powstał z jednego zdania:
A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.Ten sam kształt zdania, z podmienionym tylko tematem, dał boksera w starej siłowni:
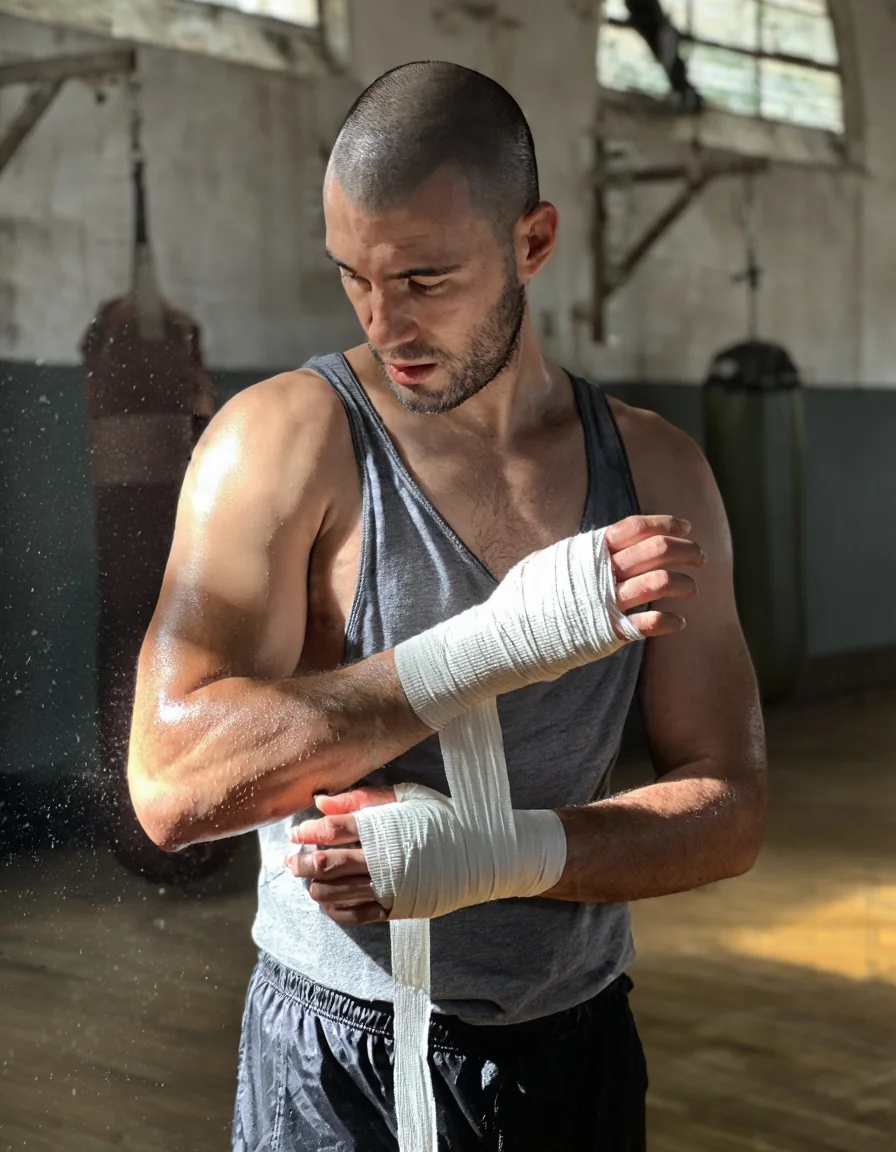
Z-Image Base LoRA, tekst na obraz, 3:4 (896×1152), seed 42, bez LoRA.
Nie ma pola promptu negatywnego, guidance ani kroków. Wydawca zaleca dla samego modelu guidance 3.0 do 5.0 i 28 do 50 kroków, ale ten endpoint nie udostępnia żadnego z nich, więc ton i styl pochodzą z promptu i z LoRA.
Które LoRA działają na Base
Na to pytanie ta rodzina ma odpowiadać, więc wypróbowaliśmy cztery rodzaje plików:
| LoRA | Wytrenowana pod | Co się stało |
|---|---|---|
mikkoph/mikkoani-z-image | Z-Image Base | Działała przy 0.5 i przy 1 |
| LoRA do Z-Image Turbo | Z-Image Turbo | Wczytała się bez błędu i zepsuła obraz (szum i pseudotekst) |
furaidosu/flat-cartoon-zimage, opisana jako do Z-Image | Inny format kluczy | Wczytała się bez błędu, wynik identyczny co do piksela: bez zmian |
| LoRA do Pony | Pony SDXL | Wczytała się bez błędu, wynik identyczny co do piksela: bez zmian |
Dwie porażki są ciche, a jedna wygląda głośno. Źle opisany plik albo plik z innego modelu bazowego niczego nie zmienia, więc możesz godzinę obwiniać własny prompt; plik Turbo na Base robi bałagan, co przynajmniej mówi, że coś jest nie tak. Zanim zbudujesz coś na adapterze, uruchom jedną parę z plikiem i jedną bez, z tym samym seedem. Jeśli się zgadzają, plik tu nic nie robi; jeśli wynik to szum, został wytrenowany pod Turbo.
Hugging Face wylicza adaptery, których modelem bazowym jest Tongyi-MAI/Z-Image. Pobraliśmy tylko 40 najczęściej pobieranych: głównie LoRA z podobizną prawdziwych osób oraz kilka LoRA stylu. Nie liczyliśmy całej listy, więc nie podajemy liczby.
Lista kontrolna przed wyborem LoRA:
- Model bazowy: karta mówi Z-Image Base albo Tongyi-MAI/Z-Image, a nie Turbo, Pony ani FLUX.
- Plik, do którego da się dać link: repozytorium zawiera plik
.safetensorsi można zbudować linkresolve/main/. - Publiczny dostęp: zablokowany plik kończy się komunikatem HTTP 401.
- Fraza wyzwalająca: skopiuj ją dokładnie z karty.
- Licencja: przeczytaj tę z karty samej LoRA.
LoRA mikkoani: jedna fraza, inny wygląd
LoRA mikkoani włącza się swoją frazą, mature illustration with muted color and complex linework, na początku promptu. Oto scena w sali balowej z tą LoRA przy scale 1:
{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "prompt": "mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.",
  "aspect_ratio": "16:9",
  "seed": 43,
  "loras": [
    {
      "path": "https://huggingface.co/mikkoph/mikkoani-z-image/resolve/main/z-image-mikkoani-v2.safetensors",
      "scale": 1
    }
  ]
}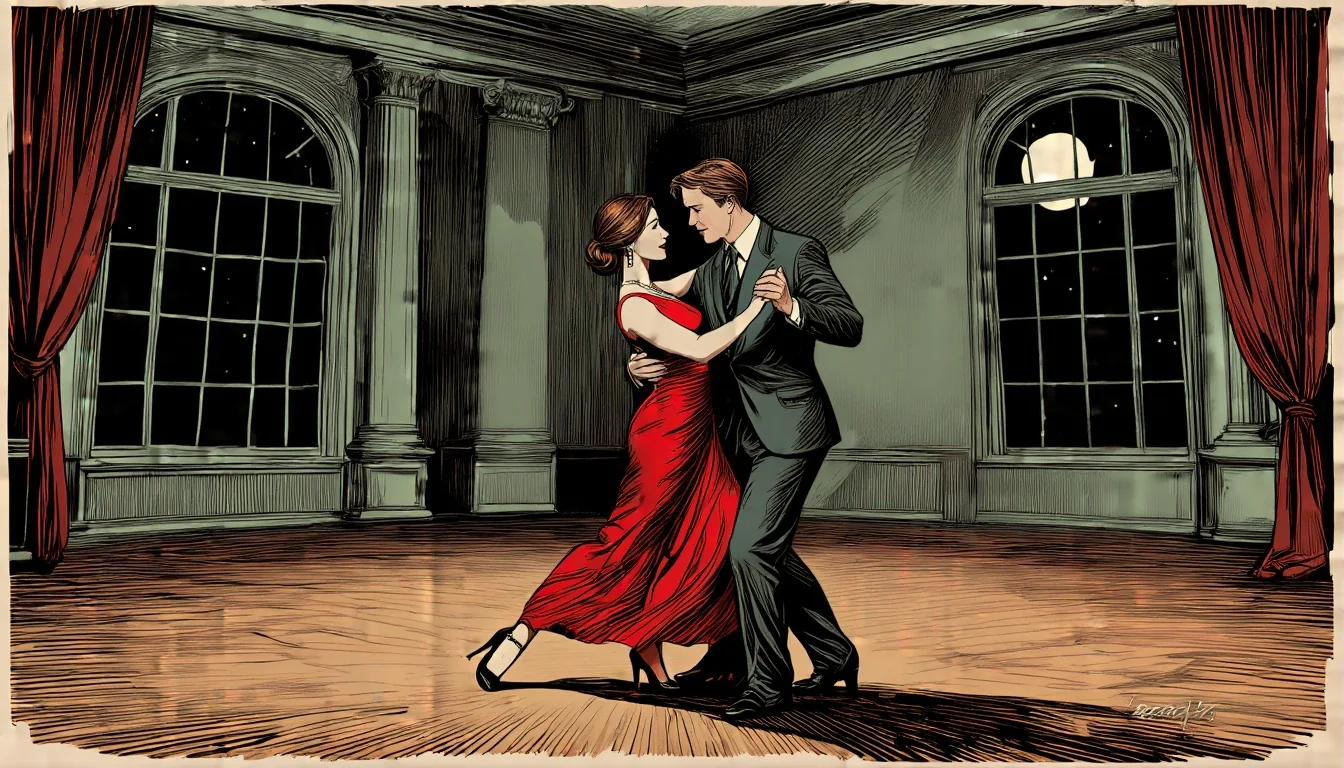
Z-Image Base LoRA, tekst na obraz, 16:9 (1344×768), seed 43, LoRA mikkoani przy scale 1.
Jeszcze jedno spostrzeżenie, które warto znać: sama fraza, bez LoRA, już skierowała prompt fotograficzny w stronę ilustracji. Base mocno trzyma się sformułowań, więc fraza wyzwalająca może przenieść część stylu nawet wtedy, gdy plik się nie wczyta. To sprawia, że para z plikiem i bez jest odrobinę mniej oczywista: porównuj jakość kreski i paletę, a nie tylko gatunek.
Strength w edycji: drabinka
Endpoint edycji przyjmuje jeden obraz źródłowy, strength od 0 do 1 i to samo pole loras. Nasz publiczny default to 0.7; default upstreamu to 0.6. Przeszliśmy drabinkę na zdjęciu bez LoRA:
| Strength | Co zobaczyliśmy |
|---|---|
| 0.3 i 0.5 | Prawie bez zmian |
| 0.6 | Niewielka zmiana |
| 0.7 | Treść zaczyna się zmieniać; kompozycja zachowana |
| 0.75 | Scena jest ustawiona i zainscenizowana od nowa, światło i paleta zachowane |
| 0.85 | Nowy obraz |
Ze stylową LoRA obraz się zmienia: przy 0.6 przestylizowała cały kadr i zachowała kompozycję co do joty. To optimum do zamiany zdjęcia w ilustrację.
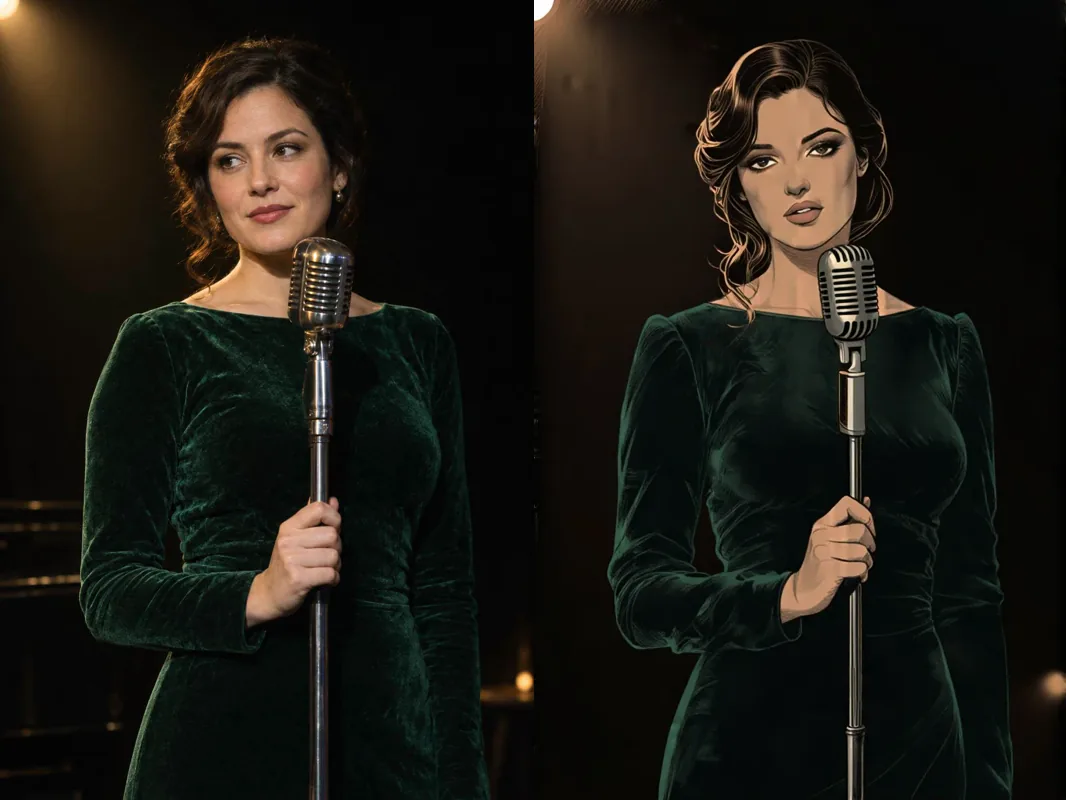
Po lewej: nasze wygenerowane zdjęcie źródłowe. Po prawej: Z-Image Base LoRA, obraz na obraz, 1k, seed 51, LoRA mikkoani przy scale 1, strength 0.6.
Prompt edycji opisuje cały obraz, który chcesz uzyskać, a nie tylko zmianę:
mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.Drugie źródło, mężczyzna na dachu o zachodzie słońca w rozpiętej białej lnianej koszuli, przy tym samym strength:
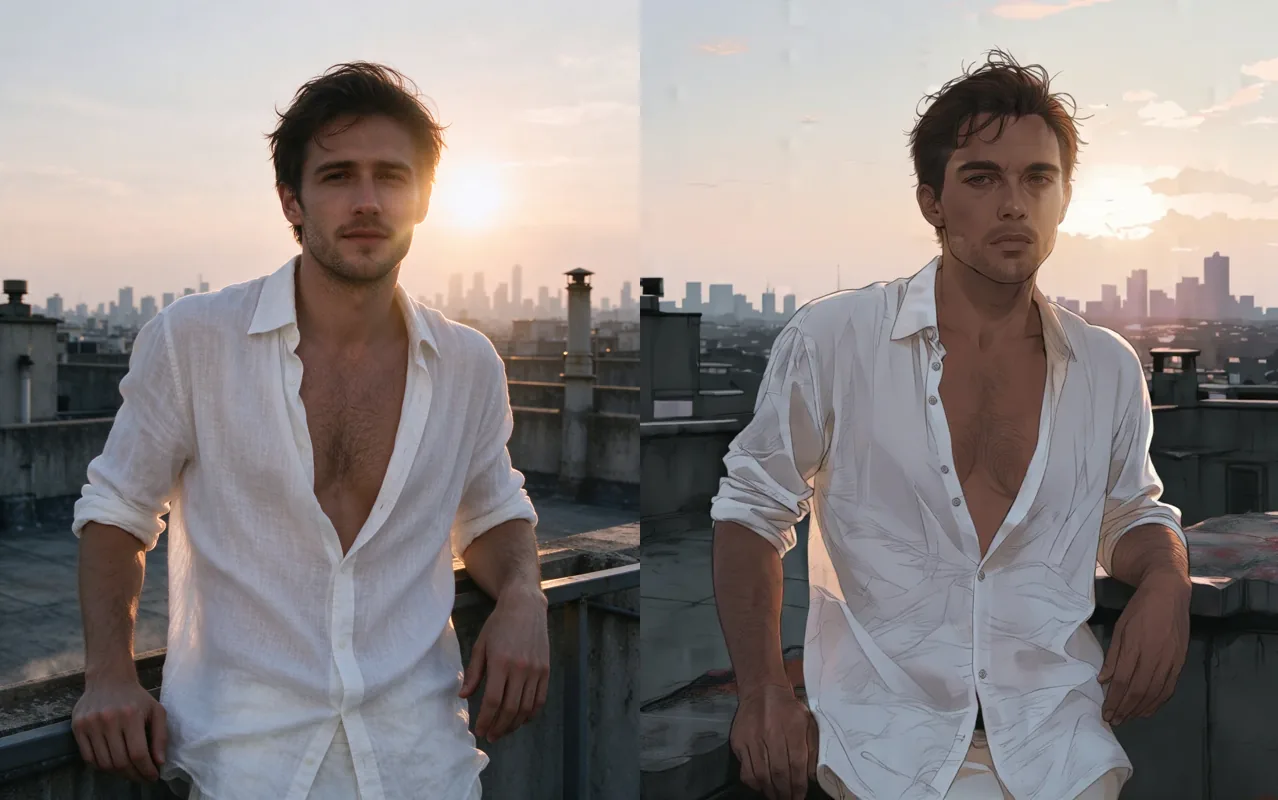
Po lewej: nasze wygenerowane zdjęcie źródłowe. Po prawej: Z-Image Base LoRA, obraz na obraz, 1k, seed 54, LoRA mikkoani przy scale 1, strength 0.6.
I szerokie źródło przy 1.5k i strength 0.65:
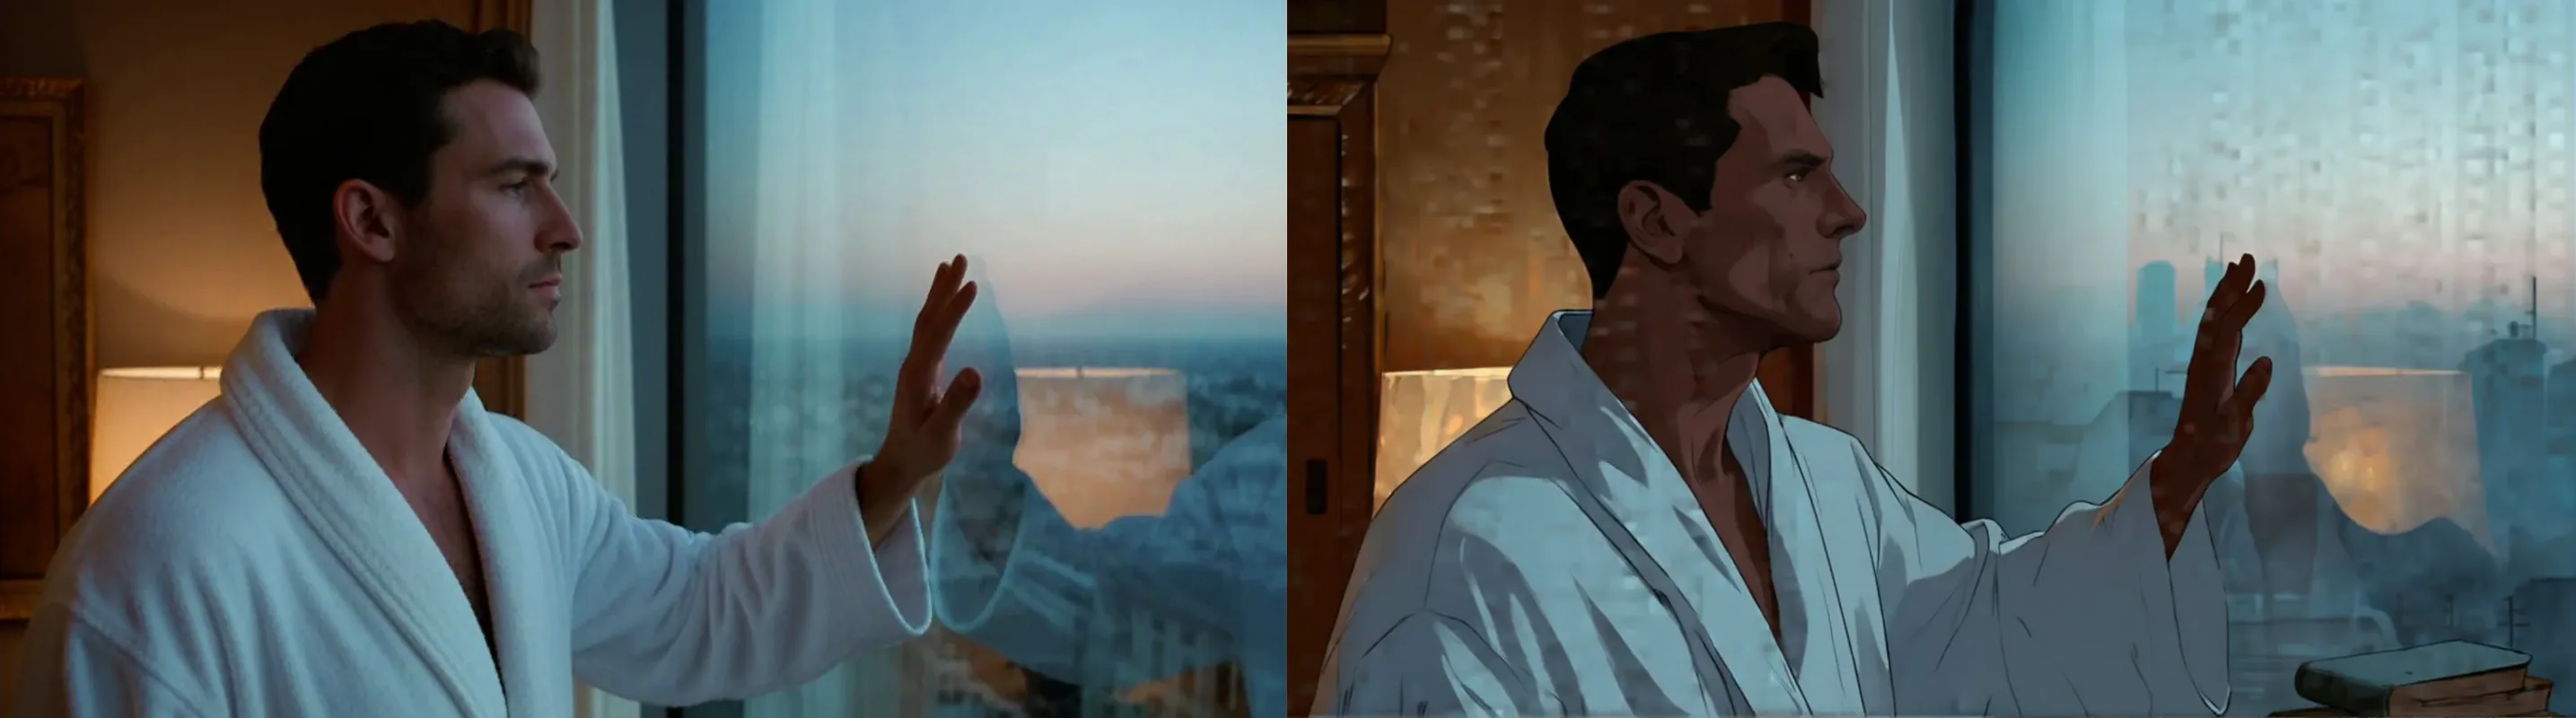
Po lewej: nasze wygenerowane zdjęcie źródłowe. Po prawej: Z-Image Base LoRA, obraz na obraz, 1.5k, seed 55, LoRA mikkoani przy scale 1, strength 0.65.
Przestylizowuje, ale nie wykonuje poleceń
Bez LoRA „zrób to czarno-białe” pozostało kolorowe przy strength 0.65 i 0.8, a „ubierz go w smoking” niewiele zmieniło przy 0.7 i 0.8. Model przerysowuje kadr na podstawie twojego opisu. Do zmiany medium weź LoRA stylu; do innej sceny opisz ją w całości i podnieś strength. Szczegóły są na stronie edycji.
Rozmiary
Tekst na obraz oferuje dziewięć proporcji obrazu na natywnych rozmiarach SDXL i wszystkie dziewięć zakończyło się dokładnie zażądanym rozmiarem:
| Proporcje | Rozmiar | Proporcje | Rozmiar |
|---|---|---|---|
| 1:1 | 1024×1024 | 3:2 | 1216×832 |
| 16:9 | 1344×768 | 2:3 | 832×1216 |
| 9:16 | 768×1344 | 21:9 | 1536×640 |
| 4:3 | 1152×896 | 9:21 | 640×1536 |
| 3:4 | 896×1152 |
Upstream przyjmuje od 256 do 1536 na bok: 1536×1536 i 256×256 zakończyły się powodzeniem, a 1600×896, 2048×2048 i 200×200 padły z błędem ograniczenia rozmiaru. W edycji resolution ustala tylko dłuższy bok, a proporcje źródła są zachowane: zdjęcie 2:3 przy 1k wróciło jako 680×1024, a zdjęcie 16:9 przy 1.5k jako 1536×856.
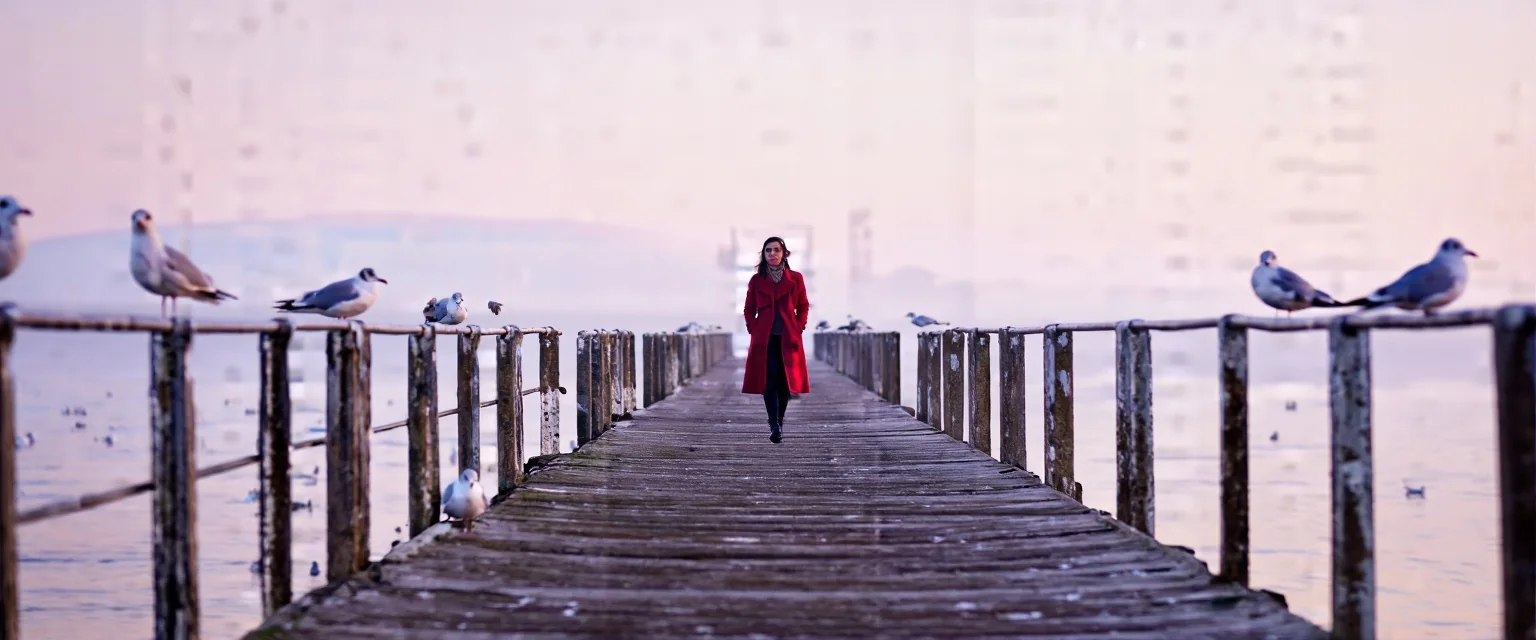
Z-Image Base LoRA, tekst na obraz, 21:9 (1536×640), seed 45, bez LoRA.
Ten sam szeroki kształt pasuje do scen ulicznych:
Z-Image Base LoRA, tekst na obraz, 21:9, bez LoRA.
Co łagodnieje
Przed modelem nie stoi żaden filtr treści. W naszej drabinie, z dorosłymi zaznaczonymi w każdym prompcie, tekst na obraz dostarczył zgodnie z opisem L1 Sugestywny (bielizna, zsuwające się ramiączko), L2 Dojrzałe motywy, L3 Mocny, L5 Ekstremalny (dobrowolne skrępowanie między dorosłymi albo filmowy gore) oraz męską wersję L3. L4 Intensywny (intymna scena między dwojgiem dorosłych) wrócił złagodzony w trzech próbach: seedy dały postacie i trochę kontaktu, ale żadnej spójnej sceny. Obraz na obraz na ubranym źródle zachowywał się tak samo: niższe poziomy zostały dostarczone, L3 od strength 0.8 w górę (0.7 było częściowe), a L4 złagodzony.
Uczciwe podsumowanie jest więc takie, że sam Base słabo rysuje ten najwyższy poziom. Zamierzoną drogą są LoRA wytrenowane pod niego, z tą samą regułą „tylko Base”, co wyżej. Nie testowaliśmy obrazu na obraz z trzema LoRA ani LoRA z linków Civitai.
Z-Image Base LoRA czy Z-Image Turbo LoRA
Porównanie obu modeli według samego wydawcy:
| Z-Image (Base) | Z-Image Turbo | |
|---|---|---|
| Kroki | 28 do 50 | 8 |
| CFG | tak | nie |
| Możliwość dostrajania | tak | nie |
| Prompt negatywny | tak (ten endpoint go nie udostępnia) | nie |
| Różnorodność | Wysoka | Niska |
| Jakość wizualna | Wysoka | Bardzo wysoka |
Z-Image Turbo LoRA to destylowany model 8-krokowy z maksymalnie trzema LoRA wytrenowanymi pod Turbo, około megapiksela w dziewięciu proporcjach, a jego domyślny strength w obrazie na obraz to 0.8. Jak zachowuje się adapter Turbo, zobacz w naszym teście Turbo LoRA na tym samym seedzie. Obie rodziny nie dzielą LoRA. Plik Turbo na Base zepsuł obraz w naszym teście; odwrotnego kierunku nie testowaliśmy, więc nie zakładaj, że plik Base jest bezpieczny na Turbo.
| Czego chcesz | Wybierz |
|---|---|
| LoRA wytrenowanej na Z-Image Base | Z-Image Base LoRA |
| LoRA wytrenowanej na Z-Image Turbo | Z-Image Turbo LoRA |
| Najszybszej odpowiedzi, w sekundach | Turbo; Base potrzebował mediany 32,8 s dla tekstu na obraz |
| Zdjęcia w ilustrację z LoRA stylu | Edycja Base przy strength około 0.6, z LoRA stylu wytrenowaną na Base |
| Zwykłych promptów z silnym trzymaniem się opisu, bez LoRA | Oba; Base ściśle trzymał się sformułowań w naszych testach |
| Kontroli nad krokami, guidance lub promptem negatywnym | Żaden endpoint ich nie udostępnia |
Z-Image Base LoRA, tekst na obraz, bez LoRA, filmowy prompt portretowy z naszego zestawu okładek.
FAQ
Czy mogę użyć LoRA do Z-Image Turbo na Base?
Nie. W naszym teście LoRA wytrenowana pod Turbo wczytała się na Base bez błędu i rozbiła obraz na szum i pseudotekst. Używaj plików wytrenowanych na Z-Image Base.
Dlaczego moja LoRA do Z-Image niczego nie zmieniła?
Prawdopodobnie została zapisana w innym formacie kluczy albo wytrenowana pod inny model. Plik opisany jako do Z-Image, ale zapisany inaczej, oraz LoRA do Pony wczytały się i dały wynik identyczny co do piksela. Uruchom parę z plikiem i bez.
Jakiego strength użyć w edycji?
Zacznij od domyślnego 0.7 albo około 0.6 ze stylową LoRA, by zachować kompozycję. W naszej drabince 0.3 i 0.5 ledwo zmieniły zdjęcie, 0.75 zainscenizowało scenę od nowa, a 0.85 dało nowy obraz.
Czy wykona polecenia typu „zrób to czarno-białe”?
Nie. Bez LoRA czarno-białe pozostało kolorowe przy 0.65 i 0.8, a prośba o smoking niewiele zmieniła. Model przerysowuje na podstawie twojego opisu, więc wygląd załatw LoRA stylu.
Jakich rozmiarów mogę użyć?
Dziewięciu proporcji obrazu w tekście na obraz, do 1536 na bok, oraz 1k lub 1.5k dla dłuższego boku w edycjach. Żądanie 200×200 lub 2048×2048 zakończyło się w naszych testach niepowodzeniem.
Jak wolny jest Base?
Tekst na obraz trwał od 9,8 do 56,7 sekundy, z medianą 32,8 w 36 przebiegach. Edycje trwały od 4,9 do 41,7 sekundy, z medianą 16,8 w 28 przebiegach.
Czy Base rysuje najbardziej intymne sceny?
Sam nie przekonująco. W trzech próbach ten poziom wrócił złagodzony, podczas gdy niższe poziomy wyrenderowały się zgodnie z opisem. Dalej dojdziesz z LoRA wytrenowanymi pod niego.
Czy mogę ustawić kroki, guidance lub prompt negatywny?
Nie. Endpoint nie ma takich pól, chociaż wydawca zaleca dla modelu 28 do 50 kroków.