Vai al contenuto principale

Immagine in immagine su Z-Image Base, il modello da 6 miliardi di parametri di Alibaba Tongyi-MAI, con fino a tre LoRA tuoi e un controllo della strength. Entra un’immagine sorgente, esce lo stesso formato con lato lungo da 1k o 1.5k, e nessun filtro su prompt, pesi o risultati.

Da $0.014/immagine

Playground

Input

Editing di immagini
300/5000
Descrivi l’intera immagine che vuoi ottenere, non solo il cambiamento. Metti per prima la frase trigger di un LoRA. Fino a 5.000 caratteri. almeno 1 caratteri · al massimo 5000 caratteri
1/1

Trascina file o link ai media, incolla oppure sfoglia · 1 file · Max 10 MB · JPG · PNG · WEBP · GIF

  • 1
1 / 1 file
L’immagine da ridisegnare. Il risultato ne mantiene le proporzioni; il livello di risoluzione stabilisce il lato lungo.
1k restituisce un lato lungo di 1.024 pixel ed è il valore predefinito; 1.5k ne restituisce 1.536. Costano uguale e le proporzioni seguono sempre la sorgente.
Intensità della trasformazione
Quanto allontanarsi dalla sorgente, da 0 a 1; di default 0,7. Con un LoRA di stile, 0,6 mantiene la composizione; intorno a 0,75 posa e ambientazione vengono ridisegnate; da 0,85 è un’immagine nuova. non meno di 0 · non più di 1
LoRA di stile1/3

Mikkoani

Fino a tre voci {path, scale} addestrate su Z-Image Base; scale da 0 a 4, 1 è neutro. Qui è soprattutto un LoRA di stile a fare il cambio di aspetto. al massimo 3 elementi
Formato di output
JPEGPNGWebP
JPEG di default, oppure PNG o WebP. Il formato non cambia il prezzo.
Seed
Mantiene confrontabili i risultati mentre regoli la strength. Non garantisce gli stessi identici pixel a ogni esecuzione. non meno di 0 · non più di 2147483647
Controllo di sicurezzaDisattivato

SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

Controllo del tuo account prima di abilitare invio e prezzi.

Output

Pronto per una nuova esecuzione
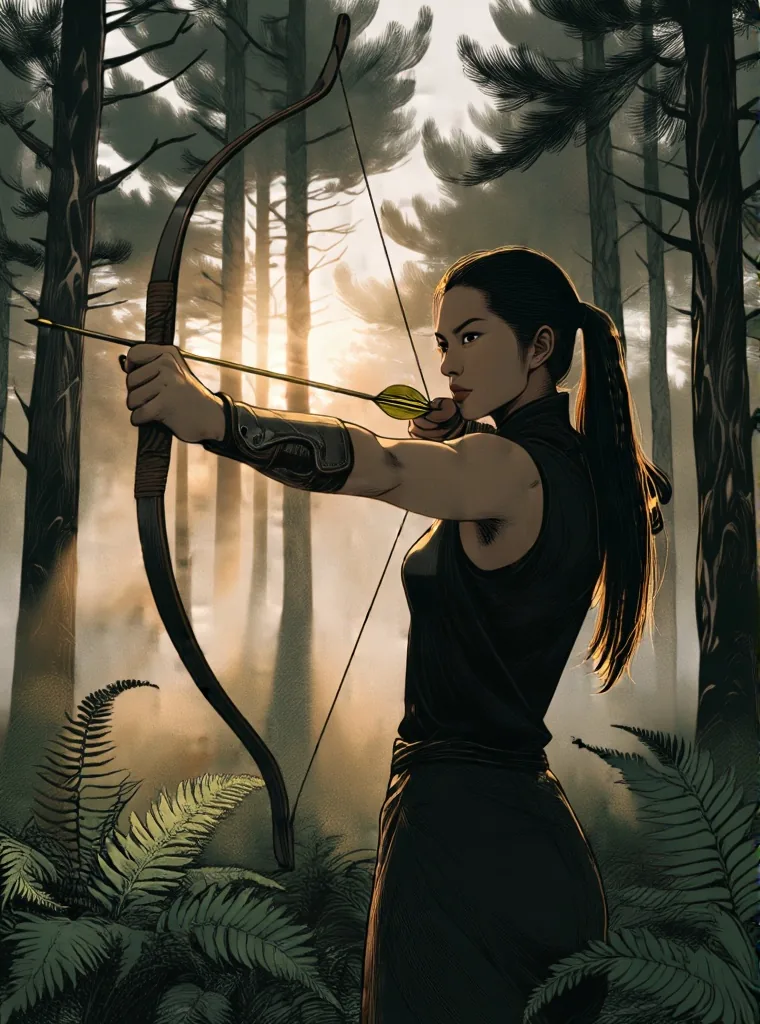
archery-forest-to-inkRisultato di esempio

Modelli correlati e attività successive

Manca il modello che ti serve?

Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

Usa le LoRA fatte per Z-Image Base e ridisegna le foto con un cursore di strength

Z-Image Base LoRA esegue Z-Image Base, il modello di fondazione da 6 miliardi di parametri di Tongyi-MAI di Alibaba, con fino a tre LoRA da testo a immagine e da immagine a immagine. Base è il modello non distillato su cui si addestra la community, quindi è più lento di Turbo: da testo a immagine ha richiesto da 9,8 a 56,7 secondi con una mediana di 32,8, e le modifiche da 4,9 a 41,7 con una mediana di 16,8. Niente filtra il prompt né l’immagine, anche se il solo modello base disegna male il livello Molto forte del nostro test sui contenuti e per queste esistono apposite LoRA.

Apri il Playground
Usa le LoRA fatte per Z-Image Base e ridisegna le foto con un cursore di strength
LoRA per richiesta
Fino a 3, ciascuna {path, scale}; il file deve essere addestrato su Z-Image Base, non su Turbo
Strength di modifica
Da 0 a 1, predefinito 0.7; intorno a 0.6 ha ridisegnato lo stile con una LoRA, 0.75 ha rimesso in scena la composizione
Dimensioni
9 proporzioni fino a 1536 per lato; le modifiche accettano 1k o 1.5k sul lato lungo e mantengono la proporzione della sorgente
Velocità
Da testo a immagine mediana 32,8 secondi in 36 prove; modifica mediana 16,8 secondi in 28 prove
Fatturazione
Per immagine a una tariffa fissa; dimensioni, immagine sorgente e numero di LoRA non la cambiano
Non disponibili
Passi, guidance e prompt negativo; l’endpoint non ha questi campi
Base giusta
Una LoRA del modello sbagliato fallisce senza erroriUna LoRA addestrata su Z-Image Turbo, caricata su Base, ha ridotto l’immagine a rumore e pseudo-testo. Una LoRA Pony e un file etichettato Z-Image salvato in un altro formato di chiavi si sono caricati entrambi e non hanno cambiato nulla. Usa file addestrati su Base e fai prima una coppia con e senza.
Limiti di modifica
Le modifiche ridisegnano l’inquadratura e non seguono istruzioniSenza LoRA, chiedere il bianco e nero con strength 0.65 e 0.8 è rimasto a colori, e chiedere uno smoking con 0.7 e 0.8 ha cambiato poco. Descrivi l’intera immagine che vuoi e porta una LoRA di stile quando vuoi che l’aspetto cambi.
Limite onesto
Un solo livello di contenuto esce attenuatoNessun filtro dei contenuti sta davanti al modello e su entrambi gli endpoint, il nostro test sui contenuti a cinque livelli ha reso tutti i livelli tranne Molto forte, incluso Massimo. Molto forte è tornato attenuato in tre tentativi: il modello base da solo non lo disegna in modo convincente, ed è a questo che servono le LoRA addestrate per questo.

Lavorare con Z-Image Base LoRA

Scrivi i prompt fotografici come semplici frasi

Scrivi i prompt fotografici come semplici frasi

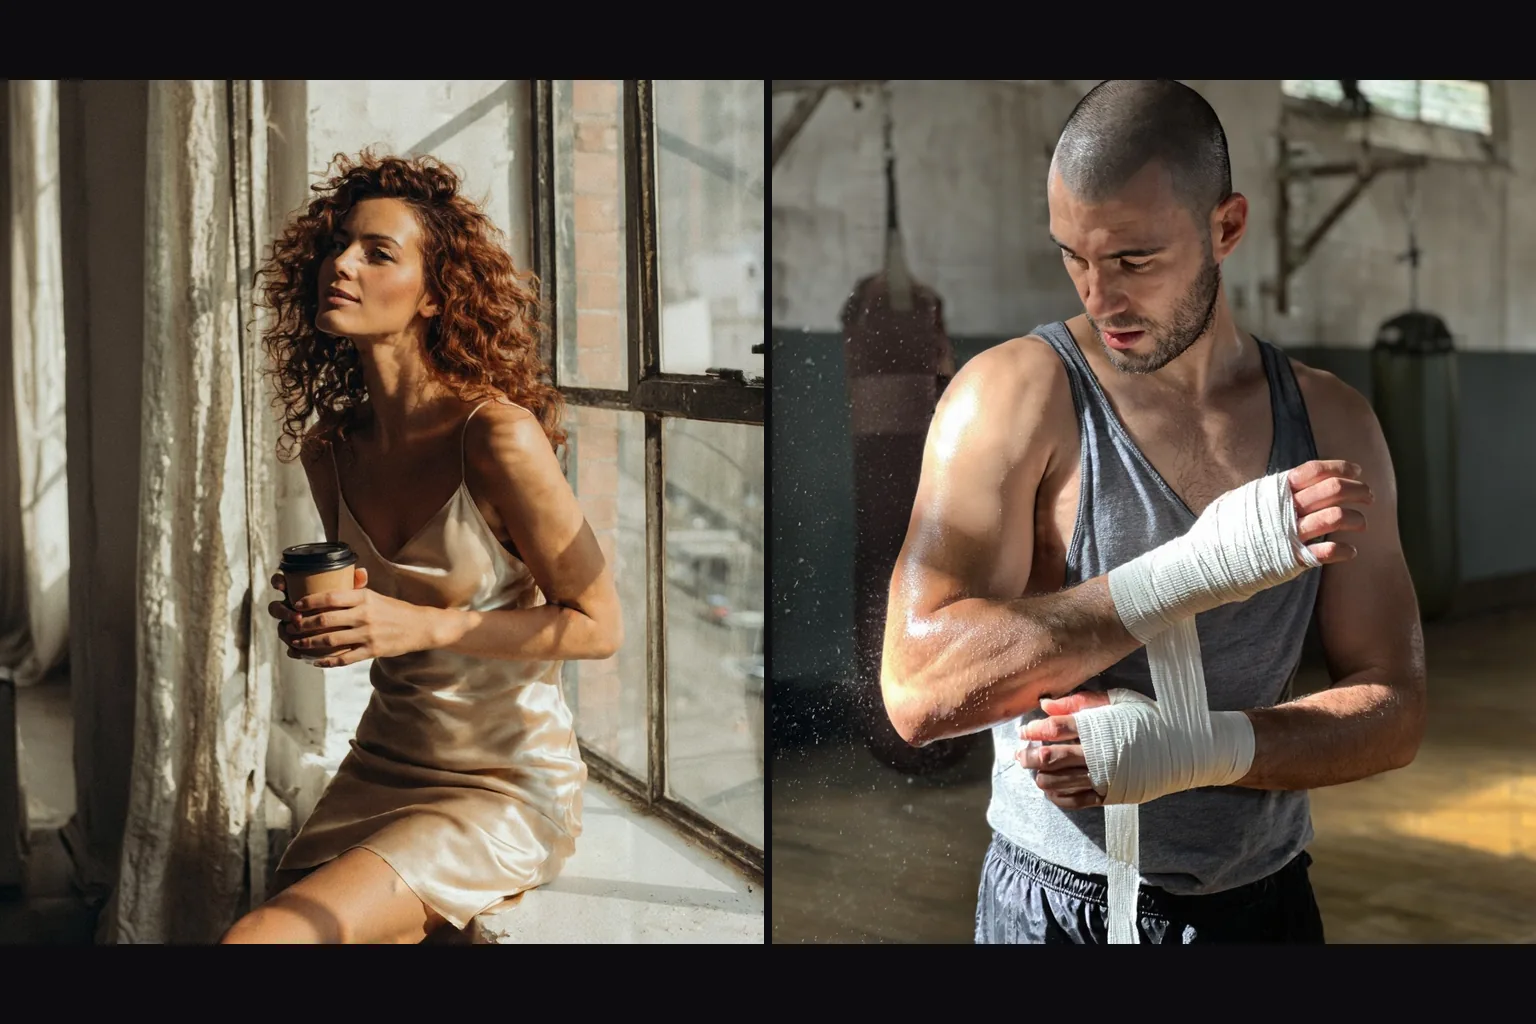
L’aderenza al prompt è forte, quindi descrivi la fotografia come faresti un brief a un fotografo: soggetto, abiti, luogo, luce, grana. I nostri ritratti in loft e in palestra sono nati da una frase ciascuno. La stessa forma di frase, cambiando solo il soggetto, regge un’intera serie.

Usa LoRA addestrate su Base

Usa LoRA addestrate su Base

Una LoRA addestrata su Z-Image Base ha funzionato a 0.5 e a 1. La LoRA di illustrazione mikkoani si attiva con la sua frase “mature illustration with muted color and complex linework” all’inizio del prompt, e già la sola frase, senza il file, spingeva un prompt fotografico verso l’illustrazione.

  • Scegli la strength prima di riscrivere il prompt

    In modifica, la strength decide quanto della sorgente sopravvive. Nella nostra scala, 0.3 e 0.5 lasciavano l’immagine quasi invariata e 0.6 la cambiava di poco. A 0.7 il contenuto cominciava a cambiare mantenendo la composizione, 0.75 cambiava posa e messa in scena mantenendo luce e tavolozza, e 0.85 dava un’immagine nuova. Con una LoRA di stile, 0.6 ridisegnava lo stile di tutta l’inquadratura mantenendo la composizione esattamente.

  • Aspettati un cambio di stile, non istruzioni

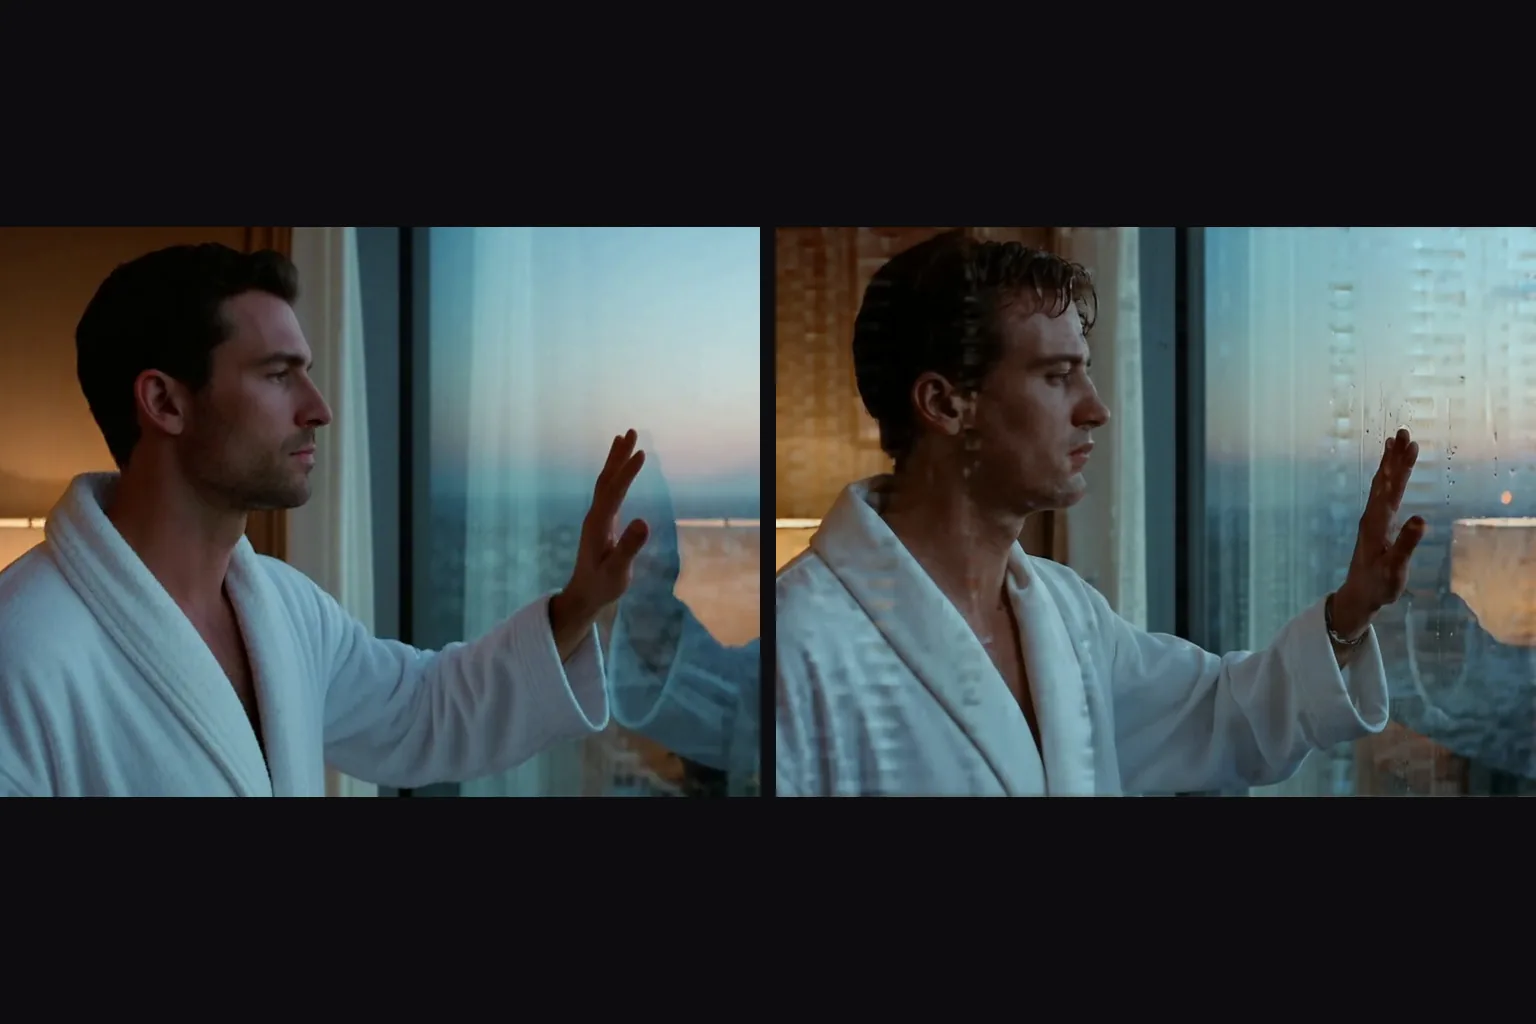
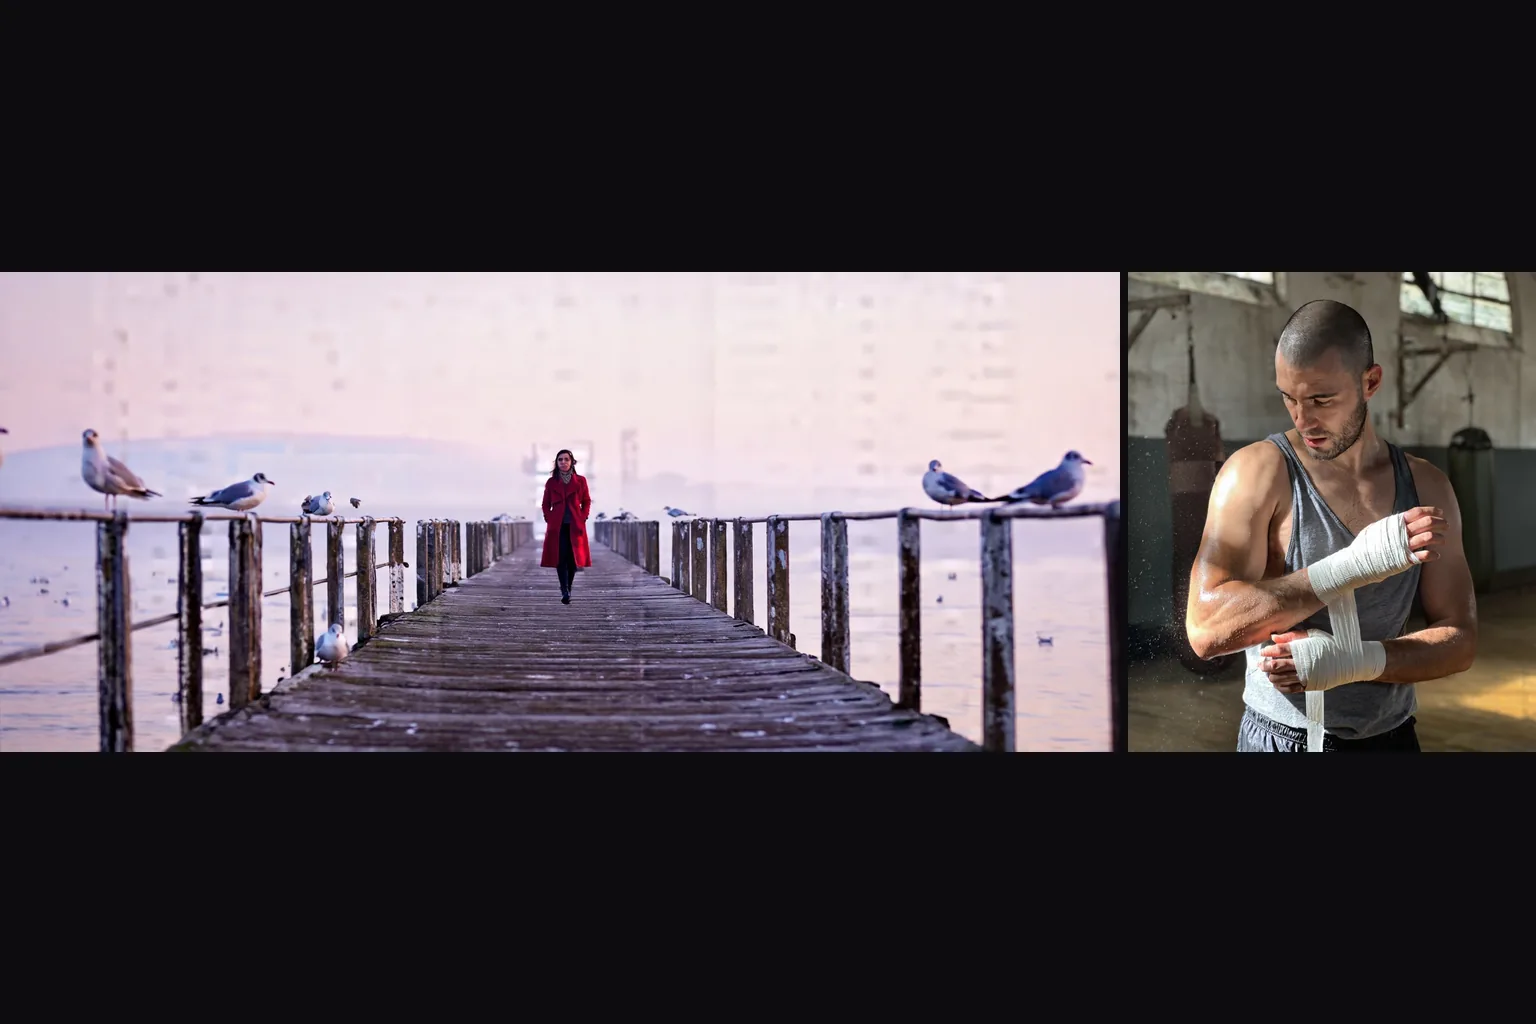
    Il modello di modifica ridisegna l’inquadratura a partire dalla tua descrizione. “Make it black and white” è rimasto a colori a 0.65 e 0.8 nel nostro test, come mostra l’immagine di destra. Per cambiare medium usa una LoRA di stile; per una scena diversa, descrivila per intero.

  • Attenzione alle dimensioni

    Da testo a immagine offre nove proporzioni, da 1024×1024 per 1:1 a 1536×640 per 21:9, e ognuna è tornata esattamente della dimensione richiesta. In modifica, 1k e 1.5k fissano il lato lungo e la proporzione della sorgente viene mantenuta: una foto 2:3 a 1k è tornata 680×1024 e una foto 16:9 a 1.5k è tornata 1536×856.

Chi usa Z-Image Base LoRA

  • Illustrazione dai colori tenui e ricca di tratti da testo

    Illustratori e concept artist

    Illustrazione dai colori tenui e ricca di tratti da testo

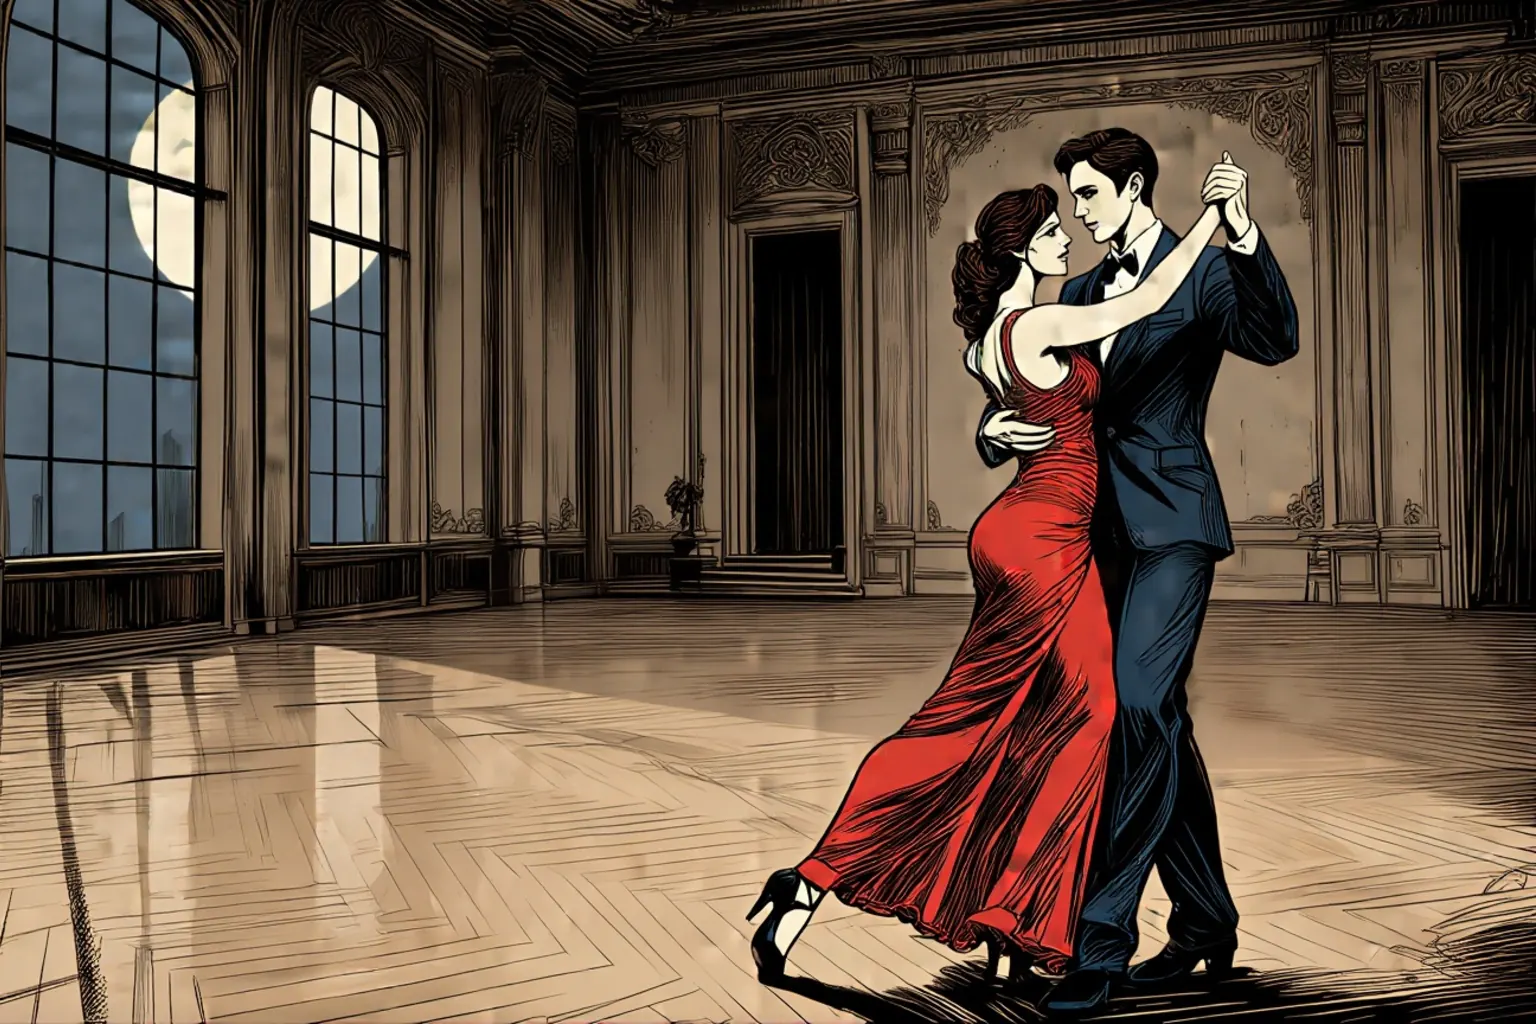
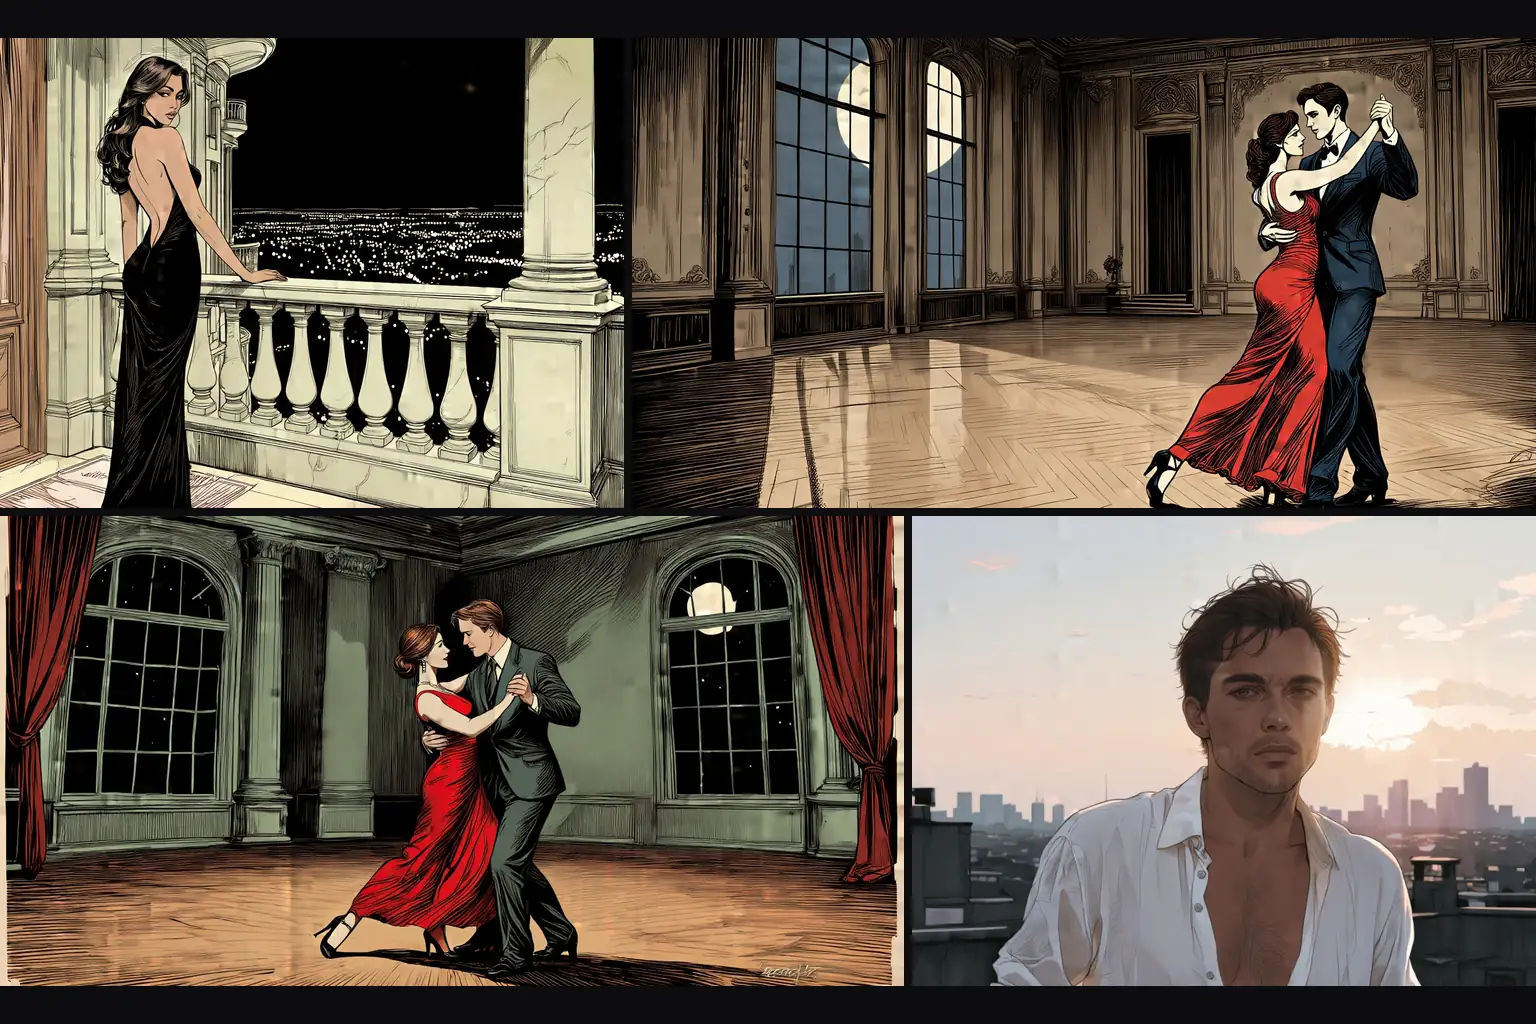
    Con la LoRA mikkoani a 1, i nostri prompt per un ballo in sala, un balcone di notte e una coppia in una sala al chiaro di luna sono tornati tutti come illustrazione a inchiostro dai colori tenui. Tieni la frase per prima e scrivi la scena in frasi.

  • Una foto trasformata in illustrazione

    Fotografi e ritoccatori

    Una foto trasformata in illustrazione

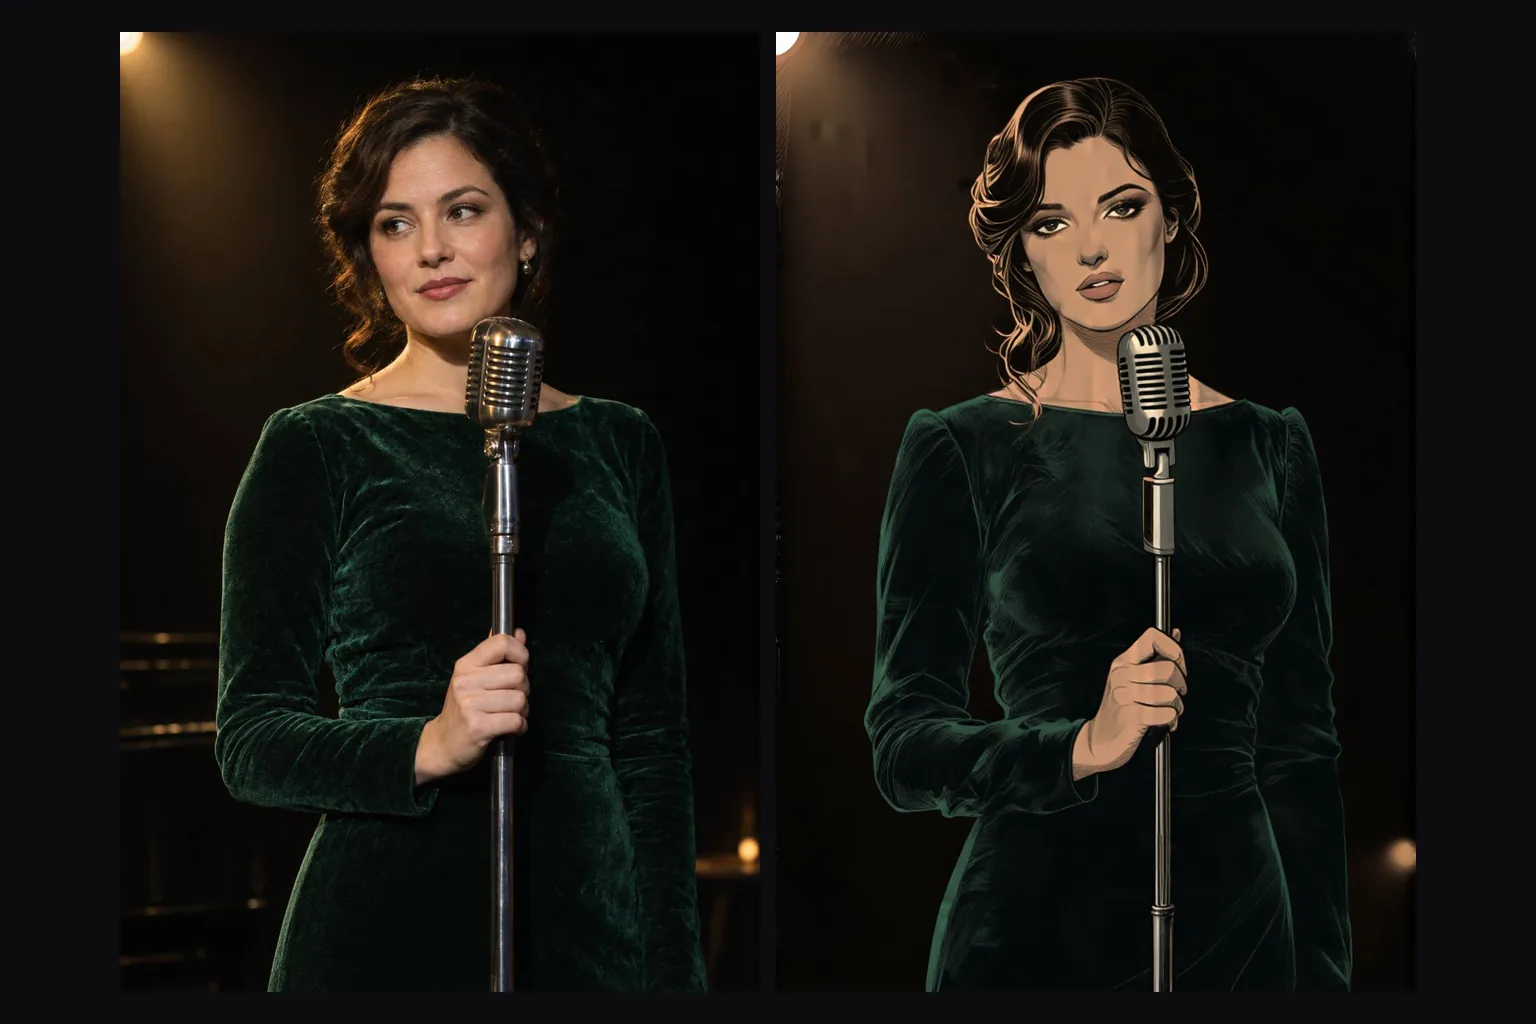
    A sinistra una foto sorgente di una cantante in abito di velluto verde, a destra la modifica con la LoRA mikkoani a strength 0.6. La posa, il microfono e l’inquadratura sono rimasti al loro posto mentre la resa è diventata disegnata.

  • Scegliere fin dove arriva una variazione

    Team social e di campagne

    Scegliere fin dove arriva una variazione

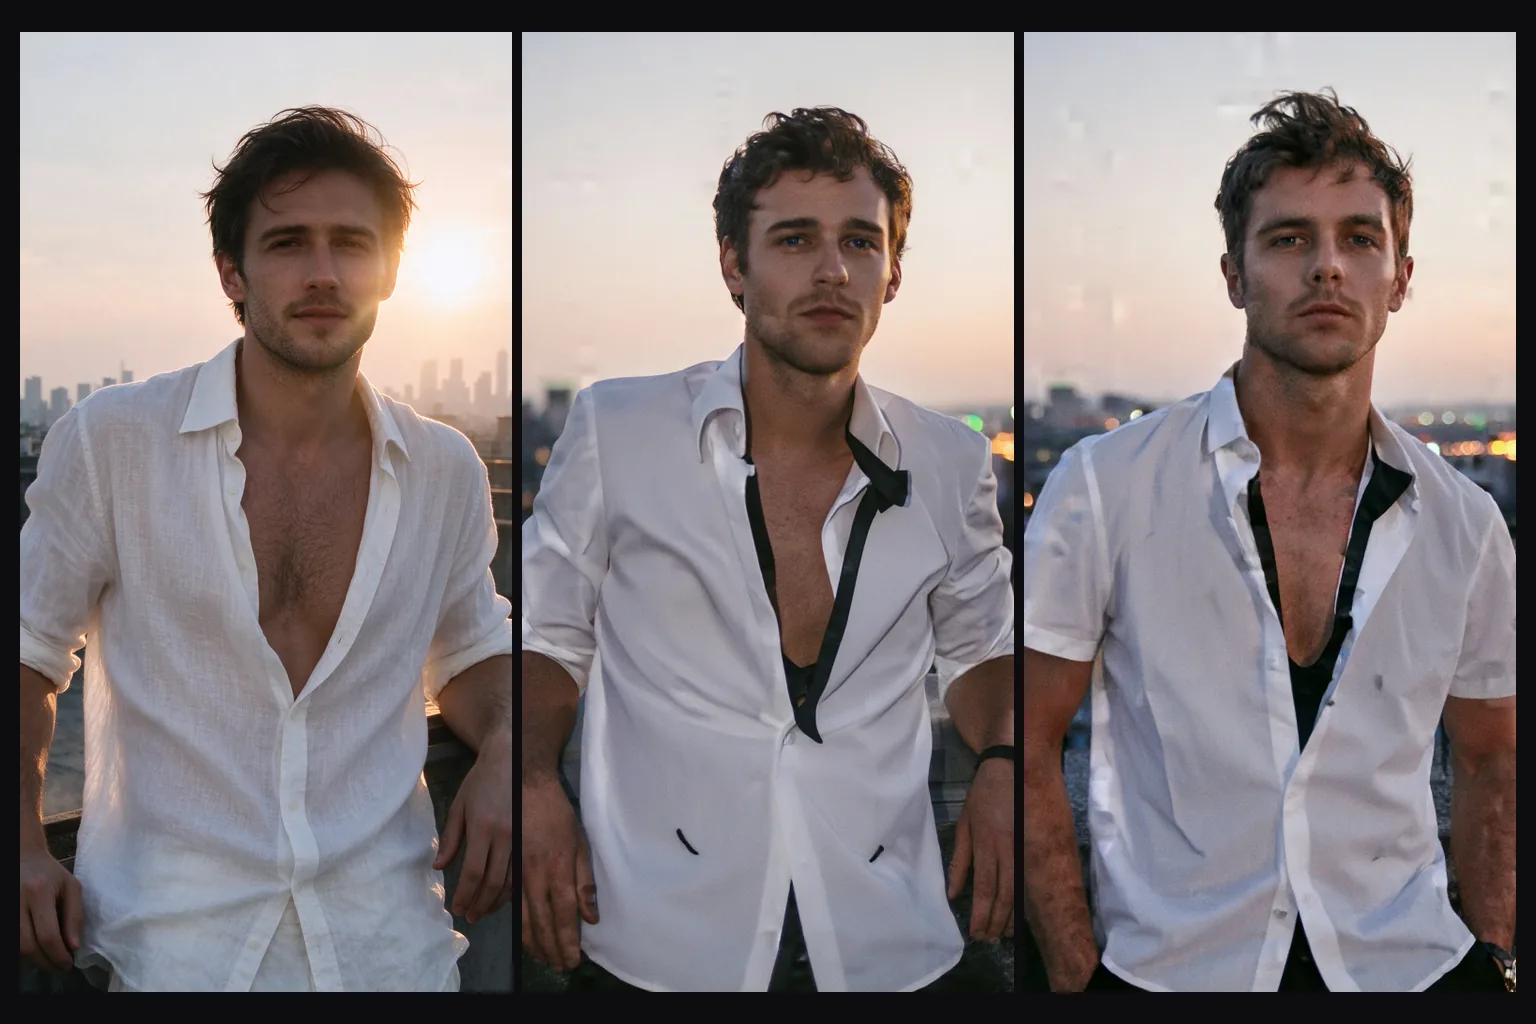
    Il nostro ritratto sul tetto è passato da una modifica senza LoRA che chiedeva uno smoking a 0.7 e 0.8. Ha cambiato poco e la composizione è rimasta. Usa la strength come cursore della variazione e tieni i valori più forti per quando vuoi un’inquadratura diversa.

  • Scene larghe 21:9 a 1536 pixel

    Chi crea contenuti cinematografici e sfondi

    Scene larghe 21:9 a 1536 pixel

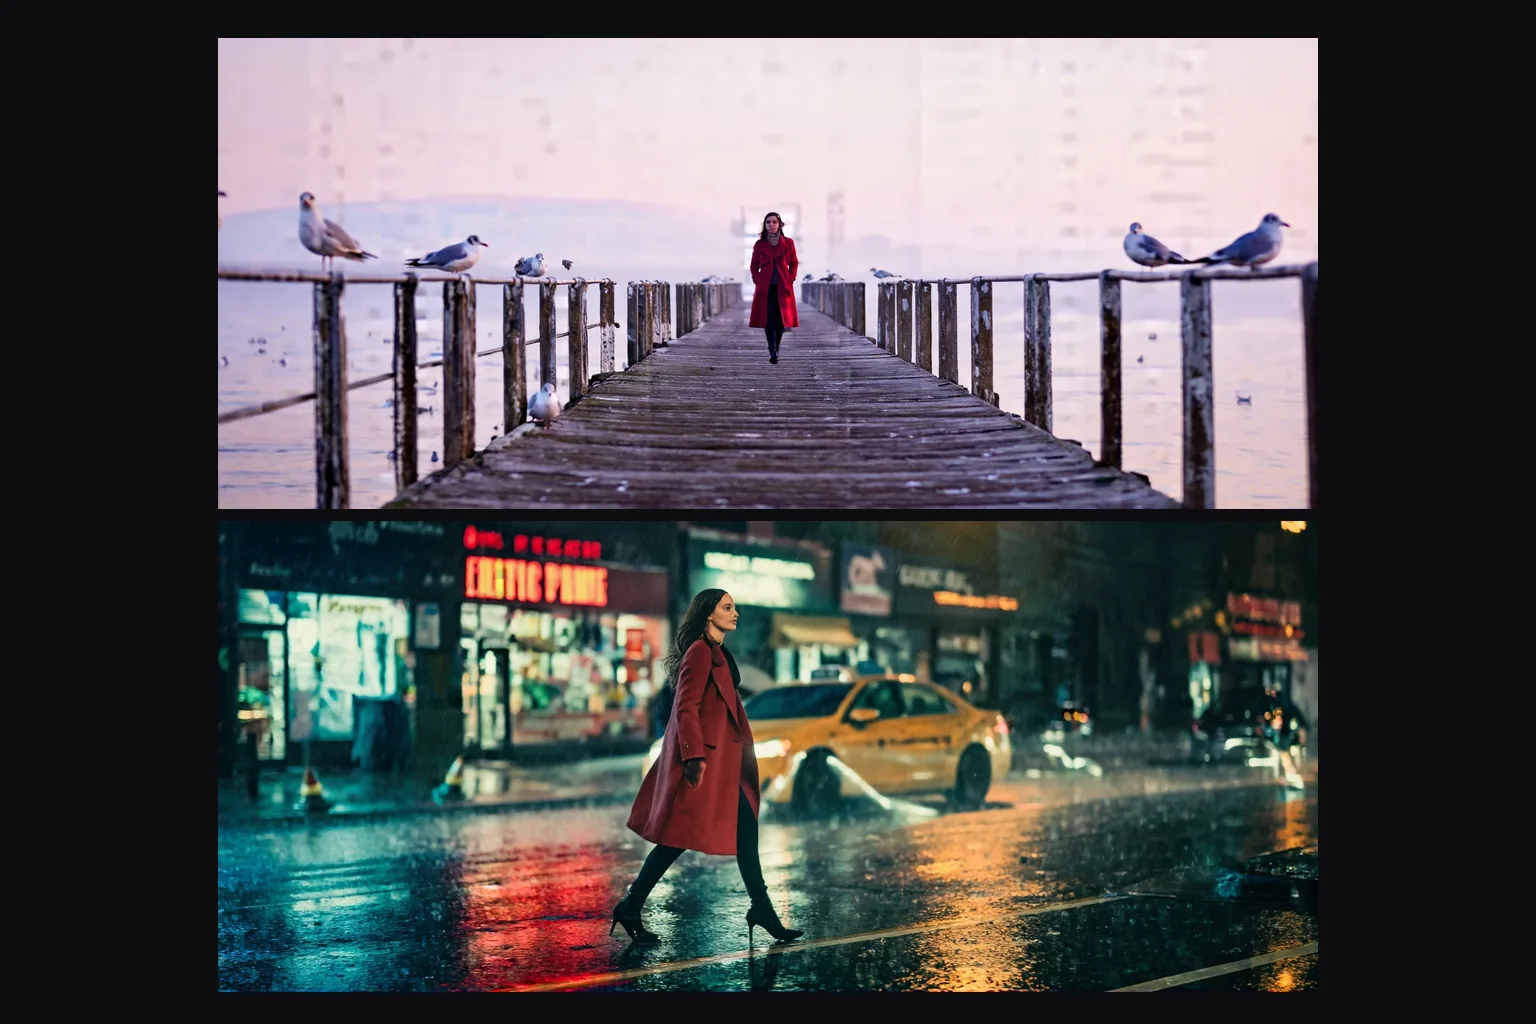
    Una donna in cappotto rosso su un molo nella nebbia all’alba e su una strada piovosa al neon sono nate entrambe da semplici frasi in 21:9 (1536×640), senza LoRA. La proporzione larga fa parte del prompt, non è un ritaglio fatto dopo.

Dal primo prompt alla modifica finita con Z-Image Base LoRA

  1. Parti da un prompt in semplici frasi

    Lancia prima da testo a immagine senza LoRA, nella proporzione in cui pubblicherai, per vedere cosa ti dà il modello base.

  2. Aggiungi una LoRA addestrata su Base

    Copia il link di download diretto del file .safetensors e lancialo con e senza il file con lo stesso seed.

  3. Controlla lo scale

    Prova 0.5 e 1 e tieni il valore in cui l’aspetto si posa senza prendere il sopravvento sul soggetto.

  4. Modifica con una scala di strength

    Invia un’immagine sorgente con l’array loras e parti da 0.6; usa 0.7 e 0.75 quando vuoi rimettere in scena la composizione.

  5. Descrivi l’intero risultato

    Il modello ridisegna l’intera inquadratura, quindi scrivi l’immagine completa, non solo la modifica.

Prompt per Z-Image Base LoRA da copiare

  • Una foto in semplici frasi

    Nessuna LoRA; proporzione verticale 2:3.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • Un’illustrazione dai colori tenui

    Con la LoRA mikkoani con scale 1 e la proporzione 16:9; la frase resta per prima.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • Una foto in tratti disegnati

    Per l’endpoint di modifica con la LoRA mikkoani con scale 1 e strength 0.6. Descrivi l’intera immagine, non solo la modifica.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Altre domande su Z-Image Base LoRA

Usalo come il tuo laboratorio del modello base

Parti da un prompt in semplici frasi, aggiungi una LoRA addestrata su Base e verificala con una coppia con e senza.

In modifica, sali con la strength da 0.6 e descrivi l’intero risultato. Se un file non cambia nulla o rovina l’immagine, è stato addestrato per un altro modello.