Wprowadzenie
FLUX.2 Klein 9B LoRA Tekst na obraz tworzy jeden obraz z pisemnego promptu w FLUX.2 [klein] 9B od Black Forest Labs, modelu 9B destylowanym krokowo, z maksymalnie trzema twoimi plikami LoRA ładowanymi z bezpośrednich linków. Wybierz jedną z dziewięciu proporcji w 1k lub 2k i odbierz JPEG, najczęściej w około dziesięć sekund czasu modelu. Platforma nie dodaje filtra treści do promptu, wag ani obrazu, a cena za obraz jest stała.
Wybierz tryb według materiału wyjściowego
| Co masz | Tryb |
|---|---|
| pisemny opis i LoRA | FLUX.2 Klein 9B LoRA Tekst na obraz |
| od jednego do trzech obrazów do zmiany | FLUX.2 Klein 9B LoRA Edycja obrazu |
Najważniejsze funkcje
Twoje LoRA, obie wersje klein 9B
LoRA wytrenowane na destylowanym klein 9B i na klein Base 9B załadowały się tutaj w naszych testach. LoRA wytrenowane na Base dla mocniejszych poziomów zmieniało to, co model rysował; LoRA w stylu kadru filmowego przesunęło gradację całej sceny w stronę turkusu i bursztynu. LoRA FLUX.1 i klein 4B oraz pliki zapisane w formacie PEFT biblioteki diffusers działały bez błędu i niczego nie zmieniały, więc przed użyciem sprawdź model bazowy na karcie LoRA.
Dość szybko, by iterować
Większość obrazów trwała około dziesięciu sekund czasu modelu, tak w 1k, jak i w 2k, a 2k kosztuje tyle samo co 1k. Dzięki temu można w jednej sesji wypróbować LoRA na trzech wartościach siły (strength) i kilku seedach, a potem zachować najlepszy kadr.
Brak filtra treści
Prompty i pliki LoRA nie są weryfikowane. Sam model powstrzymuje się na poziomach Silny i Bardzo silny; LoRA wytrenowane na taką treść na klein 9B wyrenderowały oba w naszych testach. Poziom Maksymalny wyrenderował się bez żadnego LoRA.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
prompt | Tak | Wymagane, do 5000 znaków. Zacznij od frazy wyzwalającej LoRA, a potem opisz postać, ubiór, miejsce, światło i obiektyw zdaniami. od 1 znaków · do 5000 znaków |
aspect_ratio | Nie | Dziewięć kształtów od 21:9 do 9:21; domyślnie 1:1. Kształt nie zmienia ceny. |
resolution | Nie | 1k (domyślnie) to około jednego megapiksela, na przykład 1344 x 768 lub 1024 x 1024; 2k daje 2048 pikseli po dłuższym boku, na przykład 2048 x 1152. Oba kosztują tyle samo. |
loras | Nie | Do trzech wpisów {path, scale} wytrenowanych pod FLUX.2 [klein] 9B, destylowany lub Base; scale od 0 do 4, domyślnie 1. W naszych testach 0,5 było słabe, a 4 rozbijało obraz. Domyślnie: |
seed | Nie | Opcjonalnie, od 0 do 2 147 483 647. Użyj go ponownie, by porównywać po jednej zmianie; w naszych testach ten sam seed dawał ten sam lub niemal identyczny obraz. |
Cennik
$0.018 / obraz
Rozliczane za obraz w jednej stałej cenie. Proporcje, 1k lub 2k i ładowanie LoRA nie zmieniają ceny.
Zastosowania
LoRA z serwisu jako wywołanie API
Wklej bezpośredni link .safetensors z serwisu z modelami, ustaw scale i napisz prompt. Nie ma czego trenować, hostować ani trzymać w gotowości, a do trzech LoRA łączy się w jednym żądaniu.
Kadry z korekcją barw i serie w jednym stylu
LoRA filmowa lub analogowa utrzymuje cały zestaw obrazów w jednej tonacji w dziewięciu kształtach, od banerów 21:9 po ekrany telefonów 9:16, w jednej stałej cenie za obraz.
Praca nad postacią z nakładanymi LoRA
Załaduj LoRA wytrenowane na klein 9B dla mocniejszych poziomów razem z LoRA postaci lub stylu i pilnuj, by każda osoba była dorosła.
Wskazówki
Najpierw wyzwalacz, potem zdania
Zacznij od frazy wyzwalającej z karty modelu LoRA, a potem opisz postać, ubiór, miejsce, światło i obiektyw pełnymi zdaniami. Model dobrze radzi sobie z długimi, konkretnymi promptami, a promptu negatywnego nie ma, więc pisz, czego chcesz, a nie czego unikać.
Zmieniaj scale małymi krokami
Zacznij od 0,8–1. W naszych testach 0,5 dawało słabą wersję stylu, a 4 rozbijało obraz na bloki. Podnoś lub obniżaj o 0,2 i patrz najpierw na twarze i dłonie; one zniekształcają się jako pierwsze.
Sprawdź, czy LoRA naprawdę działa
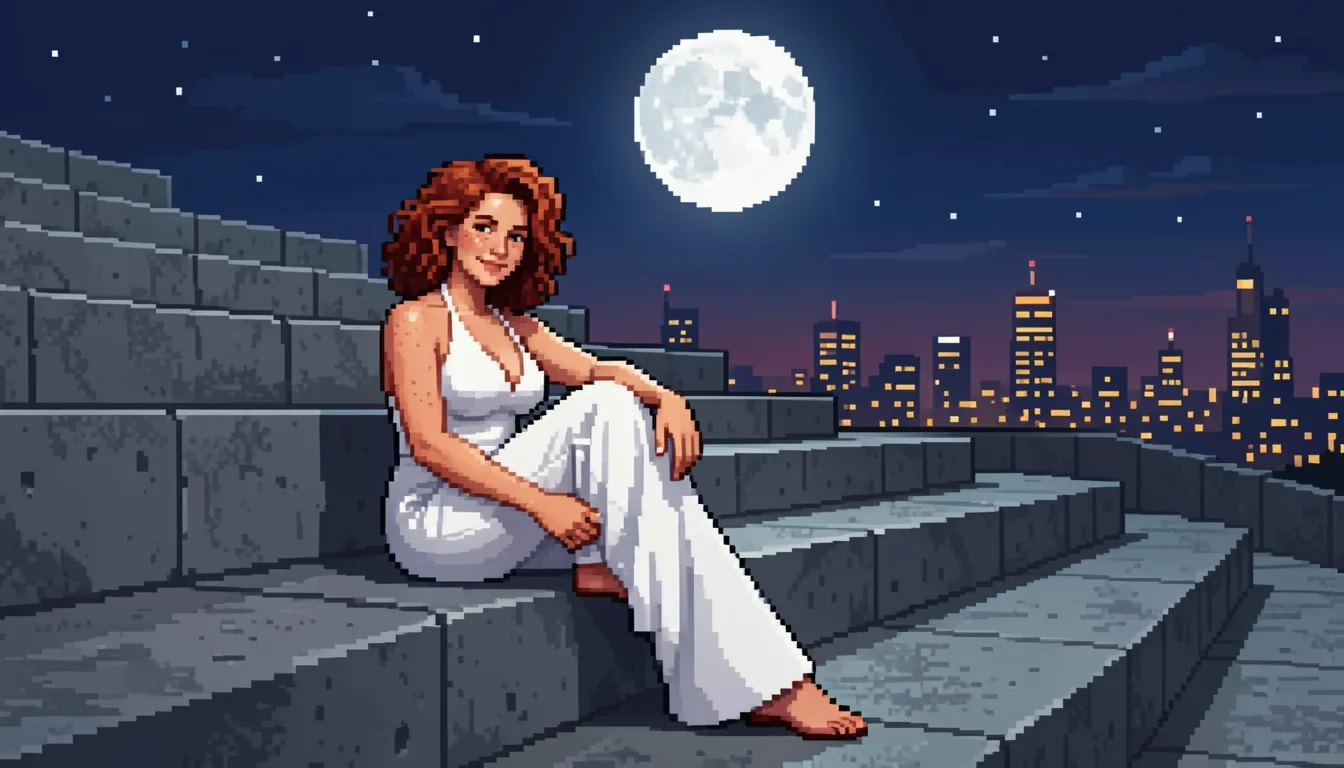
Uruchom ten sam prompt i seed z plikiem i bez niego. LoRA stylu często dopracowują wygląd, o który słowa już proszą, na przykład ziarno, korekcję barw albo siatkę pikseli; LoRA uczące nowej treści zmieniają obraz od podstaw. Brak widocznej zmiany zwykle oznacza zły model bazowy.
Opisz wygląd, światło i obiektyw
Bez LoRA model sam dobiera ubiór. Poświęć prompt na miejsce, światło i obiektyw, a opis stroju trzymaj krótki i prosty.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-2-klein-9b-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.