Введение
daVinci-MagiHuman Image to video запускает клип с вашего фото и придаёт ему движение и голос. daVinci-MagiHuman — открытая модель на 15 млрд параметров от Sand.ai и SII-GAIR, которая создаёт картинку и звуковую дорожку вместе. Фото становится первым кадром; промпт говорит, что будет дальше и, в кавычках, что говорит человек. Эндпоинт возвращает от 5 до 10 секунд в 256p, 720p или 1080p, в 16:9 или 9:16, и принимает вашу речь или песню как audio_url.
Выберите режим по исходному материалу
| Что у вас есть | Режим |
|---|---|
| письменное описание | daVinci-MagiHuman Text to video |
| фото, с которого начнётся видео, с вашим аудио или без него | daVinci-MagiHuman Image to video |
Ключевые возможности и особенности
Первый кадр, который движется и говорит
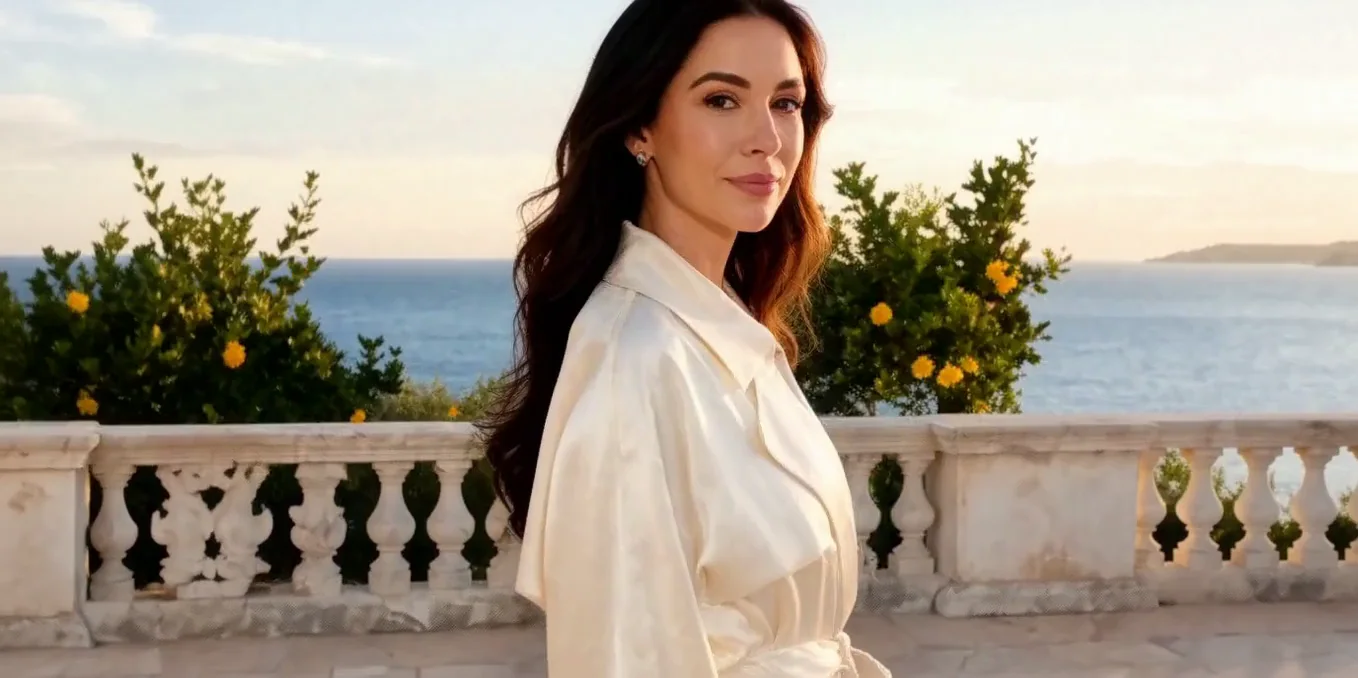
Клип начинается с вашего изображения. В нашем запуске без аудиофайла она повернулась от моря, заправила волосы за ухо и произнесла реплику в кавычках; расшифровка звуковой дорожки совпала слово в слово.
Свой голос
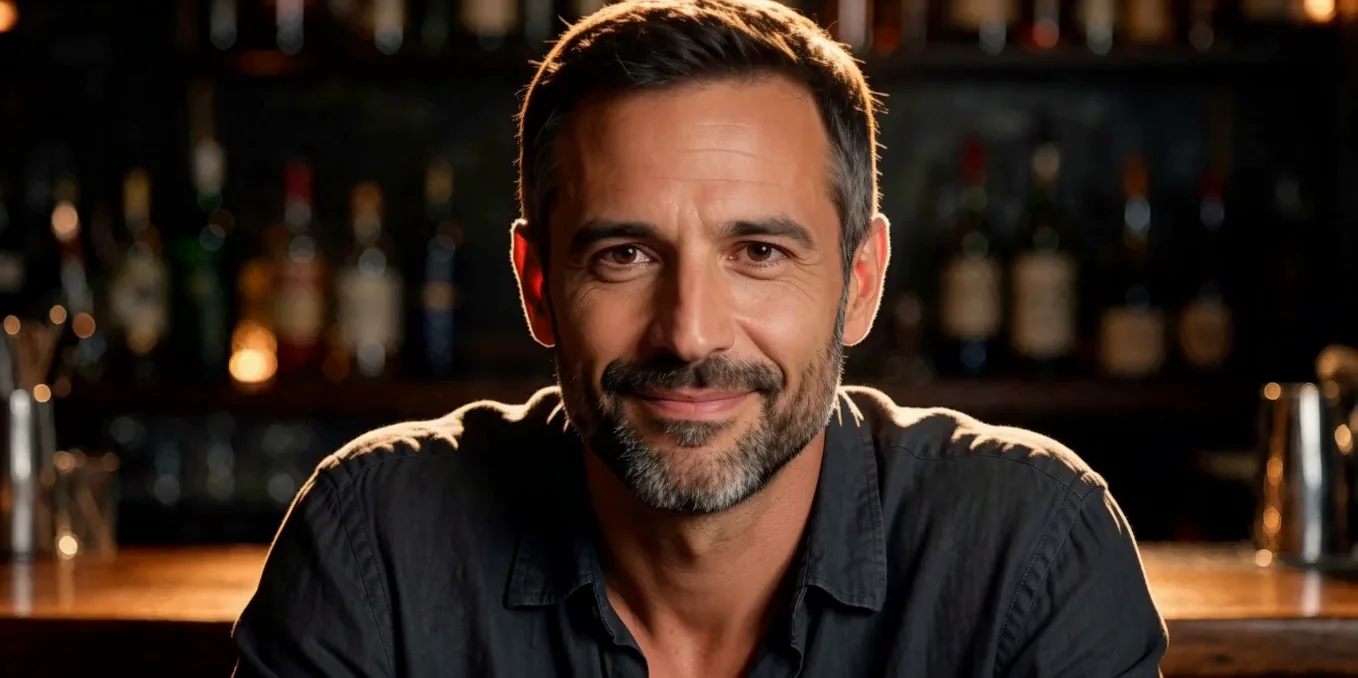
С audio_url видео создаётся в синхронизации с вашей речью или песней, а не с придуманным голосом. В нашем запуске с 5-секундной записью речи губы следовали за заданным аудио, с полуулыбкой и движением бровей, а лицо оставалось близким к входному портрету.
Что мы измерили
Мы запустили два клипа image to video в 720p и 16:9, оба по 5,0 секунды и оба около 1358 x 678 при 25 fps, так что 720p — не ровно 1280 x 720. Запуск без аудио занял около 1 мин 45 с; запуск с 5-секундной записью речи как audio_url — около 3 мин 7 с. Мы не запускали этот эндпоинт в 1080p, в 9:16 или с записью длины, отличной от клипа.
Разрешения и форматы кадра
resolution — 256p, 720p (по умолчанию) или 1080p, а aspect_ratio — 16:9 (по умолчанию) или 9:16. Модель генерирует в низком базовом разрешении, а собственный этап сверхразрешения даёт старшие уровни. Старшие уровни стоят дороже за секунду; звук и формат кадра цену не меняют.
Параметры запроса
| Параметр | Обязательно | Описание |
|---|---|---|
prompt | Да | Опишите, что происходит после фото: что делает человек и, в кавычках, что он говорит. Если задано |
image_url | Да | Первый кадр. Публичная ссылка, по которой файл скачивается напрямую; клип начинается с этого фото. |
audio_url | Нет | Необязательно. Публичная ссылка на файл речи или песни; видео создаётся в синхронизации с ним, а не с придуманным голосом. |
aspect_ratio | Нет | 16:9 (по умолчанию) или 9:16. Наши запуски image to video шли в 16:9. |
resolution | Нет | 256p, 720p (по умолчанию) или 1080p. Старшие уровни стоят дороже за секунду; наши запуски в 720p пришли около 1358 x 678. |
duration_seconds | Нет | От 5 до 10 секунд, по умолчанию 5, оплата за секунду. |
seed | Нет | Необязательное целое число. Одинаковый seed при тех же входных данных даёт похожие, но не гарантированно идентичные результаты. |
Стоимость
Оплата за секунду заявленной длительности; цена за секунду зависит от разрешения, а звук и формат кадра её не меняют. Неудачные запросы не тарифицируются.
| Спецификация | Стоимость |
|---|---|
| $0.024 / секунду |
| $0.048 / секунду |
| $0.072 / секунду |
Сценарии использования
Портрет, который говорит вашей записью
Портретное фото и файл речи: губы следуют за вашим аудио, а лицо остаётся близким к фото.
Персонаж, который произносит реплику
Изображение первого кадра и короткая реплика в кавычках, чтобы увидеть, как персонаж выглядит и звучит, прежде чем вкладываться в большее.
Вертикальные клипы из фото
Выбирайте 9:16 для лент и сторис. Все наши запуски на этом эндпоинте шли в 16:9, поэтому проверьте первый клип.
Руководство по промптам и практические советы
Опишите следующий момент
Напишите, что происходит после того, как сделано фото: она поворачивается к камере, заправляет волосы, говорит. В нашем запуске всё это произошло.
Со своим аудио оставьте слова
Голос приходит из audio_url, поэтому промпт может задавать настроение, движение и свет, например he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.
Подгоните запись под клип
Наш запуск использовал 5-секундную запись для 5-секундного клипа. Мы не тестировали запись короче или длиннее duration_seconds, поэтому обрежьте аудио до заданной длины.
Без аудио ставьте реплику в кавычки
Поставьте то, что говорит человек, в кавычки, и модель её произнесёт. Мы тестировали английский.
Выбор между моделями
Если у вас уже есть запись голоса и портрет и вы хотите более длинный клип, до 300 секунд, который ведётся этим аудио, используйте OmniHuman 2.0; Kling Avatar 2.0 — та же идея. Выбирайте daVinci-MagiHuman, когда нужно, чтобы модель произнесла написанную вами реплику, или нужен клип 9:16.
Быстрый старт API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "sand-ai/davinci-magihuman/image-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "resolution": "720p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Аутентификация, полная схема, опрос статуса и обработка ошибок описаны в справочнике API.