Перейти к основному контенту

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

Изображение в видео daVinci-MagiHuman запускает клип от 5 до 10 секунд с вашего фото и придаёт ему движение и голос: поставьте реплику в кавычки в промпте или прикрепите своё аудио. 256p, 720p или 1080p, 16:9 или 9:16.

От $0.024/с

Рабочая область

Ввод

Изображение в видео
211/5000
Опишите, что происходит после фото: что делает человек и, в кавычках, что он говорит. Если задано audio_url, оставьте слова и опишите настроение, движение и свет. Не менее 3 символов · Не более 5000 символов
1/1

Перетащите файл или ссылку на медиа, вставьте или выберите · 1 файл · Не более 10 МБ · JPG · PNG · WEBP

  • 1
Файлы: 1 / 1
Первый кадр. Публичная ссылка, по которой файл скачивается напрямую; клип начинается с этого фото.
0/1

Перетащите аудиофайл или выберите файл на устройстве · 1 файл · Не более 90 МБ · MP3 · WAV

Файлы: 0 / 1
Необязательно. Публичная ссылка на файл речи или песни; видео создаётся в синхронизации с ним, а не с придуманным голосом. В нашем запуске была 5-секундная запись для 5-секундного клипа.
16:9 (по умолчанию) или 9:16. Наши запуски image to video шли в 16:9. Формат кадра цену не меняет.
влияет на цену
256p, 720p (по умолчанию) или 1080p. Старшие уровни стоят дороже за секунду; наши запуски в 720p пришли около 1358 x 678.
Длительностьвлияет на цену
От 5 до 10 секунд, по умолчанию 5, оплата за секунду. Не меньше 5 · Не больше 10
Сид
Необязательное целое число. Одинаковый seed при тех же входных данных даёт похожие, но не гарантированно идентичные результаты. Не меньше 0 · Не больше 2147483647
Фильтр безопасностиВыключен

SpicyAPI не применяет фильтр безопасности к этой модели. Промпт и материалы передаются модели без изменений, а результат определяет сама модель.

Проверяем аккаунт перед включением отправки и расчёта стоимости.

Вывод

Готово к запуску
Пример результата

Нужной модели нет?

Напишите, какую модель добавить и для чего она вам нужна. Запрос попадёт к тем, кто решает, что подключать дальше.

ГОВОРЯЩЕЕ ВИДЕО API

API daVinci-MagiHuman: главное

Одна модель на 15 млрд параметров создаёт картинку и голос вместе: человек говорит в кадре по тексту или по фото, от 5 до 10 секунд в разрешении до 1080p.

Параметры
15B
Одна модель создаёт картинку и звуковую дорожку вместе. Веса открыты по лицензии Apache 2.0.
Длительность клипа
5–10 с
Выберите длительность от 5 до 10 секунд; по умолчанию 5. Наши клипы приходили с частотой 25 fps.
Максимальное разрешение
1080p
256p, 720p (по умолчанию) или 1080p. Модель рендерит в малом разрешении, а собственный этап сверхразрешения даёт старшие уровни; размеры приходят близко к номинальным, например около 1904 x 1088 при 1080p.
Форматы кадра
2
Альбомный 16:9 (по умолчанию) или портретный 9:16 на обоих эндпоинтах. Звук и формат кадра цену не меняют.
Свой звук
Опция
Загрузите речь или песню как audio_url, и видео будет создано в синхронизации с записью, а не с придуманным голосом.
Языки речи
6
Китайский (путунхуа и кантонский), английский, японский, корейский, немецкий и французский — по списку издателя. Мы тестировали английский.

Результаты

Что можно сделать с daVinci-MagiHuman

  • Текст в видео

    Реплика, произнесённая на балконе

    Один промпт с репликой в кавычках дал 1080p-клип: женщина с платиновым каре на ночном балконе, огни города размыты позади неё. Пришло около 1904 x 1088 при 25 fps, 5,0 секунды, со звуком; расшифровка звуковой дорожки совпала с репликой слово в слово. Обработка заняла около 3 мин 53 с.

    Текст в видео, 1080p, 16:9, пять секунд, реплика в кавычках звучит на звуковой дорожке.

  • Портрет

    Вертикальный клип со смехом и фразой

    С форматом 9:16 веснушчатый мужчина с рыжими волосами на мокрой неоновой улице смеётся и произносит свою реплику. В 720p пришло около 726 x 1270, 5,0 секунды, расшифровка совпала слово в слово. Обработка заняла около минуты. Мы написали "looks straight into the camera" вместо просьбы о селфи.

    Текст в видео в портретном формате, 9:16 в 720p, пять секунд, реплика в кавычках звучит на звуковой дорожке.

  • Изображение в видео

    Фото, которое поворачивается и говорит

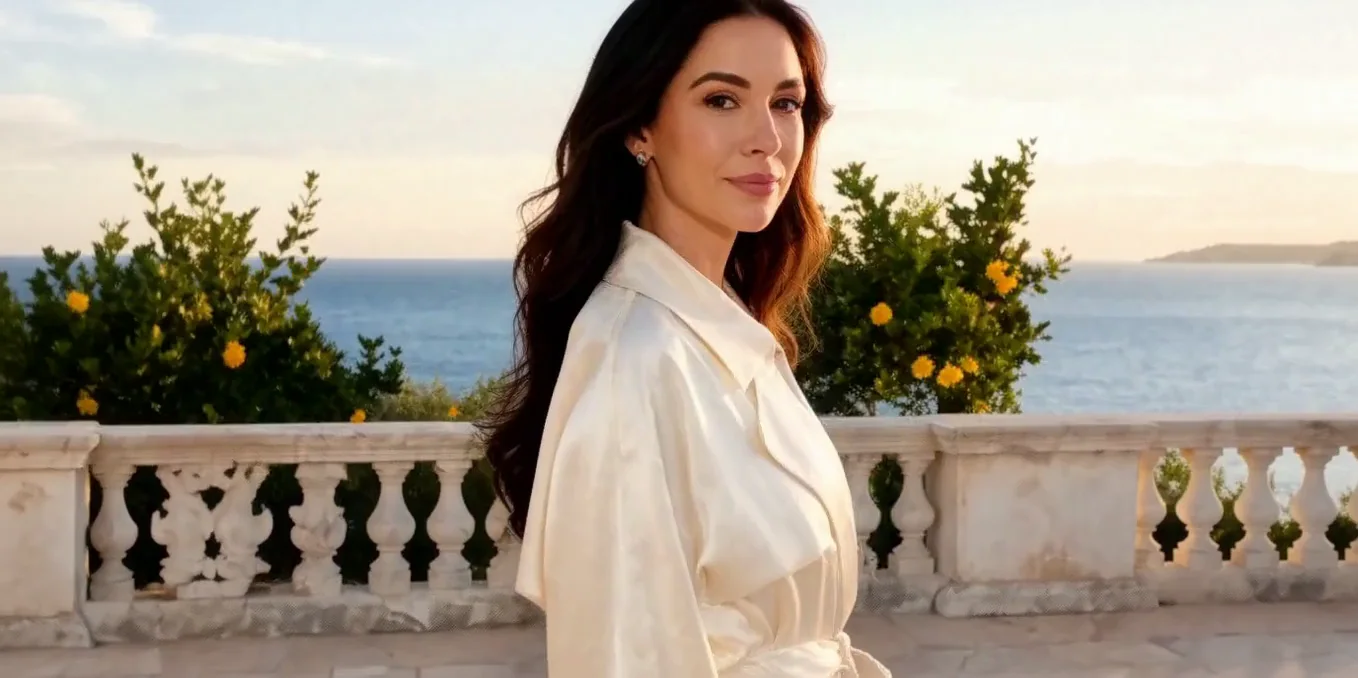
    По изображению первого кадра и промпту, без аудиофайла, она поворачивается от моря, заправляет волосы за ухо и произносит реплику. Расшифровка совпала слово в слово. В 720p пришло около 1358 x 678, 5,0 секунды, после около 1 мин 45 с.

    Изображение в видео без аудиофайла, 16:9 в 720p, пять секунд, реплика в кавычках звучит на звуковой дорожке.

  • Свой звук

    Портрет, который следует за вашей записью

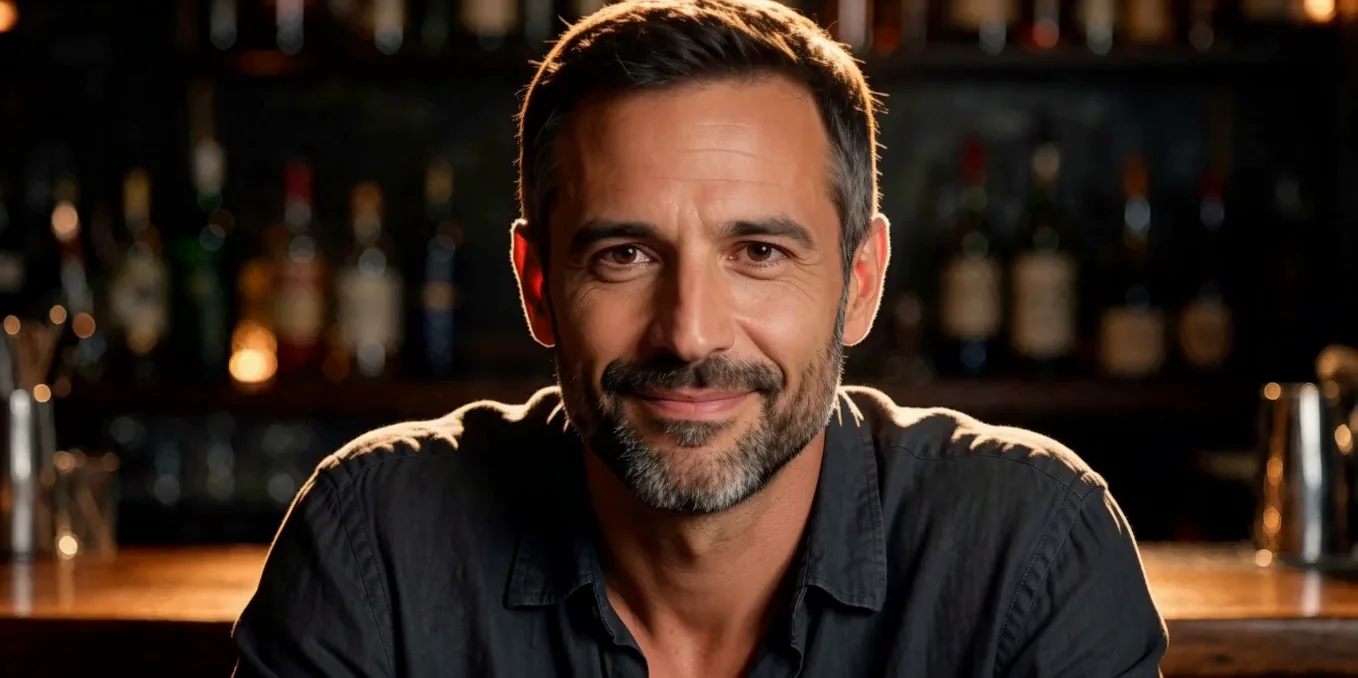
    С 5-секундной записью речи как audio_url губы следовали за заданным аудио, с полуулыбкой и движением бровей, а лицо оставалось близким к входному портрету. В 720p пришло около 1358 x 678, 5,0 секунды, после около 3 мин 7 с.

    Изображение в видео с 5-секундной записью речи как audio_url, 16:9 в 720p, пять секунд.

Перед запуском

Что знать перед запуском daVinci-MagiHuman

Все режимы
Клипы длятся от 5 до 10 секунд, в 256p, 720p или 1080p, в 16:9 или 9:16. Размеры приходят близко к номинальным, но не точно: 720p в 16:9 дало около 1358 x 678, а 1080p — около 1904 x 1088. Мы тестировали английскую речь и не тестировали пение. Что может показывать клип, зависит от вашего промпта и нашей политики использования.
Текст в видео
Человек и сцена берутся из ваших слов, поэтому описывайте кадр: просьба о селфи с телефоном в одном дополнительном запуске поставила телефон в кадр. Мы не запускали audio_url на этом эндпоинте.
Изображение в видео
Изображение первого кадра обязательно, и клип начинается с него. Все наши запуски image to video шли в 16:9. С audio_url мы тестировали 5-секундную запись на 5-секундном клипе и не тестировали запись короче или длиннее клипа.

Сценарии

Что построить на API daVinci-MagiHuman

  • Короткие клипы с речью

    Человек произносит одну фразу в камеру за 5–10 секунд: интро, тизер, приветствие, а голос создаётся за вас.

  • Вертикальные клипы для телефона

    Выберите формат 9:16 для лент и сторис. Наш портретный запуск в 720p пришёл примерно 726 x 1270.

  • Портрет, который говорит вашей записью

    Начните с фото и добавьте файл с речью как audio_url: губы следуют за вашим аудио, а лицо остаётся близким к фото.

  • Тесты персонажа и диалога

    Проверьте, как персонаж выглядит и звучит на фото первого кадра с короткой репликой в кавычках, прежде чем делать более длинный ролик. Мы тестировали английский; издатель перечисляет ещё пять языков.

Промпты

Примеры промптов для daVinci-MagiHuman, которые можно скопировать

Вставьте любой в песочницу как есть, а потом меняйте по одному параметру за раз.

  • Текст в видео

    Кто, где, реплика в кавычках, затем свет

    Результат по этому промпту

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    Почему это работает. Человек и место идут первыми, реплика стоит в кавычках вместе со способом произнесения, а свет завершает промпт. Расшифровка совпала с репликой слово в слово.

    Попробовать этот промпт
  • Текст в видео

    Задайте, куда смотрят глаза

    Результат по этому промпту

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    Почему это работает. "Looks straight into the camera" задал план. В дополнительном запуске просьба о селфи с телефоном поставила в кадр телефон.

    Попробовать этот промпт
  • Изображение в видео

    Дайте фото следующий момент

    Результат по этому промпту

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    Почему это работает. Промпт говорит, что она делает после фото: поворачивается к камере, заправляет волосы, произносит реплику. Всё это произошло, и расшифровка совпала.

    Этот режим начинается с вашего изображения: добавьте его в песочнице перед запуском.

    Попробовать этот промпт
  • Изображение в видео

    Со своим голосом задайте образ

    Результат по этому промпту

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    Почему это работает. Слова берутся из присланной записи, поэтому промпт задаёт только настроение, движение и свет. Губы следовали за аудио, с полуулыбкой и движением бровей.

    Этот режим начинается с вашего изображения: добавьте его в песочнице перед запуском.

    Попробовать этот промпт

Сравнение

daVinci-MagiHuman и похожие модели: что выбрать

МодельРежимыОтКонтентВыбирайте, если
OmniHuman 2.0Говорящий аватар$0.108 / секунда результатаС фильтром — Эта модель прямо отклоняет запросы за пределами собственных ограничений. Это измеренный результат, а не предположение; у неизмеренных моделей отметки нет вовсе.У вас уже есть запись голоса и портрет, и вы хотите более длинный клип, до 300 секунд, который ведётся этим аудио. Выбирайте daVinci-MagiHuman, если нужно, чтобы модель произнесла написанную вами в кавычках реплику, или нужен клип 9:16.
Kling Avatar 2.0Говорящий аватар$0.051 / секунда результатаС фильтром — Эта модель прямо отклоняет запросы за пределами собственных ограничений. Это измеренный результат, а не предположение; у неизмеренных моделей отметки нет вовсе.У вас есть портрет и свой звук, и вы хотите клип, ведомый этим аудио, — та же идея, что у OmniHuman 2.0. Выбирайте daVinci-MagiHuman, если нужно, чтобы модель произнесла написанную вами в кавычках реплику.

Цены

Цены на API daVinci-MagiHuman

Ролик длиной 5 с — от $0.12 в 256p и от $0.36 в 1080p.

Песочница показывает точную цену для ваших настроек до запуска. Неудачные задачи и задачи с истёкшим сроком обычно не оплачиваются. Некоторые модели взимают плату за отказ по содержанию, как указано на странице модели; проверьте эти условия до отправки.

Все ценовые уровни

Начало работы

Как использовать API daVinci-MagiHuman за три шага

  1. Шаг 1

    Ставьте реплику в кавычки

    Модель произносит то, что стоит в кавычках. Опишите, кто говорит и как (тихо, тепло, смеясь), а затем саму реплику. Наши три реплики в кавычках для 5-секундного клипа были по 8–10 слов, и каждая прозвучала слово в слово.

  2. Шаг 2

    Описывайте кадр, а не устройство

    В дополнительном запуске в формате 9:16 просьба снять селфи с телефоном поставила в кадр телефон, направленный на камеру сзади. Напишите "looks straight into the camera" и размер плана ("vertical medium close-up").

  3. Шаг 3

    Свой голос через audio_url

    Если прикреплён файл с речью или песней, в промпте уже не нужны слова. Опишите настроение, движение и свет, а губы будут следовать за записью. В нашем запуске 5-секундная запись совпала с 5-секундным клипом.

Справочник параметров и примеры кода — во вкладках API и Readme в верхней части страницы.

Почему SpicyAPI

Почему стоит запускать daVinci-MagiHuman в SpicyAPI

  • Без нашего фильтра

    Мы не добавляем собственный фильтр контента. Что сгенерирует модель, то вы и получите.

  • Проверено, а не предположено

    Уровни контента основаны на реальных генерациях, которые мы запускали и проверяли, с датой теста на странице.

  • Оплата за результат, в долларах

    Без подписки и кредитов. Неудачные задачи и задачи с истёкшим сроком обычно не оплачиваются. Некоторые модели взимают плату за отказ по содержанию, как указано на странице модели; проверьте эти условия до отправки.

  • Один ключ для всех моделей

    Один ключ API и баланс работают с моделями изображений, видео, аудио и чата, поэтому вы можете пробовать больше моделей в одном аккаунте.

FAQ

Частые вопросы об API daVinci-MagiHuman

О модели daVinci-MagiHuman

daVinci-MagiHuman открывает за одним API открытую модель на 15 млрд параметров от Sand.ai и SII-GAIR: text-to-video и image-to-video с картинкой и голосом, созданными вместе, от 5 до 10 секунд в 256p, 720p или 1080p, в 16:9 или 9:16, с возможностью принести свой звук. Оплата идёт за секунду заявленной длительности, неудачные запросы не тарифицируются.

Связанные модели и следующие шаги