Zum Hauptinhalt springen

Neta Lumina Text-zu-Bild zeichnet eine Anime-Illustration aus Tags im Danbooru-Stil, einfachen Sätzen oder beidem, auf dem Finetuning von Lumina-Image-2.0 durch Neta.art Lab. Neun Seitenverhältnisse mit etwa einem Megapixel, Ausgabe als JPEG, PNG oder WebP und kein Content-Filter.

Ab $0.012/Bild

Playground

Eingabe

Text zu Bild
494/5000
Tags, Sätze oder beides, bis zu 5.000 Zeichen. Beginnen Sie mit „masterpiece, best quality“, nennen Sie als Nächstes die Personenzahl („1girl“, „1boy“), dann Outfit, Pose, Kamera und Licht. Es gibt keinen Negativ-Prompt. mindestens 1 Zeichen · höchstens 5000 Zeichen
Neun Optionen von 21:9 bis 9:21; standardmäßig 1:1. 1:1 ist 1024 x 1024, 3:4 ist 960 x 1280 und 16:9 ist 1536 x 864. Das Seitenverhältnis ändert den Preis nicht.
Ausgabeformat
JPEGPNGWebP
Standardmäßig JPEG, bei Bedarf PNG oder WebP. Ändert den Preis nicht.
Seed
Hält eine Bildserie vergleichbar, während Sie jeweils nur ein Tag ändern. Er garantiert nicht bei jedem Lauf exakt dieselben Pixel. nicht kleiner als 0 · nicht größer als 2147483647
SicherheitsfilterAus

SpicyAPI führt bei diesem Modell keinen Sicherheitsfilter aus. Prompt und Material gehen unverändert an das Modell, und das Modell selbst entscheidet über das Ergebnis.

Wir prüfen Ihr Konto, bevor Absenden und Preisberechnung freigeschaltet werden.

Ausgabe

Bereit für einen neuen Lauf
grimoire-archiveBeispielergebnis

Verwandte Modelle und nächste Schritte

Ihr Modell ist nicht dabei?

Sagen Sie uns, welches Modell fehlt und wofür Sie es brauchen. Ihre Anfrage geht direkt an das Team, das über die nächsten Modelle entscheidet.

Anime-Key-Art aus Danbooru-Tags oder ganz normalen Sätzen, mit echten Action-Posen

Neta Lumina ist das Anime-Illustrations-Finetuning von Neta.art Lab auf Basis von Alpha-VLLMs Lumina-Image-2.0, mit einem Gemma-2B-Textencoder. Es versteht Tags im Danbooru-Stil, normale Sätze oder beides und zeichnet neun Seitenverhältnisse mit etwa einem Megapixel. In 31 Läufen brauchte ein Bild 13 bis 75 Sekunden Modellzeit, im Median 40 und nie unter zehn; planen Sie also Batches ein statt Live-Tippen. Nichts filtert Prompt oder Ergebnis: Unser härtester Inhaltstest wurde gleich beim ersten Versuch so gerendert, wie er geschrieben war.

Playground öffnen
Anime-Key-Art aus Danbooru-Tags oder ganz normalen Sätzen, mit echten Action-Posen
Modell
Neta Lumina von Neta.art Lab, ein Finetuning von Lumina-Image-2.0 mit einem Gemma-2B-Textencoder
Tempo
13 bis 75 Sekunden Modellzeit pro Bild in unseren 31 Läufen, Median 40; keines war in unter 10 fertig
Größen
9 Seitenverhältnisse mit etwa einem Megapixel: 1024 x 1024 bei 1:1, 960 x 1280 bei 3:4, 1536 x 864 bei 16:9, 1536 x 656 bei 21:9
Prompt
Bis zu 5.000 Zeichen aus Tags, Sätzen oder beidem; kein Negativ-Prompt
Ausgabe
Ein Bild pro Anfrage als JPEG (Standard), PNG oder WebP, mit optionalem Seed
Preis
Abrechnung pro Bild zu einem Einheitspreis für jedes Verhältnis und Format
Content-Filter
Keiner; unser härtester Inhaltstest wurde gleich beim ersten Versuch so gerendert, wie er geschrieben war
Prompten
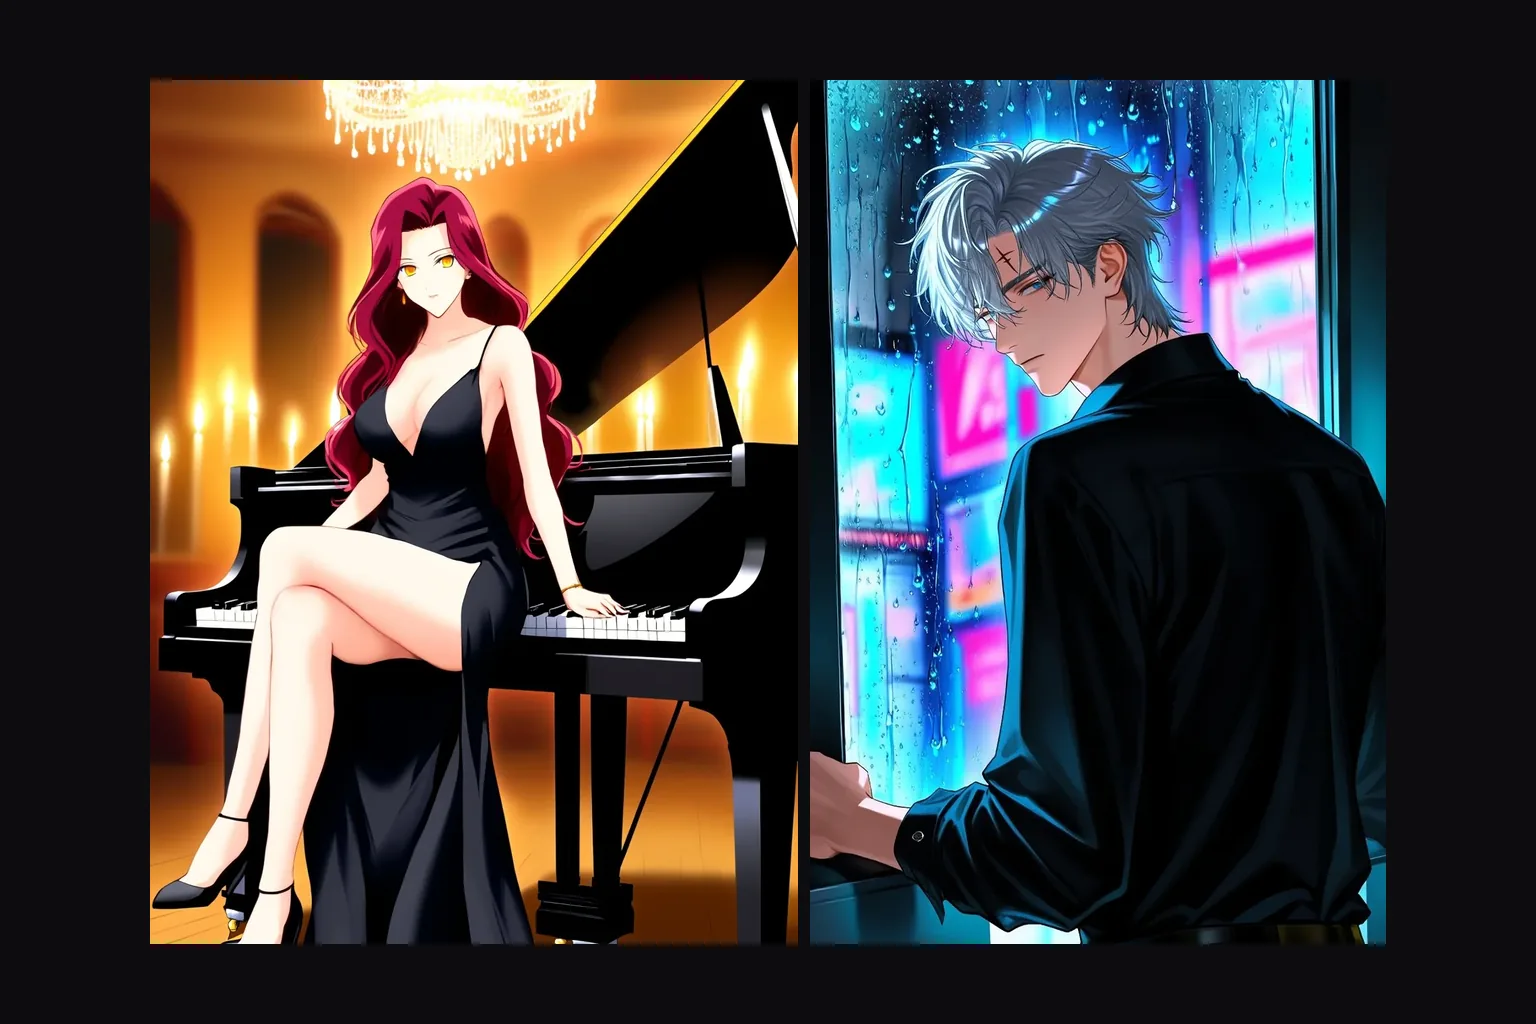
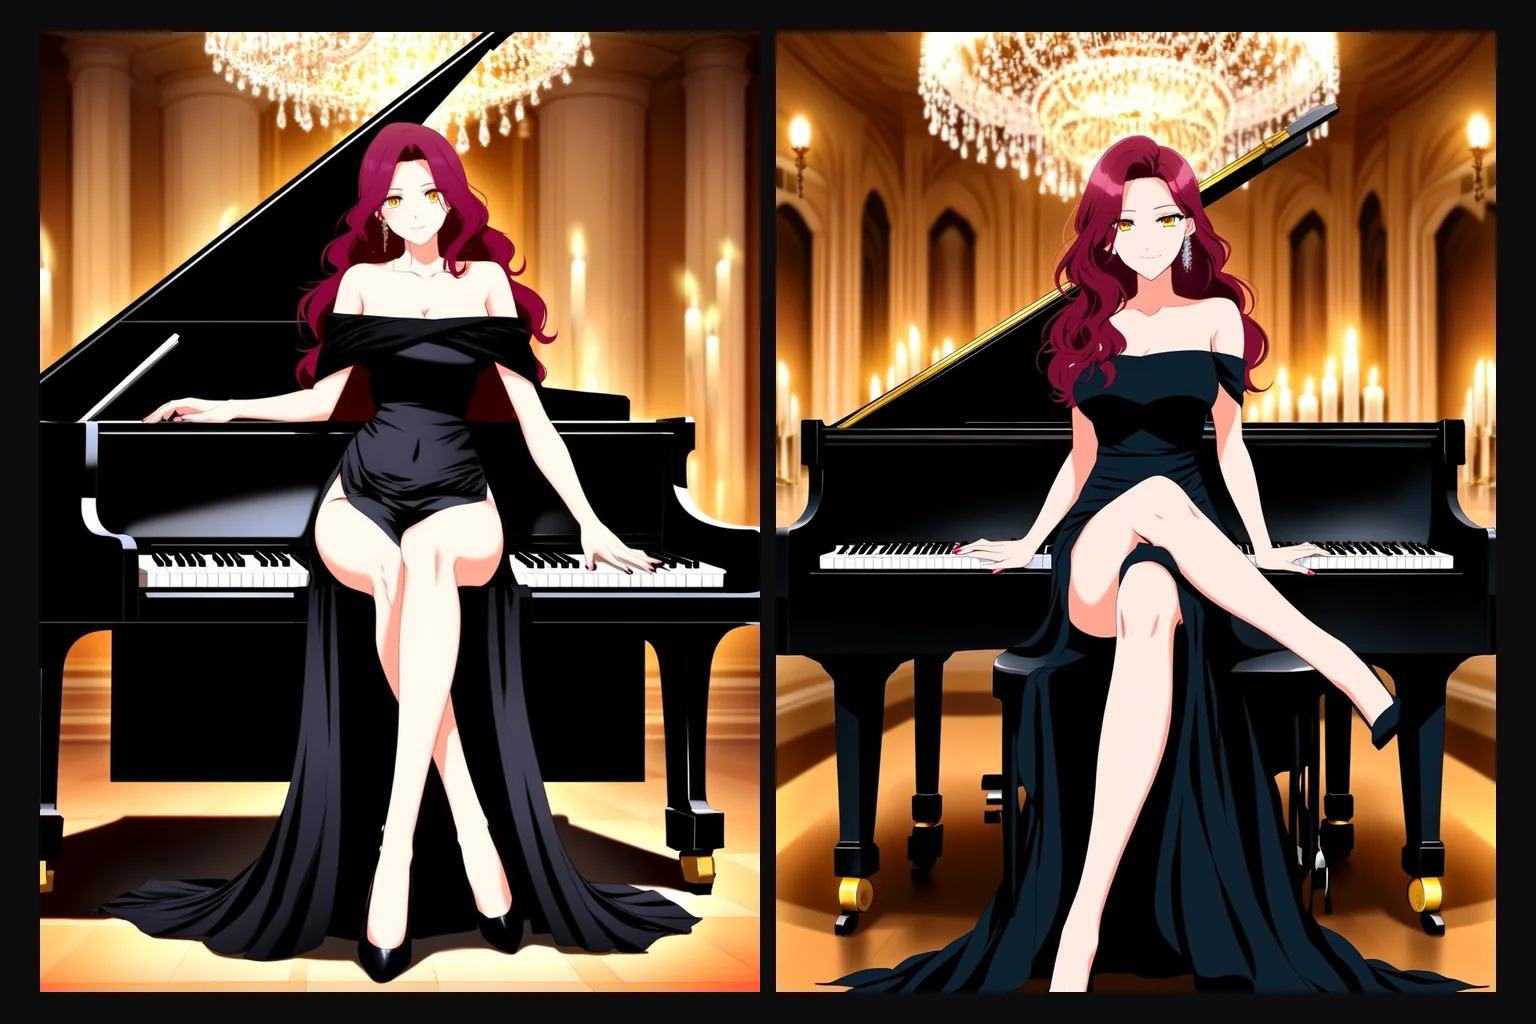
Tags und Sätze funktionieren beideQualitäts-Tags, eine Personenzahl und Outfit-Tags zeichneten die Pianistin im Kerzenlicht, und drei einfache Sätze zeichneten einen Mann an einem regennassen Fenster, mit Narbe, Hemd und Neon-Spiegelungen. Mischen Sie beides: Tags für den Look, einen Satz für Kamera und Lichtführung.
Tempo
Planen Sie Zeit ein, nicht GeldDie Bilder brauchten 13 bis 75 Sekunden, im Median 40, und die Bildgröße erklärt das nicht: Ein Lauf mit 656 x 1536 dauerte 13 Sekunden, Läufe mit 960 x 1280 dauerten 14 bis 75. Lassen Sie Varianten parallel laufen und halten Sie den Seed beim Vergleichen fest.
Grenzen
Was es nicht kannEs gibt keinen Negativ-Prompt, keine Bildeingabe, keinen LoRA-Platz, keine Einstellung für Schritte oder Guidance, und pro Anfrage kommt ein Bild. Action-Szenen sind am wenigsten verlässlich: Ein zweiter Seed unseres Prompts mit dem fliegenden Tritt verhedderte ein Bein. Gelegentlich fügt das Modell außerdem ein signaturähnliches Gekritzel oder einen verpixelten Fleck hinzu, den es aus seinem Trainingsmaterial gelernt hat; ein neuer Seed behebt das.

Das Beste aus Neta Lumina herausholen

Mit Qualität und Personenzahl beginnen

Mit Qualität und Personenzahl beginnen

Beginnen Sie mit „masterpiece, best quality, anime illustration“, dann „1girl“, „1boy“ oder beides, dann Figur, Outfit, Pose, Kamera, Licht und Stimmung. Kleingeschriebene Tags mit Leerzeichen lesen sich am besten. Die Pianistin im ersten Bild nutzte genau diese Reihenfolge.

Für die schwierigen Teile einen Satz schreiben

Für die schwierigen Teile einen Satz schreiben

Kameraposition, Lichtrichtung und das Verhältnis zweier Figuren lassen sich in einem Satz leichter sagen als in Tags. Der Mann am Neonfenster im zweiten Bild entstand aus drei einfachen Sätzen, und Narbe, offenes Hemd sowie die cyan- und magentafarbenen Spiegelungen kamen alle ins Bild.

  • Jeder Figur eine eigene Wendung geben

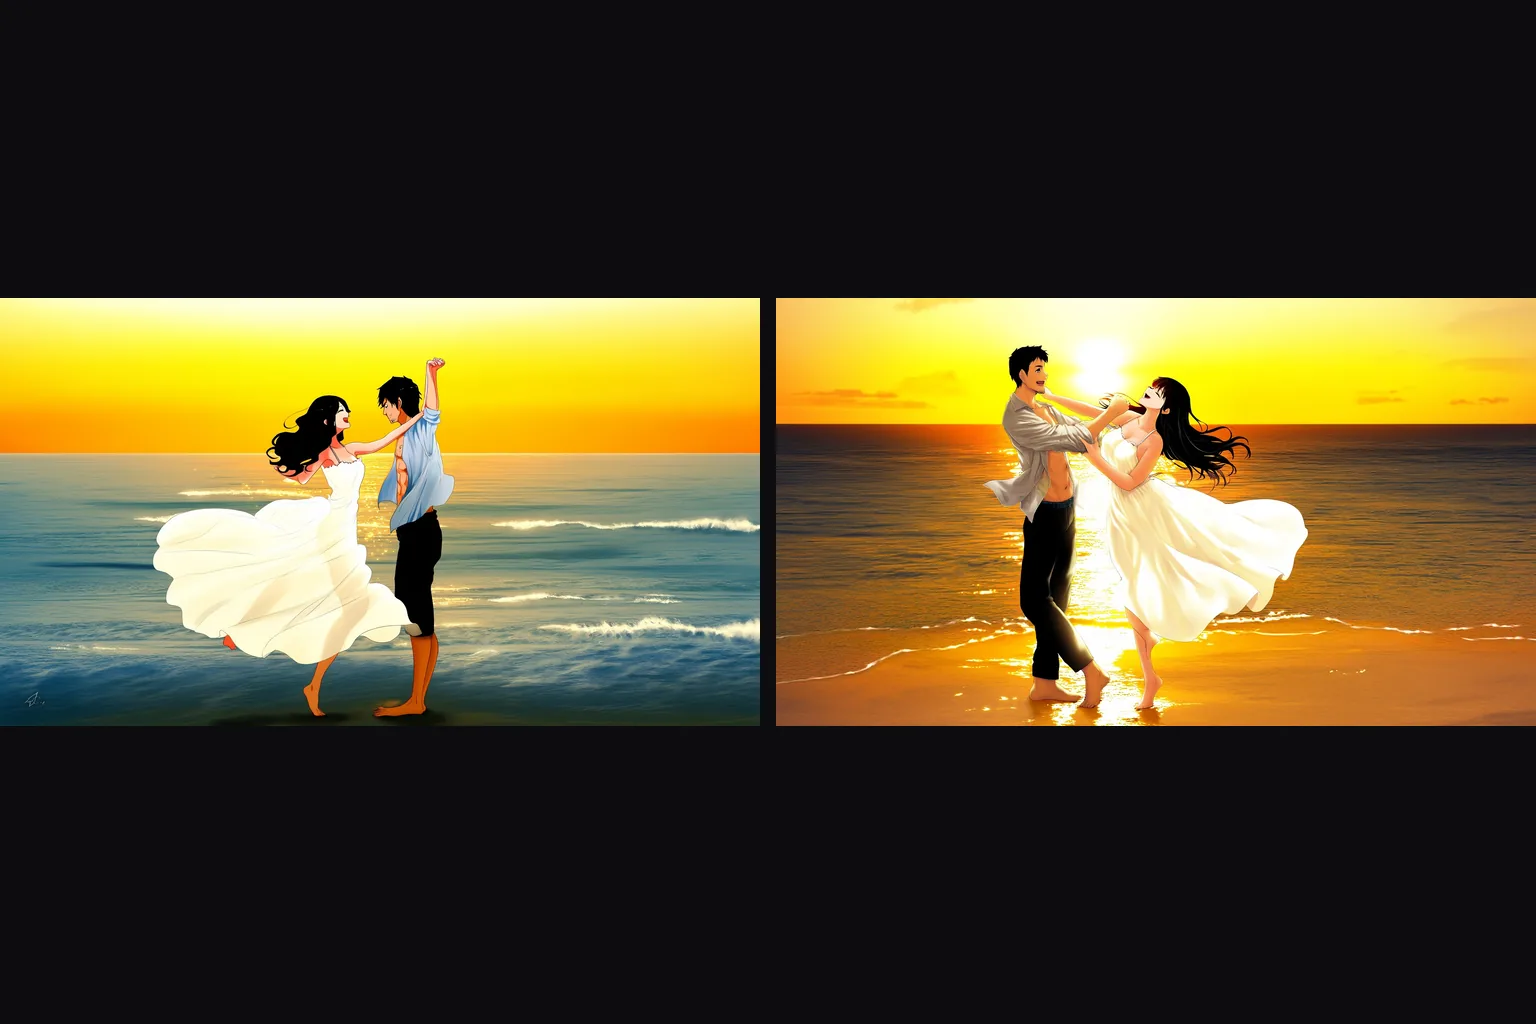
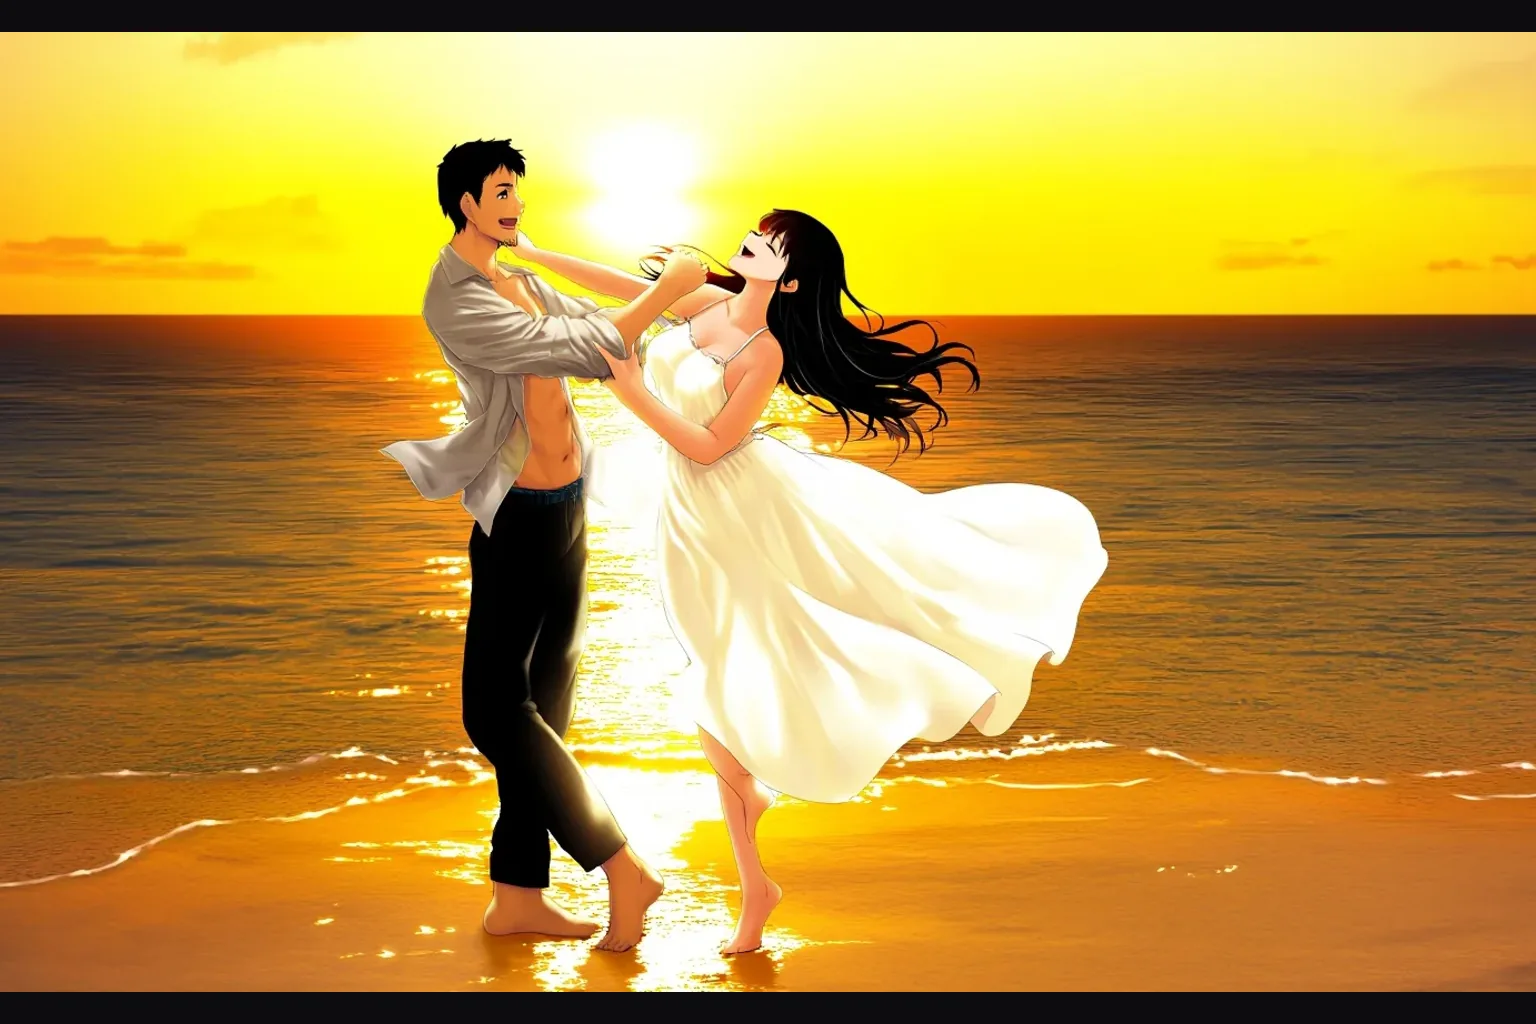
    Setzen Sie bei zwei Figuren zuerst die Tags für die Personenzahl und geben Sie dann jeder ein Outfit in einer eigenen Wendung. Im Strandpaar blieben ihr weißes Sommerkleid und sein offenes Leinenhemd in unseren Läufen bei der richtigen Person.

  • Verkürzung und Bewegung anfordern

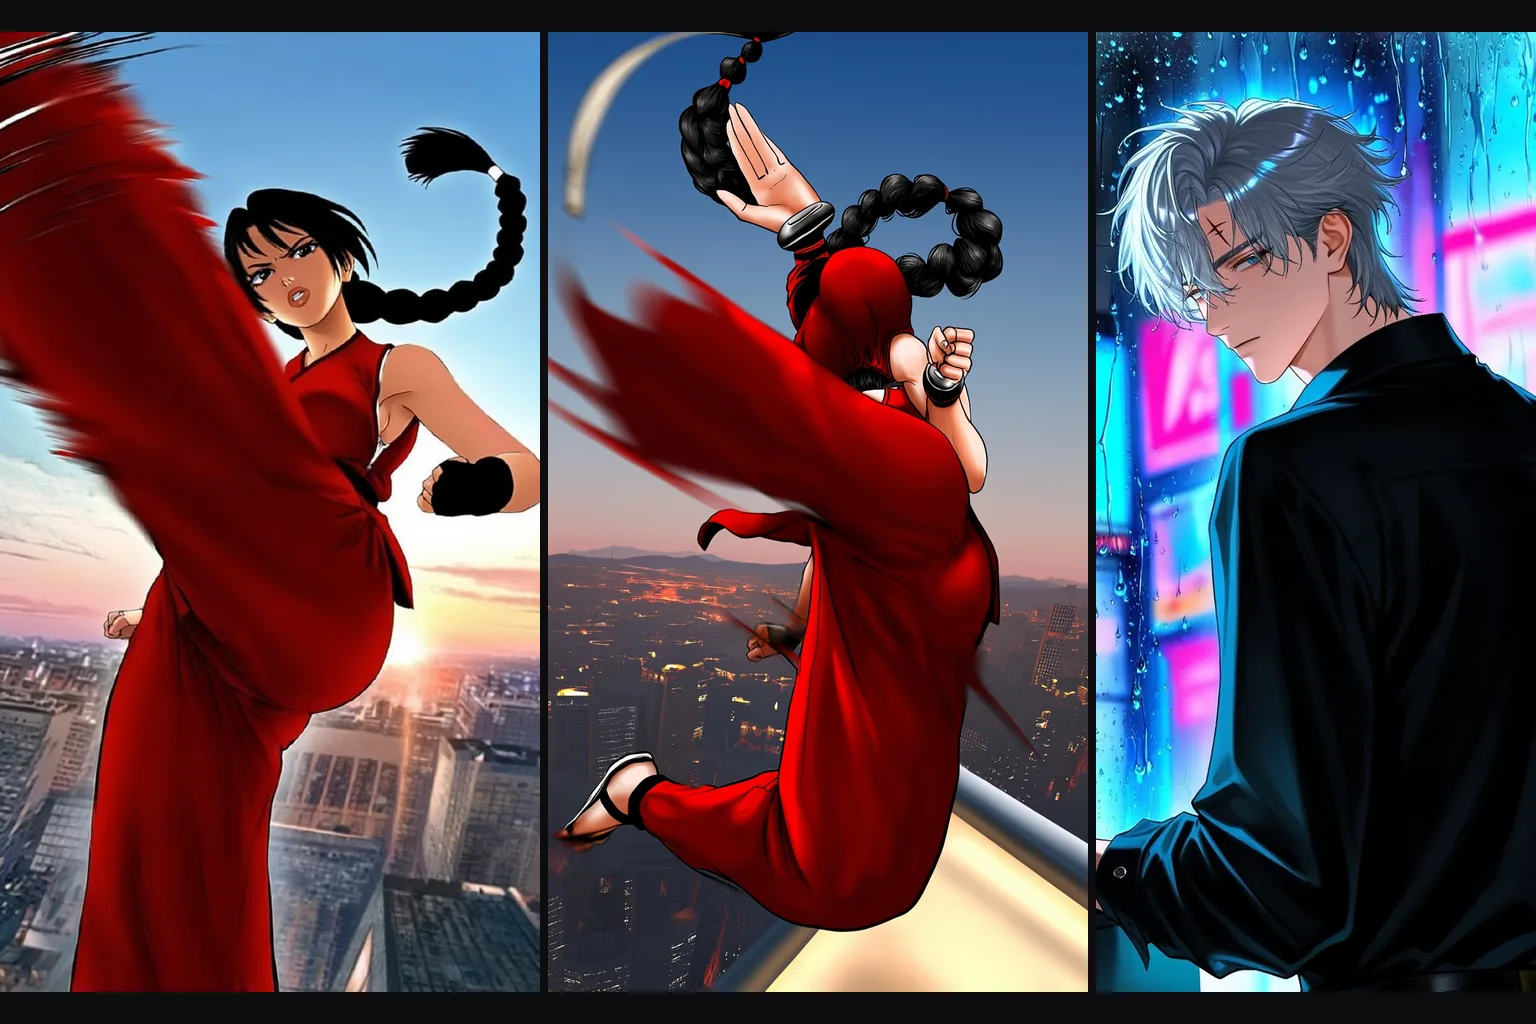
    „Foreshortening, dynamic angle, motion lines“ in einem hohen 9:16-Format ergab einen fliegenden Tritt in Richtung Betrachter. Action ist die unzuverlässigste Ecke, rechnen Sie also mit neuen Würfen: Unser zweiter Seed desselben Prompts verhedderte ein Bein.

  • Das Format wählen

    Neun Verhältnisse, alle um ein Megapixel: 1:1 sind 1024 x 1024, 3:4 sind 960 x 1280, 3:2 sind 1344 x 896, 16:9 sind 1536 x 864 und 21:9 sind 1536 x 656, die Hochformate jeweils gespiegelt. Verhältnis und Ausgabeformat ändern den Preis nie.

Wer Neta Lumina nutzt

  • Ein Key Visual im Mondlicht aus einem Prompt

    Key-Visual- und Poster-Künstler

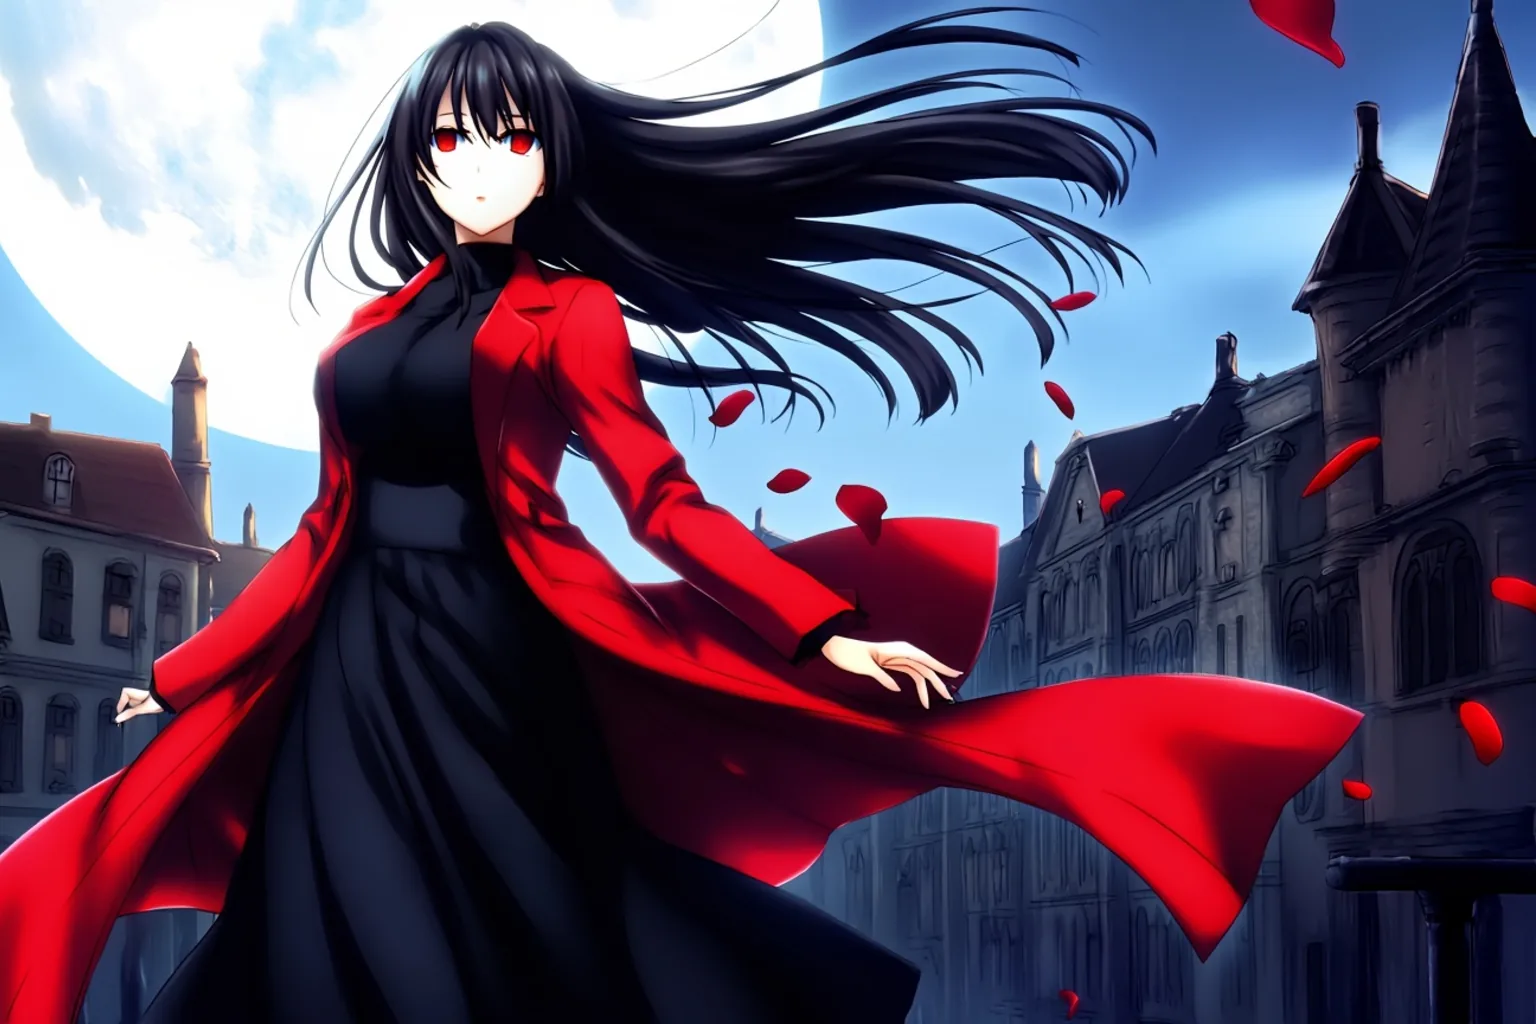
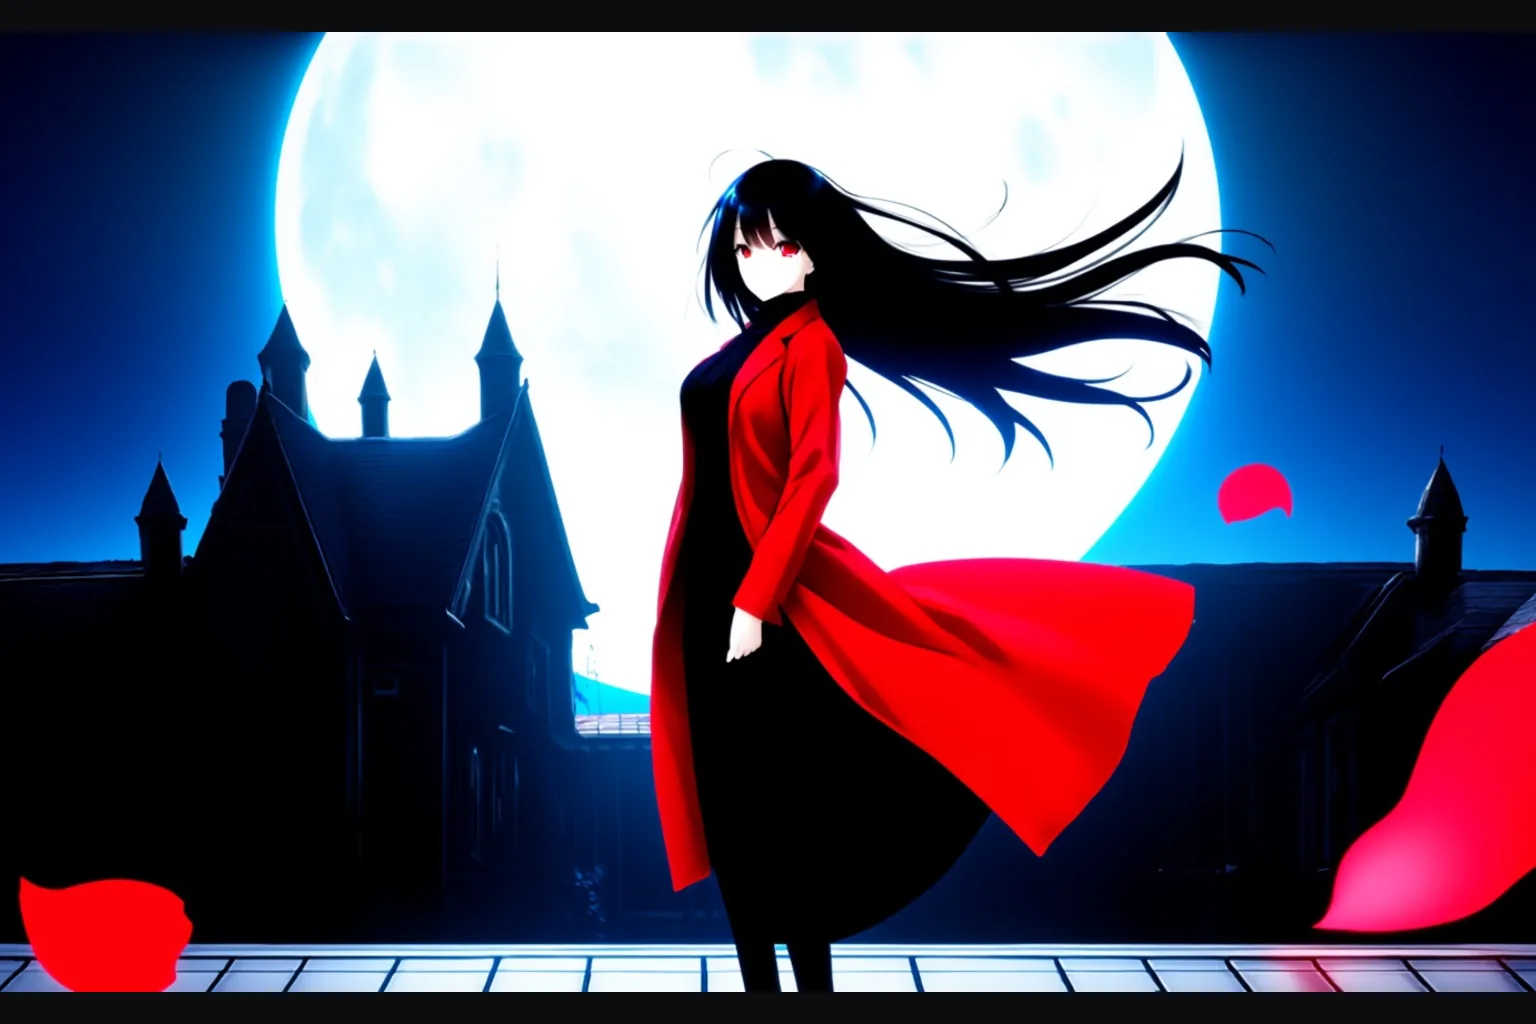
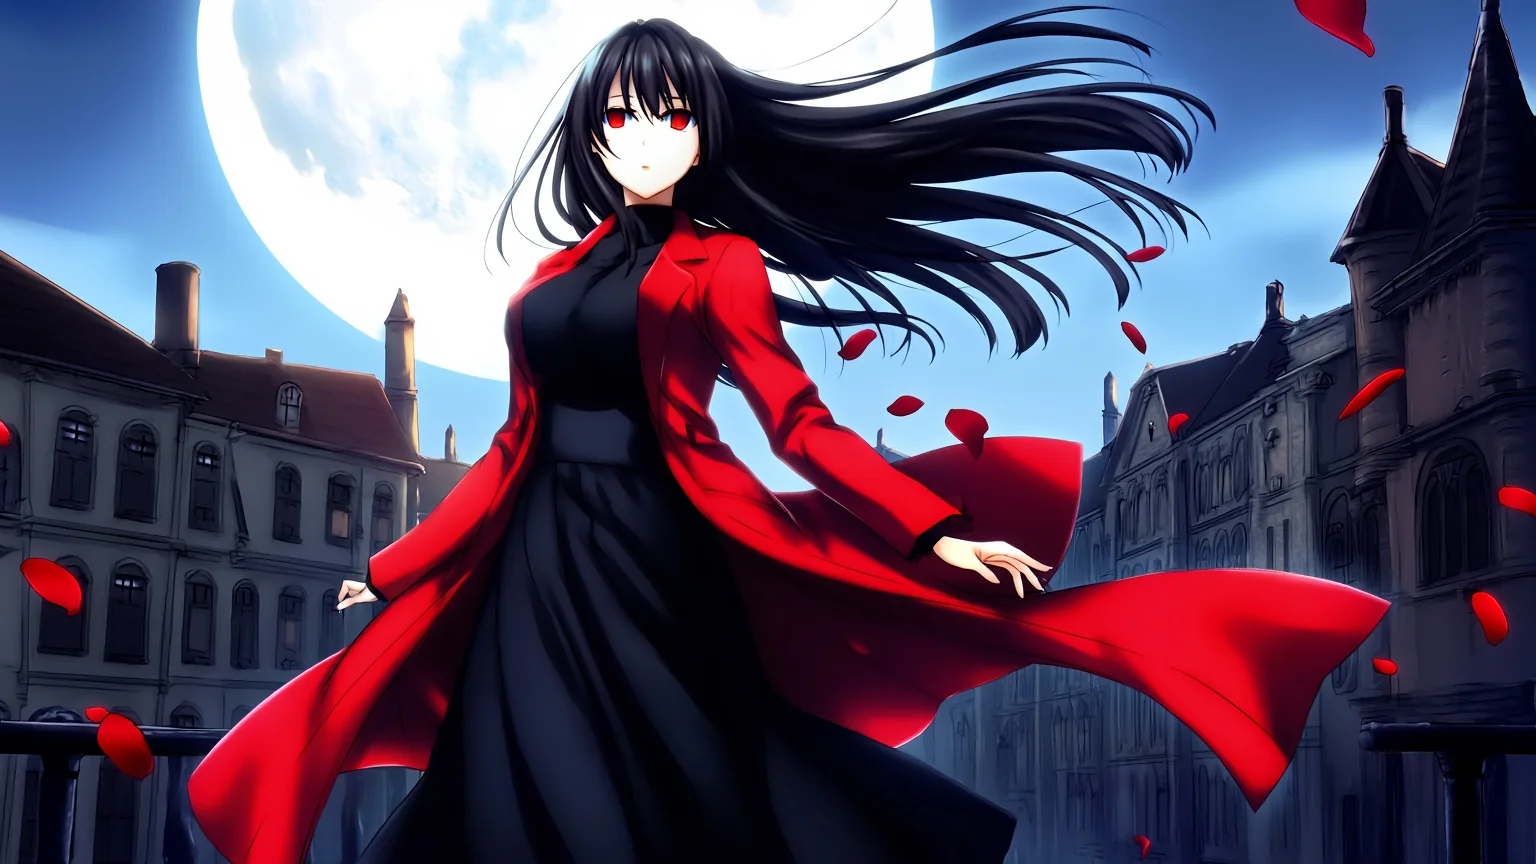
    Ein Key Visual im Mondlicht aus einem Prompt

    Eine schwarzhaarige erwachsene Frau in einem wehenden purpurroten Mantel auf einem mondbeschienenen Dach einer alten europäischen Stadt, hinter ihr ein riesiger Vollmond, Rosenblätter im Wind, Totale. Tags legen Look und Licht fest; derselbe Prompt mit anderen Seeds ergab andere Kompositionen derselben Idee.

  • Hohe Action-Bilder für Smartphones

    Comic- und Storyboard-Zeichner

    Hohe Action-Bilder für Smartphones

    Zwei Seeds eines fliegenden Tritts auf einem Dach in 9:16 und das Porträt am Neonfenster in 2:3. Hohe Formate passen zu Smartphone-Displays und Comic-Panels; würfeln Sie den Seed neu, wenn sich eine Gliedmaße verheddert.

  • Eine Figur, viele Varianten

    Character-Designer

    Eine Figur, viele Varianten

    Halten Sie die Tags fest und ändern Sie nur den Seed, um dieselbe Pianistin in verschiedenen Posen zu sehen. Ändern Sie dann einen Tag nach dem anderen, um Outfits und Licht für dieselbe Figur auszuprobieren.

  • Breite Szenen für Banner

    Banner- und Breitformat-Designer

    Breite Szenen für Banner

    Ein Paar, das bei Sonnenuntergang barfuß am Meeresrand tanzt, in 16:9, mit glitzerndem Himmel und Wellen. Für Banner gehen Sie mit 21:9 noch breiter, das sind 1536 x 656.

Vom ersten Tag zur fertigen Illustration mit Neta Lumina

  1. Mit dem Standardanfang starten

    „masterpiece, best quality, anime illustration“, dann die Personenzahl, dann die Figur.

  2. Outfit, Pose, Kamera und Licht ergänzen

    Tags für den Look; ein Satz für Kameraposition und Lichtrichtung.

  3. Das Verhältnis wählen und einmal laufen lassen

    Wählen Sie das Format passend zum Ort, an dem das Bild landet, und legen Sie den Seed fest.

  4. Einen Tag nach dem anderen ändern

    Behalten Sie den Seed und tauschen Sie ein einziges Detail, um Outfits und Licht zu erkunden.

  5. Die schiefe Ecke neu würfeln

    Ein verirrtes Gekritzel, ein verpixelter Fleck oder eine verhedderte Gliedmaße lässt sich mit einem neuen Seed beheben, denn es gibt keinen Negativ-Prompt.

Neta Lumina-Prompts zum Kopieren

  • Pianistin im Kerzenlicht

    Reine Tags: Qualität, Personenzahl, Figur, Abendkleid, Raum und Licht. Seed 5 in 3:4.

    masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smile
  • Neonfenster in Sätzen

    Überhaupt keine Tags. Seed 2 in 2:3.

    An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.
  • Sonnenuntergangstanz zu zweit

    Zuerst die Tags für die Personenzahl, dann jedes Outfit in einer eigenen Wendung. Seed 2 in 16:9.

    masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shot

Weitere Fragen zu Neta Lumina

Nutzen Sie es für Key-Art mit Tags

Beginnen Sie mit den Qualitäts-Tags und einer Personenzahl, ergänzen Sie Figur, Outfit und Pose als Tags und beschreiben Sie Kamera und Licht in einem Satz.

Halten Sie den Seed fest, während Sie einen Tag nach dem anderen ändern, lassen Sie Varianten parallel laufen, weil jedes Bild etwa 40 Sekunden braucht, und würfeln Sie jedes Bild mit verirrtem Gekritzel oder verhedderter Gliedmaße neu.