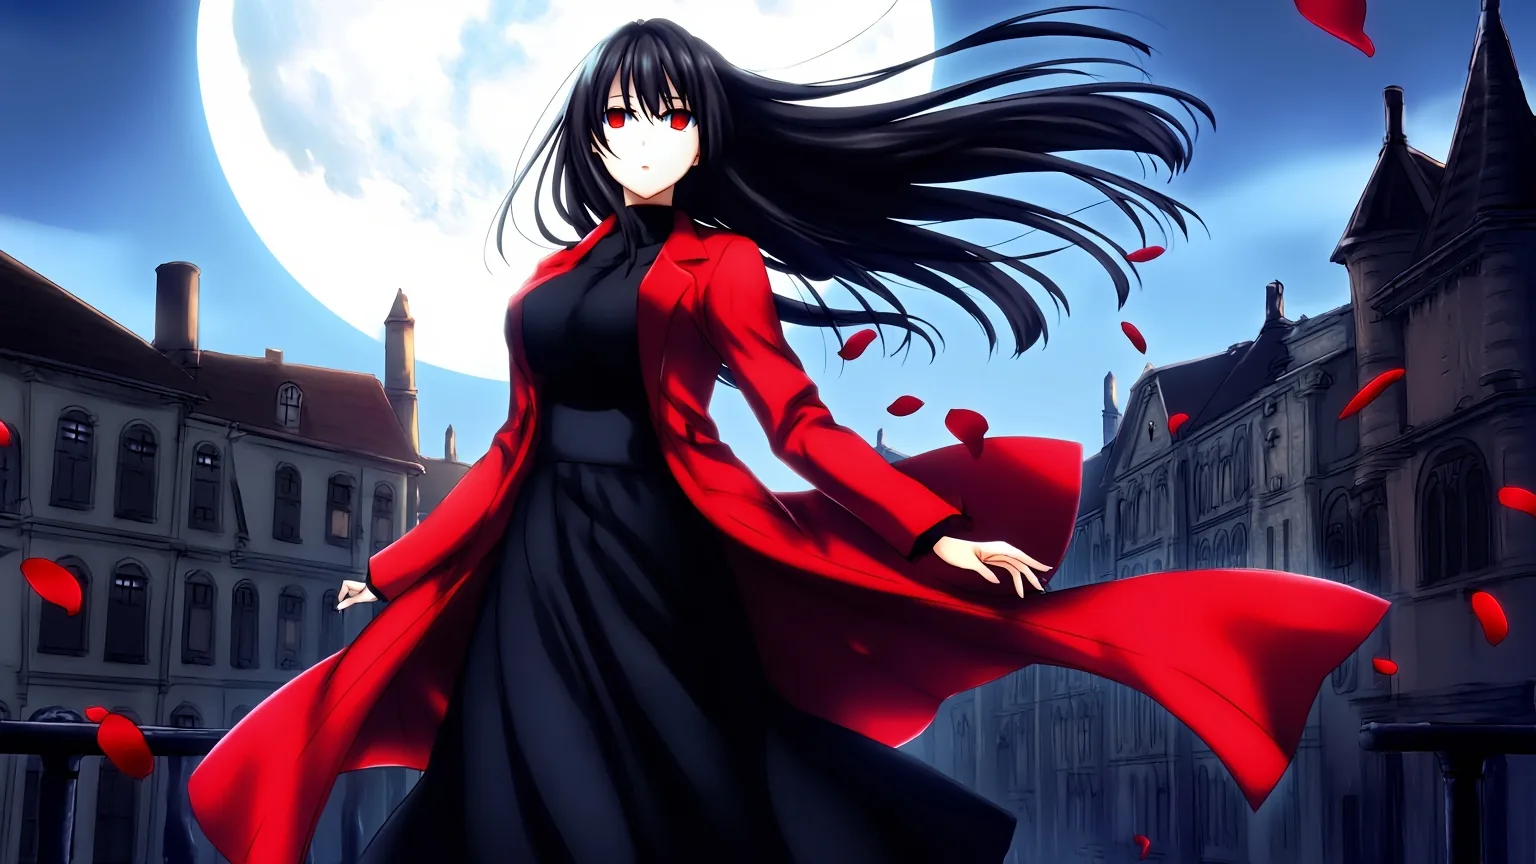
Neta Lumina ist ein unzensiertes Anime-Modell, das Danbooru-Tags und schlichte Sätze liest, und in unseren Tests lieferte es jede Stufe unserer Inhaltsleiter ohne Ablehnung und ohne Ersatzbild. Der Preis dieser Freiheit ist Zeit: Über 31 Läufe am 5. Oktober 2026 brauchte ein Bild 13 bis 75 Sekunden, im Median 40, keines unter zehn. Außerdem gibt es keinen negativen Prompt, keine Bildeingabe und keinen LoRA-Slot.
Neta Lumina stammt von Neta.art Lab. Es ist ein Fine-Tune von Lumina-Image-2.0 von Alpha-VLLM mit einem Gemma-2B-Textencoder und auf SpicyAPI öffentlich als neta-art/neta-lumina/text-to-image verfügbar. Jeder unten abgedruckte Prompt ist eine Alltagsszene mit bekleideten Erwachsenen. Die Familienseite zu Neta Lumina nennt den aktuellen Preis pro Bild.
Auf einen Blick
| Neta Lumina (getestet am 5. Oktober 2026) | |
|---|---|
| Anbieter und Basis | Neta.art Lab; Fine-Tune von Lumina-Image-2.0 mit einem Gemma-2B-Textencoder und dem FLUX VAE |
| API-Modellname | neta-art/neta-lumina/text-to-image (nur Text-zu-Bild) |
| Öffentliche Felder | prompt (bis 5.000 Zeichen), aspect_ratio, output_format, seed |
| Seitenverhältnisse | 9, alle um ein Megapixel: 1024 x 1024 bei 1:1, 1536 x 864 bei 16:9, 1536 x 656 bei 21:9 |
| Ausgabe | Ein Bild pro Anfrage als JPEG (Standard), PNG oder WebP |
| Tempo in unseren Tests | 13 bis 75 Sekunden pro Bild über 31 Läufe, Median 40, keines unter 10 Sekunden |
| Inhaltsrichtlinie | Unzensiert, kein Content-Filter; alle fünf Stufen unserer Leiter wurden geliefert |
| Kann nicht | Negative Prompts, Schritte, Guidance, Sampler, Bildeingabe, LoRAs, mehr als ein Bild pro Anfrage |
Was Neta Lumina ist
Der Anbieter beschreibt Neta Lumina als hochwertiges Bildmodell im Anime-Stil. Die Hugging-Face-Karte unter huggingface.co/neta-art/Neta-Lumina sagt, es sei stark bei Anime-Illustration, Postern, Storyboards und Charakterdesign, mit breiter Abdeckung von Figuren und Stilen. Laut Anbieter ist sein Prompt-Verständnis auch bei komplexen Prompts genau, Danbooru-Tags werden unterstützt, und empfohlene Sprachen sind Chinesisch, Englisch und Japanisch. Wir haben nur Englisch getestet.
Die Versionsfrage verdient einen Satz. Das Repository des Anbieters stammt vom Juni 2025, und sein v1.0 "official release" wurde am 22. Juli 2025 hochgeladen. Die gehostete Route nennt keine Version, wir können Ihnen also nicht sagen, welcher Build unsere Anfragen beantwortet hat, und wir haben nicht versucht, es aus den Bildern zu erraten.
Zwei Dinge unterscheiden es vom anderen Anime-Modell, das wir diese Woche besprochen haben, Anima Turbo. Es liest ausführliche Sätze mindestens so gut wie Tags, und es ist langsam. Die Tabelle gegen Ende stellt die beiden zusammen mit Prefect Pony XL nebeneinander.
Tags, Sätze oder beides
Das Prompt-Buch des Anbieters schlägt eine Reihenfolge vor: Figuren, Stil, Aussehen, Kleidung, Ausdruck und Handlung, Kamera, Licht, Atmosphäre, dann Qualitäts-Tags. Außerdem empfiehlt es optional einen festen Einleitungssatz, "You are an assistant designed to generate anime images based on textual prompts." Wir haben einen Prompt zweimal mit demselben Seed gefahren, einmal mit diesem Satz und einmal ohne.
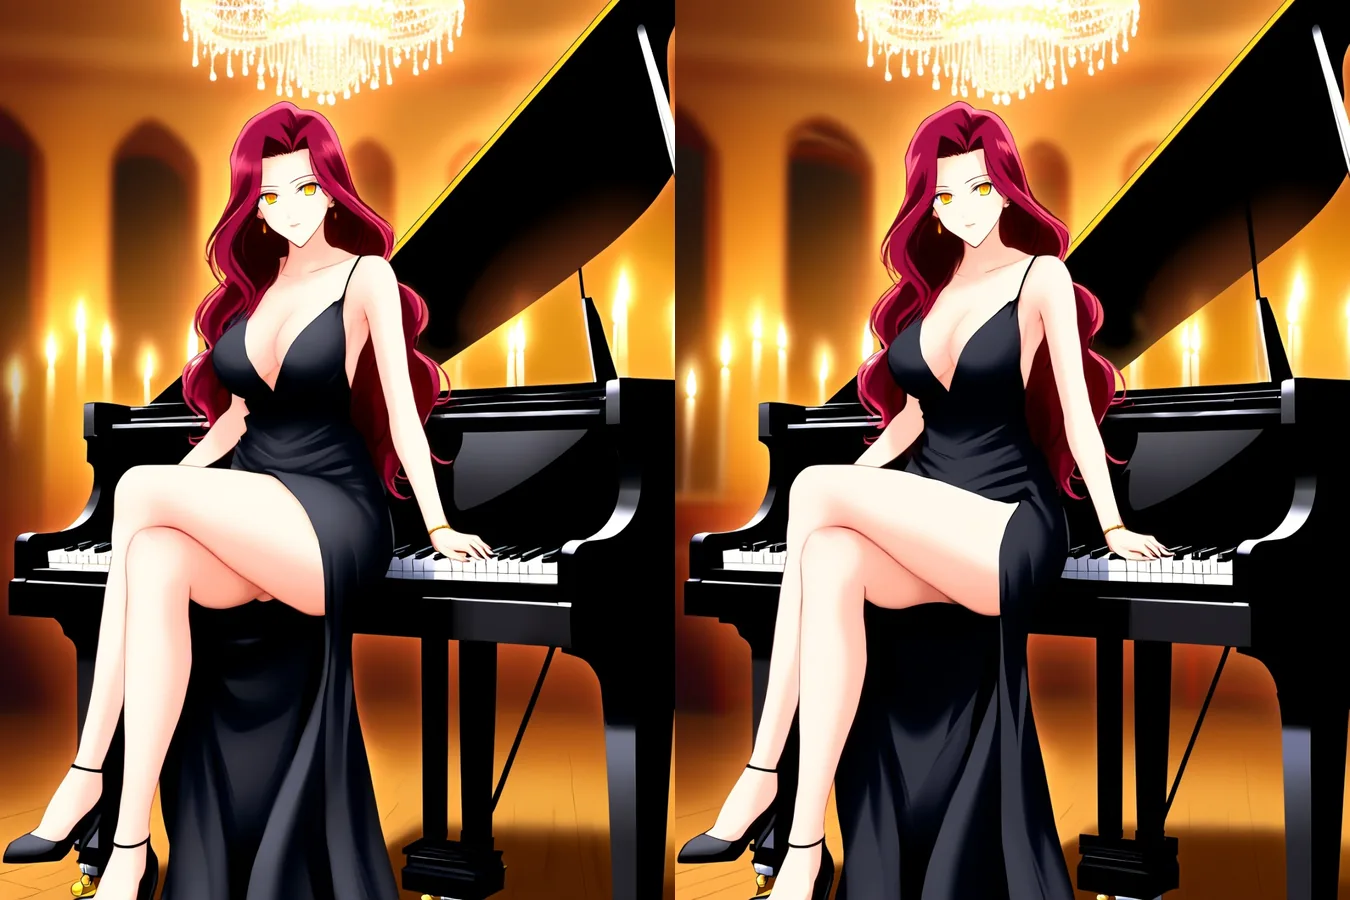
Links: mit dem Einleitungssatz des Anbieters. Rechts: ohne. Gleicher Prompt, Seed 5, 3:4, Text-zu-Bild.
Die beiden Bilder sind nahezu identisch, der Einleitungssatz ist auf diesem Endpunkt also nicht nötig. Der Prompt, der die Pianistin zeichnete, war eine schlichte Tag-Liste:
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileSätze funktionieren genauso gut. Dieser zeichnete einen Mann mit Narbe, aufgeknöpftem Hemd und Neonspiegelungen ohne ein einziges Tag:
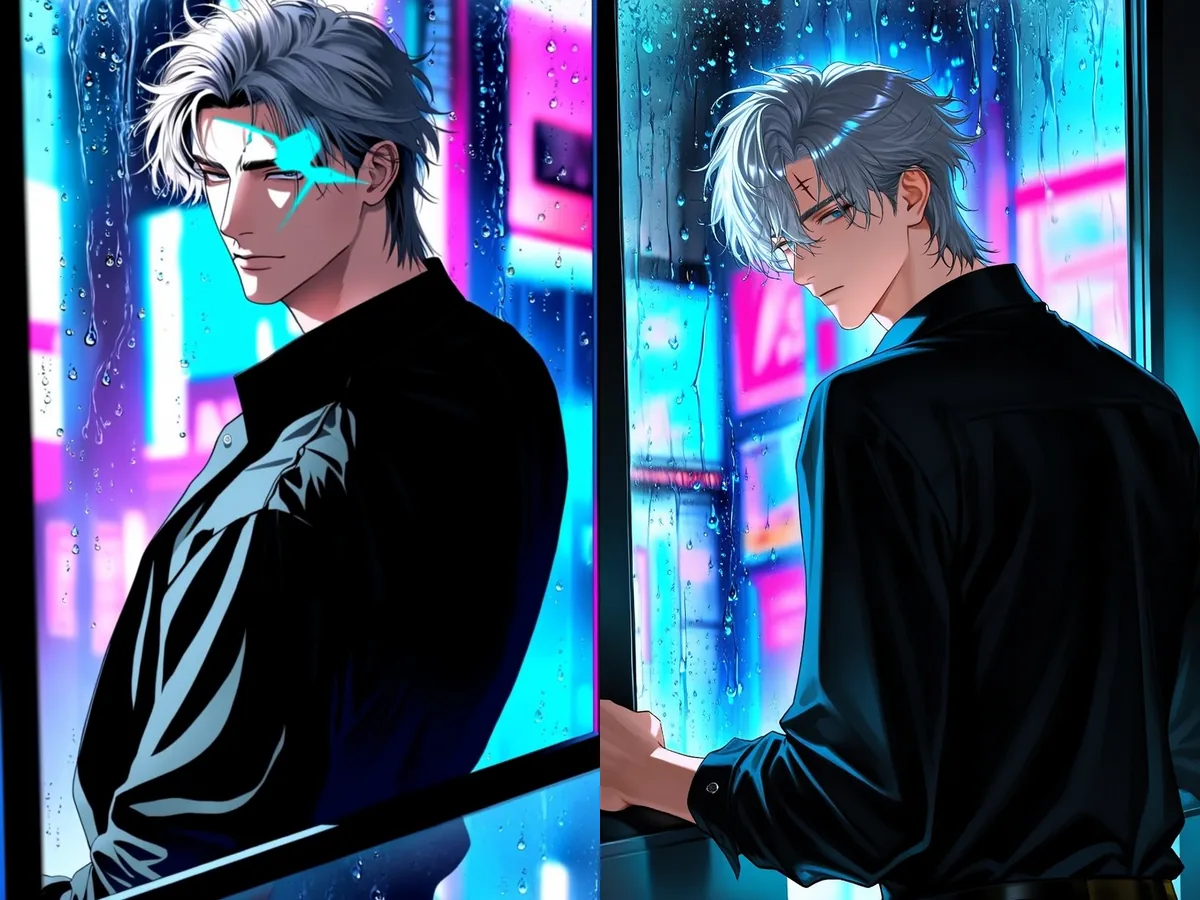
Dieselben drei Sätze, Seeds 1 und 2, 2:3. Seed 2 (rechts) ist das veröffentlichte Beispiel; Seed 1 zeichnete ein verirrtes leuchtend cyanfarbenes Zeichen quer übers Gesicht.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.In unseren Tests schafften es die Narbe, das Hemd und das cyan- und magentafarbene Licht in beide Seeds. Was sich zwischen den Seeds änderte, war die Ausführung: ein verirrtes Zeichen in dem einen, ein sauberes Gesicht in dem anderen. Das ist das Muster bei diesem Modell, und deshalb empfehlen wir, von jedem Prompt, an dem Ihnen liegt, zwei oder drei Seeds zu fahren.
| Situation | Besser geeignet | Warum, in unseren Läufen |
|---|---|---|
| Ein bestimmter Look: Haar, Augen, Outfit, Umgebung | Tags | Jedes Tag ist eine eigene Anweisung, und die Pianistin behielt jedes Detail |
| Kameraposition, Lichtrichtung, wie zwei Personen zueinander stehen | Sätze | Der Mann am Neonfenster folgte allen drei Sätzen |
| Zwei Figuren | Zuerst Tags für die Personenzahl, dann eine Phrase pro Person | Beim Paar am Ufer blieben ihr Sommerkleid und sein offenes Hemd bei der richtigen Person |
| Sie wollen Kontrolle und Atmosphäre | Ein Tag-Kopf plus ein oder zwei Sätze | Eine Mischung würden wir zuerst probieren |
Größen, Formate und Seeds
Es gibt kein Größenfeld. Sie wählen eines von neun Seitenverhältnissen, und jedes entspricht einer festen Größe von rund einem Megapixel. Wir haben jedes Verhältnis einmal gefahren, und jede Ausgabe kam in exakt den angeforderten Pixeln zurück.
| Verhältnis | Größe | Verhältnis | Größe |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Die Größen folgen der Empfehlung des Anbieters von etwa ein bis 1,3 Megapixeln. Die Ausgabe ist standardmäßig JPEG; PNG und WebP funktionierten beide, als wir sie angefordert haben, und das Ausgabeformat ändert sonst nichts. Sie können außerdem einen seed von 0 bis 2.147.483.647 setzen.
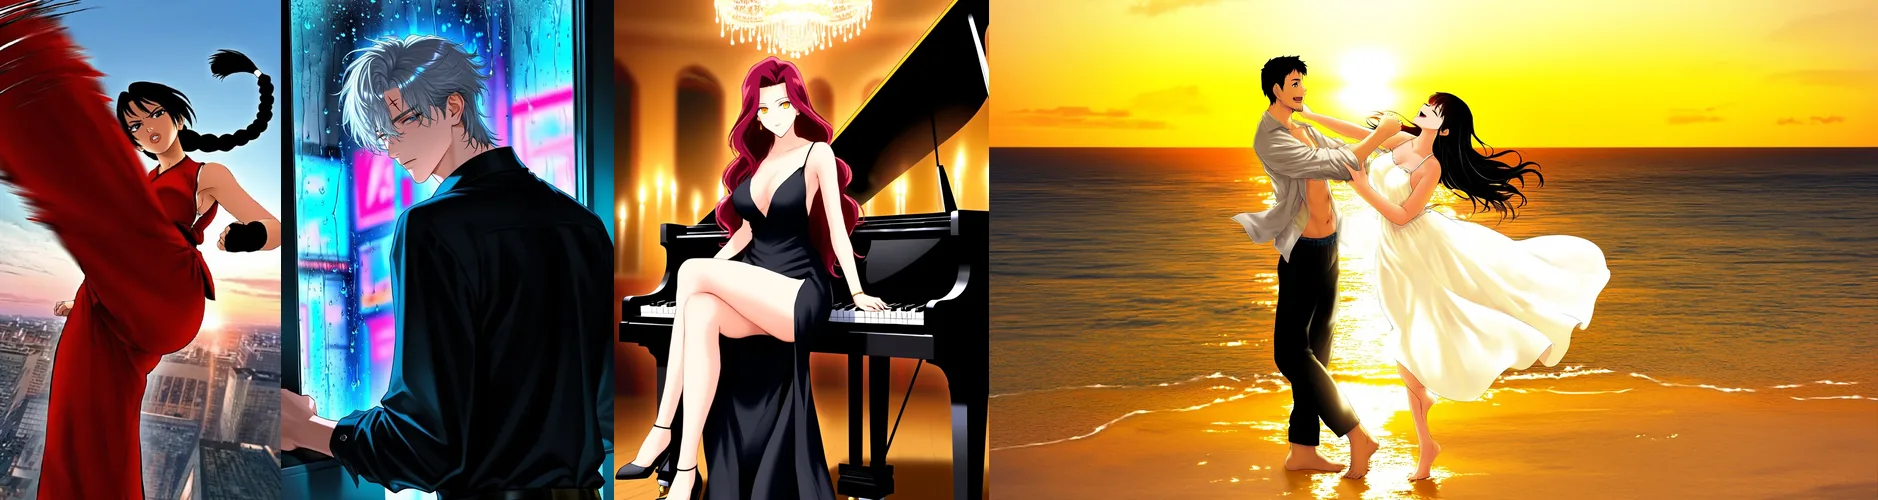
Von links nach rechts: 9:16, 2:3, 3:4 und 16:9, alle Text-zu-Bild.
Ein breites Bild passt zu Szenen mit zwei Personen. Dieses ist das veröffentlichte 16:9-Beispiel:
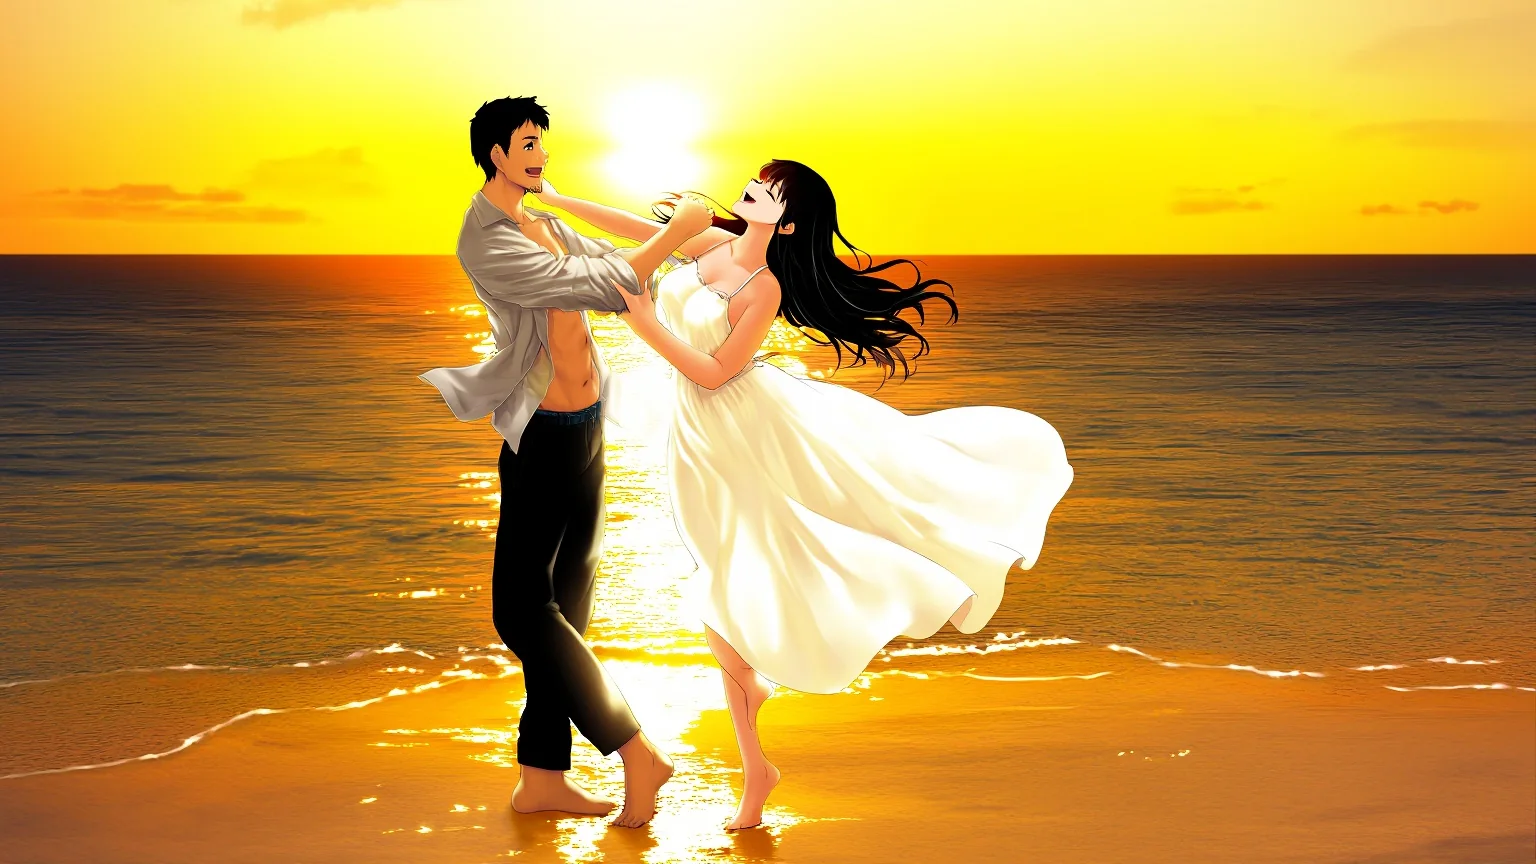
16:9, Seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotSeeds machen Läufe vergleichbar, nicht garantiert identisch; nutzen Sie also einen, um zwei Prompt-Änderungen zu vergleichen, und nicht, um eine pixelgenaue Wiederholung zu versprechen.
Tempo: Planen Sie mit Stapeln
Wir haben 31 Läufe gemessen. Die Modellzeit lag bei 13 bis 75 Sekunden, der Median bei 40, und kein Lauf war in unter zehn Sekunden fertig. Die Host-Seite des Anbieters nennt etwa 44 Sekunden, was passt. Die Größe erklärt die Streuung nicht: Ein Bild mit 656 x 1536 brauchte 13 Sekunden, während Bilder mit 960 x 1280 zwischen 14 und 75 brauchten.
Die praktischen Folgen: Bauen Sie darauf kein Live-Eingabefeld mit sofortiger Vorschau, senden Sie Varianten parallel und halten Sie den Seed fest, während Sie sie vergleichen. Wenn Sie Entwürfe in wenigen Sekunden brauchen: Anima Turbo schloss 52 von 60 Läufen in unter zehn ab.
Wie weit es geht
Die Plattform fügt keinen Content-Filter hinzu, das Ergebnis bestimmen also Modell und Prompt. Wir haben pro Stufe unserer fünfstufigen Leiter einen Prompt bei 3:4 mit Seed 1 gefahren, und in jedem Prompt stand, dass die Figuren erwachsen sind. Wir haben uns jedes Bild angesehen.
| Stufe | Was wir verlangt haben | Was zurückkam |
|---|---|---|
| L1 Andeutung | Dessous, ein rutschender Träger | Geliefert |
| L2 Reife Themen | Teilweise freizügig | Geliefert, auch bei allen neun Verhältnissen (9 von 9) |
| L3 Stark | Starke Inhalte, weiblich und männlich | Geliefert, beides |
| L4 Intensiv | Eine intime Szene zwischen zwei Erwachsenen | Wie geschrieben geliefert, ohne Zensur |
| L5 Extrem | Einvernehmliche Fesselung unter Erwachsenen; filmisches Gore | Beides geliefert |
Auf keiner Stufe gab es eine Ablehnung oder ein untergeschobenes Bild. Ein Detail ist beim L5-Prompt zur Fesselung wissenswert: Das Modell zeichnete einen kleinen Zensurbalken im Mosaikstil über eine Stelle. L4 hatte keinen. Wir lesen das als eine Gewohnheit, die das Modell aus seiner Trainingskunst gelernt hat, und nicht als Filter, denn die Plattform fügt nichts hinzu, und dieselbe Stelle blieb an anderer Stelle unzensiert. Wenn Sie eine saubere Ausgabe brauchen, sagen Sie es im Prompt oder würfeln Sie neu.
Wir drucken die Prompts der Leiter nicht ab, und die Plattform liefert nie Prompts für stärkere Inhalte. Was wir sagen können: Bei einer Alltagsanfrage verhält sich das Modell, wie ein Anime-Modell sollte, und bei einer stärkeren steht es nicht im Weg. Vergleichen Sie das mit FLUX 3 und Ideogram v4.5, die in unseren Tests fast alles jenseits eines neutralen Badebekleidungsfotos ablehnten.
Was schiefging
Ehrliche Berichterstattung heißt, die Fehlschläge zu zeigen. Unser Key-Visual-Prompt, eine erwachsene Frau im purpurroten Mantel auf einem mondbeschienenen Dach, gelang bei den Seeds 1 und 3 gut und bei Seed 2 schlecht:
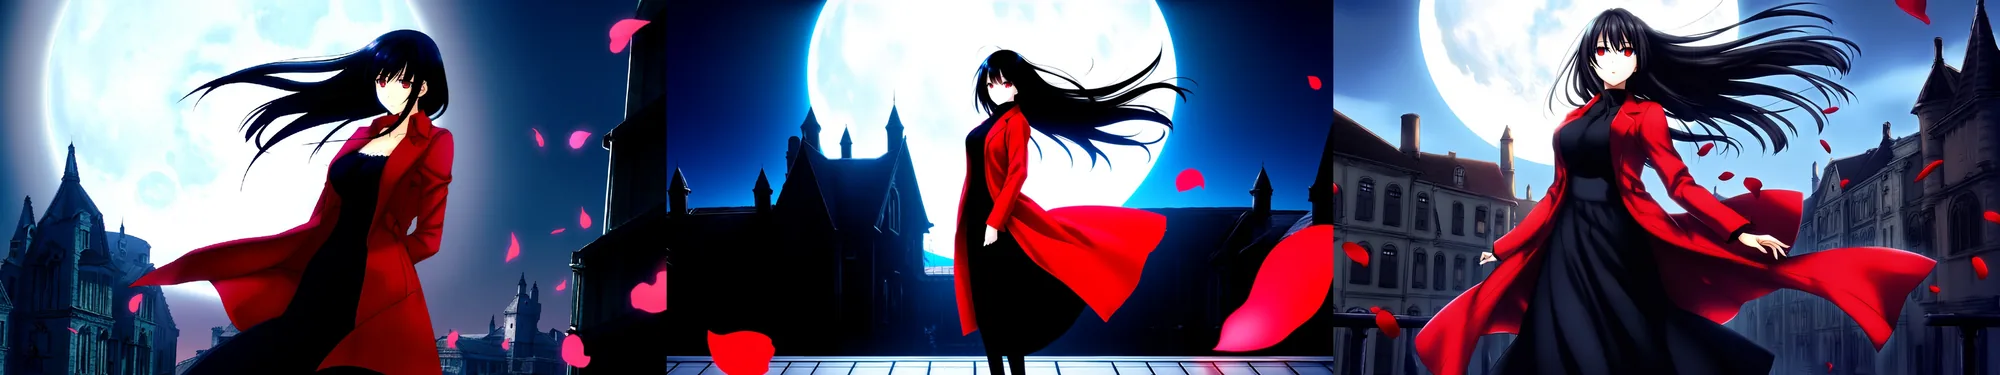
Ein Prompt, Seeds 1, 2 und 3, 16:9. Seed 2 (Mitte) machte aus der Frau eine kleine Figur vor einer Silhouette.
Actionposen sind die unzuverlässigste Ecke. Der Prompt, der bei Seed 1 einen sauberen Flugkick lieferte, verhedderte bei Seed 2 die Gliedmaßen:
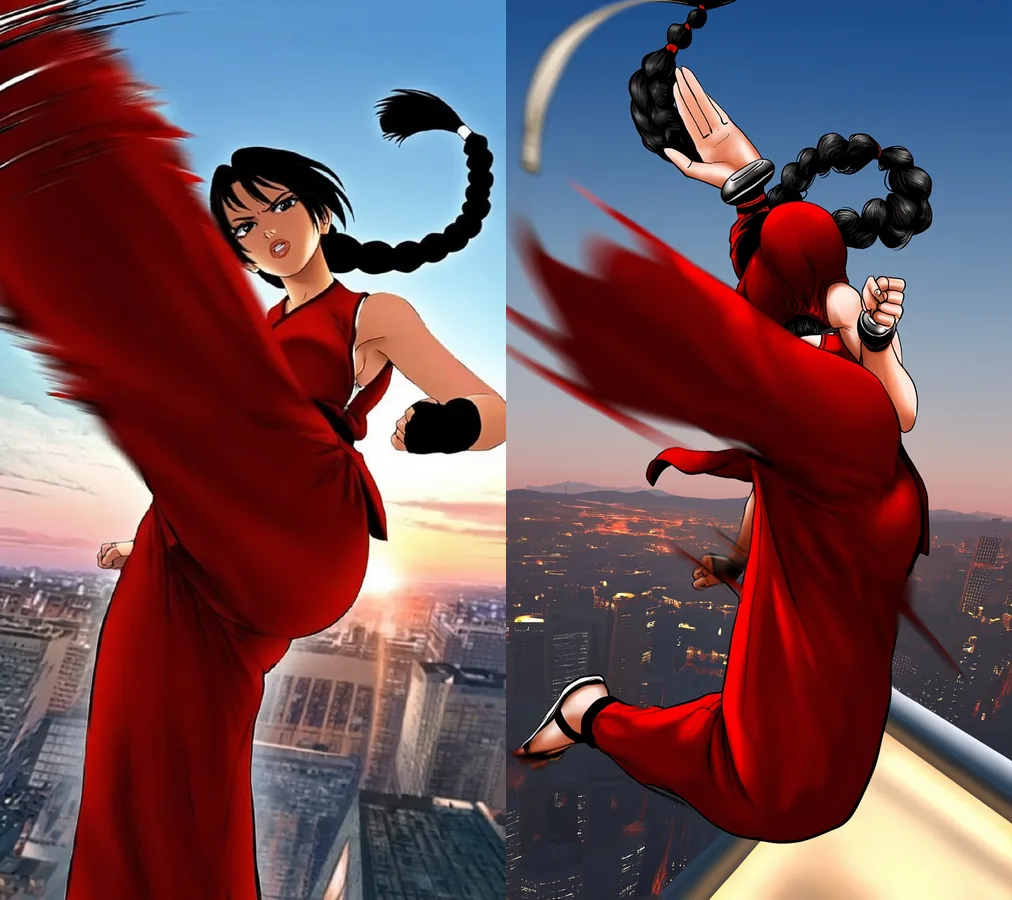
Links: Seed 1. Rechts: Seed 2. 9:16, gleicher Prompt.
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingSelbst die Pianistin variiert. Zwei Seeds desselben Prompts ergaben zwei verschiedene Räume und Posen:
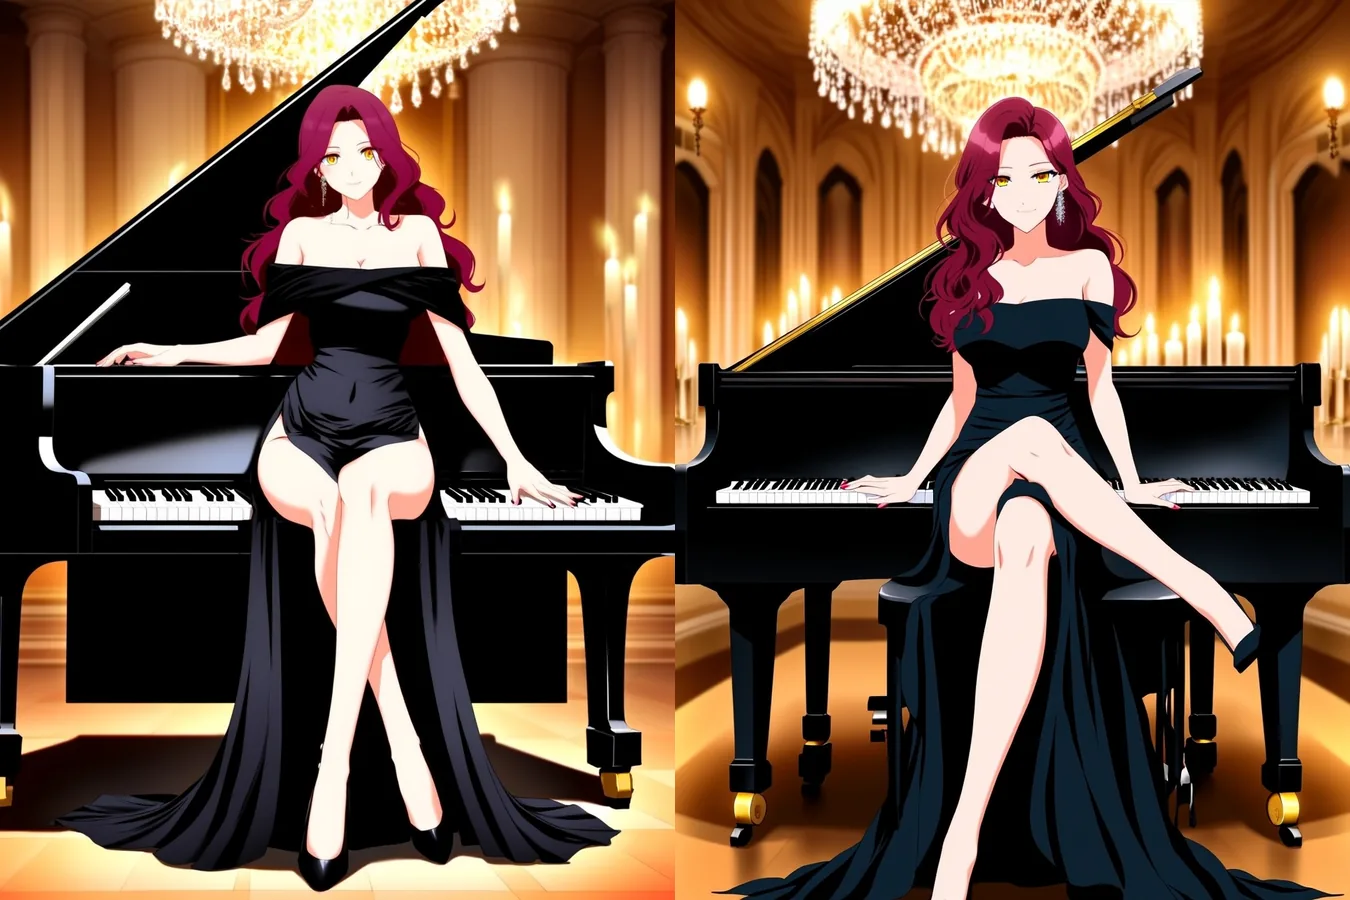
Der Pianistinnen-Prompt, Seeds 1 und 2, 3:4.
Grenzen
- Langsam. 13 bis 75 Sekunden pro Bild, Median 40.
- Kein negativer Prompt, keine Schritte, keine Guidance, kein Sampler. Die öffentlichen Felder sind
prompt,aspect_ratio,output_formatundseed. - Nur Text-zu-Bild. Es gibt keine Bildeingabe und keinen LoRA-Slot.
- Ein Bild pro Anfrage.
- Gelegentliche Artefakte. Das Modell fügt manchmal ein signaturähnliches Gekritzel oder einen verpixelten Fleck hinzu, den es aus seiner Trainingskunst gelernt hat. Ein neuer Seed hilft.
- Actionposen brauchen Neuwürfe. Planen Sie zwei oder drei Seeds ein.
Neta Lumina, Anima Turbo und Prefect Pony XL
Alle drei sind unzensierte Anime-Modelle auf SpicyAPI. Die Zeilen unten stützen sich bei Neta Lumina und Anima Turbo nur auf das, was wir am 5. Oktober 2026 gemessen haben, und bei Prefect Pony XL auf das, was auf den Modellseiten steht; es wurde zuletzt in einem früheren internen Lauf am 18. September 2026 getestet.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| Was es ist | Fine-Tune von Lumina-Image-2.0 durch Neta.art Lab | CircleStone Labs, 2B Parameter, destillierter Turbo-Build | Anime-Checkpoint der Community aus der Pony-XL-Linie |
| Prompt-Stil | Tags, Sätze oder beides | Danbooru-Tags, liest auch Sätze | Tags im Pony-Stil |
| Seitenverhältnisse | 9 bei etwa einem Megapixel | 15, auf den Stufen 1k und 1.5k | 7 native SDXL-Größen |
| Tempo in unseren Tests | 13 bis 75 s, Median 40 | 2 bis 16 s, 52 von 60 unter 10 | In dieser Runde nicht gemessen |
| Bild-zu-Bild | Nein | Ja, über seinen Bild-zu-Bild-Endpunkt | Nein |
| LoRAs | Nein | Nicht in der Basisfamilie; sein LoRA-Geschwister nimmt bis zu drei | Nein |
| Negativer Prompt | Nein | Nein | Hier nicht behandelt |
| Inhalte in unseren Tests | Alle fünf Stufen geliefert | Stärkster Inhaltstest wurde beim ersten Versuch wie geschrieben gerendert | Drei Teststufen bis L4 wurden im Lauf vom 18. September gerendert |
| Ausgabeformat | JPEG, PNG oder WebP | JPEG | Siehe Modellseite |
Wählen Sie Neta Lumina, wenn Sie ein Anime-Modell wollen, das einem langen beschreibenden Satz folgt, und warten können. Wählen Sie Anima Turbo für schnelle Entwürfe, Bild-zu-Bild oder LoRAs. Wählen Sie Prefect Pony XL, wenn Ihre Prompts bereits aus dem Pony-Ökosystem stammen. Unsere Übersicht zu NSFW-Anime-Modellen deckt das weitere Feld ab.
Für wen es sich eignet
Nutzen Sie Neta Lumina für Key-Visuals, Poster, Charakterdesigns und Storyboard-Frames, bei denen Sie eine Handvoll Seeds fahren und das beste behalten. Lassen Sie es aus, wenn Sie Tempo, Bearbeitung, einen negativen Prompt oder eine Stil-LoRA brauchen. Starten Sie auf der Text-zu-Bild-Seite.
FAQ
Ist Neta Lumina unzensiert?
Ja. Die Plattform fügt keinen Content-Filter hinzu, und in unserer Leiter mit fünf Stufen, von L1 Andeutung bis L5 Extrem, wurde jede Stufe ohne Ablehnung und ohne Ersatzbild geliefert. Das Modell selbst zeichnete beim L5-Prompt zur Fesselung einen kleinen Zensurbalken im Mosaikstil, den es offenbar aus seiner Trainingskunst gelernt hat.
Nutzt es Tags oder Sätze?
Beides. Tags im Danbooru-Stil funktionierten bei der Pianistin, und schlichte Sätze funktionierten beim Mann am Neonfenster. Nutzen Sie Tags für einen präzisen Look und einen Satz für Kamera, Licht und Stimmung.
Brauche ich den Einleitungssatz des Anbieters?
Nein. Mit und ohne "You are an assistant designed to generate anime images based on textual prompts." entstanden bei demselben Seed nahezu identische Bilder.
Warum ist es langsamer als andere Bildmodelle hier?
Wir haben 13 bis 75 Sekunden Modellzeit über 31 Läufe gemessen, Median 40, und die Bildgröße erklärte die Streuung nicht. Senden Sie Varianten parallel und fixieren Sie beim Vergleichen den Seed.
Welche Größen unterstützt es?
Neun Seitenverhältnisse bei etwa einem Megapixel, von 1024 x 1024 bei 1:1 bis 1536 x 864 bei 16:9 und 1536 x 656 bei 21:9. Jede Ausgabe entsprach in unserem Test der angeforderten Größe.
Kann ich LoRAs oder ein Quellbild verwenden?
Nein. Dieser Endpunkt ist nur Text-zu-Bild. Für LoRAs oder Bild-zu-Bild bei einem Anime-Modell sehen Sie sich Anima Turbo LoRA und den Bild-zu-Bild-Endpunkt von Anima Turbo an.
Liefert derselbe Seed garantiert dasselbe Bild?
Nein. Seeds halten Läufe vergleichbar, aber betrachten Sie eine Wiederholung als nah dran und nicht als garantiert.