Neta Lumina è un modello anime senza censura che legge i tag Danbooru e le frasi semplici, e nei nostri test ha reso ogni livello della nostra scala di contenuti senza rifiuti e senza sostituzioni. Il prezzo di questa libertà è il tempo: su 31 esecuzioni del 5 ottobre 2026 un'immagine ha richiesto da 13 a 75 secondi, con una mediana di 40 e nessuna sotto i dieci. Inoltre non ha prompt negativo, né immagine in ingresso, né slot per LoRA.
Neta Lumina è realizzato da Neta.art Lab. È un fine-tune di Lumina-Image-2.0 di Alpha-VLLM con un text encoder Gemma 2B, ed è pubblico su SpicyAPI come neta-art/neta-lumina/text-to-image. Ogni prompt riportato qui sotto è una scena quotidiana con adulti vestiti. La pagina della famiglia Neta Lumina riporta il prezzo attuale per immagine.
In breve
| Neta Lumina (testato il 5 ottobre 2026) | |
|---|---|
| Editore e base | Neta.art Lab; fine-tune di Lumina-Image-2.0 con un text encoder Gemma 2B e il VAE di FLUX |
| Nome del modello API | neta-art/neta-lumina/text-to-image (solo testo in immagine) |
| Campi pubblici | prompt (fino a 5.000 caratteri), aspect_ratio, output_format, seed |
| Proporzioni | 9, tutte intorno a un megapixel: 1024 x 1024 a 1:1, 1536 x 864 a 16:9, 1536 x 656 a 21:9 |
| Output | Un'immagine per richiesta in JPEG (predefinito), PNG o WebP |
| Velocità nei nostri test | Da 13 a 75 secondi per immagine su 31 esecuzioni, mediana 40, nessuna sotto i 10 secondi |
| Politica sui contenuti | Senza censura, nessun filtro sui contenuti; tutti e cinque i livelli della nostra scala resi |
| Non può fare | Prompt negativi, passi, guidance, sampler, immagine in ingresso, LoRA, più di un'immagine per richiesta |
Che cos'è Neta Lumina
L'editore descrive Neta Lumina come un modello di immagini di alta qualità in stile anime. La scheda su Hugging Face, huggingface.co/neta-art/Neta-Lumina, dice che è forte nell'illustrazione anime, nei poster, negli storyboard e nel character design, con un'ampia copertura di personaggi e stili. L'editore afferma che la comprensione dei prompt è accurata anche per quelli complessi, che i tag Danbooru sono supportati e che le lingue consigliate sono cinese, inglese e giapponese. Noi abbiamo testato solo l'inglese.
La questione della versione merita una frase. Il repository dell'editore risale a giugno 2025 e la sua v1.0 «official release» è stata caricata il 22 luglio 2025. La route ospitata non dichiara una versione, quindi non possiamo dirti quale build abbia risposto alle nostre richieste, e non abbiamo provato a indovinarlo dalle immagini.
Due cose lo distinguono dall'altro modello anime che abbiamo recensito questa settimana, Anima Turbo. Legge frasi descrittive complete almeno altrettanto bene dei tag, ed è lento. La tabella verso la fine li mette a confronto insieme a Prefect Pony XL.
Tag, frasi o entrambi
Il prompt book dell'editore suggerisce un ordine: personaggi, stile, aspetto, abbigliamento, espressione e azione, camera, illuminazione, atmosfera, poi i tag di qualità. Suggerisce anche una riga iniziale fissa facoltativa, "You are an assistant designed to generate anime images based on textual prompts." Abbiamo eseguito due volte lo stesso prompt con lo stesso seed, una volta con quella riga e una senza.
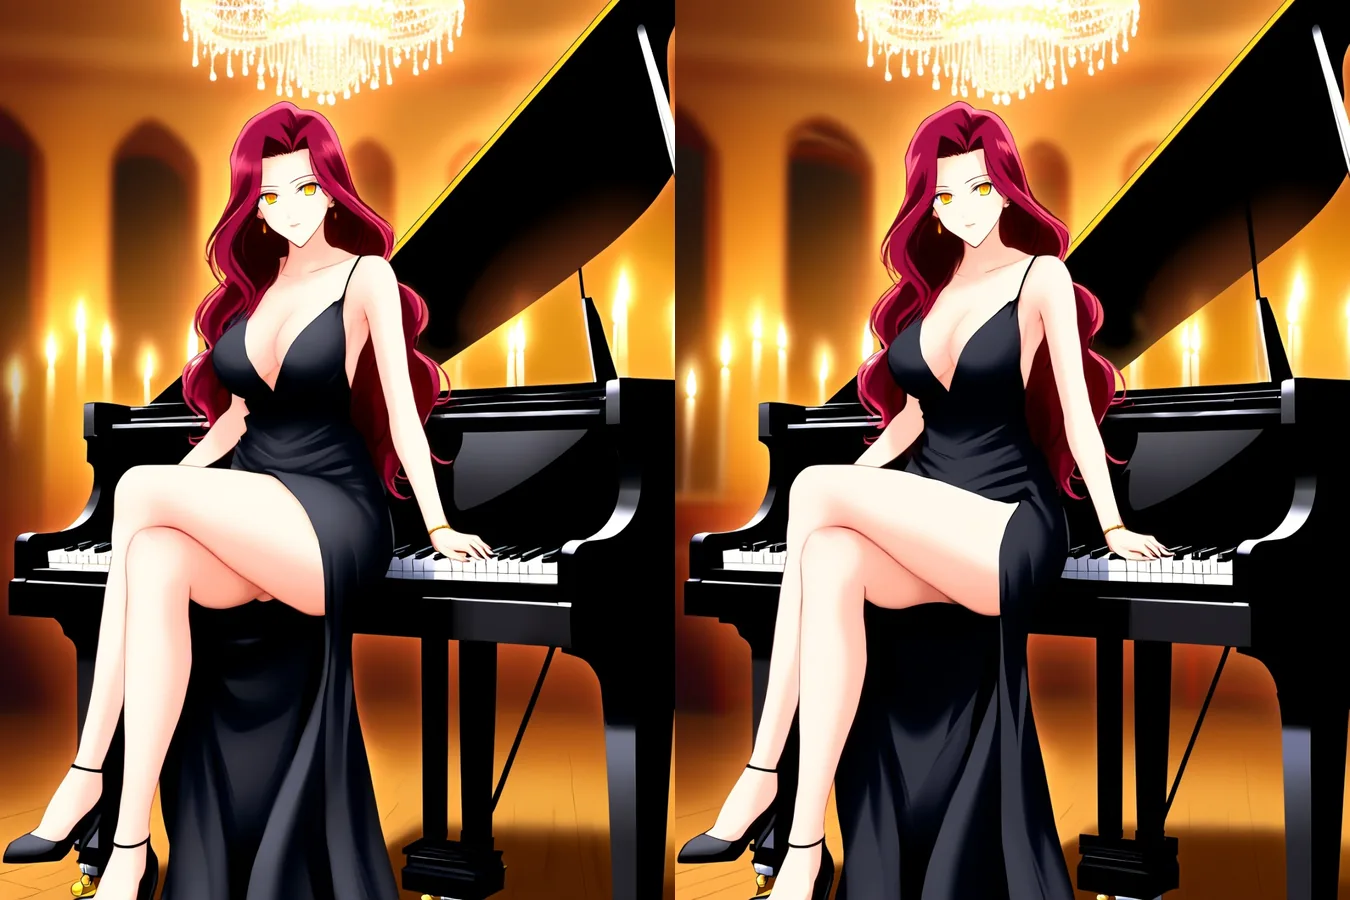
A sinistra: con la riga iniziale dell'editore. A destra: senza. Stesso prompt, seed 5, 3:4, testo in immagine.
Le due immagini sono quasi identiche, quindi su questo endpoint la riga iniziale non serve. Il prompt che ha disegnato la pianista era un semplice elenco di tag:
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileLe frasi funzionano altrettanto bene. Questa ha disegnato un uomo con una cicatrice, una camicia sbottonata e riflessi al neon senza un solo tag:
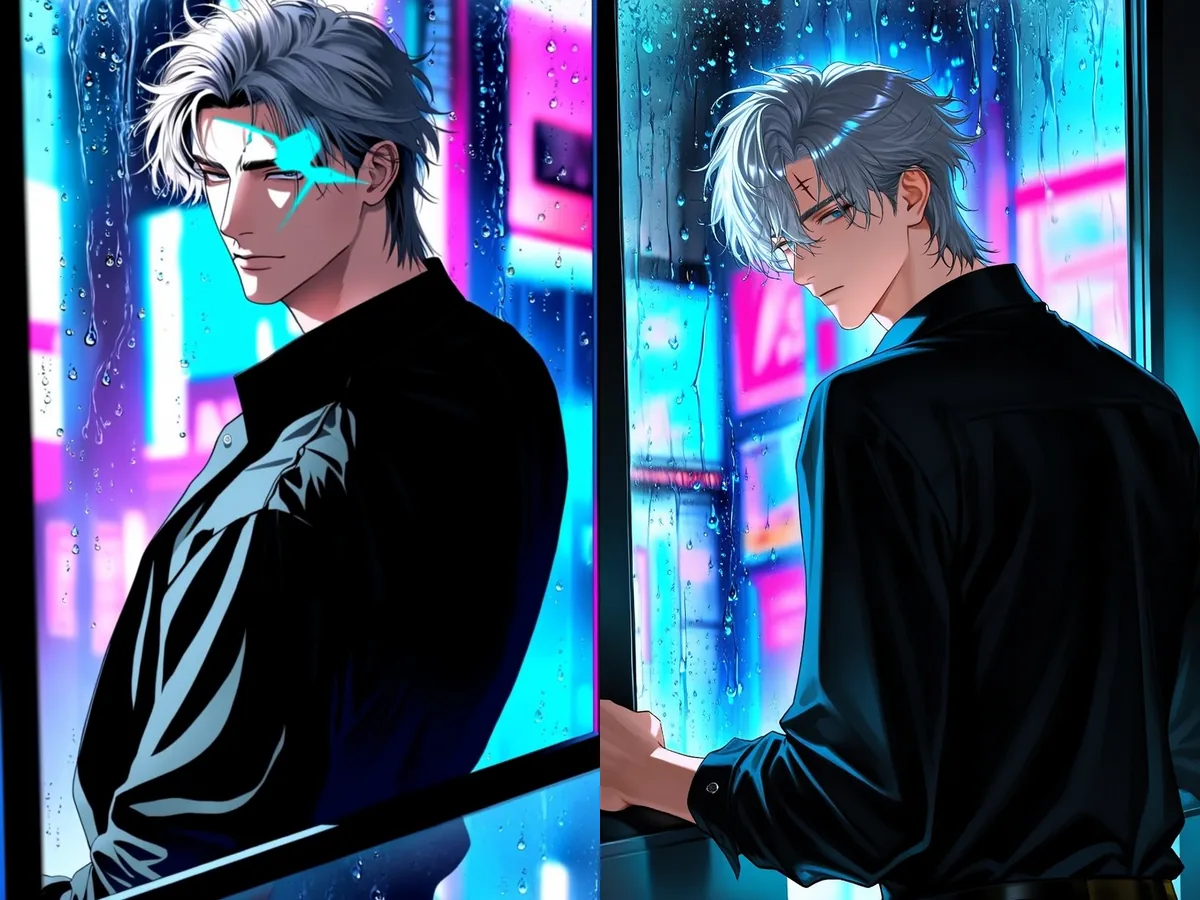
Le stesse tre frasi, seed 1 e 2, 2:3. Il seed 2 (a destra) è l'esempio pubblicato; il seed 1 ha disegnato un segno ciano luminoso vagante sul viso.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.Nei nostri test la cicatrice, la camicia e la luce ciano e magenta sono arrivate in entrambi i seed. Ciò che è cambiato tra un seed e l'altro è stata l'esecuzione: un segno vagante in uno, un viso pulito nell'altro. È lo schema che si ripete in questo modello, ed è il motivo per cui consigliamo di eseguire due o tre seed di ogni prompt a cui tieni.
| Situazione | Scelta migliore | Perché, nelle nostre esecuzioni |
|---|---|---|
| Un look preciso: capelli, occhi, abito, ambientazione | Tag | Ogni tag è un'istruzione a sé, e la pianista ha mantenuto ogni dettaglio |
| Posizione della camera, direzione della luce, rapporto tra due persone | Frasi | L'uomo alla finestra al neon ha seguito tutte e tre le frasi |
| Due personaggi | Prima i tag del numero di persone, poi una frase per ciascuna | Nella coppia in riva al mare, l'abito estivo di lei e la camicia aperta di lui sono rimasti alla persona giusta |
| Vuoi controllo e atmosfera | Un'intestazione di tag più una o due frasi | Un mix è ciò che proveremmo per primo |
Dimensioni, formati e seed
Non c'è un campo per la dimensione. Scegli una delle nove proporzioni, e ciascuna corrisponde a una dimensione fissa di circa un megapixel. Abbiamo eseguito ogni proporzione una volta e ogni output è tornato esattamente ai pixel richiesti.
| Proporzione | Dimensione | Proporzione | Dimensione |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Le dimensioni seguono il consiglio dell'editore di circa da uno a 1,3 megapixel. L'output è JPEG per impostazione predefinita; PNG e WebP hanno funzionato entrambi quando li abbiamo richiesti, e il formato di output non cambia nient'altro. Puoi anche impostare un seed da 0 a 2.147.483.647.
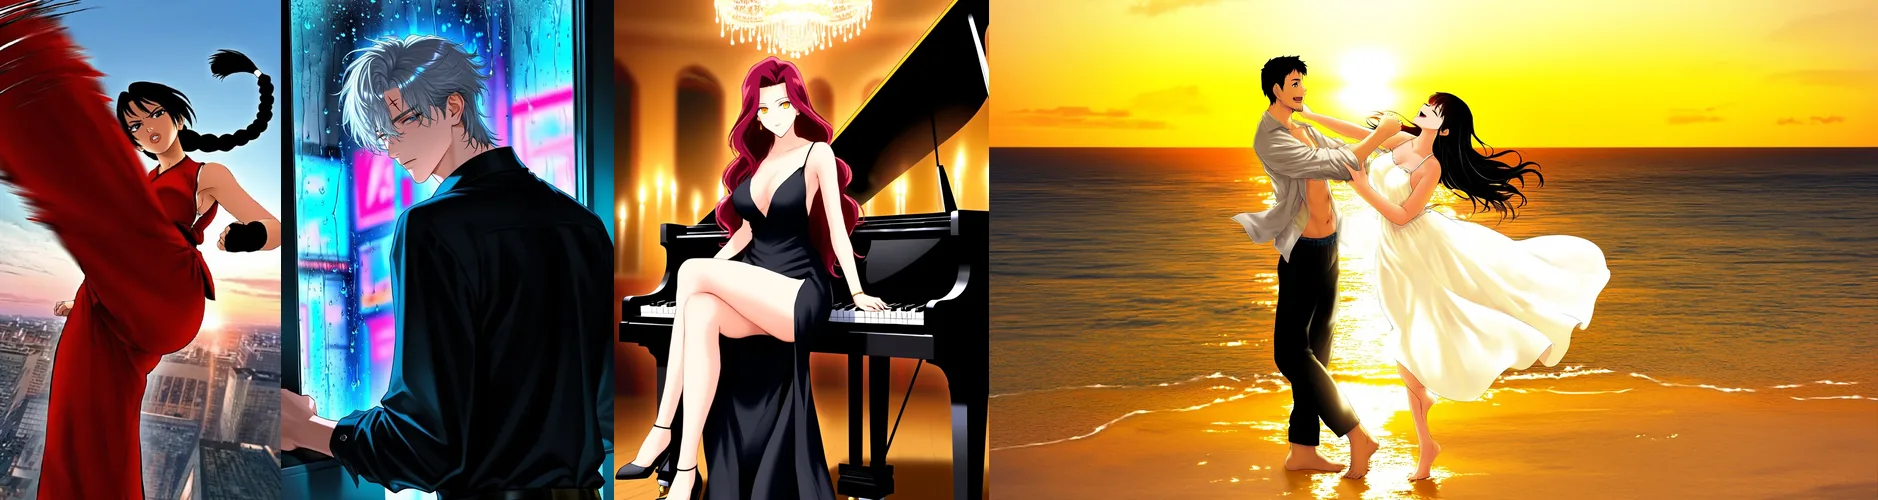
Da sinistra a destra: 9:16, 2:3, 3:4 e 16:9, tutte in testo in immagine.
Un'inquadratura larga si adatta alle scene con due persone. Questo è l'esempio 16:9 pubblicato:
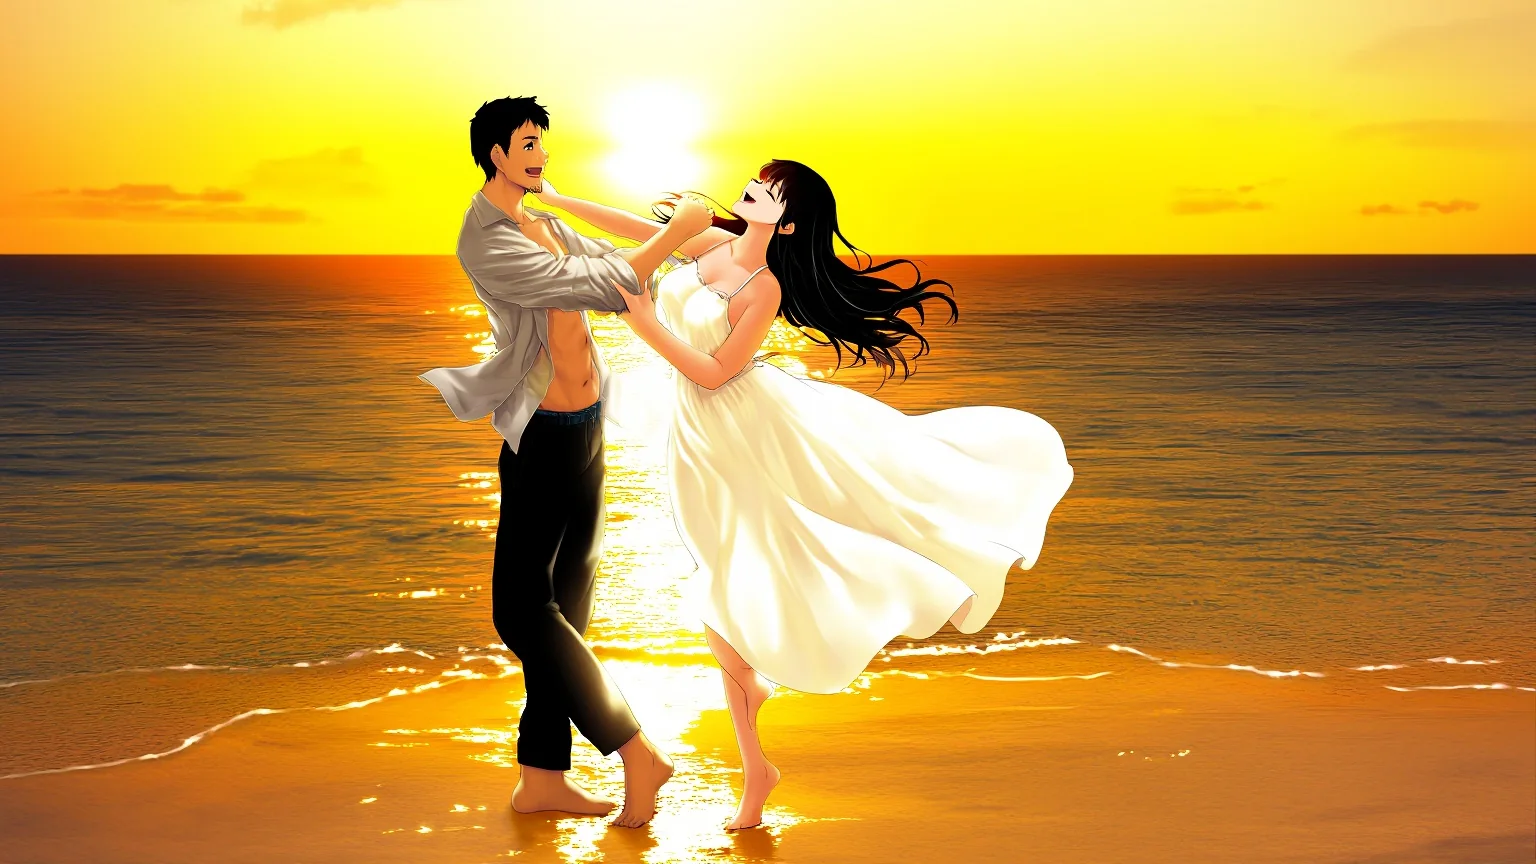
16:9, seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotI seed rendono le esecuzioni confrontabili, non garantite identiche: usane uno per confrontare due ritocchi al prompt, non per promettere una rifacitura identica al pixel.
Velocità: pianifica per lotti
Abbiamo cronometrato 31 esecuzioni. Il tempo del modello è stato da 13 a 75 secondi, la mediana 40, e nessuna esecuzione è finita in meno di dieci secondi. La pagina dell'host dell'editore indica circa 44 secondi, il che coincide. La dimensione non spiega la dispersione: un'immagine 656 x 1536 ha impiegato 13 secondi, mentre immagini 960 x 1280 hanno impiegato da 14 a 75.
Le conseguenze pratiche: non costruirci sopra una casella «scrivi e guarda» in tempo reale, invia le varianti in parallelo e tieni fisso il seed mentre le confronti. Se ti servono bozze in pochi secondi, Anima Turbo ha concluso 52 esecuzioni su 60 in meno di dieci.
Fin dove arriva
La piattaforma non aggiunge alcun filtro sui contenuti, quindi ciò che ottieni dipende dal modello e dal prompt. Abbiamo eseguito un prompt per ogni gradino della nostra scala a cinque livelli, a 3:4 con seed 1, e ogni prompt dichiarava che i personaggi sono adulti. Abbiamo guardato ogni immagine.
| Livello | Che cosa abbiamo chiesto | Che cosa è tornato |
|---|---|---|
| L1 Allusivo | Lingerie, uno spallino che scivola | Reso |
| L2 Temi maturi | Seno scoperto | Reso, anche in tutte e nove le proporzioni (9 su 9) |
| L3 Forte | Contenuto forte, femminile e maschile | Reso, entrambi |
| L4 Intenso | Una scena intima tra due adulti | Reso come scritto, senza censure |
| L5 Estremo | Bondage consensuale tra adulti; gore cinematografico | Resi entrambi |
Nessun rifiuto e nessuna immagine sostituita a nessun livello. Un dettaglio da conoscere per il prompt L5 di bondage: il modello ha disegnato una piccola censura a mosaico su una zona. L4 non ne aveva. Lo leggiamo come un'abitudine appresa dall'arte di addestramento e non come un filtro, dato che la piattaforma non aggiunge nulla e la stessa zona era senza censura altrove. Se ti serve un output pulito, scrivilo nel prompt, oppure rilancia.
Non pubblichiamo i prompt della scala, e la piattaforma non fornisce mai prompt per contenuti più forti. Possiamo dire che per una richiesta quotidiana il modello si comporta come dovrebbe un modello anime, e per una più forte non si mette di traverso. Confrontalo con FLUX 3 e Ideogram v4.5, che nei nostri test hanno rifiutato quasi tutto oltre una foto neutra in costume da bagno.
Che cosa è andato storto
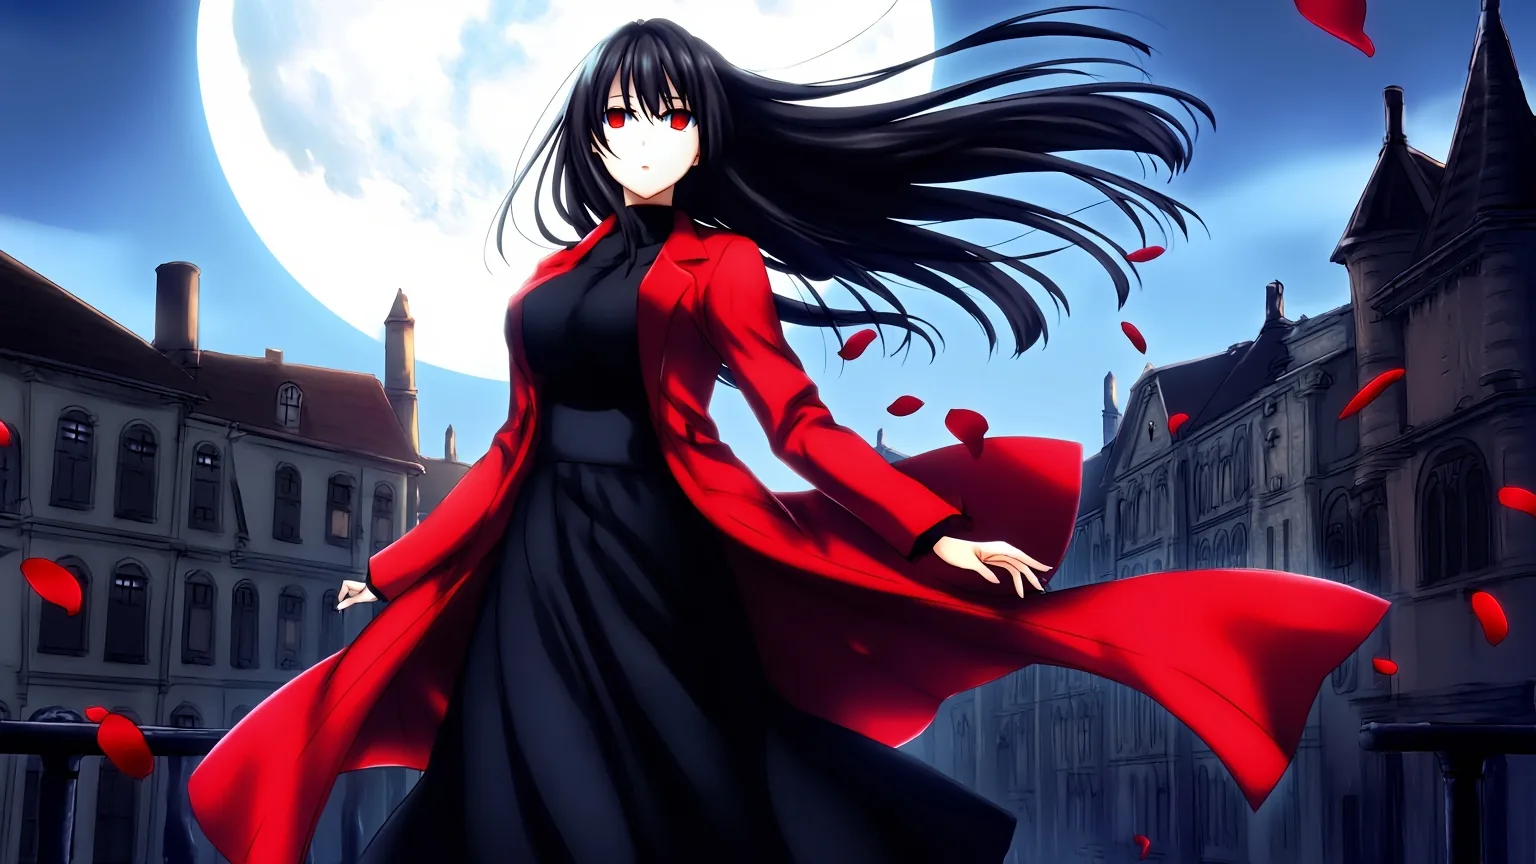
Un resoconto onesto significa mostrare anche gli errori. Il nostro prompt da key visual, una donna adulta in un cappotto cremisi su un tetto al chiaro di luna, è venuto bene con i seed 1 e 3 e male con il seed 2:
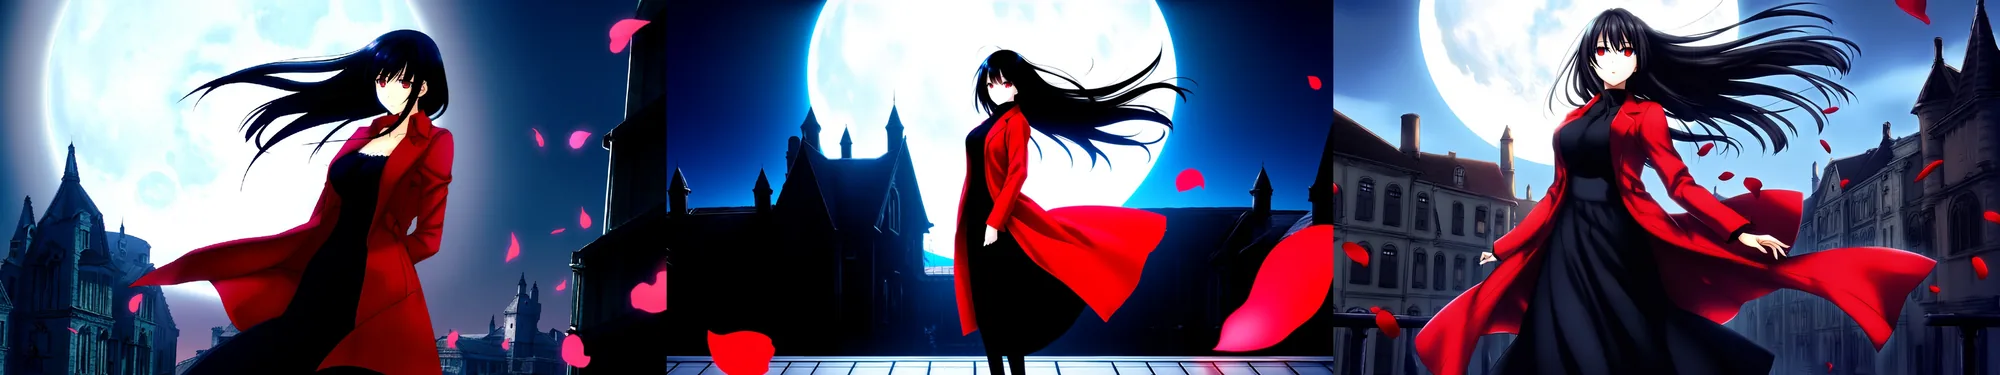
Un prompt, seed 1, 2 e 3, 16:9. Il seed 2 (al centro) ha trasformato la donna in una piccola figura contro una silhouette.
Le pose d'azione sono l'angolo meno affidabile. Il prompt che ci ha dato un calcio volante pulito con il seed 1 ha ingarbugliato gli arti con il seed 2:
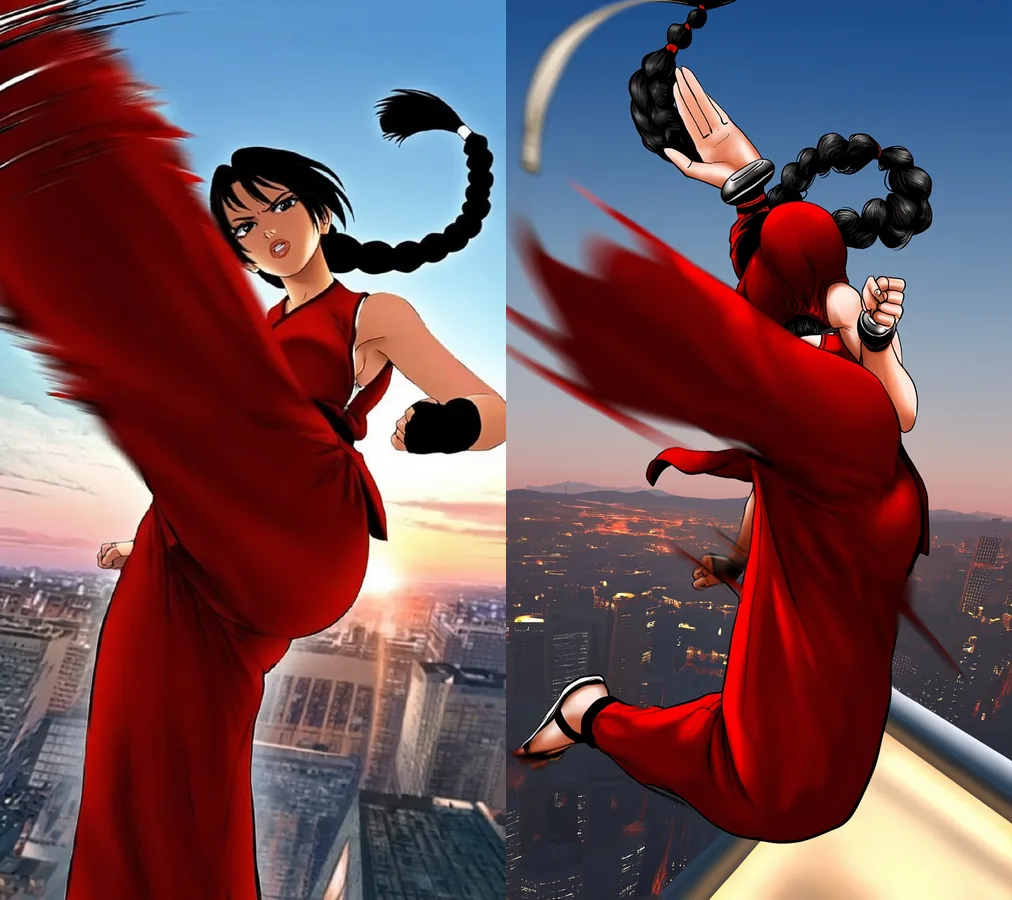
A sinistra: seed 1. A destra: seed 2. 9:16, stesso prompt.
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingPerfino la pianista varia. Due seed dello stesso prompt hanno dato due stanze e pose diverse:
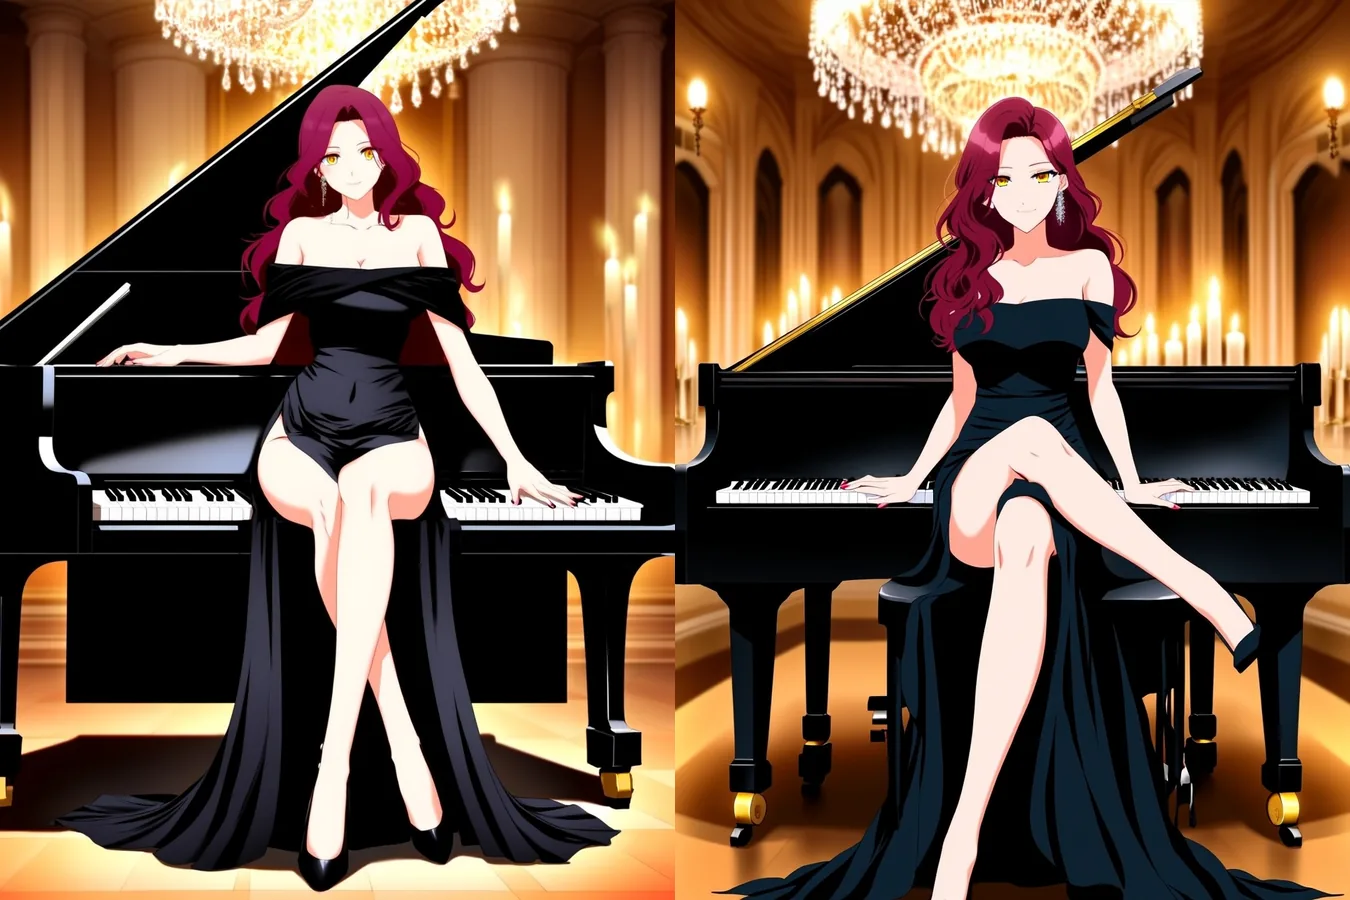
Il prompt della pianista, seed 1 e 2, 3:4.
Limiti
- Lento. Da 13 a 75 secondi per immagine, mediana 40.
- Nessun prompt negativo, passi, guidance o sampler. I campi pubblici sono
prompt,aspect_ratio,output_formateseed. - Solo testo in immagine. Non c'è immagine in ingresso né slot per LoRA.
- Un'immagine per richiesta.
- Artefatti occasionali. Il modello a volte aggiunge uno scarabocchio simile a una firma o una zona pixelata appresa dall'arte di addestramento. La soluzione è un nuovo seed.
- Le pose d'azione richiedono nuovi tentativi. Prevedi due o tre seed.
Neta Lumina, Anima Turbo e Prefect Pony XL
Tutti e tre sono modelli anime senza censura su SpicyAPI. Le righe qui sotto usano solo ciò che abbiamo misurato il 5 ottobre 2026 per Neta Lumina e Anima Turbo, e ciò che è pubblicato sulle pagine del modello per Prefect Pony XL, che abbiamo testato l'ultima volta in un'esecuzione interna precedente, il 18 settembre 2026.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| Che cos'è | Fine-tune di Neta.art Lab di Lumina-Image-2.0 | CircleStone Labs, 2 miliardi di parametri, build Turbo distillata | Checkpoint anime della community della linea Pony XL |
| Stile del prompt | Tag, frasi o entrambi | Tag Danbooru, legge anche le frasi | Tag in stile Pony |
| Proporzioni | 9 a circa un megapixel | 15, su livelli 1k e 1.5k | 7 dimensioni native SDXL |
| Velocità nei nostri test | Da 13 a 75 s, mediana 40 | Da 2 a 16 s, 52 su 60 sotto i 10 | Non misurata in questo giro |
| Immagine in immagine | No | Sì, sul suo endpoint immagine in immagine | No |
| LoRA | No | Non sulla famiglia base; il suo fratello con LoRA ne accetta fino a tre | No |
| Prompt negativo | No | No | Non trattato qui |
| Contenuti nei nostri test | Tutti e cinque i livelli resi | Il prompt di prova più spinto è stato generato come scritto al primo tentativo | Tre livelli di prova fino a L4 resi nell'esecuzione del 18 settembre |
| Formato di output | JPEG, PNG o WebP | JPEG | Vedi la pagina del modello |
Scegli Neta Lumina quando vuoi un modello anime che segua una lunga frase descrittiva e puoi aspettare. Scegli Anima Turbo per bozze rapide, immagine in immagine o LoRA. Scegli Prefect Pony XL se i tuoi prompt vengono già dall'ecosistema Pony. La nostra rassegna dei modelli anime NSFW copre il campo più ampio.
Per chi è
Usa Neta Lumina per key visual, poster, character design e fotogrammi da storyboard in cui eseguirai una manciata di seed e terrai il migliore. Lascialo perdere se ti servono velocità, modifica, un prompt negativo o una LoRA di stile. Comincia dalla pagina del testo in immagine.
FAQ
Neta Lumina è senza censura?
Sì. La piattaforma non aggiunge alcun filtro sui contenuti e, nella nostra scala di cinque livelli, da L1 Allusivo a L5 Estremo, ogni livello è stato reso senza rifiuti e senza immagini sostituite. Il modello stesso ha disegnato una piccola censura a mosaico sul prompt L5 di bondage, che sembra aver appreso dall'arte di addestramento.
Usa tag o frasi?
Entrambi. I tag in stile Danbooru hanno funzionato per la pianista e le frasi semplici per l'uomo alla finestra al neon. Usa i tag per un look preciso e una frase per camera, luce e atmosfera.
Mi serve la riga iniziale dell'editore?
No. Con e senza "You are an assistant designed to generate anime images based on textual prompts." le immagini con lo stesso seed sono risultate quasi identiche.
Perché è più lento degli altri modelli di immagini qui?
Abbiamo misurato da 13 a 75 secondi di tempo del modello su 31 esecuzioni, mediana 40, e la dimensione dell'immagine non spiegava la dispersione. Invia le varianti in parallelo e fissa il seed mentre le confronti.
Quali dimensioni supporta?
Nove proporzioni a circa un megapixel, da 1024 x 1024 a 1:1 a 1536 x 864 a 16:9 e 1536 x 656 a 21:9. Ogni output corrispondeva alla dimensione richiesta nel nostro test.
Posso usare LoRA o un'immagine sorgente?
No. Questo endpoint è solo testo in immagine. Per LoRA o immagine in immagine su un modello anime, guarda Anima Turbo LoRA e l'endpoint immagine in immagine di Anima Turbo.
Lo stesso seed garantisce la stessa immagine?
No. I seed mantengono le esecuzioni confrontabili, ma considera una ripetizione come vicina, non garantita.