Anima Turbo, da testo a immagine, 16:9 al livello 1.5k. Il tag di rating era sensitive; il prompt descrive un’adulta vestita in una camera d’albergo.
Risposta breve: sì, Anima Turbo è senza censura. Su SpicyAPI non c’è alcun filtro sui contenuti davanti al modello e, nei nostri test su 25 richieste distribuite su quattro livelli, dalla lingerie allusiva fino a una scena intima tra due adulti, abbiamo avuto zero rifiuti e zero sostituzioni. Immagine in immagine e LoRA adatti agli adulti si sono comportati allo stesso modo. Quello che il modello non fa è il fotorealismo, che per questo tipo di lavoro è un pregio: tutto ciò che disegna si legge come illustrazione.
Questa guida racconta cosa abbiamo testato, come i tag di rating cambiano il tono, come mantenere riconoscibile un personaggio adulto da una scena all’altra, come aggiungere uno stile con un LoRA, come scrivere scene di coppia e dove il modello ti delude ancora. Ogni prompt d’esempio qui è una scena vestita, al massimo allusiva; la piattaforma non scrive né pubblica prompt per scene per adulti e non te ne serve nessuno per seguire la guida.
In sintesi
| Domanda | Risposta dai nostri test (5 ottobre 2026) |
|---|---|
| Rifiuta? | No. 25 richieste, zero rifiuti, zero sostituzioni |
| Livelli provati | Da L1 a L4 (su Anima non abbiamo eseguito L5) |
| Provato anche | Immagine in immagine, con e senza LoRA, soggetti femminili e maschili, due seed per i livelli alti, livelli 1k e 1.5k |
| Controllo del tono | Tag di rating: safe, sensitive, nsfw e un tag più forte |
| Stile | Solo anime e illustrazione; niente fotorealismo |
| Stili personalizzati | Fino a 3 LoRA nella famiglia LoRA |
| Velocità tipica | Da 2 a 16 secondi per immagine nel nostro test di velocità da 60 esecuzioni |
| Non disponibili | Prompt negativo, step, CFG, maschere, più immagini per richiesta |
Anima Turbo è senza censura?
Sì: nei nostri test nulla è stato rifiutato, sfocato o attenuato. Abbiamo fatto salire il modello lungo la nostra scala dei contenuti, che usa nomi di livello neutri:
| Livello | Cosa significa | Risultato con Anima |
|---|---|---|
| L1 Allusivo | Lingerie, una spallina che scivola dalla spalla | Resa come scritto |
| L2 Parziale | Un look parzialmente rivelatore | Resa come scritto |
| L3 Forte | Un look molto più rivelatore | Resa come scritto |
| L4 Intenso | Una scena intima tra due adulti | Resa come scritto al primo tentativo |
| L5 Estremo | Contenzione consensuale tra adulti, o violenza cruenta in stile cinematografico | Non eseguito su Anima |
Le 25 richieste mescolavano da testo a immagine e immagine in immagine, con e senza LoRA, soggetti femminili e maschili, due seed ciascuno per L3 e L4 e entrambi i livelli di risoluzione. Le esecuzioni di immagine in immagine partivano da un’immagine di origine vestita e, quando abbiamo chiesto L3 o L4 con una strength tra 0.8 e 0.9, il modello ha seguito la richiesta. Un lotto separato di 60 esecuzioni sulle proporzioni usava un prompt di livello L2 e tutte e 60 sono state consegnate. Non abbiamo visto alcun flag sui contenuti, alcuna sfocatura, alcuna attenuazione.
«Senza rifiuti» non significa «ogni immagine è perfetta». Anatomia e mani richiedono comunque di rilanciare il seed, come con qualsiasi modello di immagini, e ne parliamo nella sezione dei limiti.
Come hanno gestito la stessa scala gli altri modelli
Per contesto, abbiamo eseguito la stessa scala su due modelli di immagini generalisti tramite un’API ospitata di terze parti: FLUX 3 da testo a immagine e Ideogram v4.5. Entrambi hanno consegnato una scena in bikini sulla spiaggia e una foto neutra da catalogo di lingerie. FLUX 3 ha rifiutato 10 delle sue 12 richieste e Ideogram 11 delle sue 13, compresi un dipinto classico di studio della figura e un prompt eufemistico senza parole segnalate. I rifiuti sono tornati in circa due secondi, prima che venisse creata qualsiasi immagine, con il messaggio «Content flagged as potentially sensitive. Please try different prompts or images.» Le richieste rifiutate non sono state addebitate. Poiché è stato rifiutato anche il prompt eufemistico, il filtro sembra semantico e non una lista di parole chiave. Non possiamo dire se quel filtro appartenga alle API dei produttori dei modelli o all’host, quindi leggilo come un’affermazione su quei percorsi, non sui soli modelli.
Come guidano il tono i tag di rating?
I tag di rating stabiliscono quanta moderazione applica il modello e, con una descrizione vestita, safe e sensitive danno quasi la stessa immagine. Anima conosce safe, sensitive e nsfw, e l’editore, CircleStone Labs, documenta un ulteriore tag, più forte. L’editore descrive nsfw e quel tag più forte come quelli che tolgono la moderazione. Poiché non esiste un prompt negativo, il tag di rating è il modo principale per dare il tono, quindi vale la pena sceglierlo con cura.
Abbiamo testato i primi due con un solo prompt da lounge (una donna adulta in abito da sera nero con spalline sottili al bar di un albergo) e un solo seed, cambiando soltanto il tag.
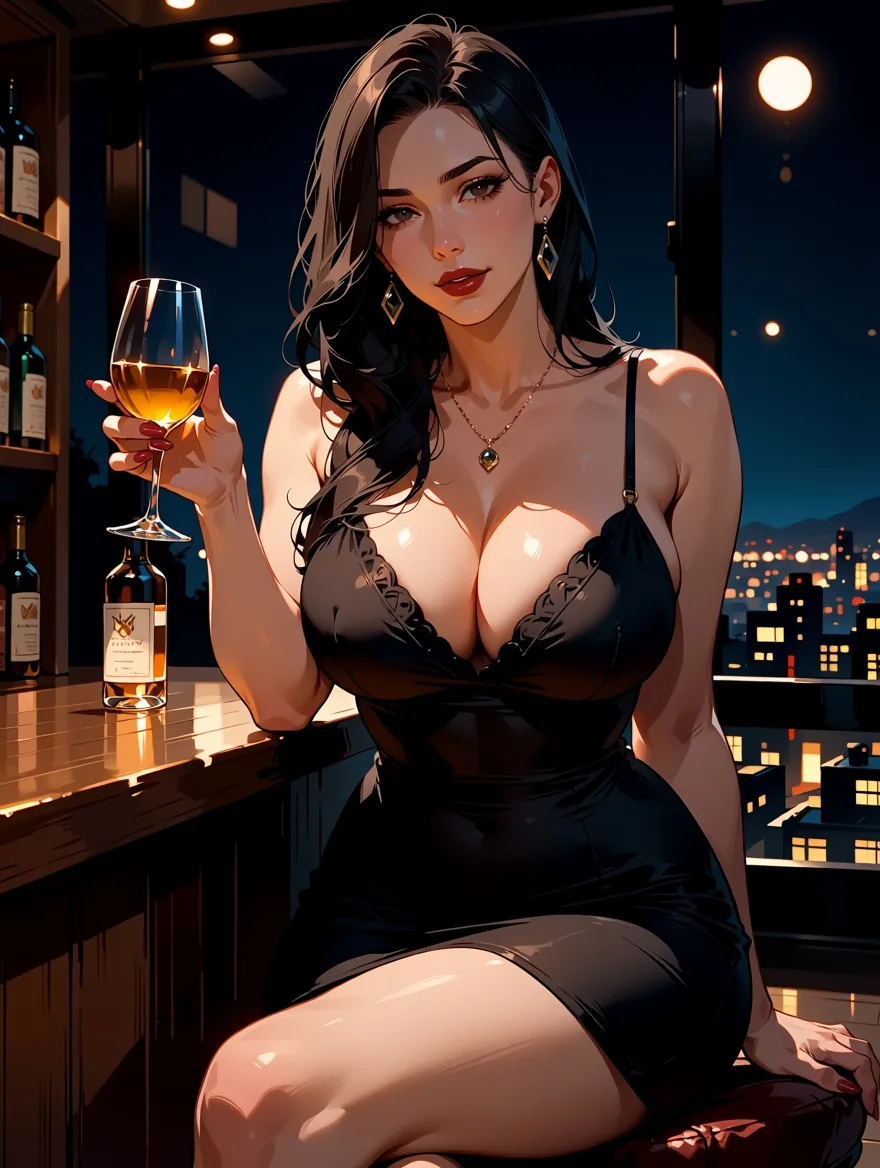
Stesso prompt e stesso seed, safe.
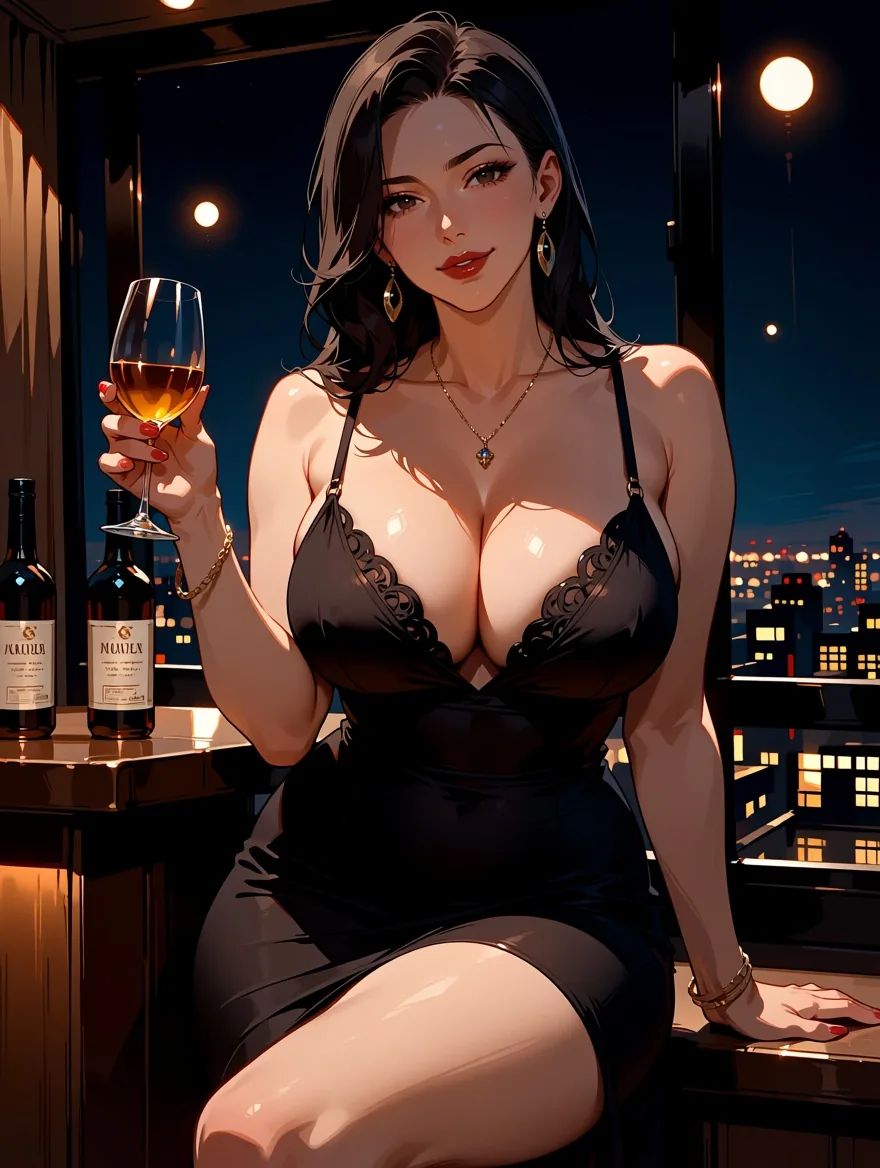
Stesso prompt e stesso seed, sensitive.
Composizione, posa e atmosfera coincidono; piccoli dettagli come i gioielli e le bottiglie sono cambiati. Considera safe e sensitive una leggera spinta per le scene vestite e aspettati il cambiamento più grande dai tag più forti. Non pubblichiamo alcun prompt che li usi, e non lo fa nemmeno la documentazione della piattaforma; sono lì se scegli di usarli, e la sezione sull’uso responsabile qui sotto vale per ognuno di essi.
Alcune convenzioni sui tag, indicate dall’editore, che aiutano in qualsiasi scena: scrivi i tag in minuscolo con spazi al posto dei trattini bassi, parti dai tag di qualità e di rating, poi il numero di soggetti (1girl, 1boy), poi personaggio, serie, artista e tag generali. Un buon inizio è masterpiece, best quality, eventualmente score_7. Anche i nostri test hanno funzionato con frasi complete e con misti di tag e frasi; l’editore consiglia almeno due frasi quando scrivi in linguaggio naturale. I nostri test più ampi sui prompt sono in Anima Turbo alla prova: tag, frasi e tag di stile.
Come mantieni coerente un personaggio adulto tra le scene?
Blocca il seed, riusa la descrizione del personaggio parola per parola e cambia solo l’abbigliamento e il luogo. Non esiste una funzione di immagine di riferimento o di blocco del personaggio, quindi la coerenza nasce dal prompt. Abbiamo scritto un personaggio adulto come blocco di tag e lo abbiamo riusato tre volte:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye,
black turtleneck, standing in an art gallery, looking at viewer
Per la seconda e la terza scena abbiamo tenuto tutto fino a beauty mark under the left eye, abbiamo portato il tag di rating a sensitive e abbiamo cambiato solo i vestiti e l’ambientazione: una sottoveste di seta rossa su un balcone di notte, poi una camicia bianca oversize sul davanzale di una finestra al mattino. Tutte e tre usavano il seed 31 al livello 1k in 3:4.
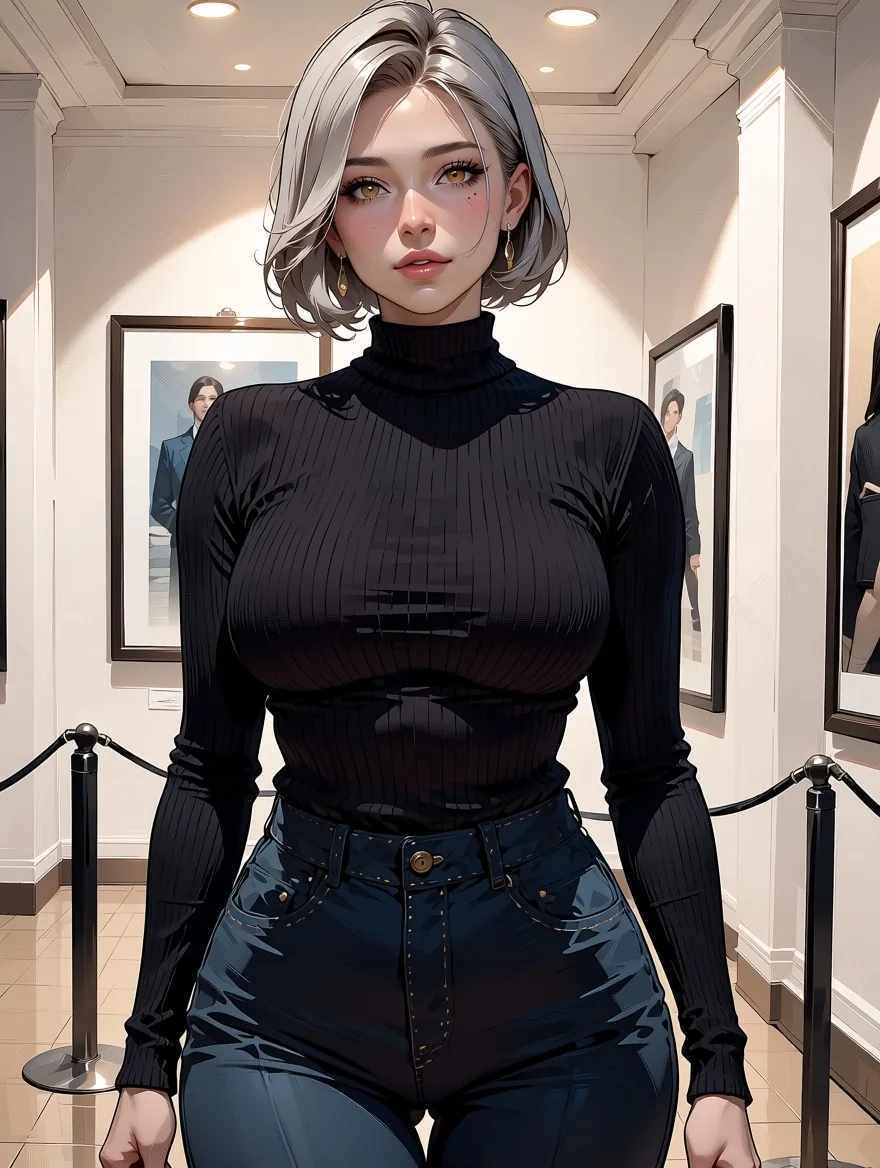
Scena 1: dolcevita, galleria.
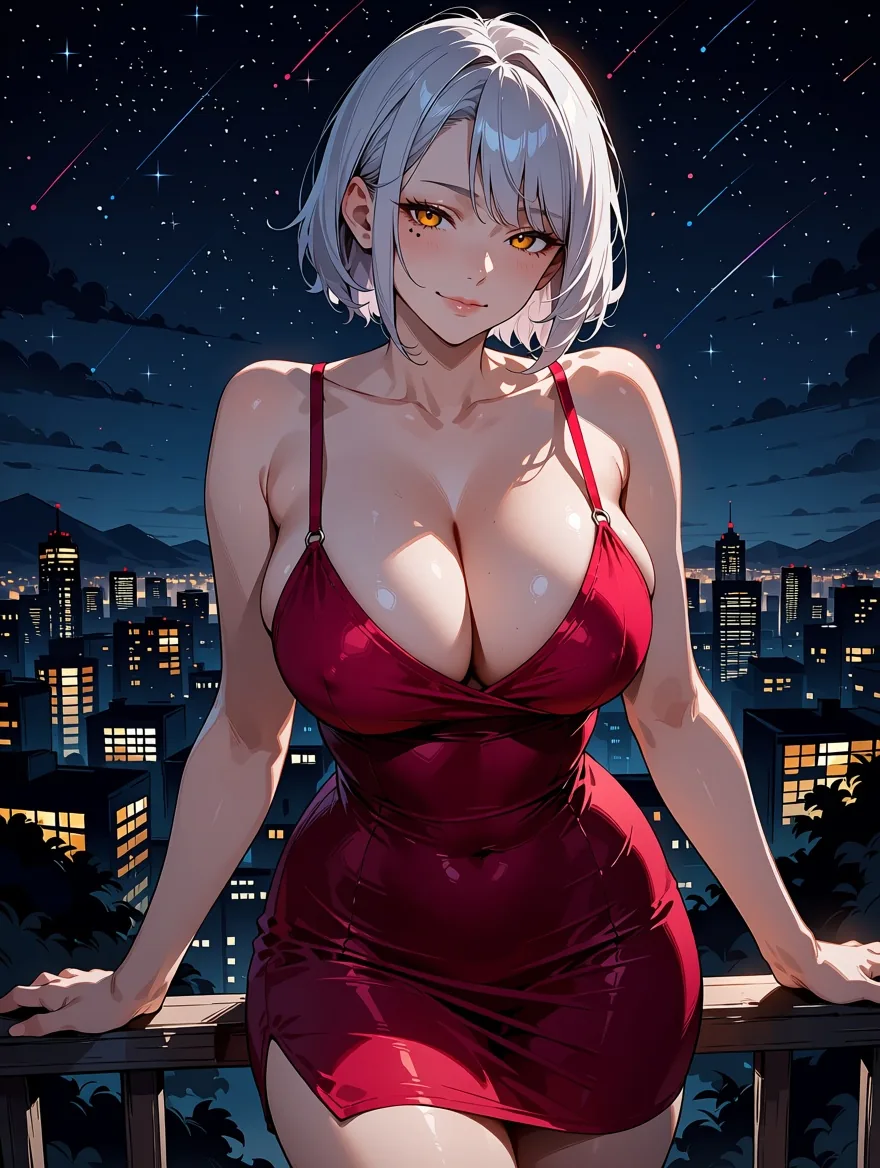
Scena 2: sottoveste rossa, balcone.
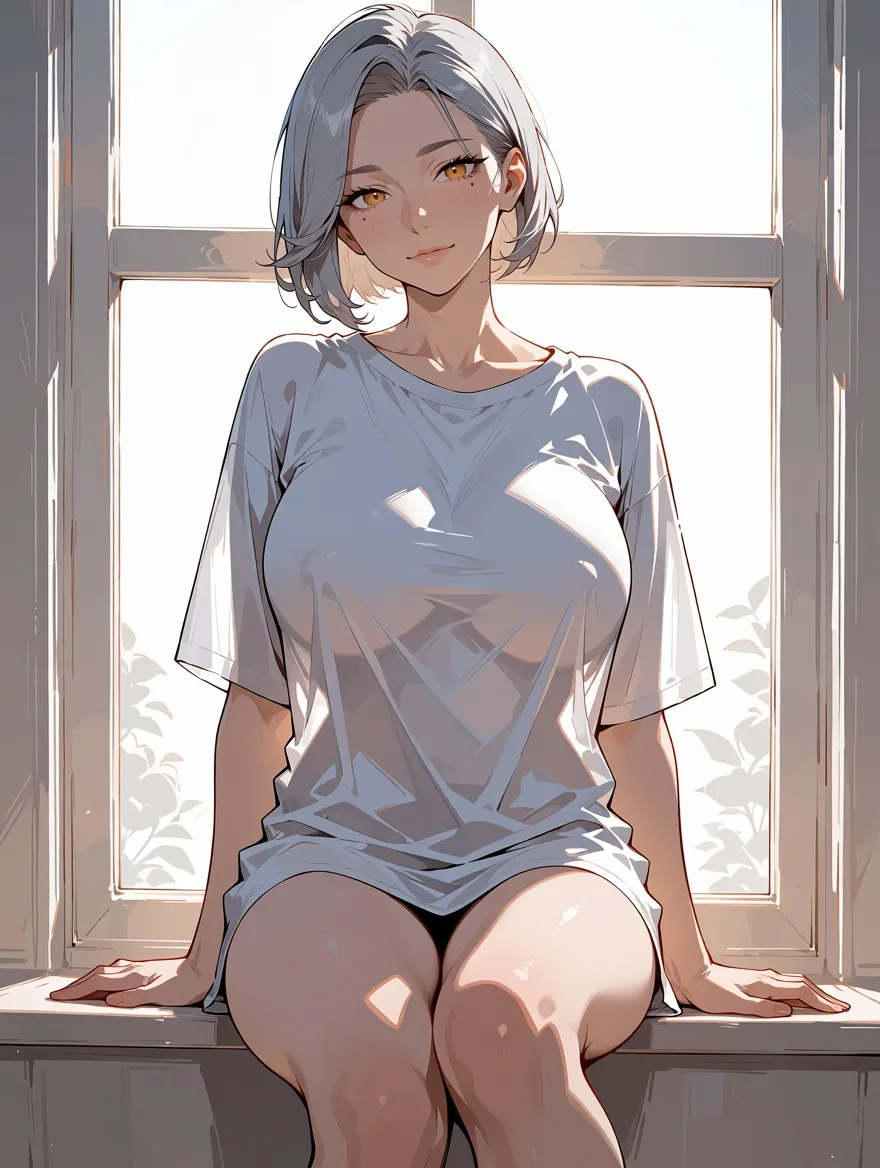
Scena 3: camicia bianca oversize, davanzale.
Il caschetto argento, gli occhi dorati e il neo si sono mantenuti in tutte e tre, e il volto resta riconoscibilmente lo stesso personaggio. Lo stile di resa cambia un poco da una scena all’altra (l’immagine della galleria è più pittorica delle altre due), che è il costo normale di cambiare tutta la scena attorno a un seed fisso. Due abitudini fanno funzionare meglio il metodo:
- Descrivi il personaggio con tratti concreti e numerabili: lunghezza e colore dei capelli, colore degli occhi, un segno distintivo. Parole vaghe («carina», «elegante») non aggiungono nulla alla riconoscibilità.
- Cambia una cosa alla volta quando vuoi confrontare. Se abbigliamento, luogo e luce cambiano tutti insieme, non puoi capire quale ha rotto la somiglianza.
Un seed fisso rende le esecuzioni confrontabili, ma non garantisce pixel identici: la stessa richiesta con lo stesso seed ci ha dato rese leggermente diverse in momenti diversi. Metti in conto di scegliere la migliore tra qualche tentativo.
Come aggiungi uno stile con un LoRA adatto agli adulti?
Usa la famiglia LoRA, incolla un link diretto a un file .safetensors e tieni lo scale tra circa 0.5 e 1.2. La pagina di Anima Turbo LoRA accetta fino a tre LoRA per richiesta, ciascuno come coppia {path, scale}. Caricare i LoRA non comporta un addebito separato e la piattaforma non aggiunge alcun filtro. Il 5 ottobre 2026 Hugging Face elencava 129 adattatori LoRA per Anima. Un LoRA addestrato per un altro modello di base si carica senza errori e non cambia nulla, quindi controlla che quello scelto sia stato addestrato per Anima.
Abbiamo usato due LoRA pubblici. Il primo è l’estetica dei giochi dell’era PC-98, Melon-Bread/anima-pc98-gal-style-v0.2, con la trigger word pc98gal_style.
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework,
sensitive, 1girl, solo, adult woman, mature female, long purple hair, black slip dress,
leaning on a balcony at night, city lights, sultry smile, looking at viewer,
retro anime aesthetic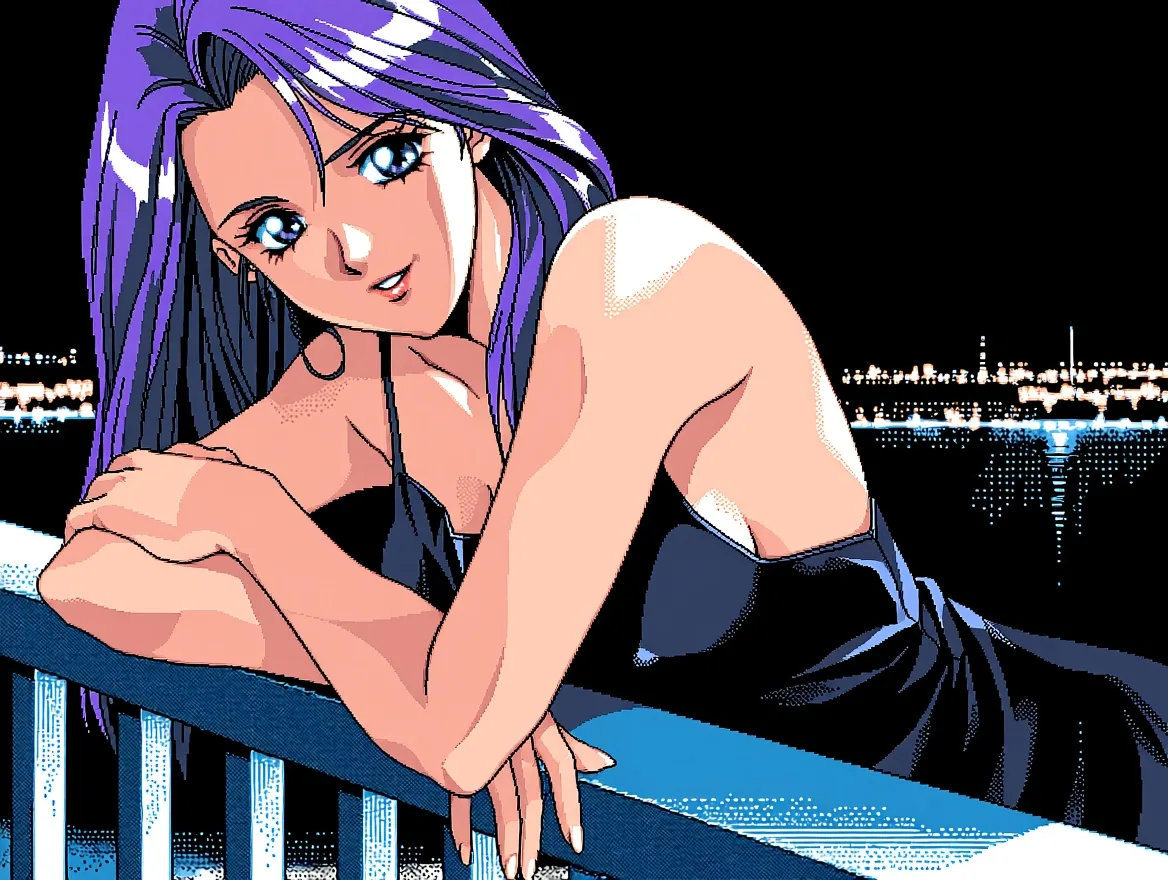
Anima Turbo LoRA, LoRA PC-98 con scale 1, 4:3, livello 1k.
Il secondo è un look a inchiostro manga, notverriegod/monochrome-grayscale_style. Nel prompt servivano le parole monochrome, greyscale: senza quelle la nostra esecuzione è rimasta a colori. Qui una donna adulta in kimono è seduta accanto a una lanterna di carta, con sensitive come tag di rating.
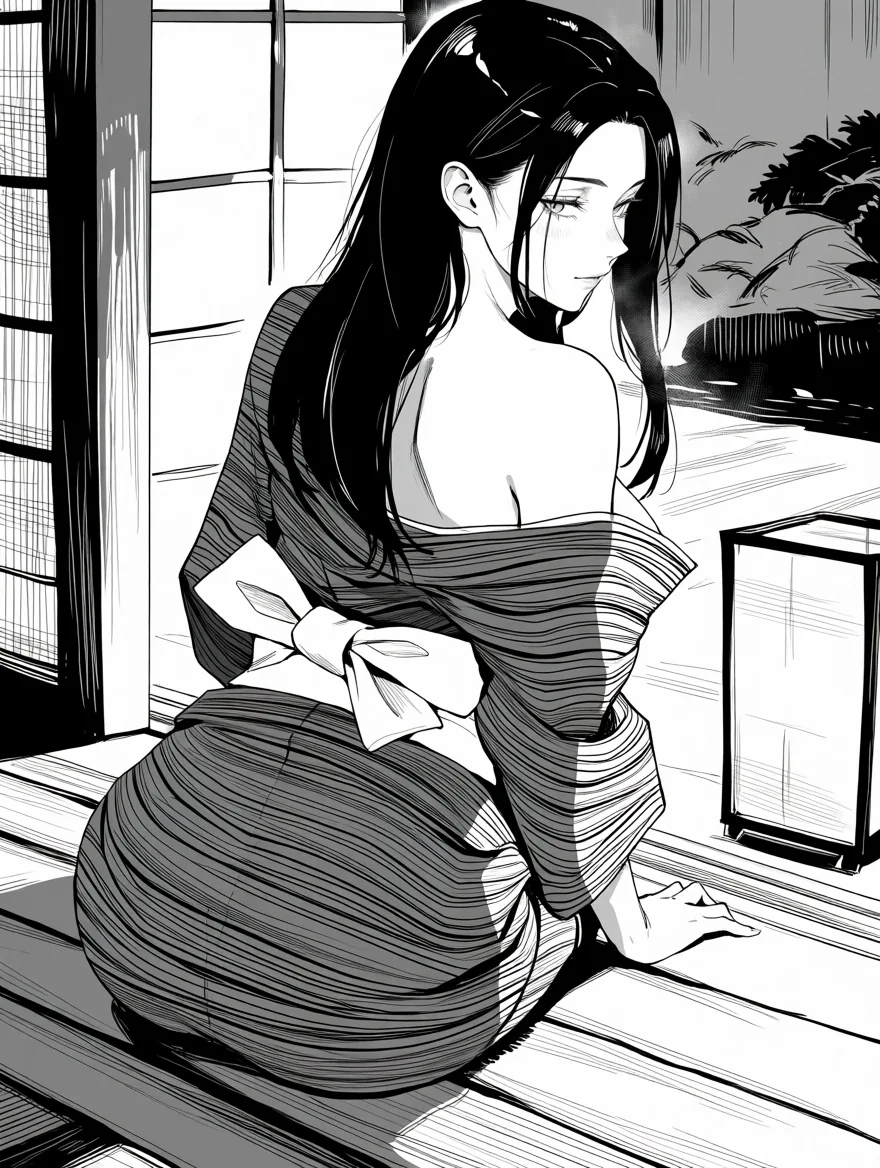
Anima Turbo LoRA, LoRA monochrome con scale 1, 3:4, livello 1k.
Cosa sapere sullo scale, dalla nostra scala di prove: 0 è identico a nessun LoRA, 0.5 è un tocco leggero, 1 è lo stile pieno, 1.5 spinge lo stile più forte e 4 ha disgregato l’immagine in forme astratte. Tre LoRA impilati a 1, 0.6 e 0.25 hanno funzionato, con lo stile principale ancora ben leggibile; più di tre vengono rifiutati. La prima richiesta con un LoRA nuovo può richiedere più tempo mentre il file viene scaricato (una delle nostre ha impiegato quasi tre minuti). Se un link è protetto (richiede un login), la richiesta fallisce con un messaggio HTTP 401, e se incolli la pagina di un repository invece del file ti viene chiesto il link di download diretto; nessuno dei due casi viene addebitato. Altre informazioni su impilamento e trigger word sono in Anima Turbo LoRA: stili, scale e impilamento.
Puoi scrivere scene di coppia allusive?
Sì: scrivi entrambi i personaggi come adulti, crea l’atmosfera con luce e postura e lascia il resto al tag di rating. Questo lento ballo in un jazz bar è un buon modello:
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood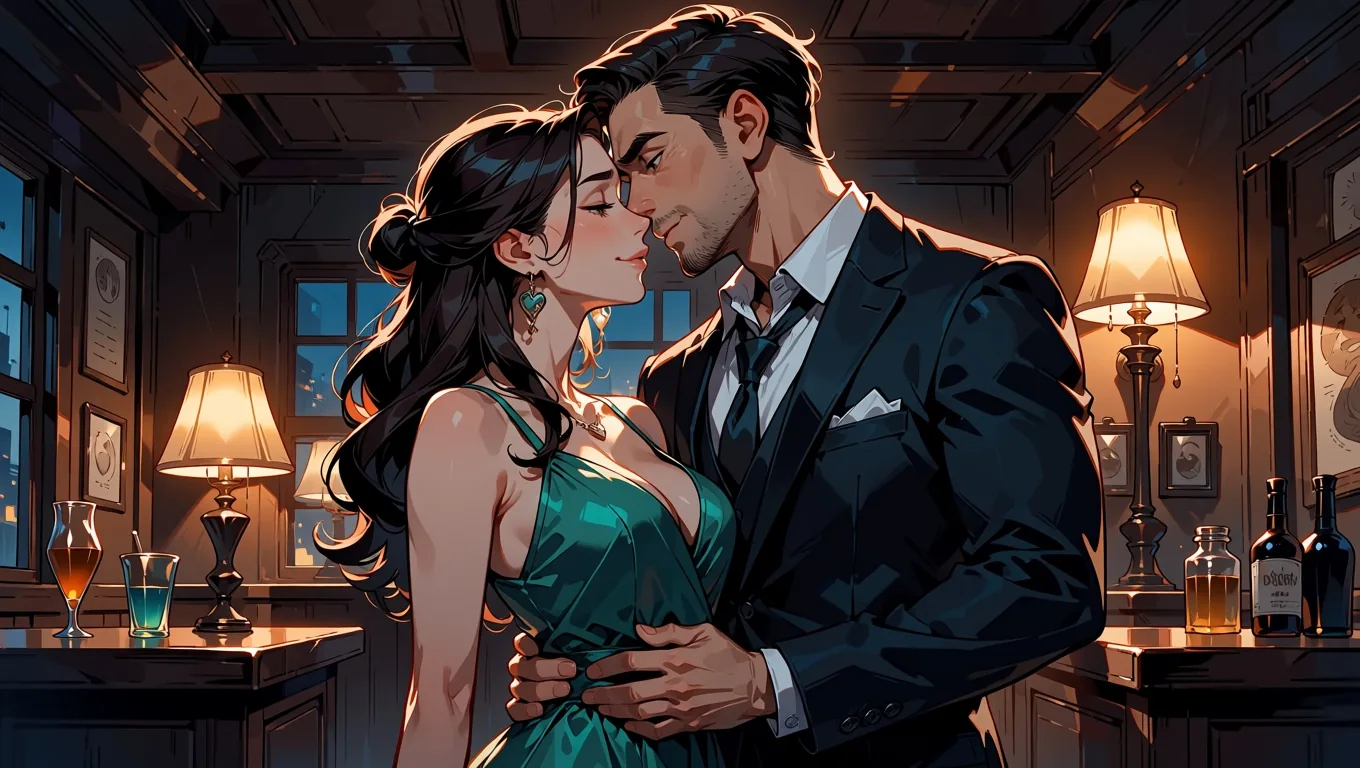
Anima Turbo, 16:9, livello 1k, sensitive.
Il modello segue bene i tag di gruppo (1girl, 1boy, 2boys, 2girls). Abbiamo eseguito anche altre due coppie, una di due uomini e una di due donne, con la stessa struttura, usando 2boys e 2girls e i tag da adulti per ciascuna persona.
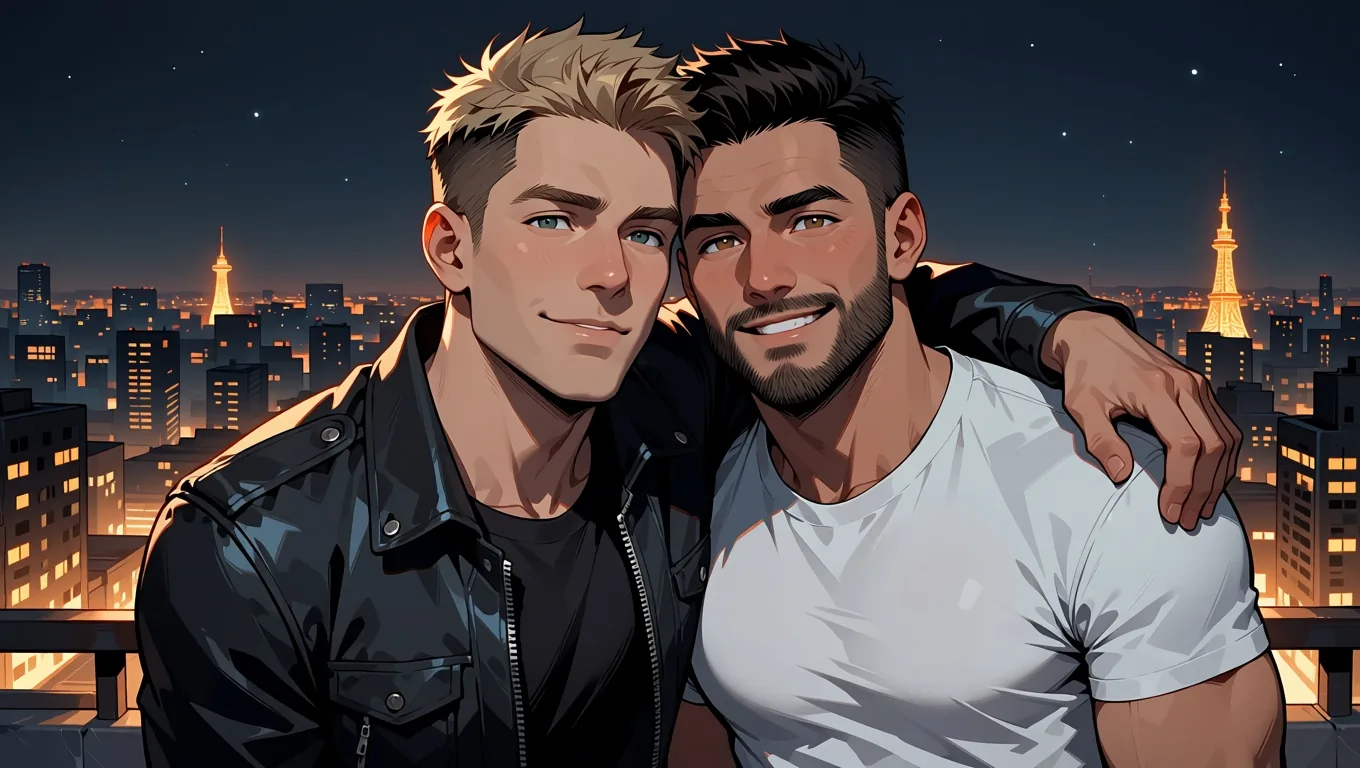
Due uomini adulti su un tetto di notte, 2boys, sensitive.
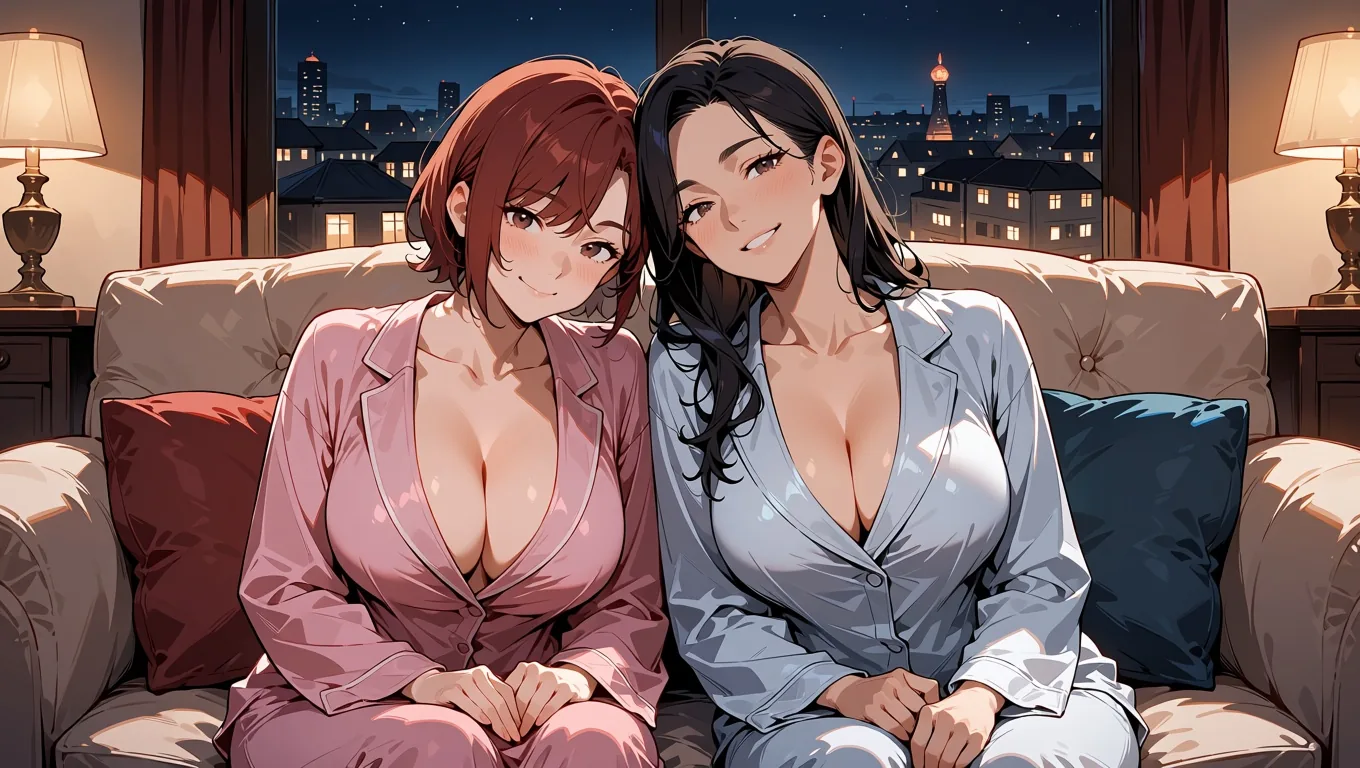
Due donne adulte su un divano in pigiama di seta, 2girls, sensitive.
Due cose che abbiamo notato. Primo, il modello legge mature male e mature female come un’istruzione sui volti, quindi lascia quelle parole; inoltre dichiarano chiaramente nel prompt che ogni personaggio è un adulto. Secondo, le scene con un solo personaggio sono le più affidabili. Per un singolo uomo adulto la stessa ricetta funziona: una camicia bianca sbottonata sulla soglia di una camera da letto con la luce del mattino è venuta come voluto al primo seed, e lo stesso vale per una donna in accappatoio che scivola da una spalla accanto a una finestra all’alba.
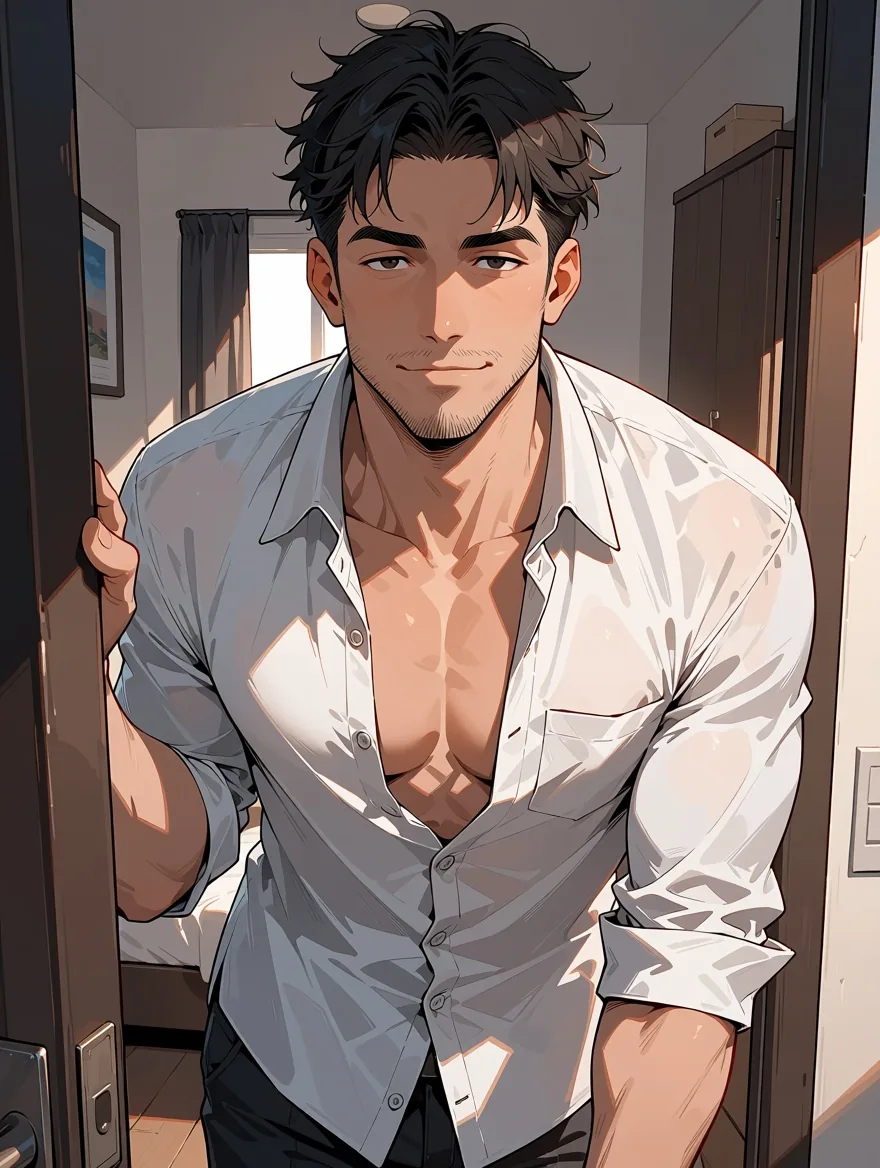
Uomo adulto da solo, 3:4, sensitive.
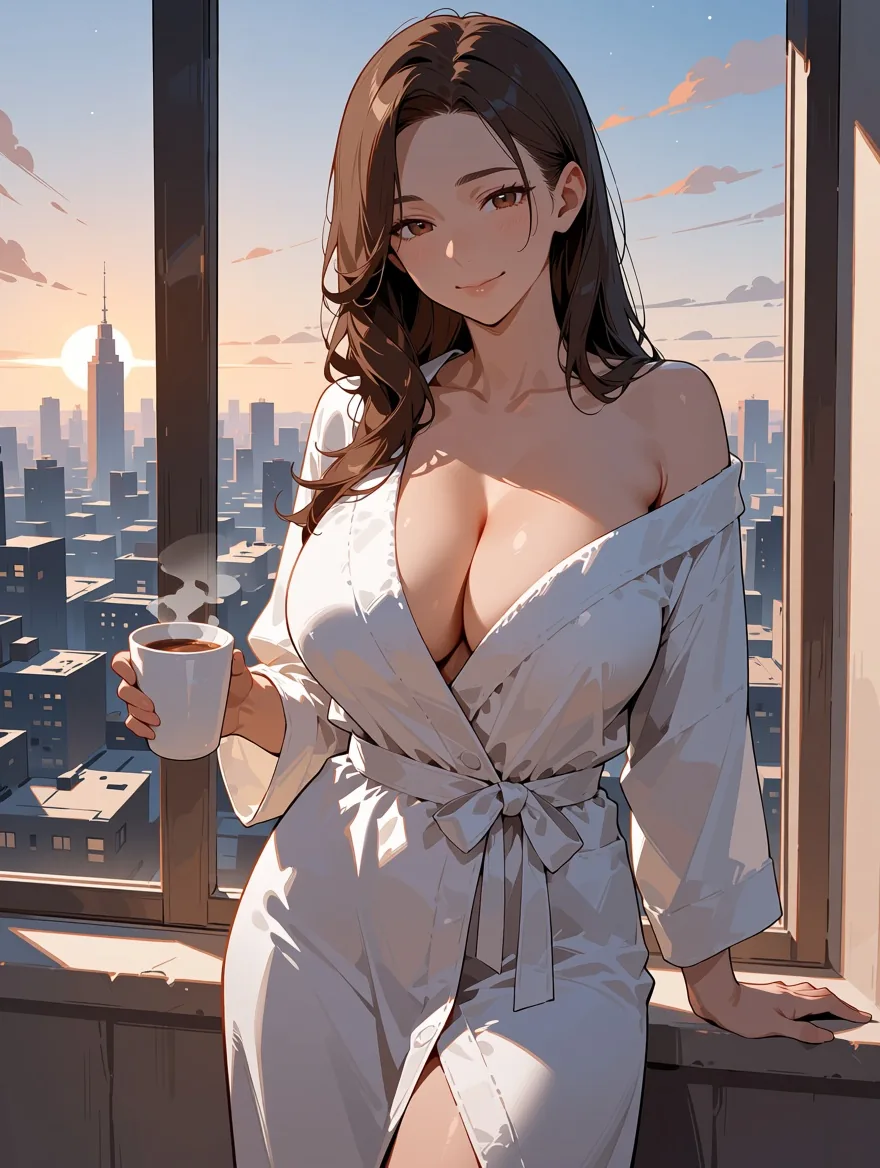
Donna adulta da sola, 3:4, sensitive.
Quali sono i limiti?
È un modello anime: niente fotorealismo, l’abitudine di disegnare scarabocchi simili a firme e i soliti problemi con le mani. Nei nostri test:
- Niente fotorealismo. Il modello di base è addestrato su dati anime e di illustrazione; l’editore indica diversi milioni di immagini anime più circa 800.000 altre immagini artistiche. Non produce fotografie. Per i contenuti per adulti questo ha un effetto collaterale utile: i risultati si leggono come illustrazioni e mai come fotografie di persone reali.
- Il vezzo della firma. A volte il modello disegna in un angolo uno scarabocchio simile a una firma o una riga di pseudo-testo, un’abitudine appresa dalle opere d’arte. L’abbiamo vista in circa un’immagine su cinque. Non c’è un prompt negativo per sopprimerla, quindi cambia il seed o ritaglia l’angolo.
- Mani e anatomia. Senza rifiuti non significa senza difetti. Mani e anatomia richiedono nuovi tentativi, come con qualsiasi modello di immagini.
- Testo. Rende soltanto una parola o due di testo.
- L’immagine in immagine ridisegna nello stile; non segue istruzioni di modifica. Con una foto come origine, una strength di 0.6 si legge già come un’illustrazione con gli stessi dettagli e 0.75 dà un anime pulito con la stessa composizione. Chiedere a un’illustrazione esistente un nuovo abito o il passaggio dal giorno alla notte ha cambiato pochissimo tra 0.6 e 0.8. La strength è spiegata in Da foto ad anime con Anima Turbo: scegliere la strength giusta. La pagina dell’immagine in immagine mantiene la forma dell’origine, perché non ha un campo per le proporzioni.
- Controlli mancanti. Niente prompt negativo, step, CFG, sampler, formato di output (sempre JPEG), maschere o più immagini per richiesta.
Quale famiglia Anima scegliere?
Parti da Anima Turbo; passa alla famiglia LoRA quando vuoi uno stile che il modello di base non dà. I due livelli costano uguale per ogni livello di risoluzione, l’immagine in immagine costa come il testo a immagine e le proporzioni non cambiano il prezzo. I prezzi aggiornati sono sulle pagine dei modelli e le richieste fallite non vengono addebitate.
| Cosa vuoi | Scegli | Perché |
|---|---|---|
| Anime pulito da tag o frasi, da testo a immagine o immagine in immagine | Anima Turbo | Partenza più rapida; L3 e L4 resi nei nostri test |
| Un look specifico (PC-98, inchiostro manga) o il tuo LoRA adatto agli adulti | Anima Turbo LoRA | Fino a 3 LoRA con uno scale da 0 a 4; L3 e L4 resi |
| Un checkpoint anime della community della linea Pony XL, solo da testo a immagine | Prefect Pony XL | Sette dimensioni SDXL native; tre livelli di prova fino a L4 resi nella nostra esecuzione interna del 18 settembre 2026 |
| Una base fotorealistica che diventa anime con un LoRA anime | Z-Image Turbo LoRA | Fotorealistico di default; L3 e L4 resi da testo a immagine |
Scelta del livello: 1k è circa un megapixel e 1.5k circa 2,4 megapixel, generati in modo nativo e non ingranditi. Nel nostro test di velocità da 60 esecuzioni il tempo del modello è stato di 2–16 secondi per immagine, 52 su 60 sotto i dieci secondi, quindi rilanciare costa poco. La pagina da testo a immagine ha le 15 proporzioni.
Uso responsabile
Sei responsabile di ciò che generi e pubblichi. Rendi adulto ogni personaggio e dillo nel prompt (adult woman, mature male, «sulla trentina»). Non usare persone reali né la loro immagine senza consenso. Tieni privati i tuoi risultati a meno che tu non sia sicuro di poterli condividere e rispetta le regole di ogni sito in cui pubblichi. La piattaforma non esamina i tuoi contenuti e non scrive per te prompt per adulti; gli esempi di questa guida sono volutamente vestiti. Se una richiesta non è appropriata per la tua situazione, non farla.
FAQ
Anima Turbo è davvero senza censura?
Sì. Su SpicyAPI non c’è alcun filtro sui contenuti davanti al modello e, nei nostri test su 25 richieste distribuite su quattro livelli, abbiamo visto zero rifiuti e zero sostituzioni, con e senza LoRA e in immagine in immagine. Senza rifiuti non significa che ogni immagine sia perfetta; anatomia e mani richiedono comunque nuovi tentativi.
Il tag di rating nsfw conta?
Sì, cambia il tono. Anima conosce safe, sensitive, nsfw e un tag più forte, e l’editore descrive nsfw e il tag più forte come quelli che tolgono la moderazione. Con una descrizione vestita abbiamo trovato safe e sensitive quasi identici, quindi scegli il tag che corrisponde all’atmosfera che vuoi.
Le immagini somiglieranno a persone reali?
No. Il modello di base non fa fotorealismo, quindi ogni risultato si legge come illustrazione e non come fotografia. Questo non rende accettabile la somiglianza con persone reali: non richiederle nei prompt senza consenso.
Posso mantenere lo stesso personaggio in più immagini?
In gran parte sì. Riusa il blocco del personaggio parola per parola, blocca il seed e cambia solo l’abbigliamento e il luogo. Il personaggio dai capelli argento nel nostro set di tre scene è rimasto riconoscibile, anche se lo stile di resa è cambiato un poco. Un seed fisso non garantisce pixel identici.
I LoRA per adulti funzionano e c’è un costo extra?
Sì a entrambe. La famiglia LoRA accetta fino a tre LoRA addestrati per Anima e caricarli non comporta un addebito separato. Un LoRA addestrato per un altro modello di base si carica senza errori e non cambia nulla. Tieni lo scale tra circa 0.5 e 1.2; a 4 l’immagine si è disgregata.
Posso trasformare la mia illustrazione o la mia foto in qualcosa di più spinto?
L’immagine in immagine ridisegna nello stile; non segue istruzioni di modifica. Con un’immagine di origine vestita, chiedere L3 o L4 con una strength tra 0.8 e 0.9 è stato seguito nei nostri test. Una foto a 0.75 diventa anime pulito con la stessa composizione e a 1.0 l’origine viene ignorata.
Perché alcune immagini hanno uno scarabocchio in un angolo?
Il modello ha appreso dalle opere d’arte l’abitudine di disegnare uno scarabocchio simile a una firma o una riga di pseudo-testo. L’abbiamo vista in circa un’immagine su cinque. Non c’è un prompt negativo, quindi cambia il seed o ritaglia l’angolo.