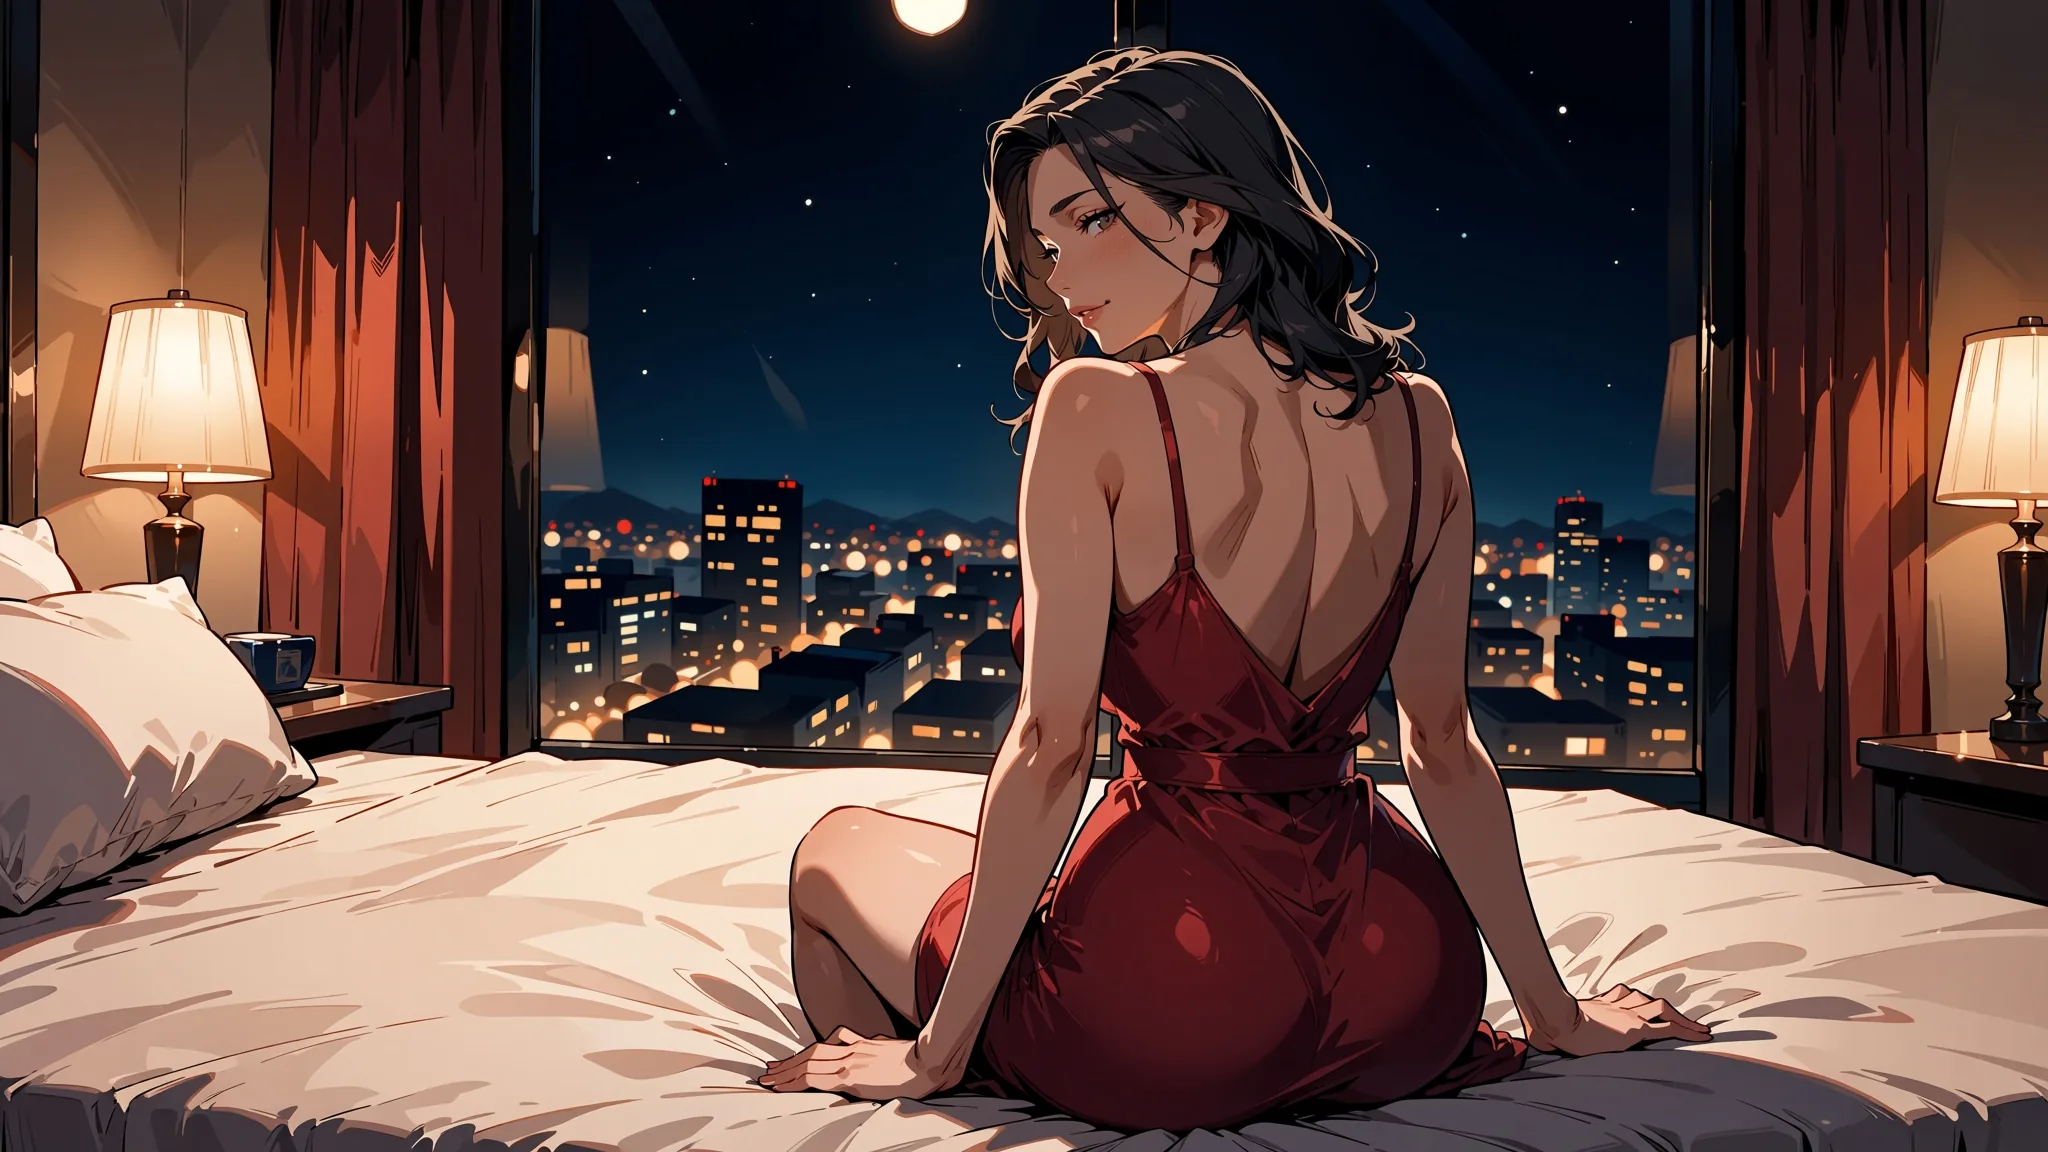
Per trasformare una foto in anime con Anima Turbo, invia la foto come image_url, scrivi un prompt che descriva l’immagine già presente nella foto e imposta strength a 0.75. Nei nostri test quel valore ha dato un anime pulito con la composizione intatta. Più in basso la foto traspare; più in alto il modello comincia a ridisegnare la scena. Tutto il resto di questa guida riguarda come spostare quell’unico numero e cosa fare quando non basta.
Anima Turbo è la versione distillata di Anima, un modello anime e di illustrazione da 2 miliardi di parametri di CircleStone Labs, basato su NVIDIA Cosmos-Predict2 con un encoder di testo Qwen3. Questi endpoint sono senza censura e non aggiungono alcun filtro sui contenuti, e tutto ciò che è riportato qui è una scena di tutti i giorni con adulti vestiti. Abbiamo eseguito ogni test il 5 ottobre 2026.
In breve
| Modello | Anima Turbo di CircleStone Labs (2 miliardi di parametri; Turbo è la versione distillata da cui l’editore consiglia di partire) |
| Nome API dell’immagine in immagine | circlestone-labs/anima-turbo/edit |
| Con LoRA | circlestone-labs/anima-turbo-lora/edit, fino a 3 LoRA, scale da 0 a 4 |
| Input | image_url (un’immagine sorgente), prompt, strength (da 0 a 1, default 0.8), resolution, seed |
| Strength migliore nei nostri test | 0.75 per una fotografia; 0.85 per trasformare un’illustrazione a colori in inchiostro manga |
| Dimensione dell’output | Mantiene la proporzione della sorgente: una foto 16:9 è tornata a 1360 x 752 con 1k; 1k è circa 1 megapixel, 1.5k circa 2,4 |
| Formato dell’output | Sempre JPEG |
| Velocità | Da 2 a 16 secondi di tempo del modello per immagine su 60 esecuzioni; 52 su 60 in meno di 10 secondi |
| Politica sui contenuti | Senza censura, nessun filtro sui contenuti |
| Cosa non sa fare | Istruzioni di modifica, maschere, prompt negativi, fotorealismo, più di un’immagine sorgente |
Cosa fa davvero strength
strength va da 0 a 1 (default 0.8). A 0 ottieni la sorgente intatta. A 1 la sorgente viene ignorata e ottieni una nuova immagine dal prompt. Tutto ciò che serve sta nel mezzo. Abbiamo eseguito una fotografia di una cantante con un solo prompt e un solo seed, cambiando soltanto il numero.
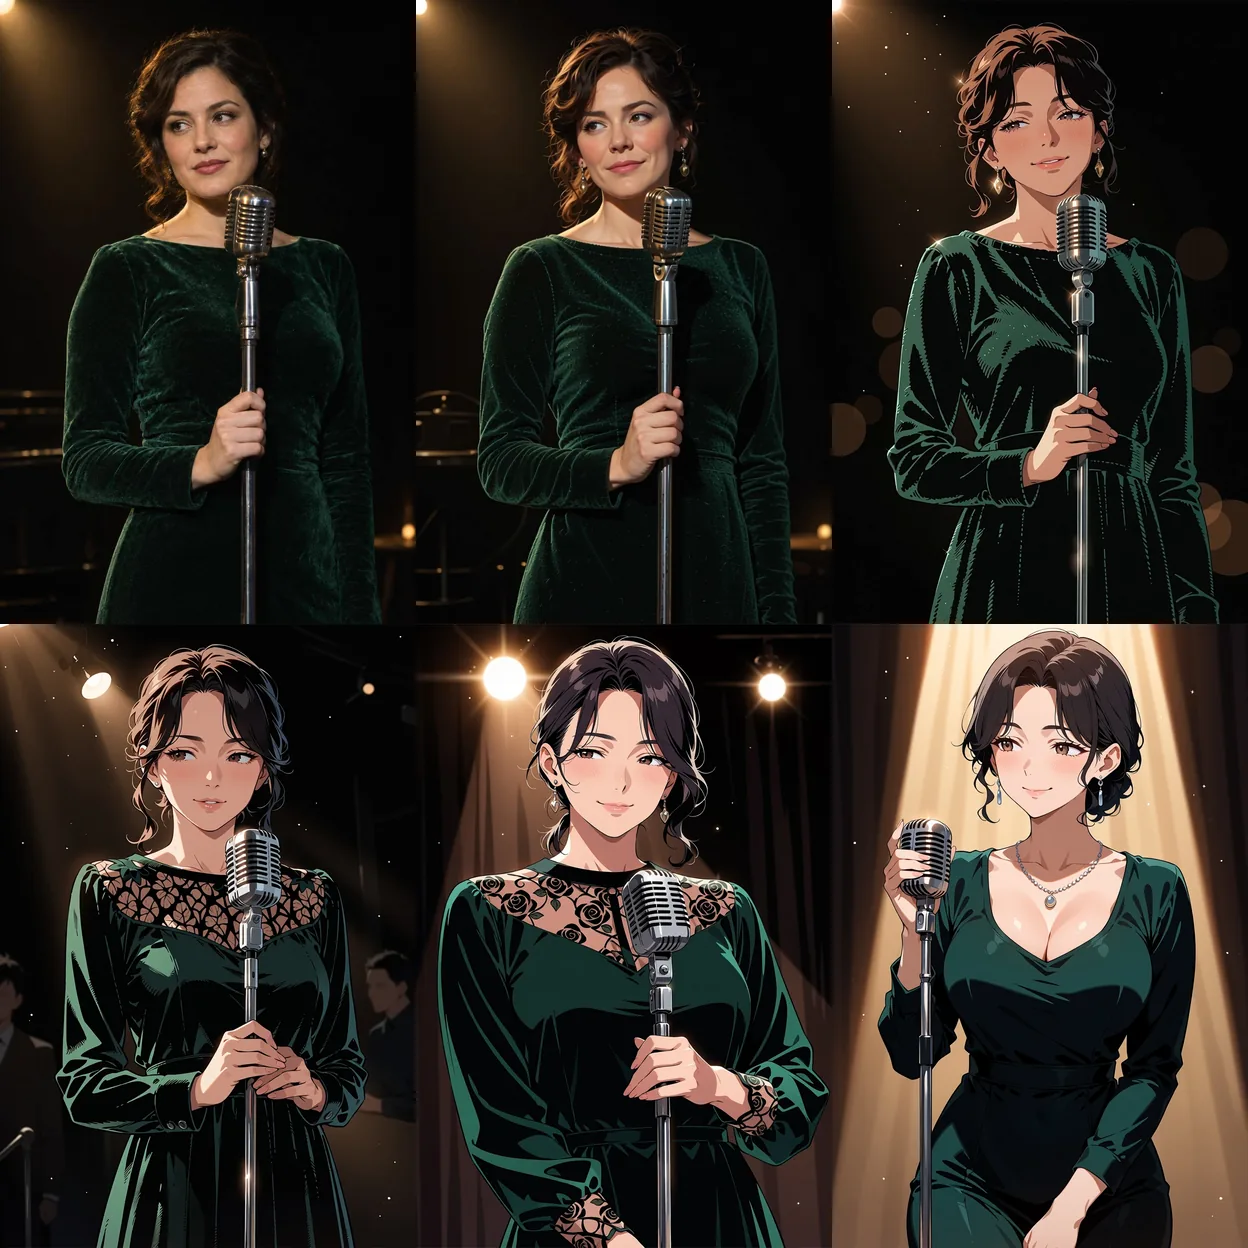
Riga in alto, da sinistra a destra: fotografia sorgente, poi strength 0.3 e 0.6. Riga in basso: 0.75, 0.9 e 1.0. Anima Turbo immagine in immagine, livello 1k, stesso prompt e stesso seed per tutte.
| Strength | Cosa abbiamo visto |
|---|---|
| 0 | La tua sorgente, intatta |
| 0.3 | È ancora una fotografia |
| 0.6 | Già un’illustrazione, con gli stessi dettagli |
| 0.75 | Anime pulito, stessa composizione |
| 0.9 | I dettagli cominciano a cambiare: abito, posa, sfondo |
| 1.0 | Sorgente ignorata; una nuova immagine dal prompt |
Parti da 0.75 e regola a passi di 0.05. Il default di 0.8 va bene, ma 0.75 ha mantenuto meglio posa e inquadratura in tutti gli esempi qui sotto.
Quale valore scegliere dipende da cosa hai e da cosa vuoi:
| Punto di partenza e obiettivo | Strength usata | Risultato nei nostri test |
|---|---|---|
| Da fotografia ad anime semplice | 0.75 | Composizione mantenuta, piccoli meccanismi alla deriva |
| Da fotografia ad anime, un dettaglio deve sopravvivere | 0.7 | Il nostro suggerimento per l’esempio della barista; non eseguito a parte |
| Da fotografia a un look con LoRA di stile (PC-98) | 0.75 | Stile applicato, composizione mantenuta |
| Da illustrazione a colori a inchiostro manga (LoRA monocromatico) | 0.85 | A 0.8 il colore restava; a 0.85 la posa viene ridisegnata |
| Illustrazione esistente più un prompt di “modifica” (nuovo abito, dal giorno alla notte) | Da 0.6 a 0.8 | Ha cambiato pochissimo; con una strength più alta ha aggiunto pseudo-testo |
Scrivi il prompt per l’immagine, non per la modifica
È l’errore che fa perdere più tempo. Anima cambia lo stile; non segue istruzioni come «cambia il suo abito» o «fai notte». Descrivi ciò che c’è nella foto, nello stile che vuoi, e nomina le cose che il modello deve conservare: capelli, abiti, ambiente, luce. La scala con la cantante usava questo prompt:
masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, mature female, short dark wavy hair, dark green velvet dress with long sleeves, holding a vintage microphone on a stand, jazz club stage, warm spotlight from above, dark background, soft smile, looking to the sideValgono le convenzioni di tag dell’editore: minuscolo, spazi al posto dei trattini bassi, prima i tag di qualità e di rating, poi il numero di soggetti (1girl, 1boy), poi i tag generali. I nostri prompt iniziano con safe; non c’è un prompt negativo, quindi il tag di rating è il modo principale per dare il tono. Funzionano anche le frasi (l’editore ne suggerisce almeno due), e va bene mescolarle ai tag.
La richiesta
{
  "model": "circlestone-labs/anima-turbo/edit",
  "input": {
    "image_url": "https://example.com/singer.jpg",
    "prompt": "masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, short dark wavy hair, dark green velvet dress, holding a vintage microphone, jazz club stage, warm spotlight",
    "strength": 0.75,
    "resolution": "1k",
    "seed": 3
  }
}
Non c’è un campo per le proporzioni. L’output mantiene la forma della sorgente: una foto 16:9 è tornata a 1360 x 752 sul livello 1k. resolution imposta il numero di pixel: 1k è circa un megapixel, 1.5k circa 2,4 megapixel, generati in modo nativo e non ingranditi. L’output è sempre JPEG. L’immagine in immagine viene fatturata per immagine in base al livello, come il testo in immagine; il prezzo aggiornato è sulla pagina del modello. Nel nostro test di velocità su 60 esecuzioni il tempo del modello è stato da 2 a 16 secondi per immagine.
Cosa rende buona una foto sorgente
- Un soggetto chiaro. Ogni esempio qui ha una persona o una coppia in un ambiente leggibile, e il prompt può nominare tutto ciò che è nell’inquadratura.
- Niente bordi, didascalie o filigrane. Anima ridisegna l’intera inquadratura, quindi anche tutto ciò che vi è stampato viene ridisegnato.
- Una forma che vuoi conservare. Non c’è un campo per le proporzioni; l’output segue la sorgente (una foto 16:9 ha dato 1360 x 752), quindi ritaglia prima di inviare.
- Un livello adatto all’uso.
1kè circa un megapixel;1.5kè circa 2,4 megapixel, generati in modo nativo e non ingranditi. Lo stesso prompt e lo stesso seed a entrambi i livelli:
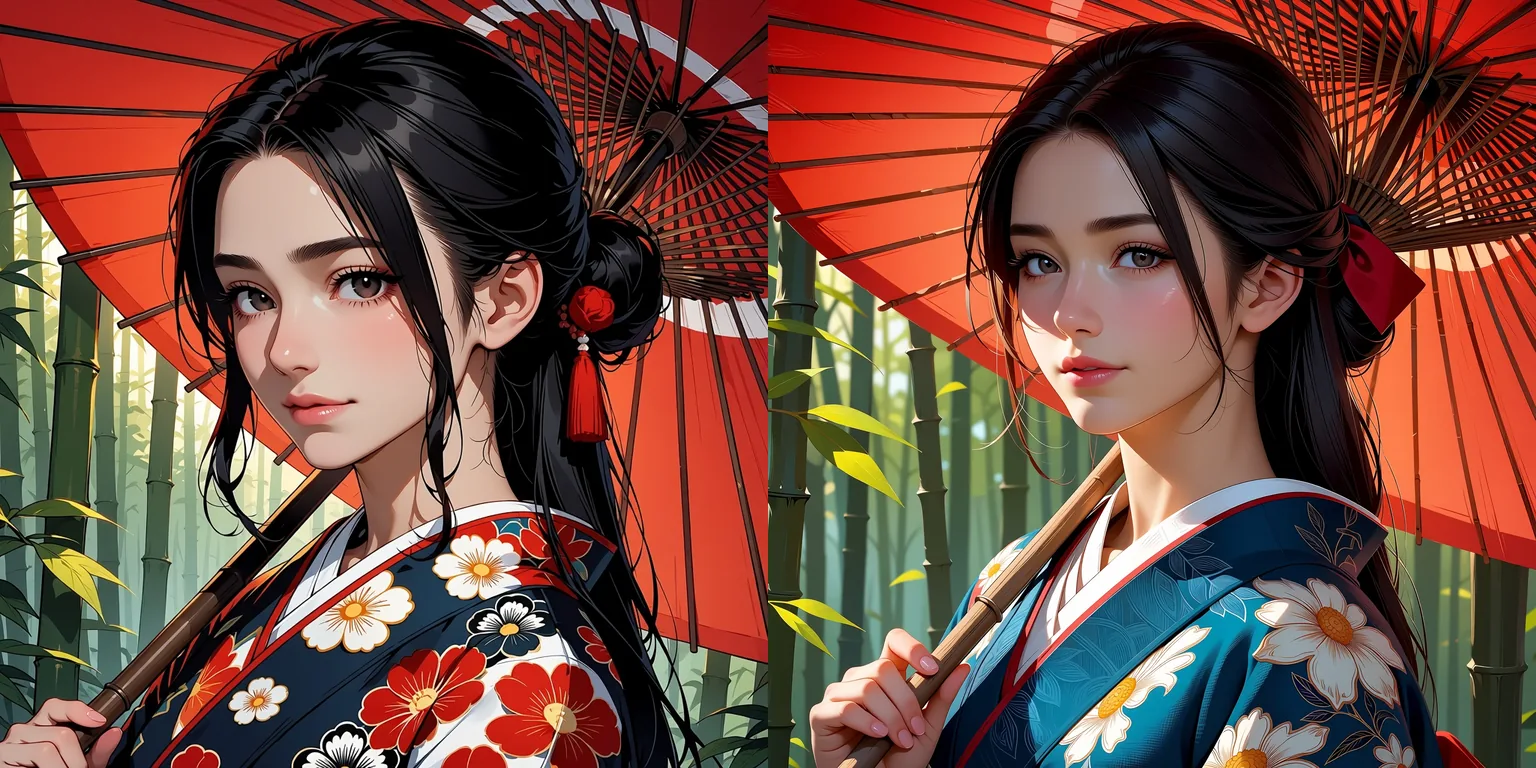
A sinistra: 1k (1024 x 1024). A destra: 1.5k (1536 x 1536). Anima Turbo testo in immagine, stesso prompt e stesso seed. Mostriamo i livelli sul testo in immagine; l’immagine in immagine usa lo stesso campo resolution.
La composizione è la stessa, ma il render a 1.5k ridisegna la fantasia del kimono e il volto invece di aggiungere semplicemente pixel, quindi scegli il livello prima di confrontare i seed.
Tre esempi svolti
Un ritratto
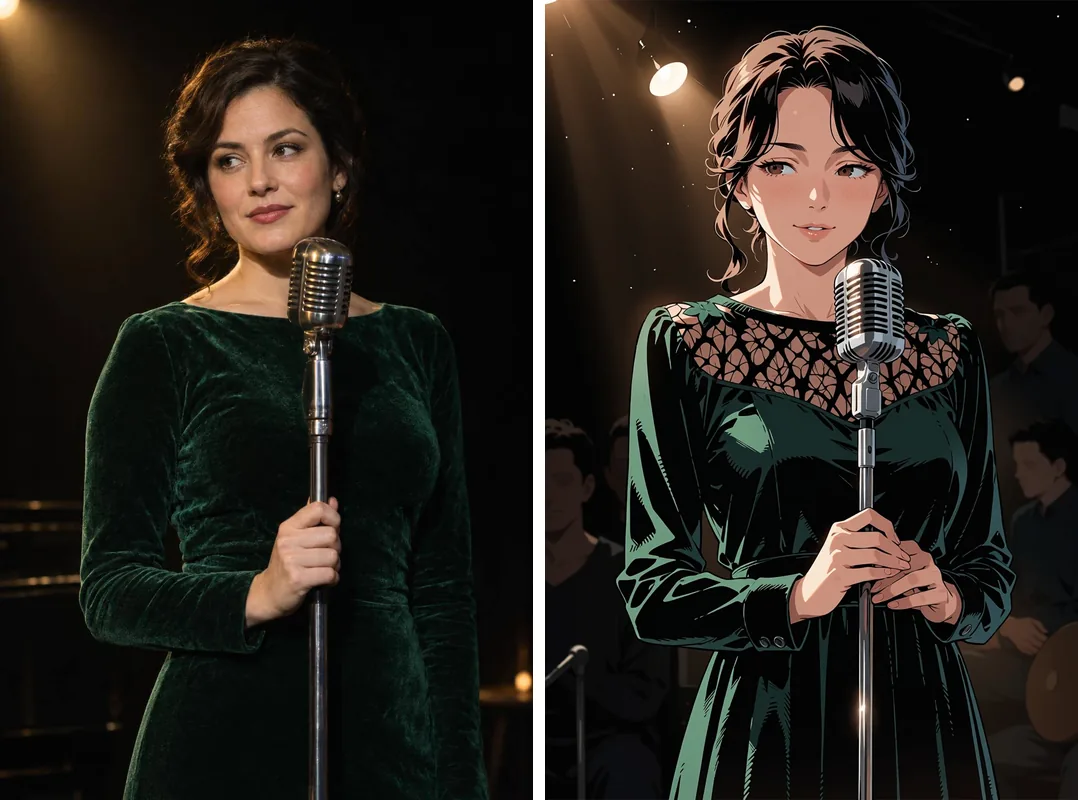
A sinistra: fotografia sorgente. A destra: Anima Turbo immagine in immagine, strength 0.75, 1k, seed 3. Prompt come sopra.
L’abito di velluto, l’asta del microfono e lo sguardo di lato sono sopravvissuti, e la luce del palco è diventata un cono pulito di luce calda. È il riquadro 0.75 della scala, mostrato a dimensione intera.
Una scena in formato orizzontale
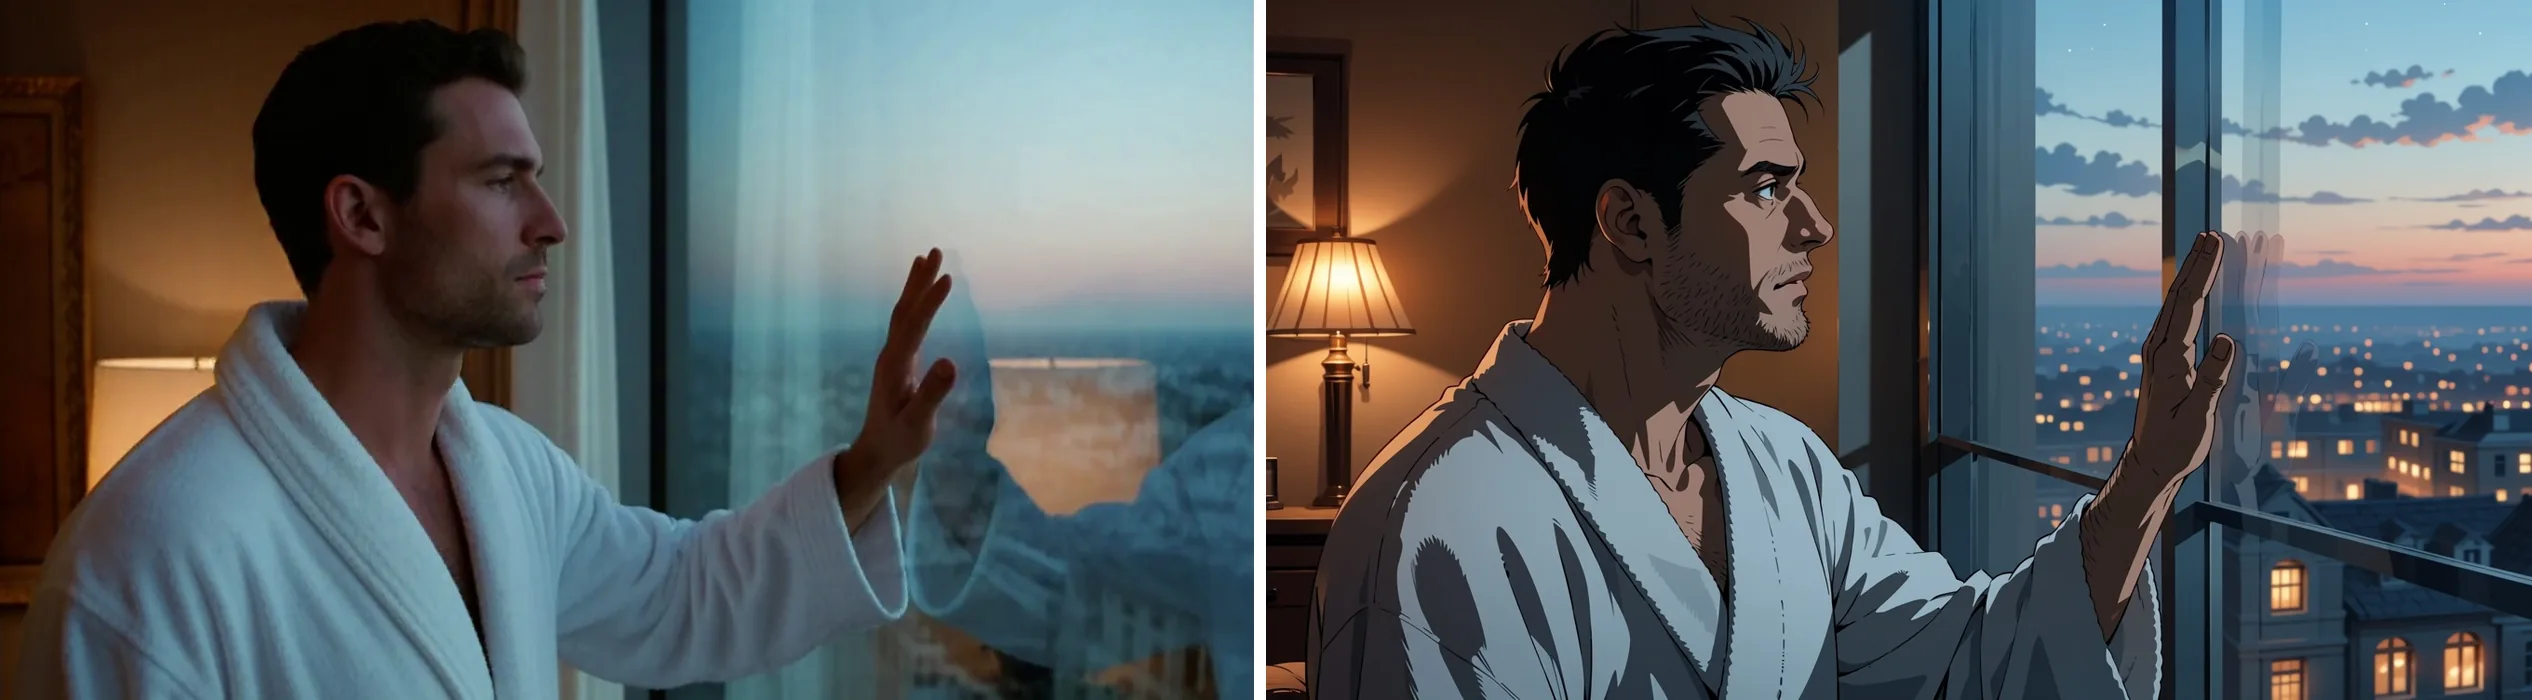
A sinistra: fotografia sorgente. A destra: Anima Turbo immagine in immagine, strength 0.75, 1k, seed 1.
Il prompt nominava la posa (profile view, one hand touching a large window), la lampada alle sue spalle e la luce blu della sera sul vetro. Il modello ha mantenuto il profilo e la mano, e ha disegnato la città fuori con più dettagli di quelli della foto.
Una coppia su uno scooter
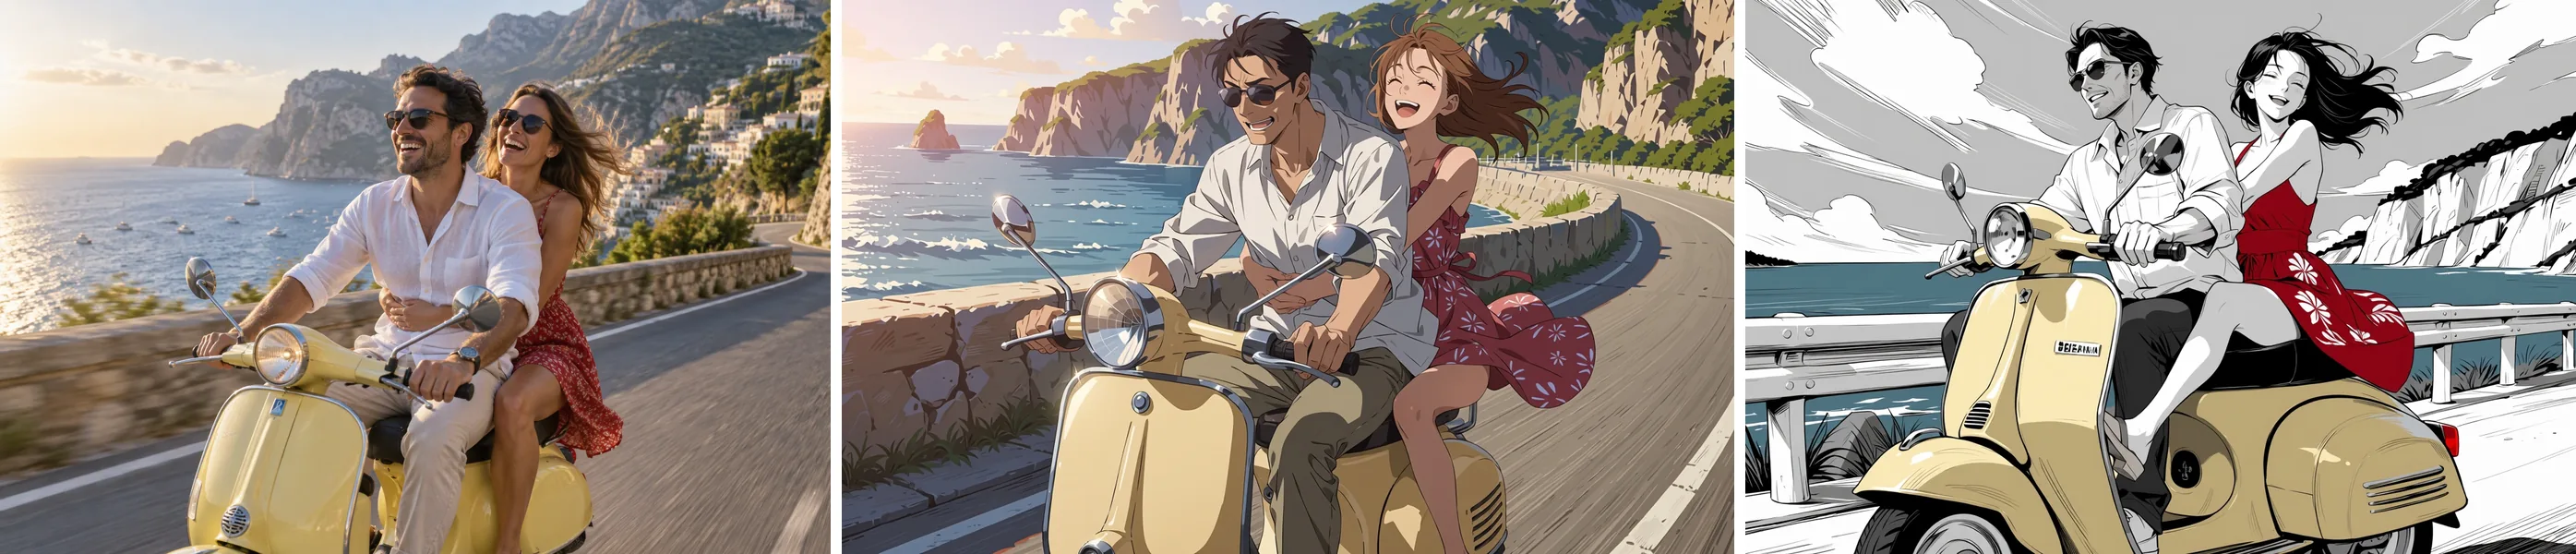
A sinistra: fotografia sorgente, generata da noi. Al centro: Anima Turbo immagine in immagine, strength 0.75, 1k, seed 3, 7% superiore ritagliato. A destra: la stessa richiesta con il LoRA monocromatico e strength 0.85.
masterpiece, best quality, safe, anime illustration, 1girl, 1boy, hetero, adult couple, mature female, mature male, riding a pale yellow vintage scooter on a coastal road, he drives in a white linen shirt and sunglasses, she sits behind him in a red summer dress with her arms around his waist, hair blowing in the wind, laughing, blue sea and cliffsLe scene con due persone richiedono colori e abiti specificati per ciascuna, come sopra. Abbiamo ritagliato il 7% superiore del risultato centrale perché il modello aveva disegnato in quell’angolo un piccolo scarabocchio di pseudo-testo, il che ci porta alla risoluzione dei problemi più sotto. L’esempio della barista, invece, non l’abbiamo ritagliato: ha spostato l’inquadratura.
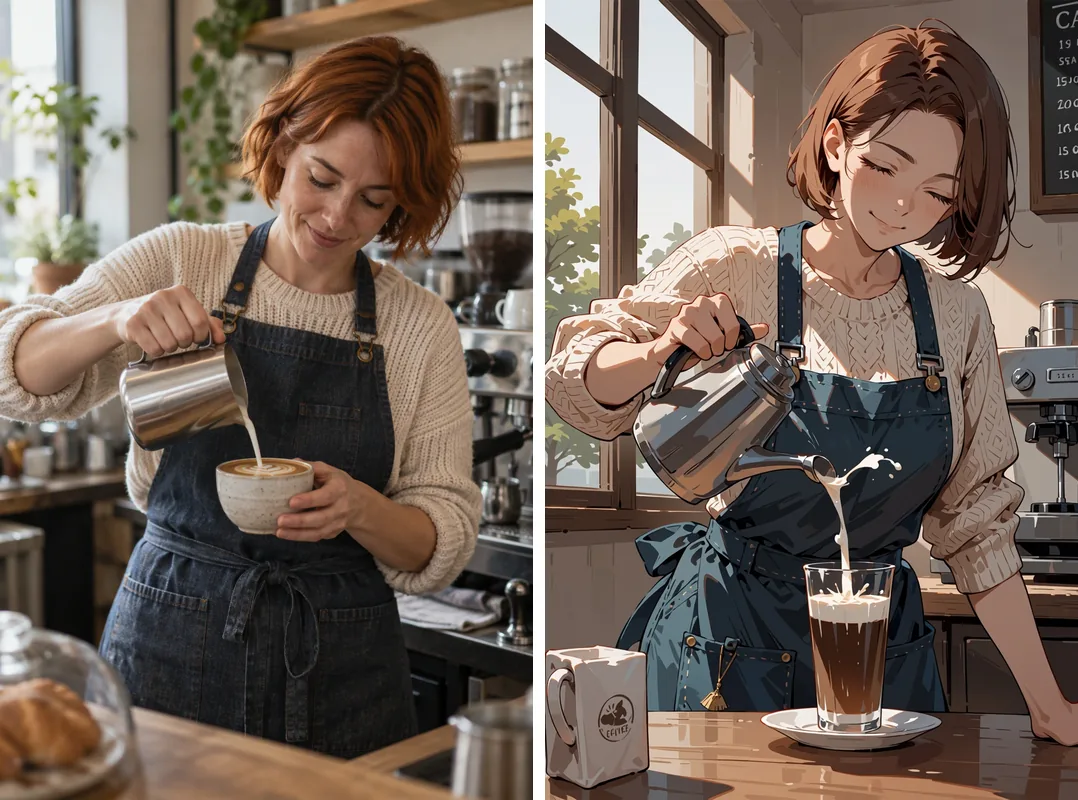
A sinistra: fotografia sorgente, generata da noi. A destra: Anima Turbo immagine in immagine, strength 0.75, 1k, seed 3.
Il grembiule, il maglione, la luce della finestra e la macchina da espresso sono rimasti; la brocca del latte, la tazza e l’angolo di ripresa si sono spostati. A 0.75 aspettati che il contenuto regga e che i piccoli meccanismi derivino. Se un dettaglio è importante, scendi a 0.7.
Cosa non può fare
- Non segue istruzioni di modifica. Chiedere a un’illustrazione esistente un nuovo abito, o il passaggio dal giorno alla notte, ha cambiato pochissimo tra 0.6 e 0.8, e con una strength più alta ha aggiunto pseudo-testo. Il prompt descrive il risultato; non è un comando.
- Non c’è una maschera. Non puoi proteggere una zona né ridipingerne una sola.
- Un’immagine sorgente per richiesta, e nessun campo per prompt negativo, passi o sampler.
- È un modello anime. Non fa fotorealismo e rende solo una parola o due di testo.
- Un seed fisso non garantisce pixel identici. La stessa richiesta con lo stesso seed ci ha dato tre rese leggermente diverse in momenti diversi, quindi conserva le immagini che ti piacciono.
Cambiare stile o modificare: cosa può e cosa non può fare questo endpoint
| Vuoi | Funziona? | Cosa fare |
|---|---|---|
| Trasformare un’intera foto in anime | Sì | Descrivi la foto, strength 0.75 |
| Mantenere posa e inquadratura | Quasi sempre | Nomina la posa nel prompt; abbassa la strength di 0.05 |
| Applicare lo stile di un LoRA a una foto | Sì | LoRA addestrato per Anima, parole trigger, strength 0.75 |
| Cambiare un solo oggetto o l’abito | No | Descrivi l’immagine finita e accetta un ridisegno completo |
| Cambiare l’ora del giorno | No | Come sopra |
| Proteggere o ridipingere una zona | No | Non è disponibile alcuna maschera |
| Ottenere fotorealismo | No | Anima è un modello anime |
Spingere una foto verso uno stile preciso con i LoRA
Anima Turbo LoRA accetta fino a tre voci loras, ciascuna con un link HTTPS diretto a un file .safetensors più uno scale. Il nome del modello nell’API è circlestone-labs/anima-turbo-lora/edit; caricare LoRA non comporta un addebito a parte. Usa LoRA addestrati per Anima: uno addestrato per un altro modello base si è caricato senza errori e non ha cambiato nulla nel nostro test.
Look PC-98, strength 0.75. Con il LoRA PC-98 gal style di Melon-Bread a scale 1, la fotografia di un uomo su un tetto ha assunto lo stile a dithering e a tavolozza limitata dei giochi per PC degli anni Novanta, mantenendo la composizione. Il prompt si apriva con le parole trigger:
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, ...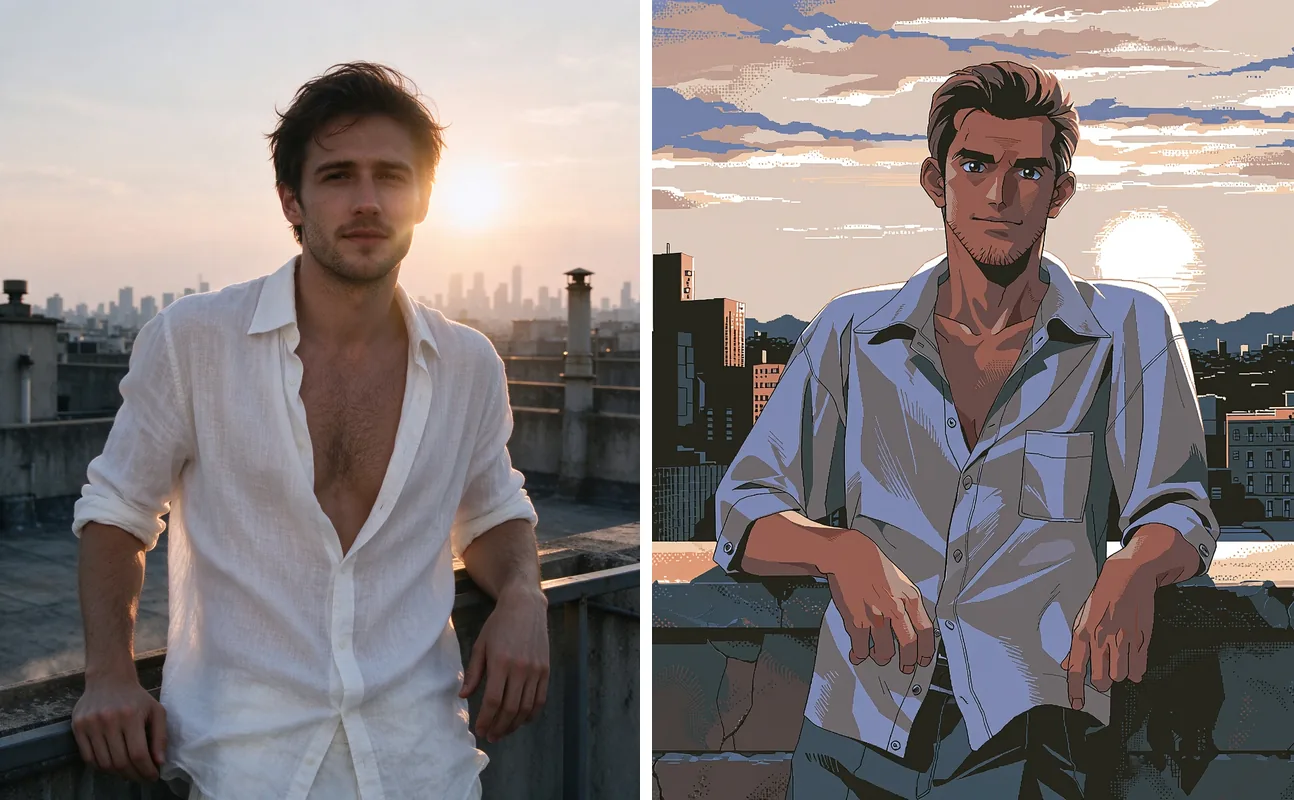
A sinistra: fotografia sorgente (stock). A destra: Anima Turbo LoRA immagine in immagine, LoRA PC-98 a scale 1, strength 0.75, 1k, seed 42.
Lo stesso LoRA sulla nostra fotografia con la chitarra, tra la versione anime semplice e la sorgente:
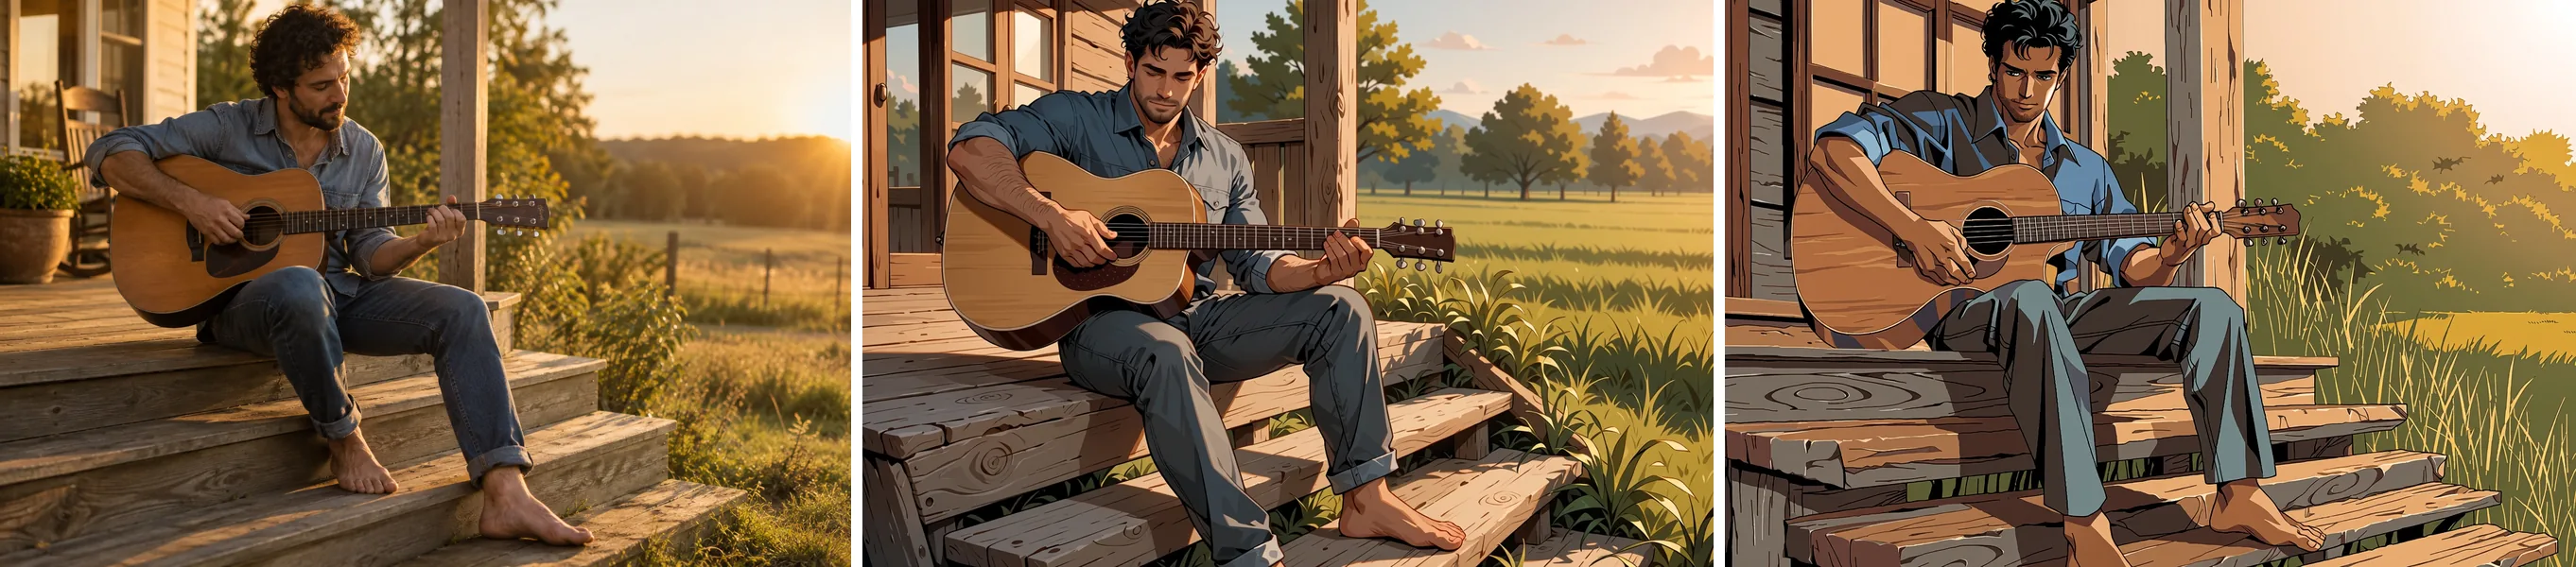
Da sinistra a destra: fotografia sorgente (generata da noi); Anima Turbo con strength 0.75; Anima Turbo LoRA con il LoRA PC-98 a scale 1, strength 0.75. 1k, seed 3.
Inchiostro manga, strength 0.85. Il LoRA monocromatico di notverriegod richiede monochrome, greyscale nel prompt; senza, il nostro test è rimasto a colori. Trasformare in inchiostro un’illustrazione a colori ha richiesto 0.85, perché a 0.8 il colore è rimasto, e con quella strength la posa viene ridisegnata.
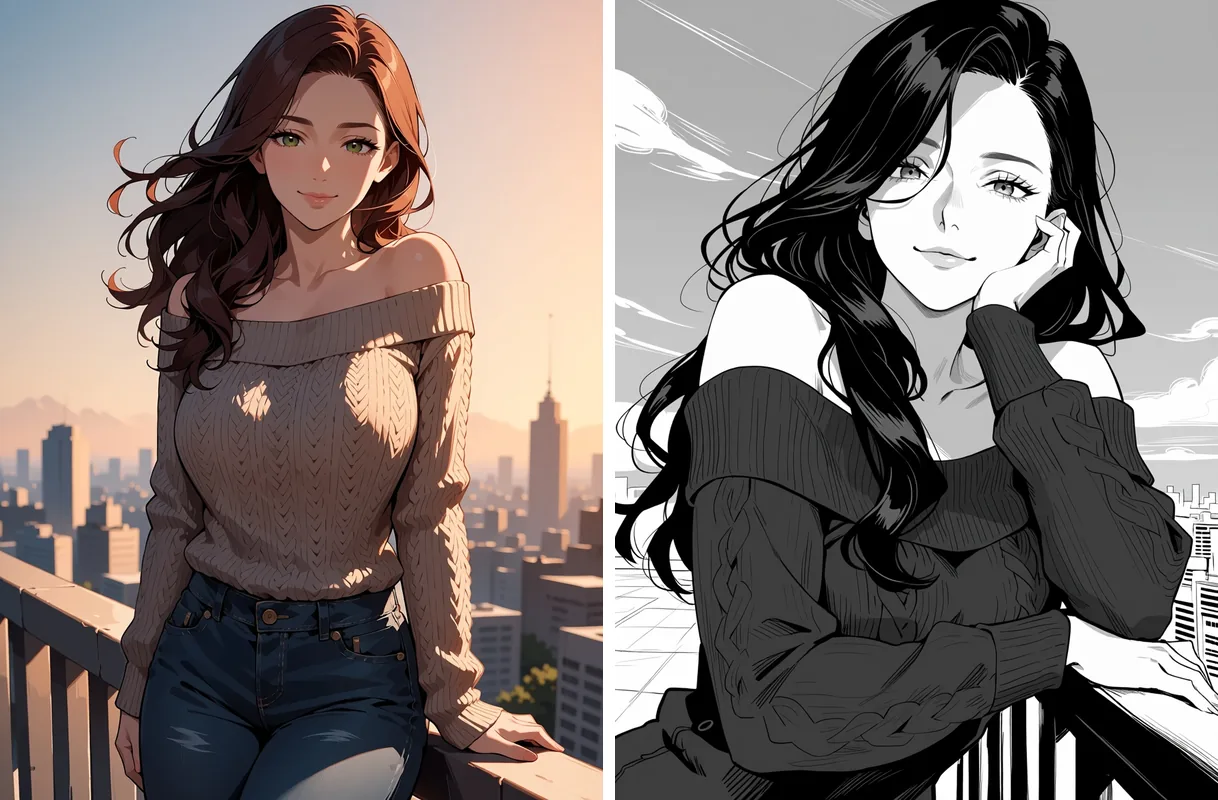
A sinistra: un’illustrazione a colori di Anima Turbo (non una fotografia). A destra: Anima Turbo LoRA immagine in immagine, LoRA monocromatico, strength 0.85, 1k.
Sulla foto dello scooter lo stesso LoRA ha mantenuto un colore di accento sullo scooter e sull’abito (vedi il riquadro di destra qui sopra). Gli scale utili dei LoRA nei nostri test andavano da circa 0.5 a 1.2; a scale 4 l’immagine si è frantumata in forme astratte.
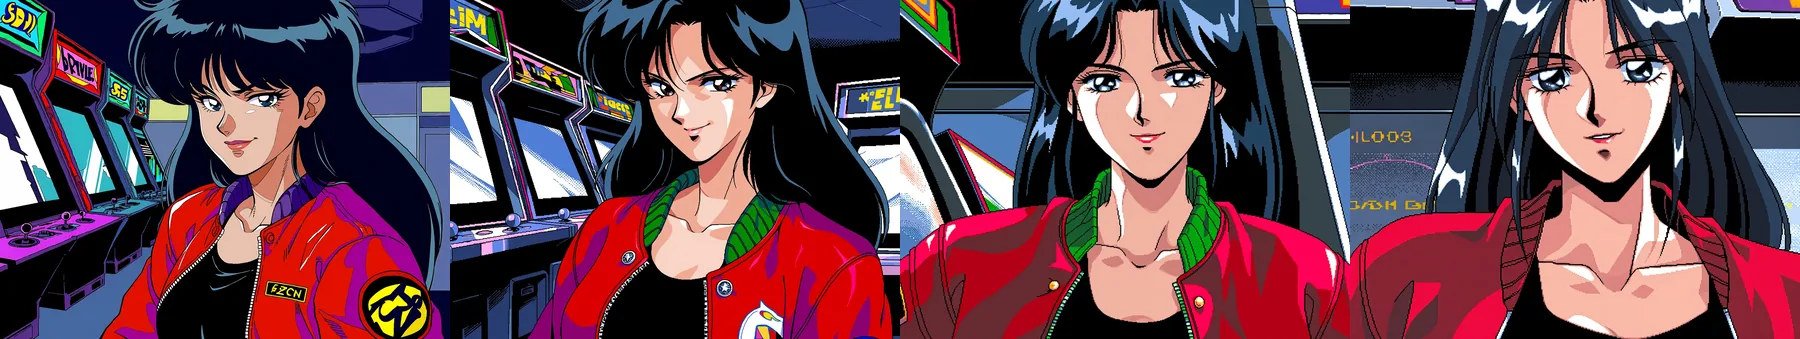
Da sinistra a destra: LoRA PC-98 a scale 0, 0.5, 1 e 1.5. Anima Turbo LoRA testo in immagine, 1k, stesso prompt e stesso seed. A 0 il LoRA è spento; 1 è lo stile completo; 1.5 lo spinge più a fondo.
Risoluzione dei problemi
- La foto traspare ancora: aumenta
strengthdi 0.05 e rilancia. - Il volto o la posa derivano: abbassala di 0.05 e nomina la posa nel prompt.
- Uno scarabocchio o dello pseudo-testo compare in un angolo: cambia il
seed. L’abbiamo visto in circa un’immagine su cinque e nessun prompt negativo può eliminarlo. Funziona anche ritagliare qualche punto percentuale. - Un LoRA non cambia nulla: verifica che sia stato addestrato per Anima e aggiungi le sue parole trigger.
- Vuoi cambiare una sola cosa nell’immagine: questo è lo strumento sbagliato. Anima cambia lo stile di intere immagini e non ha maschera né istruzioni di modifica.
Verdetto: per trasformare foto in anime, Anima Turbo è rapido e prevedibile una volta accettato che strength sia l’unica manopola. Inizia da 0.75, descrivi la foto e spendi i tentativi sui seed invece che su riformulazioni.
Domande frequenti
Che strength devo usare per trasformare una foto in anime?
Parti da 0.75. Nei nostri test ha dato un anime pulito con la composizione intatta; valori più bassi mantengono più della fotografia e valori più alti cominciano a cambiare i dettagli. Regola a passi di 0.05.
Anima Turbo supporta i prompt negativi?
No. Non c’è alcun campo per prompt negativo, passi, CFG o sampler. Il tag di rating all’inizio del prompt (noi usiamo safe) è il modo principale per dare il tono.
Posso dirgli di cambiare una sola cosa nella mia immagine?
No. Cambia lo stile dell’intera immagine e non segue istruzioni di modifica; chiedere a un’illustrazione un nuovo abito o una scena notturna ha cambiato pochissimo tra 0.6 e 0.8. Descrivi invece l’immagine finita e aspettati un ridisegno completo.
Perché l’output ha una forma diversa da quella che avevo chiesto?
Perché l’immagine in immagine non ha un campo per le proporzioni. L’output mantiene la forma della sorgente (una foto 16:9 ha dato 1360 x 752 a 1k), quindi ritaglia prima la foto.
Perché c’è una firma o dello pseudo-testo nell’angolo?
Il modello ha preso l’abitudine dalle opere da cui ha imparato. L’abbiamo vista in circa un’immagine su cinque. Cambia il seed, oppure ritaglia qualche punto percentuale da quel bordo; nessun prompt negativo può eliminarla.
Un seed fisso dà la stessa immagine?
Non in modo affidabile. La stessa richiesta con lo stesso seed ci ha dato tre rese leggermente diverse in momenti diversi, quindi i seed rendono le esecuzioni confrontabili, ma conserva le immagini che ti piacciono.
Posso usare LoRA di altri modelli?
Solo LoRA addestrati per Anima. Uno addestrato per un altro modello base si è caricato senza errori e non ha cambiato nulla nel nostro test. Usa Anima Turbo LoRA con fino a tre link a file .safetensors.
Quanto è veloce?
Su 60 esecuzioni il tempo del modello è stato da 2 a 16 secondi per immagine, 52 delle quali sotto i 10 secondi. La prima richiesta con un nuovo LoRA può richiedere più tempo mentre il file viene scaricato.