Pour transformer une photo en anime avec Anima Turbo, envoyez la photo dans image_url, rédigez un prompt qui décrit l’image déjà présente dans la photo, et réglez strength sur 0.75. Lors de nos tests, cette valeur a donné un anime net avec la composition intacte. En dessous, la photo transparaît ; au-dessus, le modèle commence à redessiner la scène. Tout le reste de ce guide consiste à déplacer ce seul chiffre, et à savoir quoi faire quand cela ne suffit pas.
Anima Turbo est la version distillée d’Anima, un modèle d’anime et d’illustration de 2 milliards de paramètres de CircleStone Labs, bâti sur NVIDIA Cosmos-Predict2 avec un encodeur de texte Qwen3. Ces points d’accès sont sans censure et n’ajoutent aucun filtre de contenu ; tout ce qui est publié ici est une scène du quotidien avec des adultes habillés. Nous avons réalisé tous les tests le 5 octobre 2026.
En un coup d’œil
| Modèle | Anima Turbo de CircleStone Labs (2B de paramètres ; Turbo est la version distillée par laquelle l’éditeur recommande de commencer) |
| Nom d’API de l’image vers image | circlestone-labs/anima-turbo/edit |
| Avec des LoRA | circlestone-labs/anima-turbo-lora/edit, jusqu’à 3 LoRA, scale de 0 à 4 |
| Entrées | image_url (une image source), prompt, strength (de 0 à 1, 0.8 par défaut), resolution, seed |
| Meilleure strength lors de nos tests | 0.75 pour une photographie ; 0.85 pour transformer une illustration en couleur en encre de manga |
| Taille de sortie | Garde le ratio d’image de la source : une photo 16:9 a donné 1360 x 752 en 1k ; 1k fait environ 1 mégapixel, 1.5k environ 2,4 |
| Format de sortie | Toujours JPEG |
| Vitesse | De 2 à 16 secondes de temps de modèle par image sur 60 essais ; 52 sur 60 en moins de 10 secondes |
| Politique de contenu | Sans censure, aucun filtre de contenu |
| Ce qu’il ne sait pas faire | Instructions de modification, masques, prompts négatifs, photoréalisme, plus d’une image source |
Ce que fait vraiment strength
strength va de 0 à 1 (0,8 par défaut). À 0, vous récupérez votre source intacte. À 1, la source est ignorée et vous obtenez une nouvelle image issue du prompt. Tout ce qui est utile se situe entre les deux. Nous avons traité une photo de chanteuse avec un seul prompt et un seul seed, en ne changeant que ce nombre.
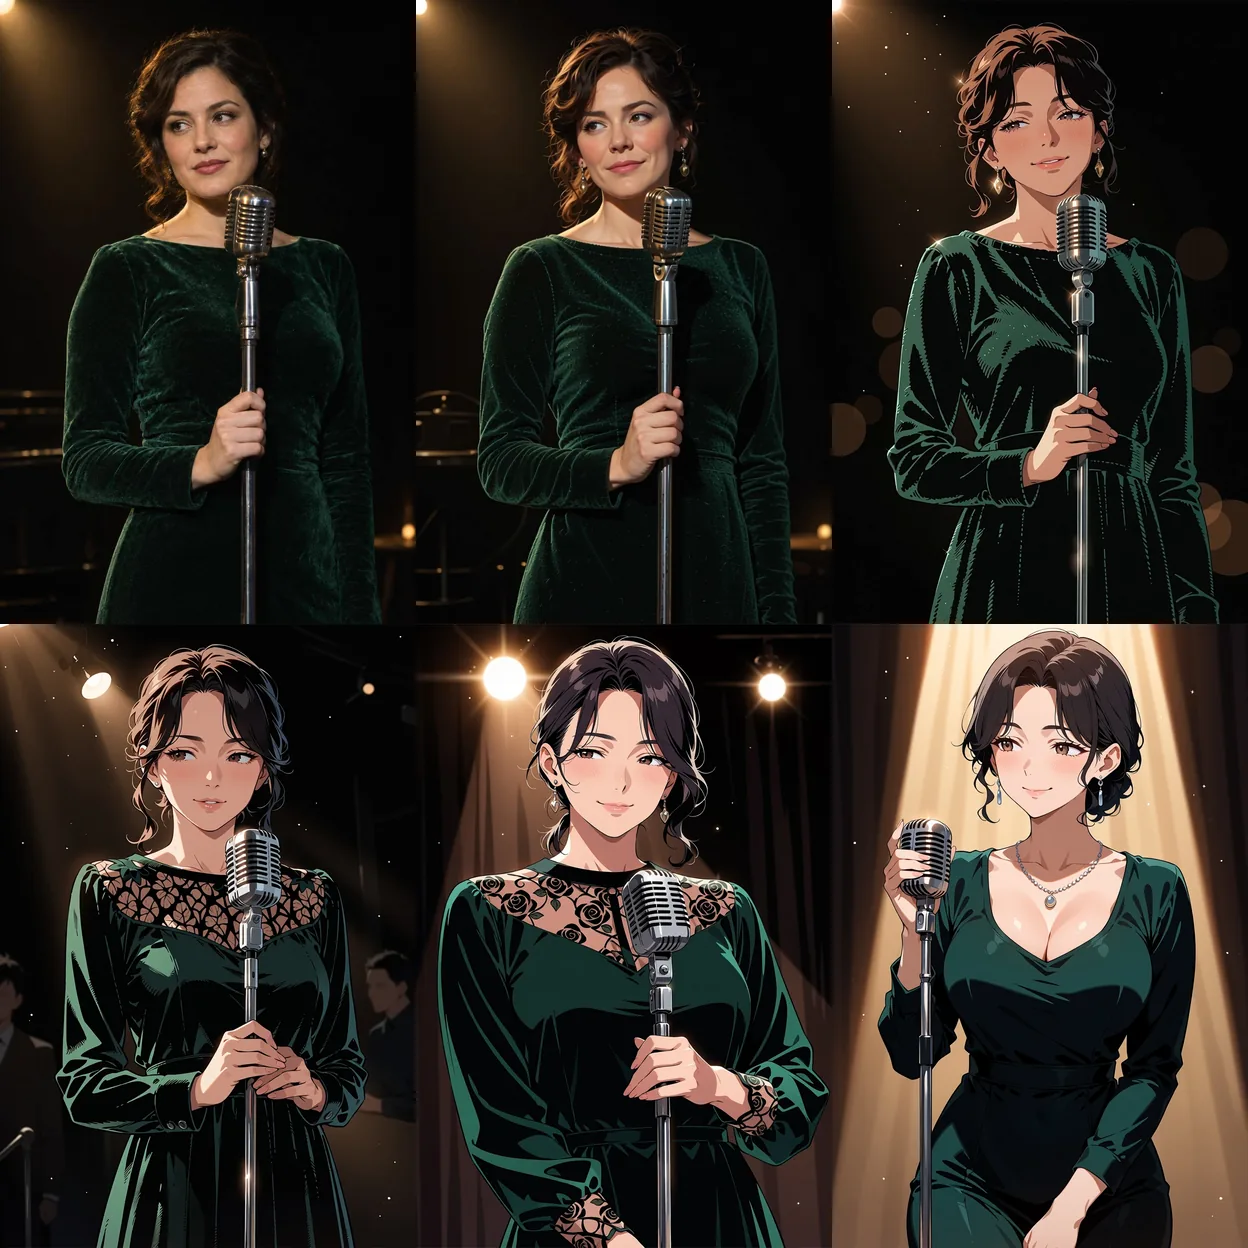
Rangée du haut, de gauche à droite : photo source, puis strength 0.3 et 0.6. Rangée du bas : 0.75, 0.9 et 1.0. Anima Turbo image vers image, palier 1k, même prompt et même seed partout.
| Strength | Ce que nous avons vu |
|---|---|
| 0 | Votre source, intacte |
| 0.3 | Toujours une photographie |
| 0.6 | Déjà une illustration, avec les mêmes détails |
| 0.75 | Un anime net, même composition |
| 0.9 | Les détails commencent à changer : robe, pose, décor |
| 1.0 | Source ignorée ; une nouvelle image issue du prompt |
Commencez à 0,75 et ajustez par pas de 0,05. La valeur par défaut de 0,8 convient, mais 0,75 a mieux gardé la pose et le cadrage dans chacun des exemples ci-dessous.
Le choix de la valeur dépend de votre point de départ et de ce que vous voulez :
| Point de départ et objectif | Strength utilisée | Résultat lors de nos tests |
|---|---|---|
| Photographie vers anime simple | 0.75 | Composition conservée, petits détails mécaniques qui dérivent |
| Photographie vers anime, un détail doit survivre | 0.7 | Notre suggestion pour l’exemple du barista ; non testée séparément |
| Photographie vers un rendu LoRA de style (PC-98) | 0.75 | Style appliqué, composition conservée |
| Illustration en couleur vers encre de manga (LoRA monochrome) | 0.85 | 0.8 a laissé la couleur ; à 0.85, la pose est redessinée |
| Illustration existante plus un prompt de « modification » (nouvelle tenue, du jour à la nuit) | 0.6 à 0.8 | Très peu de changement ; à force plus élevée, du pseudo-texte est apparu |
Écrivez le prompt pour l’image, pas pour la modification
C’est l’erreur qui fait perdre le plus de temps. Anima change le style ; il ne suit pas des instructions comme « change sa tenue » ou « fais-en une scène de nuit ». Décrivez ce qui se trouve dans la photo, dans le style voulu, et nommez ce que le modèle doit conserver : cheveux, vêtements, décor, lumière. L’échelle de la chanteuse utilisait ce prompt :
masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, mature female, short dark wavy hair, dark green velvet dress with long sleeves, holding a vintage microphone on a stand, jazz club stage, warm spotlight from above, dark background, soft smile, looking to the sideLes conventions de tags de l’éditeur s’appliquent : minuscules, espaces à la place des tirets bas, tags de qualité et de classification d’abord, puis le nombre de personnages (1girl, 1boy), puis les tags généraux. Nos prompts commencent par safe ; comme il n’y a pas de prompt négatif, le tag de classification est le principal moyen de donner le ton. Les phrases fonctionnent aussi (l’éditeur en suggère au moins deux), et les mélanger avec des tags est possible.
La requête
{
  "model": "circlestone-labs/anima-turbo/edit",
  "input": {
    "image_url": "https://example.com/singer.jpg",
    "prompt": "masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, short dark wavy hair, dark green velvet dress, holding a vintage microphone, jazz club stage, warm spotlight",
    "strength": 0.75,
    "resolution": "1k",
    "seed": 3
  }
}
Il n’y a pas de champ de ratio d’image. La sortie garde la forme de la source : une photo 16:9 est revenue en 1360 x 752 au palier 1k. resolution fixe le nombre de pixels : 1k fait environ un mégapixel, 1.5k environ 2,4 mégapixels, générés nativement et non mis à l’échelle. La sortie est toujours en JPEG. L’image vers image est facturée à l’image selon le palier, comme le texte vers image ; le prix actuel figure sur la page du modèle. Lors de notre test de vitesse sur 60 essais, le temps de calcul a varié de 2 à 16 secondes par image.
Ce qui fait une bonne photo source
- Un sujet clair. Chaque exemple ici montre une personne ou un couple dans un décor lisible, et le prompt peut nommer tout ce qui est dans le cadre.
- Pas de bordures, de légendes ni de filigranes. Anima restylise tout le cadre : tout ce qui y est imprimé est redessiné aussi.
- Une forme que vous voulez garder. Il n’y a pas de champ de ratio d’image ; la sortie suit la source (une photo 16:9 a donné 1360 x 752) : rognez donc avant d’envoyer.
- Un palier adapté à l’usage.
1kfait environ un mégapixel ;1.5kenviron 2,4 mégapixels, générés nativement et non agrandis. Le même prompt et le même seed aux deux paliers :
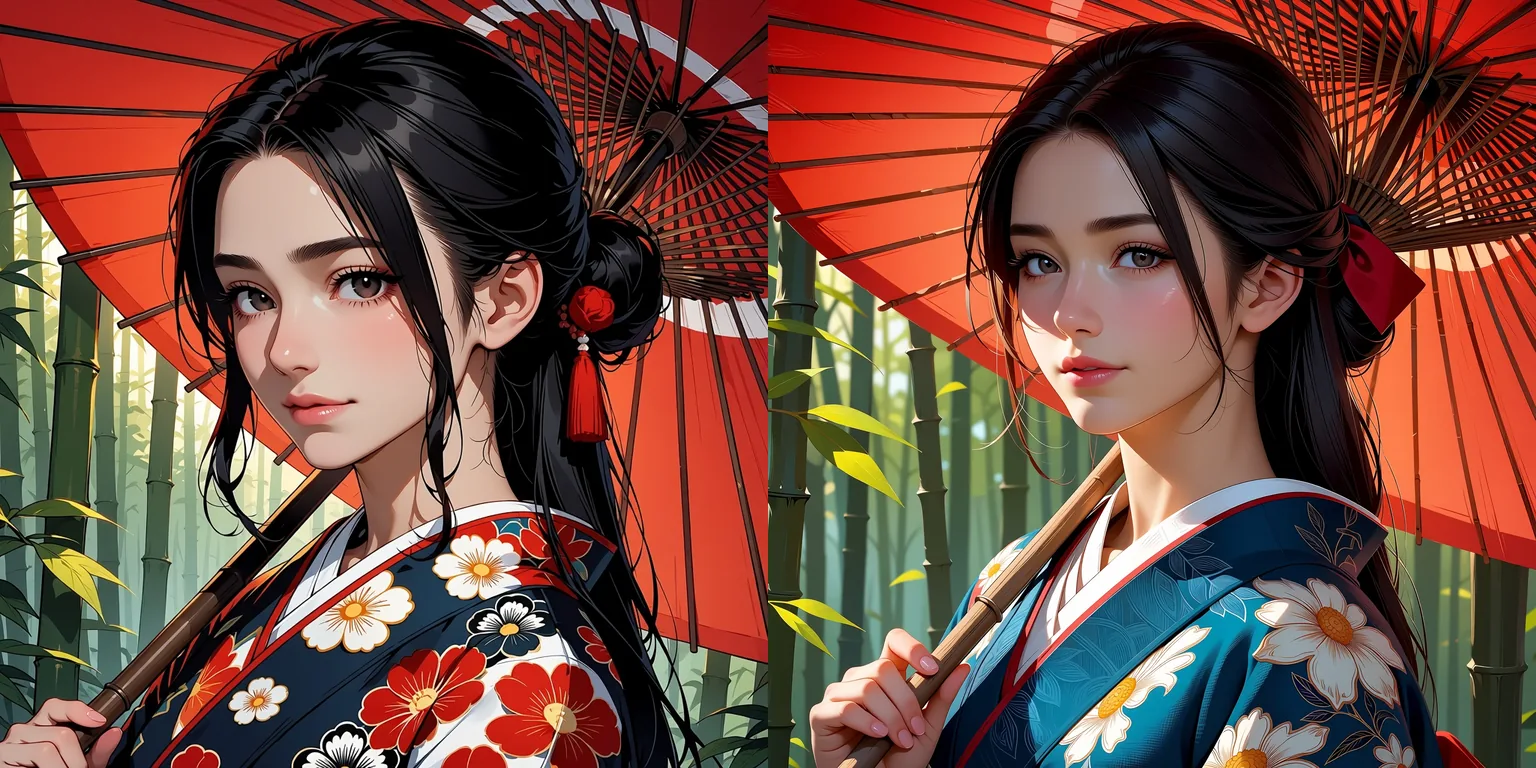
À gauche : 1k (1024 x 1024). À droite : 1.5k (1536 x 1536). Anima Turbo texte vers image, même prompt et même seed. Nous montrons les paliers en texte vers image ; l’image vers image utilise le même champ resolution.
La composition est la même, mais le rendu 1.5k redessine le motif du kimono et le visage au lieu d’ajouter simplement des pixels : choisissez donc le palier avant de comparer des seeds.
Trois exemples concrets
Un portrait
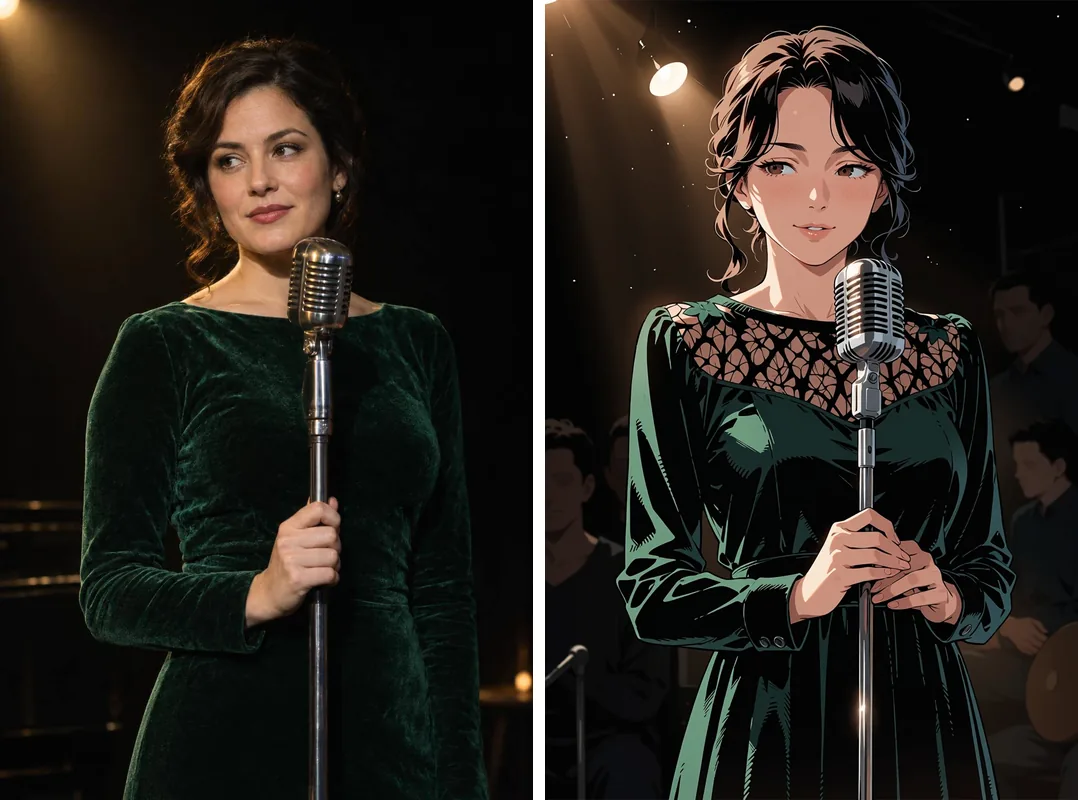
À gauche : photo source. À droite : Anima Turbo image vers image, strength 0.75, 1k, seed 3. Prompt ci-dessus.
La robe de velours, le pied de micro et le regard de côté ont tous survécu, et la lumière de scène est devenue un cône net de lumière chaude. C’est la vignette 0.75 de l’échelle, ici en pleine taille.
Une scène au format paysage
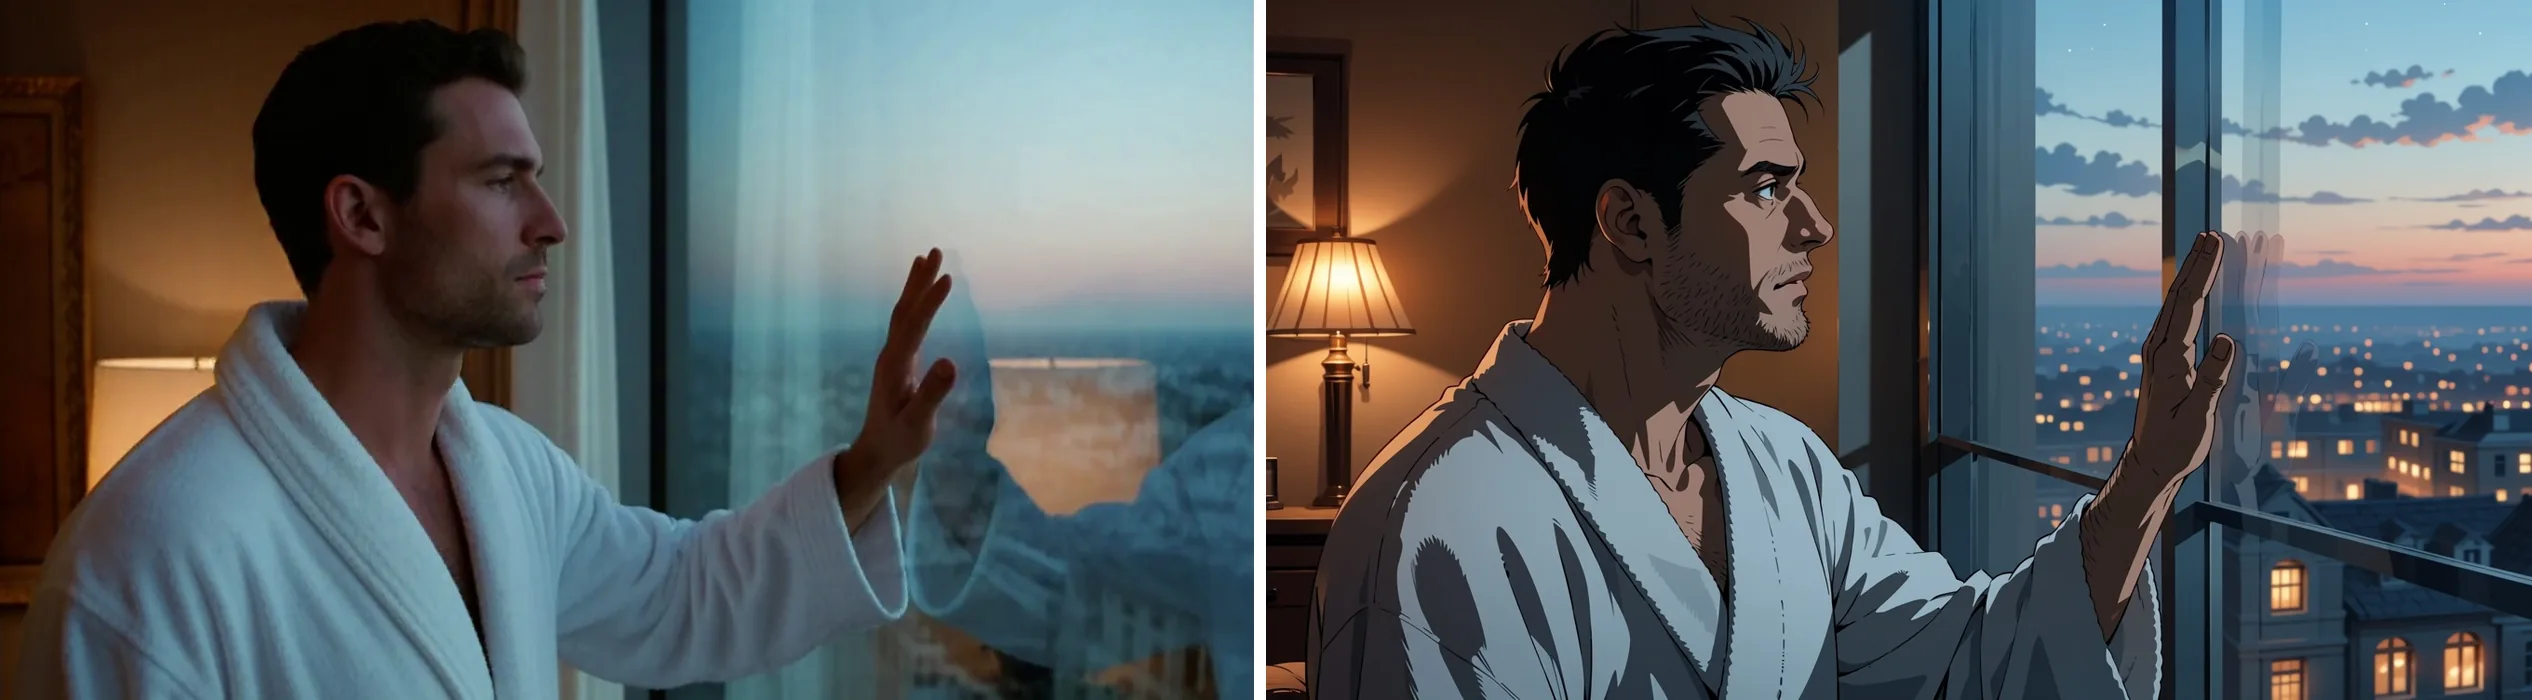
À gauche : photo source. À droite : Anima Turbo image vers image, strength 0.75, 1k, seed 1.
Le prompt nommait la pose (profile view, one hand touching a large window), la lampe derrière lui et la lumière bleue du soir sur la vitre. Le modèle a conservé le profil et la main, et a dessiné la ville au-dehors avec plus de détails que la photo.
Un couple sur un scooter
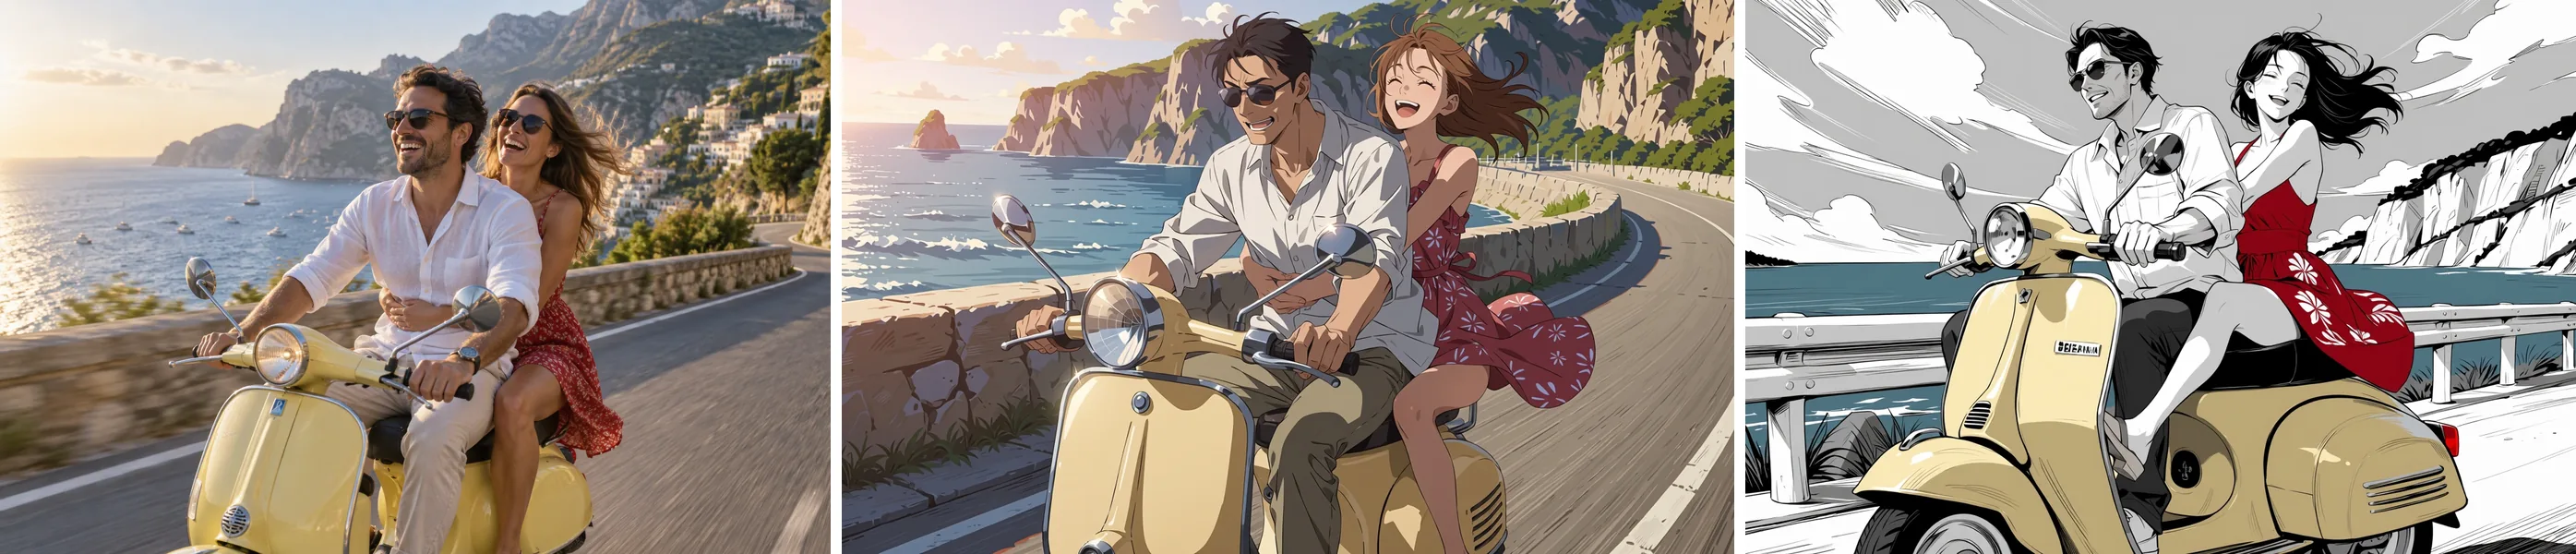
À gauche : photo source, générée par nos soins. Au centre : Anima Turbo image vers image, strength 0.75, 1k, seed 3, 7 % du haut rognés. À droite : la même requête avec le LoRA monochrome à strength 0.85.
masterpiece, best quality, safe, anime illustration, 1girl, 1boy, hetero, adult couple, mature female, mature male, riding a pale yellow vintage scooter on a coastal road, he drives in a white linen shirt and sunglasses, she sits behind him in a red summer dress with her arms around his waist, hair blowing in the wind, laughing, blue sea and cliffsLes scènes à deux personnes demandent de préciser les couleurs et les vêtements de chacune, comme ci-dessus. Nous avons rogné les 7 % du haut du résultat central, car le modèle avait dessiné un petit gribouillis de pseudo-texte dans ce coin, ce qui nous amène au dépannage plus bas. Nous n’avons pas rogné l’exemple du barista, dont le cadrage s’est déplacé :
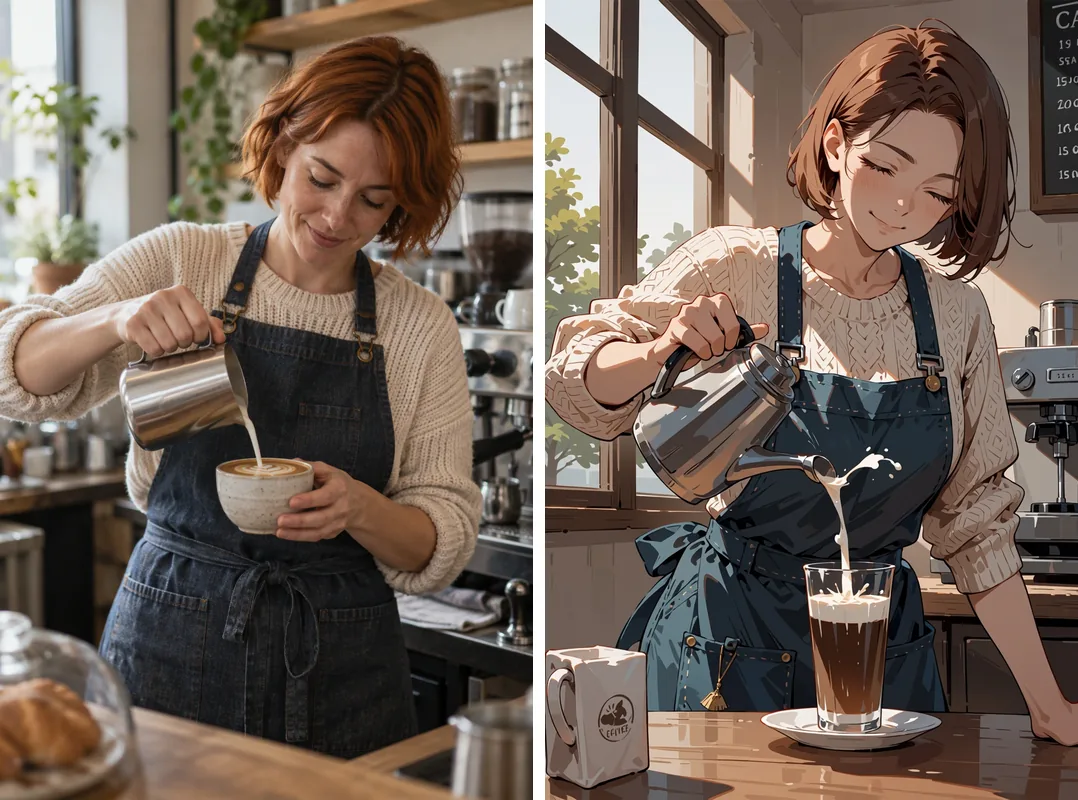
À gauche : photo source, générée par nos soins. À droite : Anima Turbo image vers image, strength 0.75, 1k, seed 3.
Le tablier, le pull, la lumière de la fenêtre et la machine à espresso sont restés ; le pichet de lait, la tasse et l’angle de vue ont bougé. À 0,75, attendez-vous à ce que le contenu tienne et que les petits mécanismes dérivent. Si un détail compte, descendez à 0,7.
Ce qu’il ne sait pas faire
- Il ne suit pas les instructions de modification. Demander à une illustration existante une nouvelle tenue, ou de passer du jour à la nuit, n’a presque rien changé entre 0,6 et 0,8, et à une force plus élevée, il a ajouté du pseudo-texte. Le prompt décrit le résultat ; ce n’est pas une commande.
- Il n’y a pas de masque. Vous ne pouvez pas protéger une zone ni en repeindre une seule.
- Une seule image source par requête, et pas de prompt négatif, d’étapes ni de sampler.
- C’est un modèle d’anime. Il ne fait pas de photoréalisme et ne rend qu’un mot ou deux de texte.
- Un seed fixe ne garantit pas des pixels identiques. La même requête avec le même seed nous a donné trois rendus légèrement différents à des moments différents : gardez donc les images qui vous plaisent.
Restylisation ou modification : ce que ce point d’accès sait faire ou non
| Vous voulez | Possible ? | Que faire |
|---|---|---|
| Transformer toute une photo en anime | Oui | Décrivez la photo, strength 0.75 |
| Garder la pose et le cadrage | En grande partie | Nommez la pose dans le prompt ; baissez strength de 0.05 |
| Appliquer un style LoRA à une photo | Oui | LoRA entraîné pour Anima, mots déclencheurs, strength 0.75 |
| Changer un seul objet ou la tenue | Non | Décrivez l’image finale et acceptez un redessin complet |
| Changer l’heure de la journée | Non | Même chose |
| Protéger ou repeindre une zone | Non | Aucun masque n’est disponible |
| Obtenir du photoréalisme | Non | Anima est un modèle d’anime |
Pousser une photo vers un style précis avec des LoRA
Anima Turbo LoRA accepte jusqu’à trois entrées loras, chacune étant un lien HTTPS direct vers un fichier .safetensors plus un scale. Le nom du modèle dans l’API est circlestone-labs/anima-turbo-lora/edit ; le chargement de LoRA n’entraîne aucun supplément. Utilisez des LoRA entraînés pour Anima : un LoRA entraîné pour un autre modèle de base s’est chargé sans erreur et n’a rien changé lors de notre test.
Rendu PC-98, strength 0.75. Avec le LoRA PC-98 gal style de Melon-Bread à scale 1, la photo d’un homme sur un toit a pris le style tramé, à palette limitée, des jeux PC des années 1990, en conservant la composition. Le prompt s’ouvrait sur les mots déclencheurs :
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, ...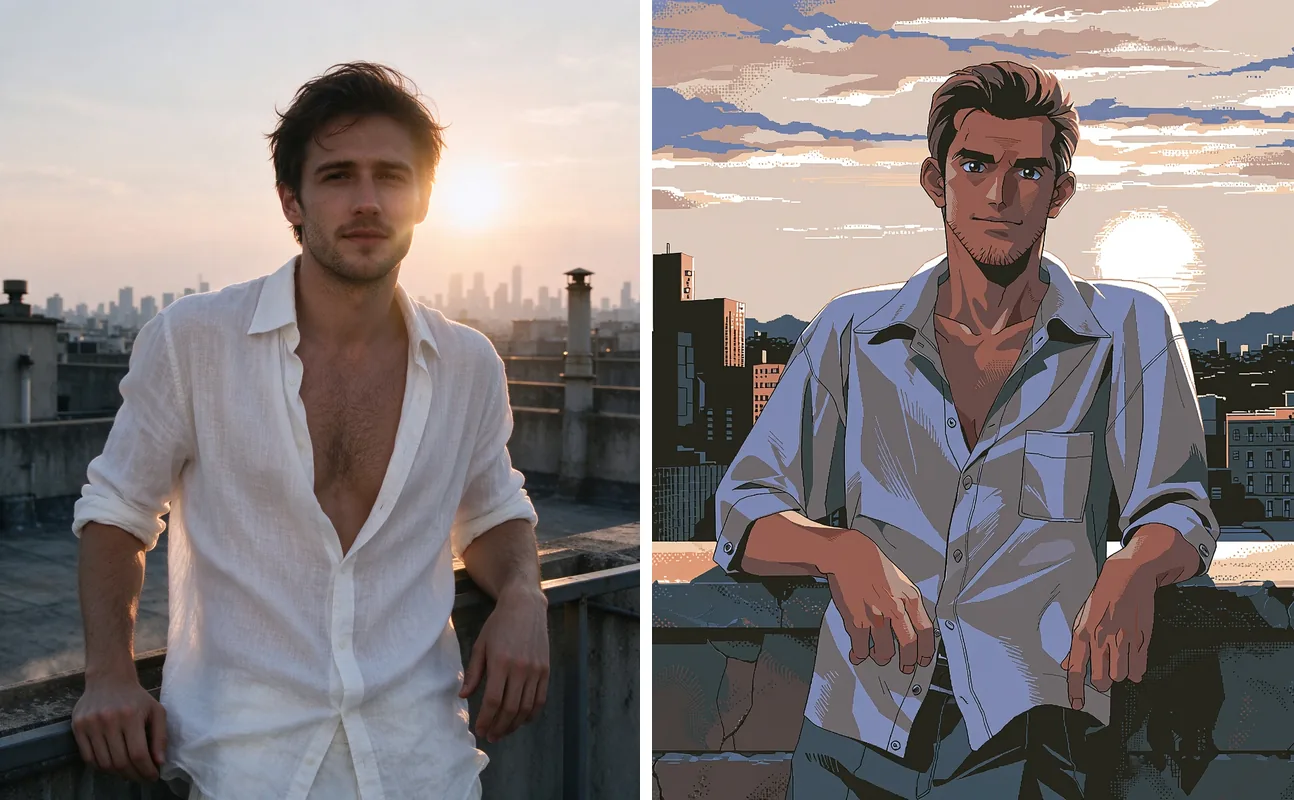
À gauche : photo source (banque d’images). À droite : Anima Turbo LoRA image vers image, LoRA PC-98 à scale 1, strength 0.75, 1k, seed 42.
Le même LoRA sur notre photo de guitare, entre la version anime simple et la source :
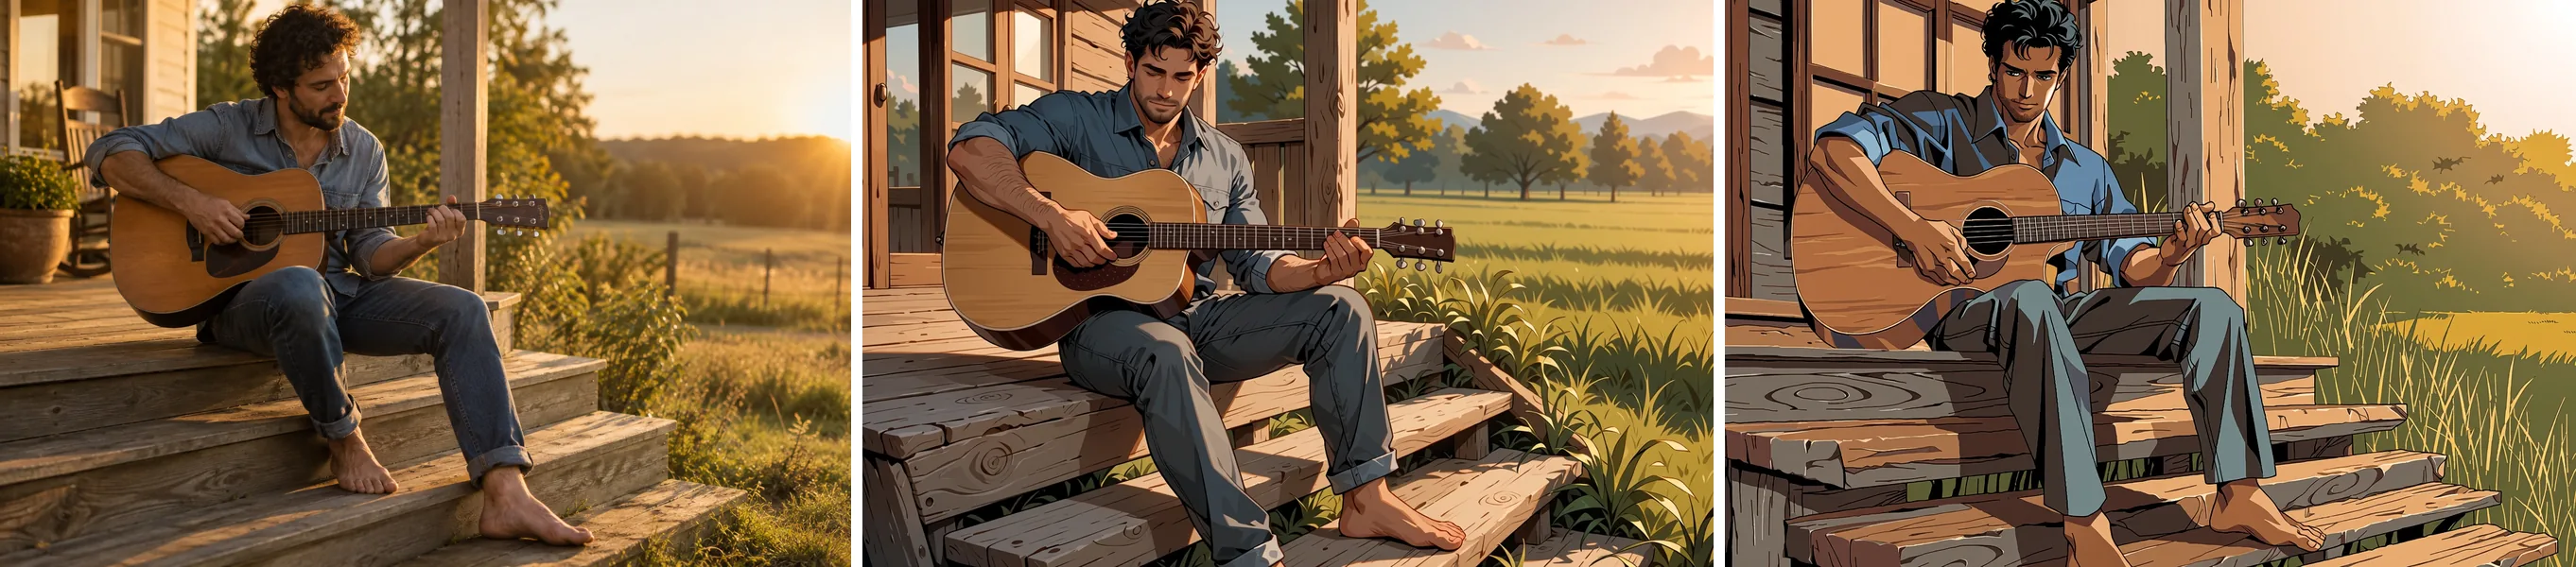
De gauche à droite : photo source (générée par nos soins) ; Anima Turbo à strength 0.75 ; Anima Turbo LoRA avec le LoRA PC-98 à scale 1, strength 0.75. 1k, seed 3.
Encre de manga, strength 0.85. Le LoRA monochrome de notverriegod exige monochrome, greyscale dans le prompt ; sans eux, notre test est resté en couleur. Transformer une illustration en couleur en encre a demandé 0,85, car à 0,8 la couleur est restée, et à cette force la pose est redessinée.
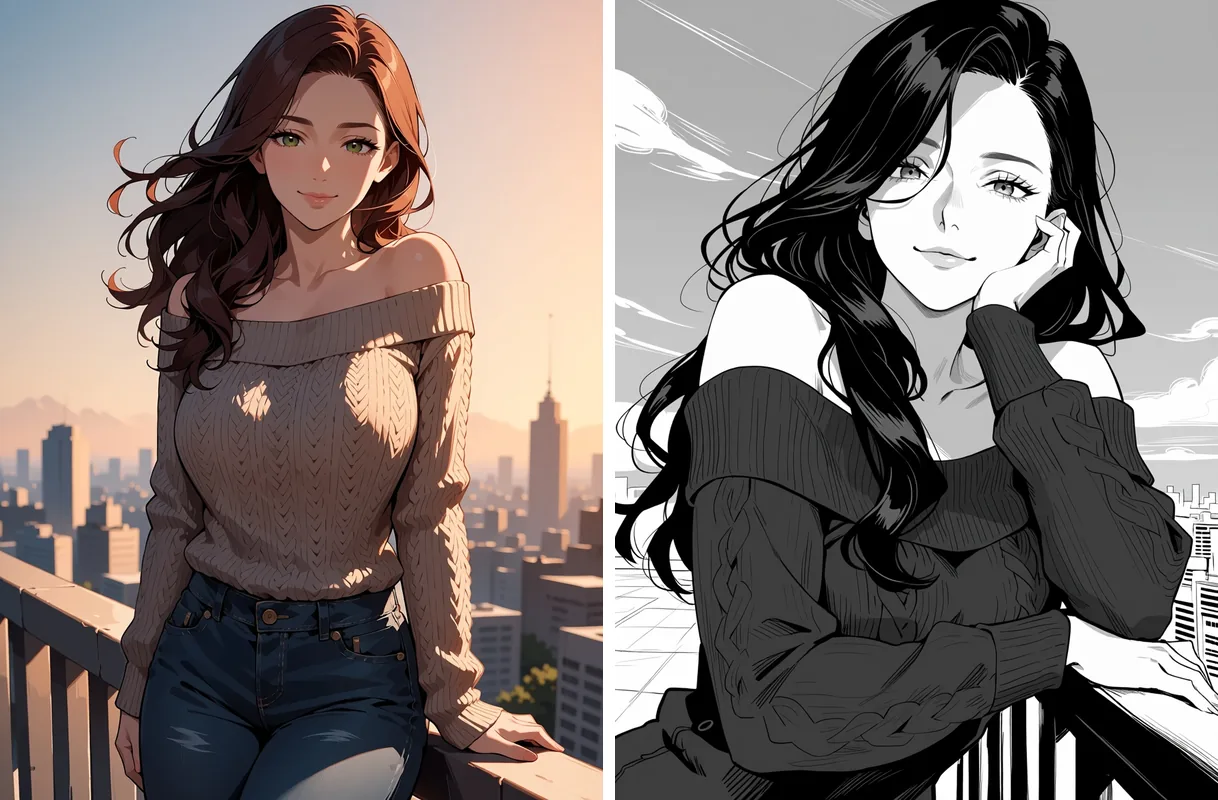
À gauche : une illustration Anima Turbo en couleur (pas une photographie). À droite : Anima Turbo LoRA image vers image, LoRA monochrome, strength 0.85, 1k.
Sur la photo du scooter, le même LoRA a conservé une couleur d’accent sur le scooter et la robe (voir le panneau de droite plus haut). Les scales de LoRA utiles lors de nos tests allaient d’environ 0,5 à 1,2 ; à 4, l’image s’est désagrégée en formes abstraites.
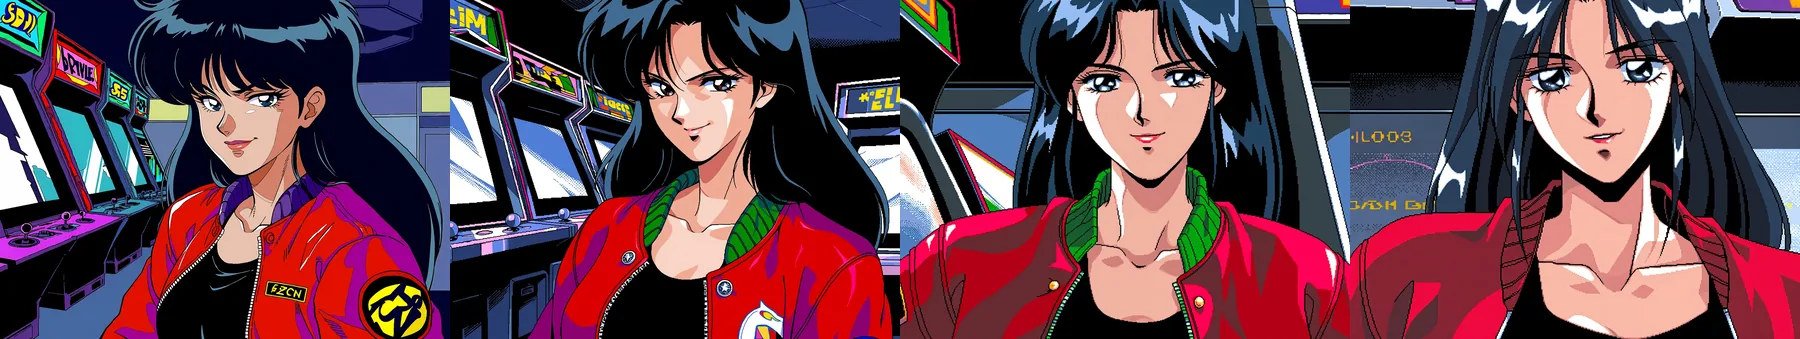
De gauche à droite : LoRA PC-98 à scale 0, 0.5, 1 et 1.5. Anima Turbo LoRA texte vers image, 1k, même prompt et même seed. À 0, le LoRA est désactivé ; 1 donne le style complet ; 1.5 le pousse plus fort.
Dépannage
- La photo transparaît encore : augmentez
strengthde 0,05 et relancez. - Le visage ou la pose dérive : diminuez-la de 0,05 et nommez la pose dans le prompt.
- Un gribouillis ou du pseudo-texte apparaît dans un coin : changez de
seed. Nous l’avons vu dans environ une image sur cinq, et aucun prompt négatif ne peut le supprimer. Rogner quelques pour cent fonctionne aussi. - Un LoRA ne change rien : vérifiez qu’il a été entraîné pour Anima et ajoutez ses mots déclencheurs.
- Vous voulez changer un seul élément de l’image : ce n’est pas le bon outil. Anima change le style d’images entières et n’a ni masque ni instructions de modification.
Verdict : pour transformer des photos en anime, Anima Turbo est rapide et prévisible, dès lors qu’on accepte que strength soit le seul bouton. Commencez à 0,75, décrivez la photo et consacrez vos essais aux seeds plutôt qu’à la reformulation.
FAQ
Quelle strength utiliser pour transformer une photo en anime ?
Partez de 0.75. Lors de nos tests, elle a donné un anime net avec la composition intacte ; des valeurs plus basses gardent davantage de la photographie et des valeurs plus hautes commencent à changer les détails. Ajustez par pas de 0.05.
Anima Turbo accepte-t-il les prompts négatifs ?
Non. Il n’y a ni prompt négatif, ni champ pour les étapes, le CFG ou le sampler. Le tag de classification au début du prompt (nous utilisons safe) est le principal moyen de donner le ton.
Puis-je lui demander de changer une seule chose dans mon image ?
Non. Il restylise toute l’image et ne suit pas d’instructions de modification ; demander à une illustration une nouvelle tenue ou une scène de nuit a très peu changé l’image à 0.6–0.8. Décrivez plutôt l’image finale, et attendez-vous à un redessin complet.
Pourquoi la sortie n’a-t-elle pas la forme que j’ai demandée ?
Parce que l’image vers image n’a pas de champ de ratio d’image. La sortie garde la forme de la source (une photo 16:9 a donné 1360 x 752 en 1k) : rognez donc d’abord la photo.
Pourquoi y a-t-il une signature ou du pseudo-texte dans un coin ?
Le modèle a pris cette habitude à partir des illustrations. Nous l’avons vue sur environ une image sur cinq. Changez de seed, ou rognez quelques pour cent de ce bord ; aucun prompt négatif ne peut la supprimer.
Un seed fixe donne-t-il la même image ?
Pas de façon fiable. La même requête avec le même seed nous a donné trois rendus légèrement différents à des moments différents : les seeds rendent donc les essais comparables, mais conservez les images qui vous plaisent.
Puis-je utiliser des LoRA d’autres modèles ?
Seulement des LoRA entraînés pour Anima. Un LoRA entraîné pour un autre modèle de base s’est chargé sans erreur et n’a rien changé lors de notre test. Utilisez Anima Turbo LoRA avec jusqu’à trois liens vers des fichiers .safetensors.
Quelle est sa vitesse ?
Sur 60 essais, le temps de modèle a été de 2 à 16 secondes par image, dont 52 en moins de 10 secondes. La première requête avec un nouveau LoRA peut être plus longue, le temps de récupérer le fichier.