Anima Turbo est un modèle d’anime et d’illustration, petit et rapide, qui récompense un prompt de tags bien propre et comprend aussi les phrases simples. Lors de nos tests, il a produit la plupart des images en moins de dix secondes, a suivi nettement les tags de style et est resté sans censure : notre sonde de contenu la plus poussée a été rendue telle qu’écrite dès le premier essai. Ses limites sont tout aussi nettes. Il ne fait pas de photoréalisme, il ne rend qu’un mot ou deux de texte et n’a pas de prompt négatif.
Anima Turbo est la version distillée d’Anima, de CircleStone Labs, un modèle de 2 milliards de paramètres bâti sur NVIDIA Cosmos-Predict2 avec un encodeur de texte Qwen3. Nous avons réalisé ces tests le 5 octobre 2026 avec le point d’accès texte vers image d’Anima Turbo. Chaque prompt ci-dessous décrit une scène du quotidien avec des adultes habillés.
En un coup d’œil
| Anima Turbo (testé le 5 octobre 2026) | |
|---|---|
| Éditeur et base | CircleStone Labs avec Comfy Org ; 2B de paramètres sur NVIDIA Cosmos-Predict2 (2B), encodeur de texte Qwen3 |
| Noms de modèle d’API | circlestone-labs/anima-turbo/text-to-image et circlestone-labs/anima-turbo/edit |
| Champs publics (texte vers image) | prompt (jusqu’à 5 000 caractères), aspect_ratio, resolution, seed |
| Ratios d’image | 15, du 1:1 et du 16:9 au 21:9 et au 1:3 |
| Paliers de résolution | 1k (environ 1 mégapixel, p. ex. 1360 x 768 en 16:9) et 1.5k (environ 2,4 mégapixels, p. ex. 2048 x 1152, généré nativement) |
| Vitesse lors de nos tests | De 2 à 16 secondes par image sur 60 essais ; 52 sur 60 en moins de 10 secondes |
| Sortie | Un JPEG par requête |
| Politique de contenu | Sans censure, aucun filtre de contenu ; notre sonde de contenu la plus poussée a été rendue telle qu’écrite dès le premier essai |
| Ce qu’il ne sait pas faire | Photoréalisme, plus d’un mot ou deux de texte, prompts négatifs, étapes, CFG, sampler, masques |
Ce qu’est Anima Turbo
Anima vient de CircleStone Labs et a été conçu avec Comfy Org. C’est un modèle de 2 milliards de paramètres, bâti sur Cosmos-Predict2 (2B) de NVIDIA, avec un encodeur de texte Qwen3. L’éditeur propose trois versions : Base, Aesthetic et Turbo. Turbo est la version distillée, pensée pour 8 à 12 étapes de sampling. Selon l’éditeur, elle est en moyenne à peine moins bonne qu’Anima-Aesthetic tout en étant bien plus rapide, et il recommande de commencer par elle. D’après l’éditeur, les données d’entraînement comptent plusieurs millions d’images d’anime et environ 800 000 images artistiques hors anime, sans aucune donnée synthétique. La fiche du modèle se trouve sur huggingface.co/circlestone-labs/Anima.
Sur SpicyAPI, le modèle est publié sous le nom circlestone-labs/anima-turbo/text-to-image. La plateforme n’ajoute aucun filtre de contenu : le résultat dépend donc du modèle et de votre prompt. La page de la famille indique le prix actuel par image pour chaque résolution.
Tags ou phrases : les deux fonctionnent, mais le rendu diffère
Anima suit les conventions de tags de Danbooru. Le conseil de l’éditeur, que nous avons suivi : minuscules, espaces à la place des tirets bas, et un ordre fixe : d’abord les tags de qualité et de classification, puis le nombre de personnages (1girl, 1boy, no humans), puis le personnage, la série et l’artiste, et enfin tout le reste. Une ouverture sûre est masterpiece, best quality, éventuellement avec score_7.
Le langage naturel fonctionne aussi. L’éditeur recommande au moins deux phrases, et nous avons compris pourquoi : les prompts très courts dérivent. Nous avons lancé deux fois la même scène de café sous la pluie avec le même seed, une fois en tags et une fois en quatre phrases.
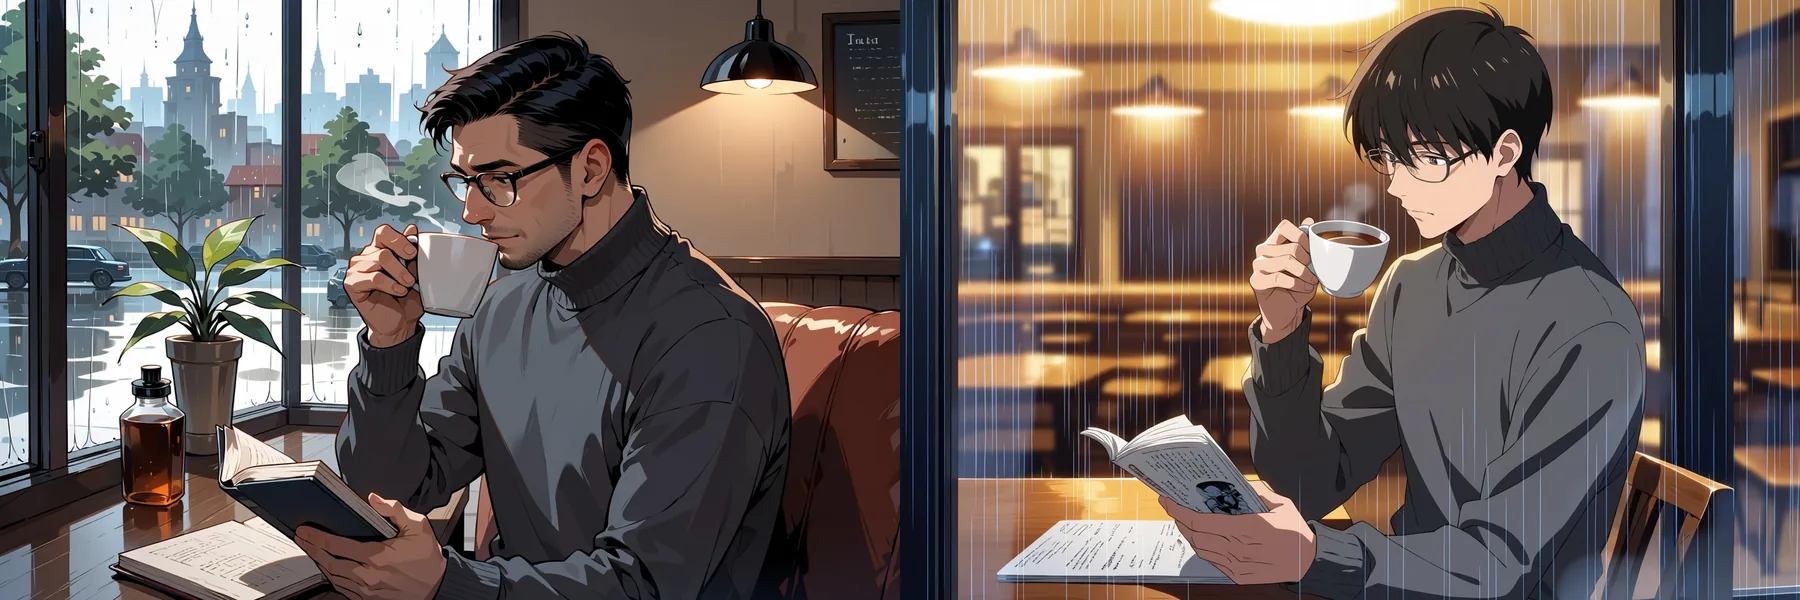
À gauche : tags. À droite : quatre phrases. Même seed (4), 3:2, palier 1k, texte vers image.
La version en tags :
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyLa version en phrases :
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.Les deux ont retenu les lunettes, le col roulé, la tasse et le livre. Les différences portent sur ce que vous n’avez pas précisé. Le prompt en tags a donné un visage plus mûr et une scène lumineuse près de la fenêtre ; le prompt en phrases a donné un visage plus jeune et une pièce plus sombre. Lors de nos tests, les tags offrent un contrôle plus serré du personnage, et les phrases apportent gratuitement plus d’ambiance. Mélanger les deux, avec un en-tête de tags suivi d’une ou deux phrases descriptives, a aussi bien fonctionné.
Lequel utiliser, d’après nos essais et les conseils de l’éditeur :
| Situation | Meilleur choix | Pourquoi |
|---|---|---|
| Vous voulez un personnage précis (cheveux, lunettes, vêtements) | Tags | Chaque tag est une instruction distincte : les détails restent en place |
| Vous voulez une ambiance, une lumière ou une scène qui « donne » un certain sentiment | Phrases | La version en phrases nous a donné la pièce plus sombre sans que nous le demandions |
| Vous appelez un artiste connu ou un style reconnu | Tags, avec @ devant l’artiste | Selon l’éditeur, un style d’artiste sans le @ est faible |
| Vous comparez des seeds ou de petites variantes de prompt | Tags | Des prompts courts et fixes permettent d’attribuer facilement un changement |
| Vous rédigez une courte description | Au moins deux phrases | L’éditeur en recommande au moins deux ; les prompts très courts dérivent |
| Vous voulez à la fois du contrôle et de l’ambiance | Un en-tête de tags plus une ou deux phrases | Le mélange a bien fonctionné lors de nos tests |
Rédiger des prompts qui tiennent
L’ordre ci-dessous suit les conseils de l’éditeur et correspond à ce que nous avons utilisé pour chaque prompt de cet article :
- D’abord les tags de qualité et de classification.
masterpiece, best quality, éventuellementscore_7, puissafe,sensitiveounsfw. Sans prompt négatif, le tag de classification donne le ton. - Ensuite le nombre de personnages.
1girl,1boy,1girl, 1boy, ouno humanspour un décor. - Personnage, série et artiste. Les artistes prennent le préfixe
@. - Tout le reste. Cheveux, vêtements, lieu, lumière, cadrage. En minuscules, avec des espaces à la place des tirets bas.
- Des pondérations quand un tag est trop discret.
(chibi:2)a fonctionné lors de notre test de styles, mais le modèle a demandé des pondérations plus élevées que les modèles de l’ère SDXL : ne vous arrêtez donc pas à 1,2.
La limite du prompt est de 5 000 caractères, que les prompts de tags approchent rarement. Trois habitudes ont fait une différence visible lors de nos essais :
- Commencez par un tag de classification. Le modèle connaît
safe,sensitiveetnsfw, plus un tag encore plus marqué. Sans prompt négatif, le tag de classification est votre principal moyen de donner le ton ; c’est pourquoi chaque prompt de cet article s’ouvre sursafe. - Précisez que les personnages sont adultes.
adult woman, mature femaleou « un homme dans la trentaine » garde la distribution là où vous le voulez. - Placez
@devant les noms d’artistes. Selon l’éditeur, un style d’artiste sans le@est faible.
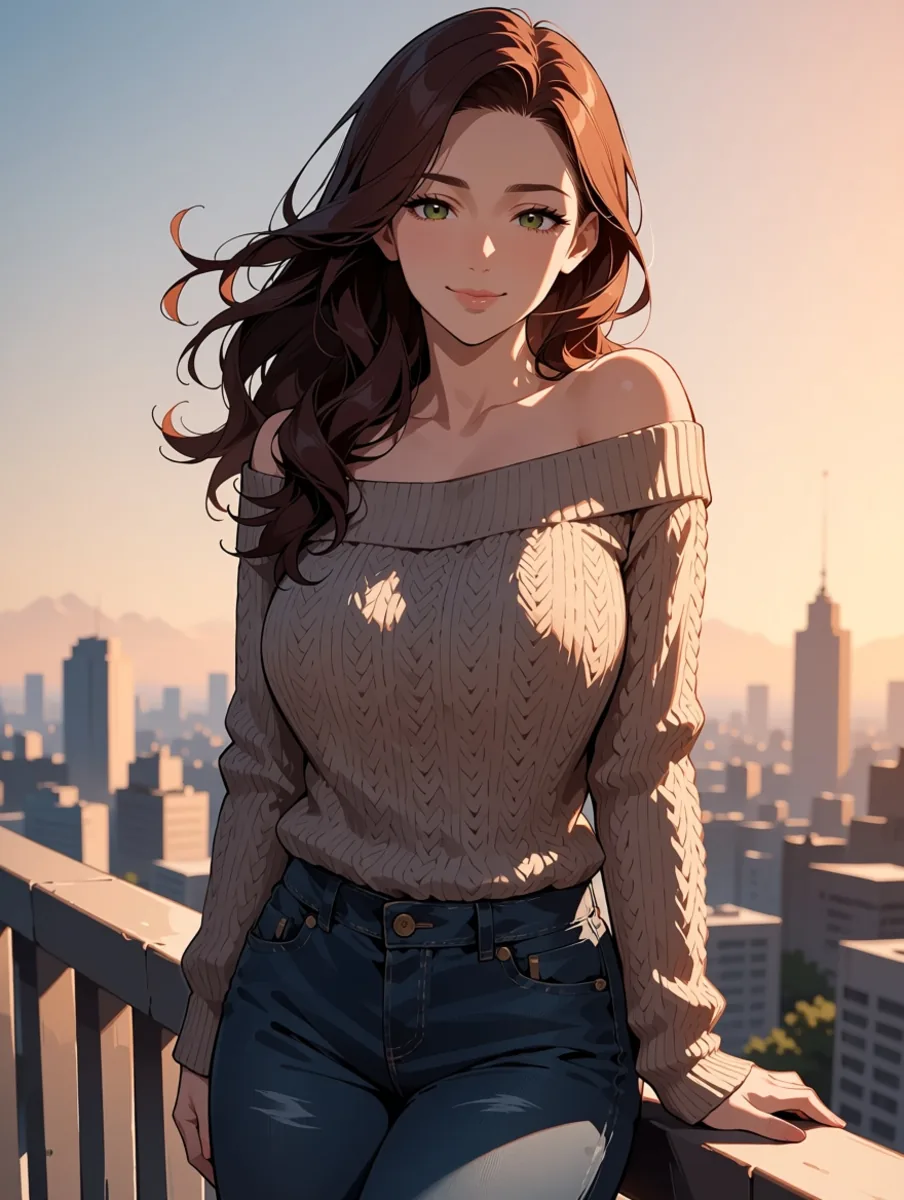
Un prompt composé uniquement de tags : tag de classification, nombre de personnages, cheveux, vêtements, lieu, lumière. 3:4, palier 1k, seed 3.
Ce que font les tags de style
C’est le test qui nous importait le plus. Nous avons fixé un personnage (une femme adulte aux cheveux argentés courts, en trench, dans une rue d’automne) et un seed (12), changé uniquement les tags de style, et lancé chaque variante en 1:1 au palier 1k. Le prompt de base :
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile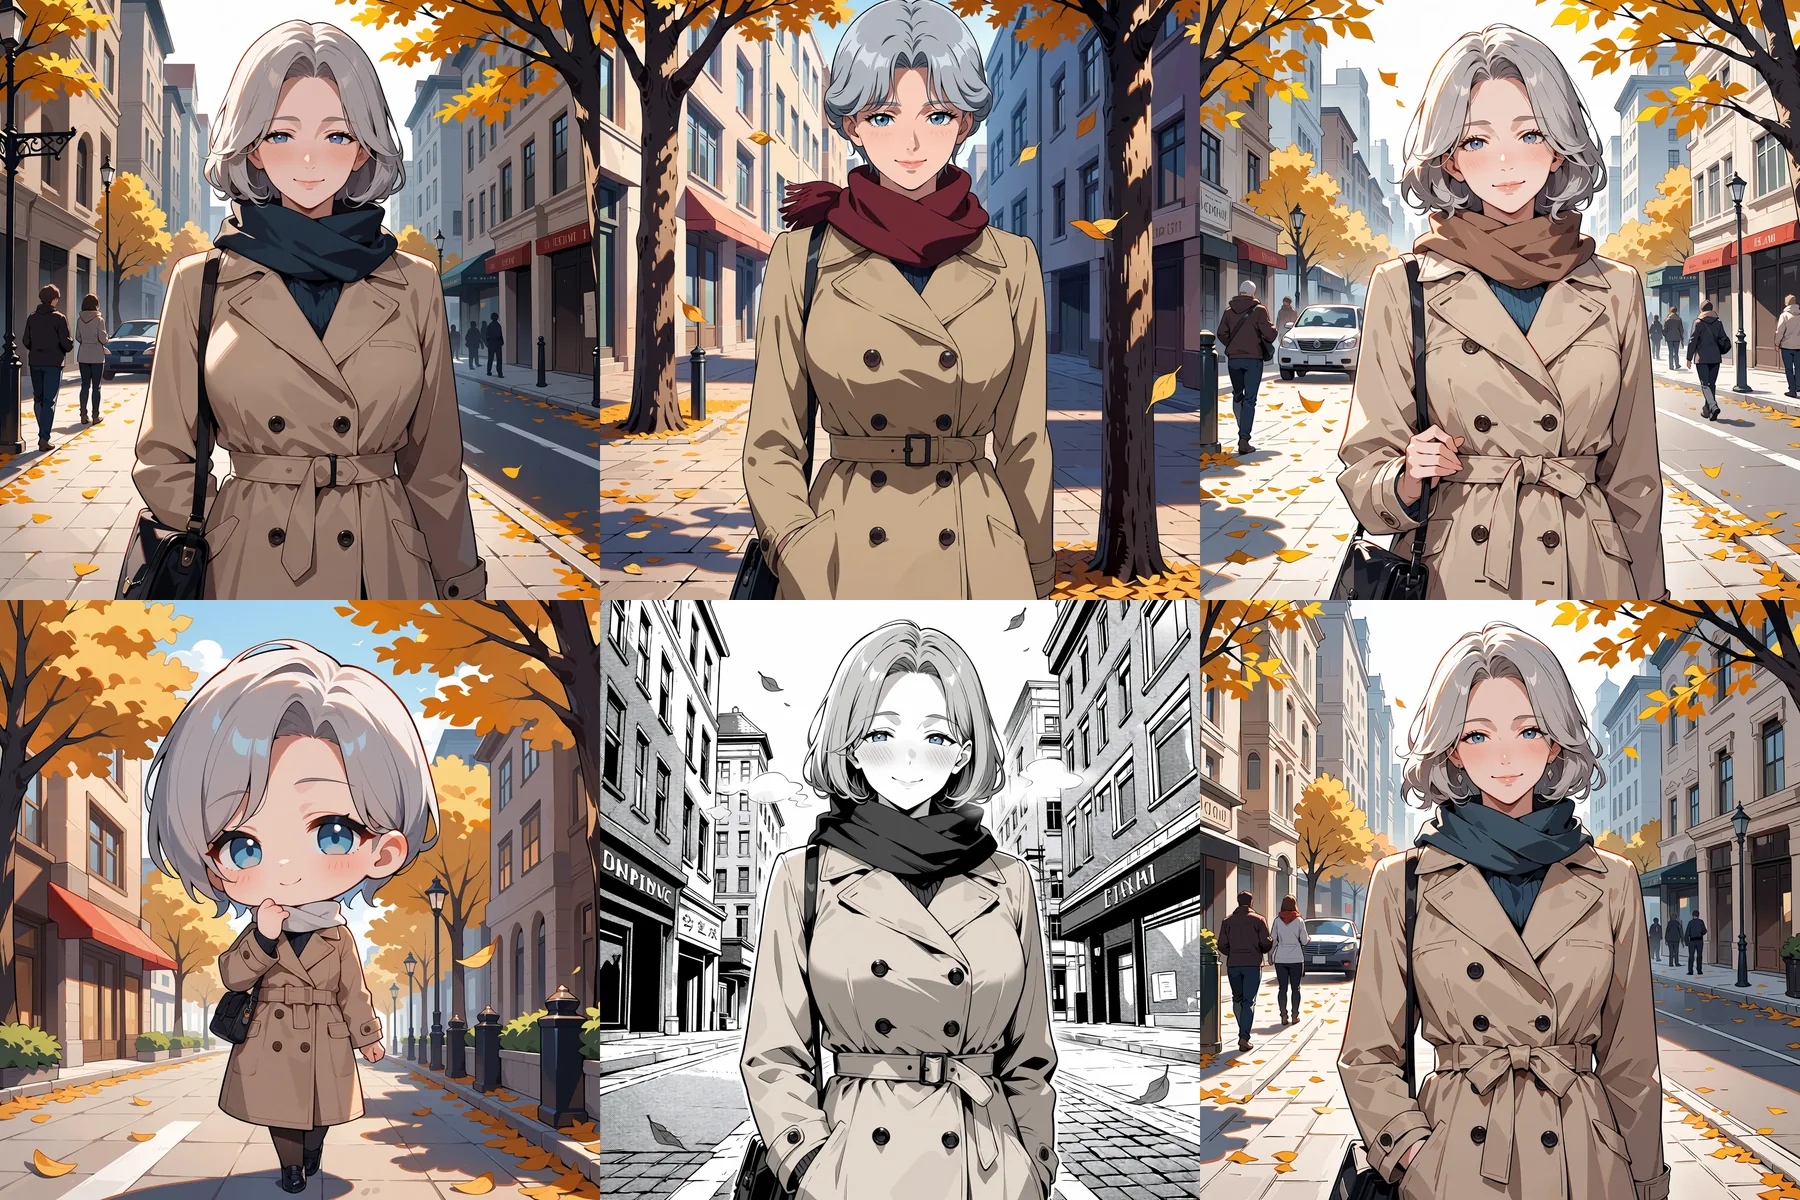
Rangée du haut : aucun tag de style, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Rangée du bas : (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Seed 12 partout.
Ce que nous avons observé :
| Tags de style ajoutés | Résultat lors de nos tests |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Un net rendu cel des années 90 : couleurs plus plates, ombres plus dures |
(chibi:2) | Un vrai chibi, grosse tête et petit corps |
monochrome, greyscale, manga, screentone | Une case de manga en noir et blanc convaincante, avec trames |
watercolor (medium), traditional media | Seulement un léger changement de rendu |
sketch, pencil drawing, traditional media | Seulement un léger changement de rendu |
Les styles forts sont ceux qui possèdent un vocabulaire visuel reconnaissable : l’anime cel capturé à l’écran, les proportions chibi, l’encre de manga. Les deux tags de médium traditionnel n’ont fait qu’effleurer la surface. Si vous voulez un vrai rendu aquarelle ou crayon, attendez-vous à devoir recourir à un LoRA de style plutôt qu’à un tag.
Un dernier détail : la pondération de prompt comme (chibi:2) fonctionne, mais elle a demandé un poids plus élevé que celui auquel les modèles de l’ère SDXL nous ont habitués.
Taille, résolution et vitesse
Il n’y a pas de champ de taille. Vous choisissez un aspect_ratio parmi 15 options (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) et un palier de resolution, 1k ou 1.5k, plus un seed facultatif. Le palier 1k fait environ un mégapixel ; le 1.5k fait environ 2,4 mégapixels et est généré nativement, sans mise à l’échelle. Une image 16:9 mesure 1360 x 768 en 1k et 2048 x 1152 en 1.5k ; le 1:3 mesure 576 x 1760 et 880 x 2048. La sortie est toujours en JPEG, une image par requête. Le ratio ne change pas le prix, le palier 1.5k coûte plus cher que le 1k, et les requêtes échouées ne sont pas facturées.
Nous avons chronométré 60 essais couvrant tous les ratios sur les deux paliers. Le temps de calcul du modèle a varié de 2 à 16 secondes par image, et 52 essais sur 60 se sont terminés en moins de 10 secondes.
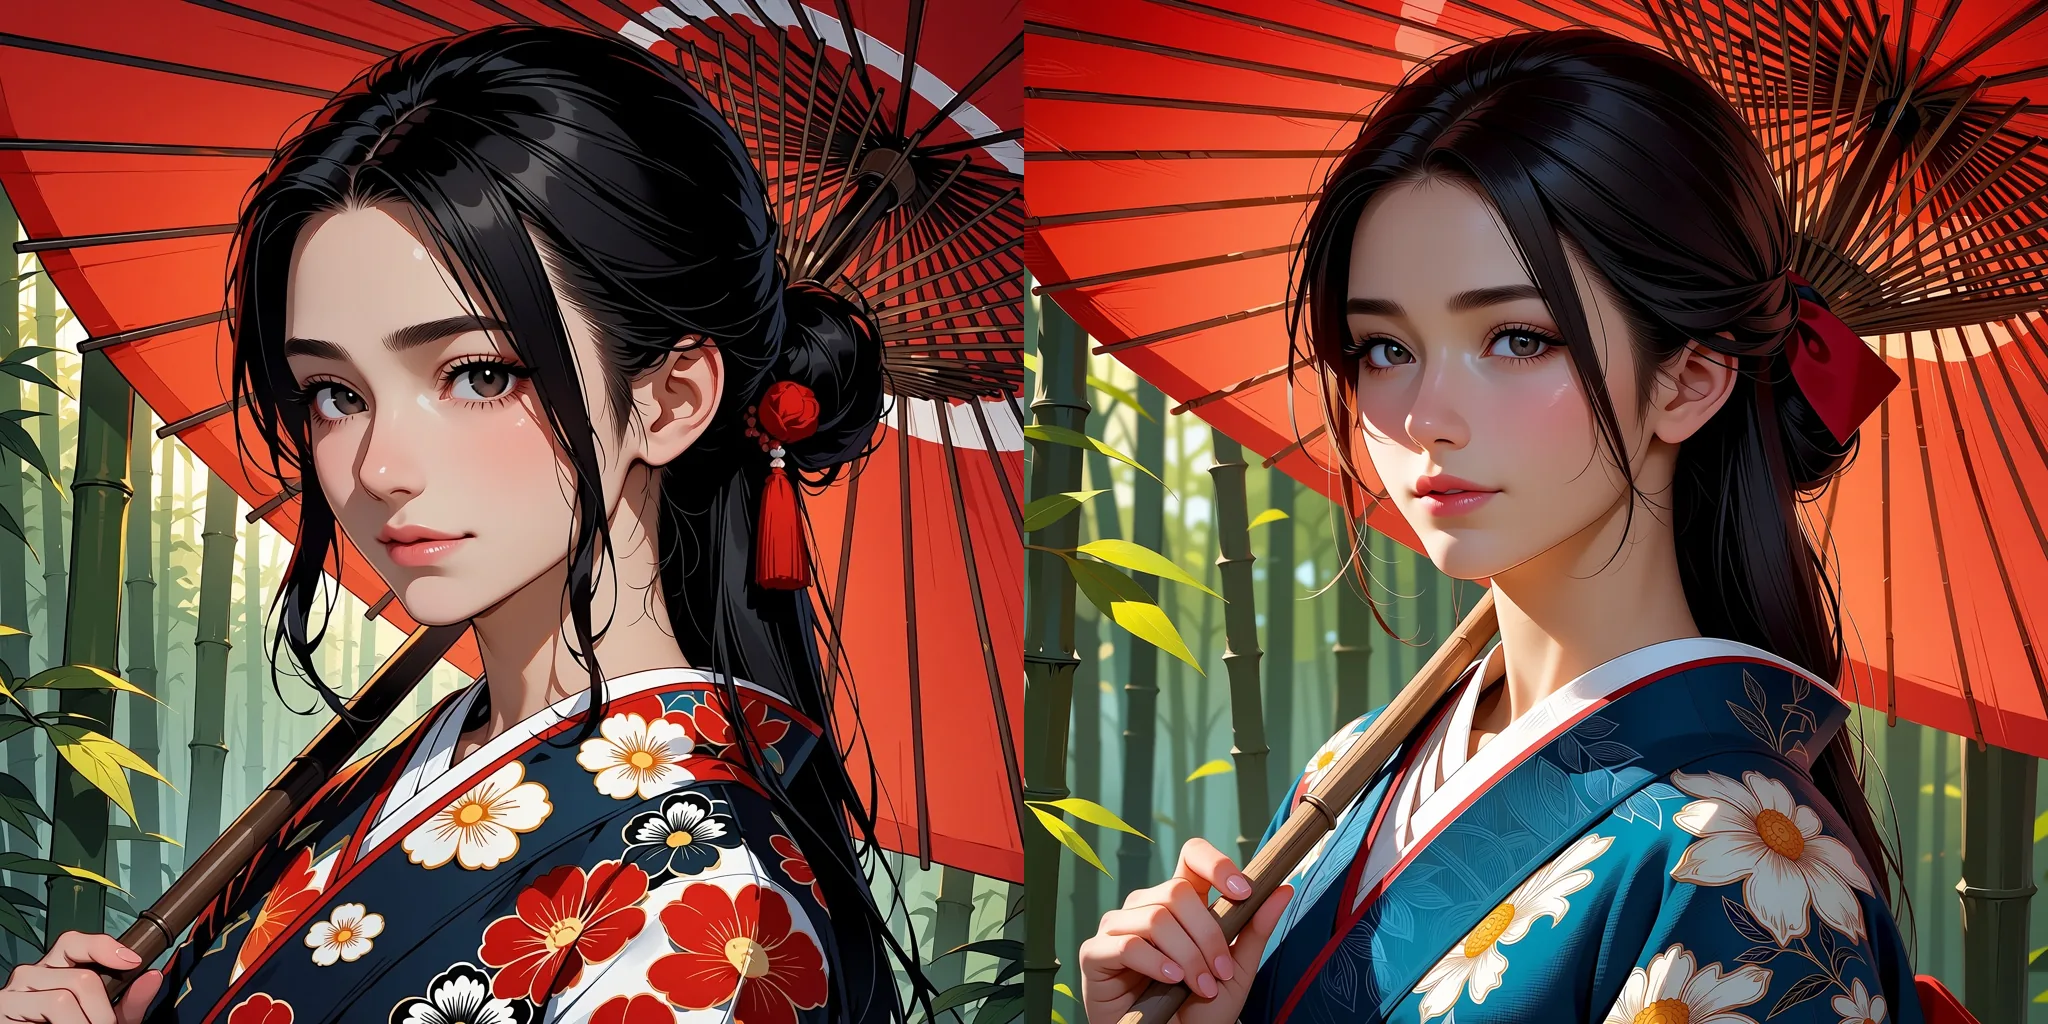
À gauche : 1k (1024 x 1024). À droite : 1.5k (1536 x 1536). Même prompt, seed 8, 1:1.
Les deux paliers ne sont pas un agrandissement pixel pour pixel. Le même prompt et le même seed ont donné un autre visage et un autre motif de kimono. Ce que vous payez en 1.5k, c’est un tissu plus finement détaillé et un trait plus net. Faites vos brouillons en 1k, relancez ensuite les images retenues en 1.5k et considérez le résultat comme une nouvelle prise, non comme une copie plus nette.
Jusqu’où il va
Le point d’accès est sans censure et la plateforme n’ajoute aucun filtre de contenu. Lors de nos tests, le modèle ne s’est pas retenu non plus : notre sonde de contenu la plus poussée a été rendue telle qu’écrite dès le premier essai, en texte vers image comme en image vers image, avec ou sans LoRA, sur plusieurs seeds. Nous ne publions pas ce prompt ; les exemples ci-dessous sont des scènes du quotidien.
Ce que le modèle fait bien dans les scènes ordinaires, c’est l’amplitude. Un seul style de prompt a produit des portraits, des couples, un barman de nuit et des paysages vides :
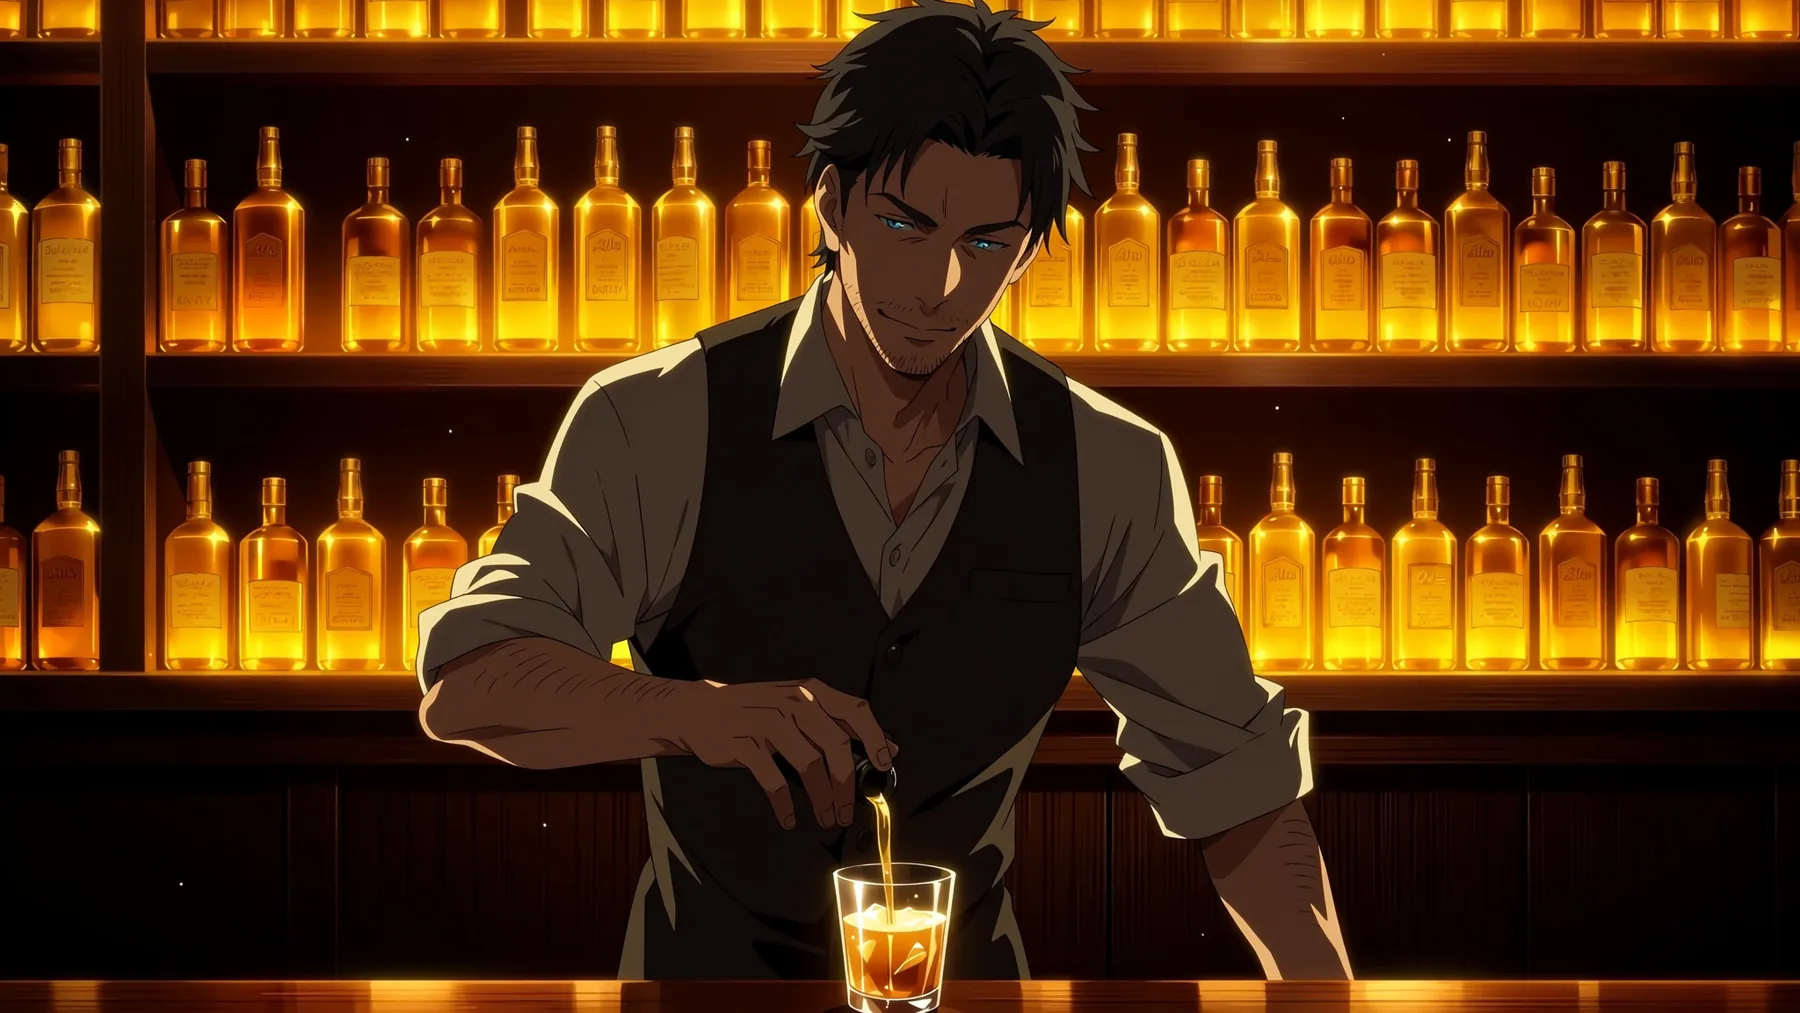
Trois phrases, tag de classification safe, 16:9, palier 1.5k, seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.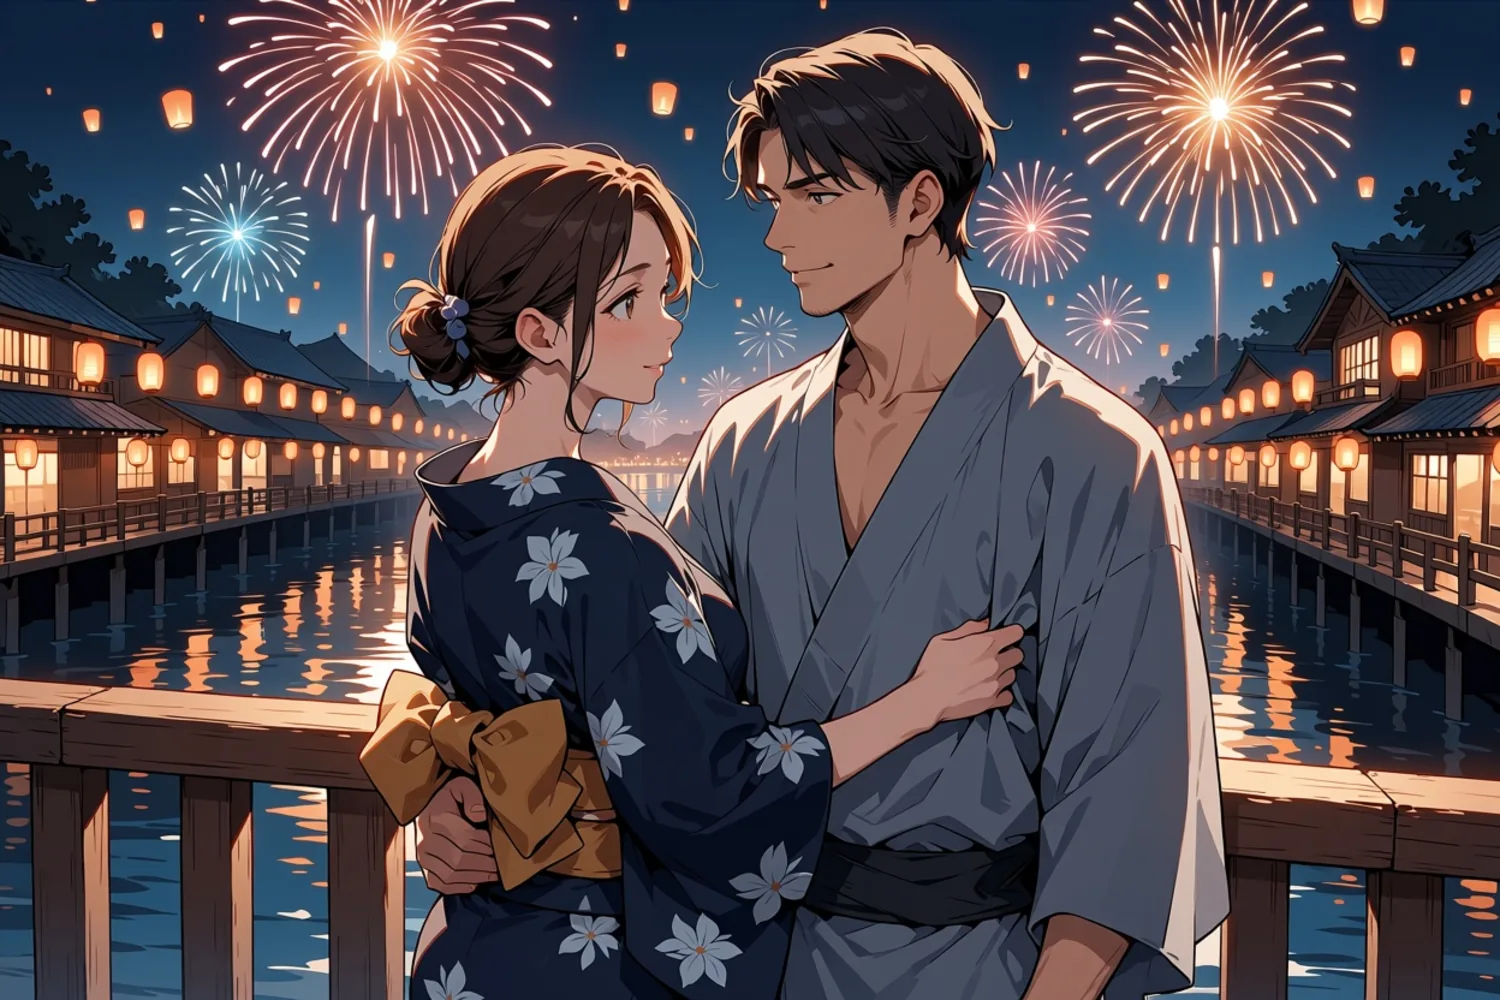
Tags avec nombre de personnages 1girl, 1boy, 3:2, palier 1k, seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections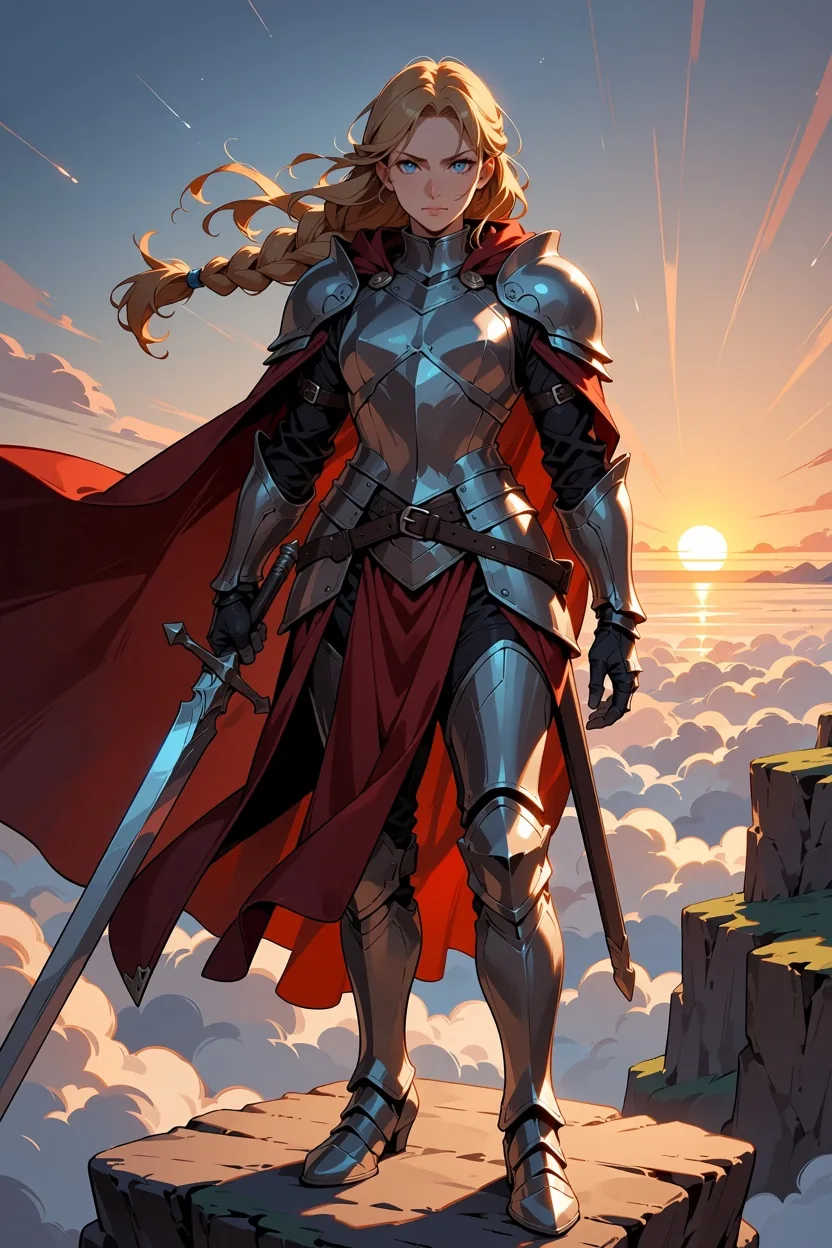
Tags, portrait 2:3, palier 1k, seed 6 : long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, après les tags habituels de qualité, de classification et de nombre de personnages.
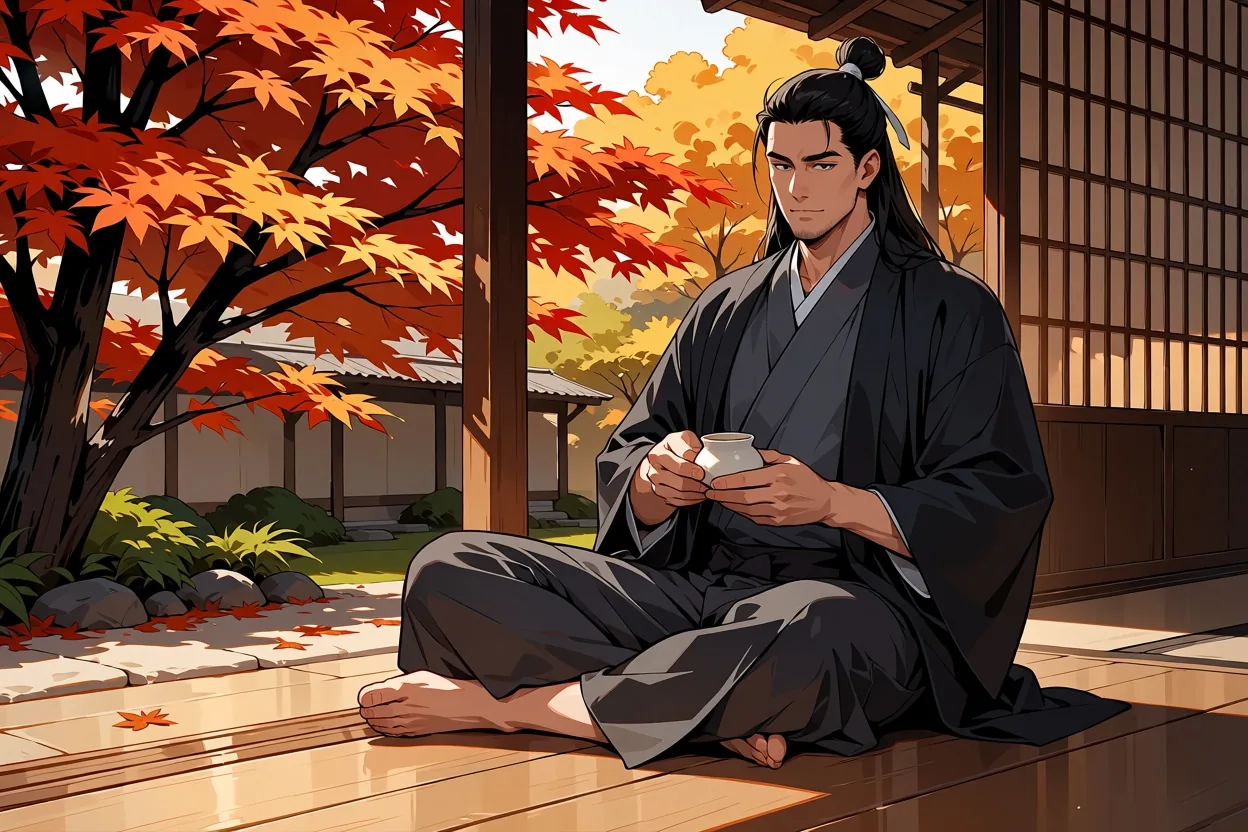
Tags, 3:2, palier 1k, seed 13 : long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
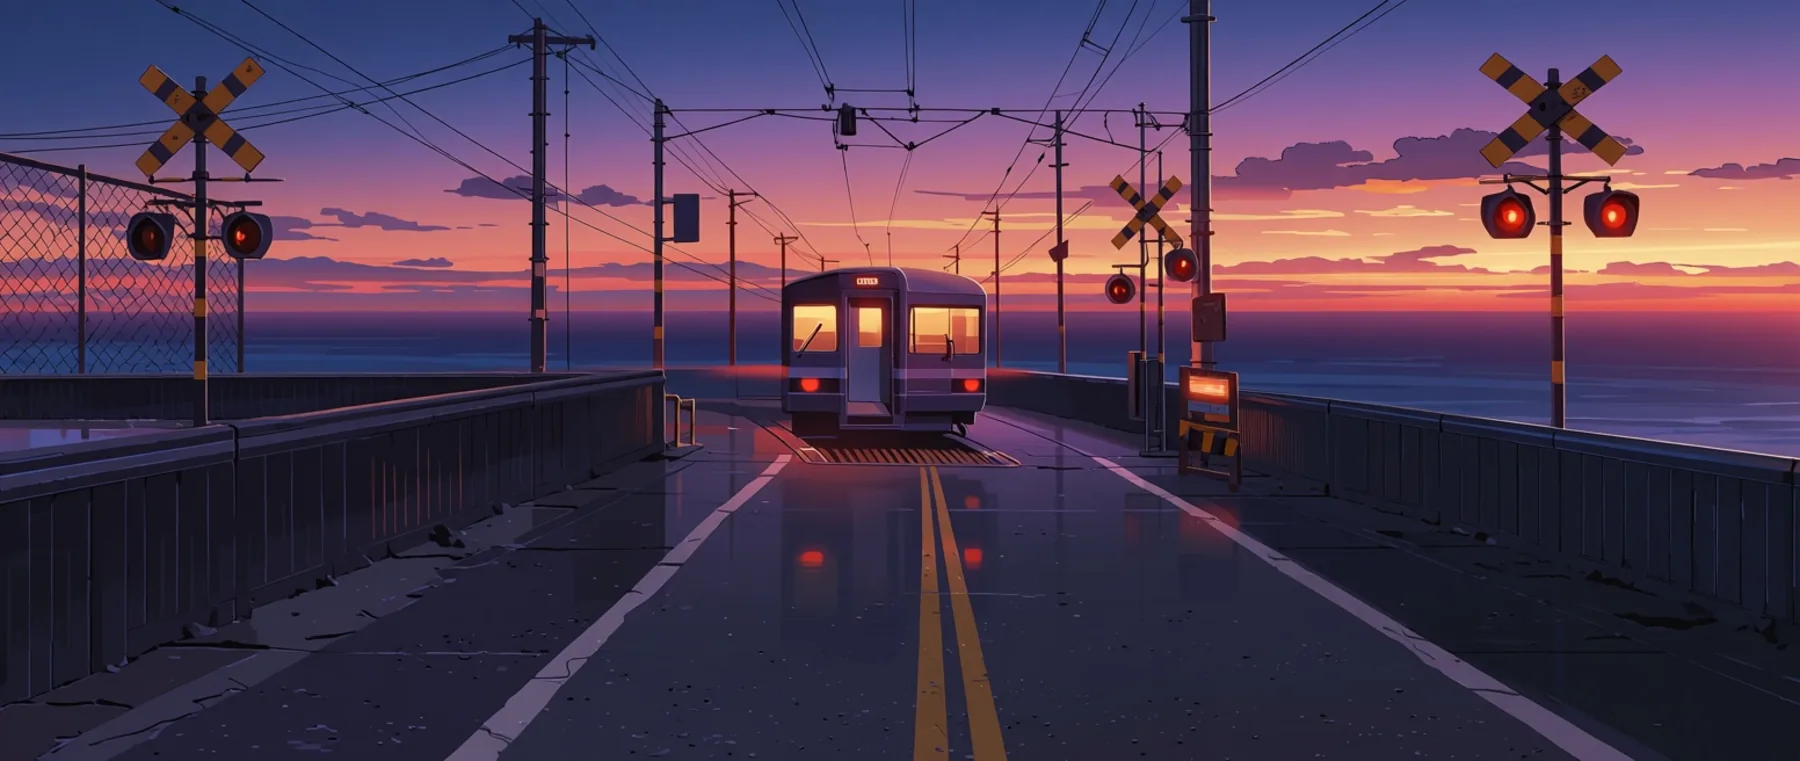
Paysage avec no humans, 21:9, palier 1k (1552 x 656), seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotLes ratios inhabituels tiennent aussi. Le 9:16, une haute bannière 1:3 et un plan large 16:9 ont tous donné des images composées pour leur cadre, et non recadrées à partir d’un carré :
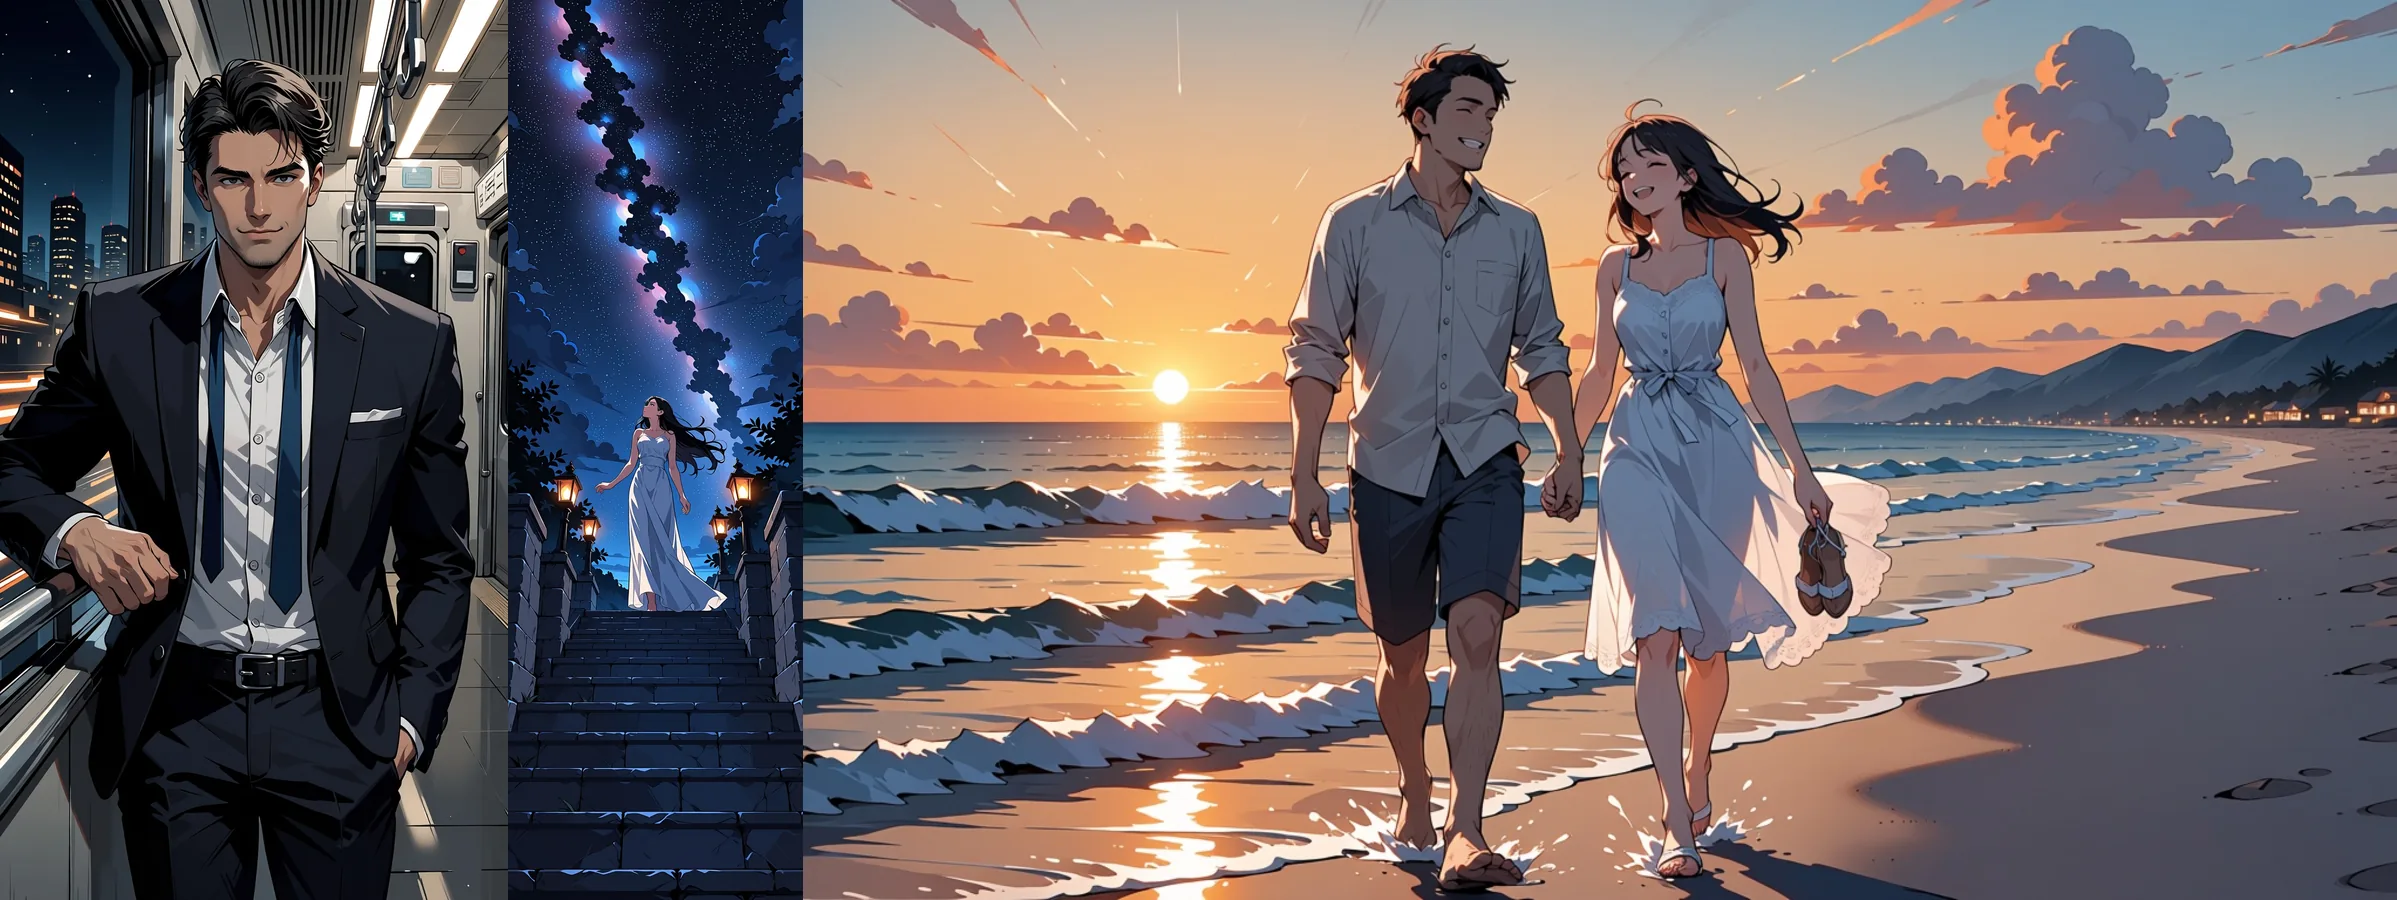
De gauche à droite : 9:16, 1:3, 16:9, tous au palier 1k, tous en texte vers image.
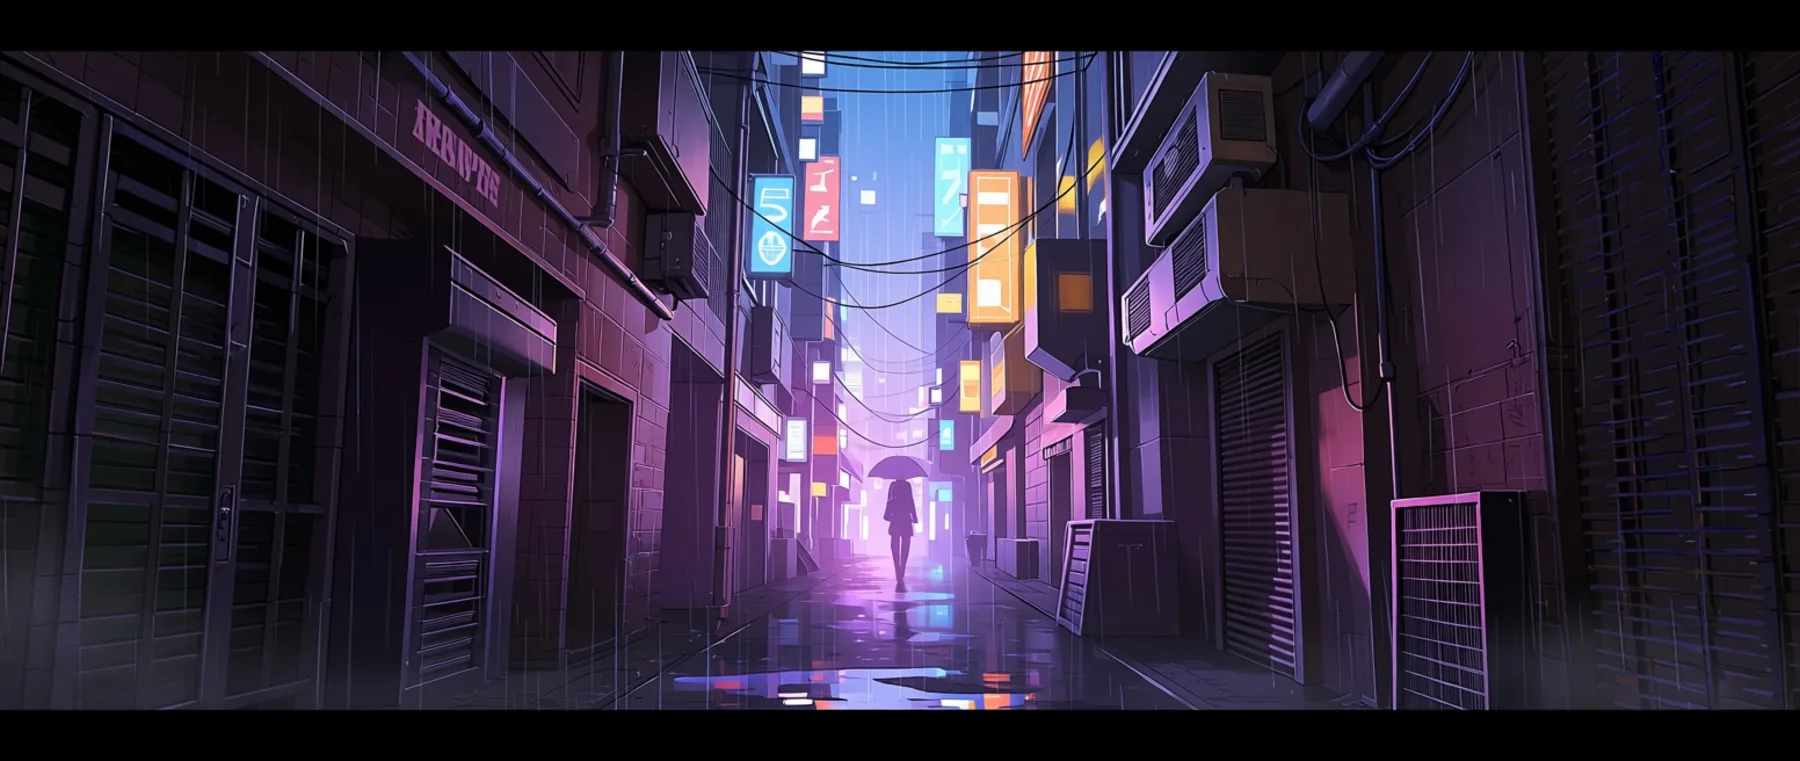
Paysage de ruelle cyberpunk, 21:9, palier 1k.
Où il montre ses limites
- Pas de photoréalisme. C’est un modèle d’anime et d’illustration. N’attendez d’aucun prompt un rendu photographique.
- Le texte est faible. Il rend un mot ou deux, pas une phrase, une enseigne ou une légende.
- Pas de prompt négatif, d’étapes, de CFG ni de sampler. Les champs publics sont
prompt,aspect_ratio,resolutionetseed. Le tag de classification et votre formulation sont les seuls freins dont vous disposez. - Un gribouillis qui ressemble à une signature. Le modèle dessine parfois une signature ou une ligne de pseudo-texte dans un coin, une habitude héritée des illustrations. Nous l’avons vue dans environ une image sur cinq. Aucun prompt négatif ne peut la supprimer. Changez de seed, ou rognez le bord.
- Un seed rend les essais comparables, pas identiques. La même requête avec le même seed nous a donné trois rendus légèrement différents à des moments différents. Utilisez un seed pour comparer deux modifications de prompt, pas pour promettre à un client une reprise identique au pixel près.
- Une image par requête, JPEG uniquement, pas de masque. Il n’y a pas de champ d’inpainting.
À qui s’adresse-t-il
Utilisez Anima Turbo si vous voulez des brouillons d’anime et d’illustration rapides, facturés à l’image, si vous aimez écrire des prompts de tags ou mélanger les tags avec quelques phrases, ou si vous avez besoin d’une sortie non filtrée venant d’un petit modèle. C’est un bon modèle pour explorer des personnages et des scènes en 1k, puis passer les images retenues en 1.5k.
Cherchez ailleurs si vous avez besoin de réalisme photographique ou de texte lisible dans l’image.
Quelle famille Anima choisir
SpicyAPI propose deux familles Anima. Elles partagent le même modèle de base : le choix dépend donc de votre besoin d’un rendu personnalisé :
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| Noms de modèle d’API | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Champ supplémentaire | Aucun | loras : jusqu’à 3 entrées, chacune avec un path et un scale de 0 à 4 |
| Idéal pour | Brouillons rapides, prompts en tags et en phrases, le rendu de base | Un style graphique, un personnage ou une époque précis grâce à un LoRA Anima |
| Contrôle du style | Tags de style dans le prompt | Tags de style plus LoRA |
| Tarification | À l’image selon le palier de résolution | Même structure ; le chargement des LoRA n’ajoute aucun frais distinct |
Commencez par Anima Turbo. Passez à la famille LoRA quand un tag de style ne suffit pas, par exemple quand un tag d’aquarelle ou de crayon n’a fait qu’effleurer la surface lors de notre test.
Deux suites naturelles :
- Des styles sur mesure. La famille Anima Turbo LoRA charge jusqu’à trois LoRA par requête : vous pouvez ainsi ajouter un rendu précis, y compris des LoRA pour adultes issus de la communauté. Notre guide complémentaire en parle : guide des styles Anima Turbo LoRA.
- Redessiner des photos. Le point d’accès image vers image prend une image source et une
strengthde 0 à 1. Voyez de la photo à l’anime avec Anima Turbo pour savoir ce que fait chaque valeur de force.
FAQ
Anima Turbo accepte-t-il les prompts négatifs ?
Non. Les champs publics sont prompt, aspect_ratio, resolution et seed, sans prompt négatif, étapes, CFG ni sampler. Mettez ce que vous voulez dans le prompt, et utilisez le tag de classification (safe, sensitive ou nsfw) pour donner le ton.
Quelle résolution choisir ?
Faites vos brouillons en 1k, puis relancez les images retenues en 1.5k. Le palier 1k fait environ un mégapixel et le 1.5k environ 2,4 mégapixels, générés nativement. Lors de nos tests, le même prompt et le même seed ont donné un autre visage en 1.5k : considérez-le comme une nouvelle prise plus finement détaillée, pas comme un agrandissement.
Pourquoi y a-t-il une signature ou un texte étrange dans un coin ?
Le modèle a pris cette habitude à partir des illustrations. Nous avons vu un gribouillis qui ressemble à une signature, ou une ligne de pseudo-texte, sur environ une image sur cinq. Un prompt négatif ne peut pas le supprimer ici : changez de seed ou rognez le bord.
Un seed fixe donne-t-il la même image à chaque fois ?
Pas de façon fiable. La même requête avec le même seed nous a donné trois rendus légèrement différents à des moments différents. Utilisez un seed pour comparer deux modifications de prompt, pas pour promettre une reprise identique au pixel près.
Puis-je utiliser des LoRA SDXL ou Pony avec Anima ?
Non, utilisez des LoRA entraînés pour Anima, c’est-à-dire la famille Anima Turbo LoRA. Lors de nos tests, un LoRA entraîné pour un autre modèle de base (un LoRA FLUX) s’est chargé sans erreur et n’a rien changé. Le point d’accès Anima Turbo de base n’accepte aucun LoRA.
Anima peut-il modifier une image au lieu de la redessiner ?
Il la restylise plutôt qu’il ne la modifie. Le point d’accès image vers image prend une image source et une strength de 0 à 1 ; lors de nos tests, demander à une illustration existante une nouvelle tenue ou un passage du jour à la nuit a très peu changé l’image. Il n’y a ni masque ni champ d’inpainting.
Peut-il écrire du texte dans l’image ?
Seulement un mot ou deux. Les phrases, les enseignes et les légendes ne sont pas son fort : ajoutez le texte ensuite dans un éditeur.
Fait-il du photoréalisme ?
Non. C’est un modèle d’anime et d’illustration, et aucun prompt ne nous a donné un rendu photographique.