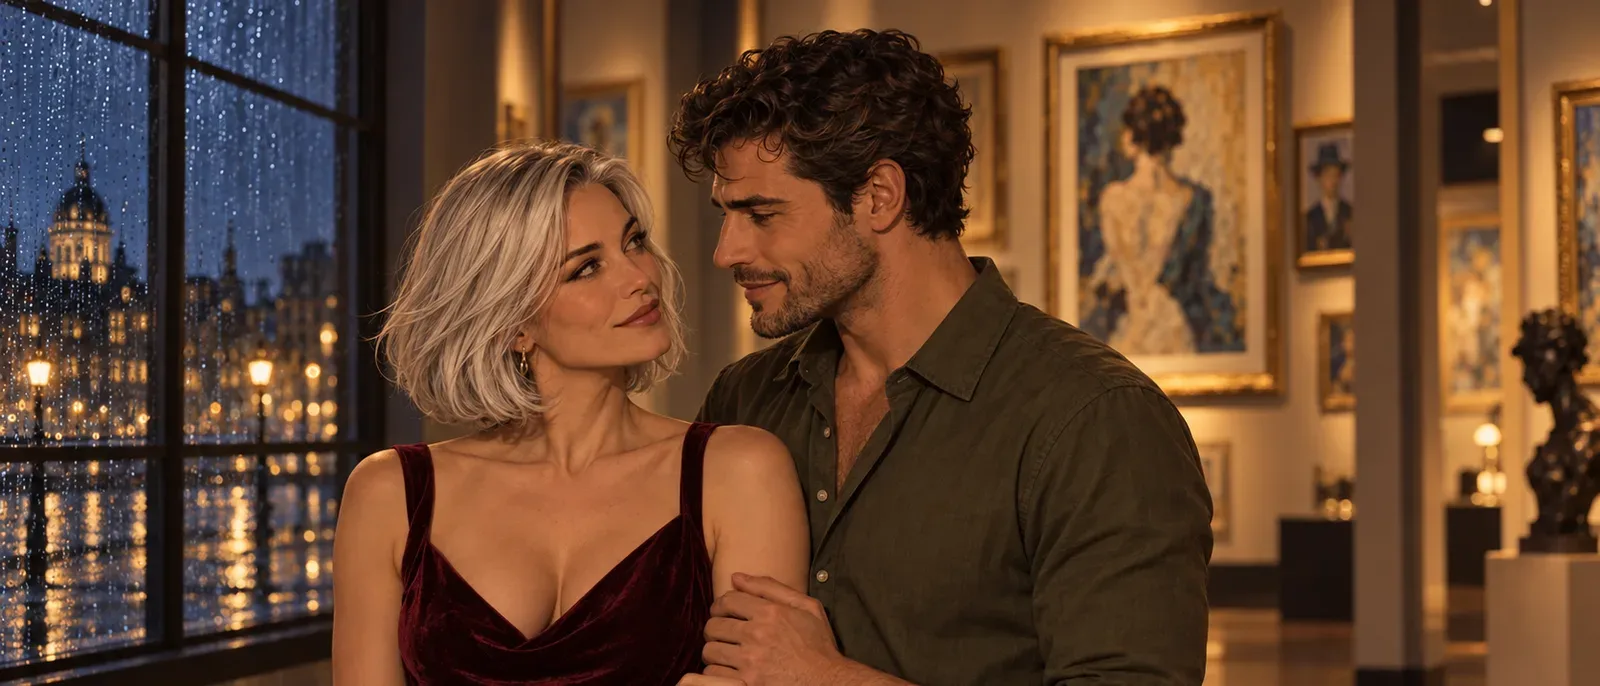
Anima Turbo es un modelo de anime e ilustración pequeño y rápido que responde bien a un prompt de etiquetas limpio y que también entiende frases normales. En nuestras pruebas terminó la mayoría de las imágenes en menos de diez segundos, siguió las etiquetas de estilo con claridad y no aplicó ninguna censura: nuestra prueba de contenido más exigente se generó tal como se escribió al primer intento. Sus límites también son claros. No hace fotorrealismo, solo dibuja una o dos palabras de texto y no tiene prompt negativo.
Anima Turbo es la versión destilada de Anima, de CircleStone Labs, un modelo de 2 mil millones de parámetros basado en NVIDIA Cosmos-Predict2 con un codificador de texto Qwen3. Hicimos estas pruebas el 5 de octubre de 2026 con el endpoint de texto a imagen de Anima Turbo. Todos los prompts de abajo son escenas cotidianas con adultos vestidos.
De un vistazo
| Anima Turbo (probado el 5 de octubre de 2026) | |
|---|---|
| Editor y base | CircleStone Labs con Comfy Org; 2B parámetros sobre NVIDIA Cosmos-Predict2 (2B), codificador de texto Qwen3 |
| Nombres del modelo en la API | circlestone-labs/anima-turbo/text-to-image y circlestone-labs/anima-turbo/edit |
| Campos públicos (texto a imagen) | prompt (hasta 5,000 caracteres), aspect_ratio, resolution, seed |
| Relaciones de aspecto | 15, de 1:1 y 16:9 a 21:9 y 1:3 |
| Niveles de resolución | 1k (alrededor de 1 megapíxel, p. ej. 1360 x 768 en 16:9) y 1.5k (alrededor de 2.4 megapíxeles, p. ej. 2048 x 1152, generado de forma nativa) |
| Velocidad en nuestras pruebas | De 2 a 16 segundos por imagen en 60 ejecuciones; 52 de 60 en menos de 10 segundos |
| Salida | Un JPEG por solicitud |
| Política de contenido | Sin censura, sin filtro de contenido; nuestra prueba de contenido más exigente se generó tal como se escribió al primer intento |
| No puede | Fotorrealismo, más de una o dos palabras de texto, prompts negativos, pasos, CFG, sampler, máscaras |
Qué es Anima Turbo
Anima es de CircleStone Labs, creado junto con Comfy Org. Es un modelo de 2 mil millones de parámetros basado en Cosmos-Predict2 (2B) de NVIDIA, con un codificador de texto Qwen3. El editor publica tres versiones: Base, Aesthetic y Turbo. Turbo es la versión destilada, pensada para de 8 a 12 pasos de muestreo. Según el editor, es solo un poco peor que Anima-Aesthetic en promedio y mucho más rápida, y recomienda empezar por ella. También según el editor, los datos de entrenamiento son varios millones de imágenes anime más unas 800,000 imágenes artísticas que no son anime, sin datos sintéticos. La ficha del modelo está en huggingface.co/circlestone-labs/Anima.
En SpicyAPI el modelo se publica como circlestone-labs/anima-turbo/text-to-image. La plataforma no agrega ningún filtro de contenido, así que el resultado depende del modelo y de tu prompt. La página de la familia muestra el precio actual por imagen para cada resolución.
Etiquetas o frases: ambas funcionan, pero se ven distintas
Anima sigue las convenciones de etiquetas de Danbooru. El consejo del editor, que seguimos: minúsculas, espacios en lugar de guiones bajos y un orden fijo, con las etiquetas de calidad y de clasificación primero, luego el número de personajes (1girl, 1boy, no humans), después personaje, serie y artista, y al final todo lo demás. Una apertura segura es masterpiece, best quality, opcionalmente con score_7.
El lenguaje natural también funciona. El editor recomienda al menos dos frases, y vimos por qué: los prompts muy cortos se desvían. Ejecutamos dos veces la misma escena de una cafetería lluviosa con el mismo seed, una vez como etiquetas y otra como cuatro frases.
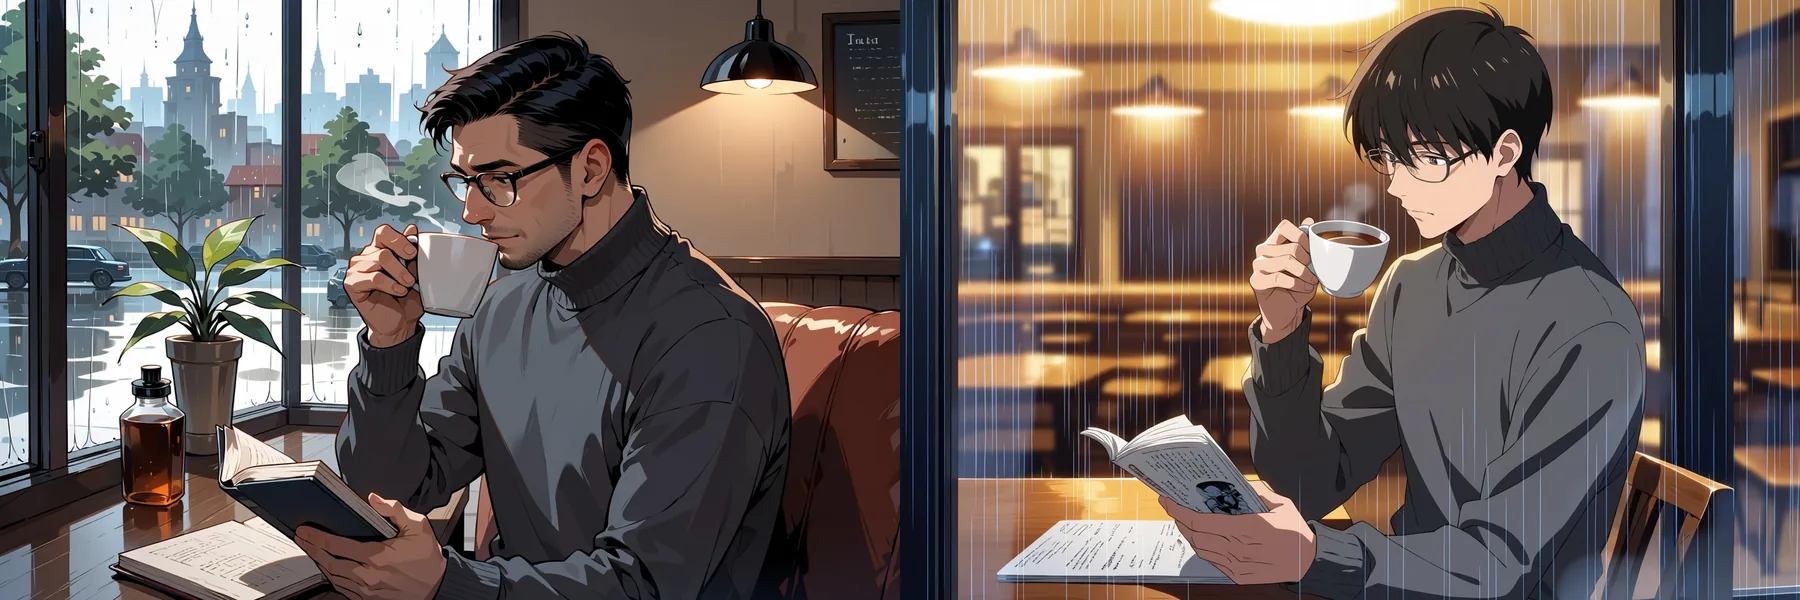
Izquierda: etiquetas. Derecha: cuatro frases. Mismo seed (4), 3:2, nivel 1k, texto a imagen.
La versión con etiquetas:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyLa versión con frases:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.Las dos reprodujeron los anteojos, el cuello alto, la taza y el libro. Las diferencias están en lo que no especificaste. El prompt de etiquetas dio un rostro más maduro y una escena de ventana luminosa; el de frases dio un rostro más joven y un ambiente más sombrío. En nuestras pruebas, las etiquetas dan un control más preciso sobre el personaje y las frases aportan más atmósfera sin esfuerzo. Combinar ambas, con un encabezado de etiquetas y una o dos frases descriptivas, también funcionó.
Cuál usar, según nuestras ejecuciones y las indicaciones del editor:
| Situación | Mejor opción | Por qué |
|---|---|---|
| Necesitas un aspecto concreto de personaje (cabello, anteojos, ropa) | Etiquetas | Cada etiqueta es una instrucción independiente, así que los detalles se mantienen |
| Quieres ambiente, iluminación o una escena que "se sienta" de cierta manera | Frases | La versión con frases nos dio la habitación más sombría sin pedirlo |
| Invocas a un artista conocido o un estilo reconocido | Etiquetas, con @ antes del artista | Según el editor, un estilo de artista sin la @ es débil |
| Estás comparando seeds o ajustes del prompt | Etiquetas | Los prompts cortos y fijos facilitan atribuir un cambio |
| Estás escribiendo una descripción breve | Dos o más frases | El editor recomienda al menos dos; los prompts muy cortos se desvían |
| Quieres control y ambiente | Un encabezado de etiquetas más una o dos frases | La mezcla funcionó en nuestras pruebas |
Cómo escribir prompts que funcionen
El orden de abajo sigue el consejo del editor y es el que usamos en todos los prompts de este artículo:
- Primero las etiquetas de calidad y de clasificación.
masterpiece, best quality, opcionalmentescore_7, y luegosafe,sensitiveonsfw. Sin prompt negativo, la etiqueta de clasificación fija el tono. - Después el número de personajes.
1girl,1boy,1girl, 1boy, ono humanspara paisajes. - Personaje, serie y artista. Los artistas llevan el prefijo
@. - Todo lo demás. Cabello, ropa, lugar, luz, encuadre. En minúsculas, con espacios en lugar de guiones bajos.
- Pesos cuando una etiqueta se queda corta.
(chibi:2)funcionó en nuestra prueba de estilos, pero el modelo necesitó pesos más altos que los modelos de la época de SDXL, así que no te quedes en 1.2.
El límite del prompt es de 5,000 caracteres, algo a lo que los prompts de etiquetas rara vez se acercan. Tres hábitos marcaron una diferencia visible en nuestras ejecuciones:
- Empieza con una etiqueta de clasificación. El modelo conoce
safe,sensitiveynsfw, además de una etiqueta más fuerte. Sin prompt negativo, la etiqueta de clasificación es tu principal forma de fijar el tono, por eso todos los prompts de este artículo abren consafe. - Indica que los personajes son adultos.
adult woman, mature femaleo "a man in his thirties" mantiene el reparto donde lo quieres. - Pon
@delante del nombre de los artistas. Según el editor, un estilo de artista sin la@es débil.
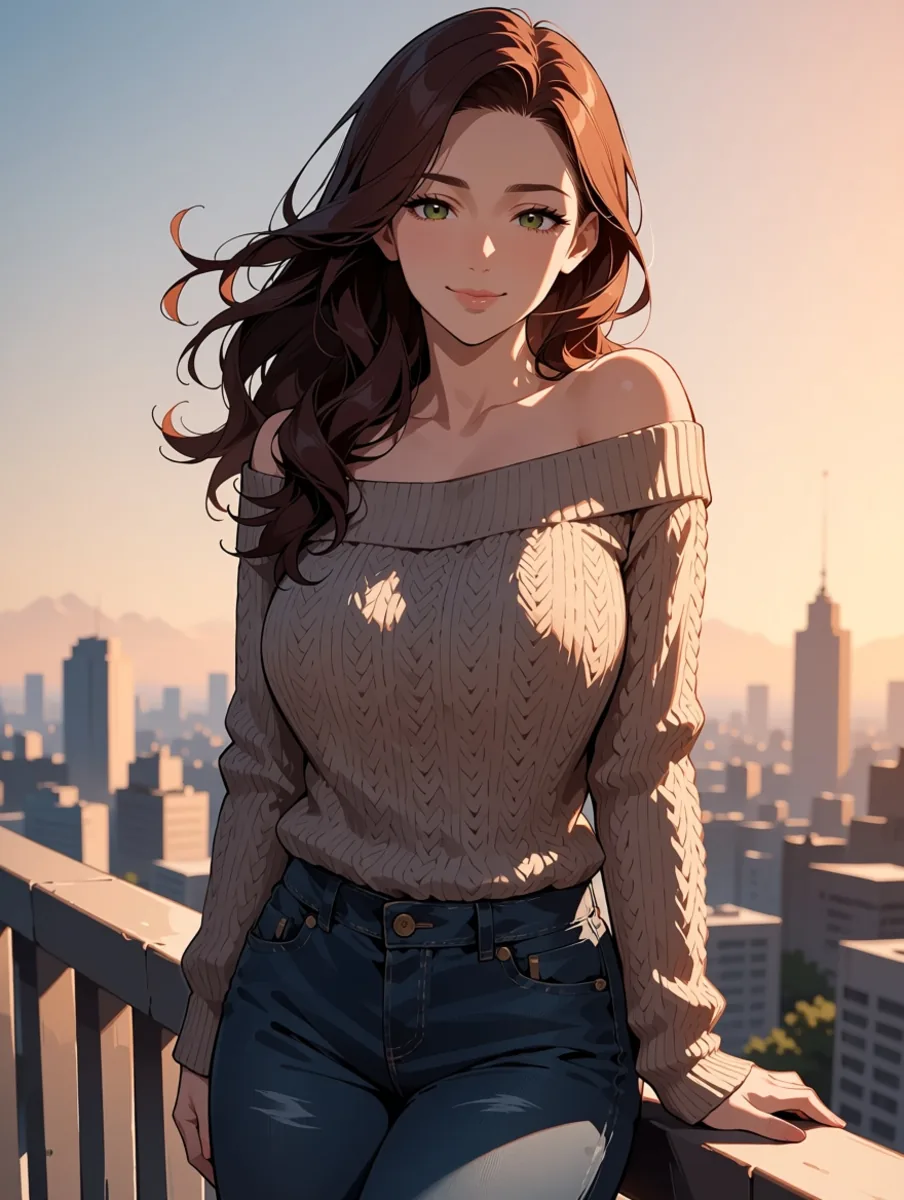
Un prompt solo de etiquetas: etiqueta de clasificación, número de personajes, cabello, ropa, lugar, luz. 3:4, nivel 1k, seed 3.
Qué hacen las etiquetas de estilo
Esta fue la prueba que más nos interesaba. Fijamos un personaje (una mujer adulta de cabello plateado corto con una gabardina en una calle de otoño) y un seed (12), cambiamos solo las etiquetas de estilo y ejecutamos cada una en 1:1 en el nivel 1k. El prompt base:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile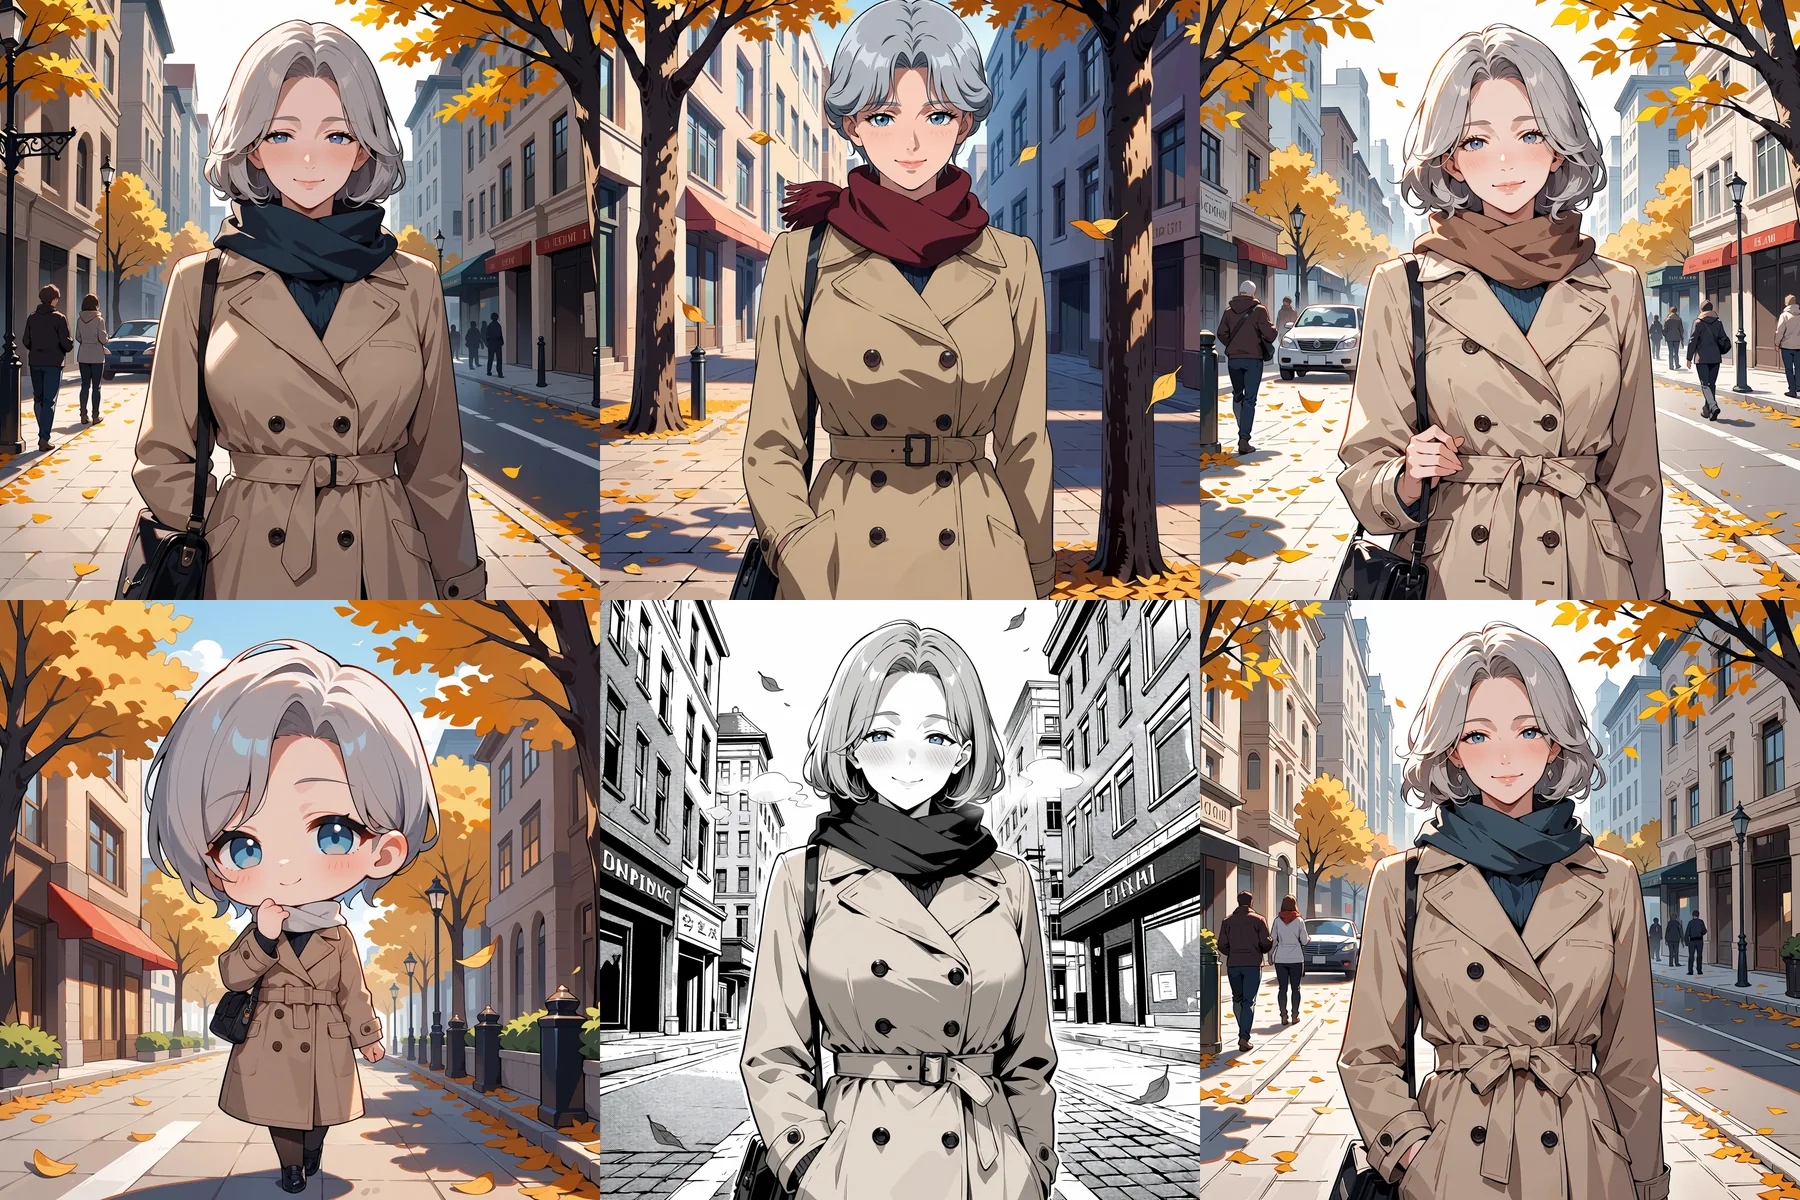
Fila superior: sin etiqueta de estilo, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Fila inferior: (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Seed 12 en todas.
Lo que vimos:
| Etiquetas de estilo añadidas | Resultado en nuestras pruebas |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Un aspecto claro de cel de los 90: colores más planos, sombras más duras |
(chibi:2) | Un chibi completo, cabeza grande y cuerpo pequeño |
monochrome, greyscale, manga, screentone | Una viñeta de manga en blanco y negro convincente, con trama de pantalla |
watercolor (medium), traditional media | Solo un leve cambio en el renderizado |
sketch, pencil drawing, traditional media | Solo un leve cambio en el renderizado |
Los estilos fuertes son los que tienen un vocabulario visual reconocible: anime de cel capturado de pantalla, proporciones chibi, tinta de manga. Las dos etiquetas de medios tradicionales apenas movieron la superficie y poco más. Si quieres un verdadero aspecto de acuarela o de lápiz, espera tener que recurrir a un LoRA de estilo en lugar de una etiqueta.
Un detalle más: la ponderación de prompts como (chibi:2) funciona, pero necesitó un peso más alto del que estamos acostumbrados con los modelos de la época de SDXL.
Tamaño, resolución y velocidad
No hay un campo de tamaño. Eliges un aspect_ratio entre 15 opciones (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) y un nivel de resolution, 1k o 1.5k, más un seed opcional. El nivel 1k es de alrededor de un megapíxel; 1.5k es de alrededor de 2.4 megapíxeles y se genera de forma nativa, sin escalado. Una imagen 16:9 mide 1360 x 768 en 1k y 2048 x 1152 en 1.5k; 1:3 mide 576 x 1760 y 880 x 2048. La salida siempre es JPEG, una imagen por solicitud. La relación de aspecto no cambia el precio, el nivel 1.5k cuesta más que el 1k y las solicitudes fallidas no se cobran.
Medimos 60 ejecuciones que cubrían todas las relaciones de aspecto en ambos niveles. El tiempo del modelo fue de 2 a 16 segundos por imagen, y 52 de las 60 terminaron en menos de 10 segundos.
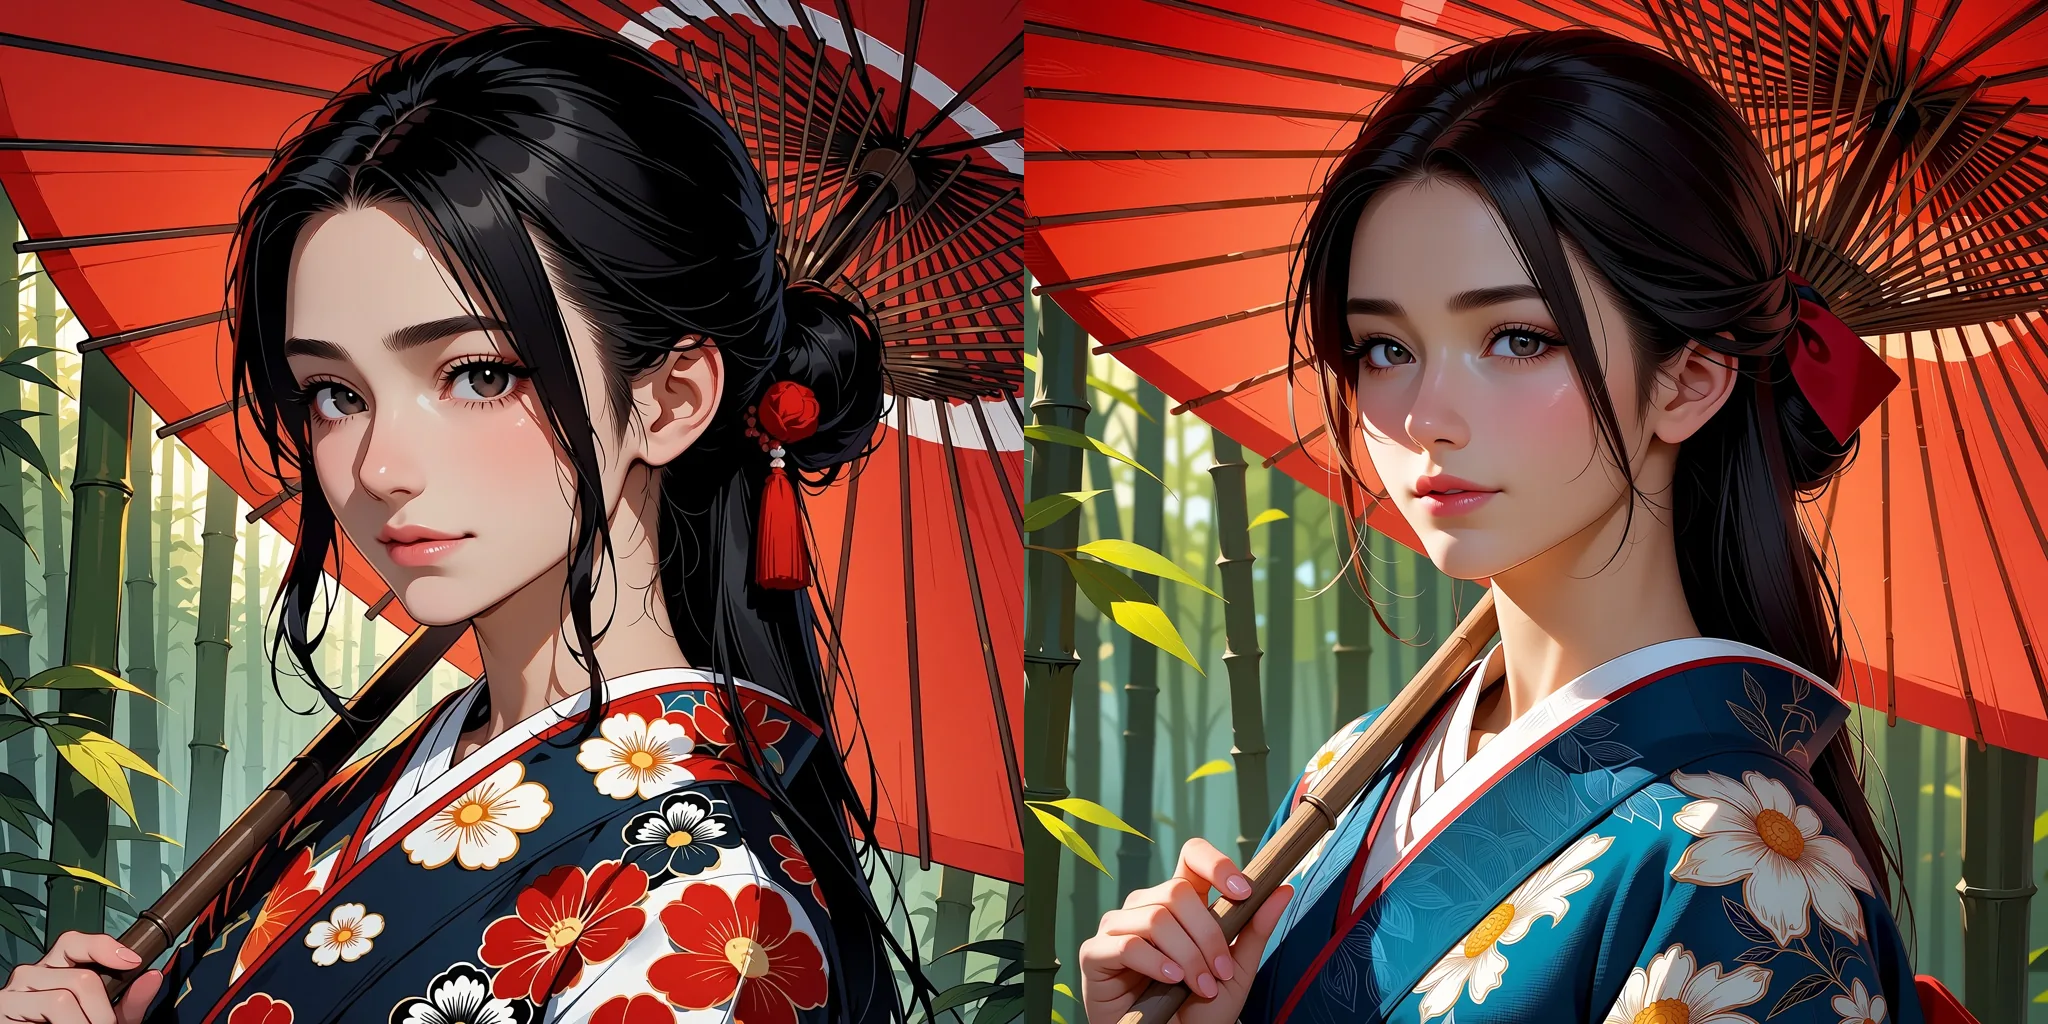
Izquierda: 1k (1024 x 1024). Derecha: 1.5k (1536 x 1536). Mismo prompt, seed 8, 1:1.
Los dos niveles no son una ampliación píxel por píxel. El mismo prompt y seed dieron un rostro distinto y un estampado de kimono diferente. Lo que se paga en 1.5k es más detalle en las telas y líneas más limpias. Haz los borradores en 1k, vuelve a ejecutar los mejores en 1.5k y trata el resultado como una toma nueva, no como una copia más nítida.
Hasta dónde llega
El endpoint no tiene censura y la plataforma no agrega ningún filtro de contenido. En nuestras pruebas, el modelo tampoco se contuvo: nuestra prueba de contenido más exigente se generó tal como se escribió al primer intento, en texto a imagen y en imagen a imagen, con y sin LoRA, y con varios seeds. No publicamos ese prompt; los ejemplos de abajo son escenas cotidianas.
Lo que el modelo hace bien en escenas ordinarias es abarcar un gran rango. Un solo estilo de prompt produjo retratos, parejas, un cantinero del turno de noche y paisajes vacíos:
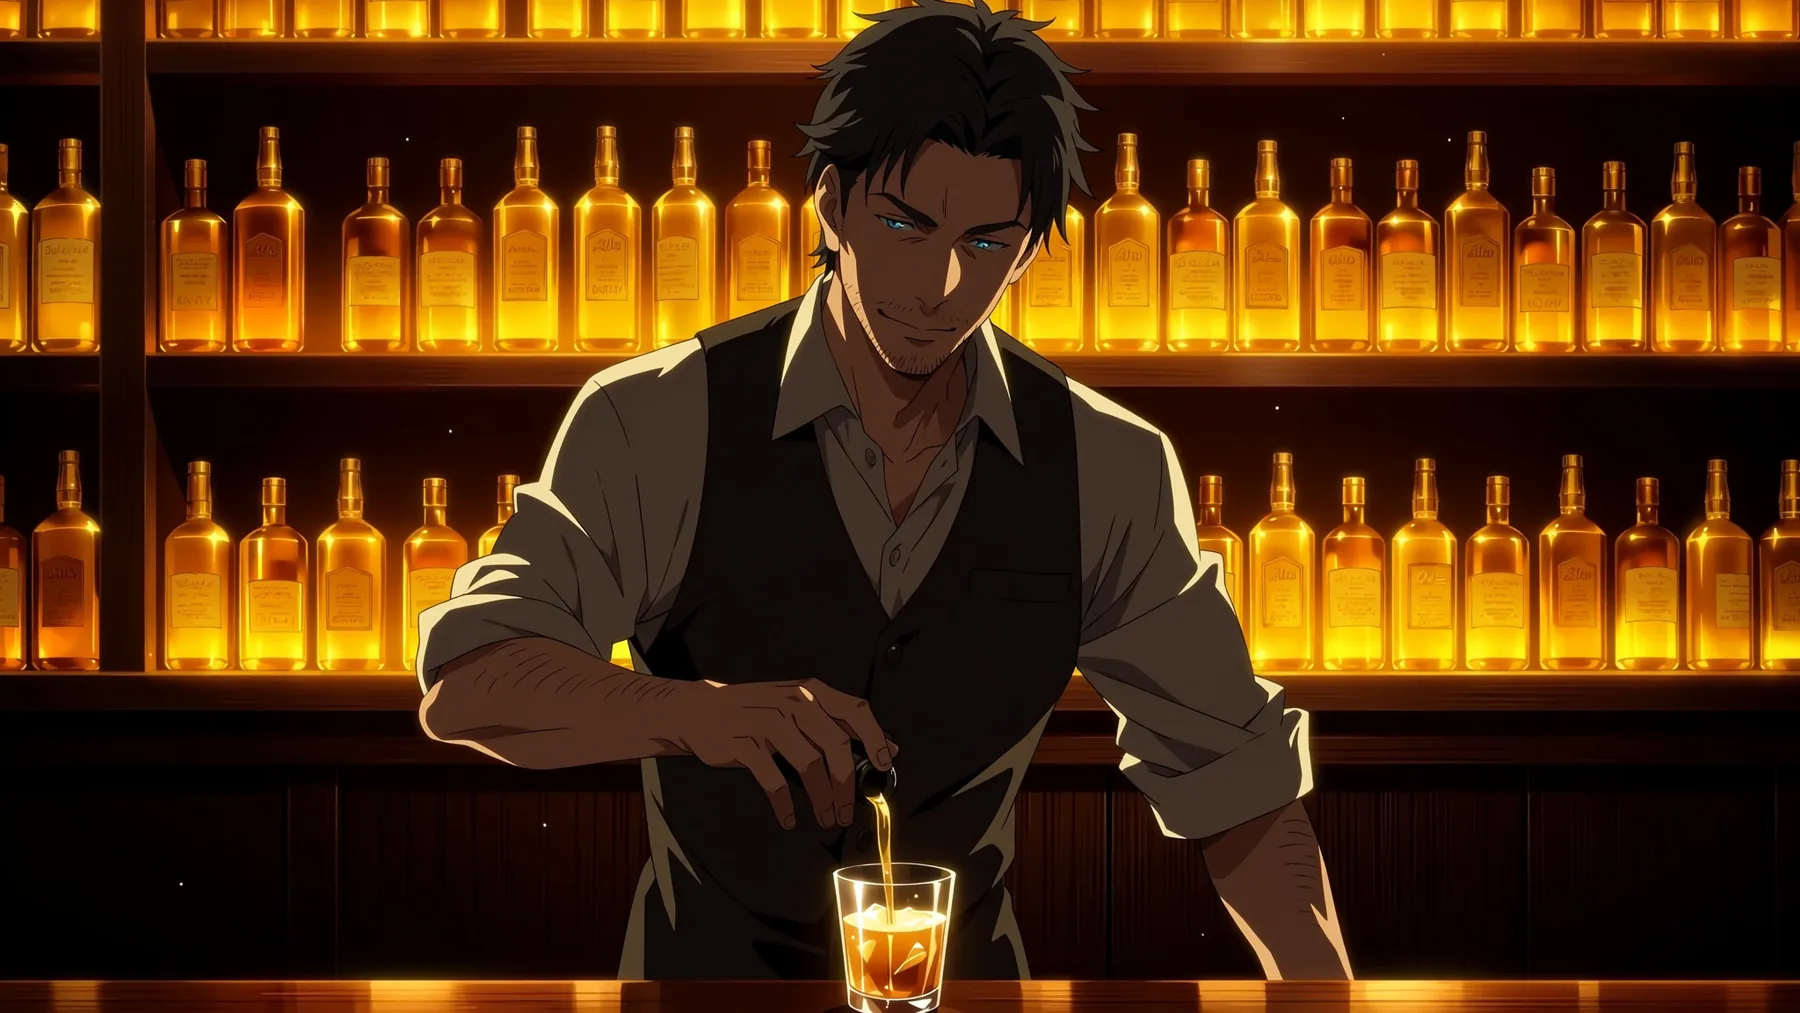
Tres frases, etiqueta de clasificación safe, 16:9, nivel 1.5k, seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.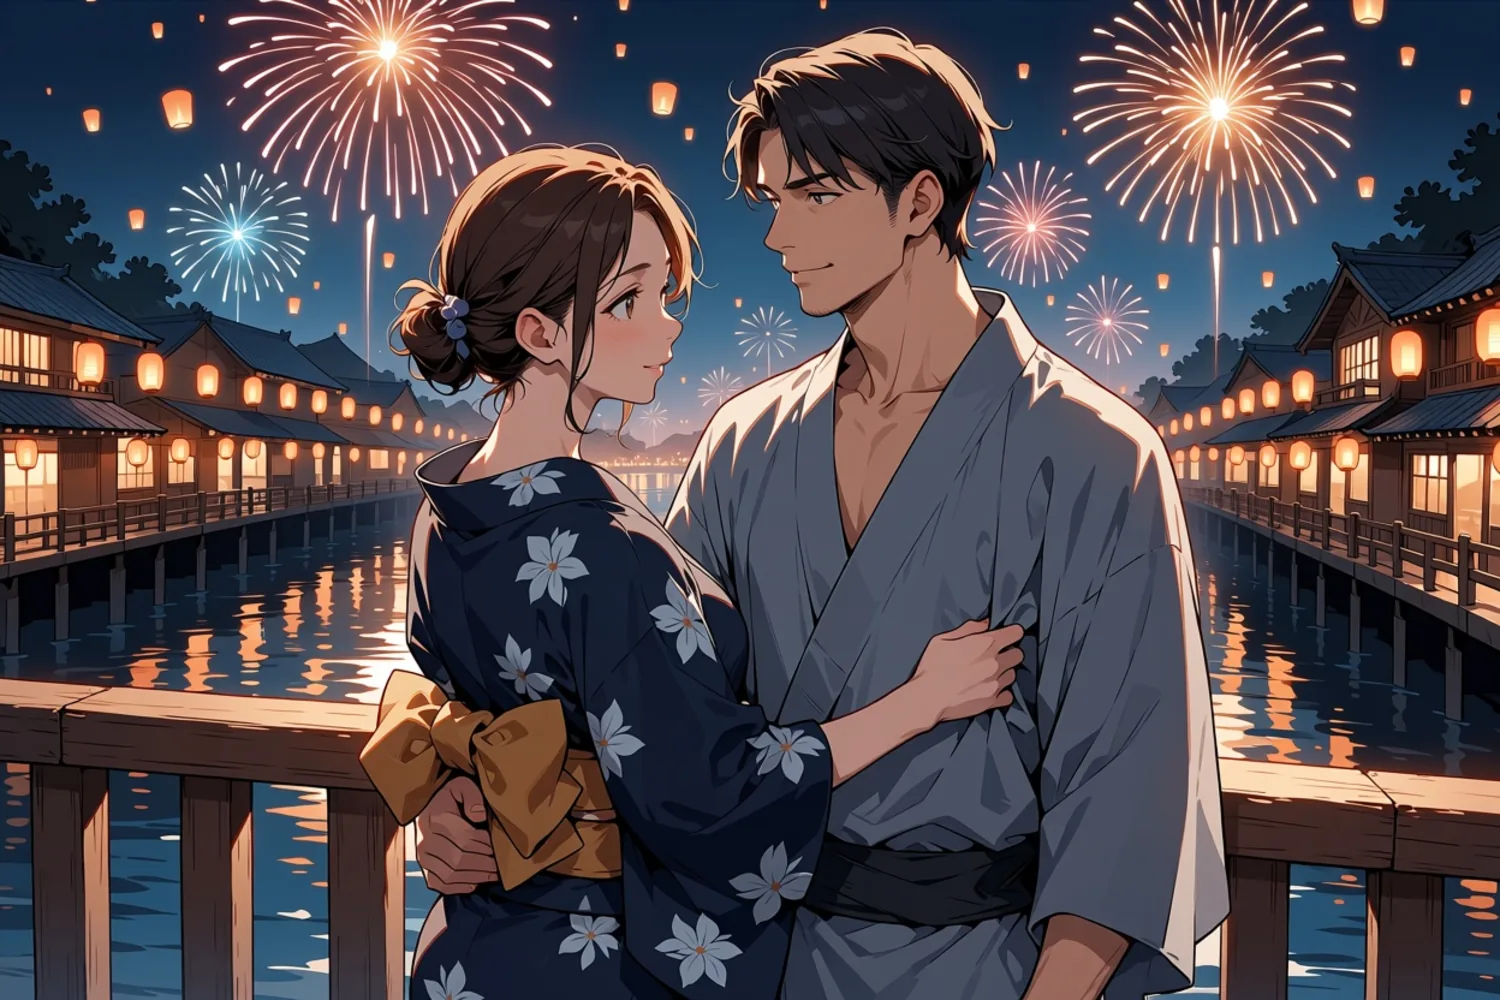
Etiquetas con el número de personajes 1girl, 1boy, 3:2, nivel 1k, seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections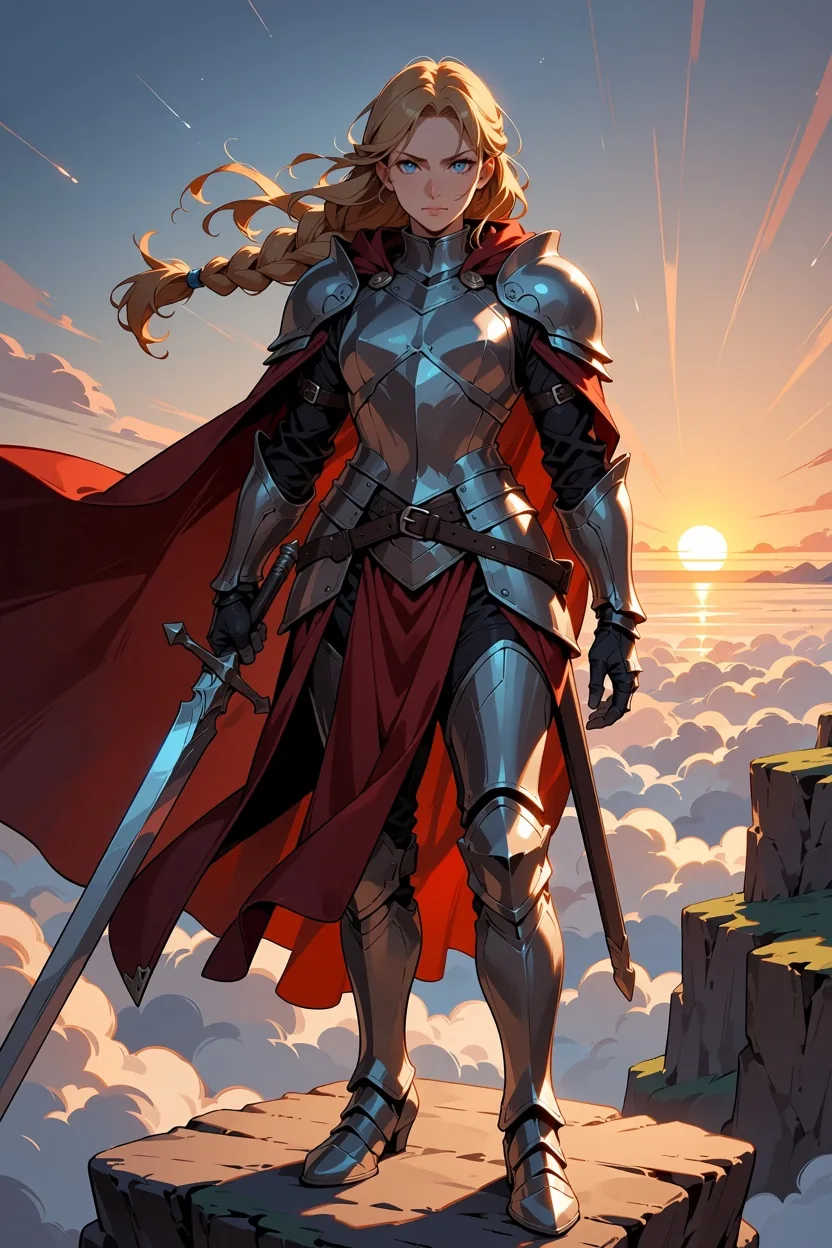
Etiquetas, retrato 2:3, nivel 1k, seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, después de las etiquetas habituales de calidad, clasificación y número de personajes.
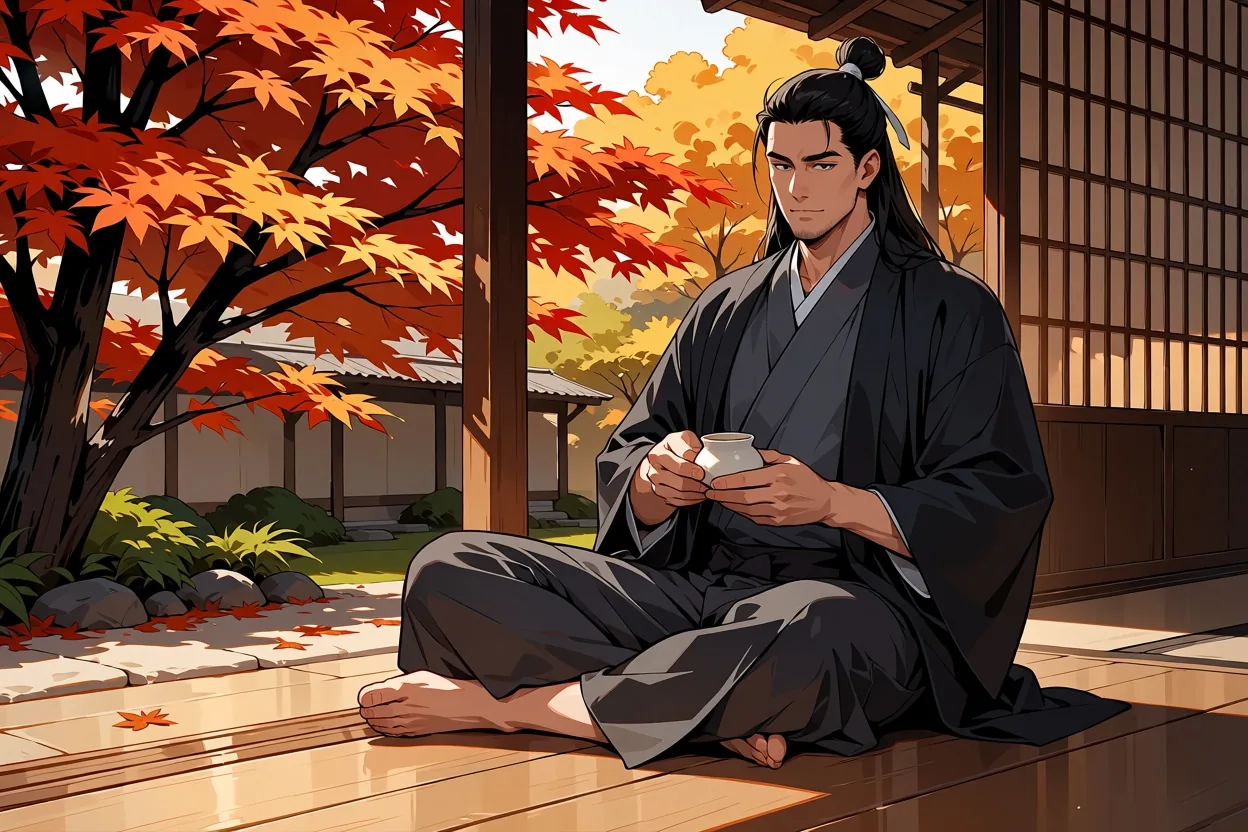
Etiquetas, 3:2, nivel 1k, seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
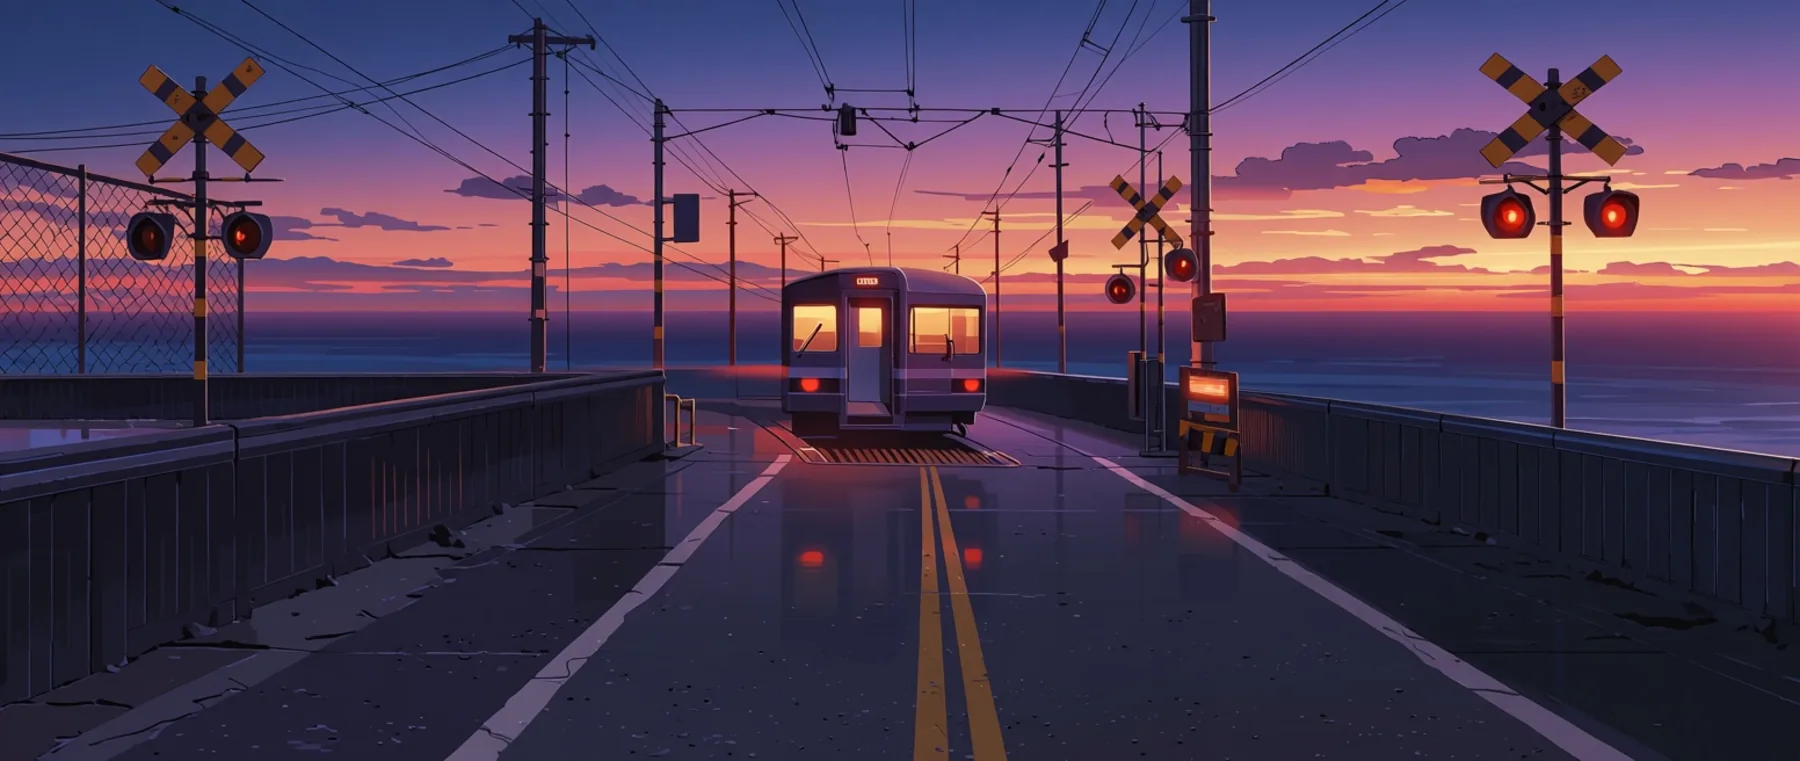
Paisaje con no humans, 21:9, nivel 1k (1552 x 656), seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotLas relaciones poco habituales también se sostienen. Un 9:16, un banner alto 1:3 y una toma ancha 16:9 salieron compuestos para su encuadre, no recortados de un cuadrado:
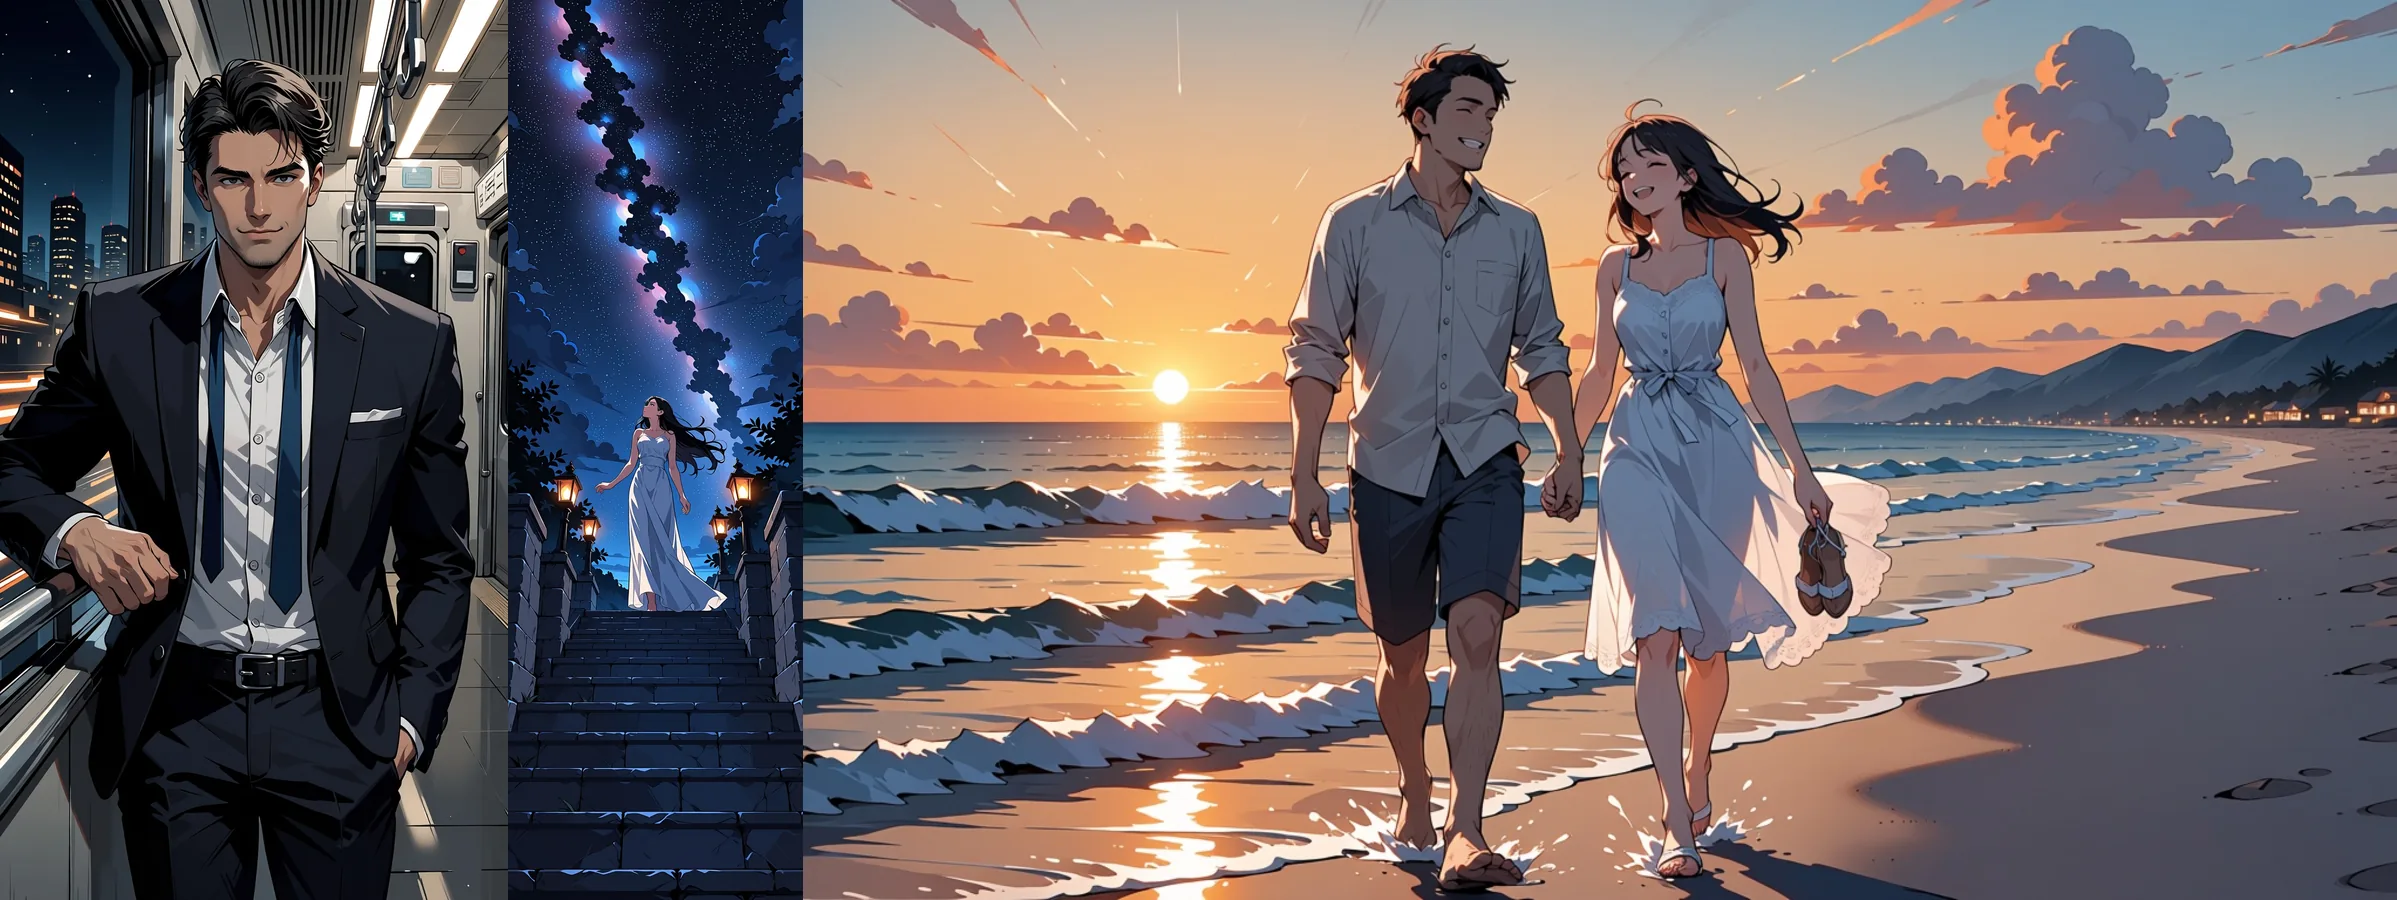
De izquierda a derecha: 9:16, 1:3, 16:9, todas en el nivel 1k y todas de texto a imagen.
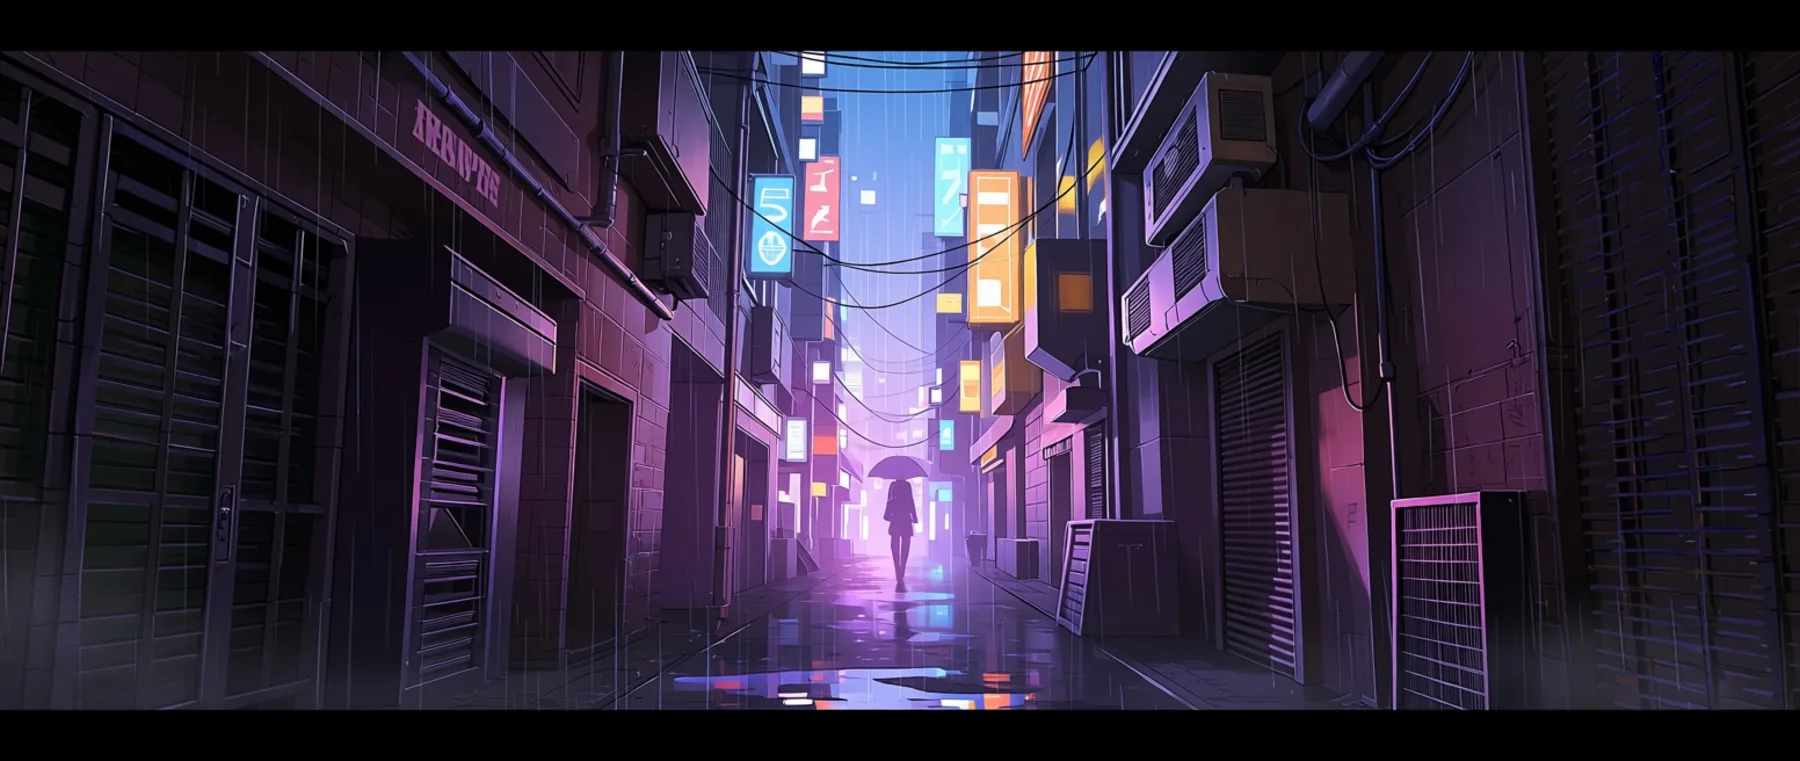
Paisaje de un callejón cyberpunk, 21:9, nivel 1k.
Dónde se queda corto
- Sin fotorrealismo. Es un modelo de anime e ilustración. No esperes un aspecto fotográfico con ningún prompt.
- El texto es débil. Dibuja una o dos palabras, no una frase, un letrero ni un pie de foto.
- Sin prompt negativo, pasos, CFG ni sampler. Los campos públicos son
prompt,aspect_ratio,resolutionyseed. La etiqueta de clasificación y tu redacción son los únicos frenos que tienes. - Un garabato parecido a una firma. A veces el modelo dibuja una firma o una línea de pseudotexto en una esquina, un hábito que aprendió de las obras de arte. Lo vimos en aproximadamente una de cada cinco imágenes. Ningún prompt negativo puede suprimirlo. Cambia el seed o recorta el borde.
- Los seeds hacen comparables las ejecuciones, no idénticas. La misma solicitud con el mismo seed nos dio tres renderizados ligeramente distintos en momentos diferentes. Usa un seed para comparar dos cambios de prompt, no para prometerle a un cliente una repetición exacta al píxel.
- Una imagen por solicitud, solo JPEG, sin máscaras. No hay un campo de inpainting.
Quién debería usarlo
Usa Anima Turbo si quieres borradores rápidos de anime e ilustración con un precio por imagen, si te gusta escribir prompts de etiquetas o quieres combinar etiquetas con un par de frases, o si necesitas una salida sin filtros de un modelo pequeño. Es un buen modelo para explorar personajes y escenas en 1k y luego pasar los mejores a 1.5k.
Busca otra opción si necesitas realismo fotográfico o texto legible dentro de la imagen.
Qué familia Anima conviene usar
SpicyAPI tiene dos familias Anima. Comparten el mismo modelo base, así que la elección depende de si necesitas un aspecto personalizado:
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| Nombres del modelo en la API | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Campo adicional | Ninguno | loras: hasta 3 entradas, cada una con un path y un scale de 0 a 4 |
| Ideal para | Borradores rápidos, prompts con etiquetas y frases, el aspecto base | Un estilo artístico, personaje o look de época concreto a partir de un LoRA de Anima |
| Control de estilo | Etiquetas de estilo en el prompt | Etiquetas de estilo más LoRA |
| Precio | Por imagen según el nivel de resolución | Misma estructura; cargar LoRA no suma un cargo aparte |
Empieza con Anima Turbo. Pasa a la familia LoRA cuando una etiqueta de estilo no baste, por ejemplo cuando una etiqueta de acuarela o de lápiz solo movió la superficie en nuestra prueba.
Dos pasos siguientes naturales:
- Estilos personalizados. La familia Anima Turbo LoRA carga hasta tres LoRA por solicitud, así que puedes añadir un aspecto específico, incluidos los LoRA para adultos de la comunidad. Nuestra guía complementaria lo explica: guía de estilos LoRA para Anima Turbo.
- Cambiar el estilo de fotos. El endpoint de imagen a imagen recibe una imagen de origen y un
strengthde 0 a 1. Consulta de foto a anime con Anima Turbo para ver qué hace cada valor de fuerza.
Preguntas frecuentes
¿Anima Turbo admite prompts negativos?
No. Los campos públicos son prompt, aspect_ratio, resolution y seed, sin prompt negativo, pasos, CFG ni sampler. Pon en el prompt lo que quieres, y usa la etiqueta de clasificación (safe, sensitive o nsfw) para fijar el tono.
¿Qué resolución debo usar?
Haz los borradores en 1k y vuelve a ejecutar en 1.5k las imágenes que te gusten. El nivel 1k es de alrededor de un megapíxel y 1.5k de alrededor de 2.4 megapíxeles, generados de forma nativa. En nuestras pruebas el mismo prompt y seed dieron un rostro distinto en 1.5k, así que trátalo como una toma nueva con más detalle y no como una ampliación.
¿Por qué hay una firma o texto extraño en la esquina?
El modelo aprendió ese hábito de las obras de arte. Vimos un garabato parecido a una firma o una línea de pseudotexto en aproximadamente una de cada cinco imágenes. Aquí un prompt negativo no puede eliminarlo, así que cambia el seed o recorta el borde.
¿Un seed fijo da la misma imagen siempre?
No de forma fiable. La misma solicitud con el mismo seed nos dio tres renderizados ligeramente distintos en momentos diferentes. Usa un seed para comparar dos cambios de prompt, no para prometer una repetición exacta al píxel.
¿Puedo usar LoRA de SDXL o de Pony con Anima?
No, usa LoRA entrenados para Anima, es decir, la familia Anima Turbo LoRA. En nuestras pruebas, un LoRA entrenado para otro modelo base (uno de FLUX) se cargó sin error y no cambió nada. El endpoint base de Anima Turbo no admite LoRA en absoluto.
¿Puede Anima editar una imagen en lugar de volver a dibujarla?
Reestiliza en lugar de editar. El endpoint de imagen a imagen recibe una imagen de origen y un strength de 0 a 1, y en nuestras pruebas pedirle a una ilustración existente un atuendo nuevo o pasar de día a noche cambió muy poco. No hay campo de máscara ni de inpainting.
¿Puede escribir texto dentro de la imagen?
Solo una o dos palabras. Las frases, los letreros y los pies de foto no son algo que este modelo haga bien, así que agrega el texto después en un editor.
¿Hace fotorrealismo?
No. Es un modelo de anime e ilustración, y ningún prompt nos dio un aspecto fotográfico.