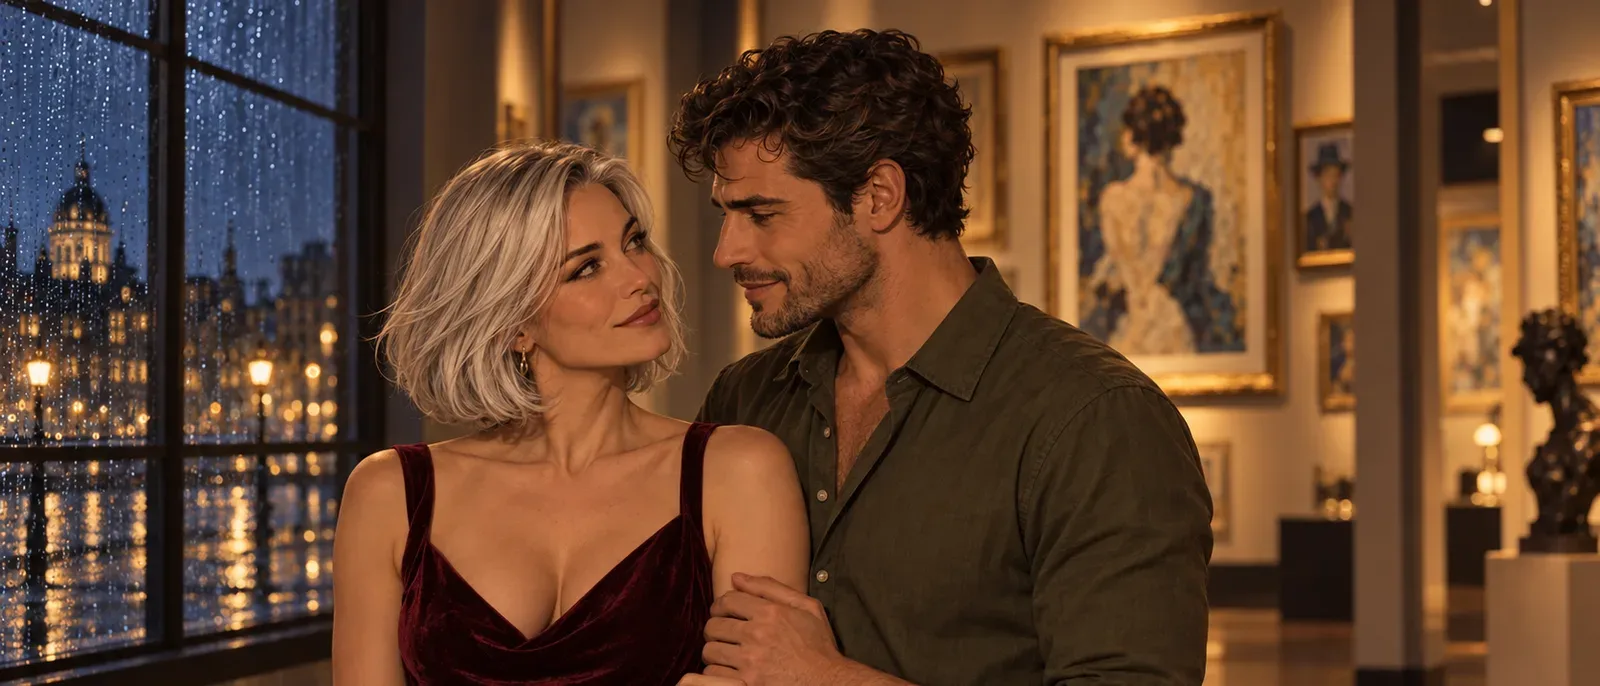
O Anima Turbo é um modelo pequeno e rápido de anime e ilustração, que recompensa um prompt de tags bem organizado e também entende frases comuns. Nos nossos testes, ele terminou a maioria das imagens em menos de dez segundos, seguiu bem as tags de estilo e não aplicou nenhuma censura: nosso teste de conteúdo mais pesado saiu como foi escrito, de primeira. Os limites são igualmente claros. Ele não faz fotorrealismo, desenha só uma ou duas palavras de texto e não tem prompt negativo.
O Anima Turbo é a versão destilada do Anima, da CircleStone Labs, um modelo de 2 bilhões de parâmetros baseado no NVIDIA Cosmos-Predict2 com um codificador de texto Qwen3. Fizemos estes testes em 5 de outubro de 2026, pelo endpoint de texto para imagem do Anima Turbo. Todos os prompts abaixo são cenas do dia a dia com adultos vestidos.
Visão geral
| Anima Turbo (testado em 5 de outubro de 2026) | |
|---|---|
| Desenvolvedora e base | CircleStone Labs com a Comfy Org; 2B de parâmetros no NVIDIA Cosmos-Predict2 (2B), codificador de texto Qwen3 |
| Nomes do modelo na API | circlestone-labs/anima-turbo/text-to-image e circlestone-labs/anima-turbo/edit |
| Campos públicos (texto para imagem) | prompt (até 5.000 caracteres), aspect_ratio, resolution, seed |
| Proporções | 15, de 1:1 e 16:9 até 21:9 e 1:3 |
| Níveis de resolução | 1k (cerca de 1 megapixel, por exemplo 1360 x 768 em 16:9) e 1.5k (cerca de 2,4 megapixels, por exemplo 2048 x 1152, gerado de forma nativa) |
| Velocidade nos nossos testes | De 2 a 16 segundos por imagem em 60 execuções; 52 de 60 abaixo de 10 segundos |
| Saída | Um JPEG por requisição |
| Política de conteúdo | Sem censura, sem filtro de conteúdo; nosso teste de conteúdo mais pesado saiu como foi escrito, de primeira |
| O que não faz | Fotorrealismo, mais que uma ou duas palavras de texto, prompts negativos, passos, CFG, sampler, máscaras |
O que é o Anima Turbo
O Anima vem da CircleStone Labs, em parceria com a Comfy Org. É um modelo de 2 bilhões de parâmetros, baseado no Cosmos-Predict2 (2B) da NVIDIA, com um codificador de texto Qwen3. A desenvolvedora lança três versões: Base, Aesthetic e Turbo. A Turbo é a destilada, feita para 8 a 12 passos de amostragem. Segundo a desenvolvedora, ela fica só um pouco abaixo da Anima-Aesthetic na média, sendo muito mais rápida, e é por ela que se recomenda começar. Ainda segundo a desenvolvedora, os dados de treino são vários milhões de imagens de anime mais cerca de 800 mil imagens artísticas que não são de anime, sem nenhum dado sintético. A página do modelo está em huggingface.co/circlestone-labs/Anima.
Na SpicyAPI, o modelo é público como circlestone-labs/anima-turbo/text-to-image. A plataforma não adiciona filtro de conteúdo, então o resultado depende do modelo e do seu prompt. A página da família mostra o preço atual por imagem em cada resolução.
Tags ou frases: as duas funcionam, mas o resultado é diferente
O Anima segue as convenções de tags do Danbooru. O conselho da desenvolvedora, que seguimos: minúsculas, espaços no lugar de sublinhados e uma ordem fixa, com as tags de qualidade e de classificação primeiro, depois o número de pessoas (1girl, 1boy, no humans), depois personagem, série e artista e, por fim, todo o resto. Uma abertura segura é masterpiece, best quality, opcionalmente com score_7.
A linguagem natural também funciona. A desenvolvedora recomenda pelo menos duas frases, e vimos o motivo: prompts muito curtos se perdem. Rodamos duas vezes a mesma cena de um café na chuva com o mesmo seed, uma vez em tags e outra em quatro frases.
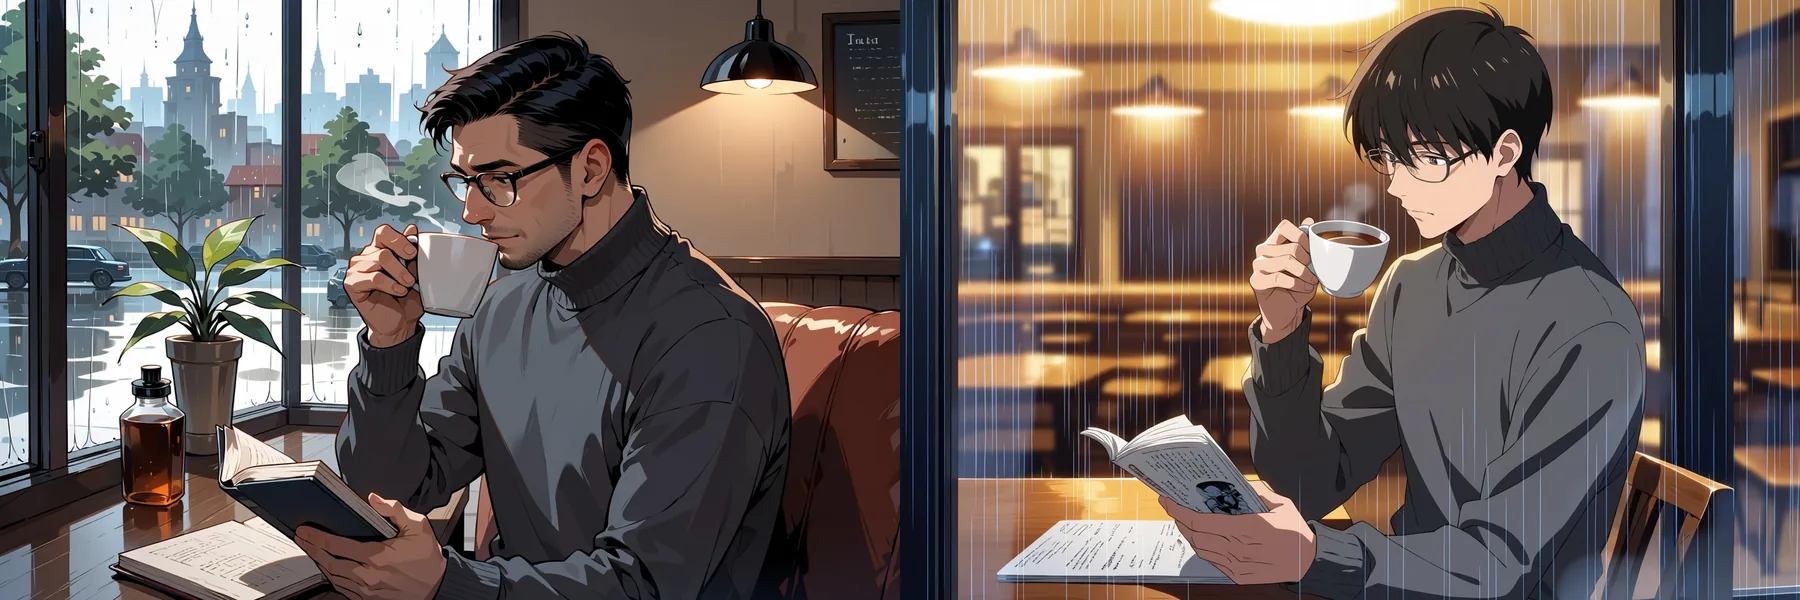
Esquerda: tags. Direita: quatro frases. Mesmo seed (4), 3:2, nível 1k, texto para imagem.
A versão com tags:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyA versão com frases:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.As duas acertaram os óculos, a gola alta, a xícara e o livro. A diferença está no que você não especificou. O prompt de tags deu um rosto mais maduro e uma cena com janela clara; o de frases deu um rosto mais jovem e um ambiente mais sombrio. Nos nossos testes, as tags dão controle mais preciso sobre o personagem, e as frases trazem atmosfera de graça. Misturar os dois, com um cabeçalho de tags e uma ou duas frases descritivas, também funcionou.
Qual usar, com base nas nossas execuções e na orientação da desenvolvedora:
| Situação | Melhor opção | Por quê |
|---|---|---|
| Você precisa do visual exato de um personagem (cabelo, óculos, roupa) | Tags | Cada tag é uma instrução separada, então os detalhes ficam no lugar |
| Você quer clima, iluminação ou uma cena que "transmita" uma sensação | Frases | A versão em frases nos deu o ambiente mais sombrio sem pedirmos |
| Você está chamando um artista conhecido ou um estilo reconhecido | Tags, com @ antes do artista | A desenvolvedora diz que o estilo de um artista sem o @ é fraco |
| Você está comparando seeds ou ajustes de prompt | Tags | Prompts curtos e fixos facilitam atribuir uma mudança à causa |
| Você está escrevendo uma descrição curta | Duas ou mais frases | A desenvolvedora recomenda pelo menos duas; prompts muito curtos se perdem |
| Você quer controle e atmosfera | Um cabeçalho de tags mais uma ou duas frases | A mistura funcionou nos nossos testes |
Escrevendo prompts que se sustentam
A ordem abaixo segue o conselho da desenvolvedora e é a que usamos em todos os prompts deste artigo:
- Tags de qualidade e de classificação primeiro.
masterpiece, best quality, opcionalmentescore_7, depoissafe,sensitiveounsfw. Sem prompt negativo, a tag de classificação define o tom. - Número de pessoas em seguida.
1girl,1boy,1girl, 1boyouno humanspara cenários. - Personagem, série e artista. Artistas levam o prefixo
@. - Todo o resto. Cabelo, roupa, lugar, luz, enquadramento. Minúsculas, espaços no lugar de sublinhados.
- Pesos quando uma tag está fraca demais.
(chibi:2)funcionou no nosso teste de estilos, mas o modelo precisou de pesos mais altos do que os modelos da era SDXL, então não pare em 1.2.
O limite do prompt é de 5.000 caracteres, e prompts de tags raramente chegam perto. Três hábitos fizeram diferença visível nas nossas execuções:
- Comece com uma tag de classificação. O modelo conhece
safe,sensitiveensfw, além de uma tag ainda mais forte. Sem prompt negativo, a tag de classificação é sua principal forma de definir o tom, por isso todos os prompts deste artigo abrem comsafe. - Diga que os personagens são adultos.
adult woman, mature femaleou "a man in his thirties" mantém o elenco onde você quer. - Coloque
@antes do nome do artista. Segundo a desenvolvedora, o estilo de um artista sem o@é fraco.
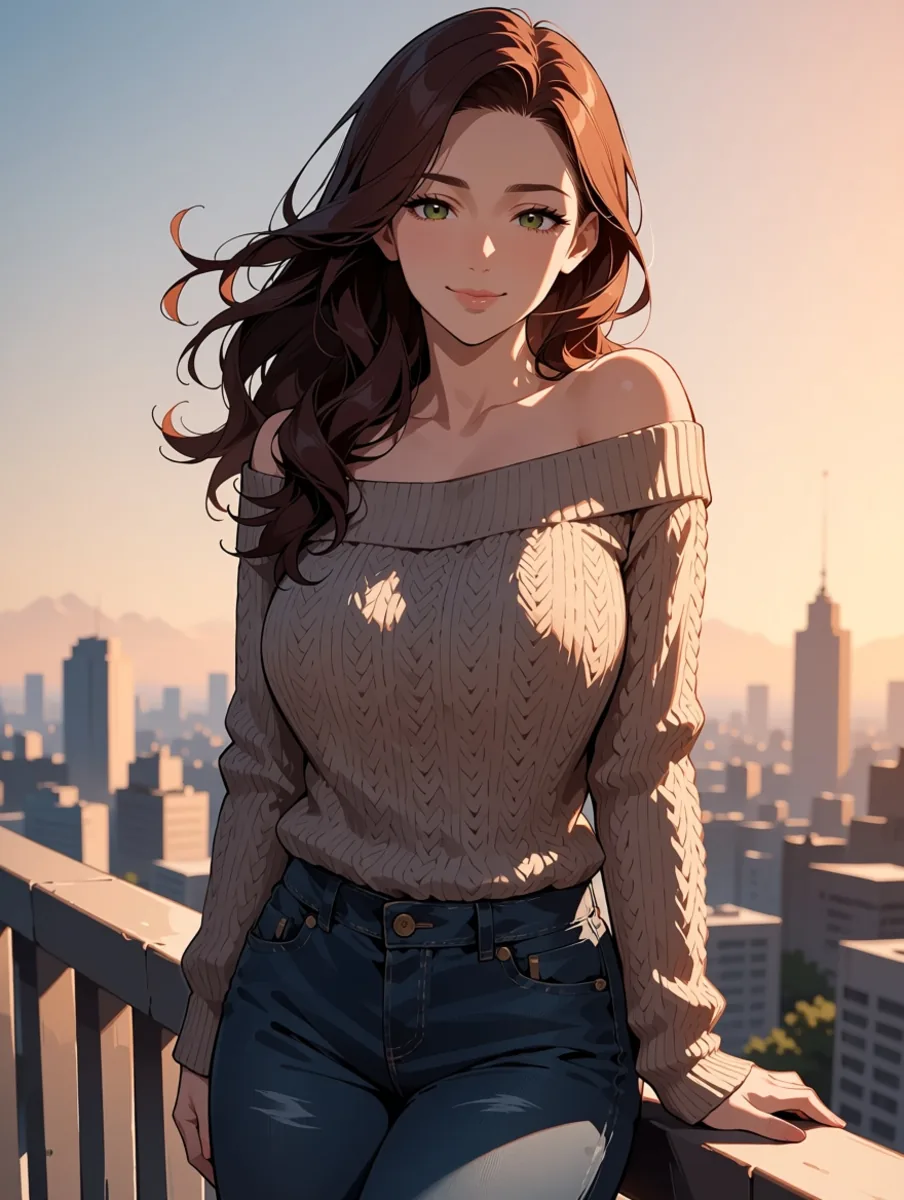
Um prompt só de tags: tag de classificação, número de pessoas, cabelo, roupa, lugar, luz. 3:4, nível 1k, seed 3.
O que as tags de estilo fazem
Este foi o teste que mais nos interessava. Fixamos um personagem (uma mulher adulta de cabelo curto prateado, de trench coat numa rua no outono) e um seed (12), mudamos só as tags de estilo e rodamos cada uma em 1:1 no nível 1k. O prompt base:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile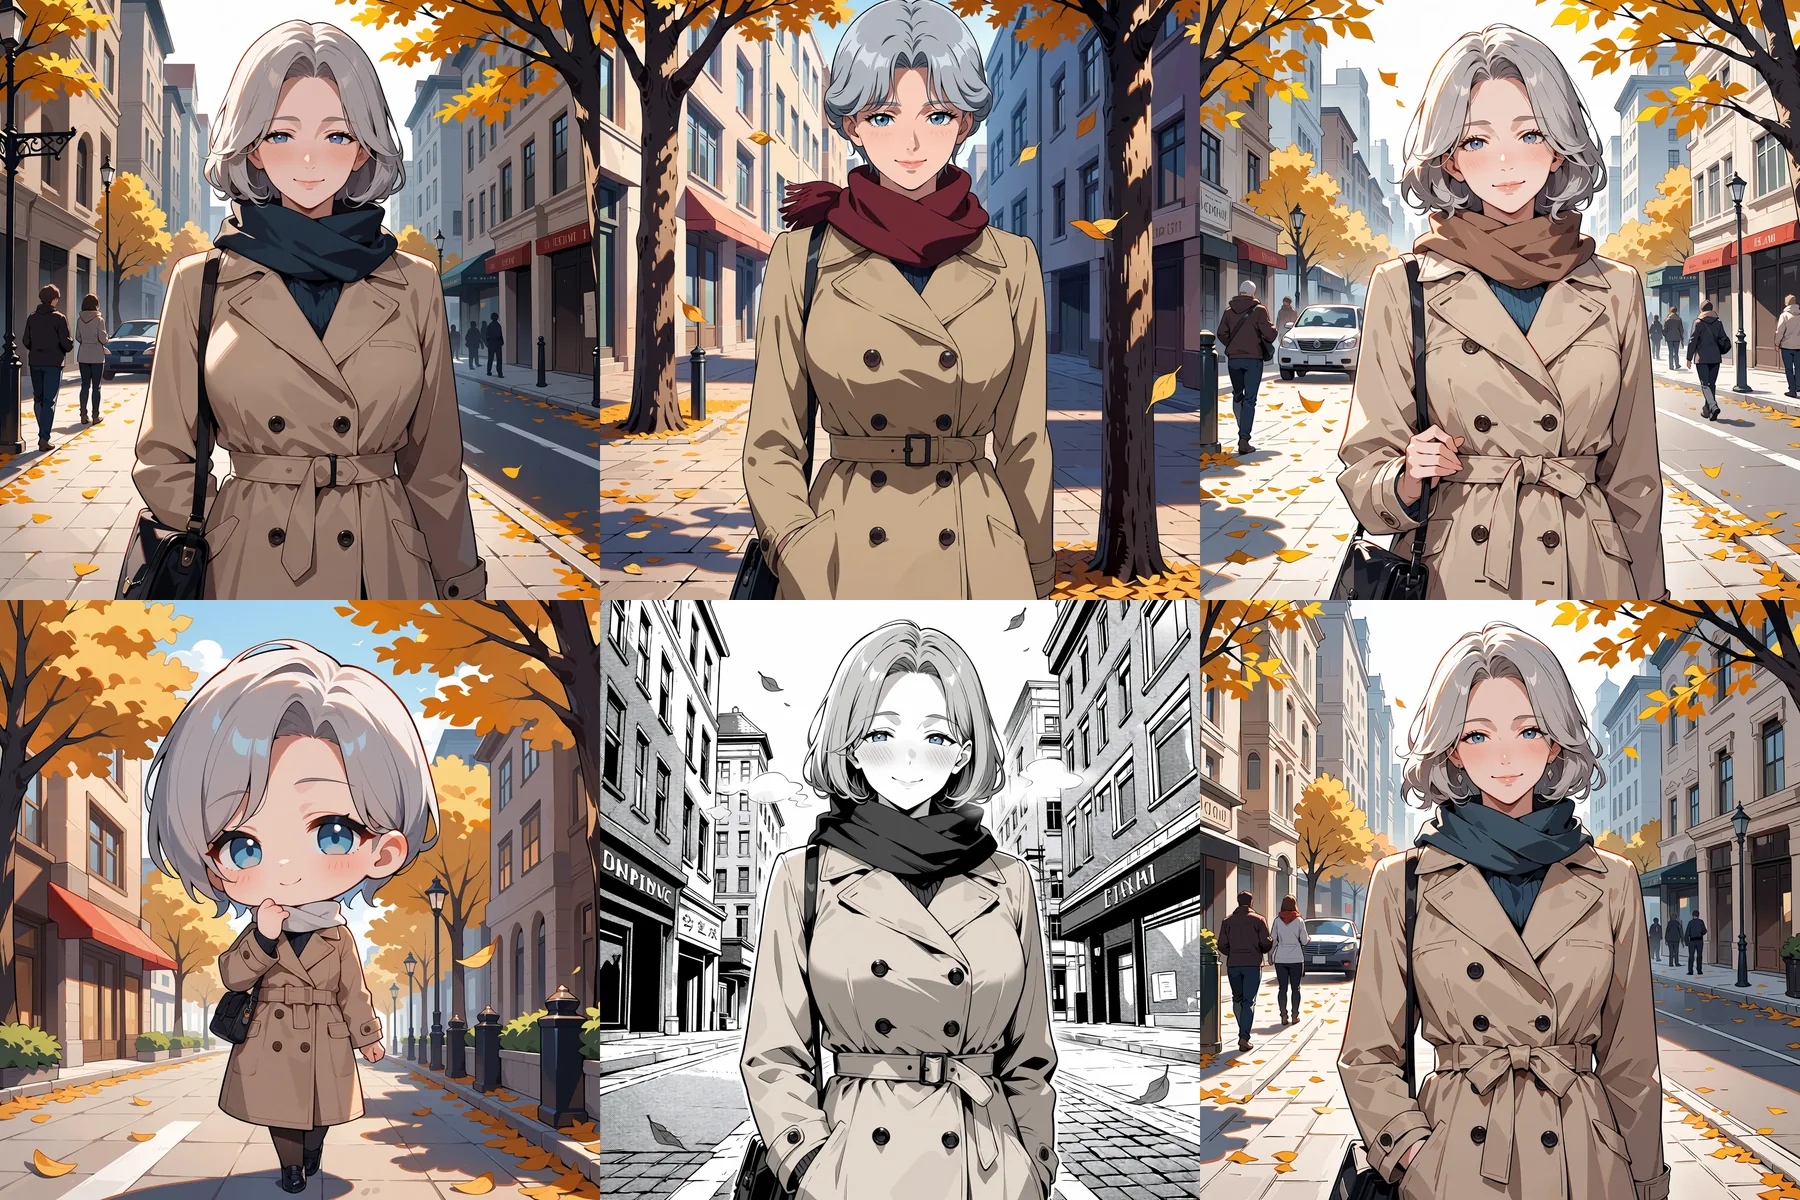
Fileira de cima: sem tag de estilo, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Fileira de baixo: (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Seed 12 em todas.
O que vimos:
| Tags de estilo adicionadas | Resultado nos nossos testes |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Um visual claro de cel dos anos 90: cores mais chapadas, sombras mais duras |
(chibi:2) | Um chibi completo, cabeça grande e corpo pequeno |
monochrome, greyscale, manga, screentone | Um painel de mangá em preto e branco convincente, com screentone |
watercolor (medium), traditional media | Só uma leve mudança na renderização |
sketch, pencil drawing, traditional media | Só uma leve mudança na renderização |
Os estilos fortes são os que têm um vocabulário visual reconhecível: anime em cel capturado de tela, proporções chibi, nanquim de mangá. As duas tags de mídia tradicional só mexeram na superfície e pouco mais. Se você quer um visual de aquarela ou lápis de verdade, espere precisar de um LoRA de estilo em vez de uma tag.
Mais um detalhe: o peso de prompt como (chibi:2) funciona, mas exigiu um peso maior do que estamos acostumados nos modelos da era SDXL.
Tamanho, resolução e velocidade
Não existe campo de tamanho. Você escolhe um aspect_ratio entre 15 opções (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) e um nível de resolution, 1k ou 1.5k, além de um seed opcional. O nível 1k tem cerca de um megapixel; o 1.5k tem cerca de 2,4 megapixels e é gerado de forma nativa, não ampliado. Uma imagem 16:9 tem 1360 x 768 no 1k e 2048 x 1152 no 1.5k; a 1:3 tem 576 x 1760 e 880 x 2048. A saída é sempre JPEG, uma imagem por requisição. A proporção não muda o preço, o nível 1.5k custa mais que o 1k e requisições com falha não são cobradas.
Cronometramos 60 execuções cobrindo todas as proporções nos dois níveis. O tempo de modelo foi de 2 a 16 segundos por imagem, e 52 das 60 terminaram em menos de 10 segundos.
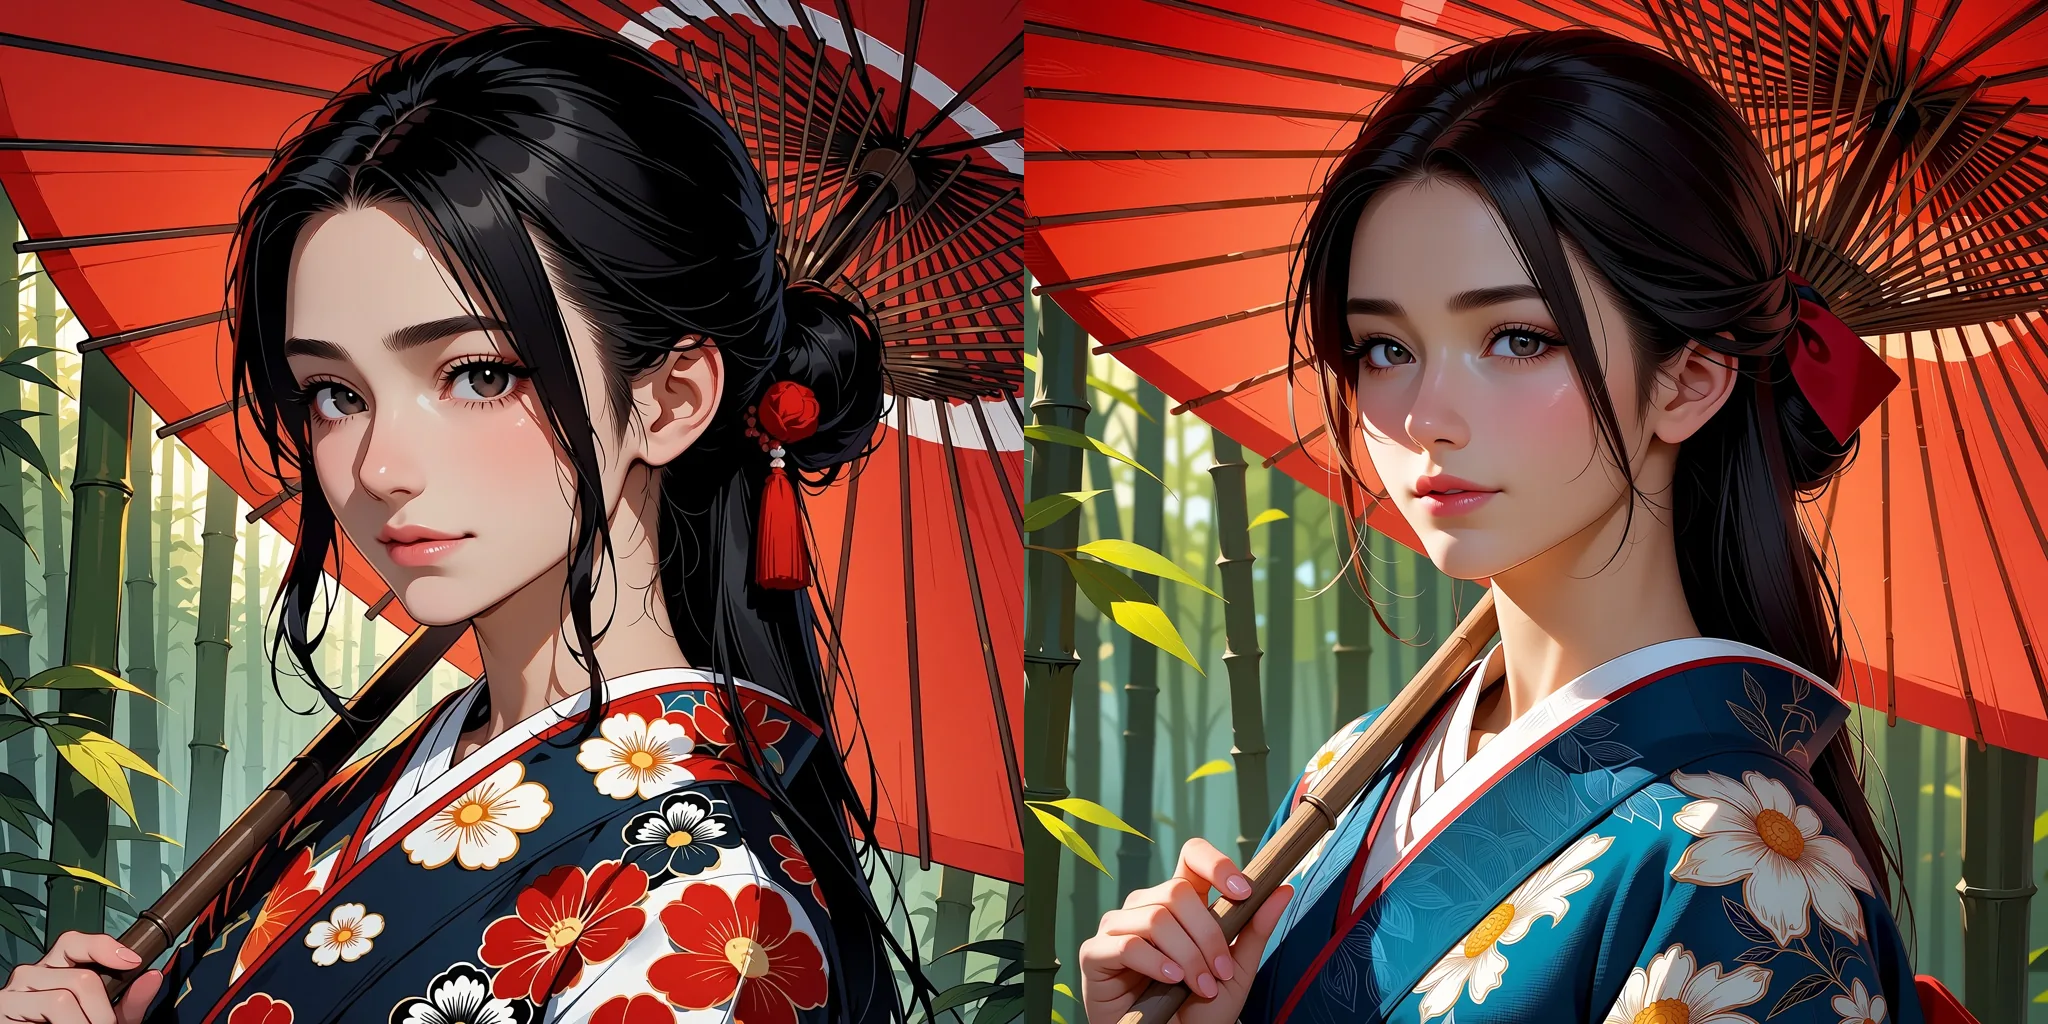
Esquerda: 1k (1024 x 1024). Direita: 1.5k (1536 x 1536). Mesmo prompt, seed 8, 1:1.
Os dois níveis não são uma ampliação pixel a pixel. O mesmo prompt e seed deram um rosto diferente e outro estampado de quimono. O que você paga no 1.5k é mais detalhe no tecido e traço mais limpo. Faça rascunhos em 1k, depois rode de novo os escolhidos em 1.5k e trate o resultado como uma nova versão, não como uma cópia mais nítida.
Até onde vai
O endpoint não tem censura e a plataforma não adiciona filtro de conteúdo. Nos nossos testes, o modelo também não se conteve: nosso teste de conteúdo mais pesado saiu como foi escrito, de primeira, em texto para imagem e em imagem para imagem, com e sem LoRAs, em seeds repetidos. Não publicamos esse prompt; os exemplos abaixo são cenas do dia a dia.
O que o modelo faz bem em cenas comuns é variedade. Um único estilo de prompt produziu retratos, casais, um barman do turno da noite e paisagens vazias:
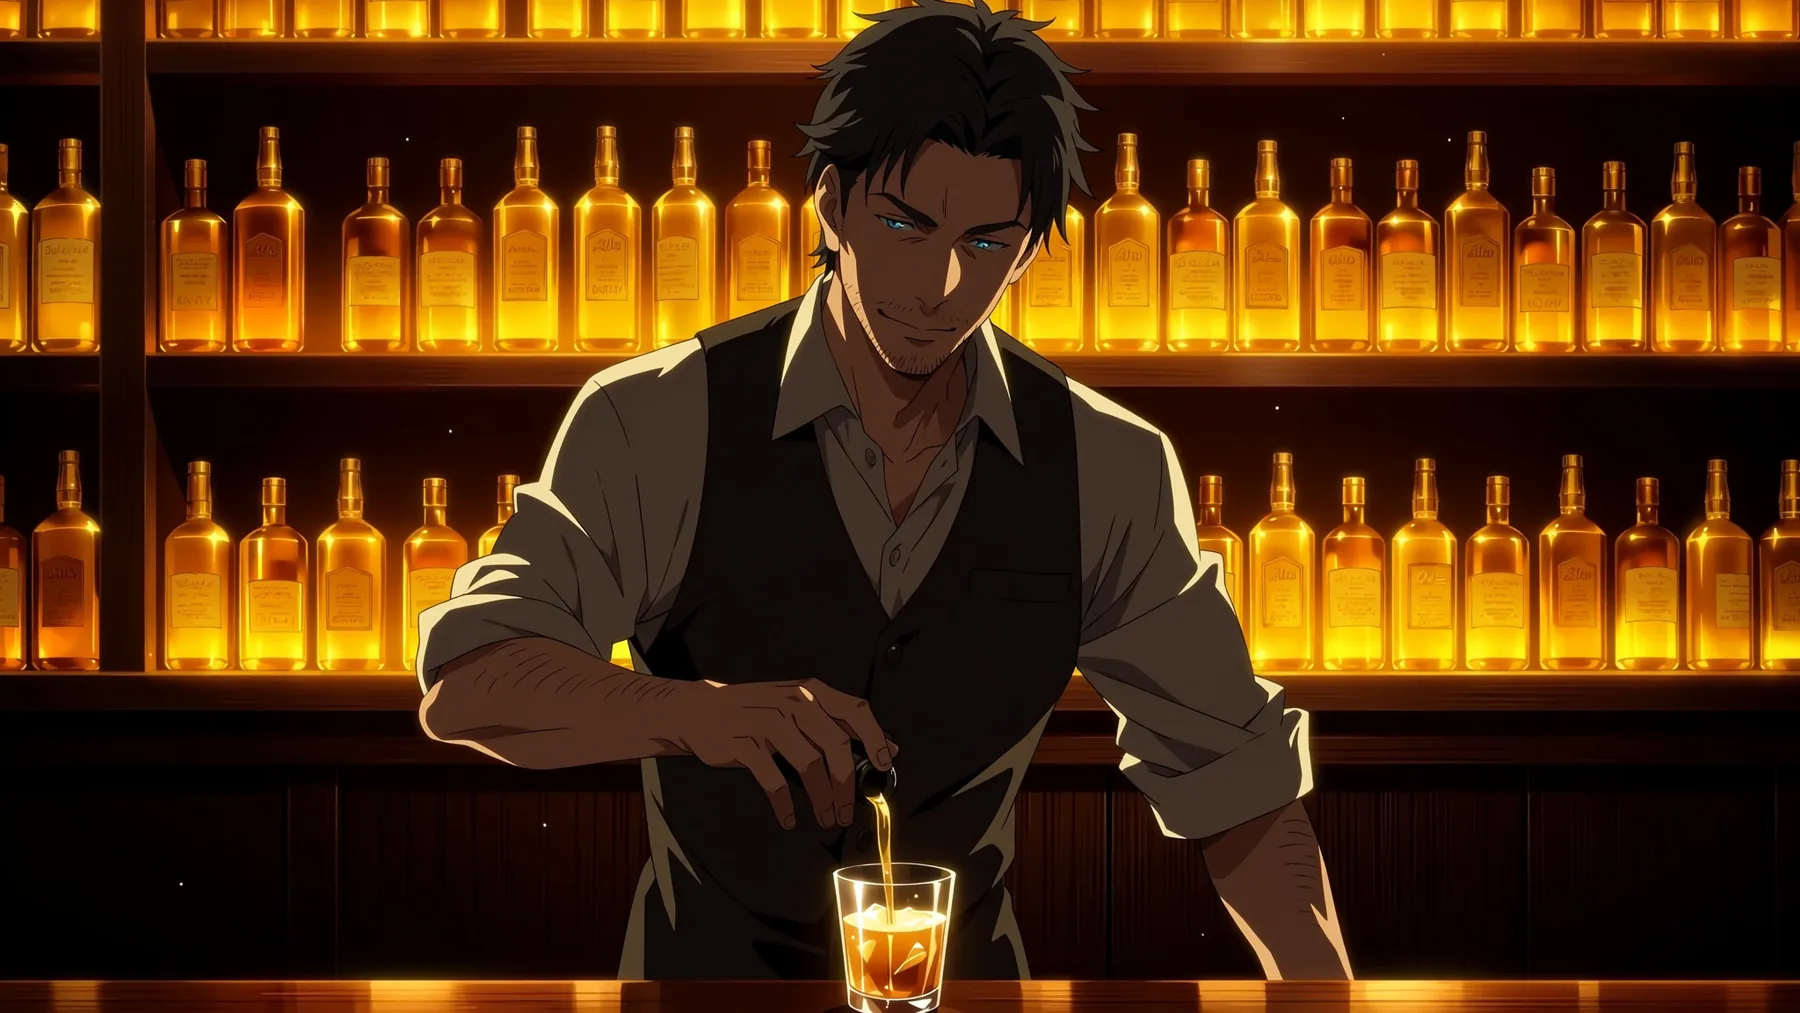
Três frases, tag de classificação safe, 16:9, nível 1.5k, seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.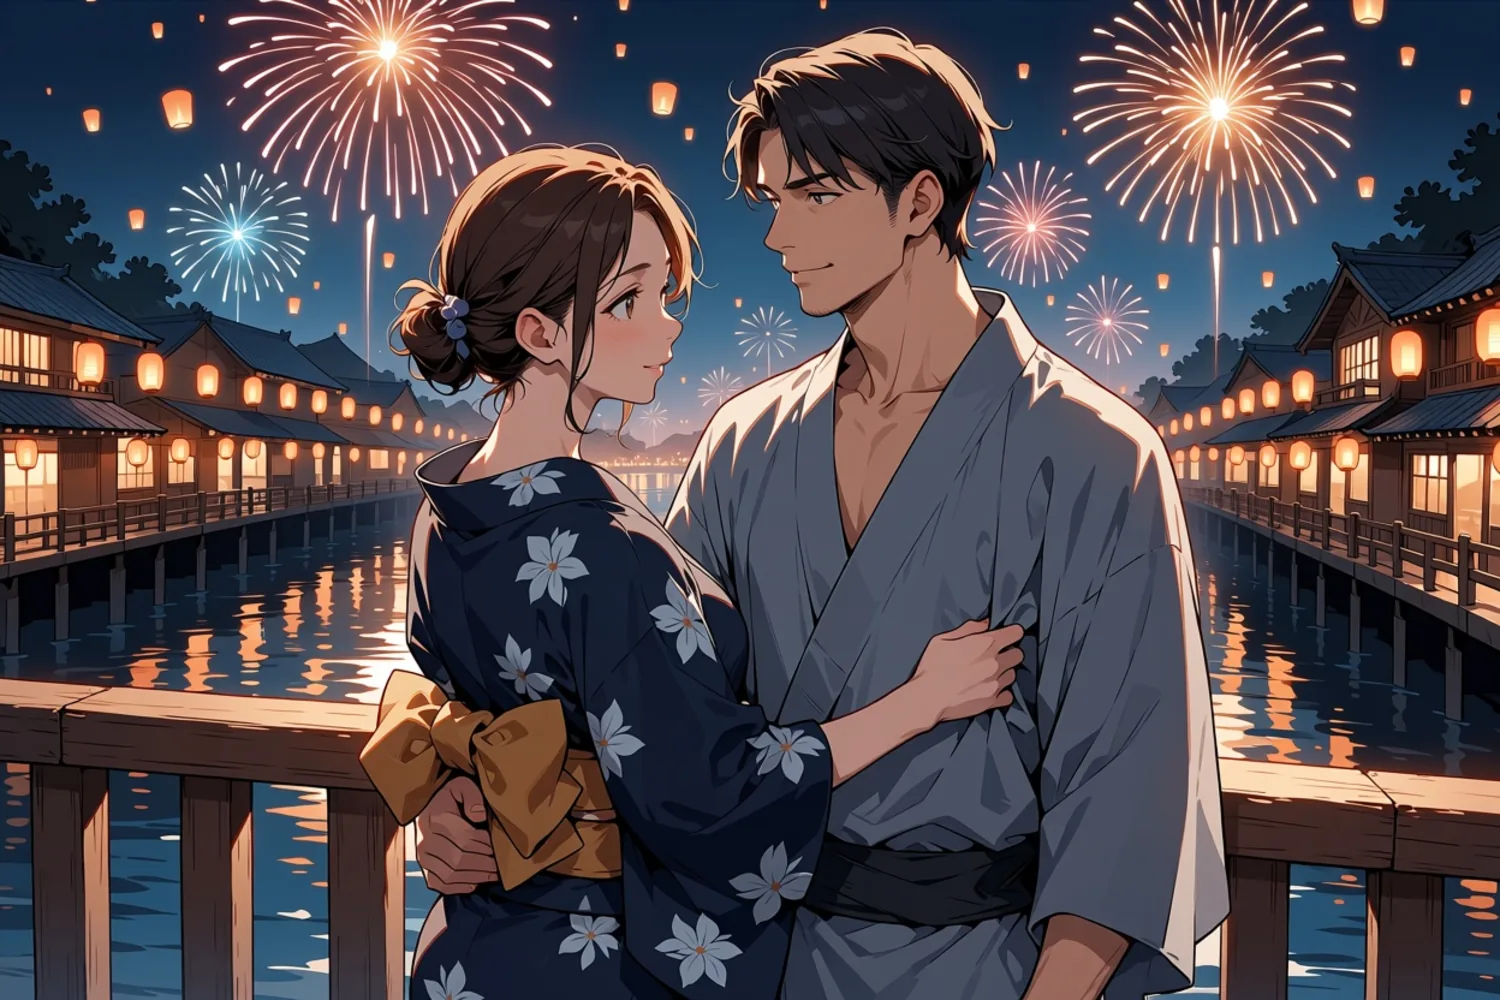
Tags com número de pessoas 1girl, 1boy, 3:2, nível 1k, seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections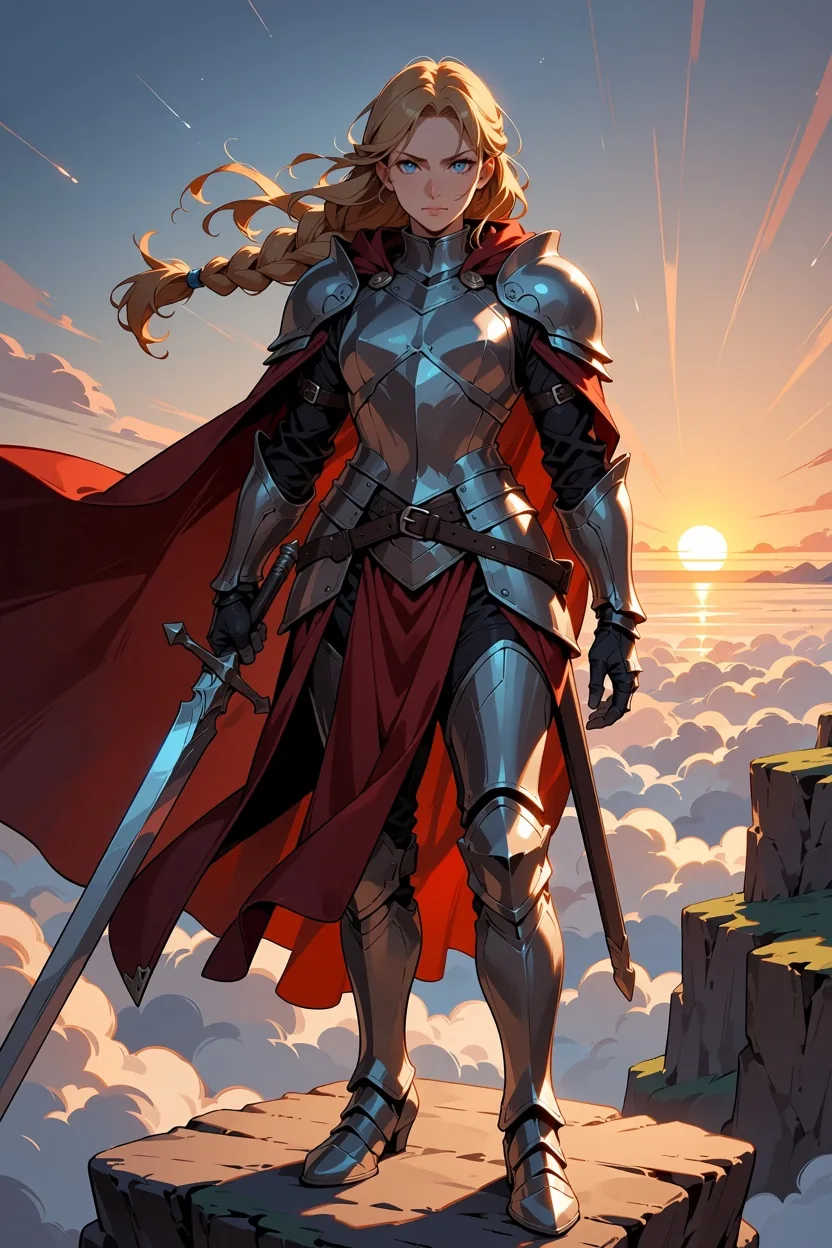
Tags, retrato 2:3, nível 1k, seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, depois das tags habituais de qualidade, classificação e número de pessoas.
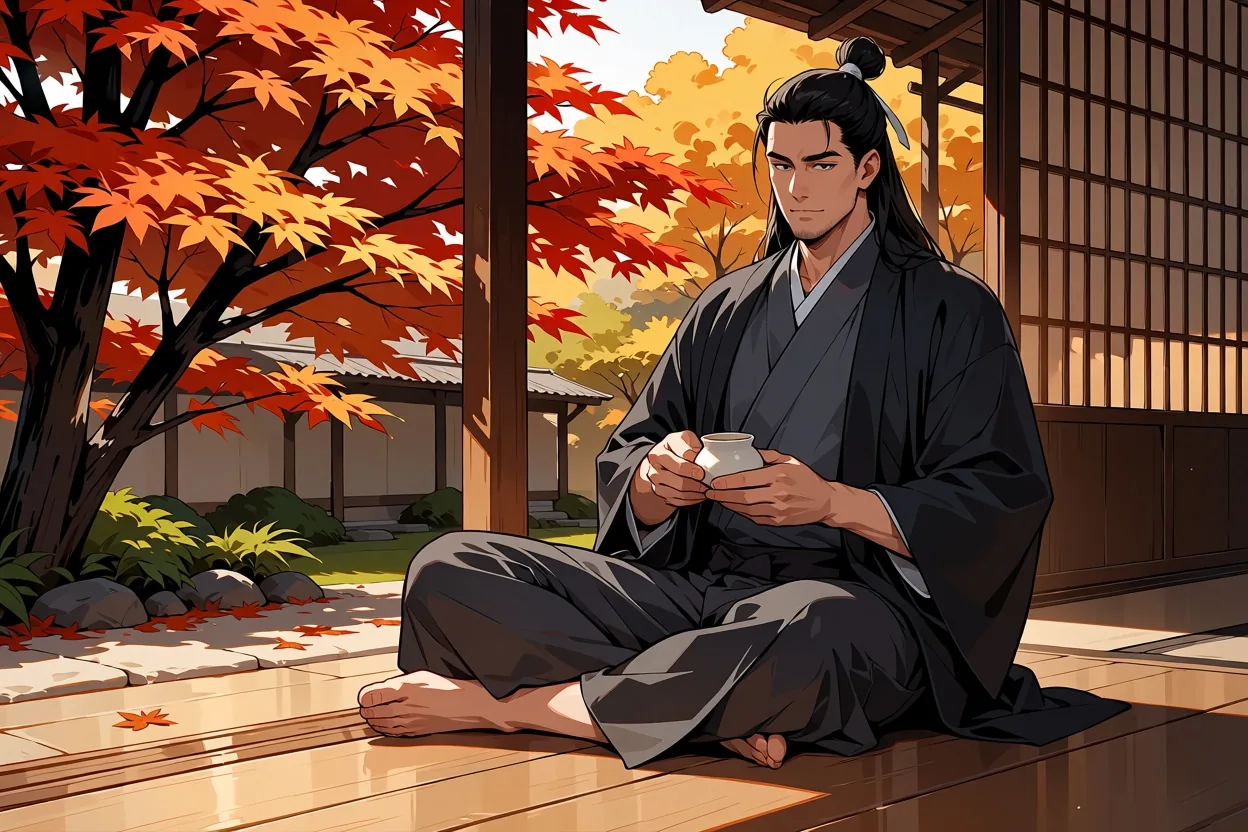
Tags, 3:2, nível 1k, seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
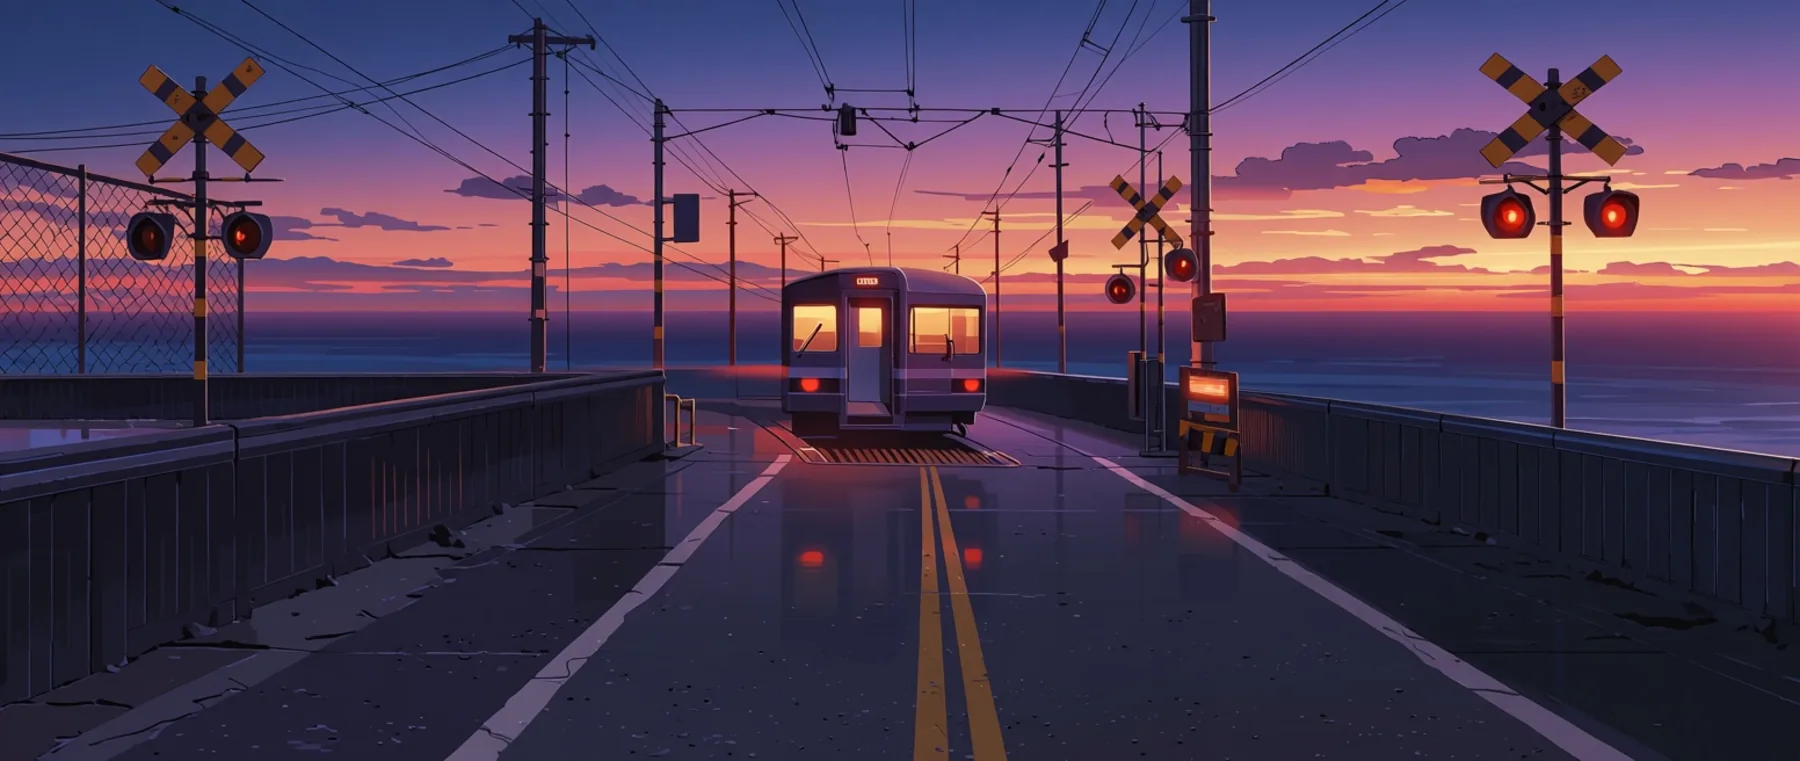
Cenário com no humans, 21:9, nível 1k (1552 x 656), seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotAs proporções incomuns também se sustentam. O 9:16, um banner alto 1:3 e um plano aberto 16:9 saíram compostos para o seu enquadramento, em vez de recortados de um quadrado:
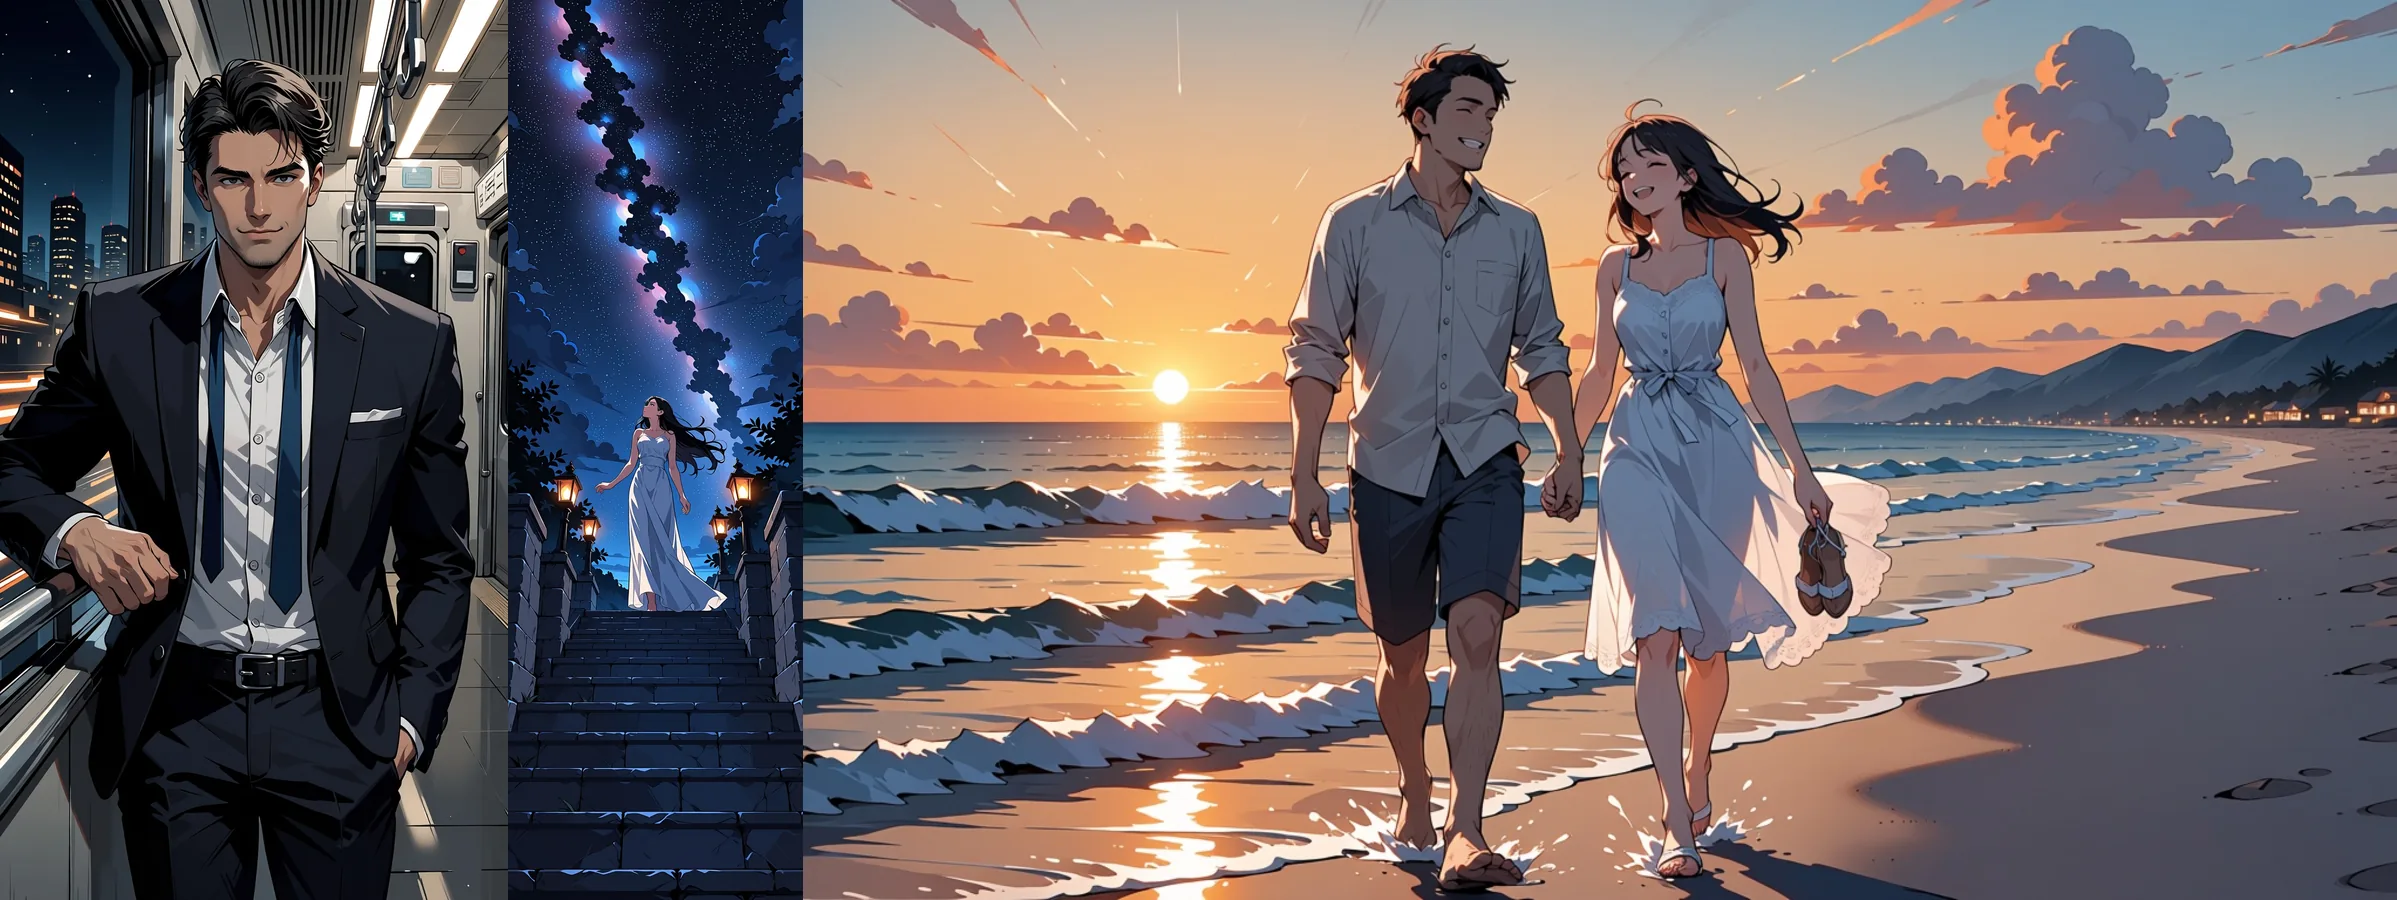
Da esquerda para a direita: 9:16, 1:3, 16:9, todas no nível 1k, todas em texto para imagem.
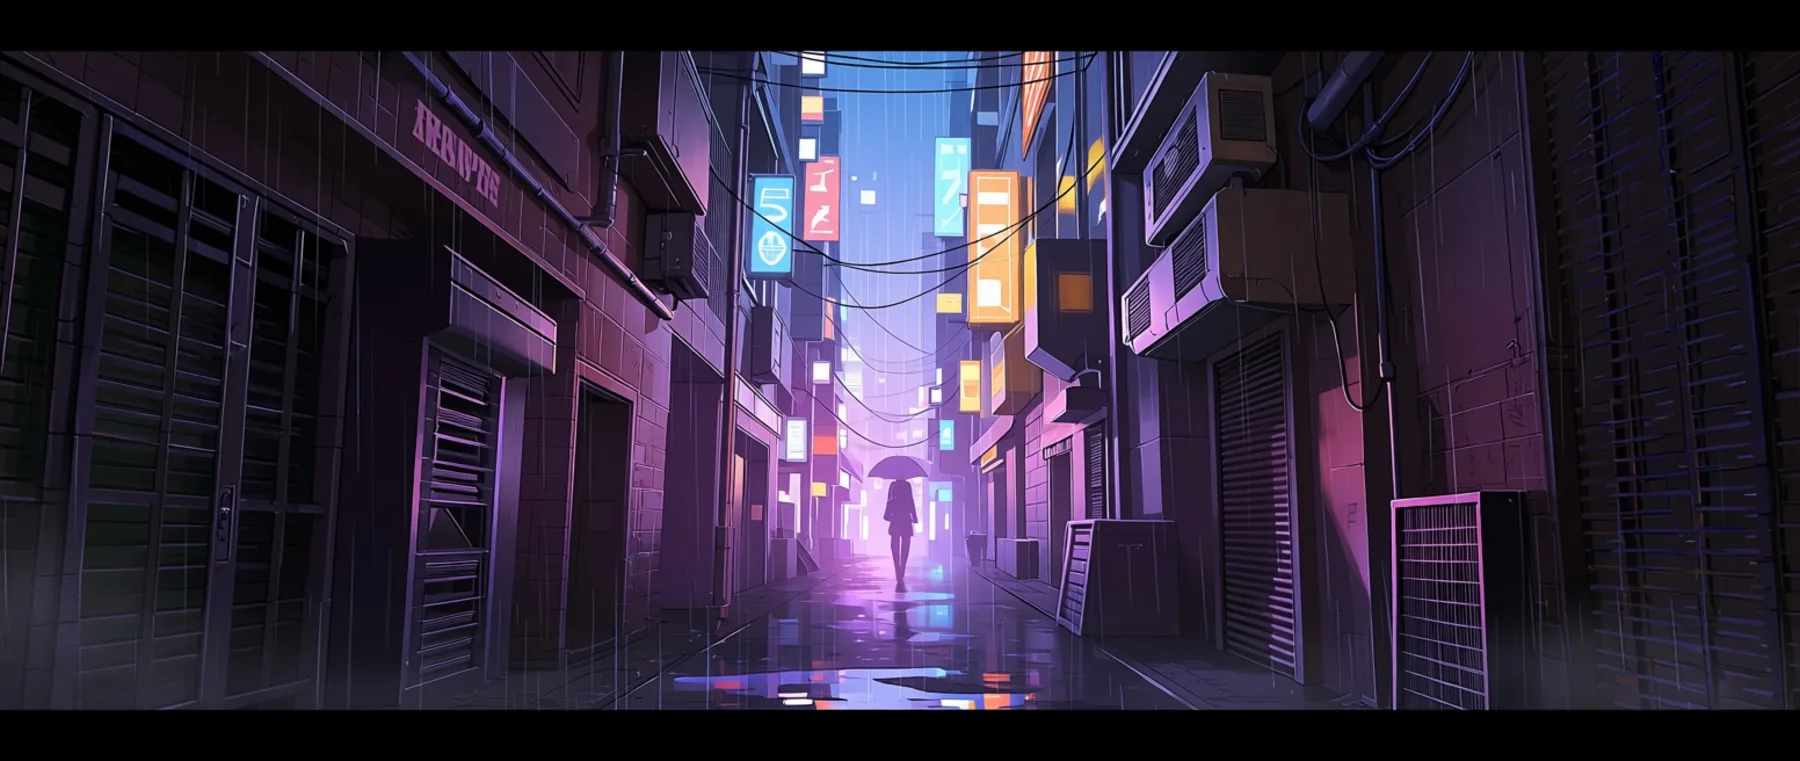
Cenário de um beco cyberpunk, 21:9, nível 1k.
Onde ele fica devendo
- Sem fotorrealismo. É um modelo de anime e ilustração. Não espere um visual fotográfico de nenhum prompt.
- Texto fraco. Ele desenha uma ou duas palavras, não uma frase, uma placa ou uma legenda.
- Sem prompt negativo, passos, CFG nem sampler. Os campos públicos são
prompt,aspect_ratio,resolutioneseed. A tag de classificação e a sua redação são os únicos freios que você tem. - Um rabisco parecido com assinatura. O modelo às vezes desenha uma assinatura ou uma linha de pseudotexto num canto, um hábito aprendido com ilustrações. Vimos isso em cerca de uma imagem em cinco. Nenhum prompt negativo consegue suprimir. Troque o seed ou corte a borda.
- O seed torna as execuções comparáveis, não idênticas. A mesma requisição com o mesmo seed nos deu três renderizações ligeiramente diferentes em momentos diferentes. Use o seed para comparar duas mudanças de prompt, não para prometer a um cliente um refazer idêntico, pixel por pixel.
- Uma imagem por requisição, só JPEG, sem máscaras. Não existe campo de inpainting.
Para quem serve
Use o Anima Turbo se você quer rascunhos rápidos de anime e ilustração com preço por imagem, se gosta de escrever prompts de tags ou quer misturar tags com algumas frases, ou se precisa de saída sem filtro de um modelo pequeno. É um bom modelo para explorar personagens e cenas em 1k e depois promover os escolhidos para 1.5k.
Procure outra opção se precisa de realismo fotográfico ou de texto legível dentro da imagem.
Qual família do Anima usar
A SpicyAPI tem duas famílias do Anima. Elas compartilham o mesmo modelo base, então a escolha depende de você precisar ou não de um visual personalizado:
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| Nomes do modelo na API | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Campo extra | Nenhum | loras: até 3 entradas, cada uma com um path e um scale de 0 a 4 |
| Melhor para | Rascunhos rápidos, prompts de tags e frases, o visual base | Um estilo de arte, personagem ou visual de época específico, vindo de um LoRA do Anima |
| Controle de estilo | Tags de estilo no prompt | Tags de estilo mais LoRAs |
| Preço | Por imagem, conforme o nível de resolução | Mesma estrutura; carregar LoRAs não gera cobrança à parte |
Comece pelo Anima Turbo. Passe para a família LoRA quando uma tag de estilo não bastar, por exemplo quando uma tag de aquarela ou de lápis só mexeu na superfície no nosso teste.
Dois próximos passos naturais:
- Estilos personalizados. A família Anima Turbo LoRA carrega até três LoRAs por requisição, então você pode acrescentar um visual específico, inclusive LoRAs adultos da comunidade. Nosso guia complementar trata disso: guia de estilos do Anima Turbo LoRA.
- Reestilizar fotos. O endpoint de imagem para imagem recebe uma imagem de origem e uma
strengthde 0 a 1. Veja de foto para anime com o Anima Turbo para saber o que cada valor faz.
Perguntas frequentes
O Anima Turbo aceita prompts negativos?
Não. Os campos públicos são prompt, aspect_ratio, resolution e seed, sem prompt negativo, passos, CFG nem sampler. Coloque no prompt o que você quer e use a tag de classificação (safe, sensitive ou nsfw) para definir o tom.
Qual resolução devo usar?
Faça o rascunho em 1k e rode de novo em 1.5k as imagens de que gostou. O nível 1k tem cerca de um megapixel e o 1.5k cerca de 2,4 megapixels, gerados de forma nativa. Nos nossos testes, o mesmo prompt e seed deram um rosto diferente em 1.5k; por isso, trate-o como uma nova versão com mais detalhe, não como uma ampliação.
Por que há uma assinatura ou um texto estranho no canto?
O modelo aprendeu o hábito com as ilustrações. Vimos um rabisco parecido com uma assinatura, ou uma linha de pseudotexto, em cerca de uma imagem em cinco. Aqui, um prompt negativo não consegue removê-lo; por isso, troque o seed ou corte a borda.
Um seed fixo dá a mesma imagem sempre?
Não de forma confiável. A mesma requisição com o mesmo seed nos deu três renderizações ligeiramente diferentes em momentos diferentes. Use o seed para comparar duas mudanças de prompt, não para prometer um refazer idêntico, pixel por pixel.
Posso usar LoRAs de SDXL ou Pony com o Anima?
Não, use LoRAs treinados para o Anima, ou seja, a família Anima Turbo LoRA. Nos nossos testes, um LoRA treinado para outro modelo base (um do FLUX) carregou sem erro e não mudou nada. O endpoint base do Anima Turbo não aceita LoRAs.
O Anima consegue editar uma imagem em vez de redesenhá-la?
Ele reestiliza, não edita. O endpoint de imagem para imagem recebe uma imagem de origem e uma strength de 0 a 1 e, nos nossos testes, pedir a uma ilustração existente uma roupa nova ou a passagem do dia para a noite mudou muito pouco. Não há campo de máscara nem de inpainting.
Ele escreve texto dentro da imagem?
Só uma ou duas palavras. Frases, placas e legendas não são o forte deste modelo; por isso, acrescente o texto depois, num editor.
Ele faz fotorrealismo?
Não. É um modelo de anime e ilustração, e nenhum prompt nos deu um visual fotográfico.