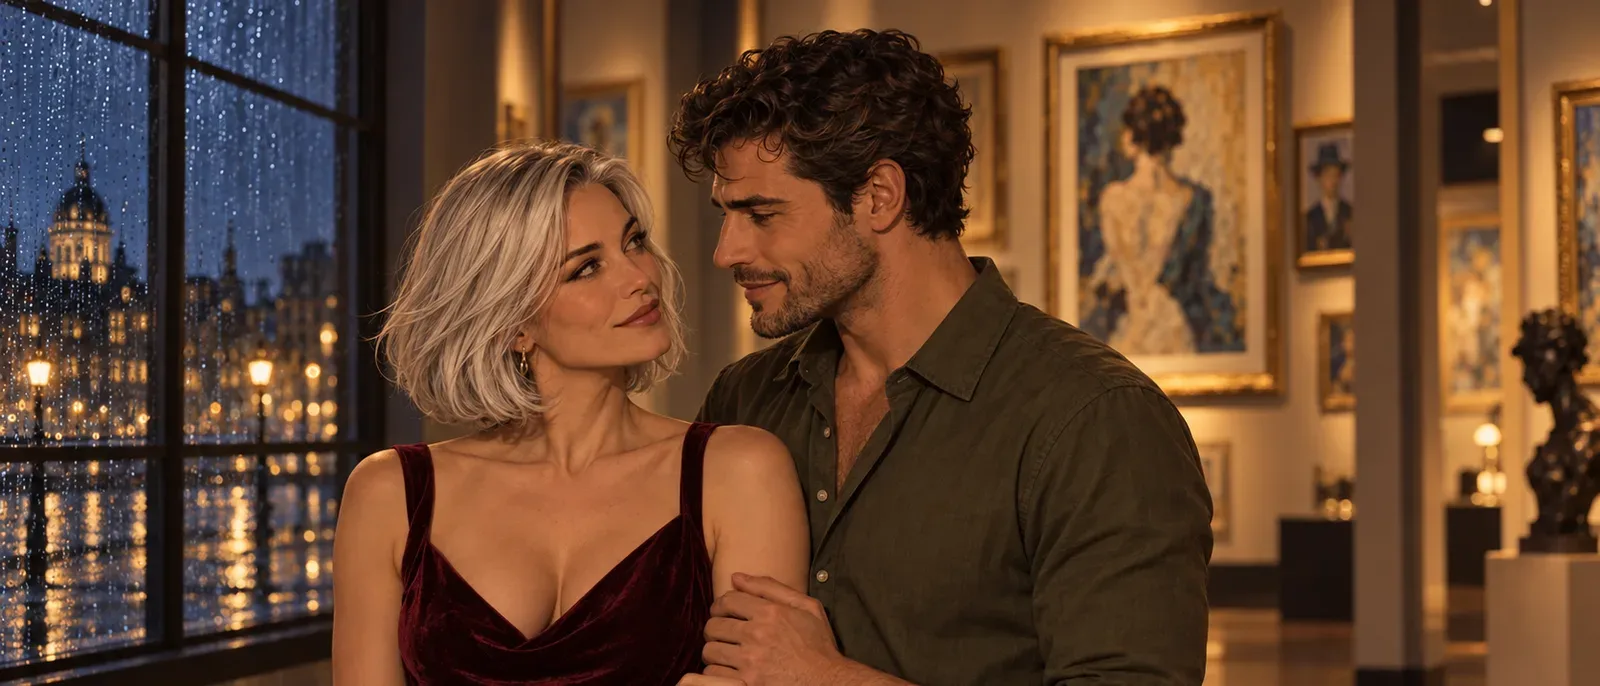
Anima Turbo は、小型で高速なアニメ・イラスト向けモデルです。整ったタグのプロンプトが得意で、普通の文章も読み取れます。 今回のテストでは、ほとんどの画像が 10 秒未満で完成し、スタイルタグにもはっきり反応しました。しかも規制はなく、当社で最も強いレベルのテストも 1 回目から書いたとおりに生成されました。一方で制限もはっきりしています。フォトリアルは描けず、読める文字は 1、2 語だけで、ネガティブプロンプトもありません。
Anima Turbo は、CircleStone Labs の Anima を蒸留したビルドで、NVIDIA Cosmos-Predict2 をベースに Qwen3 のテキストエンコーダーを組み合わせた 20 億パラメーターのモデルです。テストは 2026 年 10 月 5 日に、Anima Turbo のテキストから画像エンドポイントで行いました。以下のプロンプトはすべて、服を着た成人が登場する日常の場面です。
概要
| Anima Turbo (2026 年 10 月 5 日にテスト) | |
|---|---|
| 提供元とベース | CircleStone Labs と Comfy Org。NVIDIA Cosmos-Predict2 (2B) をベースにした 2B パラメーター、テキストエンコーダーは Qwen3 |
| API のモデル名 | circlestone-labs/anima-turbo/text-to-image と circlestone-labs/anima-turbo/edit |
| 公開フィールド (テキストから画像) | prompt (最大 5,000 文字)、aspect_ratio、resolution、seed |
| アスペクト比 | 15 種類。1:1 と 16:9 から 21:9 と 1:3 まで |
| 解像度の段階 | 1k (約 100 万画素。例: 16:9 で 1360 x 768) と 1.5k (約 240 万画素。例: 2048 x 1152、ネイティブ生成) |
| テストでの速度 | 60 回の実行で 1 枚あたり 2 〜 16 秒。60 回中 52 回が 10 秒未満 |
| 出力 | 1 リクエストにつき JPEG 1 枚 |
| コンテンツポリシー | 規制なし、コンテンツフィルターなし。当社で最も強いレベルのテストも 1 回目から書いたとおりに生成 |
| できないこと | フォトリアル、1、2 語を超える文字、ネガティブプロンプト、ステップ数、CFG、サンプラー、マスク |
Anima Turbo とは
Anima は、Comfy Org と共同で開発された CircleStone Labs のモデルです。NVIDIA の Cosmos-Predict2 (2B) をベースに、テキストエンコーダーに Qwen3 を使った 20 億パラメーターのモデルです。提供元は Base、Aesthetic、Turbo の 3 つのビルドを公開しています。Turbo は蒸留版で、8 から 12 のサンプリングステップで動くよう作られています。提供元によると、平均では Anima-Aesthetic よりわずかに劣るだけで大幅に高速なため、まず Turbo から試すことを勧めています。同じく提供元によると、学習データは数百万枚のアニメ画像と約 80 万枚のアニメ以外の芸術的な画像で、合成データは含まれていません。モデルカードは huggingface.co/circlestone-labs/Anima にあります。
SpicyAPI では、このモデルを circlestone-labs/anima-turbo/text-to-image として公開しています。プラットフォーム側ではコンテンツフィルターを追加していないので、結果はモデルとプロンプトだけで決まります。解像度ごとの現在の 1 枚あたりの料金は、ファミリーページで確認できます。
タグでも文章でも使える。ただし見た目は変わる
Anima は Danbooru のタグ規則に従います。提供元の推奨は次のとおりで、今回もこれに従いました。小文字で書き、アンダースコアの代わりにスペースを使い、並び順は固定します。まず品質タグとレーティングタグ、次に人数 (1girl、1boy、no humans)、その次にキャラクター・作品・作家、最後にそれ以外のすべてです。無難な書き出しは masterpiece, best quality で、必要に応じて score_7 を加えます。
自然な文章も使えます。提供元は 2 文以上を推奨していて、その理由はテストでも確認できました。ごく短いプロンプトはぶれやすいのです。同じ雨の日のカフェの場面を同じ seed で 2 回生成しました。1 回はタグ、もう 1 回は 4 文の文章です。
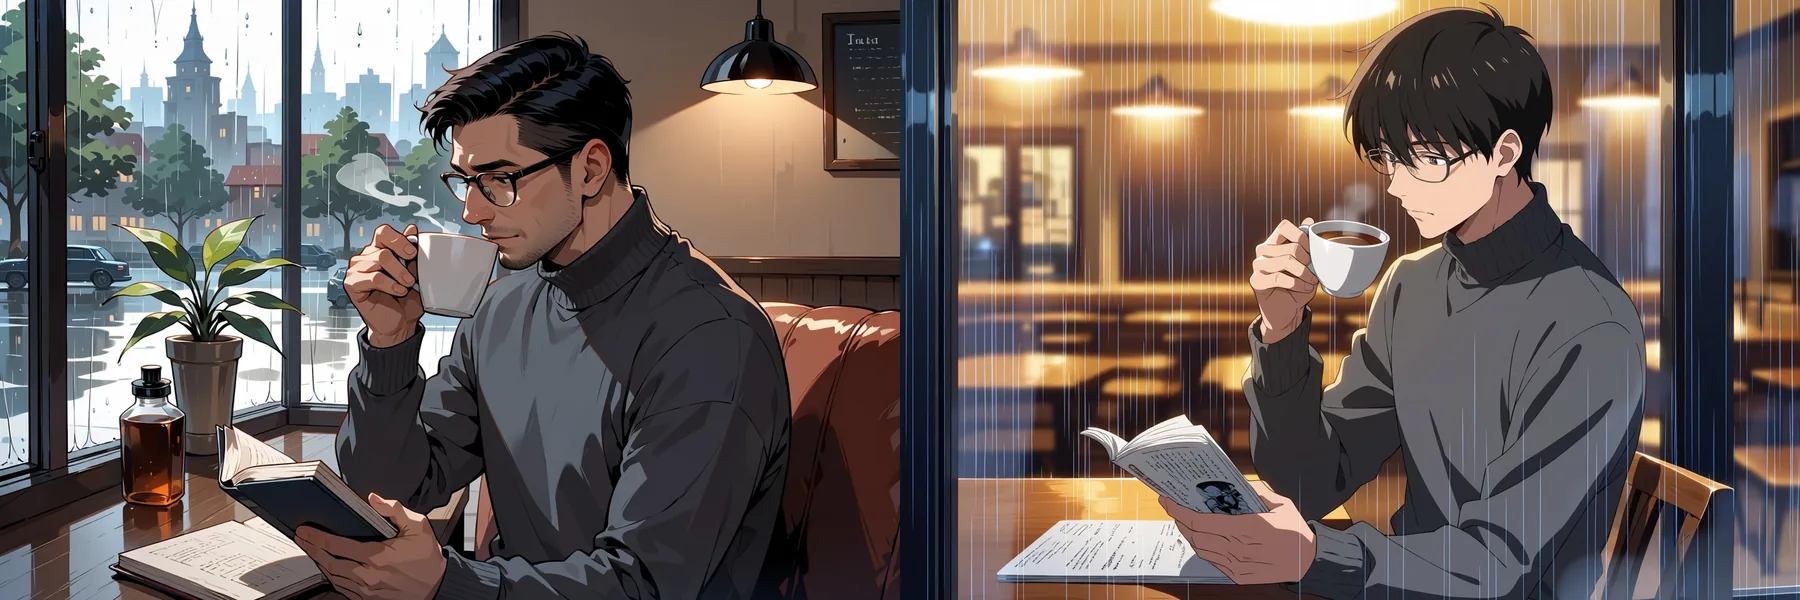
左: タグ。右: 4 文の文章。seed は同じ (4)、3:2、1k、テキストから画像。
タグ版:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozy文章版:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.どちらも眼鏡、タートルネック、カップ、本は描かれました。違いが出たのは、指定しなかった部分です。タグのプロンプトでは顔つきが大人びて、明るい窓辺の場面になりました。文章のプロンプトでは顔つきが若く、より雰囲気のある室内になりました。今回のテストでは、キャラクターを細かく制御したいならタグ、雰囲気を自然に出したいなら文章が向いていました。タグの見出しに 1、2 文の説明を足す併用も、うまく機能しました。
今回の実行と提供元の推奨にもとづく使い分けは次のとおりです。
| 状況 | 向いている書き方 | 理由 |
|---|---|---|
| 特定のキャラクターの見た目 (髪、眼鏡、服装) が必要 | タグ | タグ 1 つ 1 つが独立した指示なので、細部が保たれる |
| ムード、光、場面の「空気感」がほしい | 文章 | 文章版は、頼まなくても雰囲気のある室内になった |
| 有名な作家や既知のスタイルを呼び出す | タグ。作家名の前に @ | 提供元によると、@ のない作家スタイルは効果が弱い |
| seed やプロンプトの微調整を比べる | タグ | 短く固定したプロンプトなら、変化の原因をつかみやすい |
| 短い説明文を書く | 2 文以上 | 提供元は 2 文以上を推奨。ごく短いプロンプトはぶれやすい |
| 制御と雰囲気の両方がほしい | タグの見出し + 1、2 文 | 併用はテストでうまく機能した |
崩れにくいプロンプトの書き方
次の順序は提供元の推奨にもとづくもので、この記事のすべてのプロンプトに使いました。
- 品質タグとレーティングタグを最初に。
masterpiece, best quality、必要ならscore_7、続けてsafe、sensitive、nsfwのいずれか。ネガティブプロンプトがないので、トーンはレーティングタグで決まります。 - 次に人数。
1girl、1boy、1girl, 1boy、風景ならno humans。 - キャラクター、作品、作家。 作家には
@を前置します。 - それ以外のすべて。 髪、服装、場所、光、構図。小文字で、アンダースコアの代わりにスペースを使います。
- タグの効きが弱いときは重みを。
(chibi:2)はスタイルのテストで機能しましたが、SDXL 世代のモデルより高い重みが必要でした。1.2 で止めないでください。
プロンプトの上限は 5,000 文字で、タグのプロンプトがそこまで届くことはまずありません。今回の実行で、見た目に差が出た習慣が 3 つあります。
- レーティングタグから始める。 モデルは
safe、sensitive、nsfwと、さらに強い 1 つのタグを理解します。ネガティブプロンプトがないので、トーンを決める主な手段はレーティングタグです。そのため、この記事のプロンプトはすべてsafeで始めています。 - 登場人物が成人だと明記する。
adult woman, mature femaleや「30 代の男性」と書くと、登場人物の年齢層を狙いどおりに保てます。 - 作家名の前に
@を付ける。 提供元によると、@のない作家スタイルは効果が弱くなります。
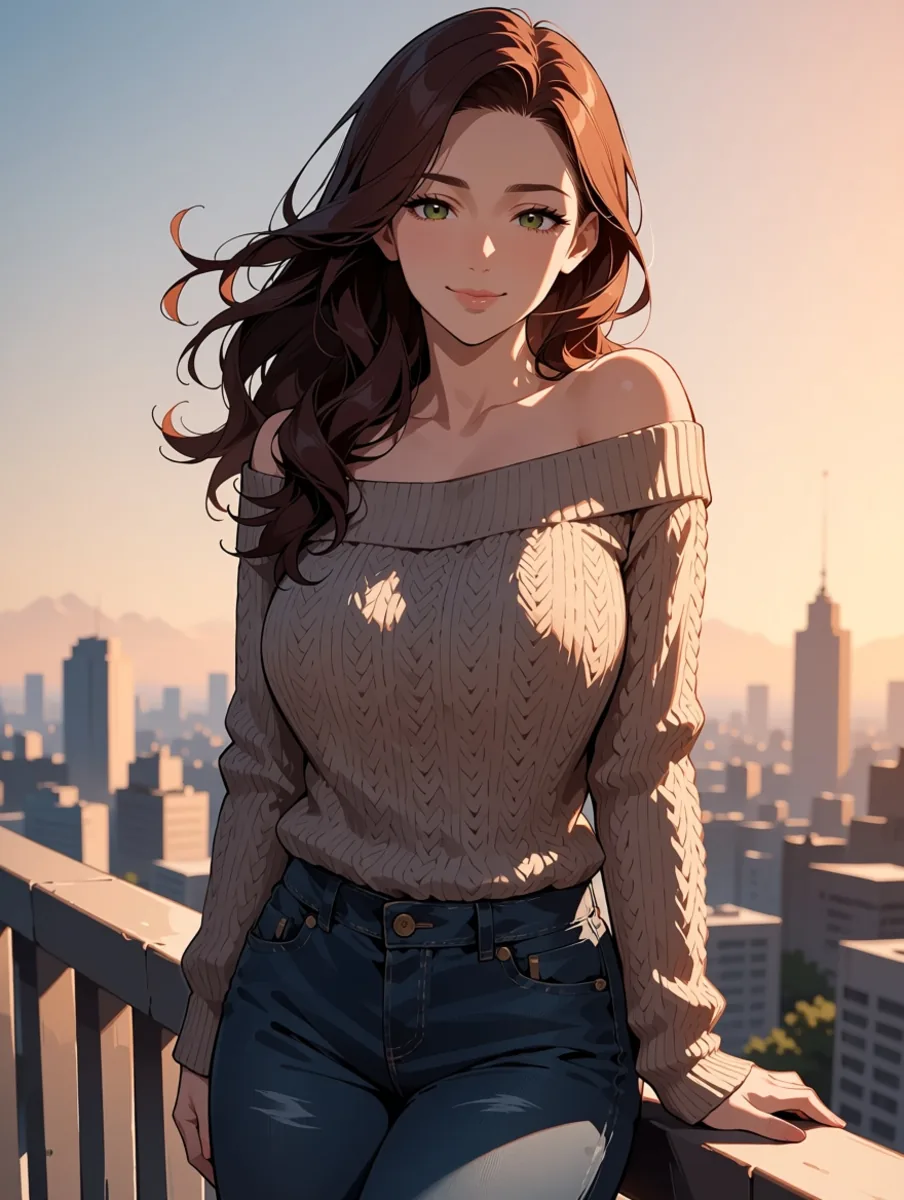
タグだけのプロンプト: レーティングタグ、人数、髪、服装、場所、光。3:4、1k、seed 3。
スタイルタグの効果
今回いちばん知りたかったテストです。キャラクター (秋の街角でトレンチコートを着た、銀色のショートヘアの成人女性) と seed (12) を固定し、スタイルタグだけを変えて、すべて 1:1・1k で生成しました。ベースのプロンプトは次のとおりです。
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile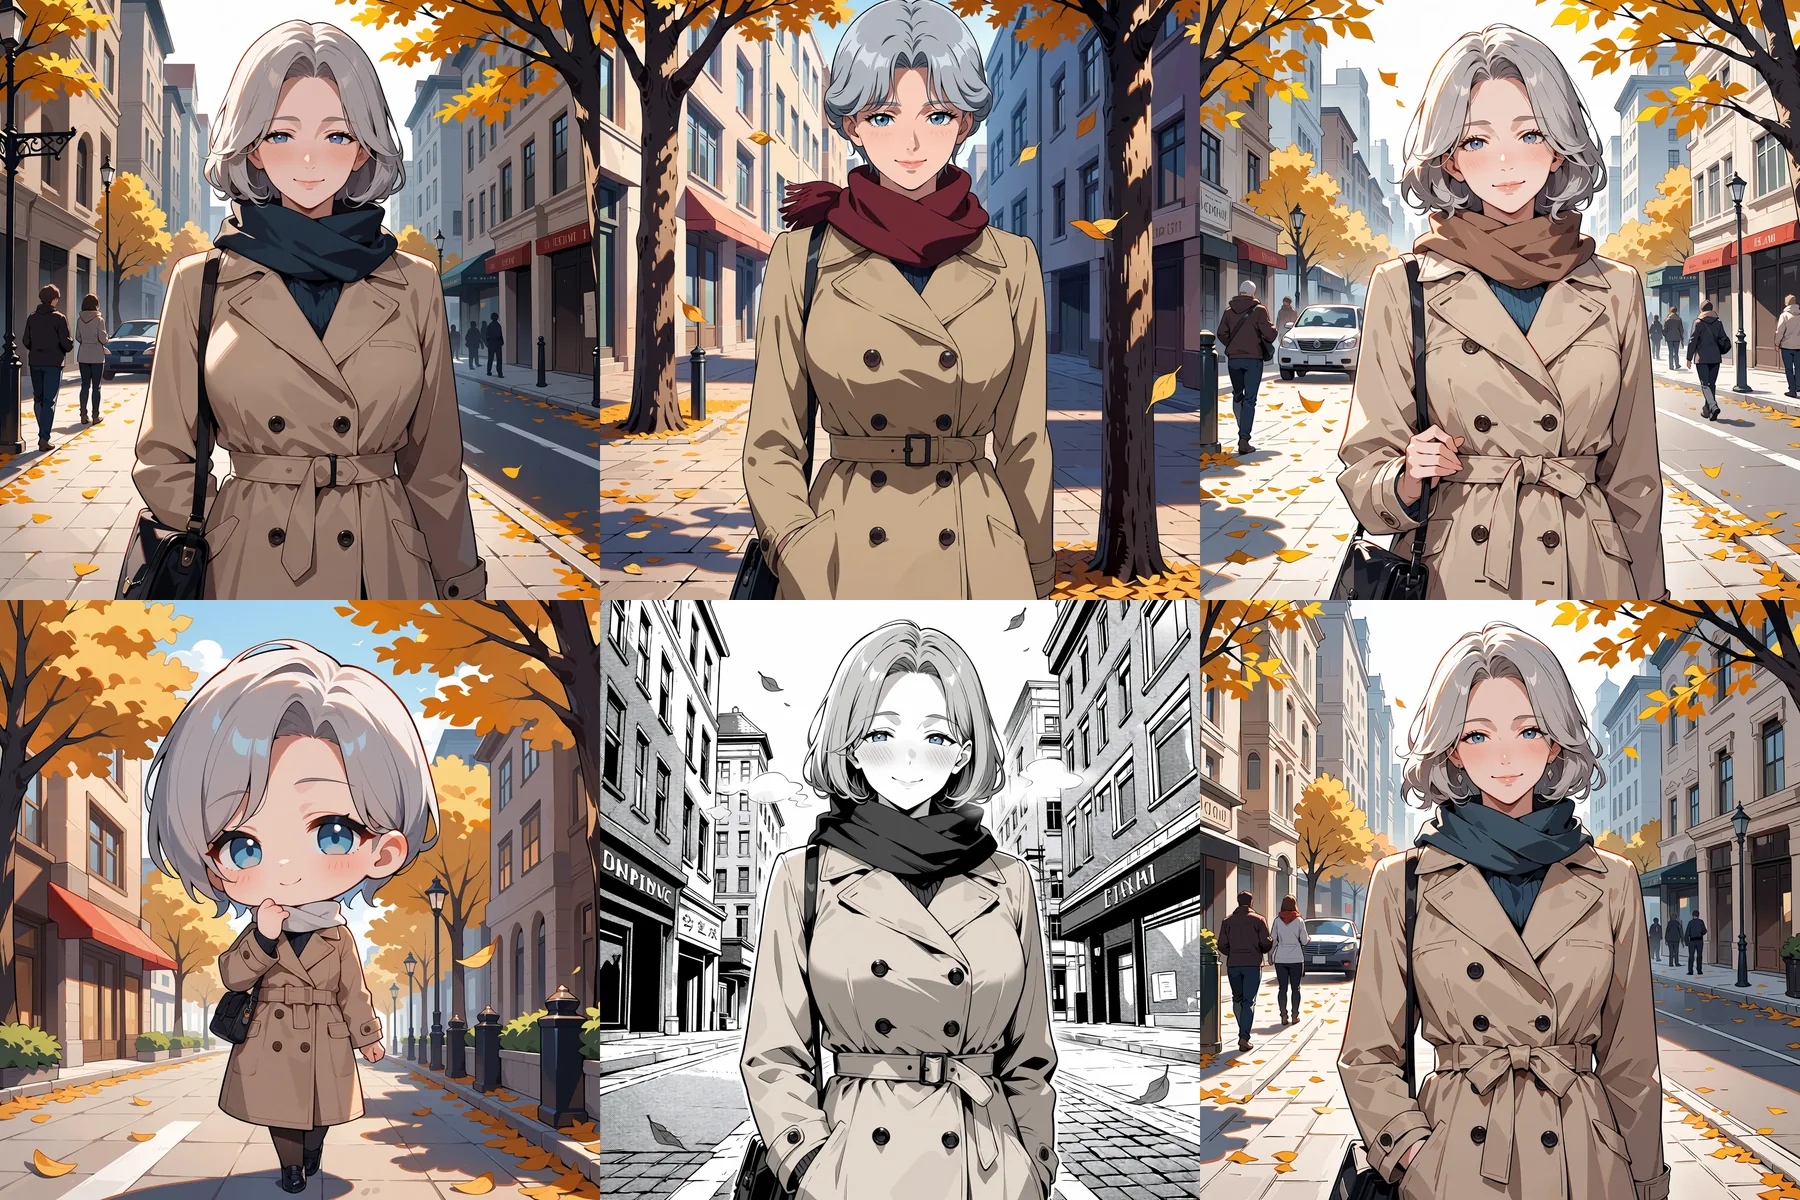
上段: スタイルタグなし、retro artstyle, 1990s (style), anime screenshot、watercolor (medium), traditional media。下段: (chibi:2)、monochrome, greyscale, manga, screentone、sketch, pencil drawing, traditional media。すべて seed 12。
結果は次のとおりです。
| 追加したスタイルタグ | テストでの結果 |
|---|---|
retro artstyle, 1990s (style), anime screenshot | はっきりした 90 年代のセル画調。色は平坦になり、影は硬くなる |
(chibi:2) | 頭が大きく体が小さい、完全なちびキャラ |
monochrome, greyscale, manga, screentone | スクリーントーン付きの、説得力のある白黒マンガのコマ |
watercolor (medium), traditional media | 描画がわずかに変わっただけ |
sketch, pencil drawing, traditional media | 描画がわずかに変わっただけ |
強く効くのは、視覚的な語彙がはっきりしているスタイルです。画面キャプチャのセルアニメ、ちびキャラの頭身、マンガのインクがそれにあたります。伝統メディア系の 2 つのタグは、表面の質感を少し動かしただけでした。本物の水彩や鉛筆の仕上がりがほしいなら、タグよりもスタイル LoRA を使うことになるでしょう。
もう 1 点。(chibi:2) のようなプロンプトの重み付けは機能しますが、SDXL 世代のモデルに慣れた感覚より高い重みが必要でした。
サイズ、解像度、速度
サイズのフィールドはありません。15 種類の aspect_ratio (1:1、16:9、9:16、4:3、3:4、3:2、2:3、21:9、9:21、2:1、1:2、3:1、1:3、5:4、4:5) と、resolution の段階 (1k または 1.5k)、任意の seed を選びます。1k は約 100 万画素、1.5k は約 240 万画素で、アップスケールではなくネイティブに生成されます。16:9 の画像は 1k で 1360 x 768、1.5k で 2048 x 1152、1:3 は 576 x 1760 と 880 x 2048 です。出力は常に JPEG で、1 リクエストにつき 1 枚です。アスペクト比で料金は変わらず、1.5k は 1k より高く、失敗したリクエストには課金されません。
すべてのアスペクト比を両方の段階で網羅した 60 回の実行で時間を計測しました。モデルの処理時間は 1 枚あたり 2 秒から 16 秒で、60 回のうち 52 回が 10 秒未満でした。
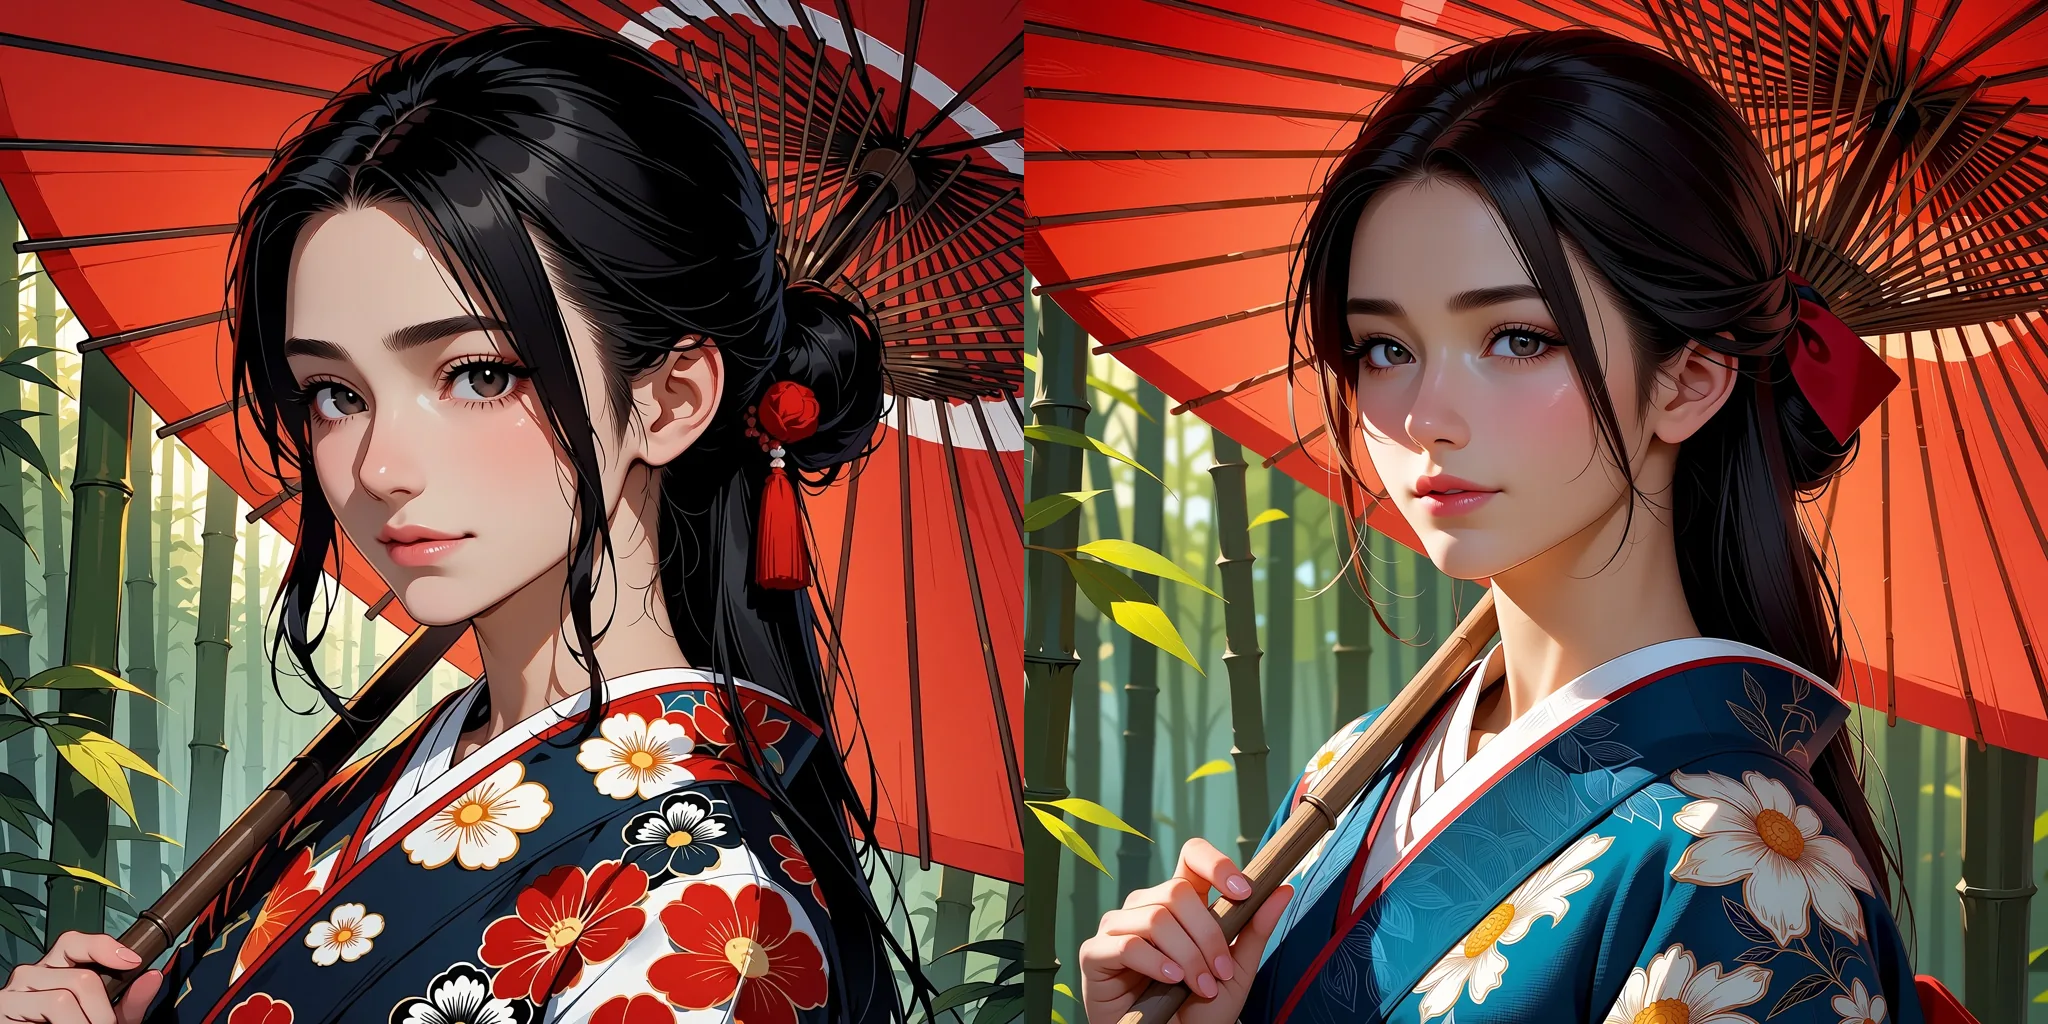
左: 1k (1024 x 1024)。右: 1.5k (1536 x 1536)。同じプロンプト、seed 8、1:1。
2 つの段階は、画素をそのまま拡大した関係ではありません。同じプロンプトと seed でも、顔も着物の柄も別のものになりました。1.5k で得られるのは、布地の細部のより細かな描き込みと、すっきりした線画です。1k で下書きを作り、気に入ったものだけを 1.5k で再実行しましょう。その結果は、鮮明になったコピーではなく、新しい 1 枚として扱ってください。
どこまで描けるか
このエンドポイントは規制なしで、プラットフォームもコンテンツフィルターを追加していません。テストでは、モデル自体も控えめにはなりませんでした。当社で最も強いレベルのテストは、テキストから画像でも画像から画像でも、LoRA の有無にかかわらず、seed を変えて繰り返しても、1 回目から書いたとおりに生成されました。そのプロンプトは掲載しません。以下の例はすべて日常の場面です。
普通の場面でのこのモデルの強みは、表現の幅です。1 種類のプロンプトの書き方で、ポートレート、カップル、夜勤のバーテンダー、人のいない風景まで描き分けられました。
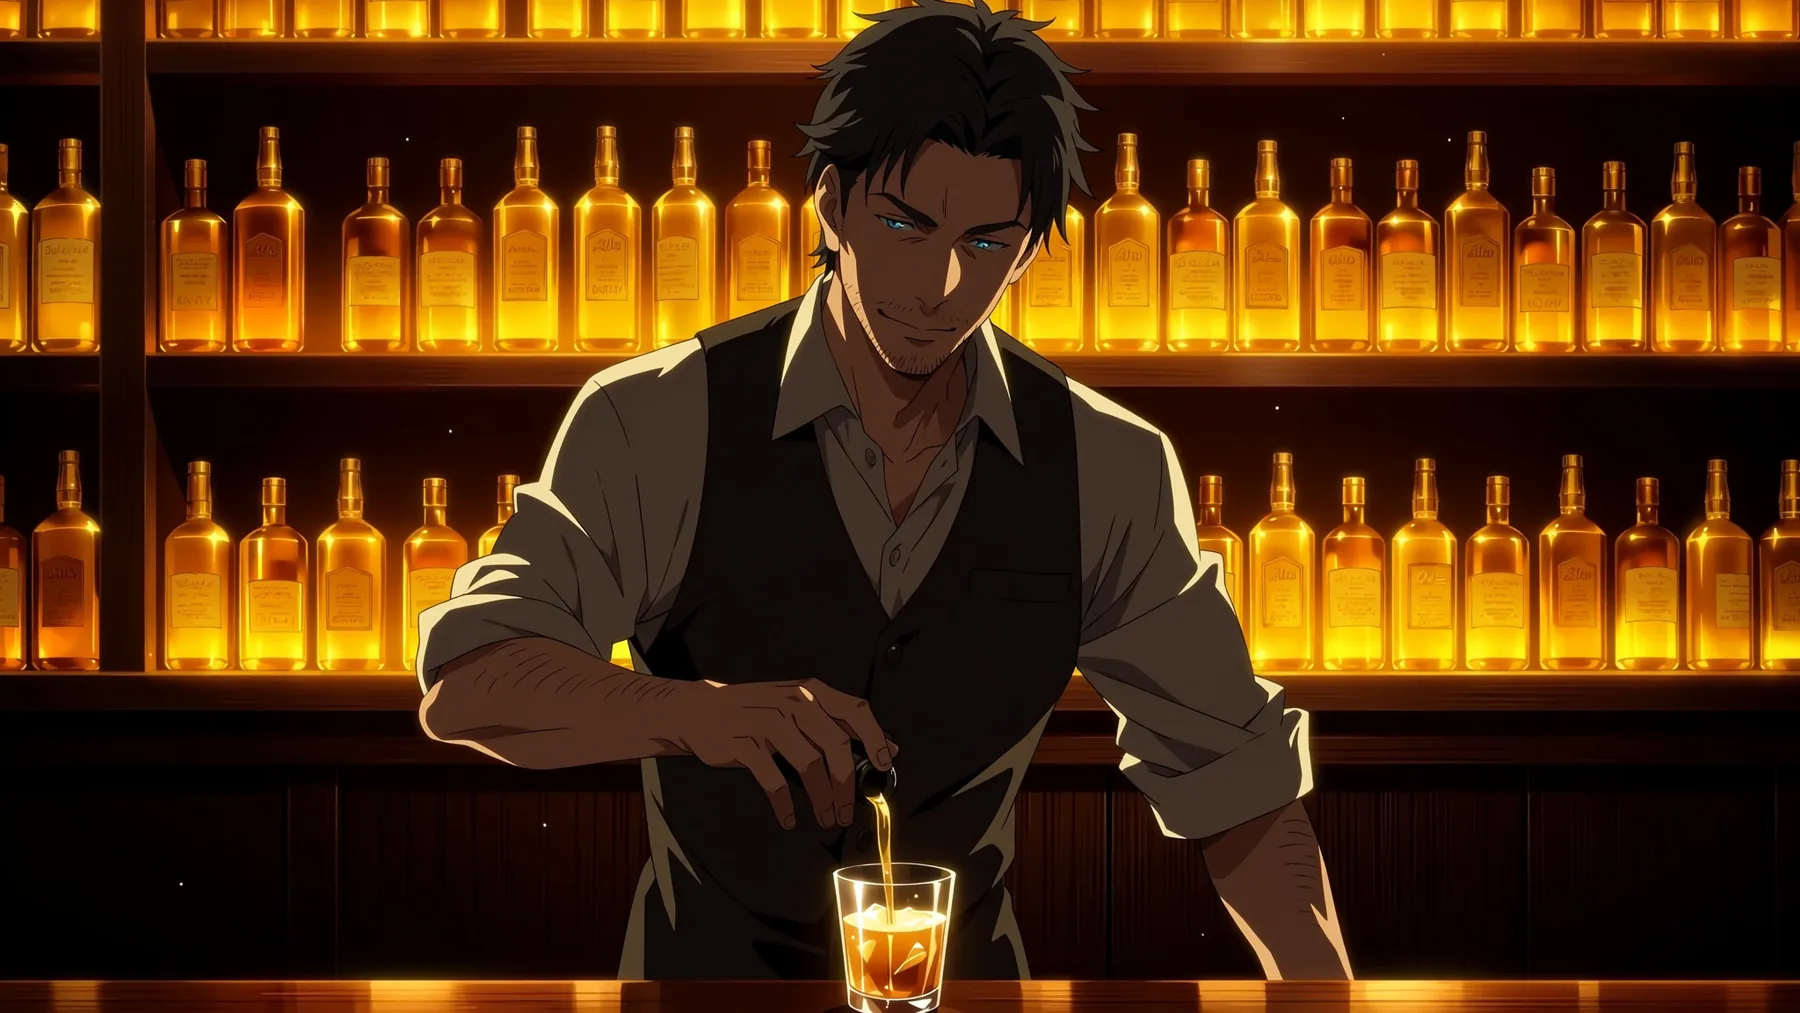
3 文、レーティングタグ safe、16:9、1.5k、seed 7。
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.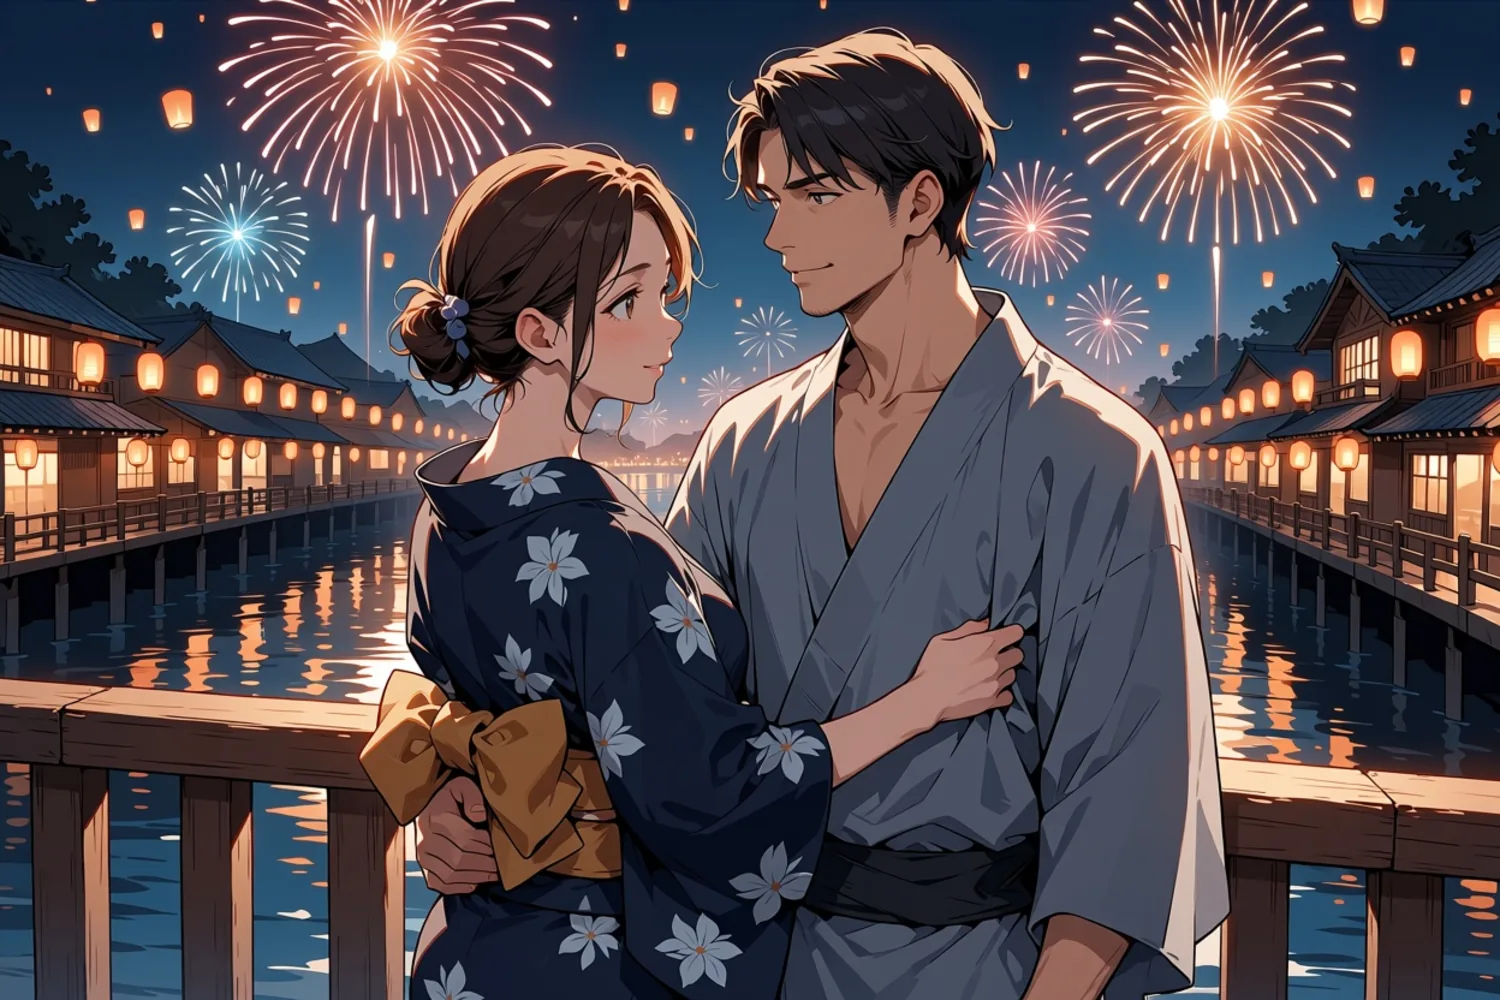
人数タグ 1girl, 1boy を使ったタグ指定、3:2、1k、seed 11。
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections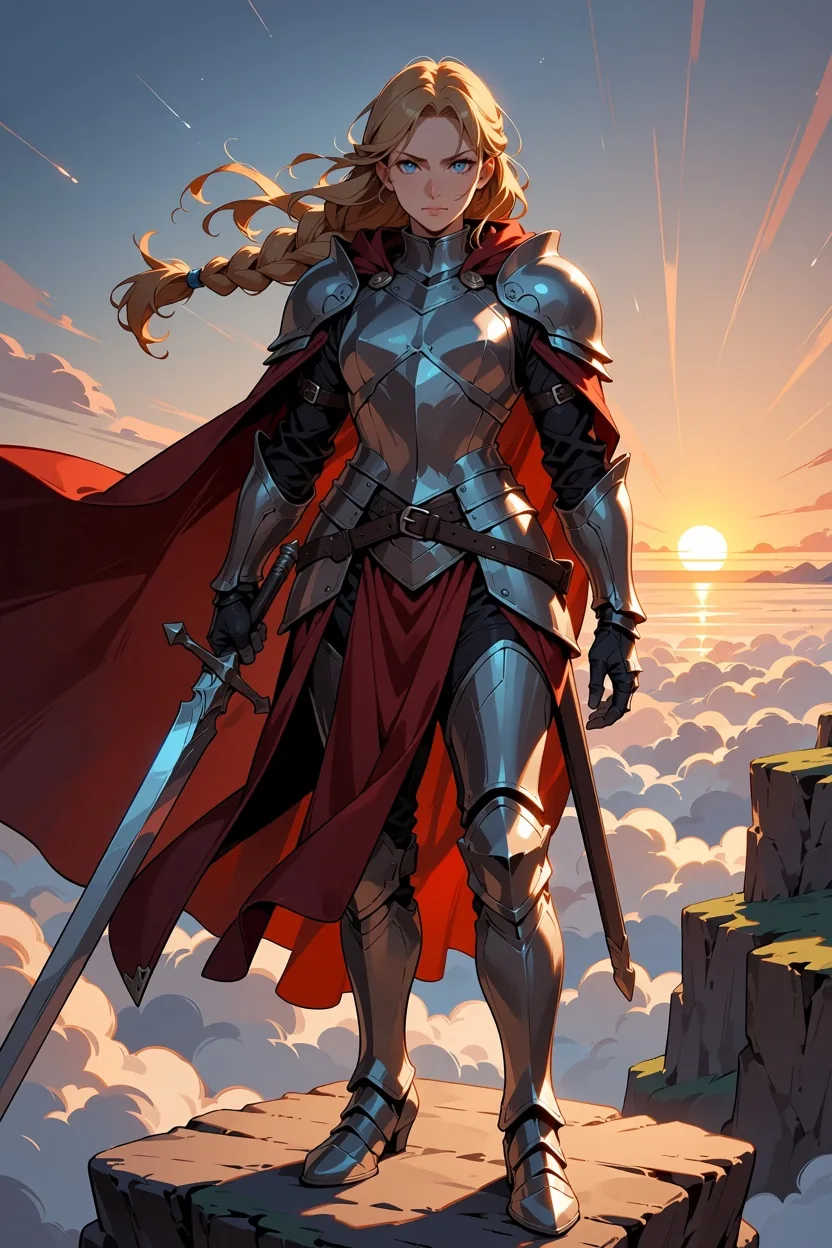
タグ指定、2:3 の縦長、1k、seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy。このあとに、いつもの品質、レーティング、人数のタグを置きました。
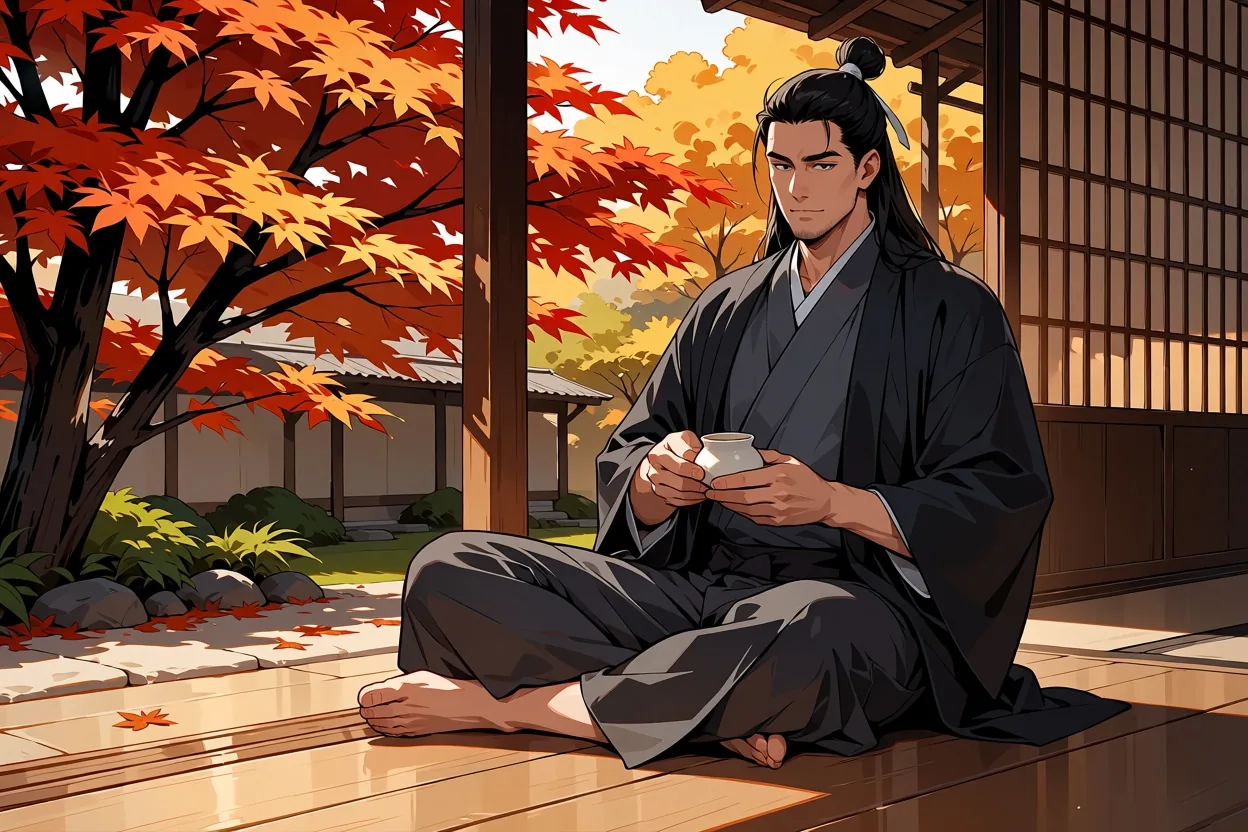
タグ指定、3:2、1k、seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light。
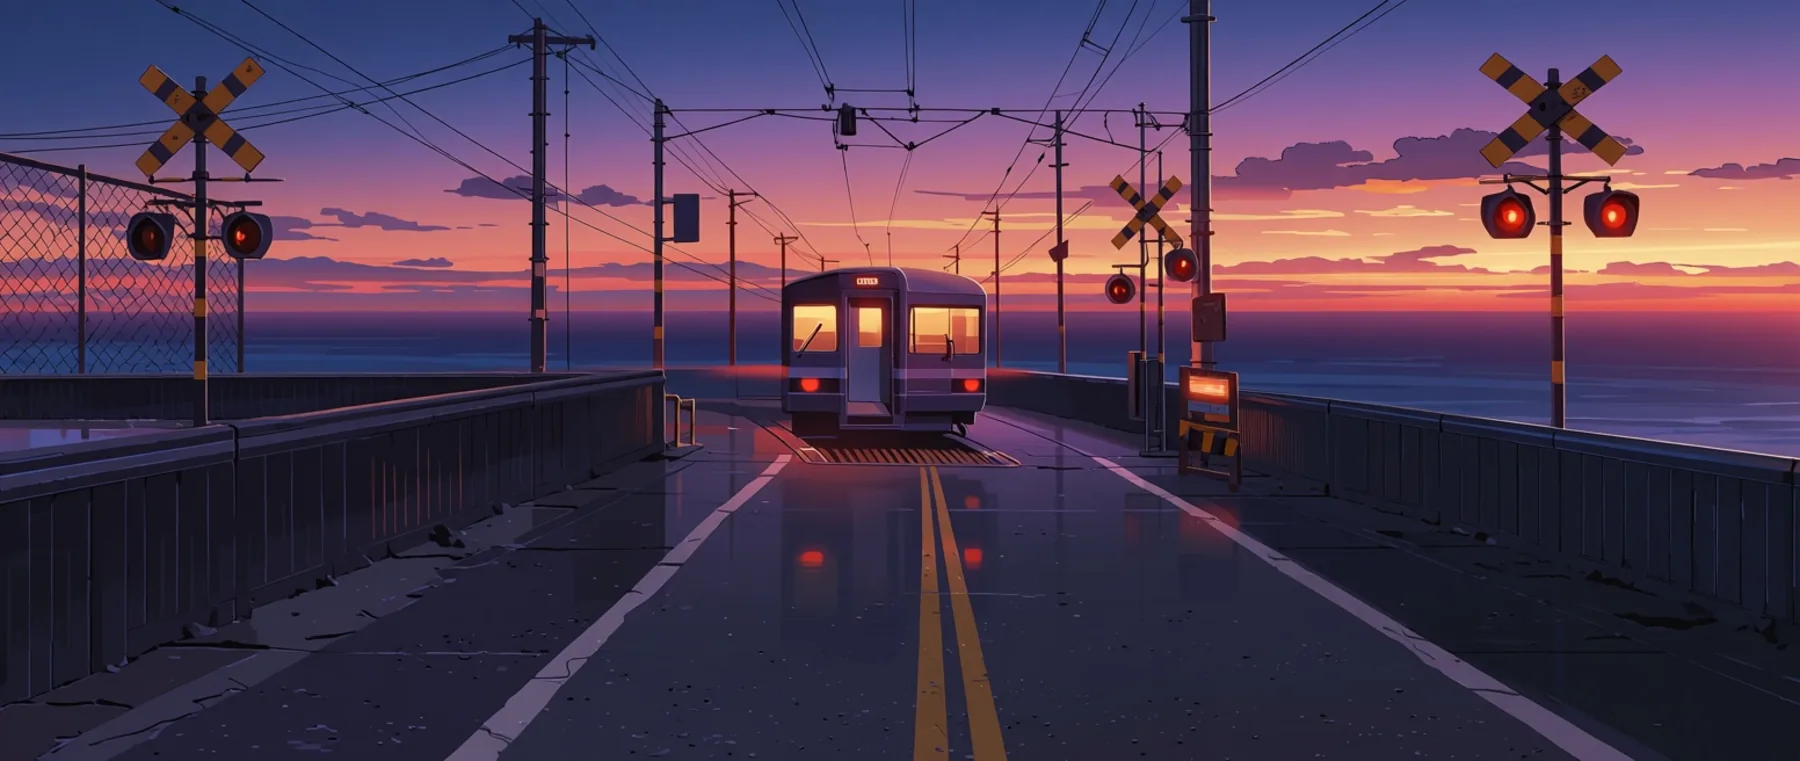
no humans の風景、21:9、1k (1552 x 656)、seed 5。
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shot変わった比率でも崩れません。9:16、縦長の 1:3 のバナー、16:9 のワイドショットは、正方形から切り出したのではなく、それぞれの画面に合わせた構図で仕上がりました。
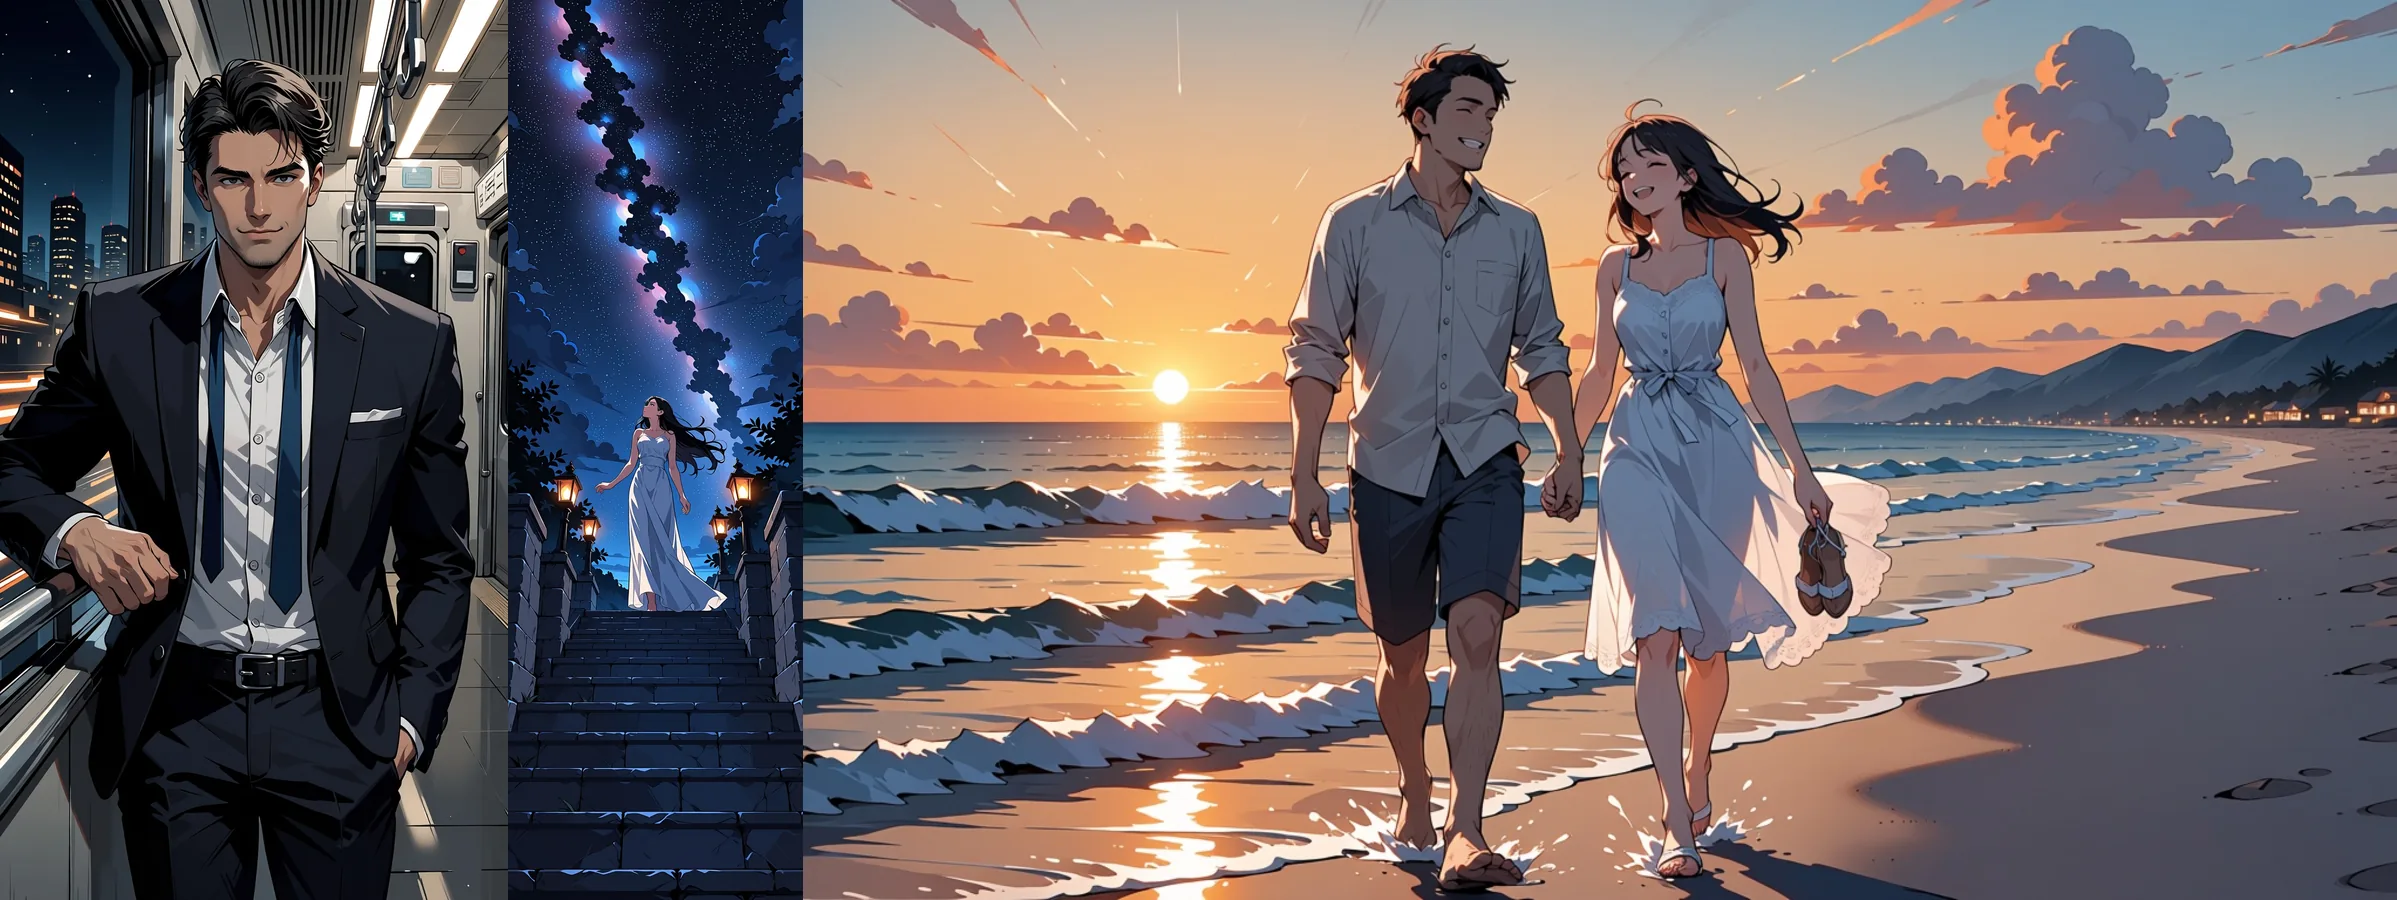
左から 9:16、1:3、16:9。すべて 1k、すべてテキストから画像。
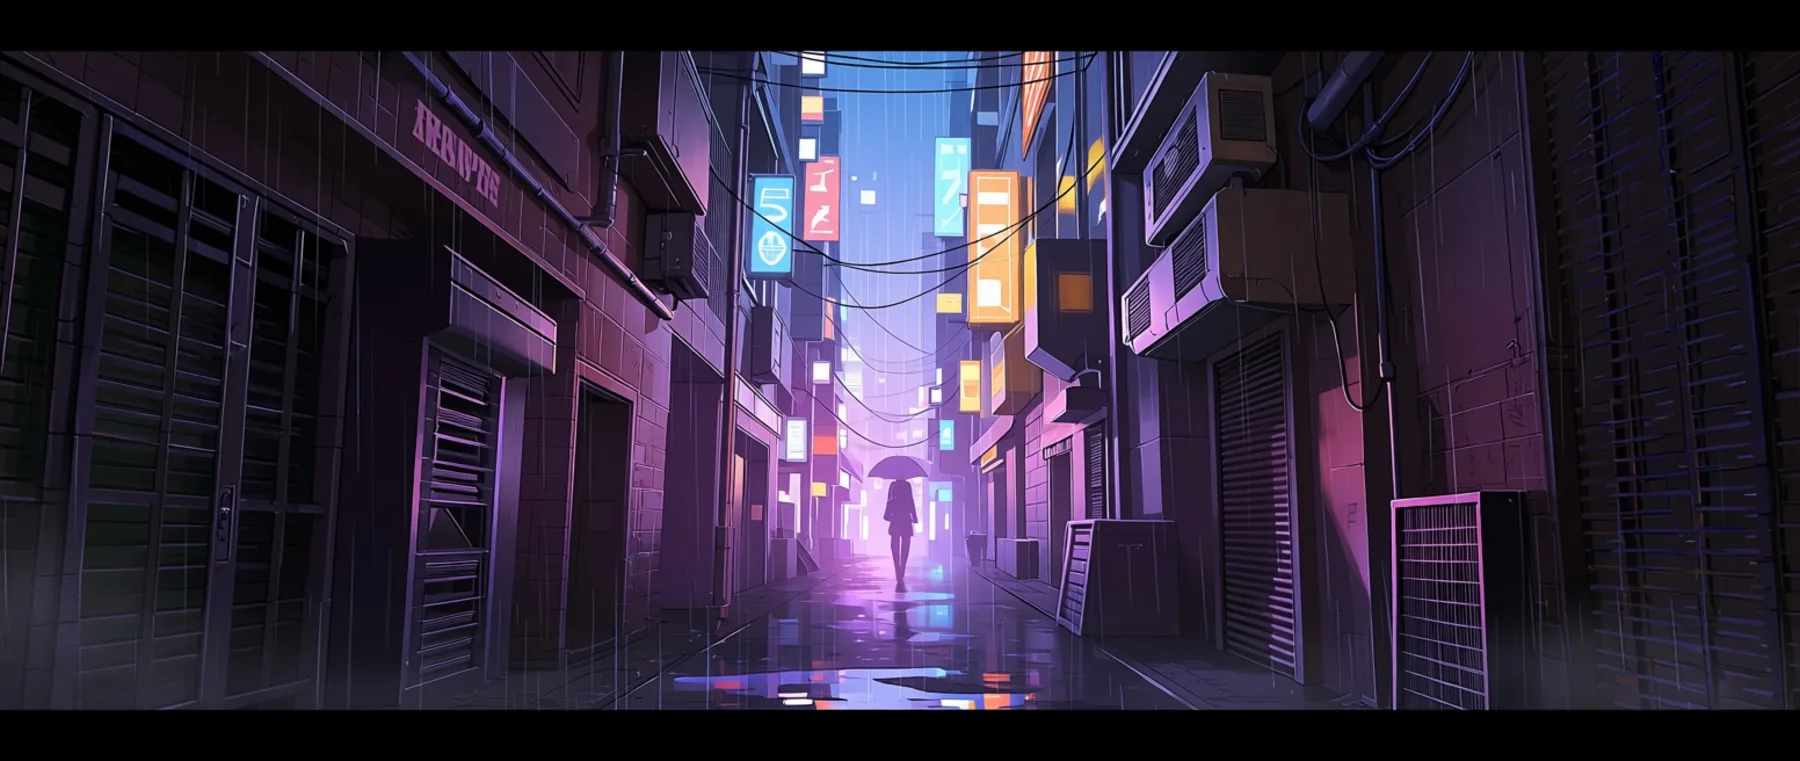
サイバーパンクの路地の風景、21:9、1k。
苦手なこと
- フォトリアルは不可。 アニメ・イラスト向けのモデルです。どんなプロンプトでも写真のような質感は期待しないでください。
- 文字は弱い。 描けるのは 1、2 語までで、文、看板、キャプションは描けません。
- ネガティブプロンプト、ステップ数、CFG、サンプラーはありません。 公開しているフィールドは
prompt、aspect_ratio、resolution、seedです。ブレーキになるのは、レーティングタグと書き方だけです。 - 署名のような走り書き。 作品から身についた癖で、隅に署名や疑似文字の 1 行を描くことがあります。5 枚に 1 枚ほどの頻度で見られました。ネガティブプロンプトでは抑えられません。seed を変えるか、端を切り取ってください。
- seed で比較はできても、同一にはなりません。 同じリクエストと seed でも、時間をおくと少しずつ違う仕上がりが 3 回得られました。seed は 2 つのプロンプト変更を比べるために使い、クライアントにピクセル単位で同じやり直しを約束する目的には使わないでください。
- 1 リクエストにつき画像は 1 枚、形式は JPEG のみ、マスクなし。 インペイント用のフィールドはありません。
向いている人
Anima Turbo が向いているのは、1 枚あたりの料金で、高速にアニメやイラストの下書きを作りたい人です。タグでプロンプトを書くのが好きな人、タグに 2、3 文を混ぜて使いたい人、小型のモデルでフィルターなしの出力が必要な人にも合います。1k でキャラクターや場面を探り、気に入ったものを 1.5k に上げる使い方に適したモデルです。
写真のようなリアルさや、絵の中の読める文字が必要なら、ほかのモデルを探してください。
どの Anima ファミリーを使うか
SpicyAPI には Anima のファミリーが 2 つあります。ベースモデルは同じなので、選ぶ基準は、オリジナルの絵柄が必要かどうかです。
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| API のモデル名 | circlestone-labs/anima-turbo/text-to-image、.../edit | circlestone-labs/anima-turbo-lora/text-to-image、.../edit |
| 追加フィールド | なし | loras: 最大 3 件。それぞれ path と、0 〜 4 の scale を指定 |
| 向いている用途 | 高速な下書き、タグと文章のプロンプト、ベースの絵柄 | Anima 向け LoRA による、特定の画風、キャラクター、時代の見た目 |
| スタイルの制御 | プロンプトのスタイルタグ | スタイルタグと LoRA |
| 料金 | 解像度の段階ごとに 1 枚単位 | 同じ構造。LoRA の読み込みに別料金なし |
まず Anima Turbo から始めてください。スタイルタグでは足りなくなったら LoRA ファミリーに移りましょう。たとえば今回のテストでは、水彩や鉛筆のタグが表面をわずかに動かしただけでした。
次の自然なステップは 2 つあります。
- オリジナルのスタイル。 Anima Turbo LoRA ファミリーは、1 リクエストに最大 3 つの LoRA を読み込めます。コミュニティ製の成人向け LoRA を含め、特定の画風を加えられます。詳しくは姉妹ガイドの Anima Turbo LoRA スタイルガイドをご覧ください。
- 写真のスタイル変換。 画像から画像のエンドポイントは、元画像 1 枚と 0 から 1 の
strengthを受け取ります。strength ごとの違いは Anima Turbo で写真をアニメにで解説しています。
FAQ
Anima Turbo はネガティブプロンプトに対応していますか?
いいえ。公開フィールドは prompt、aspect_ratio、resolution、seed で、ネガティブプロンプト、ステップ数、CFG、サンプラーはありません。ほしいものはプロンプトに書き、トーンはレーティングタグ (safe、sensitive、nsfw) で決めてください。
どの解像度を使えばよいですか?
1k で下書きし、気に入った画像を 1.5k で再実行します。1k は約 100 万画素、1.5k は約 240 万画素で、ネイティブに生成されます。今回のテストでは、同じプロンプトと seed でも 1.5k では顔が変わったため、拡大ではなく、細部がより細かい新しい 1 枚として扱ってください。
隅に署名や変な文字が入るのはなぜですか?
モデルが作品から身につけた癖です。署名のような走り書きや疑似文字の 1 行が、5 枚に 1 枚ほどの頻度で見られました。ここではネガティブプロンプトで消せないので、seed を変えるか、端を切り取ってください。
seed を固定すれば、毎回同じ画像になりますか?
確実にはなりません。同じリクエストと seed でも、時間をおくと少しずつ違う仕上がりが 3 回得られました。seed は 2 つのプロンプト変更を比べるために使い、ピクセル単位で同じやり直しを約束する目的には使わないでください。
SDXL や Pony の LoRA を Anima で使えますか?
使えません。Anima 向けに学習された LoRA を使ってください。つまり Anima Turbo LoRA ファミリーです。今回のテストでは、別のベースモデル (FLUX 向け) で学習した LoRA はエラーなく読み込まれましたが、何も変わりませんでした。ベースの Anima Turbo エンドポイントは LoRA を一切受け付けません。
Anima は画像を描き直さずに編集できますか?
編集ではなく、スタイルの変換になります。画像から画像のエンドポイントは元画像 1 枚と 0 から 1 の strength を受け取りますが、今回のテストでは、既存のイラストに新しい服や昼から夜への変更を求めても、ほとんど変わりませんでした。マスクやインペイント用のフィールドはありません。
絵の中に文字を入れられますか?
1、2 語だけです。文、看板、キャプションはこのモデルが得意とするものではないので、文字はあとからエディターで足してください。
フォトリアルは描けますか?
描けません。アニメ・イラスト向けのモデルで、どのプロンプトでも写真のような質感は得られませんでした。