Anima Turbo to mały, szybki model do anime i ilustracji, który nagradza czysty prompt z tagów, ale czyta też zwykłe zdania. W naszych testach większość obrazów była gotowa w mniej niż dziesięć sekund, style z tagów działały wyraźnie, a model pozostał bez cenzury: nasz najmocniejszy prompt testowy wygenerował się zgodnie z opisem już za pierwszym razem. Ograniczenia są równie czytelne. Model nie robi fotorealizmu, rysuje tylko jedno-dwa słowa tekstu i nie ma promptu negatywnego.
Anima Turbo to zdestylowana wersja Anima od CircleStone Labs, modelu z 2 miliardami parametrów zbudowanego na NVIDIA Cosmos-Predict2 z enkoderem tekstu Qwen3. Testy przeprowadziliśmy 5 października 2026 przez endpoint tekst na obraz Anima Turbo. Każdy prompt poniżej to zwykła scena z ubranymi dorosłymi.
W skrócie
| Anima Turbo (test z 5 października 2026) | |
|---|---|
| Wydawca i baza | CircleStone Labs z Comfy Org; 2B parametrów na NVIDIA Cosmos-Predict2 (2B), enkoder tekstu Qwen3 |
| Nazwy modelu w API | circlestone-labs/anima-turbo/text-to-image i circlestone-labs/anima-turbo/edit |
| Pola publiczne (tekst na obraz) | prompt (do 5000 znaków), aspect_ratio, resolution, seed |
| Proporcje obrazu | 15, od 1:1 i 16:9 po 21:9 i 1:3 |
| Poziomy rozdzielczości | 1k (około 1 megapiksela, np. 1360 x 768 przy 16:9) i 1.5k (około 2,4 megapiksela, np. 2048 x 1152, generowane natywnie) |
| Szybkość w naszych testach | od 2 do 16 sekund na obraz w 60 przebiegach; 52 z 60 poniżej 10 sekund |
| Wynik | Jeden JPEG na żądanie |
| Polityka treści | Bez cenzury, bez filtra treści; nasz najmocniejszy prompt testowy wygenerował się zgodnie z opisem już za pierwszym razem |
| Czego nie potrafi | Fotorealizmu, więcej niż słowa lub dwóch tekstu, promptów negatywnych, kroków, CFG, samplera, masek |
Czym jest Anima Turbo
Anima pochodzi od CircleStone Labs i powstała we współpracy z Comfy Org. To model z 2 miliardami parametrów oparty na NVIDIA Cosmos-Predict2 (2B) z enkoderem tekstu Qwen3. Wydawca udostępnia trzy wersje: Base, Aesthetic i Turbo. Turbo jest wersją zdestylowaną, przeznaczoną do 8–12 kroków próbkowania. Według wydawcy jest średnio tylko nieznacznie gorsza od Anima-Aesthetic, a przy tym znacznie szybsza, i to od niej zaleca zacząć. Jak podaje wydawca, dane treningowe to kilka milionów obrazów anime plus około 800 000 artystycznych obrazów spoza anime, bez danych syntetycznych. Karta modelu jest pod adresem huggingface.co/circlestone-labs/Anima.
W SpicyAPI model jest dostępny publicznie jako circlestone-labs/anima-turbo/text-to-image. Platforma nie dodaje żadnego filtra treści, więc o wyniku decydują model i twój prompt. Strona rodziny pokazuje aktualną cenę za obraz dla każdej rozdzielczości.
Tagi czy zdania: działa jedno i drugie, ale wyglądają inaczej
Anima stosuje konwencje tagów Danbooru. Rada wydawcy, którą zastosowaliśmy: małe litery, spacje zamiast podkreślników i stała kolejność: najpierw tagi jakości i oceny, potem liczba postaci (1girl, 1boy, no humans), potem postać, seria i artysta, a na końcu wszystko inne. Bezpiecznym otwarciem jest masterpiece, best quality, opcjonalnie z score_7.
Język naturalny też działa. Wydawca zaleca co najmniej dwa zdania i widzieliśmy dlaczego: bardzo krótkie prompty się rozjeżdżają. Dwa razy uruchomiliśmy tę samą scenę w deszczowej kawiarni z tym samym seedem: raz jako tagi, raz jako cztery zdania.
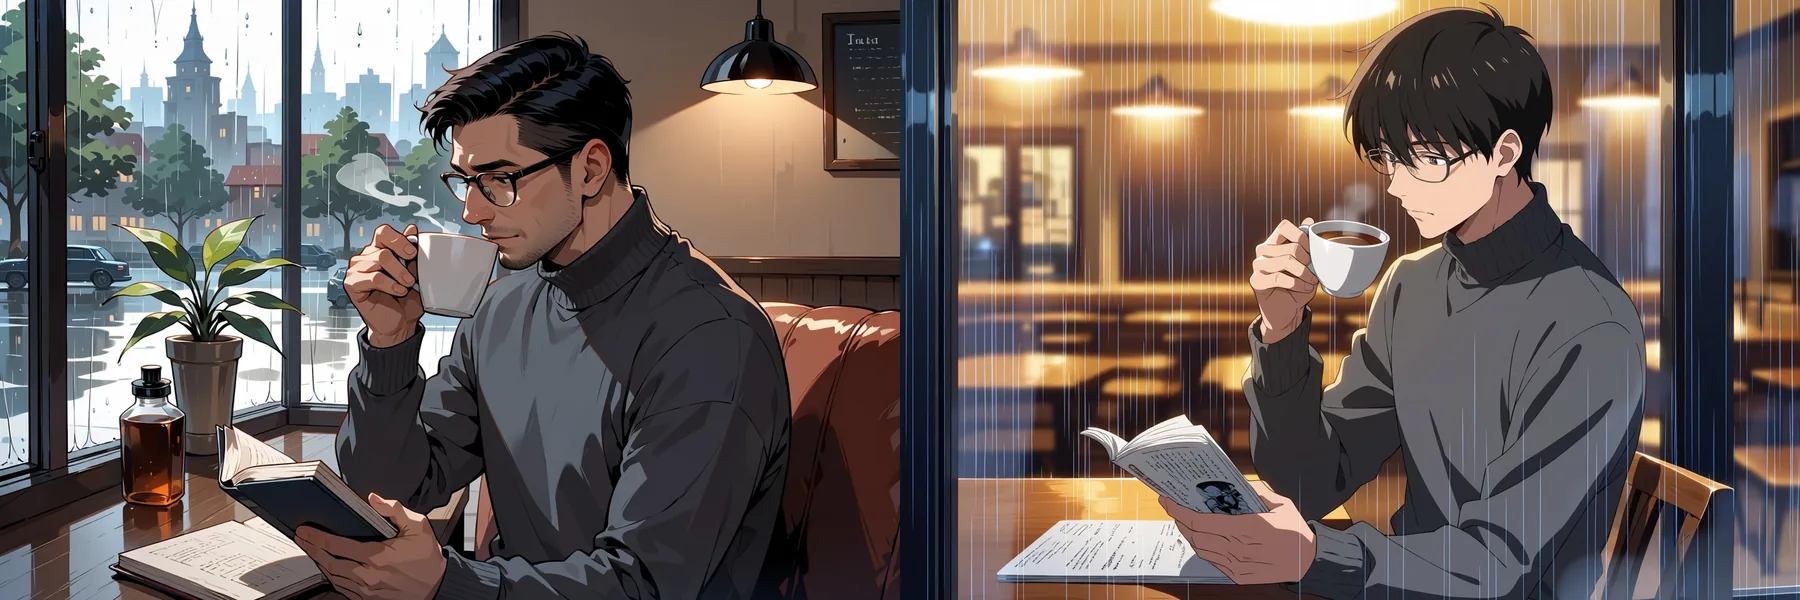
Po lewej: tagi. Po prawej: cztery zdania. Ten sam seed (4), 3:2, poziom 1k, tekst na obraz.
Wersja z tagami:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyWersja ze zdaniami:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.Obie wersje oddały okulary, golf, filiżankę i książkę. Różnice dotyczą tego, czego nie określiłeś. Prompt z tagami dał dojrzalszą twarz i jasną scenę przy oknie; prompt ze zdań dał młodszą twarz i bardziej nastrojowe wnętrze. W naszych testach tagi dają ściślejszą kontrolę nad postacią, a zdania za darmo dodają atmosferę. Połączenie obu, czyli nagłówek z tagów i jedno-dwa zdania opisu, również działało.
Którego użyć, na podstawie naszych przebiegów i zaleceń wydawcy:
| Sytuacja | Lepszy wybór | Dlaczego |
|---|---|---|
| Potrzebujesz wyglądu jednej konkretnej postaci (włosy, okulary, ubranie) | Tagi | Każdy tag to osobna instrukcja, więc szczegóły zostają na miejscu |
| Chcesz nastroju, oświetlenia albo sceny, która ma „czuć się” w określony sposób | Zdania | Wersja ze zdaniami dała bardziej nastrojowe wnętrze bez proszenia o to |
| Przywołujesz znanego artystę albo rozpoznawalny styl | Tagi, ze znakiem @ przed artystą | Wydawca mówi, że styl artysty bez @ jest słaby |
| Porównujesz seedy albo drobne zmiany promptu | Tagi | Krótkie, stałe prompty ułatwiają przypisanie zmiany do przyczyny |
| Piszesz krótki opis | Dwa lub więcej zdań | Wydawca zaleca co najmniej dwa; bardzo krótkie prompty się rozjeżdżają |
| Chcesz kontroli i atmosfery naraz | Nagłówek z tagów plus jedno-dwa zdania | Taka mieszanka sprawdziła się w naszych testach |
Pisanie promptów, które wytrzymują
Poniższa kolejność wynika z rady wydawcy i według niej napisaliśmy każdy prompt w tym artykule:
- Najpierw tagi jakości i oceny.
masterpiece, best quality, opcjonalniescore_7, potemsafe,sensitivealbonsfw. Skoro nie ma promptu negatywnego, tag oceny nadaje ton. - Dalej liczba postaci.
1girl,1boy,1girl, 1boyalbono humansdla pejzaży. - Postać, seria i artysta. Artyści dostają prefiks
@. - Cała reszta. Włosy, ubranie, miejsce, światło, kadr. Małe litery, spacje zamiast podkreślników.
- Wagi, gdy tag jest zbyt cichy.
(chibi:2)zadziałało w naszym teście stylu, ale model potrzebował wyższych wag niż modele z ery SDXL, więc nie poprzestawaj na 1.2.
Limit promptu to 5000 znaków, do którego prompty z tagów rzadko się zbliżają. Trzy nawyki wyraźnie coś zmieniły w naszych przebiegach:
- Zacznij od tagu oceny. Model zna
safe,sensitiveinsfworaz jeszcze jeden mocniejszy tag. Skoro nie ma promptu negatywnego, tag oceny to twój główny sposób na nadanie tonu, dlatego każdy prompt w tym artykule zaczyna się odsafe. - Napisz, że postacie są dorosłe.
adult woman, mature femalealbo „a man in his thirties” trzyma obsadę tam, gdzie chcesz. - Postaw
@przed nazwiskami artystów. Według wydawcy styl artysty bez@jest słaby.
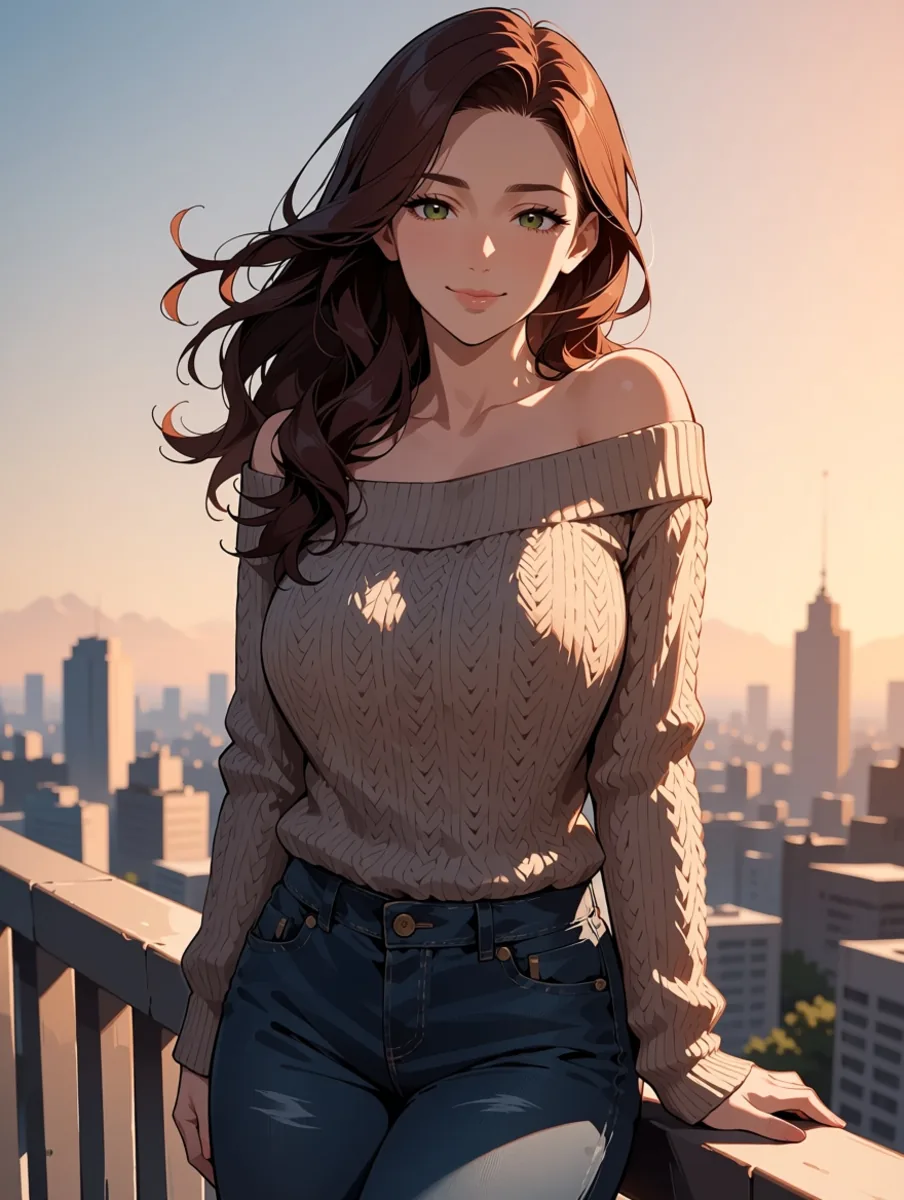
Prompt wyłącznie z tagów: tag oceny, liczba postaci, włosy, ubranie, miejsce, światło. 3:4, poziom 1k, seed 3.
Co robią tagi stylu
To był test, na którym najbardziej nam zależało. Ustaliliśmy jedną postać (dorosła kobieta z krótkimi srebrnymi włosami w trenczu na jesiennej ulicy) i jeden seed (12), zmienialiśmy tylko tagi stylu i każdy wariant uruchamialiśmy w 1:1 na poziomie 1k. Prompt bazowy:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile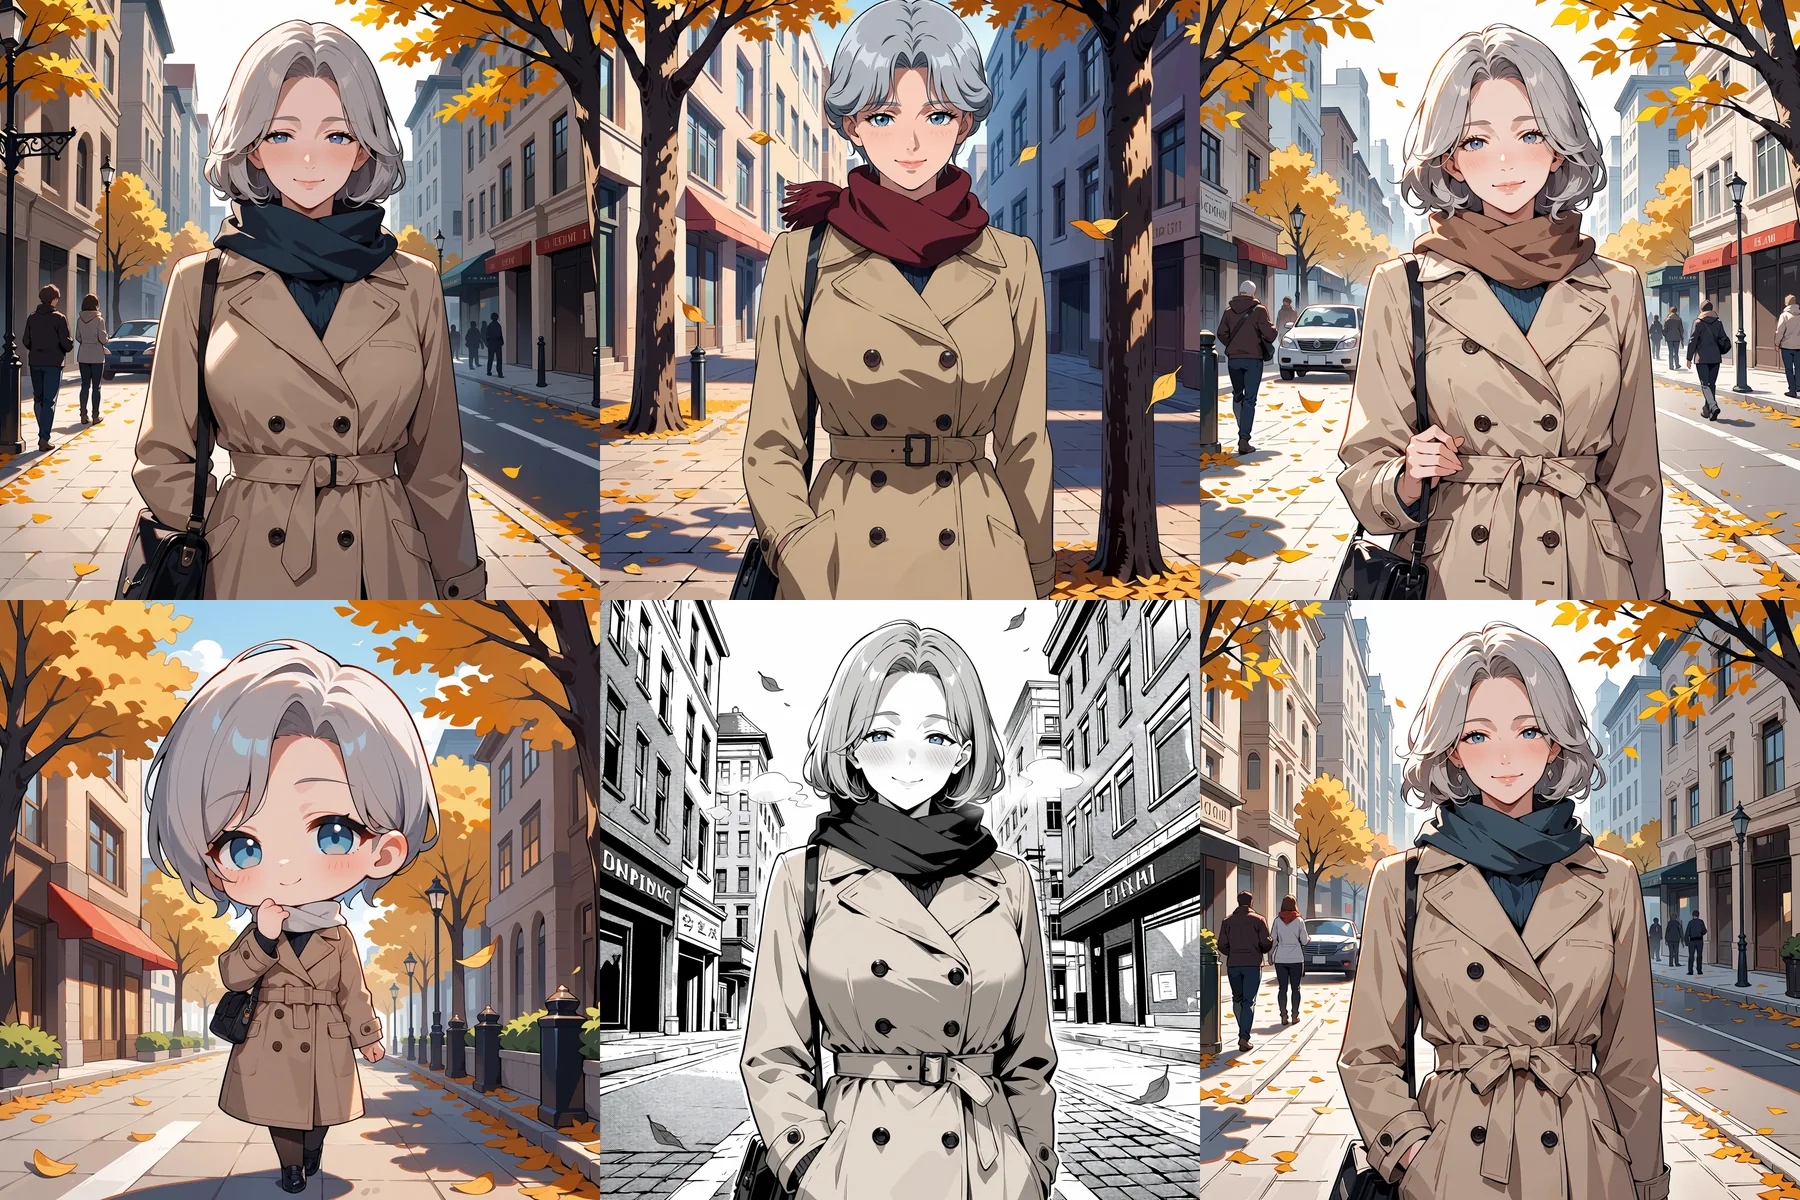
Górny rząd: bez tagu stylu, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Dolny rząd: (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Wszędzie seed 12.
Co zobaczyliśmy:
| Dodane tagi stylu | Wynik w naszych testach |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Wyraźny wygląd cela z lat 90.: płaskie kolory, twardsze cienie |
(chibi:2) | Pełne chibi: duża głowa, małe ciało |
monochrome, greyscale, manga, screentone | Przekonujący czarno-biały kadr mangi z rastrem |
watercolor (medium), traditional media | Tylko niewielka zmiana renderu |
sketch, pencil drawing, traditional media | Tylko niewielka zmiana renderu |
Mocne style to te, które mają rozpoznawalny słownik wizualny: anime z przechwyconych klatek, proporcje chibi, tusz mangi. Dwa tagi tradycyjnych mediów tylko lekko ruszyły powierzchnię i niewiele więcej. Jeśli chcesz prawdziwej akwareli albo ołówka, spodziewaj się, że zamiast tagu trzeba będzie sięgnąć po LoRA stylu.
Jeszcze jedna uwaga: ważenie promptu, np. (chibi:2), działa, ale potrzebowało wyższej wagi, niż znamy z modeli ery SDXL.
Rozmiar, rozdzielczość i szybkość
Nie ma pola rozmiaru. Wybierasz aspect_ratio spośród 15 opcji (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) oraz poziom resolution, 1k lub 1.5k, a opcjonalnie seed. Poziom 1k to około jeden megapiksel; 1.5k to około 2,4 megapiksela generowanego natywnie, a nie skalowanego w górę. Obraz 16:9 ma 1360 x 768 na poziomie 1k i 2048 x 1152 na 1.5k; 1:3 to 576 x 1760 oraz 880 x 2048. Wynik to zawsze JPEG, jeden obraz na żądanie. Proporcje nie zmieniają ceny, poziom 1.5k kosztuje więcej niż 1k, a nieudane żądania nie są rozliczane.
Zmierzyliśmy czas 60 przebiegów obejmujących każdą proporcję na obu poziomach. Czas modelu wyniósł od 2 do 16 sekund na obraz, a 52 z 60 przebiegów zakończyło się w mniej niż 10 sekund.
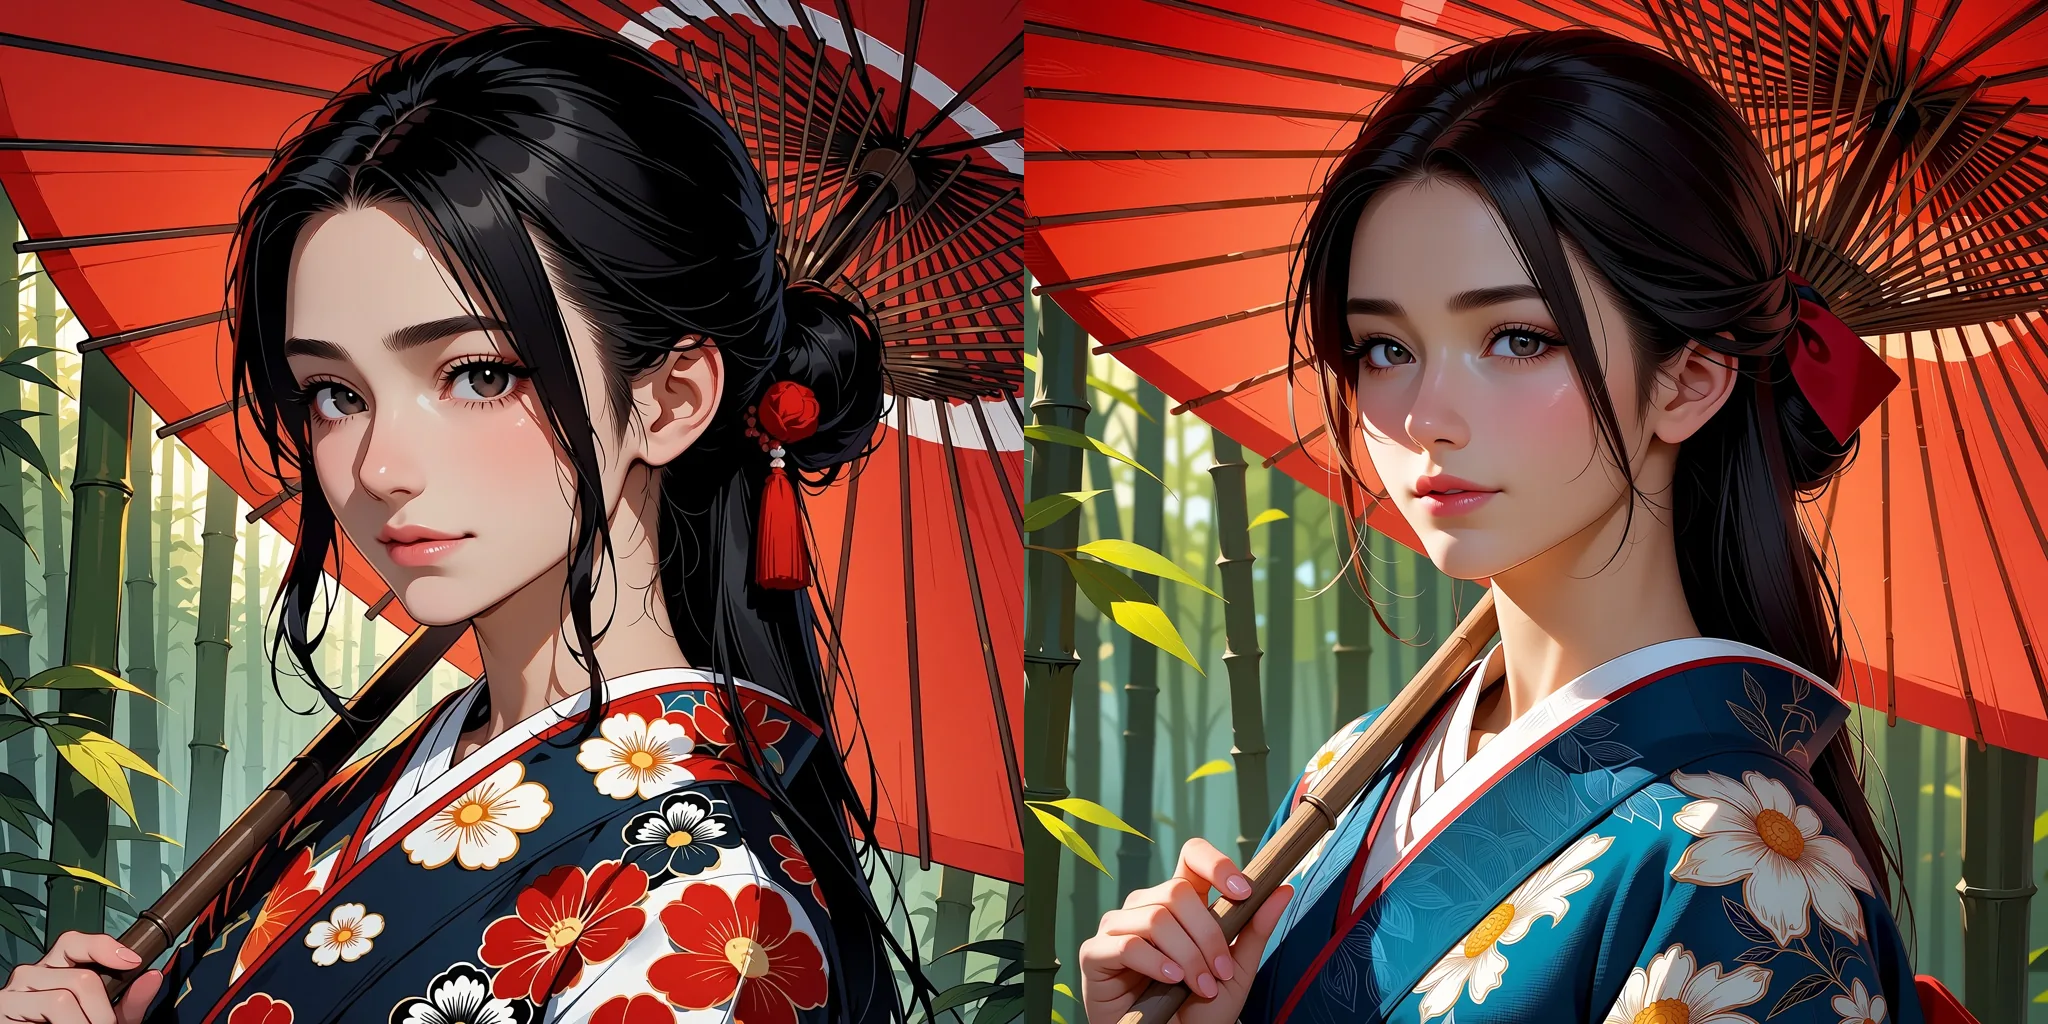
Po lewej: 1k (1024 x 1024). Po prawej: 1.5k (1536 x 1536). Ten sam prompt, seed 8, 1:1.
Oba poziomy to nie powiększenie piksel w piksel. Ten sam prompt i seed dały inną twarz i inny wzór kimona. Za 1.5k płacisz drobniejszymi detalami tkaniny i czystszą kreską. Szkicuj na 1k, a potem uruchom wybrane prace na 1.5k i traktuj wynik jak nowe ujęcie, a nie ostrzejszą kopię.
Jak daleko sięga
Endpoint jest bez cenzury, a platforma nie dodaje filtra treści. W naszych testach model też się nie hamował: nasz najmocniejszy prompt testowy wygenerował się zgodnie z opisem za pierwszym razem, w trybie tekst na obraz i obraz na obraz, z LoRA i bez nich, na wielu seedach. Tego promptu nie drukujemy; poniższe przykłady to zwykłe sceny.
W zwykłych scenach model błyszczy rozpiętością. Jeden styl promptu dał portrety, pary, barmana na nocnej zmianie i puste pejzaże:
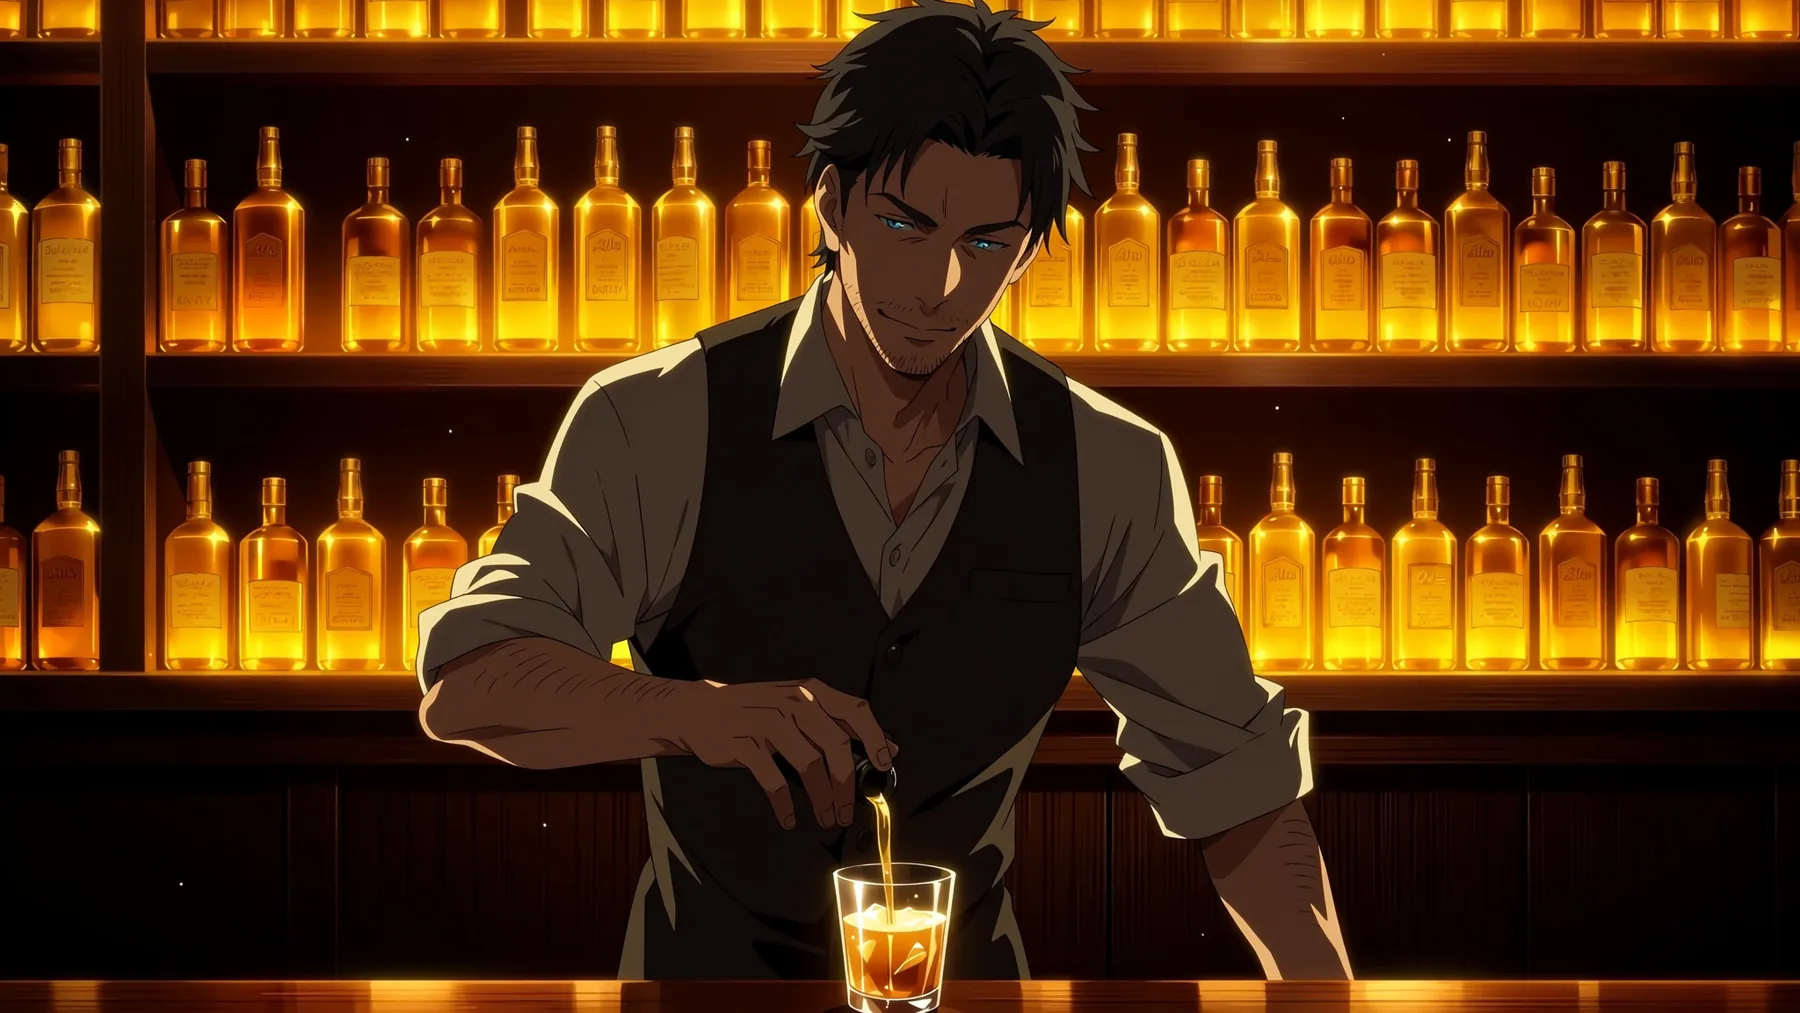
Trzy zdania, tag oceny safe, 16:9, poziom 1.5k, seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.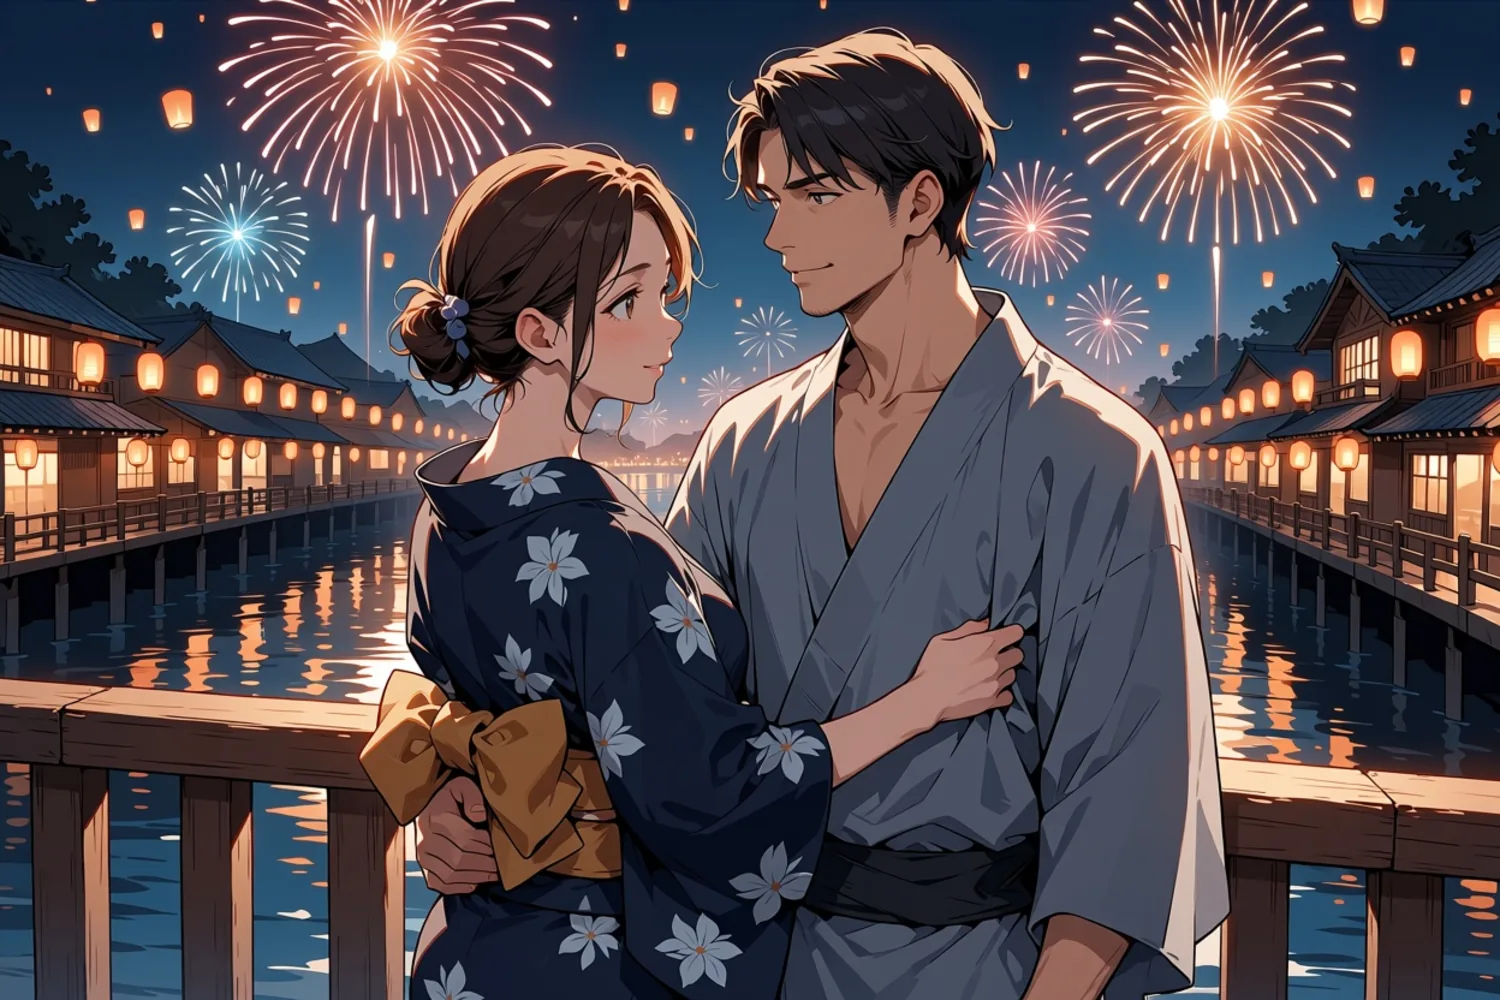
Tagi z liczbą postaci 1girl, 1boy, 3:2, poziom 1k, seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections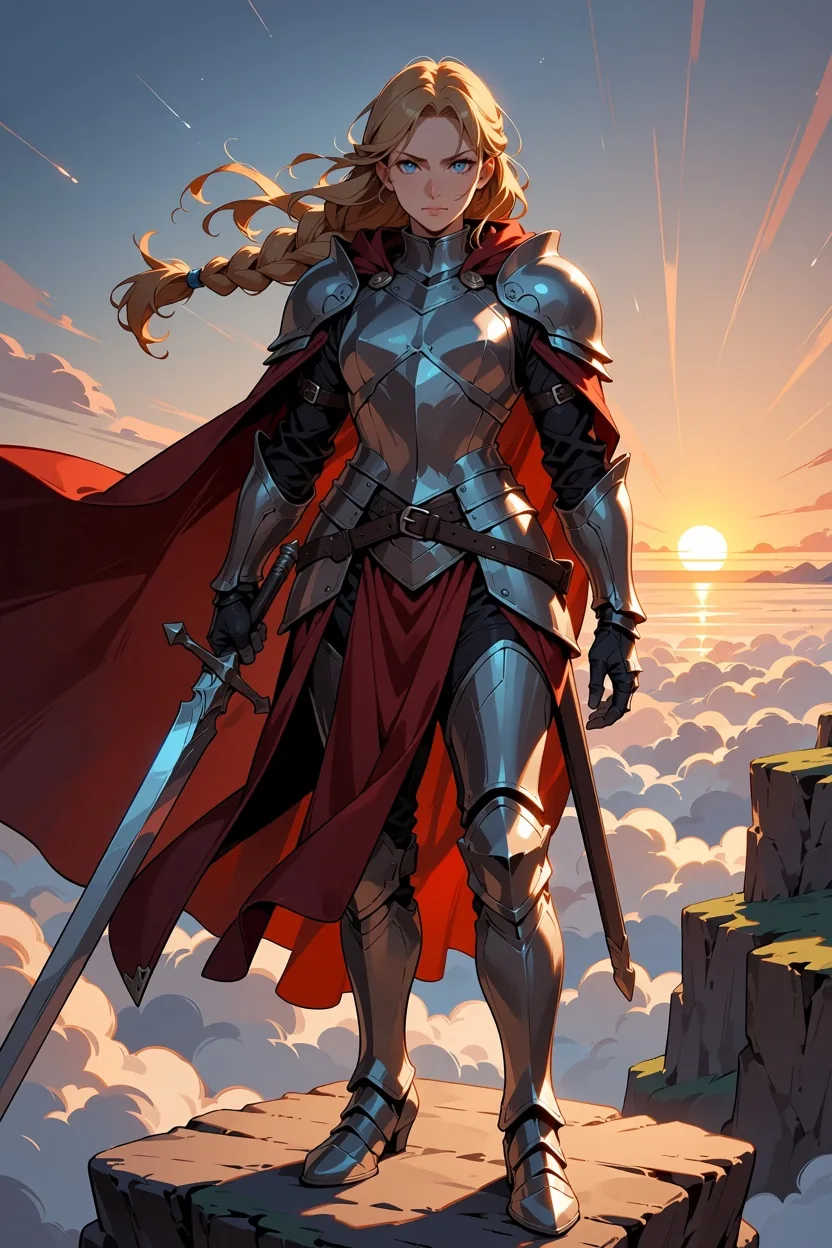
Tagi, portret 2:3, poziom 1k, seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, po zwykłych tagach jakości, oceny i liczby postaci.
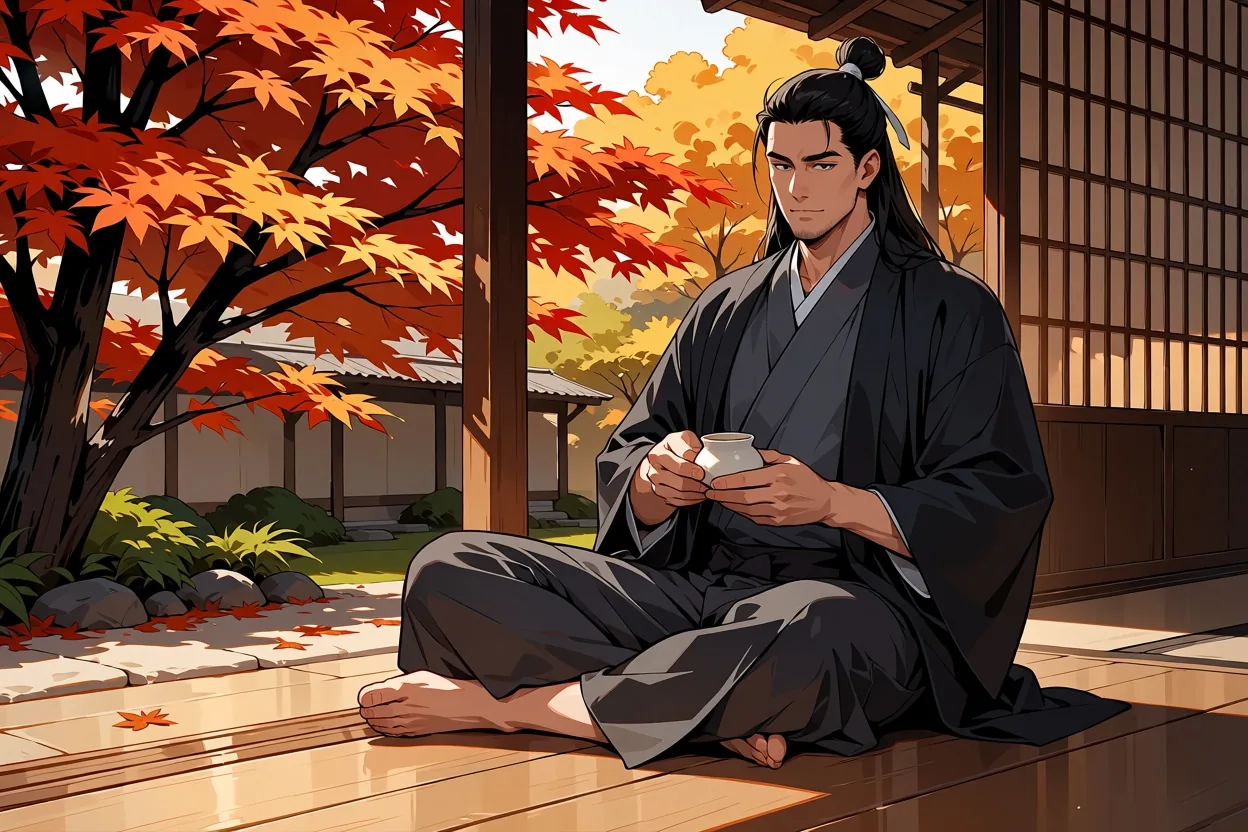
Tagi, 3:2, poziom 1k, seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
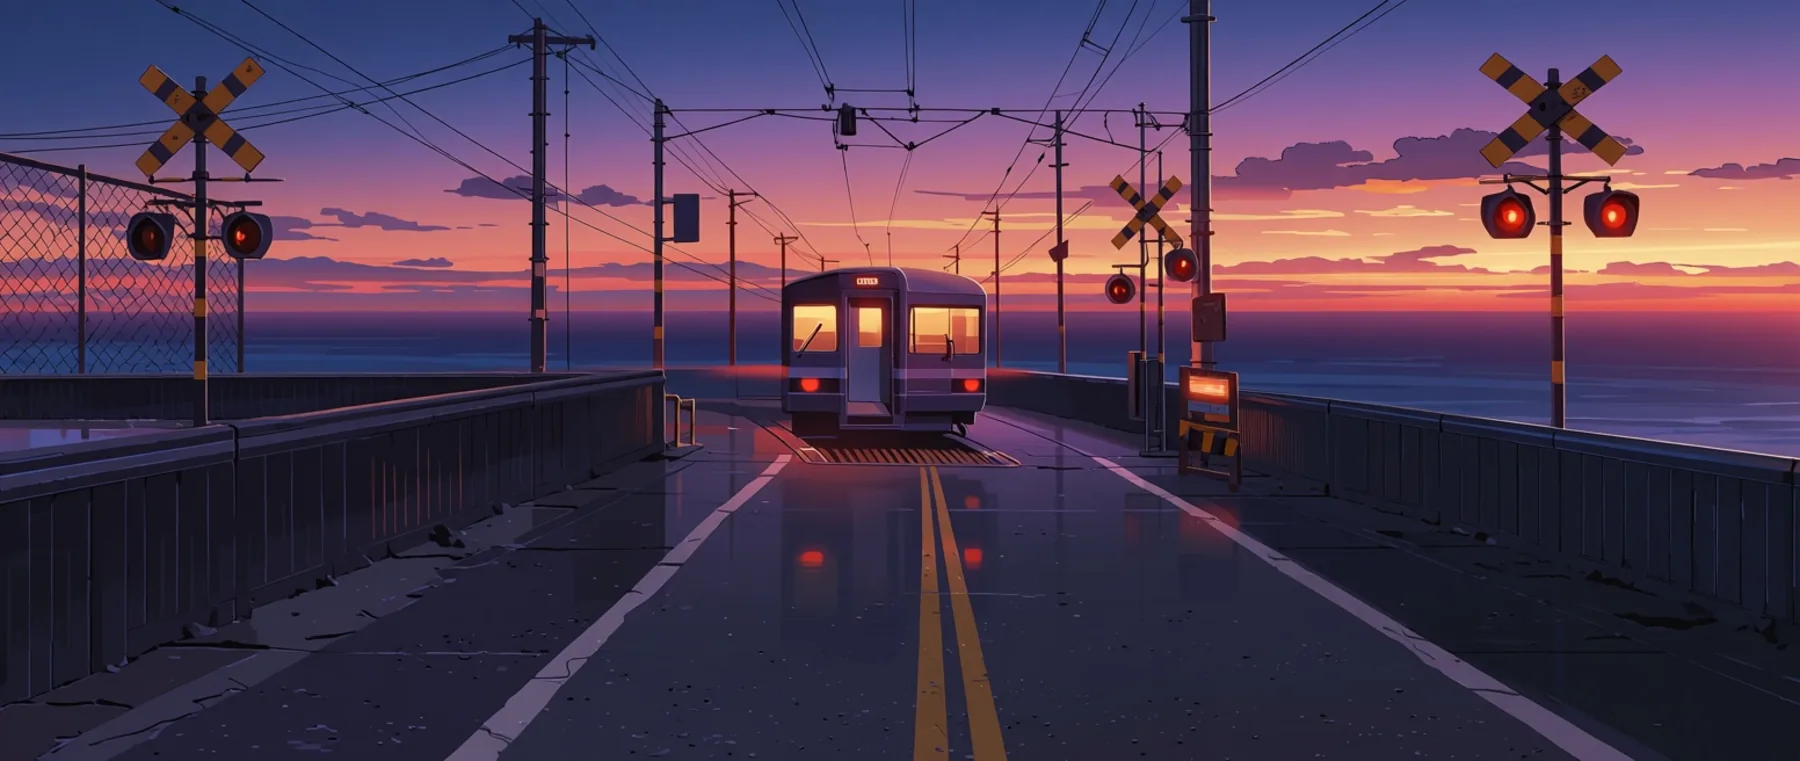
Pejzaż z no humans, 21:9, poziom 1k (1552 x 656), seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotNietypowe proporcje też się sprawdzają. 9:16, wysoki baner 1:3 i szeroki kadr 16:9 wyszły skomponowane pod swój format, a nie wycięte z kwadratu:
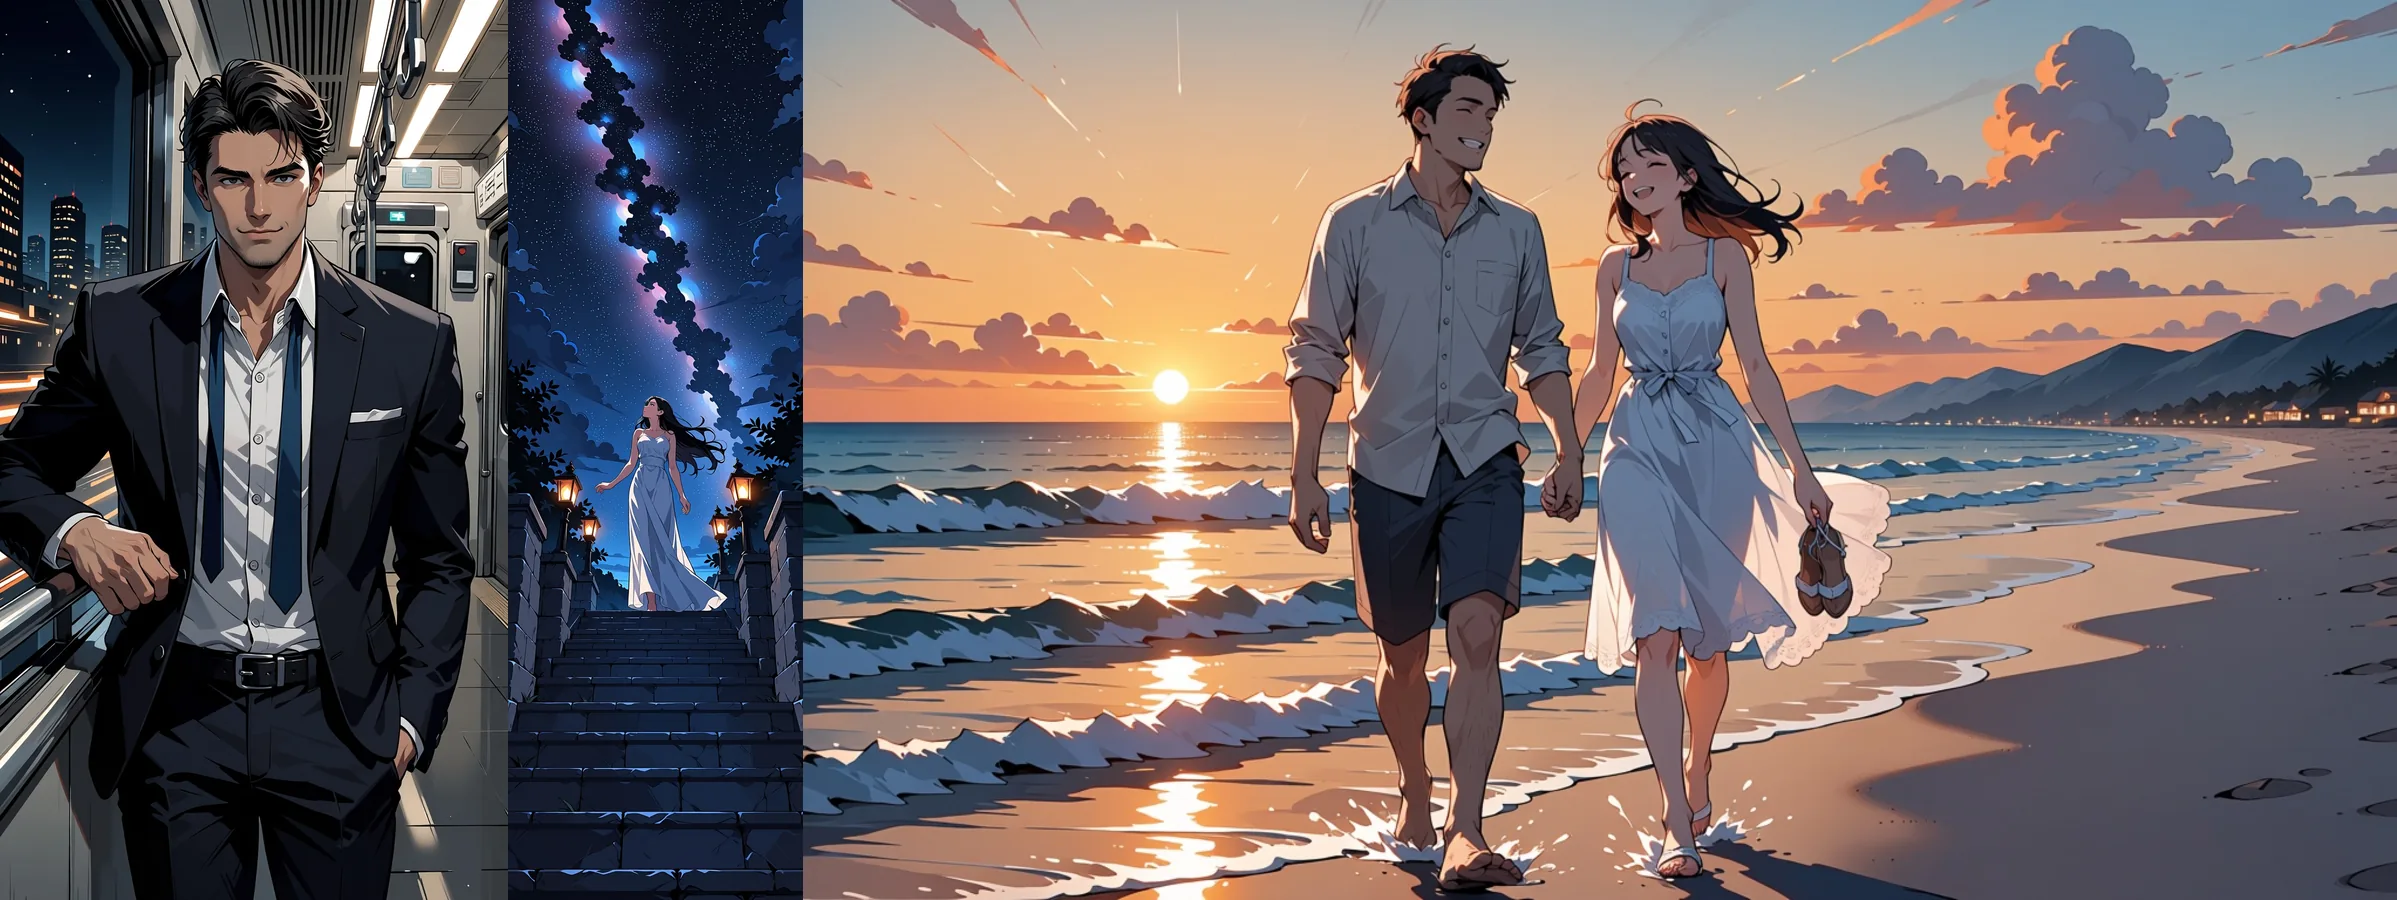
Od lewej do prawej: 9:16, 1:3, 16:9, wszystko na poziomie 1k, wszystko tekst na obraz.
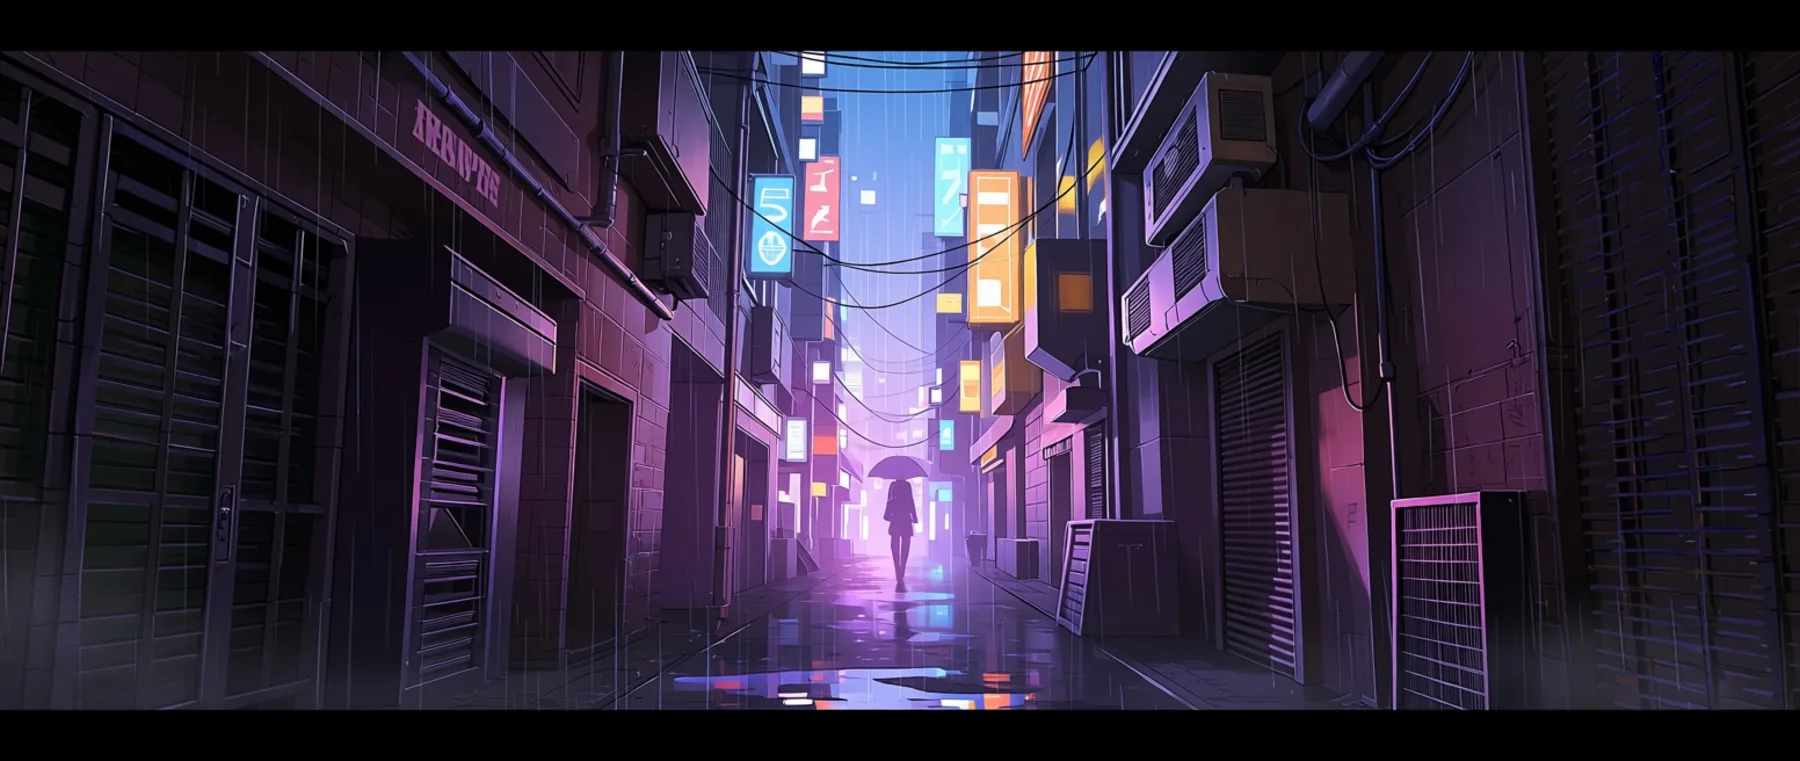
Pejzaż cyberpunkowej uliczki, 21:9, poziom 1k.
Gdzie model zawodzi
- Brak fotorealizmu. To model anime i ilustracji. Nie oczekuj fotograficznego wyglądu przy żadnym prompcie.
- Tekst jest słaby. Rysuje jedno-dwa słowa, a nie zdanie, szyld czy napis.
- Brak promptu negatywnego, kroków, CFG i samplera. Publiczne pola to
prompt,aspect_ratio,resolutioniseed. Tag oceny i twoje sformułowania to jedyne hamulce, jakie masz. - Coś w rodzaju podpisu. Model czasem rysuje w rogu podpis albo linijkę pseudo-tekstu, nawyk wyniesiony z grafik. Widzieliśmy to mniej więcej na co piątym obrazie. Żaden prompt negatywny tego nie stłumi. Zmień seed albo przytnij brzeg.
- Seed umożliwia porównywanie przebiegów, ale nie daje identycznych wyników. To samo żądanie z tym samym seedem dało nam trzy nieco różne renderingi w różnych momentach. Używaj seeda, żeby porównać dwie zmiany promptu, a nie żeby obiecywać klientowi powtórkę co do piksela.
- Jeden obraz na żądanie, tylko JPEG, bez masek. Nie ma pola do inpaintingu.
Dla kogo
Użyj Anima Turbo, jeśli chcesz szybkich szkiców anime i ilustracji w cenie za obraz, jeśli lubisz pisać prompty z tagów albo łączyć tagi z kilkoma zdaniami, albo jeśli potrzebujesz niefiltrowanego wyniku z małego modelu. To dobry model do eksplorowania postaci i scen na 1k, a następnie awansowania wybranych prac na 1.5k.
Szukaj gdzie indziej, jeśli potrzebujesz fotograficznego realizmu albo czytelnego tekstu na obrazie.
Którą rodzinę Anima wybrać
SpicyAPI ma dwie rodziny Anima. Mają ten sam model bazowy, więc wybór sprowadza się do tego, czy potrzebujesz własnego wyglądu:
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| Nazwy modelu w API | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Dodatkowe pole | Brak | loras: do 3 wpisów, każdy z path i scale od 0 do 4 |
| Najlepsza do | Szybkich szkiców, promptów z tagów i zdań, wyglądu bazowego | Konkretnego stylu graficznego, postaci albo wyglądu epoki z LoRA do Animy |
| Kontrola stylu | Tagi stylu w prompcie | Tagi stylu plus LoRA |
| Rozliczenie | Za obraz według poziomu rozdzielczości | Ta sama struktura; załadowanie LoRA nie dokłada osobnej opłaty |
Zacznij od Anima Turbo. Przejdź na rodzinę LoRA, gdy tag stylu nie wystarcza, na przykład gdy tag akwareli albo ołówka w naszym teście tylko musnął powierzchnię.
Dwa naturalne kolejne kroki:
- Własne style. Rodzina Anima Turbo LoRA ładuje do trzech LoRA na żądanie, więc możesz dodać konkretny wygląd, także LoRA dla dorosłych od społeczności. Omawia to nasz poradnik towarzyszący: Poradnik LoRA do Anima Turbo.
- Zmiana stylu zdjęć. Endpoint obraz na obraz przyjmuje jeden obraz źródłowy i
strengthod 0 do 1. W artykule Ze zdjęcia w anime z Anima Turbo zobaczysz, co robi każda wartość.
FAQ
Czy Anima Turbo obsługuje prompty negatywne?
Nie. Pola publiczne to prompt, aspect_ratio, resolution i seed, bez promptu negatywnego, kroków, CFG ani samplera. Wpisz w prompcie to, czego chcesz, a tonem steruj tagiem oceny (safe, sensitive albo nsfw).
Jakiej rozdzielczości użyć?
Szkicuj na 1k, a obrazy, które ci się podobają, uruchom ponownie na 1.5k. Poziom 1k to około jeden megapiksel, a 1.5k około 2,4 megapiksela, generowane natywnie. W naszych testach ten sam prompt i seed dały na 1.5k inną twarz, więc traktuj go jak nowe ujęcie z drobniejszymi detalami, a nie jak powiększenie.
Skąd podpis albo dziwny tekst w rogu?
Model wyniósł ten nawyk z grafik. Widzieliśmy coś w rodzaju podpisu albo linijkę pseudotekstu mniej więcej na co piątym obrazie. Prompt negatywny tego tu nie usunie, więc zmień seed albo przytnij brzeg.
Czy stały seed daje za każdym razem ten sam obraz?
Niezawodnie nie. To samo żądanie z tym samym seedem dało nam trzy nieco różne renderingi w różnych momentach. Używaj seeda, żeby porównać dwie zmiany promptu, a nie żeby obiecywać powtórkę co do piksela.
Czy mogę używać LoRA do SDXL albo Pony z Animą?
Nie, używaj LoRA wytrenowanych pod Animę, czyli rodziny Anima Turbo LoRA. W naszych testach LoRA wytrenowana pod inny model bazowy (pod FLUX) załadowała się bez błędu i nic nie zmieniła. Bazowy endpoint Anima Turbo w ogóle nie przyjmuje LoRA.
Czy Anima potrafi edytować obraz zamiast go przerysowywać?
Zmienia styl, a nie edytuje. Endpoint obraz na obraz przyjmuje jeden obraz źródłowy i strength od 0 do 1, a w naszych testach prośba o nowy strój albo o zmianę dnia w noc na istniejącej ilustracji zmieniała bardzo mało. Nie ma maski ani pola do inpaintingu.
Czy potrafi pisać tekst na obrazie?
Tylko słowo lub dwa. Zdania, szyldy i podpisy to nie jest coś, co ten model robi dobrze, więc dodaj tekst później w edytorze.
Czy robi fotorealizm?
Nie. To model anime i ilustracji, a żaden prompt nie dał nam wyglądu fotograficznego.