Żeby zamienić zdjęcie w anime w Anima Turbo, wyślij zdjęcie jako image_url, napisz prompt, który opisuje obraz już obecny na zdjęciu, i ustaw strength na 0.75. W naszych testach ta wartość dawała czyste anime z zachowaną kompozycją. Niżej przebija zdjęcie; wyżej model zaczyna przerysowywać scenę. Reszta tego poradnika dotyczy przesuwania tej jednej liczby i tego, co robić, gdy to nie wystarcza.
Anima Turbo to zdestylowana wersja Anima, modelu anime i ilustracji z 2 miliardami parametrów od CircleStone Labs, zbudowanego na NVIDIA Cosmos-Predict2 z enkoderem tekstu Qwen3. Te endpointy są bez cenzury i nie dodają filtra treści, a wszystko, co tu wydrukowano, to zwykłe sceny z ubranymi dorosłymi. Wszystkie testy wykonaliśmy 5 października 2026.
W skrócie
| Model | Anima Turbo od CircleStone Labs (2B parametrów; Turbo to zdestylowana wersja, od której wydawca zaleca zacząć) |
| Nazwa API dla obraz na obraz | circlestone-labs/anima-turbo/edit |
| Z LoRA | circlestone-labs/anima-turbo-lora/edit, do 3 LoRA, scale od 0 do 4 |
| Dane wejściowe | image_url (jeden obraz źródłowy), prompt, strength (od 0 do 1, domyślnie 0.8), resolution, seed |
| Najlepszy strength w naszych testach | 0.75 dla fotografii; 0.85, by zamienić kolorową ilustrację w tusz mangi |
| Rozmiar wyniku | Zachowuje proporcje źródła: zdjęcie 16:9 dało 1360 x 752 na poziomie 1k; 1k to około 1 megapiksel, 1.5k około 2,4 |
| Format wyniku | Zawsze JPEG |
| Szybkość | Od 2 do 16 sekund czasu modelu na obraz w 60 przebiegach; 52 z 60 poniżej 10 sekund |
| Polityka treści | Bez cenzury, bez filtra treści |
| Czego nie potrafi | Instrukcji edycji, masek, promptów negatywnych, fotorealizmu, więcej niż jednego obrazu źródłowego |
Co naprawdę robi strength
strength mieści się w przedziale od 0 do 1 (domyślnie 0.8). Przy 0 dostajesz źródło nietknięte. Przy 1 źródło jest ignorowane i dostajesz nowy obraz z promptu. Wszystko, co przydatne, leży pomiędzy. Uruchomiliśmy jedno zdjęcie piosenkarki z jednym promptem i jednym seedem, zmieniając tylko liczbę.
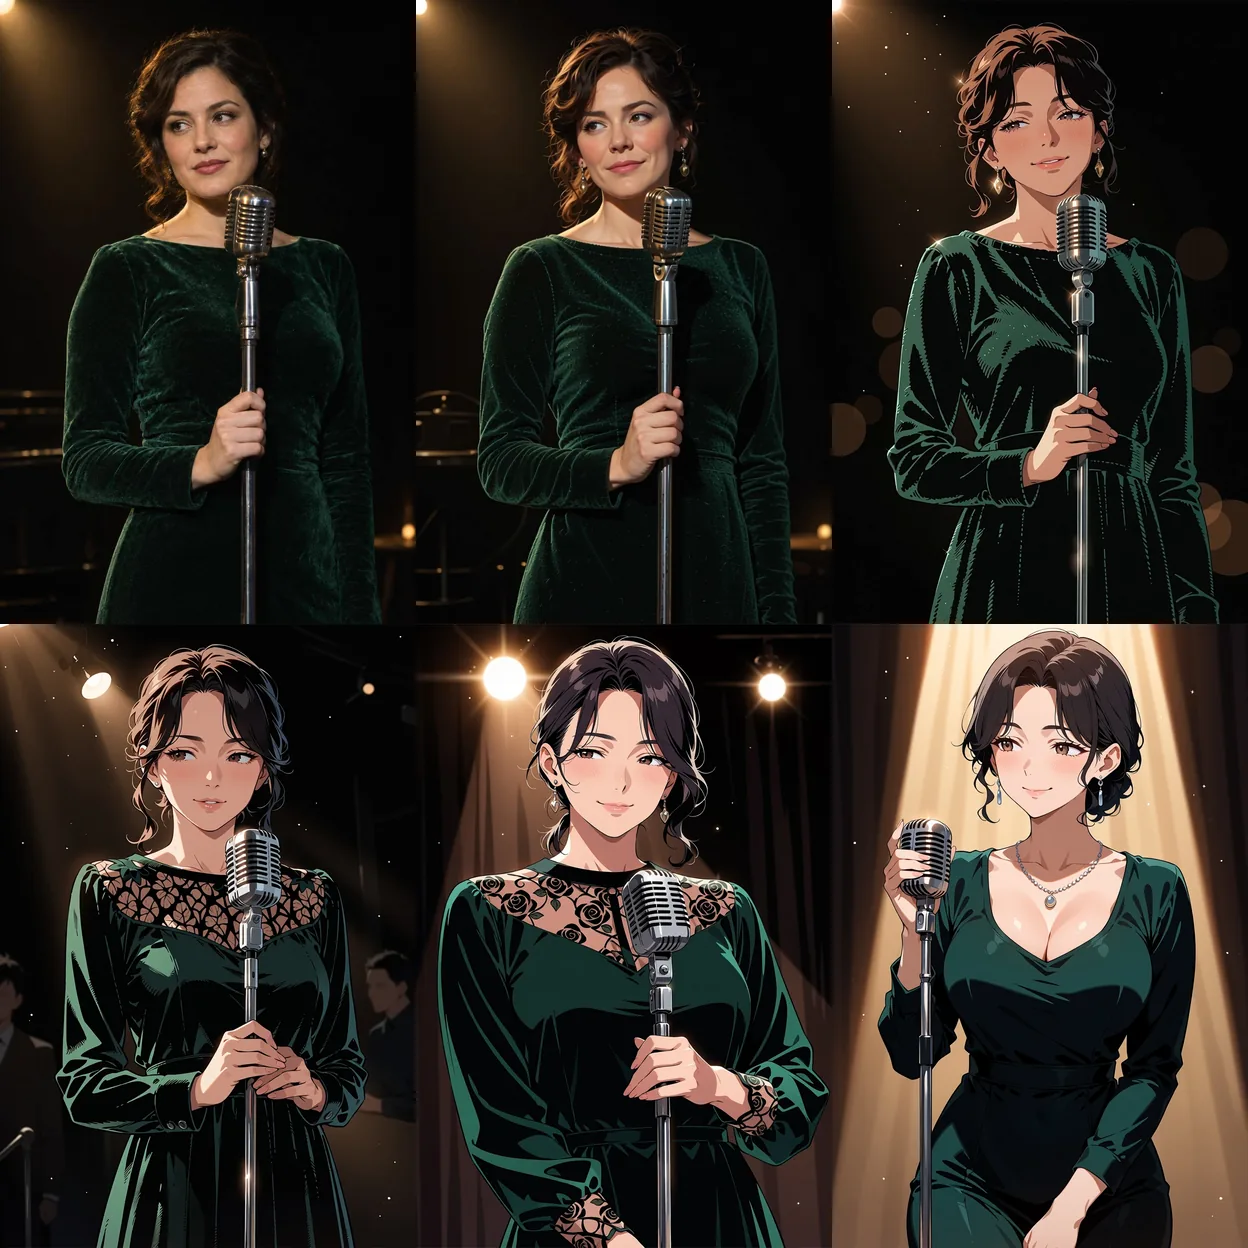
Górny rząd, od lewej: zdjęcie źródłowe, potem strength 0.3 i 0.6. Dolny rząd: 0.75, 0.9 i 1.0. Anima Turbo obraz na obraz, poziom 1k, wszędzie ten sam prompt i seed.
| Strength | Co zobaczyliśmy |
|---|---|
| 0 | Twoje źródło, nietknięte |
| 0.3 | Wciąż fotografia |
| 0.6 | Już ilustracja, z tymi samymi detalami |
| 0.75 | Czyste anime, ta sama kompozycja |
| 0.9 | Detale zaczynają się zmieniać: suknia, poza, tło |
| 1.0 | Źródło ignorowane; nowy obraz z promptu |
Zacznij od 0.75 i koryguj co 0.05. Domyślne 0.8 jest w porządku, ale 0.75 lepiej zachowywało pozę i kadr w każdym z poniższych przykładów.
Którą wartość wybrać, zależy od tego, od czego zaczynasz i czego chcesz:
| Punkt wyjścia i cel | Użyty strength | Wynik w naszych testach |
|---|---|---|
| Fotografia na zwykłe anime | 0.75 | Kompozycja się utrzymała, drobna mechanika odpłynęła |
| Fotografia na anime, jeden szczegół musi przetrwać | 0.7 | Nasza sugestia dla przykładu z baristą; nie uruchamialiśmy osobno |
| Fotografia na wygląd z LoRA stylu (PC-98) | 0.75 | Styl zastosowany, kompozycja zachowana |
| Kolorowa ilustracja na tusz mangi (LoRA monochromatyczna) | 0.85 | 0.8 zostawiło kolor; przy 0.85 poza jest rysowana od nowa |
| Istniejąca ilustracja plus prompt „edycyjny” (nowy strój, dzień w noc) | od 0.6 do 0.8 | Zmieniło bardzo niewiele; wyższy strength dodawał pseudotekst |
Pisz prompt do obrazu, nie do edycji
To błąd, który kosztuje najwięcej czasu. Anima zmienia styl; nie wykonuje poleceń w rodzaju „zmień jej strój” albo „zrób z tego noc”. Opisz to, co jest na zdjęciu, w stylu, jakiego chcesz, i nazwij rzeczy, które model musi zachować: włosy, ubranie, miejsce, światło. Drabinka z piosenkarką użyła tego promptu:
masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, mature female, short dark wavy hair, dark green velvet dress with long sleeves, holding a vintage microphone on a stand, jazz club stage, warm spotlight from above, dark background, soft smile, looking to the sideObowiązują konwencje tagów wydawcy: małe litery, spacje zamiast podkreślników, najpierw tagi jakości i oceny, potem liczba postaci (1girl, 1boy), potem tagi ogólne. Nasze prompty zaczynają się od safe; nie ma promptu negatywnego, więc tag oceny to główny sposób na nadanie tonu. Zdania też działają (wydawca sugeruje co najmniej dwa), a mieszanie ich z tagami jest w porządku.
Żądanie
{
  "model": "circlestone-labs/anima-turbo/edit",
  "input": {
    "image_url": "https://example.com/singer.jpg",
    "prompt": "masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, short dark wavy hair, dark green velvet dress, holding a vintage microphone, jazz club stage, warm spotlight",
    "strength": 0.75,
    "resolution": "1k",
    "seed": 3
  }
}
Nie ma pola proporcji obrazu. Wynik zachowuje kształt źródła: zdjęcie 16:9 wróciło w rozmiarze 1360 x 752 na poziomie 1k. resolution ustala liczbę pikseli: 1k to około jeden megapiksel, 1.5k około 2,4 megapiksela, generowanego natywnie, a nie skalowanego w górę. Wynik to zawsze JPEG. Obraz na obraz jest rozliczany za obraz według poziomu, tak samo jak tekst na obraz; aktualna cena jest na stronie modelu. Czas modelu w naszym teście szybkości na 60 przebiegach wynosił od 2 do 16 sekund na obraz.
Co składa się na dobre zdjęcie źródłowe
- Jeden wyraźny temat. Każdy przykład tutaj ma jedną osobę albo jedną parę w czytelnym otoczeniu, a prompt może nazwać wszystko, co jest w kadrze.
- Bez ramek, podpisów i znaków wodnych. Anima zmienia styl całego kadru, więc wszystko, co jest na nim nadrukowane, też zostanie przerysowane.
- Kształt, który chcesz zachować. Nie ma pola proporcji obrazu; wynik podąża za źródłem (zdjęcie 16:9 dało 1360 x 752), więc przytnij zdjęcie przed wysłaniem.
- Poziom dopasowany do zastosowania.
1kto około jeden megapiksel;1.5kto około 2,4 megapiksela, generowane natywnie, a nie skalowane w górę. Ten sam prompt i seed na obu poziomach:
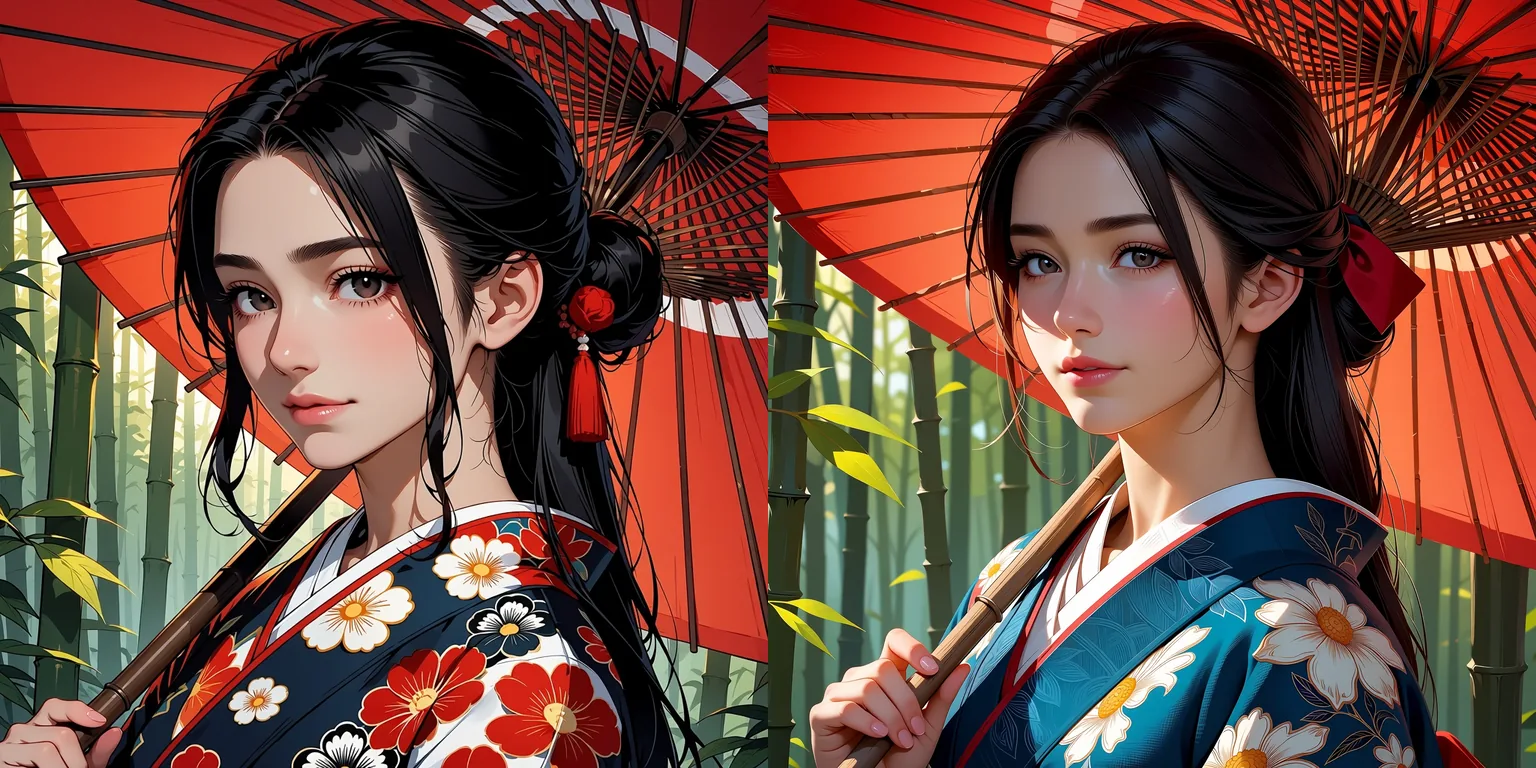
Po lewej: 1k (1024 x 1024). Po prawej: 1.5k (1536 x 1536). Anima Turbo tekst na obraz, ten sam prompt i seed. Poziomy pokazujemy na tekście na obraz; obraz na obraz używa tego samego pola resolution.
Kompozycja jest wspólna, ale render 1.5k przerysowuje wzór kimona i twarz, a nie tylko dodaje piksele, więc wybierz poziom, zanim zaczniesz porównywać seedy.
Trzy przykłady
Portret
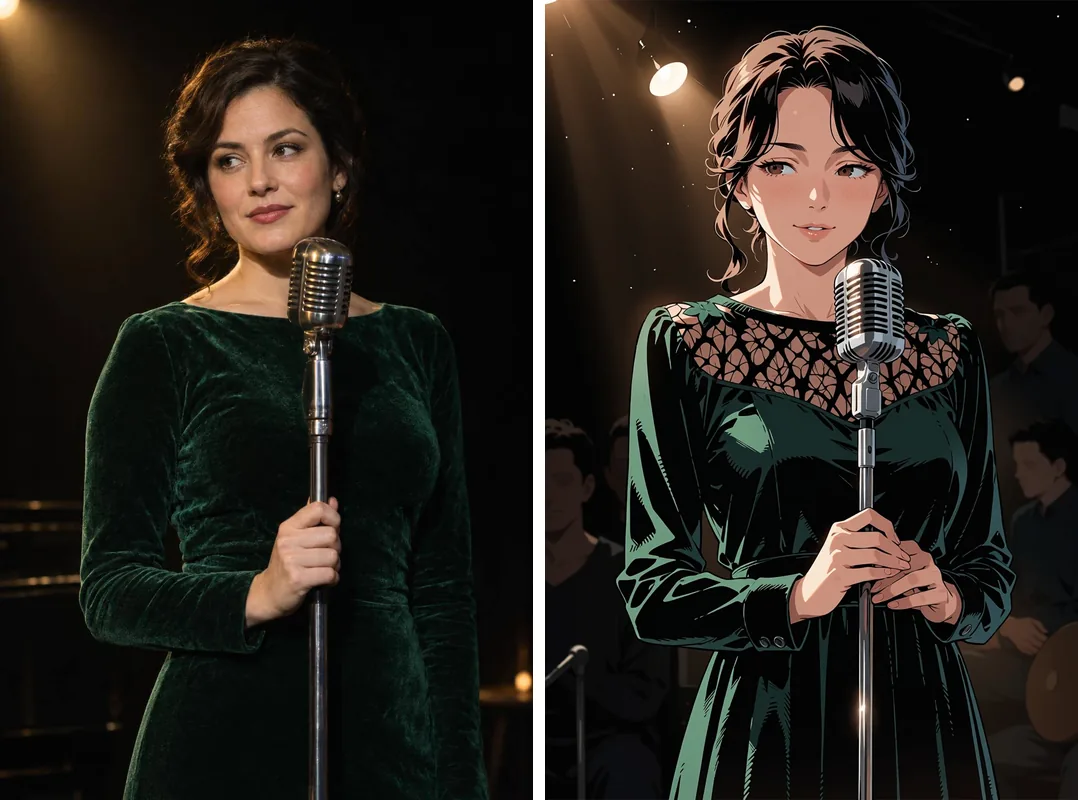
Po lewej: zdjęcie źródłowe. Po prawej: Anima Turbo obraz na obraz, strength 0.75, 1k, seed 3. Prompt jak wyżej.
Aksamitna suknia, statyw mikrofonu i spojrzenie w bok przetrwały, a światło sceny zmieniło się w czysty stożek ciepłego światła. To kafelek 0.75 z drabinki, pokazany w pełnym rozmiarze.
Scena w poziomym kadrze
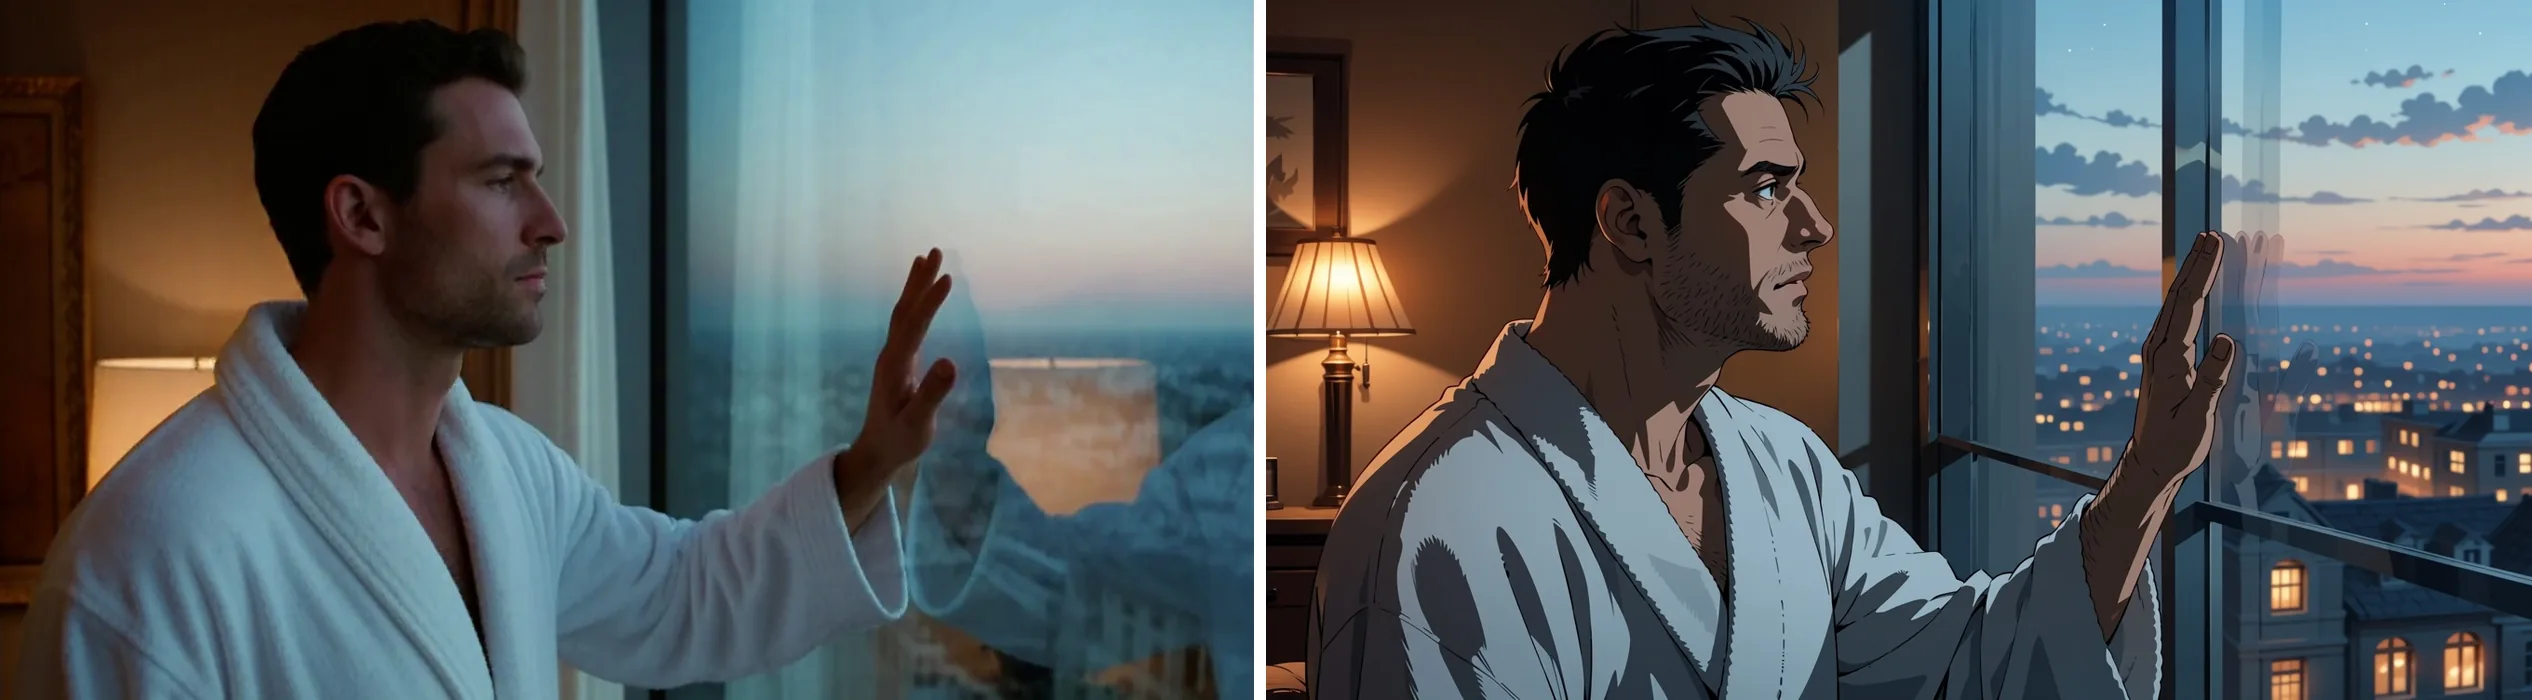
Po lewej: zdjęcie źródłowe. Po prawej: Anima Turbo obraz na obraz, strength 0.75, 1k, seed 1.
Prompt nazwał pozę (profile view, one hand touching a large window), lampę za nim i niebieskie wieczorne światło na szybie. Model zachował profil i dłoń, a miasto za oknem narysował bardziej szczegółowo niż na zdjęciu.
Para na skuterze
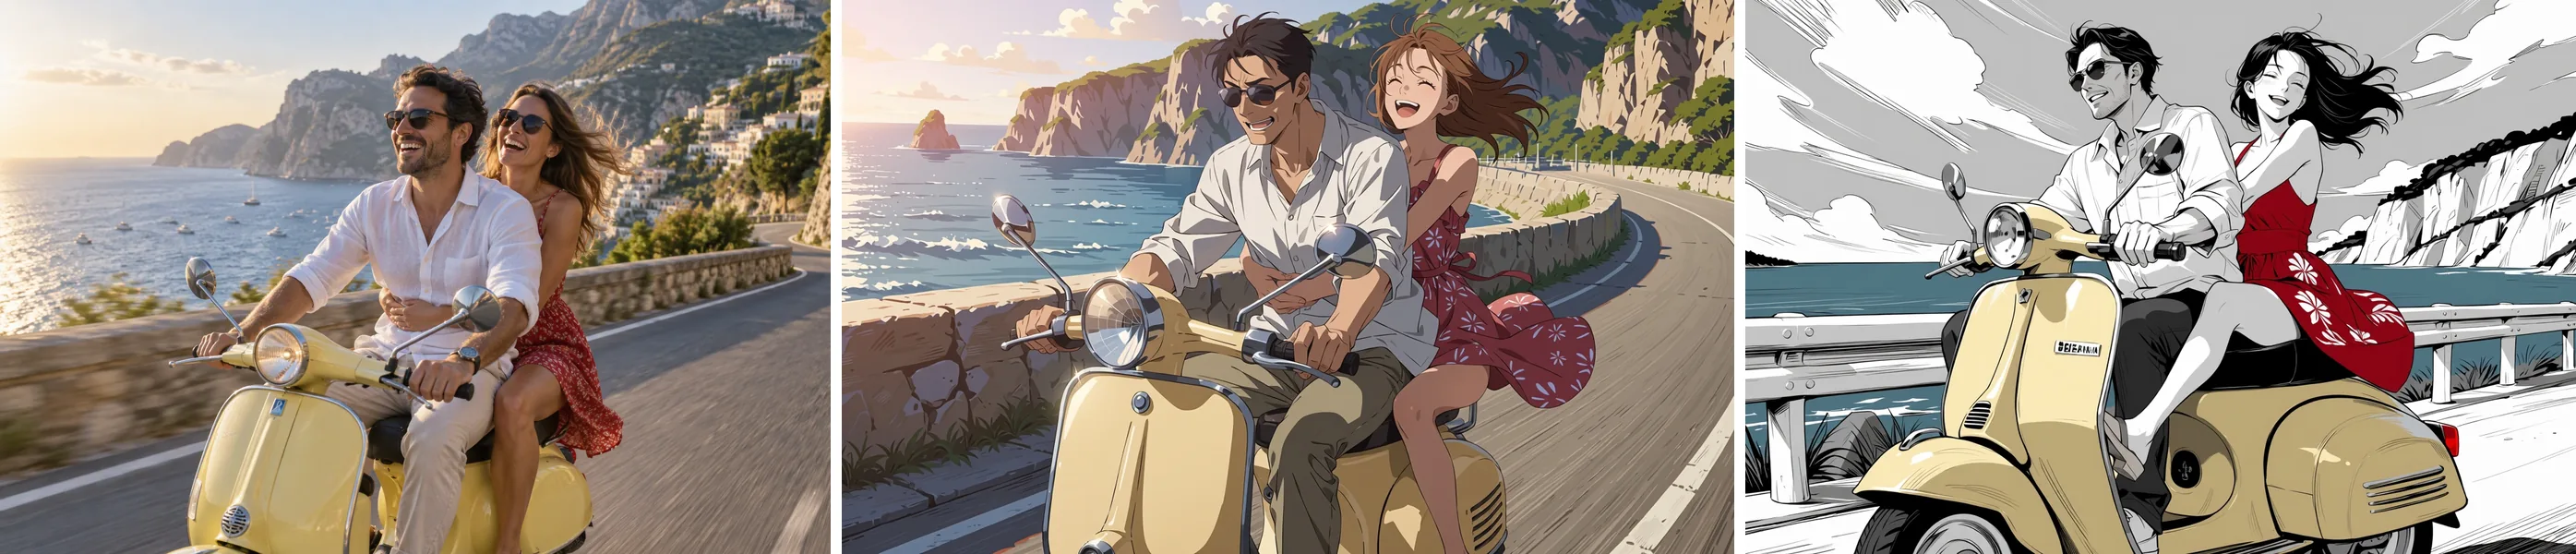
Po lewej: zdjęcie źródłowe, wygenerowane przez nas. Pośrodku: Anima Turbo obraz na obraz, strength 0.75, 1k, seed 3, górne 7% przycięte. Po prawej: to samo żądanie z LoRA monochromatyczną przy strength 0.85.
masterpiece, best quality, safe, anime illustration, 1girl, 1boy, hetero, adult couple, mature female, mature male, riding a pale yellow vintage scooter on a coastal road, he drives in a white linen shirt and sunglasses, she sits behind him in a red summer dress with her arms around his waist, hair blowing in the wind, laughing, blue sea and cliffsSceny z dwiema osobami wymagają wypisania kolorów i ubrań dla każdej osoby osobno, jak powyżej. Górne 7% środkowego wyniku przycięliśmy, bo model narysował w tym rogu mały zalążek pseudo-tekstu, co prowadzi nas do rozwiązywania problemów poniżej. Przykładu z baristą nie przycinaliśmy; zamiast tego przesunął się w nim kadr:
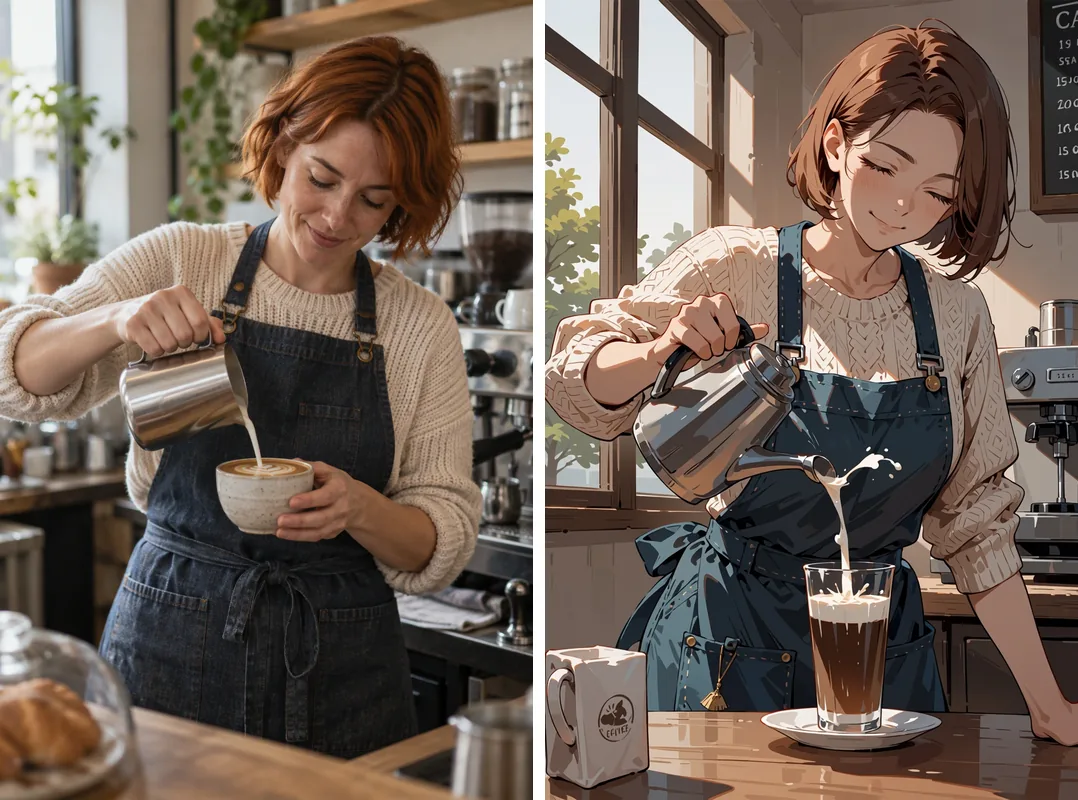
Po lewej: zdjęcie źródłowe, wygenerowane przez nas. Po prawej: Anima Turbo obraz na obraz, strength 0.75, 1k, seed 3.
Fartuch, sweter, światło z okna i ekspres do espresso zostały; dzbanek na mleko, filiżanka i kąt kamery się przesunęły. Przy 0.75 spodziewaj się, że treść się utrzyma, a drobna mechanika odpłynie. Jeśli jeden detal jest ważny, zejdź do 0.7.
Czego nie potrafi
- Nie wykonuje instrukcji edycji. Prośba do istniejącej ilustracji o nowy strój albo zmianę dnia na noc zmieniła bardzo niewiele przy 0.6–0.8, a przy wyższym strength dodała pseudo-tekst. Prompt opisuje wynik; to nie jest polecenie.
- Nie ma maski. Nie możesz chronić fragmentu ani przemalować tylko jednego.
- Jeden obraz źródłowy na żądanie, bez promptu negatywnego, kroków i pól samplera.
- To model anime. Nie robi fotorealizmu i rysuje tylko jedno-dwa słowa tekstu.
- Stały seed nie gwarantuje identycznych pikseli. To samo żądanie z tym samym seedem dało nam trzy nieco różne renderingi w różnych momentach, więc zachowuj obrazy, które ci się podobają.
Zmiana stylu a edycja: co ten endpoint potrafi, a czego nie
| Chcesz | Działa? | Co zrobić |
|---|---|---|
| Zamienić całe zdjęcie w anime | Tak | Opisz zdjęcie, strength 0.75 |
| Zachować pozę i kadr | W większości | Nazwij pozę w prompcie; obniż strength o 0.05 |
| Zastosować styl LoRA na zdjęciu | Tak | LoRA wytrenowana pod Animę, słowa wyzwalające, strength 0.75 |
| Zmienić jeden przedmiot albo strój | Nie | Opisz gotowy obraz i zaakceptuj pełne przerysowanie |
| Zmienić porę dnia | Nie | Tak samo jak wyżej |
| Chronić albo przemalować fragment | Nie | Maska nie jest dostępna |
| Uzyskać fotorealizm | Nie | Anima to model anime |
Wpychanie zdjęcia w konkretny styl za pomocą LoRA
Anima Turbo LoRA przyjmuje do trzech wpisów loras, każdy to bezpośredni link HTTPS do pliku .safetensors plus scale. Nazwa modelu w API to circlestone-labs/anima-turbo-lora/edit; ładowanie LoRA nie wiąże się z osobną opłatą. Używaj LoRA wytrenowanych pod Anima: LoRA wytrenowana pod inny model bazowy załadowała się bez błędu i w naszym teście niczego nie zmieniła.
Wygląd PC-98, strength 0.75. Z LoRA stylu PC-98 gal od Melon-Bread przy scale 1 zdjęcie mężczyzny na dachu przejęło rastrowy styl z ograniczoną paletą z gier komputerowych lat 90., z zachowaną kompozycją. Prompt otwierały słowa wyzwalające:
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, ...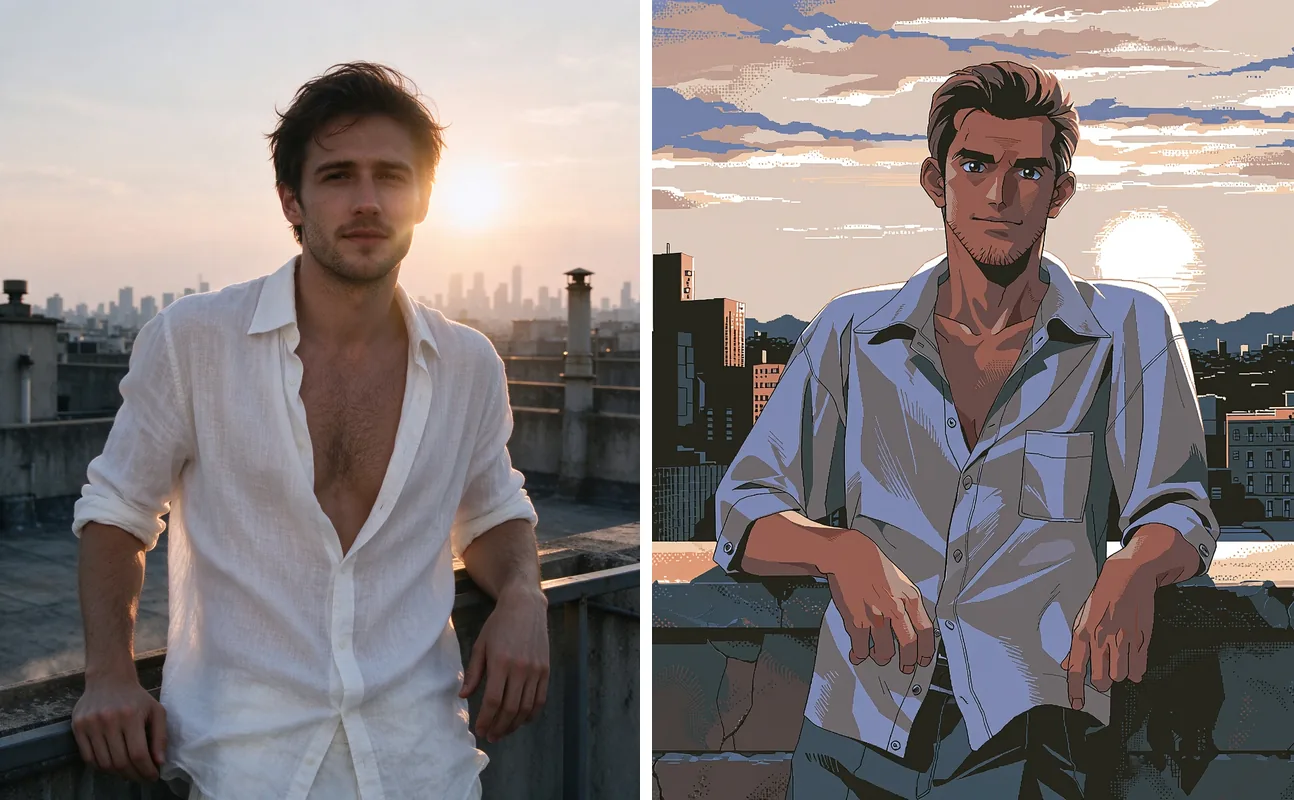
Po lewej: zdjęcie źródłowe (stockowe). Po prawej: Anima Turbo LoRA obraz na obraz, LoRA PC-98 przy scale 1, strength 0.75, 1k, seed 42.
Ta sama LoRA na naszym zdjęciu z gitarą, między zwykłą wersją anime a źródłem:
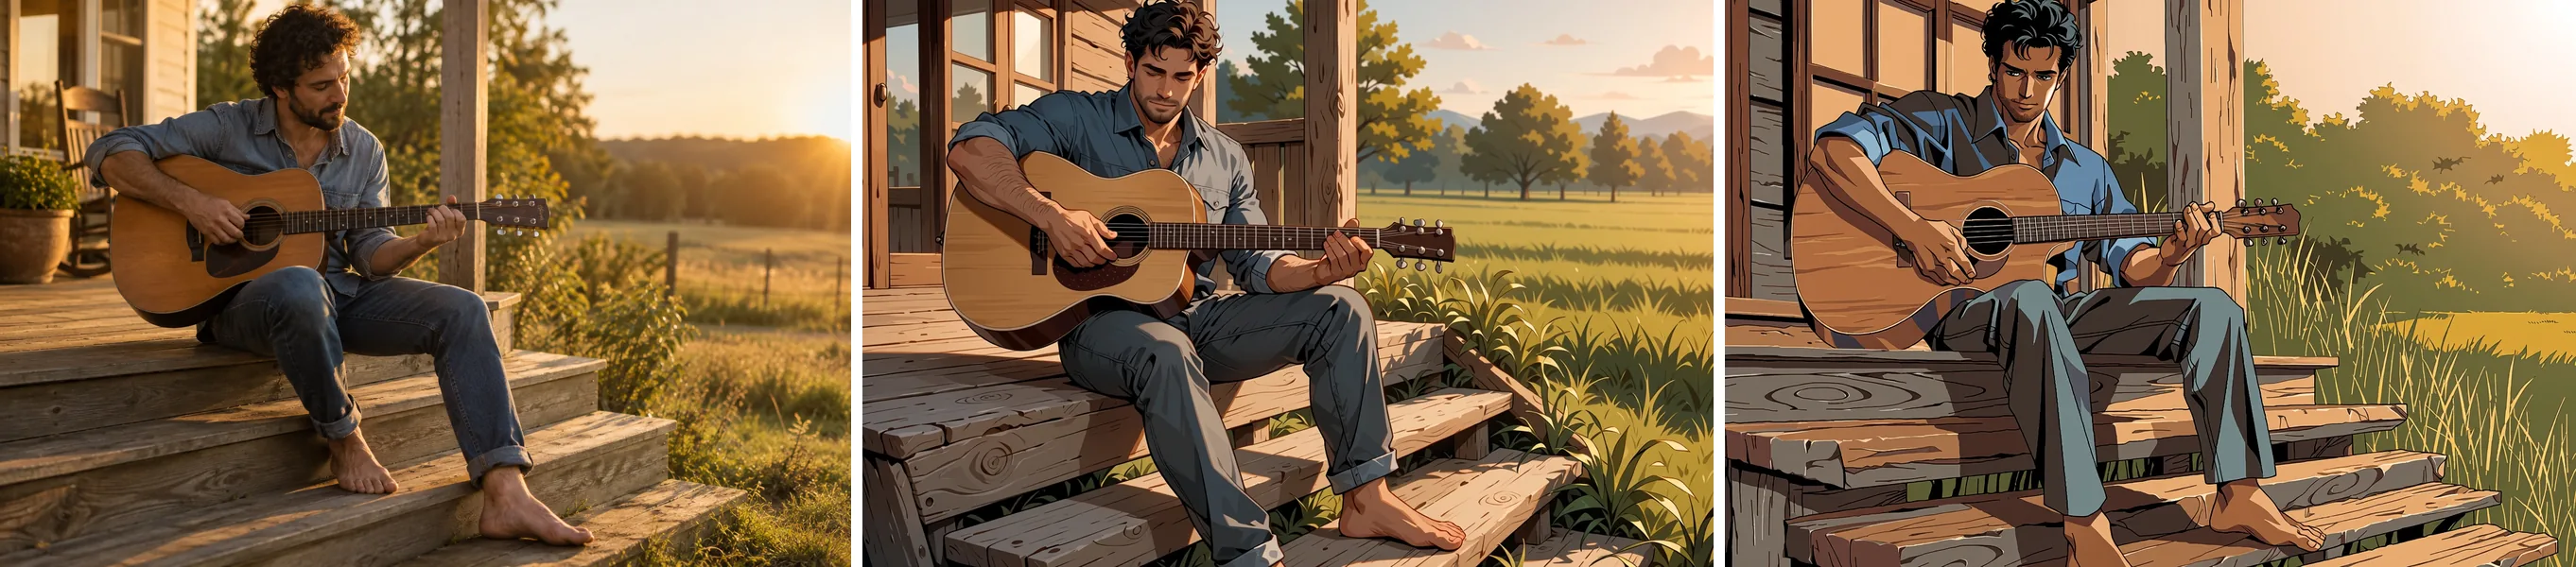
Od lewej do prawej: zdjęcie źródłowe (wygenerowane przez nas); Anima Turbo przy strength 0.75; Anima Turbo LoRA z LoRA PC-98 przy scale 1, strength 0.75. 1k, seed 3.
Tusz mangi, strength 0.85. LoRA monochromatyczna od notverriegod wymaga w prompcie monochrome, greyscale; bez nich nasz test został w kolorze. Zamiana kolorowej ilustracji w tusz wymagała 0.85, bo przy 0.8 kolor został, a przy tym strength poza jest przerysowywana.
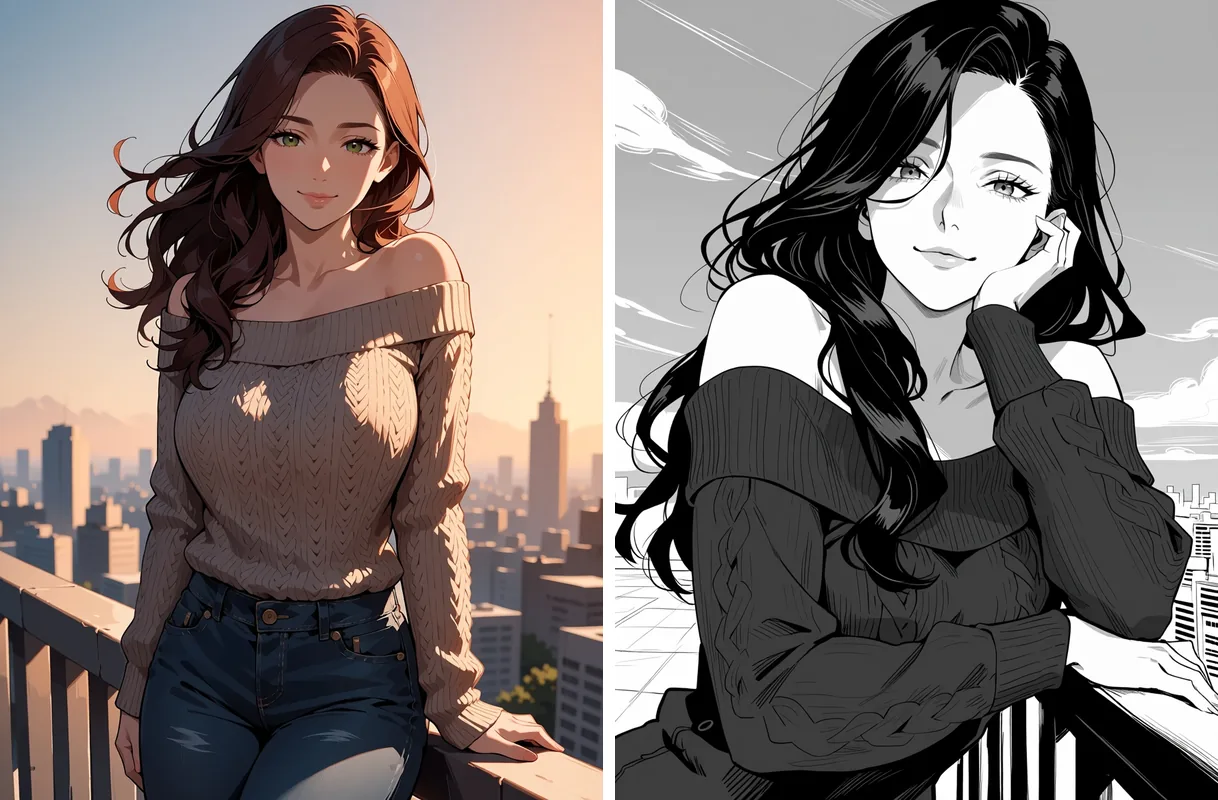
Po lewej: kolorowa ilustracja Anima Turbo (nie fotografia). Po prawej: Anima Turbo LoRA obraz na obraz, LoRA monochromatyczna, strength 0.85, 1k.
Na zdjęciu ze skuterem ta sama LoRA zachowała kolor punktowy na skuterze i sukni (zobacz prawy panel wyżej). Użyteczne scale LoRA w naszych testach mieściły się od około 0.5 do 1.2; scale 4 rozbijało obraz na abstrakcyjne kształty.
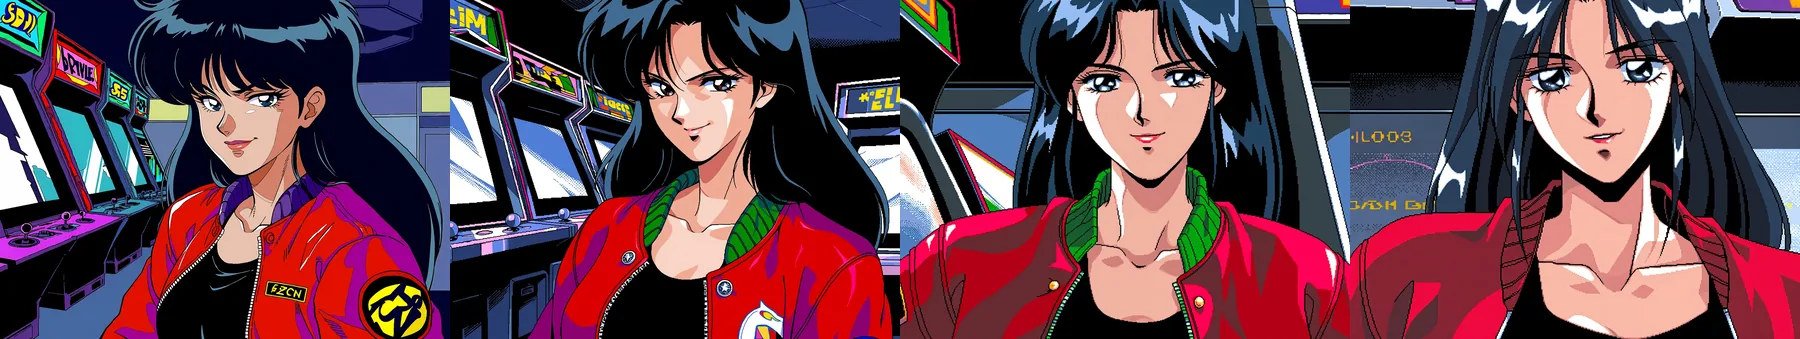
Od lewej do prawej: LoRA PC-98 przy scale 0, 0.5, 1 i 1.5. Anima Turbo LoRA tekst na obraz, 1k, ten sam prompt i seed. Przy 0 LoRA jest wyłączona; 1 to pełny styl; 1.5 pcha go mocniej.
Rozwiązywanie problemów
- Zdjęcie wciąż przebija: zwiększ
strengtho 0.05 i uruchom ponownie. - Twarz albo poza odpływa: zmniejsz o 0.05 i nazwij pozę w prompcie.
- W rogu jest bazgroł albo pseudo-tekst: zmień
seed. Widzieliśmy to mniej więcej na co piątym obrazie, a żaden prompt negatywny tego nie stłumi. Przycięcie kilku procent też pomaga. - LoRA niczego nie zmienia: sprawdź, czy została wytrenowana pod Anima, i dodaj jej słowa wyzwalające.
- Chcesz zmienić jedną rzecz na obrazie: to złe narzędzie. Anima zmienia styl całych obrazów i nie ma maski ani instrukcji edycji.
Werdykt: do zamiany zdjęć w anime Anima Turbo jest szybka i przewidywalna, gdy zaakceptujesz, że strength to jedyne pokrętło. Zacznij od 0.75, opisz zdjęcie, a poprawki wydawaj na seedy, a nie na przepisywanie promptu.
FAQ
Jakiego strength użyć, żeby zamienić zdjęcie w anime?
Zacznij od 0.75. W naszych testach dawało czyste anime z zachowaną kompozycją; niższe wartości zachowują więcej z fotografii, a wyższe zaczynają zmieniać szczegóły. Koryguj co 0.05.
Czy Anima Turbo obsługuje prompty negatywne?
Nie. Nie ma pola promptu negatywnego, kroków, CFG ani samplera. Tag oceny na początku promptu (my używamy safe) to główny sposób na nadanie tonu.
Czy mogę kazać zmienić jedną rzecz na moim obrazie?
Nie. Model zmienia styl całego obrazu i nie wykonuje instrukcji edycji; prośba o nowy strój albo scenę nocną na ilustracji zmieniła bardzo niewiele przy 0.6–0.8. Opisz zamiast tego gotowy obraz i licz się z pełnym przerysowaniem.
Dlaczego wynik ma inny kształt, niż prosiłem?
Bo obraz na obraz nie ma pola proporcji. Wynik zachowuje kształt źródła (zdjęcie 16:9 dało 1360 x 752 na poziomie 1k), więc najpierw przytnij zdjęcie.
Skąd podpis albo pseudotekst w rogu?
Model wyniósł ten nawyk z grafik. Widzieliśmy to mniej więcej na co piątym obrazie. Zmień seed albo przytnij kilka procent z tej krawędzi; żaden prompt negatywny tego nie stłumi.
Czy stały seed daje ten sam obraz?
Niezawodnie nie. To samo żądanie z tym samym seedem dało nam trzy nieco różne renderingi w różnych momentach, więc seedy pozwalają porównywać przebiegi, ale obrazy, które ci się podobają, zachowuj.
Czy mogę używać LoRA z innych modeli?
Tylko LoRA wytrenowanych pod Animę. LoRA wytrenowana pod inny model bazowy załadowała się bez błędu i w naszym teście niczego nie zmieniła. Użyj Anima Turbo LoRA z maksymalnie trzema linkami do plików .safetensors.
Jak szybko działa?
W 60 przebiegach czas modelu wynosił od 2 do 16 sekund na obraz, a 52 z nich zajęły poniżej 10 sekund. Pierwsze żądanie z nową LoRA może trwać dłużej, gdy plik jest pobierany.