Prefect Pony XL LoRA pozwala wczytać do trzech własnych LoRA do Pony na checkpoint anime bez cenzury i kręcić pokrętłem guidance od 1 do 20. W naszych testach z 5 października 2026 czas modelu wynosił od 1,6 do 23,8 sekundy na obraz, z medianą 12,3 sekundy w 47 przebiegach, a nasz najmocniejszy prompt testowy wygenerował się zgodnie z opisem, z wczytaną LoRA i bez niej. Jedna pułapka, o której warto wiedzieć na starcie: LoRA wytrenowana pod inny model bazowy wczytuje się bez błędu i niczego nie zmienia.
Prefect Pony XL LoRA uruchamia Prefect Pony XL, społecznościowy merge na architekturze SDXL z linii Pony Diffusion V6, dostrojony pod anime i ilustracje. Strona na Civitai podaje jako autora Goofy_Ai, a najnowszą wersję, v6, opublikowano 14 sierpnia 2025; wydawca naszego endpointu nie podaje, którą wersję uruchamia, więc my też tego nie robimy. Ten poradnik opisuje to, co zmierzyliśmy: słowa wyzwalające, scale, guidance, łączenie LoRA, rozmiary i typowe błędy. Wszystkie poniższe prompty to codzienne sceny z ubranymi dorosłymi, a to w zupełności wystarczy, by poznać sterowanie.
W skrócie
| Pytanie | Odpowiedź (test z 5 października 2026) |
|---|---|
| Model | Prefect Pony XL, merge do anime i ilustracji (architektura SDXL) |
| Nazwa modelu w API | prefect/pony-xl-lora/text-to-image |
| Pole LoRA | loras: do 3 wpisów, każdy {path, scale}; czwarty jest odrzucany |
path | Publiczny, bezpośredni link HTTPS do pliku .safetensors wytrenowanego pod model SDXL z rodziny Pony |
scale | Od 0 do 4; wydawca sugeruje start około 0.7 do 1.0 |
| Guidance | guidance_scale od 1 do 20, domyślnie 3.5 |
| Rozmiary | Dziewięć proporcji obrazu na natywnych rozmiarach SDXL, od 640×1536 do 1536×640 |
| Szybkość w naszych testach | 1,6 do 23,8 sekundy czasu modelu, mediana 12,3 (47 przebiegów) |
| Niedostępne | Obraz wejściowy, prompt negatywny, liczba kroków |
| Rozliczenie | Jedna stała stawka za obraz; rozmiar, liczba LoRA i format wyjściowy jej nie zmieniają |
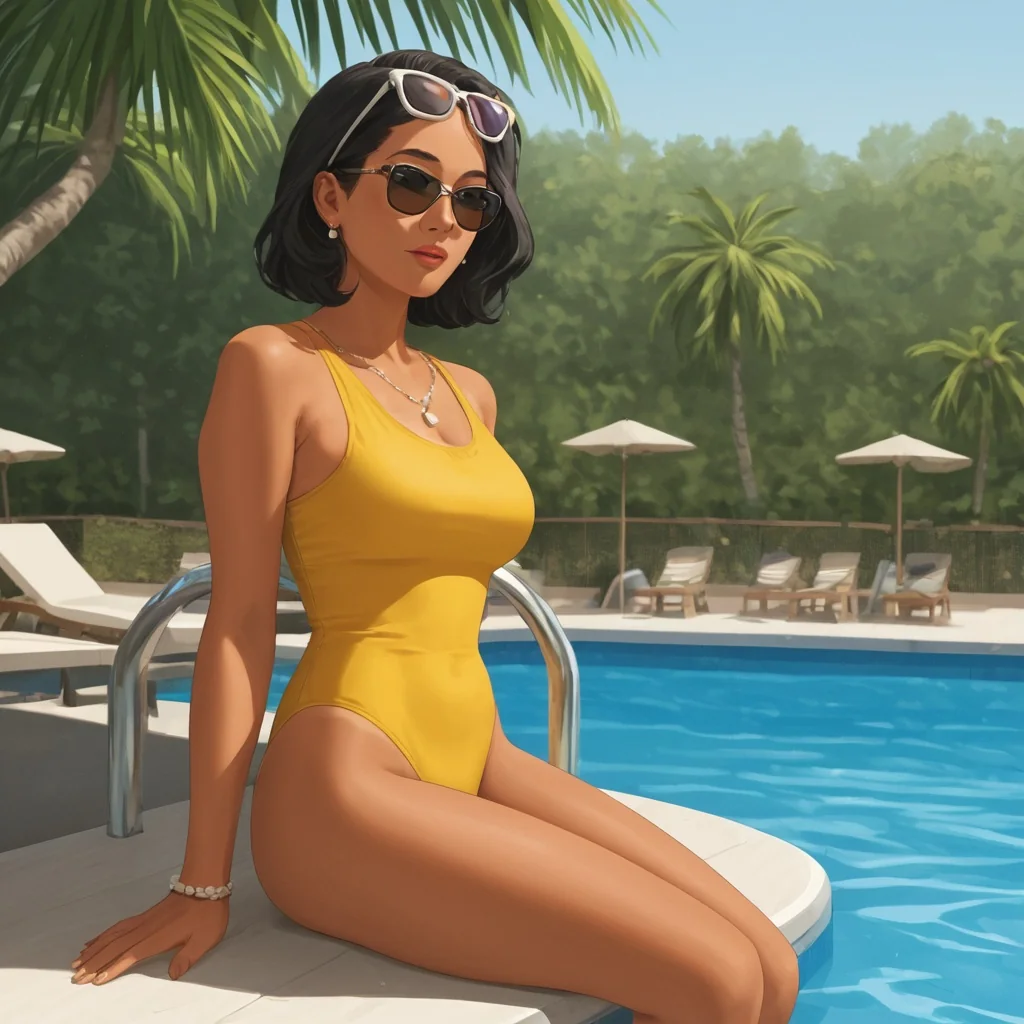
Prefect Pony XL LoRA, tekst na obraz, 1:1, seed 33, LoRA Flat Vector przy scale 1. Prompt jest podany poniżej.
Co to jest LoRA do Pony
LoRA do Pony to plik adaptera wytrenowany pod model SDXL z rodziny Pony. Wskazówka wydawcy dla tego endpointu jest jednoznaczna: używaj wyłącznie LoRA wytrenowanych pod modele SDXL z rodziny Pony. Użyliśmy trzech publicznych adapterów z repozytorium EarthnDusk na Hugging Face oraz jednego do pixel artu:
- Flat Vector, wyzwalacz
vztdzsxx. Dał czystą, płaską ilustrację wektorową. - InkPunk, wyzwalacz
end_inkpunk_style. Dał kreskę tuszem z rozlewami i plamami. - Art Deco, wyzwalacz
end_artdeco_inspo. Dał złote, geometryczne wnętrza z lat 20.
Lista kontrolna przed wyborem kolejnej LoRA do Pony:
- Model bazowy: na karcie jest Pony lub Pony XL, a nie SD 1.5, Illustrious, Z-Image ani FLUX.
- Plik, do którego da się dać link: repozytorium zawiera plik
.safetensorsi można zbudować linkresolve/main/. - Publiczny dostęp: repozytorium otwiera się bez logowania. Zablokowane kończą się komunikatem HTTP 401.
- Słowo wyzwalające: karta je podaje albo pisze, że nie jest potrzebne. Skopiuj je dokładnie.
- Licencja: przeczytaj licencję na karcie samej LoRA; ustala ją autor adaptera.
Pierwsze żądanie
Każdy wpis w loras przyjmuje bezpośredni link i scale. Oto całe żądanie dla obrazu z basenem powyżej:
{
  "model": "prefect/pony-xl-lora/text-to-image",
  "prompt": "vztdzsxx, vector art, flat color, vector illustration, score_9, score_8_up, score_7_up, source_anime, rating_safe, 1girl, solo, mature female, adult woman, tanned skin, long black hair, yellow one-piece swimsuit, sunglasses on her head, sitting at the edge of a swimming pool, palm tree shadows, summer afternoon",
  "aspect_ratio": "1:1",
  "seed": 33,
  "loras": [
    {
      "path": "https://huggingface.co/EarthnDusk/Loras2024/resolve/main/Flat_Vector_Art_PDXL.safetensors",
      "scale": 1
    }
  ]
}
Kolejność w prompcie, która działała z każdą wypróbowaną LoRA stylu: najpierw słowo wyzwalające, potem tagi jakości, potem tag źródła, tag oceny i scena. Wydawca pisze, że prompty w formie tagów działają dobrze, i zaleca score_9, score_8_up, score_7_up na początku bloku jakości. Przy promptowaniu Pony używa się też tagów źródła, takich jak source_anime, oraz tagów oceny: rating_safe, rating_questionable. W każdym prompcie piszemy adult woman albo mature male. Domyślny format wyjściowy to JPEG; PNG i WebP są opcjami i niczego poza formatem nie zmieniają. Parametry i aktualne ceny znajdziesz na stronie tekst-na-obraz.
Słowa wyzwalające: każda LoRA stylu chciała własnego
Adaptery Flat Vector, InkPunk i Art Deco zmieniały wygląd, gdy ich wyzwalacz stał na początku promptu. Najlepiej widać to na InkPunk: z end_inkpunk_style, inked, ink wash, ink splatter na przedzie kobieta w skórzanej kurtce na motocyklu wróciła jako mokra, malarska scena nocna przy scale 0.9.
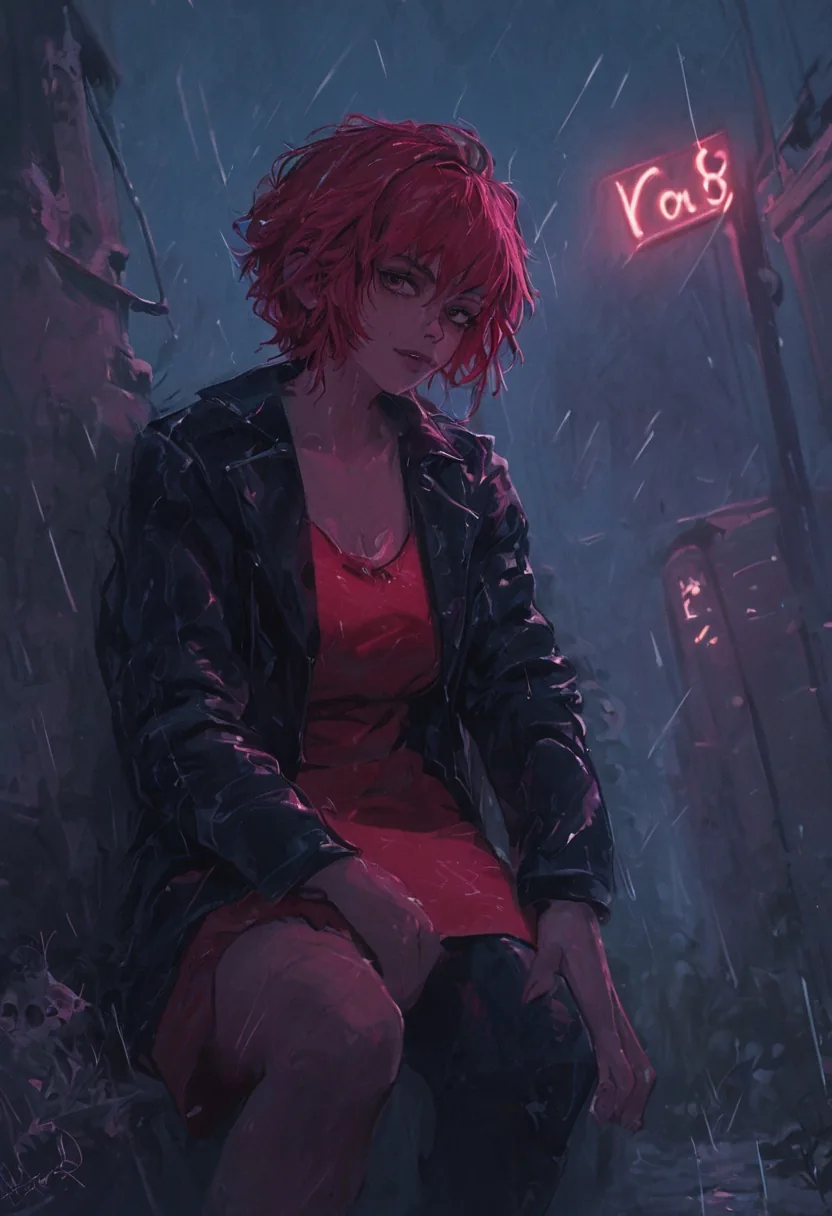
Prefect Pony XL LoRA, tekst na obraz, 832×1216 (2:3), seed 31, LoRA InkPunk przy scale 0.9.
Przeczytaj kartę, żeby poznać wyzwalacz, daj go na początek i resztę promptu zostaw w zwykłej kolejności tagów. Ten sam trik utrzymuje cały zestaw: zmieniasz linię z tematem, zostawiasz LoRA, scale i tagi jakości, a obrazy mają wspólny wygląd. Oto detektyw z tą samą LoRA przy 0.8:
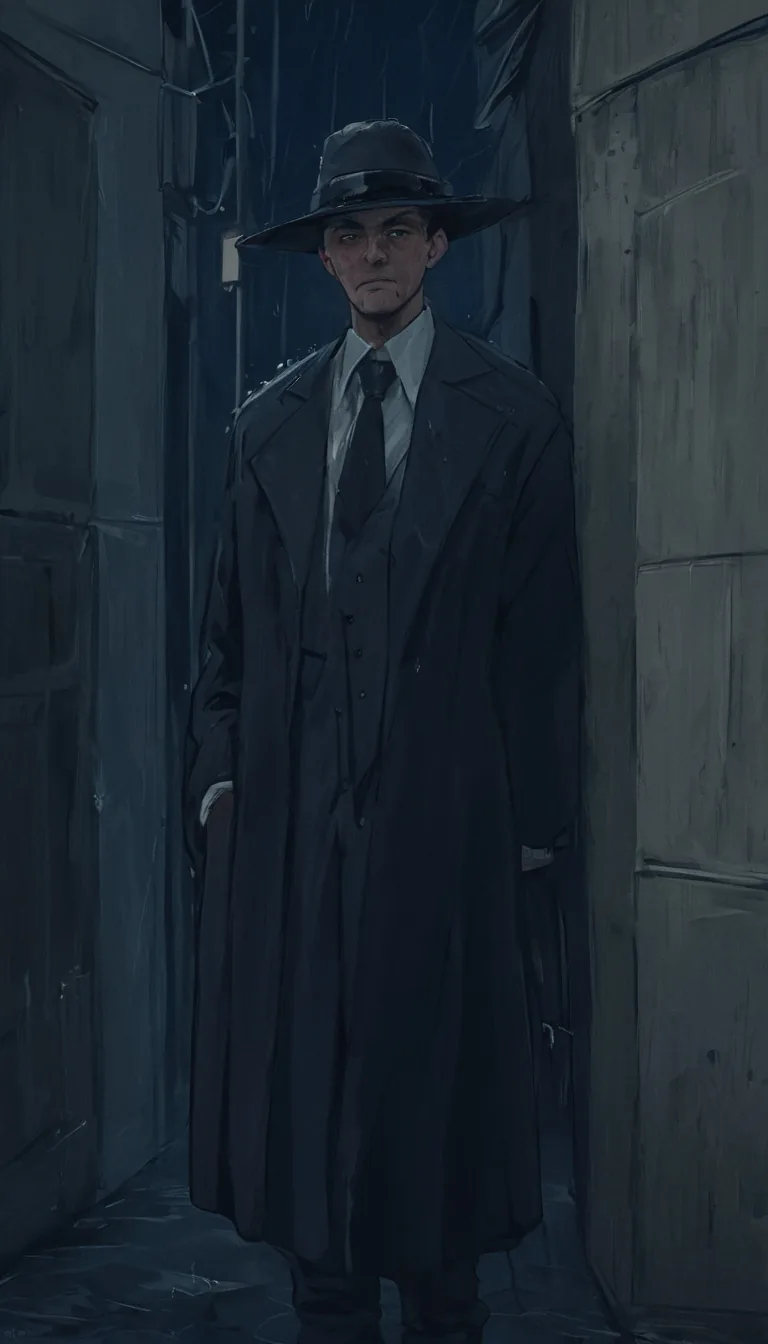
Prefect Pony XL LoRA, tekst na obraz, 768×1344 (9:16), seed 35, LoRA InkPunk przy scale 0.8.
Scale: jak mocno LoRA naciska
scale mieści się w przedziale od 0 do 4. W naszych testach LoRA do pixel artu przy 1 zamieniła cały kadr w pixel art, a przy 0.5 dała lżejszy efekt, więc scale to prawdziwe pokrętło, a nie przełącznik włącz/wyłącz. Wydawca sugeruje start około 0.7 do 1.0 i lekkie obniżanie każdego scale przy łączeniu adapterów. Nasze opublikowane przykłady mieszczą się w tym paśmie: InkPunk przy 0.8 i 0.9, Flat Vector i Art Deco przy 1.
| Scale | Co robi | Do czego |
|---|---|---|
| 0 | Najniższa wartość, jaką przyjmuje pole | Niesprawdzone na tym endpoincie |
| 0.5 | Lżejszy efekt (LoRA do pixel artu, w naszym teście) | Przyprawa albo drugi adapter w zestawie |
| 0.7 do 1.0 | Pasmo startowe sugerowane przez wydawcę | Domyślne dla pojedynczego stylu |
| Powyżej 1 | Przyjmowane do 4 | Tylko gdy 1 nadal wygląda zbyt łagodnie; przetestuj, zanim na tym oprzesz pracę |
Nie przeprowadziliśmy pełnej drabinki powyżej 1 na tym endpoincie, więc nie opisujemy, jak wyglądają tu 2 czy 4. Jeśli je wypróbujesz, zmieniaj jedną liczbę naraz i trzymaj stały seed.
Guidance od 1 do 20: gdzie jest optimum
Ten endpoint ma guidance_scale od 1 do 20, domyślnie 3.5. Nasze odczyty z serii na jednym prompcie i seedzie:
| Guidance | Co zobaczyliśmy |
|---|---|
| 0 | Prompt został całkowicie zignorowany; wrócił niepowiązany szkic. Dlatego publiczny zakres zaczyna się od 1 |
| 1 | Wyprane i miękkie |
| 3.5 | Zrównoważone; wartość domyślna |
| 7 | Więcej kontrastu i więcej nasycenia |
| 12 | Przepalone: ostre i przesycone |
Zwiększaj go małymi krokami od 3.5, gdy wygląd LoRA potrzebuje więcej pazura. Tango Art Deco otwierające ten poradnik użyło 5, co utrzymało złoto wyraźne, nie przepalając go. Nie szukaj jakości powyżej 12; górna część zakresu istnieje, ale nie mamy do niej zastosowania.
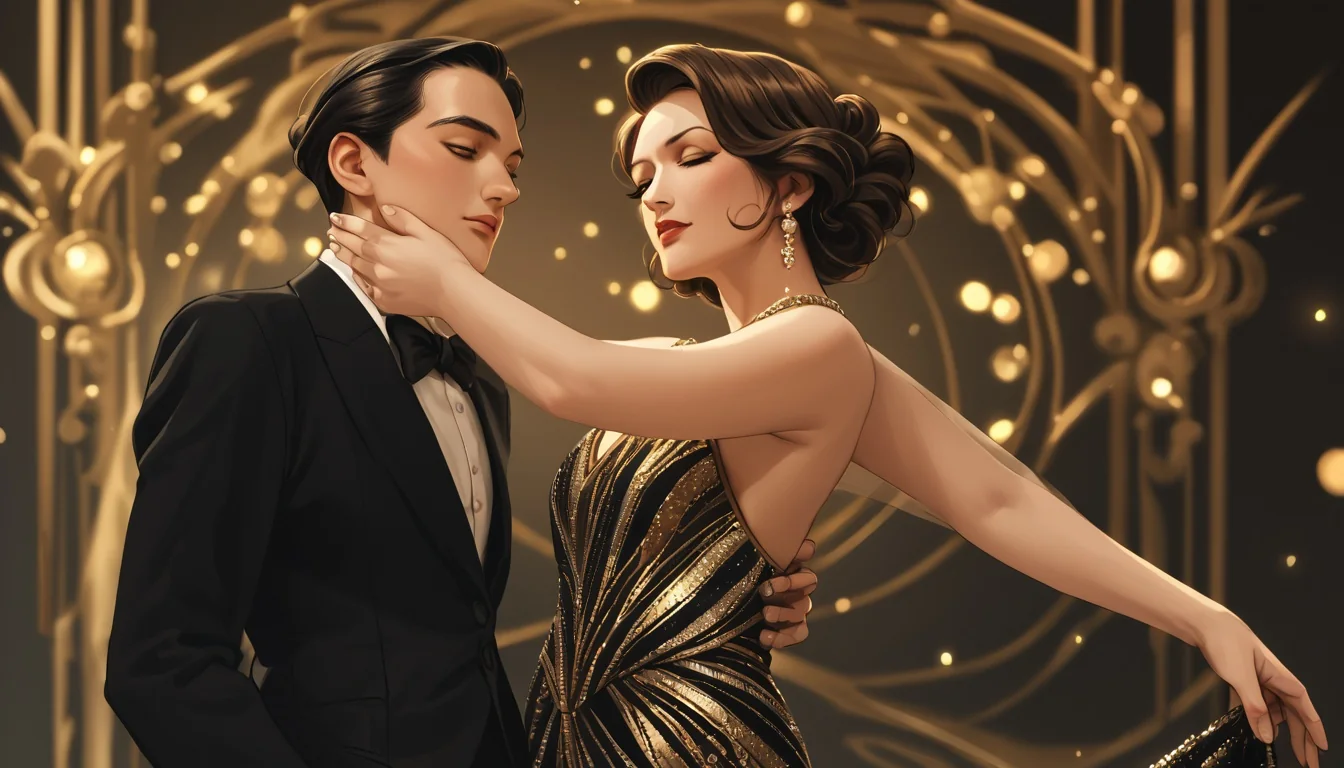
Prefect Pony XL LoRA, tekst na obraz, 16:9 (1344×768), seed 34, LoRA Art Deco przy scale 1, guidance 5.
Łączenie trzech LoRA
Możesz wczytać do trzech; czwarta jest odrzucana. W naszych testach trzy LoRA przy 0.8, 0.5 i 0.3 działały razem, a główny styl pozostał czytelny. Reguła, która się sprawdziła: najważniejszy styl daj najwyżej, pozostałe niżej, a przy łączeniu obniż każdy scale odrobinę w porównaniu z samodzielnym użyciem. Jeśli obraz się zamula, usuń adapter, zanim ruszysz prompt.
Uwaga o tym, czego nie testowaliśmy: na naszym najmocniejszym prompcie testowym uruchamialiśmy żądania z jedną LoRA i nie łączyliśmy na nim kilku adapterów, więc nie twierdzimy nic o takim połączeniu.
Cichy błąd: LoRA do innego modelu bazowego
LoRA wytrenowana pod inny model bazowy wczytuje się bez błędu i niczego nie zmienia. Wczytaliśmy na tym endpoincie LoRA do Z-Image: żądanie się powiodło, a obraz był identyczny co do piksela z przebiegiem bez pliku. Jeśli ten sam prompt i seed wyglądają tak samo z adapterem i bez niego, został wytrenowany pod inny model.
Sprawdzenie kosztuje dwa obrazy. Uruchom prompt raz bez LoRA i raz z nią, z tym samym seedem, i porównaj. Niektóre style są subtelne, więc oceniaj po tym, czy styl słowa wyzwalającego w ogóle się pojawia.
Dlaczego żądanie się nie powiodło albo LoRA nic nie zrobiła
| Objaw | Przyczyna | Rozwiązanie |
|---|---|---|
| Powodzenie, obraz identyczny jak bez LoRA | Adapter wytrenowany pod inny model bazowy | Porównaj z plikiem i bez, ten sam seed; znajdź LoRA do Pony |
| Styl ledwo widoczny | Brak wyzwalacza albo za niski scale | Daj wyzwalacz na początek; spróbuj 0.8 do 1 |
| Błąd z prośbą o bezpośredni link do pobrania | Wklejono stronę repozytorium, a nie plik | Użyj linku resolve/main/...safetensors |
Failed to load LoRA ... 401 | Zablokowane repozytorium wymagające logowania | Wybierz plik publiczny |
| Odrzucone przy wysyłaniu | Więcej niż trzy LoRA, scale powyżej 4, guidance powyżej 20 albo pusty prompt | Popraw żądanie |
| Niepowiązany szkic | guidance_scale równe 0 | Zostań przy 1 lub więcej |
Błędy linku i zablokowanego pliku wracają jako nieprawidłowe żądania.
Rozmiary: zostań przy dziewięciu proporcjach
Dziewięć proporcji obrazu odpowiada natywnym rozmiarom SDXL i wszystkie dziewięć zakończyło się dokładnie zażądanym rozmiarem:
| Proporcje | Rozmiar |
|---|---|
| 1:1 | 1024×1024 |
| 16:9 | 1344×768 |
| 9:16 | 768×1344 |
| 4:3 | 1152×896 |
| 3:4 | 896×1152 |
| 3:2 | 1216×832 |
| 2:3 | 832×1216 |
| 21:9 | 1536×640 |
| 9:21 | 640×1536 |
Upstream przyjmuje od 256 do 1536 na bok, ale gdy wyszliśmy poza natywne kształty, 1536×864 narysowało zdublowane postacie w trzech próbach na cztery. Dlatego publiczne API oferuje tylko kształty natywne. Żądanie tworzy jeden obraz: nie ma liczby w partii.
Codzienne prompty, które działały bez LoRA
Endpoint równie dobrze radzi sobie bez żadnej LoRA. Ten barman powstał z promptu w tagach, z niczym wczytanym:
score_9, score_8_up, score_7_up, source_anime, rating_safe, 1boy, solo, mature male, adult man, 30 years old, messy black hair, stubble, white shirt open at the collar, rolled sleeves, forearm tattoos, bartender pouring a cocktail behind a bar, warm amber light, bottles on shelves, smile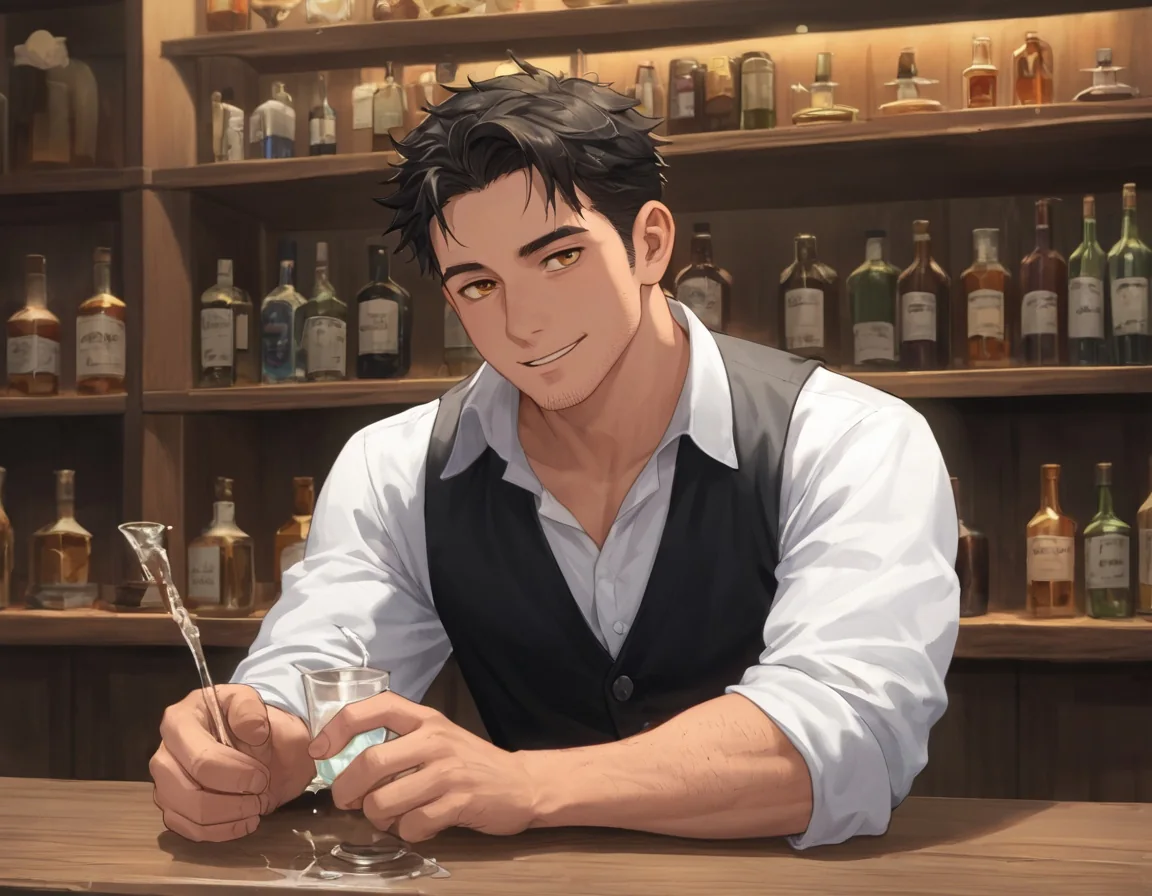
Prefect Pony XL LoRA, tekst na obraz, 4:3 (1152×896), seed 32, bez LoRA.
Ten sam przepis z adapterem InkPunk przy 0.8, mężczyzna na pustynnej stacji benzynowej o zmierzchu:
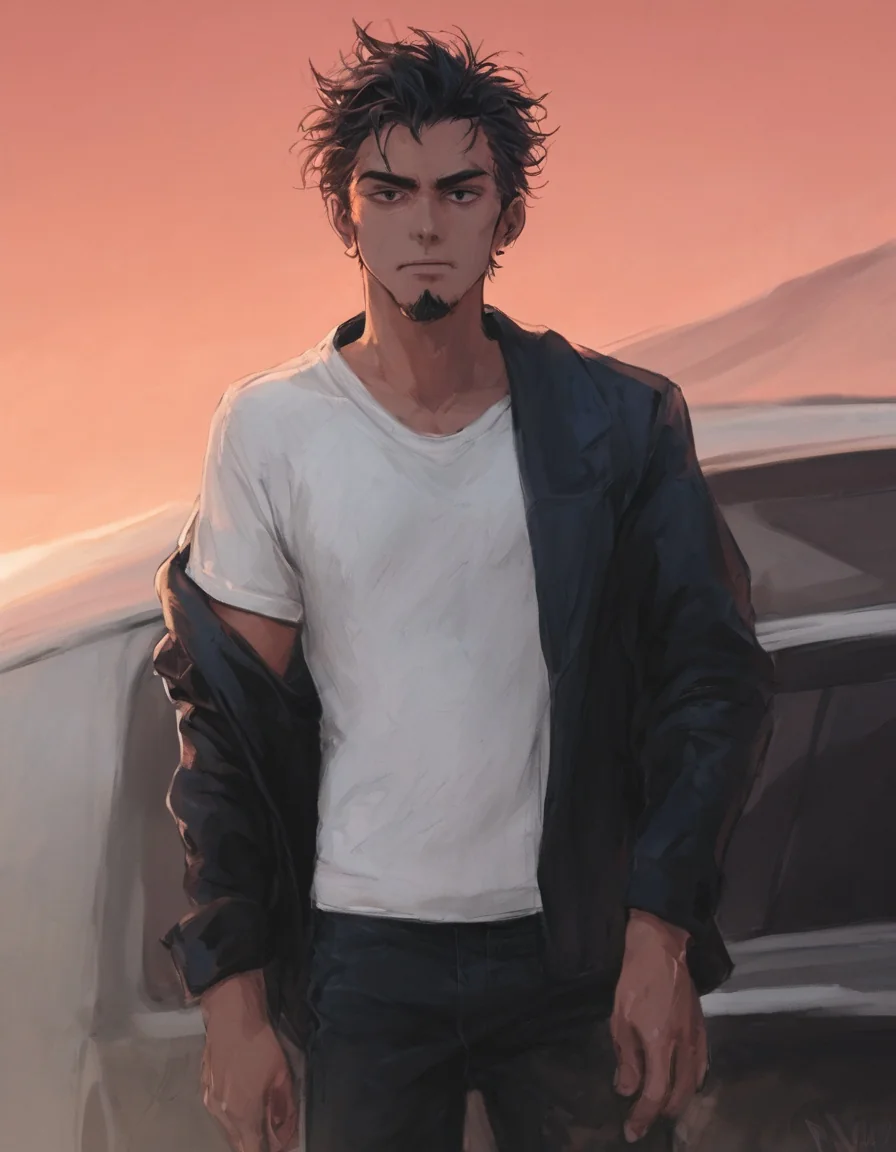
Prefect Pony XL LoRA, tekst na obraz, 3:4 (896×1152), seed 62, LoRA InkPunk przy scale 0.8.
Jak daleko to sięga
Te endpointy są bez cenzury: platforma nie dodaje żadnego filtra treści. Przeszliśmy siedmiostopniową drabinę treści na zwykłym endpoincie, z dorosłymi zaznaczonymi w każdym prompcie, i każdy stopień wrócił zgodnie z opisem: L1 Sugestywny (bielizna, zsuwające się ramiączko), L2 Dojrzałe motywy, L3 Mocny, L4 Intensywny (intymna scena między dwojgiem dorosłych), L5 Ekstremalny (dobrowolne skrępowanie między dorosłymi albo filmowy gore). Męska wersja stopnia z nagością również wróciła zgodnie z opisem. W stopniu z gore krew i rany się wyrenderowały; odcięta kończyna nie. To odczyt z jednego przebiegu na stopień, a nie gwarancja dla każdego promptu. Na najmocniejszych stopniach nie testowaliśmy więcej niż jednej LoRA.
Pony XL LoRA czy zwykły Prefect Pony XL
Zwykły Prefect Pony XL to ta sama rodzina checkpointów bez slotu na LoRA. Jego własna strona endpointu mówi, że nie ma slotu na LoRA, obrazu wejściowego, promptu negatywnego ani liczby w partii, przyjmuje size z zestawu natywnych kształtów SDXL i rozlicza za obraz. Rodzina LoRA dodaje pole loras i pokrętło guidance_scale.
| Czego chcesz | Wybierz |
|---|---|
| Anime z promptów w tagach, bez konkretnego pliku stylu | Prefect Pony XL |
| Nazwanego stylu, postaci albo wyglądu danego autora z LoRA do Pony | Prefect Pony XL LoRA, scale 0.7 do 1, wyzwalacz na początku |
| Dostrojenia kontrastu i nasycenia wyglądu LoRA | Prefect Pony XL LoRA, guidance od 3.5 do 7 |
| Stylu wytrenowanego pod inny model (FLUX, Z-Image, Illustrious) | Nie ten endpoint; użyj rodziny pasującej do pliku |
| Edycji istniejącego obrazu | Nie ten endpoint; nie ma obrazu wejściowego |
FAQ
Czy mogę użyć dowolnej LoRA z Hugging Face lub Civitai?
Tylko plików wytrenowanych pod modele SDXL z rodziny Pony i tylko jako publiczny, bezpośredni link do pliku .safetensors. Testowaliśmy linki z Hugging Face; linków z Civitai nie testowaliśmy.
Od jakiego scale zacząć?
Zacznij około 0.8 do 1, jak sugeruje wydawca, i zmieniaj małymi krokami. LoRA do pixel artu przy 0.5 dawała w naszych testach lżejszy efekt niż przy 1.
Ile LoRA mogę wczytać naraz?
Trzy; czwarta jest odrzucana. Trzy przy 0.8, 0.5 i 0.3 działały w naszych testach, a główny styl pozostał czytelny.
Co robi guidance na tym endpoincie?
Ustala, jak mocno prompt jest naciskany. Na jednym prompcie i seedzie 1 wyglądało na wyprane, 3.5 było zrównoważone, 7 miało więcej kontrastu i nasycenia, a 12 wyglądało na przepalone. Guidance równe 0 ignorowało prompt, więc publiczny zakres zaczyna się od 1.
Dlaczego moja LoRA niczego nie zmieniła?
Prawdopodobnie została wytrenowana pod inny model bazowy, a taki błąd jest cichy. LoRA do Z-Image wczytała się tu bez błędu, a obraz był identyczny z przebiegiem bez niej. Uruchom jedną parę z plikiem i bez niego.
Czy potrzebuję słowa wyzwalającego?
Każda użyta przez nas LoRA stylu chciała własnego: vztdzsxx, end_inkpunk_style i end_artdeco_inspo. Przeczytaj kartę, daj wyzwalacz na początek, a potem tagi jakości.
Czy mogę wybrać dowolny rozmiar?
Nie. Użyj dziewięciu proporcji obrazu. Poza natywnymi kształtami jeden testowy rozmiar rysował zdublowane postacie w trzech próbach na cztery.
Czy ten sam seed daje ten sam obraz?
Często, ale nie obiecuj tego. Jedna para identycznych żądań wysłanych w odstępie godziny wróciła identyczna co do piksela i nie polegalibyśmy na tym w potoku przetwarzania.