Workflow, który w naszych testach sprawdził się najlepiej: zaprojektuj jedną dorosłą postać w tagach, ustaw ton tagiem oceny, rób szkice w 1k, finalne wersje w 1.5k, dodaj LoRA ze stylem, a problemy naprawiaj zmianą ziarna albo scale, zamiast przepisywać prompt. Cały łańcuch przeszliśmy na Anima Turbo, modelu anime i ilustracji, który w SpicyAPI jest bez cenzury: nie ma filtra treści, a nasz najmocniejszy test treści narysował zgodnie z opisem już za pierwszym razem.
Ten poradnik to wersja praktyczna: osiem kroków od pomysłu do gotowego zestawu, każdy prompt przetestowany 5 października 2026. Każdy prompt wydrukowany tutaj to scena z ubranymi dorosłymi postaciami, co najwyżej zmysłowa, bo tylko takie publikujemy. Mocniejsze tony istnieją i dzieli je od ciebie jeden tag oceny; wyjaśniamy, jak działają tagi, bez drukowania ich.
W skrócie
| Krok | Co robisz | Kluczowe ustawienie | Co zobaczyliśmy |
|---|---|---|---|
| 1. Postać | Ustalasz wygląd w bloku tagów, którego używasz wielokrotnie | To samo ziarno, ten sam blok postaci | Jedna postać pozostała rozpoznawalna w trzech strojach |
| 2. Ton | Wybierasz tag oceny | safe lub sensitive | Prawie ten sam obraz dla sceny z ubraną postacią |
| 3. Scena | Wybierasz proporcje i poziom | Szkice w 1k, finały w 1.5k | 2 do 16 sekund na obraz |
| 4. Styl | Dodajesz LoRA | Scale 0.5 do 1.2 | Scale 4 rozbiło obraz |
| 5. Referencja | Zamieniasz zdjęcie lub szkic w anime | strength 0.75 | Czyste anime, kompozycja zachowana |
| 6. Ruch | Ożywiasz gotowy obraz (opcjonalnie) | Obraz plus prompt | Krótki klip z rodziny wideo bez cenzury |
| 7. Naprawa | Ponowne losowanie, obniżenie, korekta | Ziarno, scale, strength | Zawijasy podpisów i dryf da się naprawić |
| 8. Prywatność | Trzymaj wyniki prywatnie | Twoje własne miejsce na pliki | Twoja odpowiedzialność |
Krok 1: Zaprojektuj jedną dorosłą postać w tagach
Opisz postać raz, jako blok tagów, i wklejaj ten sam blok do każdego promptu. Anima rozumie tagi w stylu Danbooru, zwykłe zdania i mieszanki jednych i drugich. Wydawca, CircleStone Labs, opisuje konwencje tagów na karcie modelu: małe litery, spacje zamiast podkreślników i stała kolejność.
Kolejność, która u nas zadziałała:
- tagi jakości:
masterpiece, best quality, ewentualniescore_7 - tag oceny:
safelubsensitive(krok 2) - liczba postaci:
1girl,1boy,1girl, 1boy,no humans - informacja o wieku:
adult woman, mature femalelubmature male - blok postaci: włosy, oczy, jeden charakterystyczny znak
- strój, miejsce, poza, światło
Zawsze pisz w samym prompcie, że postać jest dorosła, żeby niosły to tagi.
Oto dowód, że blok postaci działa. Trzy obrazy poniżej mają jedno ziarno i jeden blok, short silver bob, golden eyes, beauty mark under the left eye. Zmieniały się tylko strój i miejsce: golf w galerii, czerwona jedwabna sukienka-halka na balkonie, za duża biała koszula na parapecie.
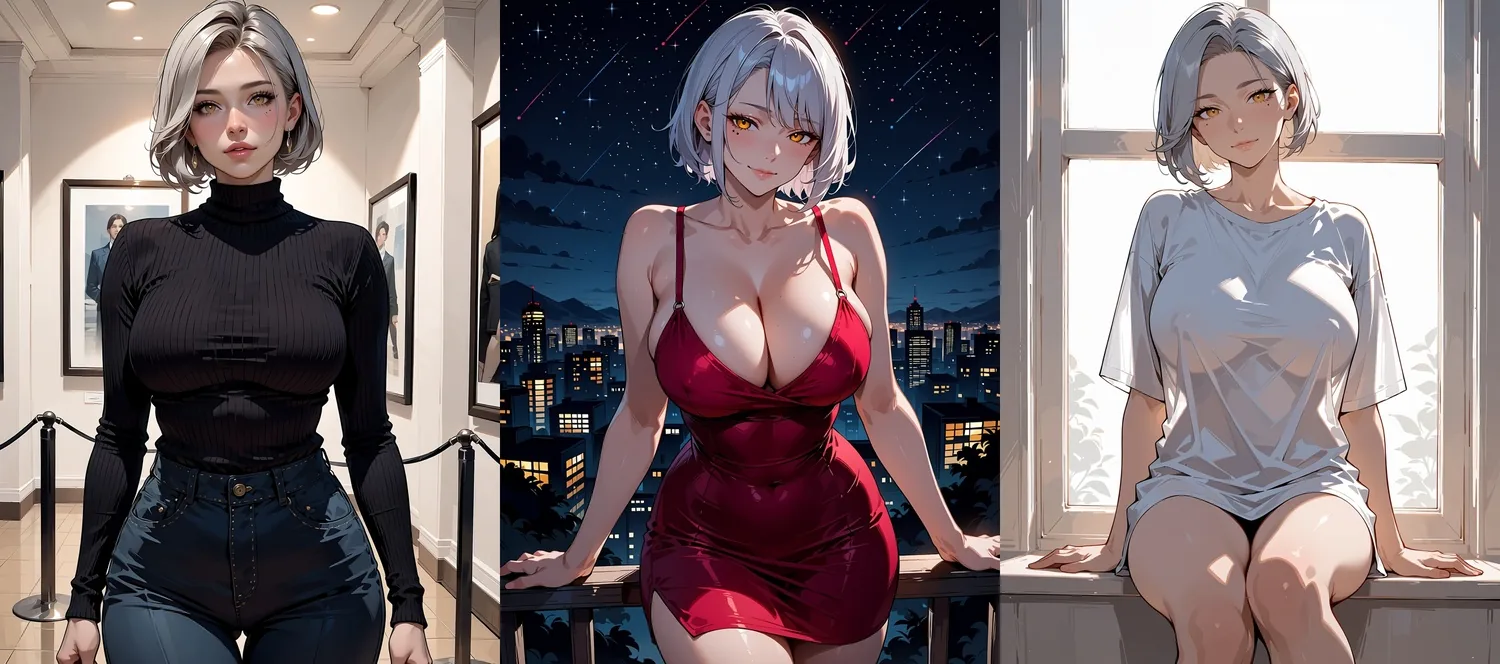
Jeden blok postaci, ziarno 31, trzy stroje (Anima Turbo, 1k, 3:4). Włosy, oczy i pieprzyk się przenoszą; poza i kadr zmieniają się z promptem.
Pierwszy prompt z tego zestawu, żebyś mógł skopiować kształt:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye, black turtleneck,
standing in an art gallery, looking at viewer
Pozostałe dwa zmieniają strój i miejsce oraz używają sensitive. Jeśli twarz dryfuje, gdy zmieniasz naraz wiele, zachowaj ziarno i zmieniaj tylko jedną frazę naraz.
Krok 2: Wybierz ton tagiem oceny
Ponieważ Anima nie ma promptu negatywnego, tag oceny to twoja główna kontrola nad tonem. Model zna safe, sensitive i nsfw oraz jeden mocniejszy tag. Wydawca opisuje dwa ostatnie jako tagi, które znoszą powściągliwość. Nie drukujemy promptów, które ich używają, i nie nazywamy najmocniejszego tagu, ale powinieneś wiedzieć, że istnieją, żeby wybierać świadomie.
Dla sceny z ubraną postacią safe i sensitive to bliscy kuzyni. Poniższa para używa tego samego promptu i tego samego ziarna, zmienia się tylko to jedno słowo. Kobieta w czarnej sukni wieczorowej w hotelowym barze wyszła za każdym razem niemal identycznie.
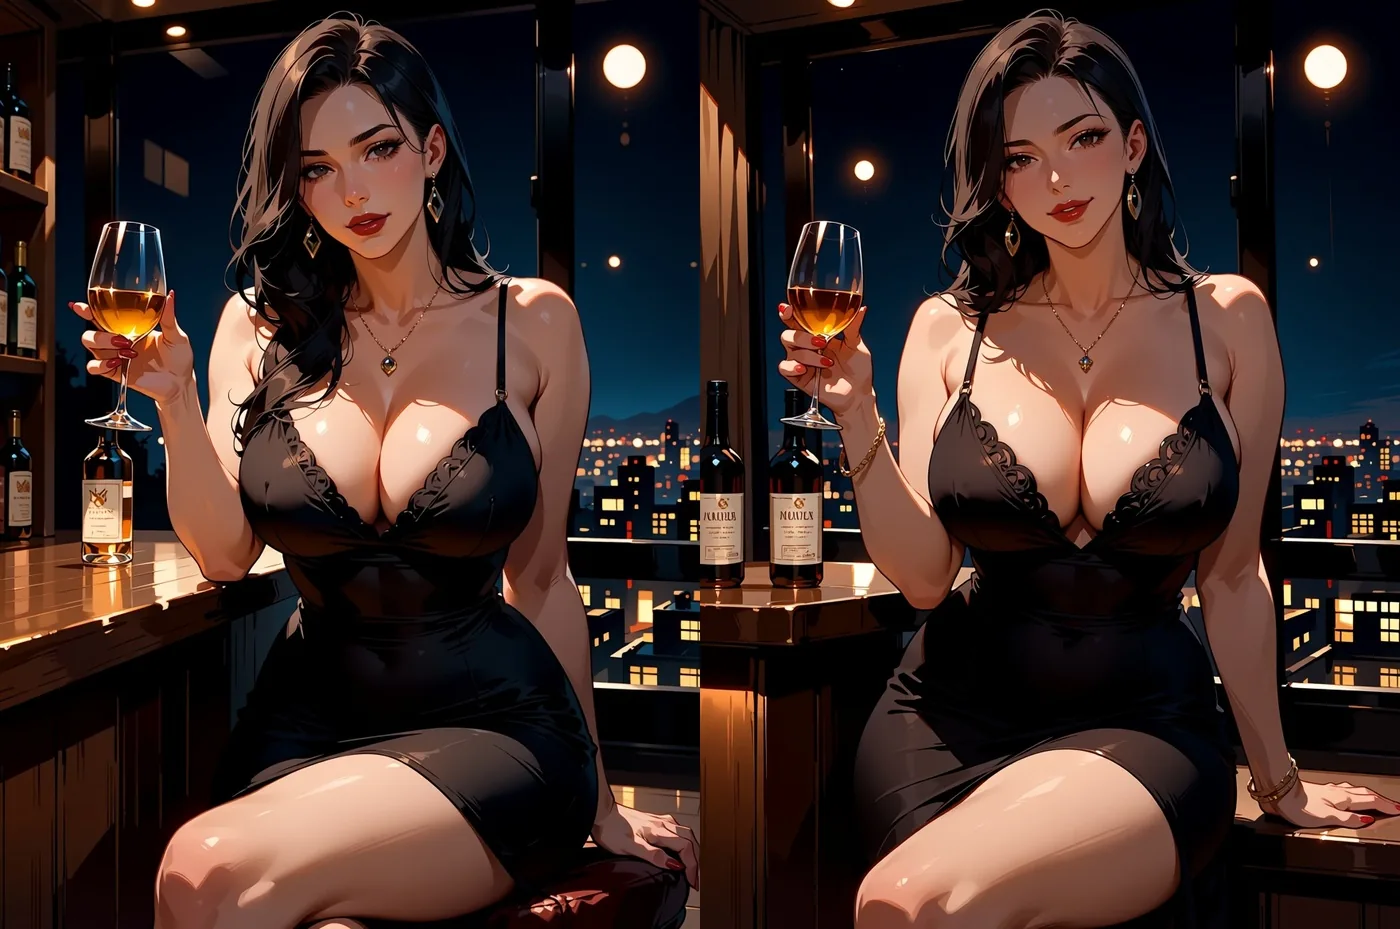
Ten sam prompt, to samo ziarno 27, po lewej safe, po prawej sensitive (Anima Turbo, 1k, 3:4).
| Tag oceny | Co sygnalizuje | Jak go używamy |
|---|---|---|
safe | Codzienny, powściągliwy | Domyślny dla pierwszych szkiców i wszystkiego, co zamierzasz udostępniać |
sensitive | Co najwyżej zmysłowy | Strój wieczorowy, zsuwające się ramiączko, taniec w objęciach |
nsfw | Znosi powściągliwość | Tylko praca dla dorosłych, na twoje ryzyko i odpowiedzialność |
| Jeden mocniejszy tag | Znosi ją jeszcze bardziej | To samo; przeczytaj kartę modelu |
W 25 zapytaniach na czterech poziomach treści, tekst na obraz i obraz na obraz, z LoRA i bez, nie zobaczyliśmy ani jednej odmowy ani jednego podstawienia. Anatomia i dłonie nadal wymagają ponownych losowań ziarna, jak w każdym modelu obrazów (krok 7).
Krok 3: Skomponuj scenę
Dobierz proporcje do opowieści, rób szkice w 1k i dopiero potem wydaj render 1.5k na te najlepsze. Tekst na obraz przyjmuje aspect_ratio (15 opcji, domyślnie 1:1), resolution (1k lub 1.5k) i seed. Proporcje nie zmieniają ceny; poziom 1.5k kosztuje więcej niż 1k, i to jest powód, by szkicować w małym. Aktualna cena jest na stronie tekst na obraz.
| Zastosowanie | Proporcje | Rozmiar 1k | Rozmiar 1.5k |
|---|---|---|---|
| Portret, karta postaci | 3:4 | 880 x 1168 | 1328 x 1760 |
| Tapeta na telefon | 9:16 | 768 x 1360 | 1152 x 2048 |
| Filmowa para lub okładka | 16:9 | 1360 x 768 | 2048 x 1152 |
| Szeroki kadr otwierający | 21:9 | 1552 x 656 | 2048 x 992 |
| Wysoki baner | 1:3 | 576 x 1760 | 880 x 2048 |
Poziom 1.5k jest generowany natywnie, nie skalowany w górę. W 60 mierzonych przebiegach model potrzebował od 2 do 16 sekund na obraz, 52 z 60 poniżej 10.
Przy parach sprawdził się szeroki kadr 16:9, fraza o ubiorze dla każdej osoby i jeden gest kotwiczący.
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood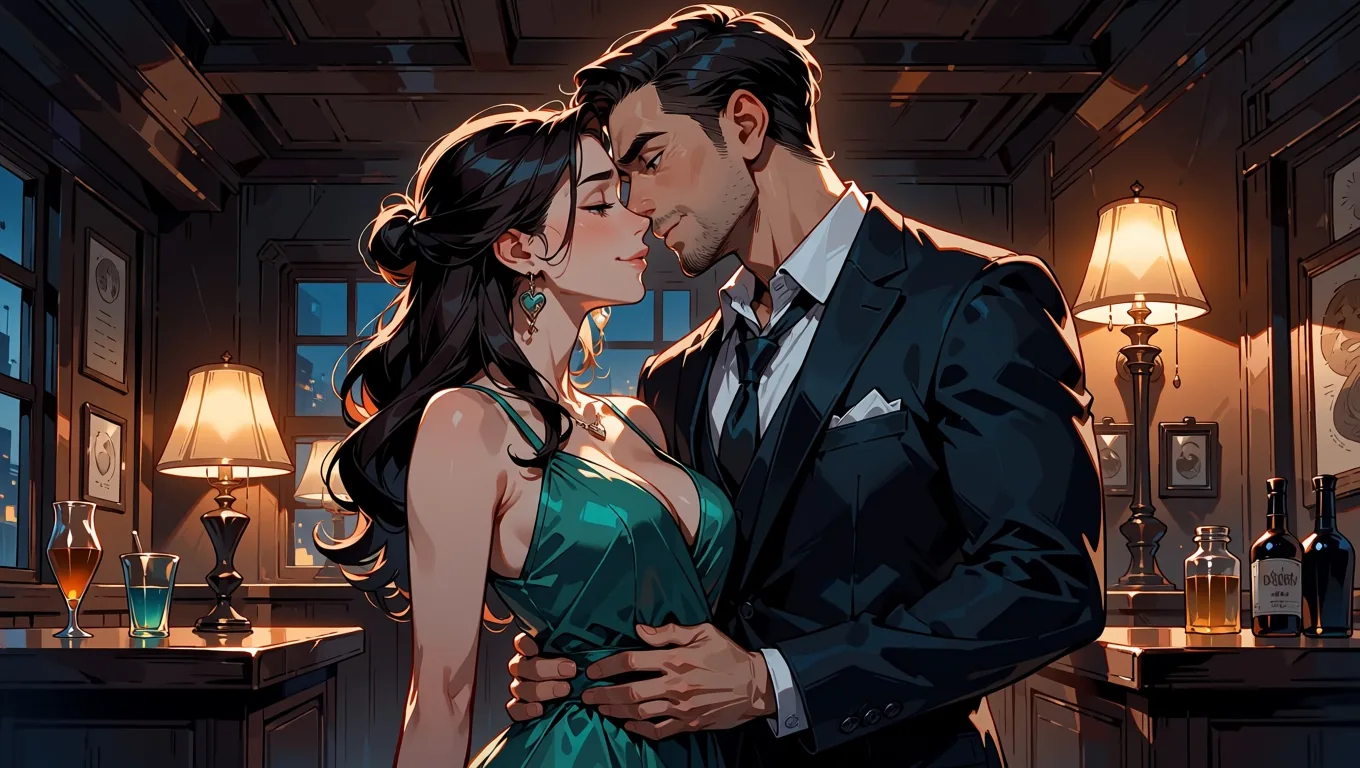
Ziarno 24, 16:9, 1k, Anima Turbo. Własna fraza o ubiorze dla każdej osoby sprawia, że dwie postacie nie zlewają się w jedną.
Jeśli wolisz zdania, pisz co najmniej dwa; wydawca ostrzega, że bardzo krótkie prompty dryfują.
Krok 4: Nadaj styl przez LoRA
LoRA to najszybszy sposób, by cały zestaw dostał jedną tożsamość wizualną; trzymaj scale mniej więcej między 0.5 a 1.2 i używaj słów wyzwalających. Anima Turbo LoRA to ten sam model z listą loras zawierającą do trzech wpisów, każdy w postaci {path, scale}. path musi być bezpośrednim linkiem HTTPS do pliku .safetensors i musi to być LoRA wytrenowana pod Anima. Wczytanie LoRA nie wiąże się z osobną opłatą.
Dwie publiczne LoRA, których użyliśmy:
- Melon-Bread/anima-pc98-gal-style-v0.2 (MIT): wygląd gier z ery PC-98, słowo wyzwalające
pc98gal_style. - notverriegod/monochrome-grayscale_style (Apache-2.0): czarno-biały tusz mangi. W naszym teście pozostawała w kolorze, dopóki w prompcie nie pojawiło się
monochrome, greyscale.
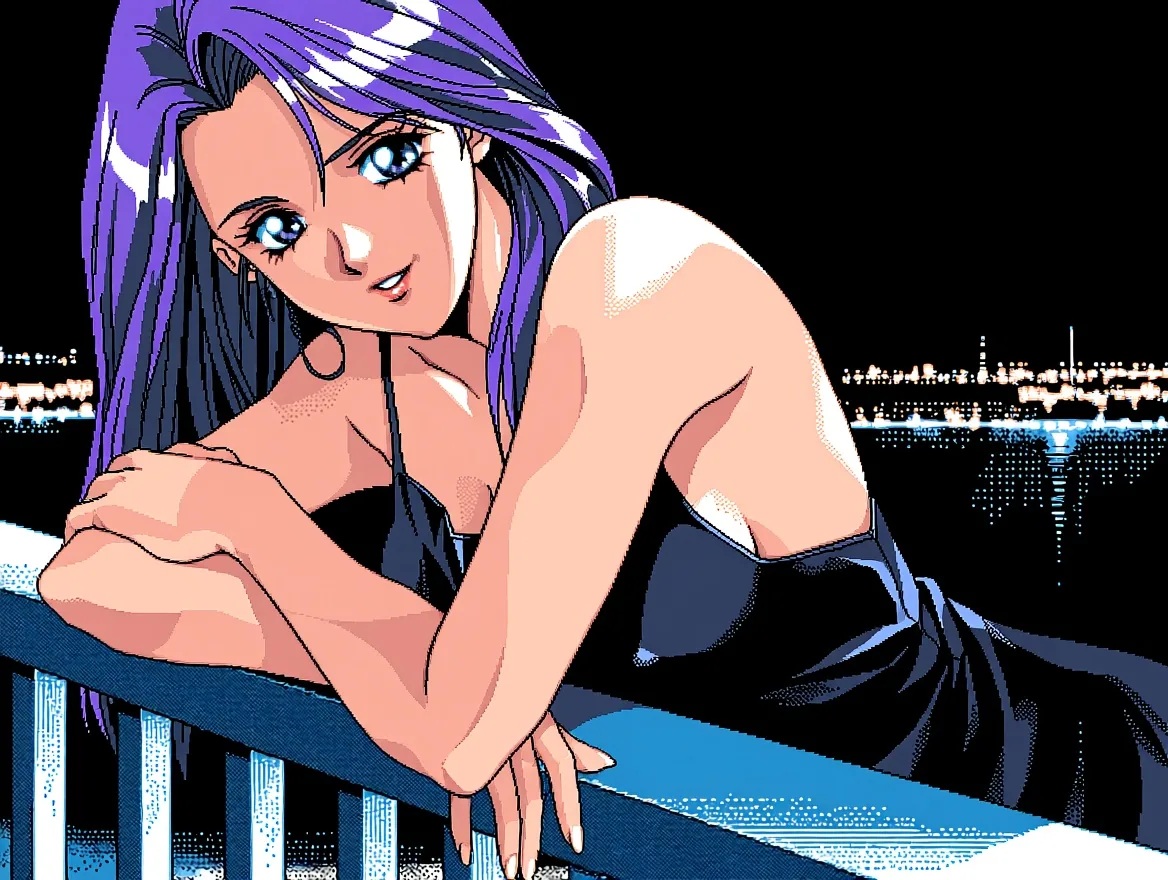
LoRA PC-98 przy scale 1, sensitive, 4:3, 1k. Dithering i płaskie cieniowanie cel pochodzą z LoRA.
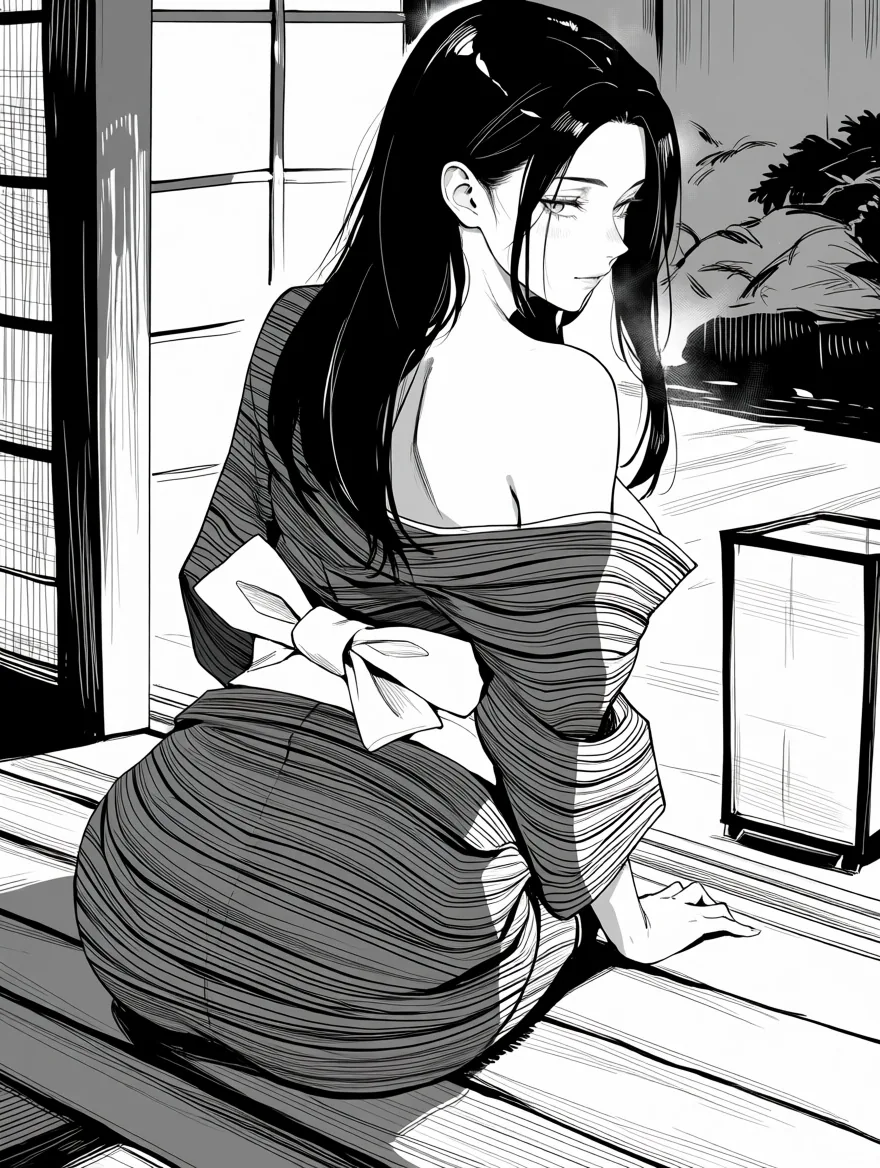
LoRA monochromatyczna przy scale 1, sensitive, 3:4, 1k, z monochrome, greyscale, screentone w prompcie.
Scale to pokrętło, które się liczy. Na jednym prompcie i jednym ziarnie z LoRA PC-98 porównaliśmy 0.5, 1, 1.5 i 4 (od lewej do prawej poniżej). 0.5 to lekkie muśnięcie, 1 to pełny styl, 1.5 mocniej wypycha styl, a 4 rozbiło obraz na abstrakcyjne kształty. Scale 0 jest identyczne z brakiem LoRA.
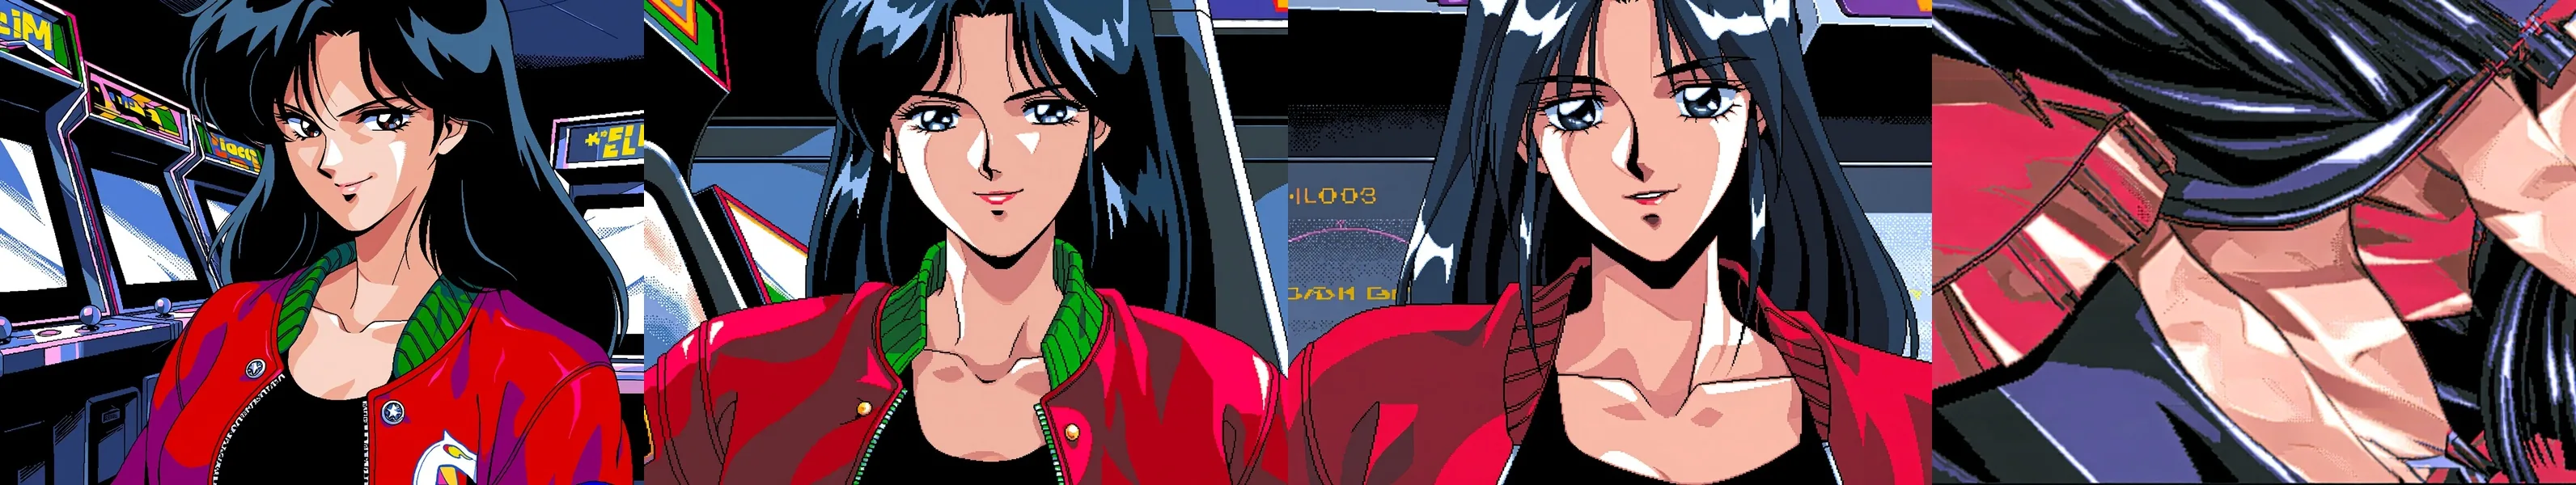
LoRA PC-98 przy 0.5, 1, 1.5 i 4 (od lewej do prawej), ten sam prompt i to samo ziarno.
| Sytuacja | Co sugerujemy |
|---|---|
| Pierwsza próba z dowolną LoRA | Scale 1 ze słowami wyzwalającymi |
| Styl walczy z postacią | Zejdź do 0.5 do 0.8 |
| Chcesz mocniejszego efektu | 1.2, nie 4 |
| Dwie lub trzy LoRA | Główny styl przy 1, pozostałe przy 0.6 i 0.25 (u nas to zadziałało) |
| LoRA do innego modelu bazowego | Wczytuje się bez błędu i niczego nie zmienia, więc sprawdź, pod co została wytrenowana |
Pierwsze zapytanie z nową LoRA może być wolne, gdy plik jest pobierany (jedno nasze trwało prawie trzy minuty). Link wymagający logowania albo prowadzący do strony repozytorium zamiast do pliku kończy się czytelnym komunikatem i nie jest rozliczany. Nasz dłuższy poradnik o stylach LoRA przechodzi przez więcej kombinacji.
Krok 5: Zamień zdjęcie lub szkic w anime
Wyślij referencję jako image_url, opisz, co już na niej jest, i ustaw strength na 0.75. Obraz na obraz na stronie edycji przyjmuje prompt, image_url, strength (0 do 1, domyślnie 0.8), resolution i seed. Nie ma pola proporcji obrazu: wynik zachowuje kształt źródła. Kosztuje tyle samo co tekst na obraz.
W naszej drabinie strength na zdjęciu 0.3 nadal było zdjęciem, 0.6 wyglądało już jak ilustracja, 0.75 to czyste anime z tą samą kompozycją, od 0.9 szczegóły zaczynały się zmieniać, a przy 1.0 źródło było ignorowane. Przy 0 źródło wraca nietknięte. Nasz osobny poradnik o strength pokazuje całą drabinę.
Obrazy „przed” poniżej to zdjęcia źródłowe, które wygenerowaliśmy do testu w GPT Image 2.5: fikcyjni dorośli, nie prawdziwe osoby. To dane wejściowe, a nie wynik Anima.
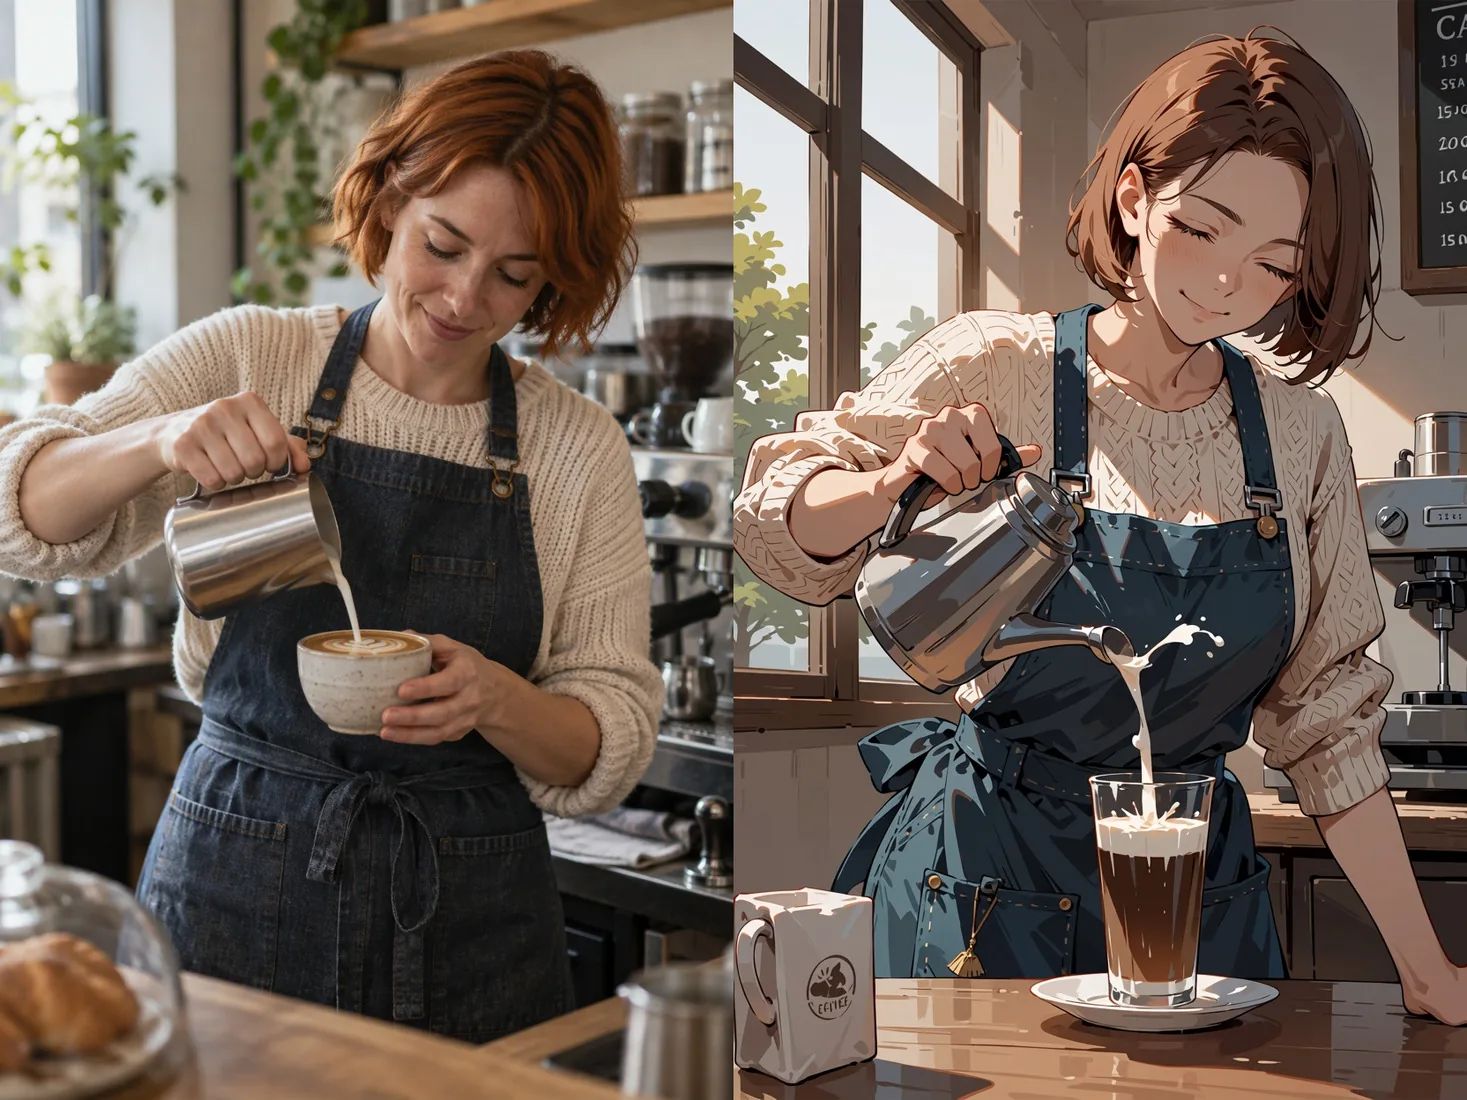
Przed (po lewej, zdjęcie źródłowe) i po (po prawej, Anima Turbo przy strength 0.75). Kadr trochę się przesunął: model przerysowuje szczegóły, nie kalkuje.
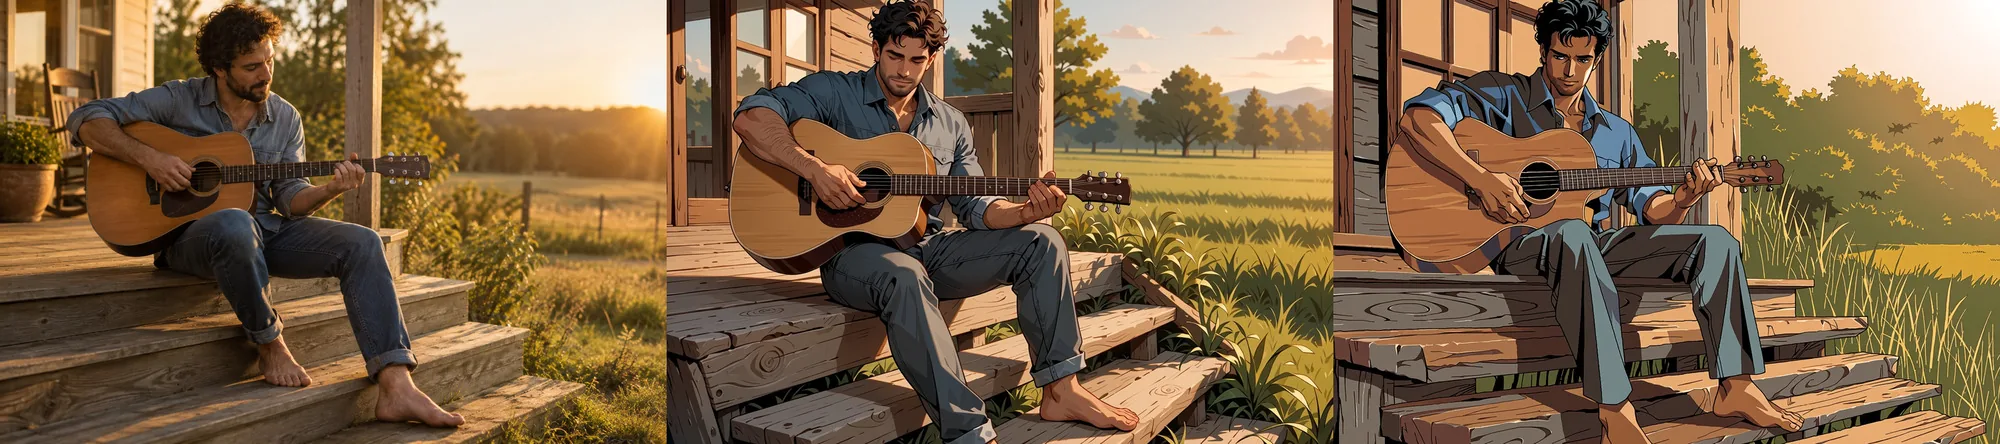
Przed (po lewej), anime przy 0.75 (w środku) i anime z LoRA PC-98 przy 0.75 (po prawej). W obu przypadkach kompozycja pozostaje blisko źródła.
Obraz na obraz zmienia styl; nie wykonuje poleceń edycji (prośba do ilustracji o nowy strój zmieniała bardzo niewiele przy 0.6 do 0.8). Kolorowa ilustracja przechodząca w tusz mangi wymagała w naszym teście 0.85, a przy takim strength poza jest przerysowywana. Przy szkicu opisz jego motyw, zacznij od 0.75 i podnoś tylko wtedy, gdy kreska zostaje zbyt mocno.
Używaj tylko zdjęć, do których masz prawo. Nigdy nie zamieniaj zdjęcia prawdziwej osoby w sztukę przeznaczoną dla dorosłych bez jej zgody.
Krok 6 (opcjonalnie): Ożyw gotowy obraz
Wybierz najlepszy obraz, a potem przekaż go rodzinie obraz na wideo bez cenzury razem z krótkim promptem. SpicyAPI ma trzy takie rodziny: Seedance 2.5 Spicy, Wan 2.2 Spicy i MiniMax H3 Spicy. Każda przyjmuje obraz plus prompt i zwraca krótkie wideo. Nie uruchamialiśmy tego kroku na obrazach z tego artykułu, więc szczegóły takie jak długości i ustawienia zostawiamy stronom poszczególnych modeli.
Najpierw dokończ obraz, bo wadliwa dłoń na obrazie to wadliwa dłoń w każdej klatce, a prompt ruchu ogranicz do jednej czynności.
Krok 7: Napraw typowe problemy
Większość usterek ma jednolinijkową poprawkę: ponownie wylosuj ziarno, obniż scale LoRA albo skoryguj strength.
| Problem | Prawdopodobna przyczyna | Poprawka |
|---|---|---|
| Zawijas przypominający podpis albo linijka fałszywego tekstu w rogu | Nawyk wyniesiony z prac artystów; widzieliśmy to mniej więcej na jednym obrazie na pięć | Zmień ziarno; nie ma promptu negatywnego, który by to tłumił; albo przytnij |
| Dziwne dłonie lub anatomia | Normalne dla modeli obrazów | Wylosuj ziarno ponownie; trzymaj szkice w 1k, aż pojawi się dobry |
| Postać dryfuje między obrazami | Zmieniono naraz zbyt wiele fraz | Użyj ponownie bloku postaci, zachowaj ziarno, zmień jedną frazę |
| Styl zbyt mocny albo obraz się rozpada | Scale LoRA zbyt wysokie | Obniż do 0.5 do 1.2; scale 4 rozbija obraz |
| LoRA nic nie robi | Wytrenowana pod inny model bazowy albo brak słowa wyzwalającego | Sprawdź model bazowy i dodaj słowa wyzwalające |
| Zdjęcie nadal wygląda jak zdjęcie | strength zbyt niskie | Przesuń w stronę 0.75 |
| Szczegóły zbytnio się zmieniają w obraz na obraz | strength zbyt wysokie | Zejdź poniżej 0.9 |
Oto pierwszy z nich: w rogu tej sceny w kawiarni pojawiła się linijka pseudotekstu.
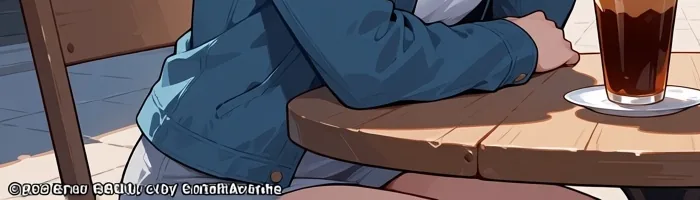
Zawijas przypominający podpis w rogu (wycinek obrazu 1360 x 768).
Ziarna czynią przebiegi porównywalnymi, ale nie gwarantują identycznych pikseli, więc zapisuj obrazy, które ci się podobają.
Krok 8: Zachowaj prywatność i tylko dorosłych
Odpowiadasz za to, co generujesz, przechowujesz i udostępniasz. Każda postać jest dorosła i prompt to mówi; żadnych wizerunków prawdziwych osób bez zgody; żadnych małoletnich ani postaci wyglądających młodo, nigdy; trzymaj wyniki w miejscu, które kontrolujesz; i przestrzegaj prawa tam, gdzie mieszkasz.
Cały workflow jako lista kontrolna
| Gotowe? | Sprawdź |
|---|---|
| ☐ | Blok postaci napisany raz: tagi jakości, tag oceny, liczba postaci, informacja o wieku, wygląd, jeden znak |
| ☐ | Tag oceny wybrany świadomie (safe lub sensitive dla wszystkiego, co udostępniasz) |
| ☐ | Proporcje dobrane do zastosowania; szkic w 1k |
| ☐ | Najlepsze obrazy wyrenderowane ponownie w 1.5k |
| ☐ | LoRA jest zgodna z Anima, słowa wyzwalające wpisane, scale 0.5 do 1.2 |
| ☐ | Referencje ze zdjęć przy strength 0.75, prompt opisuje zdjęcie |
| ☐ | Rogi sprawdzone pod kątem zawijasów, dłonie sprawdzone |
| ☐ | Opcjonalnie: obraz ożywiony rodziną obraz na wideo |
| ☐ | Wyniki przechowywane prywatnie; tylko dorośli |
Krótki szablon promptu
Uzupełnij nawiasy i zostaw resztę. Ta wersja to scena z ubraną postacią, sensitive.
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
[hair], [eyes], [one distinctive mark], [outfit: e.g. black slip dress],
[place and pose: e.g. leaning on a balcony at night], looking at viewer,
[light: e.g. warm lamp light, city lights]
Dla dwóch osób użyj 1girl, 1boy i frazy o ubiorze dla każdej; dla stylu dodaj słowa wyzwalające LoRA. Więcej znajdziesz w naszym raporcie z testu Anima Turbo, a szersze pole porównaj z innymi generatorami obrazów NSFW.
FAQ
Czy naprawdę mogę tworzyć anime NSFW z AI w SpicyAPI?
Tak. Anima Turbo i Anima Turbo LoRA są bez cenzury, bez filtra treści, a na czterech poziomach treści nie zobaczyliśmy ani jednej odmowy. Za to, co tworzysz, nadal odpowiadasz ty.
Jak najlepiej uzyskać spójną postać?
Napisz jeden blok tagów dla twarzy, włosów i charakterystycznego znaku, wklejaj go do każdego promptu i zachowaj ziarno, zmieniając jedną frazę naraz. W naszym zestawie ze srebrnym bobem to utrzymało jedną postać w trzech strojach.
Którego tagu oceny użyć?
Używaj safe dla wszystkiego, co zamierzasz udostępniać, a sensitive dla scen zmysłowych, ale z ubraną postacią. Model zna też nsfw i mocniejszy tag, które wydawca opisuje jako znoszące powściągliwość. Dla sceny z ubraną postacią safe i sensitive dały prawie ten sam obraz.
Od jakiego scale LoRA zacząć?
Zacznij od 1 ze słowami wyzwalającymi, a potem poruszaj się w zakresie 0.5 do 1.2. W naszych testach 0.5 było lekkim muśnięciem, 1.5 mocniej wypychało styl, a 4 rozbiło obraz.
Jaki strength zamienia zdjęcie w anime?
0.75. W naszej drabinie dał czyste anime z nienaruszoną kompozycją. Przy 0.3 nadal było to zdjęcie, od 0.9 szczegóły zaczynały się zmieniać, a przy 1.0 źródło było ignorowane.
Dlaczego w rogu jest podpis albo fałszywy tekst?
Model nauczył się tego z prac artystów. Widzieliśmy to mniej więcej na jednym obrazie na pięć, a prompt negatywny nie może tego stłumić, bo go nie ma. Zmień ziarno albo przytnij róg.
Czy mogę zamienić gotowy obraz w wideo?
Tak, rodziną obraz na wideo bez cenzury, taką jak Seedance 2.5 Spicy, Wan 2.2 Spicy lub MiniMax H3 Spicy. Każda przyjmuje obraz i prompt, a zwraca krótki klip. Sprawdź stronę modelu, żeby zobaczyć, co każda przyjmuje.
Czy można użyć zdjęcia prawdziwej osoby?
Nie bez zgody tej osoby i nie do sztuki przeznaczonej dla dorosłych. Używaj fikcyjnych postaci albo własnych szkiców i zdjęć dorosłych osób, które wyraziły zgodę, a wyniki trzymaj prywatnie.