Der Workflow, der in unseren Tests am besten funktionierte: eine erwachsene Figur in Tags entwerfen, den Ton mit einem Rating-Tag festlegen, in 1k entwerfen, in 1.5k finalisieren, eine Stil-LoRA ergänzen und Probleme durch einen anderen Seed oder Scale beheben, statt den Prompt umzuschreiben. Wir haben die gesamte Kette mit Anima Turbo durchlaufen, einem Anime- und Illustrationsmodell, das auf SpicyAPI unzensiert ist: Es gibt keinen Content-Filter, und unsere stärkste Inhaltsprobe wurde gleich beim ersten Versuch wie geschrieben gerendert.
Dieser Guide ist die praktische Version: acht Schritte von der Idee bis zum fertigen Set, jeder Prompt am 5. Oktober 2026 getestet. Jeder hier abgedruckte Prompt beschreibt höchstens eine bekleidete, andeutungsweise anzügliche Szene mit erwachsenen Figuren, weil wir nur das veröffentlichen. Stärkere Töne gibt es, und sie sind nur ein Rating-Tag entfernt; wir erklären, wie die Tags funktionieren, ohne sie abzudrucken.
Auf einen Blick
| Schritt | Was Sie tun | Wichtige Einstellung | Was wir sahen |
|---|---|---|---|
| 1. Figur | Den Look in einem wiederverwendbaren Tag-Block festhalten | Gleicher Seed, gleicher Figurenblock | Eine Figur blieb in drei Outfits erkennbar |
| 2. Ton | Ein Rating-Tag wählen | safe oder sensitive | Bei einer bekleideten Szene nahezu dasselbe Bild |
| 3. Szene | Seitenverhältnis und Stufe wählen | 1k für Entwürfe, 1.5k für Finals | 2 bis 16 Sekunden pro Bild |
| 4. Stil | Eine LoRA ergänzen | Scale 0,5 bis 1,2 | Scale 4 zerlegte das Bild |
| 5. Referenz | Ein Foto oder eine Skizze in Anime umwandeln | strength 0.75 | Sauberer Anime, Komposition erhalten |
| 6. Bewegung | Ein fertiges Standbild animieren (optional) | Bild plus Prompt | Kurzer Clip aus einer unzensierten Video-Familie |
| 7. Korrektur | Neu würfeln, senken, anpassen | Seed, Scale, Stärke | Signatur-Kritzeleien und Drift lassen sich beheben |
| 8. Privatsphäre | Ergebnisse privat halten | Ihr eigener Speicher | Ihre Verantwortung |
Schritt 1: Eine erwachsene Figur in Tags entwerfen
Schreiben Sie die Figur einmal als Tag-Block und fügen Sie denselben Block in jeden Prompt ein. Anima folgt Tags im Danbooru-Stil, normalen Sätzen und Mischungen aus beidem. Der Herausgeber, CircleStone Labs, dokumentiert die Tag-Konventionen auf der Modellkarte: Kleinschreibung, Leerzeichen statt Unterstriche und eine feste Reihenfolge.
Die Reihenfolge, die bei uns funktionierte:
- Qualitäts-Tags:
masterpiece, best quality, optionalscore_7 - Rating-Tag:
safeodersensitive(Schritt 2) - Personenzahl:
1girl,1boy,1girl, 1boy,no humans - eine Altersangabe:
adult woman, mature femaleodermature male - der Figurenblock: Haare, Augen, ein auffälliges Merkmal
- das Outfit, der Ort, die Pose, das Licht
Sagen Sie im Prompt selbst immer, dass die Figur erwachsen ist, damit die Tags es tragen.
Hier der Beweis, dass ein Figurenblock funktioniert. Die drei Bilder unten teilen sich einen Seed und einen Block, short silver bob, golden eyes, beauty mark under the left eye. Nur Outfit und Ort änderten sich: ein Rollkragenpullover in einer Galerie, ein rotes Seiden-Slipkleid auf einem Balkon, ein übergroßes weißes Hemd auf einer Fensterbank.
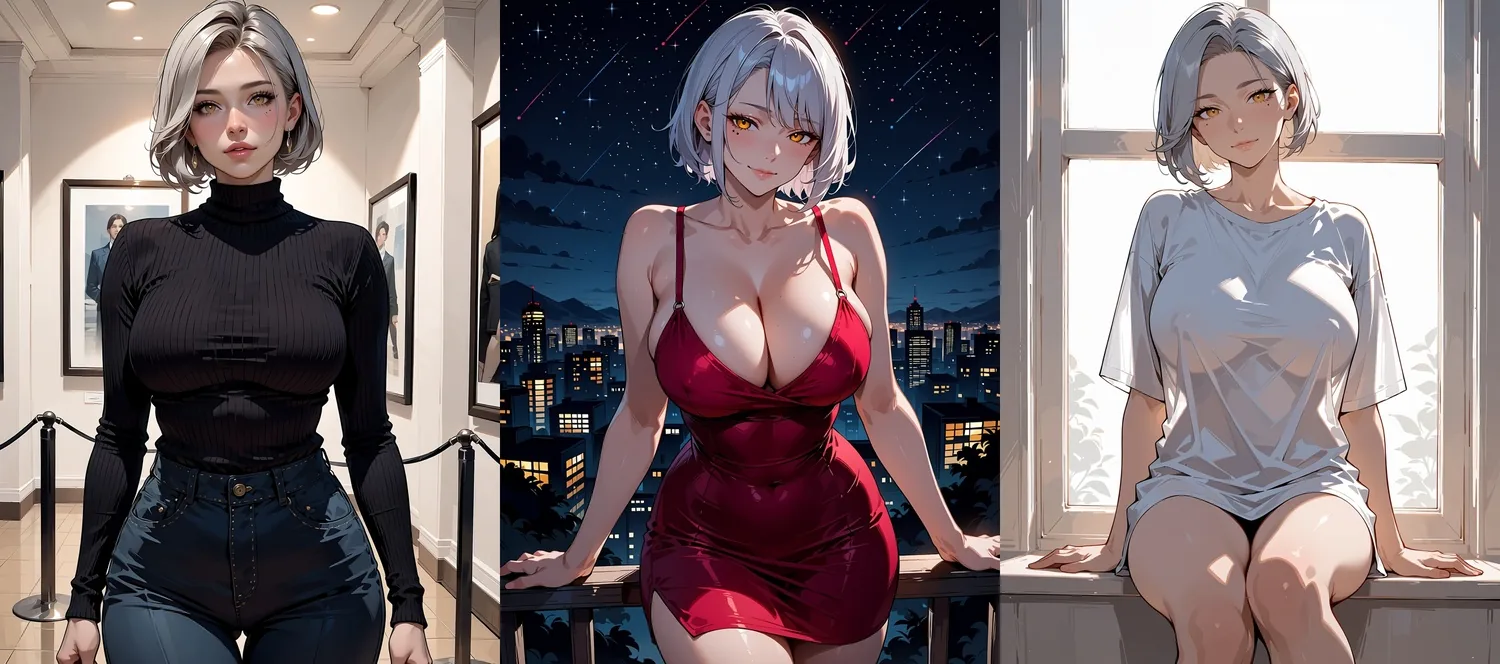
Ein Figurenblock, Seed 31, drei Outfits (Anima Turbo, 1k, 3:4). Haare, Augen und Schönheitsfleck bleiben erhalten; Pose und Bildausschnitt ändern sich mit dem Prompt.
Der erste Prompt des Sets, damit Sie die Form übernehmen können:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye, black turtleneck,
standing in an art gallery, looking at viewer
Die anderen beiden ersetzen Outfit und Ort und verwenden sensitive. Wenn das Gesicht abdriftet, weil Sie auf einmal viel ändern, behalten Sie den Seed bei und ändern jeweils nur eine Wendung.
Schritt 2: Den Ton mit einem Rating-Tag wählen
Da Anima keinen Negativ-Prompt hat, ist das Rating-Tag Ihr wichtigstes Mittel, den Ton zu steuern. Das Modell kennt safe, sensitive und nsfw sowie ein stärkeres Tag. Der Herausgeber dokumentiert die letzten beiden als die Tags, die die Zurückhaltung aufheben. Wir drucken keine Prompts ab, die sie verwenden, und nennen das stärkste Tag nicht, aber Sie sollten wissen, dass es sie gibt, damit Sie bewusst wählen.
Bei einer bekleideten Szene sind safe und sensitive enge Verwandte. Das Paar unten nutzt denselben Prompt und denselben Seed; nur dieses eine Wort wurde geändert. Eine Frau in einem schwarzen Abendkleid an einer Hotelbar kam beide Male nahezu identisch heraus.
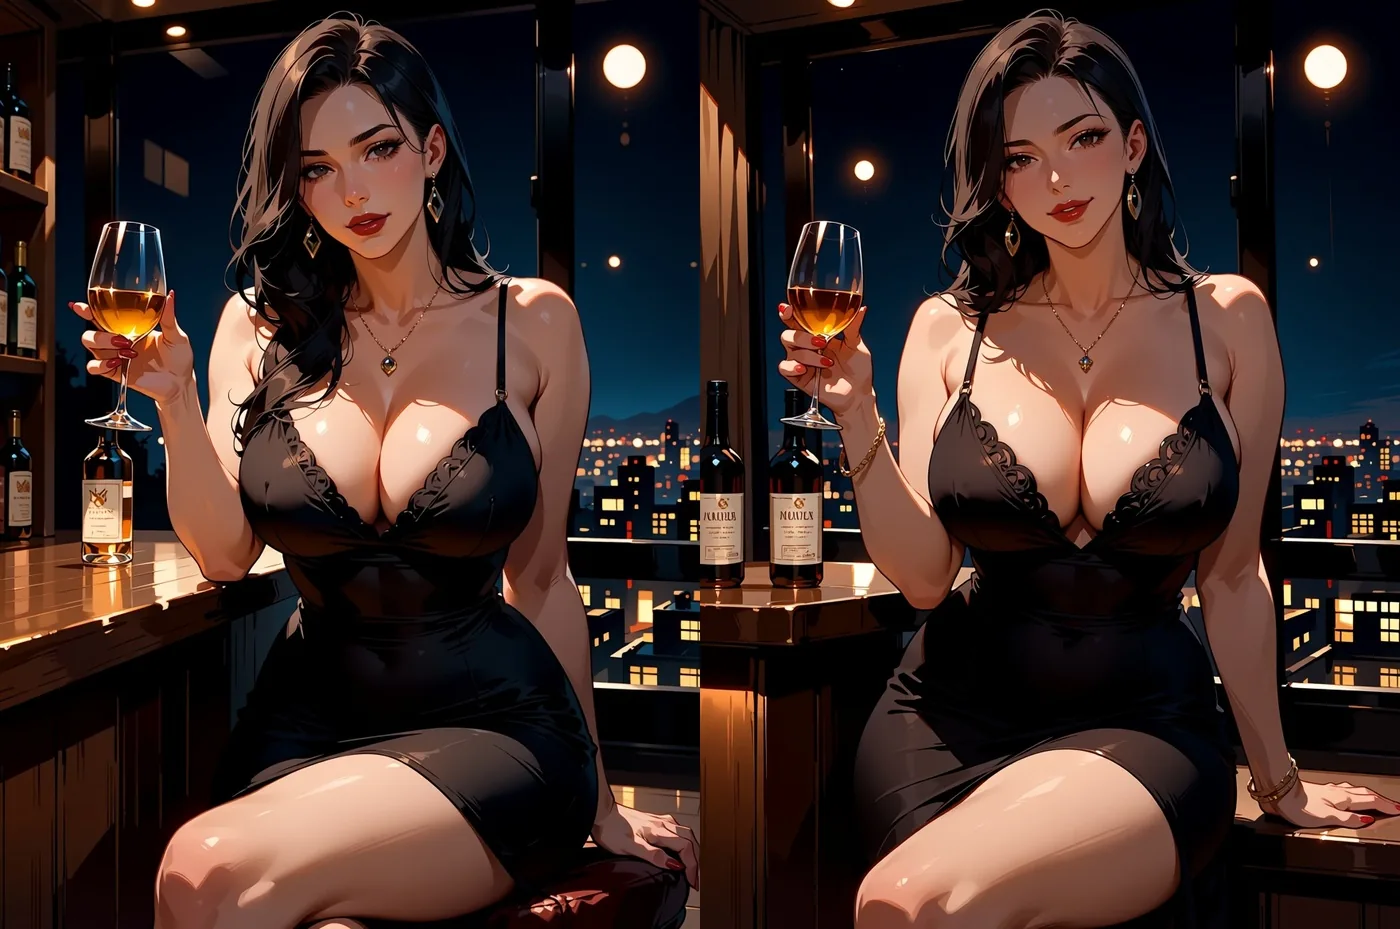
Gleicher Prompt, gleicher Seed 27, links safe, rechts sensitive (Anima Turbo, 1k, 3:4).
| Rating-Tag | Was es signalisiert | Wie wir es einsetzen |
|---|---|---|
safe | Alltäglich, zurückhaltend | Standard für erste Entwürfe und alles, was Sie teilen wollen |
sensitive | Höchstens anzüglich | Abendmode, ein rutschender Träger, enges Tanzen |
nsfw | Hebt die Zurückhaltung auf | Nur für Erwachsene, auf eigenes Risiko und eigene Verantwortung |
| Ein stärkeres Tag | Hebt sie noch weiter auf | Dasselbe; lesen Sie die Modellkarte |
Bei 25 Anfragen auf vier Inhaltsstufen, Text-zu-Bild und Bild-zu-Bild, mit und ohne LoRAs, sahen wir keine einzige Ablehnung und keine einzige Ersetzung. Anatomie und Hände brauchen wie bei jedem Bildmodell neue Seeds (Schritt 7).
Schritt 3: Die Szene komponieren
Wählen Sie das Seitenverhältnis passend zur Geschichte, entwerfen Sie in 1k und investieren Sie erst dann einen 1.5k-Render in die Treffer. Text-zu-Bild nimmt aspect_ratio (15 Optionen, Standard 1:1), resolution (1k oder 1.5k) und seed entgegen. Das Seitenverhältnis ändert den Preis nicht; die Stufe 1.5k kostet mehr als 1k, und das ist der Grund, klein zu entwerfen. Den aktuellen Preis finden Sie auf der Text-zu-Bild-Seite.
| Verwendung | Verhältnis | Größe 1k | Größe 1.5k |
|---|---|---|---|
| Porträt, Figurenkarte | 3:4 | 880 x 1168 | 1328 x 1760 |
| Handy-Hintergrundbild | 9:16 | 768 x 1360 | 1152 x 2048 |
| Filmisches Paar oder Cover | 16:9 | 1360 x 768 | 2048 x 1152 |
| Weite Totale | 21:9 | 1552 x 656 | 2048 x 992 |
| Hohes Banner | 1:3 | 576 x 1760 | 880 x 2048 |
Die Stufe 1.5k wird nativ erzeugt und nicht hochskaliert. In 60 gemessenen Läufen brauchte das Modell 2 bis 16 Sekunden pro Bild, 52 von 60 unter 10.
Für Paare funktionierte ein breites 16:9-Bild, eine Kleidungswendung für jede Person und eine verankernde Geste.
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood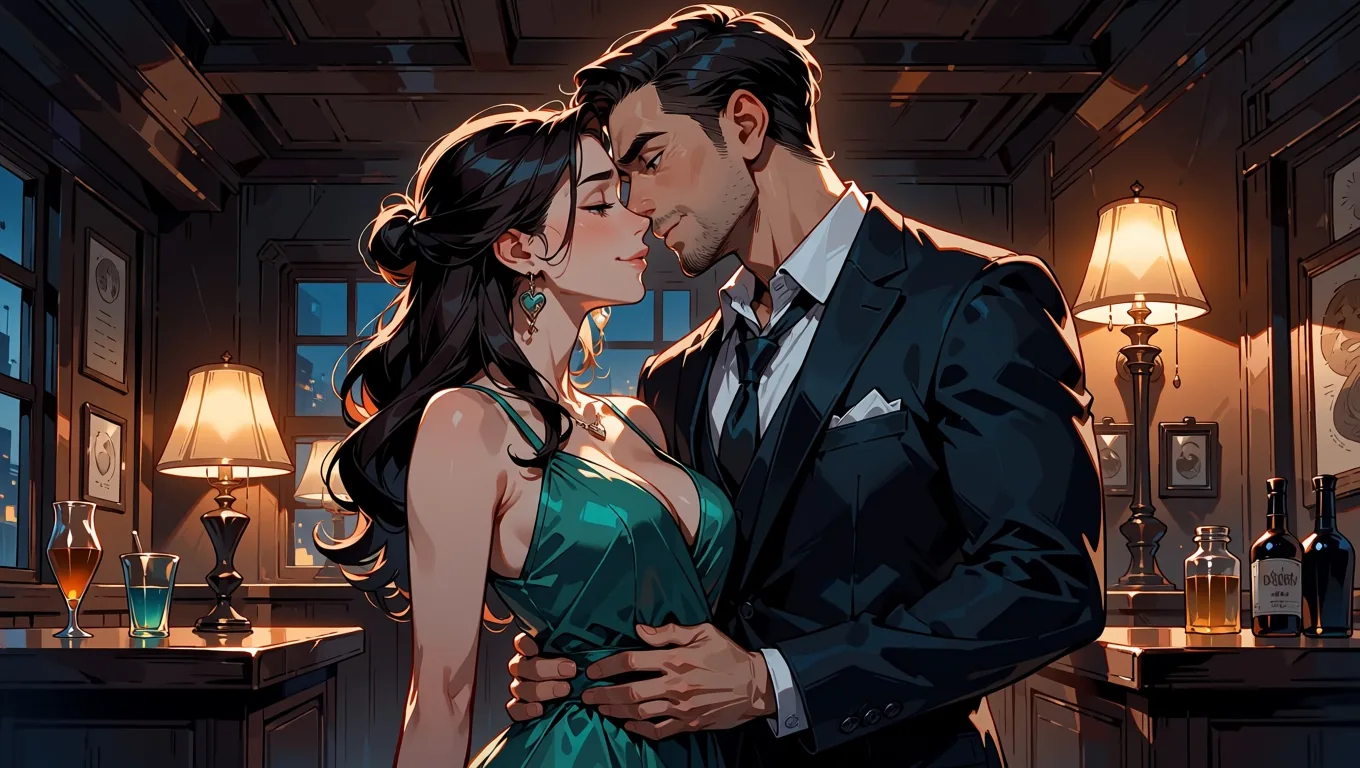
Seed 24, 16:9, 1k, Anima Turbo. Eine eigene Kleidungswendung für jede Person verhindert, dass zwei Figuren zu einer verschmelzen.
Wenn Sie Sätze bevorzugen, schreiben Sie mindestens zwei; der Herausgeber warnt, dass sehr kurze Prompts abdriften.
Schritt 4: Einen Stil mit einer LoRA geben
Mit einer LoRA geben Sie einem ganzen Set am schnellsten eine visuelle Identität; halten Sie den Scale zwischen etwa 0,5 und 1,2 und nutzen Sie die Triggerwörter. Anima Turbo LoRA ist dasselbe Modell mit einer loras-Liste mit bis zu drei Einträgen, jeweils {path, scale}. Der path muss ein direkter HTTPS-Link auf eine .safetensors-Datei sein, und es muss eine für Anima trainierte LoRA sein. Das Laden von LoRAs verursacht keine gesonderte Gebühr.
Zwei öffentliche LoRAs, die wir genutzt haben:
- Melon-Bread/anima-pc98-gal-style-v0.2 (MIT): ein Look wie bei PC-98-Spielen, Trigger
pc98gal_style. - notverriegod/monochrome-grayscale_style (Apache-2.0): Schwarzweiß-Manga-Tusche. In unserem Test blieb sie farbig, bis
monochrome, greyscaleim Prompt stand.
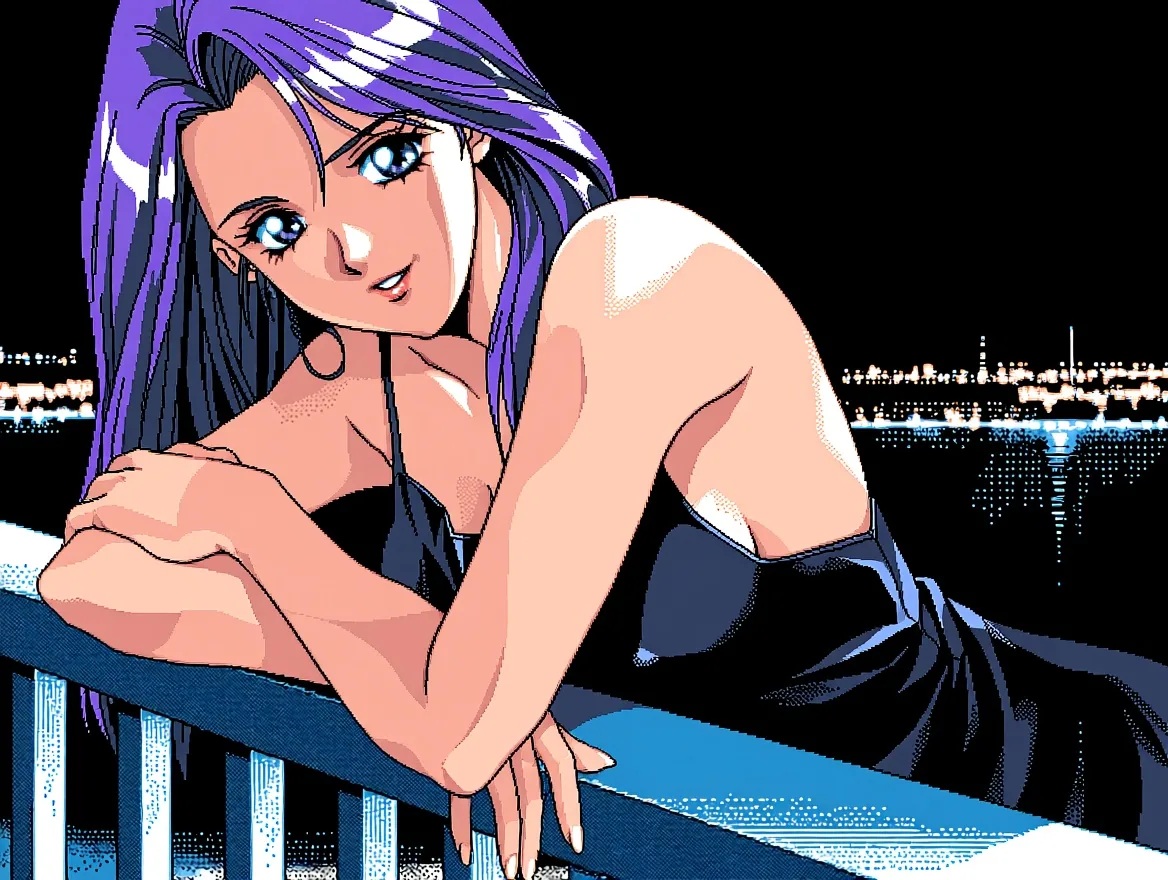
PC-98-LoRA mit Scale 1, sensitive, 4:3, 1k. Das Dithering und die flache Cel-Schattierung stammen von der LoRA.
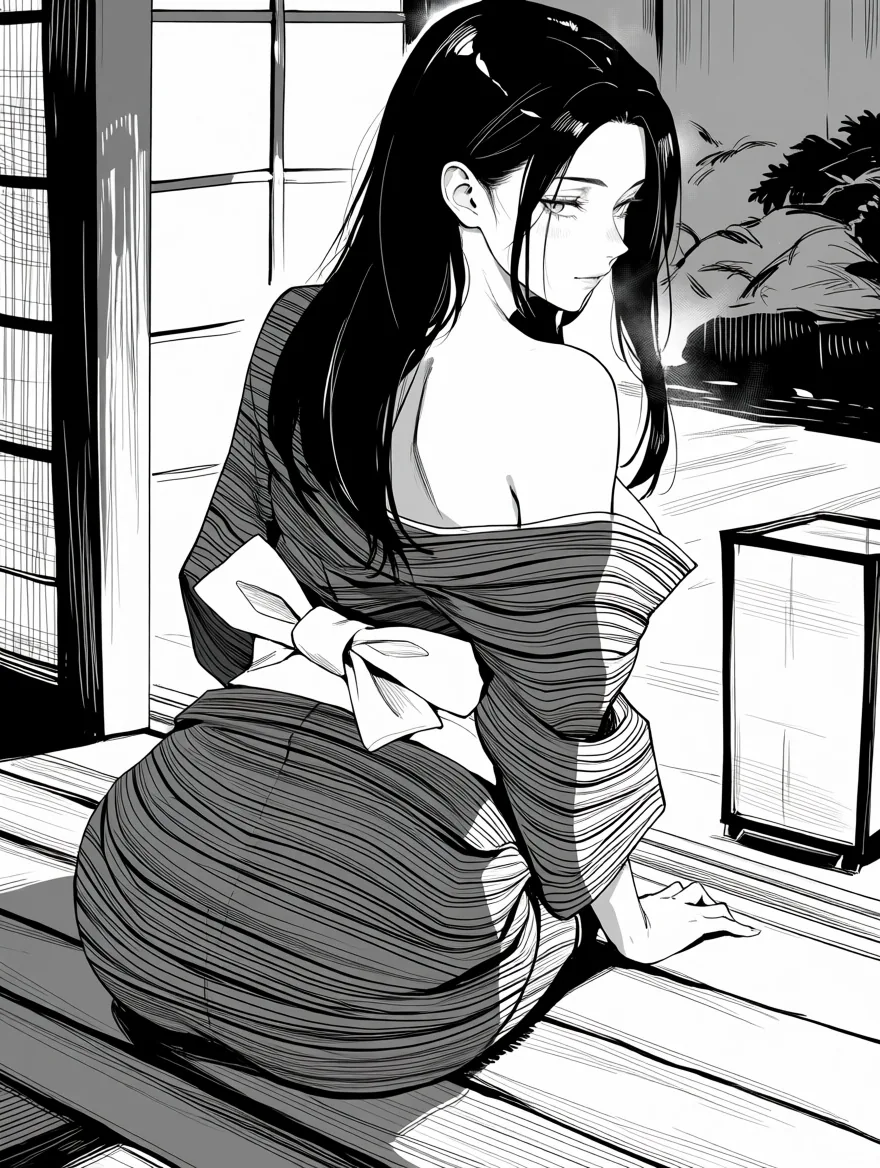
Monochrom-LoRA mit Scale 1, sensitive, 3:4, 1k, mit monochrome, greyscale, screentone im Prompt.
Der Scale ist der Regler, auf den es ankommt. Mit einem Prompt und einem Seed haben wir bei der PC-98-LoRA 0,5, 1, 1,5 und 4 verglichen (unten von links nach rechts). 0,5 ist eine leichte Berührung, 1 der volle Stil, 1,5 drückt stärker, und 4 zerlegte das Bild in abstrakte Formen. Ein Scale von 0 entspricht dem Lauf ohne LoRA.
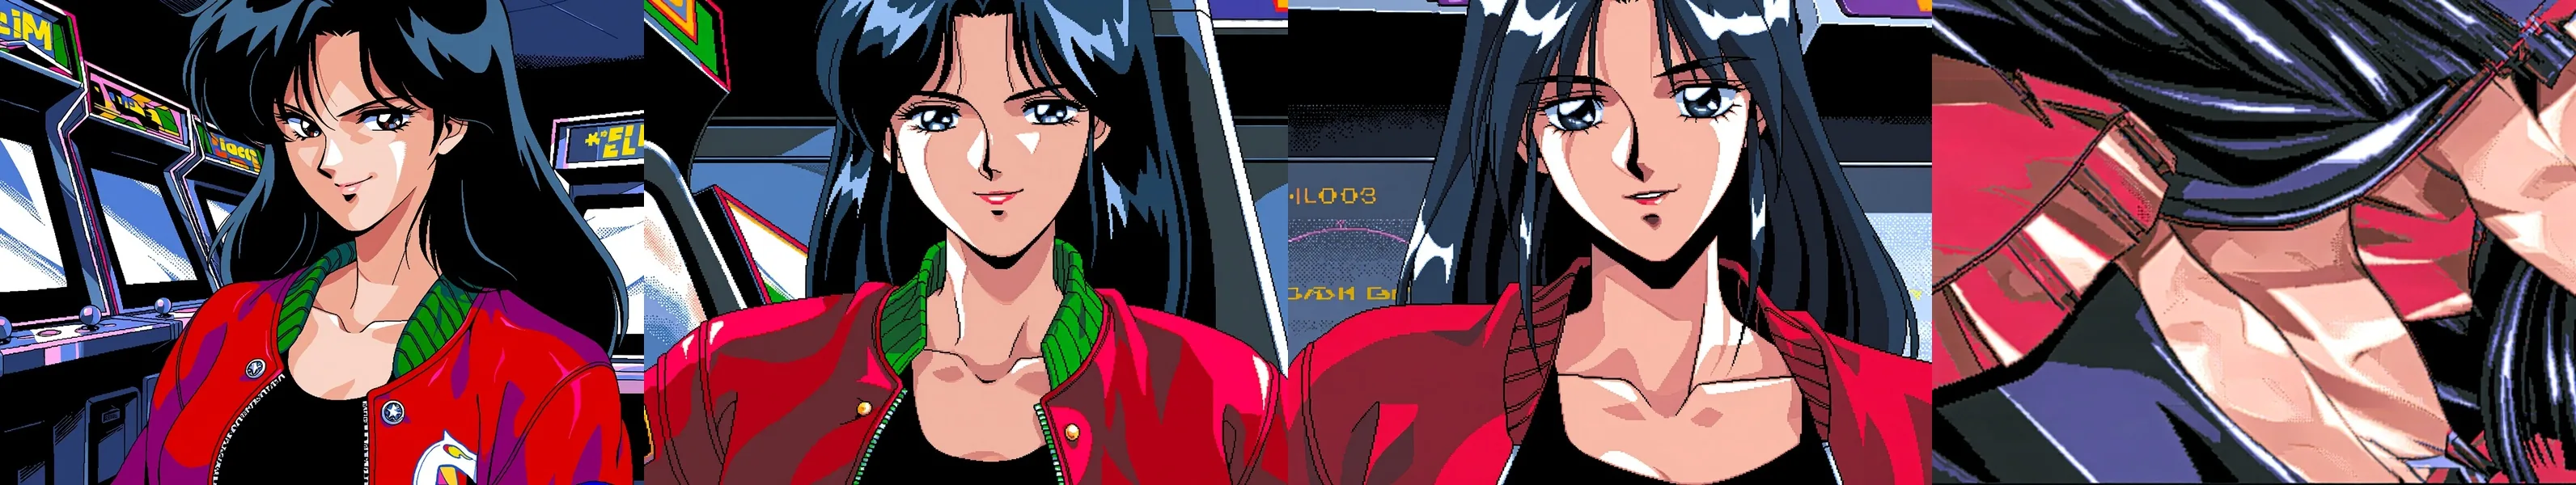
PC-98-LoRA mit 0,5, 1, 1,5 und 4 (von links nach rechts), gleicher Prompt und gleicher Seed.
| Situation | Unsere Empfehlung |
|---|---|
| Erster Versuch mit einer beliebigen LoRA | Scale 1 mit den Triggerwörtern |
| Der Stil kämpft gegen die Figur | Auf 0,5 bis 0,8 senken |
| Sie wollen es lauter | 1,2, nicht 4 |
| Zwei oder drei LoRAs | Hauptstil mit 1, die anderen mit 0,6 und 0,25 (das funktionierte bei uns) |
| Eine LoRA für ein anderes Basismodell | Sie lädt ohne Fehler und ändert nichts; prüfen Sie also, wofür sie trainiert wurde |
Die erste Anfrage mit einer neuen LoRA kann langsam sein, während die Datei geholt wird (eine unserer Anfragen brauchte fast drei Minuten). Ein Link, der eine Anmeldung verlangt oder auf eine Repository-Seite statt auf die Datei zeigt, schlägt mit einer eindeutigen Meldung fehl und wird nicht berechnet. Unser ausführlicherer LoRA-Stilguide geht weitere Kombinationen durch.
Schritt 5: Ein Foto oder eine Skizze in Anime umwandeln
Senden Sie Ihre Referenz als image_url, beschreiben Sie, was bereits darin zu sehen ist, und setzen Sie strength auf 0.75. Bild-zu-Bild auf der Bearbeitungsseite nimmt prompt, image_url, strength (0 bis 1, Standard 0.8), resolution und seed entgegen. Es gibt kein Feld für das Seitenverhältnis: Die Ausgabe behält die Form der Vorlage. Es kostet dasselbe wie Text-zu-Bild.
In unserer Stärke-Leiter bei einem Foto war 0,3 noch ein Foto, 0,6 wirkte bereits wie eine Illustration, 0,75 war sauberer Anime mit derselben Komposition, ab 0,9 begannen sich Details zu verändern, und bei 1,0 wurde die Vorlage ignoriert. Bei 0 kommt die Vorlage unverändert zurück. Unser eigener Stärke-Guide zeigt die ganze Leiter.
Die „Vorher"-Bilder unten sind Ausgangsfotos, die wir für den Test mit GPT Image 2.5 erzeugt haben: fiktive Erwachsene, keine echten Personen. Sie sind Eingaben, keine Ausgabe von Anima.
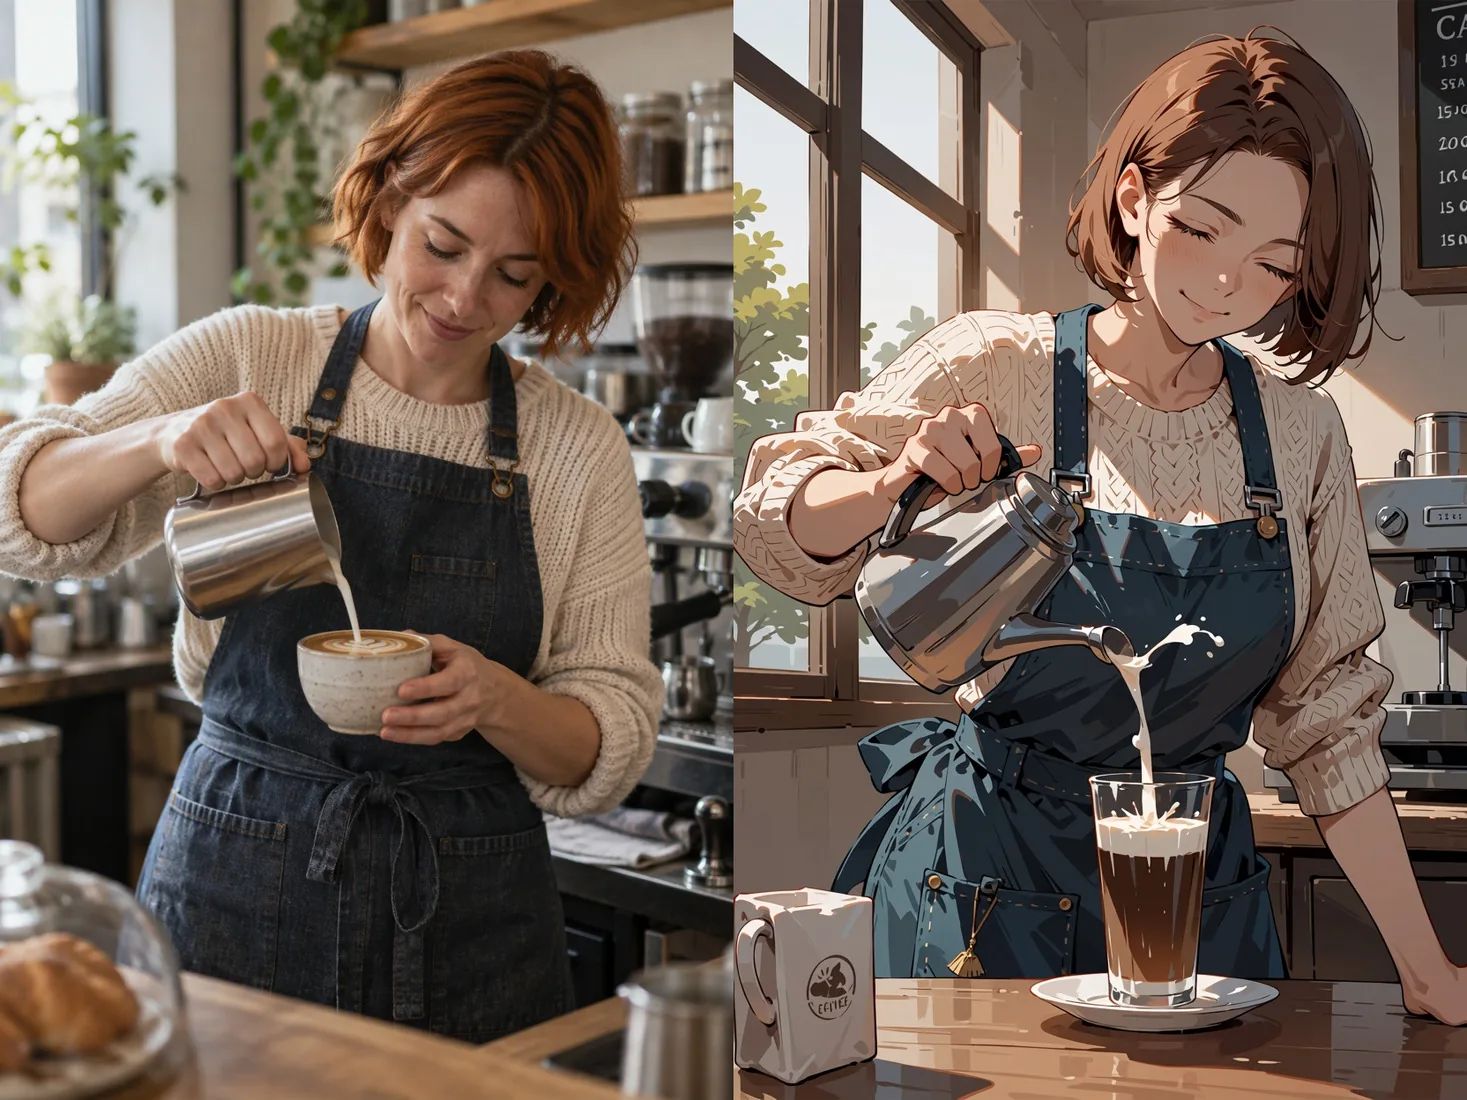
Vorher (links, Ausgangsfoto) und nachher (rechts, Anima Turbo bei Stärke 0.75). Der Bildausschnitt hat sich etwas verschoben: Das Modell zeichnet Details neu, es zeichnet nicht nach.
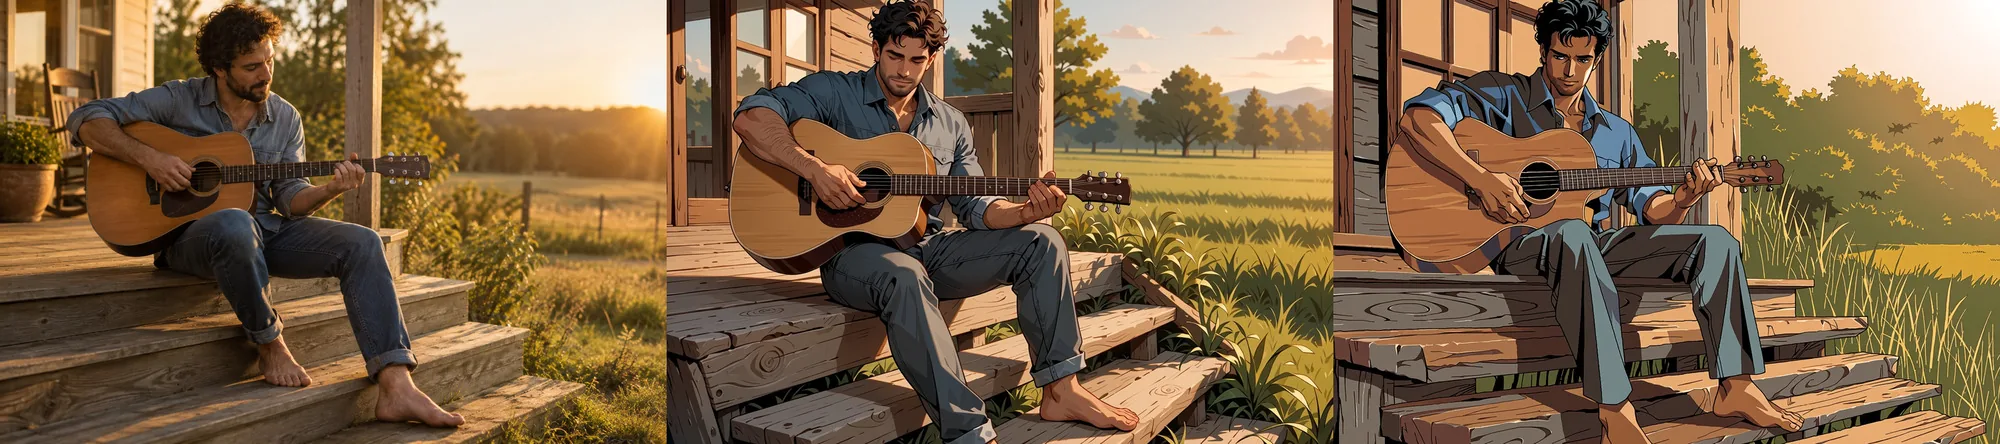
Vorher (links), Anime bei 0.75 (Mitte) und Anime mit der PC-98-LoRA bei 0.75 (rechts). Die Komposition bleibt in beiden nah an der Vorlage.
Bild-zu-Bild gestaltet um; es folgt keinen Bearbeitungsanweisungen (die Bitte an eine Illustration um ein neues Outfit änderte bei 0,6 bis 0,8 kaum etwas). Eine farbige Illustration in Manga-Tusche zu verwandeln, brauchte in unserem Test 0,85, und bei dieser Stärke wird die Pose neu gezeichnet. Beschreiben Sie bei einer Skizze ihr Motiv, beginnen Sie bei 0,75 und erhöhen Sie den Wert nur, wenn die Linienführung zu stark erhalten bleibt.
Verwenden Sie nur Fotos, an denen Sie die Rechte haben. Wandeln Sie niemals das Foto einer echten Person ohne deren Einwilligung in Kunst für Erwachsene um.
Schritt 6 (optional): Ein fertiges Standbild animieren
Wählen Sie Ihr bestes Standbild und geben Sie es zusammen mit einem kurzen Prompt an eine unzensierte Bild-zu-Video-Familie. SpicyAPI hat drei davon: Seedance 2.5 Spicy, Wan 2.2 Spicy und MiniMax H3 Spicy. Jede nimmt ein Bild plus einen Prompt entgegen und liefert ein kurzes Video. Diesen Schritt haben wir mit den Bildern dieses Artikels nicht durchgeführt; Details wie Längen und Einstellungen überlassen wir daher den jeweiligen Modellseiten.
Beenden Sie zuerst das Standbild, denn eine verunglückte Hand im Standbild ist eine verunglückte Hand in jedem Frame, und beschränken Sie den Bewegungs-Prompt auf eine Aktion.
Schritt 7: Häufige Probleme beheben
Die meisten Fehler haben eine Einzeiler-Lösung: den Seed neu würfeln, den LoRA-Scale senken oder strength anpassen.
| Problem | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Eine signaturartige Kritzelei oder eine Zeile Fake-Text in einer Ecke | Eine aus Kunstwerken gelernte Angewohnheit; wir sahen sie bei etwa jedem fünften Bild | Seed ändern; es gibt keinen Negativ-Prompt, der sie unterdrückt; oder zuschneiden |
| Seltsame Hände oder Anatomie | Normal bei Bildmodellen | Seed neu würfeln; Entwürfe in 1k halten, bis ein gutes erscheint |
| Die Figur driftet zwischen den Bildern | Zu viele Wendungen auf einmal geändert | Figurenblock wiederverwenden, Seed beibehalten, eine Wendung ändern |
| Stil zu stark oder das Bild zerfällt | LoRA-Scale zu hoch | Auf 0,5 bis 1,2 senken; Scale 4 zerlegt das Bild |
| Die LoRA bewirkt nichts | Für ein anderes Basismodell trainiert oder Triggerwort fehlt | Basismodell prüfen und Triggerwörter ergänzen |
| Das Foto sieht noch wie ein Foto aus | strength zu niedrig | Richtung 0.75 erhöhen |
| Details ändern sich bei Bild-zu-Bild zu stark | strength zu hoch | Von 0.9 aus senken |
Hier das erste Beispiel: In der Ecke dieser Café-Szene landete eine Zeile Pseudotext.
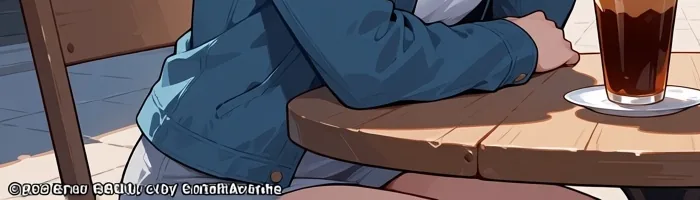
Eine signaturartige Kritzelei in einer Ecke (Ausschnitt eines Bildes mit 1360 x 768).
Seeds machen Läufe vergleichbar, garantieren aber keine identischen Pixel; speichern Sie daher die Bilder, die Ihnen gefallen.
Schritt 8: Privat und nur für Erwachsene halten
Sie sind verantwortlich für das, was Sie erzeugen, speichern und teilen. Jede Figur ist erwachsen, und der Prompt sagt es; kein Abbild einer echten Person ohne Einwilligung; keine Minderjährigen oder jugendlich wirkenden Figuren, niemals; bewahren Sie Ergebnisse in einem Speicher auf, den Sie kontrollieren; und beachten Sie die Gesetze an Ihrem Wohnort.
Der ganze Workflow als Checkliste
| Erledigt? | Prüfpunkt |
|---|---|
| ☐ | Figurenblock einmal geschrieben: Qualitäts-Tags, Rating-Tag, Personenzahl, Altersangabe, Look, ein Merkmal |
| ☐ | Rating-Tag bewusst gewählt (safe oder sensitive für alles, was Sie teilen) |
| ☐ | Verhältnis passend zur Verwendung gewählt; in 1k entworfen |
| ☐ | Treffer in 1.5k neu gerendert |
| ☐ | LoRA ist Anima-kompatibel, Triggerwörter drin, Scale 0,5 bis 1,2 |
| ☐ | Fotoreferenzen mit strength 0.75, der Prompt beschreibt das Foto |
| ☐ | Ecken auf Kritzeleien und Hände geprüft |
| ☐ | Optional: Standbild mit einer Bild-zu-Video-Familie animiert |
| ☐ | Ergebnisse privat gespeichert; nur Erwachsene |
Eine kurze Prompt-Vorlage
Füllen Sie die Klammern aus und behalten Sie den Rest. Diese Version ist eine bekleidete Szene mit sensitive.
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
[hair], [eyes], [one distinctive mark], [outfit: e.g. black slip dress],
[place and pose: e.g. leaning on a balcony at night], looking at viewer,
[light: e.g. warm lamp light, city lights]
Verwenden Sie für zwei Personen 1girl, 1boy und je eine Kleidungswendung; für einen Stil ergänzen Sie die Triggerwörter der LoRA. Mehr finden Sie in unserem Testbericht zu Anima Turbo, und für das breitere Feld vergleichen Sie andere NSFW-Bildgeneratoren.
FAQ
Kann ich auf SpicyAPI wirklich NSFW-Anime-Art mit KI erstellen?
Ja. Anima Turbo und Anima Turbo LoRA sind unzensiert, ohne Content-Filter, und wir sahen über vier Inhaltsstufen keine einzige Ablehnung. Sie bleiben verantwortlich für das, was Sie erstellen.
Wie bekomme ich am besten eine konsistente Figur?
Schreiben Sie einen Tag-Block für Gesicht, Haare und ein auffälliges Merkmal, fügen Sie ihn in jeden Prompt ein und behalten Sie den Seed bei, während Sie jeweils nur eine Wendung ändern. In unserem Set mit dem silbernen Bob trug das eine Figur durch drei Outfits.
Welches Rating-Tag sollte ich verwenden?
Nutzen Sie safe für alles, was Sie teilen wollen, und sensitive für anzügliche, aber bekleidete Szenen. Das Modell kennt außerdem nsfw und ein stärkeres Tag, die der Herausgeber als Aufhebung der Zurückhaltung dokumentiert. Bei einer bekleideten Szene lieferten safe und sensitive fast dasselbe Bild.
Mit welchem LoRA-Scale sollte ich beginnen?
Beginnen Sie mit 1 und den Triggerwörtern und bewegen Sie sich dann zwischen 0,5 und 1,2. In unseren Tests war 0,5 eine leichte Berührung, 1,5 drückte den Stil stärker, und 4 zerlegte das Bild.
Welche Stärke macht aus einem Foto Anime?
0.75. In unserer Leiter ergab das sauberen Anime bei intakter Komposition. Bei 0,3 war es noch ein Foto, ab 0,9 begannen sich Details zu verändern, und bei 1,0 wurde die Vorlage ignoriert.
Warum steht eine Signatur oder ein Fake-Text in der Ecke?
Das Modell hat es sich aus Kunstwerken angeeignet. Wir sahen es bei etwa jedem fünften Bild, und ein Negativ-Prompt kann es nicht unterdrücken, weil es keinen gibt. Ändern Sie den Seed oder schneiden Sie die Ecke zu.
Kann ich ein fertiges Bild in ein Video verwandeln?
Ja, mit einer unzensierten Bild-zu-Video-Familie wie Seedance 2.5 Spicy, Wan 2.2 Spicy oder MiniMax H3 Spicy. Jede nimmt ein Bild und einen Prompt entgegen und liefert einen kurzen Clip. Auf der Modellseite steht, was jede akzeptiert.
Darf ich das Foto einer echten Person verwenden?
Nicht ohne deren Einwilligung und nicht für Kunst für Erwachsene. Verwenden Sie fiktive Figuren oder Ihre eigenen Originalskizzen und Fotos einwilligender Erwachsener, und halten Sie die Ergebnisse privat.