Le flux de travail qui a le mieux fonctionné dans nos tests : concevoir un personnage adulte en tags, régler le ton avec un tag de classification, faire les brouillons en 1k, finaliser en 1.5k, ajouter un LoRA de style, et corriger les problèmes en changeant le seed ou le scale plutôt qu’en réécrivant le prompt. Nous avons déroulé toute la chaîne sur Anima Turbo, un modèle d’anime et d’illustration sans censure sur SpicyAPI : il n’y a pas de filtre de contenu, et notre sonde de contenu la plus forte a été rendue telle qu’écrite dès le premier essai.
Ce guide est la version pratique : huit étapes, de l’idée à une série terminée, chaque prompt testé le 5 octobre 2026. Chaque prompt imprimé ici décrit une scène habillée, suggestive au plus, avec des personnages adultes, car c’est tout ce que nous publions. Des tons plus forts existent et sont à un tag de classification de distance ; nous expliquons comment fonctionnent les tags sans les imprimer.
En un coup d’œil
| Étape | Ce que vous faites | Réglage clé | Ce que nous avons vu |
|---|---|---|---|
| 1. Personnage | Fixer l’apparence dans un bloc de tags réutilisé | Même seed, même bloc de personnage | Un personnage resté reconnaissable sur trois tenues |
| 2. Ton | Choisir un tag de classification | safe ou sensitive | Image presque identique pour une scène habillée |
| 3. Scène | Choisir le format et le palier | Brouillons en 1k, finales en 1.5k | 2 à 16 secondes par image |
| 4. Style | Ajouter un LoRA | Scale de 0,5 à 1,2 | Un scale de 4 a fait éclater l’image |
| 5. Référence | Transformer une photo ou un croquis en anime | strength 0.75 | Anime net, composition conservée |
| 6. Mouvement | Animer une image terminée (facultatif) | Image plus prompt | Court clip d’une famille vidéo sans censure |
| 7. Retouche | Relancer, baisser, ajuster | Seed, scale, strength | Gribouillis de signature et dérive sont corrigeables |
| 8. Confidentialité | Garder les sorties privées | Votre propre stockage | Votre responsabilité |
Étape 1 : concevoir un personnage adulte en tags
Écrivez le personnage une seule fois, sous forme de bloc de tags, et collez le même bloc dans chaque prompt. Anima suit les tags de style Danbooru, les phrases simples et les mélanges des deux. L’éditeur, CircleStone Labs, documente les conventions de tags sur la fiche du modèle : minuscules, espaces au lieu de tirets bas, et un ordre fixe.
L’ordre qui a fonctionné pour nous :
- tags de qualité :
masterpiece, best quality, éventuellementscore_7 - tag de classification :
safeousensitive(étape 2) - nombre de personnages :
1girl,1boy,1girl, 1boy,no humans - une mention d’âge :
adult woman, mature femaleoumature male - le bloc du personnage : cheveux, yeux, un signe distinctif
- la tenue, le lieu, la pose, la lumière
Dites toujours dans le prompt lui-même que le personnage est adulte, pour que les tags le portent.
Voici la preuve qu’un bloc de personnage fonctionne. Les trois images ci-dessous partagent un seed et un bloc, short silver bob, golden eyes, beauty mark under the left eye. Seuls la tenue et le lieu ont changé : un col roulé dans une galerie, une nuisette de soie rouge sur un balcon, une chemise blanche trop grande sur un rebord de fenêtre.
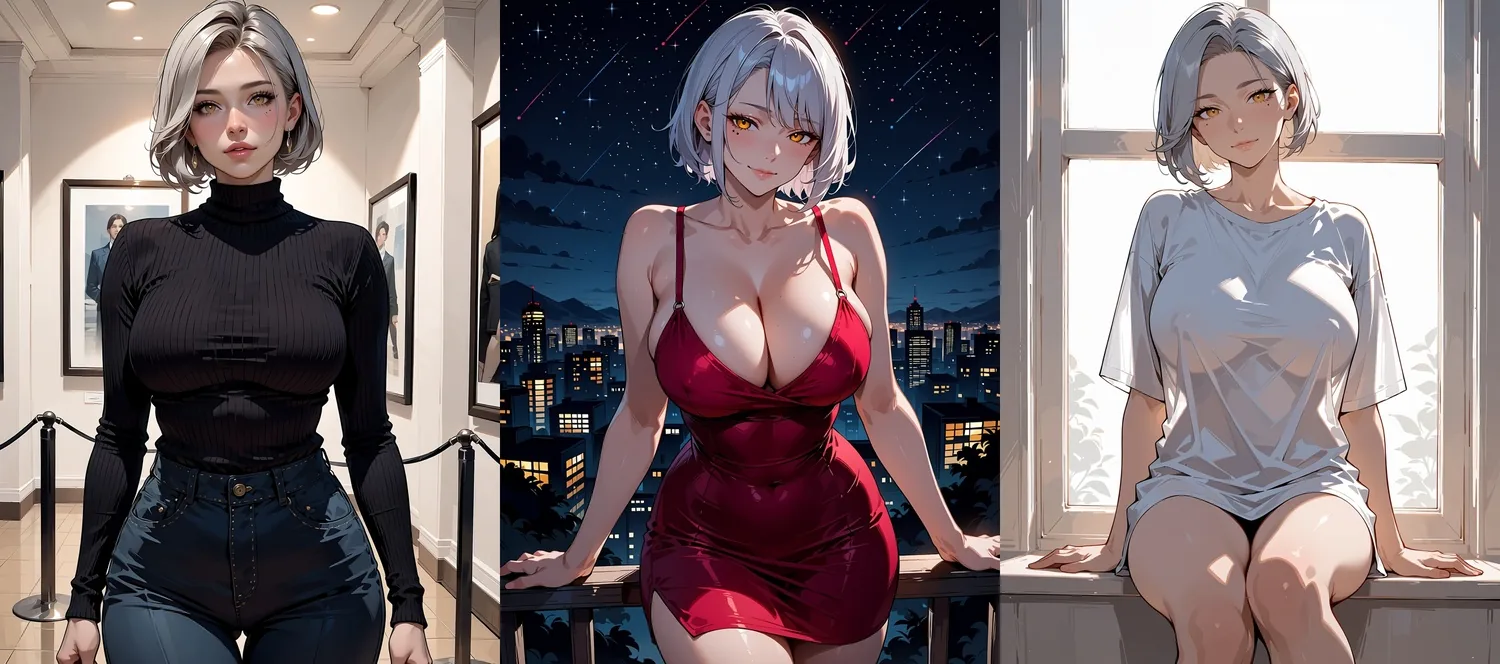
Un bloc de personnage, seed 31, trois tenues (Anima Turbo, 1k, 3:4). Les cheveux, les yeux et le grain de beauté se retrouvent d’une image à l’autre ; la pose et le cadrage changent avec le prompt.
Le premier prompt de la série, pour que vous puissiez copier la forme :
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye, black turtleneck,
standing in an art gallery, looking at viewer
Les deux autres remplacent la tenue et le lieu et utilisent sensitive. Si le visage dérive quand vous changez beaucoup de choses d’un coup, gardez le seed et ne changez qu’une proposition à la fois.
Étape 2 : choisir le ton avec un tag de classification
Comme Anima n’a pas de prompt négatif, le tag de classification est votre principal contrôle du ton. Le modèle connaît safe, sensitive et nsfw, plus un tag plus fort. L’éditeur documente les deux derniers comme les tags qui lèvent la retenue. Nous n’imprimons pas de prompts qui les utilisent et nous ne nommons pas le tag le plus fort, mais vous devez savoir qu’ils existent pour choisir en connaissance de cause.
Pour une scène habillée, safe et sensitive sont proches cousins. La paire ci-dessous utilise le même prompt et le même seed, avec un seul mot changé. Une femme en robe de soirée noire dans un bar d’hôtel est sortie presque identique les deux fois.
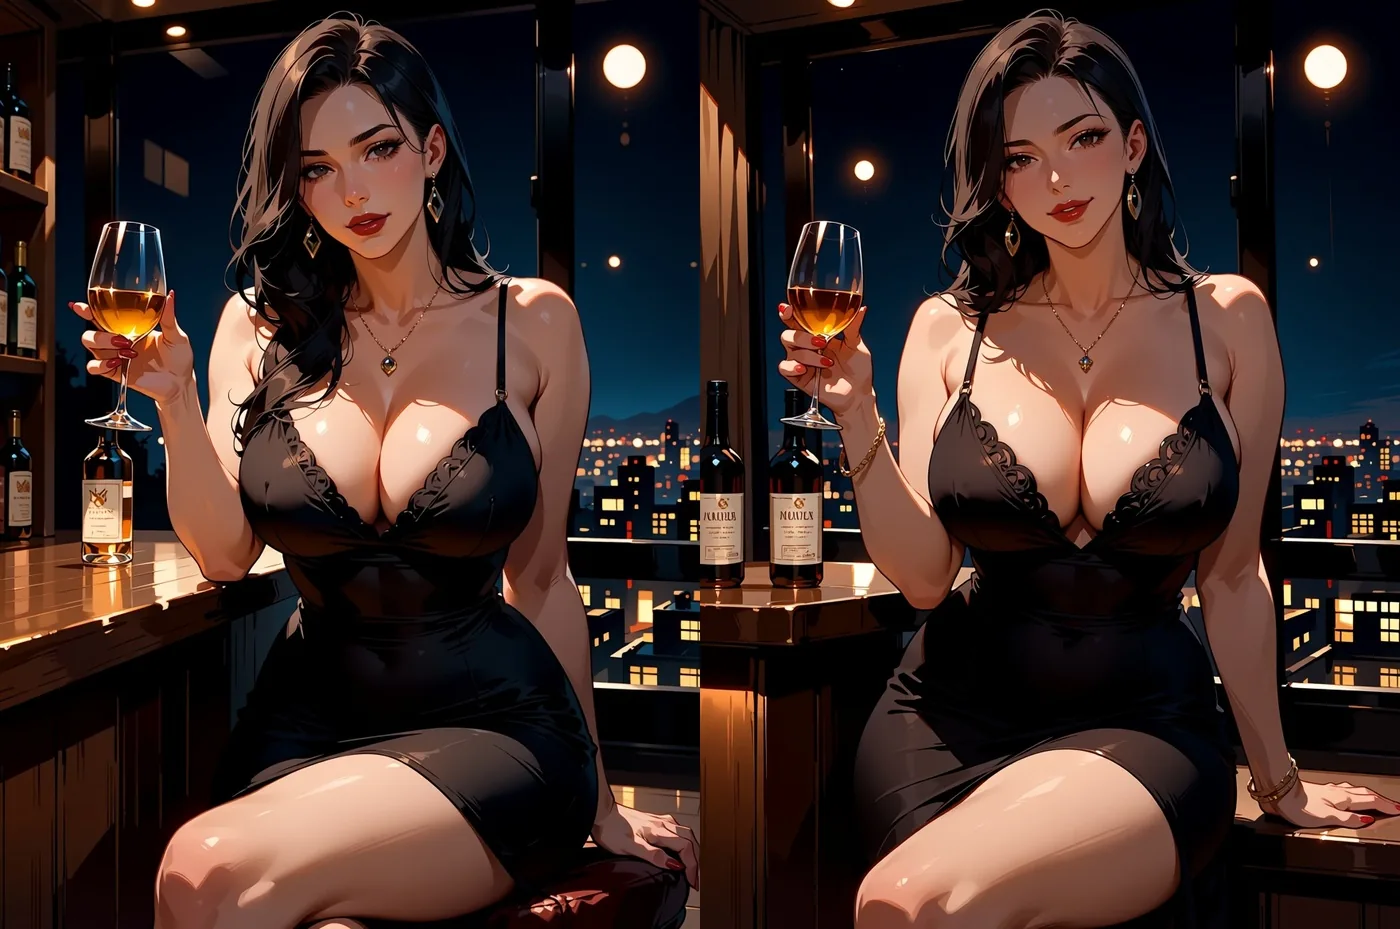
Même prompt, même seed 27, à gauche safe, à droite sensitive (Anima Turbo, 1k, 3:4).
| Tag de classification | Ce qu’il signale | Comment nous l’utilisons |
|---|---|---|
safe | Quotidien, retenu | Par défaut pour les premiers brouillons et tout ce que vous comptez partager |
sensitive | Suggestif au plus | Tenue de soirée, une bretelle qui glisse, danse rapprochée |
nsfw | Lève la retenue | Travail réservé aux adultes, à vos risques et sous votre responsabilité |
| Un tag plus fort | La lève encore davantage | Pareil ; lisez la fiche du modèle |
Sur 25 requêtes à quatre niveaux de contenu, en texte vers image et en image vers image, avec et sans LoRA, nous avons constaté zéro refus et zéro substitution. L’anatomie et les mains demandent encore de relancer le seed, comme avec n’importe quel modèle d’image (étape 7).
Étape 3 : composer la scène
Choisissez le format d’image pour l’histoire, faites les brouillons en 1k, et ne dépensez un rendu 1.5k que pour les images retenues. Le texte vers image accepte aspect_ratio (15 options, 1:1 par défaut), resolution (1k ou 1.5k) et seed. Le format d’image ne change pas le prix ; le palier 1.5k coûte plus cher que le 1k, ce qui est la raison de faire les brouillons en petit. Le prix en direct est sur la page texte vers image.
| Usage | Format | Taille 1k | Taille 1.5k |
|---|---|---|---|
| Portrait, fiche de personnage | 3:4 | 880 x 1168 | 1328 x 1760 |
| Fond d’écran de téléphone | 9:16 | 768 x 1360 | 1152 x 2048 |
| Couple cinématographique ou couverture | 16:9 | 1360 x 768 | 2048 x 1152 |
| Plan d’ensemble large | 21:9 | 1552 x 656 | 2048 x 992 |
| Bannière haute | 1:3 | 576 x 1760 | 880 x 2048 |
Le palier 1.5k est généré nativement, sans agrandissement. Sur 60 exécutions chronométrées, le modèle a mis de 2 à 16 secondes par image, 52 sur 60 en moins de 10.
Pour les couples, un cadre large en 16:9, une proposition vestimentaire pour chaque personne et un geste d’ancrage ont fonctionné.
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood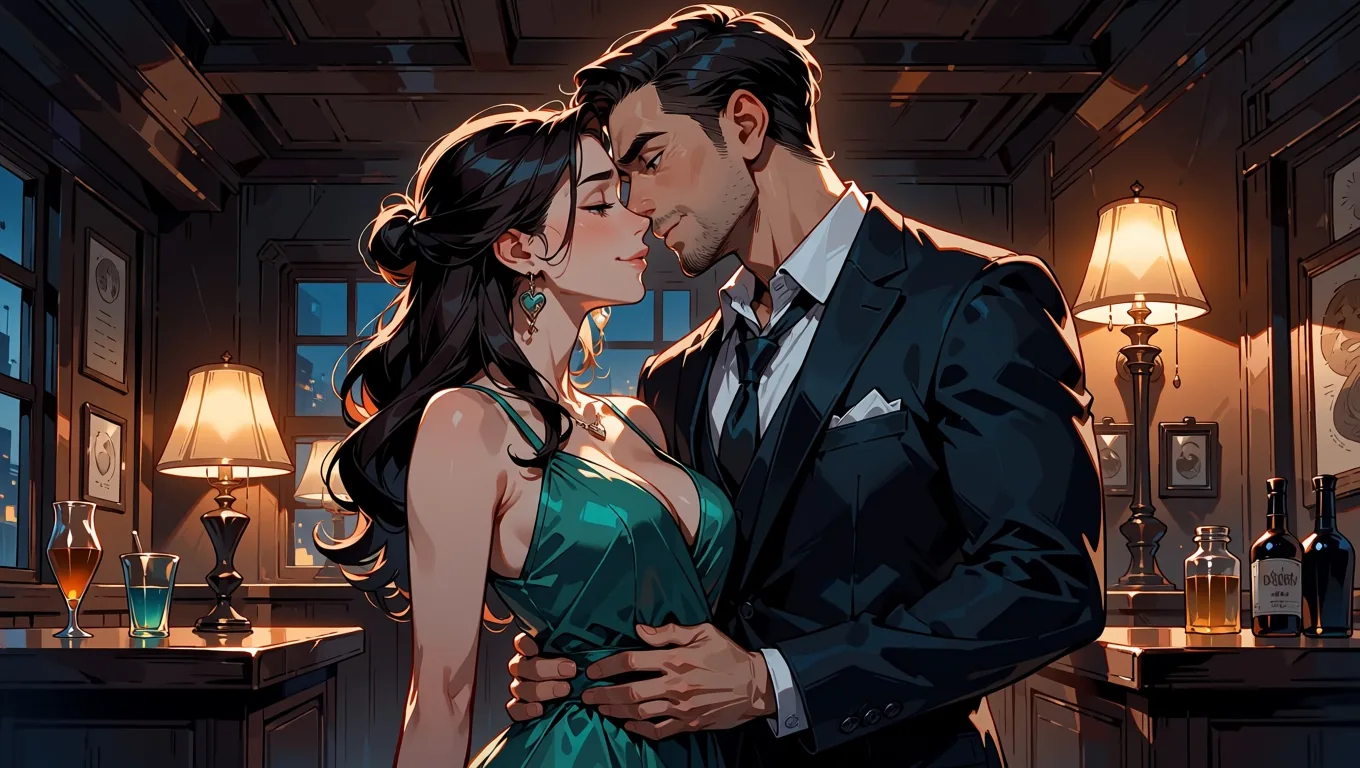
Seed 24, 16:9, 1k, Anima Turbo. Donner à chaque personne sa propre proposition vestimentaire évite que deux silhouettes ne se fondent en une seule.
Si vous préférez les phrases, écrivez-en au moins deux ; l’éditeur avertit que les prompts très courts dérivent.
Étape 4 : donner un style avec un LoRA
Un LoRA est le moyen le plus rapide de donner une identité visuelle à toute une série ; gardez le scale entre 0,5 et 1,2 environ et utilisez les mots déclencheurs. Anima Turbo LoRA est le même modèle avec une liste loras d’au plus trois entrées, chacune {path, scale}. Le path doit être un lien HTTPS direct vers un fichier .safetensors, et ce doit être un LoRA entraîné pour Anima. Le chargement des LoRA n’ajoute aucuns frais distincts.
Deux LoRA publics que nous avons utilisés :
- Melon-Bread/anima-pc98-gal-style-v0.2 (MIT) : un rendu de jeu de l’époque PC-98, mot déclencheur
pc98gal_style. - notverriegod/monochrome-grayscale_style (Apache-2.0) : encre de manga en noir et blanc. Dans notre test, il restait en couleur tant que
monochrome, greyscalen’était pas dans le prompt.
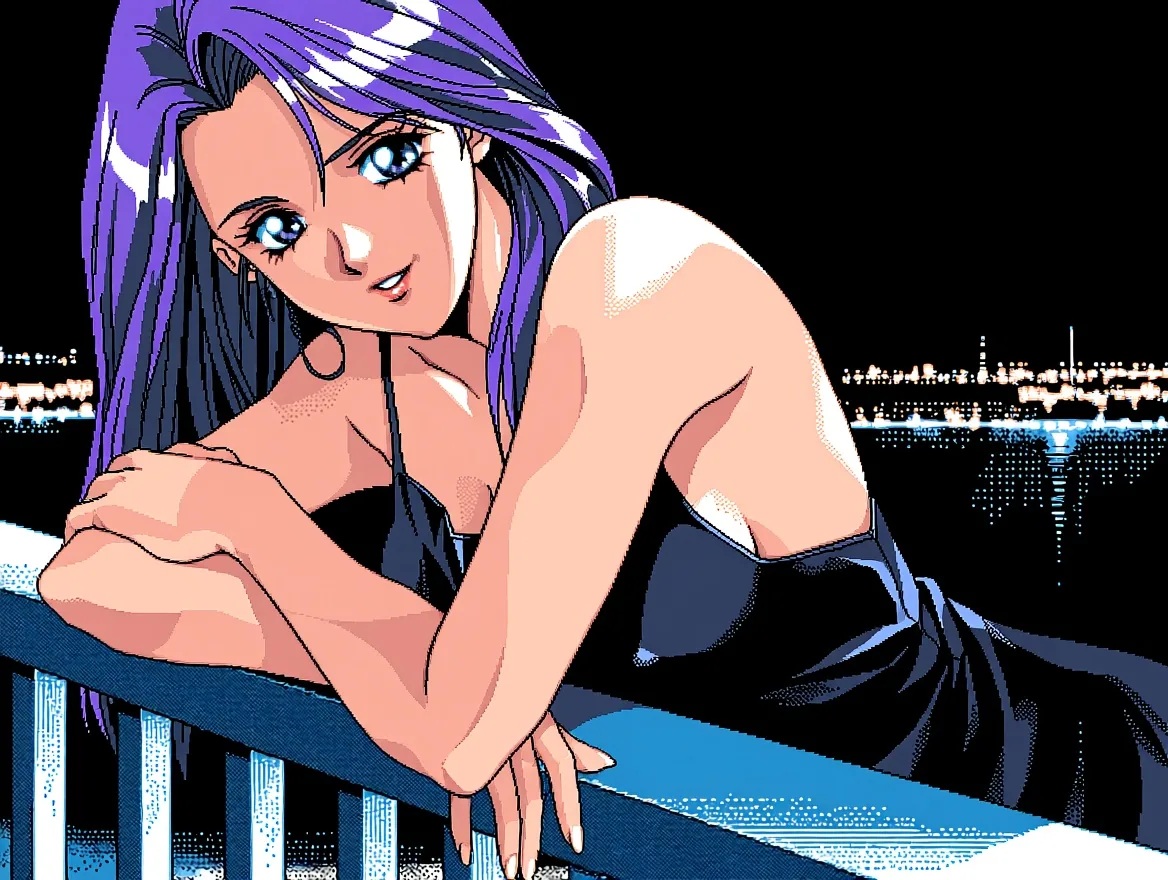
LoRA PC-98 à scale 1, sensitive, 4:3, 1k. Le tramage et l’ombrage cel plat viennent du LoRA.
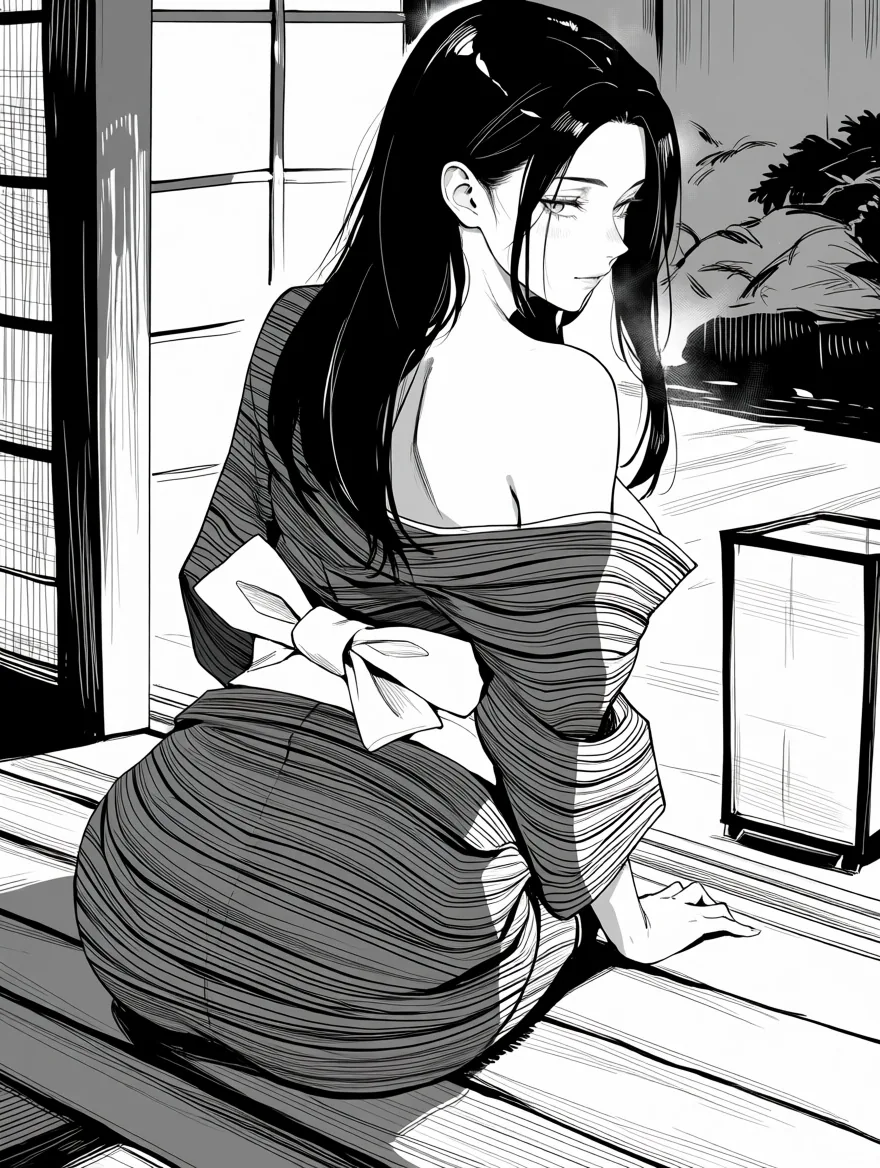
LoRA monochrome à scale 1, sensitive, 3:4, 1k, avec monochrome, greyscale, screentone dans le prompt.
Le scale est le bouton qui compte. Sur un même prompt et un même seed avec le LoRA PC-98, nous avons comparé 0,5, 1, 1,5 et 4 (de gauche à droite ci-dessous). 0,5 est une touche légère, 1 est le style complet, 1,5 pousse davantage, et 4 a fait éclater l’image en formes abstraites. Un scale de 0 équivaut à l’absence de LoRA.
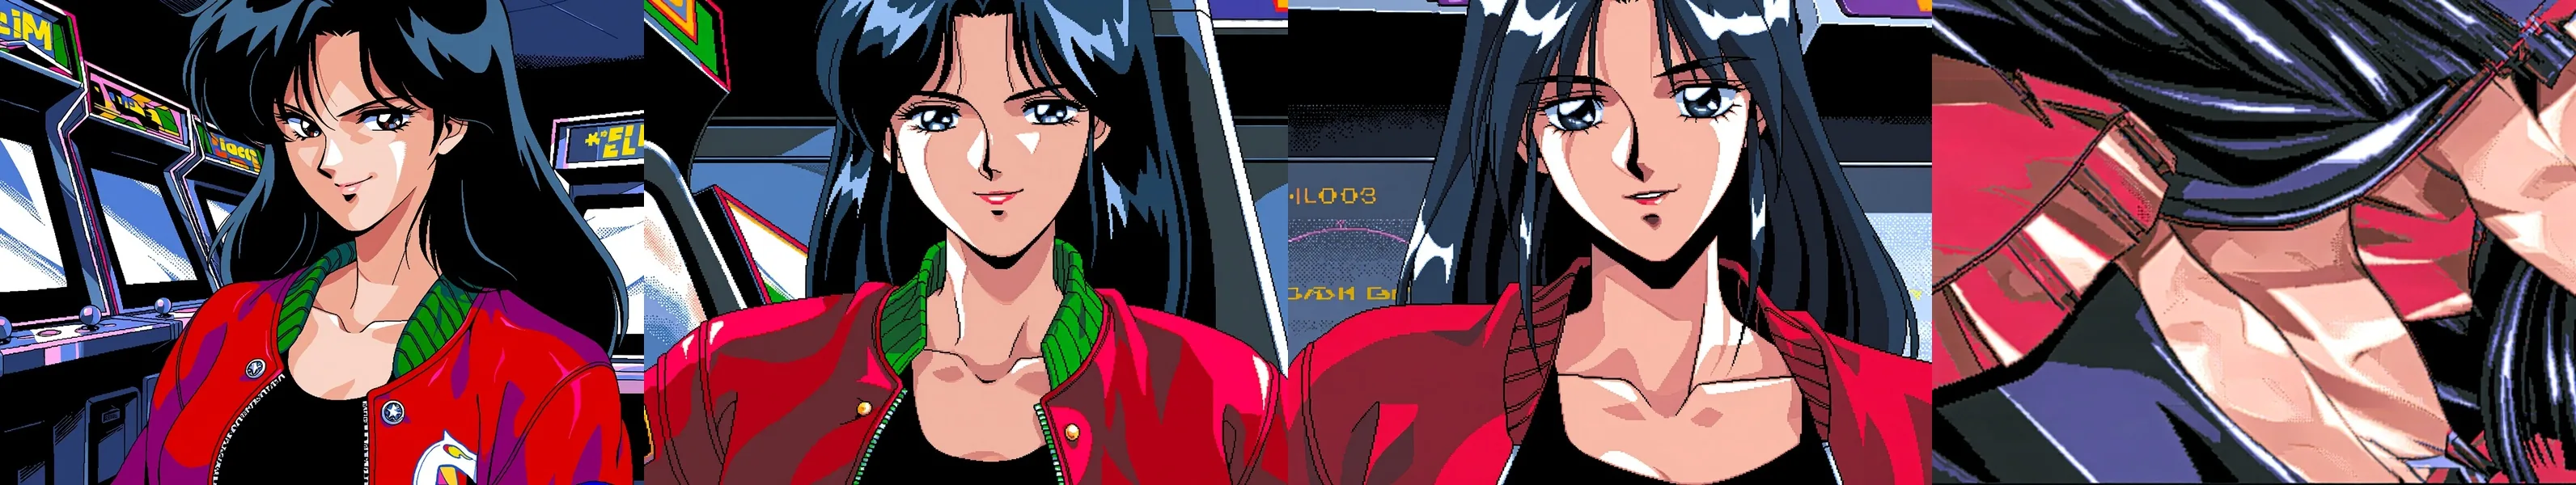
LoRA PC-98 à 0,5, 1, 1,5 et 4 (de gauche à droite), même prompt et même seed.
| Situation | Ce que nous suggérons |
|---|---|
| Premier essai avec n’importe quel LoRA | Scale 1 avec les mots déclencheurs |
| Le style lutte contre le personnage | Descendre à 0,5–0,8 |
| Vous le voulez plus marqué | 1,2, pas 4 |
| Deux ou trois LoRA | Style principal à 1, les autres à 0,6 et 0,25 (cela a fonctionné chez nous) |
| Un LoRA pour un autre modèle de base | Il se charge sans erreur et ne change rien ; vérifiez donc pour quoi il a été entraîné |
La première requête avec un nouveau LoRA peut être lente le temps de récupérer le fichier (l’une des nôtres a pris presque trois minutes). Un lien qui exige une connexion, ou qui pointe vers une page de dépôt au lieu du fichier, échoue avec un message clair et n’est pas facturé. Notre guide des styles LoRA, plus long, passe en revue d’autres combinaisons.
Étape 5 : transformer une photo ou un croquis en anime
Envoyez votre référence dans image_url, décrivez ce qu’elle contient déjà et réglez strength sur 0.75. L’image vers image sur la page de retouche accepte prompt, image_url, strength (0 à 1, 0.8 par défaut), resolution et seed. Il n’y a pas de champ de format d’image : la sortie garde la forme de la source. Elle coûte autant que le texte vers image.
Dans notre échelle de force sur une photo, 0,3 restait une photo, 0,6 se lisait déjà comme une illustration, 0,75 donnait un anime net avec la même composition, à partir de 0,9 les détails commençaient à changer, et à 1,0 la source était ignorée. À 0, la source revient intacte. Notre guide de la force dédié montre toute l’échelle.
Les images « avant » ci-dessous sont des photographies sources que nous avons générées pour le test avec GPT Image 2.5 : des adultes fictifs, pas de vraies personnes. Ce sont des entrées, pas des sorties d’Anima.
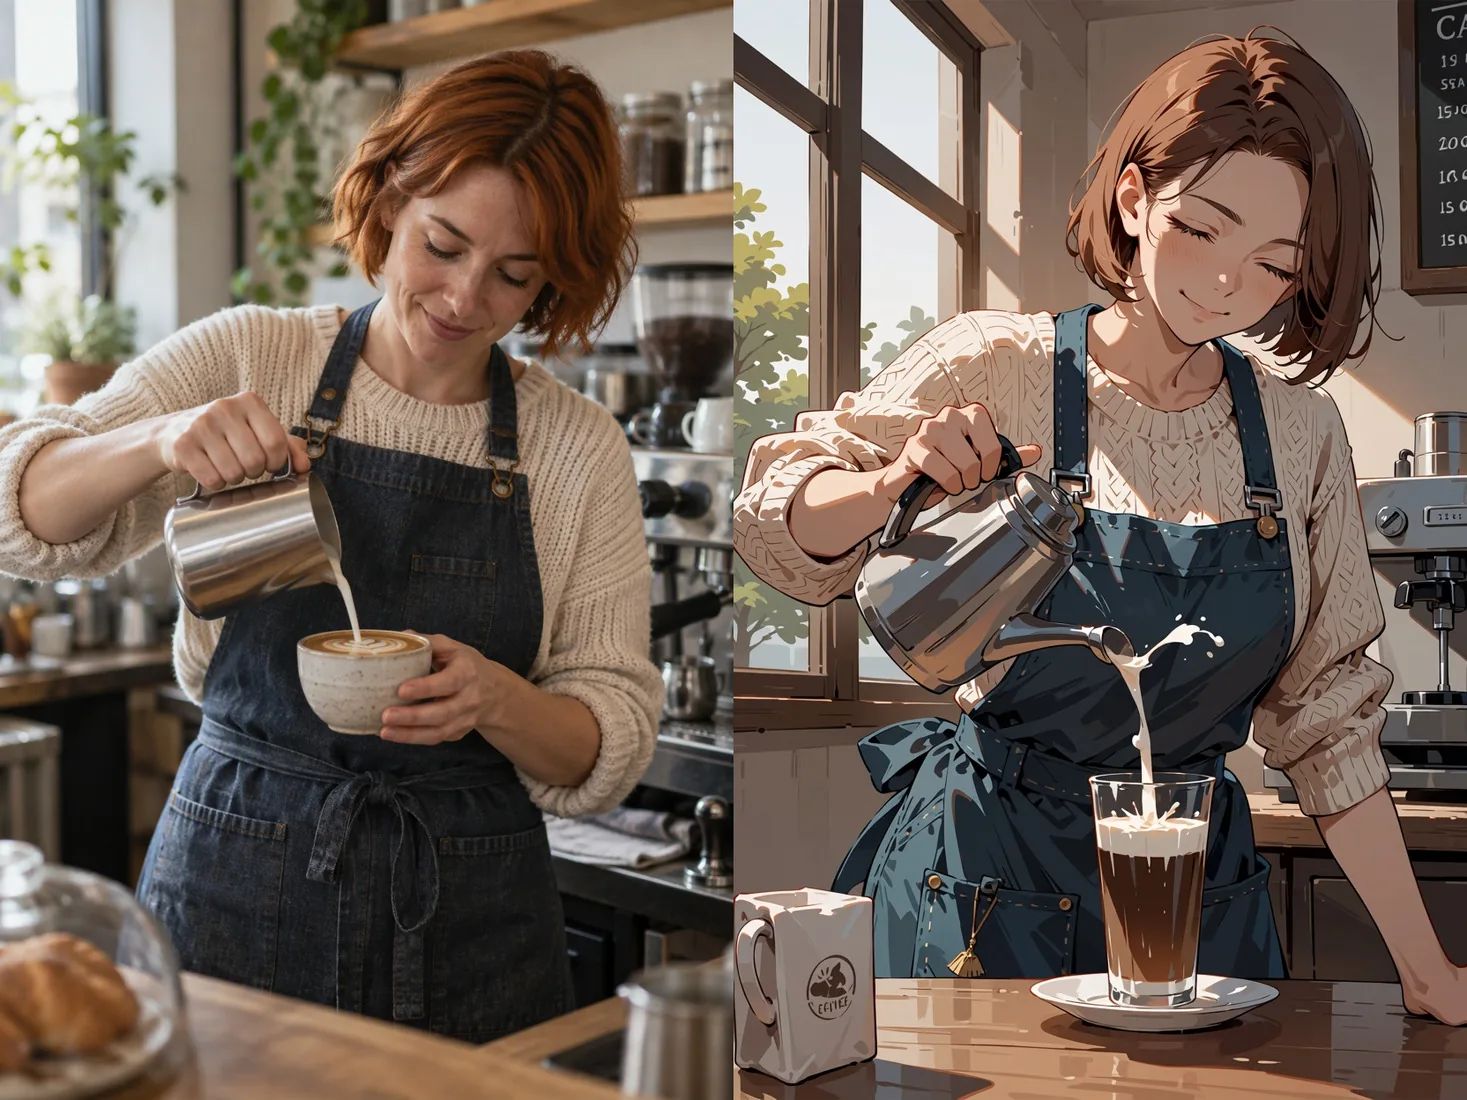
Avant (à gauche, photo source) et après (à droite, Anima Turbo à une force de 0,75). Le cadrage a un peu bougé : le modèle redessine les détails, il ne calque pas.
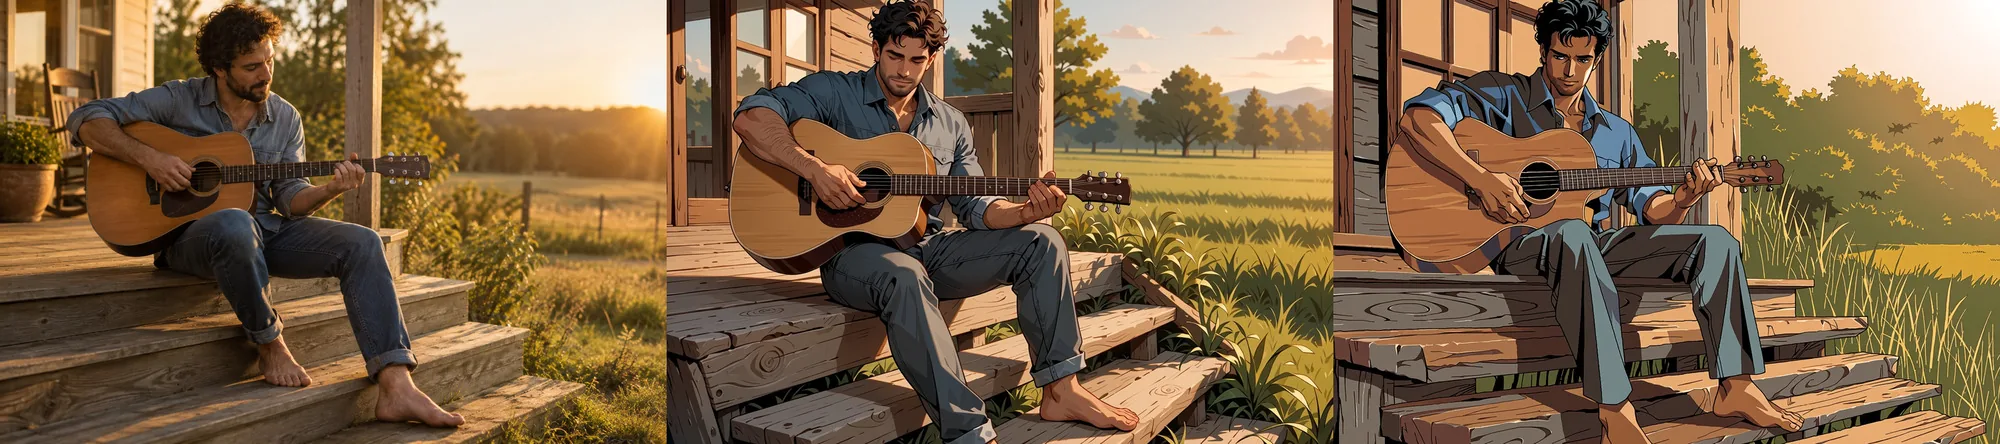
Avant (à gauche), anime à 0,75 (au milieu) et anime avec le LoRA PC-98 à 0,75 (à droite). La composition reste proche de la source dans les deux cas.
L’image vers image restyle ; elle ne suit pas les instructions de retouche (demander une nouvelle tenue à une illustration a très peu changé à 0,6–0,8). Une illustration en couleur passant à l’encre de manga a demandé 0,85 dans notre test, et la pose est redessinée à cette force. Pour un croquis, décrivez son sujet, commencez à 0,75 et ne montez que si le trait survit trop fortement.
N’utilisez que des photos que vous avez le droit d’utiliser. Ne convertissez jamais la photo d’une personne réelle en art destiné aux adultes sans son consentement.
Étape 6 (facultative) : animer une image terminée
Choisissez votre meilleure image, puis confiez-la à une famille d’image vers vidéo sans censure avec un court prompt. SpicyAPI en compte trois : Seedance 2.5 Spicy, Wan 2.2 Spicy et MiniMax H3 Spicy. Chacune prend une image plus un prompt et renvoie une courte vidéo. Nous n’avons pas lancé cette étape sur les images de cet article ; nous laissons donc les détails comme les durées et les réglages à la page de chaque modèle.
Terminez d’abord l’image, car une main ratée dans l’image est une main ratée dans chaque plan, et limitez le prompt de mouvement à une seule action.
Étape 7 : corriger les problèmes courants
La plupart des échecs ont une correction en une ligne : relancer le seed, baisser le scale du LoRA ou ajuster strength.
| Problème | Cause probable | Correction |
|---|---|---|
| Un gribouillis qui ressemble à une signature ou une ligne de faux texte dans un coin | Une habitude héritée des illustrations ; nous l’avons vue sur environ une image sur cinq | Changer le seed ; il n’y a pas de prompt négatif pour l’éviter ; ou recadrer |
| Mains ou anatomie étranges | Normal pour les modèles d’image | Relancer le seed ; garder les brouillons en 1k jusqu’à ce qu’une bonne image apparaisse |
| Le personnage dérive d’une image à l’autre | Trop de propositions changées d’un coup | Réutiliser le bloc du personnage, garder le seed, changer une proposition |
| Style trop fort ou image qui s’effondre | Scale du LoRA trop élevé | Baisser à 0,5–1,2 ; un scale de 4 fait éclater l’image |
| Le LoRA ne fait rien | Entraîné pour un autre modèle de base, ou mot déclencheur manquant | Vérifier le modèle de base et ajouter les mots déclencheurs |
| La photo ressemble encore à une photo | strength trop bas | Aller vers 0.75 |
| Les détails changent trop en image vers image | strength trop haut | Redescendre depuis 0.9 |
Voici le premier cas : le coin de cette scène de café a récupéré une ligne de pseudo-texte.
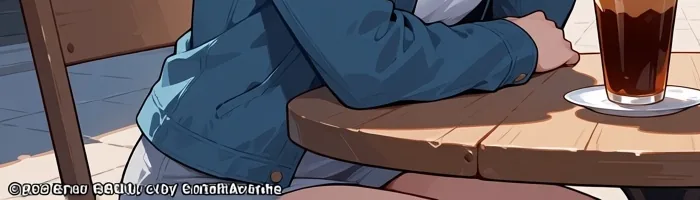
Un gribouillis qui ressemble à une signature dans un coin (recadrage d’une image de 1360 x 768).
Les seeds rendent les exécutions comparables mais ne garantissent pas des pixels identiques ; sauvegardez donc les images qui vous plaisent.
Étape 8 : rester privé et réservé aux adultes
Vous êtes responsable de ce que vous générez, stockez et partagez. Chaque personnage est adulte et le prompt le dit ; aucune ressemblance avec une personne réelle sans consentement ; aucun mineur ni personnage à l’apparence juvénile, jamais ; gardez les sorties dans un stockage que vous contrôlez ; et respectez les lois de votre lieu de résidence.
Le flux de travail complet en liste de contrôle
| Fait ? | Vérification |
|---|---|
| ☐ | Bloc du personnage écrit une fois : tags de qualité, tag de classification, nombre de personnages, mention d’âge, apparence, un signe distinctif |
| ☐ | Tag de classification choisi en connaissance de cause (safe ou sensitive pour tout ce que vous partagez) |
| ☐ | Format choisi pour l’usage ; brouillon en 1k |
| ☐ | Images retenues rendues de nouveau en 1.5k |
| ☐ | LoRA compatible avec Anima, mots déclencheurs présents, scale de 0,5 à 1,2 |
| ☐ | Références photo à strength 0.75, le prompt décrit la photo |
| ☐ | Coins vérifiés pour les gribouillis, mains vérifiées |
| ☐ | Facultatif : image animée avec une famille d’image vers vidéo |
| ☐ | Sorties stockées en privé ; adultes uniquement |
Un court modèle de prompt
Remplissez les crochets et gardez le reste. Cette version est une scène habillée en sensitive.
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
[hair], [eyes], [one distinctive mark], [outfit: e.g. black slip dress],
[place and pose: e.g. leaning on a balcony at night], looking at viewer,
[light: e.g. warm lamp light, city lights]
Pour deux personnes, utilisez 1girl, 1boy et une proposition vestimentaire chacune ; pour un style, ajoutez les mots déclencheurs du LoRA. Pour en savoir plus, voir notre rapport de test d’Anima Turbo, et pour le panorama plus large, comparez d’autres générateurs d’images NSFW.
FAQ
Puis-je vraiment créer de l’art d’anime NSFW avec l’IA sur SpicyAPI ?
Oui. Anima Turbo et Anima Turbo LoRA sont sans censure, sans filtre de contenu, et nous avons constaté zéro refus sur quatre niveaux de contenu. Vous restez responsable de ce que vous créez.
Quelle est la meilleure façon d’obtenir un personnage cohérent ?
Écrivez un bloc de tags pour le visage, les cheveux et un signe distinctif, collez-le dans chaque prompt et gardez le seed en changeant une proposition à la fois. Dans notre planche au carré argenté, cela a porté un même personnage sur trois tenues.
Quel tag de classification utiliser ?
Utilisez safe pour tout ce que vous comptez partager et sensitive pour les scènes suggestives mais habillées. Le modèle connaît aussi nsfw et un tag plus fort, que l’éditeur documente comme levant la retenue. Pour une scène habillée, safe et sensitive ont donné presque la même image.
Quel scale de LoRA choisir pour commencer ?
Commencez à 1 avec les mots déclencheurs, puis bougez dans la plage 0,5–1,2. Dans nos tests, 0,5 était une touche légère, 1,5 poussait davantage le style, et 4 a fait éclater l’image.
Quelle force transforme une photo en anime ?
0.75. Dans notre échelle, elle a donné un anime net avec la composition intacte. À 0,3 c’était encore une photo, à partir de 0,9 les détails commençaient à changer, et à 1,0 la source était ignorée.
Pourquoi y a-t-il une signature ou un faux texte dans le coin ?
Le modèle l’a appris des illustrations. Nous l’avons vu sur environ une image sur cinq, et un prompt négatif ne peut pas l’éviter puisqu’il n’y en a pas. Changez le seed ou recadrez le coin.
Puis-je transformer une image terminée en vidéo ?
Oui, avec une famille d’image vers vidéo sans censure comme Seedance 2.5 Spicy, Wan 2.2 Spicy ou MiniMax H3 Spicy. Chacune prend une image et un prompt et renvoie un court clip. Consultez la page du modèle pour savoir ce que chacune accepte.
Puis-je utiliser la photo d’une personne réelle ?
Pas sans le consentement de cette personne, et pas pour de l’art destiné aux adultes. Utilisez des personnages fictifs ou vos propres croquis et photos d’adultes consentants, et gardez les sorties privées.