O fluxo que funcionou melhor nos nossos testes é: criar um personagem adulto em tags, definir o tom com uma tag de classificação, fazer rascunhos em 1k, finalizar em 1.5k, adicionar uma LoRA de estilo e corrigir problemas trocando a seed ou a escala, em vez de reescrever o prompt. Rodamos a cadeia inteira no Anima Turbo, um modelo de anime e ilustração sem censura na SpicyAPI: não há filtro de conteúdo, e nosso teste de conteúdo mais forte saiu como escrito, de primeira.
Este guia é a versão prática: oito passos, da ideia ao conjunto finalizado, com todos os prompts testados em 5 de outubro de 2026. Todo prompt publicado aqui é uma cena com personagens adultos vestidos, no máximo sugestiva, porque é só isso que publicamos. Tons mais fortes existem e estão a uma tag de classificação de distância; explicamos como as tags funcionam sem publicá-las.
Visão geral
| Passo | O que você faz | Configuração-chave | O que vimos |
|---|---|---|---|
| 1. Personagem | Fixar o visual num bloco de tags reutilizável | Mesma seed, mesmo bloco de personagem | Um personagem continuou reconhecível em três roupas |
| 2. Tom | Escolher uma tag de classificação | safe ou sensitive | Imagem quase igual numa cena com personagem vestido |
| 3. Cena | Escolher proporção e nível | Rascunhos em 1k, finais em 1.5k | De 2 a 16 segundos por imagem |
| 4. Estilo | Adicionar uma LoRA | Escala de 0,5 a 1,2 | A escala 4 desfez a imagem |
| 5. Referência | Transformar uma foto ou esboço em anime | strength 0.75 | Anime limpo, composição mantida |
| 6. Movimento | Animar uma imagem finalizada (opcional) | Imagem mais prompt | Clipe curto de uma família de vídeo sem censura |
| 7. Reparo | Gerar de novo, reduzir, ajustar | Seed, scale, strength | Rabiscos de assinatura e variações têm solução |
| 8. Privacidade | Manter os resultados privados | Seu próprio armazenamento | Sua responsabilidade |
Passo 1: crie um personagem adulto em tags
Escreva o personagem uma vez, como um bloco de tags, e cole o mesmo bloco em todos os prompts. O Anima segue tags no estilo Danbooru, frases comuns e misturas dos dois. A desenvolvedora, a CircleStone Labs, documenta as convenções de tags no model card: minúsculas, espaços no lugar de sublinhados e uma ordem fixa.
A ordem que funcionou para nós:
- tags de qualidade:
masterpiece, best quality, opcionalmentescore_7 - tag de classificação:
safeousensitive(passo 2) - número de pessoas:
1girl,1boy,1girl, 1boy,no humans - uma declaração de idade:
adult woman, mature femaleoumature male - o bloco do personagem: cabelo, olhos, uma marca distintiva
- a roupa, o lugar, a pose, a luz
Diga sempre no próprio prompt que o personagem é adulto, para que as tags carreguem isso.
Esta é a prova de que um bloco de personagem funciona. As três imagens abaixo compartilham uma seed e um bloco, short silver bob, golden eyes, beauty mark under the left eye. Só a roupa e o lugar mudaram: gola alta numa galeria, vestido de seda vermelho numa varanda, camisa branca larga no parapeito de uma janela.
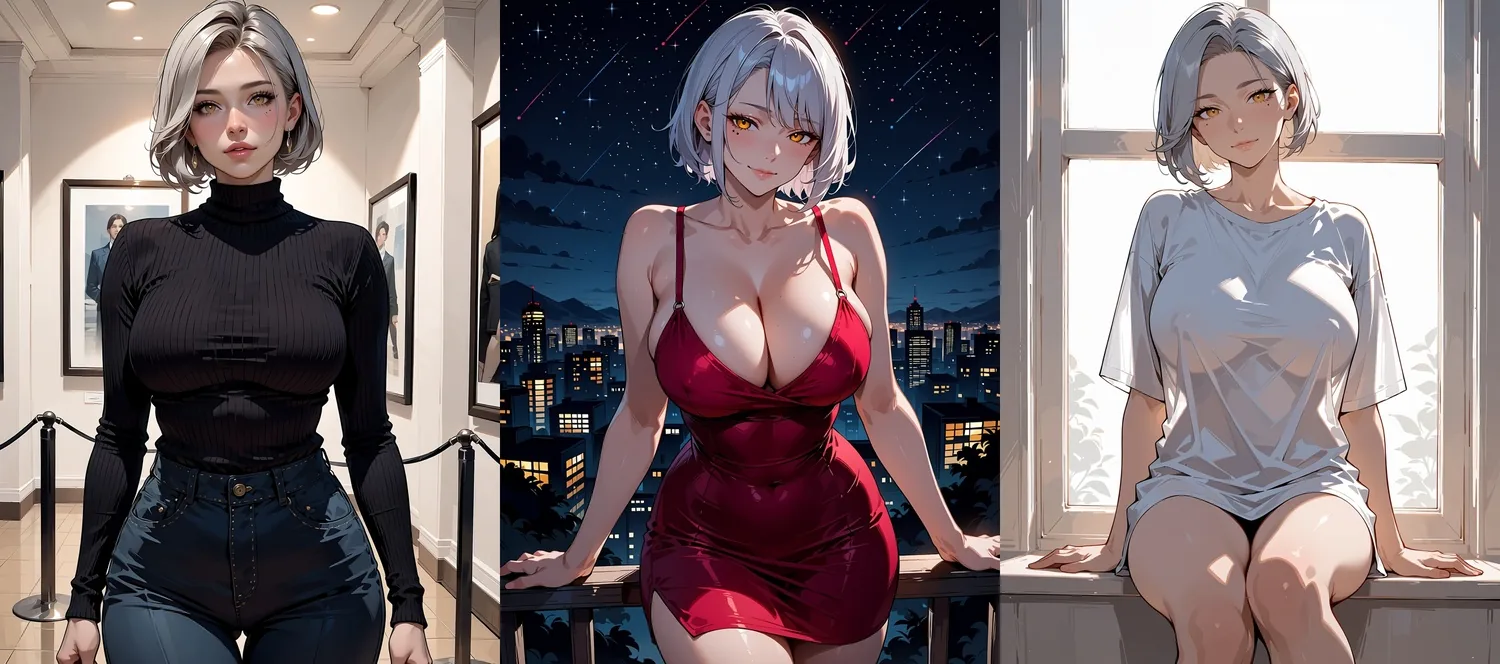
Um bloco de personagem, seed 31, três roupas (Anima Turbo, 1k, 3:4). O cabelo, os olhos e a pinta se mantêm; a pose e o enquadramento mudam com o prompt.
O primeiro prompt do conjunto, para você copiar a estrutura:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye, black turtleneck,
standing in an art gallery, looking at viewer
Os outros dois trocam a roupa e o lugar e usam sensitive. Se o rosto variar quando você muda muita coisa de uma vez, mantenha a seed e mude uma oração por vez.
Passo 2: escolha o tom com uma tag de classificação
Como o Anima não tem prompt negativo, a tag de classificação é o seu principal controle de tom. O modelo conhece safe, sensitive e nsfw, além de uma tag mais forte. A desenvolvedora documenta as duas últimas como as tags que tiram a contenção. Não publicamos prompts que as usem nem nomeamos a tag mais forte, mas você deve saber que elas existem para escolher de propósito.
Numa cena com personagem vestido, safe e sensitive são parentes próximas. O par abaixo usa o mesmo prompt e a mesma seed, mudando só essa palavra. Uma mulher de vestido de noite preto num bar de hotel saiu quase idêntica nas duas vezes.
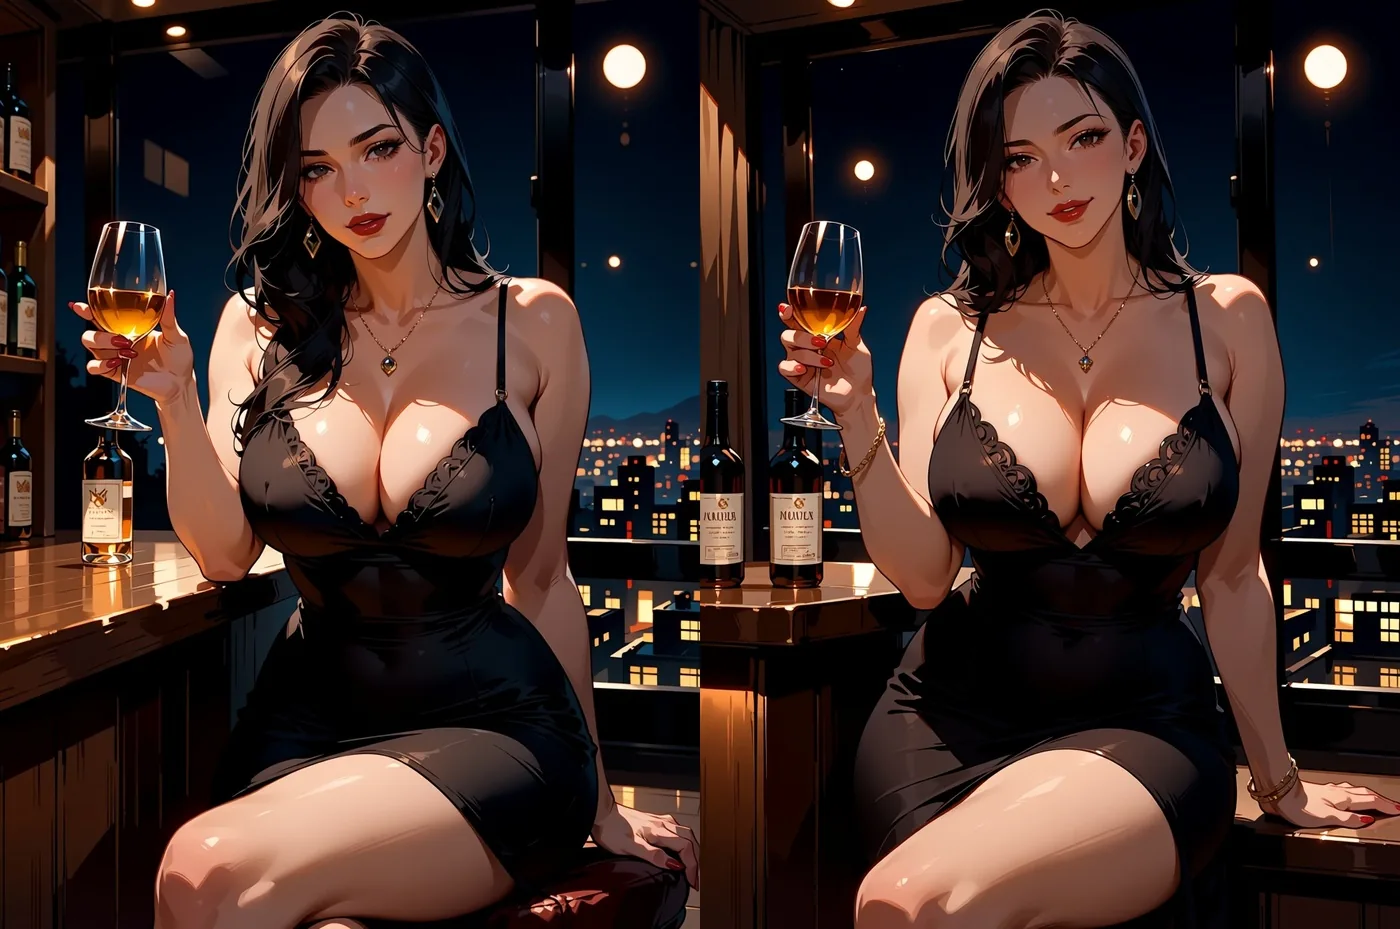
Mesmo prompt, mesma seed 27, à esquerda safe, à direita sensitive (Anima Turbo, 1k, 3:4).
| Tag de classificação | O que sinaliza | Como usamos |
|---|---|---|
safe | Cotidiano, contido | Padrão para os primeiros rascunhos e para o que você pretende compartilhar |
sensitive | No máximo sugestivo | Roupa de noite, uma alça escorregando, dança colada |
nsfw | Tira a contenção | Trabalho só para adultos, por sua conta e risco |
| Uma tag mais forte | Tira ainda mais | Igual; leia o model card |
Em 25 requisições em quatro níveis de conteúdo, texto para imagem e imagem para imagem, com e sem LoRAs, tivemos zero recusas e zero substituições. Anatomia e mãos ainda exigem novas seeds, como em qualquer modelo de imagem (passo 7).
Passo 3: componha a cena
Escolha a proporção pela história, faça rascunhos em 1k e só então gaste uma geração em 1.5k com as imagens que ficarem. Texto para imagem aceita aspect_ratio (15 opções, padrão 1:1), resolution (1k ou 1.5k) e seed. A proporção não muda o preço; o nível 1.5k custa mais que o 1k, e é por isso que se faz rascunho pequeno. O preço atual está na página de texto para imagem.
| Uso | Proporção | Tamanho em 1k | Tamanho em 1.5k |
|---|---|---|---|
| Retrato, ficha de personagem | 3:4 | 880 x 1168 | 1328 x 1760 |
| Papel de parede de celular | 9:16 | 768 x 1360 | 1152 x 2048 |
| Casal cinematográfico ou capa | 16:9 | 1360 x 768 | 2048 x 1152 |
| Plano geral aberto | 21:9 | 1552 x 656 | 2048 x 992 |
| Banner vertical | 1:3 | 576 x 1760 | 880 x 2048 |
O nível 1.5k é gerado de forma nativa, sem upscale. Em 60 execuções cronometradas, o modelo levou de 2 a 16 segundos por imagem, 52 de 60 em menos de 10.
Para casais, funcionou um quadro largo em 16:9, uma oração de roupa para cada pessoa e um gesto de ancoragem.
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood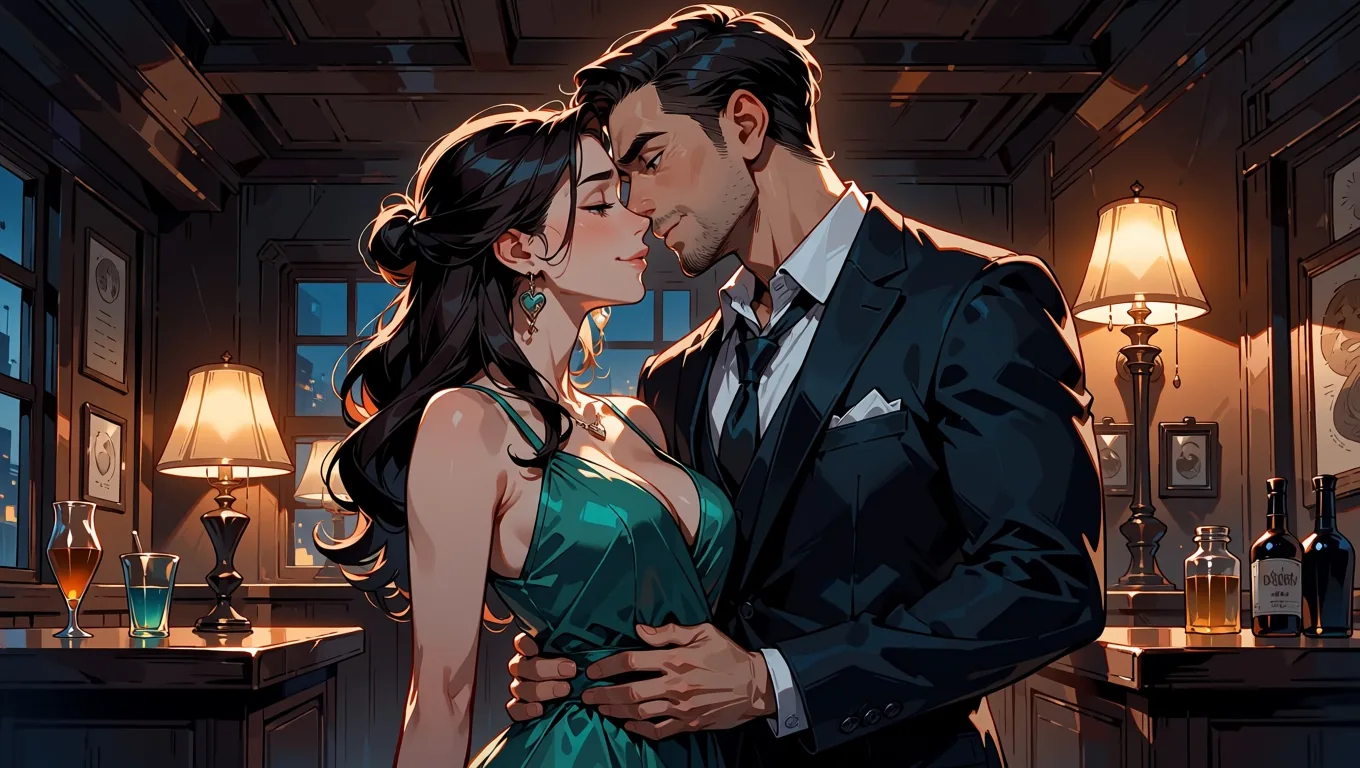
Seed 24, 16:9, 1k, Anima Turbo. Dar a cada pessoa a sua própria oração de roupa é o que impede as duas figuras de se fundirem numa só.
Se preferir frases, escreva pelo menos duas; a desenvolvedora avisa que prompts muito curtos se perdem.
Passo 4: dê um estilo com uma LoRA
Uma LoRA é a forma mais rápida de dar a um conjunto inteiro uma única identidade visual; mantenha a escala entre cerca de 0,5 e 1,2 e use as palavras-gatilho. O Anima Turbo LoRA é o mesmo modelo com uma lista loras de até três entradas, cada uma {path, scale}. O path precisa ser um link HTTPS direto para um arquivo .safetensors, e precisa ser uma LoRA treinada para o Anima. Carregar LoRAs não gera cobrança separada.
Duas LoRAs públicas que usamos:
- Melon-Bread/anima-pc98-gal-style-v0.2 (MIT): um visual de jogo da era PC-98, gatilho
pc98gal_style. - notverriegod/monochrome-grayscale_style (Apache-2.0): tinta de mangá em preto e branco. No nosso teste, ela ficou em cores até
monochrome, greyscaleentrar no prompt.
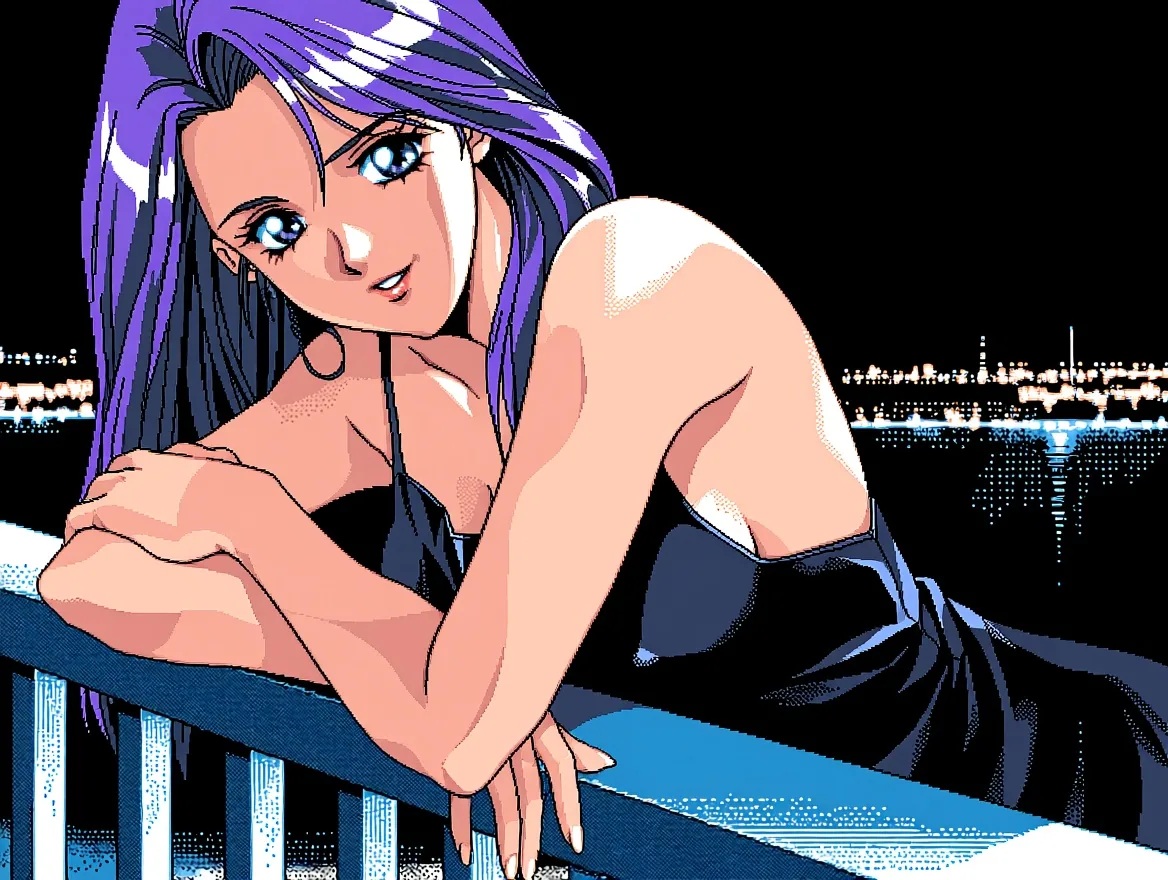
LoRA PC-98 com scale 1, sensitive, 4:3, 1k. O dithering e o sombreado chapado de cel vêm da LoRA.
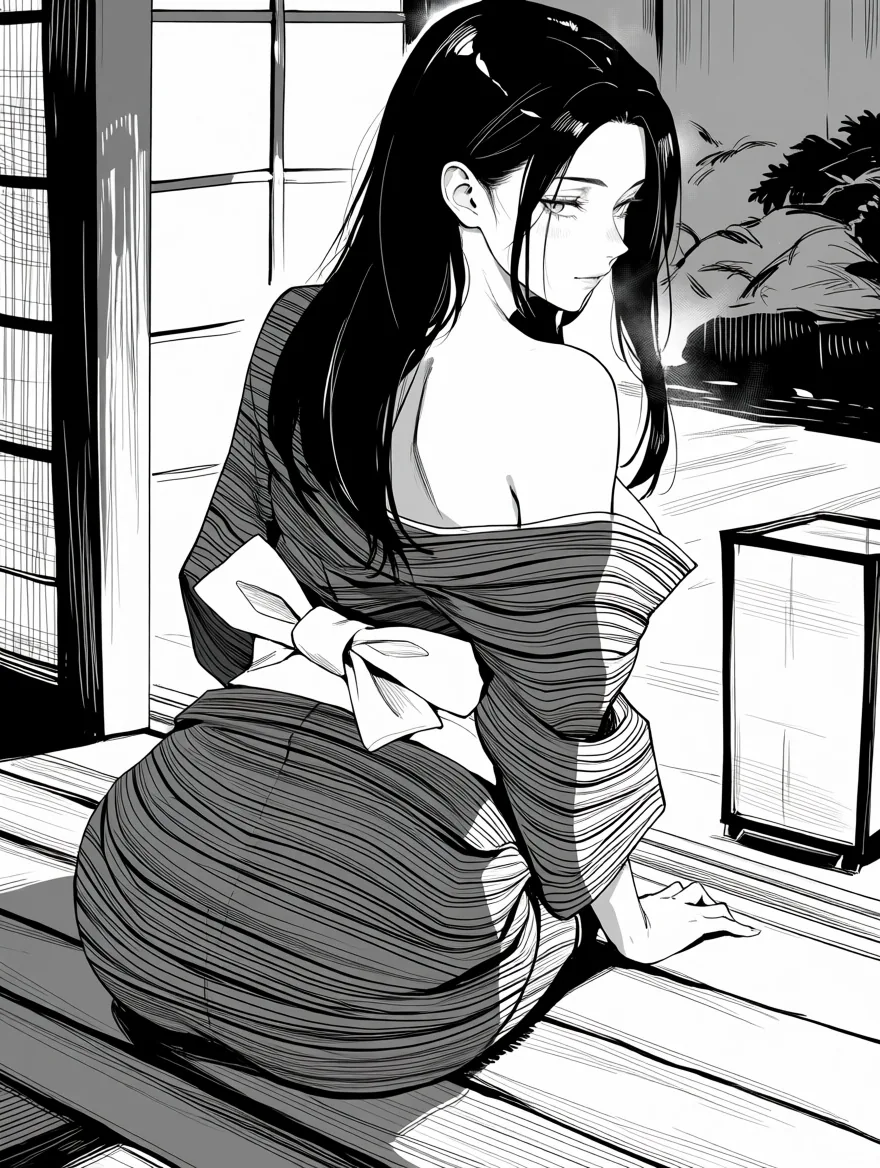
LoRA monocromática com scale 1, sensitive, 3:4, 1k, com monochrome, greyscale, screentone no prompt.
A escala é o controle que importa. Com um prompt e uma seed, usando a LoRA PC-98, comparamos 0,5, 1, 1,5 e 4 (da esquerda para a direita abaixo). 0,5 é um toque leve, 1 é o estilo completo, 1,5 empurra mais, e 4 desfez a imagem em formas abstratas. Uma escala 0 é idêntica a não usar LoRA.
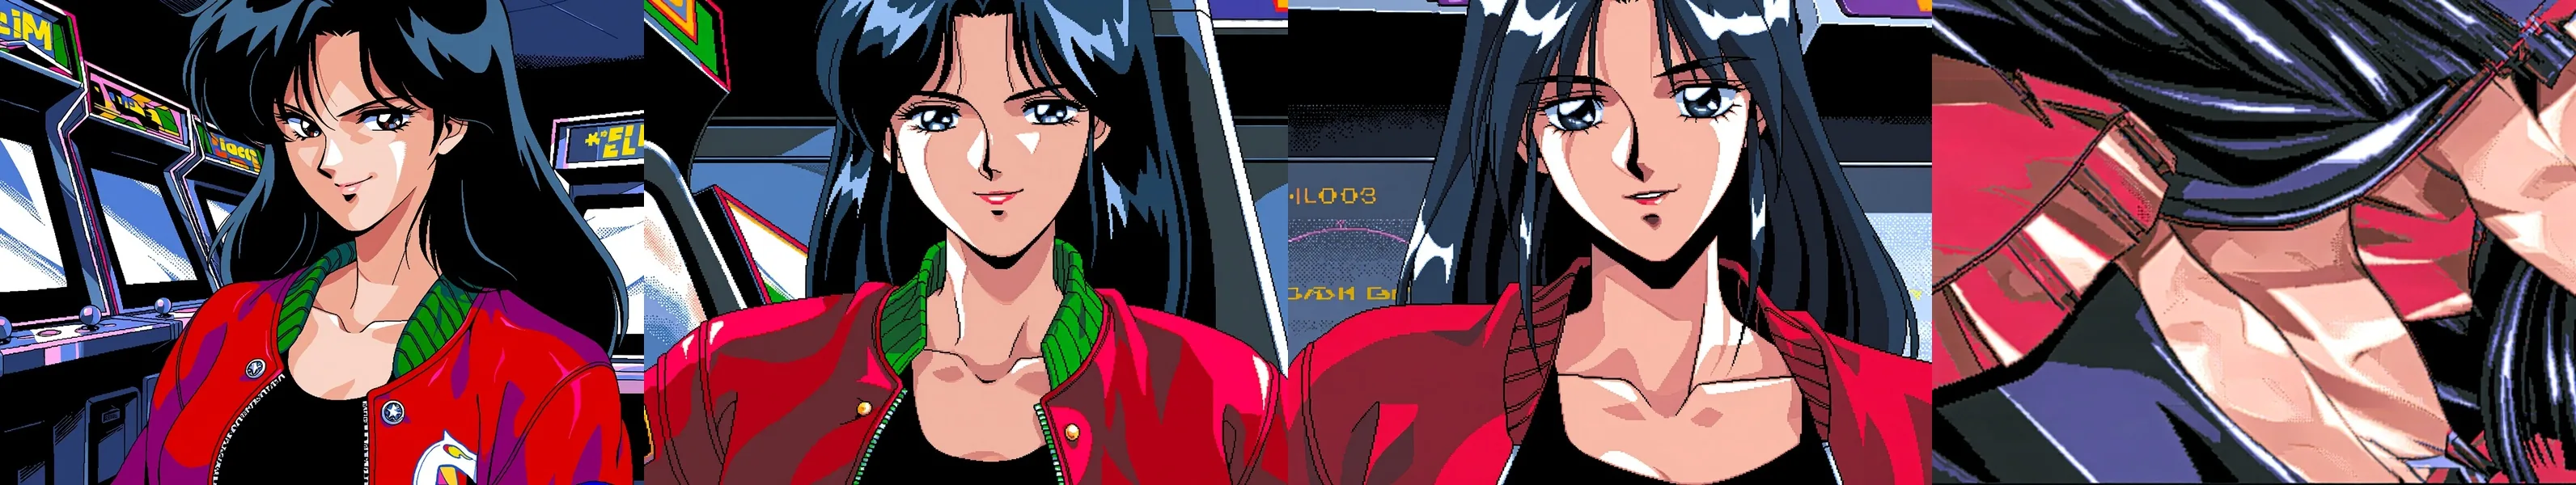
LoRA PC-98 em 0,5, 1, 1,5 e 4 (da esquerda para a direita), mesmo prompt e mesma seed.
| Situação | O que sugerimos |
|---|---|
| Primeira tentativa com qualquer LoRA | Escala 1 com as palavras-gatilho |
| O estilo briga com o personagem | Reduza para 0,5 a 0,8 |
| Você quer mais intensidade | 1,2, não 4 |
| Duas ou três LoRAs | Estilo principal em 1, as outras em 0,6 e 0,25 (funcionou para nós) |
| Uma LoRA para outro modelo base | Ela carrega sem erro e não muda nada, então confira para o que foi treinada |
A primeira requisição com uma LoRA nova pode ser lenta enquanto o arquivo é baixado (uma das nossas levou quase três minutos). Um link que exige login, ou que aponta para a página de um repositório em vez do arquivo, falha com uma mensagem clara e não é cobrado. Nosso guia de estilos com LoRA, mais longo, percorre mais combinações.
Passo 5: transforme uma foto ou esboço em anime
Envie sua referência como image_url, descreva o que já está nela e defina strength como 0.75. Imagem para imagem, na página de edição, aceita prompt, image_url, strength (de 0 a 1, padrão 0.8), resolution e seed. Não há campo de proporção: o resultado mantém o formato da origem. O custo é o mesmo de texto para imagem.
Na nossa escada de força com uma foto, 0,3 ainda era uma foto, 0,6 já parecia uma ilustração, 0,75 era anime limpo com a mesma composição, a partir de 0,9 os detalhes começaram a mudar e, em 1,0, a origem foi ignorada. Em 0 a origem volta intacta. Nosso guia de força mostra a escada inteira.
As imagens de "antes" abaixo são fotografias de origem que geramos para o teste com o GPT Image 2.5: adultos fictícios, não pessoas reais. São entradas, não resultados do Anima.
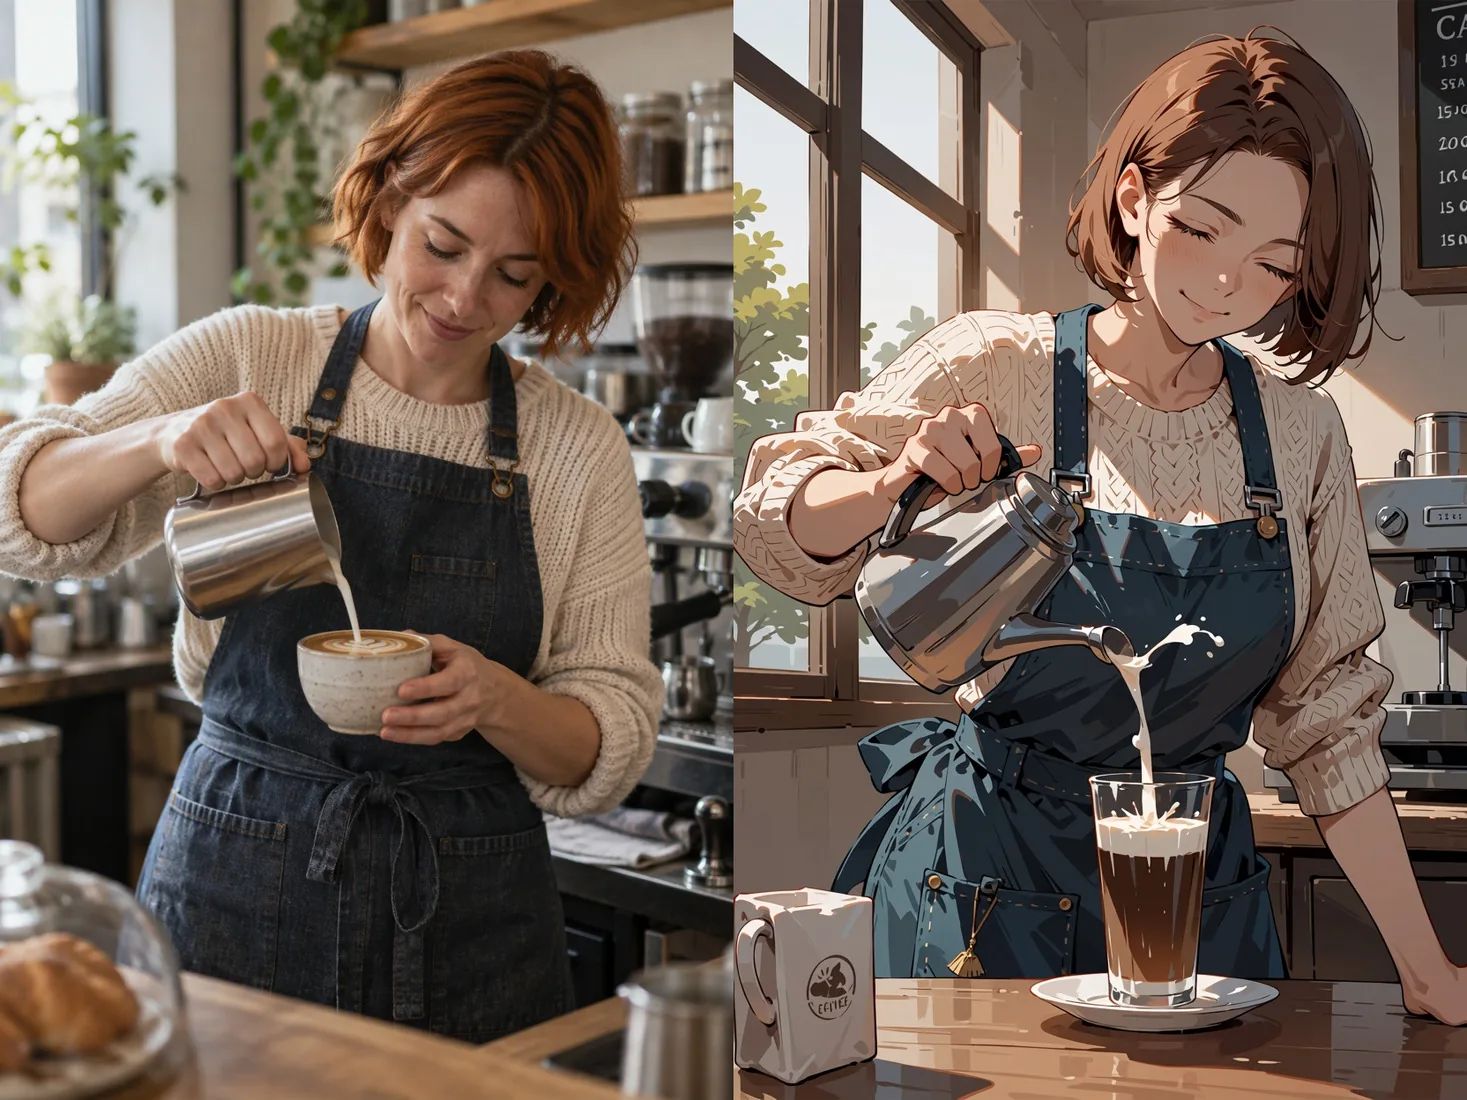
Antes (à esquerda, foto de origem) e depois (à direita, Anima Turbo com força 0,75). O enquadramento mudou um pouco: o modelo redesenha os detalhes, não faz decalque.
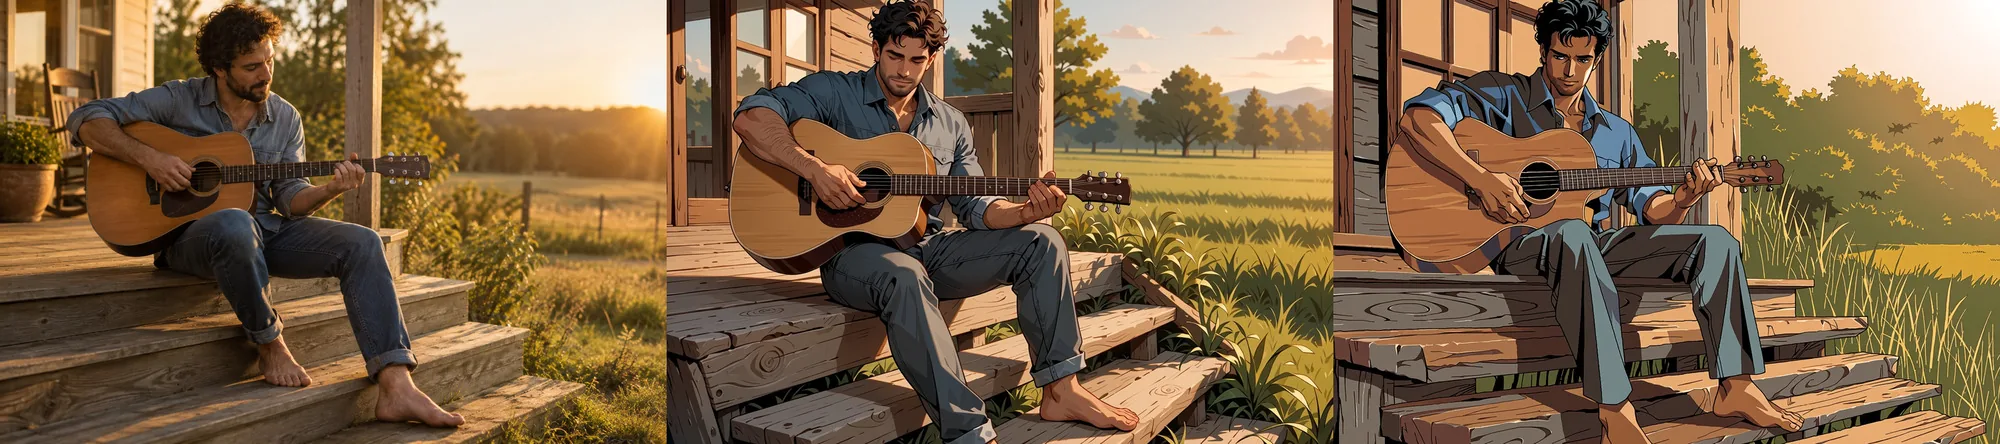
Antes (à esquerda), anime em 0,75 (no meio) e anime com a LoRA PC-98 em 0,75 (à direita). A composição fica próxima da origem nos dois casos.
Imagem para imagem muda o estilo; não segue instruções de edição (pedir a uma ilustração uma roupa nova mudou muito pouco entre 0,6 e 0,8). Uma ilustração colorida virando tinta de mangá precisou de 0,85 no nosso teste, e a pose é redesenhada nessa força. Para um esboço, descreva o assunto, comece em 0,75 e só aumente se o traço sobreviver forte demais.
Use apenas fotos que você tem o direito de usar. Nunca converta a foto de uma pessoa real em arte voltada ao público adulto sem o consentimento dela.
Passo 6 (opcional): anime uma imagem finalizada
Escolha sua melhor imagem e entregue-a a uma família de imagem para vídeo sem censura, junto com um prompt curto. A SpicyAPI tem três: Seedance 2.5 Spicy, Wan 2.2 Spicy e MiniMax H3 Spicy. Cada uma recebe uma imagem mais um prompt e devolve um vídeo curto. Não rodamos este passo nas imagens deste artigo, então deixamos detalhes como durações e configurações para a página de cada modelo.
Finalize primeiro a imagem, porque uma mão com defeito na imagem é uma mão com defeito em todos os quadros, e mantenha o prompt de movimento em uma única ação.
Passo 7: corrija os problemas comuns
A maioria das falhas tem uma correção de uma linha: gerar de novo com outra seed, reduzir a escala da LoRA ou ajustar strength.
| Problema | Causa provável | Correção |
|---|---|---|
| Um rabisco parecido com assinatura ou uma linha de texto falso num canto | Um hábito aprendido com ilustrações; vimos em cerca de uma imagem em cada cinco | Troque a seed; não há prompt negativo para suprimir; ou corte o canto |
| Mãos ou anatomia estranhas | Normal em modelos de imagem | Gere de novo com outra seed; mantenha os rascunhos em 1k até sair uma boa |
| O personagem varia entre imagens | Orações demais mudaram de uma vez | Reutilize o bloco do personagem, mantenha a seed, mude uma oração |
| Estilo forte demais ou imagem se desfazendo | Escala da LoRA alta demais | Reduza para 0,5 a 1,2; a escala 4 desfaz a imagem |
| A LoRA não faz nada | Treinada para outro modelo base, ou falta a palavra-gatilho | Confira o modelo base e adicione as palavras-gatilho |
| A foto ainda parece foto | strength baixo demais | Vá em direção a 0,75 |
| Os detalhes mudam demais em imagem para imagem | strength alto demais | Desça de 0,9 |
Aqui está o primeiro caso: o canto desta cena de café ganhou uma linha de pseudotexto.
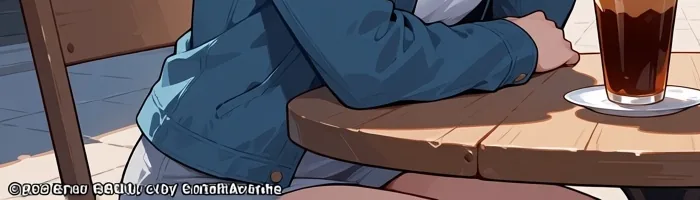
Um rabisco parecido com assinatura num canto (recorte de uma imagem de 1360 x 768).
Seeds tornam as execuções comparáveis, mas não garantem pixels idênticos, então salve as imagens de que você gosta.
Passo 8: mantenha privado e só para adultos
Você é responsável pelo que gera, armazena e compartilha. Todo personagem é adulto e o prompt diz isso; nenhuma semelhança com pessoa real sem consentimento; nenhum menor nem personagem de aparência jovem, nunca; mantenha os resultados num armazenamento que você controla; e siga as leis do lugar onde você mora.
O fluxo inteiro como checklist
| Feito? | Verificação |
|---|---|
| ☐ | Bloco do personagem escrito uma vez: tags de qualidade, tag de classificação, número de pessoas, declaração de idade, visual, uma marca |
| ☐ | Tag de classificação escolhida de propósito (safe ou sensitive para tudo o que você compartilhar) |
| ☐ | Proporção escolhida para o uso; rascunho em 1k |
| ☐ | Imagens escolhidas geradas de novo em 1.5k |
| ☐ | LoRA compatível com o Anima, palavras-gatilho no prompt, escala de 0,5 a 1,2 |
| ☐ | Referências de foto com strength 0.75, prompt descrevendo a foto |
| ☐ | Cantos checados quanto a rabiscos, mãos checadas |
| ☐ | Opcional: imagem animada com uma família de imagem para vídeo |
| ☐ | Resultados guardados em privado; só adultos |
Um modelo curto de prompt
Preencha os colchetes e mantenha o resto. Esta versão é uma cena sensitive com personagem vestido.
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
[hair], [eyes], [one distinctive mark], [outfit: e.g. black slip dress],
[place and pose: e.g. leaning on a balcony at night], looking at viewer,
[light: e.g. warm lamp light, city lights]
Para duas pessoas, use 1girl, 1boy e uma oração de roupa para cada; para um estilo, acrescente as palavras-gatilho da LoRA. Para saber mais, veja nosso relatório de teste do Anima Turbo e, para um panorama mais amplo, compare outros geradores de imagem NSFW.
FAQ
Dá mesmo para criar arte de anime NSFW com IA na SpicyAPI?
Dá. O Anima Turbo e o Anima Turbo LoRA são sem censura, sem filtro de conteúdo, e tivemos zero recusas em quatro níveis de conteúdo. A responsabilidade pelo que você cria continua sendo sua.
Qual é a melhor forma de manter um personagem consistente?
Escreva um bloco de tags para o rosto, o cabelo e uma marca distintiva, cole-o em todos os prompts e mantenha a seed enquanto muda uma oração por vez. No nosso conjunto da personagem de cabelo prateado, isso manteve um personagem em três roupas.
Qual tag de classificação devo usar?
Use safe para tudo o que pretende compartilhar e sensitive para cenas sugestivas, mas com personagens vestidos. O modelo também conhece nsfw e uma tag mais forte, que a desenvolvedora documenta como as que tiram a contenção. Numa cena com personagem vestido, safe e sensitive deram quase a mesma imagem.
Com qual escala de LoRA devo começar?
Comece em 1 com as palavras-gatilho e depois varie entre 0,5 e 1,2. Nos nossos testes, 0,5 foi um toque leve, 1,5 empurrou o estilo com mais força e 4 desfez a imagem.
Qual força transforma uma foto em anime?
0,75. Na nossa escada, ela deu anime limpo com a composição intacta. Em 0,3 ainda era uma foto, a partir de 0,9 os detalhes começaram a mudar e, em 1,0, a origem foi ignorada.
Por que há uma assinatura ou texto falso no canto?
O modelo aprendeu isso com ilustrações. Vimos em cerca de uma imagem em cada cinco, e um prompt negativo não consegue suprimir, porque não existe. Troque a seed ou corte o canto.
Posso transformar uma imagem finalizada em vídeo?
Sim, com uma família de imagem para vídeo sem censura, como o Seedance 2.5 Spicy, o Wan 2.2 Spicy ou o MiniMax H3 Spicy. Cada uma recebe uma imagem e um prompt e devolve um clipe curto. Veja na página do modelo o que cada uma aceita.
Posso usar a foto de uma pessoa real?
Não sem o consentimento dessa pessoa, e não para arte voltada ao público adulto. Use personagens fictícios ou seus próprios esboços e fotos de adultos que consentiram, e mantenha os resultados privados.