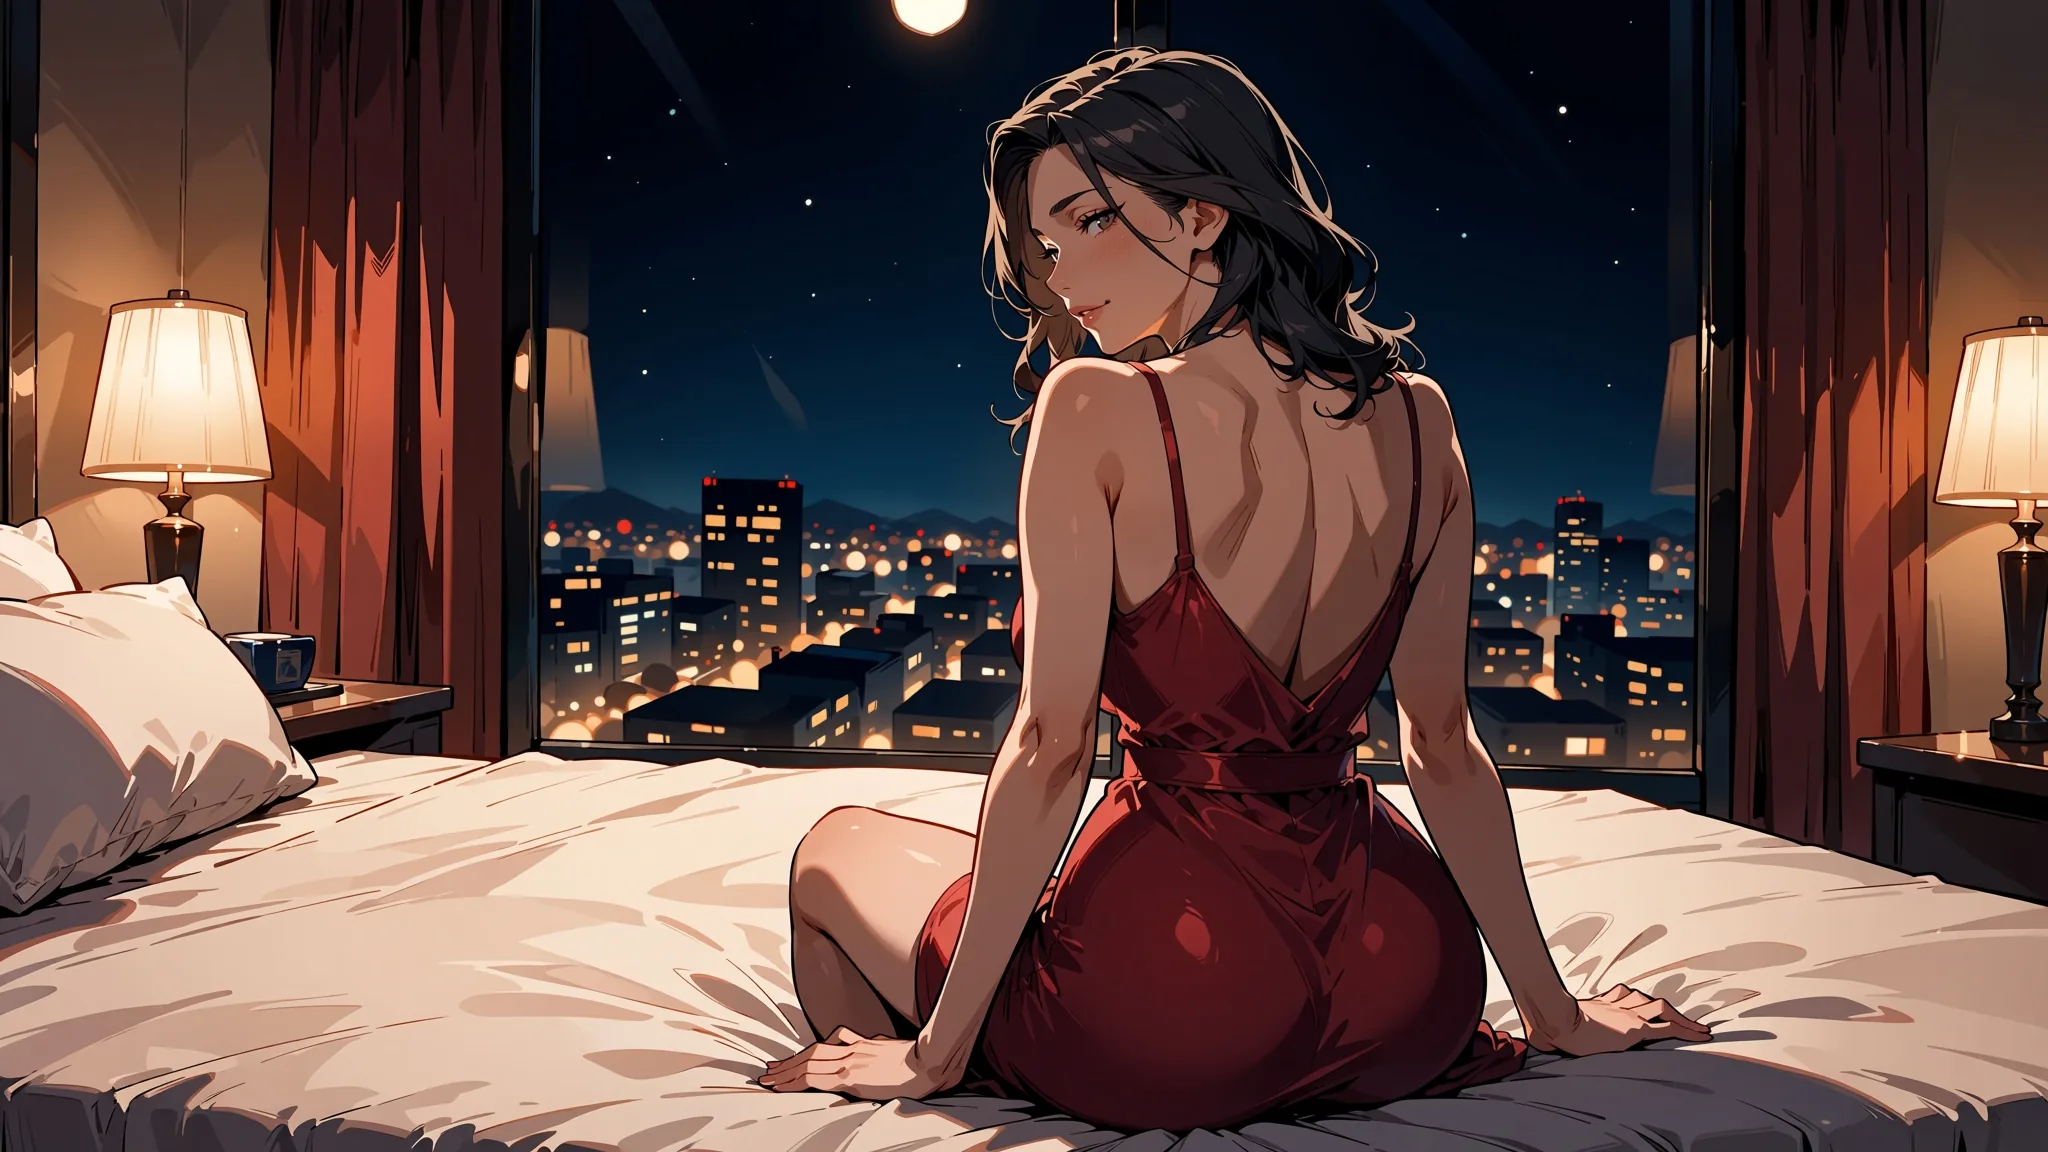
Para transformar uma foto em anime com o Anima Turbo, envie a foto como image_url, escreva um prompt que descreva a imagem que já está na foto e defina strength como 0.75. Nos nossos testes, esse valor deu um anime limpo com a composição intacta. Mais baixo, e a foto aparece por baixo; mais alto, e o modelo começa a redesenhar a cena. Todo o resto deste guia trata de mexer nesse único número e do que fazer quando ele não basta.
O Anima Turbo é a versão destilada do Anima, um modelo de anime e ilustração de 2 bilhões de parâmetros da CircleStone Labs, baseado no NVIDIA Cosmos-Predict2 com um codificador de texto Qwen3. Esses endpoints não têm censura e não adicionam filtro de conteúdo, e tudo o que está impresso aqui são cenas do dia a dia com adultos vestidos. Rodamos todos os testes em 5 de outubro de 2026.
Visão geral
| Modelo | Anima Turbo, da CircleStone Labs (2B de parâmetros; o Turbo é a versão destilada com a qual a desenvolvedora recomenda começar) |
| Nome na API de imagem para imagem | circlestone-labs/anima-turbo/edit |
| Com LoRAs | circlestone-labs/anima-turbo-lora/edit, até 3 LoRAs, scale de 0 a 4 |
| Entradas | image_url (uma imagem de origem), prompt, strength (de 0 a 1, padrão 0.8), resolution, seed |
| Melhor strength nos nossos testes | 0.75 para uma fotografia; 0.85 para transformar uma ilustração colorida em nanquim de mangá |
| Tamanho da saída | Mantém a proporção da origem: uma foto 16:9 voltou com 1360 x 752 no nível 1k; o 1k tem cerca de 1 megapixel e o 1.5k, cerca de 2,4 |
| Formato de saída | Sempre JPEG |
| Velocidade | De 2 a 16 segundos de tempo de modelo por imagem em 60 execuções; 52 de 60 abaixo de 10 segundos |
| Política de conteúdo | Sem censura, sem filtro de conteúdo |
| O que não faz | Instruções de edição, máscaras, prompts negativos, fotorrealismo, mais de uma imagem de origem |
O que a strength realmente faz
A strength vai de 0 a 1 (padrão 0.8). Em 0, você recebe a origem de volta, intacta. Em 1, a origem é ignorada e você recebe uma imagem nova a partir do prompt. Tudo o que é útil fica no meio. Rodamos uma foto de uma cantora com um prompt e um seed, mudando só o número.
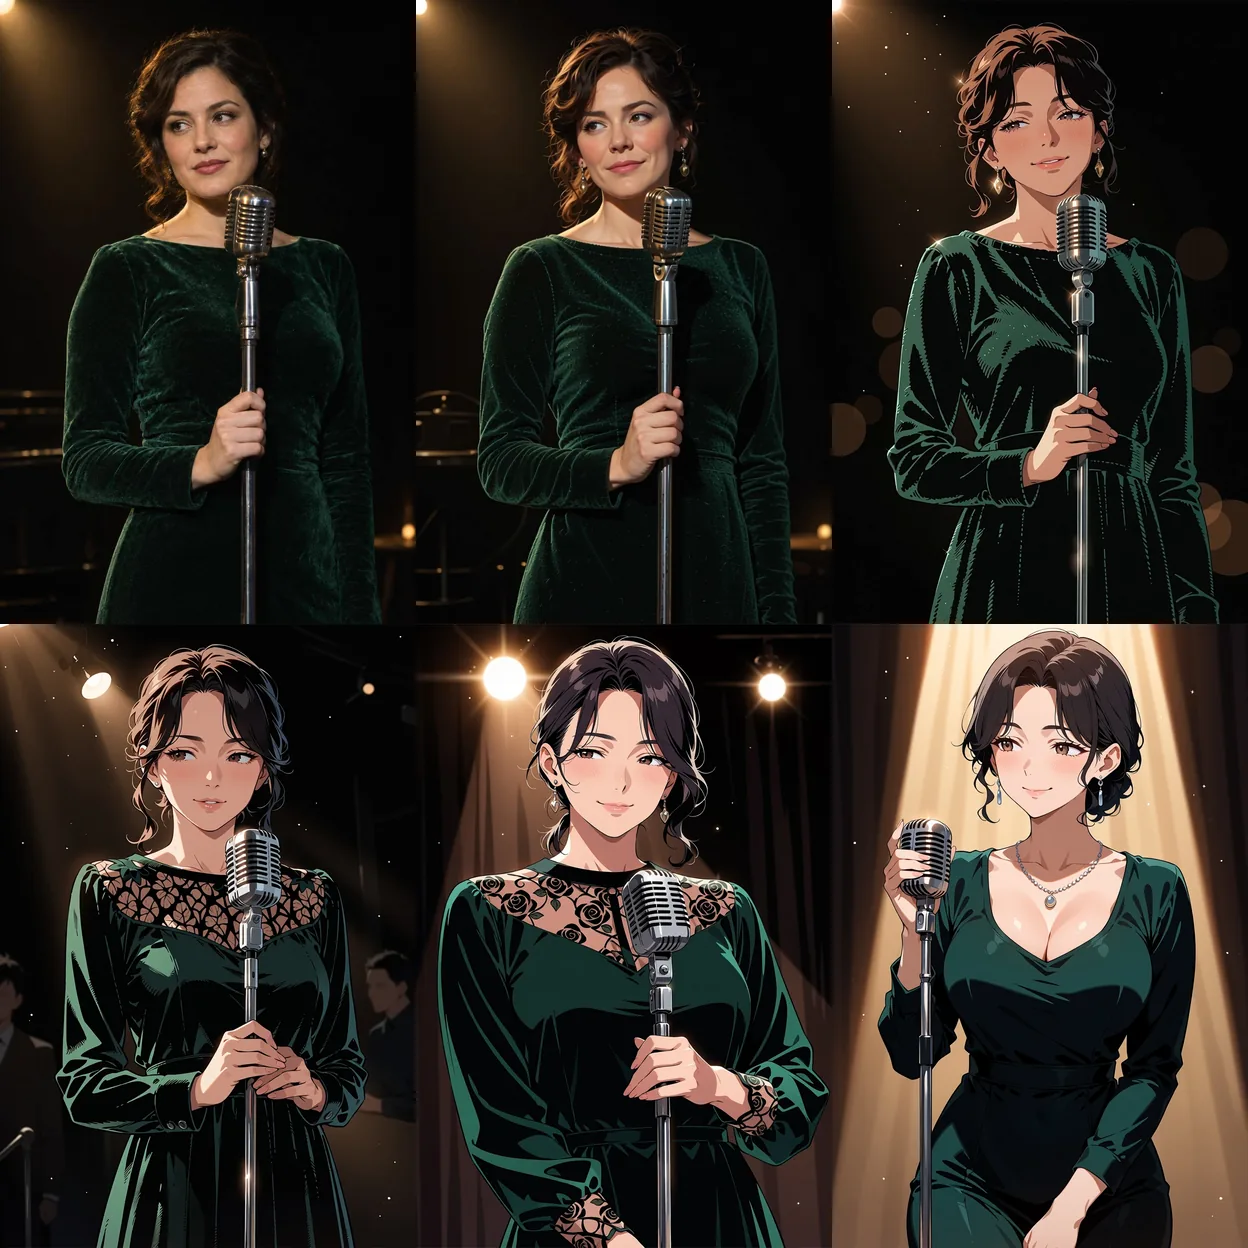
Fileira de cima, da esquerda para a direita: foto de origem, depois strength 0.3 e 0.6. Fileira de baixo: 0.75, 0.9 e 1.0. Imagem para imagem do Anima Turbo, nível 1k, mesmo prompt e seed em todas.
| Strength | O que vimos |
|---|---|
0 | A sua origem, intacta |
0.3 | Ainda uma fotografia |
0.6 | Já é uma ilustração, com os mesmos detalhes |
0.75 | Anime limpo, mesma composição |
0.9 | Os detalhes começam a mudar: vestido, pose, cenário |
1.0 | Origem ignorada; uma imagem nova a partir do prompt |
Comece em 0.75 e ajuste em passos de 0.05. O padrão de 0.8 serve, mas 0.75 manteve melhor a pose e o enquadramento em todos os exemplos abaixo.
O valor a escolher depende do ponto de partida e do que você quer:
| Ponto de partida e objetivo | Strength que usamos | Resultado nos nossos testes |
|---|---|---|
| Fotografia para anime simples | 0.75 | A composição se manteve, pequenas mecânicas se desviaram |
| Fotografia para anime, com um detalhe que precisa sobreviver | 0.7 | Nossa sugestão para o exemplo da barista; não rodado separadamente |
| Fotografia para um visual de LoRA de estilo (PC-98) | 0.75 | Estilo aplicado, composição mantida |
| Ilustração colorida para nanquim de mangá (LoRA monocromático) | 0.85 | Em 0.8 a cor permaneceu; em 0.85 a pose é redesenhada |
| Ilustração existente mais um prompt de "edição" (roupa nova, do dia para a noite) | 0.6 a 0.8 | Mudou muito pouco; uma strength mais alta acrescentou pseudotexto |
Escreva o prompt para a imagem, não para a edição
Este é o erro que mais custa tempo. O Anima reestiliza; ele não segue instruções como "troque a roupa dela" ou "faça virar noite". Descreva o que está na foto, no estilo que você quer, e nomeie o que o modelo deve manter: cabelo, roupa, cenário, luz. A escada da cantora usou este prompt:
masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, mature female, short dark wavy hair, dark green velvet dress with long sleeves, holding a vintage microphone on a stand, jazz club stage, warm spotlight from above, dark background, soft smile, looking to the sideValem as convenções de tags da desenvolvedora: minúsculas, espaços no lugar de sublinhados, tags de qualidade e de classificação primeiro, depois o número de pessoas (1girl, 1boy) e, por fim, as tags gerais. Nossos prompts começam com safe; não há prompt negativo, então a tag de classificação é a principal forma de definir o tom. Frases também funcionam (a desenvolvedora sugere pelo menos duas), e misturá-las com tags é tranquilo.
A requisição
{
  "model": "circlestone-labs/anima-turbo/edit",
  "input": {
    "image_url": "https://example.com/singer.jpg",
    "prompt": "masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, short dark wavy hair, dark green velvet dress, holding a vintage microphone, jazz club stage, warm spotlight",
    "strength": 0.75,
    "resolution": "1k",
    "seed": 3
  }
}
Não há campo de proporção. A saída mantém o formato da origem: uma foto 16:9 voltou com 1360 x 752 no nível 1k. A resolution define a contagem de pixels: 1k tem cerca de um megapixel e 1.5k, cerca de 2,4 megapixels, gerados de forma nativa, não ampliados. A saída é sempre JPEG. A imagem para imagem é cobrada por imagem, conforme o nível, como o texto para imagem; o preço atual está na página do modelo. O tempo de modelo no nosso teste de velocidade com 60 execuções foi de 2 a 16 segundos por imagem.
O que torna boa uma foto de origem
- Um assunto claro. Todos os exemplos aqui têm uma pessoa ou um casal num cenário legível, e o prompt consegue nomear tudo o que está no quadro.
- Sem bordas, legendas nem marcas d'água. O Anima reestiliza o quadro inteiro, então tudo o que estiver impresso nele também é redesenhado.
- Um formato que você quer manter. Não há campo de proporção; a saída acompanha a origem (uma foto 16:9 voltou com 1360 x 752), então corte antes de enviar.
- Um nível que combine com o uso. O
1ktem cerca de um megapixel; o1.5ktem cerca de 2,4 megapixels, gerados de forma nativa, não ampliados. O mesmo prompt e seed nos dois níveis:
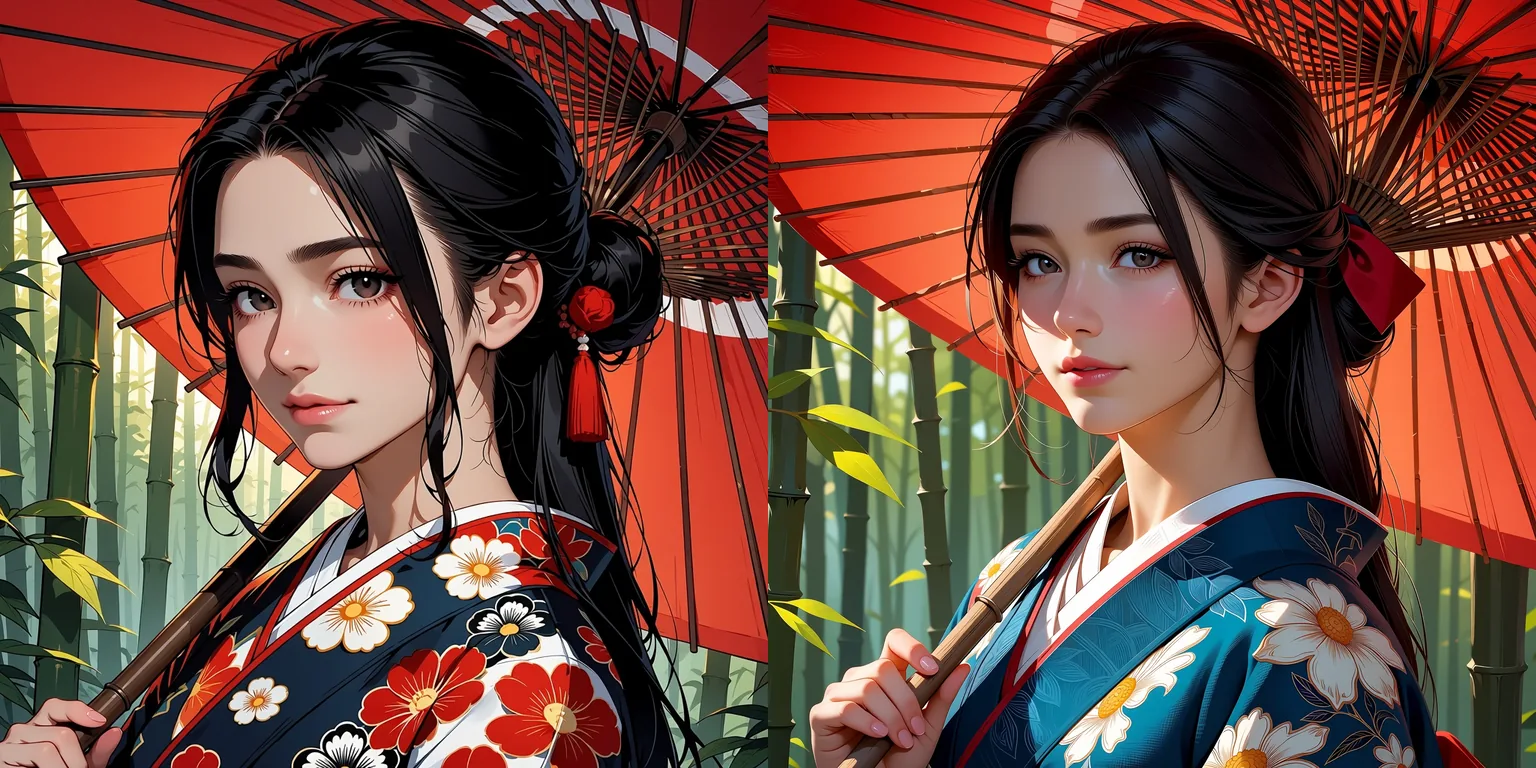
Esquerda: 1k (1024 x 1024). Direita: 1.5k (1536 x 1536). Texto para imagem do Anima Turbo, mesmo prompt e seed. Mostramos os níveis em texto para imagem; a imagem para imagem usa o mesmo campo resolution.
A composição é a mesma, mas a renderização em 1.5k redesenha o estampado do quimono e o rosto em vez de apenas acrescentar pixels; por isso, escolha o nível antes de comparar seeds.
Três exemplos práticos
Um retrato
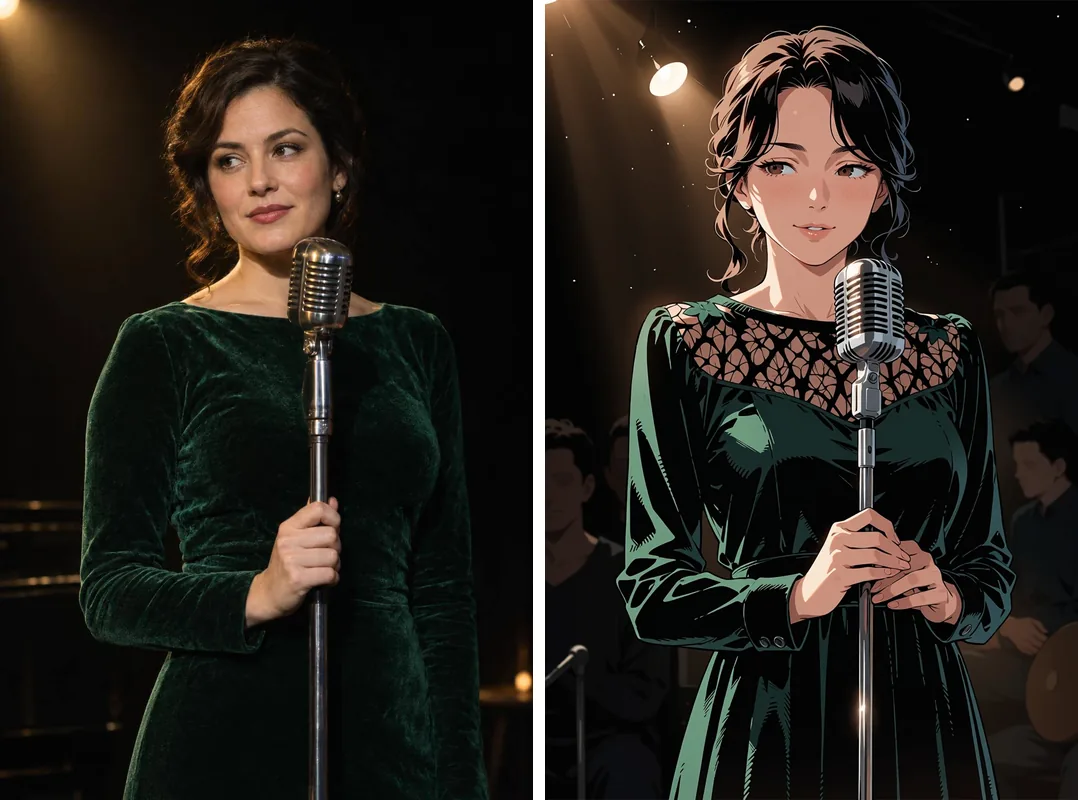
Esquerda: foto de origem. Direita: imagem para imagem do Anima Turbo, strength 0.75, 1k, seed 3. Prompt como acima.
O vestido de veludo, o pedestal do microfone e o olhar de lado sobreviveram, e a luz do palco virou um cone limpo de luz quente. Esta é a célula de 0.75 da escada, mostrada em tamanho real.
Uma cena em formato horizontal
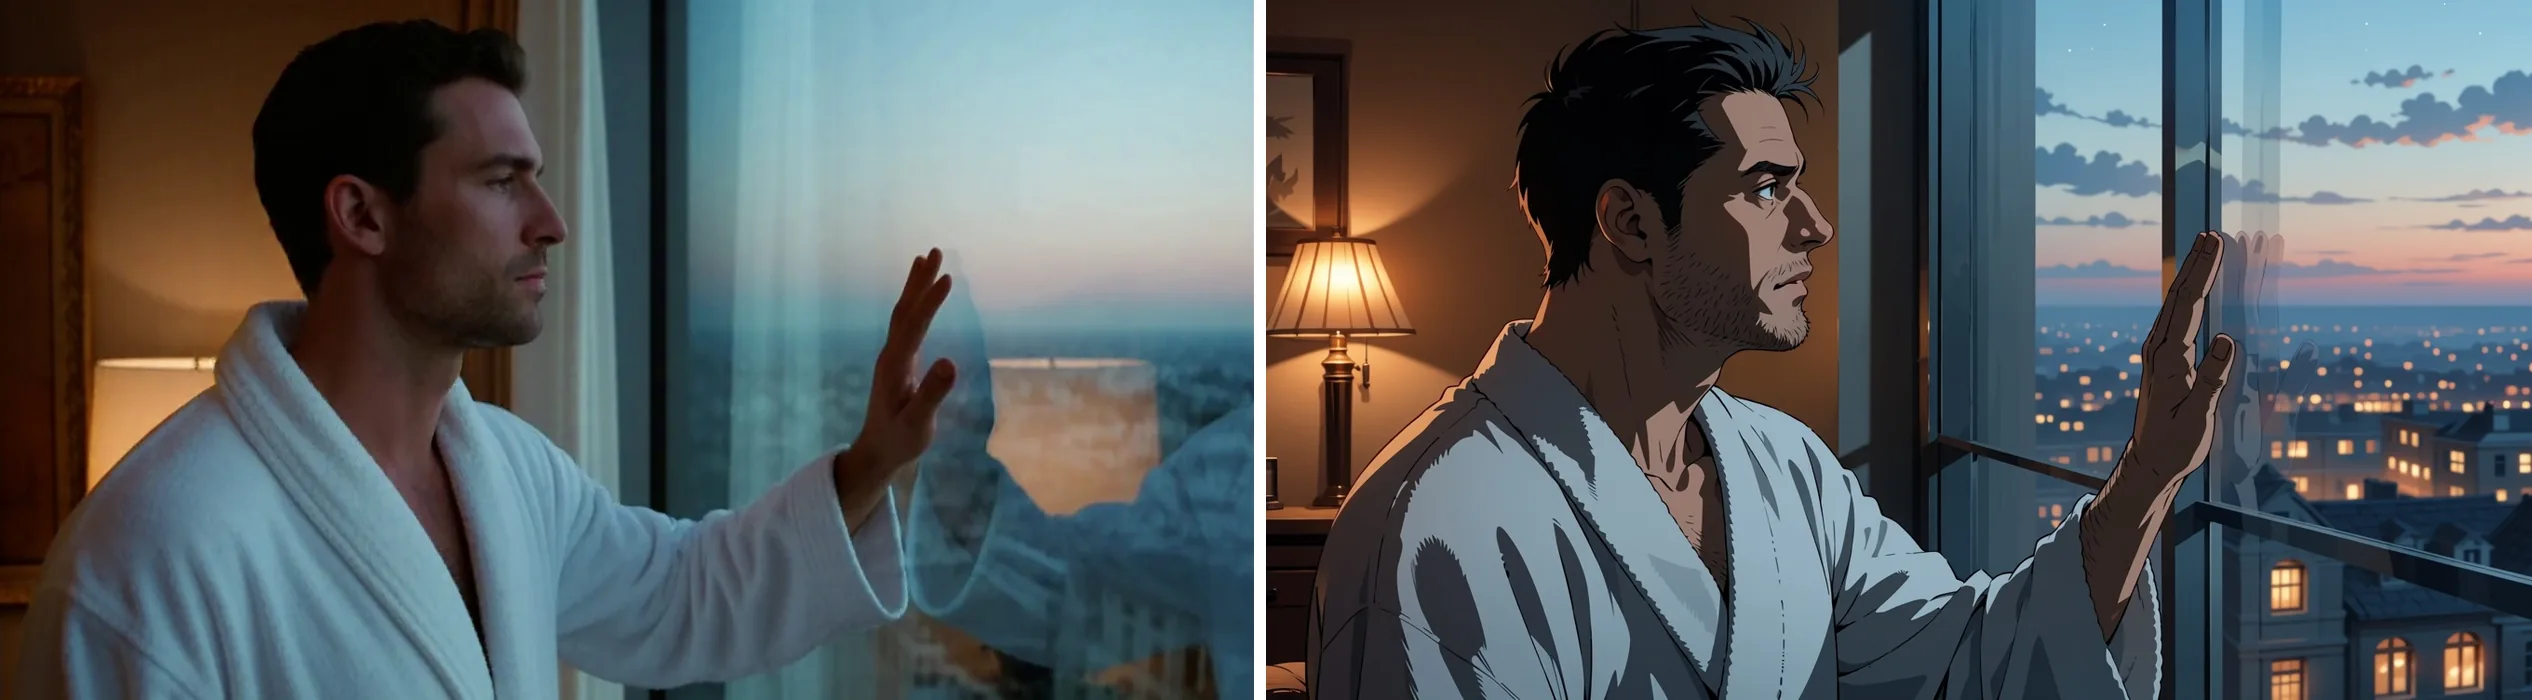
Esquerda: foto de origem. Direita: imagem para imagem do Anima Turbo, strength 0.75, 1k, seed 1.
O prompt nomeou a pose (profile view, one hand touching a large window), a luminária atrás dele e a luz azul do fim de tarde no vidro. O modelo manteve o perfil e a mão, e desenhou a cidade lá fora com mais detalhe do que a foto tinha.
Um casal numa scooter
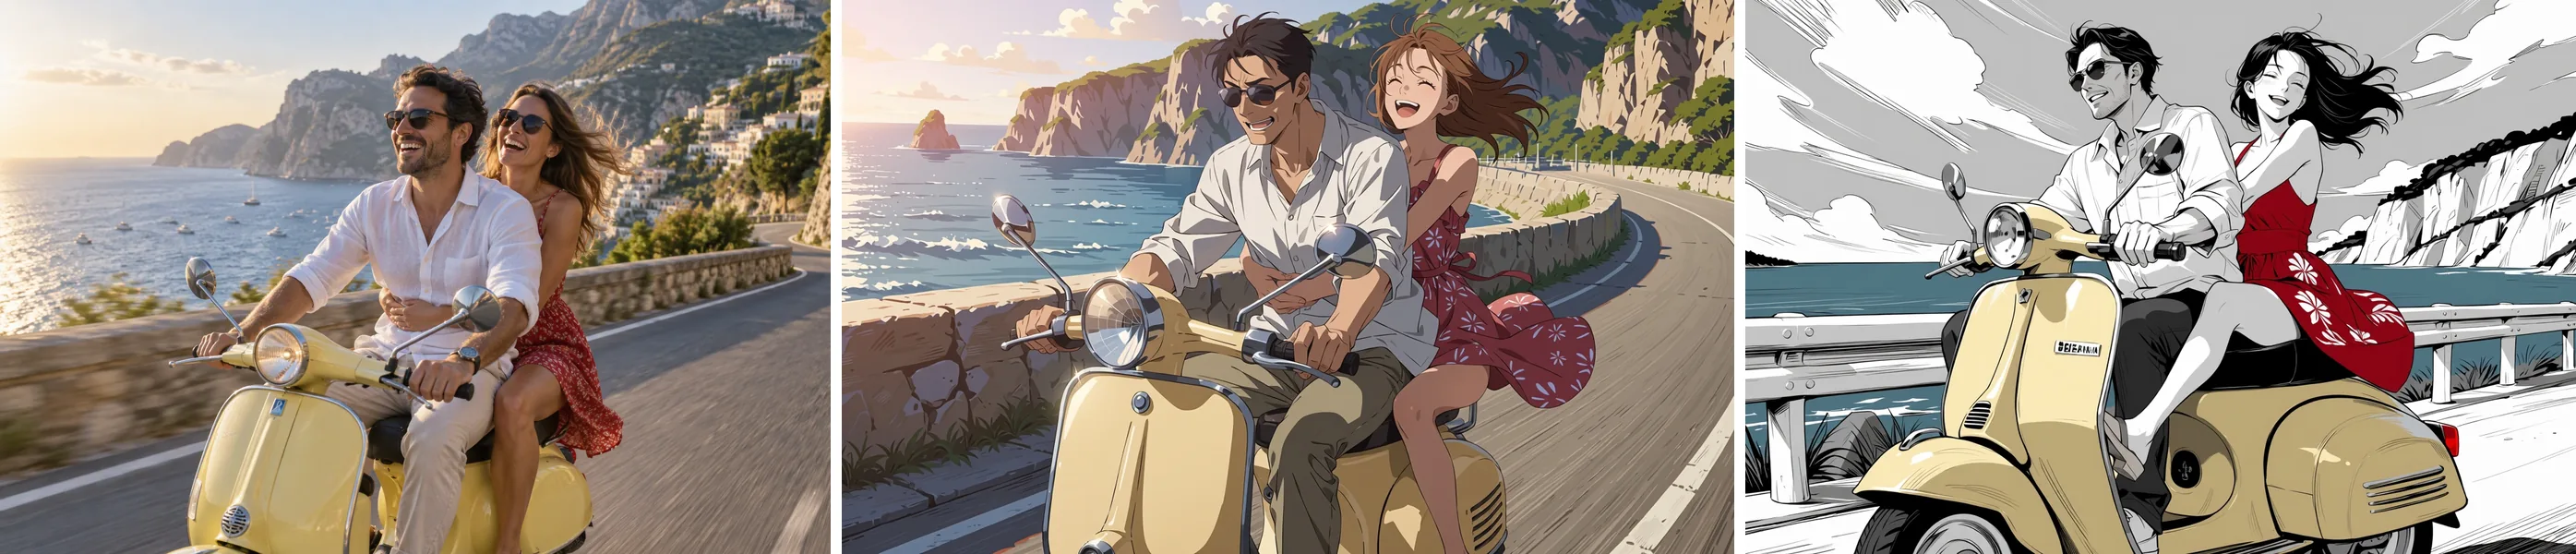
Esquerda: foto de origem, gerada por nós. Centro: imagem para imagem do Anima Turbo, strength 0.75, 1k, seed 3, 7% do topo cortados. Direita: a mesma requisição com o LoRA monocromático e strength 0.85.
masterpiece, best quality, safe, anime illustration, 1girl, 1boy, hetero, adult couple, mature female, mature male, riding a pale yellow vintage scooter on a coastal road, he drives in a white linen shirt and sunglasses, she sits behind him in a red summer dress with her arms around his waist, hair blowing in the wind, laughing, blue sea and cliffsCenas com duas pessoas exigem que cores e roupas sejam detalhadas para cada uma, como acima. Cortamos 7% do topo do resultado central porque o modelo tinha desenhado um pequeno rabisco de pseudotexto nesse canto, o que nos leva à seção de solução de problemas mais abaixo. Não cortamos o exemplo da barista, que mudou o enquadramento:
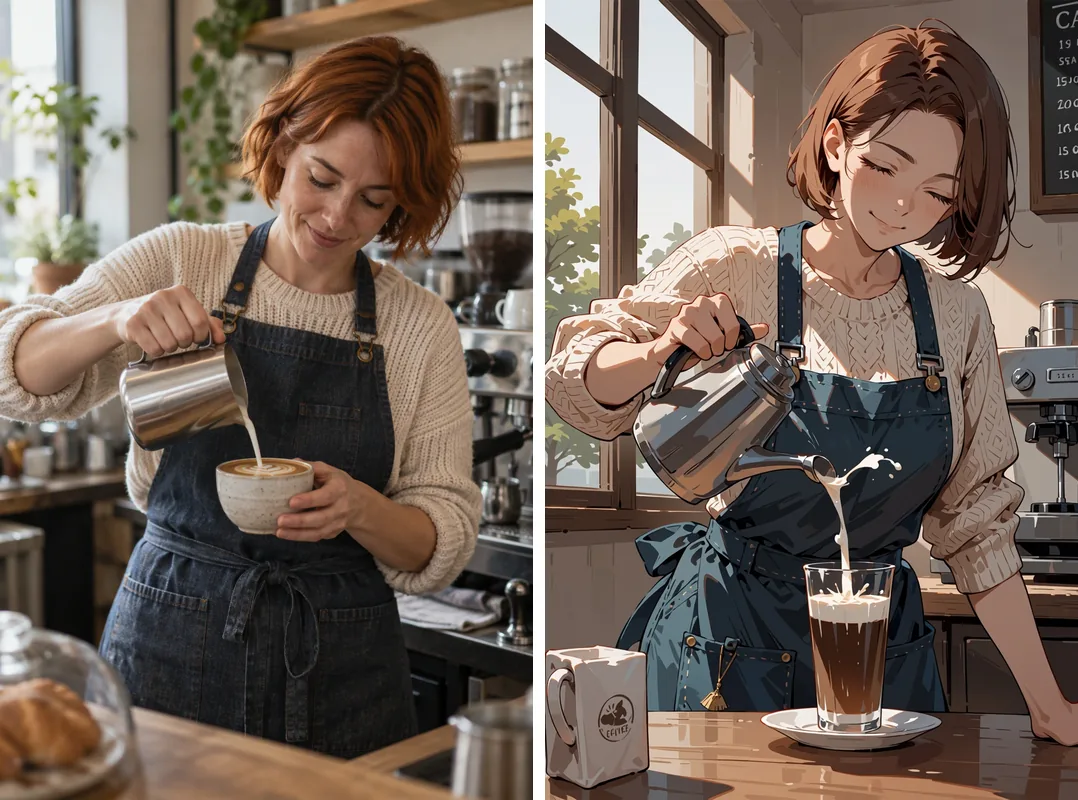
Esquerda: foto de origem, gerada por nós. Direita: imagem para imagem do Anima Turbo, strength 0.75, 1k, seed 3.
O avental, a blusa de tricô, a luz da janela e a máquina de espresso permaneceram; a jarra de leite, a xícara e o ângulo da câmera mudaram. Em 0.75, espere que o conteúdo se mantenha e que a mecânica dos pequenos detalhes se desvie. Se um detalhe importa, baixe para 0.7.
O que ele não consegue fazer
- Não segue instruções de edição. Pedir a uma ilustração existente uma roupa nova, ou a passagem do dia para a noite, mudou muito pouco entre
0.6e0.8e, com strength mais alta, acrescentou pseudotexto. O prompt descreve o resultado; não é um comando. - Não há máscara. Você não pode proteger uma região nem repintar só uma parte.
- Uma imagem de origem por requisição, e sem prompt negativo, passos nem campos de sampler.
- É um modelo de anime. Não faz fotorrealismo e desenha só uma ou duas palavras de texto.
- Um seed fixo não garante pixels idênticos. A mesma requisição com o mesmo seed nos deu três renderizações ligeiramente diferentes em momentos diferentes, então guarde as imagens de que gostar.
Reestilizar ou editar: o que este endpoint faz e não faz
| Você quer | Funciona? | O que fazer |
|---|---|---|
| Transformar uma foto inteira em anime | Sim | Descreva a foto, strength 0.75 |
| Manter pose e enquadramento | Em boa parte | Nomeie a pose no prompt; baixe a strength em 0.05 |
| Aplicar o estilo de um LoRA a uma foto | Sim | LoRA treinado para o Anima, palavras-gatilho, strength 0.75 |
| Mudar um objeto ou a roupa | Não | Descreva a imagem final e aceite um redesenho completo |
| Mudar a hora do dia | Não | O mesmo que acima |
| Proteger ou repintar uma região | Não | Não há máscara disponível |
| Obter fotorrealismo | Não | O Anima é um modelo de anime |
Levando uma foto a um estilo específico com LoRAs
O Anima Turbo LoRA aceita até três entradas em loras, cada uma com um link HTTPS direto para um arquivo .safetensors e um scale. O nome do modelo na API é circlestone-labs/anima-turbo-lora/edit; carregar LoRAs não gera cobrança separada. Use LoRAs treinados para o Anima: um treinado para outro modelo base carregou sem erro e não mudou nada no nosso teste.
Visual PC-98, strength 0.75. Com o LoRA de estilo PC-98 gal da Melon-Bread em scale 1, uma foto de um homem num terraço assumiu o estilo pontilhado e de paleta limitada dos jogos de PC dos anos 1990, mantendo a composição. O prompt abriu com as palavras-gatilho:
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, ...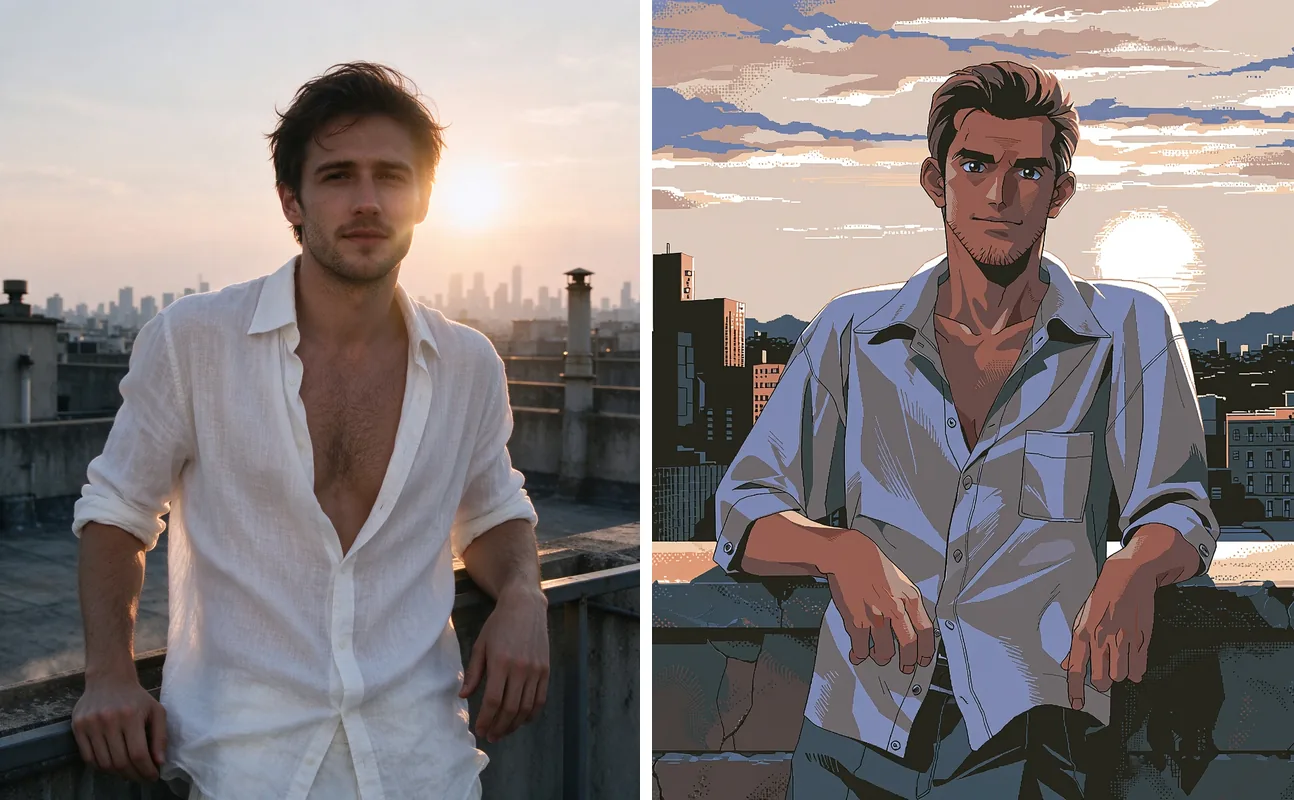
Esquerda: foto de origem (de banco de imagens). Direita: Anima Turbo LoRA, imagem para imagem, LoRA PC-98 com scale 1, strength 0.75, 1k, seed 42.
O mesmo LoRA na nossa foto do violão, entre a versão simples em anime e a origem:
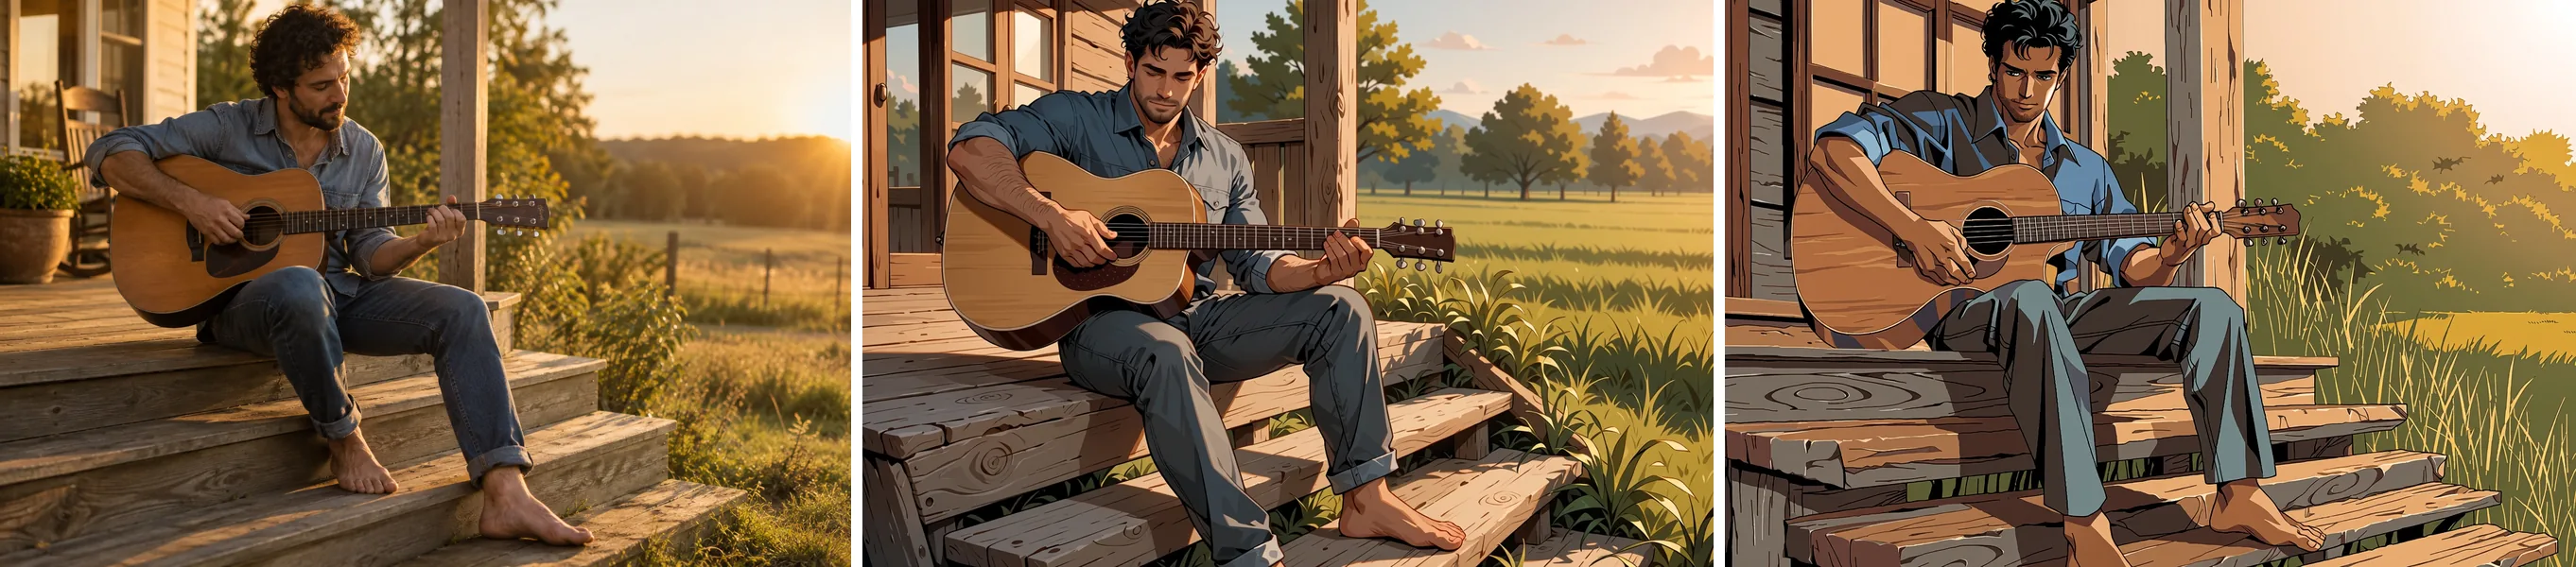
Da esquerda para a direita: foto de origem (gerada por nós); Anima Turbo com strength 0.75; Anima Turbo LoRA com o LoRA PC-98 em scale 1, strength 0.75. 1k, seed 3.
Nanquim de mangá, strength 0.85. O LoRA monocromático de notverriegod exige monochrome, greyscale no prompt; sem elas, nosso teste ficou em cores. Transformar uma ilustração colorida em nanquim exigiu 0.85, porque em 0.8 a cor permaneceu, e com essa força a pose é redesenhada.
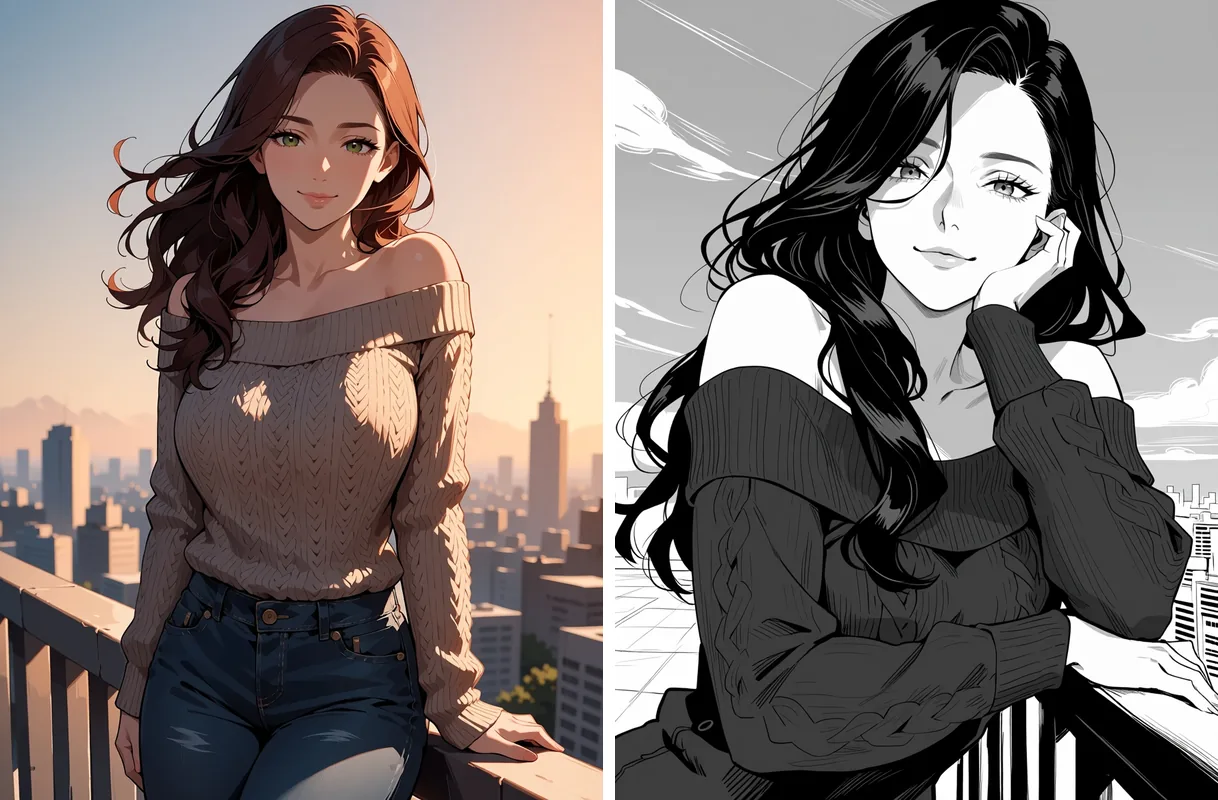
Esquerda: uma ilustração colorida do Anima Turbo (não é uma fotografia). Direita: Anima Turbo LoRA, imagem para imagem, LoRA monocromático, strength 0.85, 1k.
Na foto da scooter, o mesmo LoRA manteve cor pontual na scooter e no vestido (veja o painel da direita acima). As escalas de LoRA úteis nos nossos testes ficaram entre cerca de 0.5 e 1.2; com scale 4, a imagem se desfez em formas abstratas.
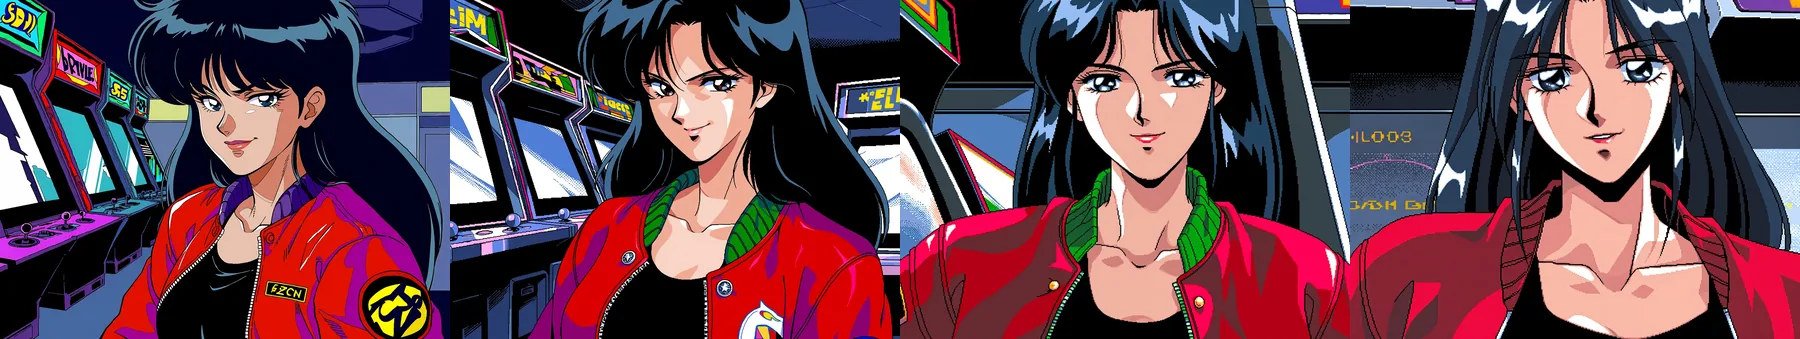
Da esquerda para a direita: LoRA PC-98 em scale 0, 0.5, 1 e 1.5. Texto para imagem do Anima Turbo LoRA, 1k, mesmo prompt e seed. Em 0 o LoRA está desligado; 1 é o estilo completo; 1.5 leva o estilo mais longe.
Solução de problemas
- A foto ainda aparece por baixo: aumente a
strengthem0.05e rode de novo. - O rosto ou a pose se desviam: reduza em
0.05e nomeie a pose no prompt. - Um rabisco ou pseudotexto aparece num canto: troque o
seed. Vimos isso em cerca de uma imagem em cinco, e nenhum prompt negativo consegue suprimir. Cortar alguns por cento também resolve. - Um LoRA não muda nada: confira se foi treinado para o Anima e acrescente as palavras-gatilho.
- Você quer mudar uma só coisa na imagem: esta é a ferramenta errada. O Anima reestiliza imagens inteiras e não tem máscara nem instruções de edição.
Veredito: para transformar fotos em anime, o Anima Turbo é rápido e previsível, desde que você aceite que a strength é o único botão. Comece em 0.75, descreva a foto e gaste suas novas tentativas em seeds, não em reescrever o prompt.
Perguntas frequentes
Que strength devo usar para transformar uma foto em anime?
Comece em 0.75. Nos nossos testes, esse valor deu um anime limpo com a composição intacta; valores mais baixos mantêm mais da fotografia e valores mais altos começam a mudar os detalhes. Ajuste em passos de 0.05.
O Anima Turbo aceita prompts negativos?
Não. Não há campo de prompt negativo, passos, CFG nem sampler. A tag de classificação no começo do prompt (usamos safe) é a principal forma de definir o tom.
Posso mandar mudar só uma coisa na minha imagem?
Não. Ele reestiliza a imagem inteira e não segue instruções de edição; pedir a uma ilustração uma roupa nova ou uma cena noturna mudou muito pouco entre 0.6 e 0.8. Descreva a imagem final e espere um redesenho completo.
Por que a saída tem um formato diferente do que pedi?
Porque a imagem para imagem não tem campo de proporção. A saída mantém o formato da origem (uma foto 16:9 voltou com 1360 x 752 no 1k); por isso, corte a foto antes.
Por que há uma assinatura ou pseudotexto no canto?
O modelo aprendeu o hábito com as ilustrações. Vimos isso em cerca de uma imagem em cinco. Troque o seed ou corte alguns por cento dessa borda; nenhum prompt negativo consegue suprimir isso.
Um seed fixo dá a mesma imagem?
Não de forma confiável. A mesma requisição com o mesmo seed nos deu três renderizações ligeiramente diferentes em momentos diferentes; por isso, os seeds tornam as execuções comparáveis, mas guarde as imagens de que gostar.
Posso usar LoRAs de outros modelos?
Só LoRAs treinados para o Anima. Um treinado para outro modelo base carregou sem erro e não mudou nada no nosso teste. Use o Anima Turbo LoRA com até três links para arquivos .safetensors.
Qual é a velocidade?
Em 60 execuções, o tempo de modelo foi de 2 a 16 segundos por imagem, e 52 delas ficaram abaixo de 10 segundos. A primeira requisição com um LoRA novo pode demorar mais enquanto o arquivo é baixado.