Anima Turbo, texto para imagem, 16:9 no nível 1.5k. A tag de classificação foi sensitive; o prompt descreve uma adulta vestida num quarto de hotel.
Resposta curta: sim, o Anima Turbo é sem censura. Na SpicyAPI não há filtro de conteúdo na frente dele e, nos nossos testes com 25 requisições em quatro níveis, de lingerie sugestiva até uma cena íntima entre dois adultos, tivemos zero recusas e zero substituições. Imagem para imagem e LoRAs compatíveis com conteúdo adulto se comportaram da mesma forma. O que o modelo não faz é fotorrealismo, o que, para esse tipo de trabalho, é uma vantagem: tudo o que ele desenha parece ilustração.
Este guia mostra o que testamos, como as tags de classificação mudam o tom, como manter um personagem adulto reconhecível em várias cenas, como adicionar um estilo com uma LoRA, como escrever cenas de casal e onde o modelo ainda deixa a desejar. Todo prompt de exemplo aqui é uma cena com pessoas vestidas, no máximo sugestiva; a plataforma não escreve nem publica prompts para cenas adultas, e você não vai precisar de um para acompanhar.
Visão geral
| Pergunta | Resposta dos nossos testes (5 de outubro de 2026) |
|---|---|
| Ele recusa? | Não. 25 requisições, zero recusas, zero substituições |
| Níveis testados | L1 a L4 (não rodamos o L5 no Anima) |
| Também testado | Imagem para imagem, com e sem LoRAs, personagens femininos e masculinos, duas seeds nos níveis mais altos, níveis 1k e 1.5k |
| Controle de tom | Tags de classificação: safe, sensitive, nsfw e uma tag mais forte |
| Estilo | Só anime e ilustração; sem fotorrealismo |
| Estilos personalizados | Até 3 LoRAs na família LoRA |
| Velocidade típica | De 2 a 16 segundos por imagem no nosso teste de velocidade com 60 execuções |
| Indisponível | Prompt negativo, passos, CFG, máscaras, várias imagens por requisição |
O Anima Turbo é sem censura?
Sim: nos nossos testes nada foi recusado, borrado ou suavizado. Subimos o modelo pela nossa escala de conteúdo, que usa nomes de nível neutros:
| Nível | O que significa | Resultado no Anima |
|---|---|---|
| L1 Sugestivo | Lingerie, uma alça escorregando do ombro | Gerado como escrito |
| L2 Parcial | Um visual parcialmente revelador | Gerado como escrito |
| L3 Forte | Um visual bem mais revelador | Gerado como escrito |
| L4 Intenso | Uma cena íntima entre dois adultos | Gerado como escrito, de primeira |
| L5 Extremo | Restrição consensual entre adultos ou gore cinematográfico | Não rodado no Anima |
As 25 requisições misturaram texto para imagem e imagem para imagem, com e sem LoRAs, personagens femininos e masculinos, duas seeds para cada um dos níveis L3 e L4 e os dois níveis de resolução. As execuções de imagem para imagem partiram de uma imagem de origem com personagem vestido e, quando pedimos L3 ou L4 com força de 0,8 a 0,9, o modelo obedeceu. Um lote separado de 60 execuções de proporção usou um prompt de nível L2, e as 60 foram entregues. Não vimos nenhum alerta de conteúdo, nenhum borrão e nenhuma suavização.
"Sem recusas" não é o mesmo que "toda imagem sai perfeita". Anatomia e mãos ainda exigem novas seeds, como em qualquer modelo de imagem, e tratamos disso na seção de limites.
Como outros modelos lidaram com a mesma escala
Para dar contexto, rodamos a mesma escala em dois modelos de imagem de uso geral, por meio de uma API hospedada de terceiros: FLUX 3 texto para imagem e Ideogram v4.5. Os dois entregaram uma cena de biquíni na praia e uma foto de catálogo de lingerie neutra. O FLUX 3 recusou 10 das suas 12 requisições e o Ideogram recusou 11 das suas 13, incluindo uma pintura clássica de estudo de figura e um prompt eufemístico sem nenhuma palavra sinalizada. As recusas voltaram em cerca de dois segundos, antes de qualquer imagem ser gerada, com a mensagem "Content flagged as potentially sensitive. Please try different prompts or images." As requisições recusadas não foram cobradas. Como o prompt eufemístico também foi recusado, o filtro parece semântico, e não uma lista de palavras. Não sabemos se esse filtro pertence às APIs próprias dos desenvolvedores dos modelos ou ao host, então leia isso como uma afirmação sobre essas rotas, não sobre os modelos em si.
Como as tags de classificação conduzem o tom?
As tags de classificação definem quanta contenção o modelo aplica e, com uma descrição de personagem vestido, safe e sensitive dão quase a mesma imagem. O Anima conhece safe, sensitive e nsfw, e a desenvolvedora, a CircleStone Labs, documenta mais uma tag, mais forte. Segundo a desenvolvedora, nsfw e essa tag mais forte são as que tiram a contenção. Como não há prompt negativo, a tag de classificação é a principal forma de definir o tom, então vale escolhê-la com critério.
Testamos as duas primeiras com um prompt de lounge (uma mulher adulta de vestido de noite preto com alças finas num bar de hotel) e uma seed, mudando só a tag.
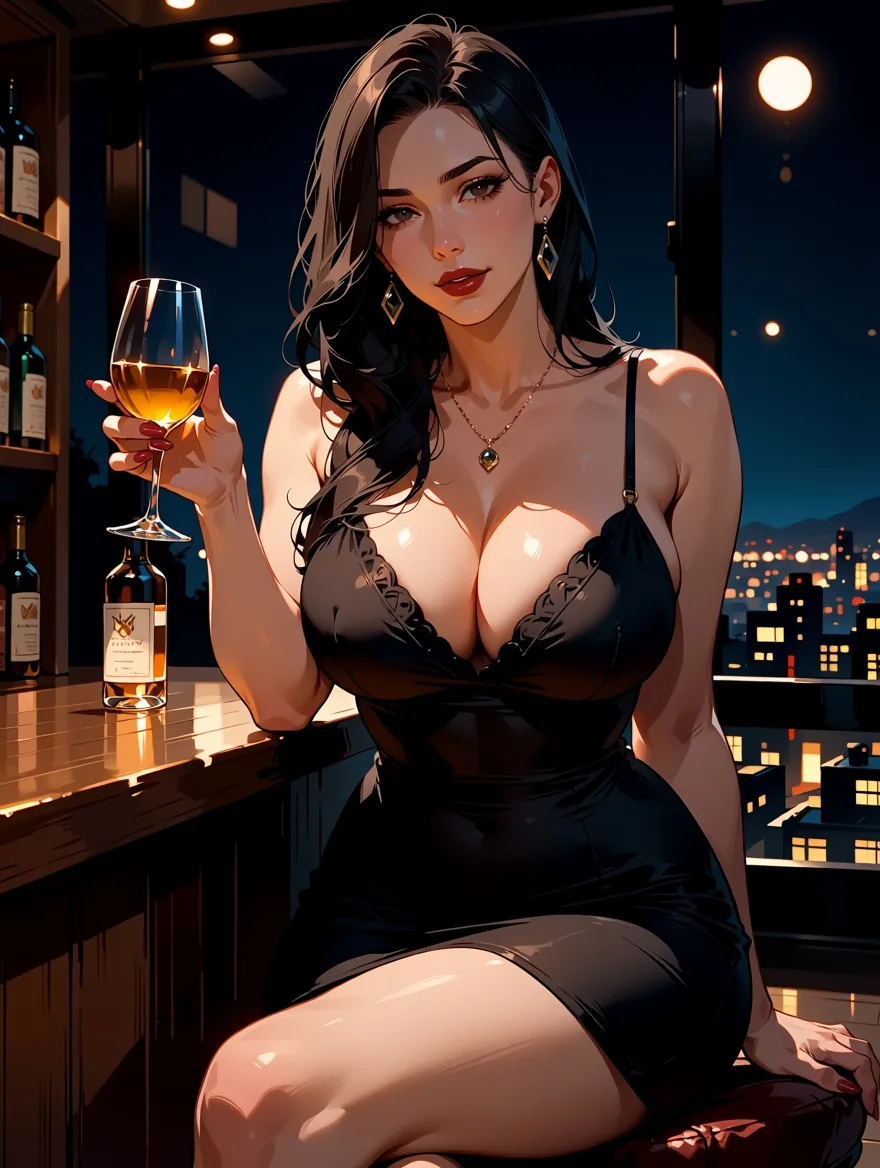
Mesmo prompt e mesma seed, safe.
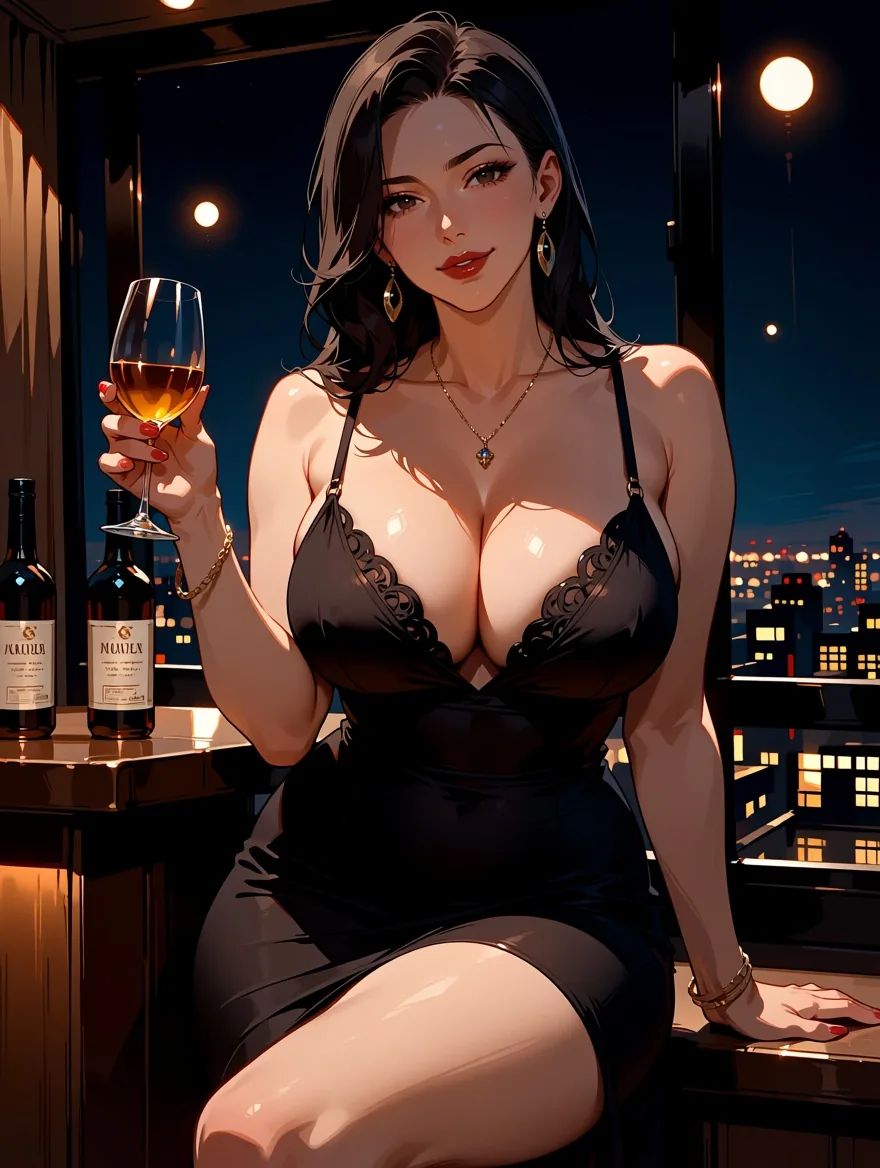
Mesmo prompt e mesma seed, sensitive.
A composição, a pose e o clima são os mesmos; pequenos detalhes, como as joias e as garrafas, mudaram. Trate safe e sensitive como um empurrãozinho leve em cenas com personagens vestidos e espere a mudança maior das tags mais fortes. Não publicamos nenhum prompt que use essas tags, e a documentação da plataforma também não; elas estão aí se você decidir usá-las, e a seção de uso responsável abaixo vale para todas.
Algumas convenções de tags da desenvolvedora que ajudam em qualquer cena: escreva as tags em minúsculas, com espaços no lugar de sublinhados, comece com as tags de qualidade e de classificação, depois o número de pessoas (1girl, 1boy), depois personagem, série, artista e tags gerais. Uma boa abertura é masterpiece, best quality, opcionalmente score_7. Nossos próprios testes também funcionaram com frases completas e com misturas de tags e frases; a desenvolvedora recomenda pelo menos duas frases quando você escreve em linguagem natural. Nossos testes de prompt mais amplos estão em Anima Turbo testado: tags, frases e tags de estilo.
Como manter um personagem adulto consistente entre cenas?
Fixe a seed, mantenha a descrição do personagem palavra por palavra e mude apenas a roupa e o lugar. Não existe recurso de imagem de referência nem de trava de personagem, então a consistência vem do prompt. Escrevemos um personagem adulto como um bloco de tags e o reutilizamos três vezes:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye,
black turtleneck, standing in an art gallery, looking at viewer
Na segunda e na terceira cena mantivemos tudo até beauty mark under the left eye, trocamos a tag de classificação para sensitive e mudamos apenas a roupa e o cenário: um vestido de seda vermelho numa varanda à noite e, depois, uma camisa branca larga no parapeito de uma janela pela manhã. As três usaram a seed 31 no nível 1k em 3:4.
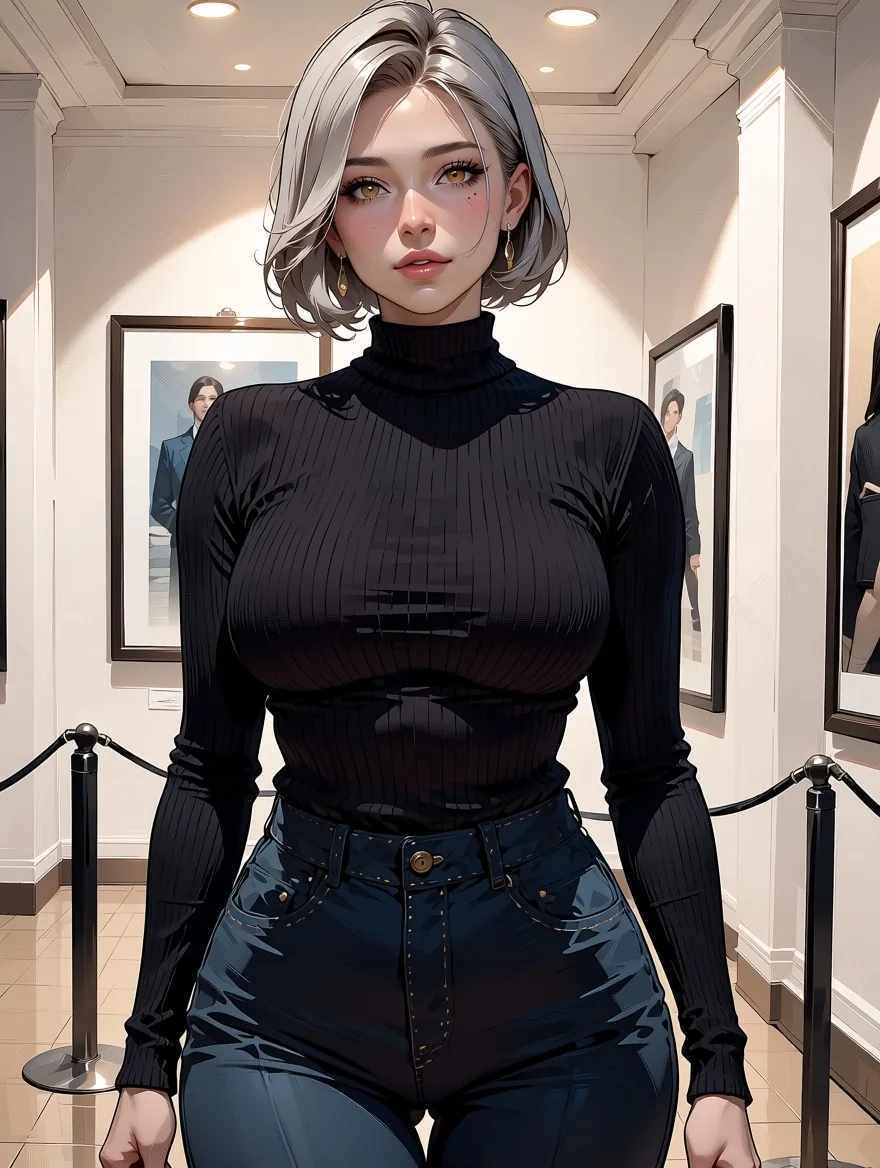
Cena 1: gola alta, galeria.
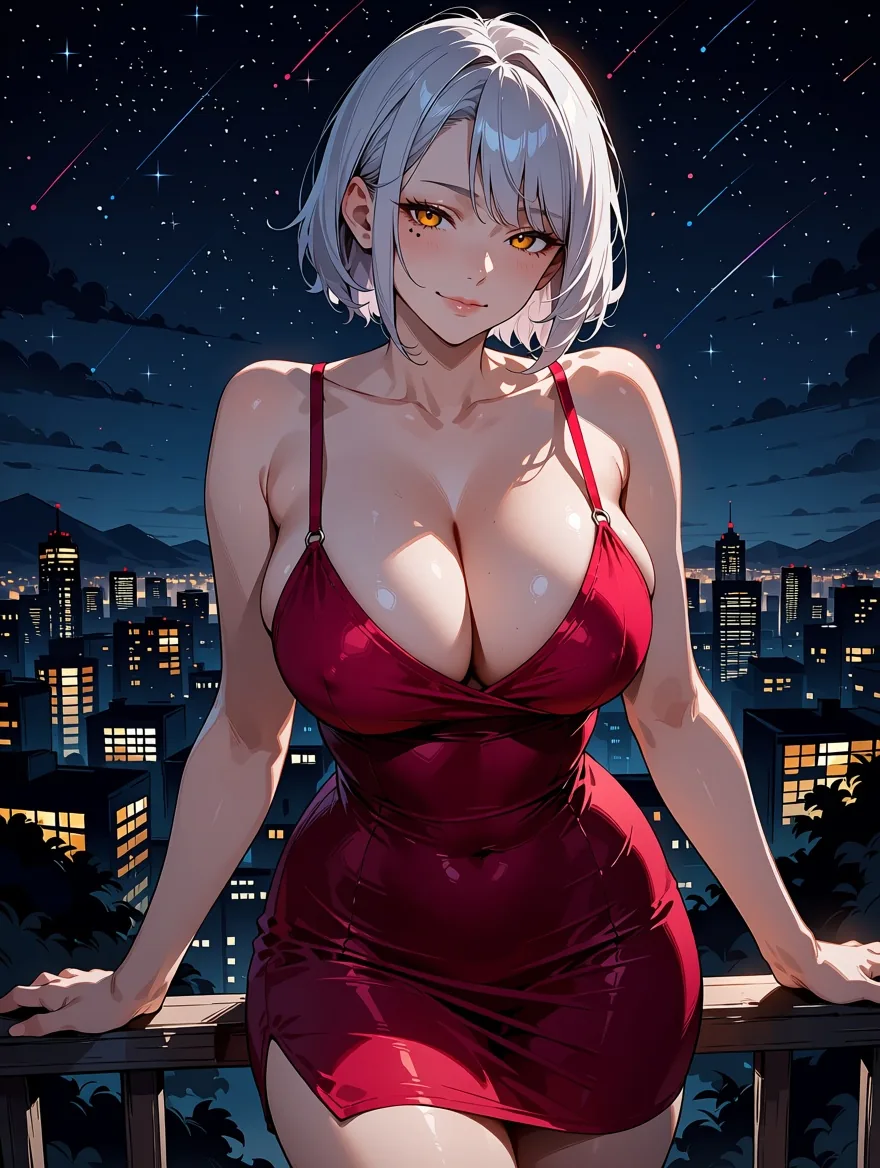
Cena 2: vestido vermelho, varanda.
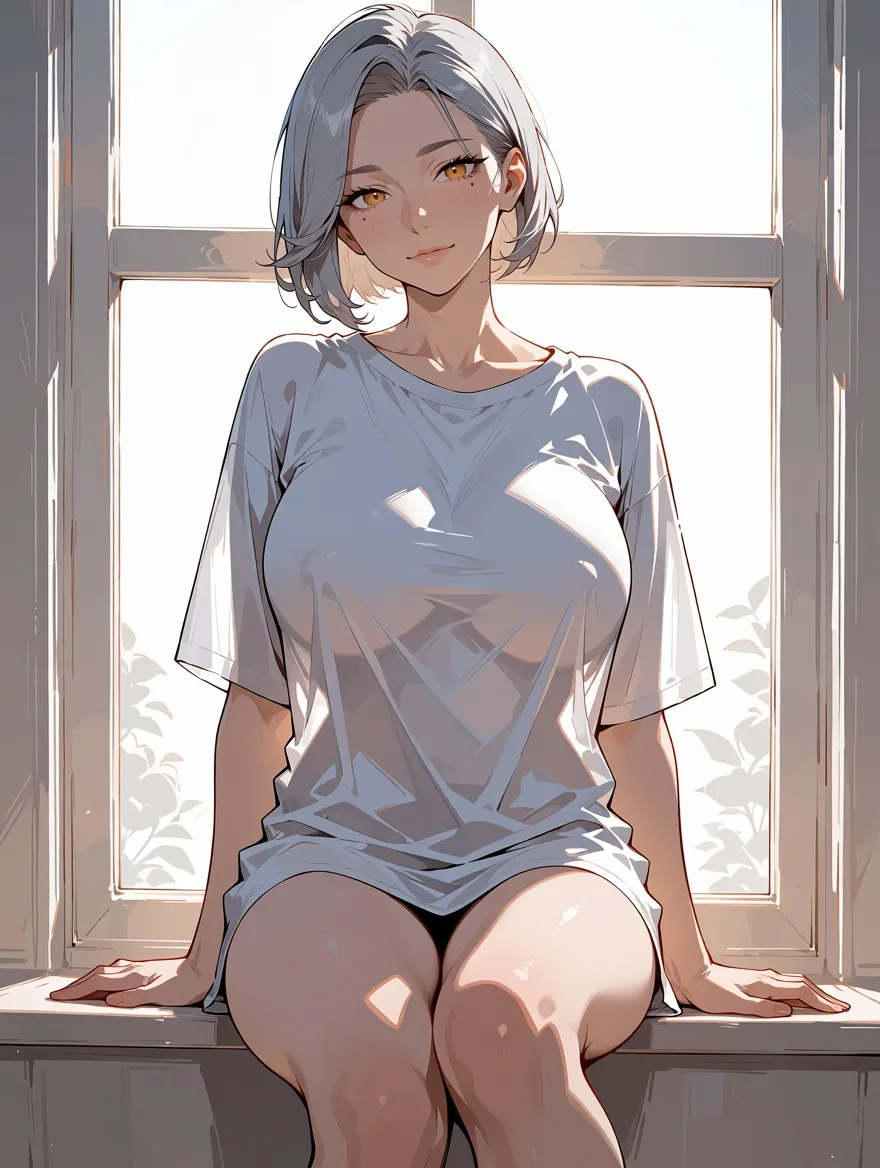
Cena 3: camisa branca larga, parapeito da janela.
O corte chanel prateado, os olhos dourados e a pinta se mantiveram nas três cenas, e o rosto continua reconhecível como a mesma personagem. O estilo de renderização varia um pouco entre as cenas (a imagem da galeria é mais pictórica que as outras duas), que é o custo normal de mudar a cena inteira em torno de uma seed fixa. Dois hábitos ajudam:
- Descreva o personagem com características concretas e contáveis: comprimento e cor do cabelo, cor dos olhos, uma marca distintiva. Palavras vagas ("bonita", "elegante") não acrescentam nada ao reconhecimento.
- Mude uma coisa de cada vez quando quiser comparar. Se a roupa, o lugar e a iluminação mudam juntos, não dá para saber qual deles quebrou a semelhança.
Uma seed fixa torna as execuções comparáveis, mas não garante pixels idênticos: a mesma requisição com a mesma seed nos deu renderizações ligeiramente diferentes em momentos diferentes. Conte com escolher a melhor entre algumas tentativas.
Como adicionar um estilo com uma LoRA compatível com conteúdo adulto?
Use a família LoRA, cole um link direto para um arquivo .safetensors e mantenha a escala entre cerca de 0,5 e 1,2. A página do Anima Turbo LoRA aceita até três LoRAs por requisição, cada uma como um par {path, scale}. Carregar LoRAs não gera cobrança separada, e a plataforma não adiciona nenhum filtro a elas. O Hugging Face listava 129 adaptadores LoRA do Anima em 5 de outubro de 2026. Uma LoRA treinada para outro modelo base carrega sem erro e não muda nada, então confirme que a que você escolheu foi treinada para o Anima.
Usamos duas LoRAs públicas. A primeira é o visual dos jogos da era PC-98, Melon-Bread/anima-pc98-gal-style-v0.2, com a palavra-gatilho pc98gal_style.
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework,
sensitive, 1girl, solo, adult woman, mature female, long purple hair, black slip dress,
leaning on a balcony at night, city lights, sultry smile, looking at viewer,
retro anime aesthetic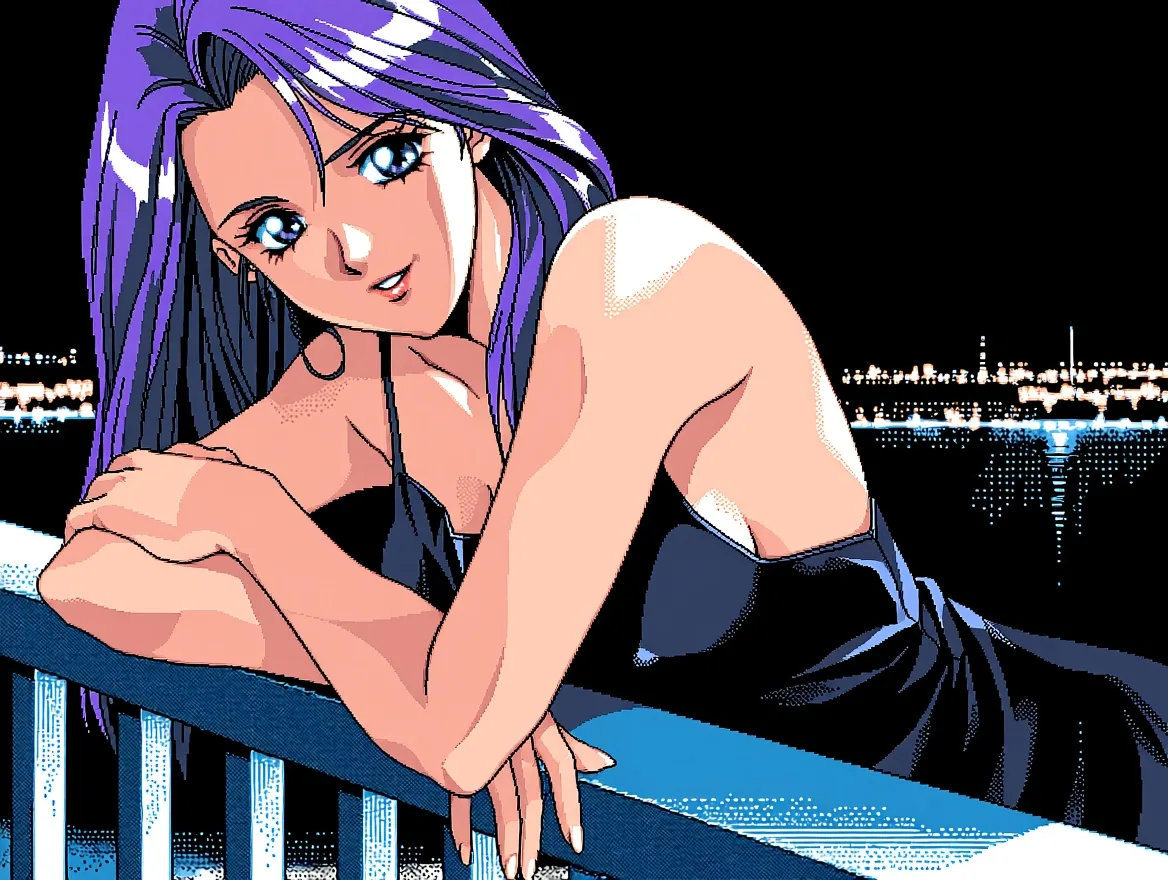
Anima Turbo LoRA, LoRA PC-98 com scale 1, 4:3, nível 1k.
A segunda é um visual de tinta de mangá, notverriegod/monochrome-grayscale_style. Ela precisou de monochrome, greyscale no prompt: sem essas palavras, nossa execução ficou em cores. Aqui uma mulher adulta de quimono está sentada junto a uma lanterna de papel, com sensitive como tag de classificação.
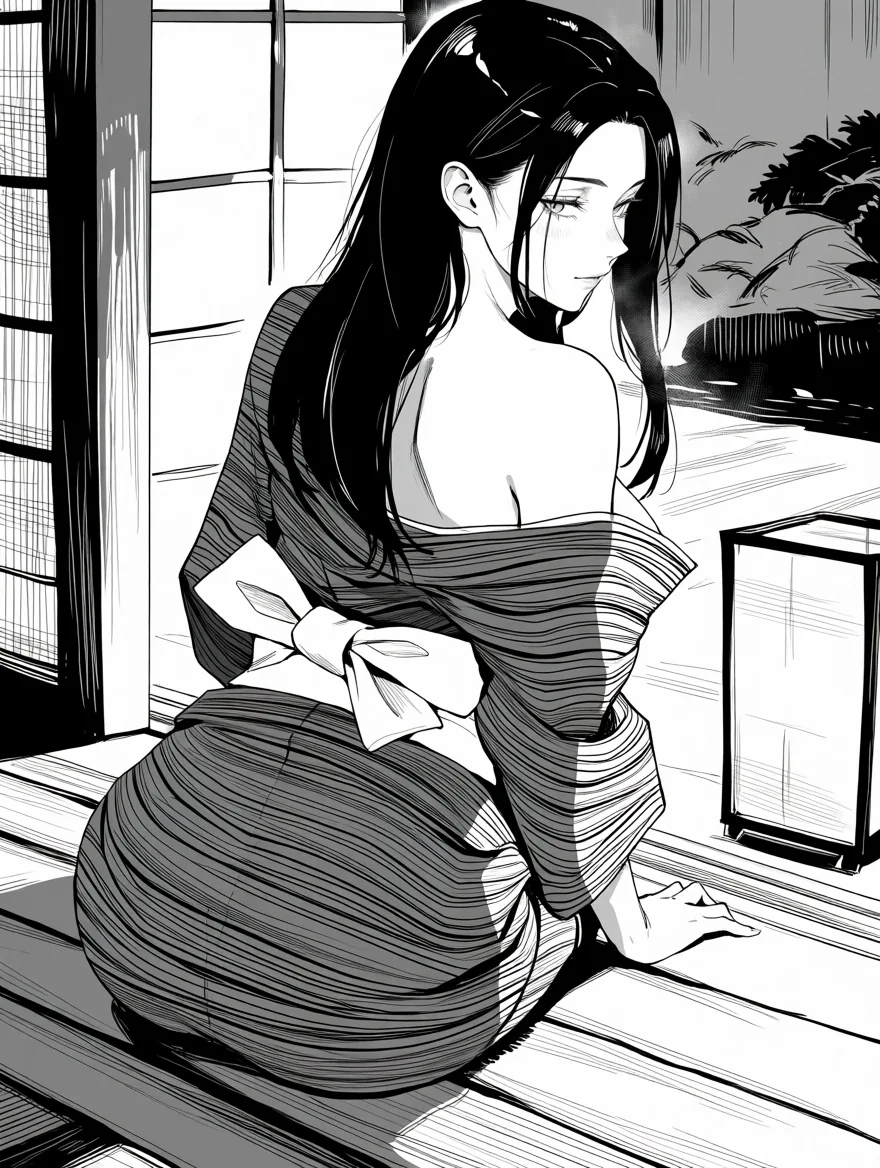
Anima Turbo LoRA, LoRA monocromática com scale 1, 3:4, nível 1k.
O que saber sobre a escala, a partir da nossa escada de valores: 0 é idêntico a não usar LoRA, 0,5 é um toque leve, 1 é o estilo completo, 1,5 empurra o estilo com mais força e 4 desfez a imagem em formas abstratas. Três LoRAs empilhadas em 1, 0,6 e 0,25 funcionaram, com o estilo principal ainda bem legível; mais de três são rejeitadas. A primeira requisição com uma LoRA nova pode demorar mais enquanto o arquivo é baixado (uma das nossas levou quase três minutos). Se um link for restrito (exige login), a requisição falha com uma mensagem HTTP 401, e se você colar a página de um repositório em vez do arquivo, a resposta pede o link de download direto; nenhum dos dois casos é cobrado. Mais sobre empilhamento e palavras-gatilho em Anima Turbo LoRA: estilos, escala e empilhamento.
Dá para escrever cenas sugestivas de casal?
Dá: escreva os dois personagens como adultos, defina o clima com luz e postura e deixe a tag de classificação fazer o resto. Esta dança lenta num bar de jazz é um bom modelo:
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood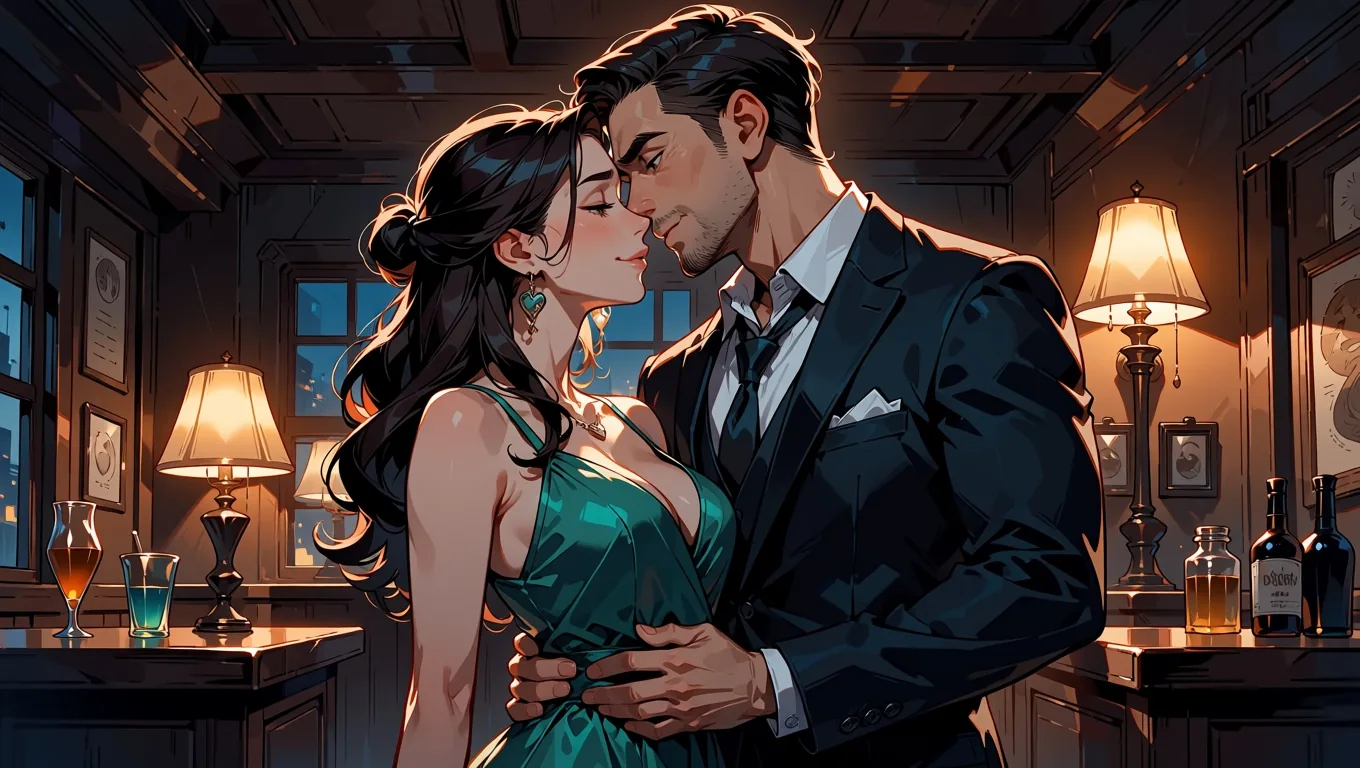
Anima Turbo, 16:9, nível 1k, sensitive.
O modelo segue bem as tags de grupo (1girl, 1boy, 2boys, 2girls). Também rodamos mais dois casais, um de dois homens e outro de duas mulheres, com a mesma estrutura, usando 2boys e 2girls e as tags de adulto para cada pessoa.
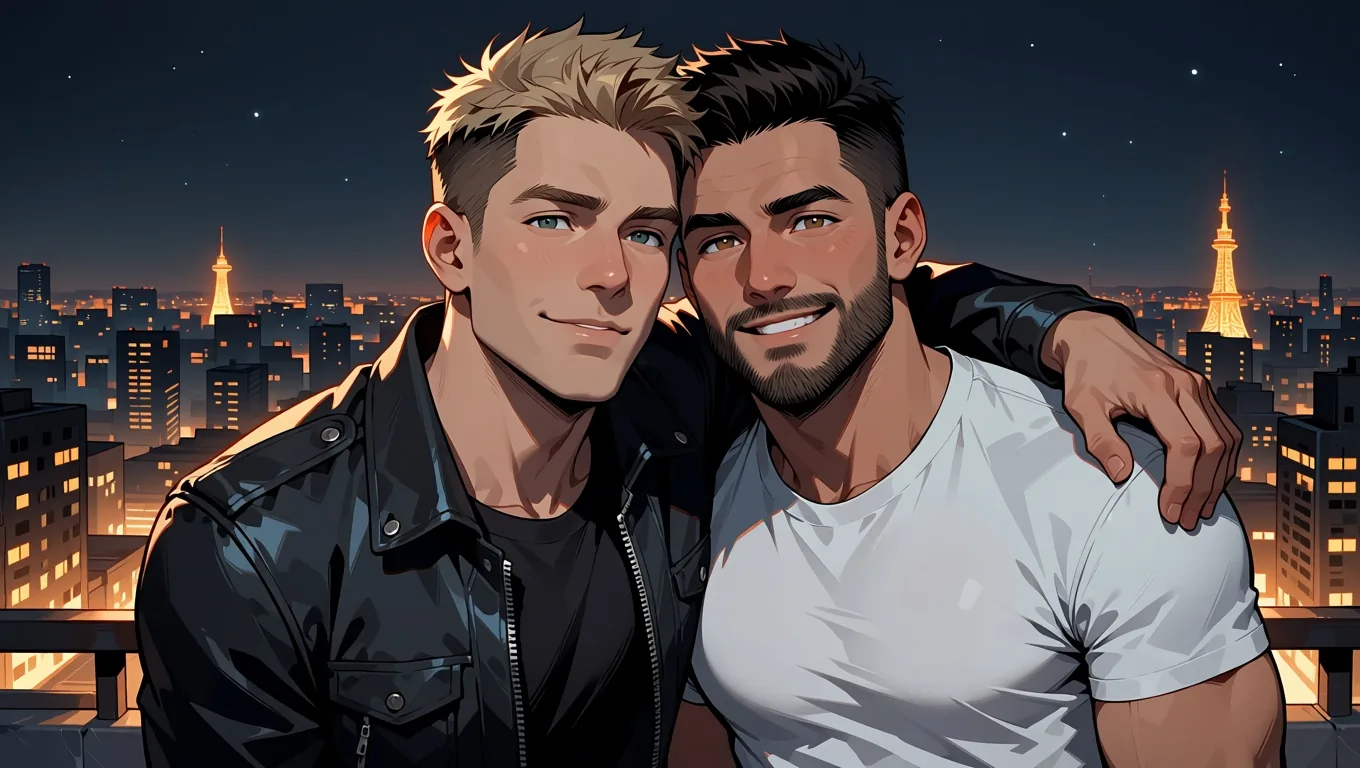
Dois homens adultos num terraço à noite, 2boys, sensitive.
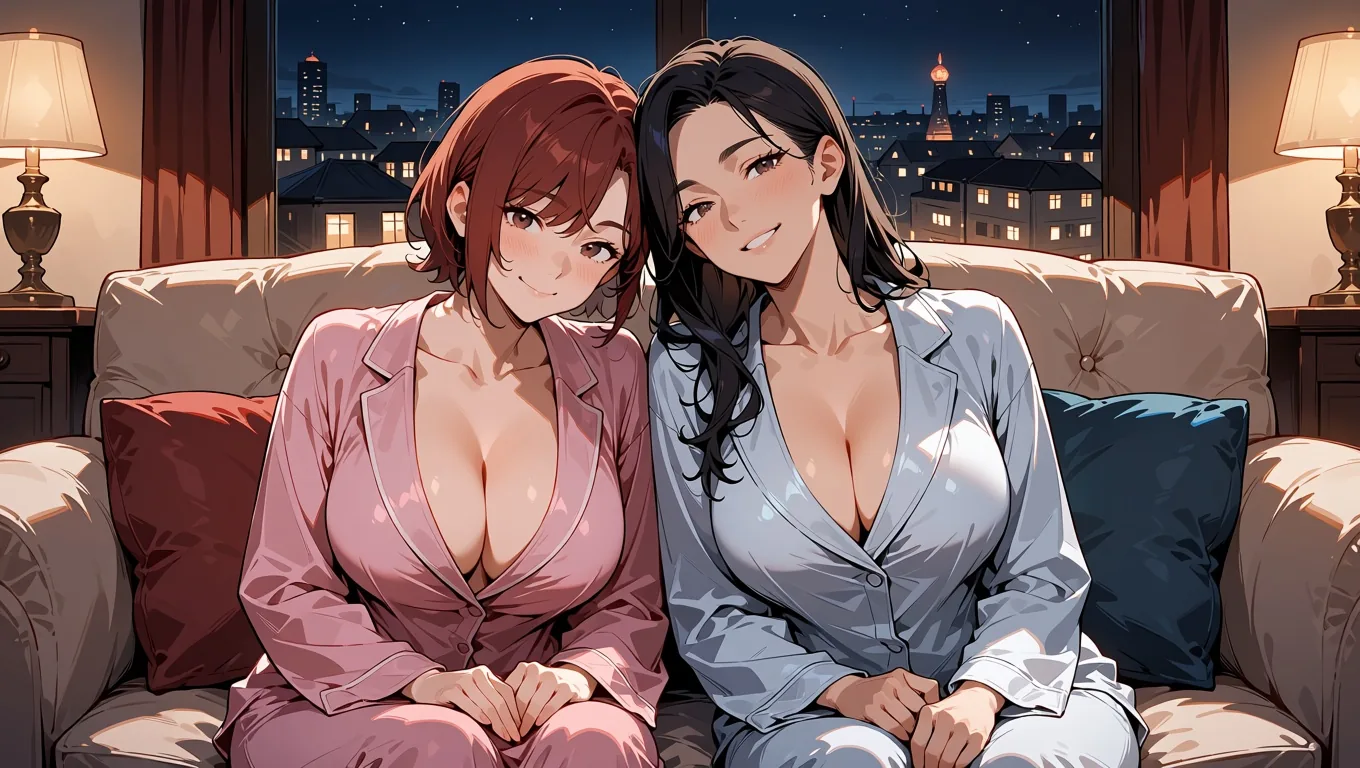
Duas mulheres adultas num sofá, de pijama de seda, 2girls, sensitive.
Duas coisas que notamos. Primeiro, o modelo lê mature male e mature female como uma instrução sobre os rostos, então mantenha essas palavras; elas também deixam claro no prompt que todos os personagens são adultos. Segundo, cenas solo são as mais confiáveis. Para um homem adulto sozinho, a mesma receita funciona: uma camisa branca desabotoada na porta de um quarto, com luz da manhã, saiu como esperado na primeira seed, e uma mulher de roupão com um ombro à mostra junto a uma janela ao amanhecer também.
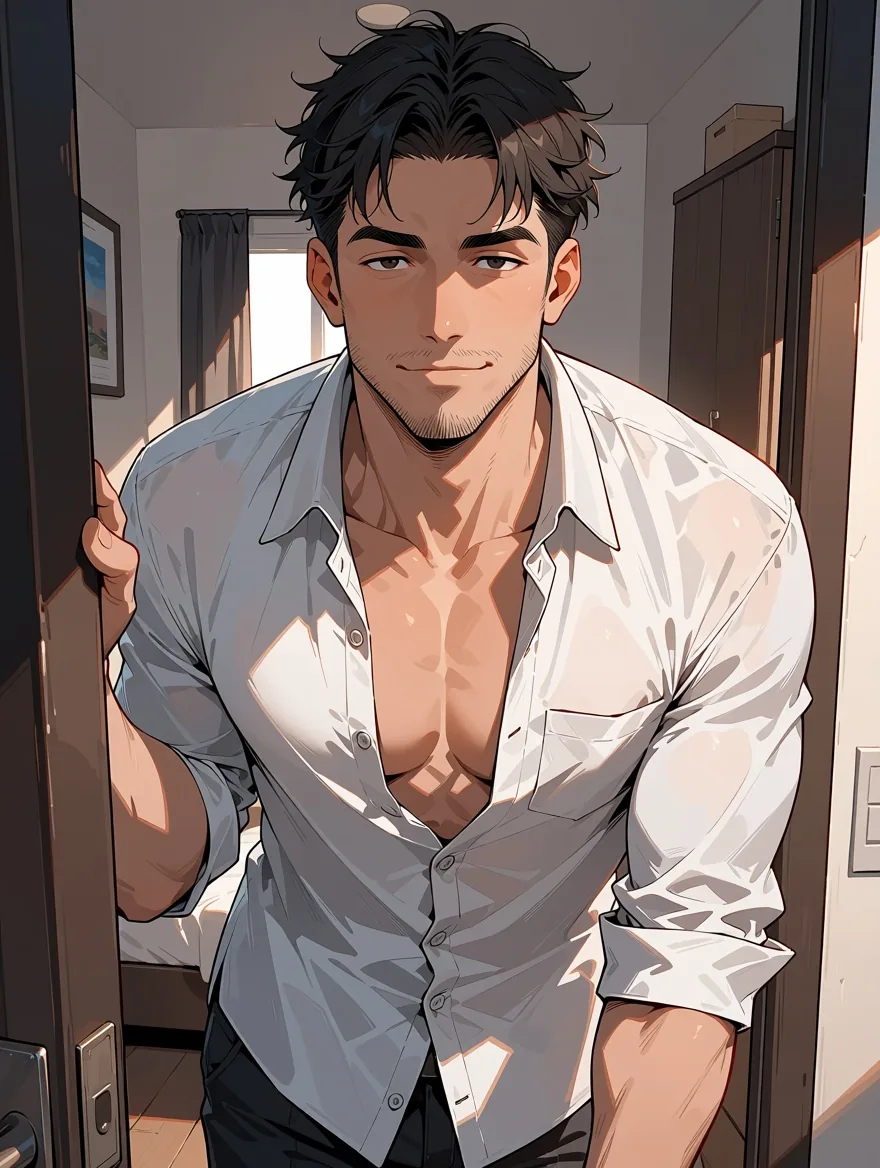
Homem adulto sozinho, 3:4, sensitive.
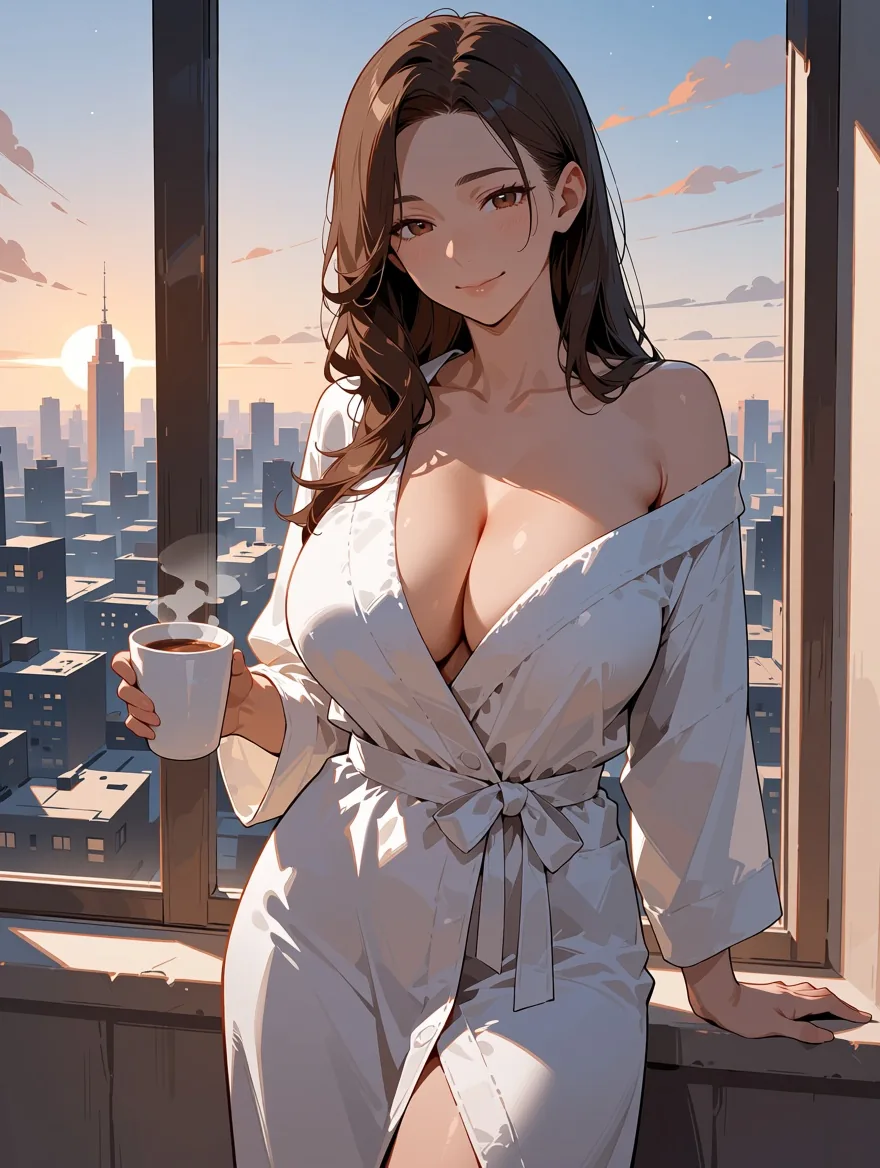
Mulher adulta sozinha, 3:4, sensitive.
Quais são os limites?
É um modelo de anime: sem fotorrealismo, com o hábito de desenhar rabiscos parecidos com assinaturas e os problemas de sempre com as mãos. Nos nossos testes:
- Sem fotorrealismo. O modelo base é treinado com dados de anime e ilustração; a desenvolvedora cita vários milhões de imagens de anime mais cerca de 800 mil outras imagens artísticas. Ele não produz fotografias. Para conteúdo adulto isso tem um efeito colateral útil: os resultados parecem ilustração e nunca fotografias de pessoas reais.
- A mania da assinatura. O modelo às vezes desenha num canto um rabisco parecido com uma assinatura ou uma linha de pseudotexto, um hábito aprendido com ilustrações. Vimos isso em cerca de uma imagem em cada cinco. Não há prompt negativo para suprimir, então troque a seed ou corte o canto.
- Mãos e anatomia. Sem recusas não significa sem falhas. Mãos e anatomia exigem novas tentativas, como em qualquer modelo de imagem.
- Texto. Ele desenha apenas uma ou duas palavras de texto.
- Imagem para imagem muda o estilo; não segue instruções de edição. Com uma foto como origem, a força 0,6 já resulta numa ilustração com os mesmos detalhes, e 0,75 dá um anime limpo com a mesma composição. Pedir a uma ilustração existente uma roupa nova ou a passagem do dia para a noite mudou muito pouco entre 0,6 e 0,8. A força é explicada em Foto para anime com o Anima Turbo: como escolher a força. A página de imagem para imagem mantém o formato da origem, já que não tem campo de proporção.
- Controles ausentes. Sem prompt negativo, passos, CFG, sampler, formato de saída (sempre JPEG), máscaras nem várias imagens por requisição.
Qual família do Anima escolher?
Comece pelo Anima Turbo; passe para a família LoRA quando quiser um estilo que o modelo base não oferece. Os dois têm o mesmo custo por nível de resolução, imagem para imagem custa o mesmo que texto para imagem e a proporção não muda o preço. Os preços atuais estão nas páginas dos modelos, e requisições com falha não são cobradas.
| Você quer | Escolha | Por quê |
|---|---|---|
| Anime limpo a partir de tags ou frases, texto para imagem ou imagem para imagem | Anima Turbo | Começo mais rápido; L3 e L4 gerados nos nossos testes |
| Um visual específico (PC-98, tinta de mangá) ou sua própria LoRA compatível com conteúdo adulto | Anima Turbo LoRA | Até 3 LoRAs com scale de 0 a 4; L3 e L4 gerados |
| Um checkpoint de anime da comunidade, da linhagem Pony XL, só texto para imagem | Prefect Pony XL | Sete tamanhos SDXL nativos; três níveis de teste, até o L4, gerados na nossa execução interna de 18 de setembro de 2026 |
| Uma base fotorrealista que vira anime com uma LoRA de anime | Z-Image Turbo LoRA | Fotorrealista por padrão; L3 e L4 gerados em texto para imagem |
Escolha do nível: 1k equivale a cerca de um megapixel e 1.5k a cerca de 2,4 megapixels, gerados de forma nativa, sem upscale. No nosso teste de velocidade com 60 execuções, o tempo do modelo foi de 2 a 16 segundos por imagem, com 52 de 60 abaixo de dez segundos, então gerar de novo sai barato. A página de texto para imagem tem as 15 proporções. Para uma visão mais ampla sobre a redação de prompts e estilos de anime adulto, veja o guia "Adult Anime AI Image Style Guide" (disponível apenas em inglês).
Uso responsável
Você é responsável pelo que gera e publica. Faça de todo personagem um adulto e diga isso no prompt (adult woman, mature male, "in her thirties"). Não use pessoas reais nem a imagem de pessoas reais sem consentimento. Mantenha seus resultados privados, a menos que tenha certeza de que pode compartilhá-los, e respeite as regras de qualquer site onde publicar. A plataforma não revisa seu conteúdo e não escreve prompts adultos para você; os exemplos deste guia são propositalmente com personagens vestidos. Se uma requisição não for adequada à sua situação, não a faça.
FAQ
O Anima Turbo é mesmo sem censura?
Sim. Na SpicyAPI não há filtro de conteúdo na frente dele e, nos nossos testes com 25 requisições em quatro níveis, vimos zero recusas e zero substituições, com e sem LoRAs e em imagem para imagem. Sem recusas não significa que toda imagem sai perfeita; anatomia e mãos ainda exigem novas tentativas.
A tag de classificação nsfw faz diferença?
Sim, ela muda o tom. O Anima conhece safe, sensitive, nsfw e uma tag mais forte, e a desenvolvedora descreve nsfw e a tag mais forte como as que tiram a contenção. Com uma descrição de personagem vestido, achamos safe e sensitive quase idênticas, então escolha a tag que combina com o clima que você quer.
As imagens vão parecer pessoas reais?
Não. O modelo base não faz fotorrealismo, então todo resultado parece ilustração, e não fotografia. Isso não torna aceitável a semelhança com pessoas reais: não peça isso no prompt sem consentimento.
Posso manter o mesmo personagem em várias imagens?
Em boa parte, sim. Reutilize o bloco do personagem palavra por palavra, fixe a seed e mude apenas a roupa e o lugar. A personagem de cabelo prateado do nosso conjunto de três cenas continuou reconhecível, embora o estilo de renderização tenha variado um pouco. Uma seed fixa não garante pixels idênticos.
LoRAs compatíveis com conteúdo adulto funcionam? Há cobrança extra?
Sim para as duas perguntas. A família LoRA aceita até três LoRAs treinadas para o Anima, e carregá-las não gera cobrança separada. Uma LoRA treinada para outro modelo base carrega sem erro e não muda nada. Mantenha a escala entre cerca de 0,5 e 1,2; em 4 a imagem se desfez.
Posso transformar minha própria ilustração ou foto em algo mais forte?
Imagem para imagem muda o estilo; não segue instruções de edição. Com uma imagem de origem com personagem vestido, pedir L3 ou L4 com força de 0,8 a 0,9 foi atendido nos nossos testes. Uma foto em 0,75 vira um anime limpo com a mesma composição e, em 1,0, a origem é ignorada.
Por que algumas imagens têm um rabisco no canto?
O modelo aprendeu com ilustrações o hábito de desenhar um rabisco parecido com uma assinatura ou uma linha de pseudotexto. Vimos isso em cerca de uma imagem em cada cinco. Não há prompt negativo, então troque a seed ou corte o canto.