Anima Turbo, texto a imagen, 16:9 en el nivel 1.5k. La etiqueta de clasificación fue sensitive; el prompt describe a una persona adulta vestida en una habitación de hotel.
Respuesta corta: sí, Anima Turbo no tiene censura. En SpicyAPI no hay ningún filtro de contenido delante del modelo y, en nuestras pruebas de 25 solicitudes repartidas en cuatro niveles, desde lencería sugerente hasta una escena íntima entre dos personas adultas, obtuvimos cero rechazos y cero sustituciones. La imagen a imagen y los LoRAs aptos para adultos se comportaron igual. Lo que el modelo no hace es fotorrealismo, que para este tipo de trabajo es una ventaja: todo lo que dibuja se lee como ilustración.
Esta guía cubre lo que probamos, cómo las etiquetas de clasificación cambian el tono, cómo mantener reconocible a un mismo personaje adulto entre escenas, cómo añadir un estilo con un LoRA, cómo escribir escenas de pareja y dónde el modelo todavía se queda corto. Todos los prompts de ejemplo de esta guía son escenas con personas vestidas y, como mucho, sugerentes; la plataforma no escribe ni publica prompts para escenas de adultos, y no necesitarás ninguno para seguir la guía.
De un vistazo
| Pregunta | Respuesta según nuestras pruebas (5 de octubre de 2026) |
|---|---|
| ¿Rechaza solicitudes? | No. 25 solicitudes, cero rechazos, cero sustituciones |
| Niveles probados | De L1 a L4 (no ejecutamos L5 en Anima) |
| También probado | Imagen a imagen, con y sin LoRAs, sujetos femeninos y masculinos, dos seeds para los niveles más altos, niveles 1k y 1.5k |
| Control del tono | Etiquetas de clasificación: safe, sensitive, nsfw y una etiqueta más fuerte |
| Estilo | Solo anime e ilustración; sin fotorrealismo |
| Estilos propios | Hasta 3 LoRAs en la familia LoRA |
| Velocidad habitual | De 2 a 16 segundos por imagen en nuestra prueba de velocidad de 60 ejecuciones |
| No disponible | Prompt negativo, pasos, CFG, máscaras, varias imágenes por solicitud |
¿Anima Turbo no tiene censura?
Sí: en nuestras pruebas no se rechazó, difuminó ni suavizó nada. Llevamos el modelo por nuestra escala de contenido, que usa nombres de nivel neutrales:
| Nivel | Qué significa | Resultado en Anima |
|---|---|---|
| L1 Sugerente | Lencería, un tirante que se resbala del hombro | Generado tal como se escribió |
| L2 Parcial | Un look parcialmente revelador | Generado tal como se escribió |
| L3 Fuerte | Un look mucho más revelador | Generado tal como se escribió |
| L4 Intenso | Una escena íntima entre dos personas adultas | Generado tal como se escribió al primer intento |
| L5 Extremo | Sujeción consensuada entre personas adultas, o gore cinematográfico | No se ejecutó en Anima |
Las 25 solicitudes combinaron texto a imagen e imagen a imagen, con y sin LoRAs, sujetos femeninos y masculinos, dos seeds para L3 y para L4, y los dos niveles de resolución. Las ejecuciones de imagen a imagen partieron de una imagen de origen con ropa y, cuando pedimos L3 o L4 con una strength de 0.8 a 0.9, el modelo lo siguió. Un lote aparte de 60 ejecuciones de relaciones de aspecto usó un prompt de nivel L2 y las 60 se entregaron. No vimos ninguna marca de contenido, ningún difuminado ni ninguna suavización.
"Sin rechazos" no es lo mismo que "todas las imágenes salen perfectas". La anatomía y las manos siguen necesitando nuevos seeds, como en cualquier modelo de imagen, y lo tratamos en la sección de límites.
Cómo trataron otros modelos la misma escala
Como referencia, ejecutamos la misma escala en dos modelos de imagen de uso general a través de una API alojada por un tercero: FLUX 3 de texto a imagen e Ideogram v4.5. Ambos entregaron una escena de playa con bikini y una foto de catálogo de lencería neutral. FLUX 3 rechazó 10 de sus 12 solicitudes e Ideogram rechazó 11 de sus 13, entre ellas una pintura clásica de estudio de figura y un prompt eufemístico sin palabras marcadas. Los rechazos llegaron en unos dos segundos, antes de generar cualquier imagen, con el mensaje "Content flagged as potentially sensitive. Please try different prompts or images." Las solicitudes rechazadas no se cobraron. Como el prompt eufemístico también fue rechazado, el filtro parece semántico y no una lista de palabras clave. No podemos saber si ese filtro pertenece a las API propias de los creadores de los modelos o al servicio que las aloja, así que léelo como una afirmación sobre esas rutas y no solo sobre los modelos.
¿Cómo dirigen el tono las etiquetas de clasificación?
Las etiquetas de clasificación fijan cuánta contención aplica el modelo y, con una descripción de personaje vestido, safe y sensitive dan casi la misma imagen. Anima conoce safe, sensitive y nsfw, y el editor, CircleStone Labs, documenta una etiqueta más y más fuerte. El editor describe nsfw y esa etiqueta más fuerte como las que quitan la contención. Como no hay prompt negativo, la etiqueta de clasificación es la forma principal de fijar el tono, así que conviene elegirla con intención.
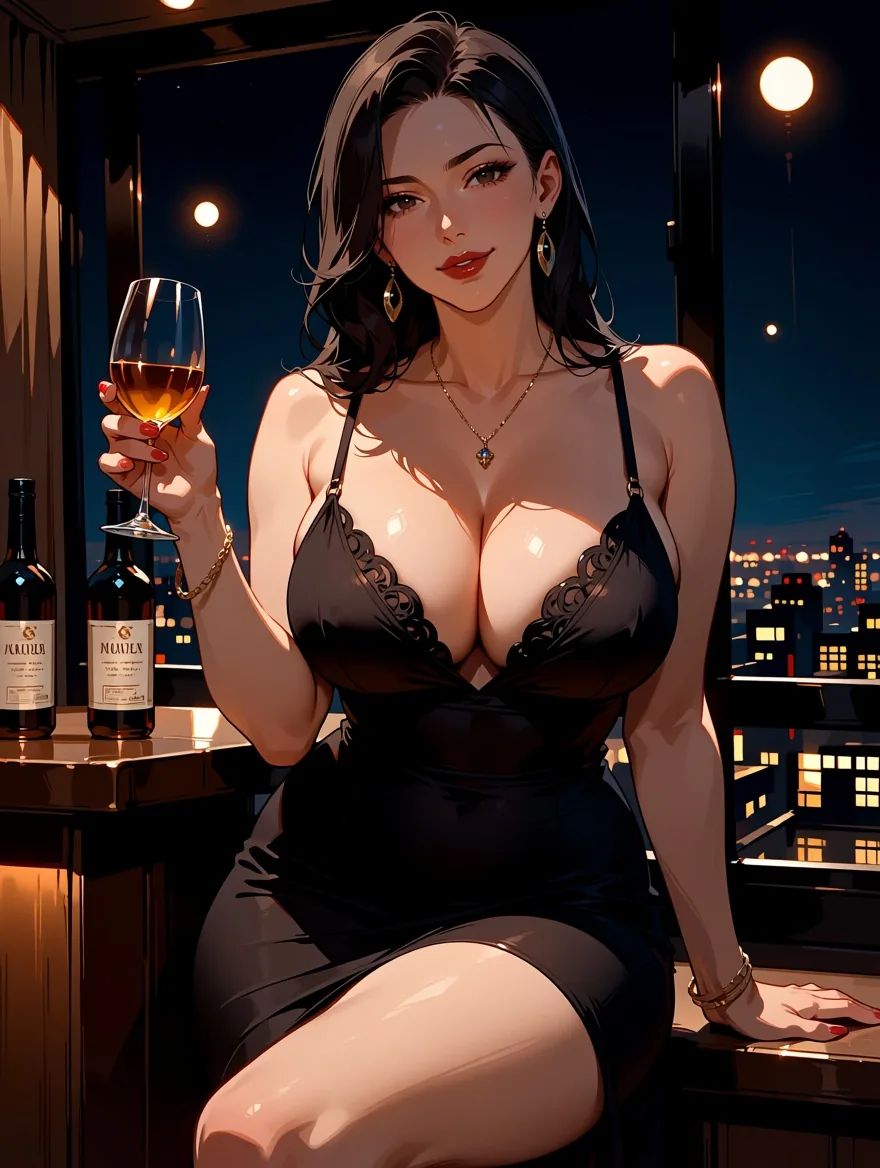
Probamos las dos primeras con un solo prompt de salón (una mujer adulta con un vestido de noche negro de tirantes finos en el bar de un hotel) y un solo seed, cambiando únicamente la etiqueta.
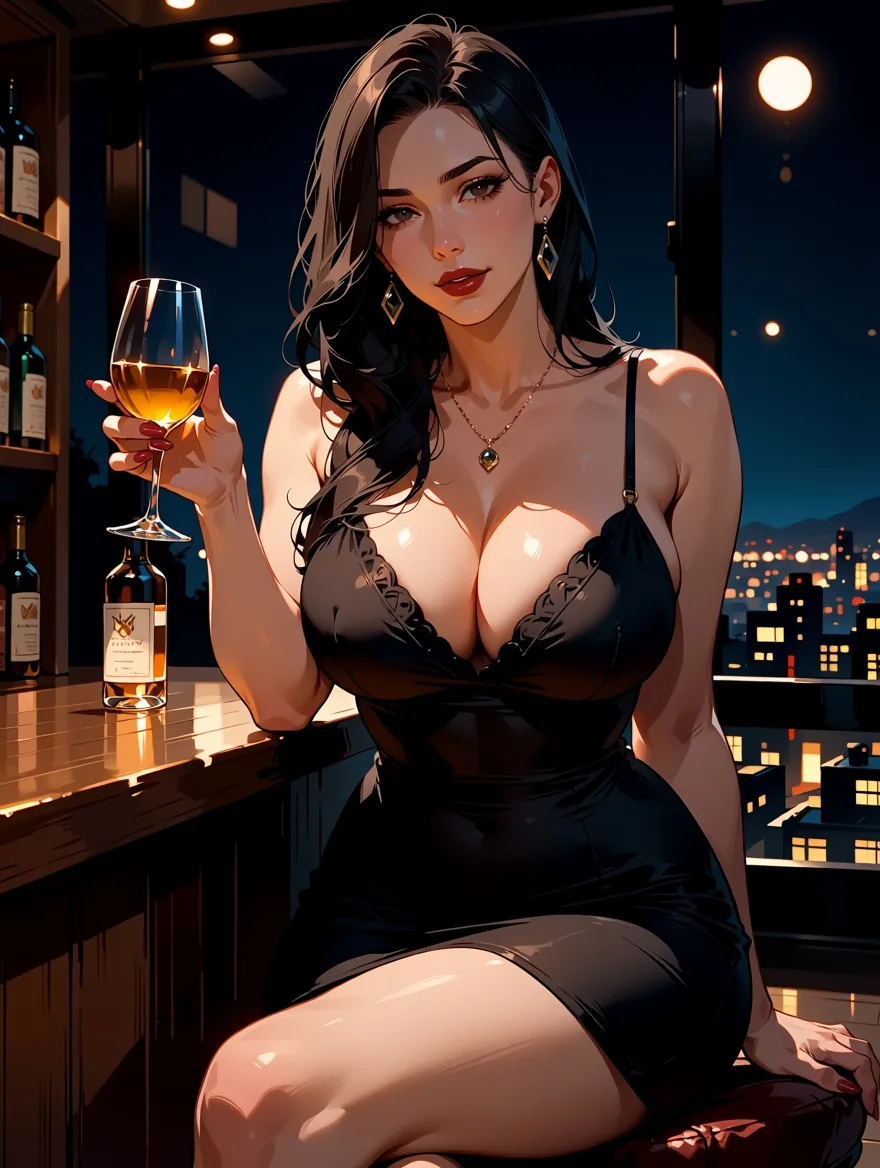
Mismo prompt y mismo seed, safe.
Mismo prompt y mismo seed, sensitive.
La composición, la pose y el ambiente coinciden; cambiaron pequeños detalles como las joyas y las botellas. Considera safe y sensitive como un empujón ligero para escenas con ropa, y espera el cambio mayor de las etiquetas más fuertes. No publicamos ningún prompt que las use, y la documentación de la plataforma tampoco; están ahí por si decides usarlas, y la sección de uso responsable de más abajo se aplica a todas ellas.
Algunas convenciones de etiquetas del editor que ayudan en cualquier escena: escribe las etiquetas en minúsculas y con espacios en lugar de guiones bajos, empieza con las etiquetas de calidad y de clasificación, luego el número de personajes (1girl, 1boy), y después el personaje, la serie, el artista y las etiquetas generales. Una buena apertura es masterpiece, best quality, y opcionalmente score_7. Nuestras propias pruebas también funcionaron con frases completas y con mezclas de etiquetas y frases; el editor recomienda al menos dos frases cuando escribes en lenguaje natural. Nuestras pruebas de prompts más amplias están en Prueba de Anima Turbo: etiquetas, frases y etiquetas de estilo.
¿Cómo mantener coherente a un mismo personaje adulto entre escenas?
Fija el seed, conserva la descripción del personaje palabra por palabra y cambia solo la ropa y el lugar. No hay función de imagen de referencia ni de bloqueo de personaje, así que la coherencia sale del prompt. Escribimos a un personaje adulto como un bloque de etiquetas y lo reutilizamos tres veces:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye,
black turtleneck, standing in an art gallery, looking at viewer
En la segunda y la tercera escena conservamos todo hasta beauty mark under the left eye, cambiamos la etiqueta de clasificación a sensitive y modificamos solo la ropa y el escenario: un vestido lencero de seda roja en un balcón de noche y, después, una camisa blanca extragrande en el alféizar de una ventana por la mañana. Las tres usaron el seed 31 en el nivel 1k con relación 3:4.
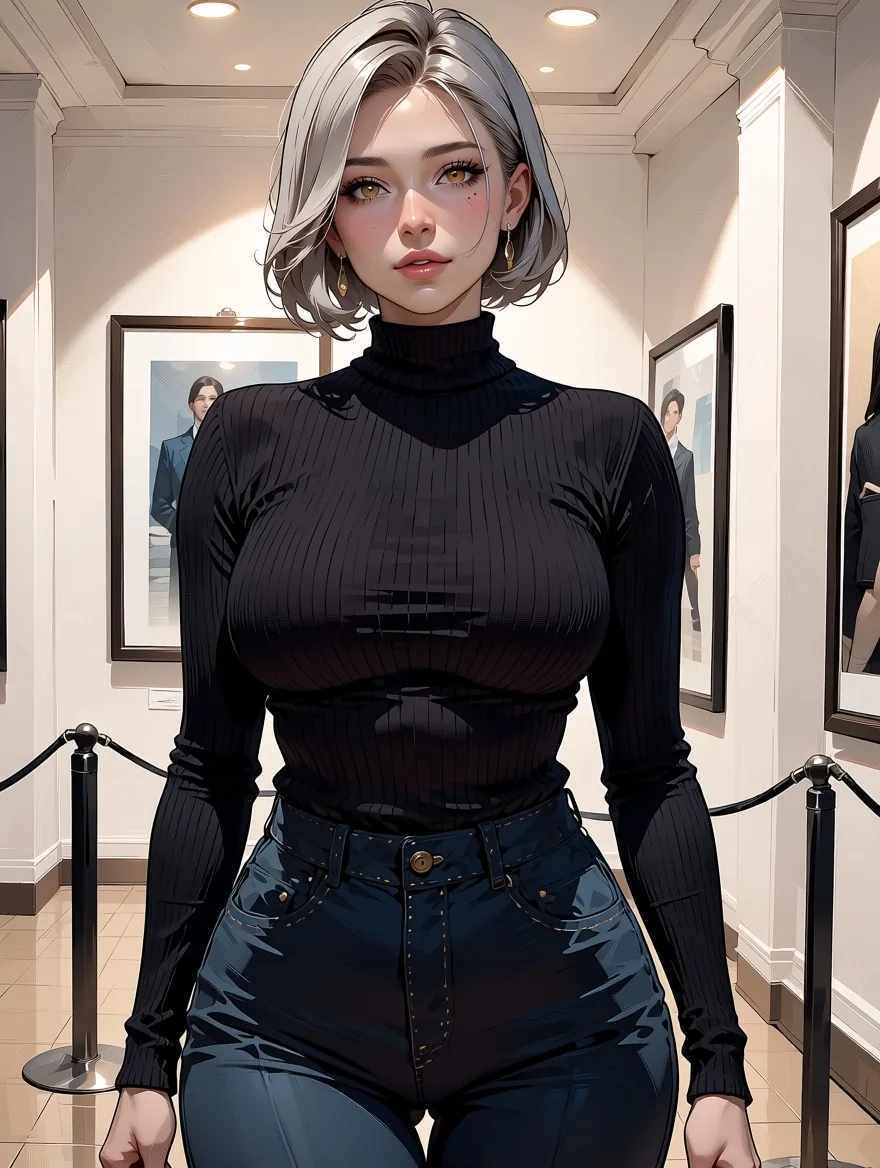
Escena 1: suéter de cuello alto, galería.
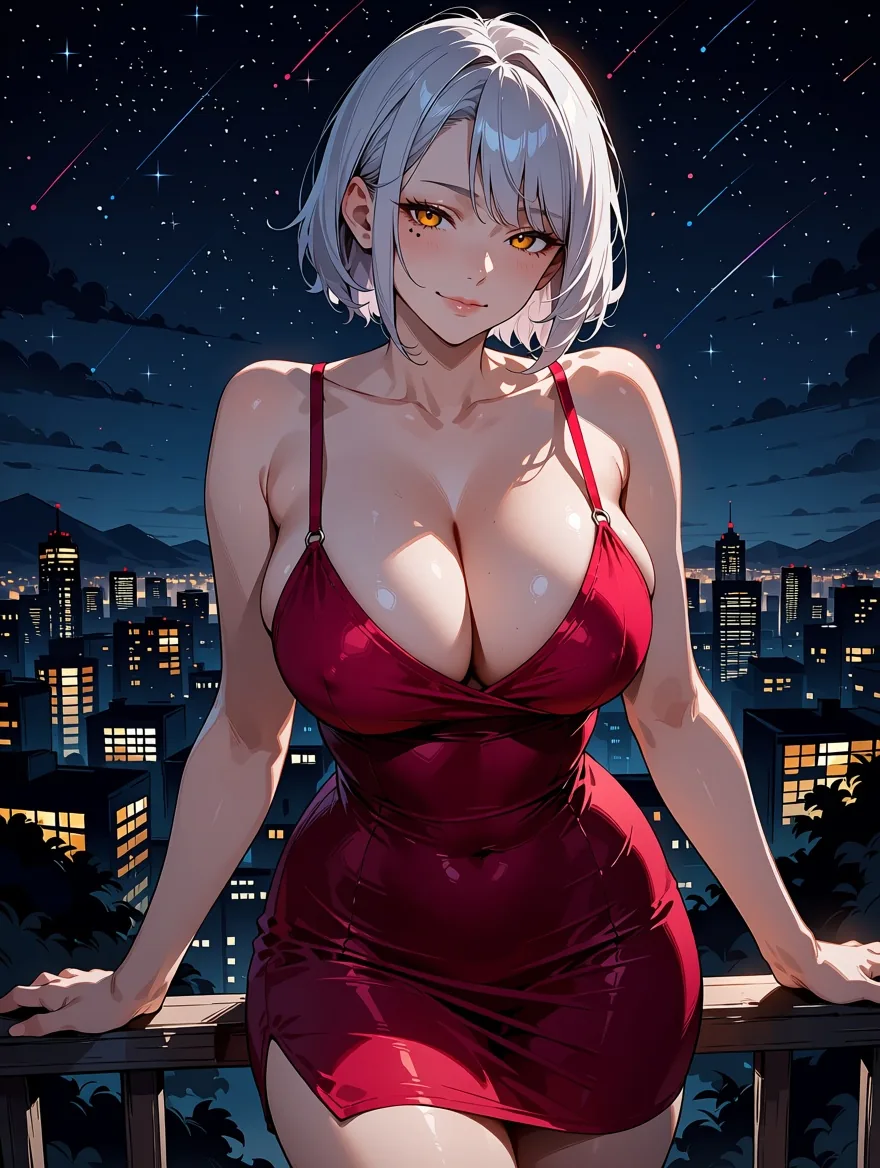
Escena 2: vestido lencero rojo, balcón.
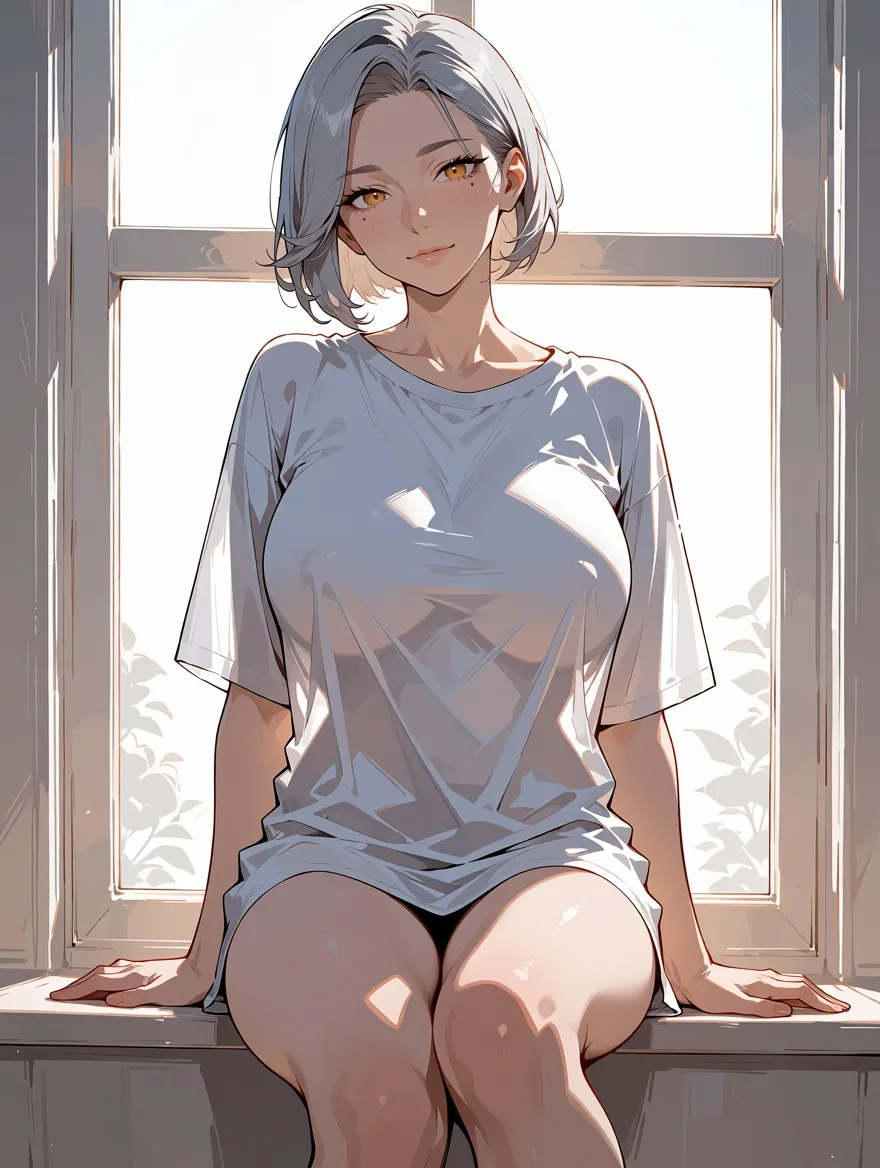
Escena 3: camisa blanca extragrande, alféizar.
El bob plateado, los ojos dorados y el lunar se mantuvieron en las tres escenas, y el rostro sigue reconociéndose como el mismo personaje. El estilo de dibujo varía un poco entre escenas (la imagen de la galería es más pictórica que las otras dos), que es el costo normal de cambiar toda la escena alrededor de un seed fijo. Dos hábitos ayudan a que funcione mejor:
- Describe al personaje con rasgos concretos y contables: largo y color del cabello, color de ojos, una marca distintiva. Las palabras vagas ("bonita", "elegante") no aportan nada al reconocimiento.
- Cambia una sola cosa a la vez cuando quieras comparar. Si cambian a la vez la ropa, el lugar y la iluminación, no puedes saber cuál rompió el parecido.
Un seed fijo hace que las ejecuciones sean comparables, pero no garantiza píxeles idénticos: la misma solicitud con el mismo seed nos dio renderizados ligeramente distintos en momentos distintos. Cuenta con elegir la mejor entre unos pocos intentos.
¿Cómo se añade un estilo con un LoRA apto para adultos?
Usa la familia LoRA, pega un enlace directo a un archivo .safetensors y mantén la scale entre 0.5 y 1.2 aproximadamente. La página de Anima Turbo LoRA acepta hasta tres LoRAs por solicitud, cada uno como un par {path, scale}. Cargar LoRAs no suma ningún cargo aparte, y la plataforma no les añade ningún filtro. Hugging Face listaba 129 adaptadores LoRA de Anima el 5 de octubre de 2026. Un LoRA entrenado para otro modelo base se carga sin error y no cambia nada, así que verifica que el que elijas esté entrenado para Anima.
Usamos dos LoRAs públicos. El primero es el aspecto de los juegos de la era PC-98, Melon-Bread/anima-pc98-gal-style-v0.2, con la palabra de activación pc98gal_style.
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework,
sensitive, 1girl, solo, adult woman, mature female, long purple hair, black slip dress,
leaning on a balcony at night, city lights, sultry smile, looking at viewer,
retro anime aesthetic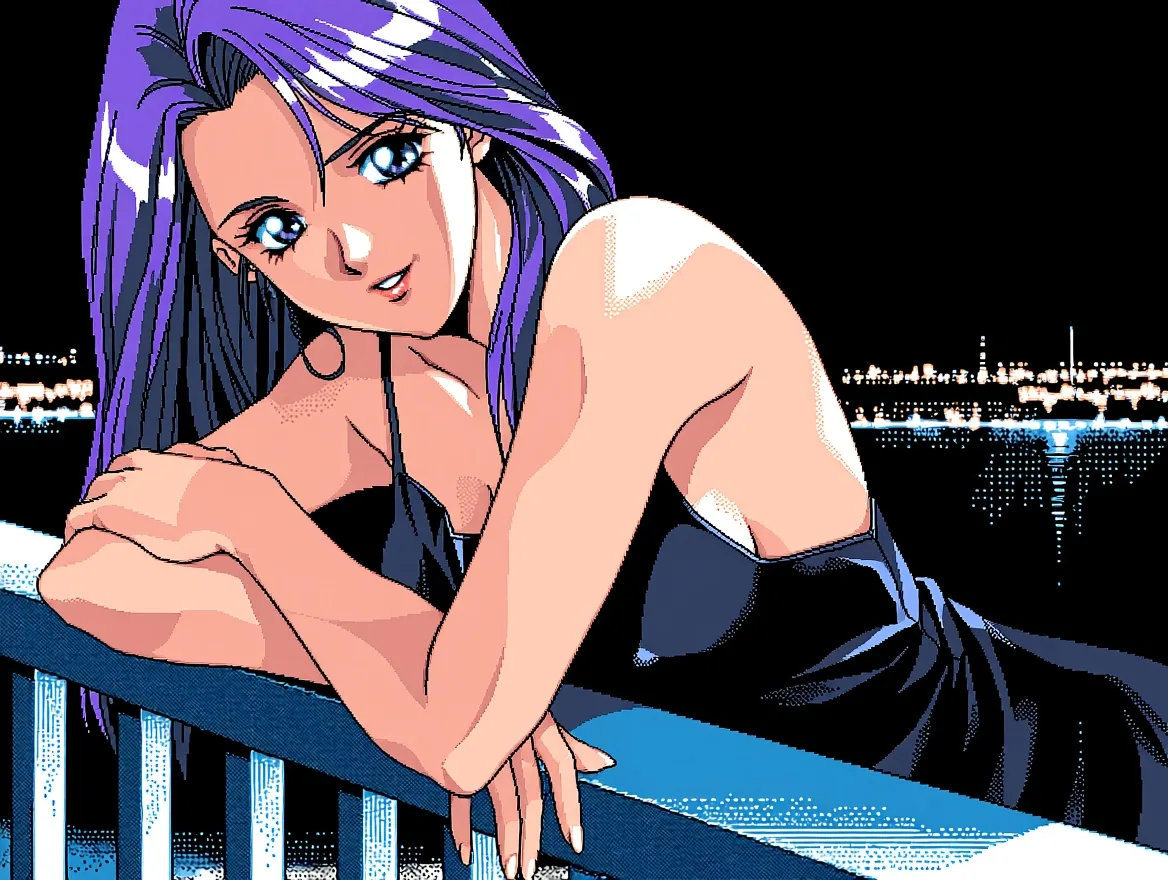
Anima Turbo LoRA, LoRA PC-98 con scale 1, 4:3, nivel 1k.
El segundo es un aspecto de tinta de manga, notverriegod/monochrome-grayscale_style. Necesitó monochrome, greyscale en el prompt: sin esas palabras nuestra ejecución se quedó en color. Aquí una mujer adulta con kimono está sentada junto a un farol de papel, con sensitive como etiqueta de clasificación.
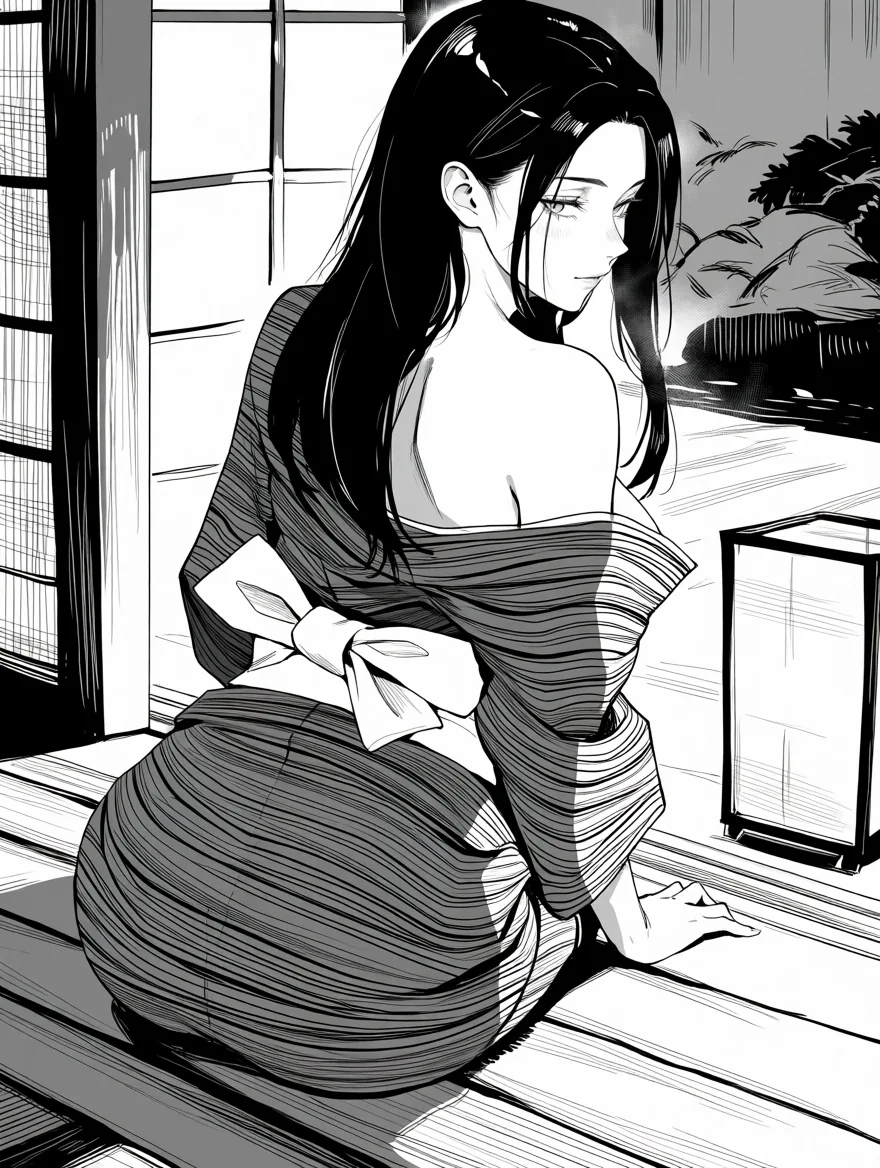
Anima Turbo LoRA, LoRA monocromo con scale 1, 3:4, nivel 1k.
Lo que hay que saber sobre la scale, según nuestra escalera de valores: 0 es idéntico a no usar LoRA, 0.5 es un toque ligero, 1 es el estilo completo, 1.5 empuja el estilo con más fuerza y 4 deshizo la imagen en formas abstractas. Tres LoRAs apilados con 1, 0.6 y 0.25 funcionaron y el estilo principal se siguió leyendo con claridad; más de tres se rechaza. La primera solicitud con un LoRA nuevo puede tardar más mientras se descarga el archivo (una de las nuestras tardó casi tres minutos). Si un enlace tiene acceso restringido (requiere iniciar sesión), la solicitud falla con un mensaje HTTP 401, y si pegas la página de un repositorio en lugar del archivo, se te pide el enlace de descarga directa; ninguno de los dos casos se cobra. Más sobre cómo apilar LoRAs y sobre las palabras de activación en Anima Turbo LoRA: estilos, scale y apilado.
¿Se pueden escribir escenas sugerentes de pareja?
Sí: escribe a ambos personajes como adultos, crea el ambiente con la luz y la postura, y deja que la etiqueta de clasificación haga el resto. Este baile lento en un bar de jazz es una buena plantilla:
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood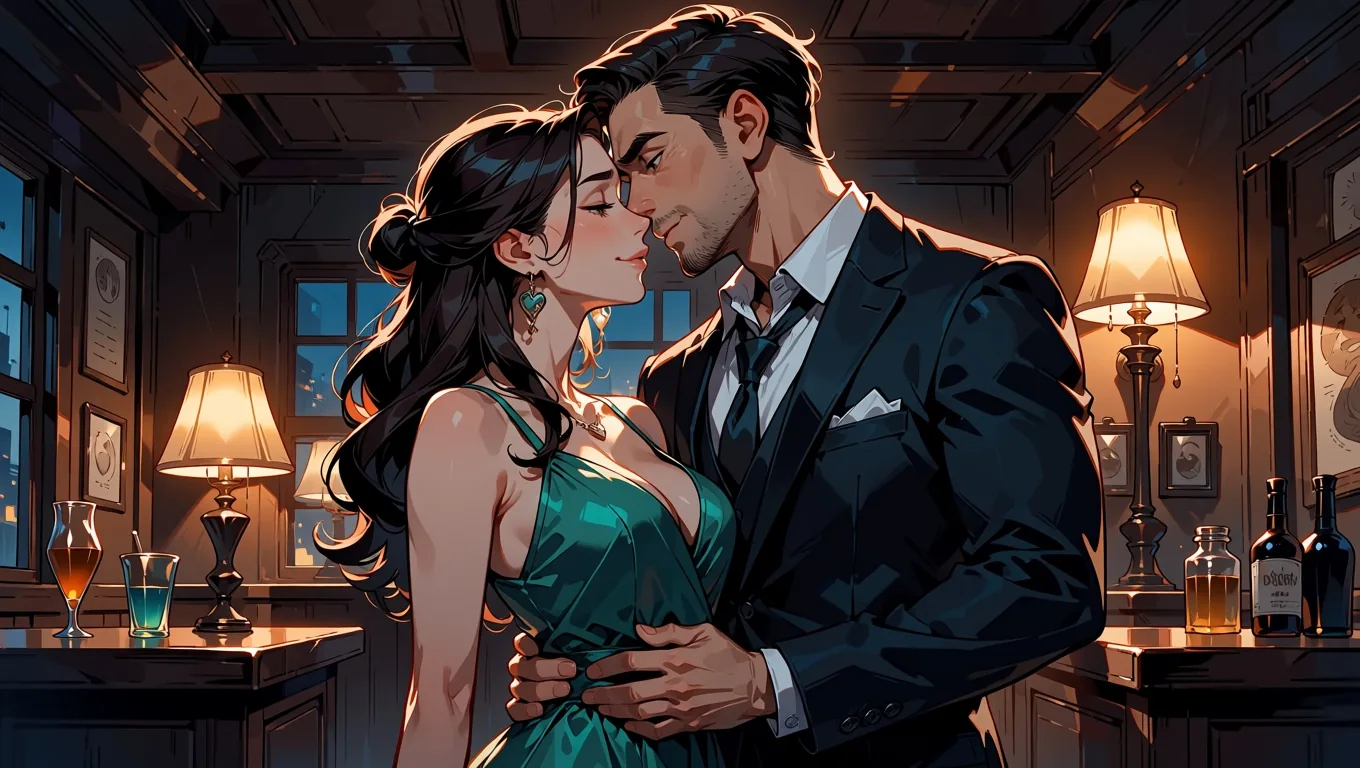
Anima Turbo, 16:9, nivel 1k, sensitive.
El modelo sigue bien las etiquetas de grupo (1girl, 1boy, 2boys, 2girls). También probamos dos parejas más, una de dos hombres y otra de dos mujeres, con la misma estructura, usando 2boys y 2girls y las etiquetas de adulto para cada persona.
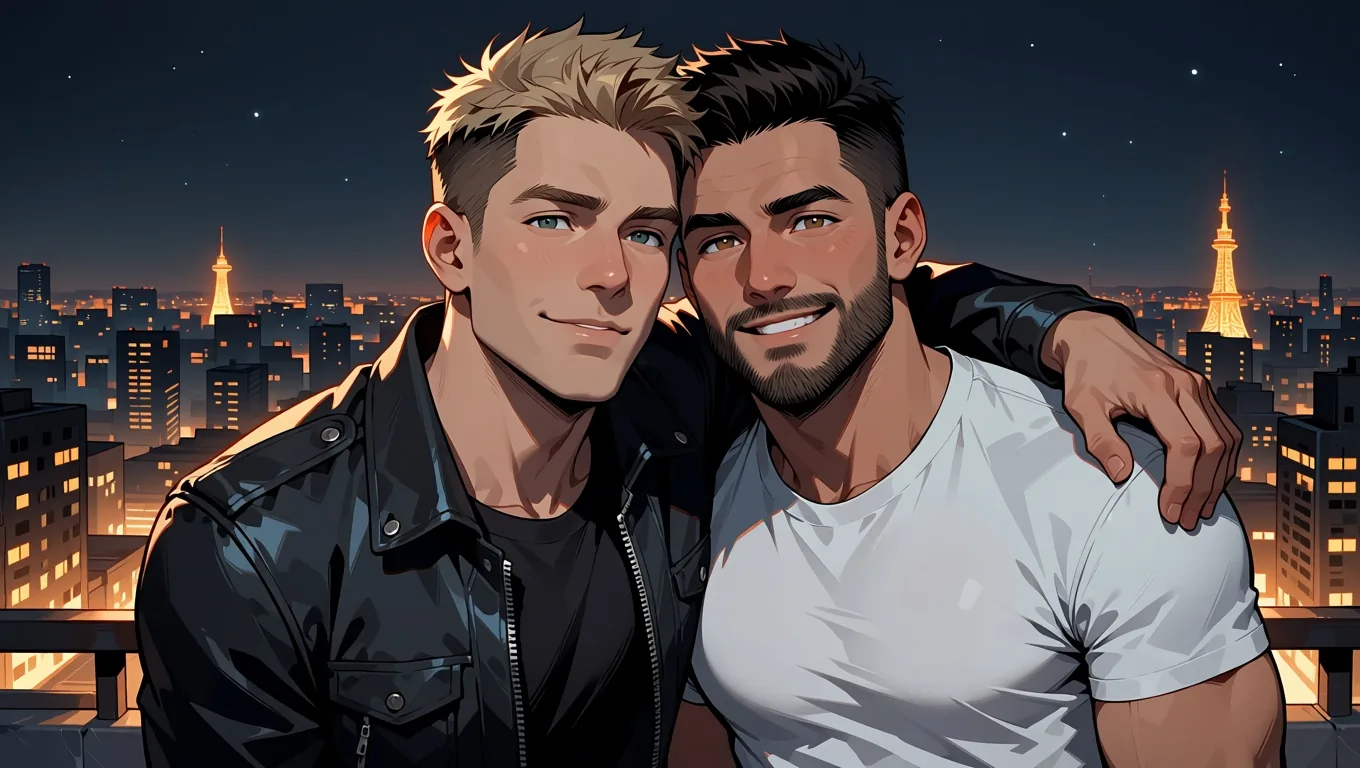
Dos hombres adultos en una azotea de noche, 2boys, sensitive.
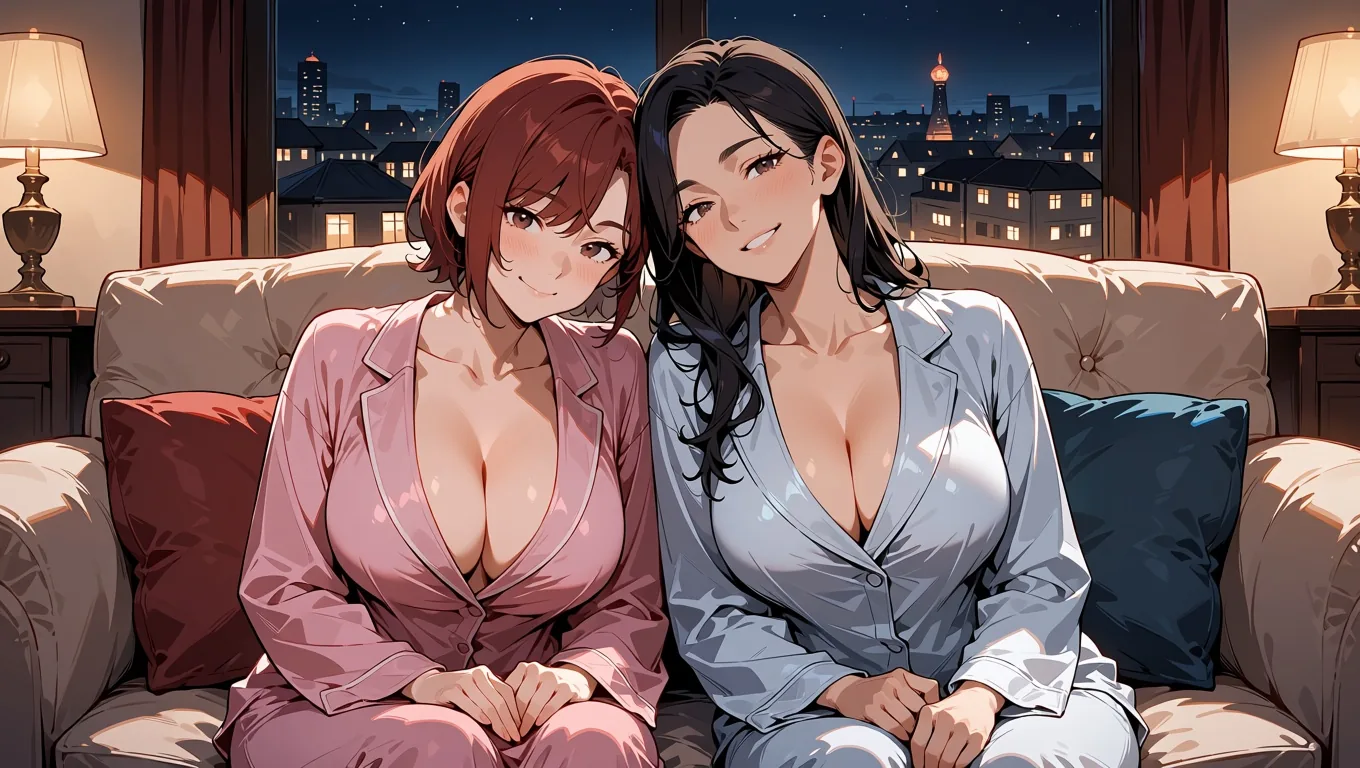
Dos mujeres adultas con pijamas de seda en un sofá, 2girls, sensitive.
Notamos dos cosas. Primero, el modelo interpreta mature male y mature female como una instrucción sobre los rostros, así que conserva esas palabras; además dejan claro en el prompt que todos los personajes son adultos. Segundo, las escenas con un solo personaje son las más fiables. Para un solo hombre adulto sirve la misma receta: una camisa blanca desabotonada en el marco de la puerta de un dormitorio con luz de la mañana salió como se pedía con el primer seed, y una mujer en bata de baño que se resbala de un hombro junto a una ventana al amanecer también.
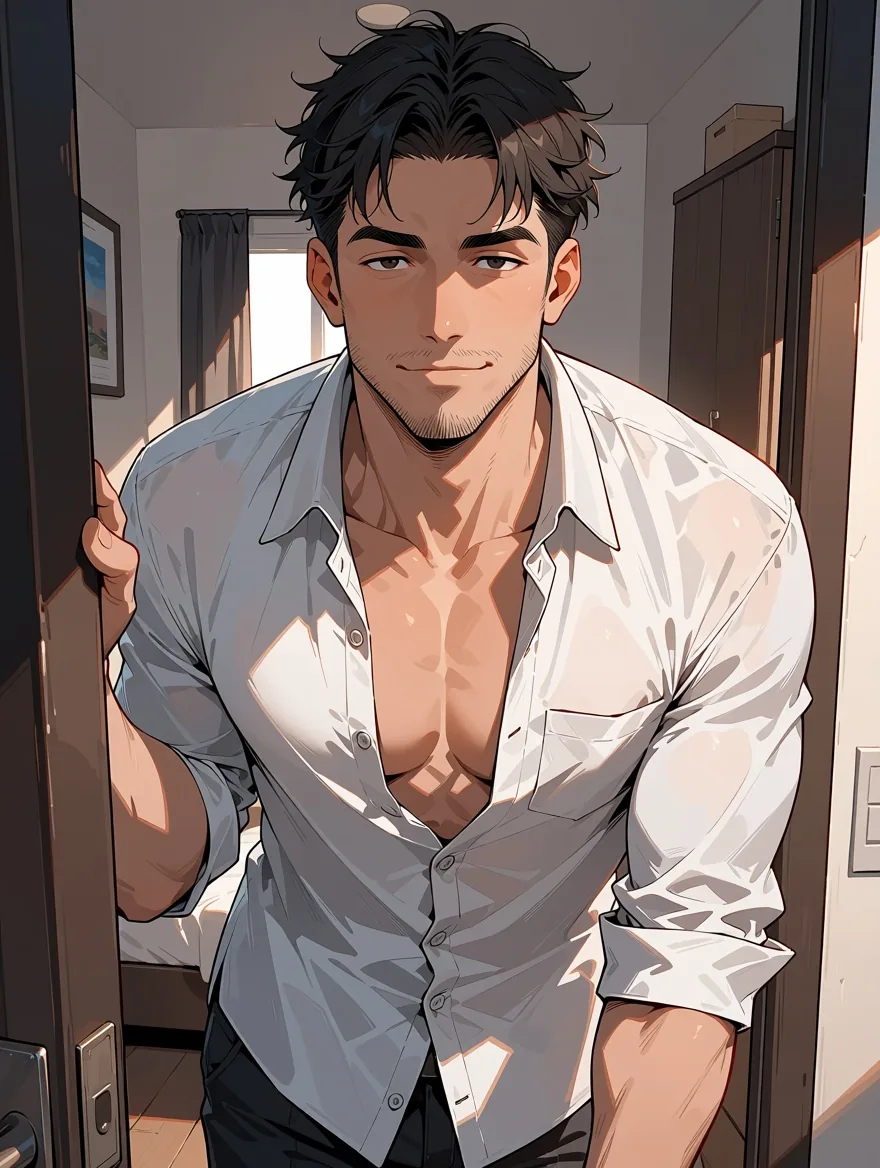
Hombre adulto en solitario, 3:4, sensitive.
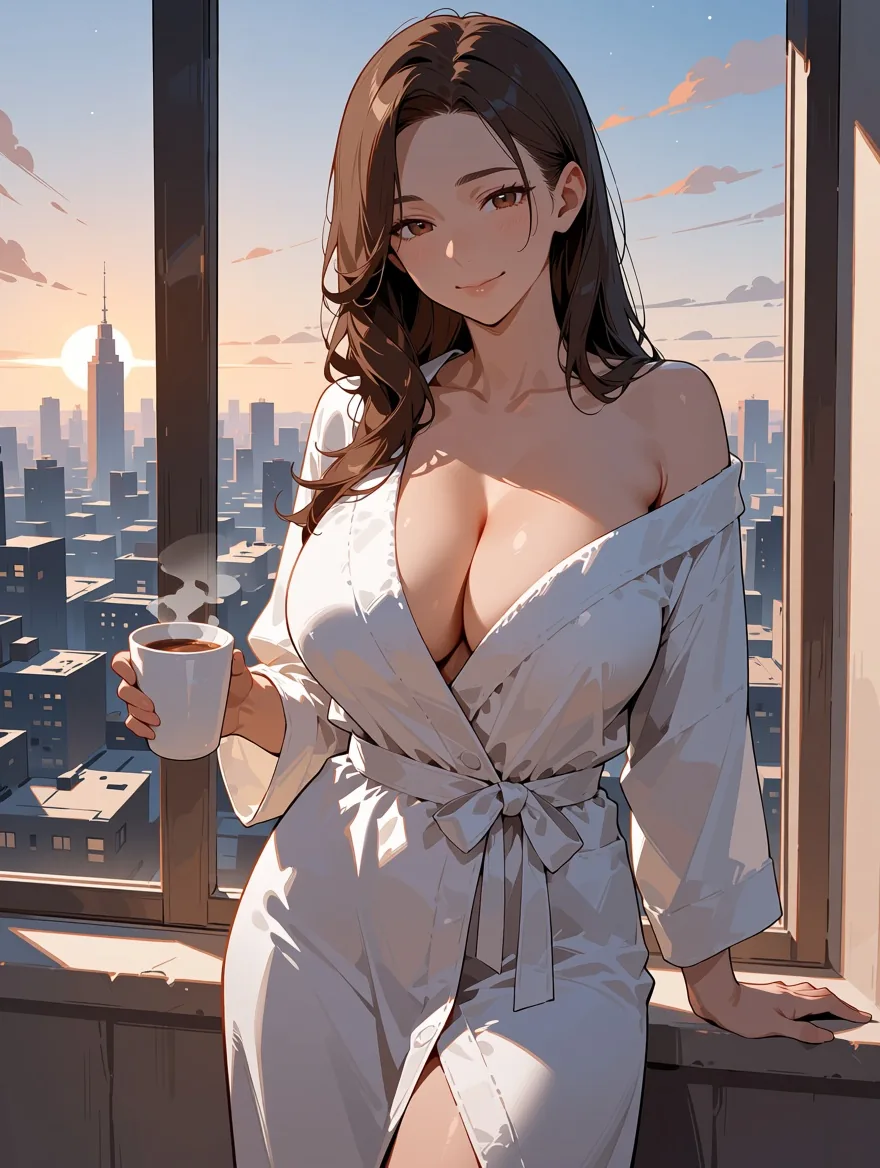
Mujer adulta en solitario, 3:4, sensitive.
¿Cuáles son los límites?
Es un modelo anime: sin fotorrealismo, con la costumbre de dibujar garabatos parecidos a firmas y los problemas habituales con las manos. En nuestras pruebas:
- Sin fotorrealismo. El modelo base se entrenó con datos de anime e ilustración; el editor menciona varios millones de imágenes de anime y unas 800,000 imágenes artísticas más. No produce fotografías. Para contenido adulto esto tiene un efecto secundario útil: los resultados se leen como ilustración y nunca como fotografías de personas reales.
- La manía de la firma. A veces el modelo dibuja en una esquina un garabato parecido a una firma o una línea de pseudotexto, un hábito aprendido de las ilustraciones. Lo vimos en aproximadamente una imagen de cada cinco. No hay prompt negativo para suprimirlo, así que cambia el seed o recorta la esquina.
- Manos y anatomía. Que no haya rechazos no significa que no haya fallos. Las manos y la anatomía necesitan nuevos intentos, como en cualquier modelo de imagen.
- Texto. Solo dibuja una o dos palabras de texto.
- La imagen a imagen cambia el estilo; no sigue instrucciones de edición. Con una foto como origen, una strength de 0.6 ya se lee como una ilustración con los mismos detalles, y 0.75 da un anime limpio con la misma composición. Pedirle a una ilustración existente un atuendo nuevo o pasar de día a noche cambió muy poco con 0.6 a 0.8. La strength se explica en De foto a anime con Anima Turbo: cómo elegir la strength. La página de imagen a imagen conserva la forma del origen, ya que no tiene un campo de relación de aspecto.
- Controles que faltan. No hay prompt negativo, pasos, CFG, sampler, formato de salida (siempre JPEG), máscaras ni varias imágenes por solicitud.
¿Qué familia de Anima conviene elegir?
Empieza con Anima Turbo; pasa a la familia LoRA cuando quieras un estilo que el modelo base no ofrece. Ambos niveles cuestan lo mismo por nivel de resolución, la imagen a imagen cuesta lo mismo que el texto a imagen y la relación de aspecto no cambia el precio. Los precios vigentes están en las páginas de los modelos, y las solicitudes fallidas no se cobran.
| Lo que quieres | Elige | Por qué |
|---|---|---|
| Anime limpio a partir de etiquetas o frases, de texto a imagen o de imagen a imagen | Anima Turbo | El arranque más rápido; L3 y L4 se generaron en nuestras pruebas |
| Un aspecto específico (PC-98, tinta de manga) o tu propio LoRA apto para adultos | Anima Turbo LoRA | Hasta 3 LoRAs con una scale de 0 a 4; L3 y L4 se generaron |
| Un checkpoint de anime de la comunidad de la línea Pony XL, solo texto a imagen | Prefect Pony XL | Siete tamaños nativos de SDXL; tres niveles de prueba hasta L4 se generaron en nuestra ejecución interna del 18 de septiembre de 2026 |
| Una base fotorrealista que pasa a anime con un LoRA de anime | Z-Image Turbo LoRA | Fotorrealista por defecto; L3 y L4 se generaron en texto a imagen |
Elección de nivel: 1k son alrededor de un megapíxel y 1.5k alrededor de 2.4 megapíxeles, generados de forma nativa y no escalados. En nuestra prueba de velocidad de 60 ejecuciones el tiempo del modelo fue de 2 a 16 segundos por imagen, y 52 de 60 tardaron menos de diez segundos, así que volver a intentarlo sale barato. La página de texto a imagen tiene las 15 relaciones de aspecto. Para una mirada más amplia a la redacción de prompts y a los estilos de anime para adultos, consulta la Guía de estilos de imágenes anime con IA para adultos.
Uso responsable
Eres responsable de lo que generas y publicas. Haz que todos los personajes sean adultos y dilo en el prompt (adult woman, mature male, "en sus treinta"). No uses personas reales ni su imagen sin consentimiento. Mantén tus resultados en privado a menos que estés seguro de que puedes compartirlos, y respeta las reglas de cualquier sitio donde publiques. La plataforma no revisa tu contenido y no escribe prompts para adultos por ti; los ejemplos de esta guía tienen ropa a propósito. Si una solicitud no es apropiada para tu situación, no la hagas.
Preguntas frecuentes
¿Anima Turbo realmente no tiene censura?
Sí. En SpicyAPI no hay ningún filtro de contenido delante del modelo y, en nuestras pruebas de 25 solicitudes repartidas en cuatro niveles, vimos cero rechazos y cero sustituciones, con y sin LoRAs y en imagen a imagen. Que no haya rechazos no significa que cada imagen salga perfecta; la anatomía y las manos siguen necesitando nuevos intentos.
¿Importa la etiqueta de clasificación nsfw?
Sí, cambia el tono. Anima conoce safe, sensitive, nsfw y una etiqueta más fuerte, y el editor describe nsfw y la etiqueta más fuerte como las que quitan la contención. Con una descripción de personaje vestido encontramos safe y sensitive casi idénticas, así que elige la etiqueta que corresponda al ambiente que quieres.
¿Las imágenes se verán como personas reales?
No. El modelo base no hace fotorrealismo, así que todos los resultados se leen como ilustración y no como fotografía. Eso no vuelve aceptable el parecido con personas reales: no lo pidas en el prompt sin consentimiento.
¿Puedo mantener al mismo personaje en varias imágenes?
En su mayor parte. Reutiliza el bloque del personaje palabra por palabra, fija el seed y cambia solo la ropa y el lugar. El personaje de cabello plateado de nuestro conjunto de tres escenas se mantuvo reconocible, aunque el estilo de dibujo varió un poco. Un seed fijo no garantiza píxeles idénticos.
¿Funcionan los LoRAs para adultos y hay un cargo adicional?
Sí a ambas. La familia LoRA acepta hasta tres LoRAs entrenados para Anima, y cargarlos no suma ningún cargo aparte. Un LoRA entrenado para otro modelo base se carga sin error y no cambia nada. Mantén la scale entre 0.5 y 1.2 aproximadamente; con 4 la imagen se deshizo.
¿Puedo convertir mi propia ilustración o foto en algo más fuerte?
La imagen a imagen cambia el estilo; no sigue instrucciones de edición. Con una imagen de origen con ropa, pedir L3 o L4 con una strength de 0.8 a 0.9 se cumplió en nuestras pruebas. Una foto con 0.75 se convierte en anime limpio con la misma composición, y con 1.0 se ignora el origen.
¿Por qué algunas imágenes tienen un garabato en la esquina?
El modelo aprendió de las ilustraciones el hábito de dibujar un garabato parecido a una firma o una línea de pseudotexto. Lo vimos en aproximadamente una imagen de cada cinco. No hay prompt negativo, así que cambia el seed o recorta la esquina.