Anima Turbo, tekst na obraz, 16:9 na poziomie 1.5k. Tag oceny to sensitive; prompt opisuje ubraną dorosłą osobę w pokoju hotelowym.
Krótko: tak, Anima Turbo jest bez cenzury. W SpicyAPI nie stoi przed nim żaden filtr treści, a w naszych testach, 25 zapytań na czterech poziomach, od zmysłowej bielizny po intymną scenę między dwiema dorosłymi osobami, nie dostaliśmy ani jednej odmowy ani jednego podstawienia. Obraz na obraz i LoRA przyjazne treściom dla dorosłych zachowywały się tak samo. Czego model nie zrobi, to fotorealizm, a przy tego rodzaju pracy to zaleta: wszystko, co rysuje, wygląda jak ilustracja.
Ten poradnik opisuje, co testowaliśmy, jak tagi ocen zmieniają ton, jak utrzymać rozpoznawalność jednej dorosłej postaci w kolejnych scenach, jak dodać styl przez LoRA, jak pisać sceny dla par i gdzie model nadal zawodzi. Każdy przykładowy prompt to scena z ubranymi osobami, co najwyżej zmysłowa; platforma nie pisze ani nie publikuje promptów do scen dla dorosłych i nie będą ci potrzebne, żeby wszystko powtórzyć.
W skrócie
| Pytanie | Odpowiedź z naszych testów (5 października 2026) |
|---|---|
| Czy odmawia? | Nie. 25 zapytań, zero odmów, zero podstawień |
| Sprawdzone poziomy | L1 do L4 (L5 na Anima nie uruchamialiśmy) |
| Dodatkowo testowane | Obraz na obraz, z LoRA i bez, postaci żeńskie i męskie, dwa ziarna (seed) dla najwyższych poziomów, poziomy 1k i 1.5k |
| Sterowanie tonem | Tagi ocen: safe, sensitive, nsfw i jeden mocniejszy tag |
| Styl | Tylko anime i ilustracja; bez fotorealizmu |
| Własne style | Do 3 LoRA w rodzinie LoRA |
| Typowa szybkość | 2 do 16 sekund na obraz w naszym teście 60 przebiegów |
| Niedostępne | Prompt negatywny, kroki, CFG, maski, kilka obrazów w jednym zapytaniu |
Czy Anima Turbo jest bez cenzury?
Tak: w naszych testach nic nie zostało odrzucone, rozmyte ani złagodzone. Model przeprowadziliśmy przez naszą drabinę treści, która używa neutralnych nazw poziomów:
| Poziom | Co oznacza | Wynik Anima |
|---|---|---|
| L1 Sugestywny | Bielizna, ramiączko zsuwające się z ramienia | Narysowane zgodnie z opisem |
| L2 Częściowy | Częściowo odsłaniający look | Narysowane zgodnie z opisem |
| L3 Mocny | Znacznie bardziej odważny look | Narysowane zgodnie z opisem |
| L4 Intensywny | Intymna scena między dwiema dorosłymi osobami | Narysowane zgodnie z opisem za pierwszym razem |
| L5 Ekstremalny | Dobrowolne unieruchomienie między dorosłymi albo filmowy gore | Nie uruchamialiśmy na Anima |
Te 25 zapytań mieszało tekst na obraz i obraz na obraz, z LoRA i bez, postaci żeńskie i męskie, po dwa ziarna dla L3 i L4 oraz oba poziomy rozdzielczości. Przebiegi obraz na obraz startowały od ubranego obrazu źródłowego, a gdy prosiliśmy o L3 lub L4 przy strength 0.8 do 0.9, model to wykonywał. Osobna seria 60 przebiegów z różnymi proporcjami obrazu używała promptu na poziomie L2 i wszystkie 60 się udało. Nie zauważyliśmy żadnej flagi treści, rozmycia ani złagodzenia.
„Bez odmów” nie znaczy „każdy obraz jest idealny”. Anatomia i dłonie nadal wymagają ponownych losowań ziarna, jak w każdym modelu obrazów, a o tym piszemy w sekcji o limitach.
Jak tę samą drabinę przeszły inne modele
Dla porównania uruchomiliśmy tę samą drabinę na dwóch modelach obrazów ogólnego przeznaczenia przez zewnętrzne hostowane API: FLUX 3 (tekst na obraz) i Ideogram v4.5. Oba narysowały scenę na plaży w bikini i neutralne zdjęcie bielizny do katalogu. FLUX 3 odmówił 10 z 12 zapytań, a Ideogram 11 z 13, w tym klasycznego obrazu ze studium postaci i eufemistycznego promptu bez oznaczonych słów. Odmowy wracały po około dwóch sekundach, zanim powstał jakikolwiek obraz, z komunikatem „Content flagged as potentially sensitive. Please try different prompts or images.” Odrzuconych zapytań nie rozliczano. Ponieważ odrzucony został także prompt eufemistyczny, filtr wygląda na semantyczny, a nie na listę słów kluczowych. Nie wiemy, czy ten filtr należy do własnych API twórców modeli, czy do hosta, więc czytaj to jako informację o tych trasach, a nie o samych modelach.
Jak tagi ocen sterują tonem?
Tagi ocen ustawiają, ile powściągliwości stosuje model, a przy opisie ubranej postaci safe i sensitive dają niemal ten sam obraz. Anima zna safe, sensitive i nsfw, a wydawca, CircleStone Labs, opisuje jeszcze jeden, mocniejszy tag. Według wydawcy nsfw i ten mocniejszy tag to te, które znoszą powściągliwość. Ponieważ nie ma promptu negatywnego, tag oceny jest głównym sposobem ustawienia tonu, więc warto wybierać go świadomie.
Pierwsze dwa przetestowaliśmy na jednym prompcie z lounge'a (dorosła kobieta w czarnej sukni wieczorowej na cienkich ramiączkach w hotelowym barze) i jednym ziarnie, zmieniając wyłącznie tag.
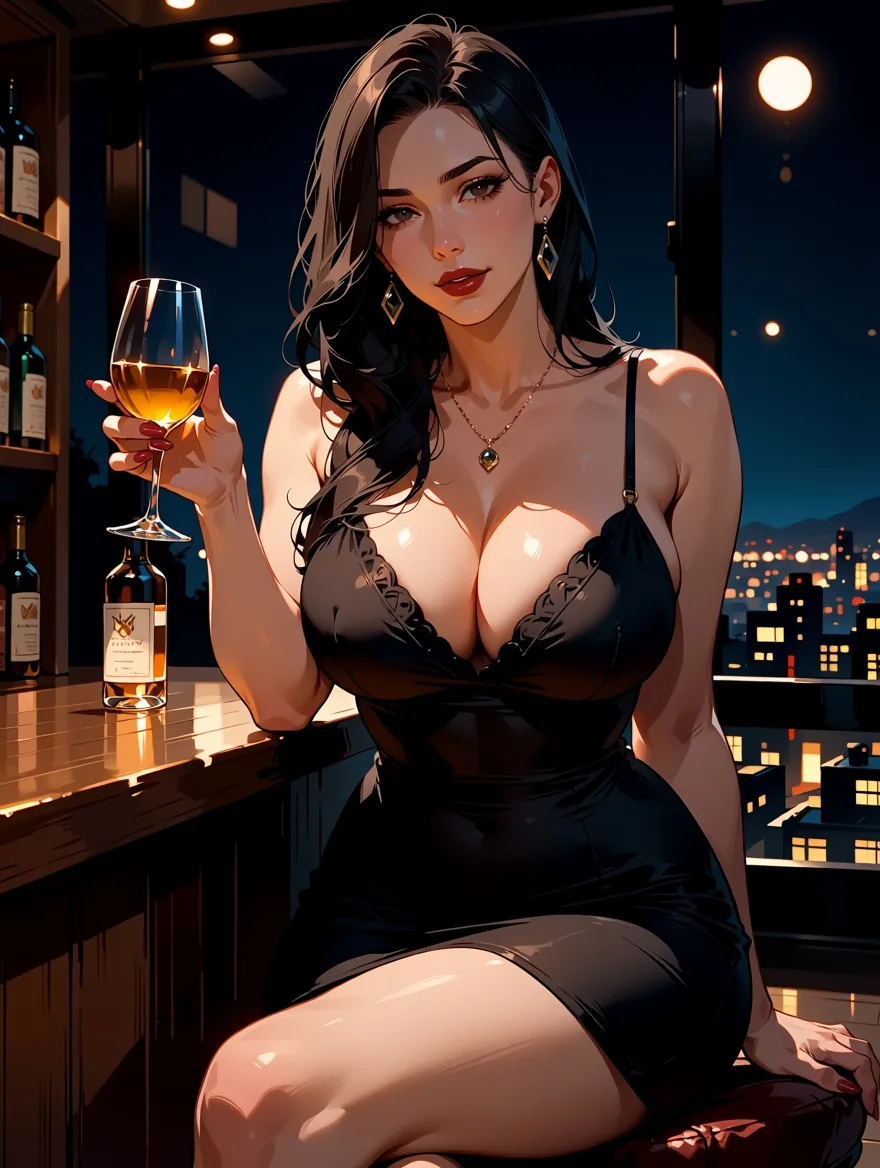
Ten sam prompt i to samo ziarno, safe.
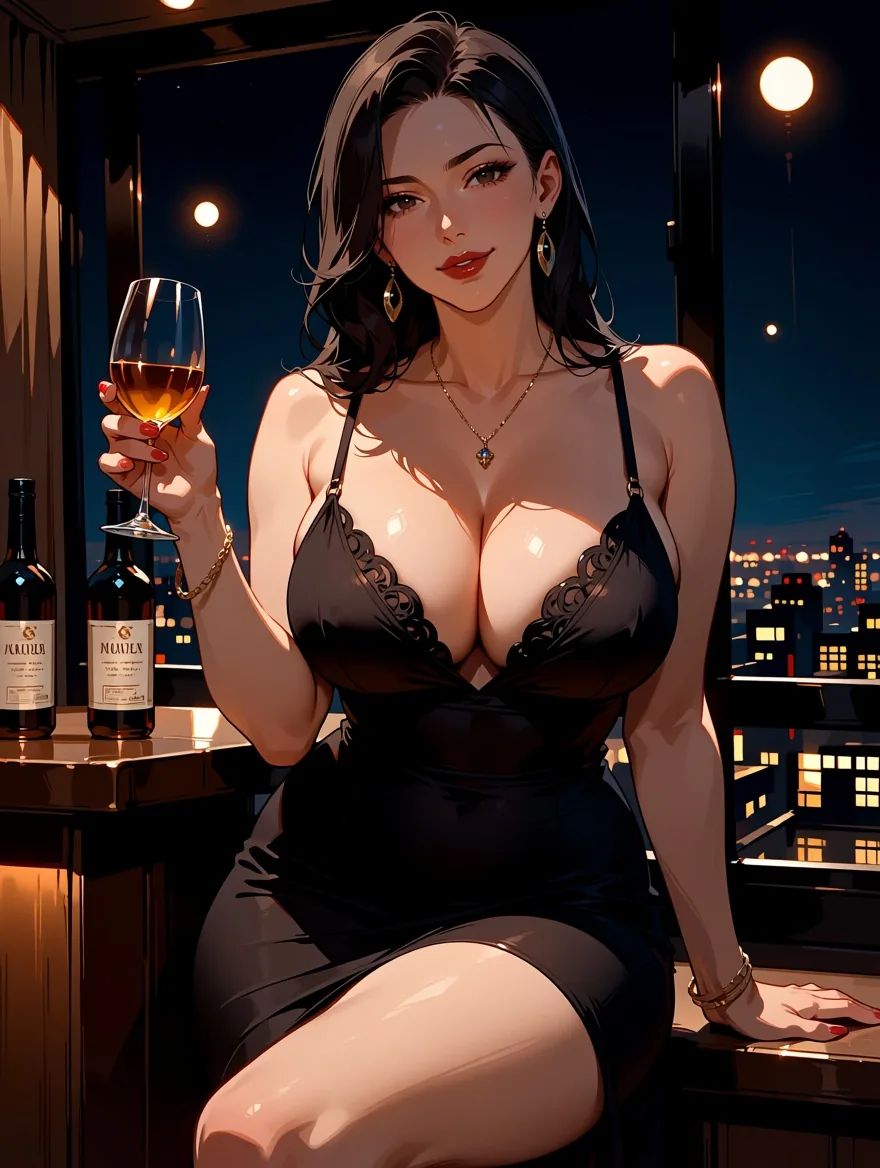
Ten sam prompt i to samo ziarno, sensitive.
Kompozycja, poza i nastrój się zgadzają; zmieniły się drobne szczegóły, takie jak biżuteria i butelki. Traktuj safe i sensitive jako lekkie wskazanie dla scen z ubranymi postaciami, a większej zmiany oczekuj po mocniejszych tagach. Nie publikujemy żadnego promptu, który ich używa, i dokumentacja platformy też tego nie robi; są do dyspozycji, jeśli zdecydujesz się z nich skorzystać, a sekcja o odpowiedzialnym użyciu poniżej dotyczy każdego z nich.
Kilka konwencji tagów od wydawcy, które pomagają w każdej scenie: pisz tagi małymi literami, ze spacjami zamiast podkreślników, zacznij od tagów jakości i oceny, potem liczba postaci (1girl, 1boy), potem postać, seria, artysta i tagi ogólne. Dobry początek to masterpiece, best quality, ewentualnie score_7. W naszych testach działały też pełne zdania i mieszanki tagów ze zdaniami; wydawca zaleca co najmniej dwa zdania, gdy piszesz językiem naturalnym. Nasze szersze testy promptów są w artykule Test Anima Turbo: tagi, zdania i tagi stylu.
Jak utrzymać spójność jednej dorosłej postaci w kolejnych scenach?
Ustaw stałe ziarno, zachowaj opis postaci słowo w słowo i zmieniaj tylko strój oraz miejsce. Nie ma obrazu referencyjnego ani blokady postaci, więc spójność bierze się z promptu. Jedną dorosłą postać zapisaliśmy jako blok tagów i użyliśmy go trzy razy:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye,
black turtleneck, standing in an art gallery, looking at viewer
W drugiej i trzeciej scenie zostawiliśmy wszystko do beauty mark under the left eye, zmieniliśmy tag oceny na sensitive i zmieniliśmy tylko ubrania i miejsce: czerwoną jedwabną sukienkę-halkę na nocnym balkonie, a potem za dużą białą koszulę na parapecie rano. Wszystkie trzy użyły ziarna 31 na poziomie 1k w proporcji 3:4.
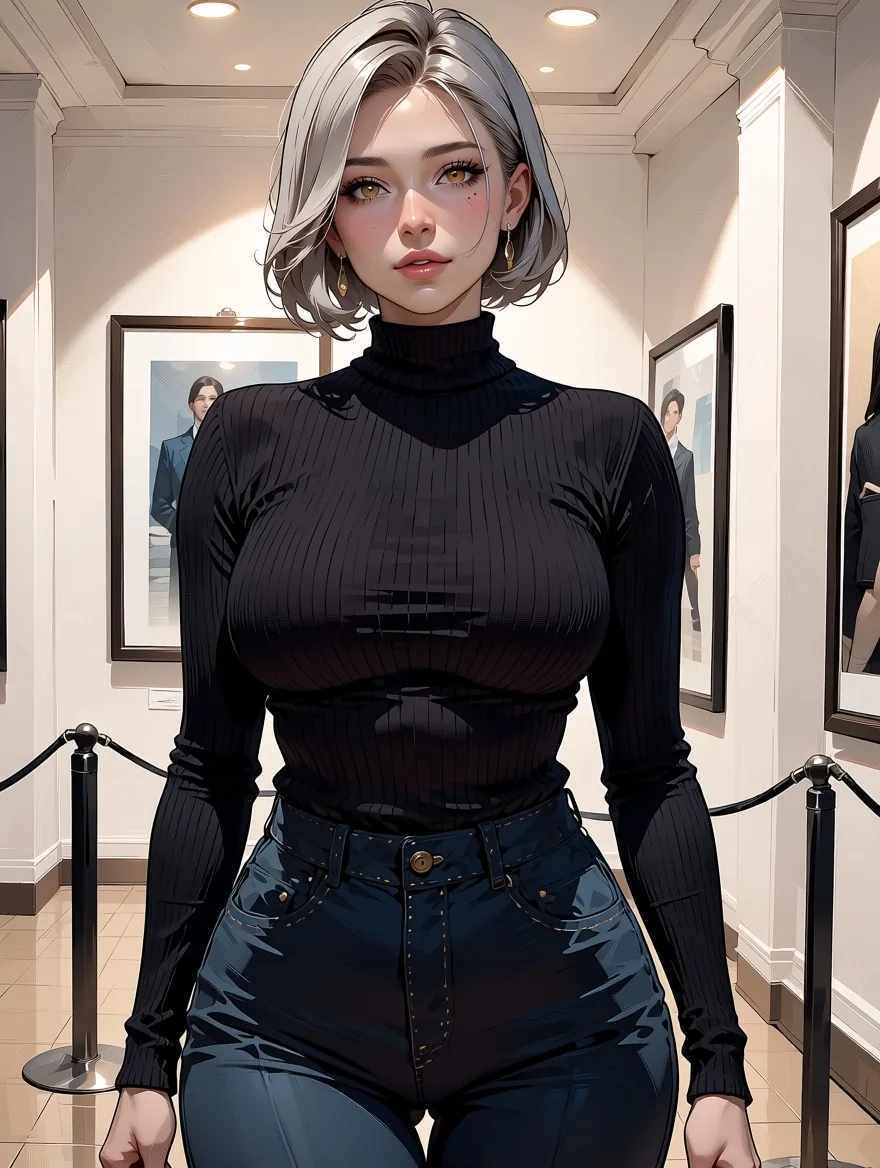
Scena 1: golf, galeria.
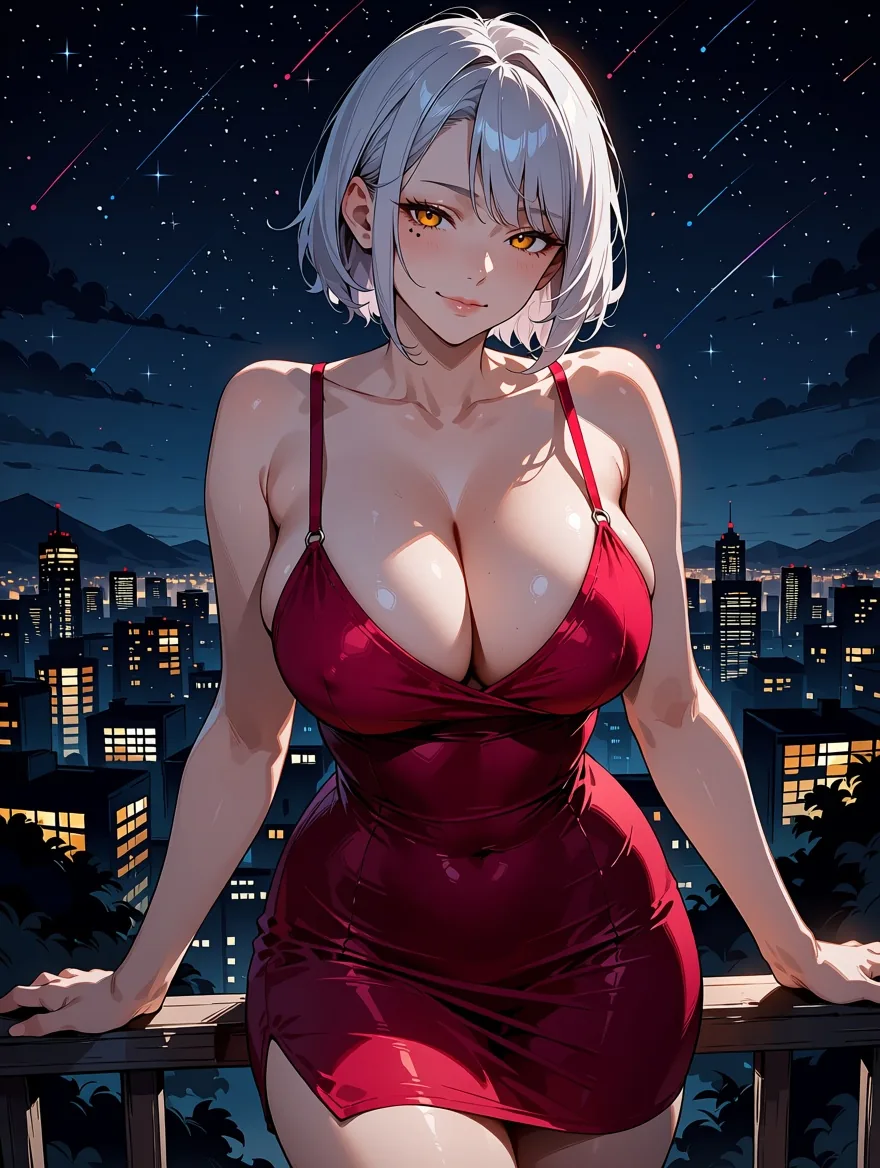
Scena 2: czerwona sukienka-halka, balkon.
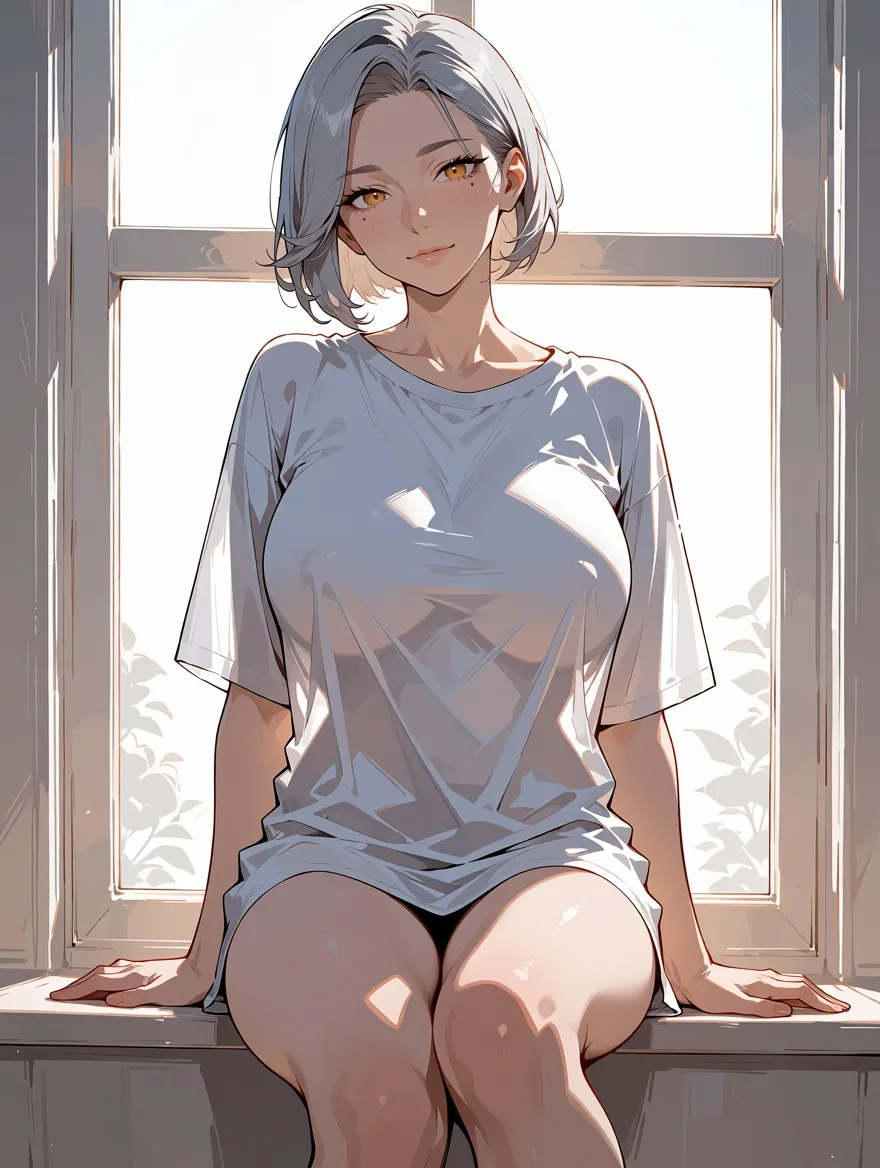
Scena 3: za duża biała koszula, parapet.
Srebrny bob, złote oczy i pieprzyk przeszły przez wszystkie trzy sceny, a twarz pozostaje rozpoznawalnie tą samą postacią. Styl rysunku trochę dryfuje między scenami (obraz z galerii jest bardziej malarski niż pozostałe dwa), co jest normalnym kosztem zmiany całej sceny przy stałym ziarnie. Dwa nawyki poprawiają ten efekt:
- Opisuj postać konkretnymi, policzalnymi cechami: długość i kolor włosów, kolor oczu, jeden charakterystyczny znak. Mgliste słowa („ładna”, „elegancka”) nic nie dodają do rozpoznawalności.
- Zmieniaj jedną rzecz naraz, gdy chcesz porównywać. Jeśli zmieniają się strój, miejsce i oświetlenie jednocześnie, nie dowiesz się, co zepsuło podobieństwo.
Stałe ziarno sprawia, że przebiegi są porównywalne, ale nie gwarantuje identycznych pikseli: to samo zapytanie z tym samym ziarnem dawało nam w różnych momentach nieco inne obrazy. Zaplanuj wybór najlepszego z kilku podejść.
Jak dodać styl przez LoRA przyjazne treściom dla dorosłych?
Użyj rodziny LoRA, wklej bezpośredni link do pliku .safetensors i trzymaj scale mniej więcej między 0.5 a 1.2. Strona Anima Turbo LoRA przyjmuje do trzech LoRA na zapytanie, każdą jako parę {path, scale}. Wczytanie LoRA nie wiąże się z osobną opłatą, a platforma nie dodaje do nich żadnego filtra. Hugging Face wymieniał 5 października 2026 roku 129 adapterów LoRA dla Anima. LoRA wytrenowana pod inny model bazowy wczytuje się bez błędu i niczego nie zmienia, więc sprawdź, czy wybrana została wytrenowana pod Anima.
Użyliśmy dwóch publicznych LoRA. Pierwsza to wygląd gier z ery PC-98, Melon-Bread/anima-pc98-gal-style-v0.2, ze słowem wyzwalającym pc98gal_style.
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework,
sensitive, 1girl, solo, adult woman, mature female, long purple hair, black slip dress,
leaning on a balcony at night, city lights, sultry smile, looking at viewer,
retro anime aesthetic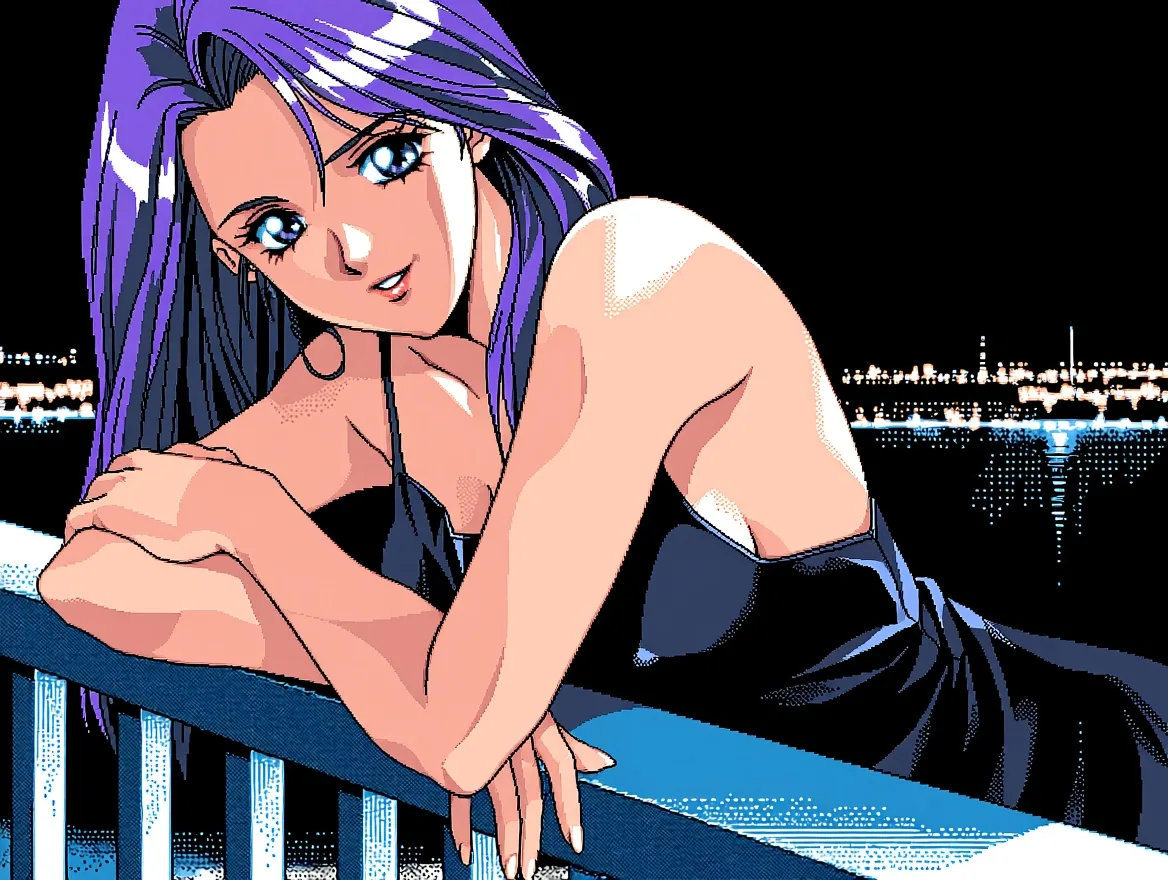
Anima Turbo LoRA, LoRA PC-98 przy scale 1, 4:3, poziom 1k.
Druga to wygląd mangowego tuszu, notverriegod/monochrome-grayscale_style. W prompcie potrzebowała monochrome, greyscale: bez tych słów nasz przebieg pozostał kolorowy. Tutaj dorosła kobieta w kimonie siedzi przy papierowej latarni, a tagiem oceny jest sensitive.
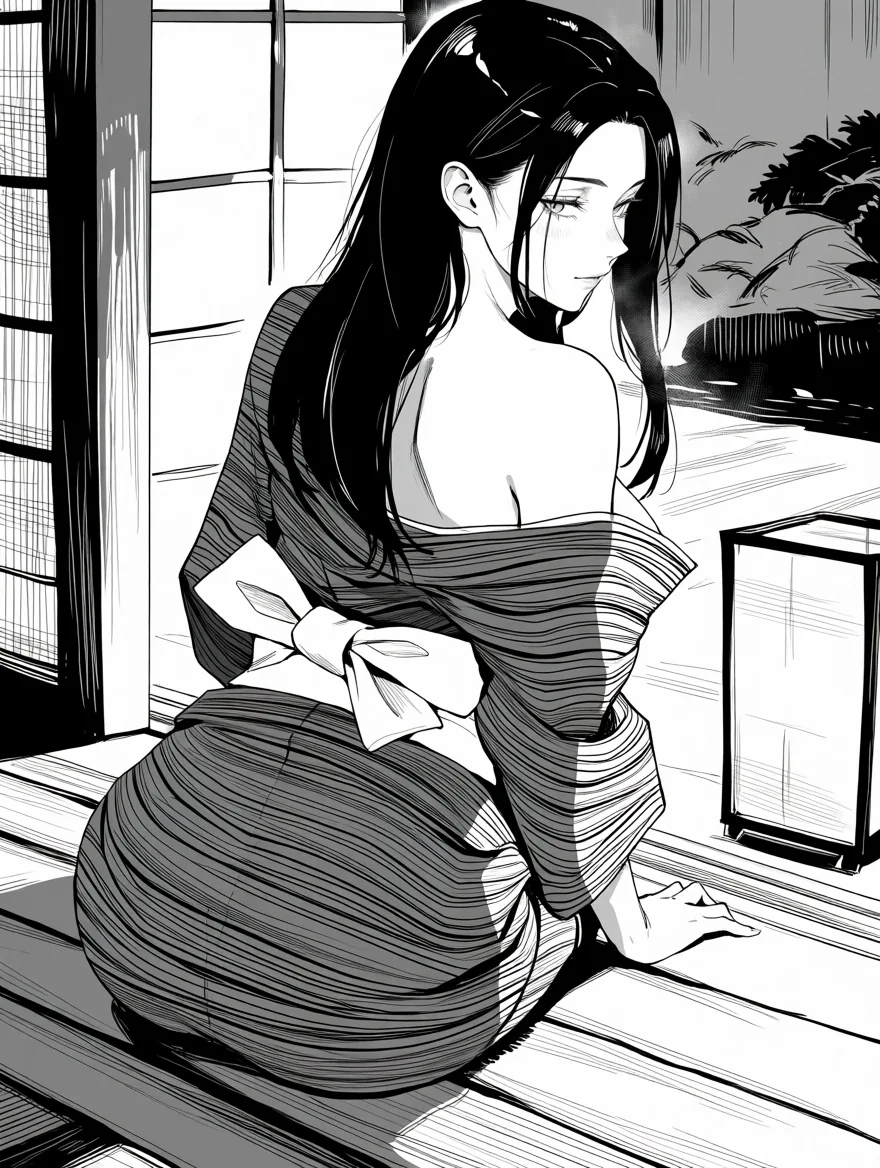
Anima Turbo LoRA, LoRA monochromatyczna przy scale 1, 3:4, poziom 1k.
Co warto wiedzieć o scale, z naszej drabiny wartości: 0 jest identyczne z brakiem LoRA, 0.5 to lekkie muśnięcie, 1 to pełny styl, 1.5 mocniej wypycha styl, a 4 rozbiło obraz na abstrakcyjne kształty. Trzy LoRA ułożone przy wartościach 1, 0.6 i 0.25 zadziałały, a główny styl nadal wyraźnie było widać; więcej niż trzy jest odrzucane. Pierwsze zapytanie z nową LoRA może trwać dłużej, gdy plik jest pobierany (jedno nasze trwało prawie trzy minuty). Jeśli link jest zablokowany (wymaga logowania), zapytanie kończy się komunikatem HTTP 401, a jeśli wkleisz stronę repozytorium zamiast pliku, zostaniesz poproszony o bezpośredni link do pobrania; żadne z tych zapytań nie jest rozliczane. Więcej o łączeniu LoRA i słowach wyzwalających znajdziesz w artykule Anima Turbo LoRA: style, scale i łączenie.
Czy można pisać zmysłowe sceny dla par?
Tak: opisz obie postacie jako dorosłe, nastrój ustaw światłem i postawą, a resztę zostaw tagowi oceny. Wolny taniec w jazzowym barze to dobry wzór:
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood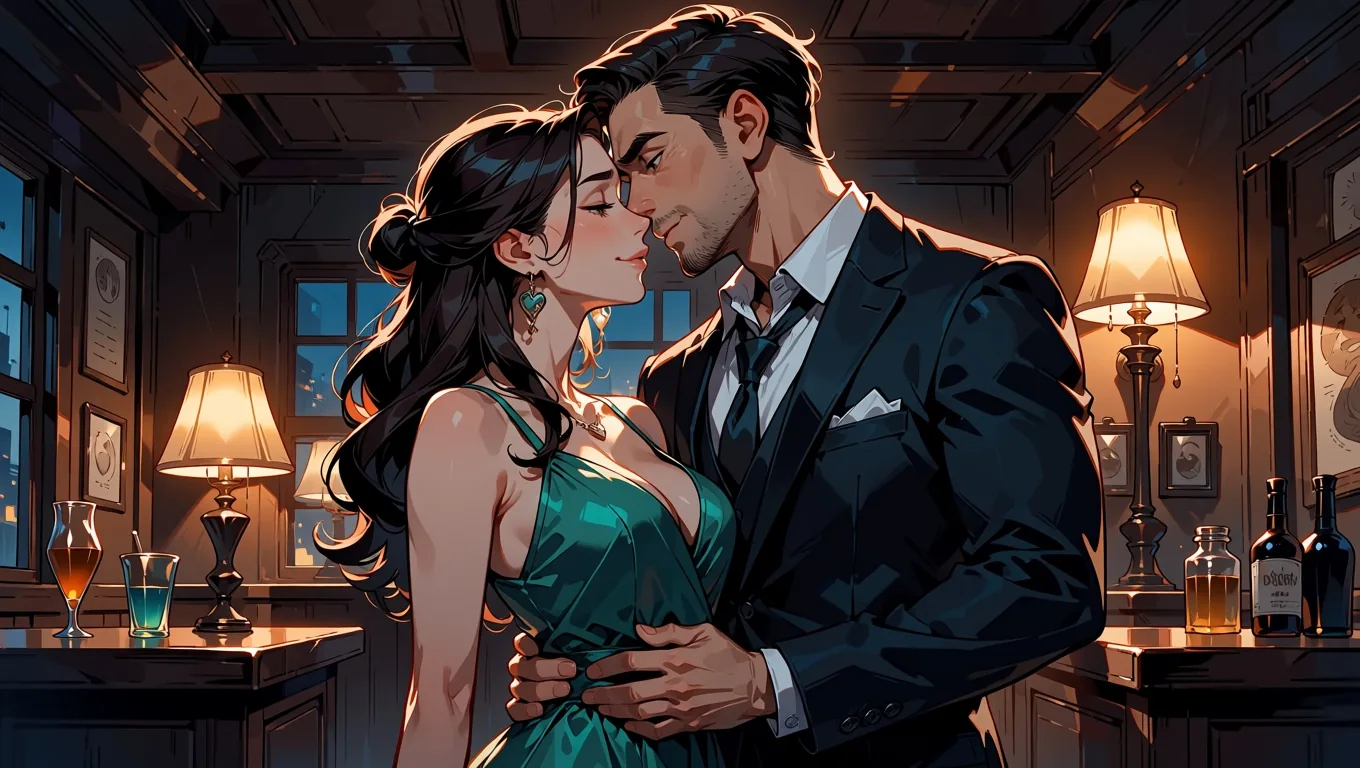
Anima Turbo, 16:9, poziom 1k, sensitive.
Model dobrze trzyma się tagów grupowych (1girl, 1boy, 2boys, 2girls). Uruchomiliśmy też jeszcze dwie pary, dwóch mężczyzn i dwie kobiety, w tej samej strukturze z 2boys i 2girls oraz tagami dorosłości dla każdej osoby.
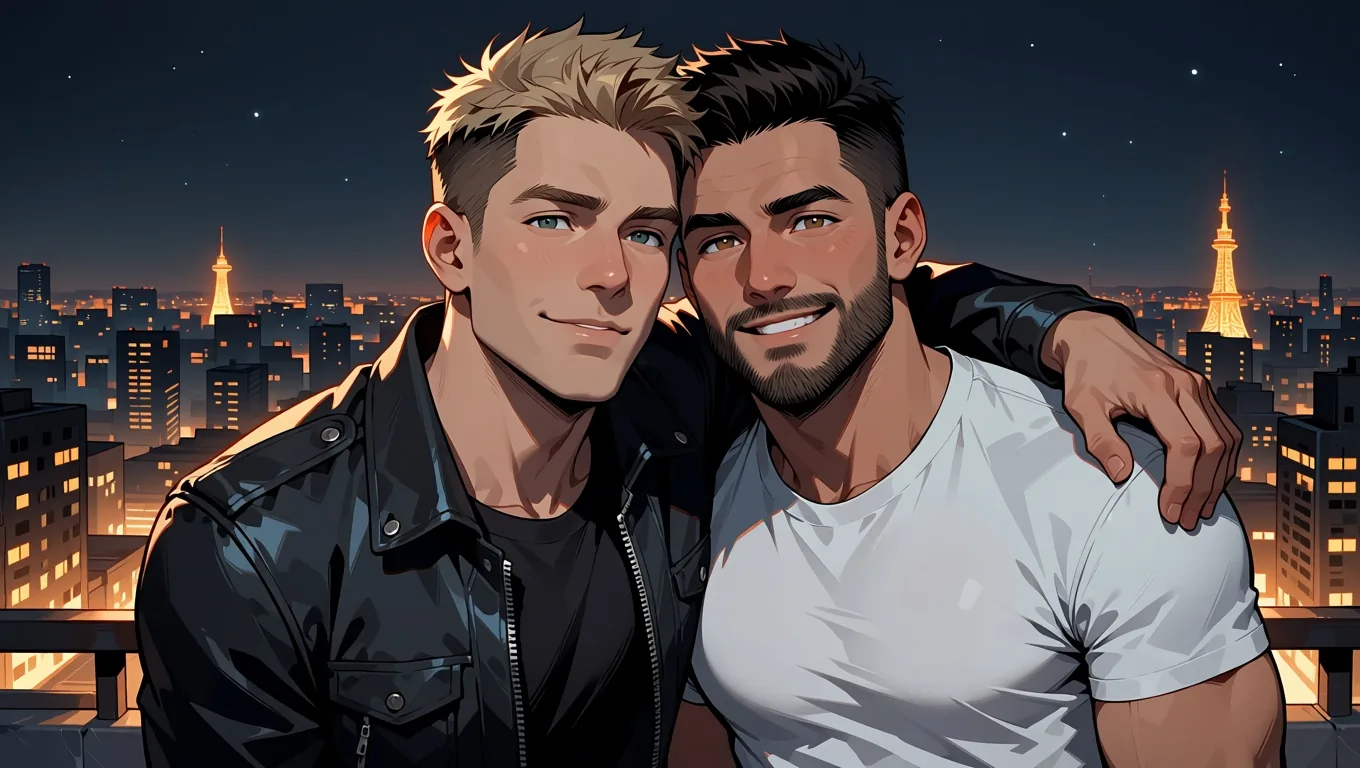
Dwóch dorosłych mężczyzn na dachu nocą, 2boys, sensitive.
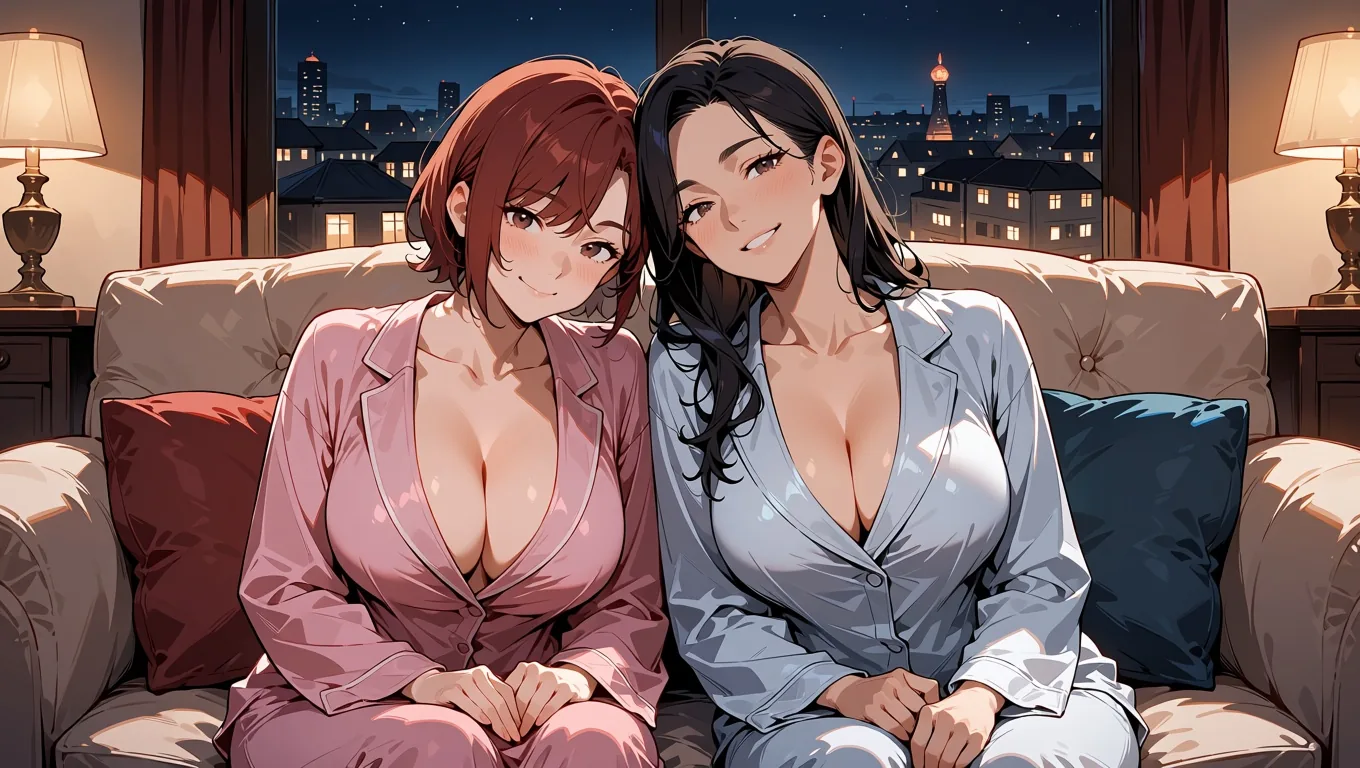
Dwie dorosłe kobiety na sofie w jedwabnych piżamach, 2girls, sensitive.
Dwie rzeczy, które zauważyliśmy. Po pierwsze, model czyta mature male i mature female jako wskazówkę dotyczącą twarzy, więc zostaw te słowa; w prompcie jasno mówią też, że każda postać jest dorosła. Po drugie, najpewniejsze są sceny solo. Dla jednego dorosłego mężczyzny ten sam przepis działa: rozpięta biała koszula w drzwiach sypialni w porannym świetle wyszła zgodnie z zamierzeniem już na pierwszym ziarnie, podobnie jak kobieta w szlafroku zsuwającym się z jednego ramienia przy oknie o świcie.
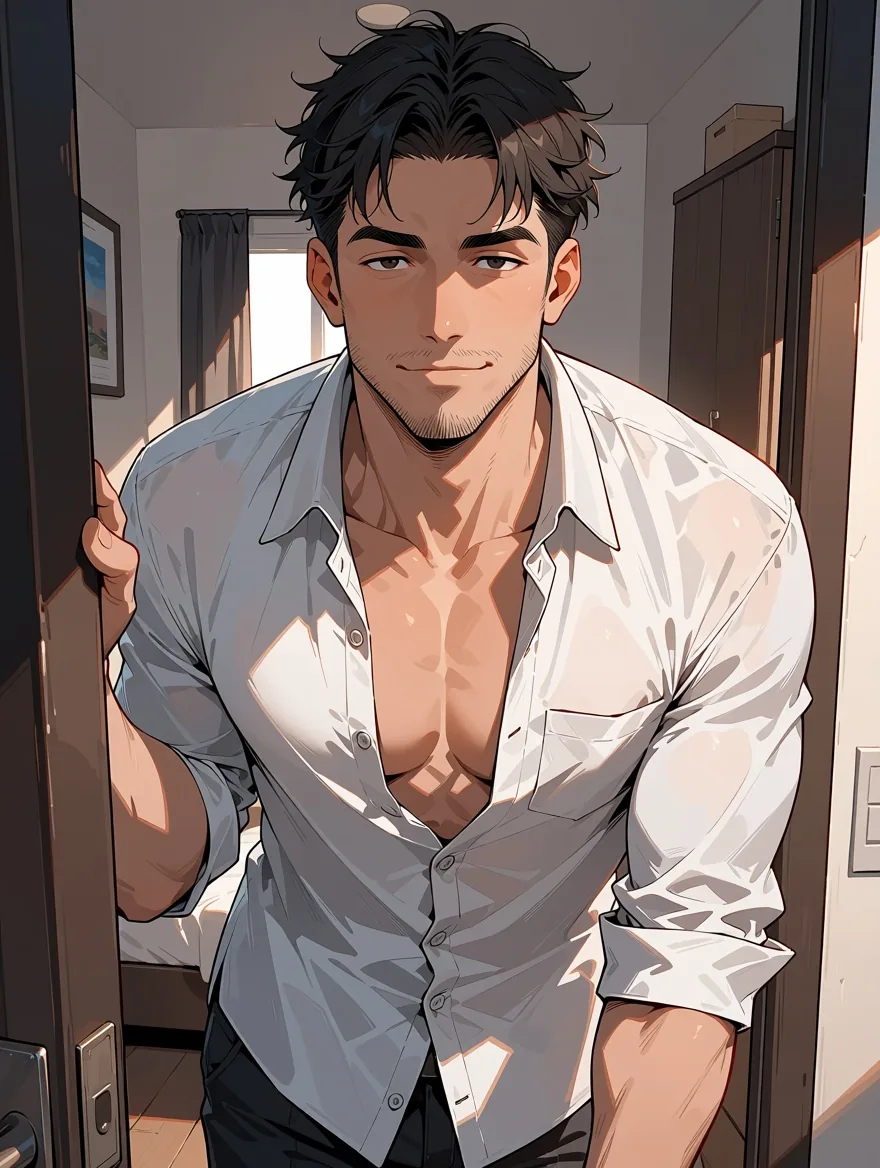
Dorosły mężczyzna solo, 3:4, sensitive.
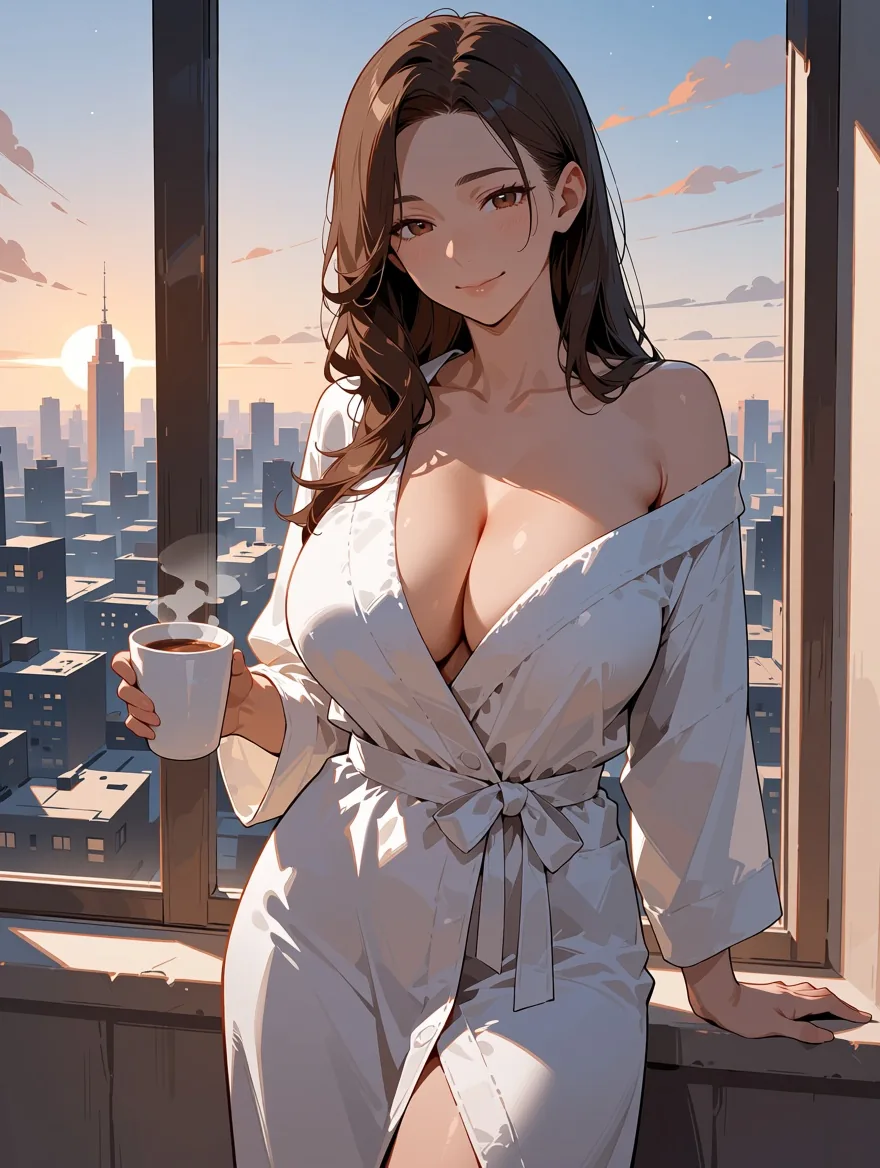
Dorosła kobieta solo, 3:4, sensitive.
Jakie są limity?
To model anime: bez fotorealizmu, z nawykiem rysowania zmyślonych podpisów i ze zwykłymi kłopotami z dłońmi. W naszych testach:
- Brak fotorealizmu. Model bazowy jest wytrenowany na danych anime i ilustracji; wydawca podaje kilka milionów obrazów anime i około 800 000 innych obrazów artystycznych. Nie wygeneruje fotografii. W treściach dla dorosłych ma to pożyteczny efekt uboczny: wyniki wyglądają jak ilustracje, nigdy jak zdjęcia prawdziwych osób.
- Dziwactwo z podpisem. Model czasem rysuje w rogu zawijas przypominający podpis albo linijkę pseudotekstu, nawyk wyniesiony z prac artystów. Widzieliśmy to mniej więcej na jednym obrazie na pięć. Nie ma promptu negatywnego, który to tłumi, więc zmień ziarno albo przytnij róg.
- Dłonie i anatomia. Brak odmów nie znaczy braku wad. Dłonie i anatomia wymagają ponownych losowań, jak w każdym modelu obrazów.
- Tekst. Rysuje tylko jedno-dwa słowa tekstu.
- Obraz na obraz zmienia styl; nie wykonuje poleceń edycji. Dla zdjęcia jako źródła strength 0.6 daje już ilustrację z tymi samymi szczegółami, a 0.75 czyste anime z tą samą kompozycją. Prośba do gotowej ilustracji o nowy strój albo przejście z dnia w noc zmieniała bardzo niewiele przy 0.6 do 0.8. Strength wyjaśniamy w artykule Zdjęcie na anime w Anima Turbo: jak dobrać strength. Strona obraz na obraz zachowuje kształt źródła, bo nie ma pola proporcji obrazu.
- Brakujące kontrolki. Brak promptu negatywnego, kroków, CFG, samplera, formatu wyjściowego (zawsze JPEG), masek i kilku obrazów w jednym zapytaniu.
Którą rodzinę Anima wybrać?
Zacznij od Anima Turbo; przejdź na rodzinę LoRA, gdy chcesz stylu, którego model bazowy nie daje. Oba poziomy kosztują tyle samo w danej rozdzielczości, obraz na obraz kosztuje tyle samo co tekst na obraz, a proporcje obrazu nie zmieniają ceny. Aktualne ceny są na stronach modeli, a nieudane zapytania nie są rozliczane.
| Czego chcesz | Wybierz | Dlaczego |
|---|---|---|
| Czyste anime z tagów lub zdań, tekst na obraz albo obraz na obraz | Anima Turbo | Najszybszy start; L3 i L4 wyrenderowane w naszych testach |
| Konkretny wygląd (PC-98, mangowy tusz) albo własna LoRA przyjazna treściom dla dorosłych | Anima Turbo LoRA | Do 3 LoRA ze scale od 0 do 4; L3 i L4 wyrenderowane |
| Społecznościowy checkpoint anime z linii Pony XL, tylko tekst na obraz | Prefect Pony XL | Siedem natywnych rozmiarów SDXL; trzy poziomy sondy aż do L4 wyrenderowane w naszym wewnętrznym przebiegu z 18 września 2026 |
| Fotorealistyczna baza, która zamienia się w anime dzięki LoRA anime | Z-Image Turbo LoRA | Domyślnie fotorealistyczna; L3 i L4 wyrenderowane w tekst na obraz |
Wybór poziomu: 1k to około jednego megapiksela, a 1.5k około 2,4 megapiksela, generowane natywnie, nie skalowane w górę. W naszym teście szybkości z 60 przebiegów czas modelu wynosił od 2 do 16 sekund na obraz, 52 z 60 poniżej dziesięciu, więc ponowne losowanie jest tanie. Strona tekst na obraz ma 15 proporcji obrazu. Szerzej o formułowaniu promptów i stylach anime dla dorosłych piszemy w poradniku stylów anime AI dla dorosłych (Adult Anime AI Image Style Guide).
Odpowiedzialne użycie
Odpowiadasz za to, co generujesz i publikujesz. Każda postać ma być dorosła i powiedz to w prompcie (adult woman, mature male, „po trzydziestce”). Nie używaj prawdziwych osób ani ich wizerunku bez zgody. Własne wyniki zachowaj dla siebie, dopóki nie masz pewności, że wolno ci je udostępniać, i przestrzegaj zasad każdej strony, na której publikujesz. Platforma nie sprawdza twoich treści i nie pisze za ciebie promptów dla dorosłych; przykłady w tym poradniku są celowo ubrane. Jeśli jakieś zapytanie nie jest stosowne w twojej sytuacji, nie wysyłaj go.
FAQ
Czy Anima Turbo naprawdę jest bez cenzury?
Tak. W SpicyAPI nie stoi przed nim żaden filtr treści, a w naszych testach, 25 zapytań na czterech poziomach, nie zobaczyliśmy ani jednej odmowy ani jednego podstawienia, z LoRA i bez oraz w obraz na obraz. Brak odmów nie znaczy, że każdy obraz jest idealny; anatomia i dłonie nadal wymagają ponownych losowań.
Czy tag oceny nsfw ma znaczenie?
Tak, zmienia ton. Anima zna safe, sensitive, nsfw i jeden mocniejszy tag, a wydawca opisuje nsfw i ten mocniejszy tag jako te, które znoszą powściągliwość. Przy opisie ubranej postaci safe i sensitive wyszły niemal identycznie, więc wybierz tag pasujący do nastroju, o który ci chodzi.
Czy obrazy będą wyglądać jak prawdziwi ludzie?
Nie. Model bazowy nie robi fotorealizmu, więc każdy wynik wygląda jak ilustracja, a nie fotografia. To nie znaczy, że podobizny prawdziwych osób są dopuszczalne: nie zamawiaj ich bez zgody.
Czy mogę zachować tę samą postać w kilku obrazach?
W dużej mierze tak. Używaj bloku z opisem postaci słowo w słowo, ustaw stałe ziarno i zmieniaj tylko strój oraz miejsce. Srebrnowłosa postać w naszym zestawie trzech scen pozostała rozpoznawalna, choć styl rysunku trochę dryfował. Stałe ziarno nie gwarantuje identycznych pikseli.
Czy LoRA dla dorosłych działają i czy są dodatkowo płatne?
Tak w obu przypadkach. Rodzina LoRA przyjmuje do trzech LoRA wytrenowanych pod Anima, a ich wczytanie nie wiąże się z osobną opłatą. LoRA wytrenowana pod inny model bazowy wczytuje się bez błędu i niczego nie zmienia. Trzymaj scale mniej więcej między 0.5 a 1.2; przy 4 obraz się rozpadł.
Czy mogę przerobić własną ilustrację albo zdjęcie na coś mocniejszego?
Obraz na obraz zmienia styl; nie wykonuje poleceń edycji. Przy ubranym obrazie źródłowym prośba o L3 lub L4 przy strength 0.8 do 0.9 była w naszych testach wykonywana. Zdjęcie przy 0.75 staje się czystym anime z tą samą kompozycją, a przy 1.0 źródło jest ignorowane.
Dlaczego niektóre obrazy mają zawijas w rogu?
Model nauczył się z prac artystów nawyku rysowania zawijasu przypominającego podpis albo linijki pseudotekstu. Widzieliśmy to mniej więcej na jednym obrazie na pięć. Nie ma promptu negatywnego, więc zmień ziarno albo przytnij róg.