Para convertir una foto en anime con Anima Turbo, envía la foto como image_url, escribe un prompt que describa la imagen que ya está en la foto y fija strength en 0.75. En nuestras pruebas, ese valor dio un anime limpio con la composición intacta. Más bajo, la foto se sigue viendo; más alto, el modelo empieza a redibujar la escena. Todo lo demás en esta guía trata de mover ese único número y de qué hacer cuando no basta.
Anima Turbo es la versión destilada de Anima, un modelo de anime e ilustración de 2 mil millones de parámetros de CircleStone Labs, basado en NVIDIA Cosmos-Predict2 con un codificador de texto Qwen3. Estos endpoints no tienen censura ni agregan ningún filtro de contenido, y todo lo que se muestra aquí son escenas cotidianas con adultos vestidos. Hicimos todas las pruebas el 5 de octubre de 2026.
De un vistazo
| Modelo | Anima Turbo, de CircleStone Labs (2B parámetros; Turbo es la versión destilada con la que el editor recomienda empezar) |
| Nombre de la API de imagen a imagen | circlestone-labs/anima-turbo/edit |
| Con LoRA | circlestone-labs/anima-turbo-lora/edit, hasta 3 LoRA, scale de 0 a 4 |
| Entradas | image_url (una imagen de origen), prompt, strength (de 0 a 1, 0.8 por defecto), resolution, seed |
| Mejor strength en nuestras pruebas | 0.75 para una fotografía; 0.85 para convertir una ilustración a color en tinta de manga |
| Tamaño de salida | Conserva la relación de aspecto del origen: una foto 16:9 dio 1360 x 752 en 1k; 1k es de alrededor de 1 megapíxel, 1.5k de alrededor de 2.4 |
| Formato de salida | Siempre JPEG |
| Velocidad | De 2 a 16 segundos de tiempo del modelo por imagen en 60 ejecuciones; 52 de 60 en menos de 10 segundos |
| Política de contenido | Sin censura, sin filtro de contenido |
| No puede | Instrucciones de edición, máscaras, prompts negativos, fotorrealismo, más de una imagen de origen |
Qué hace realmente strength
strength va de 0 a 1 (0.8 por defecto). Con 0 recibes tu origen sin tocar. Con 1 se ignora el origen y obtienes una imagen nueva a partir del prompt. Todo lo útil está en medio. Ejecutamos una fotografía de una cantante con un prompt y un seed, cambiando solo el número.
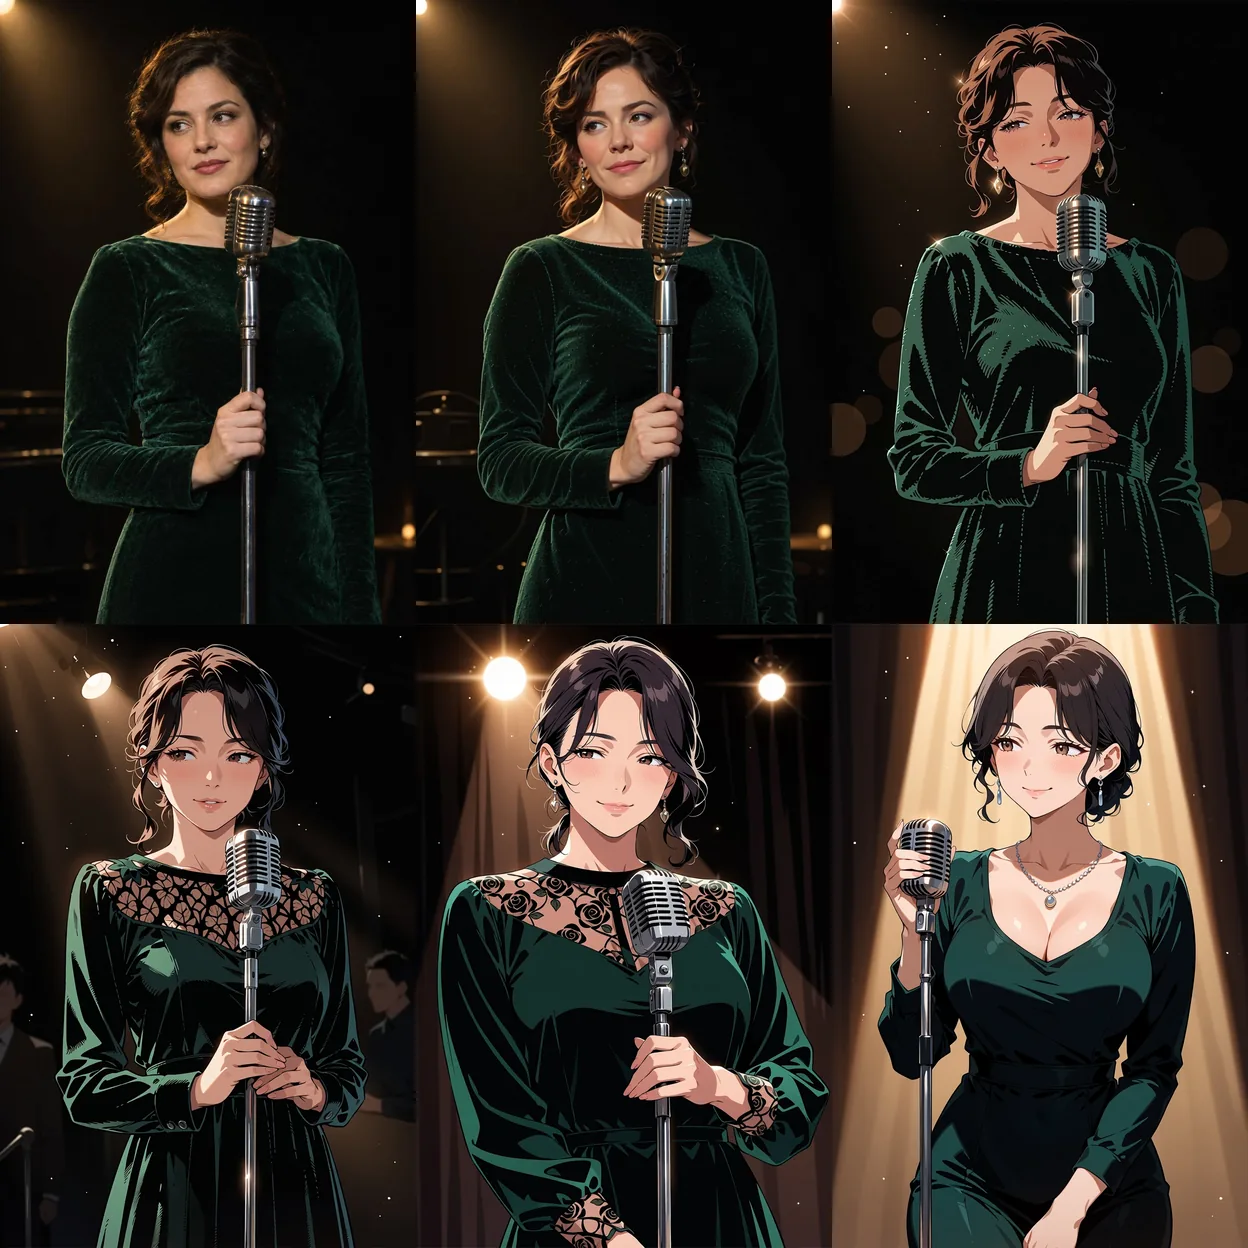
Fila superior, de izquierda a derecha: fotografía de origen, luego strength 0.3 y 0.6. Fila inferior: 0.75, 0.9 y 1.0. Imagen a imagen de Anima Turbo, nivel 1k, mismo prompt y seed en todas.
strength | Lo que vimos |
|---|---|
| 0 | Tu origen, sin tocar |
| 0.3 | Sigue siendo una fotografía |
| 0.6 | Ya es una ilustración, con los mismos detalles |
| 0.75 | Anime limpio, misma composición |
| 0.9 | Los detalles empiezan a cambiar: vestido, pose, fondo |
| 1.0 | Se ignora el origen; una imagen nueva a partir del prompt |
Empieza en 0.75 y ajusta en pasos de 0.05. El valor por defecto de 0.8 está bien, pero 0.75 conservó mejor la pose y el encuadre en todos los ejemplos de abajo.
Cuál valor elegir depende de con qué empiezas y qué quieres:
| Punto de partida y objetivo | Strength que usamos | Resultado en nuestras pruebas |
|---|---|---|
| Fotografía a anime sencillo | 0.75 | La composición se mantuvo, pequeños detalles mecánicos se desviaron |
| Fotografía a anime, un detalle debe sobrevivir | 0.7 | Nuestra sugerencia para el ejemplo del barista; no se ejecutó por separado |
| Fotografía a un look de estilo LoRA (PC-98) | 0.75 | Estilo aplicado, composición conservada |
| Ilustración a color a tinta de manga (LoRA monocromático) | 0.85 | Con 0.8 el color se quedó; con 0.85 la pose se vuelve a dibujar |
| Ilustración existente más un prompt de "edición" (vestuario nuevo, de día a noche) | 0.6 a 0.8 | Cambió muy poco; una strength más alta añadió pseudotexto |
Escribe el prompt para la imagen, no para la edición
Este es el error que más tiempo cuesta. Anima cambia el estilo; no sigue instrucciones como "cambia su ropa" o "hazlo de noche". Describe lo que hay en la foto, en el estilo que quieres, y nombra lo que el modelo debe conservar: cabello, ropa, escenario, luz. La escala de la cantante usó este prompt:
masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, mature female, short dark wavy hair, dark green velvet dress with long sleeves, holding a vintage microphone on a stand, jazz club stage, warm spotlight from above, dark background, soft smile, looking to the sideSe aplican las convenciones de etiquetas del editor: minúsculas, espacios en lugar de guiones bajos, etiquetas de calidad y de clasificación primero, luego el número de personajes (1girl, 1boy) y después las etiquetas generales. Nuestros prompts empiezan con safe; no hay prompt negativo, así que la etiqueta de clasificación es la principal forma de fijar el tono. Las frases también funcionan (el editor sugiere al menos dos) y combinarlas con etiquetas está bien.
La solicitud
{
  "model": "circlestone-labs/anima-turbo/edit",
  "input": {
    "image_url": "https://example.com/singer.jpg",
    "prompt": "masterpiece, best quality, safe, anime illustration, 1girl, solo, adult woman, short dark wavy hair, dark green velvet dress, holding a vintage microphone, jazz club stage, warm spotlight",
    "strength": 0.75,
    "resolution": "1k",
    "seed": 3
  }
}
No hay campo de relación de aspecto. La salida conserva la forma del origen: una foto 16:9 volvió con 1360 x 752 en el nivel 1k. resolution define el número de píxeles: 1k es de alrededor de un megapíxel y 1.5k de alrededor de 2.4 megapíxeles, generados de forma nativa y no escalados. La salida siempre es JPEG. La imagen a imagen se cobra por imagen según el nivel, igual que el texto a imagen; el precio vigente está en la página del modelo. El tiempo del modelo en nuestra prueba de velocidad de 60 ejecuciones fue de 2 a 16 segundos por imagen.
Qué hace buena a una foto de origen
- Un sujeto claro. Todos los ejemplos de aquí tienen una persona o una pareja en un entorno legible, y el prompt puede nombrar todo lo que está en el encuadre.
- Sin bordes, pies de foto ni marcas de agua. Anima cambia el estilo de todo el encuadre, así que lo que esté impreso en él también se vuelve a dibujar.
- Una forma que quieras conservar. No hay un campo de relación de aspecto; la salida sigue al origen (una foto 16:9 dio 1360 x 752), así que recorta antes de enviar.
- Un nivel que se ajuste al uso.
1kes de alrededor de un megapíxel;1.5kes de alrededor de 2.4 megapíxeles, generado de forma nativa y no ampliado. El mismo prompt y seed en ambos niveles:
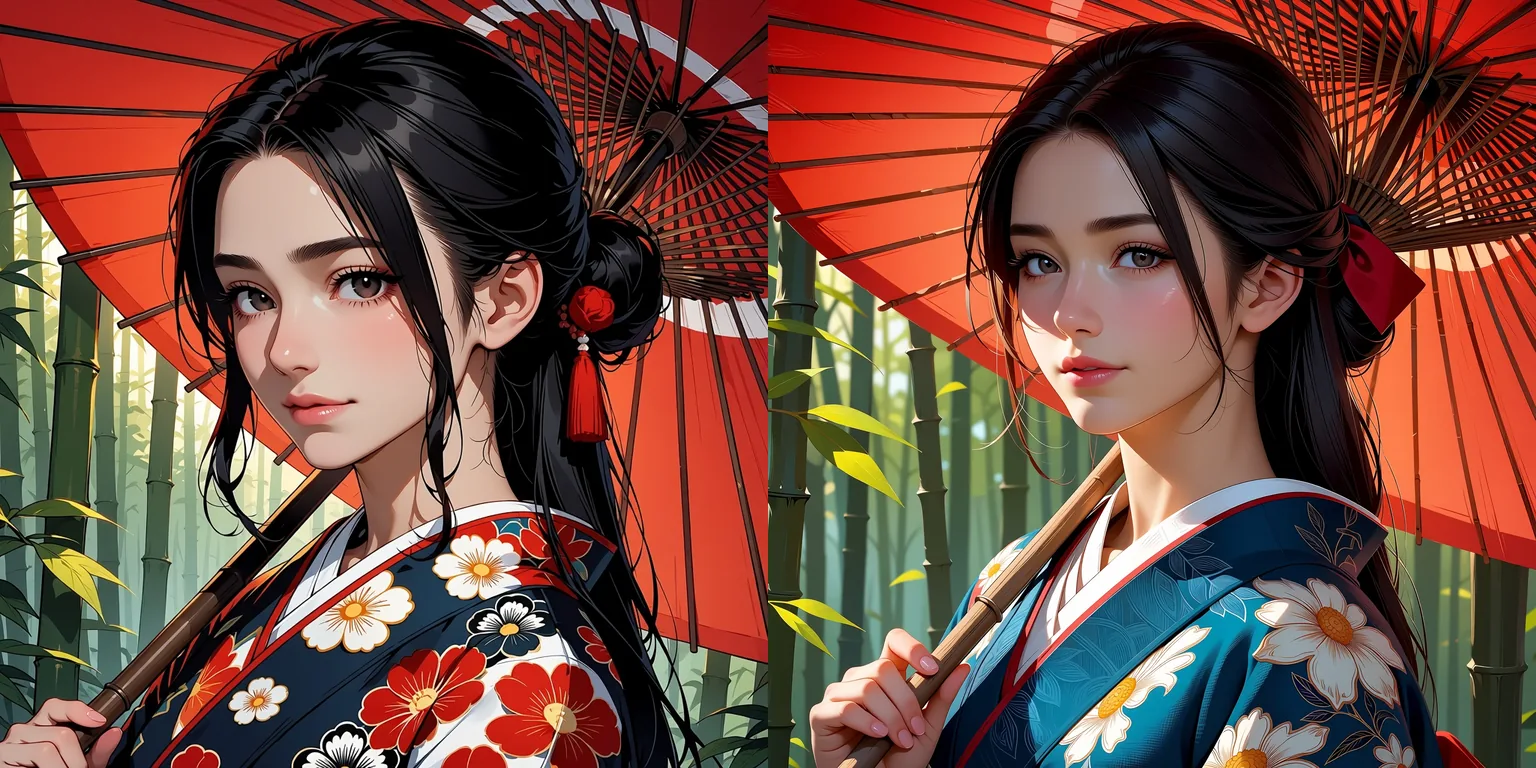
Izquierda: 1k (1024 x 1024). Derecha: 1.5k (1536 x 1536). Texto a imagen de Anima Turbo, mismo prompt y seed. Mostramos los niveles en texto a imagen; imagen a imagen usa el mismo campo resolution.
La composición es la misma, pero el render en 1.5k vuelve a dibujar el estampado del kimono y el rostro en lugar de solo añadir píxeles, así que elige el nivel antes de comparar seeds.
Tres ejemplos prácticos
Un retrato
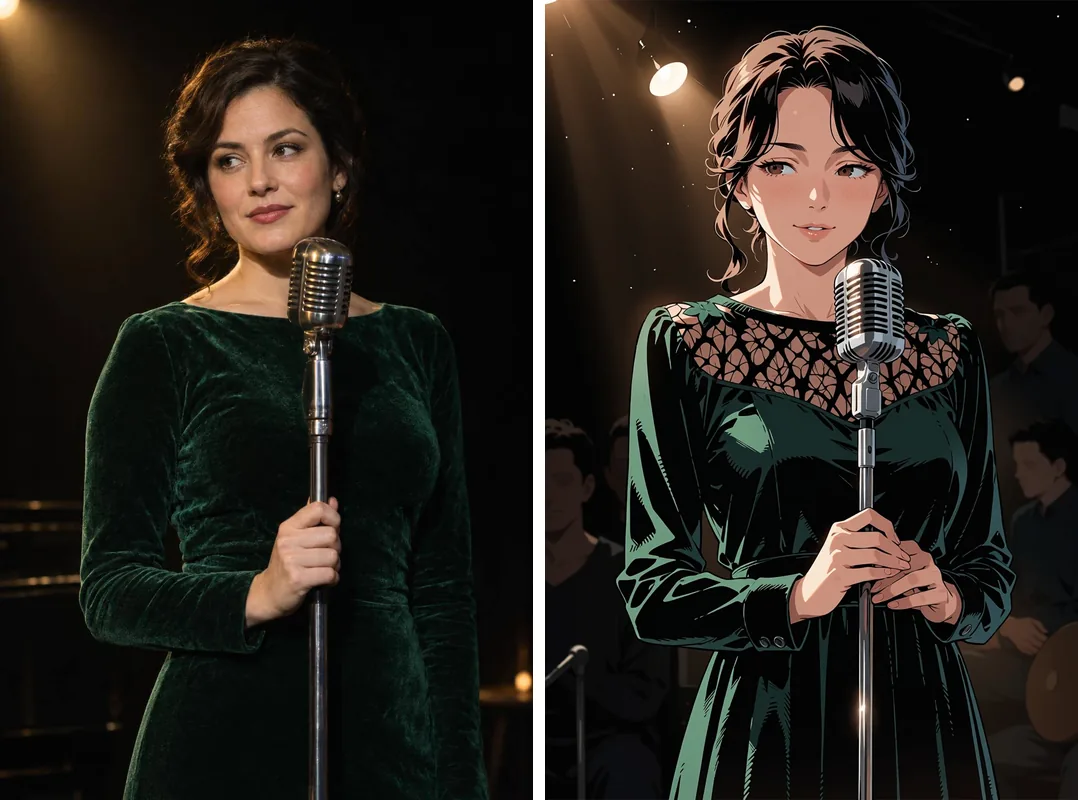
Izquierda: fotografía de origen. Derecha: imagen a imagen de Anima Turbo, strength 0.75, 1k, seed 3. Prompt como el de arriba.
El vestido de terciopelo, el pie del micrófono y la mirada de lado se conservaron, y la luz del escenario se convirtió en un cono limpio de luz cálida. Esta es la imagen de 0.75 de la escala, mostrada a tamaño completo.
Una escena en formato horizontal
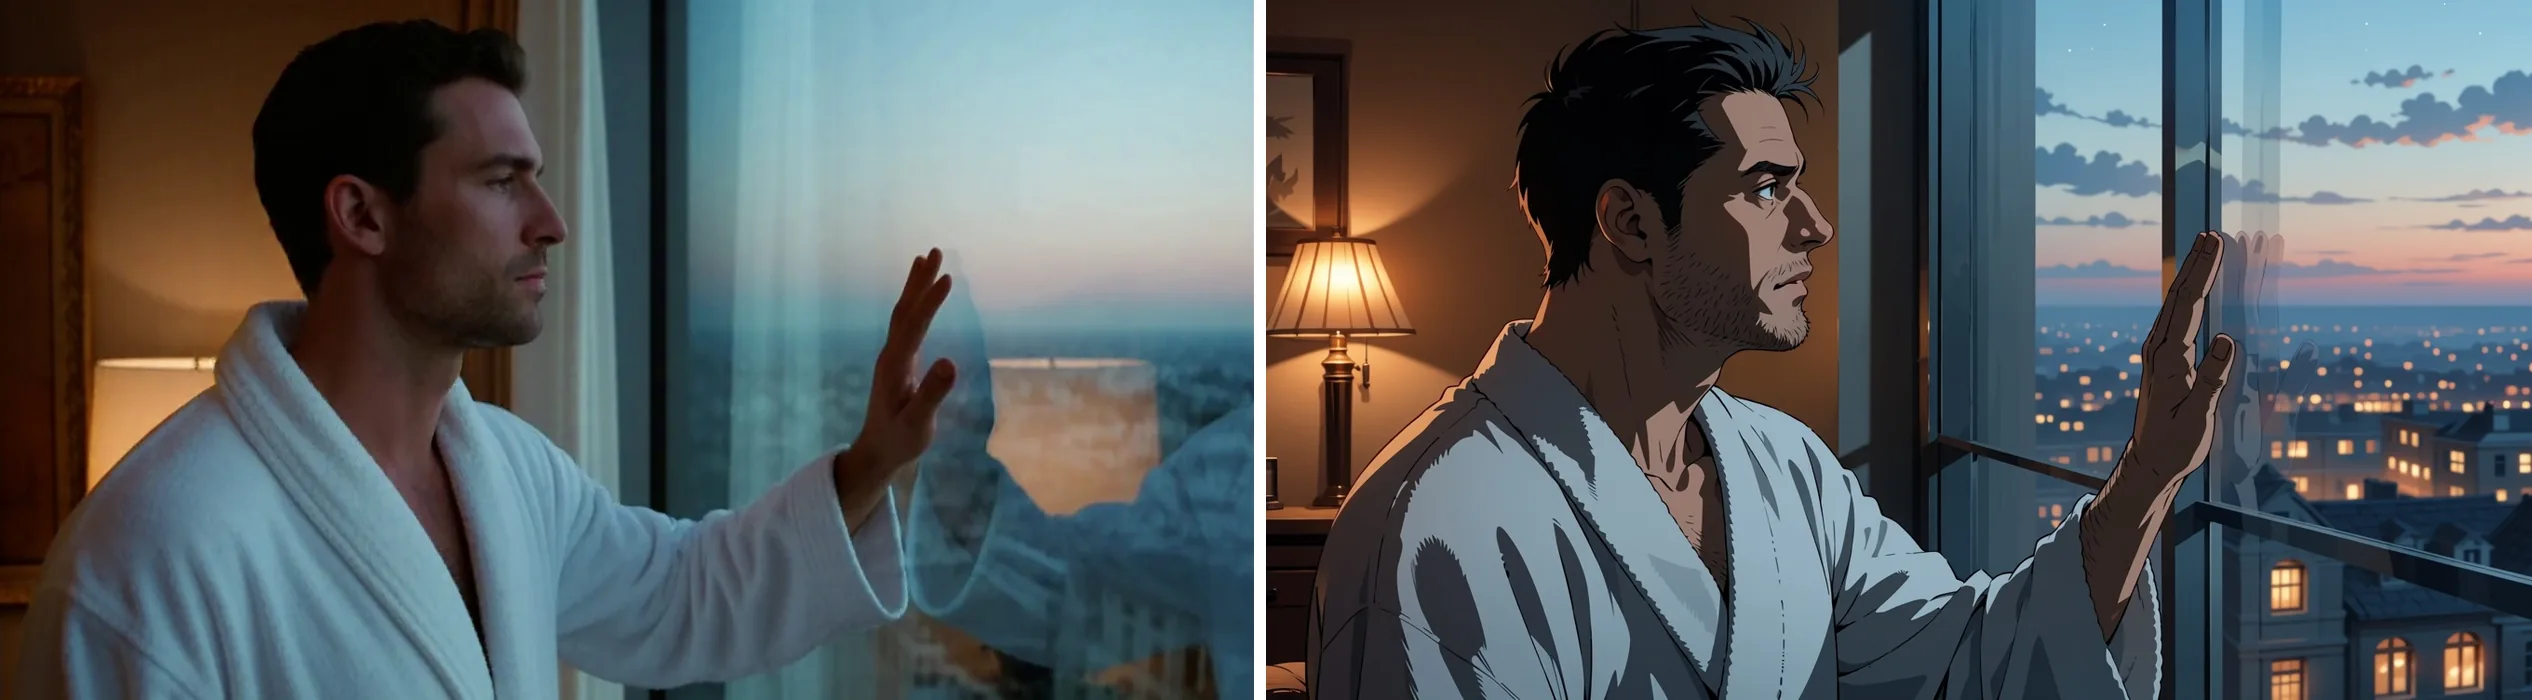
Izquierda: fotografía de origen. Derecha: imagen a imagen de Anima Turbo, strength 0.75, 1k, seed 1.
El prompt nombraba la pose (profile view, one hand touching a large window), la lámpara detrás de él y la luz azul de la tarde sobre el vidrio. El modelo conservó el perfil y la mano, y dibujó la ciudad de afuera con más detalle que la foto.
Una pareja en una scooter
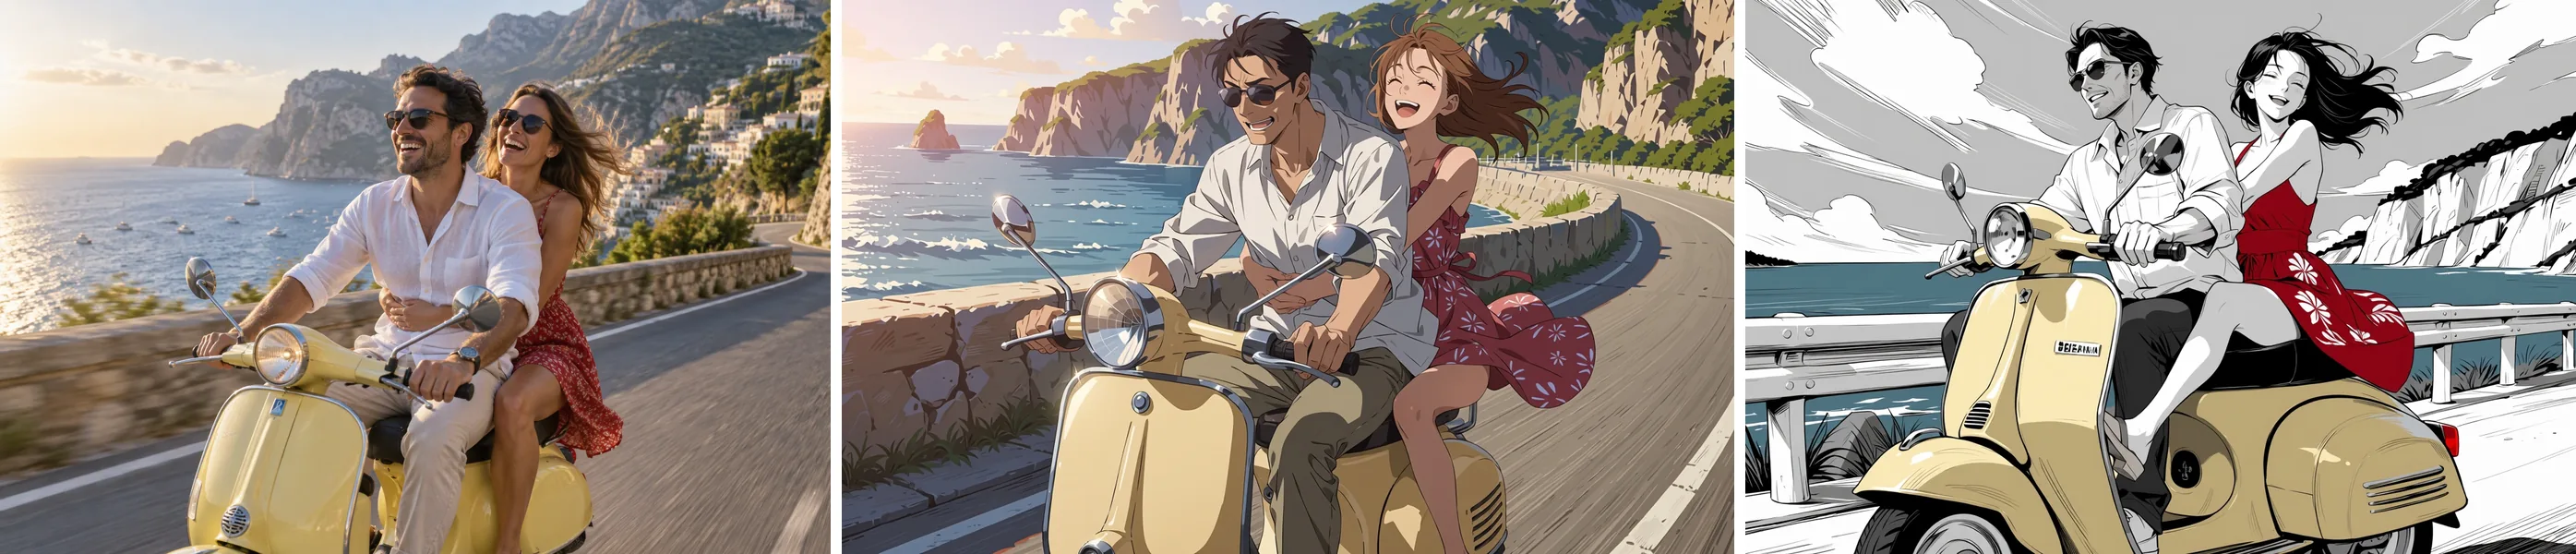
Izquierda: fotografía de origen, generada por nosotros. Centro: imagen a imagen de Anima Turbo, strength 0.75, 1k, seed 3, con el 7 % superior recortado. Derecha: la misma solicitud con el LoRA monocromático y strength 0.85.
masterpiece, best quality, safe, anime illustration, 1girl, 1boy, hetero, adult couple, mature female, mature male, riding a pale yellow vintage scooter on a coastal road, he drives in a white linen shirt and sunglasses, she sits behind him in a red summer dress with her arms around his waist, hair blowing in the wind, laughing, blue sea and cliffsLas escenas con dos personas necesitan que se especifiquen los colores y la ropa de cada una, como arriba. Recortamos el 7 % superior del resultado central porque el modelo había dibujado un pequeño garabato de pseudotexto en esa esquina, lo que nos lleva a la sección de solución de problemas más abajo. No recortamos el ejemplo de la barista, que en cambio movió su encuadre:
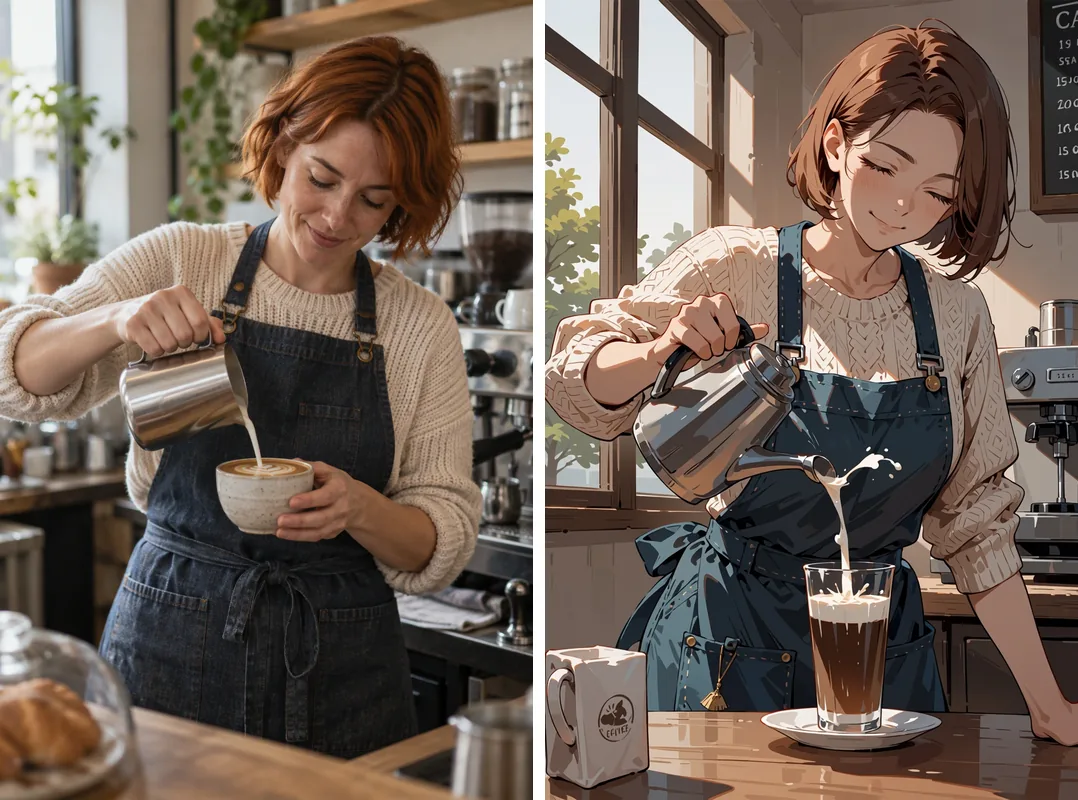
Izquierda: fotografía de origen, generada por nosotros. Derecha: imagen a imagen de Anima Turbo, strength 0.75, 1k, seed 3.
El delantal, el suéter, la luz de la ventana y la máquina de espresso se conservaron; la jarra de leche, la taza y el ángulo de la cámara se movieron. Con 0.75, espera que el contenido se mantenga y que la mecánica pequeña se desvíe. Si un detalle importa, baja a 0.7.
Lo que no puede hacer
- No sigue instrucciones de edición. Pedirle a una ilustración existente un vestuario nuevo, o que pase de día a noche, cambió muy poco con 0.6 a 0.8 y, con una fuerza mayor, añadió pseudotexto. El prompt describe el resultado; no es una orden.
- No hay máscara. No puedes proteger una región ni repintar solo una.
- Una imagen de origen por solicitud, y sin campos de prompt negativo, pasos ni sampler.
- Es un modelo de anime. No hace fotorrealismo y solo dibuja una o dos palabras de texto.
- Un seed fijo no garantiza píxeles idénticos. La misma solicitud con el mismo seed nos dio tres renderizados ligeramente distintos en momentos diferentes, así que guarda las imágenes que te gusten.
Reestilizar o editar: lo que este endpoint puede y no puede hacer
| Quieres | ¿Funciona? | Qué hacer |
|---|---|---|
| Convertir toda una foto en anime | Sí | Describe la foto, strength 0.75 |
| Conservar la pose y el encuadre | En su mayoría | Nombra la pose en el prompt; baja la strength en 0.05 |
| Aplicar un estilo de LoRA a una foto | Sí | LoRA entrenado para Anima, palabras activadoras, strength 0.75 |
| Cambiar un solo objeto o el vestuario | No | Describe la imagen terminada y acepta que se vuelva a dibujar por completo |
| Cambiar la hora del día | No | Lo mismo que arriba |
| Proteger o repintar una región | No | No hay máscara disponible |
| Obtener fotorrealismo | No | Anima es un modelo de anime |
Llevar una foto a un estilo concreto con LoRA
Anima Turbo LoRA acepta hasta tres entradas en loras, cada una con un enlace HTTPS directo a un archivo .safetensors más un scale. El nombre del modelo en la API es circlestone-labs/anima-turbo-lora/edit; cargar LoRA no tiene un cargo aparte. Usa LoRA entrenados para Anima: uno entrenado para otro modelo base se cargó sin error y no cambió nada en nuestra prueba.
Aspecto PC-98, strength 0.75. Con el LoRA de estilo PC-98 gal de Melon-Bread con scale 1, una fotografía de un hombre en una azotea adoptó el estilo tramado y de paleta limitada de los juegos de PC de los años 90, con la composición conservada. El prompt abría con las palabras activadoras:
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, ...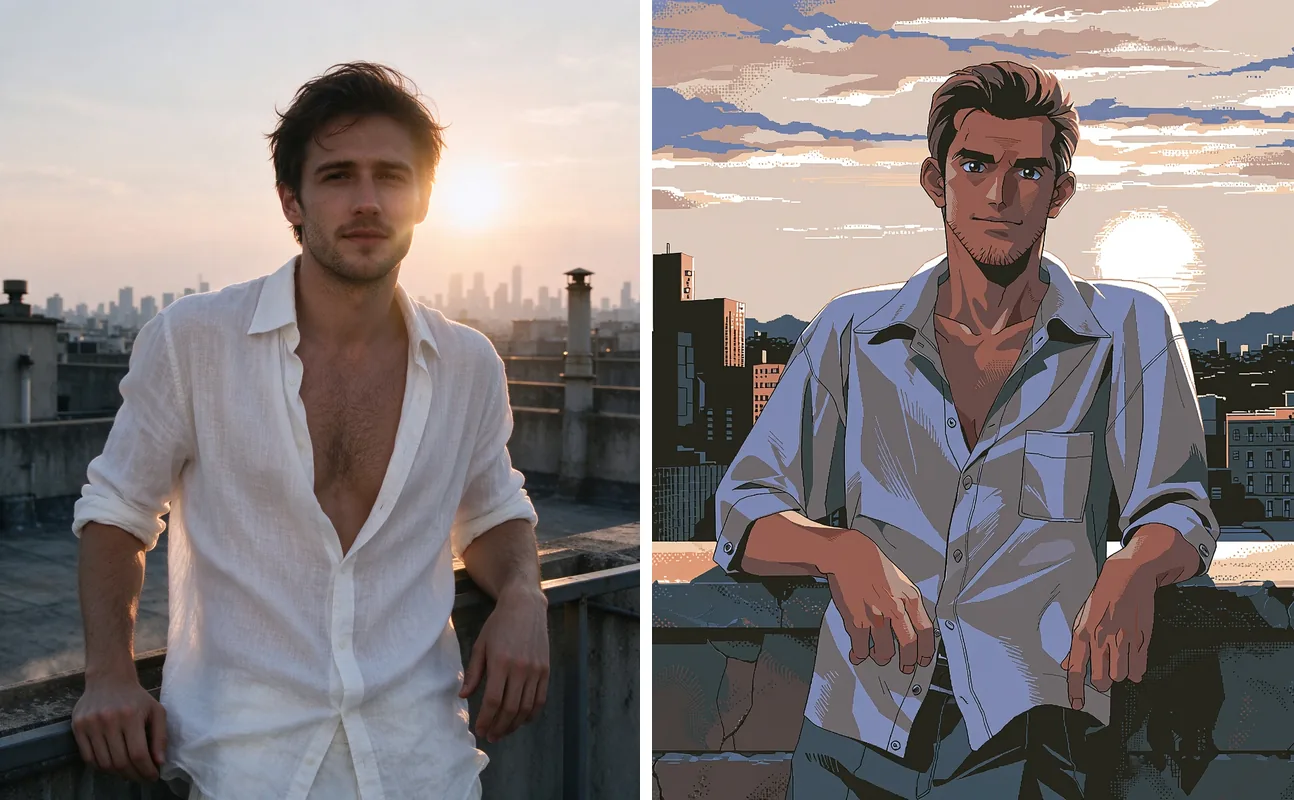
Izquierda: fotografía de origen (de archivo). Derecha: imagen a imagen de Anima Turbo LoRA, LoRA PC-98 con scale 1, strength 0.75, 1k, seed 42.
El mismo LoRA con nuestra fotografía de la guitarra, entre la versión anime sencilla y el origen:
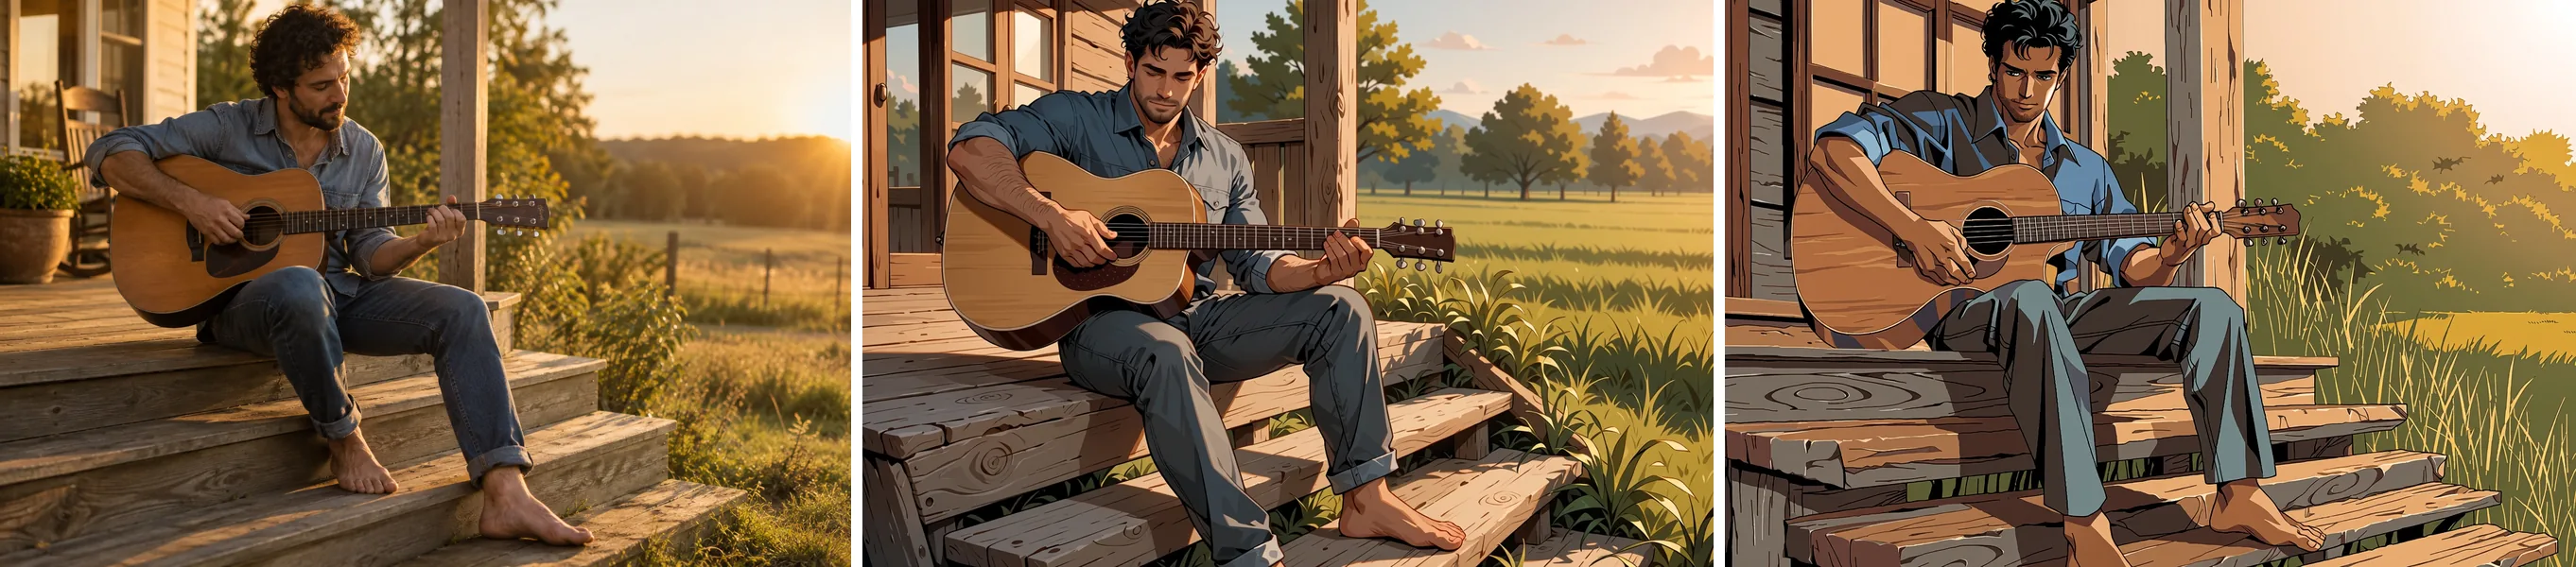
De izquierda a derecha: fotografía de origen (generada por nosotros); Anima Turbo con strength 0.75; Anima Turbo LoRA con el LoRA PC-98 con scale 1, strength 0.75. 1k, seed 3.
Tinta de manga, strength 0.85. El LoRA monocromático de notverriegod necesita monochrome, greyscale en el prompt; sin ellas, nuestra prueba se quedó en color. Convertir una ilustración a color en tinta necesitó 0.85, porque con 0.8 se mantuvo el color, y con esa fuerza la pose se redibuja.
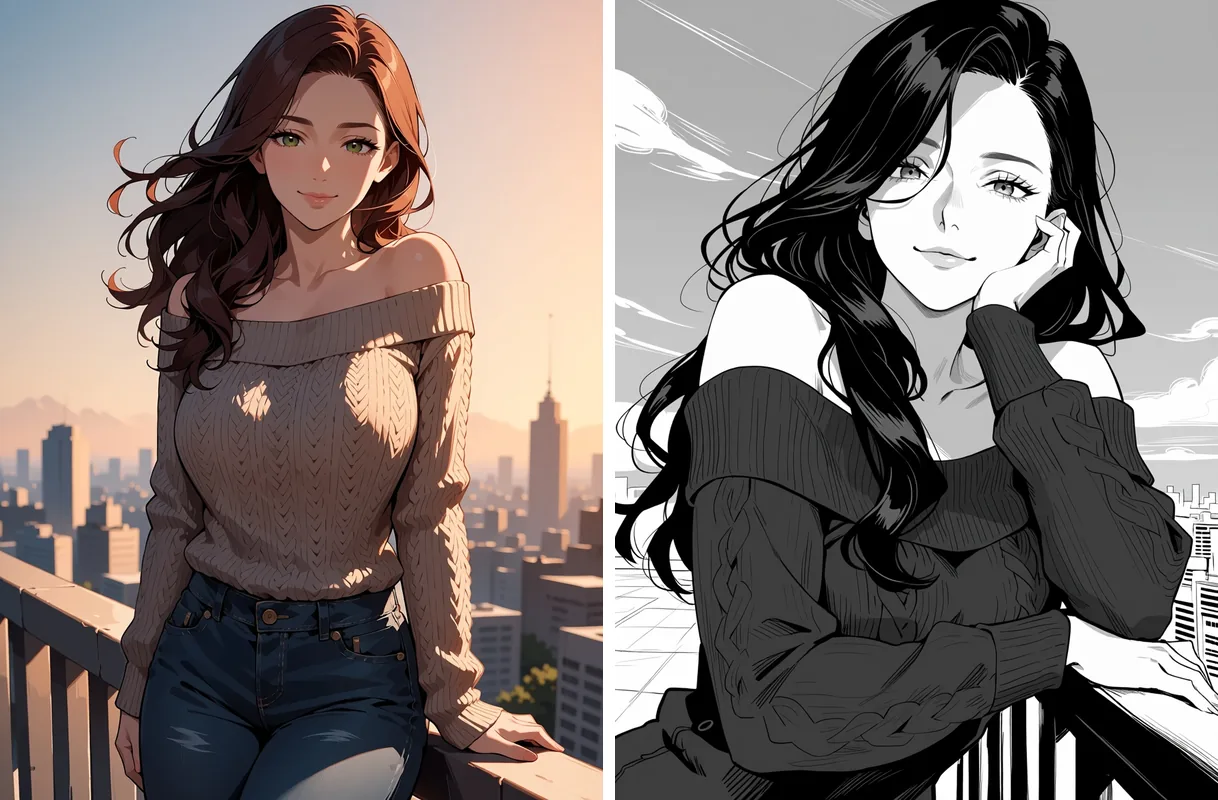
Izquierda: una ilustración a color de Anima Turbo (no una fotografía). Derecha: imagen a imagen de Anima Turbo LoRA, LoRA monocromático, strength 0.85, 1k.
En la foto de la scooter, el mismo LoRA conservó color puntual en la scooter y en el vestido (consulta el panel de la derecha más arriba). Los valores útiles de scale del LoRA en nuestras pruebas fueron de alrededor de 0.5 a 1.2; con scale 4 la imagen se deshizo en formas abstractas.
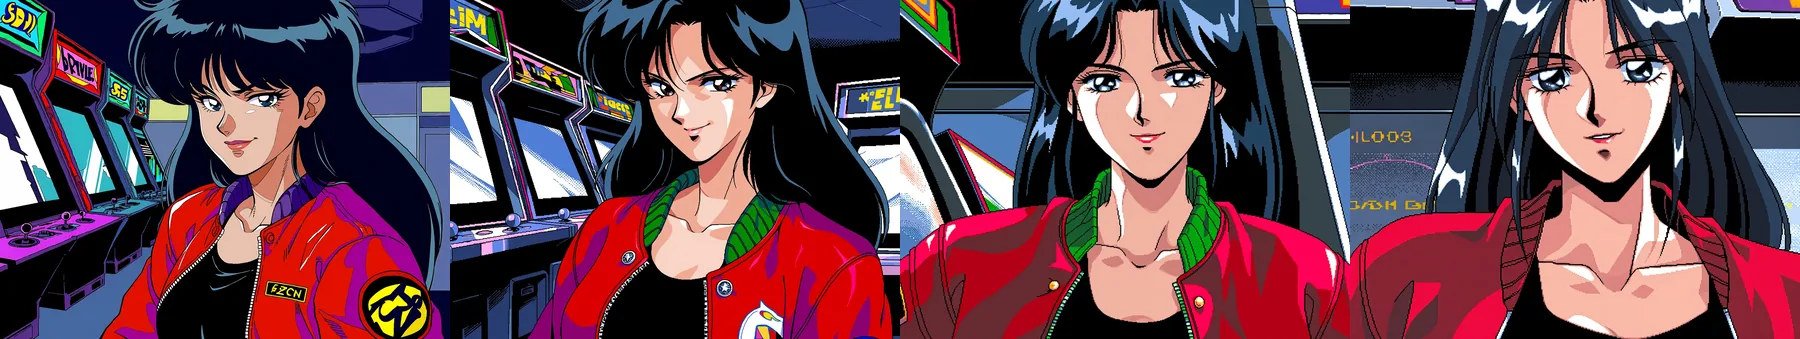
De izquierda a derecha: LoRA PC-98 con scale 0, 0.5, 1 y 1.5. Anima Turbo LoRA, texto a imagen, 1k, mismo prompt y seed. Con 0 el LoRA está apagado; 1 es el estilo completo; 1.5 lo lleva más lejos.
Solución de problemas
- La foto todavía se ve a través: sube
strengthen 0.05 y vuelve a ejecutar. - El rostro o la pose se desvían: bájalo en 0.05 y nombra la pose en el prompt.
- Hay un garabato o pseudotexto en una esquina: cambia el
seed. Lo vimos en aproximadamente una de cada cinco imágenes y ningún prompt negativo puede suprimirlo. Recortar unos pocos por ciento también funciona. - Un LoRA no cambia nada: comprueba que se haya entrenado para Anima y añade sus palabras activadoras.
- Quieres cambiar una sola cosa de la imagen: esta es la herramienta equivocada. Anima cambia el estilo de imágenes completas y no tiene máscara ni instrucciones de edición.
Veredicto: para convertir fotos en anime, Anima Turbo es rápido y predecible una vez que aceptas que strength es el único control. Empieza en 0.75, describe la foto y gasta tus reintentos en seeds en lugar de reformular el prompt.
Preguntas frecuentes
¿Qué strength debo usar para convertir una foto en anime?
Empieza en 0.75. En nuestras pruebas dio un anime limpio con la composición intacta; los valores más bajos conservan más de la fotografía y los más altos empiezan a cambiar los detalles. Ajusta en pasos de 0.05.
¿Anima Turbo admite prompts negativos?
No. No hay campo de prompt negativo, pasos, CFG ni sampler. La etiqueta de clasificación al inicio del prompt (nosotros usamos safe) es la principal forma de fijar el tono.
¿Puedo pedirle que cambie una sola cosa de mi imagen?
No. Reestiliza toda la imagen y no sigue instrucciones de edición; pedirle a una ilustración un vestuario nuevo o una escena nocturna cambió muy poco con 0.6 a 0.8. Describe mejor la imagen terminada y espera que se vuelva a dibujar por completo.
¿Por qué la salida tiene una forma distinta a la que pedí?
Porque imagen a imagen no tiene un campo de relación de aspecto. La salida conserva la forma del origen (una foto 16:9 dio 1360 x 752 en 1k), así que recorta primero la foto.
¿Por qué hay una firma o pseudotexto en la esquina?
El modelo aprendió ese hábito de las obras de arte. Lo vimos en aproximadamente una de cada cinco imágenes. Cambia el seed, o recorta unos pocos por ciento de ese borde; ningún prompt negativo puede suprimirlo.
¿Un seed fijo da la misma imagen?
No de forma fiable. La misma solicitud con el mismo seed nos dio tres renderizados ligeramente distintos en momentos diferentes, así que los seeds hacen comparables las ejecuciones pero no conservan las imágenes que te gustan.
¿Puedo usar LoRA de otros modelos?
Solo LoRA entrenados para Anima. Uno entrenado para otro modelo base se cargó sin error y no cambió nada en nuestra prueba. Usa Anima Turbo LoRA con hasta tres enlaces a archivos .safetensors.
¿Qué tan rápido es?
En 60 ejecuciones, el tiempo del modelo fue de 2 a 16 segundos por imagen, y 52 de ellas tardaron menos de 10 segundos. La primera solicitud con un LoRA nuevo puede tardar más mientras se descarga el archivo.