Il flusso di lavoro che ha funzionato meglio nei nostri test è questo: progetta un personaggio adulto con i tag, scegli il tono con un tag di rating, fai le bozze a 1k, finalizza a 1.5k, aggiungi un LoRA di stile e correggi i problemi cambiando il seed o lo scale invece di riscrivere il prompt. Abbiamo eseguito l’intera catena su Anima Turbo, un modello per anime e illustrazione senza censura su SpicyAPI: non c’è alcun filtro sui contenuti e il nostro test di contenuto più forte è stato reso come scritto al primo tentativo.
Questa è la versione pratica della guida: otto passi dall’idea a un set finito, con ogni prompt testato il 5 ottobre 2026. Ogni prompt riportato qui è una scena vestita, al massimo allusiva, con personaggi adulti, perché è tutto ciò che pubblichiamo. Esistono toni più forti, a un solo tag di rating di distanza; spieghiamo come funzionano i tag senza riportarli.
In sintesi
| Passo | Cosa fai | Impostazione chiave | Cosa abbiamo visto |
|---|---|---|---|
| 1. Personaggio | Fissa l’aspetto in un blocco di tag che riusi | Stesso seed, stesso blocco del personaggio | Un personaggio è rimasto riconoscibile in tre abiti |
| 2. Tono | Scegli un tag di rating | safe o sensitive | Quasi la stessa immagine per una scena vestita |
| 3. Scena | Scegli proporzioni e livello | Bozze a 1k, finali a 1.5k | Da 2 a 16 secondi per immagine |
| 4. Stile | Aggiungi un LoRA | Scale da 0.5 a 1.2 | Con scale 4 l’immagine si è disgregata |
| 5. Riferimento | Trasforma una foto o uno schizzo in anime | strength 0.75 | Anime pulito, composizione mantenuta |
| 6. Movimento | Anima uno still finito (facoltativo) | Immagine più prompt | Breve clip da una famiglia video senza censura |
| 7. Correzione | Rilancia, abbassa, regola | Seed, scale, strength | Scarabocchi di firma e deviazioni si possono correggere |
| 8. Privacy | Tieni privati i risultati | Il tuo archivio | Responsabilità tua |
Passo 1: progetta un personaggio adulto con i tag
Scrivi il personaggio una sola volta, come blocco di tag, e incolla lo stesso blocco in ogni prompt. Anima segue tag in stile Danbooru, frasi semplici e misti dei due. L’editore, CircleStone Labs, documenta le convenzioni sui tag nella model card: minuscolo, spazi al posto dei trattini bassi e un ordine fisso.
L’ordine che ha funzionato per noi:
- tag di qualità:
masterpiece, best quality, eventualmentescore_7 - tag di rating:
safeosensitive(passo 2) - numero di soggetti:
1girl,1boy,1girl, 1boy,no humans - un’indicazione di età:
adult woman, mature femaleomature male - il blocco del personaggio: capelli, occhi, un segno distintivo
- l’abbigliamento, il luogo, la posa, la luce
Dì sempre nel prompt stesso che il personaggio è un adulto, in modo che lo portino i tag.
Ecco la prova che un blocco del personaggio funziona. Le tre immagini qui sotto condividono un seed e un blocco, short silver bob, golden eyes, beauty mark under the left eye. Sono cambiati solo l’abbigliamento e il luogo: un dolcevita in una galleria, una sottoveste di seta rossa su un balcone, una camicia bianca oversize sul davanzale di una finestra.
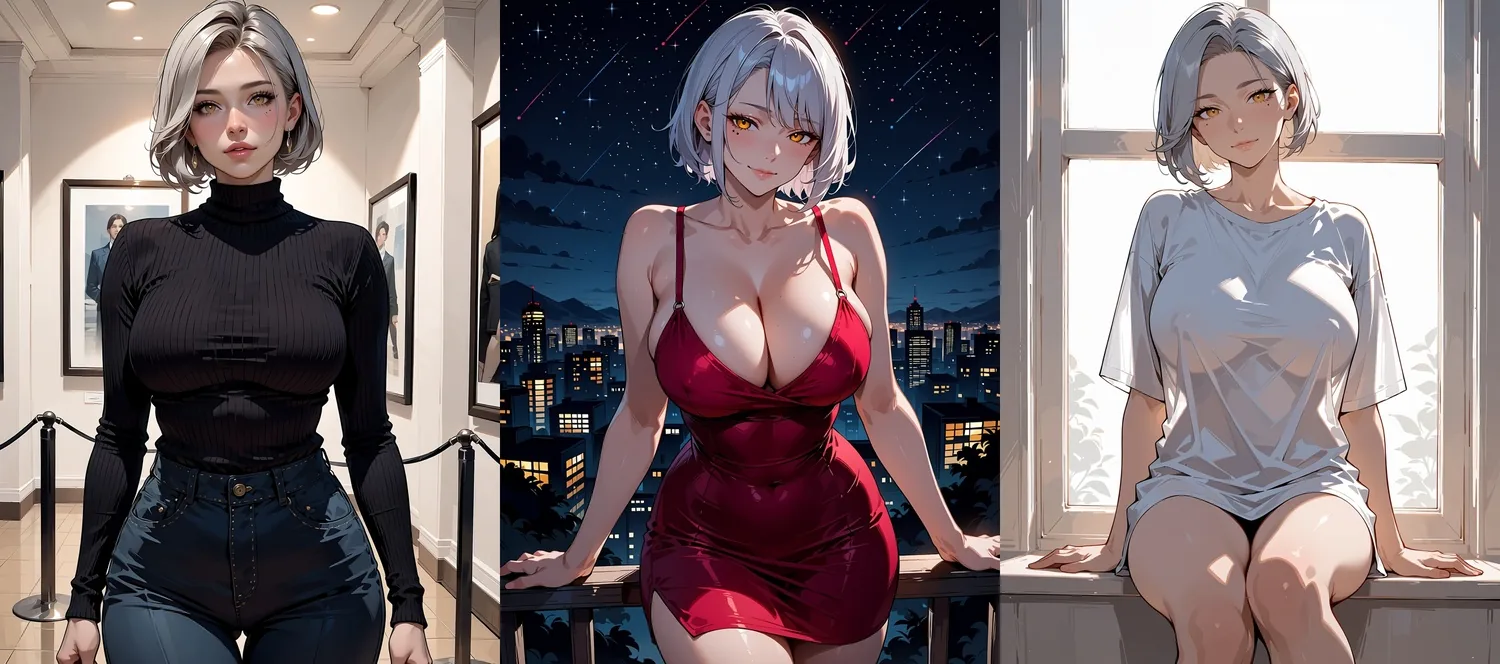
Un blocco del personaggio, seed 31, tre abiti (Anima Turbo, 1k, 3:4). Capelli, occhi e neo restano; posa e inquadratura cambiano con il prompt.
Il primo prompt del set, così puoi copiarne la forma:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female,
short silver bob, golden eyes, beauty mark under the left eye, black turtleneck,
standing in an art gallery, looking at viewer
Gli altri due sostituiscono abbigliamento e luogo e usano sensitive. Se il volto deriva quando cambi molte cose insieme, tieni il seed e cambia una sola clausola alla volta.
Passo 2: scegli il tono con un tag di rating
Poiché Anima non ha un prompt negativo, il tag di rating è il tuo controllo principale sul tono. Il modello conosce safe, sensitive e nsfw, più un tag più forte. L’editore documenta gli ultimi due come i tag che tolgono la moderazione. Non riportiamo prompt che li usano e non nominiamo il tag più forte, ma è bene sapere che esistono, così scegli con consapevolezza.
Per una scena vestita, safe e sensitive sono parenti stretti. La coppia qui sotto usa lo stesso prompt e lo stesso seed, con una sola parola cambiata. Una donna in abito da sera nero al bar di un albergo è venuta quasi identica in entrambi i casi.
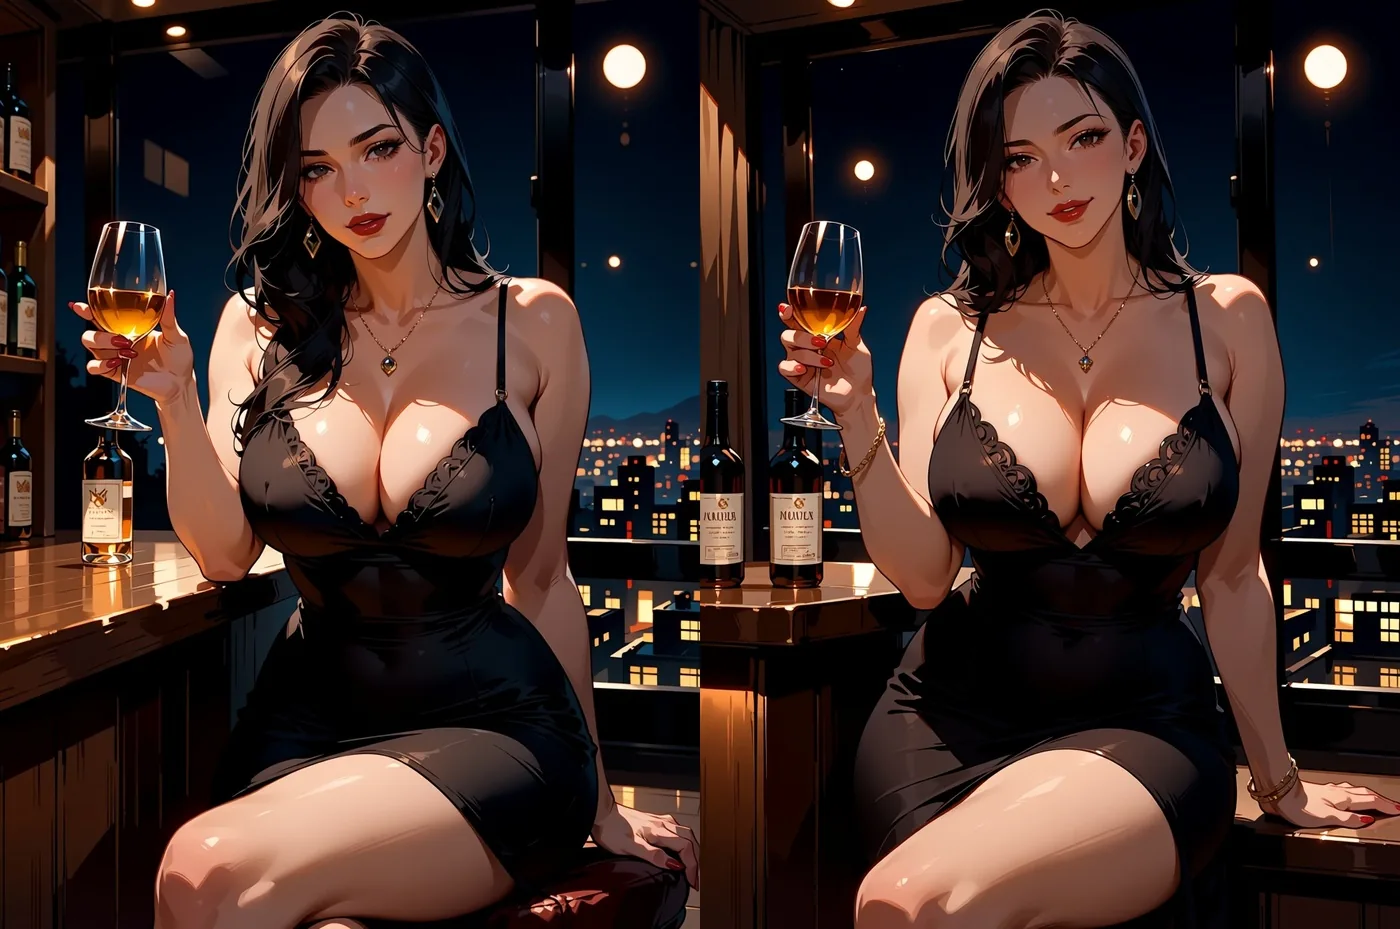
Stesso prompt, stesso seed 27, a sinistra safe, a destra sensitive (Anima Turbo, 1k, 3:4).
| Tag di rating | Cosa segnala | Come lo usiamo |
|---|---|---|
safe | Quotidiano, sobrio | Predefinito per le prime bozze e per tutto ciò che pensi di condividere |
sensitive | Al massimo allusivo | Abiti da sera, una spallina che scivola, ballo stretto |
nsfw | Toglie la moderazione | Lavoro solo per adulti, a tuo rischio e sotto la tua responsabilità |
| Un tag più forte | La toglie ancora di più | Lo stesso; leggi la model card |
Su 25 richieste a quattro livelli di contenuto, da testo a immagine e immagine in immagine, con e senza LoRA, abbiamo visto zero rifiuti e zero sostituzioni. Anatomia e mani richiedono comunque di rilanciare il seed come con qualsiasi modello di immagini (passo 7).
Passo 3: componi la scena
Scegli le proporzioni in base alla storia, fai le bozze a 1k e spendi un rendering a 1.5k solo sui migliori. Da testo a immagine accetta aspect_ratio (15 opzioni, predefinita 1:1), resolution (1k o 1.5k) e seed. Le proporzioni non cambiano il prezzo; il livello 1.5k costa più di 1k, ed è il motivo per cui conviene fare le bozze in piccolo. Il prezzo aggiornato è sulla pagina da testo a immagine.
| Uso | Proporzioni | Dimensioni 1k | Dimensioni 1.5k |
|---|---|---|---|
| Ritratto, scheda del personaggio | 3:4 | 880 x 1168 | 1328 x 1760 |
| Sfondo per telefono | 9:16 | 768 x 1360 | 1152 x 2048 |
| Coppia cinematografica o copertina | 16:9 | 1360 x 768 | 2048 x 1152 |
| Inquadratura d’ambientazione ampia | 21:9 | 1552 x 656 | 2048 x 992 |
| Banner alto | 1:3 | 576 x 1760 | 880 x 2048 |
Il livello 1.5k è generato in modo nativo, non ingrandito. In 60 esecuzioni cronometrate il modello ha impiegato da 2 a 16 secondi per immagine, 52 su 60 in meno di 10.
Per le coppie hanno funzionato un’inquadratura ampia 16:9, una clausola di abbigliamento per ciascuna persona e un gesto di ancoraggio.
masterpiece, best quality, score_7, sensitive, 1girl, 1boy, hetero, adult couple,
mature female, mature male, slow dancing close together in a dim jazz bar,
she wears a green satin dress, he wears a dark suit with loosened tie,
foreheads touching, his hand on her waist, warm lamp light, intimate mood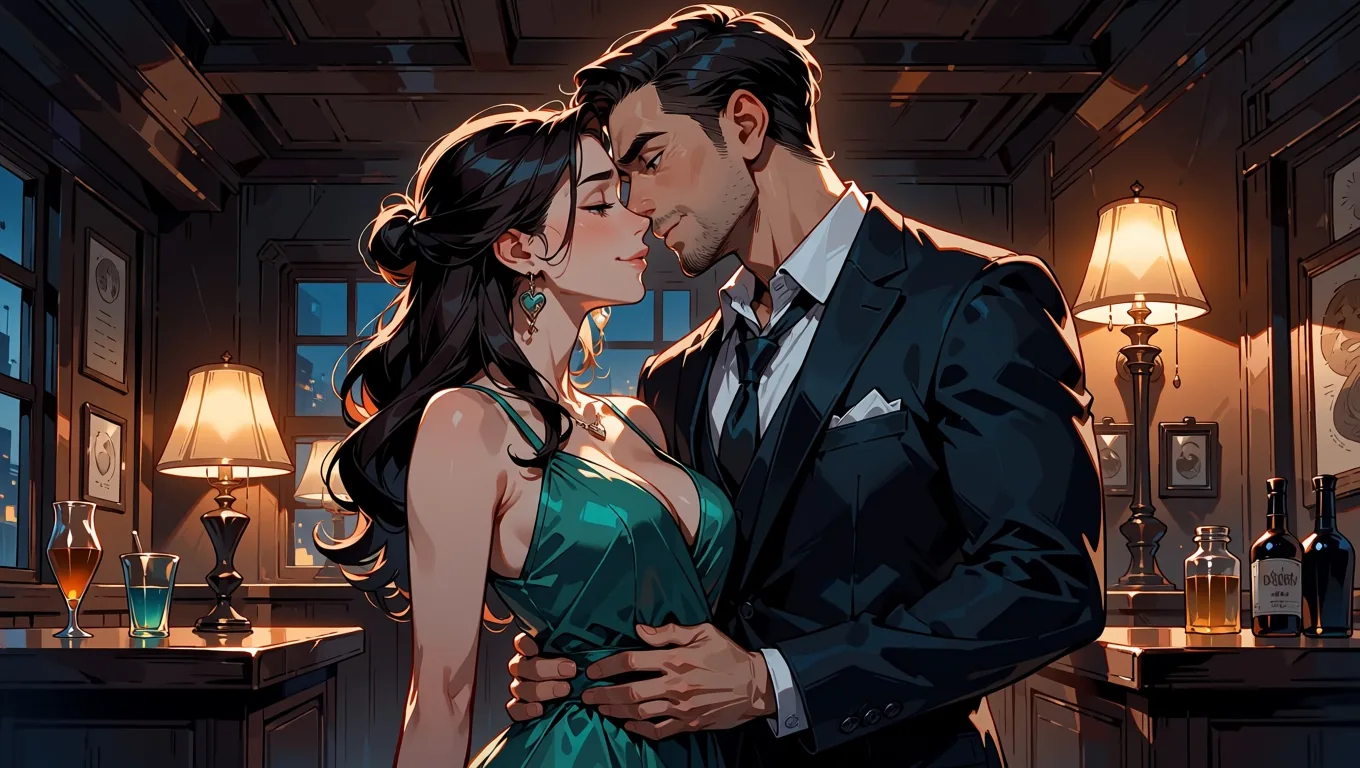
Seed 24, 16:9, 1k, Anima Turbo. Dare a ciascuna persona la propria clausola di abbigliamento è ciò che impedisce alle due figure di fondersi in una.
Se preferisci le frasi, scrivine almeno due; l’editore avverte che i prompt molto brevi tendono a deviare.
Passo 4: dai uno stile con un LoRA
Un LoRA è il modo più rapido per dare a un intero set un’unica identità visiva; tieni lo scale tra circa 0.5 e 1.2 e usa le trigger word. Anima Turbo LoRA è lo stesso modello con un elenco loras di fino a tre voci, ciascuna {path, scale}. Il path deve essere un link HTTPS diretto a un file .safetensors e deve essere un LoRA addestrato per Anima. Caricare i LoRA non comporta un addebito separato.
Due LoRA pubblici che abbiamo usato:
- Melon-Bread/anima-pc98-gal-style-v0.2 (MIT): un look da gioco dell’era PC-98, trigger
pc98gal_style. - notverriegod/monochrome-grayscale_style (Apache-2.0): inchiostro manga in bianco e nero. Nel nostro test è rimasto a colori finché
monochrome, greyscalenon era nel prompt.
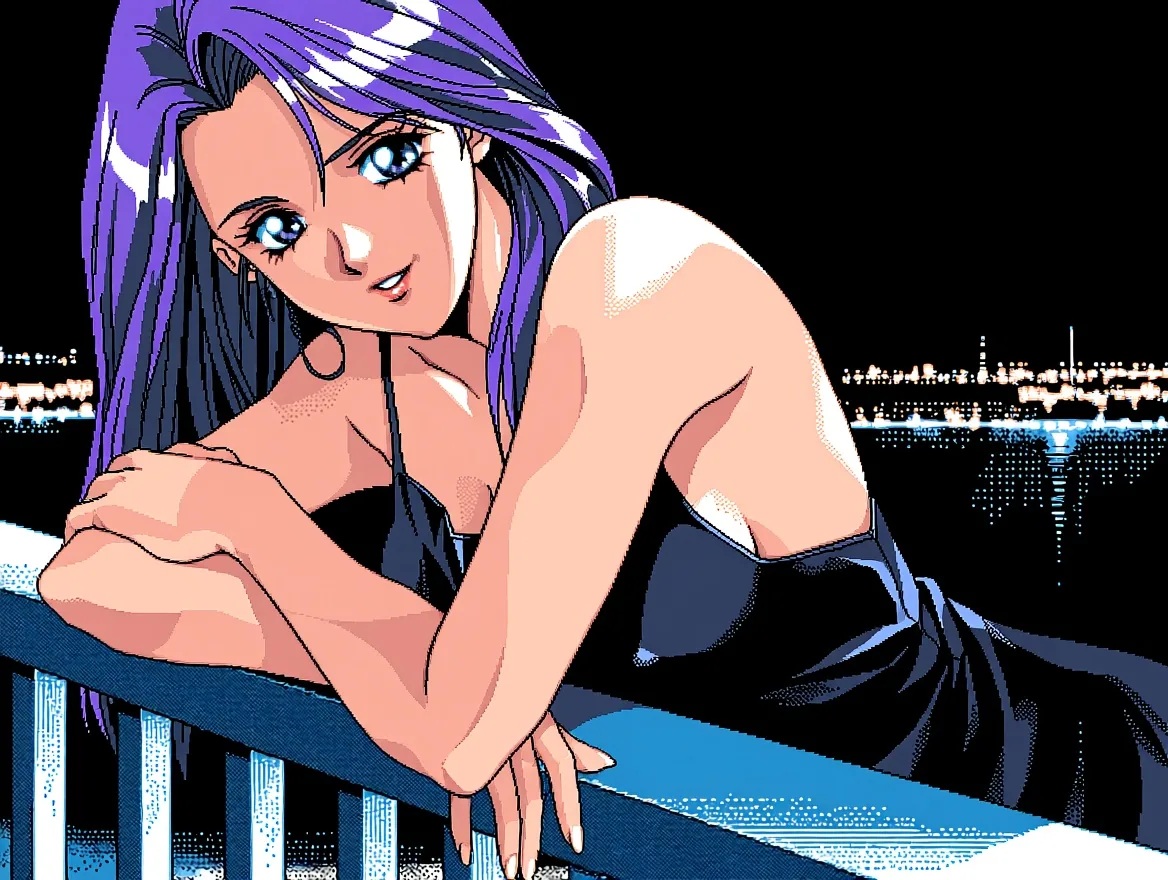
LoRA PC-98 con scale 1, sensitive, 4:3, 1k. Il dithering e la colorazione piatta a cel shading vengono dal LoRA.
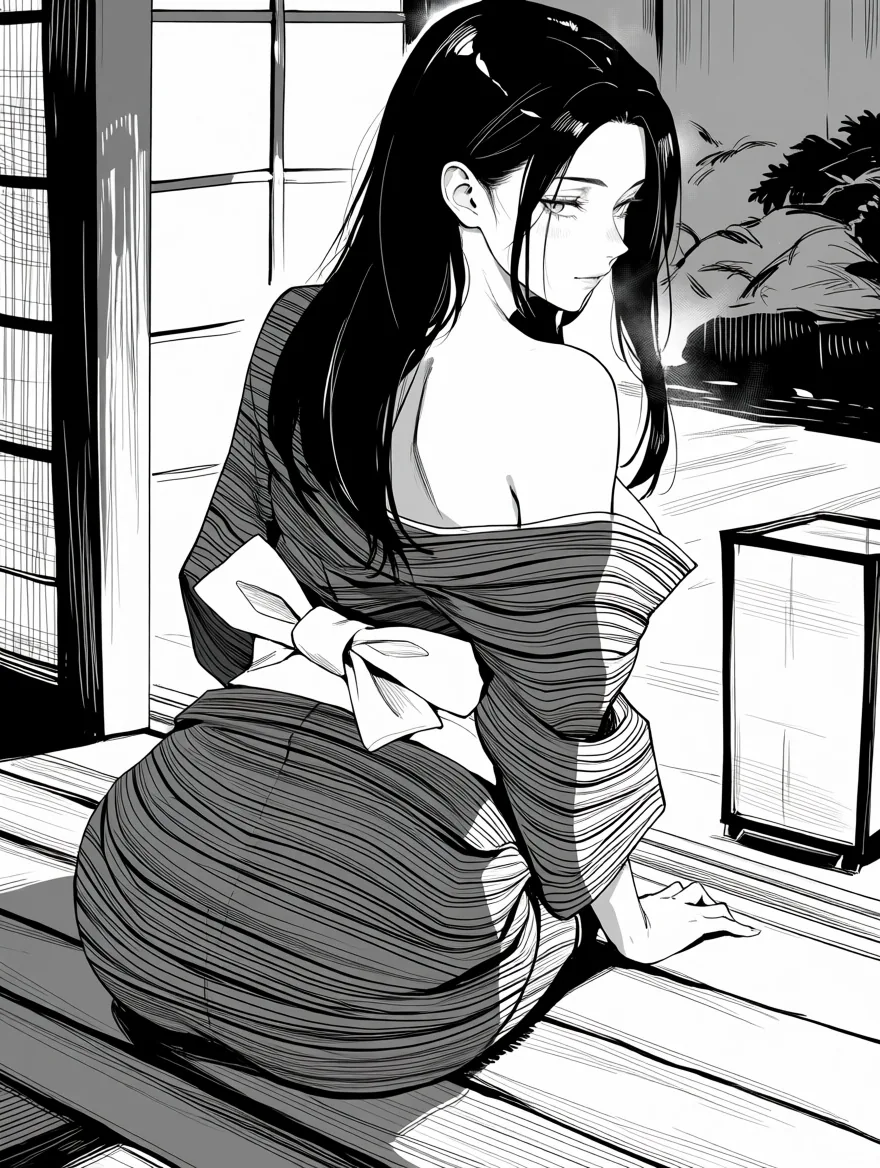
LoRA monochrome con scale 1, sensitive, 3:4, 1k, con monochrome, greyscale, screentone nel prompt.
Lo scale è la manopola che conta. Con un solo prompt e un solo seed e il LoRA PC-98, abbiamo confrontato 0.5, 1, 1.5 e 4 (da sinistra a destra qui sotto). 0.5 è un tocco leggero, 1 è lo stile pieno, 1.5 spinge di più e 4 ha disgregato l’immagine in forme astratte. Uno scale di 0 è identico a nessun LoRA.
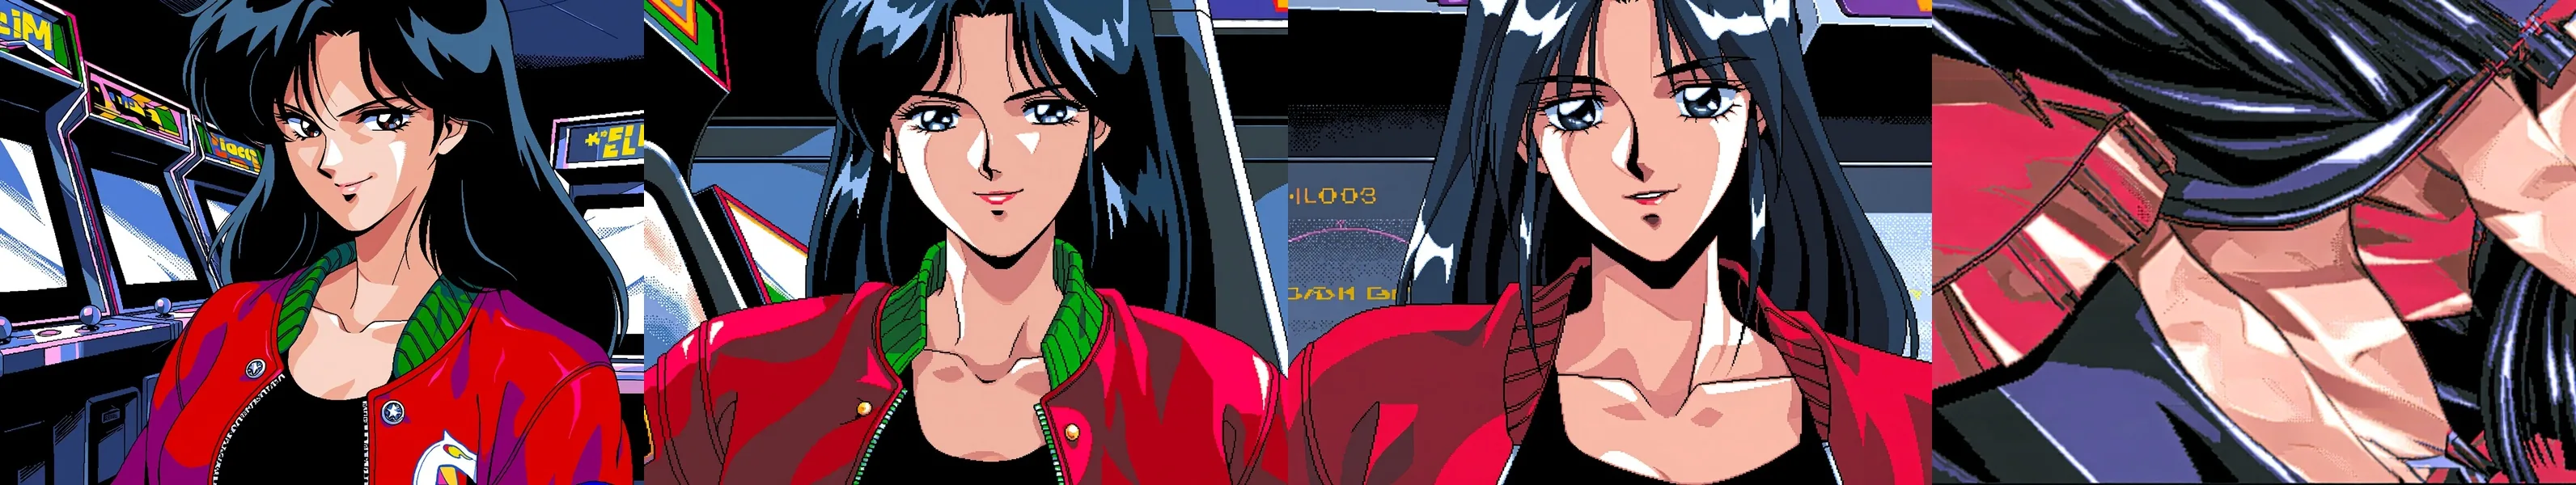
LoRA PC-98 a 0.5, 1, 1.5 e 4 (da sinistra a destra), stesso prompt e stesso seed.
| Situazione | Cosa consigliamo |
|---|---|
| Primo tentativo con qualsiasi LoRA | Scale 1 con le trigger word |
| Lo stile combatte con il personaggio | Scendi a 0.5–0.8 |
| Lo vuoi più forte | 1.2, non 4 |
| Due o tre LoRA | Stile principale a 1, gli altri a 0.6 e 0.25 (ha funzionato per noi) |
| Un LoRA per un altro modello di base | Si carica senza errori e non cambia nulla, quindi controlla per cosa è stato addestrato |
La prima richiesta con un LoRA nuovo può essere lenta mentre il file viene scaricato (una delle nostre ha impiegato quasi tre minuti). Un link che richiede un login, o che punta a una pagina di repository invece che al file, fallisce con un messaggio chiaro e non viene addebitato. La nostra guida agli stili LoRA, più approfondita, passa in rassegna altre combinazioni.
Passo 5: trasforma una foto o uno schizzo in anime
Invia il tuo riferimento come image_url, descrivi ciò che contiene già e imposta strength a 0.75. L’immagine in immagine sulla pagina di modifica accetta prompt, image_url, strength (da 0 a 1, predefinito 0.8), resolution e seed. Non c’è un campo per le proporzioni: l’output mantiene la forma dell’origine. Costa quanto il testo a immagine.
Nella nostra scala di strength su una foto, 0.3 era ancora una foto, 0.6 si leggeva già come un’illustrazione, 0.75 era anime pulito con la stessa composizione, da 0.9 i dettagli cominciavano a cambiare e a 1.0 l’origine veniva ignorata. A 0 l’origine torna intatta. La nostra guida alla strength dedicata mostra l’intera scala.
Le immagini «prima» qui sotto sono fotografie di origine che abbiamo generato per il test con GPT Image 2.5: adulti fittizi, non persone reali. Sono input, non output di Anima.
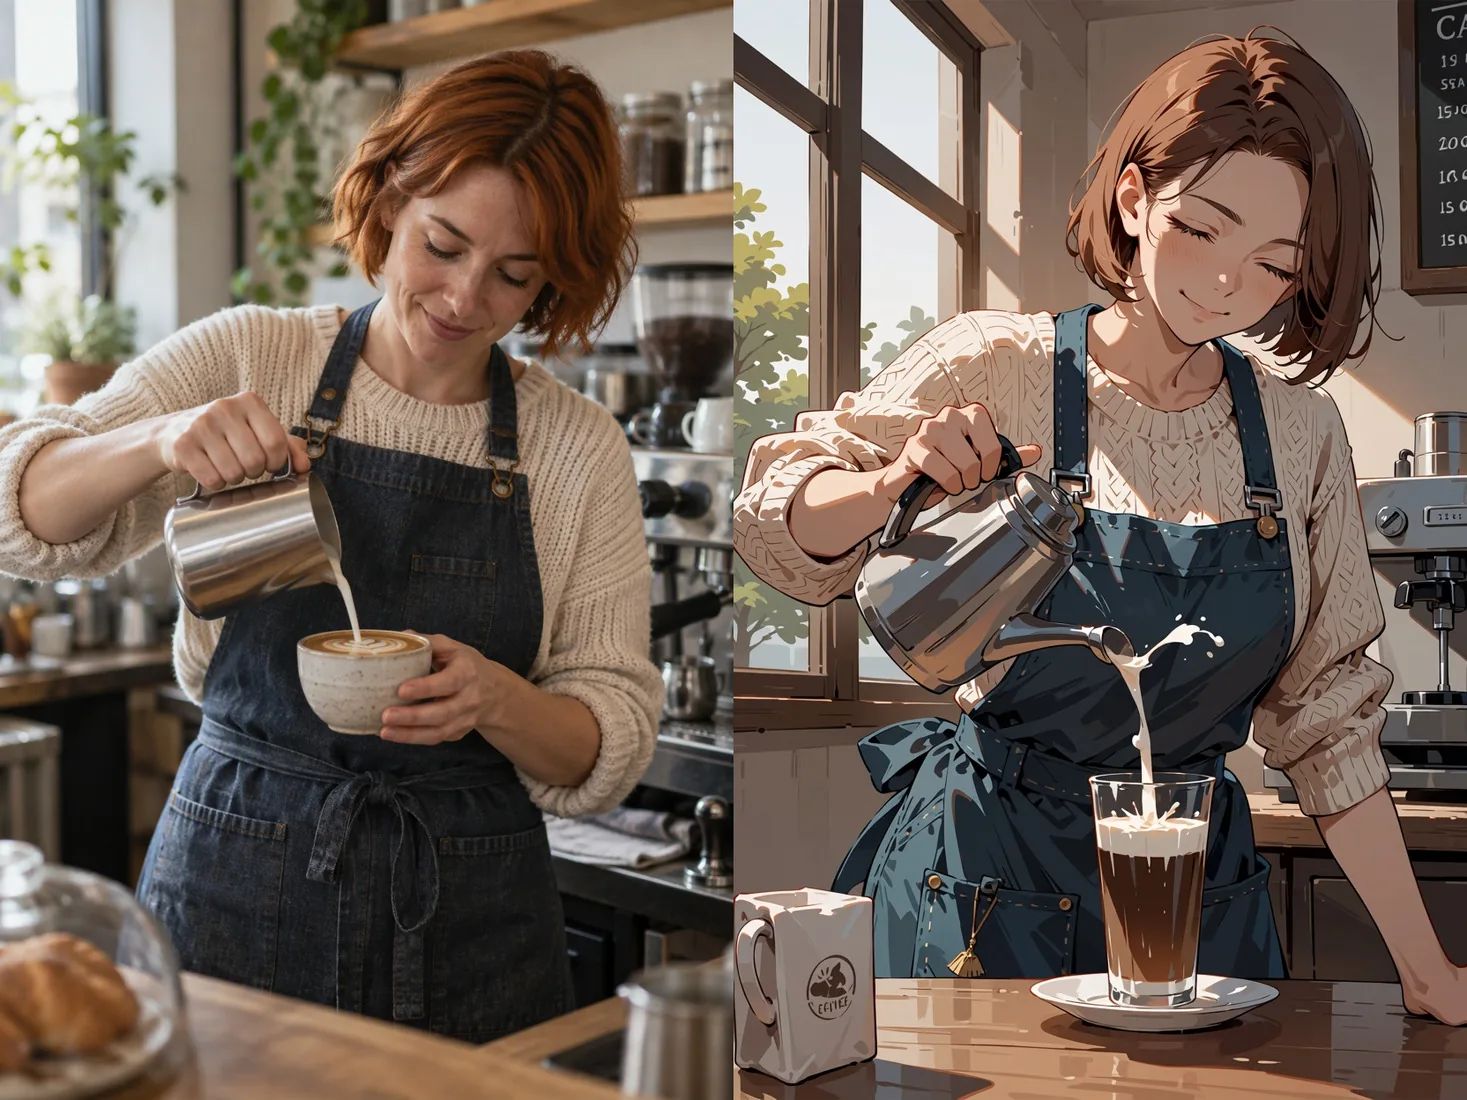
Prima (a sinistra, foto di origine) e dopo (a destra, Anima Turbo con strength 0.75). L’inquadratura si è spostata un poco: il modello ridisegna i dettagli, non li ricalca.
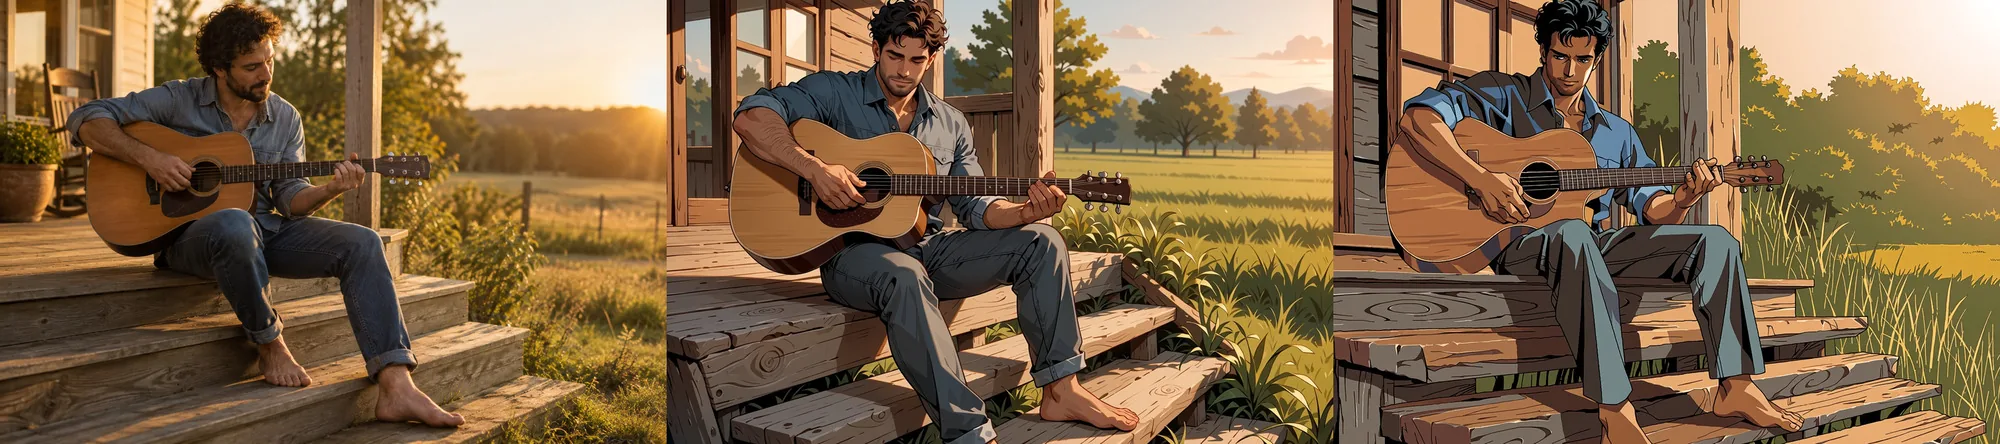
Prima (a sinistra), anime a 0.75 (al centro) e anime con il LoRA PC-98 a 0.75 (a destra). In entrambi la composizione resta vicina all’origine.
L’immagine in immagine ridisegna nello stile; non segue istruzioni di modifica (chiedere a un’illustrazione un nuovo abito ha cambiato pochissimo tra 0.6 e 0.8). Un’illustrazione a colori trasformata in inchiostro manga ha richiesto 0.85 nel nostro test, e a quella strength la posa viene ridisegnata. Per uno schizzo, descrivi il suo soggetto, parti da 0.75 e alzala solo se il tratto sopravvive in modo troppo marcato.
Usa solo foto che hai il diritto di usare. Non convertire mai la foto di una persona reale in arte destinata agli adulti senza il suo consenso.
Passo 6 (facoltativo): anima uno still finito
Scegli il tuo still migliore, poi passalo a una famiglia da immagine a video senza censura insieme a un breve prompt. SpicyAPI ne ha tre: Seedance 2.5 Spicy, Wan 2.2 Spicy e MiniMax H3 Spicy. Ognuna accetta un’immagine più un prompt e restituisce un breve video. Non abbiamo eseguito questo passo sulle immagini di questo articolo, quindi lasciamo dettagli come durate e impostazioni alla pagina di ciascun modello.
Finisci prima lo still, perché una mano difettosa nello still è una mano difettosa in ogni fotogramma, e limita il prompt di movimento a una sola azione.
Passo 7: correggi i problemi più comuni
La maggior parte dei difetti ha una correzione in una riga: rilancia il seed, abbassa lo scale del LoRA o regola strength.
| Problema | Causa probabile | Correzione |
|---|---|---|
| Uno scarabocchio simile a una firma o una riga di testo finto in un angolo | Un’abitudine appresa dalle opere d’arte; l’abbiamo vista in circa un’immagine su cinque | Cambia il seed; non c’è un prompt negativo per sopprimerlo; oppure ritaglia |
| Mani o anatomia strane | Normale per i modelli di immagini | Rilancia il seed; tieni le bozze a 1k finché non ne arriva una buona |
| Il personaggio deriva tra le immagini | Troppe clausole cambiate insieme | Riusa il blocco del personaggio, tieni il seed, cambia una clausola |
| Stile troppo forte o l’immagine si disfa | Scale del LoRA troppo alto | Scendi a 0.5–1.2; con scale 4 l’immagine si disgrega |
| Il LoRA non fa nulla | Addestrato per un altro modello di base, o manca la trigger word | Controlla il modello di base e aggiungi le trigger word |
| La foto sembra ancora una foto | strength troppo bassa | Spostati verso 0.75 |
| I dettagli cambiano troppo nell’immagine in immagine | strength troppo alta | Scendi da 0.9 |
Ecco il primo caso: l’angolo di questa scena da caffè ha ottenuto una riga di pseudo-testo.
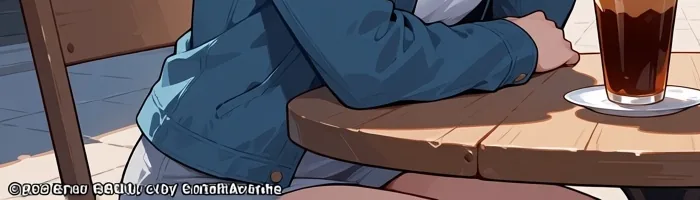
Uno scarabocchio simile a una firma in un angolo (ritaglio di un’immagine 1360 x 768).
I seed rendono confrontabili le esecuzioni ma non garantiscono pixel identici, quindi salva le immagini che ti piacciono.
Passo 8: tieni tutto privato e solo per adulti
Sei responsabile di ciò che generi, conservi e condividi. Ogni personaggio è un adulto e il prompt lo dice; nessuna somiglianza con persone reali senza consenso; mai minori né personaggi dall’aspetto giovanile; tieni i risultati in un archivio che controlli e rispetta le leggi del luogo in cui vivi.
L’intero flusso come lista di controllo
| Fatto? | Controllo |
|---|---|
| ☐ | Blocco del personaggio scritto una volta: tag di qualità, tag di rating, numero di soggetti, indicazione di età, aspetto, un segno |
| ☐ | Tag di rating scelto con consapevolezza (safe o sensitive per tutto ciò che condividi) |
| ☐ | Proporzioni scelte per l’uso; bozza a 1k |
| ☐ | Immagini migliori rifatte a 1.5k |
| ☐ | Il LoRA è compatibile con Anima, trigger word inserite, scale 0.5–1.2 |
| ☐ | Riferimenti fotografici con strength 0.75, il prompt descrive la foto |
| ☐ | Angoli controllati per gli scarabocchi, mani controllate |
| ☐ | Facoltativo: still animato con una famiglia da immagine a video |
| ☐ | Risultati conservati in privato; solo adulti |
Un breve modello di prompt
Compila le parentesi e tieni il resto. Questa versione è una scena vestita con sensitive.
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
[hair], [eyes], [one distinctive mark], [outfit: e.g. black slip dress],
[place and pose: e.g. leaning on a balcony at night], looking at viewer,
[light: e.g. warm lamp light, city lights]
Per due persone usa 1girl, 1boy e una clausola di abbigliamento ciascuna; per uno stile, aggiungi le trigger word del LoRA. Per saperne di più, vedi il nostro rapporto di test su Anima Turbo e, per un panorama più ampio, confronta altri generatori di immagini NSFW.
FAQ
Posso davvero creare arte anime NSFW con l’AI su SpicyAPI?
Sì. Anima Turbo e Anima Turbo LoRA sono senza censura, senza alcun filtro sui contenuti, e abbiamo visto zero rifiuti su quattro livelli di contenuto. Resti responsabile di ciò che crei.
Qual è il modo migliore per ottenere un personaggio coerente?
Scrivi un unico blocco di tag per volto, capelli e un segno distintivo, incollalo in ogni prompt e tieni il seed mentre cambi una clausola alla volta. Nel nostro set con il caschetto argento questo ha mantenuto un personaggio in tre abiti.
Quale tag di rating devo usare?
Usa safe per tutto ciò che pensi di condividere e sensitive per scene allusive ma vestite. Il modello conosce anche nsfw e un tag più forte, che l’editore documenta come quelli che tolgono la moderazione. Per una scena vestita, safe e sensitive hanno dato quasi la stessa immagine.
Da quale scale di LoRA devo partire?
Parti da 1 con le trigger word, poi muoviti tra 0.5 e 1.2. Nei nostri test 0.5 era un tocco leggero, 1.5 spingeva di più lo stile e 4 ha disgregato l’immagine.
Quale strength trasforma una foto in anime?
0.75. Nella nostra scala ha dato anime pulito con la composizione intatta. A 0.3 era ancora una foto, da 0.9 i dettagli cominciavano a cambiare e a 1.0 l’origine veniva ignorata.
Perché c’è una firma o del testo finto nell’angolo?
Il modello l’ha appreso dalle opere d’arte. L’abbiamo vista in circa un’immagine su cinque e un prompt negativo non può sopprimerla perché non esiste. Cambia il seed o ritaglia l’angolo.
Posso trasformare un’immagine finita in un video?
Sì, con una famiglia da immagine a video senza censura come Seedance 2.5 Spicy, Wan 2.2 Spicy o MiniMax H3 Spicy. Ognuna accetta un’immagine e un prompt e restituisce una breve clip. Controlla la pagina del modello per sapere cosa accetta ciascuna.
Posso usare la foto di una persona reale?
Non senza il consenso di quella persona, e non per arte destinata agli adulti. Usa personaggi fittizi o i tuoi schizzi originali e foto di adulti consenzienti, e tieni privati i risultati.