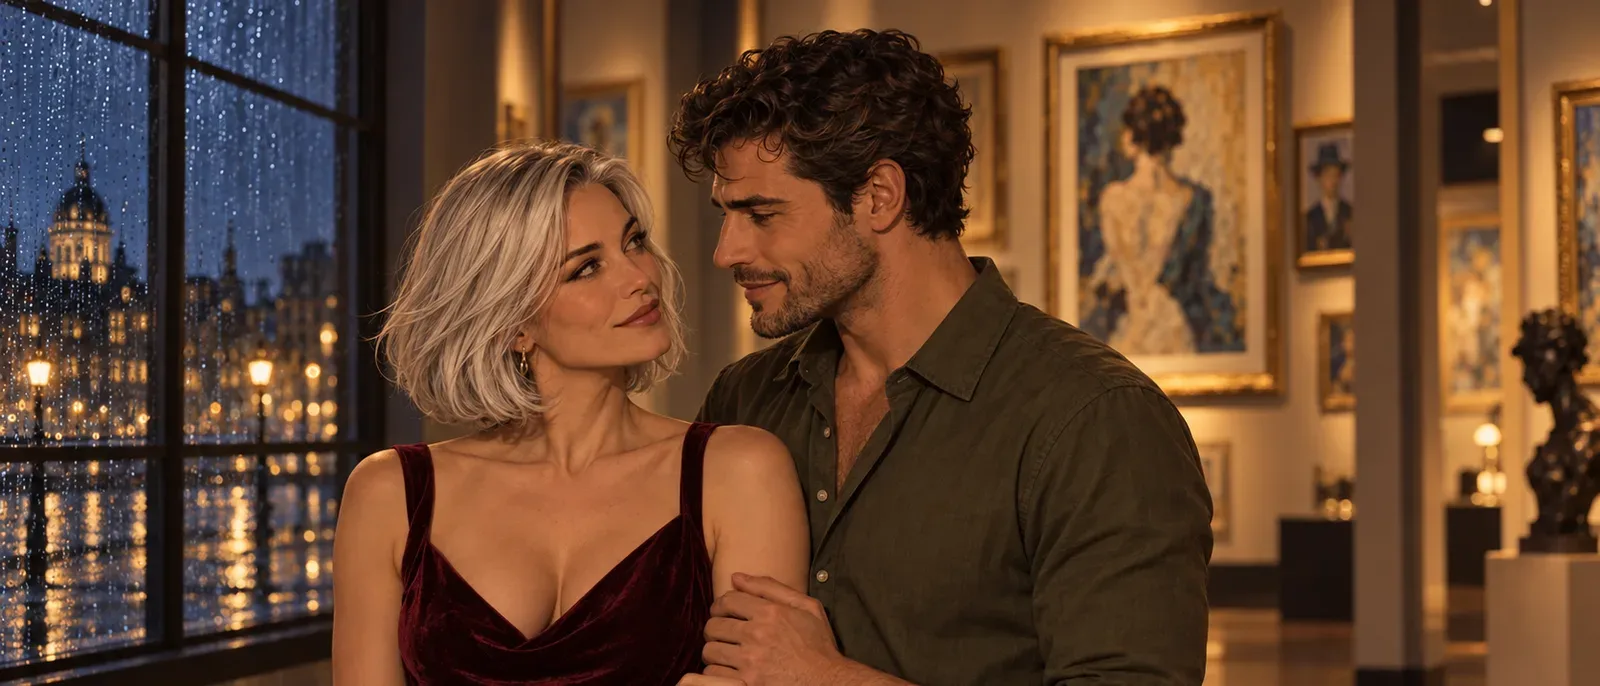
Anima Turbo è un modello anime e di illustrazione piccolo e veloce, che premia un prompt a tag pulito e legge anche le frasi semplici. Nei nostri test ha completato la maggior parte delle immagini in meno di dieci secondi, ha seguito con chiarezza i tag di stile ed è rimasto senza censura: il nostro prompt di prova più spinto è stato generato come scritto al primo colpo. I suoi limiti sono altrettanto netti. Non fa fotorealismo, rende solo una parola o due di testo e non ha un prompt negativo.
Anima Turbo è la versione distillata di Anima di CircleStone Labs, un modello da 2 miliardi di parametri basato su NVIDIA Cosmos-Predict2 con un encoder di testo Qwen3. Abbiamo eseguito questi test il 5 ottobre 2026 tramite l’endpoint testo in immagine di Anima Turbo. Ogni prompt qui sotto è una scena di tutti i giorni con adulti vestiti.
In breve
| Anima Turbo (testato il 5 ottobre 2026) | |
|---|---|
| Editore e base | CircleStone Labs con Comfy Org; 2 miliardi di parametri su NVIDIA Cosmos-Predict2 (2B), encoder di testo Qwen3 |
| Nomi dei modelli API | circlestone-labs/anima-turbo/text-to-image e circlestone-labs/anima-turbo/edit |
| Campi pubblici (testo in immagine) | prompt (fino a 5.000 caratteri), aspect_ratio, resolution, seed |
| Proporzioni | 15, da 1:1 e 16:9 a 21:9 e 1:3 |
| Livelli di risoluzione | 1k (circa 1 megapixel, per esempio 1360 x 768 in 16:9) e 1.5k (circa 2,4 megapixel, per esempio 2048 x 1152, generato in modo nativo) |
| Velocità nei nostri test | Da 2 a 16 secondi per immagine su 60 esecuzioni; 52 su 60 in meno di 10 secondi |
| Output | Un JPEG per richiesta |
| Politica sui contenuti | Senza censura, nessun filtro sui contenuti; il nostro prompt di prova più spinto è stato generato come scritto al primo colpo |
| Cosa non sa fare | Fotorealismo, più di una parola o due di testo, prompt negativi, passi, CFG, sampler, maschere |
Cos’è Anima Turbo
Anima nasce da CircleStone Labs, realizzato insieme a Comfy Org. È un modello da 2 miliardi di parametri basato su Cosmos-Predict2 (2B) di NVIDIA, con un encoder di testo Qwen3. L’editore pubblica tre versioni: Base, Aesthetic e Turbo. Turbo è quella distillata, pensata per 8-12 passi di campionamento. Secondo l’editore è solo leggermente peggiore di Anima-Aesthetic in media, ma molto più veloce, e consiglia di iniziare da lì. Sempre secondo l’editore, i dati di addestramento sono diversi milioni di immagini anime più circa 800.000 immagini artistiche non anime, senza dati sintetici. La scheda del modello è su huggingface.co/circlestone-labs/Anima.
Su SpicyAPI il modello è pubblico come circlestone-labs/anima-turbo/text-to-image. La piattaforma non aggiunge alcun filtro sui contenuti, quindi il risultato dipende dal modello e dal tuo prompt. La pagina della famiglia mostra il prezzo attuale per immagine di ogni risoluzione.
Tag o frasi: funzionano entrambi, ma il risultato è diverso
Anima segue le convenzioni dei tag Danbooru. Il consiglio dell’editore, che abbiamo seguito: minuscolo, spazi al posto dei trattini bassi e un ordine fisso, con prima i tag di qualità e di rating, poi il numero di soggetti (1girl, 1boy, no humans), poi personaggio, serie e artista, poi tutto il resto. Un’apertura sicura è masterpiece, best quality, eventualmente con score_7.
Funziona anche il linguaggio naturale. L’editore consiglia almeno due frasi, e abbiamo capito perché: i prompt molto brevi divagano. Abbiamo eseguito due volte la stessa scena di un caffè sotto la pioggia con lo stesso seed, una volta con i tag e una con quattro frasi.
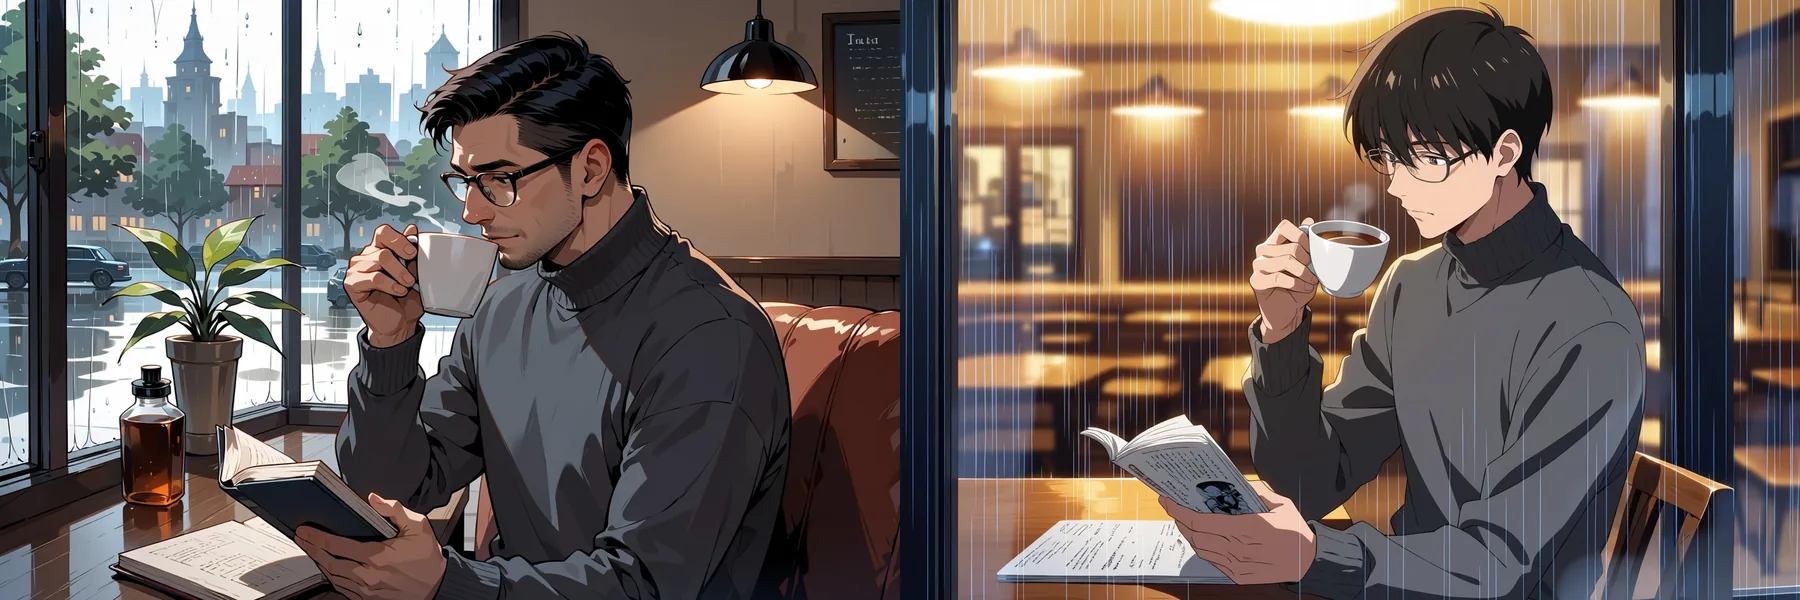
A sinistra: tag. A destra: quattro frasi. Stesso seed (4), 3:2, livello 1k, testo in immagine.
La versione a tag:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyLa versione a frasi:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.Entrambe hanno reso gli occhiali, il dolcevita, la tazza e il libro. Le differenze stanno in ciò che non hai specificato. Il prompt a tag ha dato un volto più maturo e una scena con la finestra luminosa; quello a frasi un volto più giovane e un ambiente più cupo. Nei nostri test i tag danno un controllo più preciso sul personaggio, mentre le frasi regalano più atmosfera senza sforzo. Anche mescolare i due, con un’intestazione di tag e una o due frasi descrittive, ha funzionato.
Quando usare cosa, in base alle nostre prove e ai consigli dell’editore:
| Situazione | Scelta migliore | Perché |
|---|---|---|
| Ti serve l’aspetto preciso di un personaggio (capelli, occhiali, abiti) | Tag | Ogni tag è un’istruzione separata, quindi i dettagli restano al loro posto |
| Vuoi un’atmosfera, una luce o una scena che “dia” una certa sensazione | Frasi | La versione a frasi ci ha dato l’ambiente più cupo senza chiederlo |
| Richiami un artista noto o uno stile riconoscibile | Tag, con @ davanti all’artista | Secondo l’editore, lo stile di un artista senza la @ è debole |
| Confronti seed o piccole modifiche al prompt | Tag | Prompt brevi e fissi rendono facile attribuire un cambiamento |
| Scrivi una breve descrizione | Due o più frasi | L’editore ne consiglia almeno due; i prompt molto brevi divagano |
| Vuoi controllo e atmosfera | Un’intestazione di tag più una o due frasi | Il misto ha funzionato nei nostri test |
Scrivere prompt che reggono
L’ordine qui sotto segue il consiglio dell’editore ed è quello che abbiamo usato per ogni prompt di questo articolo:
- Prima i tag di qualità e di rating.
masterpiece, best quality, eventualmentescore_7, poisafe,sensitiveonsfw. Senza prompt negativo, il tag di rating dà il tono. - Poi il numero di soggetti.
1girl,1boy,1girl, 1boy, oppureno humansper i paesaggi. - Personaggio, serie e artista. Gli artisti vogliono il prefisso
@. - Tutto il resto. Capelli, abbigliamento, luogo, luce, inquadratura. Minuscolo, spazi al posto dei trattini bassi.
- I pesi, quando un tag è troppo debole.
(chibi:2)ha funzionato nel nostro test di stile, ma il modello ha richiesto pesi più alti rispetto ai modelli dell’era SDXL, quindi non fermarti a 1.2.
Il limite del prompt è di 5.000 caratteri, che i prompt a tag raggiungono di rado. Tre abitudini hanno fatto una differenza visibile nelle nostre esecuzioni:
- Inizia con un tag di rating. Il modello conosce
safe,sensitiveensfw, più un altro tag ancora più forte. Senza prompt negativo, il tag di rating è il tuo modo principale per dare il tono, quindi ogni prompt di questo articolo si apre consafe. - Dichiara che i personaggi sono adulti.
adult woman, mature femaleo «un uomo sulla trentina» mantiene il cast dove vuoi tu. - Metti
@davanti ai nomi degli artisti. Secondo l’editore, lo stile di un artista senza la@è debole.
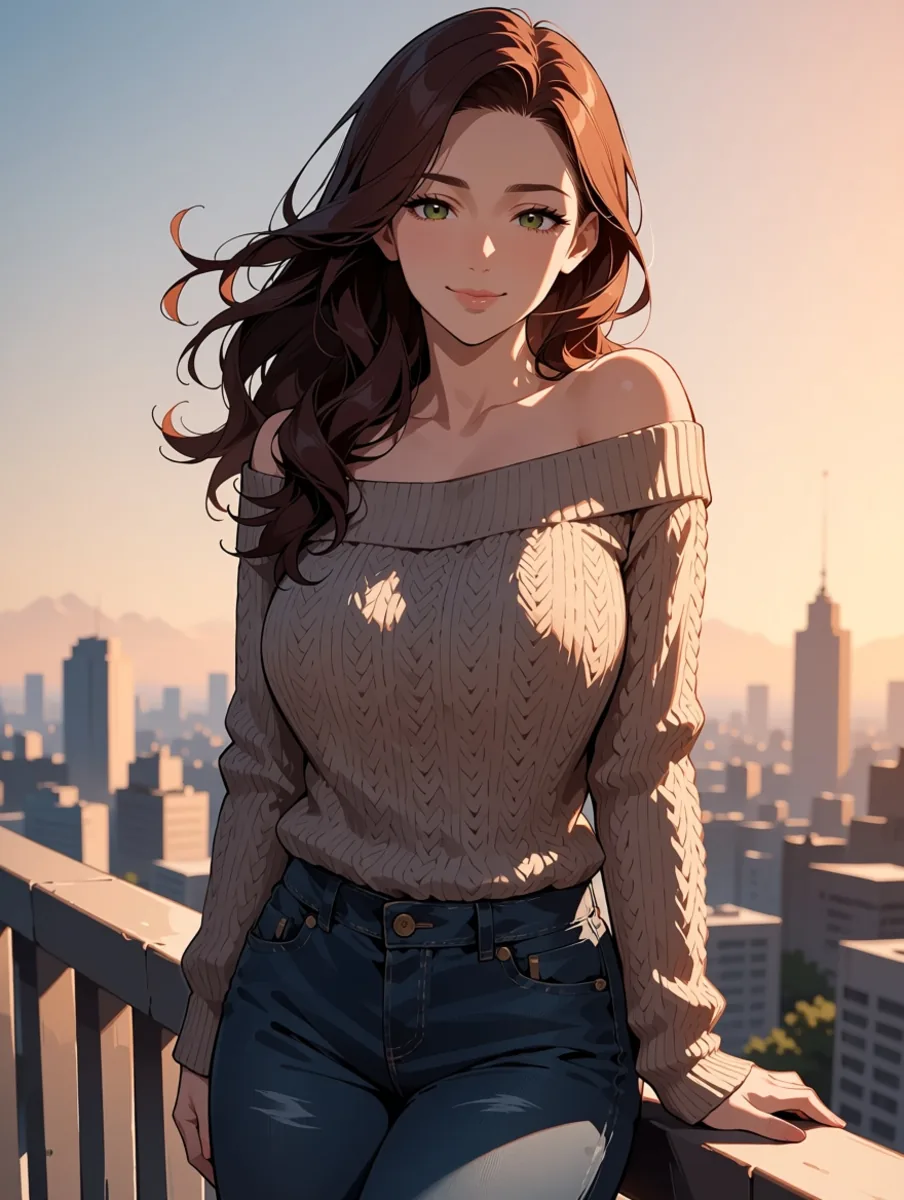
Un prompt di soli tag: tag di rating, numero di soggetti, capelli, abbigliamento, luogo, luce. 3:4, livello 1k, seed 3.
Cosa fanno i tag di stile
Era il test che ci interessava di più. Abbiamo fissato un personaggio (una donna adulta con capelli argentati corti, in trench, su una strada in autunno) e un seed (12), cambiato solo i tag di stile ed eseguito ogni prova in 1:1 sul livello 1k. Il prompt di base:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile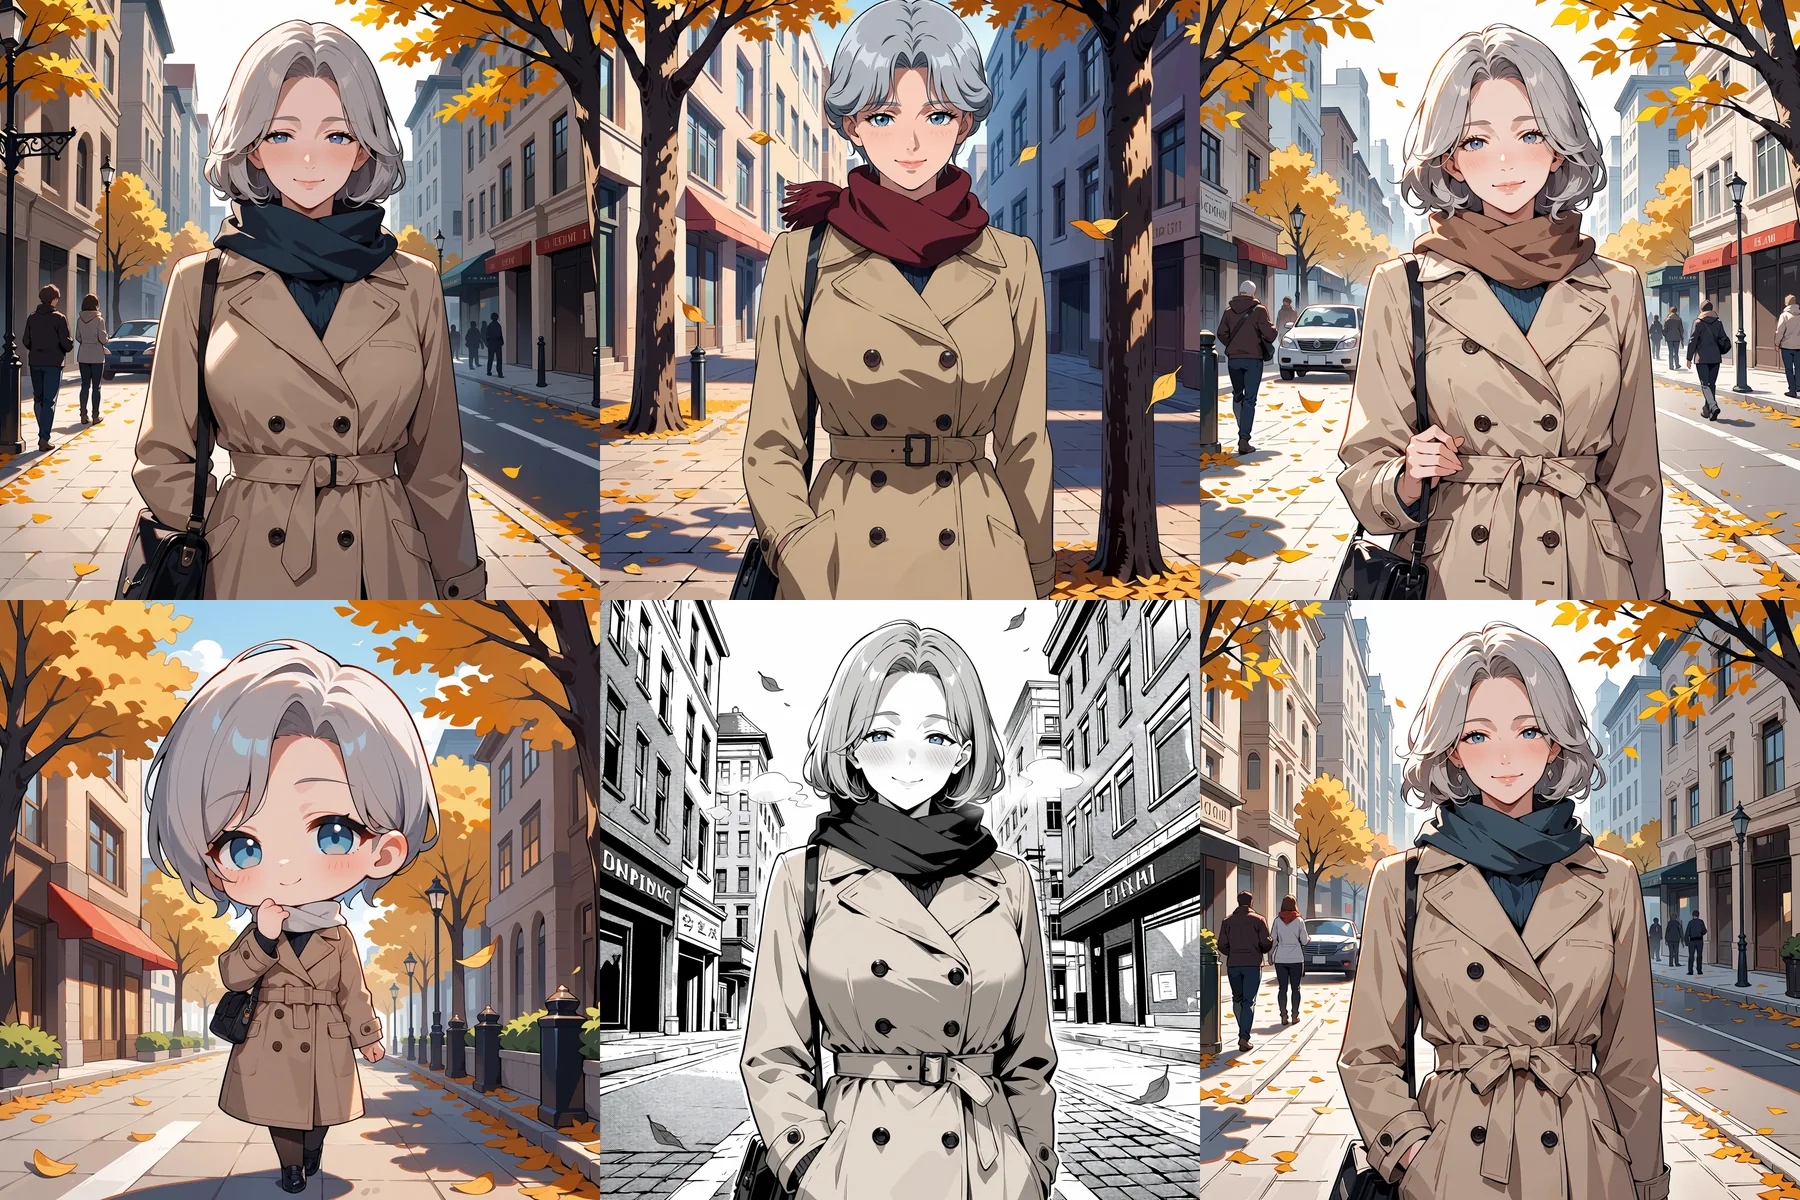
Riga in alto: nessun tag di stile, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Riga in basso: (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Seed 12 in tutte.
Cosa abbiamo visto:
| Tag di stile aggiunti | Risultato nei nostri test |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Un chiaro look cel anni Novanta: colori più piatti, ombre più dure |
(chibi:2) | Un chibi completo, testa grande e corpo piccolo |
monochrome, greyscale, manga, screentone | Una convincente tavola manga in bianco e nero con screentone |
watercolor (medium), traditional media | Solo una lieve variazione nella resa |
sketch, pencil drawing, traditional media | Solo una lieve variazione nella resa |
Gli stili forti sono quelli con un vocabolario visivo riconoscibile: anime cel catturato da schermo, proporzioni chibi, inchiostro da manga. I due tag di tecnica tradizionale hanno ritoccato la superficie e poco altro. Se vuoi un vero look ad acquerello o a matita, aspettati di dover ricorrere a un LoRA di stile invece che a un tag.
Un ultimo dettaglio: la ponderazione dei prompt come (chibi:2) funziona, ma ha richiesto un peso più alto di quello a cui siamo abituati con i modelli dell’era SDXL.
Dimensioni, risoluzione e velocità
Non c’è un campo per la dimensione. Scegli un aspect_ratio tra 15 opzioni (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) e un livello di resolution, 1k o 1.5k, più un seed facoltativo. Il livello 1k è di circa un megapixel; 1.5k è di circa 2,4 megapixel ed è generato in modo nativo, non ingrandito. Un’immagine 16:9 misura 1360 x 768 a 1k e 2048 x 1152 a 1.5k; 1:3 misura 576 x 1760 e 880 x 2048. L’output è sempre JPEG, un’immagine per richiesta. La proporzione non cambia il prezzo, il livello 1.5k costa più di 1k e le richieste fallite non vengono addebitate.
Abbiamo cronometrato 60 esecuzioni che coprivano tutte le proporzioni su entrambi i livelli. Il tempo del modello è stato da 2 a 16 secondi per immagine, e 52 delle 60 si sono concluse in meno di 10 secondi.
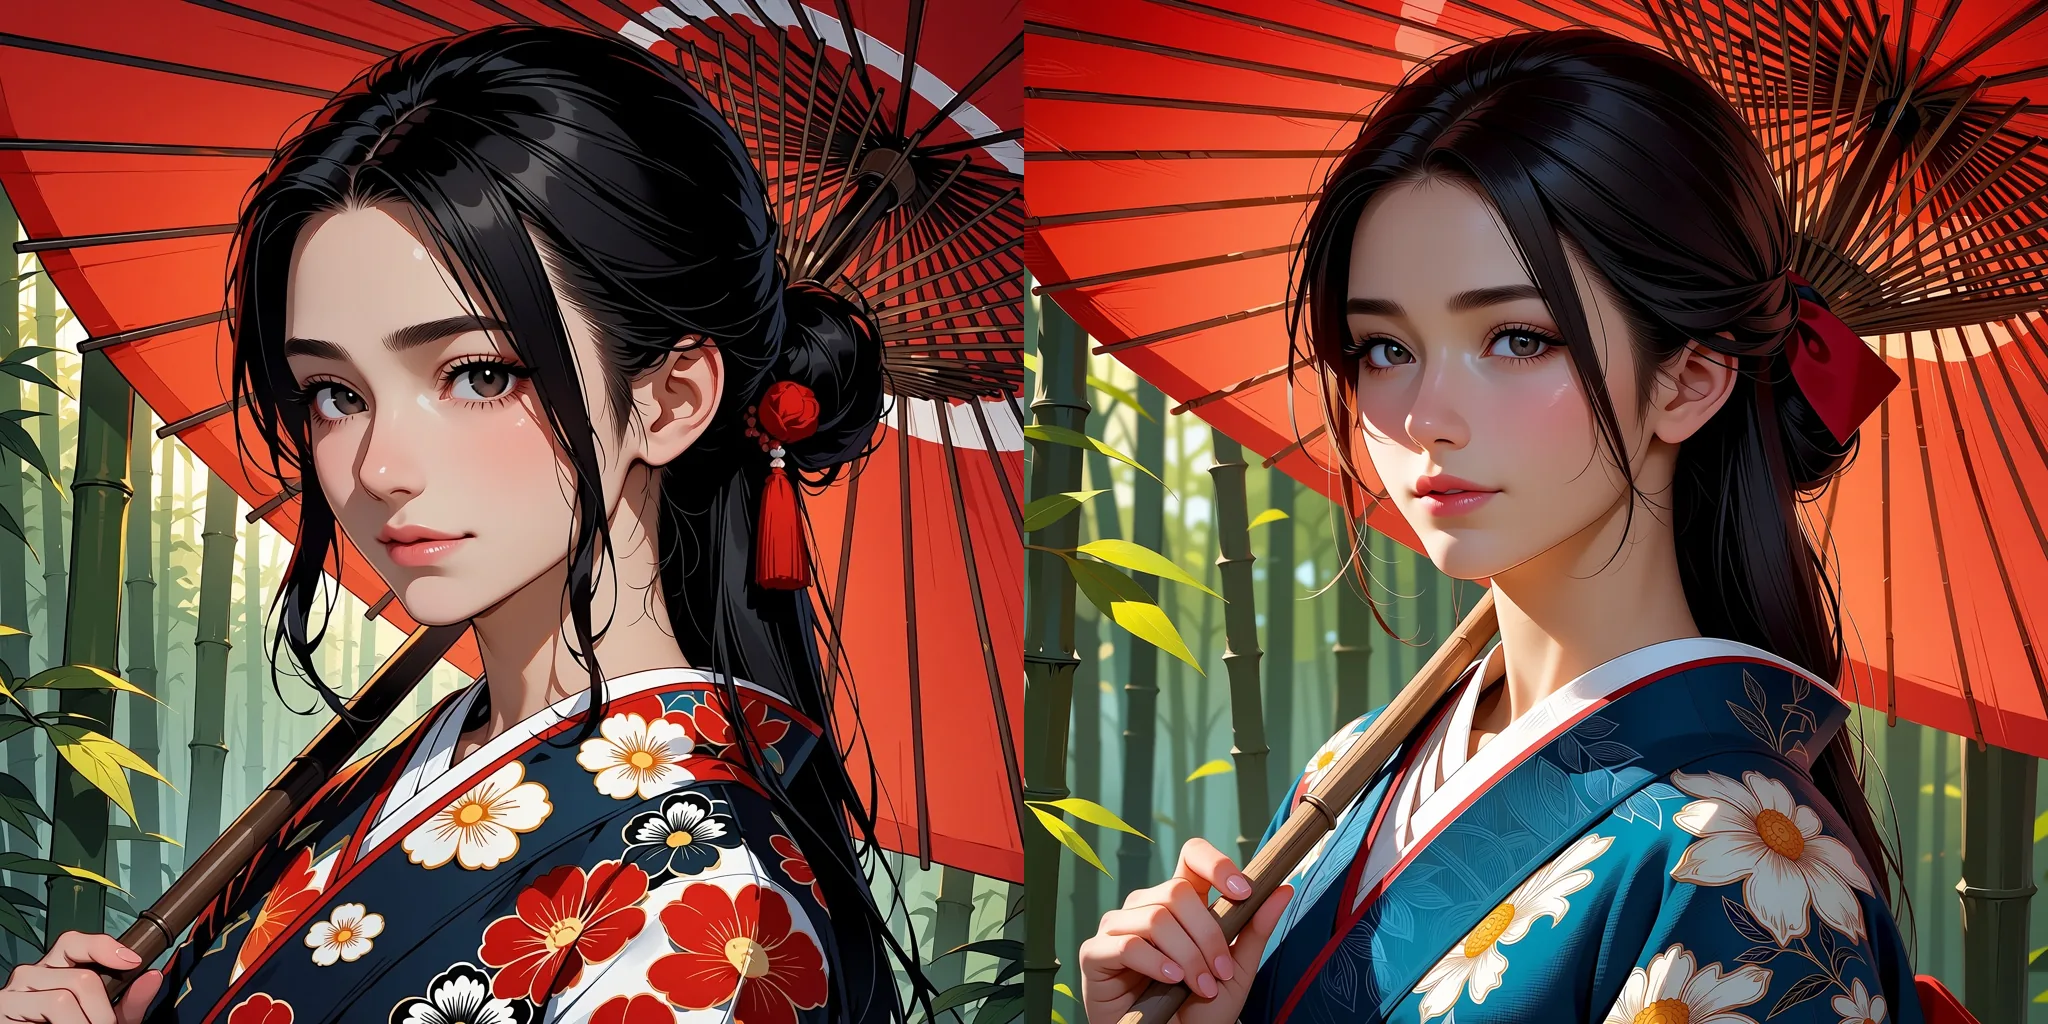
A sinistra: 1k (1024 x 1024). A destra: 1.5k (1536 x 1536). Stesso prompt, seed 8, 1:1.
I due livelli non sono un ingrandimento pixel per pixel. Lo stesso prompt con lo stesso seed ha dato un volto diverso e una fantasia del kimono diversa. Con 1.5k paghi più dettaglio nei tessuti e linee più pulite. Fai le bozze a 1k, poi rilancia quelle buone a 1.5k e trattale come una nuova ripresa, non come una copia più nitida.
Fin dove arriva
L’endpoint è senza censura e la piattaforma non aggiunge alcun filtro sui contenuti. Nei nostri test nemmeno il modello si è tirato indietro: il nostro prompt di prova più spinto è stato generato come scritto al primo colpo, in testo in immagine e in immagine in immagine, con e senza LoRA, su più seed. Quel prompt non lo pubblichiamo; gli esempi qui sotto sono scene di tutti i giorni.
Nelle scene ordinarie il modello se la cava bene soprattutto per varietà. Un unico stile di prompt ha prodotto ritratti, coppie, un barman del turno di notte e paesaggi vuoti:
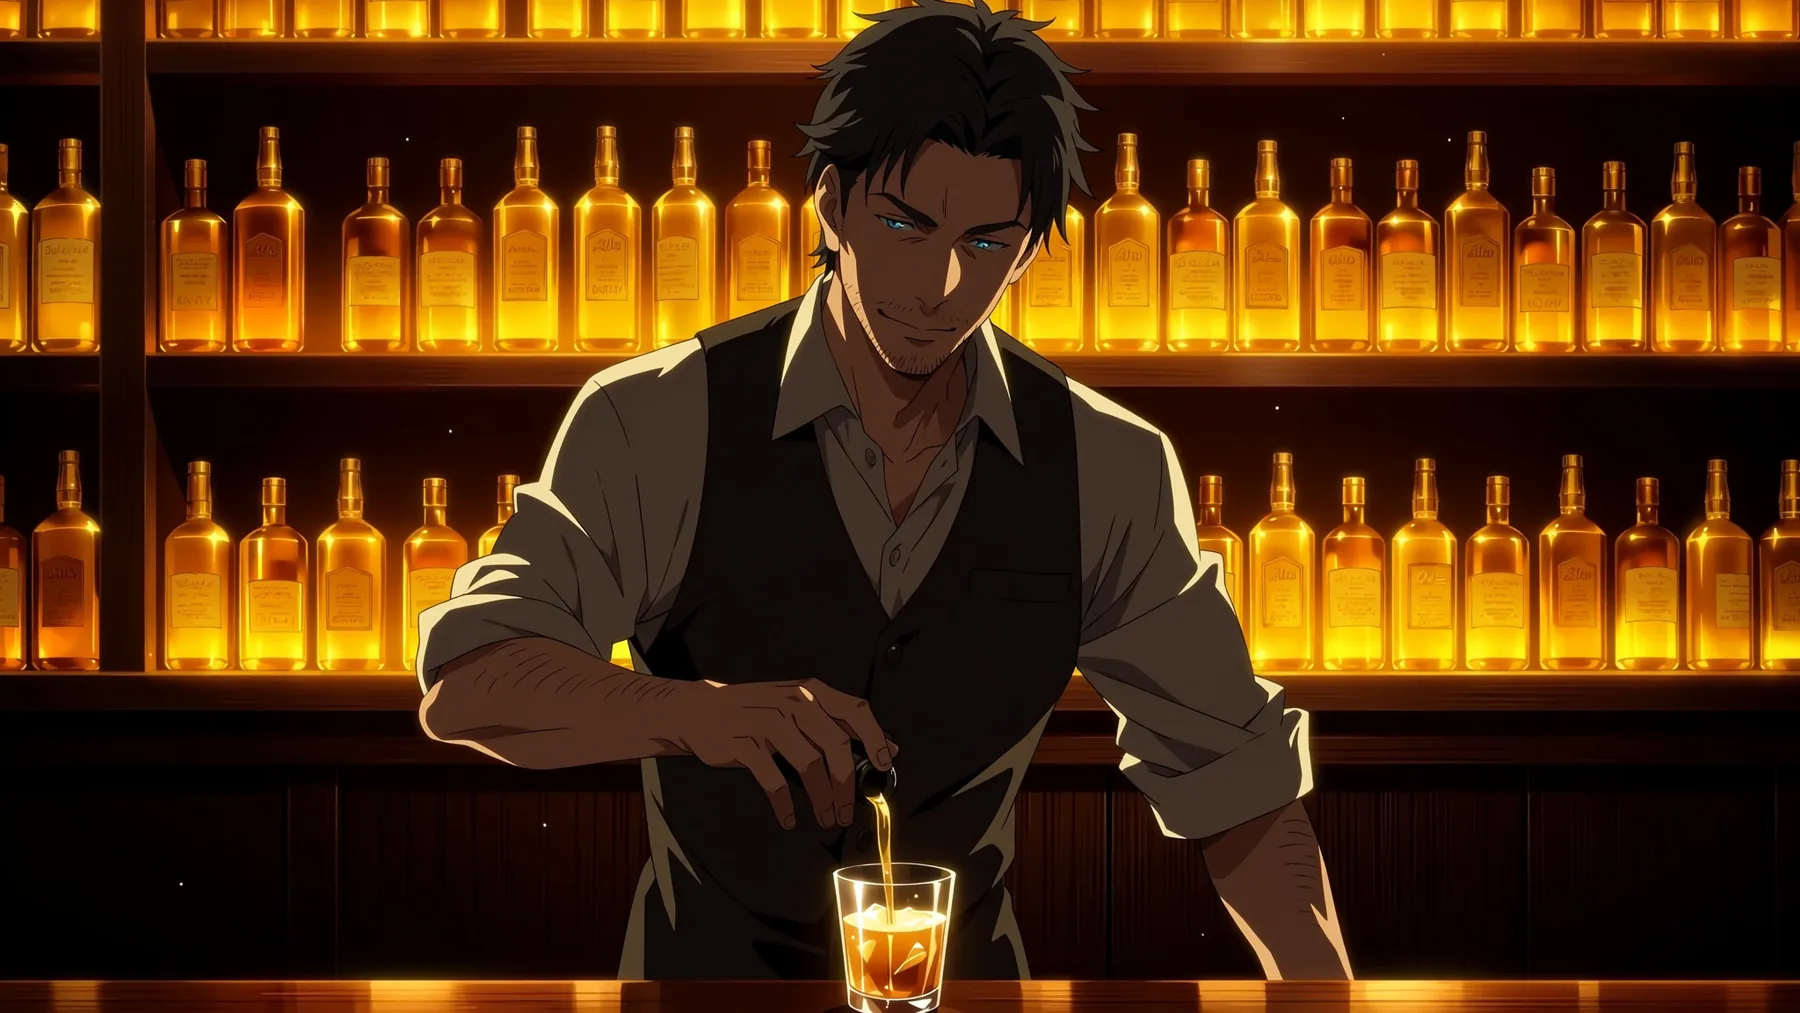
Tre frasi, tag di rating safe, 16:9, livello 1.5k, seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.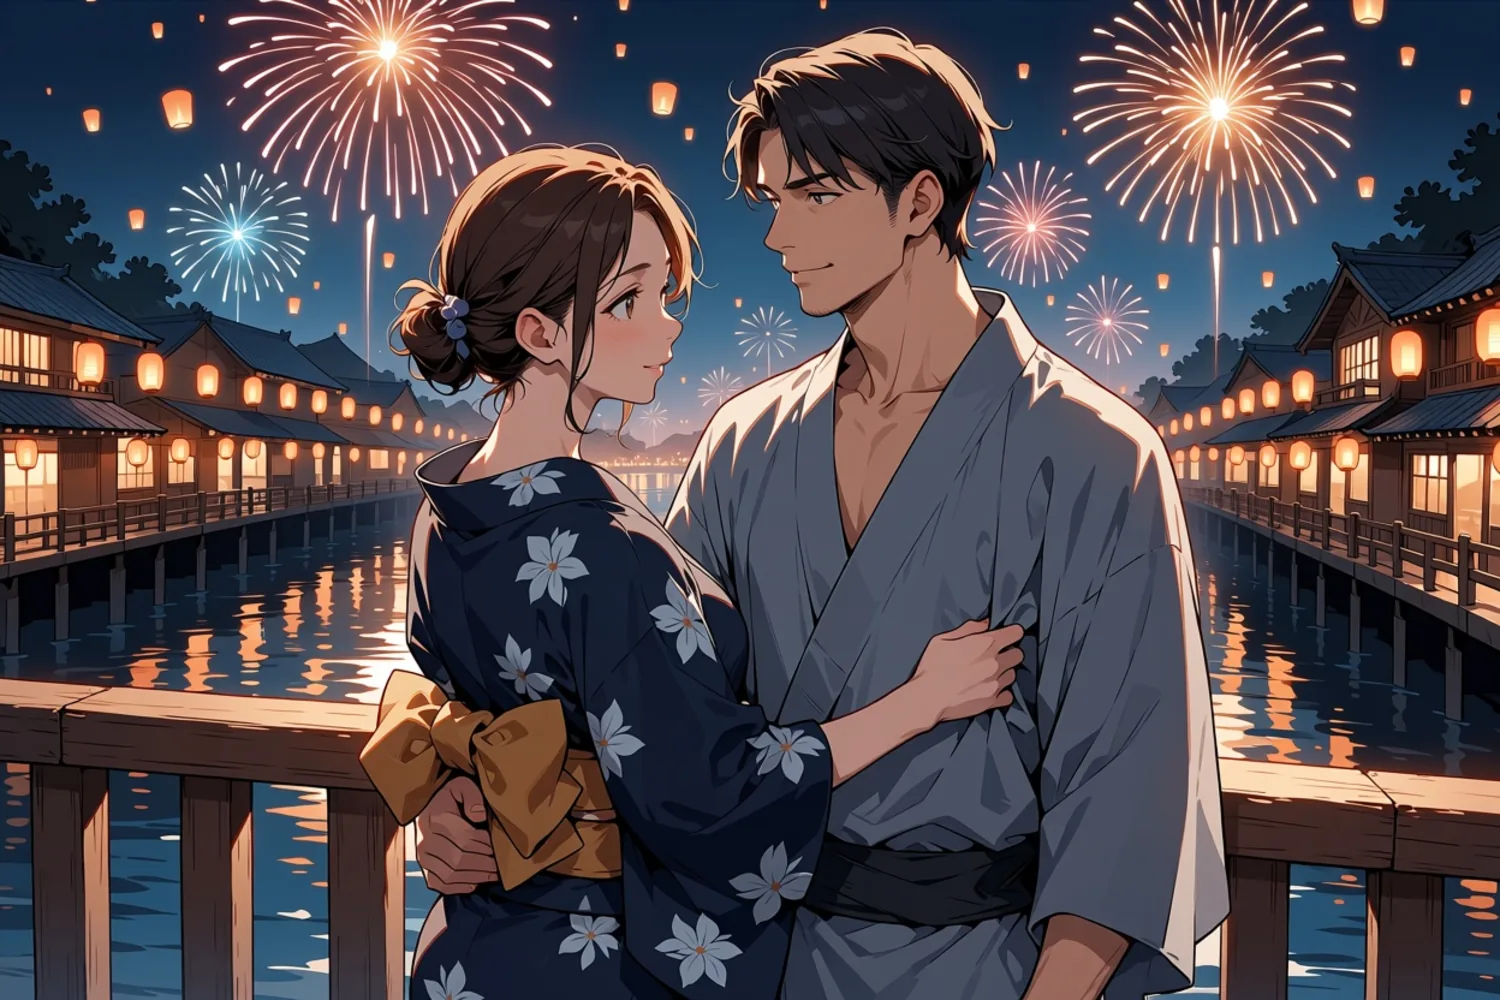
Tag con numero di soggetti 1girl, 1boy, 3:2, livello 1k, seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections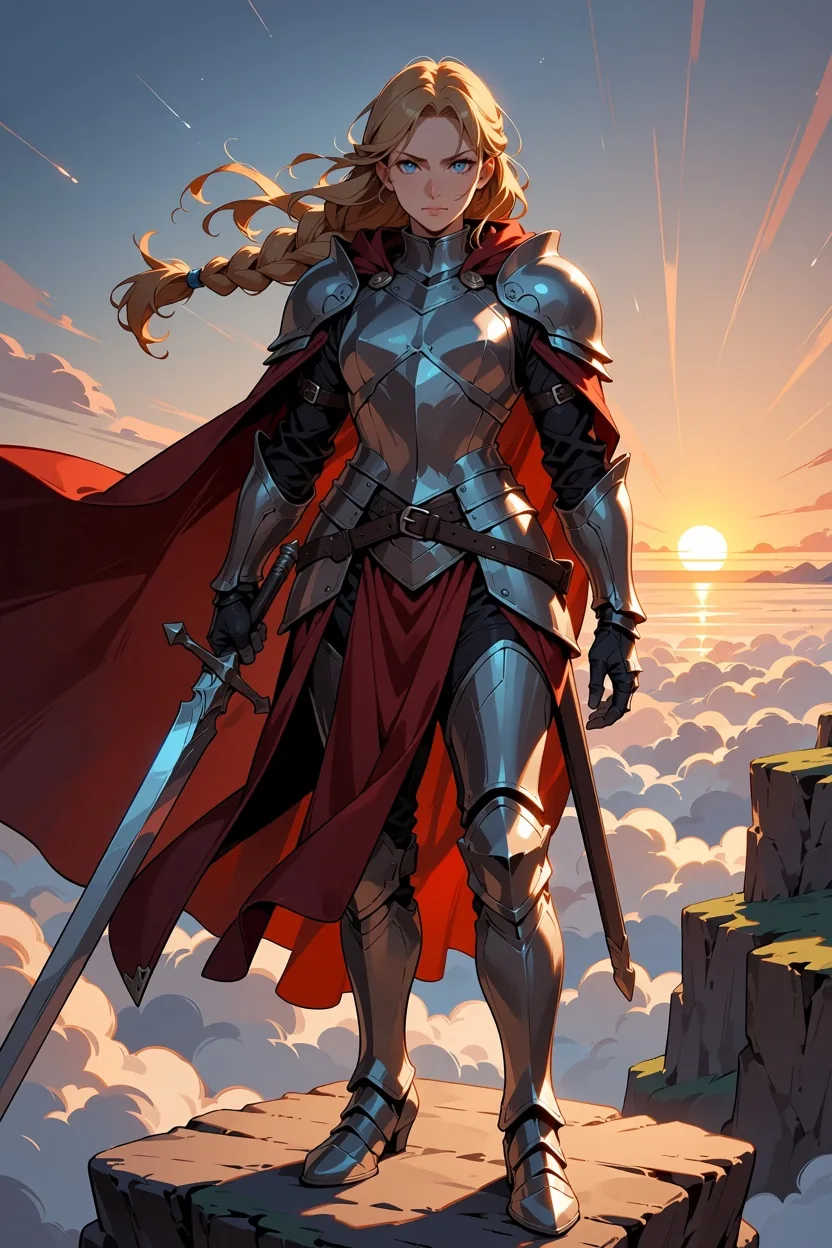
Tag, ritratto 2:3, livello 1k, seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, dopo i soliti tag di qualità, di rating e di numero di soggetti.
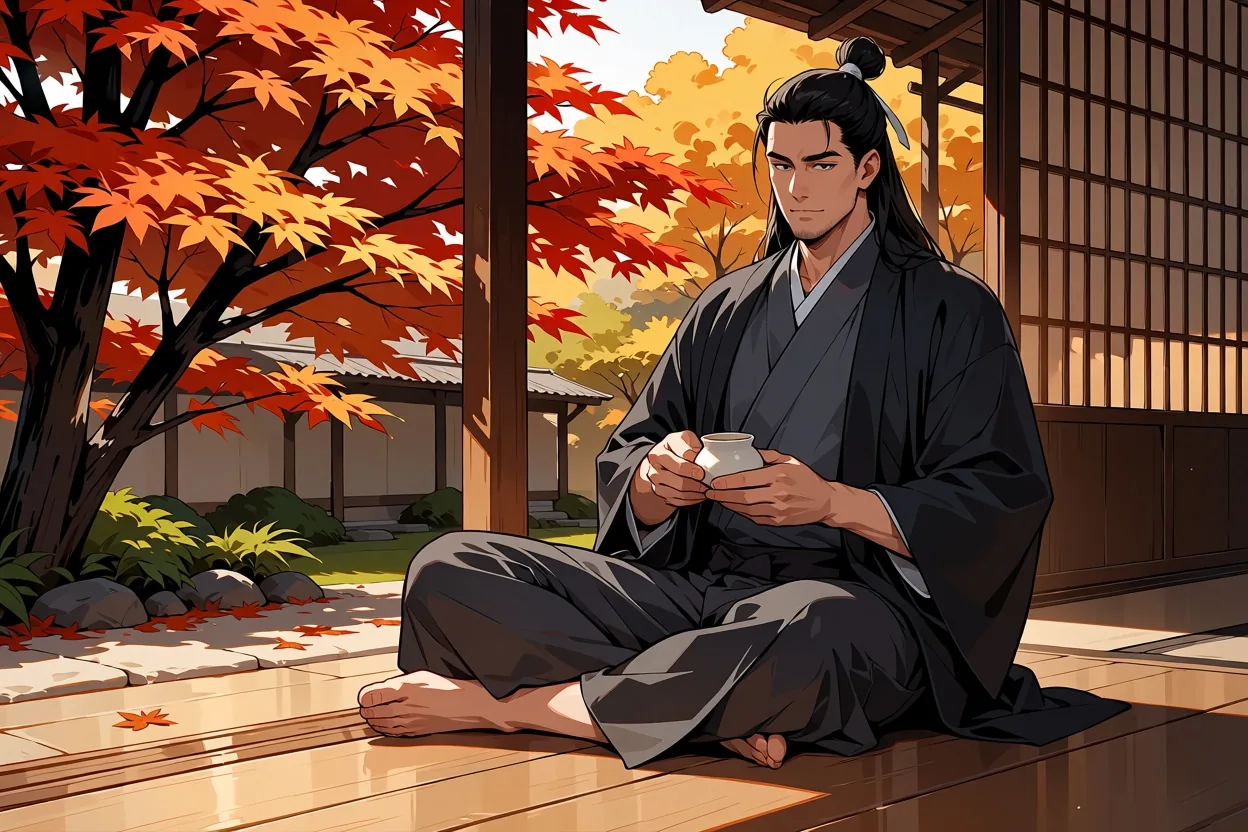
Tag, 3:2, livello 1k, seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
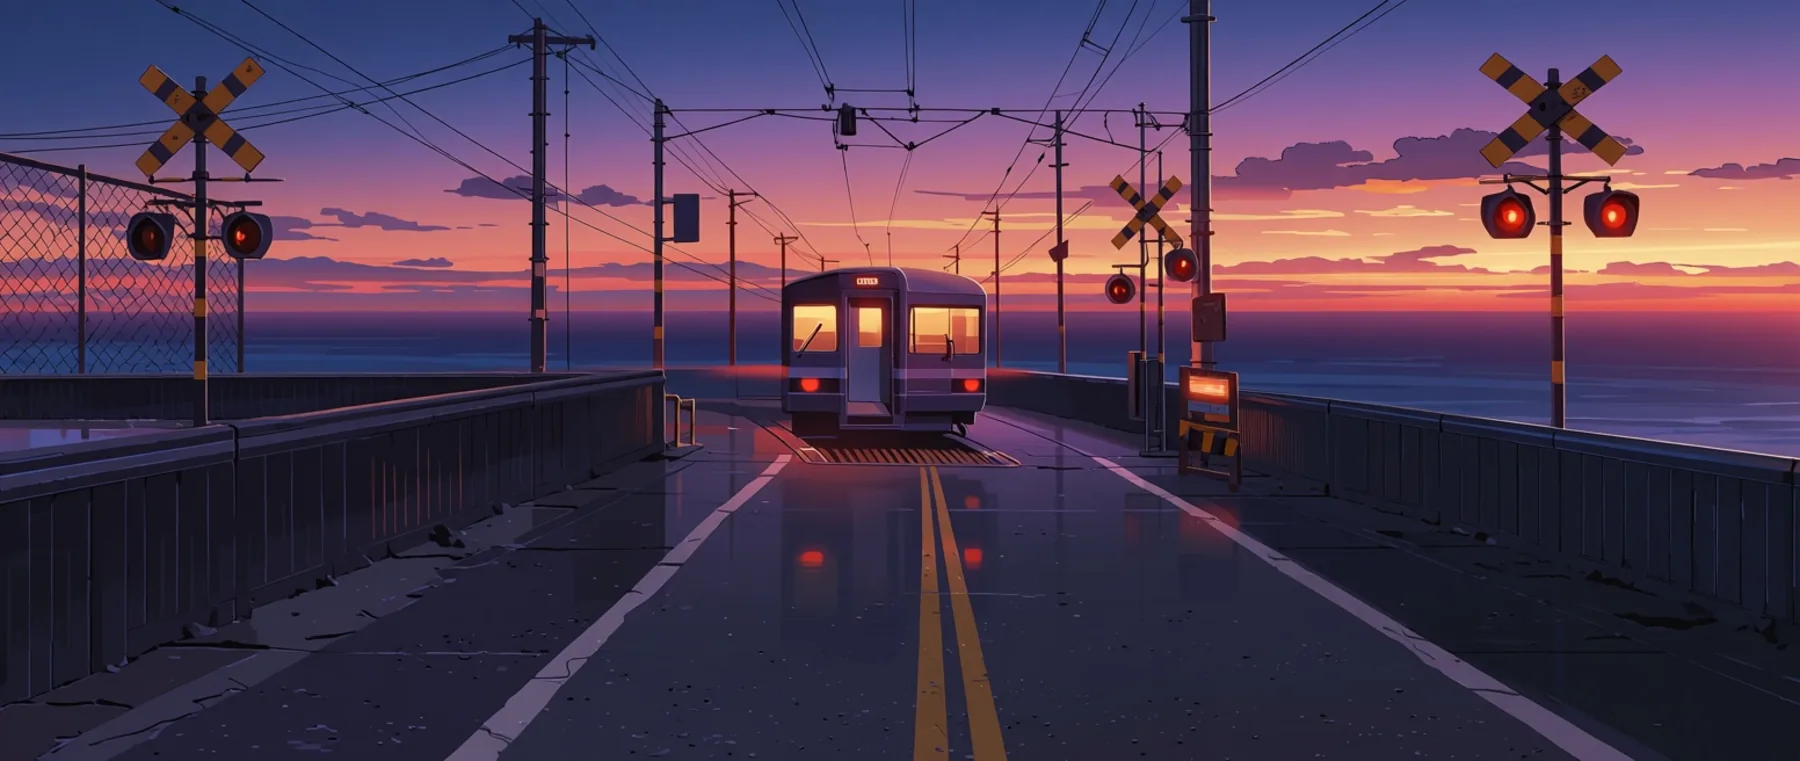
Paesaggio con no humans, 21:9, livello 1k (1552 x 656), seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotReggono bene anche le proporzioni insolite. Il 9:16, un banner alto 1:3 e un campo largo 16:9 sono usciti composti per la propria cornice, non ritagliati da un quadrato:
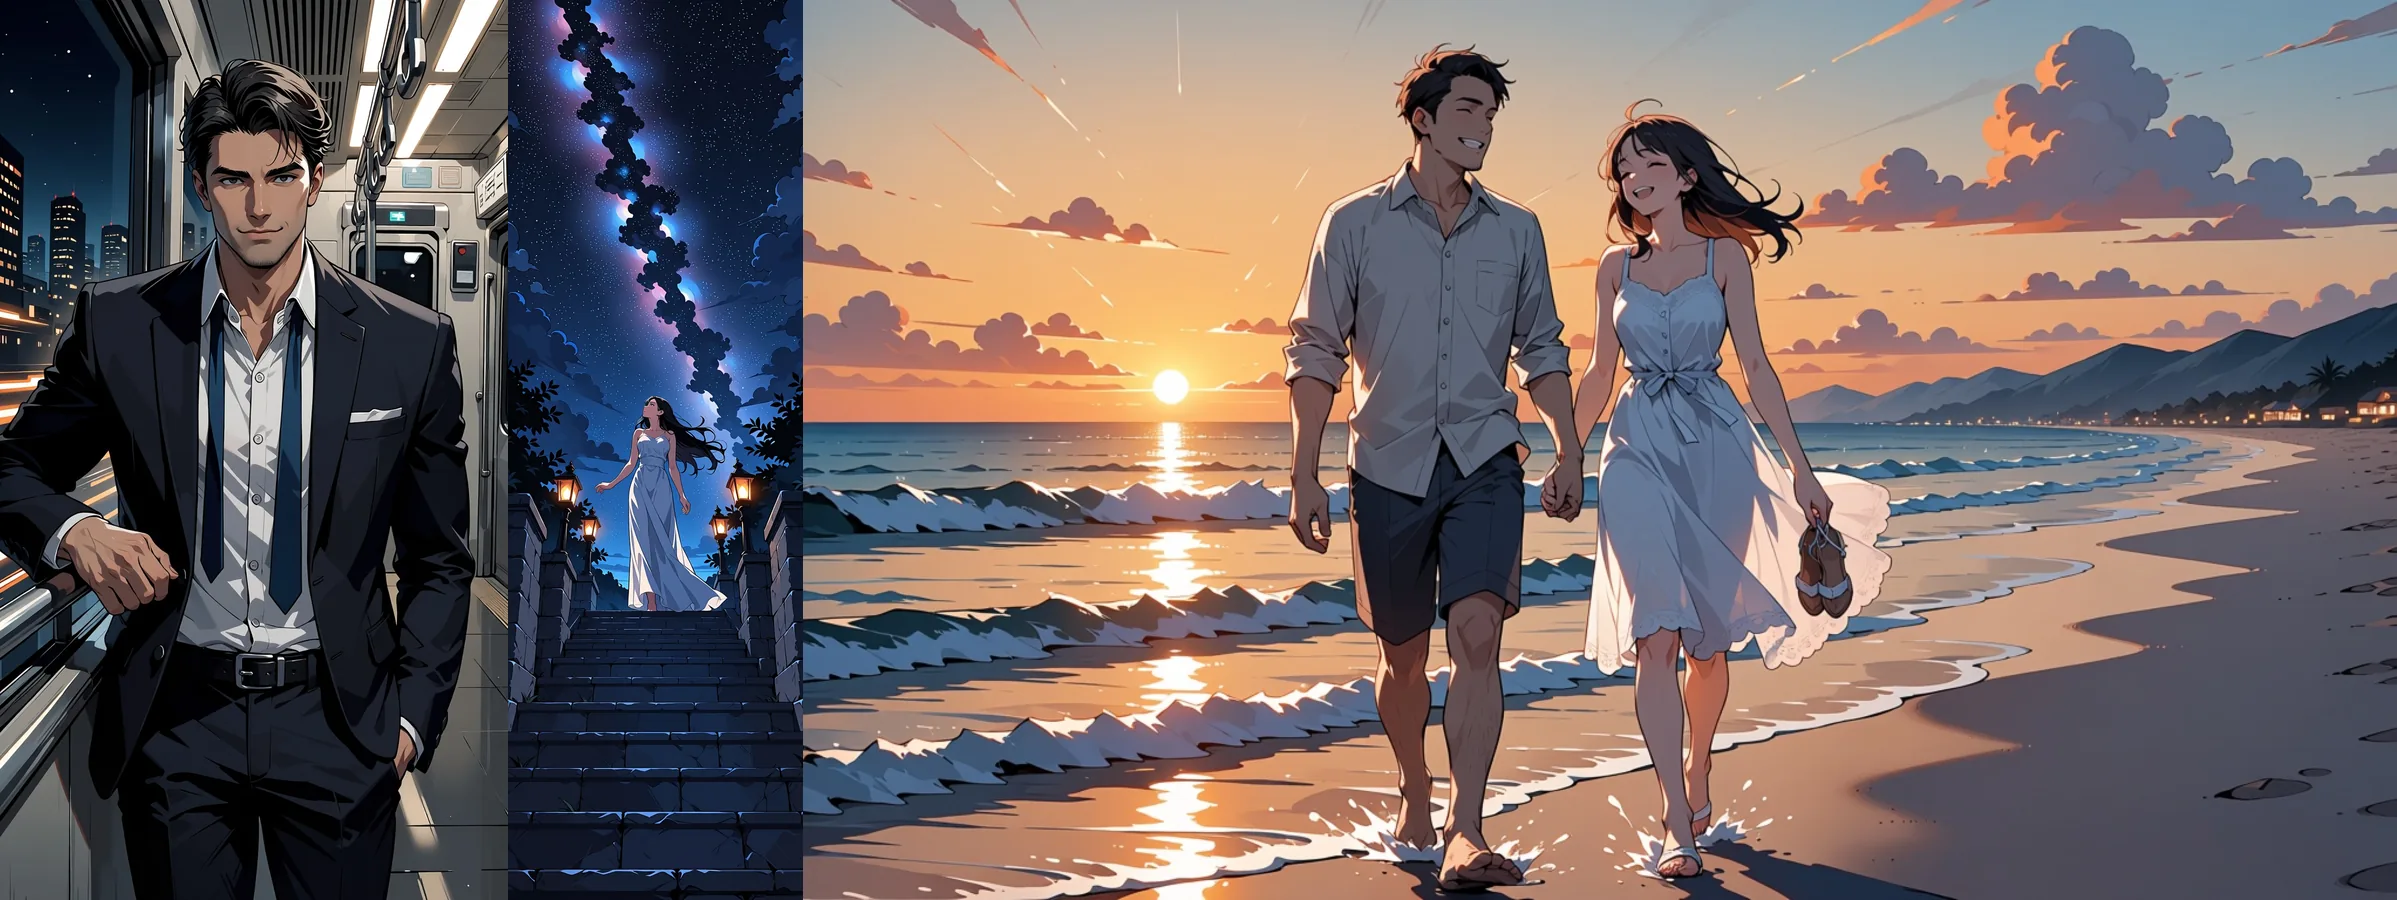
Da sinistra a destra: 9:16, 1:3, 16:9, tutte sul livello 1k, tutte in testo in immagine.
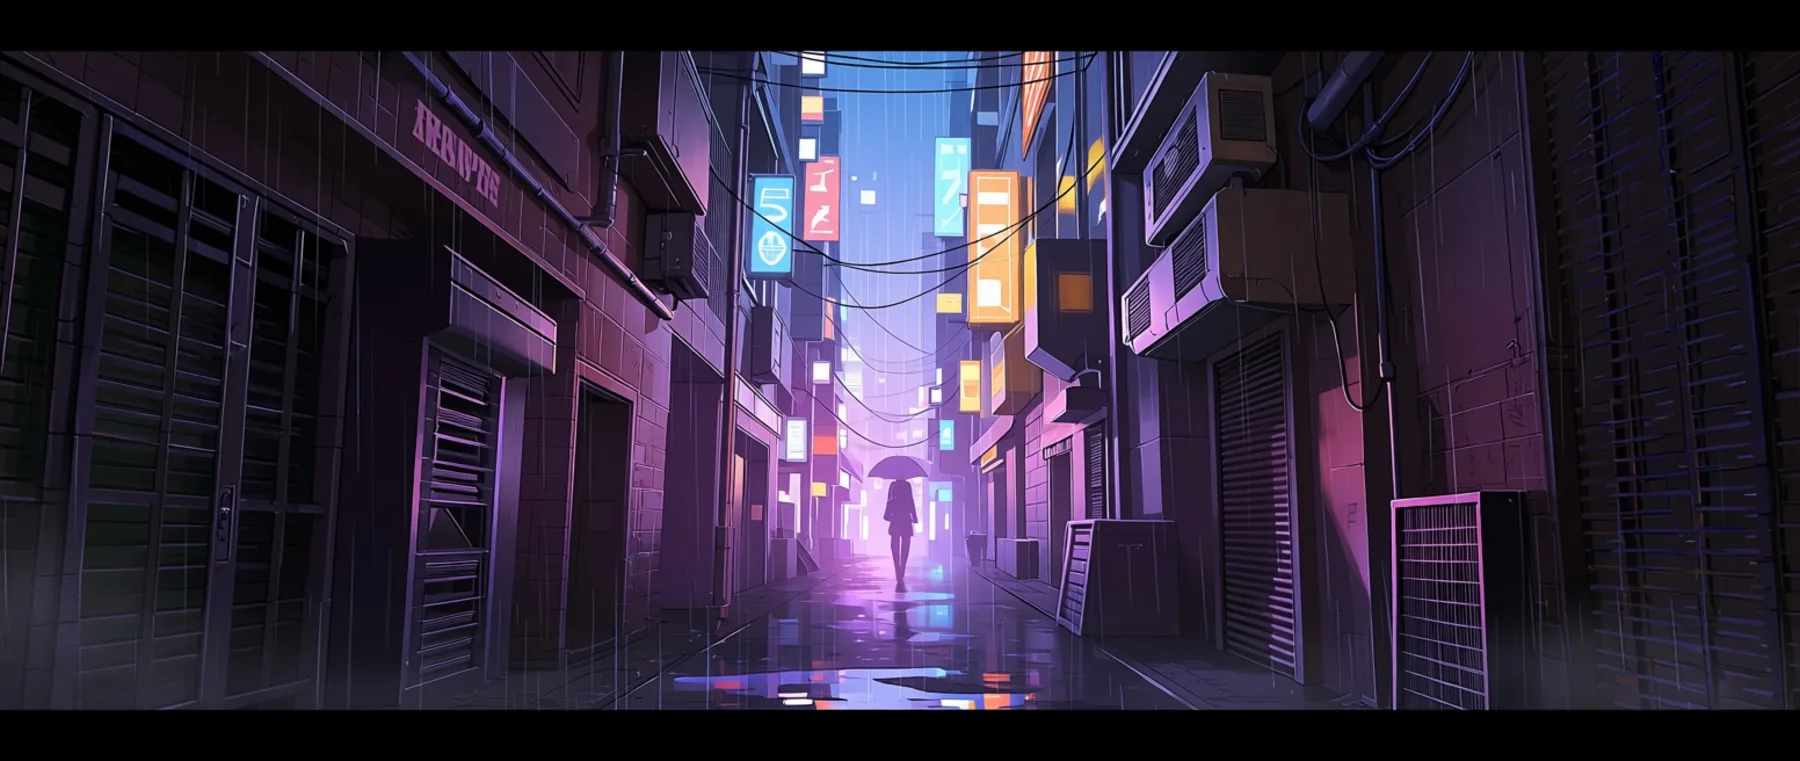
Paesaggio con vicolo cyberpunk, 21:9, livello 1k.
Dove è carente
- Niente fotorealismo. È un modello anime e di illustrazione. Non aspettarti un aspetto fotografico da nessun prompt.
- Il testo è debole. Rende una parola o due, non una frase, un’insegna o una didascalia.
- Niente prompt negativo, passi, CFG o sampler. I campi pubblici sono
prompt,aspect_ratio,resolutioneseed. Il tag di rating e le tue parole sono gli unici freni che hai. - Uno scarabocchio simile a una firma. A volte il modello disegna in un angolo una firma o una riga di pseudo-testo, un’abitudine presa dalle opere. L’abbiamo vista in circa un’immagine su cinque. Nessun prompt negativo può eliminarlo. Cambia il seed oppure ritaglia il bordo.
- I seed rendono le esecuzioni confrontabili, non identiche. La stessa richiesta con lo stesso seed ci ha dato tre rese leggermente diverse in momenti diversi. Usa un seed per confrontare due modifiche al prompt, non per promettere a un cliente un rifacimento identico al pixel.
- Un’immagine per richiesta, solo JPEG, nessuna maschera. Non c’è un campo per l’inpainting.
Chi dovrebbe usarlo
Usa Anima Turbo se vuoi bozze anime e di illustrazione veloci a un prezzo per immagine, se ti piace scrivere prompt a tag o vuoi unire i tag a un paio di frasi, o se ti serve un output senza filtri da un modello piccolo. È un buon modello per esplorare personaggi e scene a 1k e poi portare a 1.5k quelli riusciti.
Cerca altrove se ti serve il realismo fotografico o testo leggibile dentro l’immagine.
Quale famiglia Anima scegliere
SpicyAPI ha due famiglie Anima. Condividono lo stesso modello base, quindi la scelta dipende dal fatto che ti serva o no un look personalizzato:
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| Nomi dei modelli API | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Campo aggiuntivo | Nessuno | loras: fino a 3 voci, ciascuna con un path e uno scale da 0 a 4 |
| Ideale per | Bozze veloci, prompt a tag e a frasi, l’aspetto di base | Uno stile artistico, un personaggio o un look d’epoca specifico da un LoRA per Anima |
| Controllo dello stile | Tag di stile nel prompt | Tag di stile più LoRA |
| Prezzi | Per immagine in base al livello di risoluzione | Stessa struttura; caricare i LoRA non comporta un addebito a parte |
Parti da Anima Turbo. Passa alla famiglia LoRA quando un tag di stile non basta, per esempio quando un tag di acquerello o di matita ha solo ritoccato la superficie nel nostro test.
Due passi successivi naturali:
- Stili personalizzati. La famiglia Anima Turbo LoRA carica fino a tre LoRA per richiesta, così puoi aggiungere un look specifico, compresi i LoRA per adulti della community. La nostra guida di accompagnamento lo spiega: guida agli stili con Anima Turbo LoRA.
- Cambiare lo stile alle foto. L’endpoint immagine in immagine accetta un’immagine sorgente e una
strengthda 0 a 1. Leggi da foto ad anime con Anima Turbo per vedere cosa fa ogni valore.
Domande frequenti
Anima Turbo supporta i prompt negativi?
No. I campi pubblici sono prompt, aspect_ratio, resolution e seed, senza prompt negativo, passi, CFG o sampler. Metti nel prompt ciò che vuoi e usa il tag di rating (safe, sensitive o nsfw) per dare il tono.
Quale risoluzione devo usare?
Fai le bozze a 1k, poi rilancia le immagini che ti piacciono a 1.5k. Il livello 1k è di circa un megapixel e 1.5k di circa 2,4 megapixel, generati in modo nativo. Nei nostri test lo stesso prompt con lo stesso seed ha dato un volto diverso a 1.5k, quindi trattalo come una nuova ripresa con più dettaglio, non come un ingrandimento.
Perché c’è una firma o un testo strano nell’angolo?
Il modello ha preso l’abitudine dalle opere da cui ha imparato. Abbiamo visto uno scarabocchio simile a una firma o una riga di pseudo-testo in circa un’immagine su cinque. Qui un prompt negativo non può eliminarlo, quindi cambia il seed oppure ritaglia il bordo.
Un seed fisso dà ogni volta la stessa immagine?
Non in modo affidabile. La stessa richiesta con lo stesso seed ci ha dato tre rese leggermente diverse in momenti diversi. Usa un seed per confrontare due modifiche al prompt, non per promettere un rifacimento identico al pixel.
Posso usare LoRA per SDXL o Pony con Anima?
No, usa LoRA addestrati per Anima, cioè la famiglia Anima Turbo LoRA. Nei nostri test un LoRA addestrato per un altro modello base (uno per FLUX) si è caricato senza errori e non ha cambiato nulla. L’endpoint base di Anima Turbo non accetta alcun LoRA.
Anima può modificare un’immagine invece di ridisegnarla?
Cambia lo stile, non modifica. L’endpoint immagine in immagine accetta un’immagine sorgente e una strength da 0 a 1, e nei nostri test chiedere a un’illustrazione esistente un nuovo abito o il passaggio dal giorno alla notte ha cambiato pochissimo. Non c’è un campo per maschere o inpainting.
Può scrivere testo dentro l’immagine?
Solo una parola o due. Frasi, insegne e didascalie non sono il forte di questo modello, quindi aggiungi il testo dopo con un editor.
Fa fotorealismo?
No. È un modello anime e di illustrazione, e nessun prompt ci ha dato un aspetto fotografico.