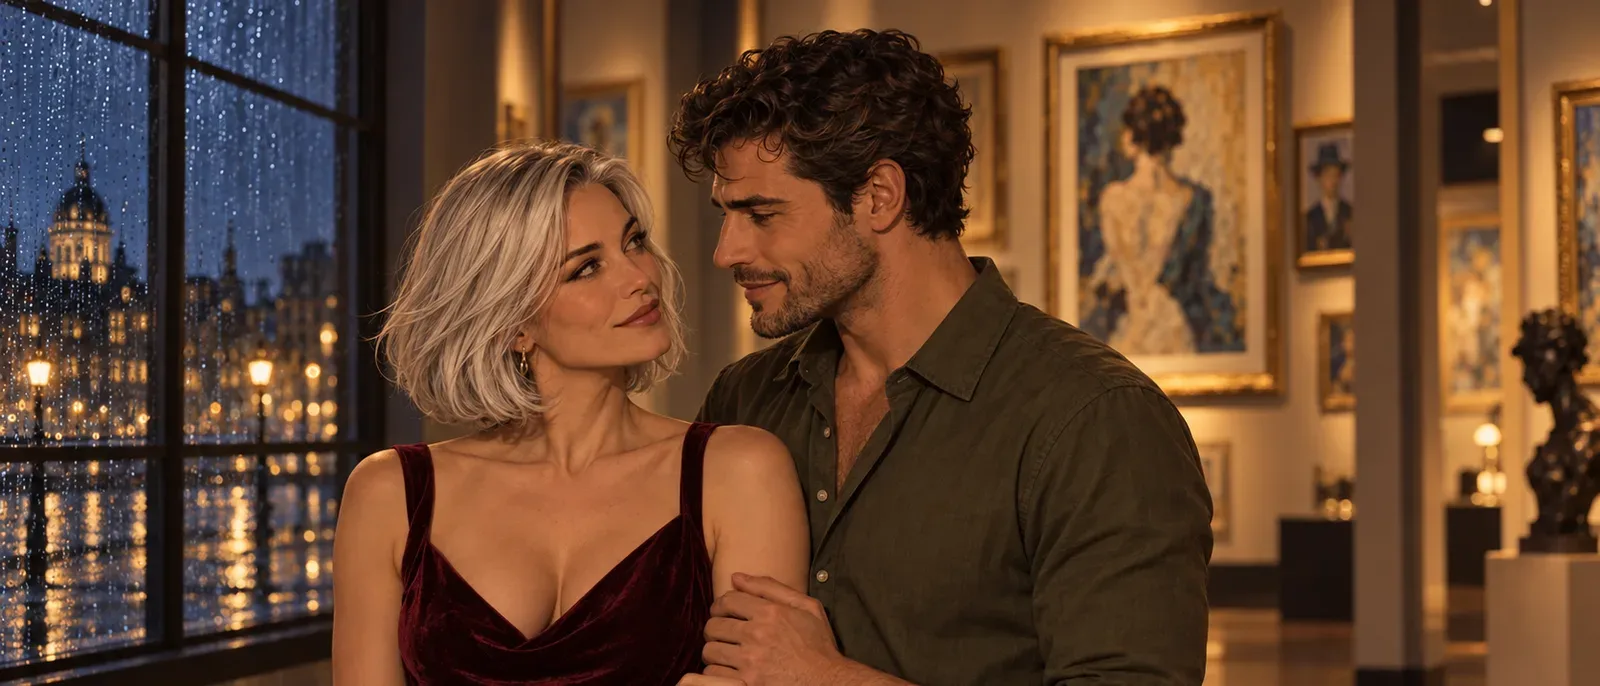
Anima Turbo ist ein kleines, schnelles Anime- und Illustrationsmodell, das einen sauberen Tag-Prompt belohnt und auch normale Sätze versteht. In unseren Tests war es bei den meisten Bildern in unter zehn Sekunden fertig, setzte Stil-Tags deutlich um und blieb unzensiert: Unser härtester Inhaltstest wurde gleich beim ersten Versuch so gerendert, wie er geschrieben war. Die Grenzen sind genauso klar. Es beherrscht keinen Fotorealismus, es rendert nur ein, zwei Wörter Text, und es gibt keinen Negativ-Prompt.
Anima Turbo ist die destillierte Variante von Anima von CircleStone Labs, einem Modell mit 2 Milliarden Parametern auf Basis von NVIDIA Cosmos-Predict2 mit einem Qwen3-Text-Encoder. Wir haben die Tests am 5. Oktober 2026 über den Anima-Turbo-Endpunkt für Text-zu-Bild durchgeführt. Jeder Prompt unten beschreibt eine Alltagsszene mit bekleideten Erwachsenen.
Auf einen Blick
| Anima Turbo (getestet am 5. Oktober 2026) | |
|---|---|
| Herausgeber und Basis | CircleStone Labs mit Comfy Org; 2B Parameter auf NVIDIA Cosmos-Predict2 (2B), Qwen3-Text-Encoder |
| API-Modellnamen | circlestone-labs/anima-turbo/text-to-image und circlestone-labs/anima-turbo/edit |
| Öffentliche Felder (Text-zu-Bild) | prompt (bis zu 5.000 Zeichen), aspect_ratio, resolution, seed |
| Seitenverhältnisse | 15, von 1:1 und 16:9 bis 21:9 und 1:3 |
| Auflösungsstufen | 1k (etwa 1 Megapixel, z. B. 1360 x 768 bei 16:9) und 1.5k (etwa 2,4 Megapixel, z. B. 2048 x 1152, nativ erzeugt) |
| Tempo in unseren Tests | 2 bis 16 Sekunden pro Bild in 60 Läufen; 52 von 60 unter 10 Sekunden |
| Ausgabe | Ein JPEG pro Anfrage |
| Inhaltsrichtlinie | Unzensiert, kein Content-Filter; unser härtester Inhaltstest wurde gleich beim ersten Versuch so gerendert, wie er geschrieben war |
| Kann nicht | Fotorealismus, mehr als ein, zwei Wörter Text, Negativ-Prompts, Schritte, CFG, Sampler, Masken |
Was Anima Turbo ist
Anima stammt von CircleStone Labs und wurde zusammen mit Comfy Org entwickelt. Es ist ein Modell mit 2 Milliarden Parametern auf Basis von NVIDIAs Cosmos-Predict2 (2B) mit einem Qwen3-Text-Encoder. Der Herausgeber liefert drei Varianten: Base, Aesthetic und Turbo. Turbo ist die destillierte Variante und für 8 bis 12 Sampling-Schritte gedacht. Laut Herausgeber ist sie im Durchschnitt nur geringfügig schlechter als Anima-Aesthetic, dabei aber deutlich schneller, und er empfiehlt, mit ihr zu beginnen. Die Trainingsdaten bestehen laut Herausgeber aus mehreren Millionen Anime-Bildern und rund 800.000 künstlerischen Bildern außerhalb des Anime-Genres, ganz ohne synthetische Daten. Die Modellkarte finden Sie unter huggingface.co/circlestone-labs/Anima.
Auf SpicyAPI ist das Modell öffentlich als circlestone-labs/anima-turbo/text-to-image verfügbar. Die Plattform fügt keinen Content-Filter hinzu, das Ergebnis bestimmen also das Modell und Ihr Prompt. Auf der Familienseite steht der aktuelle Preis pro Bild für jede Auflösung.
Tags oder Sätze: beides funktioniert, nur sieht es anders aus
Anima folgt den Danbooru-Tag-Konventionen. Der Rat des Herausgebers, den wir befolgt haben: Kleinschreibung, Leerzeichen statt Unterstrichen und eine feste Reihenfolge, zuerst Qualitäts- und Rating-Tags, dann die Personenzahl (1girl, 1boy, no humans), dann Figur, Serie und Künstler und zuletzt alles Übrige. Ein sicherer Einstieg ist masterpiece, best quality, optional mit score_7.
Natürliche Sprache funktioniert ebenfalls. Der Herausgeber empfiehlt mindestens zwei Sätze, und wir haben gesehen, warum: Sehr kurze Prompts weichen ab. Wir haben dieselbe Szene in einem verregneten Café zweimal mit demselben Seed erzeugt, einmal als Tags und einmal als vier Sätze.
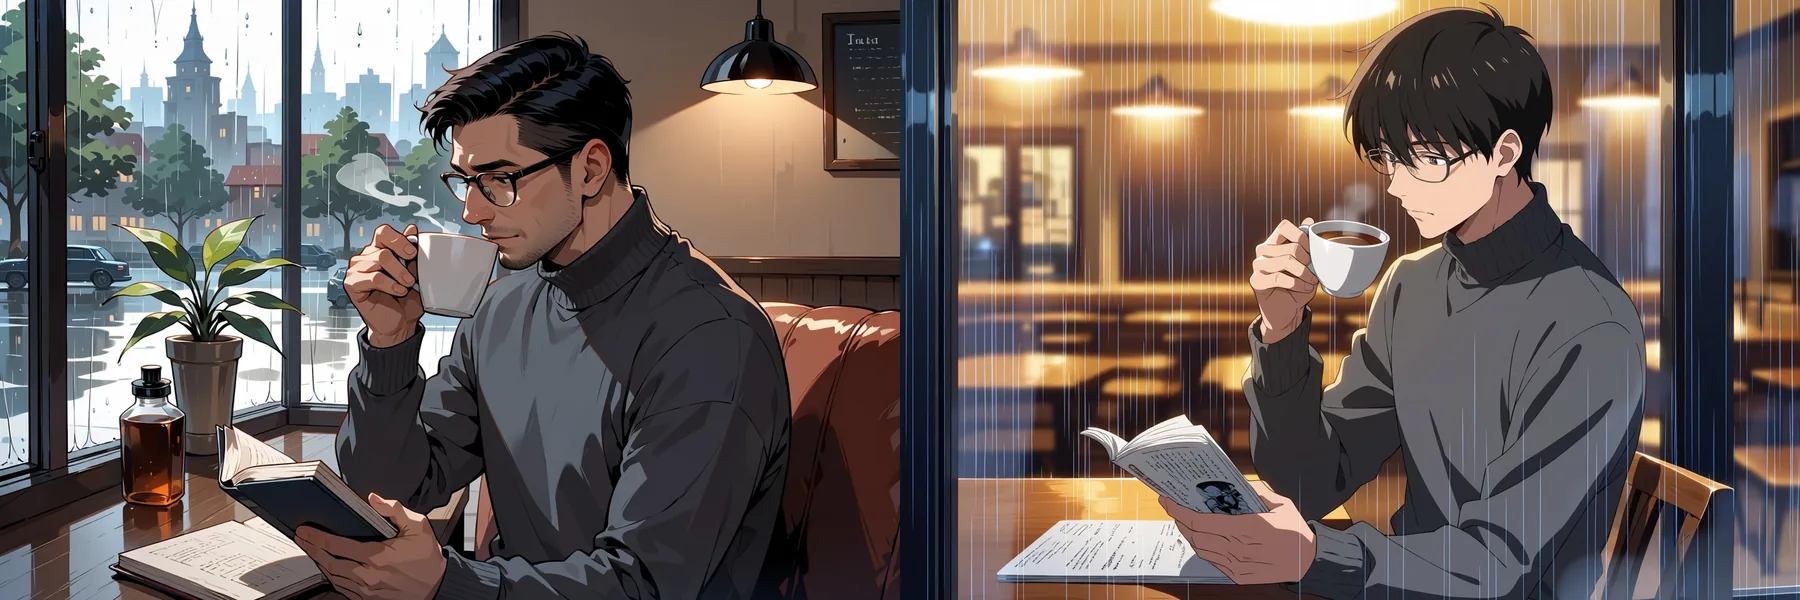
Links: Tags. Rechts: vier Sätze. Gleicher Seed (4), 3:2, Stufe 1k, Text-zu-Bild.
Die Tag-Version:
masterpiece, best quality, score_7, safe, 1boy, solo, adult man, mature male, short black hair, glasses, grey turtleneck, sitting by a cafe window, rain outside, holding a coffee cup, reading a book, warm indoor light, cozyDie Satz-Version:
masterpiece, best quality, safe. An anime illustration of a man in his thirties sitting by a cafe window on a rainy afternoon. He has short black hair and glasses and wears a grey turtleneck, holding a cup of coffee in one hand while reading a paperback. Warm light from inside the cafe falls across the table, and raindrops streak the glass behind him.Beide Versionen haben Brille, Rollkragenpullover, Tasse und Buch getroffen. Die Unterschiede liegen in dem, was Sie nicht vorgegeben haben. Der Tag-Prompt lieferte ein reiferes Gesicht und eine helle Fensterszene, der Satz-Prompt ein jüngeres Gesicht und einen stimmungsvolleren Raum. In unseren Tests geben Tags mehr Kontrolle über die Figur, Sätze liefern Atmosphäre gratis dazu. Auch eine Mischung aus beidem funktionierte: ein Tag-Kopf plus ein bis zwei beschreibende Sätze.
Wann Sie was nehmen sollten, nach unseren Läufen und der Empfehlung des Herausgebers:
| Situation | Besser geeignet | Warum |
|---|---|---|
| Sie brauchen einen bestimmten Figuren-Look (Haar, Brille, Kleidung) | Tags | Jedes Tag ist eine eigene Anweisung, deshalb bleiben die Details an ihrem Platz |
| Sie wollen Stimmung, Licht oder eine Szene, die sich nach etwas „anfühlt“ | Sätze | Die Satz-Version lieferte uns den stimmungsvolleren Raum, ohne dass wir ihn verlangt hätten |
| Sie rufen einen bekannten Künstler oder einen erkennbaren Stil auf | Tags, mit @ vor dem Künstler | Laut Herausgeber ist ein Künstlerstil ohne das @ schwach |
| Sie vergleichen Seeds oder Prompt-Änderungen | Tags | Kurze, feste Prompts machen eine Änderung leicht zuordenbar |
| Sie schreiben eine kurze Beschreibung | Zwei oder mehr Sätze | Der Herausgeber empfiehlt mindestens zwei; sehr kurze Prompts weichen ab |
| Sie wollen Kontrolle und Atmosphäre | Ein Tag-Kopf plus ein bis zwei Sätze | Die Mischung funktionierte in unseren Tests |
Prompts schreiben, die tragen
Die folgende Reihenfolge entspricht dem Rat des Herausgebers und ist die, die wir für jeden Prompt in diesem Artikel genutzt haben:
- Zuerst Qualitäts- und Rating-Tags.
masterpiece, best quality, optionalscore_7, dannsafe,sensitiveodernsfw. Ohne Negativ-Prompt bestimmt das Rating-Tag den Ton. - Dann die Personenzahl.
1girl,1boy,1girl, 1boyoderno humansfür Landschaften. - Figur, Serie und Künstler. Künstler bekommen ein
@als Präfix. - Alles Übrige. Haar, Kleidung, Ort, Licht, Bildausschnitt. Kleinschreibung, Leerzeichen statt Unterstrichen.
- Gewichte, wenn ein Tag zu leise ist.
(chibi:2)funktionierte in unserem Stiltest, aber das Modell brauchte höhere Gewichte als Modelle der SDXL-Ära, hören Sie also nicht bei 1,2 auf.
Das Prompt-Limit liegt bei 5.000 Zeichen, was Tag-Prompts selten erreichen. Drei Gewohnheiten machten in unseren Läufen einen sichtbaren Unterschied:
- Mit einem Rating-Tag beginnen. Das Modell kennt
safe,sensitiveundnsfwsowie ein weiteres, stärkeres Tag. Ohne Negativ-Prompt ist das Rating-Tag Ihr wichtigstes Mittel, den Ton festzulegen, deshalb beginnt jeder Prompt in diesem Artikel mitsafe. - Angeben, dass die Figuren erwachsen sind.
adult woman, mature femaleoder „a man in his thirties“ hält die Besetzung dort, wo Sie sie haben wollen. - Vor Künstlernamen ein
@setzen. Laut Herausgeber ist ein Künstlerstil ohne das@schwach.
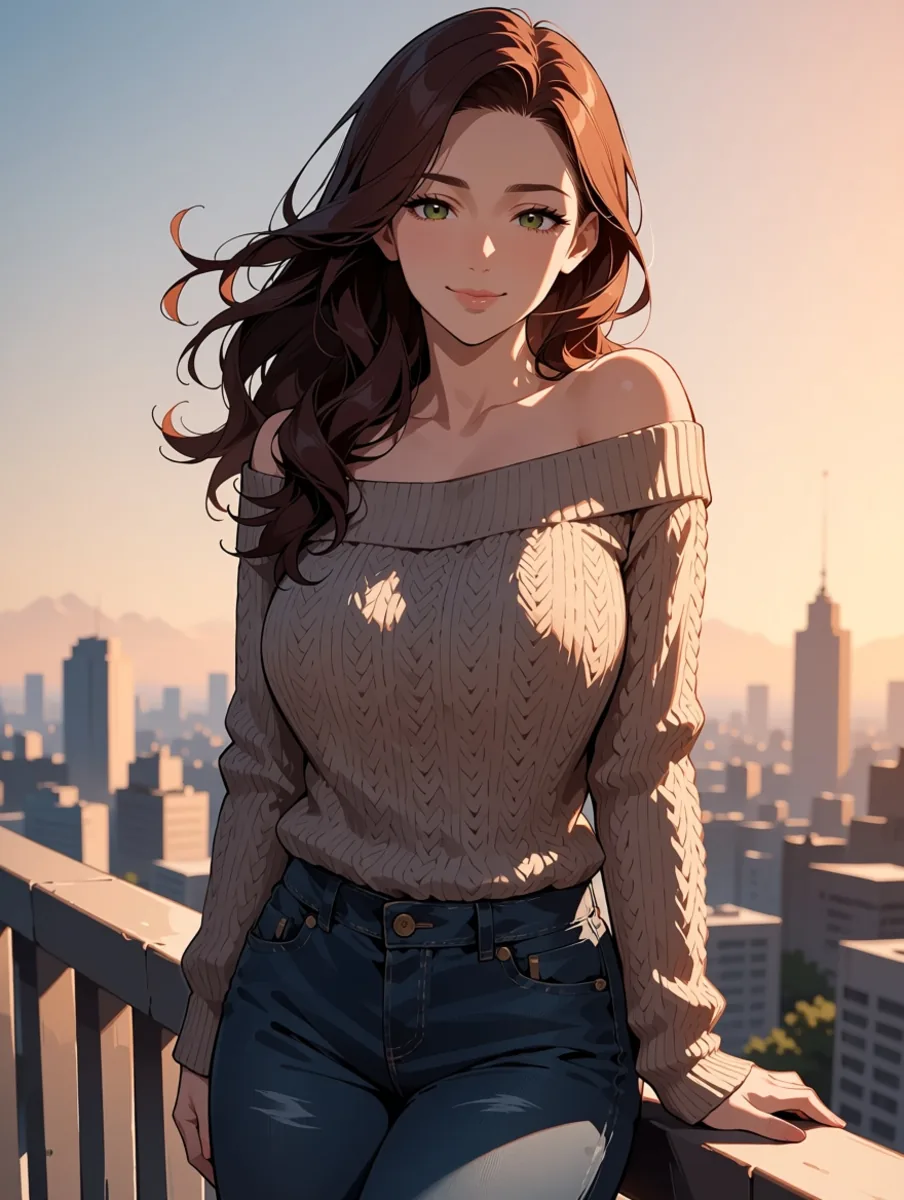
Ein reiner Tag-Prompt: Rating-Tag, Personenzahl, Haar, Kleidung, Ort, Licht. 3:4, Stufe 1k, Seed 3.
Was Stil-Tags bewirken
Das war der Test, der uns am wichtigsten war. Wir haben eine Figur festgelegt (eine erwachsene Frau mit kurzem silbernem Haar im Trenchcoat auf einer herbstlichen Straße) und einen Seed (12), nur die Stil-Tags geändert und jeden Lauf in 1:1 auf Stufe 1k gerendert. Der Basis-Prompt:
masterpiece, best quality, score_7, safe, 1girl, solo, adult woman, mature female, short silver hair, blue eyes, beige trench coat, scarf, standing on a city street in autumn, falling leaves, looking at viewer, soft smile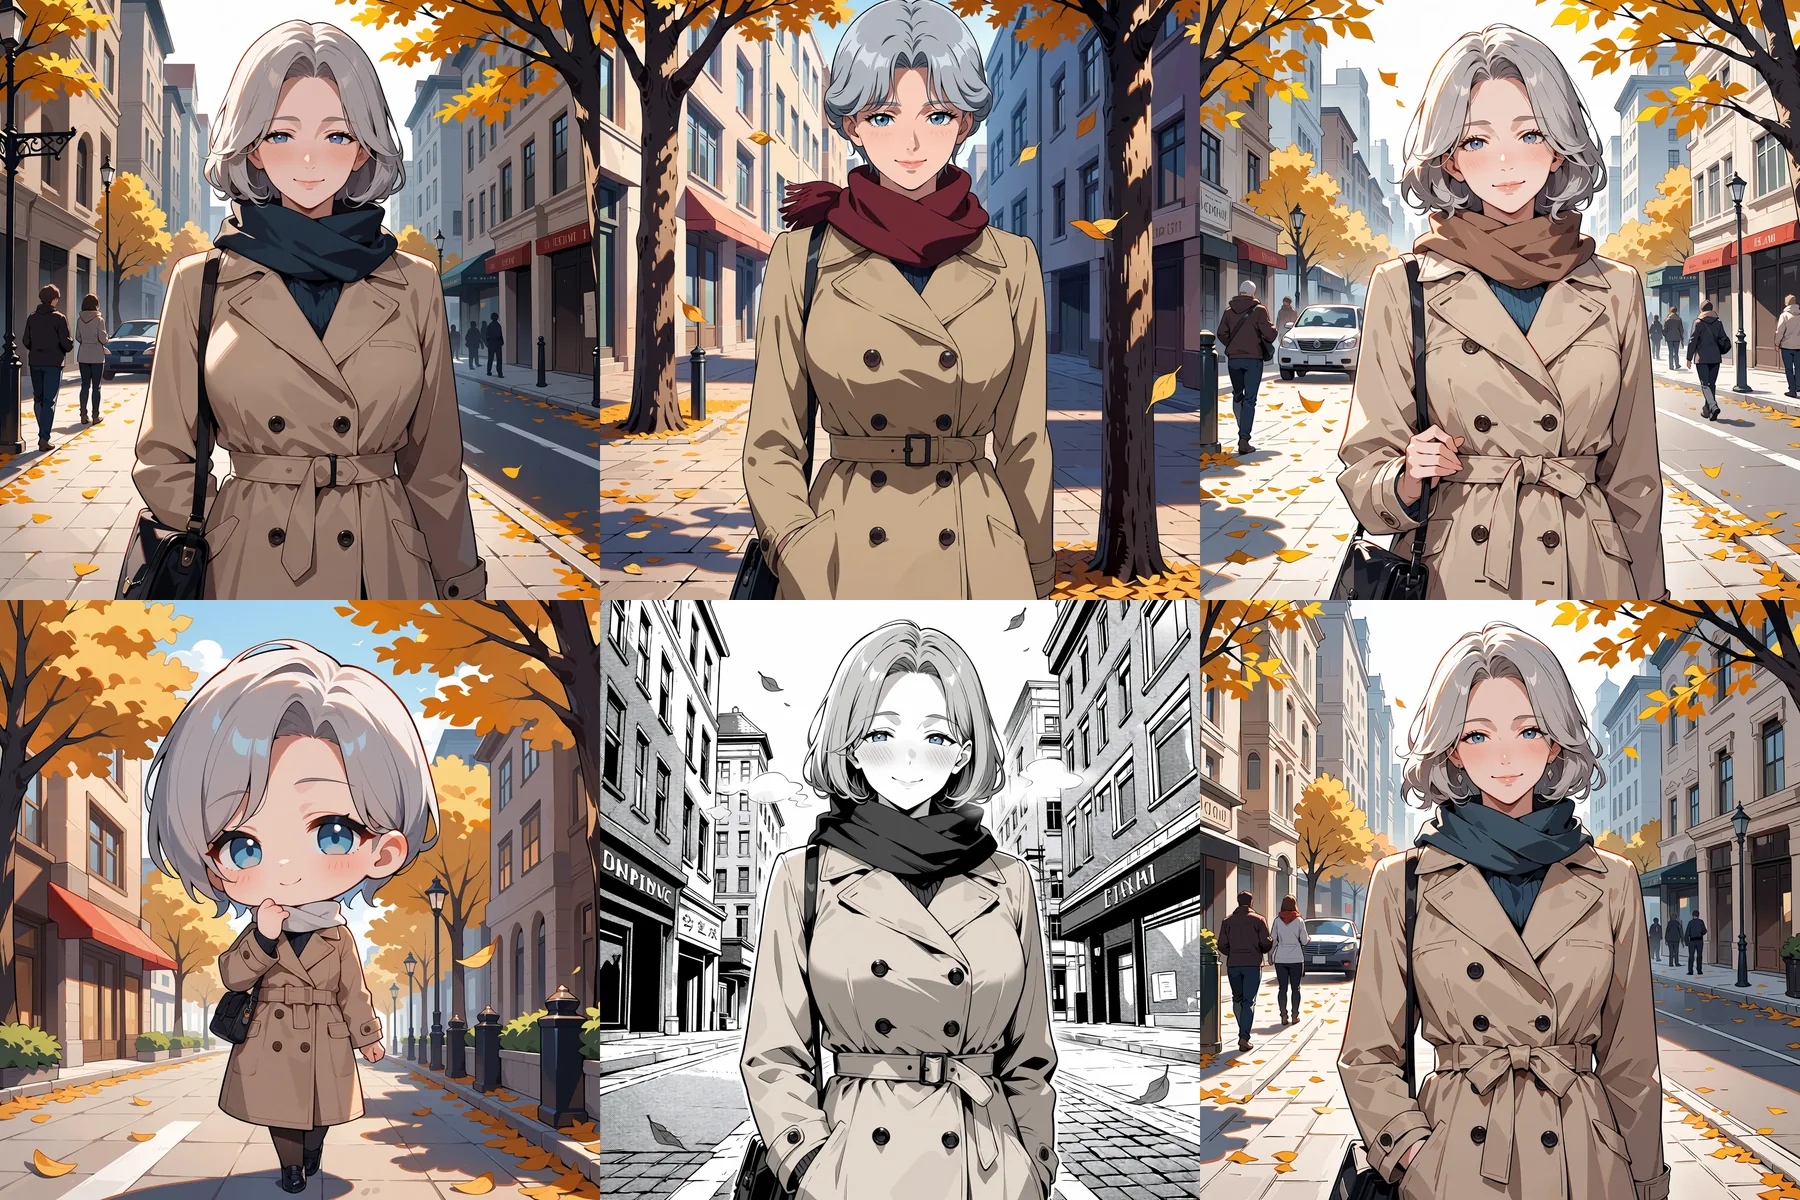
Obere Reihe: kein Stil-Tag, retro artstyle, 1990s (style), anime screenshot, watercolor (medium), traditional media. Untere Reihe: (chibi:2), monochrome, greyscale, manga, screentone, sketch, pencil drawing, traditional media. Durchgehend Seed 12.
Das haben wir gesehen:
| Hinzugefügte Stil-Tags | Ergebnis in unseren Tests |
|---|---|
retro artstyle, 1990s (style), anime screenshot | Ein klarer Cel-Look der 90er: flachere Farben, härtere Schatten |
(chibi:2) | Ein vollständiger Chibi, großer Kopf und kleiner Körper |
monochrome, greyscale, manga, screentone | Ein überzeugendes schwarz-weißes Manga-Panel mit Rasterfolie |
watercolor (medium), traditional media | Nur eine leichte Änderung der Darstellung |
sketch, pencil drawing, traditional media | Nur eine leichte Änderung der Darstellung |
Stark sind die Stile mit einem wiedererkennbaren visuellen Vokabular: Cel-Anime wie aus dem Screenshot, Chibi-Proportionen, Manga-Tusche. Die beiden Traditional-Media-Tags verschoben die Oberfläche und sonst kaum etwas. Wenn Sie einen echten Aquarell- oder Bleistift-Look wollen, greifen Sie besser zu einer Stil-LoRA statt zu einem Tag.
Noch ein Detail: Prompt-Gewichtung wie (chibi:2) funktioniert, brauchte aber ein höheres Gewicht, als wir es von Modellen der SDXL-Ära gewohnt sind.
Größe, Auflösung und Tempo
Es gibt kein Größenfeld. Sie wählen ein aspect_ratio aus 15 Optionen (1:1, 16:9, 9:16, 4:3, 3:4, 3:2, 2:3, 21:9, 9:21, 2:1, 1:2, 3:1, 1:3, 5:4, 4:5) und eine resolution-Stufe, 1k oder 1.5k, dazu optional einen seed. Die Stufe 1k entspricht etwa einem Megapixel; 1.5k sind etwa 2,4 Megapixel und werden nativ erzeugt, nicht hochskaliert. Ein Bild in 16:9 misst bei 1k 1360 x 768 und bei 1.5k 2048 x 1152; 1:3 misst 576 x 1760 und 880 x 2048. Die Ausgabe ist immer JPEG, ein Bild pro Anfrage. Das Seitenverhältnis ändert den Preis nicht, die Stufe 1.5k kostet mehr als 1k, und fehlgeschlagene Anfragen werden nicht berechnet.
Wir haben 60 Läufe gemessen, die jedes Seitenverhältnis auf beiden Stufen abdecken. Die Modellzeit lag bei 2 bis 16 Sekunden pro Bild, und 52 der 60 Läufe waren in unter 10 Sekunden fertig.
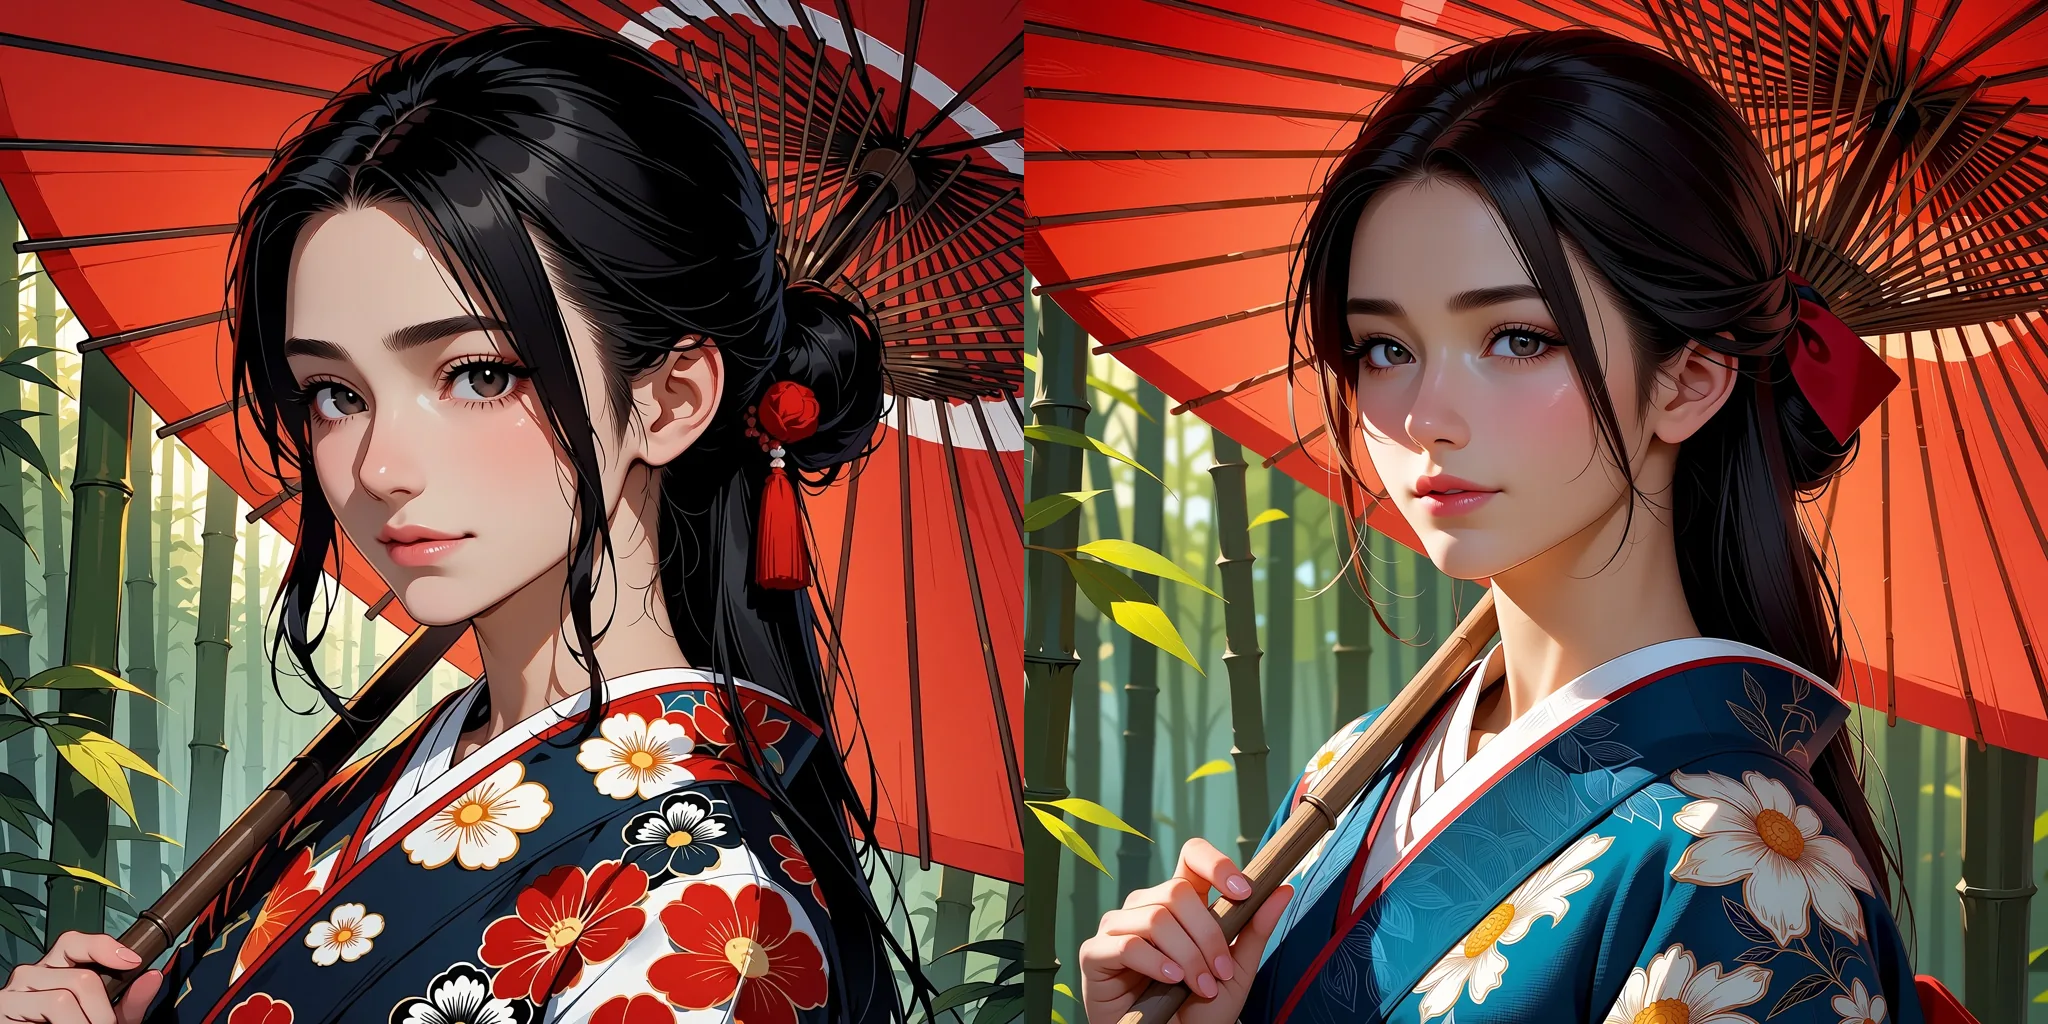
Links: 1k (1024 x 1024). Rechts: 1.5k (1536 x 1536). Gleicher Prompt, Seed 8, 1:1.
Die beiden Stufen sind keine pixelgenaue Vergrößerung. Derselbe Prompt mit demselben Seed ergab ein anderes Gesicht und ein anderes Kimono-Muster. Bei 1.5k bezahlen Sie für feinere Stoffdetails und sauberere Linien. Entwerfen Sie auf 1k, rendern Sie die Treffer dann noch einmal auf 1.5k und behandeln Sie das Ergebnis als neue Aufnahme, nicht als schärfere Kopie.
Wie weit es geht
Der Endpunkt ist unzensiert, und die Plattform fügt keinen Content-Filter hinzu. In unseren Tests hielt sich auch das Modell nicht zurück: Unser härtester Inhaltstest wurde gleich beim ersten Versuch so gerendert, wie er geschrieben war, in Text-zu-Bild und in Bild-zu-Bild, mit und ohne LoRAs, über mehrere Seeds hinweg. Diesen Prompt drucken wir nicht ab; die Beispiele unten sind Alltagsszenen.
Was das Modell in gewöhnlichen Szenen gut kann, ist Bandbreite. Ein einziger Prompt-Stil lieferte Porträts, Paare, einen Barkeeper in der Nachtschicht und menschenleere Landschaften:
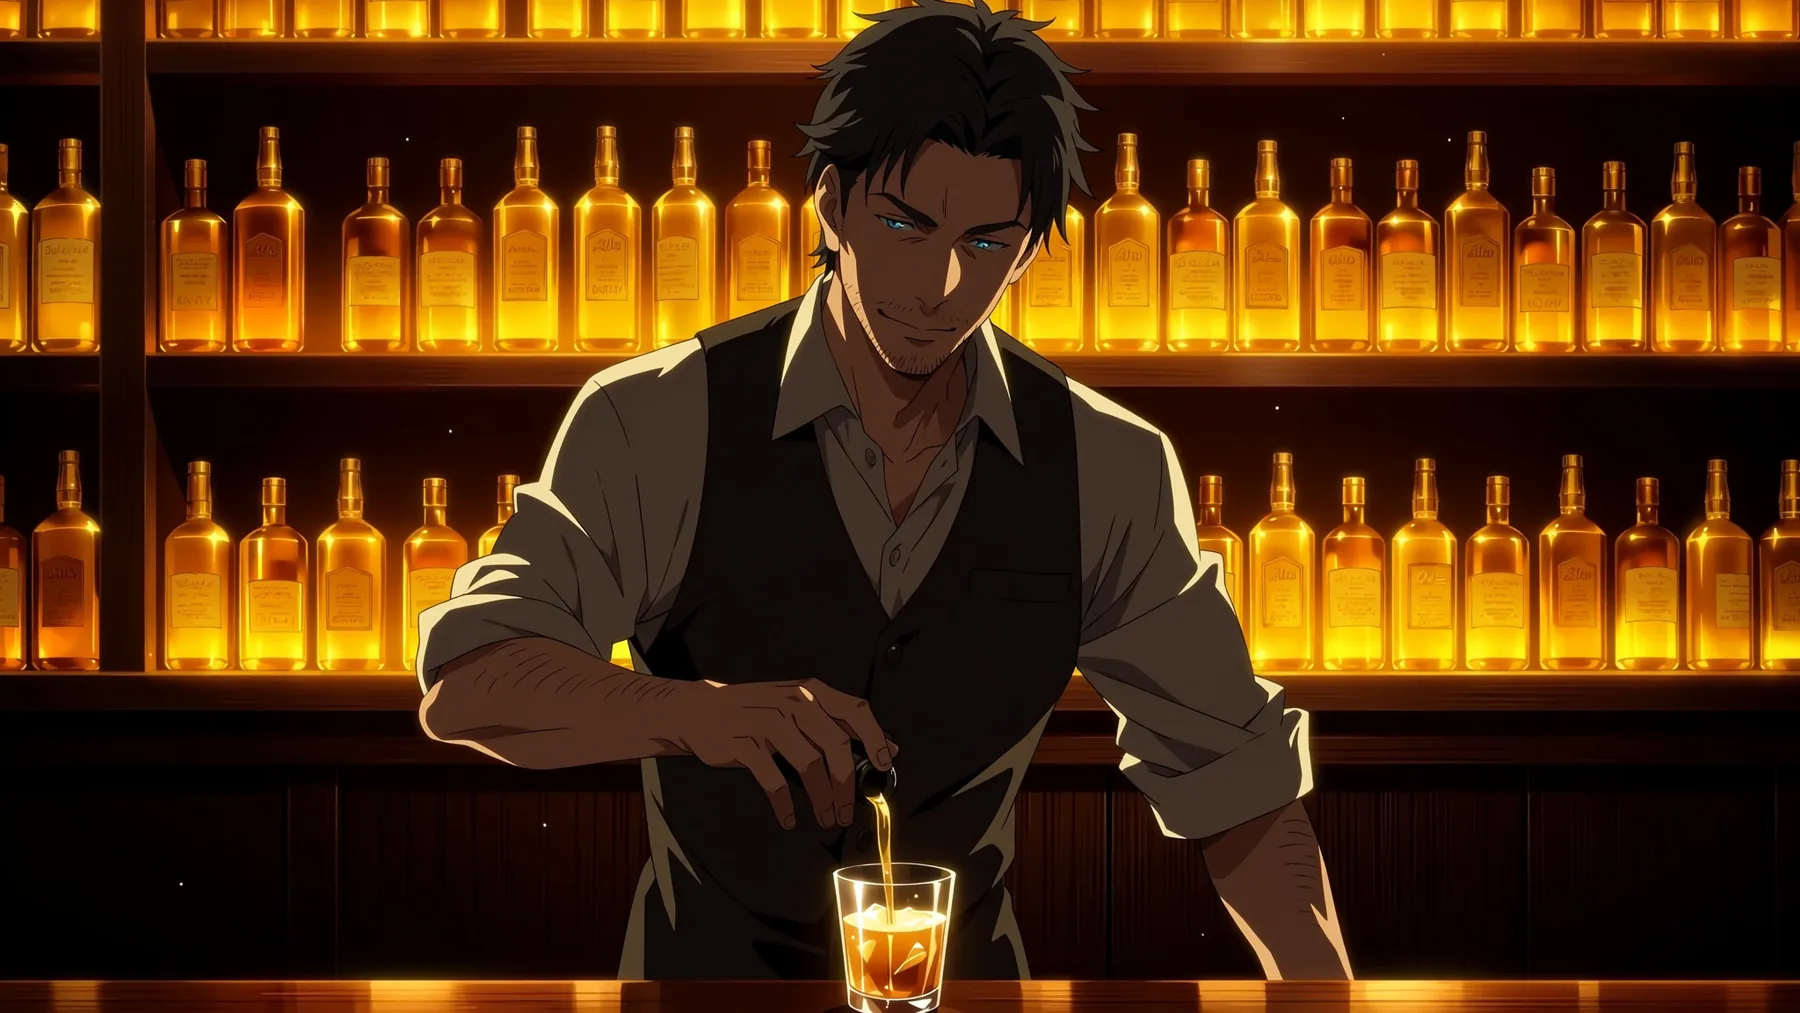
Drei Sätze, Rating-Tag safe, 16:9, Stufe 1.5k, Seed 7.
masterpiece, best quality, safe. An anime illustration of a handsome man in his thirties working as a bartender late at night. He has short dark hair and light stubble, the sleeves of his white shirt are rolled up and the collar is open, and he is pouring a drink into a glass behind a dim wooden bar. Rows of amber bottles glow on the shelves behind him, and a warm rim light falls across his face and forearms.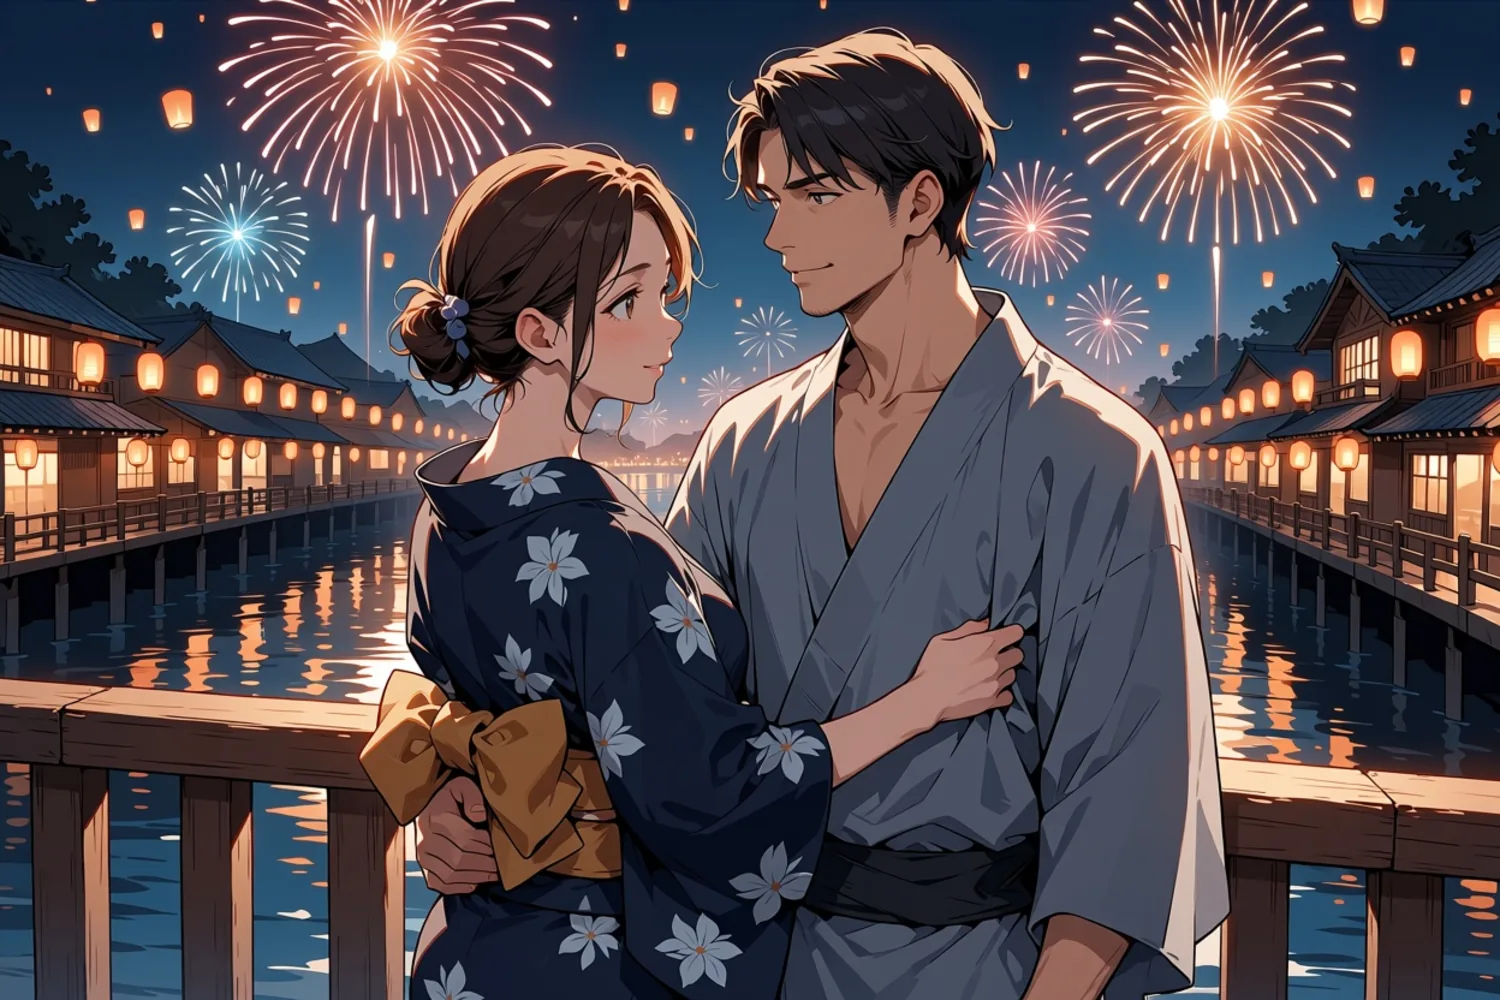
Tags mit der Personenzahl 1girl, 1boy, 3:2, Stufe 1k, Seed 11.
masterpiece, best quality, score_7, safe, 1girl, 1boy, hetero, adult couple, mature female, mature male, summer festival at night, fireworks in the sky, paper lanterns, she wears a navy yukata with her hair up, he wears a grey yukata with the collar loose, standing close together on a wooden bridge, she looks back at him over her shoulder, warm lantern light, river reflections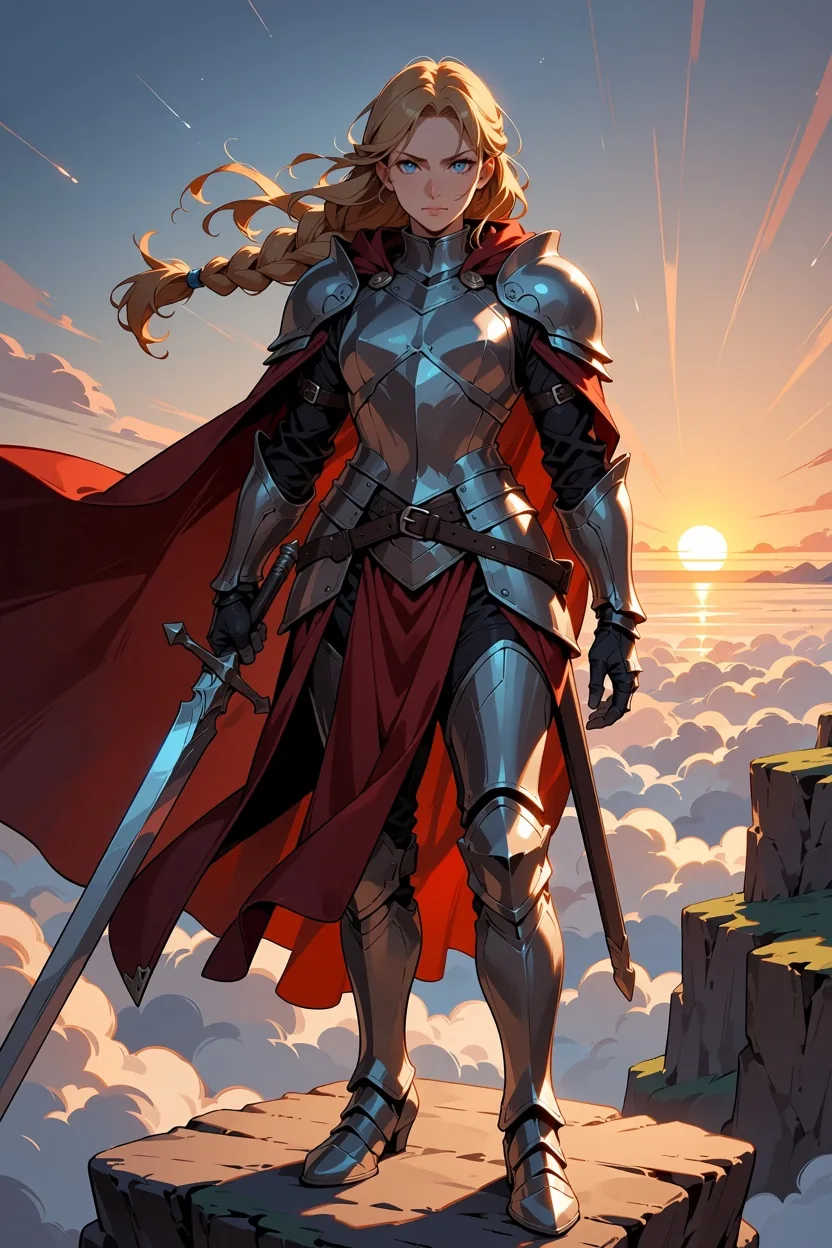
Tags, 2:3 hochkant, Stufe 1k, Seed 6: long braided blonde hair, silver plate armor, red cape, holding a longsword, standing on a cliff at dawn, clouds below, full body, fantasy, nach den üblichen Qualitäts-, Rating- und Personenzahl-Tags.
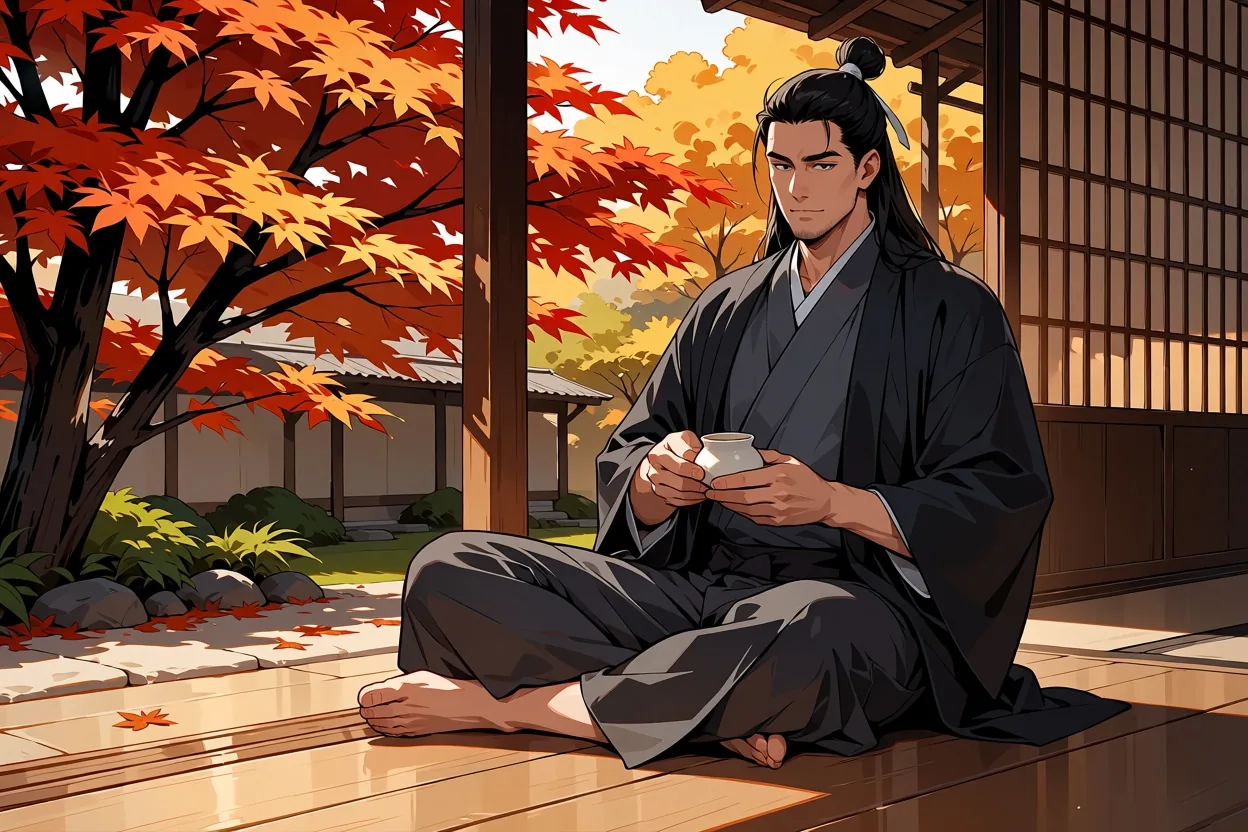
Tags, 3:2, Stufe 1k, Seed 13: long black hair in a topknot, haori worn loose, sitting on an engawa porch, pouring tea, autumn garden, maple leaves, calm expression, afternoon light.
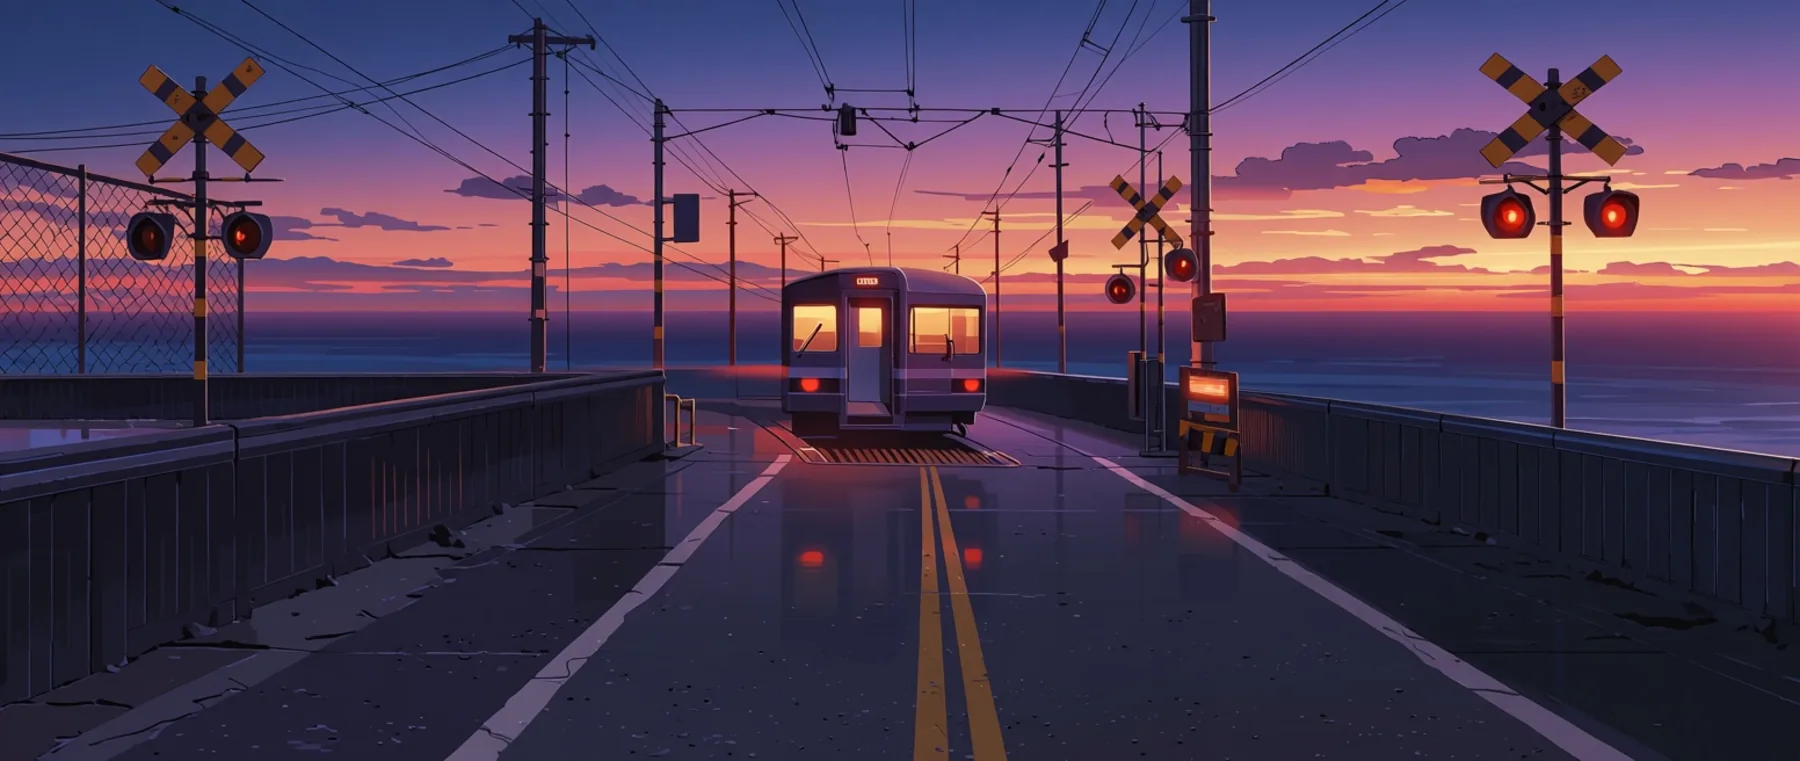
Landschaft mit no humans, 21:9, Stufe 1k (1552 x 656), Seed 5.
masterpiece, best quality, score_7, safe, scenery, no humans, seaside railway crossing at dusk, warning lights glowing red, a single-car train passing, calm ocean behind the tracks, power lines, purple and orange sky, wet road reflections, anime screenshot, wide shotAuch die ungewöhnlichen Formate halten stand. 9:16, ein hohes 1:3-Banner und eine 16:9-Totale waren jeweils für ihren Rahmen komponiert und nicht aus einem Quadrat zugeschnitten:
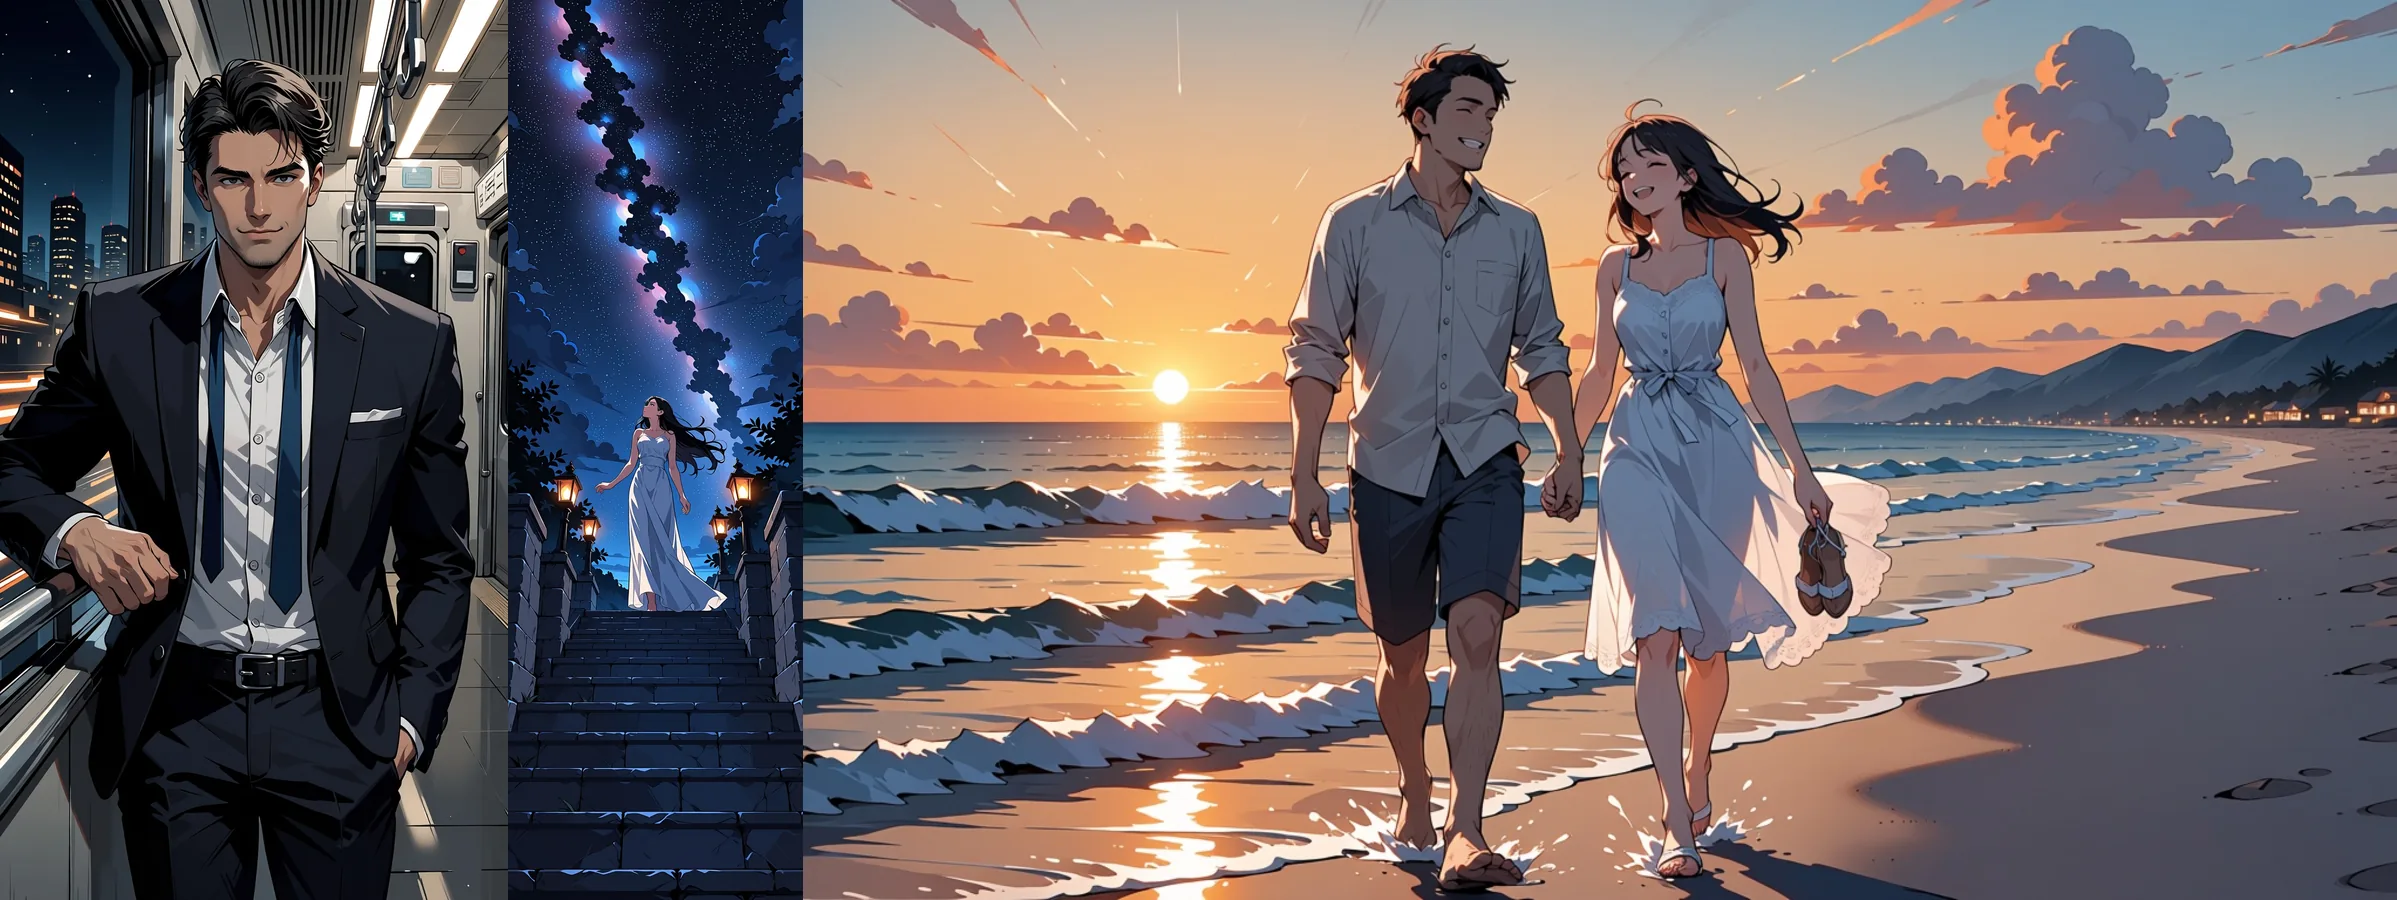
Von links nach rechts: 9:16, 1:3, 16:9, alle auf Stufe 1k, alle Text-zu-Bild.
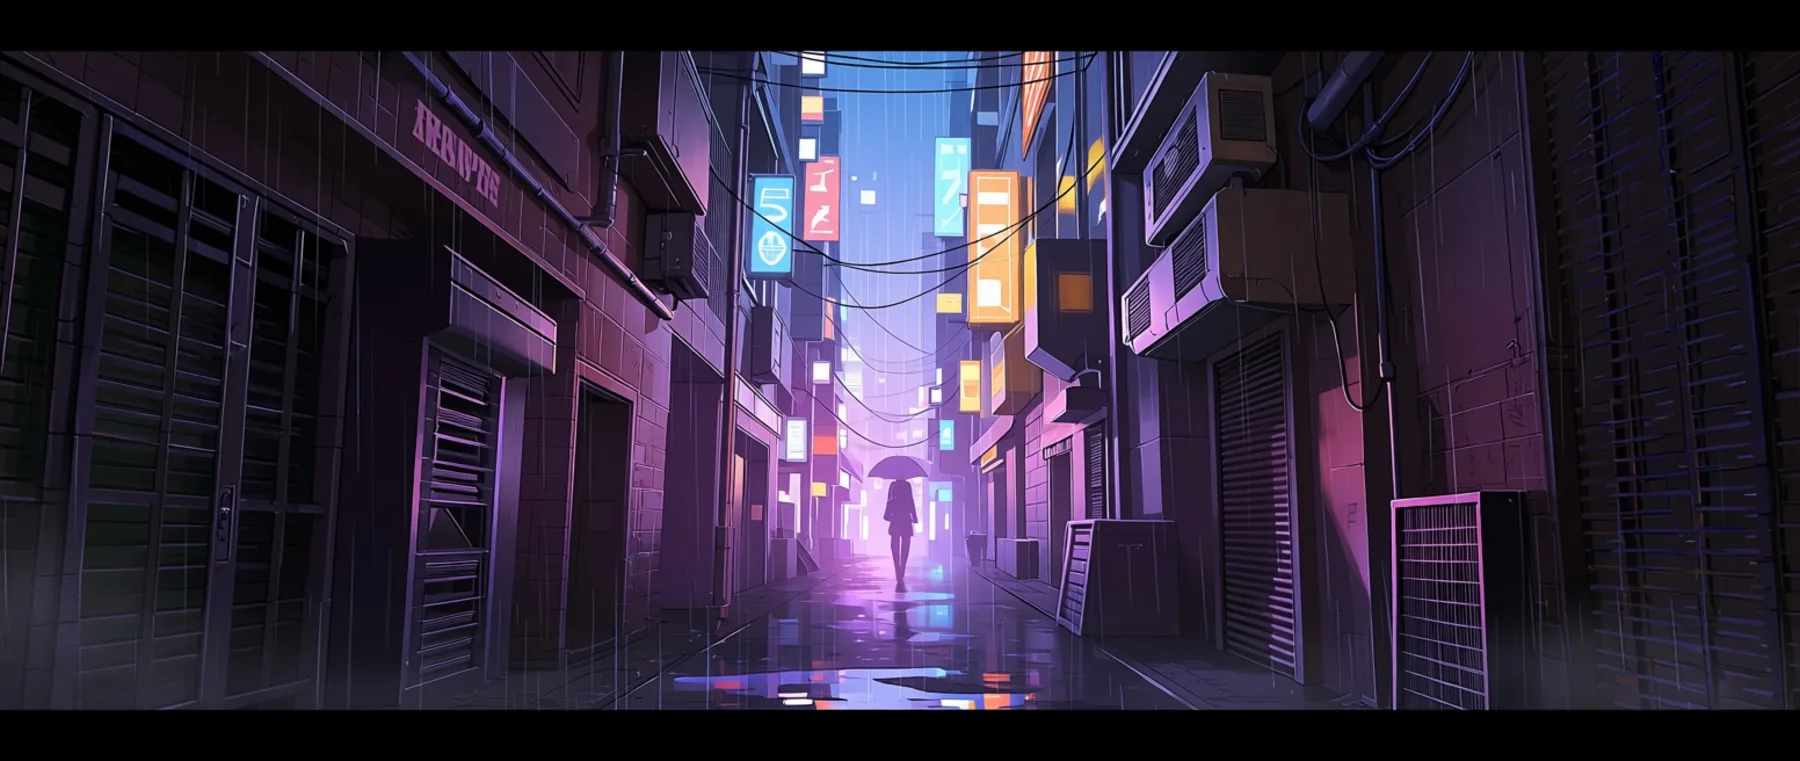
Landschaft einer Cyberpunk-Gasse, 21:9, Stufe 1k.
Wo es an Grenzen stößt
- Kein Fotorealismus. Es ist ein Anime- und Illustrationsmodell. Erwarten Sie von keinem Prompt einen fotografischen Look.
- Text ist schwach. Es rendert ein, zwei Wörter, keinen Satz, kein Schild und keine Bildunterschrift.
- Kein Negativ-Prompt, keine Schritte, kein CFG und kein Sampler. Die öffentlichen Felder sind
prompt,aspect_ratio,resolutionundseed. Das Rating-Tag und Ihre Formulierung sind die einzigen Bremsen, die Sie haben. - Eine signaturartige Kritzelei. Das Modell zeichnet manchmal eine Signatur oder eine Zeile Pseudotext in eine Ecke, eine Angewohnheit aus den Vorlagen. Wir haben das bei etwa jedem fünften Bild gesehen. Kein Negativ-Prompt kann es unterdrücken. Ändern Sie den Seed oder schneiden Sie den Rand ab.
- Seeds machen Läufe vergleichbar, nicht identisch. Dieselbe Anfrage mit demselben Seed ergab zu verschiedenen Zeiten drei leicht unterschiedliche Renderings. Nutzen Sie einen Seed, um zwei Prompt-Änderungen zu vergleichen, nicht um einem Kunden eine pixelgenaue Wiederholung zu versprechen.
- Ein Bild pro Anfrage, nur JPEG, keine Masken. Es gibt kein Inpainting-Feld.
Für wen es sich eignet
Nutzen Sie Anima Turbo, wenn Sie schnelle Anime- und Illustrationsentwürfe zu einem Preis pro Bild wollen, wenn Sie gern Tag-Prompts schreiben oder Tags mit ein paar Sätzen mischen möchten oder wenn Sie ungefilterte Ausgabe von einem kleinen Modell brauchen. Es eignet sich gut, um Figuren und Szenen auf 1k zu erkunden und die Treffer dann auf 1.5k zu heben.
Suchen Sie anderswo, wenn Sie fotografischen Realismus oder lesbaren Text im Bild brauchen.
Welche Anima-Familie Sie nehmen sollten
SpicyAPI hat zwei Anima-Familien. Sie teilen dasselbe Basismodell, die Wahl hängt also davon ab, ob Sie einen eigenen Look brauchen:
| Anima Turbo | Anima Turbo LoRA | |
|---|---|---|
| API-Modellnamen | circlestone-labs/anima-turbo/text-to-image, .../edit | circlestone-labs/anima-turbo-lora/text-to-image, .../edit |
| Zusätzliches Feld | Keines | loras: bis zu 3 Einträge, jeweils mit einem path und einem scale von 0 bis 4 |
| Am besten für | Schnelle Entwürfe, Prompts aus Tags und Sätzen, den Basis-Look | Einen bestimmten Kunststil, eine Figur oder einen Zeit-Look aus einer Anima-LoRA |
| Stilkontrolle | Stil-Tags im Prompt | Stil-Tags plus LoRAs |
| Preis | Pro Bild nach Auflösungsstufe | Gleiche Struktur; das Laden von LoRAs kostet keine gesonderte Gebühr |
Beginnen Sie mit Anima Turbo. Wechseln Sie zur LoRA-Familie, wenn ein Stil-Tag nicht reicht, etwa wenn ein Aquarell- oder Bleistift-Tag in unserem Test die Oberfläche nur angestupst hat.
Zwei naheliegende nächste Schritte:
- Eigene Stile. Die Anima-Turbo-LoRA-Familie lädt bis zu drei LoRAs pro Anfrage, sodass Sie einen bestimmten Look hinzufügen können, auch Adult-LoRAs aus der Community. Unser Begleitartikel erklärt es: Anima-Turbo-LoRA-Stilguide.
- Fotos umstylen. Der Bild-zu-Bild-Endpunkt nimmt ein Quellbild und eine
strengthvon 0 bis 1. Was jede Stärke bewirkt, lesen Sie in Foto zu Anime mit Anima Turbo.
FAQ
Unterstützt Anima Turbo Negativ-Prompts?
Nein. Die öffentlichen Felder sind prompt, aspect_ratio, resolution und seed, ohne Negativ-Prompt, Schritte, CFG oder Sampler. Schreiben Sie, was Sie wollen, in den Prompt, und legen Sie den Ton mit dem Rating-Tag (safe, sensitive oder nsfw) fest.
Welche Auflösung sollte ich nehmen?
Entwerfen Sie in 1k und lassen Sie die Bilder, die Ihnen gefallen, dann in 1.5k neu laufen. Die Stufe 1k entspricht etwa einem Megapixel, 1.5k etwa 2,4 Megapixeln, nativ erzeugt. In unseren Tests ergab derselbe Prompt mit demselben Seed bei 1.5k ein anderes Gesicht; sehen Sie es also als neue Aufnahme mit feineren Details, nicht als Vergrößerung.
Warum steht eine Signatur oder ein seltsamer Text in der Ecke?
Das Modell hat sich die Angewohnheit aus den Vorlagen abgeschaut. Wir sahen eine signaturartige Kritzelei oder eine Zeile Pseudotext bei etwa einem von fünf Bildern. Ein Negativ-Prompt kann sie hier nicht entfernen; wechseln Sie also den Seed oder schneiden Sie den Rand ab.
Liefert ein fester Seed jedes Mal dasselbe Bild?
Nicht zuverlässig. Dieselbe Anfrage mit demselben Seed ergab zu verschiedenen Zeiten drei leicht unterschiedliche Renderings. Nutzen Sie einen Seed, um zwei Prompt-Änderungen zu vergleichen, nicht um eine pixelgenaue Wiederholung zu versprechen.
Kann ich SDXL- oder Pony-LoRAs mit Anima verwenden?
Nein, nutzen Sie für Anima trainierte LoRAs, also die Anima-Turbo-LoRA-Familie. In unseren Tests wurde eine LoRA, die für ein anderes Basismodell trainiert war (ein FLUX-Modell), ohne Fehler geladen und änderte nichts. Der Basis-Endpunkt von Anima Turbo nimmt gar keine LoRAs an.
Kann Anima ein Bild bearbeiten, statt es neu zu zeichnen?
Es gestaltet um, statt zu bearbeiten. Der Bild-zu-Bild-Endpunkt nimmt ein Quellbild und eine strength von 0 bis 1, und in unseren Tests änderte sich bei einer vorhandenen Illustration kaum etwas, wenn wir ein neues Outfit oder einen Wechsel von Tag zu Nacht verlangten. Es gibt kein Masken- oder Inpainting-Feld.
Kann es Text in das Bild schreiben?
Nur ein, zwei Wörter. Sätze, Schilder und Bildunterschriften sind nichts, was dieses Modell gut kann; fügen Sie Text daher nachträglich in einem Editor hinzu.
Beherrscht es Fotorealismus?
Nein. Es ist ein Anime- und Illustrationsmodell, und kein Prompt lieferte uns einen fotografischen Look.