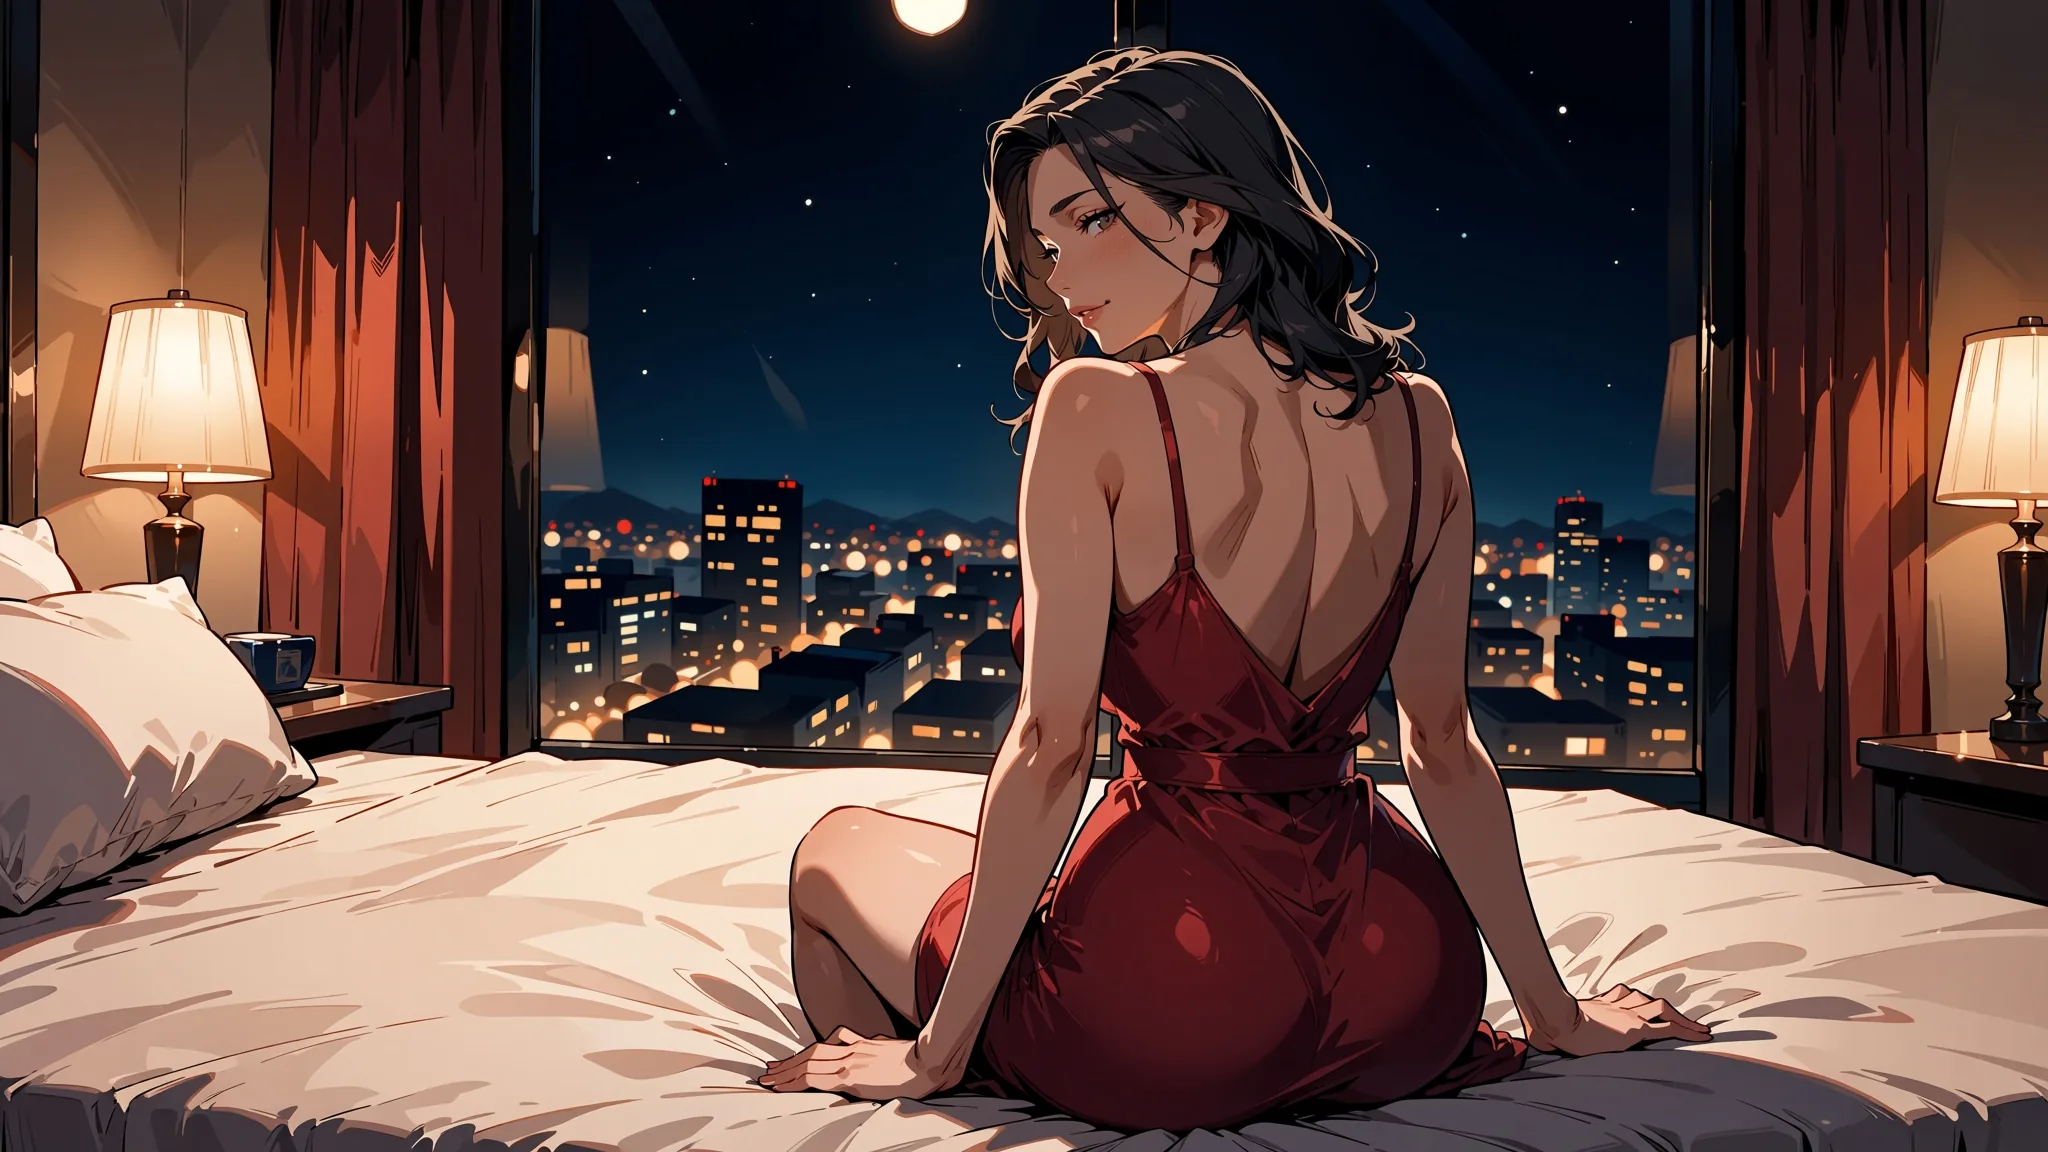
スタイル LoRA は 1 つだけ、scale 0.5 から 1.2 の範囲で読み込み、トリガーワードをプロンプトに入れてください。それ以外の用途には、通常の Anima Turbo ファミリーを使います。 2026 年 10 月 5 日に、コミュニティ製の LoRA 2 つを Anima Turbo LoRA で試して分かったことを、短くまとめるとこうなります。詳しく読むと、午後いっぱいかけたスタイルが何も効いていなかった、という落とし穴をいくつか避けられます。
Anima Turbo は、CircleStone Labs が Comfy Org と共同で公開しているアニメ・イラスト向けモデルで、NVIDIA Cosmos-Predict2 をベースに Qwen3 のテキストエンコーダーを使っています。Turbo は高速サンプリング向けの蒸留版です。LoRA ファミリーでは loras フィールドが加わります。1 リクエストにつき最大 3 つのアダプターを指定でき、それぞれ直リンクと scale で構成します。これらのエンドポイントは規制なしです。プラットフォームはコンテンツフィルターを追加していません。テストでも、当社で最も強いレベルのテストが、LoRA の有無にかかわらず、1 回目から書いたとおりに生成されました。このガイドのプロンプトはすべて、服を着た成人が登場する日常の場面です。操作を学ぶにはそれで十分です。
概要
| 質問 | 回答 (2026 年 10 月 5 日にテスト) |
|---|---|
| モデル | CircleStone Labs の Anima Turbo、20 億パラメーター |
| API のモデル名 | circlestone-labs/anima-turbo-lora/text-to-image と circlestone-labs/anima-turbo-lora/edit |
| LoRA フィールド | loras: 最大 3 件。それぞれ {path, scale} で指定。4 件目は拒否される |
path | .safetensors ファイルへの直接の HTTPS リンク |
scale | 0 〜 4、デフォルトは 1。おすすめは 0.5 〜 1.2 |
| 使えるもの | Anima 向けに学習された LoRA (提供元は Base ビルドでの学習を推奨しており、そうしたアダプターは Turbo にも適用できる) |
| 黙って何も起きないもの | FLUX など、別のベースモデル向けに学習された LoRA |
| サイズ | 1k (約 100 万画素) または 1.5k の段階。テキストから画像では 15 種類のアスペクト比 |
| テストでの速度 | 1 枚あたりのモデル処理時間は 2 〜 16 秒。新しい LoRA の最初のリクエストは遅くなることがある |
| 非対応 | ネガティブプロンプト、ステップ数、CFG、マスク。フォトリアルも不可 |
| 課金 | 解像度の段階ごとに 1 枚単位。LoRA の読み込みに別料金なし。失敗したリクエストには課金されません |
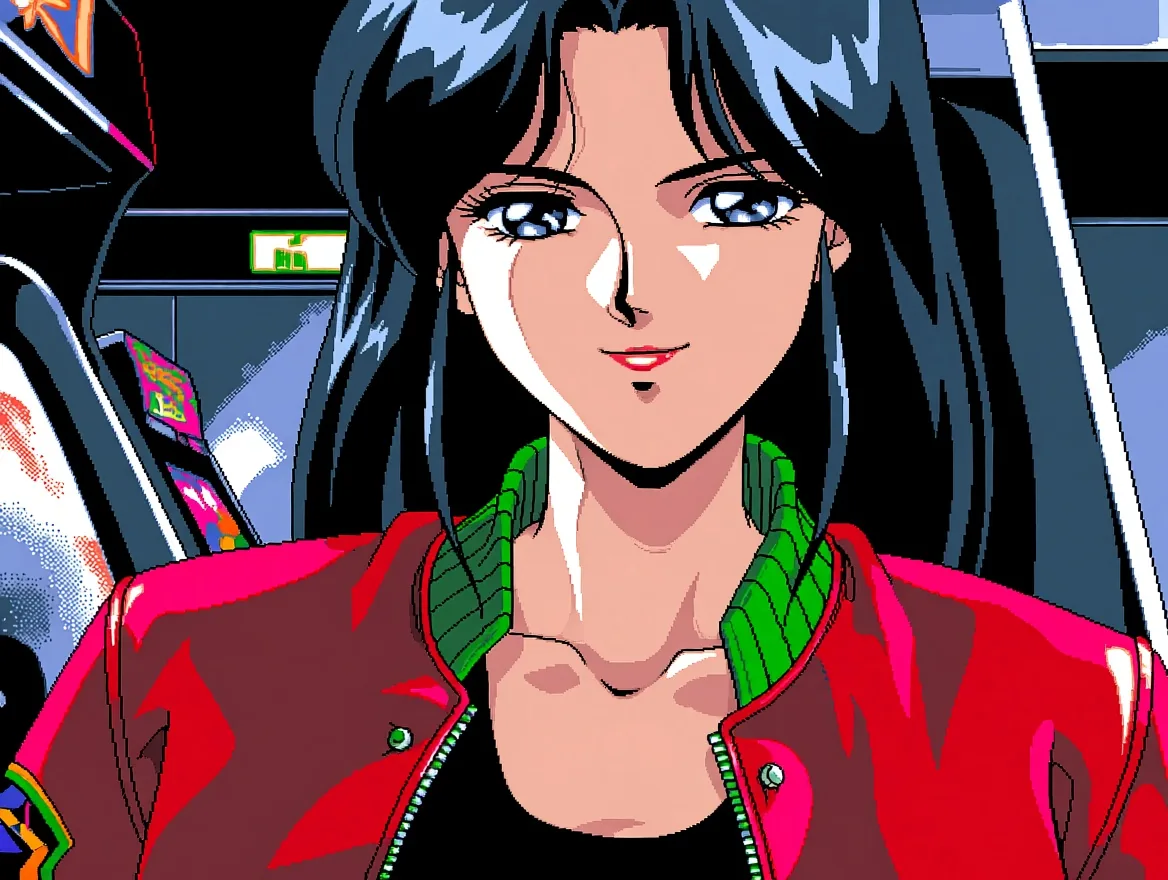
Anima Turbo LoRA、テキストから画像、4:3、1k、seed 42、PC-98 LoRA を scale 1 で使用。プロンプトは下に掲載しています。
使用した 2 つの LoRA
どちらも Hugging Face の公開リポジトリにあり、Anima 向けに作られています。
- PC-98 風: Melon-Bread/anima-pc98-gal-style-v0.2。トリガーは
pc98gal_style。1990 年代の日本の PC ゲームに見られる、ディザリングと限られたパレットの質感になります。 - マンガのインク: notverriegod/monochrome-grayscale_style。トリガータグは
monochrome, greyscale。スクリーントーン付きの白黒の線画になります。
テストした日、Hugging Face には 129 件の Anima 向け LoRA アダプターが掲載されていたので、探す対象には事欠きません。提供元は LoRA を Base ビルドで学習させることを推奨していますが、そうしたアダプターは Turbo にも適用できます。
別の Anima LoRA を選ぶ前のチェックリスト:
- ベースモデル: カードやタグに、FLUX、SDXL、Pony ではなく Anima 向けに学習されたと書かれている。
- リンクできるファイル: リポジトリに
.safetensorsファイルがあり、そのファイルへのresolve/main/のリンクを作れる。 - 公開アクセス: ログインしなくてもリポジトリを開ける。ゲート付きのものは HTTP 401 で失敗します。
- トリガーワード: カードに書かれている (または不要と明記されている)。そのままコピーしてください。
- ライセンス: その LoRA のカードに表示されているライセンスを、出力を使う前に読んでください。ライセンスはアダプターの作者が決めています。
LoRA の読み込み: リンクはファイルを指す必要がある
各エントリーの path は、.safetensors ファイルへの直接の HTTPS リンクです。Hugging Face なら、モデルの解説ページではなく resolve/main/ の URL を指します。両方の失敗パターンをわざと試しました。
- リポジトリページのリンクは、直接のダウンロードリンクを求めるメッセージで失敗します。
- ゲート付きリポジトリ (ログインが必要なもの) は、HTTP 401 のメッセージで失敗します。
どちらも課金されません。新しい LoRA の最初のリクエストは、ファイルの取得が入るため遅くなることもあります。今回は 1 回が 3 分近くかかり、それ以外は 2 秒から 26 秒でした。通常のリクエストのモデル処理時間は 2 秒から 16 秒で、60 回のうち 52 回が 10 秒未満でした。
上のアーケードの画像のリクエスト全体は次のとおりです。
{
  "model": "circlestone-labs/anima-turbo-lora/text-to-image",
  "prompt": "pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1girl, solo, adult woman, mature female, long dark blue hair, red bomber jacket worn open over a black tank top, leaning against an arcade cabinet, neon signs, night arcade, confident smirk, looking at viewer, retro anime aesthetic",
  "aspect_ratio": "4:3",
  "resolution": "1k",
  "seed": 42,
  "loras": [
    {
      "path": "https://huggingface.co/Melon-Bread/anima-pc98-gal-style-v0.2/resolve/main/pc98gal_style-v02_anima.safetensors",
      "scale": 1
    }
  ]
}
ネガティブプロンプト、ステップ数、CFG のフィールドはありません。トーンを決める主な手段はレーティングタグなので、どのプロンプトでもトリガーワードの後に safe を置いています。パラメーター、制限、現在の料金はテキストから画像のモデルページにあります。LoRA の読み込みに別途料金はかかりません。
トリガーワード: 必要な LoRA と不要な LoRA
LoRA のページでトリガーを確認し、そのうえでトリガーなしでも試してください。LoRA によって挙動が違うためです。
モノクロ LoRA は、monochrome, greyscale をプロンプトに入れるまでカラーのままでした。入れると、完全な白黒のインク画になりました。一方、PC-98 LoRA は pc98gal_style がなくても画風が変わりました。同じ素のプロンプトと seed で、LoRA なしの場合と、PC-98 LoRA を scale 1 で読み込みトリガーをどこにも入れない場合を比べます。
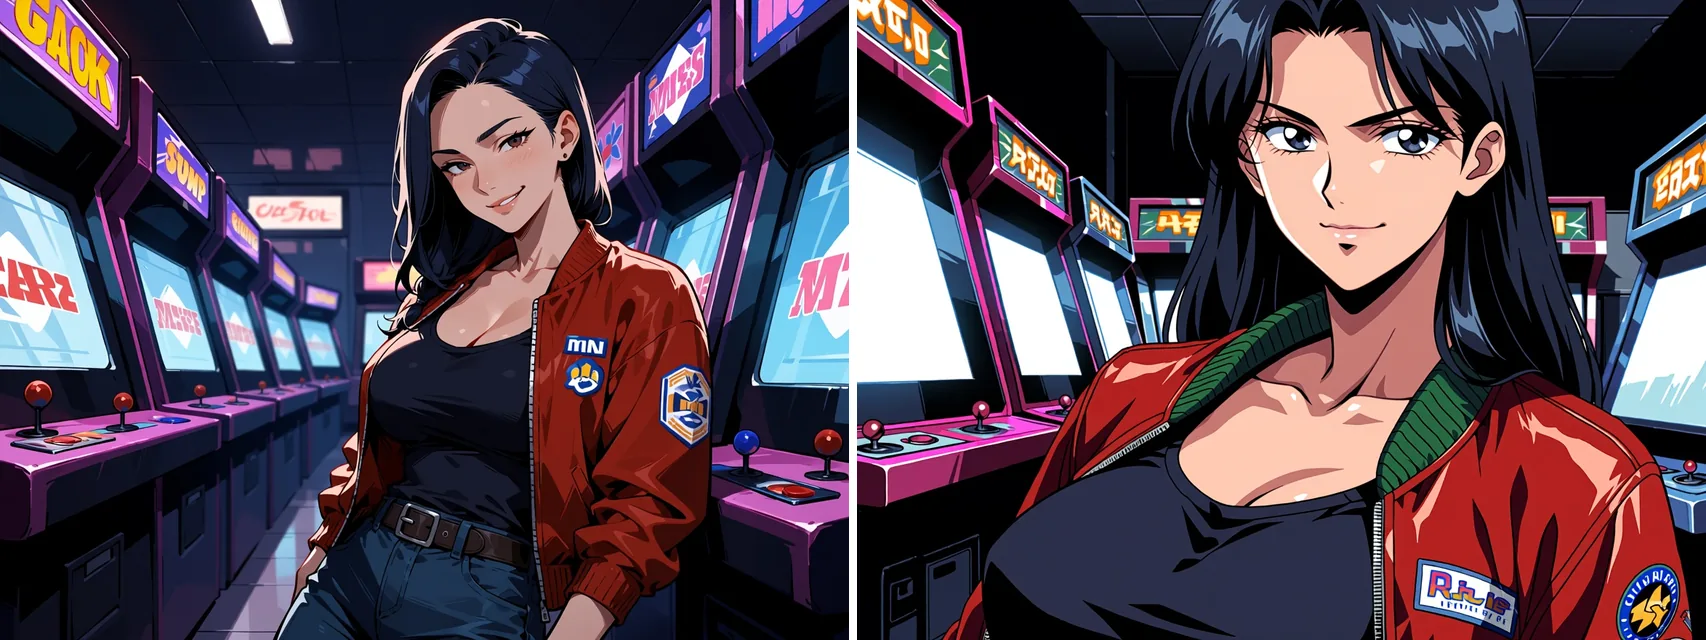
Anima Turbo LoRA、テキストから画像、4:3、1k、seed 42、トリガーワードなしの同一プロンプト。左: LoRA なし。右: PC-98 LoRA を scale 1 で使用。
右の画像は、トリガーワード入りのプロンプトで得られる画像ではありません。トリガーワード入りのほうが、さらに画風が強く出ます。そのため、トリガーなしで効く LoRA でも、トリガーは入れる価値があります。seed を使うと実行どうしを比べられますが、ピクセルまで同一になる保証はありません。同じリクエストでも、時間をおくと少しずつ違う仕上がりが 3 回得られました。
scale の段階: 0、0.5、1、1.5、4
scale は 0 から 4 までで、デフォルトは 1 です。PC-98 のプロンプトにトリガーを入れ、同じ seed で 5 つの値を試しました。
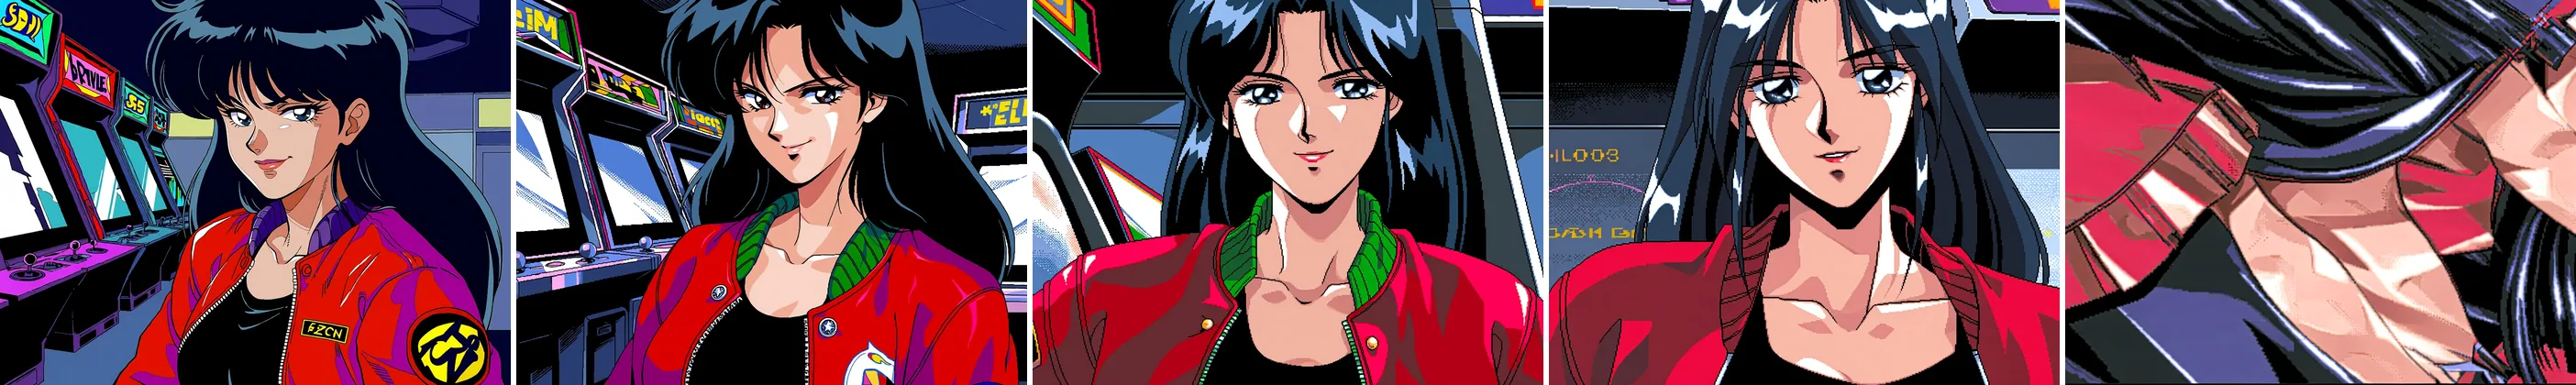
Anima Turbo LoRA、テキストから画像、4:3、1k、seed 42、PC-98 LoRA を左から scale 0、0.5、1、1.5、4 で使用。
| scale | 結果 | 使いどころ |
|---|---|---|
| 0 | LoRA なしと同一 | アダプターが本当に効いているかの確認 |
| 0.5 | スタイルがほんのり乗る | 隠し味、または重ねたときの 2 つ目のアダプター |
| 1 | 作者の意図どおりの完全なスタイル | デフォルト。まずここから |
| 1.5 | スタイルがさらに強く出る | 1.2 でもまだ弱いと感じたときだけ |
| 4 | 画像が抽象的な形に崩れた | 使いどころなし。避ける |
おすすめは 0.5 から 1.2 です。 まず 1 から始めてください。LoRA が被写体とぶつかるとき、または隠し味として使いたいときは 0.5 から 0.8 に下げます。効果が弱すぎると感じたときだけ 1.2 まで上げます。範囲の上限は存在しますが、使う理由は見当たりませんでした。4 では使える結果は返ってきませんでした。
静かな失敗: ベースモデルが違う
別のベースモデル向けに学習された LoRA は、エラーなしで読み込まれ、何も変えません。 FLUX 向けに学習したものを試したところ、出力は LoRA なしとピクセル単位で同一でした。リクエストは成功し、画像 1 枚分が課金され、プロンプトのせいだと思い込んで 1 時間悩むことになりかねません。
確認は簡単です。同じ seed で、LoRA を scale 0 にした場合と 1 にした場合の 2 回、プロンプトを実行します。2 枚が同一なら、そのアダプターは Anima 向けではありません。scale 0 は LoRA なしと同一なので、この組み合わせは信頼できるテストになり、上のような段階比較はそのままこの確認を兼ねます。
LoRA が何も効かなかった、またはリクエストが失敗したとき
| 症状 | 原因 | 対処 |
|---|---|---|
| リクエストは成功するが、LoRA なしと同じ画像になる | アダプターが別のベースモデル向けに学習されている (FLUX 向けで試した) | 同じ seed で scale 0 と scale 1 を比べ、Anima 向けのアダプターを探す |
| スタイルがほとんど見えない | トリガーワードがない、または scale が低すぎる | LoRA のカードにあるトリガーを足し、1 で試す |
| 直接のダウンロードリンクを求めるエラー | ファイルではなくリポジトリのページを貼った | resolve/main/...safetensors の URL を使う |
| HTTP 401 のメッセージ | ログインが必要なゲート付きリポジトリ | 公開されているファイルを選ぶ |
| リクエストが拒否される | loras のエントリーが 3 件を超えている | 1 件減らす |
| 画像が形に崩れる | scale が高すぎる (今回のテストでは 4 で発生) | 0.5 〜 1.2 に戻す |
| 最初のリクエストが遅い | ファイルを取得している最中 | 待つ。新しい LoRA の最初のリクエストは時間がかかることがある |
リンクに関する 2 つのエラーは課金されませんでした。
2 つまたは 3 つの LoRA を同時に使う
最大 3 つまで重ねられ、4 つ目は拒否されます。重視するスタイルを 1 にして、ほかを低くします。1、0.6、0.25 の 3 アダプターのリクエストは今回のテストで機能し、メインのスタイルもはっきり読み取れました。下のペアでは、PC-98 LoRA を 0.8、AX1Y2JP の美的調整用の LoRA を 0.5 で使いました。
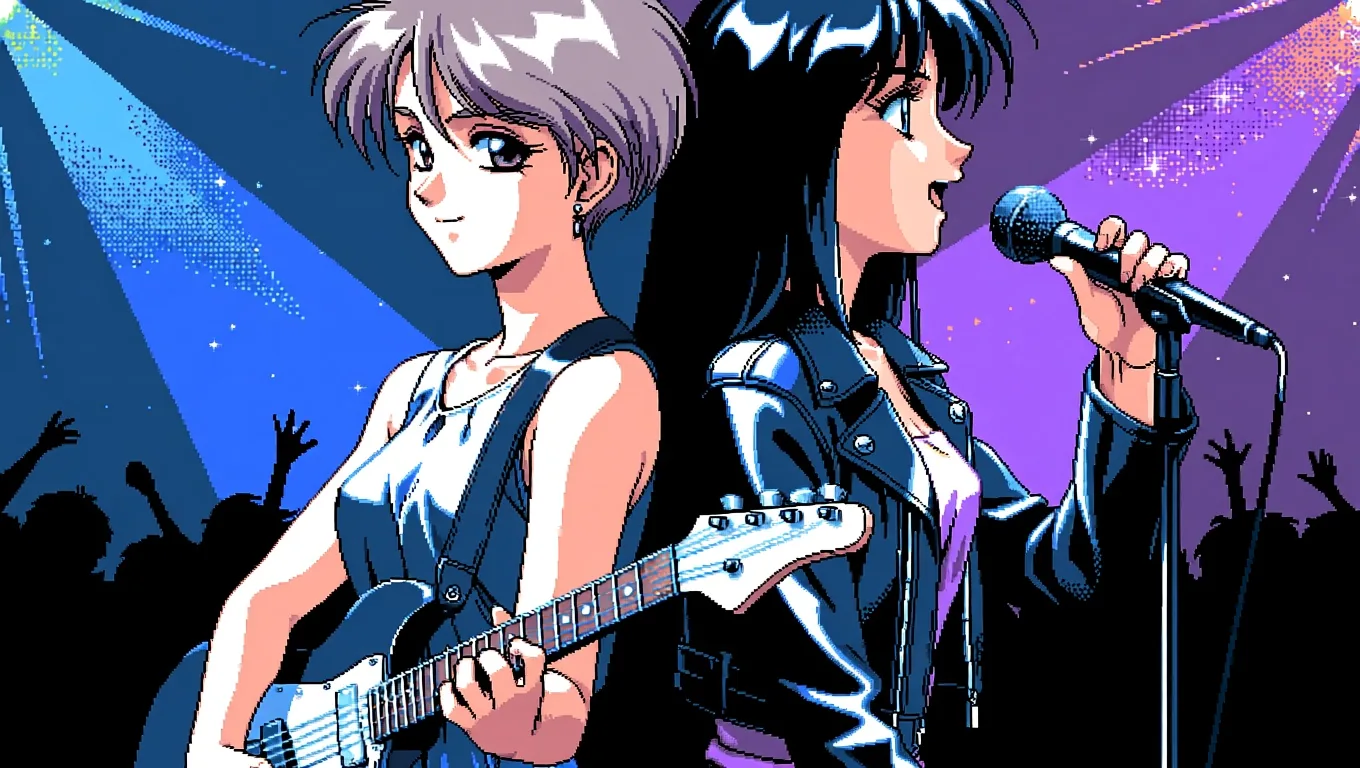
Anima Turbo LoRA、テキストから画像、16:9、1k、seed 21、2 つの LoRA を 0.8 と 0.5 で使用。
追加するアダプターは、メインより弱くしておきます。画面が濁ったら、プロンプトをいじる前に 1 つ外してください。
ほかの被写体でのマンガのインクと PC-98
同じ 2 つの LoRA は、被写体を変えても安定していました。左から、キャラクターのいない PC-98 風の海辺の町、PC-98 風のノワール探偵、バイクを持つ女性のマンガインク調ポートレートです。
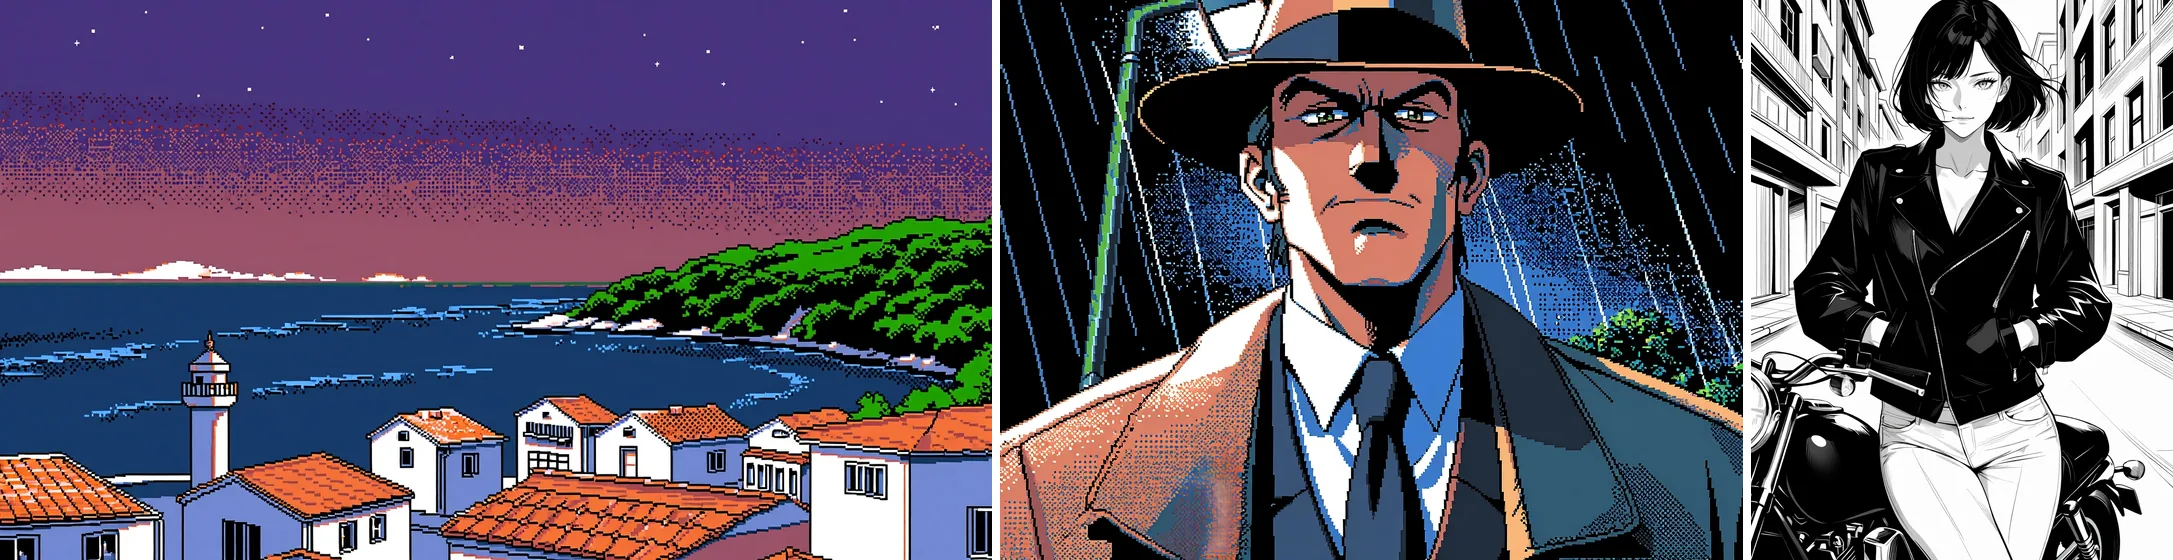
Anima Turbo LoRA、テキストから画像、LoRA scale 1 の 3 リクエスト: 16:9 seed 17、4:3 seed 18、3:4 seed 16。
探偵のプロンプトは、そのまま次のとおりです。
pc98gal_style, dithering, limited color palette, flat cel shading, thin linework, safe, 1boy, solo, adult man, mature male, detective, trench coat, fedora, loosened tie, standing under a streetlamp in the rain, noir, serious expression, retro anime aestheticマンガのインクにするには、冒頭を masterpiece, best quality, safe, monochrome, greyscale に差し替え、プロンプトの最後に ink shading, screentone を付けます。次は雨の橋に立つ剣士で、同じ LoRA を scale 1 で使っています。
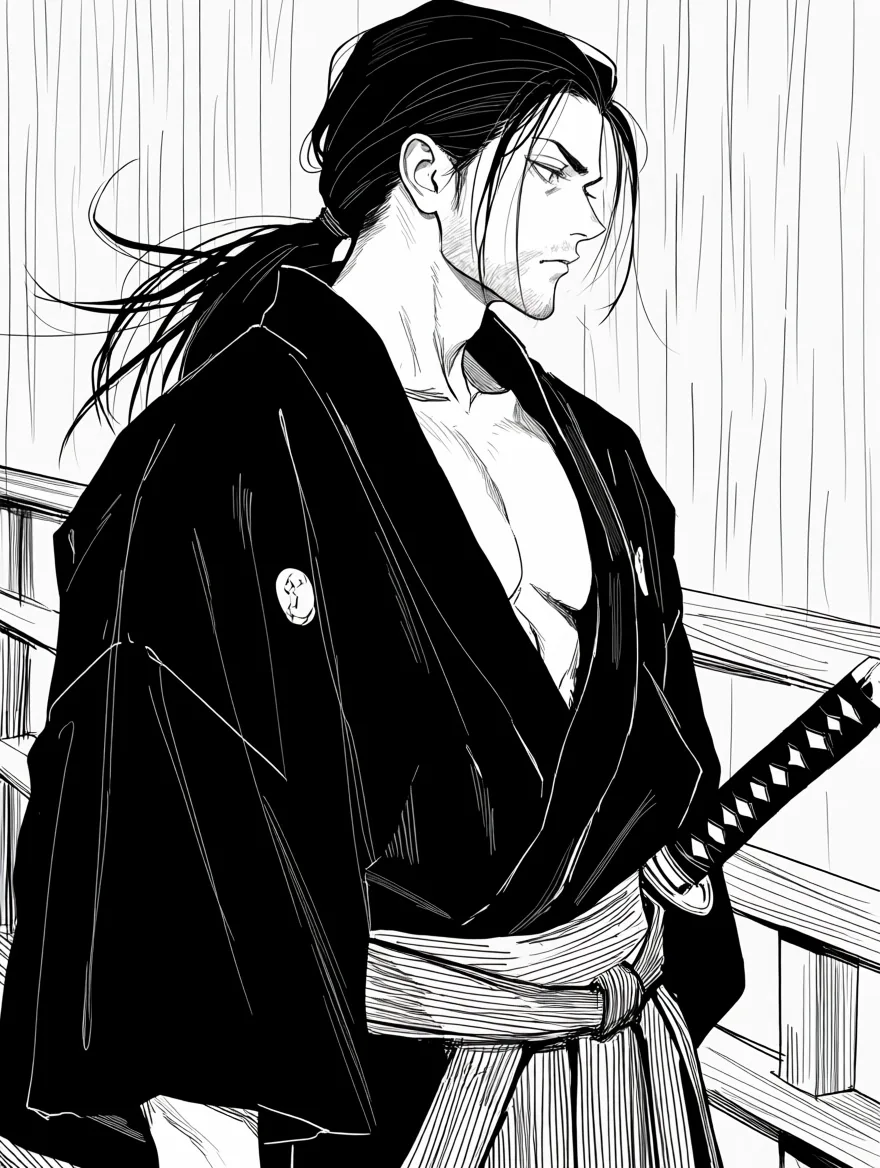
Anima Turbo LoRA、テキストから画像、3:4、1k、seed 9、モノクロ LoRA を scale 1 で使用。
注意したい癖が 1 つあります。作品から身についた癖で、隅に署名のような走り書きや疑似文字の 1 行を描くことがあります。5 枚に 1 枚ほどの頻度で見られました。ネガティブプロンプトでは抑えられないので、seed を変えてください。
写真に LoRA を使う: 画像から画像
画像から画像のエンドポイントは、元画像 1 枚、0 から 1 の strength、そして同じ loras フィールドを受け取ります。アスペクト比のフィールドはなく、出力は元画像の形を保ちます。0.75 なら、写真は構図を保ったままスタイルをまといます。この屋上の写真を、PC-98 LoRA を 0.75 で通しました。
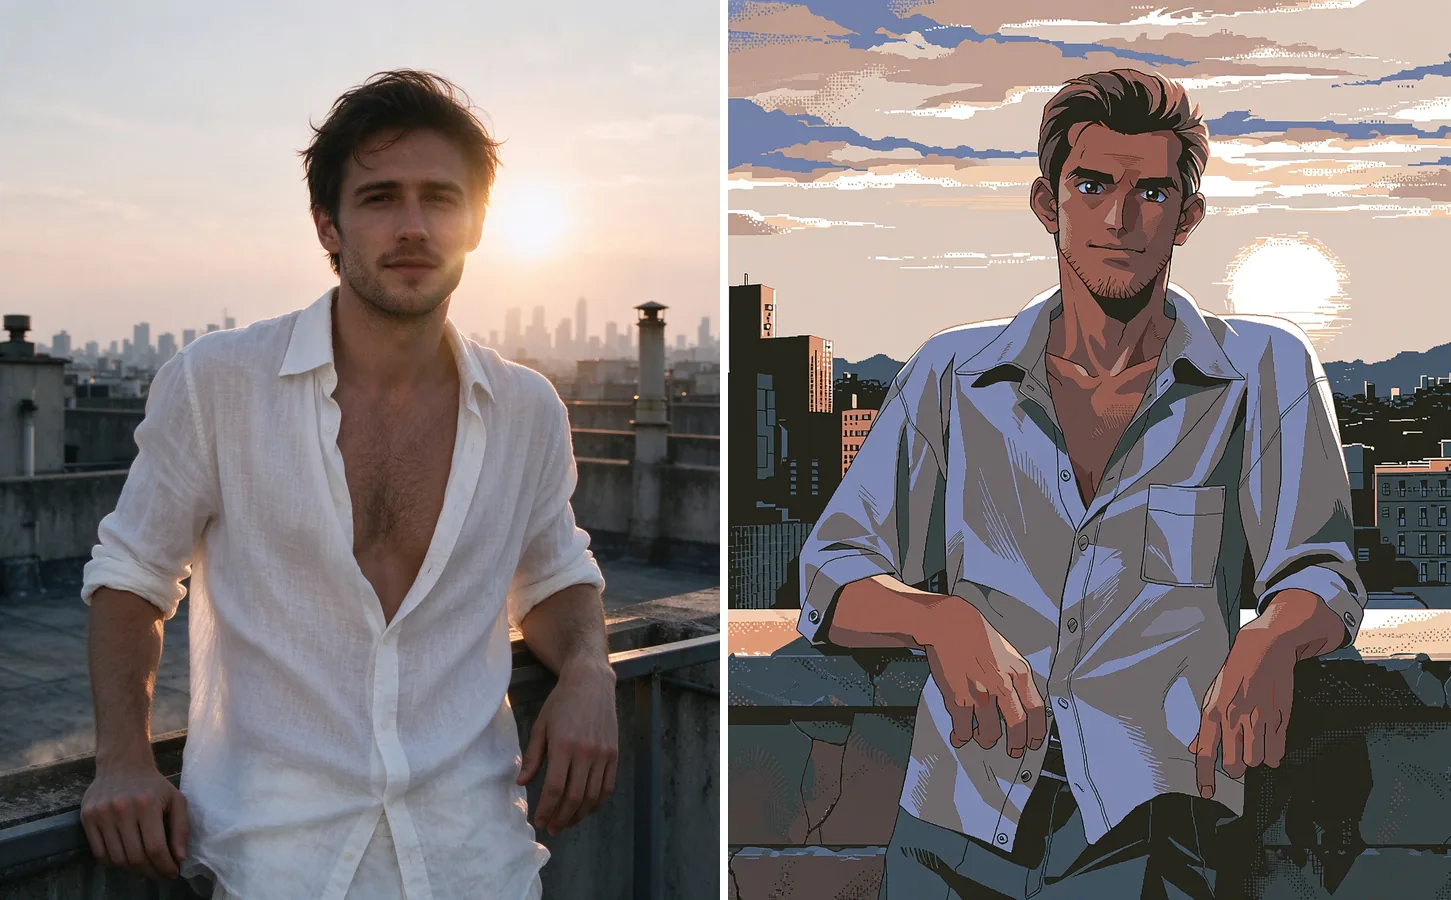
左: 元の写真。右: Anima Turbo LoRA、画像から画像、1k、seed 42、PC-98 LoRA を scale 1、strength 0.75。
別の元画像でも同じ設定を試しました。ポーチでアコースティックギターを弾く男性の生成写真です (左半分は Anima の出力ではなく、当社で用意した元写真です)。
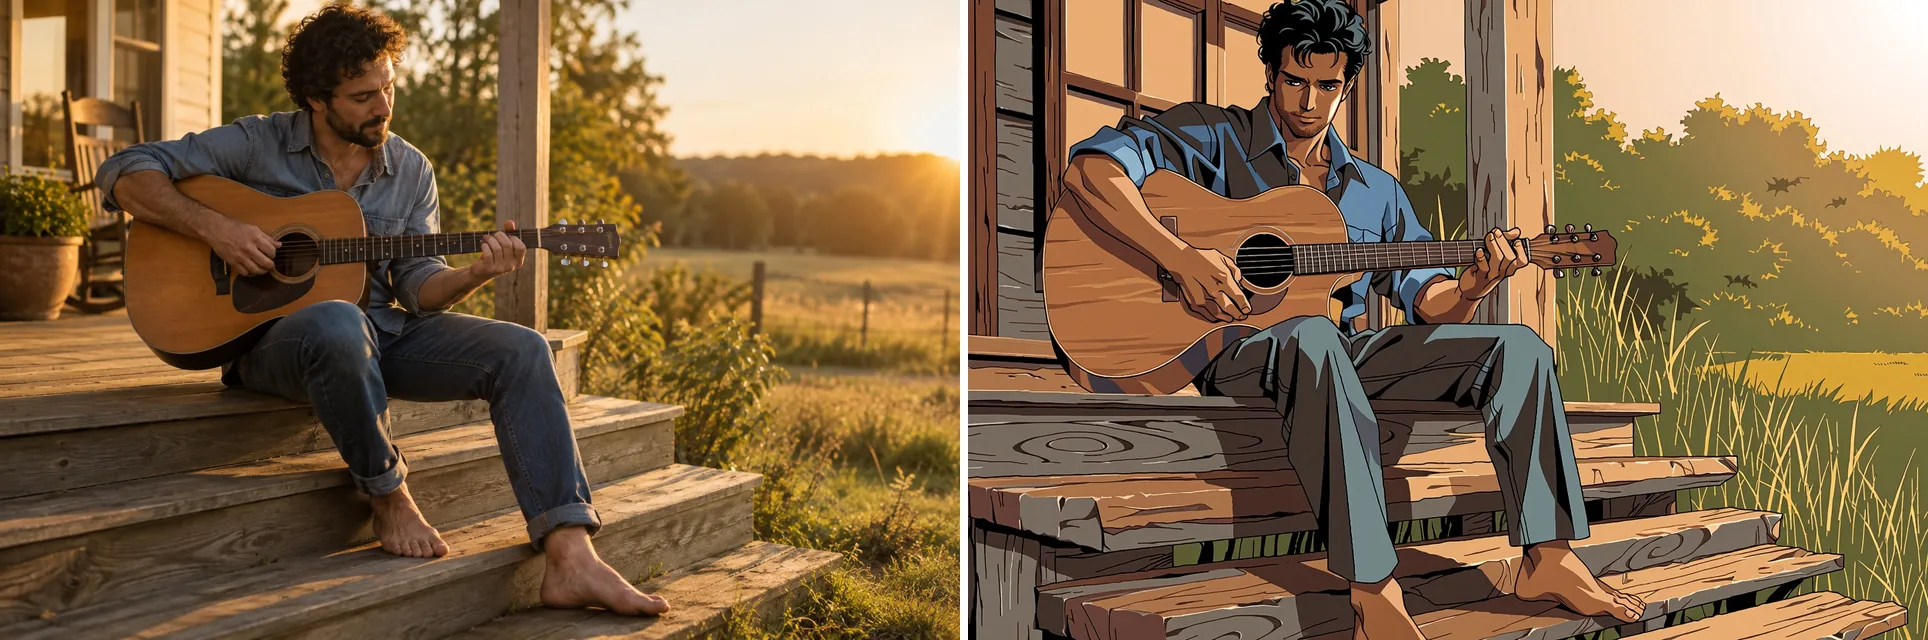
左: 元の写真。右: Anima Turbo LoRA、画像から画像、1k、seed 3、PC-98 LoRA、strength 0.75。
このツールは画風を変換するもので、編集の指示には従いません。新しい服装や昼から夜への変更を頼んでも、ほとんど何も変わらないと考えてください。既存のカラーイラストをマンガのインクにするのは難しいケースです。0.8 ではカラーのままでした。0.85 ではインク画になり、その strength ではポーズも描き直されました。
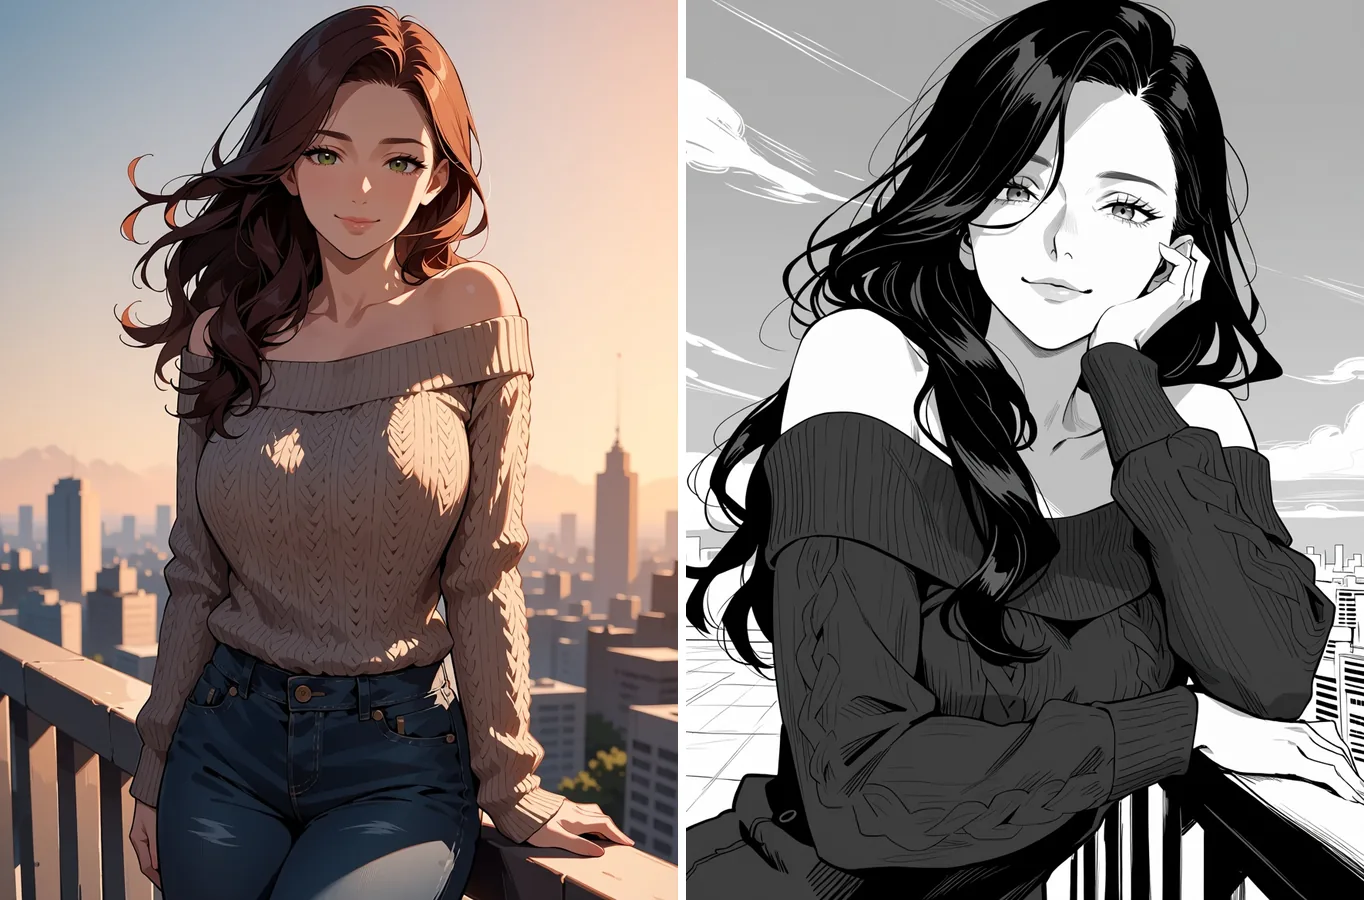
左: Anima Turbo のテキストから画像の出力。右: Anima Turbo LoRA、画像から画像、1k、seed 42、モノクロ LoRA を scale 1、strength 0.85。
元画像が写真だと、インク LoRA はフラットなイラストよりも描き込みがいがあります。ここでは、スクーターに乗るカップルの生成写真をモノクロ LoRA の 0.85 に通しました (左半分は Anima の出力ではなく、当社で用意した元写真です)。インクの質感はしっかり出て、スクーターとドレスはカラーのまま残り、構図は少しだけ動きました。
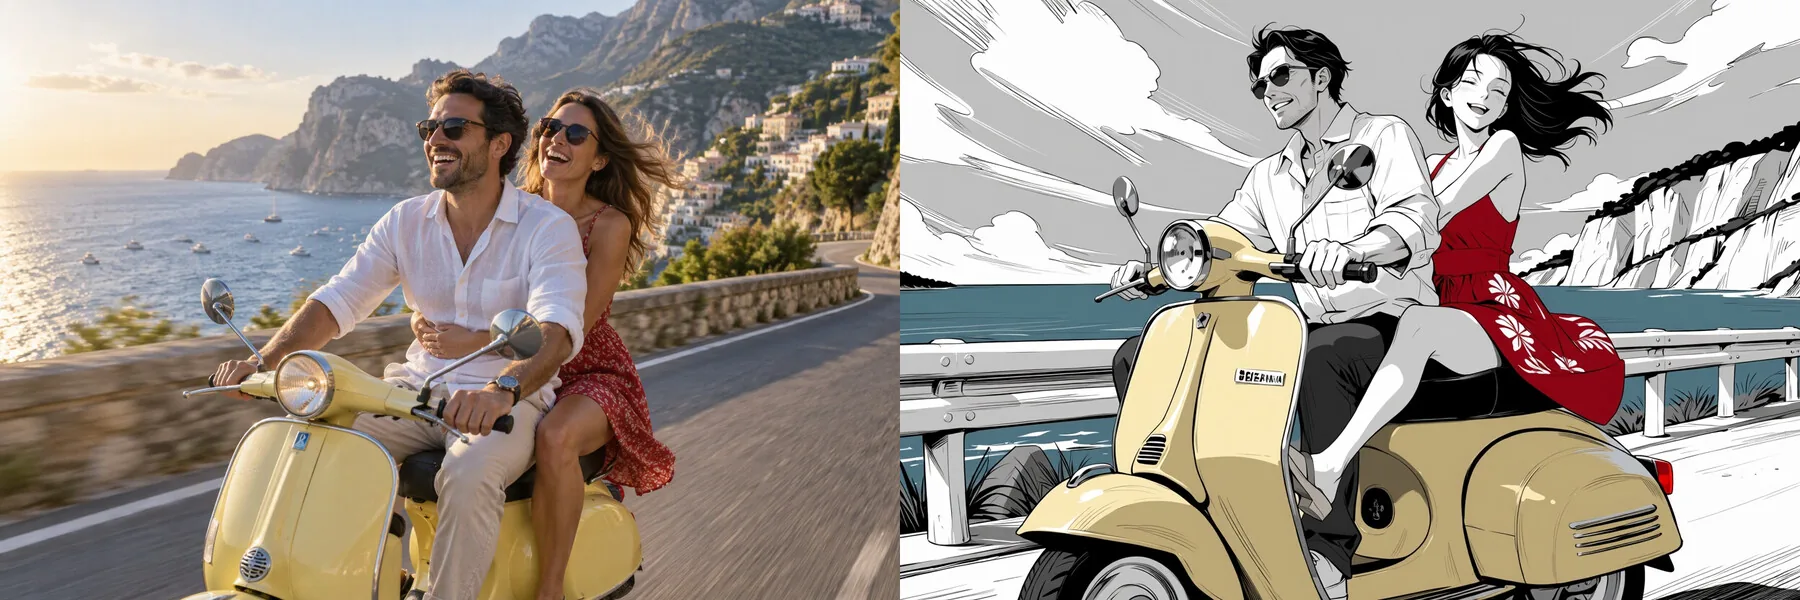
左: 元の写真。右: Anima Turbo LoRA、画像から画像、1k、seed 3、モノクロ LoRA を scale 1、strength 0.85。
屋上のイラストのインク用プロンプトです。書き出しは同じく safe です。
masterpiece, best quality, safe, monochrome, greyscale, 1girl, solo, mature female, adult woman, long wavy hair, off-shoulder knit sweater, leaning on a rooftop railing, city skyline, wind in hair, soft smile, looking at viewer, ink shading, screentone通常の写真変換に使う strength の値を段階的に並べた比較は、strength ガイドにあります。画像から画像のページに各フィールドの一覧があります。
どのファミリーを使うか
- 使いたいスタイルファイルがない、またはまずモデルに慣れたい: 通常の Anima Turbo を使います。LoRA の読み込みに別途料金はかかりませんが、スタイルファイルがなければ LoRA の出番はありません。モデル単体でできることは、モデルのテストで紹介しています。
- 特定の画風、繰り返し登場するキャラクター、作家のスタイルがほしい: Anima Turbo LoRA を使い、scale 1 でトリガーワードを入れ、scale 0 でも 1 回確認します。
- 手元にあるのが FLUX や SDXL のファイル: ここでは機能しません。Anima 向けのものを探してください。
Anima はアニメ・イラスト向けのモデルで、フォトリアルは描けません。そのため、リアル系の LoRA との組み合わせはおすすめしません。scale は 0.5 から 1.2 に収め、アダプターは 3 つまでにして、新しいファイルを試すたびに scale 0 の確認を行ってください。
| 目的 | 選ぶもの |
|---|---|
| 特定のスタイルファイルを使わない、アニメやイラスト | Anima Turbo |
| 名前のある画風、キャラクター、作家のスタイル | Anima Turbo LoRA、scale 1、トリガーワードを入れる |
| 写真の上に重ねるスタイル | Anima Turbo LoRA の画像から画像、strength は 0.75 前後 |
| フォトリアル | このモデルではない |
通常の Anima Turbo だけでも、アダプターなしで幅広い表現ができます。次の 2 枚は、LoRA をまったく使わずにタグ形式のプロンプトだけで生成しました。
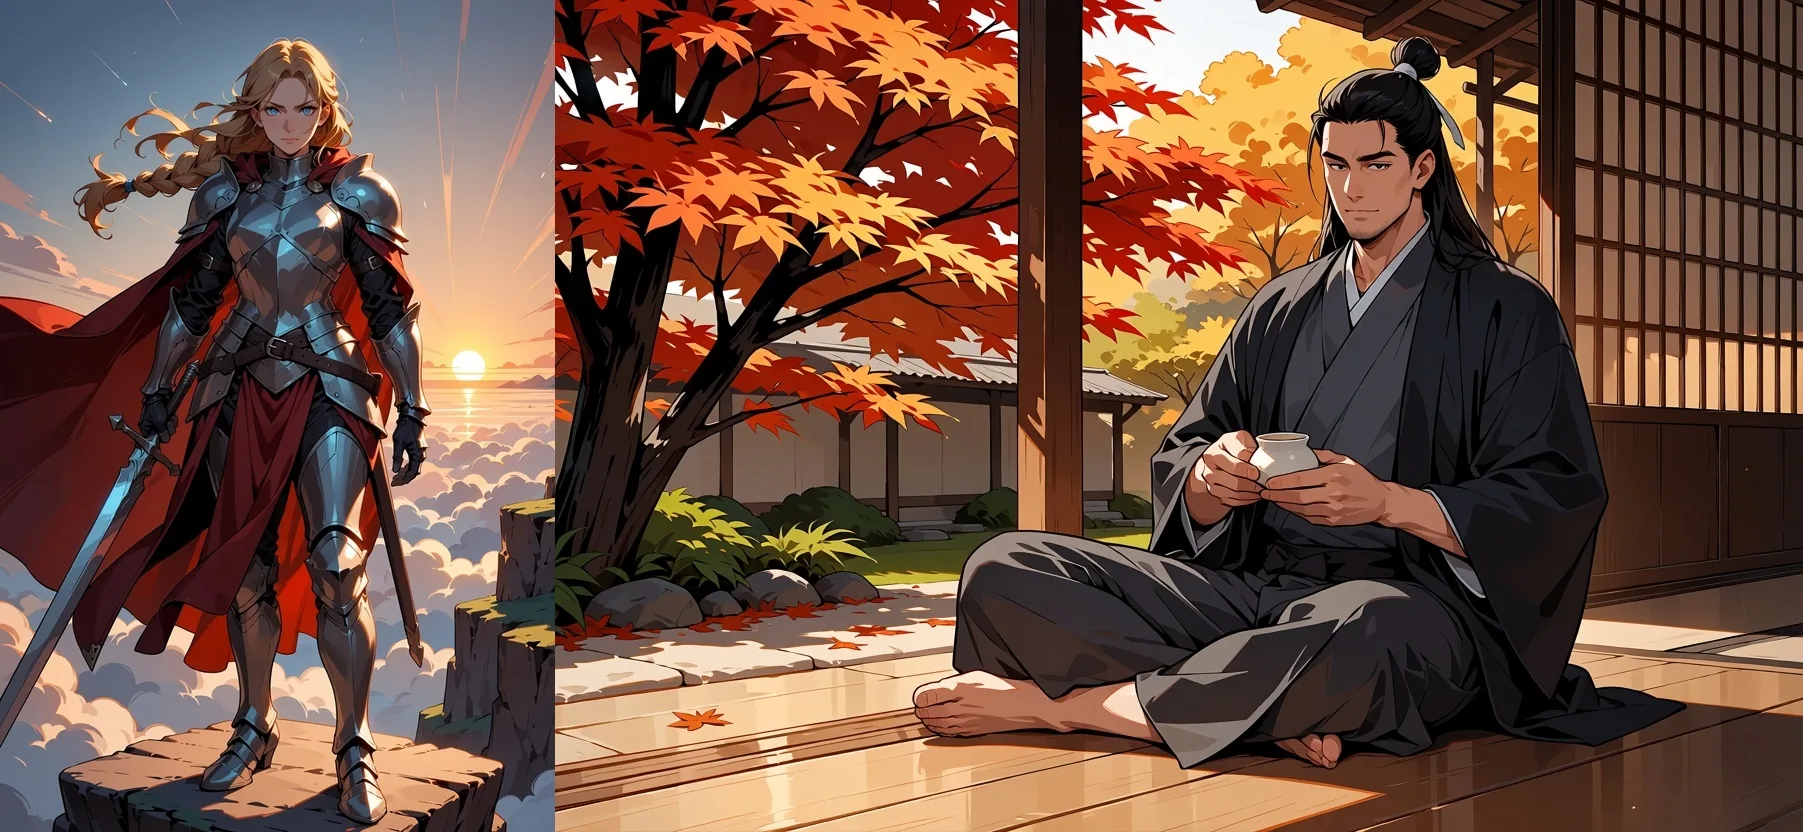
Anima Turbo (LoRA なし)、テキストから画像、1k。左: 2:3、seed 6。右: 3:2、seed 13。
FAQ
トリガーワードは必要ですか?
LoRA のカードを確認し、そのうえでトリガーワードなしでも試してください。今回のテストでは、モノクロ LoRA は monochrome, greyscale をプロンプトに入れるまでカラーのままでしたが、PC-98 LoRA は pc98gal_style がなくてもスタイルが変わりました。それでも、トリガーを入れると見た目はさらに強く出ました。
SDXL、Pony、FLUX の LoRA を Anima で使えますか?
使えません。別のベースモデル向けに学習されたアダプターは、エラーなしで読み込まれ、何も変えません。FLUX のテストでは、出力は LoRA なしとピクセル単位で同一でした。Anima 向けに作られたアダプターを探してください。
同時にいくつの LoRA を読み込めますか?
3 つです。4 つ目は拒否されます。メインのスタイルを 1 にして、ほかを低くしてください。今回のテストでは、1、0.6、0.25 で機能しました。
scale はいくつから始めればよいですか?
1 から始めて、0.5 から 1.2 の範囲で動かします。scale 0 は LoRA なしと同じで、1.5 ではスタイルがさらに強く出て、4 では今回のテストで画像が崩れました。
Anima Turbo はネガティブプロンプトに対応していますか?
いいえ。ステップ数、CFG、サンプラーのフィールドもありません。トーンは、プロンプトの先頭にある safe などのレーティングタグで決めてください。
隅に署名や変な文字が入るのはなぜですか?
モデルが作品から身につけた癖です。5 枚に 1 枚ほどの頻度で見られました。seed を変えてください。ネガティブプロンプトでは抑えられません。
seed を固定すれば、同じ画像になりますか?
確実にはなりません。seed で実行どうしを比較しやすくなりますが、同じリクエストと seed でも、時間をおくと少しずつ違う仕上がりが 3 回得られました。
画像を描き直さずに編集できますか?
できません。画像から画像はスタイルを変換するもので、編集の指示には従わず、マスクもありません。新しい服や昼から夜への変更は、今回のテストではほとんど動きませんでした。どこまで描き直すかは strength で決まり、0.75 では写真の構図が保たれました。