Per l’arte anime NSFW partendo solo da un prompt, Anima Turbo è stato la scelta migliore nei nostri test: ha reso come scritto il nostro test di contenuto più forte al primo tentativo, è pensato per l’anime e non richiede file aggiuntivi. Aggiungi Anima Turbo LoRA quando vuoi uno stile o un personaggio tuo, Prefect Pony XL quando lavori con i tag in stile Pony e una base nata fotorealistica solo se hai intenzione di guidarla con un LoRA anime. I modelli generalisti come FLUX 3 e Ideogram v4.5 hanno rifiutato quasi tutto ciò che andava oltre una foto neutra in bikini.
«Migliore» dipende dal lavoro, quindi questa è una guida alla scelta e non una classifica. Ogni affermazione qui sotto viene dalle nostre esecuzioni del 5 ottobre 2026 o dai test di contenuto del catalogo SpicyAPI, e ogni sezione dice quanto era piccolo il campione. Non classifichiamo la qualità dell’immagine oltre quello che abbiamo visto.
In sintesi: quale modello per quale lavoro
| Il tuo lavoro | Scelta | Perché, nei nostri test | Pagina |
|---|---|---|---|
| Arte anime da testo, senza file aggiuntivi | Anima Turbo | Modello per anime e illustrazione; la maggior parte dei livelli testati (scene intense comprese) resa come scritto | Anima Turbo |
| Un tuo stile artistico o un personaggio ricorrente | Anima Turbo LoRA | Lo stesso modello con fino a 3 LoRA tuoi | Anima Turbo LoRA |
| Prompt di tag in stile Danbooru o Pony | Prefect Pony XL | Checkpoint anime della community della linea Pony XL, solo da testo a immagine | Prefect Pony XL |
| Base fotorealistica che può anche passare all’anime | Z-Image Turbo LoRA | Fotorealistico di default; anime con un LoRA anime; scene intense rese | Z-Image Turbo LoRA |
| Un LoRA anime su un’altra base, più la modifica | Qwen Image 2512 LoRA | Accetta LoRA e modifica le immagini; scene intense rese | Qwen Image 2512 LoRA |
| Hai già un LoRA per FLUX.1 Dev | FLUX.1 Dev LoRA | Accetta i tuoi LoRA; il livello più forte è stato attenuato nei nostri test | FLUX.1 Dev LoRA |
| Lavoro senza restrizioni su FLUX 3 o Ideogram v4.5 | Nessuno dei due | Hanno rifiutato 10 richieste su 12 e 11 su 13 | vedi sotto |
Come descriviamo i livelli di contenuto
Usiamo una scala a cinque gradini. L1 è allusivo (lingerie, una spallina che scivola dalla spalla). L2 è parziale, più audace. L3 è contenuto molto audace. L4 è una scena intensa tra due adulti. L5 è estremo: contenzione consensuale tra adulti, o violenza cruenta in stile cinematografico. Su Anima non abbiamo eseguito L5. In questo articolo non compare alcun prompt oltre L1 e ogni personaggio è un adulto. La piattaforma stessa non aggiunge alcun filtro sui contenuti su questi endpoint, quindi conta ciò che ogni modello fa con la richiesta.
Anima Turbo: la scelta migliore per l’anime solo da prompt nei nostri test
Scegli Anima Turbo se vuoi un output anime o di illustrazione da un prompt e nient’altro. È la versione distillata di Anima di CircleStone Labs, un modello da 2 miliardi di parametri costruito su NVIDIA Cosmos-Predict2 con un encoder di testo Qwen3. L’editore consiglia di partire dalla versione Turbo, che secondo lui è in media solo leggermente peggiore della versione Aesthetic pur essendo molto più veloce.
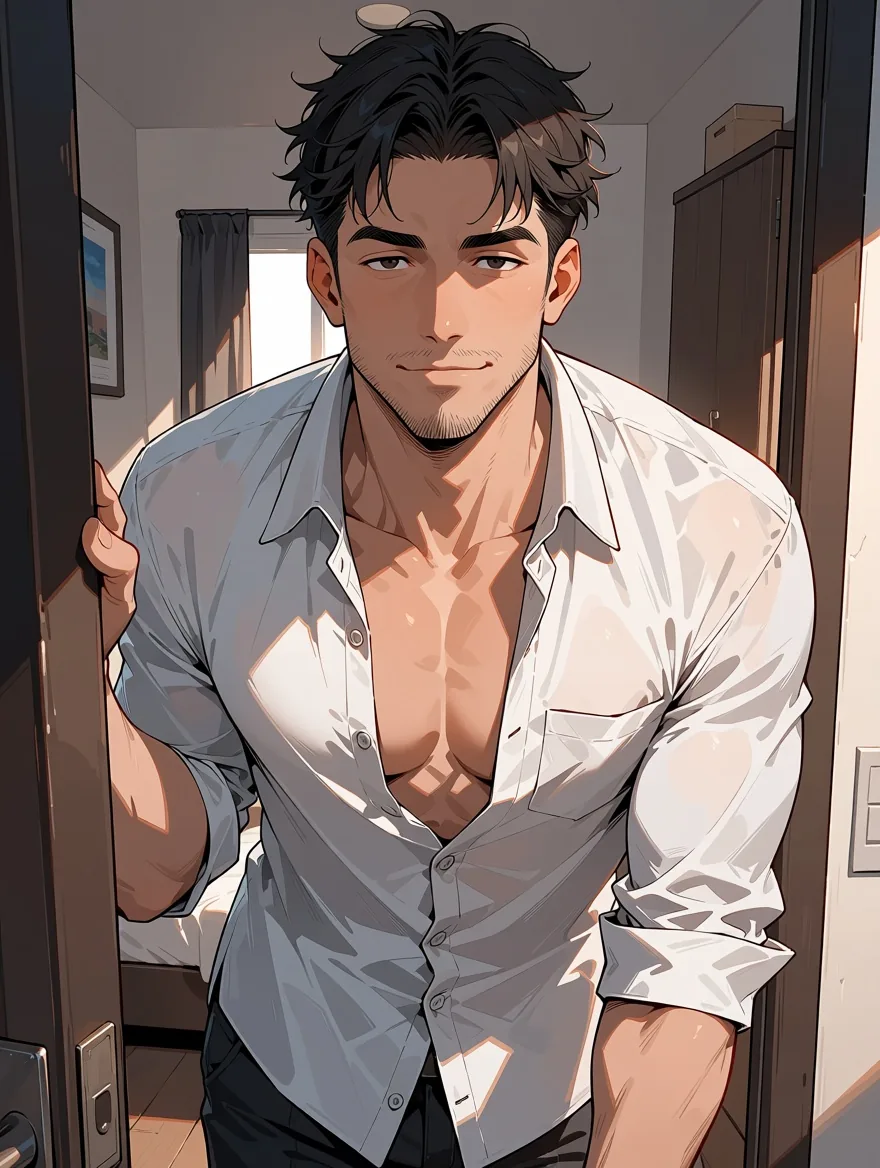
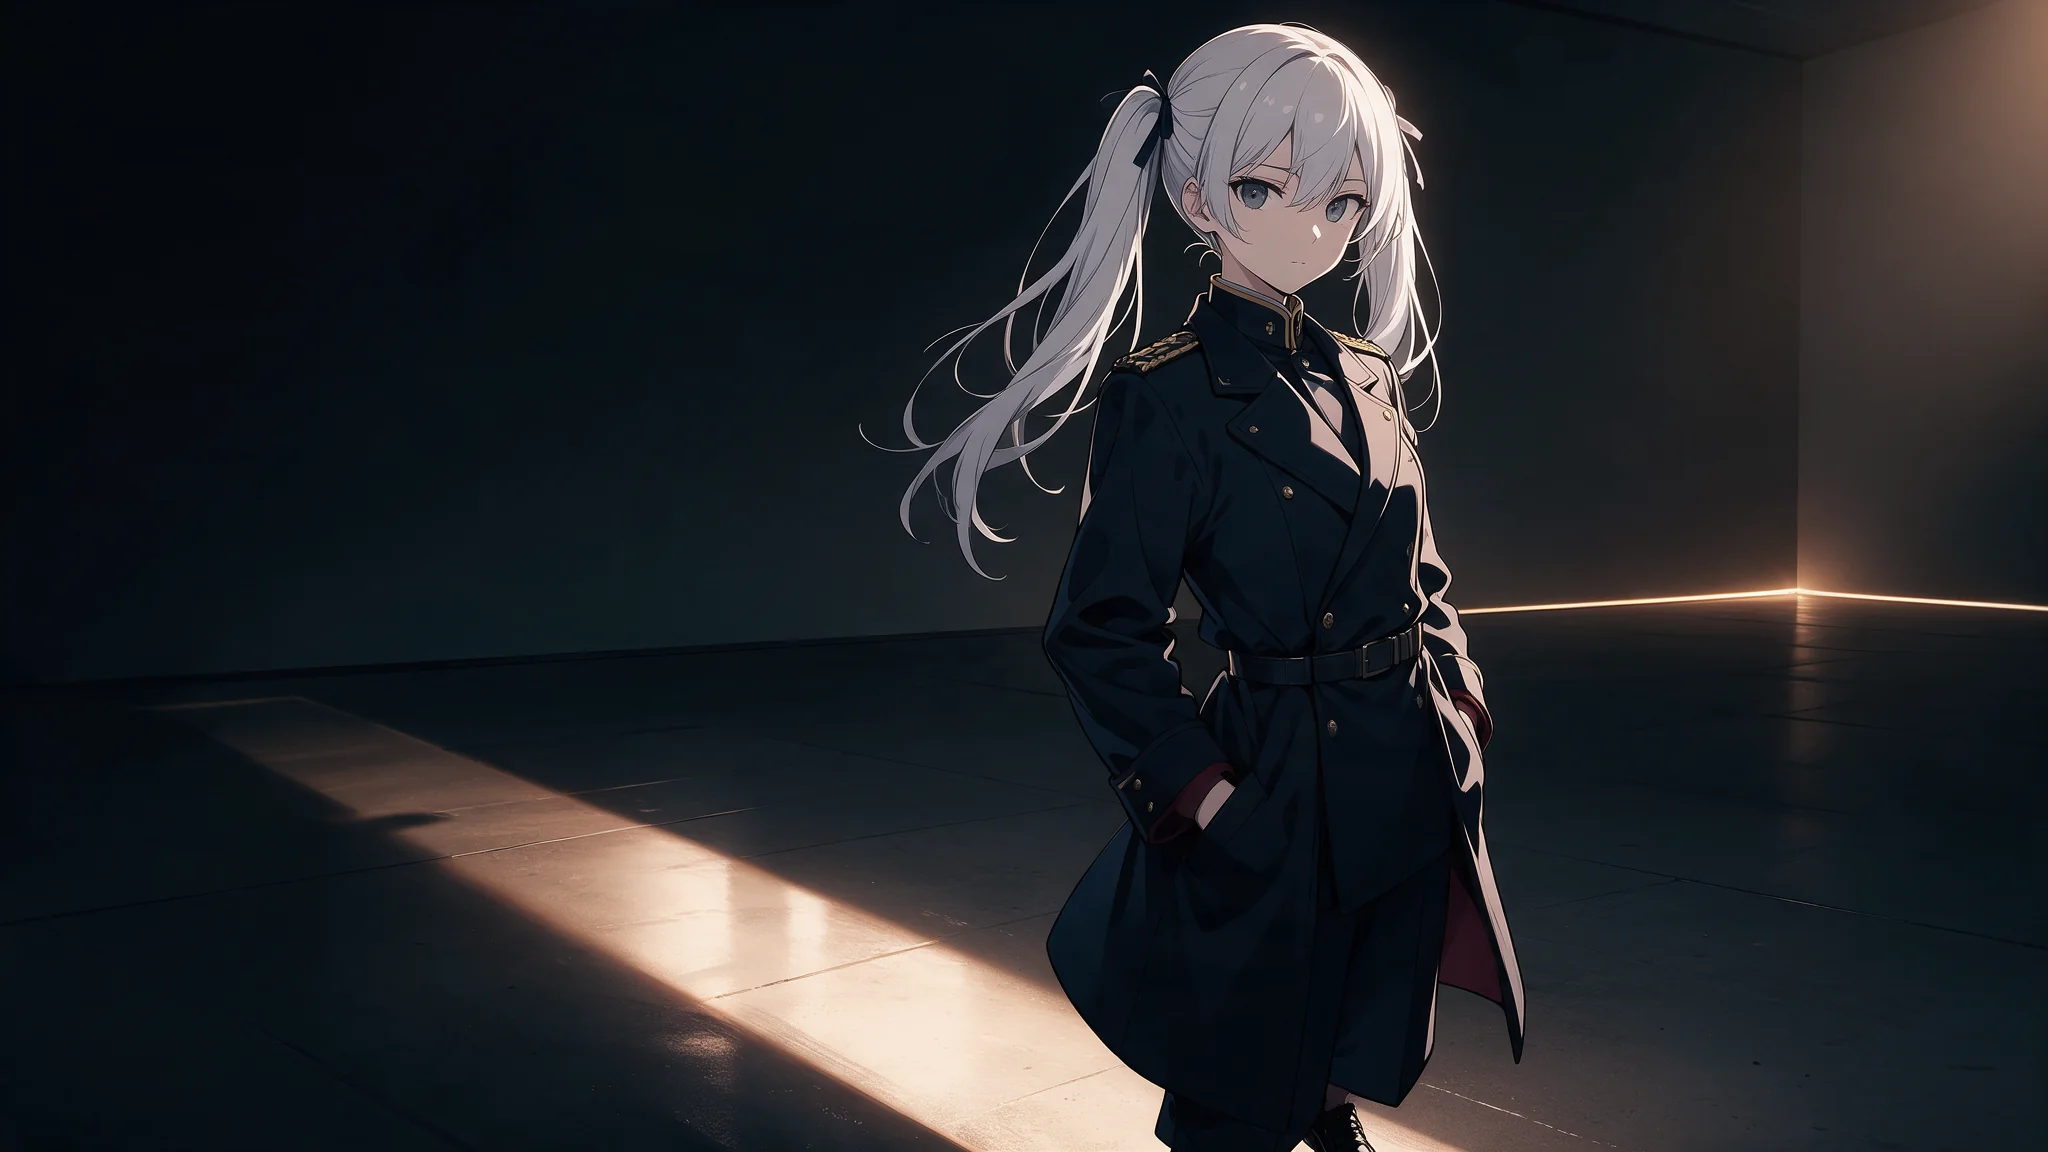
Anima Turbo da testo a immagine, 3:4, livello 1k, seed 22, tag di rating sensitive. Il prompt era un uomo adulto vestito sulla soglia di una porta.
Cosa abbiamo testato: 25 richieste su L1, L2, L3 e L4, da testo a immagine e immagine in immagine, con e senza LoRA, soggetti femminili e maschili, due seed per L3 e L4 e entrambi i livelli 1k e 1.5k. Abbiamo visto zero rifiuti e zero sostituzioni. L4 è stato reso come scritto al primo tentativo. Nelle esecuzioni di immagine in immagine partite da un’origine vestita, la richiesta di L3 o L4 con strength tra 0.8 e 0.9 è stata seguita. Altre 60 esecuzioni sulle proporzioni con un prompt di livello L2 sono state tutte consegnate.
Tre punti pratici decidono se fa per te:
- Prompt. Hanno funzionato tag in stile Danbooru, frasi semplici e misti dei due. L’ordine dell’editore è: tag di qualità e di rating, numero di soggetti (
1girl,1boy), personaggio, serie, artista, poi tag generali. Poiché non esiste un prompt negativo, il tag di rating è il modo principale per dare il tono. Il modello conoscesafe,sensitive,nsfwe un tag più forte; gli ultimi due tolgono la moderazione. Qui pubblichiamo solo esempi consafeesensitive. - Velocità. Su 60 esecuzioni cronometrate, il tempo del modello è stato di 2–16 secondi per immagine e 52 su 60 sono finite in meno di 10 secondi.
- Limiti. Niente fotorealismo, solo una parola o due di testo reso e, ogni tanto, uno scarabocchio simile a una firma in un angolo (circa un’immagine su cinque per noi; un nuovo seed lo risolve). Senza rifiuti non significa senza difetti: anatomia e mani richiedono comunque di rilanciare il seed.
Ecco un prompt che funziona come punto di partenza. Descrive un’adulta vestita:
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
long brown hair, white bathrobe slipping off one shoulder, standing by a large window at dawn,
holding a coffee cup, city skyline, soft light, calm smile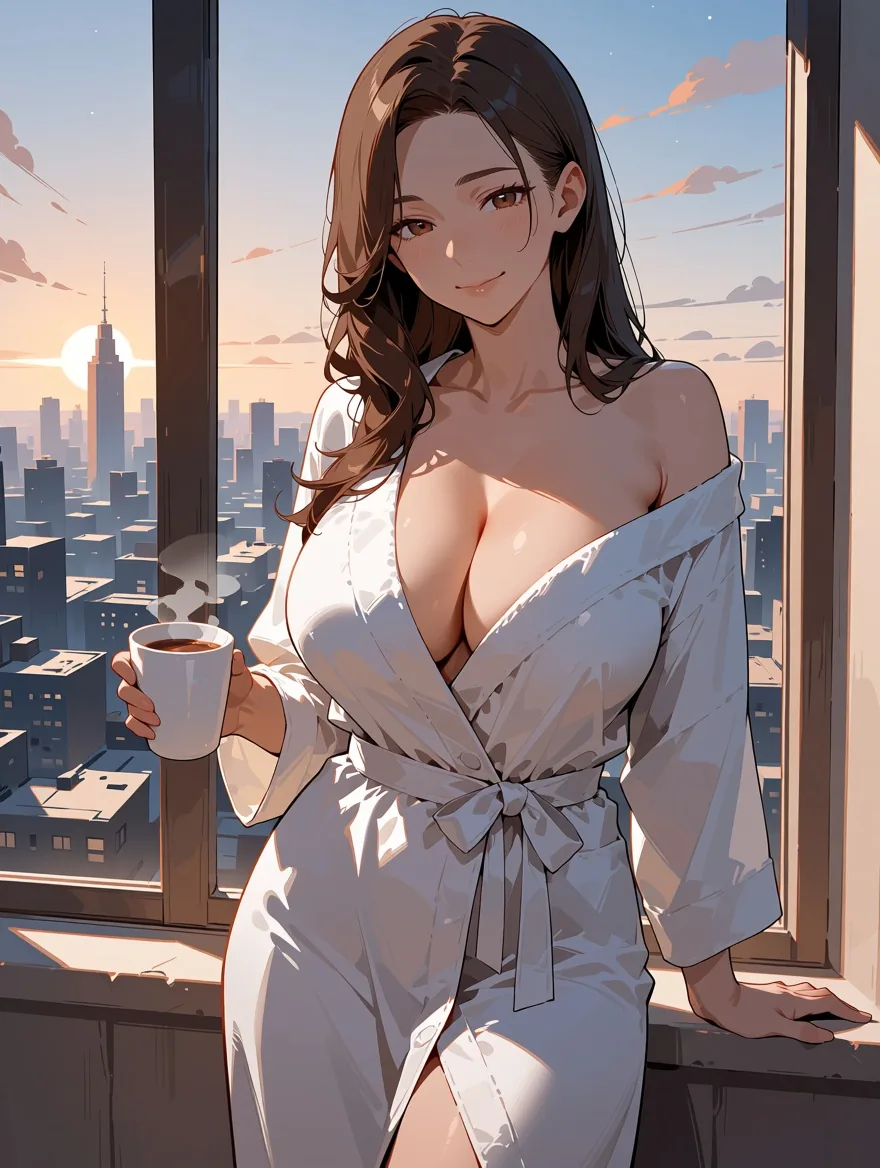
Anima Turbo da testo a immagine dal prompt qui sopra, 3:4, livello 1k, seed 23.
Anima gestisce anche due personaggi nella stessa inquadratura, il che conta per le scene di coppia:
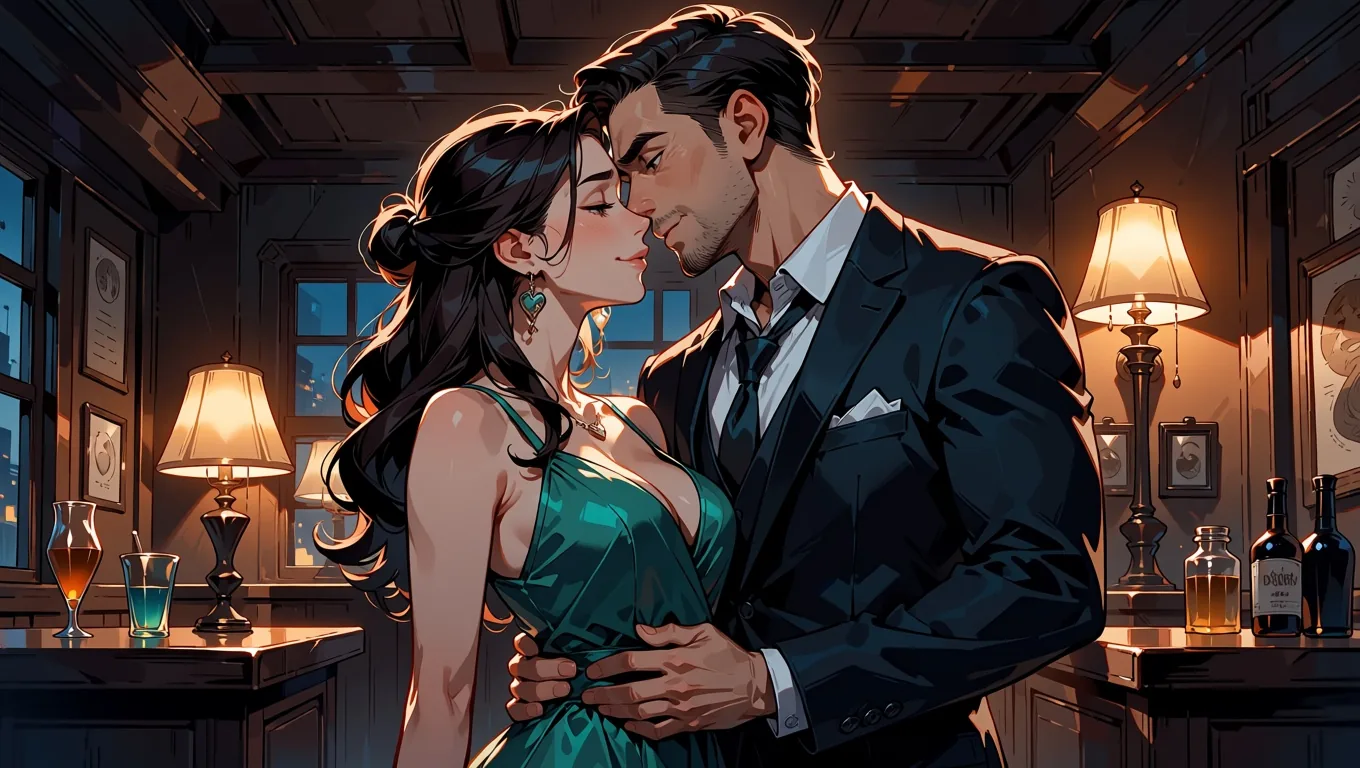
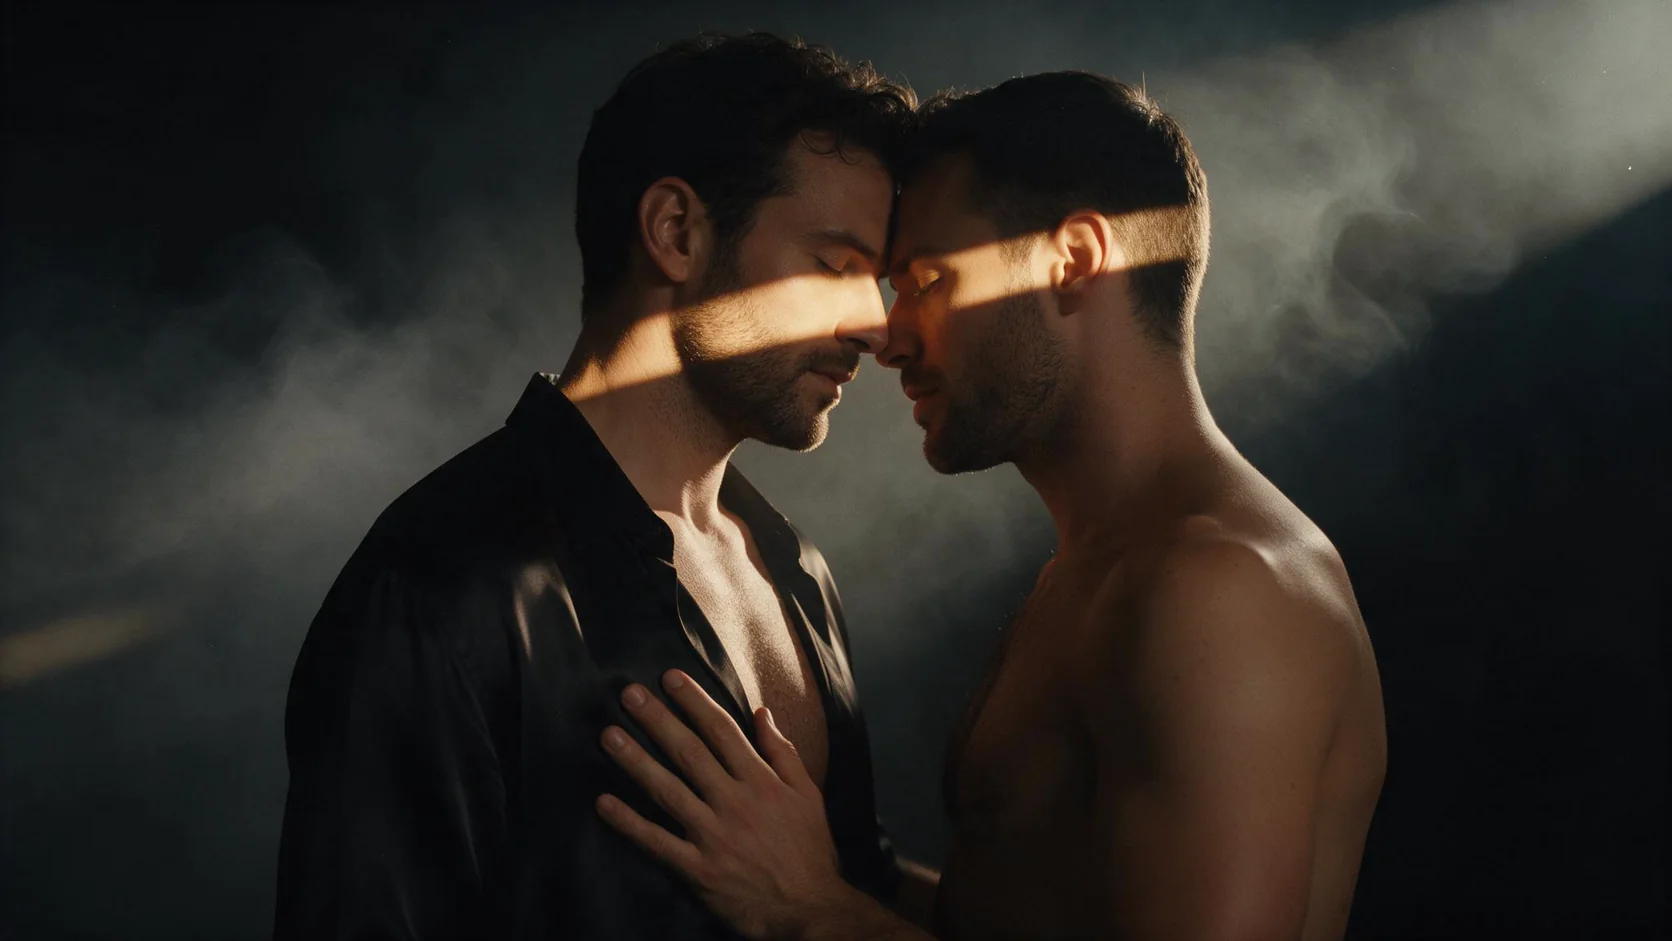
Anima Turbo da testo a immagine, 16:9, livello 1k, seed 24, tag di rating sensitive.
Se vuoi i risultati completi su prompt, strength e tag di stile per questo modello, il nostro resoconto dei test su Anima Turbo li passa in rassegna uno per uno. Puoi usarlo dalla pagina di Anima Turbo da testo a immagine o dalla pagina dell’immagine in immagine.
Mantenere un personaggio in più scene
Se realizzi una serie, vorrai lo stesso volto in luoghi diversi. In un test abbiamo fissato la descrizione (caschetto argento, occhi dorati, un neo sotto l’occhio sinistro) e il seed, e abbiamo cambiato solo l’abbigliamento e il luogo. Il personaggio è rimasto riconoscibile in tutte e tre.
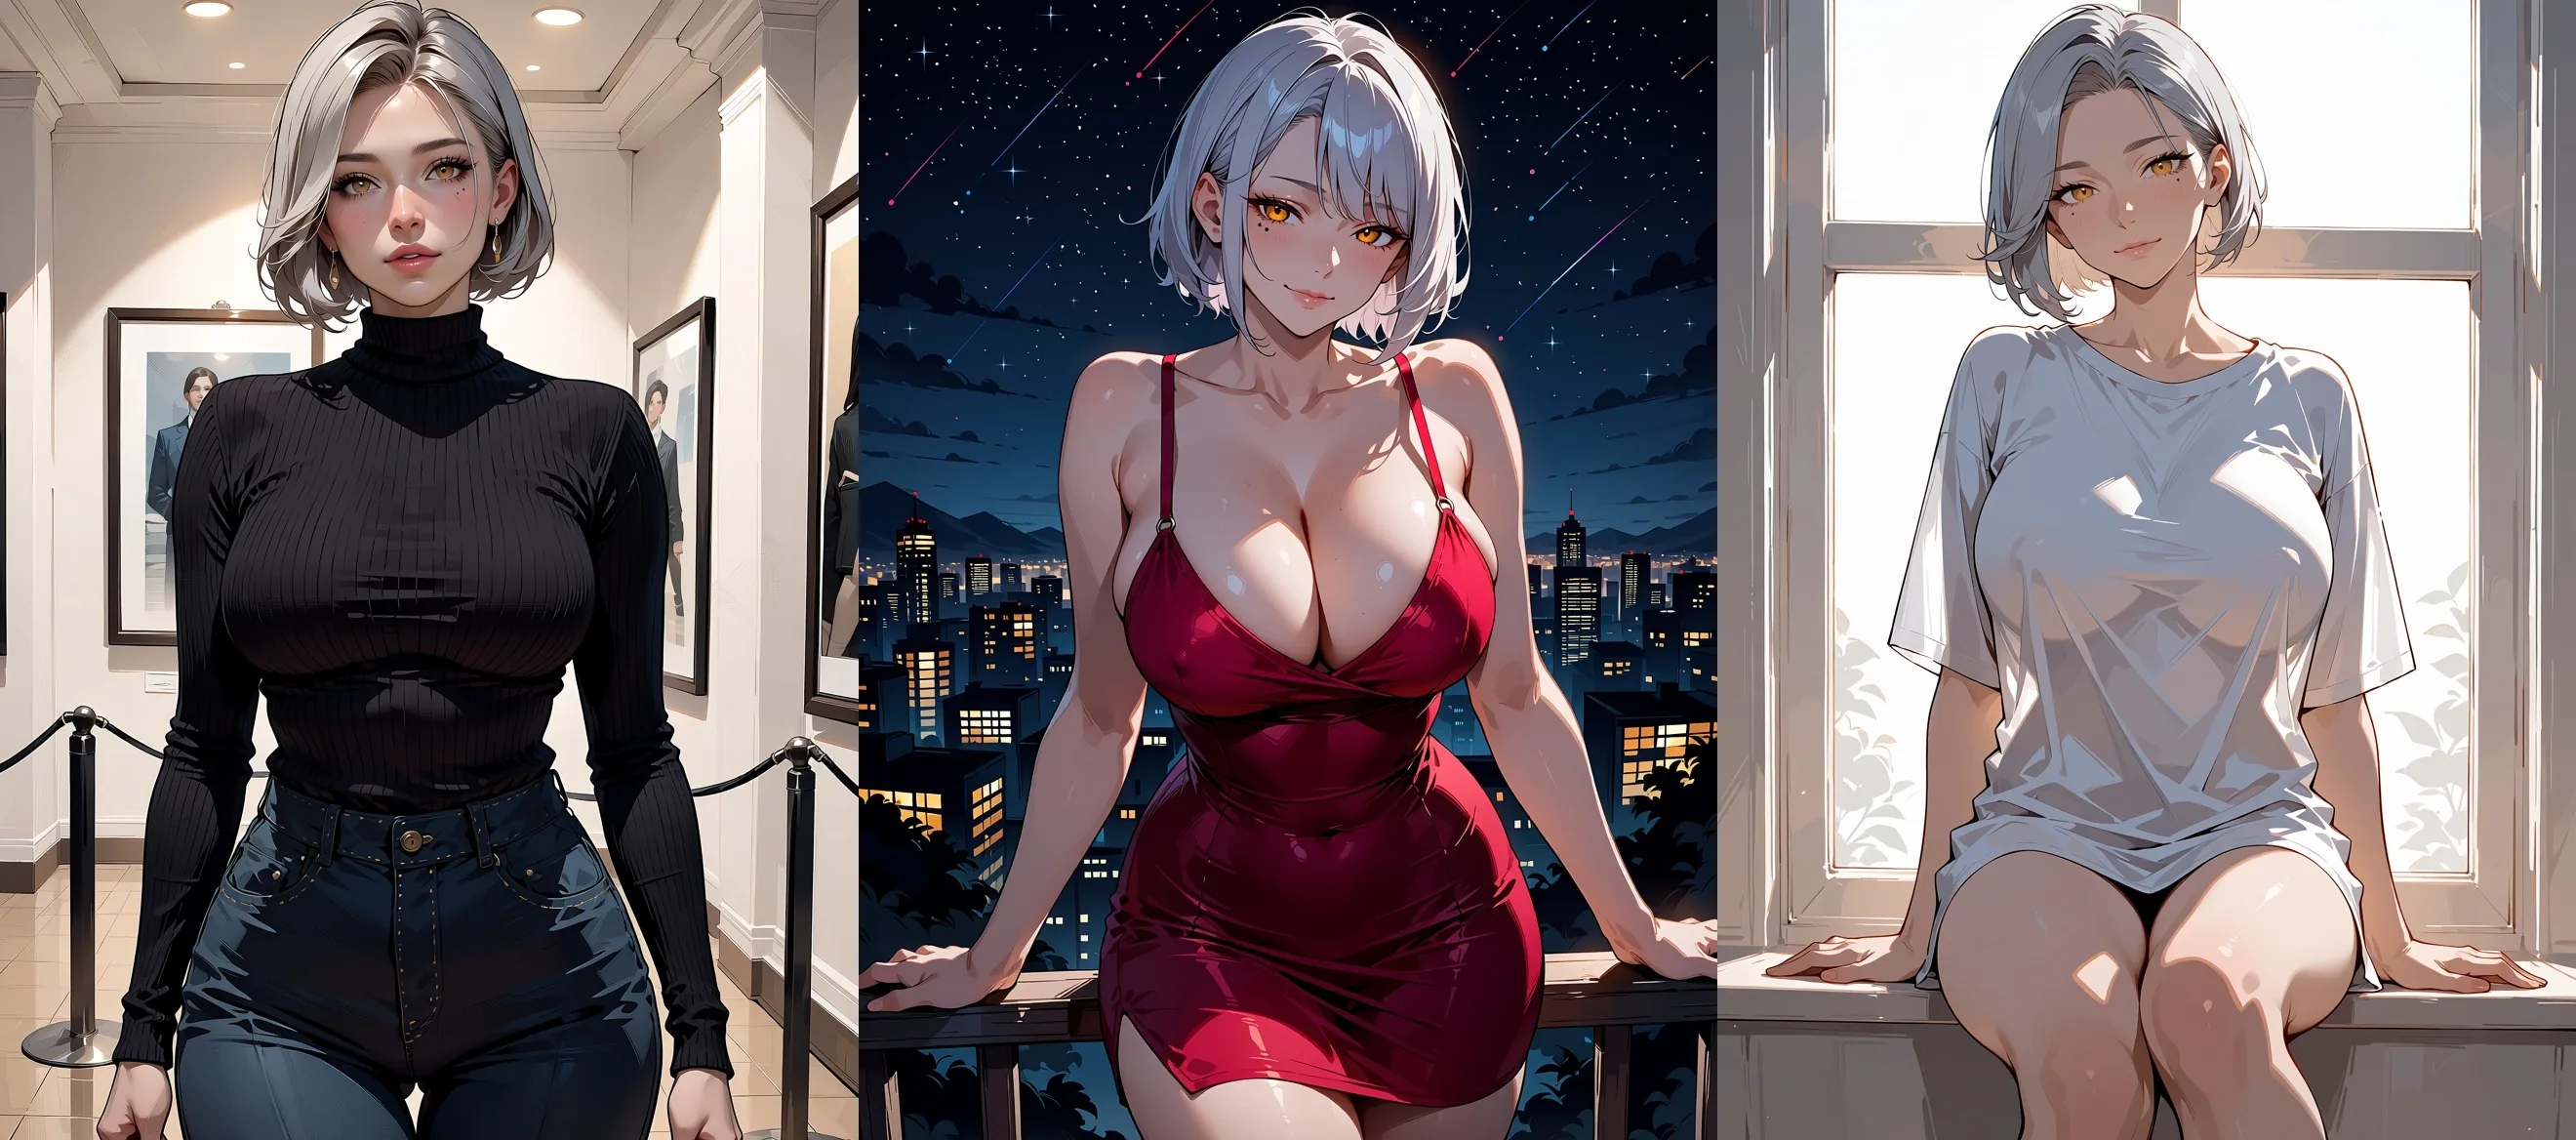
Anima Turbo da testo a immagine, 3:4, livello 1k, stesso seed (31) e stessa descrizione del personaggio in tre abiti e luoghi. Un’esecuzione per immagine.
I seed non garantiscono pixel identici, quindi consideralo un metodo che ha funzionato per noi.
Anima Turbo LoRA: stili e personaggi personalizzati
Scegli Anima Turbo LoRA quando l’aspetto conta più dell’aspetto predefinito del modello. È lo stesso modello con fino a tre LoRA per richiesta, ciascuno indicato con un path (un link HTTPS diretto a un file .safetensors) e uno scale da 0 a 4. Caricare i LoRA non comporta un addebito separato.
Nei nostri test di contenuto si è comportato come il modello semplice: L3 e L4 resi, con e senza LoRA, e nessun rifiuto. Quello che cambia è il controllo. Un look da gioco dell’era PC-98, per esempio, è venuto da un LoRA pubblico di Melon-Bread:
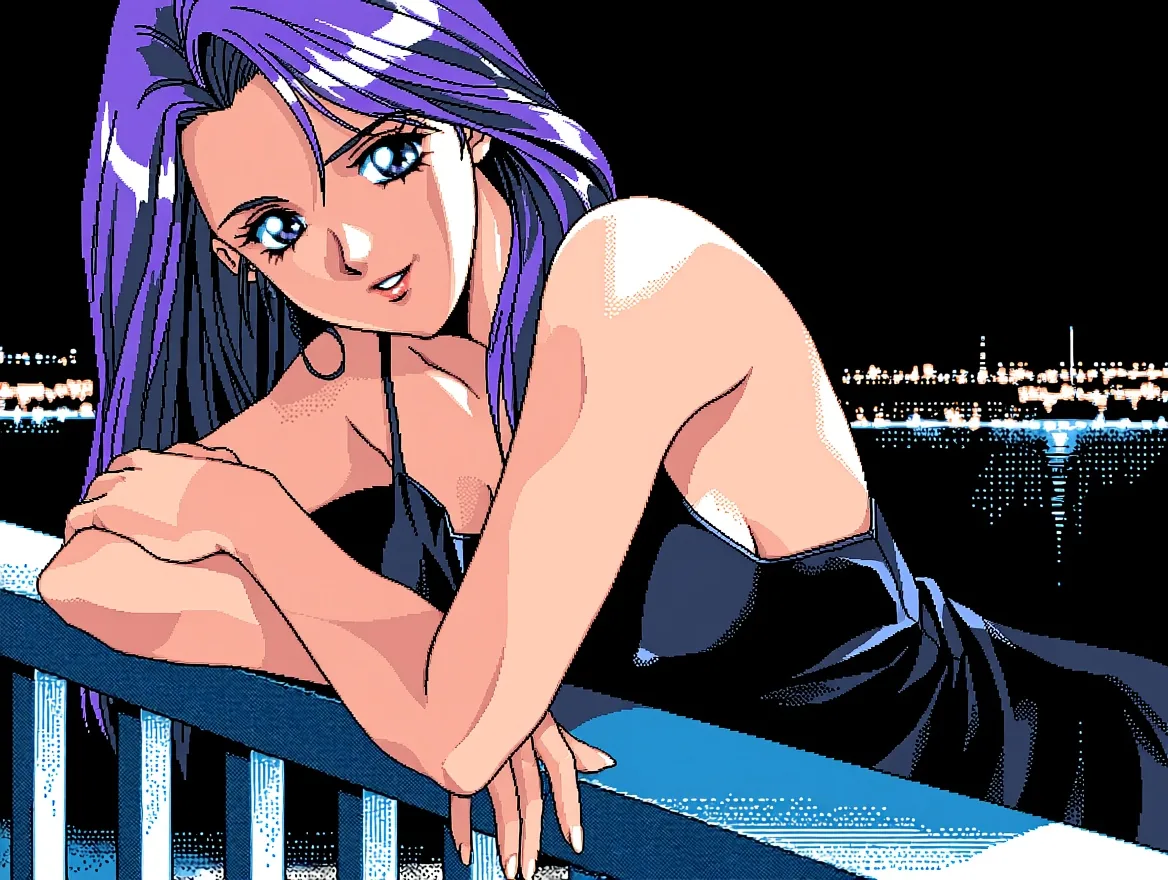
Anima Turbo LoRA da testo a immagine, 4:3, livello 1k, seed 32, LoRA PC-98 con scale 1 e la sua trigger word, tag di rating sensitive.
Un LoRA manga monocromatico ha avuto bisogno di monochrome, greyscale nel prompt prima di abbandonare i colori:
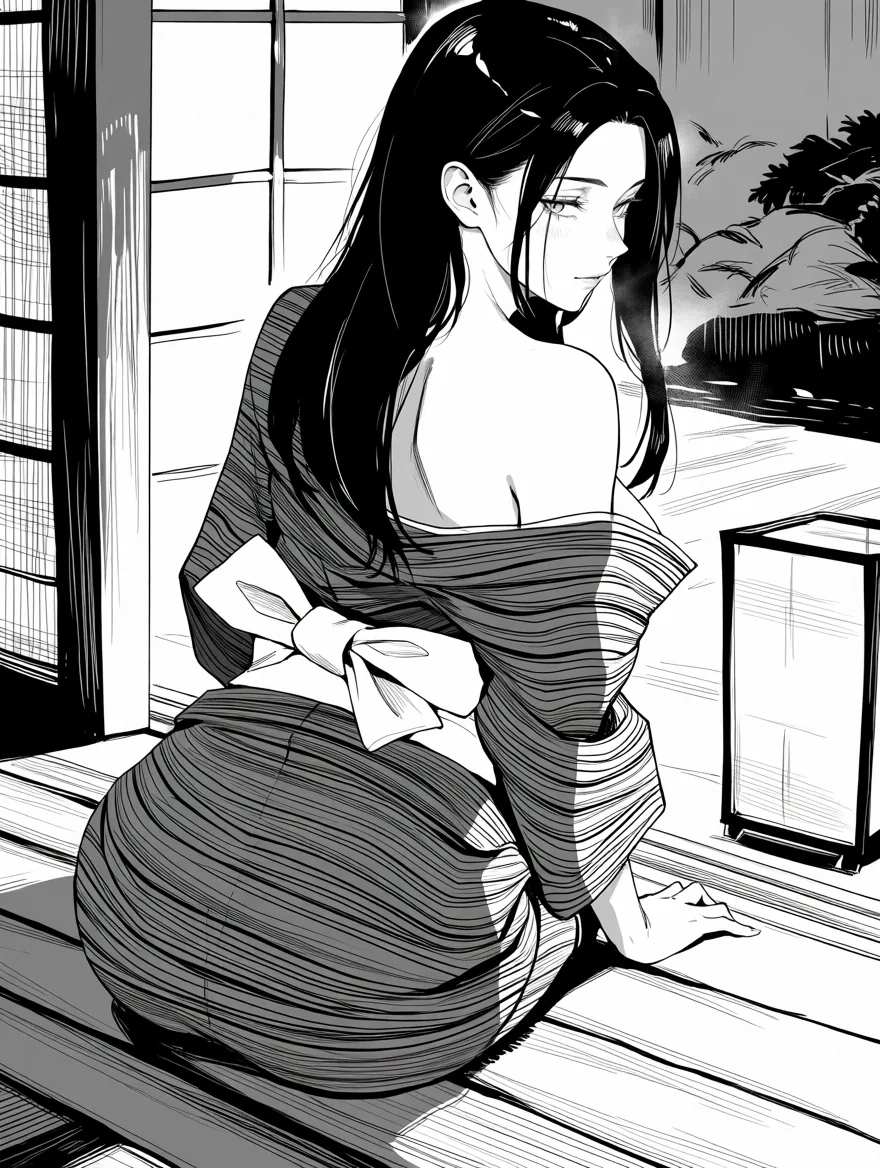
Anima Turbo LoRA da testo a immagine, 3:4, livello 1k, seed 33, LoRA monochrome con scale 1, tag di rating sensitive.
Cose da sapere prima di iniziare:
- Intervallo di scale. Nelle nostre esecuzioni 0.5 era un tocco leggero, 1 lo stile pieno, 1.5 spingeva di più e 4 ha disgregato l’immagine in forme astratte. L’intervallo utile va da circa 0.5 a 1.2.
- Abbina la base. Un LoRA addestrato per un altro modello di base (ne abbiamo provato uno per FLUX) si è caricato senza errori e non ha cambiato nulla: l’output era identico al pixel a quello senza LoRA. Usa LoRA addestrati per Anima. Il 5 ottobre 2026 Hugging Face ne elencava 129.
- Gli errori sui link non vengono addebitati. Un link protetto che richiede un login fallisce con un messaggio HTTP 401, e il link a una pagina di repository al posto del file chiede il link di download diretto.
- Il primo utilizzo è più lento. La prima richiesta con un LoRA nuovo può richiedere più tempo mentre il file viene scaricato; una delle nostre ha impiegato quasi tre minuti.
La nostra guida agli stili LoRA approfondisce scale, impilamento e trigger word, e il modello ha una pagina da testo a immagine e una pagina dell’immagine in immagine.
Prefect Pony XL: la linea Pony guidata dai tag
Scegli Prefect Pony XL se i tuoi prompt e le tue abitudini vengono dall’ecosistema Pony XL. È un checkpoint anime della community di quella linea, solo da testo a immagine, con sette dimensioni SDXL native. Nella nostra esecuzione interna del 18 settembre 2026 ha reso tre livelli di prova fino a L4.
Era un test precedente e separato, quindi non lo confrontiamo con Anima sul contenuto. La differenza che sentirai è nel flusso di lavoro: Pony è solo testo, su SpicyAPI non ha né immagine in immagine né uno slot LoRA, mentre Anima Turbo ti dà l’immagine in immagine e un fratello con i LoRA.
Basi fotorealistiche con LoRA: Z-Image Turbo LoRA, Qwen Image 2512 LoRA, FLUX.1 Dev LoRA
Scegline uno solo se hai un motivo per lasciare la strada nativa anime. Motivi tipici: vuoi un solo modello che produca sia output fotorealistico sia anime, hai già un LoRA addestrato per quella base, oppure ti serve la modifica. Ognuno accetta i tuoi LoRA e i risultati sui contenuti dei test del catalogo differiscono:
| Modello | Cos’è | Test di contenuto |
|---|---|---|
| Z-Image Turbo LoRA | Alibaba Z-Image Turbo con i tuoi LoRA; fotorealistico di default, anime con un LoRA anime | L3 e L4 resi (da testo a immagine) |
| Qwen Image 2512 LoRA | Qwen-Image-2512 con i tuoi LoRA, più la modifica | L3 e L4 resi |
| FLUX.1 Dev LoRA | FLUX.1 [dev] con i tuoi LoRA | L3 reso; L4 attenuato nei nostri test |
«Attenuato» significa che la richiesta è stata completata ma l’immagine non corrispondeva a quanto richiesto a quel livello. Se il tuo progetto dipende dal livello più intenso, quella riga è il motivo per cui FLUX.1 Dev LoRA è l’ultima scelta nella tabella qui sopra e non la prima.
Altri due modelli di immagini senza censura, MiniMax H3 Image LoRA (L4 reso) e Z-Image Spicy (fotorealistico, livello senza censura), non sono scelte anime.
Quando hai uno still che ti piace, puoi animarlo. Seedance 2.5 Spicy, Wan 2.2 Spicy e MiniMax H3 Spicy sono famiglie senza censura da immagine a video: prendono un’immagine più un prompt e restituiscono un breve video.
Modelli generalisti che rifiutano: FLUX 3 e Ideogram v4.5
Se stai valutando FLUX 3 o Ideogram v4.5 per lavori anime NSFW, lasciali perdere: entrambi hanno rifiutato quasi tutto ciò che va oltre una foto neutra in costume da bagno. Li abbiamo testati entrambi il 5 ottobre 2026 tramite un’API ospitata di terze parti, sulla stessa scala, al livello 1k.
| Modello | Consegnato | Rifiutato |
|---|---|---|
| FLUX 3 da testo a immagine (Black Forest Labs) | Una scena in bikini sulla spiaggia; una foto neutra da catalogo di lingerie | Lingerie con formulazione maliziosa (L1), L2, L3, L4, uno studio pittorico classico di figura, uno studio maschile di figura e un prompt eufemistico senza parole segnalate (10 richieste su 12) |
| Ideogram v4.5 (Ideogram) | Le stesse due | Lo stesso insieme; l’espansione del prompt attiva o disattiva non ha fatto differenza (11 richieste su 13) |
I rifiuti sono tornati in circa due secondi, prima che venisse creata qualsiasi immagine, con il messaggio «Content flagged as potentially sensitive. Please try different prompts or images.» Le richieste rifiutate non sono state addebitate. Poiché è stato rifiutato anche il prompt eufemistico, il filtro si comporta come uno semantico e non come una lista di parole chiave. Non possiamo dire se quel filtro appartenga alle API dei produttori dei modelli o all’host che abbiamo usato, quindi leggilo come «rifiutato su questo percorso» e non come un giudizio sui modelli in ogni contesto.
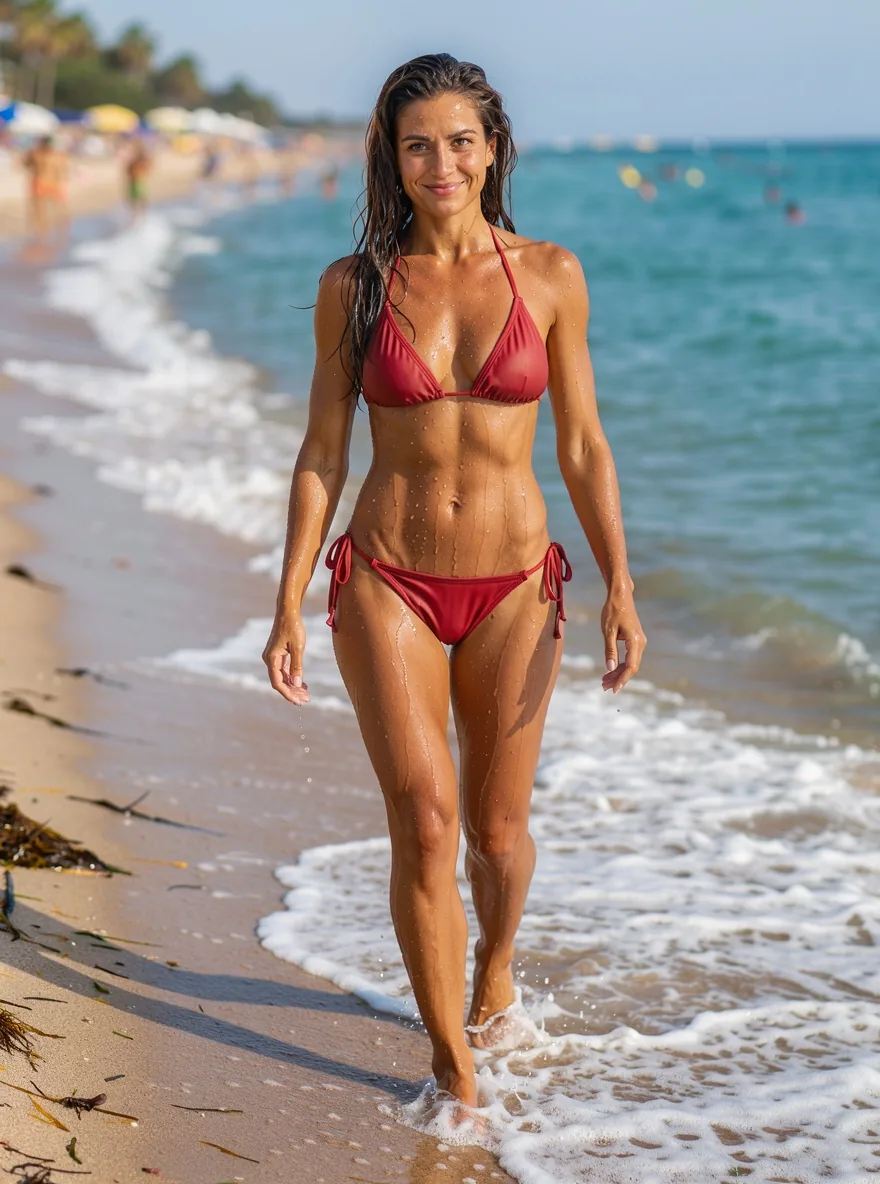
FLUX 3 da testo a immagine, livello 1k. Questa foto di spiaggia in bikini era una delle due richieste che ha consegnato.
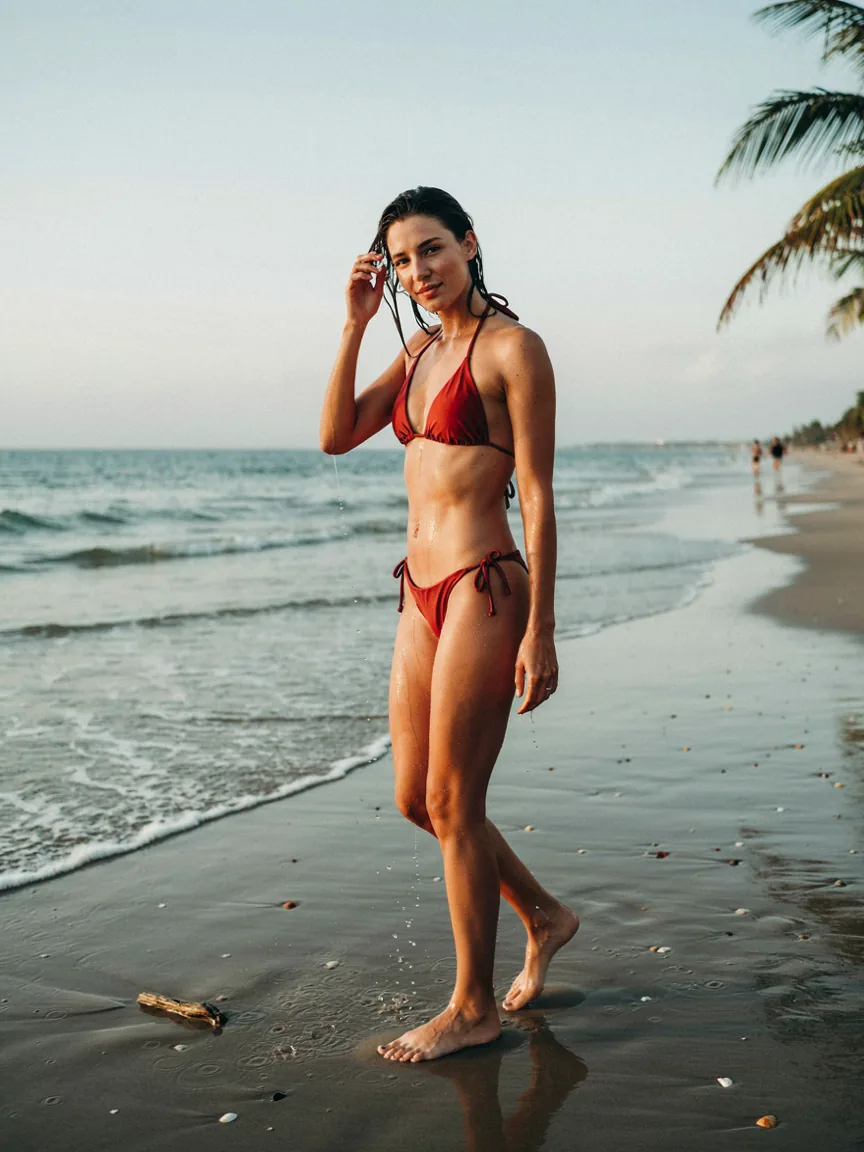
Ideogram v4.5, livello 1k. Lo stesso tipo di scena in bikini sulla spiaggia, una delle due richieste che ha consegnato.
Entrambi i modelli hanno restituito anche fotografie, non anime, quindi nemmeno un’impostazione permissiva avrebbe coperto la metà «anime» della tua richiesta. Per un confronto più ampio tra modelli di immagini, vedi il nostro confronto dei generatori di immagini NSFW.
Come abbiamo testato e cosa i test non possono dirti
Considera ogni numero qui come un piccolo campione datato. I risultati di Anima sono 25 richieste di contenuto più 60 esecuzioni sulle proporzioni del 5 ottobre 2026, per lo più con uno o due seed per caso. I risultati di FLUX 3 e Ideogram v4.5 sono 13 e 14 richieste dello stesso giorno attraverso un unico percorso di terze parti. Il risultato di Prefect Pony XL viene da un’esecuzione interna del 18 settembre 2026. Le altre righe vengono dai test di contenuto del catalogo e sono riportate come scritto lì.
Cosa i test non mostrano:
- Non classificano la qualità dell’immagine. Non abbiamo valutato volti, mani, composizione o stile tra i modelli e non sosteniamo che Anima abbia un aspetto migliore di un altro modello qui.
- Non garantiscono lo stesso risultato la prossima volta. I provider cambiano i filtri e la stessa richiesta con lo stesso seed ci ha dato rese leggermente diverse in momenti diversi.
- Il tag di rating sposta il tono meno di quanto la gente si aspetti con una descrizione vestita: con lo stesso prompt da lounge e lo stesso seed,
safeesensitivehanno dato quasi la stessa immagine.
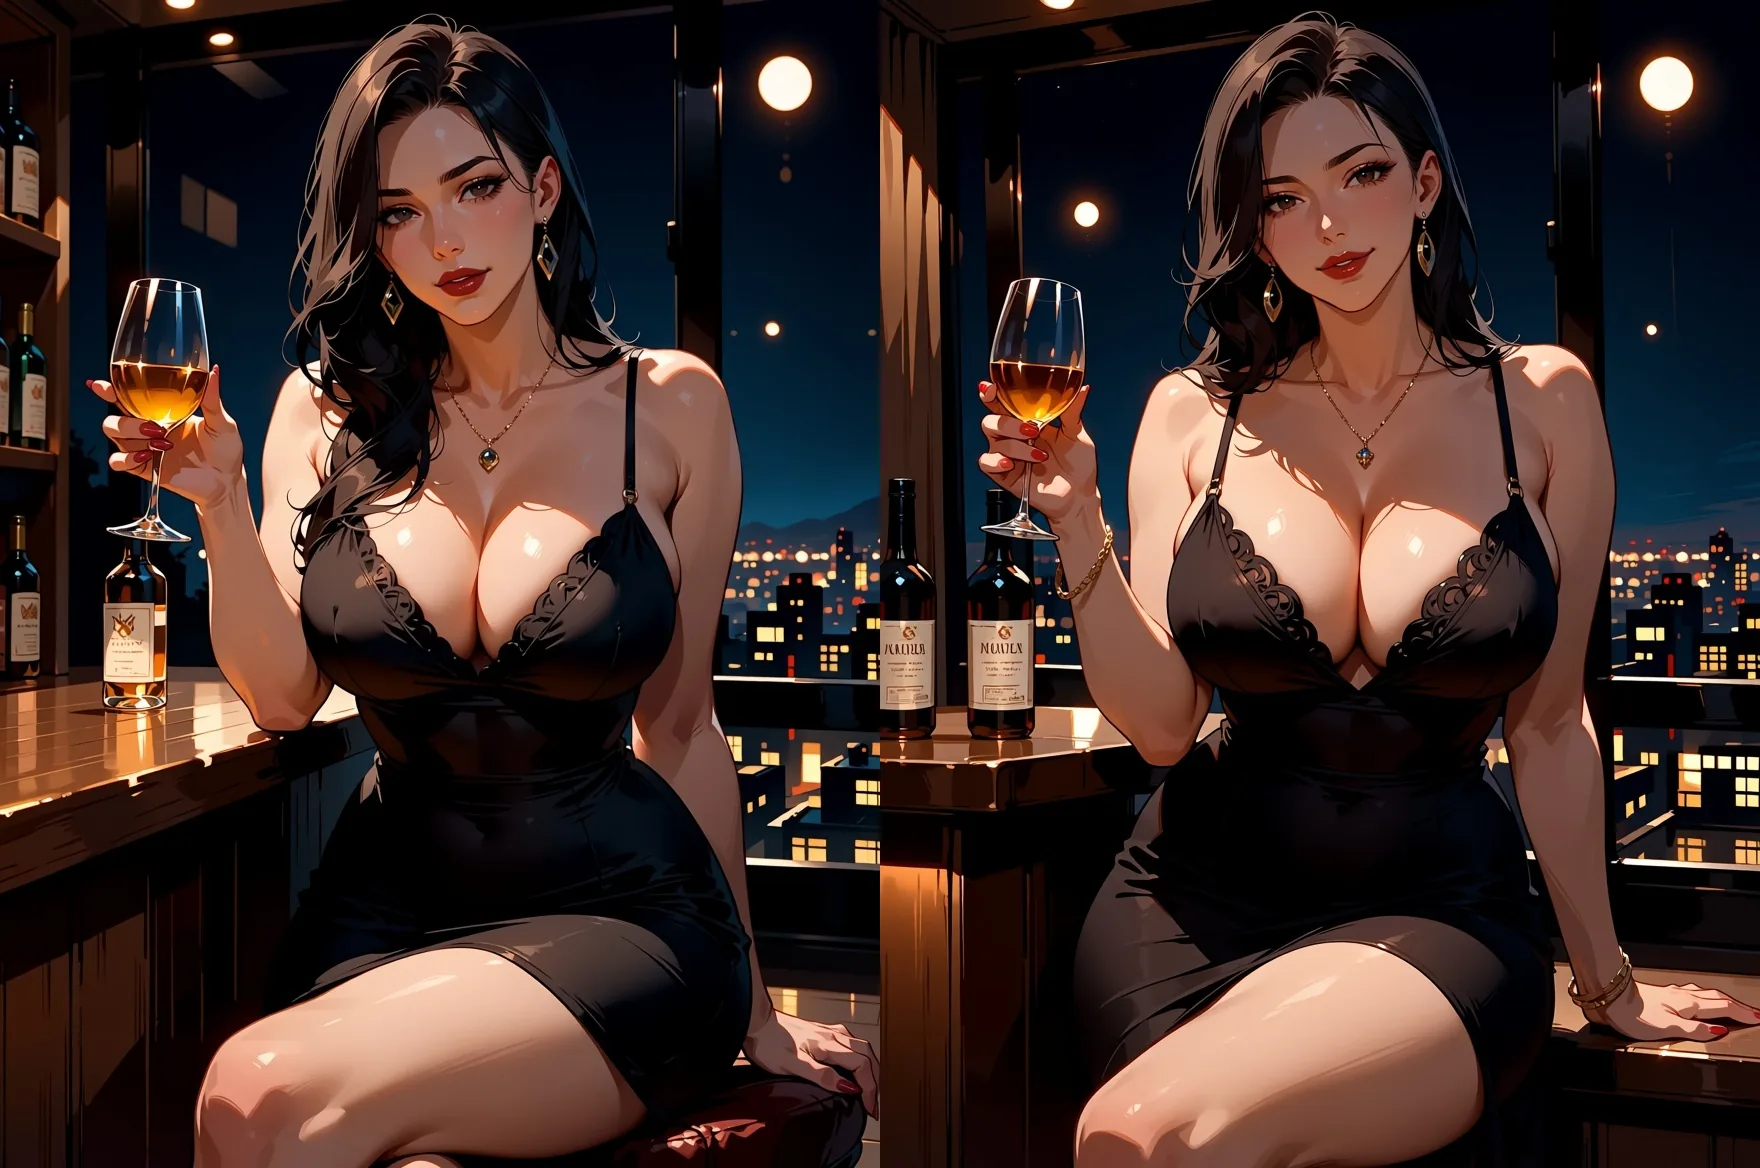
Anima Turbo da testo a immagine, 3:4, livello 1k, seed 27. A sinistra: safe. A destra: sensitive. Per il resto stesso prompt.
Come scegliere in tre domande
- Hai un LoRA o ti serve uno stile specifico? Se sì, usa Anima Turbo LoRA, o una base compatibile con i LoRA che corrisponda al LoRA che possiedi (un LoRA per un’altra base non fa nulla). Se no, parti da Anima Turbo.
- Scrivi i prompt come tag in stile Pony e vuoi proprio quell’ecosistema? Allora prova Prefect Pony XL. Se vuoi l’immagine in immagine da una foto o da un disegno, Anima Turbo è quello che la offre.
- Ti serve un output fotorealistico? Se sì, usa una base nata fotorealistica come Z-Image Turbo LoRA e controlla prima la sua riga sui contenuti. Se vuoi solo anime, resta sui modelli nativi anime.
Se hai intenzione di trasformare una foto in anime, la nostra guida alla strength mostra cosa fa ciascun valore di strength.
Usa questi modelli in modo responsabile
Crea solo personaggi adulti e dillo nel prompt. Non generare persone reali né somiglianze reali senza il loro consenso. Tieni privati i tuoi risultati a meno che tu non sia sicuro di dove puoi pubblicarli. Sei responsabile di ciò che generi, conservi e condividi e del rispetto delle leggi che ti riguardano.
FAQ
Qual è il miglior modello AI per l’arte anime NSFW?
Per l’arte anime solo da prompt, Anima Turbo è stata la scelta migliore nei nostri test: il nostro test di contenuto più forte è stato reso come scritto al primo tentativo, senza rifiuti su 25 richieste. Prefect Pony XL è adatto ai prompt con tag in stile Pony e Anima Turbo LoRA agli stili personalizzati. «Migliore» cambia con il lavoro, quindi usa la tabella di scelta rapida qui sopra.
FLUX 3 o Ideogram v4.5 possono creare anime NSFW?
Non nei nostri test. FLUX 3 ha rifiutato 10 richieste su 12 e Ideogram v4.5 ne ha rifiutate 11 su 13, compresa la lingerie con formulazione maliziosa. Entrambi hanno consegnato solo una scena neutra in bikini sulla spiaggia e una foto da catalogo di lingerie. Il filtro potrebbe appartenere all’host e non ai produttori, cosa che non abbiamo potuto verificare.
Mi serve un LoRA per l’arte anime NSFW?
No. Anima Turbo ha reso i livelli testati senza alcun LoRA. Un LoRA serve quando vuoi uno stile specifico o un personaggio ricorrente. Usane uno addestrato per Anima: un LoRA per un’altra base si è caricato senza errori e non ha cambiato nulla nel nostro test.
I modelli sono davvero senza censura o attenuano le immagini di nascosto?
Su Anima abbiamo visto zero rifiuti e zero sostituzioni su 25 richieste di contenuto. L’attenuazione esiste altrove: FLUX.1 Dev LoRA ha attenuato il livello intenso nei nostri test. Il modello può anche comportarsi in modo diverso da un seed all’altro, quindi controlla ogni risultato.
Che differenza c’è tra i tag di rating safe e sensitive?
Con una descrizione vestita hanno dato quasi la stessa immagine nel nostro test, quindi il tag è più un’indicazione di tono che un interruttore. L’editore documenta nsfw e un tag più forte come quelli che tolgono la moderazione. Poiché non esiste un prompt negativo, il tag di rating è il modo principale per dare il tono.
Posso trasformare la mia foto in anime?
Sì, con l’immagine in immagine di Anima Turbo. Nei nostri test una foto si leggeva ancora come foto con strength 0.3, come illustrazione con 0.6 e come anime pulito con 0.75. Da 0.9 i dettagli cominciano a cambiare e a 1.0 l’origine viene ignorata. Ridisegna nello stile; non segue istruzioni di modifica.
Posso animare le immagini?
Sì. Seedance 2.5 Spicy, Wan 2.2 Spicy e MiniMax H3 Spicy prendono un’immagine più un prompt e restituiscono un breve video.