Do anime NSFW tworzonego samym promptem Anima Turbo najlepiej pasował w naszych testach: nasz najmocniejszy test treści narysował zgodnie z opisem już za pierwszym razem, model jest zbudowany do anime i nie potrzebuje żadnych dodatkowych plików. Dodaj Anima Turbo LoRA, gdy chcesz własnego stylu lub postaci, Prefect Pony XL, gdy pracujesz na tagach w stylu Pony, a bazę z myślą o fotorealizmie tylko wtedy, gdy zamierzasz ją prowadzić LoRA anime. Modele ogólnego przeznaczenia, takie jak FLUX 3 i Ideogram v4.5, odmawiały niemal wszystkiego poza neutralnym zdjęciem w bikini.
„Najlepszy” zależy od zadania, więc to przewodnik decyzyjny, a nie ranking. Każde twierdzenie poniżej pochodzi z naszych własnych przebiegów z 5 października 2026 albo z testów treści w katalogu SpicyAPI, a każda sekcja mówi, jak mała była próba. Nie oceniamy jakości obrazu poza tym, co sami widzieliśmy.
W skrócie: który model do jakiego zadania
| Twoje zadanie | Wybór | Dlaczego, w naszych testach | Strona |
|---|---|---|---|
| Anime z tekstu, bez dodatkowych plików | Anima Turbo | Model anime i ilustracji; większość testowanych poziomów (łącznie z intensywnymi scenami) narysowana zgodnie z opisem | Anima Turbo |
| Własny styl rysunku albo powracająca postać | Anima Turbo LoRA | Ten sam model z maksymalnie 3 własnymi LoRA | Anima Turbo LoRA |
| Prompty z tagami Danbooru lub w stylu Pony | Prefect Pony XL | Społecznościowy checkpoint anime z linii Pony XL, tylko tekst na obraz | Prefect Pony XL |
| Fotorealistyczna baza, która potrafi też anime | Z-Image Turbo LoRA | Domyślnie fotorealistyczna; anime z LoRA anime; intensywne sceny narysowane | Z-Image Turbo LoRA |
| LoRA anime na innej bazie plus edycja | Qwen Image 2512 LoRA | Przyjmuje LoRA i obsługuje edycję; intensywne sceny narysowane | Qwen Image 2512 LoRA |
| Masz już LoRA do FLUX.1 Dev | FLUX.1 Dev LoRA | Przyjmuje twoje LoRA; najmocniejszy poziom został w naszych testach złagodzony | FLUX.1 Dev LoRA |
| Praca bez ograniczeń na FLUX 3 lub Ideogram v4.5 | Żaden | Odmówiły 10 z 12 i 11 z 13 zapytań | zobacz niżej |
Jak opisujemy poziomy treści
Używamy pięciostopniowej drabiny. L1 to sugestywny (bielizna, ramiączko zsuwające się z ramienia). L2 to częściowy, odważniejsze. L3 to najodważniejsze treści. L4 to intensywna scena między dwiema dorosłymi osobami. L5 to ekstremalny: dobrowolne unieruchomienie między dorosłymi albo filmowy gore. L5 nie uruchamialiśmy na Anima. W tym artykule nie ma żadnego promptu powyżej L1, a każda postać jest dorosła. Sama platforma nie dodaje filtra treści do tych endpointów, więc liczy się to, co każdy model robi z zapytaniem.
Anima Turbo: najlepszy wybór do anime z samego promptu w naszych testach
Wybierz Anima Turbo, jeśli chcesz uzyskać anime lub ilustrację z samego promptu i niczego więcej. To zdestylowana wersja Anima od CircleStone Labs, modelu z 2 miliardami parametrów zbudowanego na NVIDIA Cosmos-Predict2 z enkoderem tekstu Qwen3. Wydawca zaleca zaczynanie od wersji Turbo, która według niego jest średnio tylko nieco gorsza od wersji Aesthetic, a przy tym znacznie szybsza.
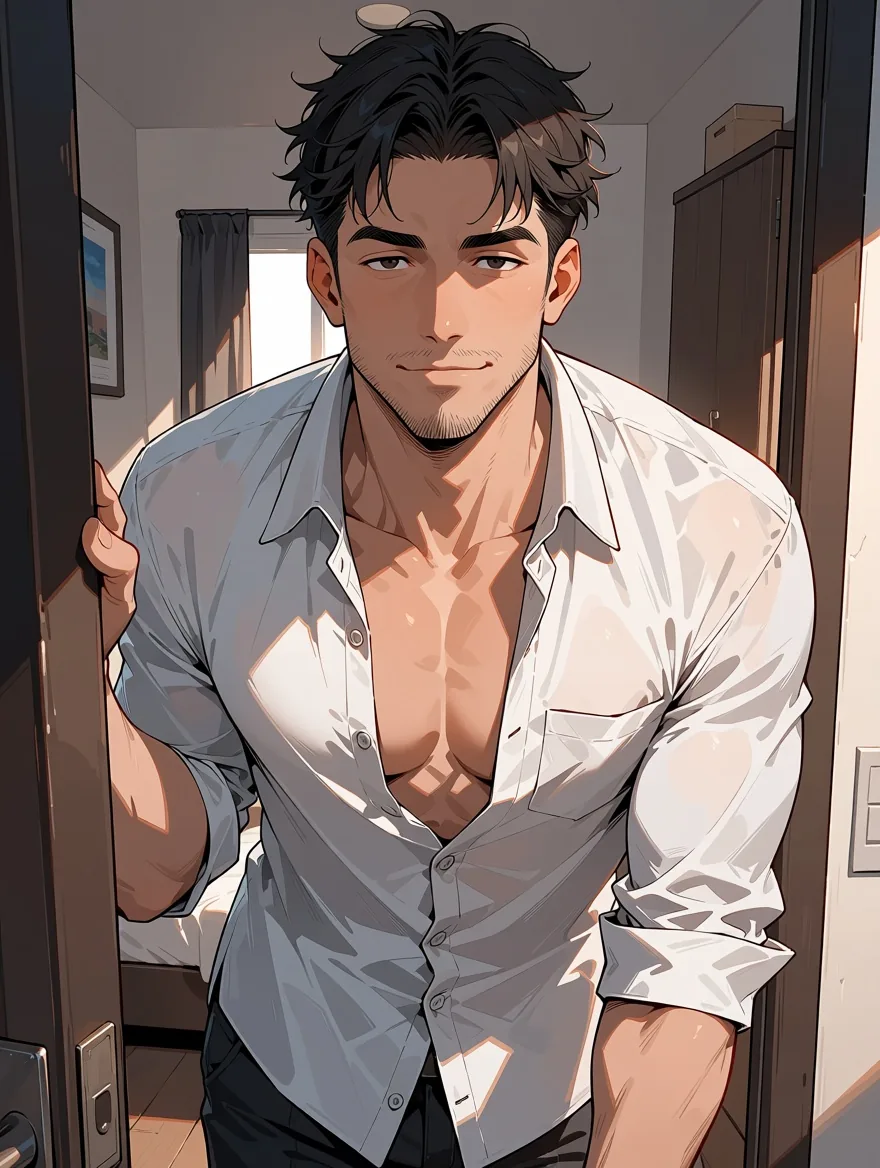
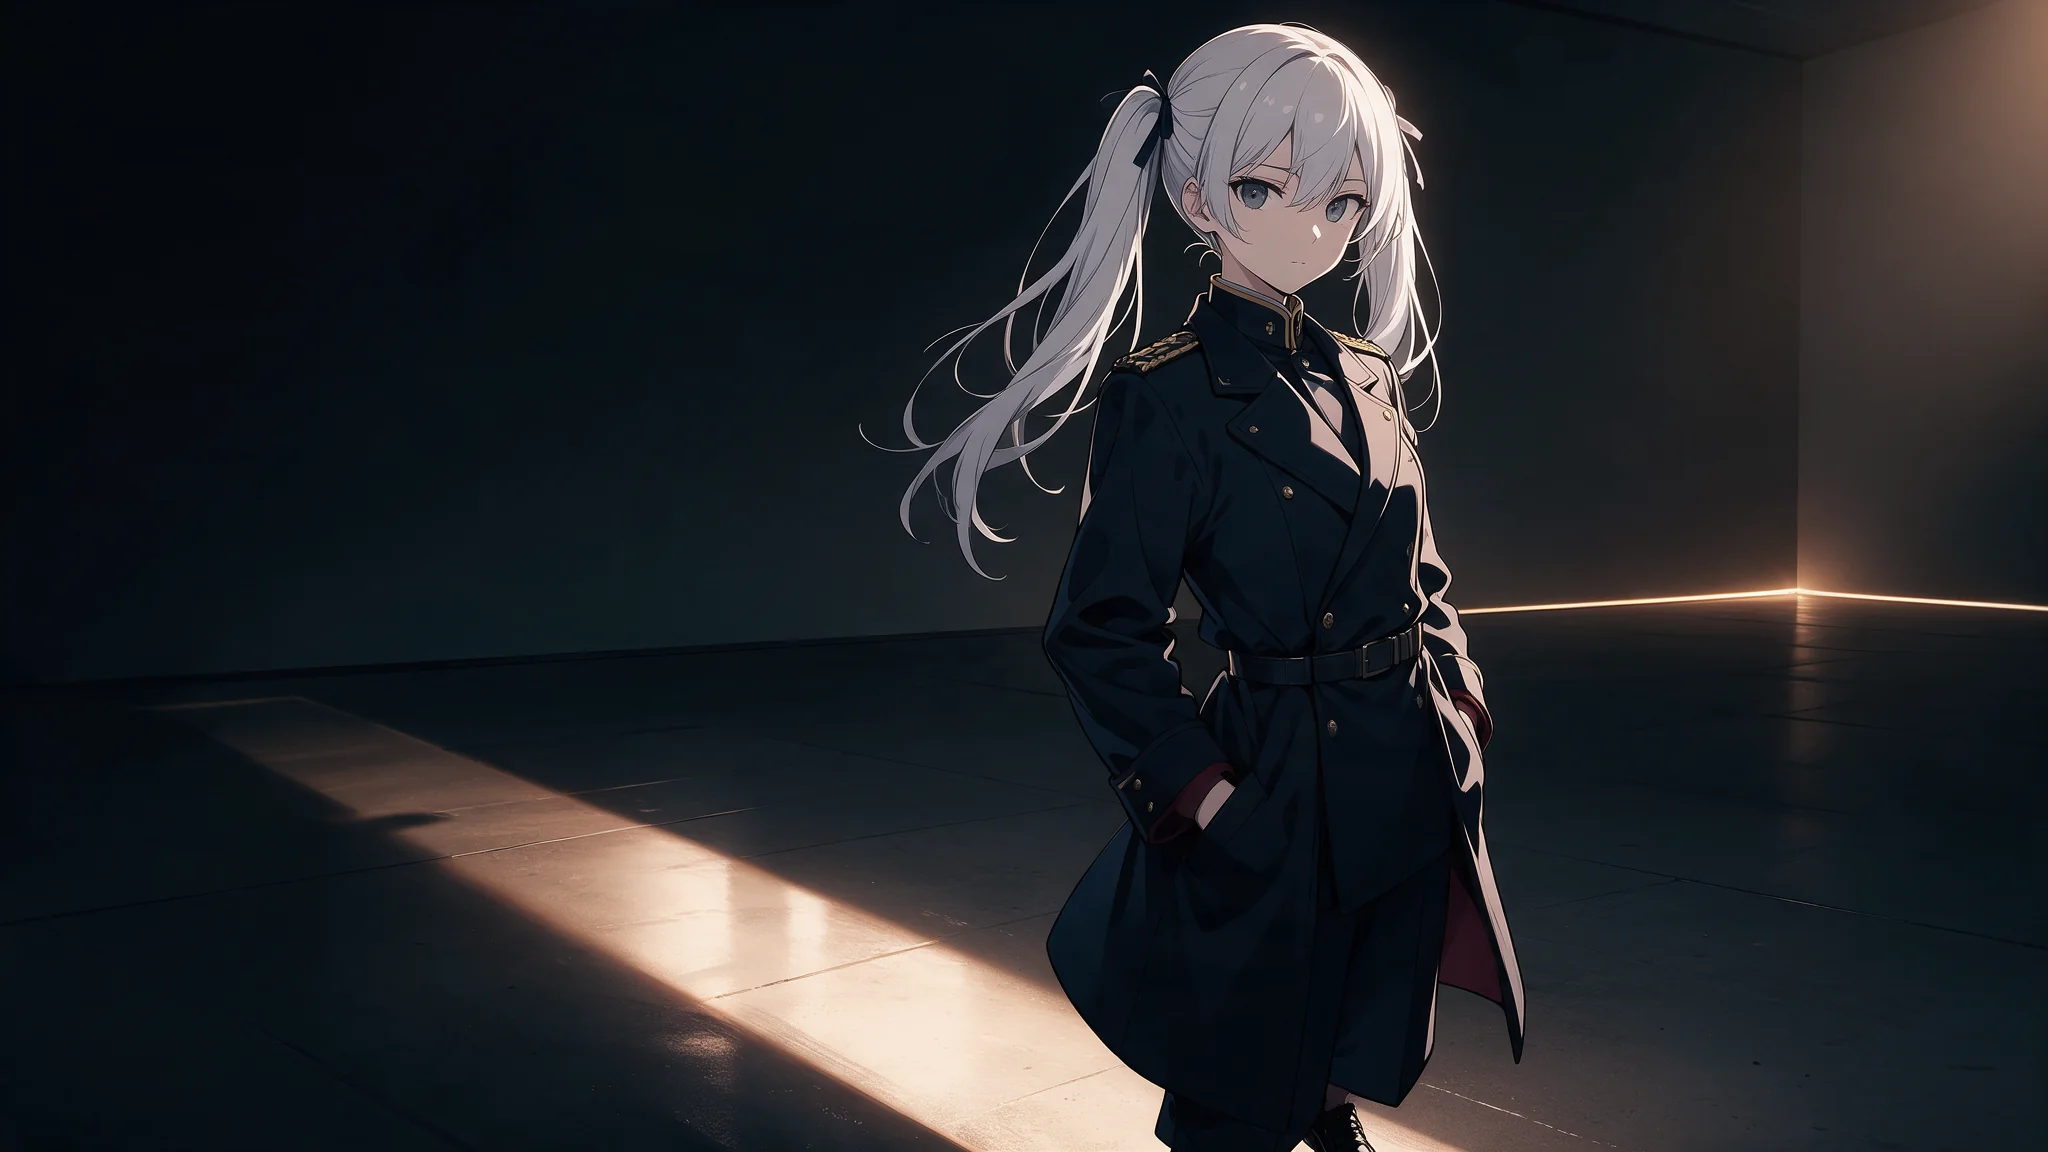
Anima Turbo, tekst na obraz, 3:4, poziom 1k, ziarno 22, tag oceny sensitive. Prompt opisywał ubranego dorosłego mężczyznę w drzwiach.
Co testowaliśmy: 25 zapytań na poziomach L1, L2, L3 i L4, tekst na obraz i obraz na obraz, z LoRA i bez, postaci żeńskie i męskie, dwa ziarna dla L3 i L4 oraz oba poziomy, 1k i 1.5k. Nie zobaczyliśmy ani jednej odmowy ani jednego podstawienia. L4 został narysowany zgodnie z opisem za pierwszym razem. W przebiegach obraz na obraz, które startowały od ubranego źródła, prośba o L3 lub L4 przy strength 0.8 do 0.9 była wykonywana. Kolejne 60 przebiegów z różnymi proporcjami obrazu z promptem na poziomie L2 zakończyło się powodzeniem.
O tym, czy model ci odpowiada, decydują trzy praktyczne sprawy:
- Prompty. Działały tagi w stylu Danbooru, zwykłe zdania i mieszanki jednych i drugich. Kolejność wydawcy to tagi jakości i oceny, liczba postaci (
1girl,1boy), postać, seria, artysta, a potem tagi ogólne. Ponieważ nie ma promptu negatywnego, tag oceny jest głównym sposobem ustawienia tonu. Model znasafe,sensitive,nsfwi jeden mocniejszy tag; dwa ostatnie znoszą powściągliwość. Publikujemy tu tylko przykłady zsafeisensitive. - Szybkość. W 60 mierzonych przebiegach czas modelu wynosił od 2 do 16 sekund na obraz, a 52 z 60 zakończyło się poniżej 10 sekund.
- Limity. Brak fotorealizmu, tylko jedno-dwa słowa wyrenderowanego tekstu i okazjonalny zawijas przypominający podpis w rogu (u nas na mniej więcej jednym obrazie na pięć; nowe ziarno to naprawia). Brak odmów nie znaczy braku wad: anatomia i dłonie nadal wymagają ponownych losowań ziarna.
Oto prompt, który działa jako punkt wyjścia. Opisuje ubraną dorosłą osobę:
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
long brown hair, white bathrobe slipping off one shoulder, standing by a large window at dawn,
holding a coffee cup, city skyline, soft light, calm smile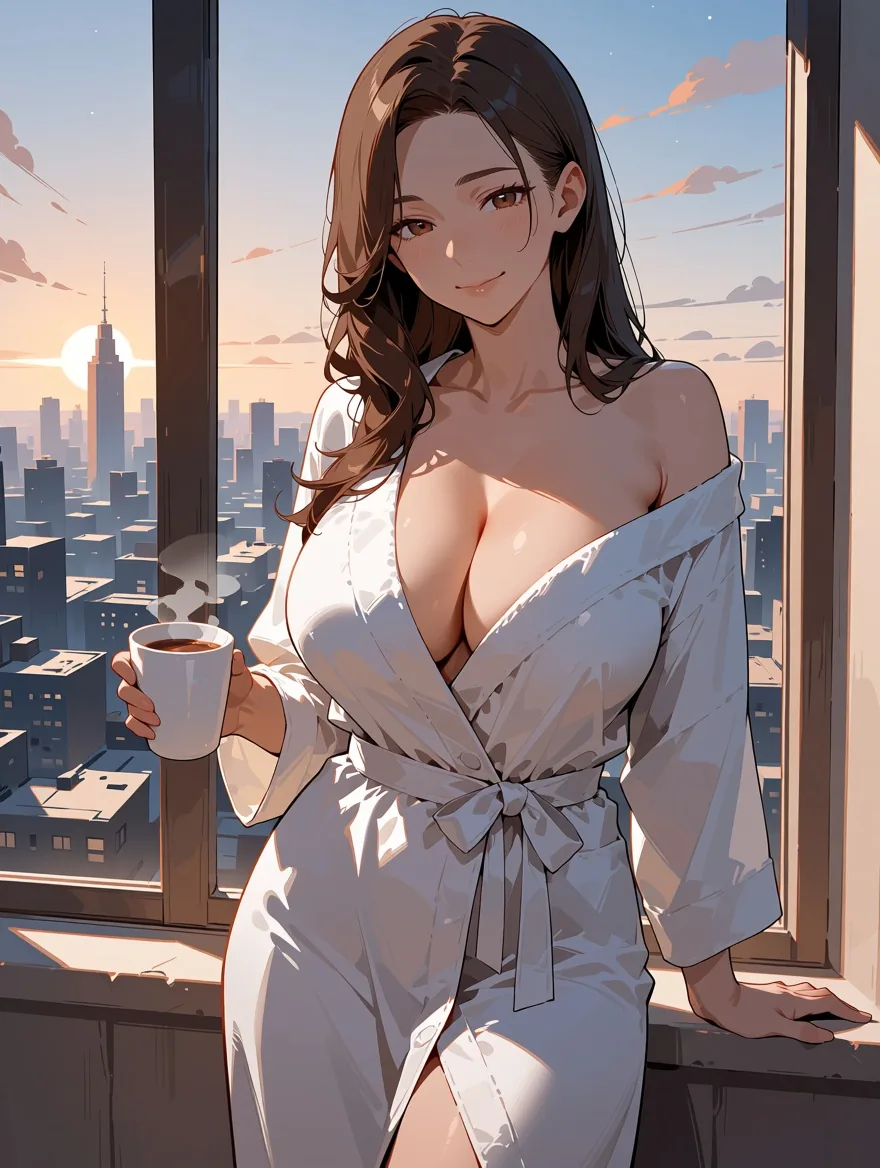
Anima Turbo, tekst na obraz z powyższego promptu, 3:4, poziom 1k, ziarno 23.
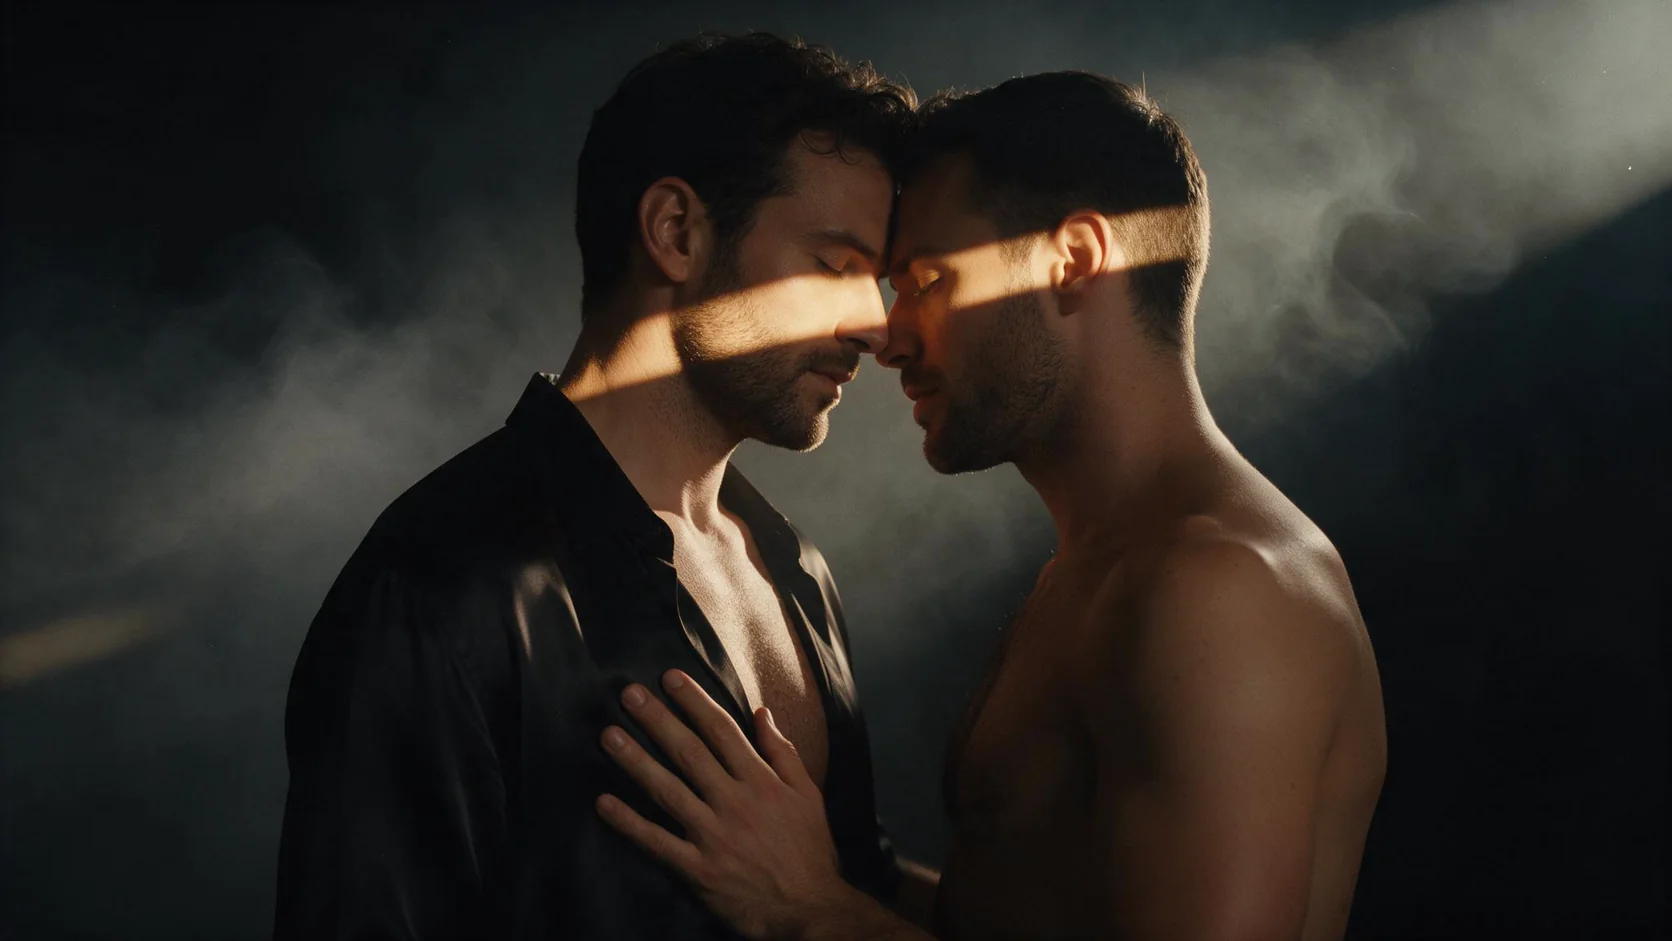
Anima radzi sobie też z dwiema postaciami w jednym kadrze, co ma znaczenie przy scenach dla par:
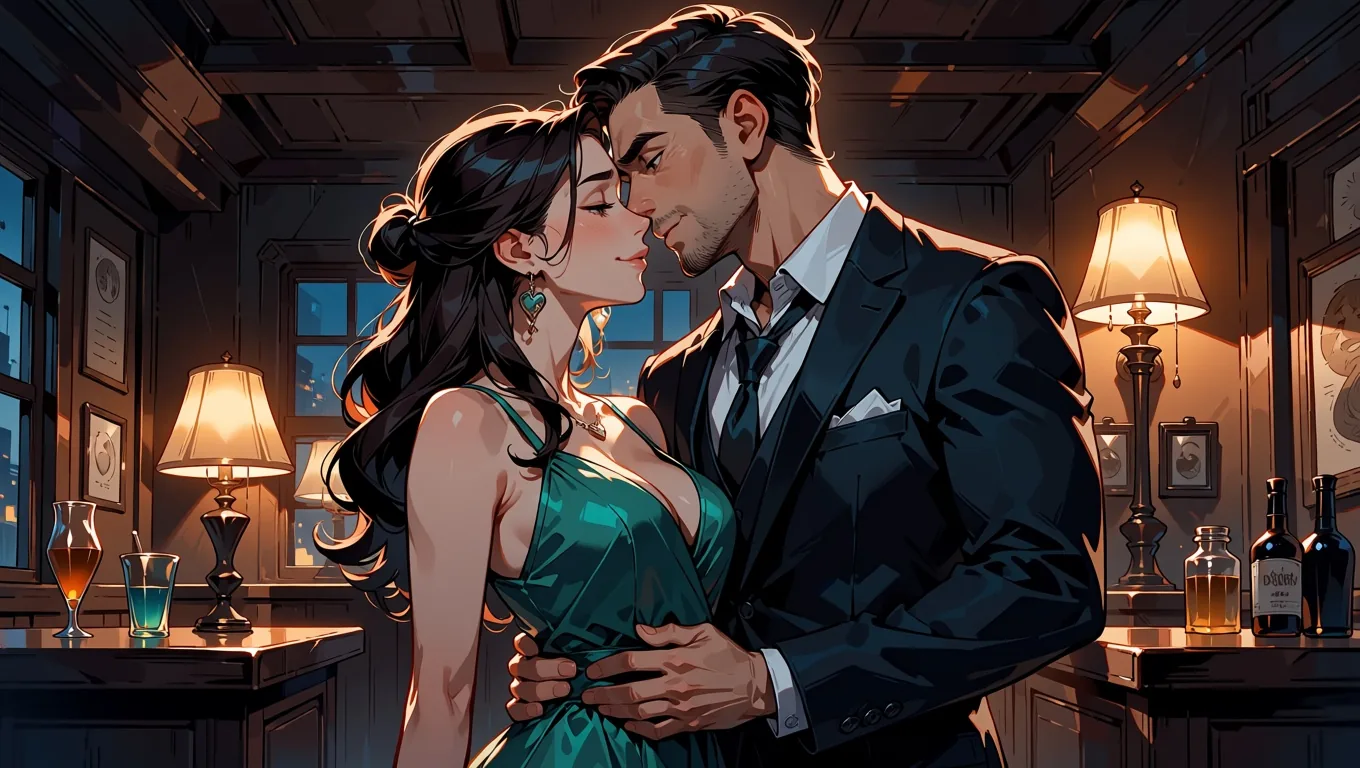
Anima Turbo, tekst na obraz, 16:9, poziom 1k, ziarno 24, tag oceny sensitive.
Jeśli chcesz zobaczyć pełne wyniki dla tego modelu, czyli prompty, strength i tagi stylu, nasz artykuł z testem Anima Turbo przechodzi przez nie po kolei. Możesz go uruchomić na stronie tekst na obraz Anima Turbo albo na stronie obraz na obraz.
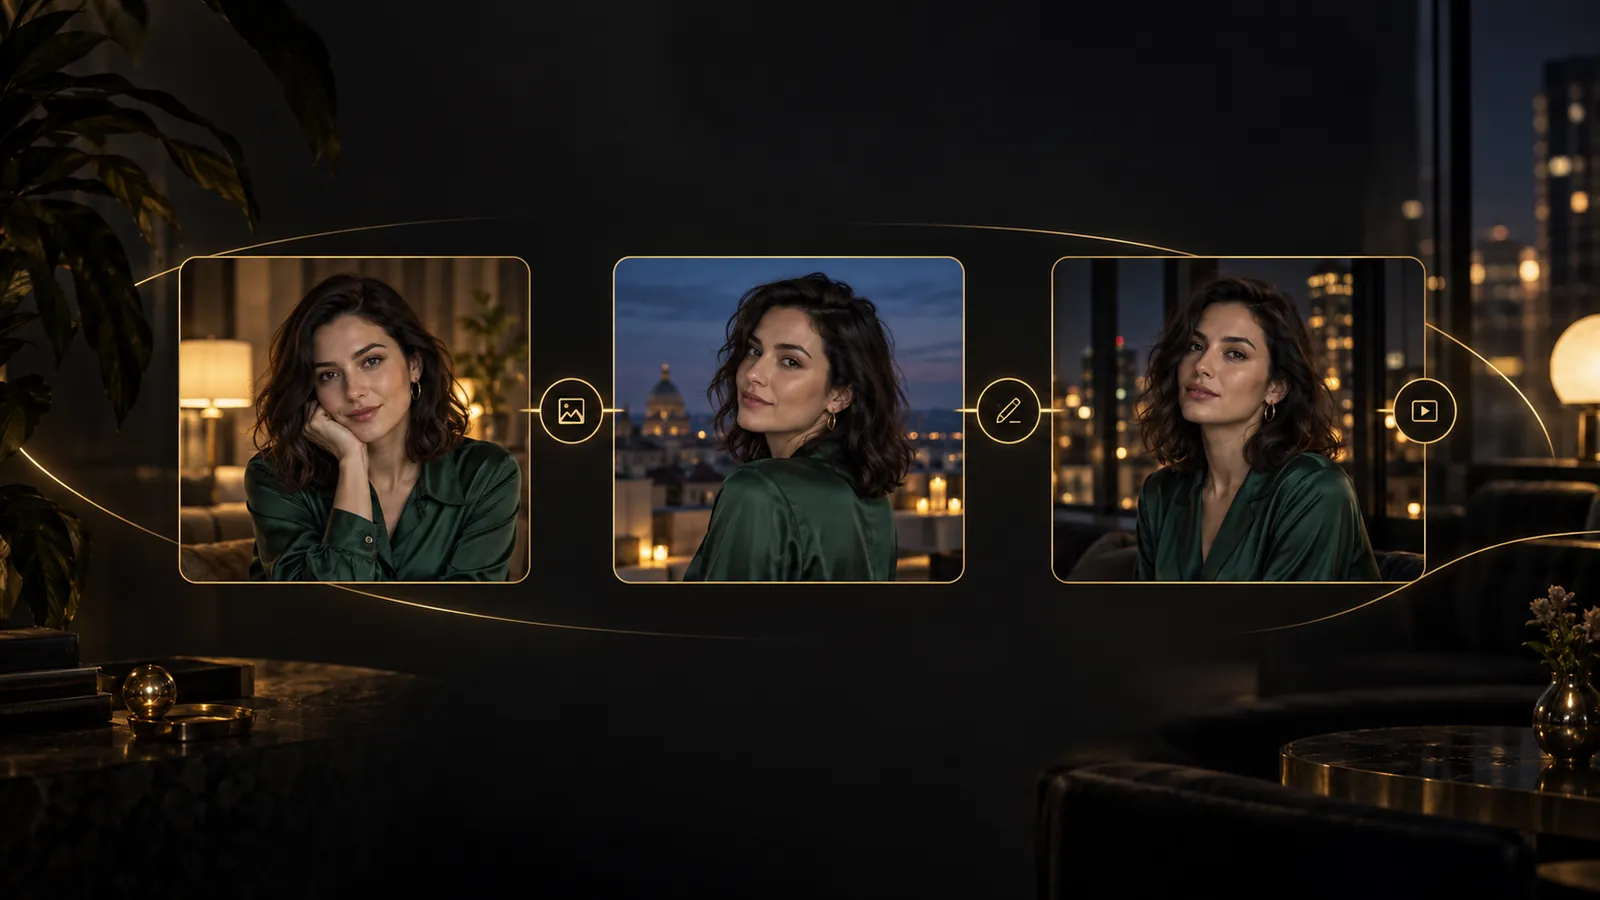
Utrzymanie jednej postaci w kolejnych scenach
Jeśli robisz serię, będziesz chciał mieć tę samą twarz w kilku miejscach. W jednym teście ustaliliśmy opis (srebrny bob, złote oczy, pieprzyk pod lewym okiem) i ziarno, a zmienialiśmy tylko strój i miejsce. Postać pozostała rozpoznawalna we wszystkich trzech obrazach.
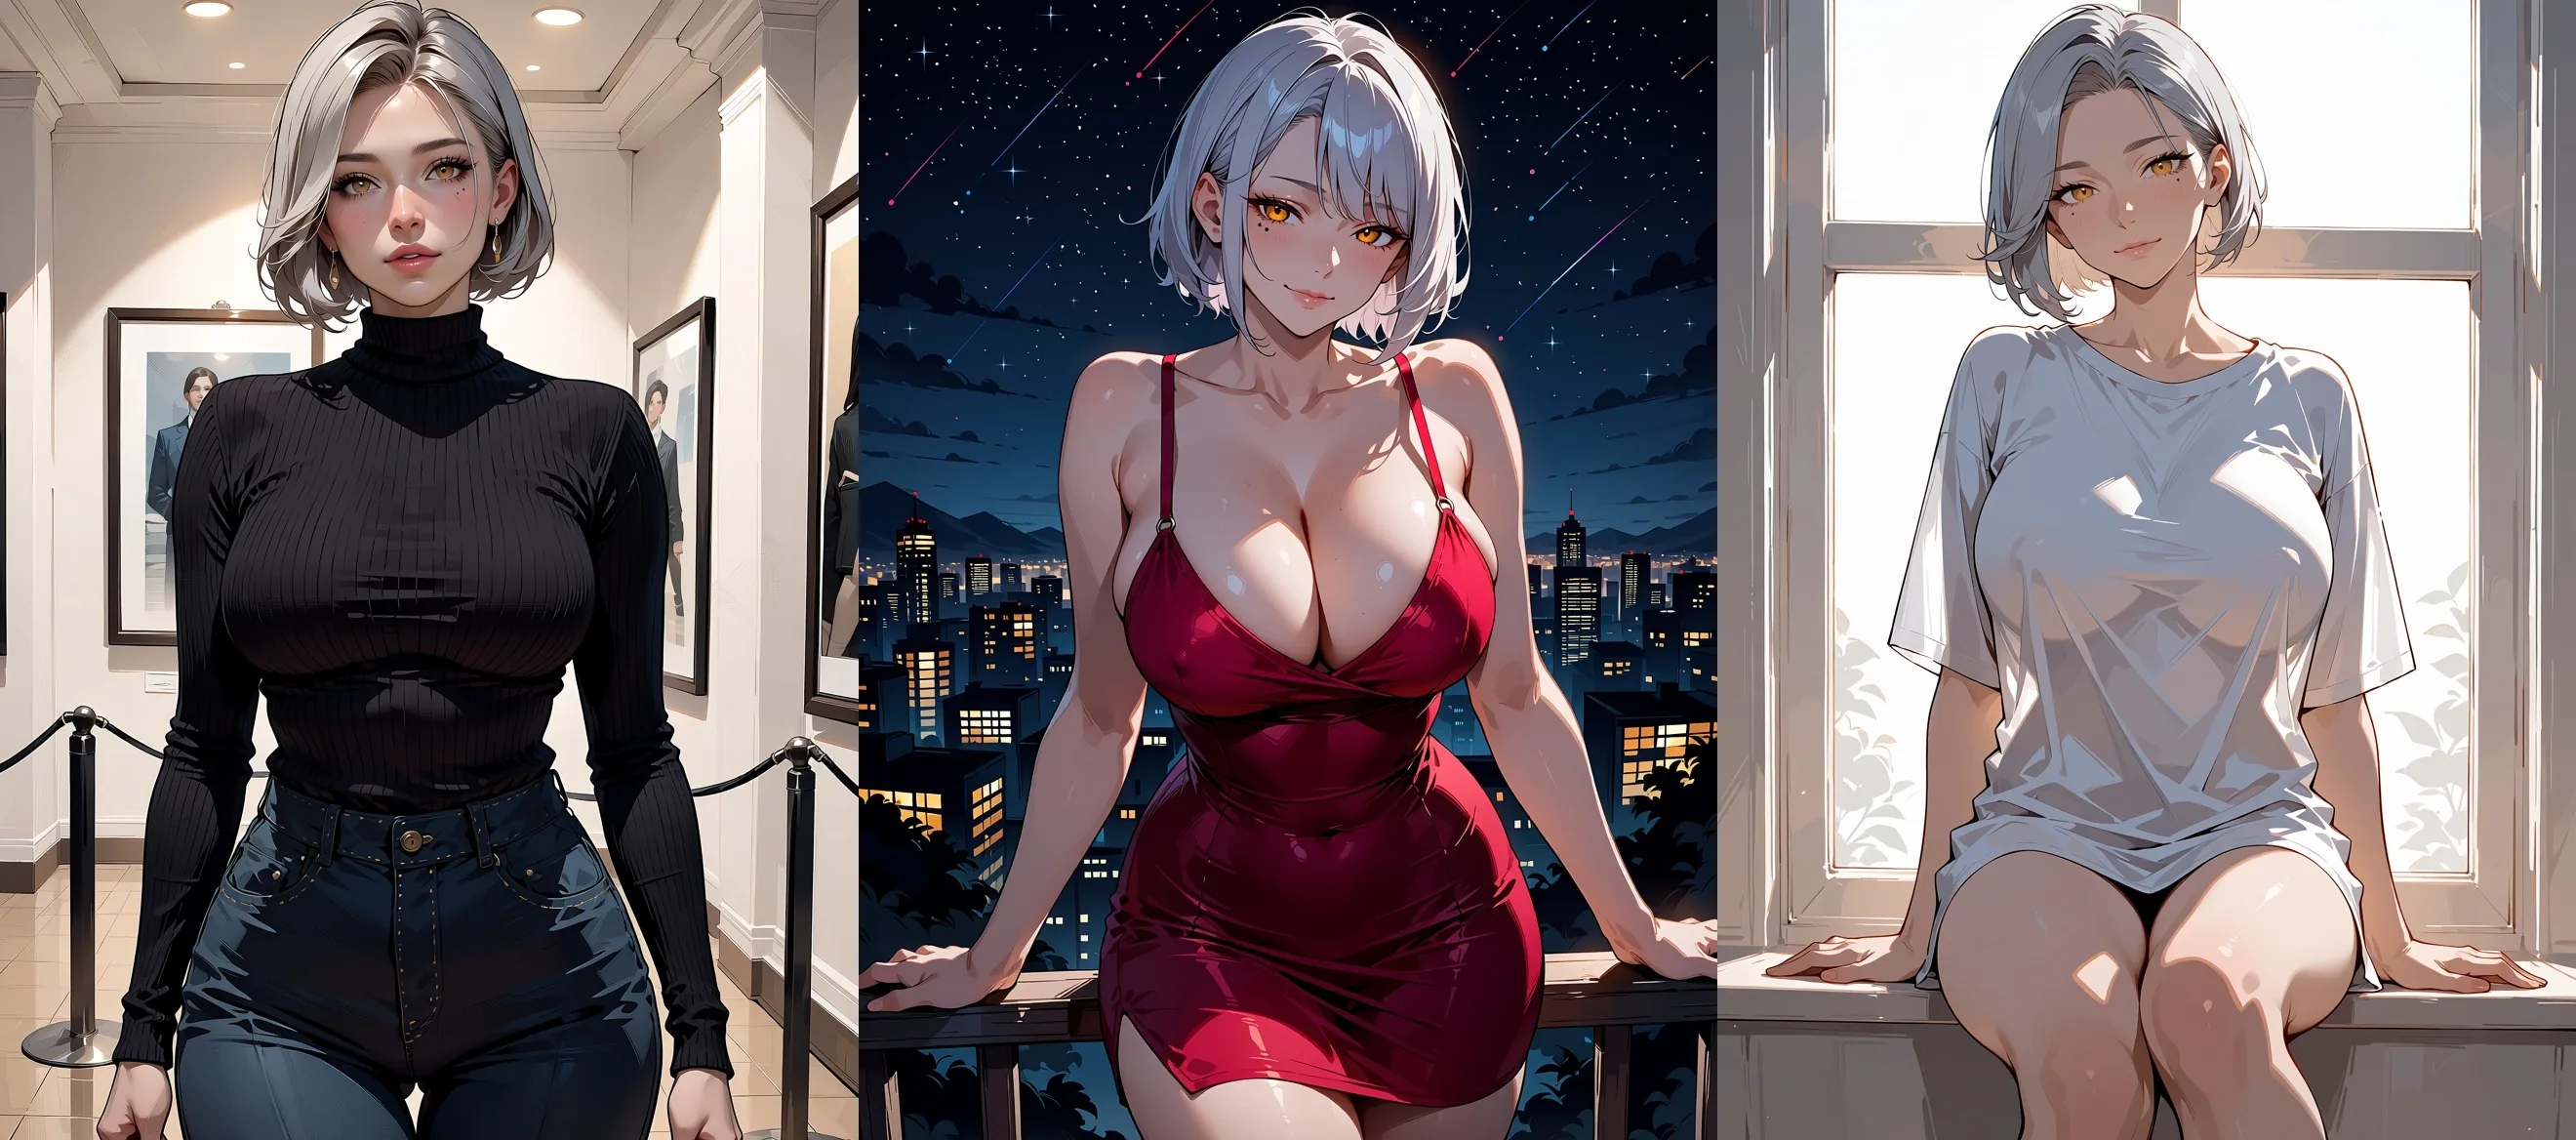
Anima Turbo, tekst na obraz, 3:4, poziom 1k, to samo ziarno (31) i ten sam opis postaci w trzech strojach i miejscach. Jeden przebieg na obraz.
Ziarna nie gwarantują identycznych pikseli, więc traktuj to jako metodę, która zadziałała u nas.
Anima Turbo LoRA: własne style i postacie
Wybierz Anima Turbo LoRA, gdy wygląd jest ważniejszy niż domyślny wygląd modelu. To ten sam model z maksymalnie trzema LoRA na zapytanie, każda podawana jako path (bezpośredni link HTTPS do pliku .safetensors) i scale od 0 do 4. Wczytanie LoRA nie wiąże się z osobną opłatą.
W naszych testach treści dorównywał zwykłemu modelowi: L3 i L4 narysowane, z LoRA i bez, i nie zobaczyliśmy odmów. Zmienia się kontrola. Wygląd gier z ery PC-98 pochodził na przykład z publicznej LoRA autorstwa Melon-Bread:
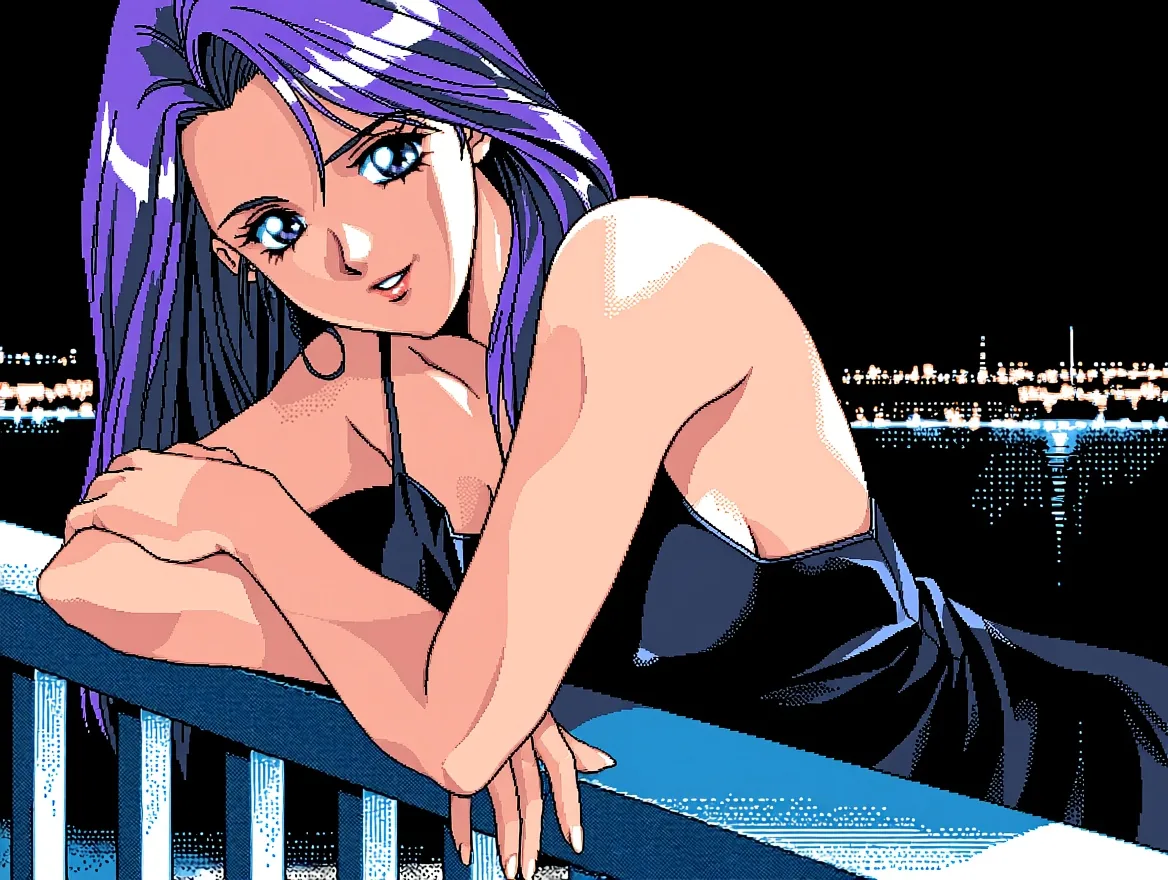
Anima Turbo LoRA, tekst na obraz, 4:3, poziom 1k, ziarno 32, LoRA PC-98 przy scale 1 ze słowem wyzwalającym, tag oceny sensitive.
Monochromatyczna LoRA w stylu mangi potrzebowała w prompcie monochrome, greyscale, żeby porzucić kolor:
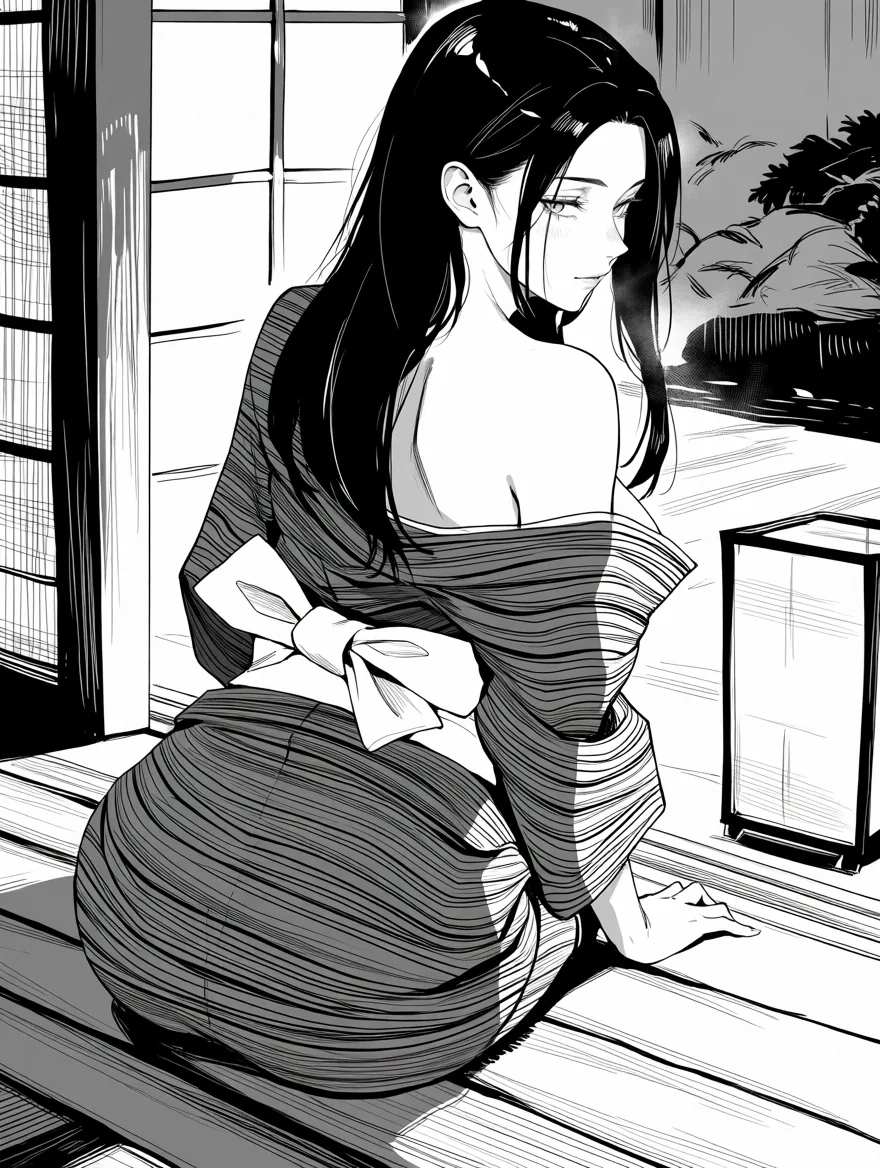
Anima Turbo LoRA, tekst na obraz, 3:4, poziom 1k, ziarno 33, LoRA monochromatyczna przy scale 1, tag oceny sensitive.
Co warto wiedzieć na starcie:
- Zakres scale. W naszych przebiegach 0.5 to było lekkie muśnięcie, 1 pełny styl, 1.5 mocniejsze wypchnięcie, a 4 rozbiło obraz na abstrakcyjne kształty. Użyteczny zakres to mniej więcej 0.5 do 1.2.
- Dopasuj bazę. LoRA wytrenowana pod inny model bazowy (próbowaliśmy jednej do FLUX) wczytała się bez błędu i niczego nie zmieniła: wynik był identyczny co do piksela z wynikiem bez LoRA. Używaj LoRA wytrenowanych pod Anima. Hugging Face wymieniał ich 129 na dzień 5 października 2026.
- Błędy linków nie są rozliczane. Zablokowany link wymagający logowania kończy się komunikatem HTTP 401, a link do strony repozytorium zamiast do pliku wywołuje prośbę o bezpośredni link do pobrania.
- Pierwsze użycie jest wolniejsze. Pierwsze zapytanie z nową LoRA może trwać dłużej, gdy plik jest pobierany; jedno nasze trwało prawie trzy minuty.
Nasz poradnik o stylach LoRA omawia scale, łączenie LoRA i słowa wyzwalające dokładniej, a model ma stronę tekst na obraz i stronę obraz na obraz.
Prefect Pony XL: linia Pony oparta na tagach
Wybierz Prefect Pony XL, jeśli twoje prompty i nawyki wywodzą się z ekosystemu Pony XL. To społecznościowy checkpoint anime z tej linii, tylko tekst na obraz, z siedmioma natywnymi rozmiarami SDXL. W naszym wewnętrznym przebiegu z 18 września 2026 narysował trzy poziomy sondy aż do L4.
To był wcześniejszy, osobny test, więc nie porównujemy go z Anima pod względem treści. Różnicę poczujesz w sposobie pracy: Pony działa tylko na tekst, nie ma obrazu na obraz ani miejsca na LoRA w SpicyAPI, a Anima Turbo daje obraz na obraz i siostrzaną rodzinę z LoRA. Dokładniej o wyborze stylów rysunku w Pony piszemy w poradniku stylów anime dla dorosłych (Adult Anime AI Image Style Guide).
Fotorealistyczne bazy z LoRA: Z-Image Turbo LoRA, Qwen Image 2512 LoRA, FLUX.1 Dev LoRA
Wybierz jedną z nich tylko wtedy, gdy masz powód, by opuścić ścieżkę natywną dla anime. Typowe powody: chcesz jednego modelu, który da zarówno wynik fotorealistyczny, jak i anime, masz już LoRA wytrenowaną pod tę bazę albo potrzebujesz edycji. Każda przyjmuje twoje LoRA, a wyniki testów treści z katalogu się różnią:
| Model | Czym jest | Testy treści |
|---|---|---|
| Z-Image Turbo LoRA | Alibaba Z-Image Turbo z twoimi LoRA; domyślnie fotorealistyczny, anime z LoRA anime | L3 i L4 narysowane (tekst na obraz) |
| Qwen Image 2512 LoRA | Qwen-Image-2512 z twoimi LoRA, plus edycja | L3 i L4 narysowane |
| FLUX.1 Dev LoRA | FLUX.1 [dev] z twoimi LoRA | L3 narysowany; L4 złagodzony w naszych testach |
„Złagodzony” znaczy, że zapytanie się zakończyło, ale obraz nie odpowiadał temu, o co prosiliśmy na danym poziomie. Jeśli twój projekt zależy od najintensywniejszego poziomu, ten wiersz jest powodem, dla którego FLUX.1 Dev LoRA jest w tabeli powyżej ostatnim wyborem, a nie pierwszym.
Dwa kolejne modele obrazów bez cenzury, MiniMax H3 Image LoRA (L4 narysowany) i Z-Image Spicy (fotorealistyczny, poziom bez cenzury), nie są wyborami do anime.
Gdy masz już obraz, który ci się podoba, możesz go ożywić. Seedance 2.5 Spicy, Wan 2.2 Spicy i MiniMax H3 Spicy to rodziny obraz na wideo bez cenzury: przyjmują obraz i prompt, a zwracają krótkie wideo.
Modele ogólnego przeznaczenia, które odmawiają: FLUX 3 i Ideogram v4.5
Jeśli rozważasz FLUX 3 lub Ideogram v4.5 do anime NSFW, pomiń je: oba odmawiały niemal wszystkiego poza neutralnym zdjęciem w kostiumie kąpielowym. Przetestowaliśmy oba 5 października 2026 przez zewnętrzne hostowane API, na tej samej drabinie na poziomie 1k.
| Model | Dostarczył | Odmówił |
|---|---|---|
| FLUX 3 tekst na obraz (Black Forest Labs) | Scenę na plaży w bikini; neutralne zdjęcie bielizny do katalogu | Bielizna z kokieteryjnym sformułowaniem (L1), L2, L3, L4, klasyczne studium malarskie aktu, akt męski i eufemistyczny prompt bez oznaczonych słów (10 z 12 zapytań) |
| Ideogram v4.5 (Ideogram) | Te same dwa | Ten sam zestaw; włączenie lub wyłączenie rozszerzania promptu nie zmieniło niczego (11 z 13 zapytań) |
Odmowy wracały po około dwóch sekundach, zanim powstał jakikolwiek obraz, z komunikatem „Content flagged as potentially sensitive. Please try different prompts or images.” Odrzuconych zapytań nie rozliczano. Ponieważ odrzucony został także prompt eufemistyczny, filtr zachowuje się jak semantyczny, a nie jak lista słów kluczowych. Nie wiemy, czy ten filtr należy do własnych API twórców modeli, czy do użytego przez nas hosta, więc czytaj to jako „odmowa na tej trasie”, a nie wyrok o modelach w każdych ustawieniach.
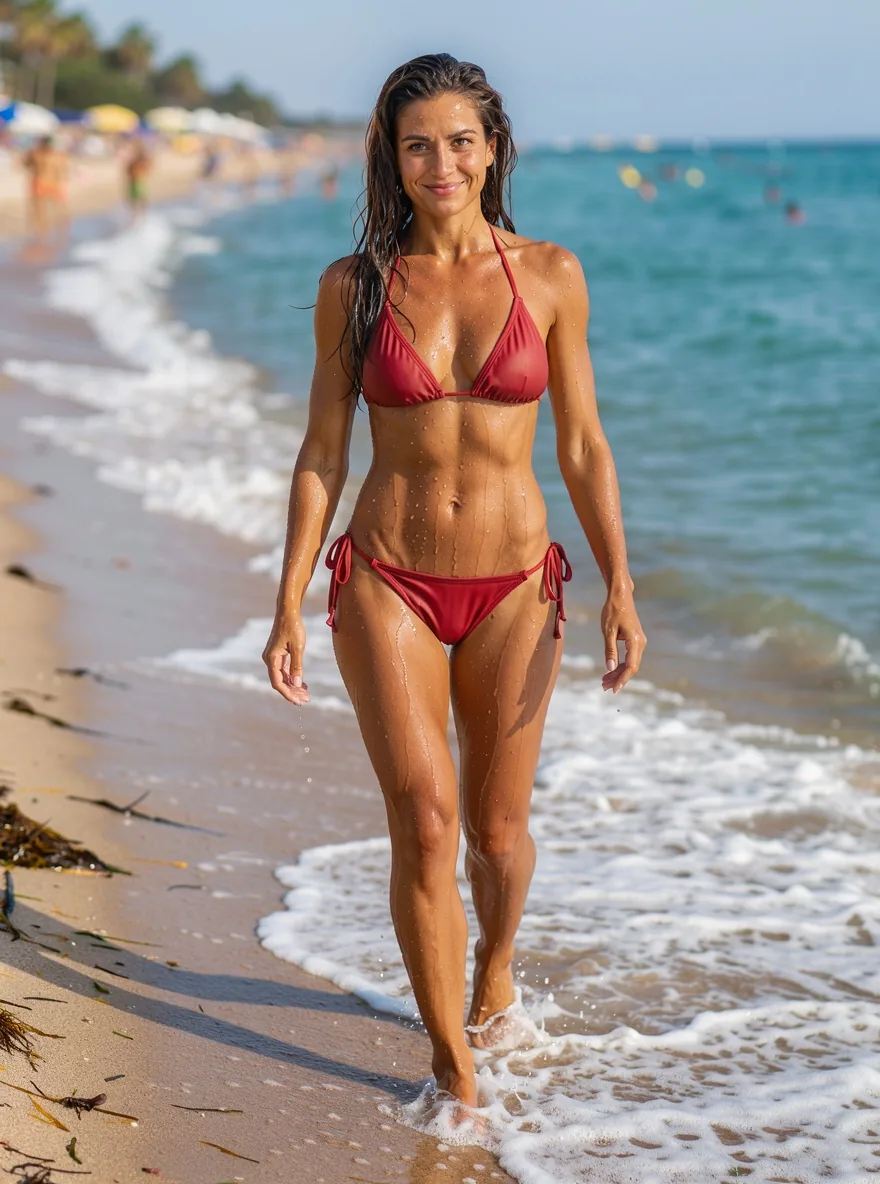
FLUX 3, tekst na obraz, poziom 1k. To zdjęcie z plaży w bikini było jednym z dwóch zapytań, które dostarczył.
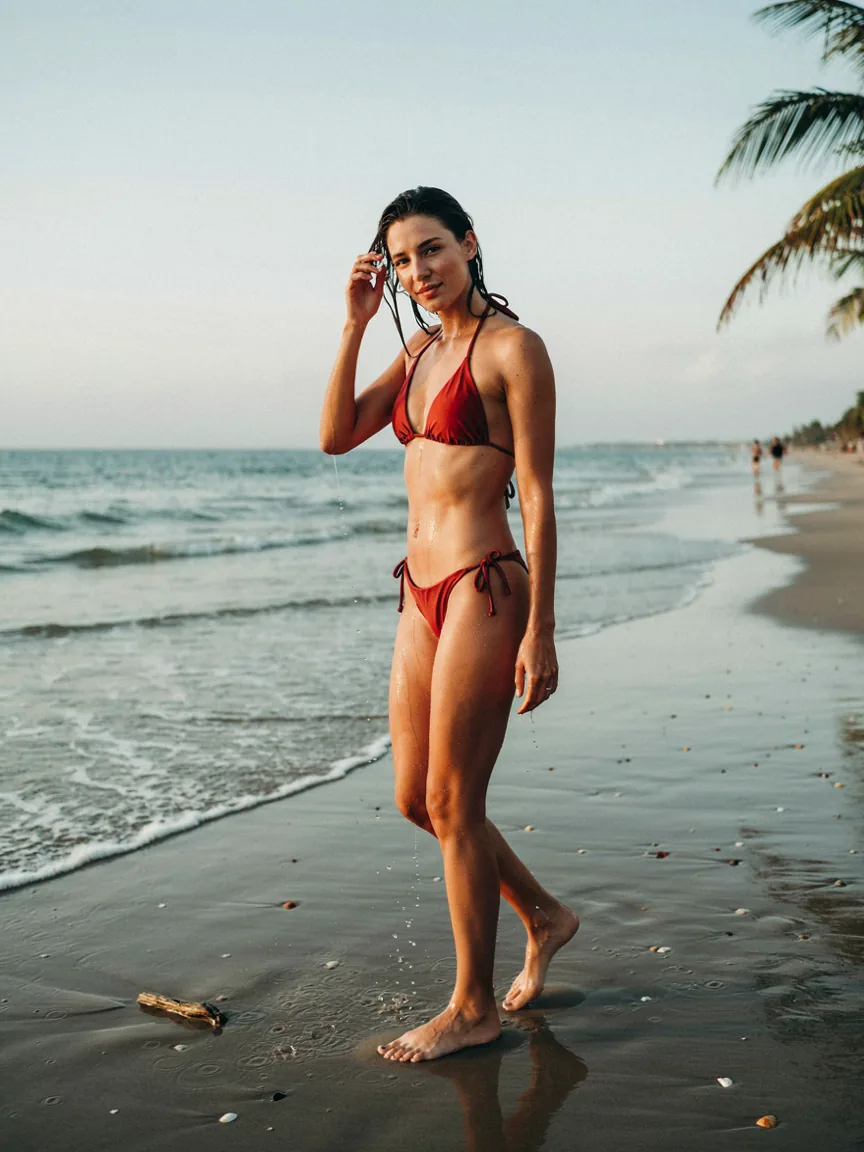
Ideogram v4.5, poziom 1k. Ten sam rodzaj sceny na plaży w bikini, jedno z dwóch zapytań, które dostarczył.
Oba modele zwracały też fotografie, a nie anime, więc nawet łagodniejsze ustawienie nie pokryłoby połowy „anime” z twojego zadania. Szersze porównanie modeli obrazów znajdziesz w naszym zestawieniu generatorów obrazów NSFW.
Jak testowaliśmy i czego testy nie mówią
Traktuj każdą liczbę tutaj jako małą próbę z datą. Wyniki Anima to 25 zapytań o treści plus 60 przebiegów z proporcjami obrazu z 5 października 2026, przeważnie jedno lub dwa ziarna na przypadek. Wyniki FLUX 3 i Ideogram v4.5 to odpowiednio 13 i 14 zapytań tego samego dnia przez jedną zewnętrzną trasę. Wynik Prefect Pony XL pochodzi z wewnętrznego przebiegu z 18 września 2026. Pozostałe wiersze pochodzą z testów treści z katalogu i są podane tak, jak tam zapisano.
Czego testy nie pokazują:
- Nie klasyfikują jakości obrazu. Nie oceniliśmy twarzy, dłoni, kompozycji ani stylu w różnych modelach i nie twierdzimy, że Anima wygląda lepiej niż jakikolwiek inny model.
- Nie gwarantują tego samego wyniku następnym razem. Dostawcy zmieniają filtry, a to samo zapytanie z tym samym ziarnem dawało nam w różnych momentach nieco inne obrazy.
- Tag oceny zmienia ton mniej, niż ludzie się spodziewają przy opisie ubranej postaci: przy tym samym prompcie z lounge'a i tym samym ziarnie
safeisensitivedały prawie ten sam obraz.
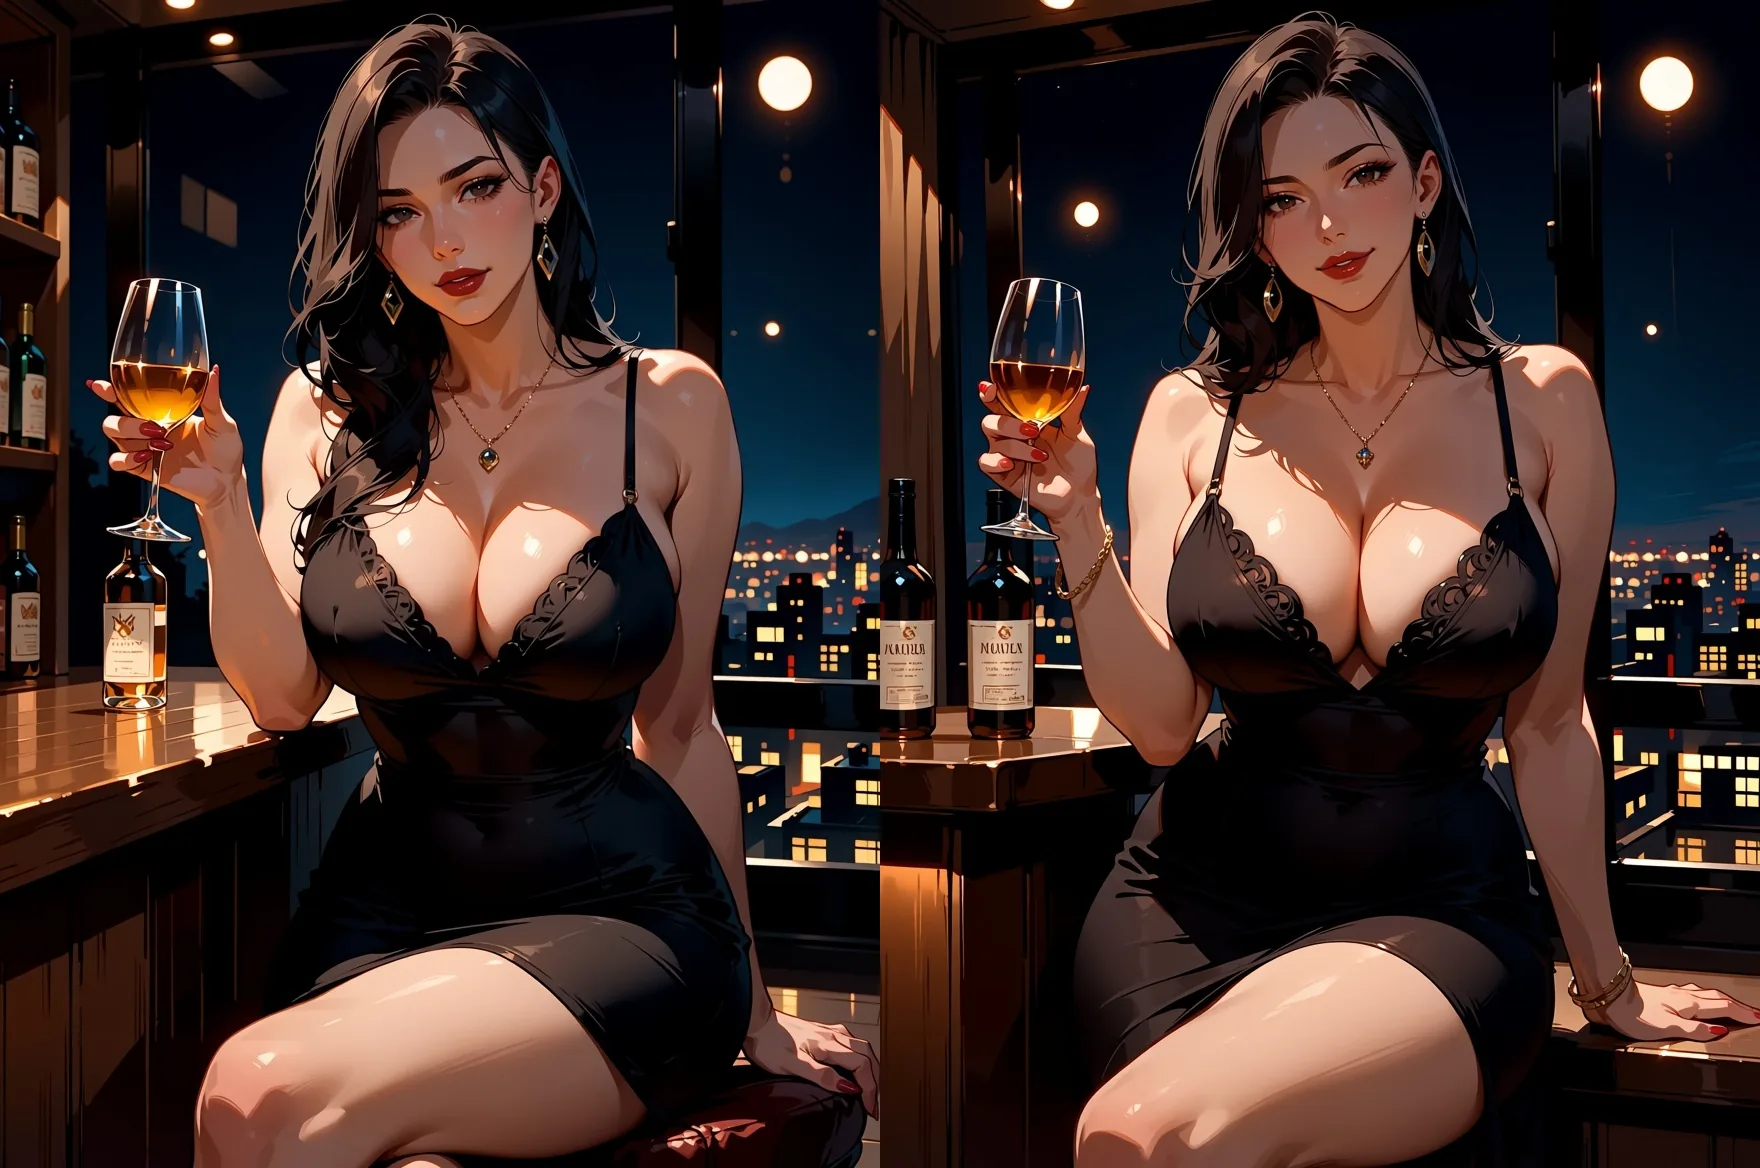
Anima Turbo, tekst na obraz, 3:4, poziom 1k, ziarno 27. Po lewej: safe. Po prawej: sensitive. Poza tym ten sam prompt.
Jak wybrać w trzech pytaniach
- Masz LoRA albo potrzebujesz konkretnego stylu? Jeśli tak, użyj Anima Turbo LoRA albo bazy z obsługą LoRA, która pasuje do posiadanej LoRA (LoRA do innej bazy nic nie robi). Jeśli nie, zacznij od Anima Turbo.
- Piszesz prompty jako tagi w stylu Pony i chcesz właśnie tego ekosystemu? Wtedy wypróbuj Prefect Pony XL. Jeśli chcesz obrazu na obraz ze zdjęcia lub rysunku, oferuje go Anima Turbo.
- Czy w ogóle potrzebujesz fotorealizmu? Jeśli tak, użyj bazy nastawionej na fotorealizm, takiej jak Z-Image Turbo LoRA, i najpierw sprawdź jej wiersz z testami treści. Jeśli chcesz tylko anime, zostań przy modelach natywnych dla anime.
Jeśli planujesz zamienić zdjęcie w anime, nasz poradnik o strength pokazuje, co robi każda wartość strength.
Używaj tych modeli odpowiedzialnie
Twórz wyłącznie dorosłe postacie i mów o tym w prompcie. Nie generuj prawdziwych osób ani prawdziwych wizerunków bez ich zgody. Własne wyniki zachowaj dla siebie, dopóki nie masz pewności, gdzie wolno ci je publikować. Odpowiadasz za to, co generujesz, przechowujesz i udostępniasz, oraz za przestrzeganie przepisów, które cię dotyczą.
FAQ
Który model AI jest najlepszy do anime NSFW?
Do anime z samego promptu Anima Turbo najlepiej pasował w naszych testach: nasz najmocniejszy test treści narysował zgodnie z opisem już za pierwszym razem, bez odmów w 25 zapytaniach. Prefect Pony XL pasuje do promptów z tagami w stylu Pony, a Anima Turbo LoRA do własnych stylów. „Najlepszy” zmienia się z zadaniem, więc skorzystaj z tabeli szybkiego wyboru powyżej.
Czy FLUX 3 lub Ideogram v4.5 narysują anime NSFW?
W naszych testach nie. FLUX 3 odmówił 10 z 12 zapytań, a Ideogram v4.5 11 z 13, w tym bielizny z kokieteryjnym sformułowaniem. Oba dostarczyły tylko neutralną scenę na plaży w bikini i zdjęcie bielizny do katalogu. Filtr może należeć do hosta, a nie do twórców, czego nie mogliśmy sprawdzić.
Czy potrzebuję LoRA do anime NSFW?
Nie. Anima Turbo narysował nasze testowane poziomy bez żadnej LoRA. LoRA pomaga, gdy chcesz konkretnego stylu albo powracającej postaci. Użyj takiej, która jest wytrenowana pod Anima: LoRA do innej bazy wczytała się bez błędu i w naszym teście niczego nie zmieniła.
Czy te modele naprawdę są bez cenzury, czy po cichu łagodzą obrazy?
Na Anima nie zobaczyliśmy ani jednej odmowy ani jednego podstawienia w 25 zapytaniach o treści. Łagodzenie istnieje gdzie indziej: FLUX.1 Dev LoRA złagodził w naszych testach najintensywniejszy poziom. Model może się też zachowywać inaczej przy różnych ziarnach, więc sprawdzaj każdy wynik.
Jaka jest różnica między tagami oceny safe i sensitive?
Przy opisie ubranej postaci dały w naszym teście prawie ten sam obraz, więc tag jest raczej wskazówką tonu niż przełącznikiem. Wydawca opisuje nsfw i jeden mocniejszy tag jako te, które znoszą powściągliwość. Ponieważ nie ma promptu negatywnego, tag oceny jest głównym sposobem ustawienia tonu.
Czy mogę zamienić własne zdjęcie w anime?
Tak, w Anima Turbo obraz na obraz. W naszych testach zdjęcie przy strength 0.3 nadal wyglądało jak zdjęcie, przy 0.6 jak ilustracja, a przy 0.75 jak czyste anime. Od 0.9 szczegóły zaczynają się zmieniać, a przy 1.0 źródło jest ignorowane. Model zmienia styl; nie wykonuje poleceń edycji.
Czy mogę ożywić te obrazy?
Tak. Seedance 2.5 Spicy, Wan 2.2 Spicy i MiniMax H3 Spicy przyjmują obraz i prompt, a zwracają krótkie wideo.