Für NSFW-Anime-Art allein aus einem Prompt passte Anima Turbo in unseren Tests am besten: Es rendert unsere stärkste Inhaltsprobe gleich beim ersten Versuch wie geschrieben, ist auf Anime ausgelegt und braucht keine zusätzlichen Dateien. Ergänzen Sie Anima Turbo LoRA, wenn Sie einen eigenen Stil oder eine eigene Figur wollen, Prefect Pony XL, wenn Sie mit Tags im Pony-Stil arbeiten, und eine Basis mit Fotorealismus als Standard nur dann, wenn Sie sie mit einer Anime-LoRA lenken wollen. Allzweckmodelle wie FLUX 3 und Ideogram v4.5 lehnten fast alles ab, was über ein neutrales Bikinifoto hinausging.
„Am besten" hängt von der Aufgabe ab; dies ist daher ein Entscheidungsleitfaden und keine Rangliste. Jede Aussage unten stammt aus unseren eigenen Läufen vom 5. Oktober 2026 oder aus den Inhaltstests des SpicyAPI-Katalogs, und jeder Abschnitt nennt, wie klein die Stichprobe war. Die Bildqualität bewerten wir nicht über das hinaus, was wir gesehen haben.
Auf einen Blick: welches Modell für welche Aufgabe
| Ihre Aufgabe | Empfehlung | Warum, nach unseren Tests | Seite |
|---|---|---|---|
| Anime-Art aus Text, ohne zusätzliche Dateien | Anima Turbo | Anime- und Illustrationsmodell; die meisten getesteten Stufen (auch intensive Szenen) wurden wie geschrieben gerendert | Anima Turbo |
| Ein eigener Kunststil oder eine wiederkehrende Figur | Anima Turbo LoRA | Dasselbe Modell mit bis zu 3 eigenen LoRAs | Anima Turbo LoRA |
| Prompts aus Danbooru- oder Pony-Tags | Prefect Pony XL | Community-Anime-Checkpoint der Pony-XL-Linie, nur Text-zu-Bild | Prefect Pony XL |
| Fotorealistische Basis, die auch Anime kann | Z-Image Turbo LoRA | Standardmäßig fotorealistisch; Anime mit einer Anime-LoRA; intensive Szenen gerendert | Z-Image Turbo LoRA |
| Eine Anime-LoRA auf einer anderen Basis, dazu Bearbeitung | Qwen Image 2512 LoRA | Nimmt LoRAs entgegen und kann bearbeiten; intensive Szenen gerendert | Qwen Image 2512 LoRA |
| Sie besitzen bereits eine FLUX.1-Dev-LoRA | FLUX.1 Dev LoRA | Nimmt Ihre LoRAs entgegen; die stärkste Stufe wurde in unseren Tests abgeschwächt | FLUX.1 Dev LoRA |
| Uneingeschränktes Arbeiten mit FLUX 3 oder Ideogram v4.5 | Keines von beiden | Sie lehnten 10 von 12 bzw. 11 von 13 Anfragen ab | siehe unten |
Wie wir Inhaltsstufen beschreiben
Wir nutzen eine Leiter mit fünf Stufen. L1 ist anzüglich (Dessous, ein von der Schulter rutschender Träger). L2 ist teilweise, oberkörperfrei. L3 ist vollständige Freizügigkeit. L4 ist eine intensive Szene zwischen zwei Erwachsenen. L5 ist extrem: einvernehmliche Fesselung zwischen Erwachsenen oder filmische Gore-Darstellung. L5 haben wir mit Anima nicht durchgeführt. In diesem Artikel steht kein Prompt oberhalb von L1, und jede Figur ist erwachsen. Die Plattform selbst setzt bei diesen Endpunkten keinen Content-Filter davor; entscheidend ist also, was jedes Modell mit der Anfrage macht.
Anima Turbo: in unseren Tests die beste Wahl für Anime allein aus Prompts
Wählen Sie Anima Turbo, wenn Sie Anime- oder Illustrations-Ausgaben aus einem Prompt wollen und sonst nichts. Es ist die destillierte Variante von Anima von CircleStone Labs, einem Modell mit 2 Milliarden Parametern auf Basis von NVIDIA Cosmos-Predict2 mit einem Qwen3-Text-Encoder. Der Herausgeber empfiehlt, mit der Turbo-Variante zu beginnen, die laut ihm im Durchschnitt nur geringfügig schlechter als die Aesthetic-Variante, dabei aber deutlich schneller ist.
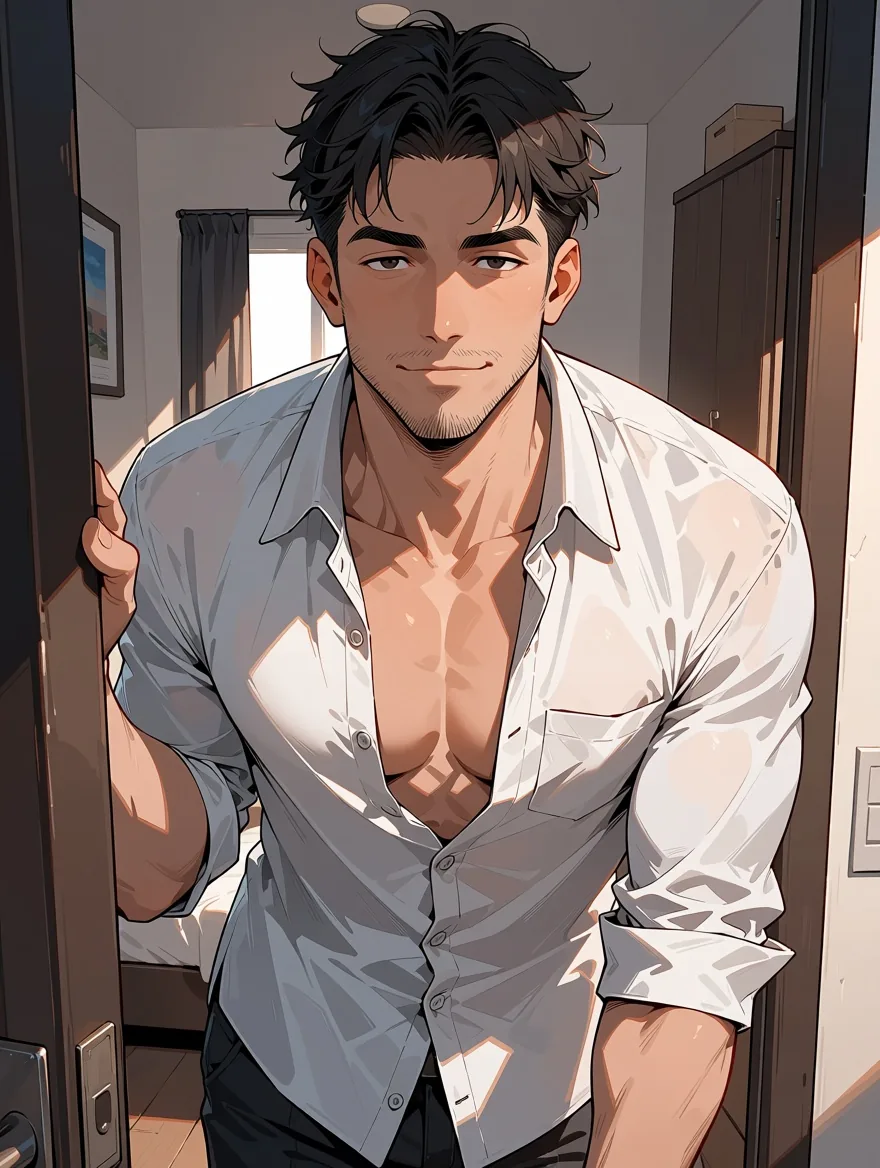
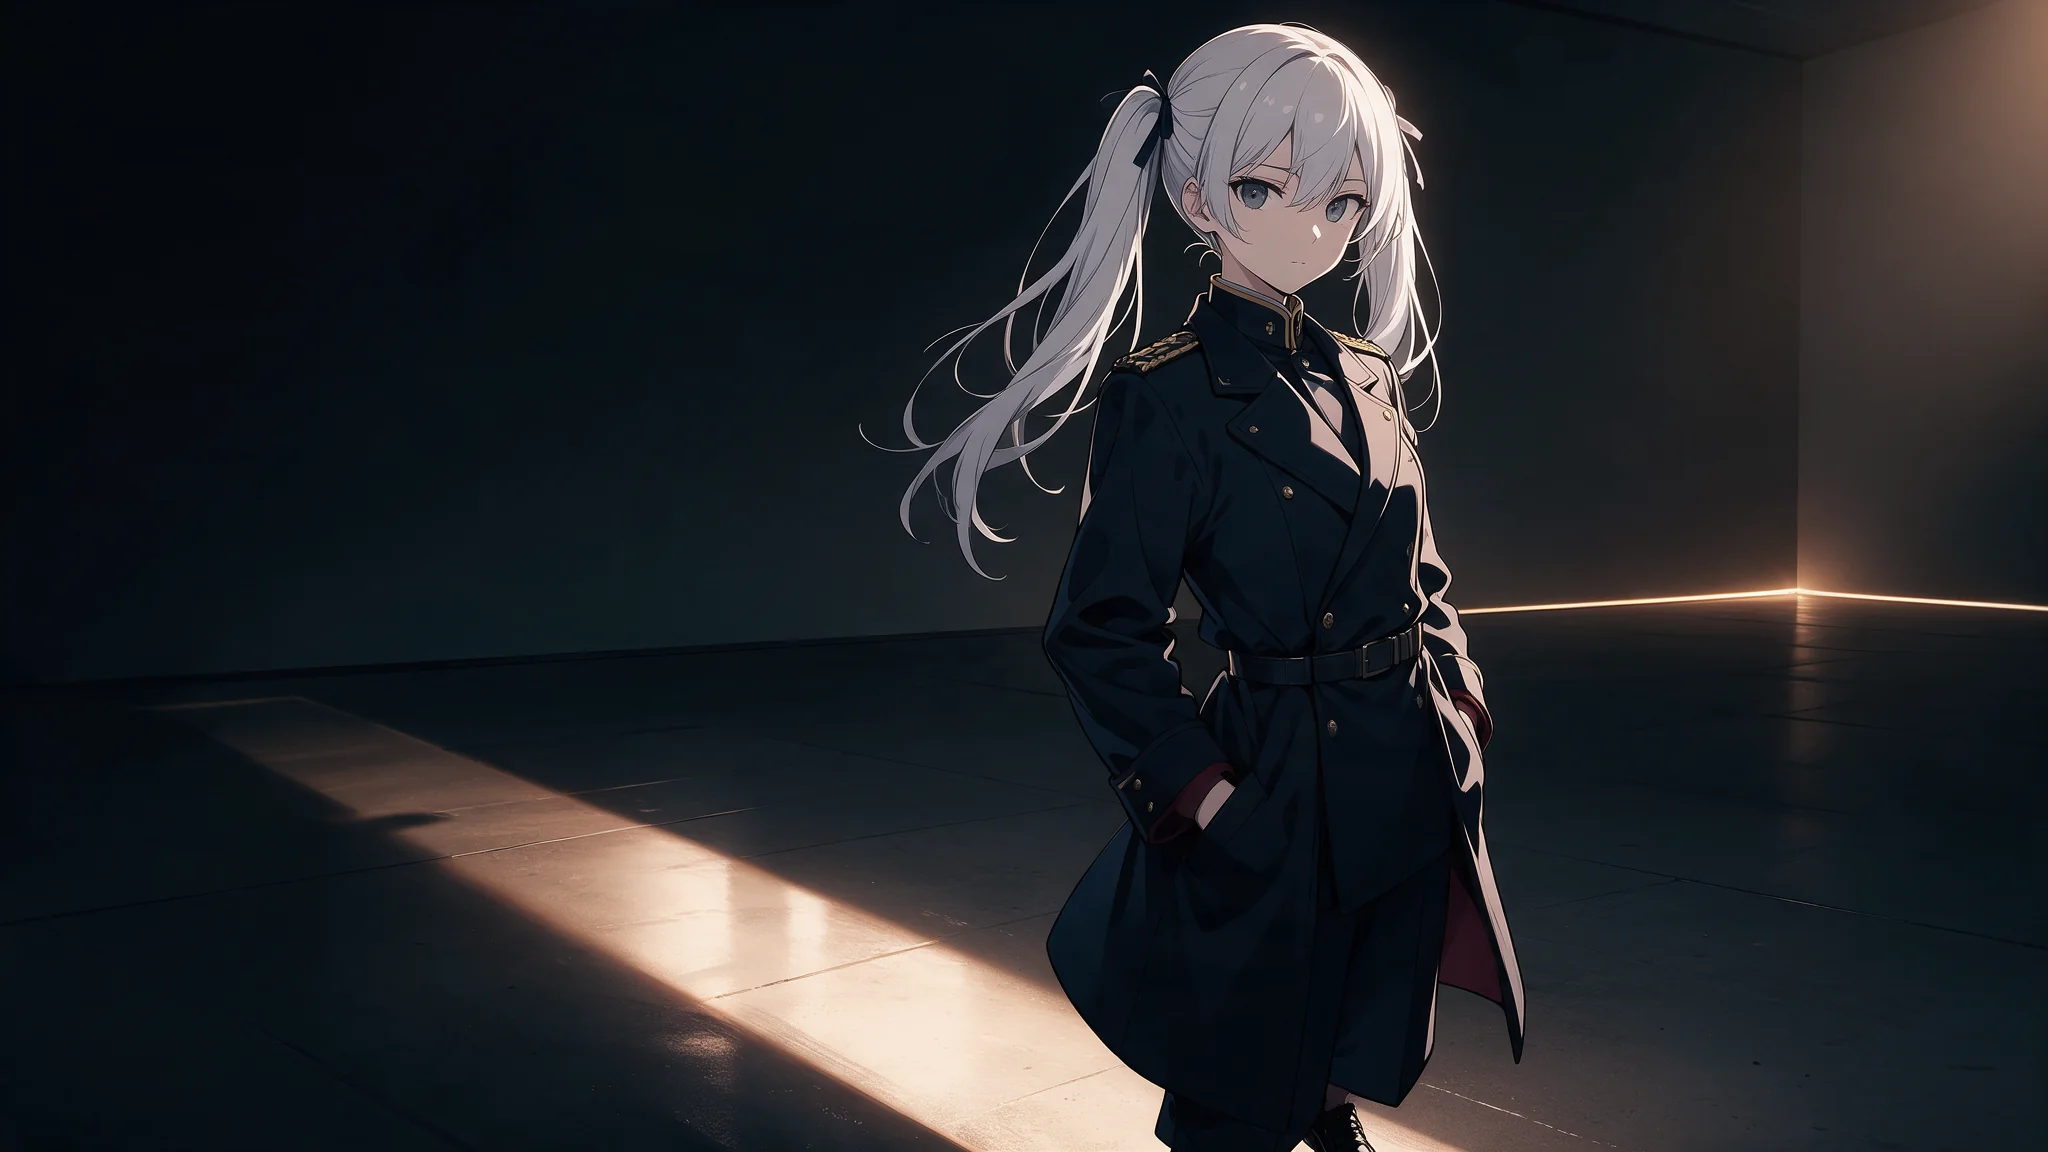
Anima Turbo Text-zu-Bild, 3:4, Stufe 1k, Seed 22, Rating-Tag sensitive. Der Prompt beschrieb einen bekleideten erwachsenen Mann in einer Tür.
Was wir getestet haben: 25 Anfragen über L1, L2, L3 und L4, Text-zu-Bild und Bild-zu-Bild, mit und ohne LoRAs, weibliche und männliche Figuren, zwei Seeds für L3 und L4 sowie beide Stufen 1k und 1.5k. Wir sahen keine einzige Ablehnung und keine einzige Ersetzung. L4 wurde gleich beim ersten Versuch wie geschrieben gerendert. In Bild-zu-Bild-Läufen, die von einer bekleideten Vorlage ausgingen, wurde die Bitte um L3 oder L4 bei Stärke 0,8 bis 0,9 umgesetzt. Weitere 60 Läufe mit verschiedenen Seitenverhältnissen und einem Prompt auf L2-Niveau lieferten alle ein Ergebnis.
Drei praktische Punkte entscheiden, ob es zu Ihnen passt:
- Prompting. Tags im Danbooru-Stil, normale Sätze und Mischungen aus beidem funktionierten. Die Reihenfolge des Herausgebers lautet: Qualitäts- und Rating-Tags, Personenzahl (
1girl,1boy), Figur, Serie, Künstler, dann allgemeine Tags. Da es keinen Negativ-Prompt gibt, ist das Rating-Tag das wichtigste Mittel, den Ton zu setzen. Das Modell kenntsafe,sensitive,nsfwund ein stärkeres Tag; die letzten beiden heben die Zurückhaltung auf. Wir veröffentlichen hier nur Beispiele mitsafeundsensitive. - Tempo. In 60 gemessenen Läufen lag die Modellzeit bei 2 bis 16 Sekunden pro Bild, und 52 von 60 waren in unter 10 Sekunden fertig.
- Grenzen. Kein Fotorealismus, nur ein oder zwei Wörter gerenderter Text und gelegentlich eine signaturartige Kritzelei in einer Ecke (bei uns etwa jedes fünfte Bild; ein neuer Seed behebt das). Ohne Ablehnungen heißt nicht fehlerfrei: Anatomie und Hände brauchen weiterhin neue Seeds.
Hier ein Prompt, der als Ausgangspunkt funktioniert. Er beschreibt eine bekleidete Erwachsene:
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
long brown hair, white bathrobe slipping off one shoulder, standing by a large window at dawn,
holding a coffee cup, city skyline, soft light, calm smile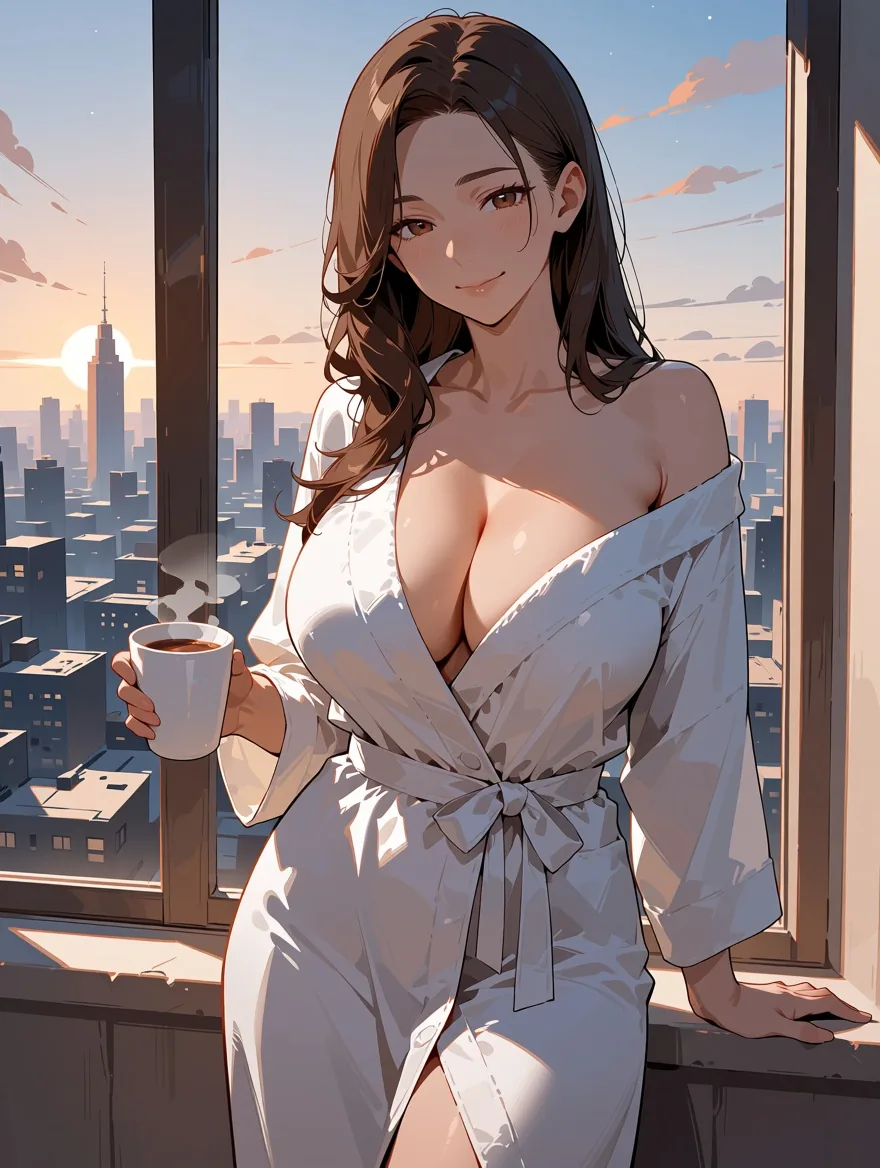
Anima Turbo Text-zu-Bild mit dem obigen Prompt, 3:4, Stufe 1k, Seed 23.
Anima kommt auch mit zwei Figuren in einem Bild zurecht, was für Paarszenen wichtig ist:
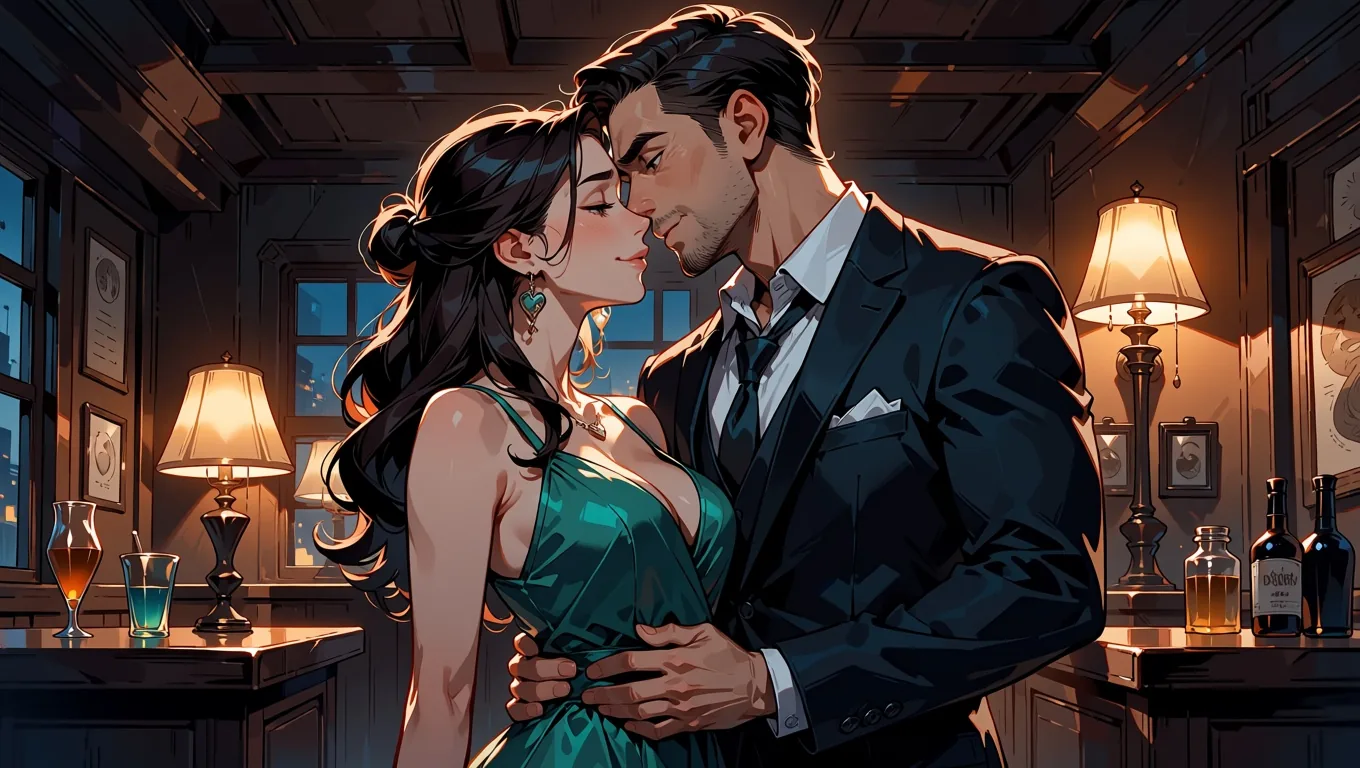
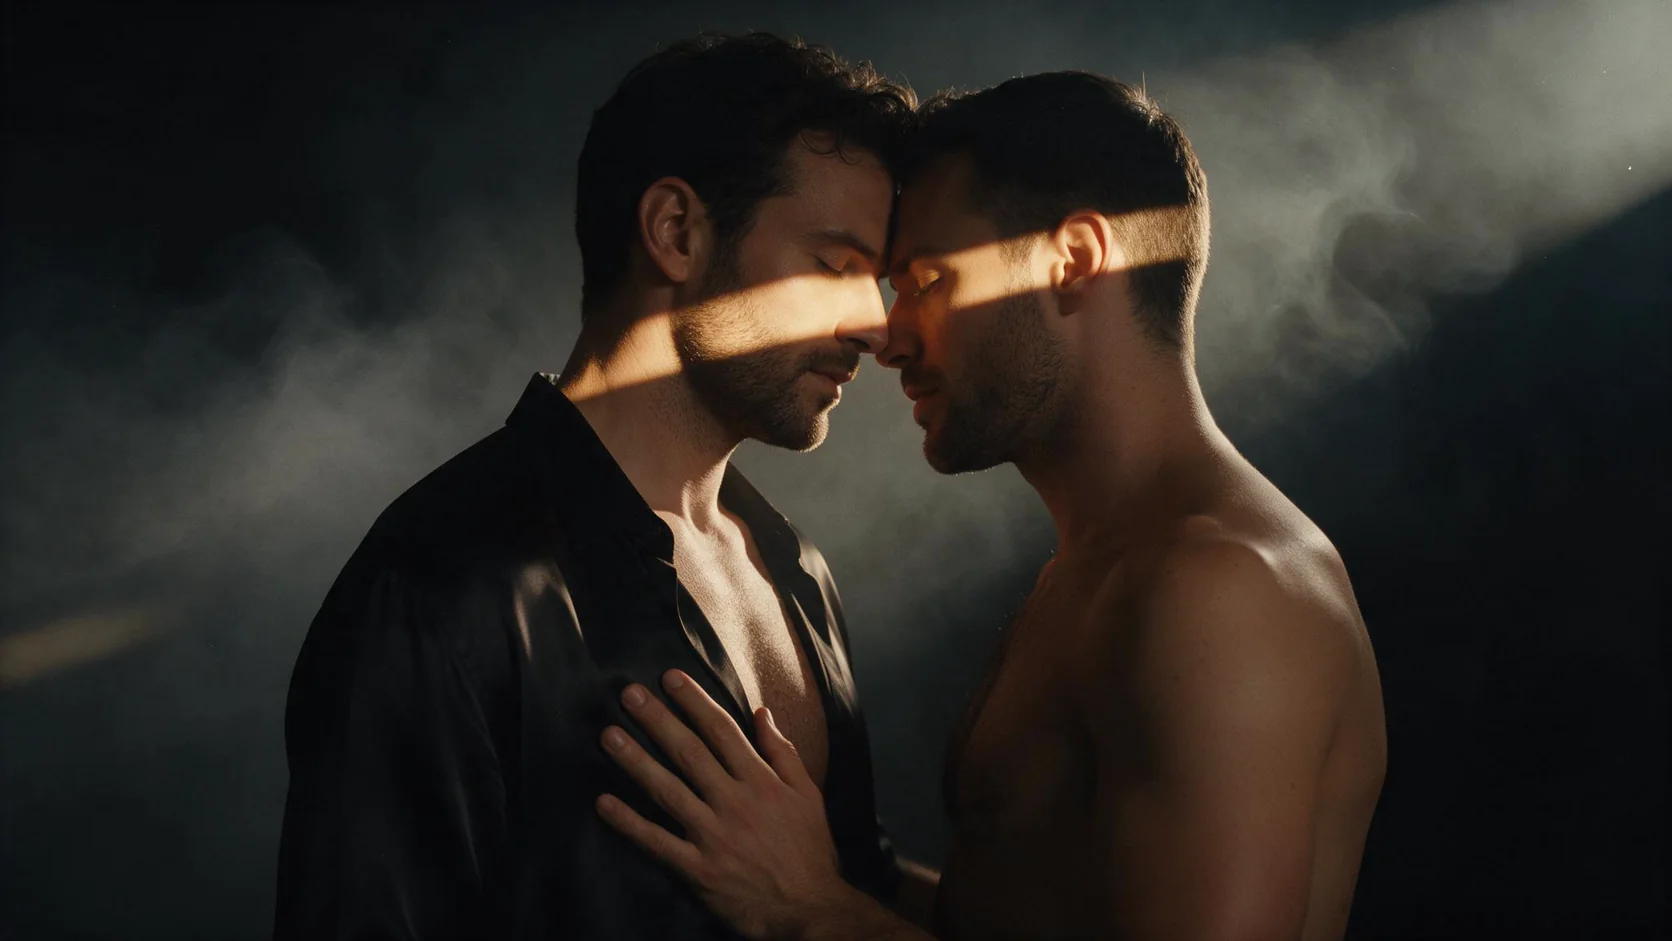
Anima Turbo Text-zu-Bild, 16:9, Stufe 1k, Seed 24, Rating-Tag sensitive.
Die vollständigen Ergebnisse zu Prompts, Stärke und Stil-Tags für dieses Modell finden Sie in unserem Testbericht zu Anima Turbo, der sie einzeln durchgeht. Sie können es über die Text-zu-Bild-Seite von Anima Turbo oder die Bild-zu-Bild-Seite ausführen.
Eine Figur über mehrere Szenen beibehalten
Wenn Sie eine Serie machen, wollen Sie an mehreren Orten dasselbe Gesicht. In einem Test haben wir die Beschreibung (silberner Bob, goldene Augen, ein Schönheitsfleck unter dem linken Auge) und den Seed festgehalten und nur Outfit und Ort geändert. Die Figur blieb in allen drei Bildern erkennbar.
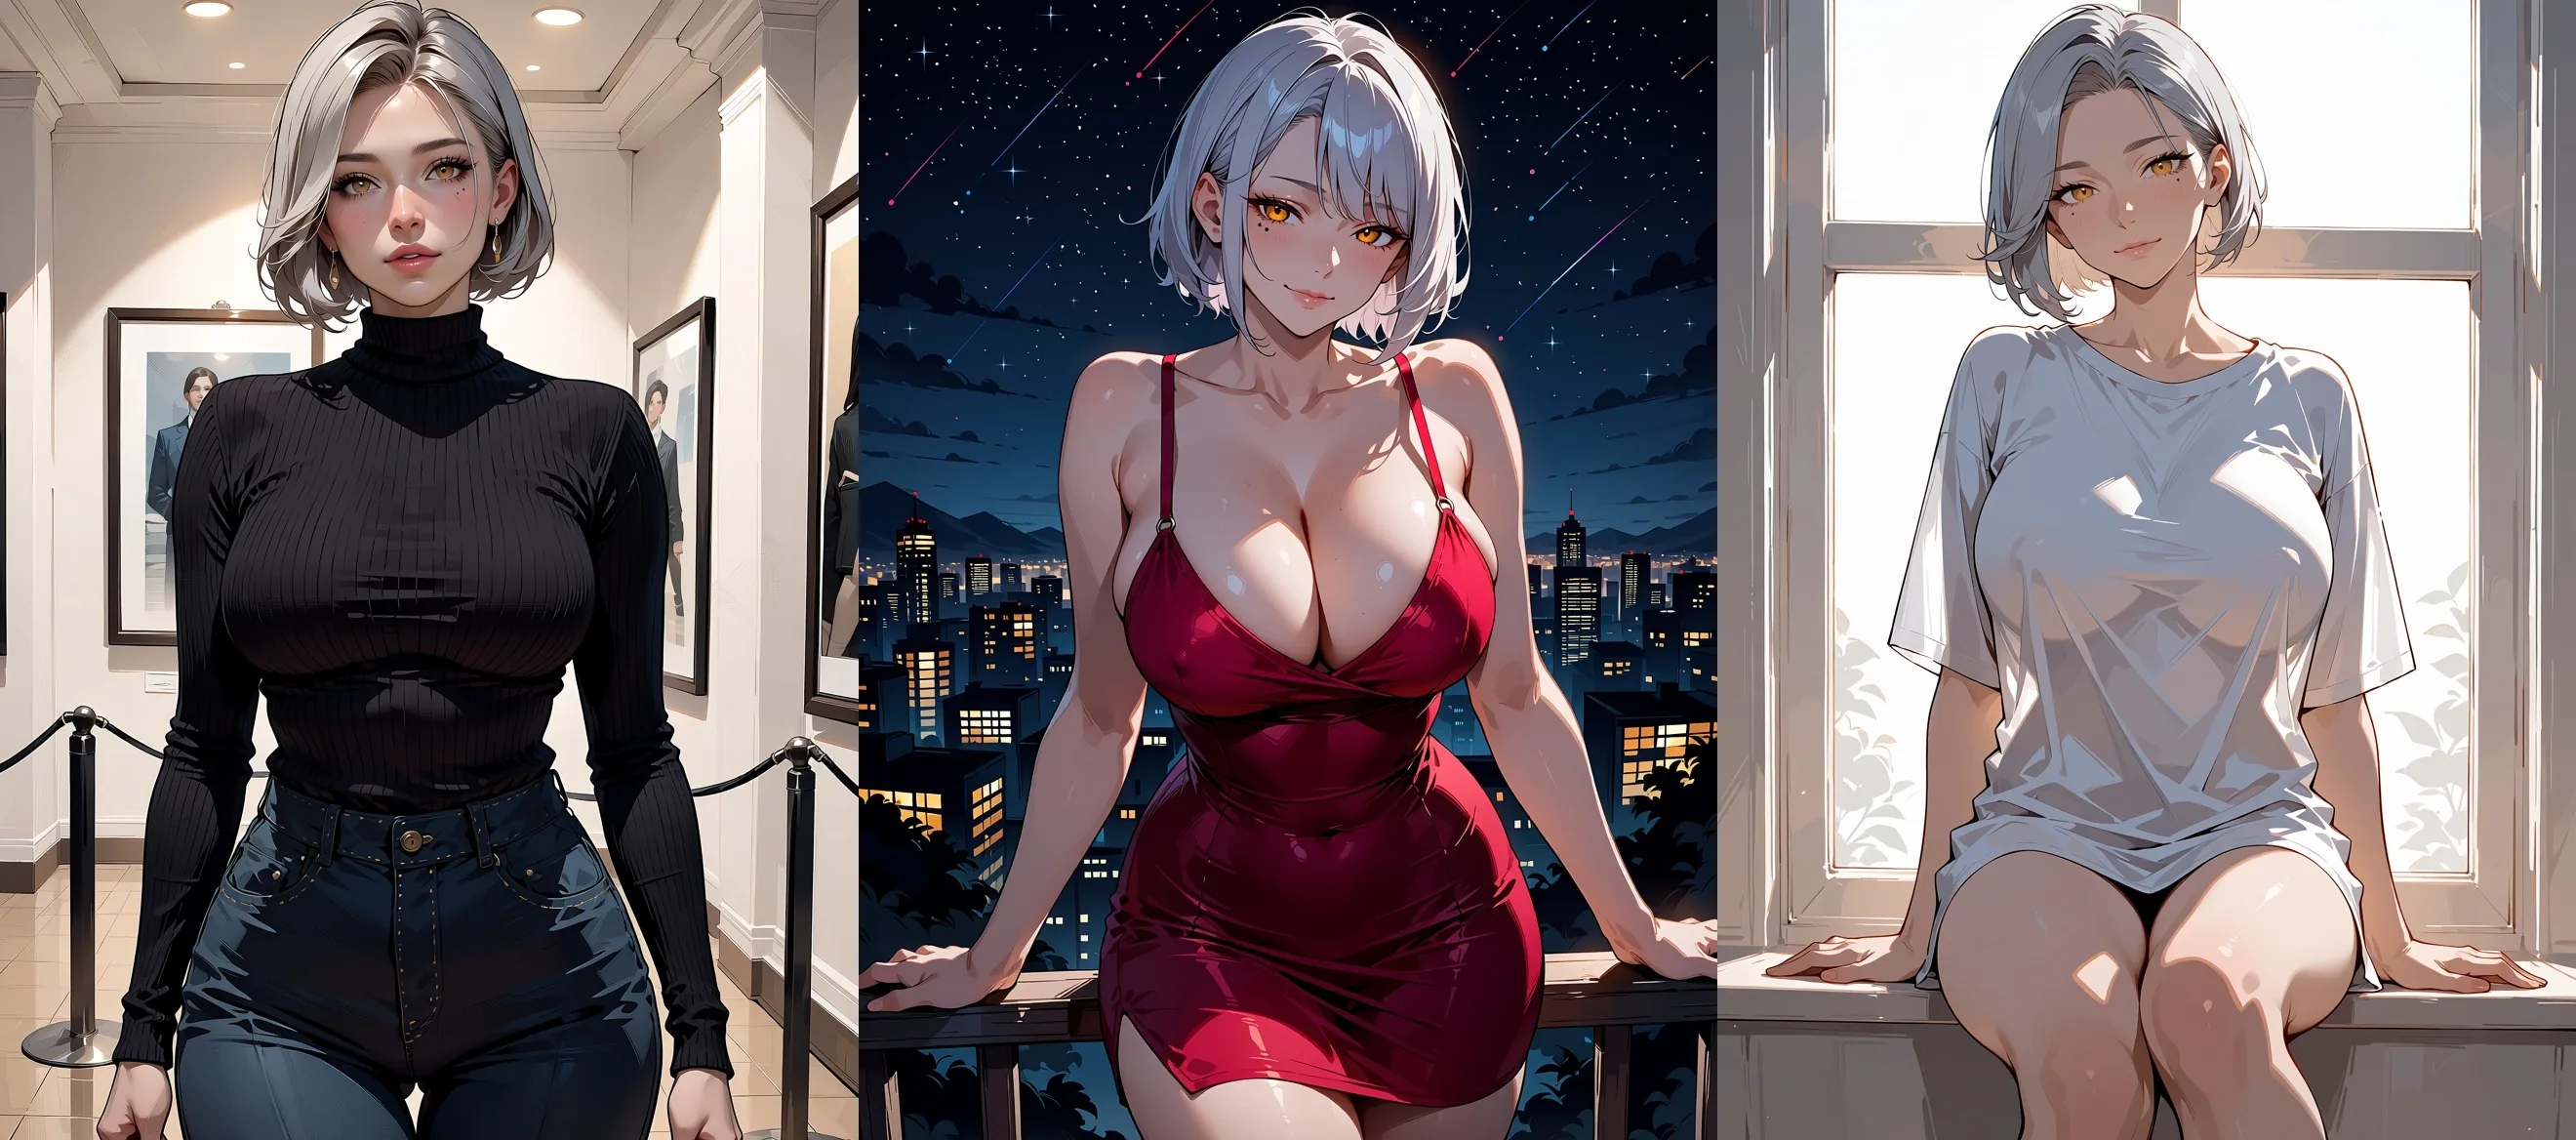
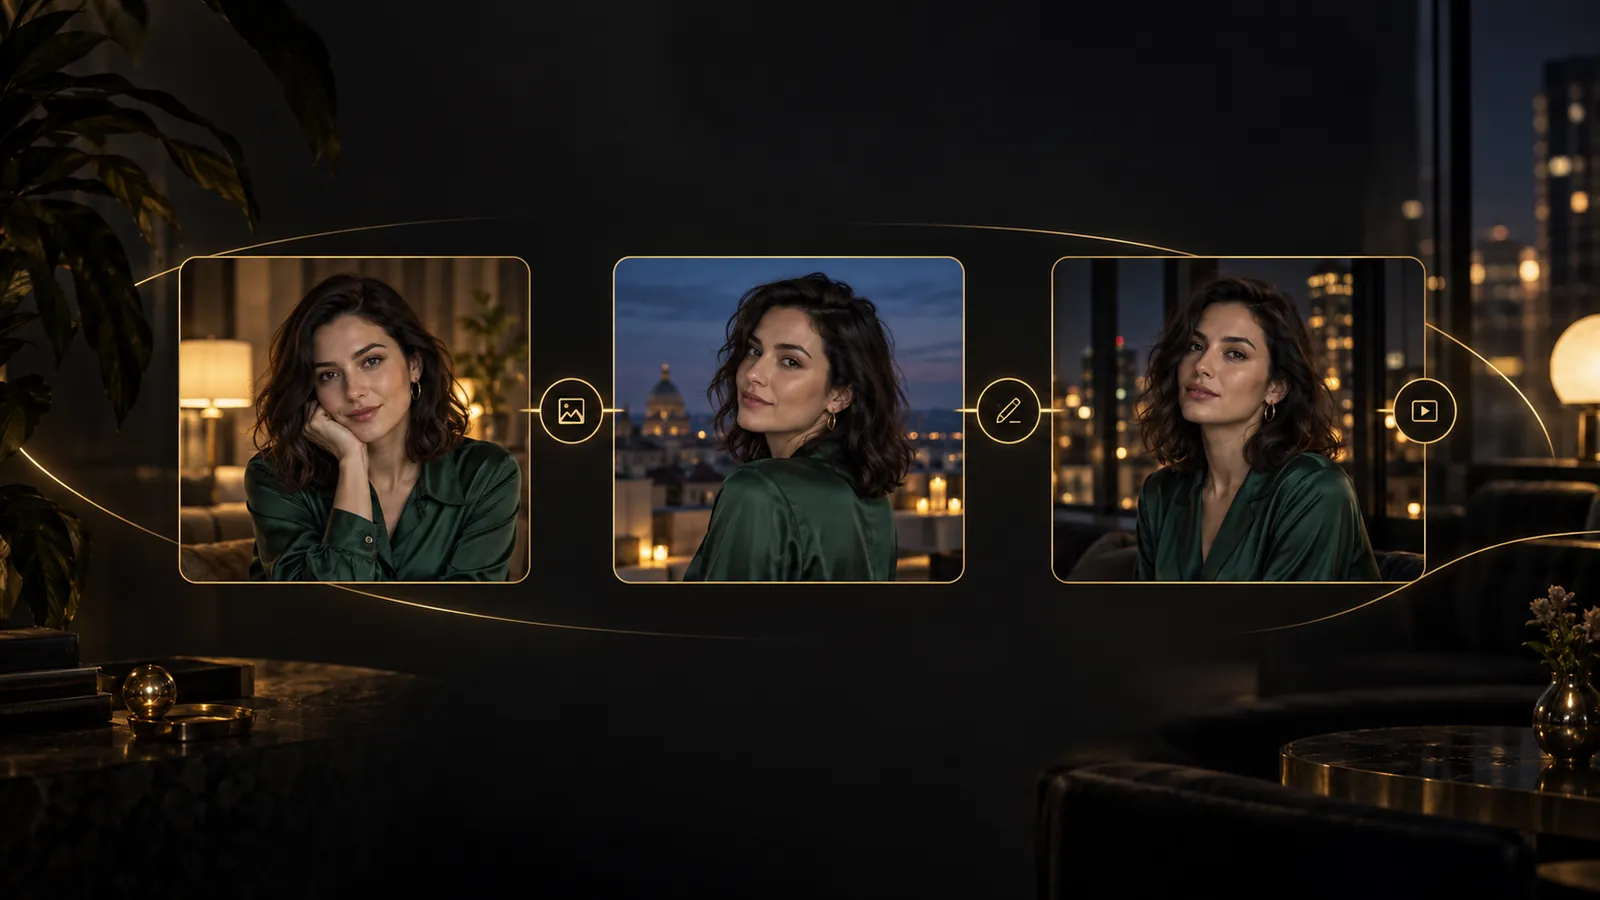
Anima Turbo Text-zu-Bild, 3:4, Stufe 1k, gleicher Seed (31) und gleiche Figurenbeschreibung in drei Outfits und an drei Orten. Ein Lauf pro Bild.
Seeds garantieren keine identischen Pixel; betrachten Sie dies also als eine Methode, die bei uns funktioniert hat.
Anima Turbo LoRA: eigene Stile und Figuren
Wählen Sie Anima Turbo LoRA, wenn Ihnen der Look wichtiger ist als der Standard-Look des Modells. Es ist dasselbe Modell mit bis zu drei LoRAs pro Anfrage, jeweils eingegeben als path (ein direkter HTTPS-Link auf eine .safetensors-Datei) und scale von 0 bis 4. Das Laden von LoRAs verursacht keine gesonderte Gebühr.
In unseren Inhaltstests entsprach es dem einfachen Modell: L3 und L4 wurden gerendert, mit und ohne LoRAs, und wir sahen keine Ablehnungen. Was sich ändert, ist die Kontrolle. Ein Look wie bei PC-98-Spielen stammte zum Beispiel aus einer öffentlichen LoRA von Melon-Bread:
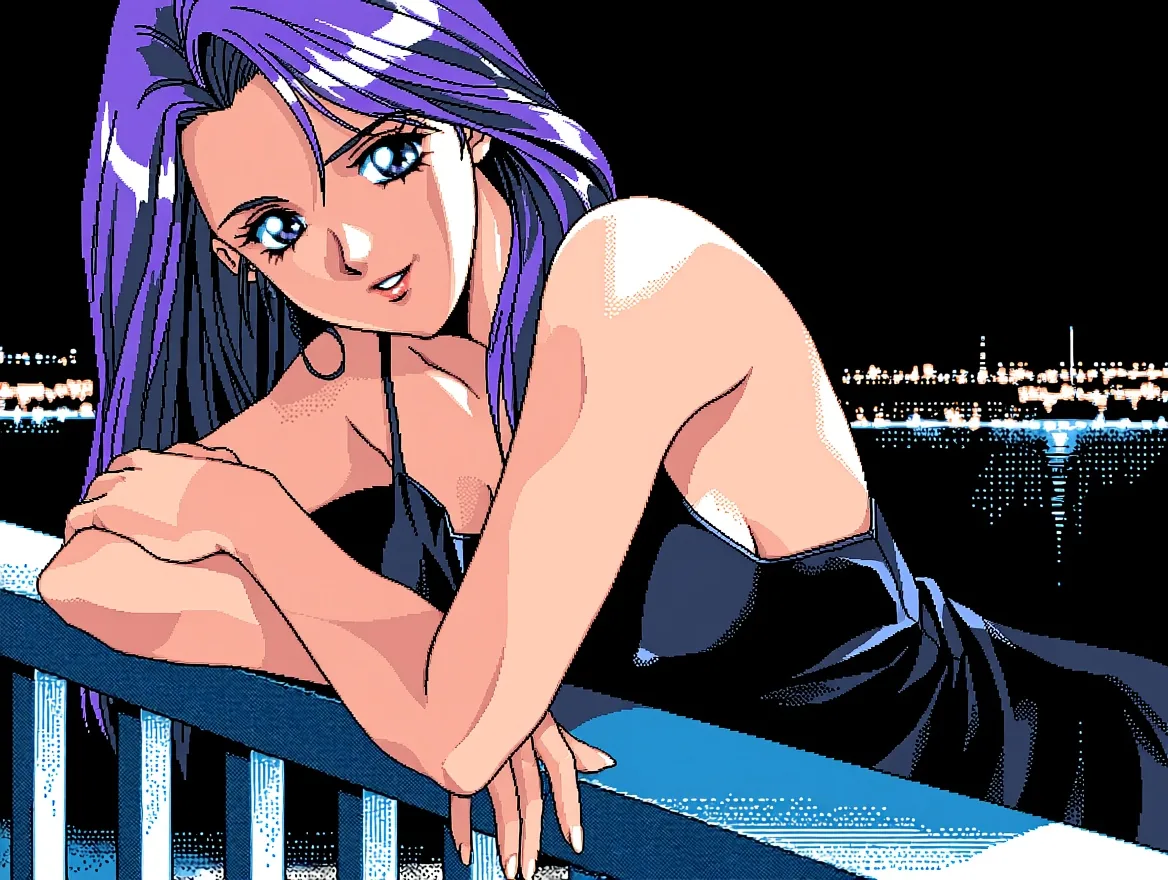
Anima Turbo LoRA Text-zu-Bild, 4:3, Stufe 1k, Seed 32, PC-98-LoRA mit Scale 1 und ihrem Triggerwort, Rating-Tag sensitive.
Eine monochrome Manga-LoRA brauchte monochrome, greyscale im Prompt, bevor sie die Farbe hinter sich ließ:
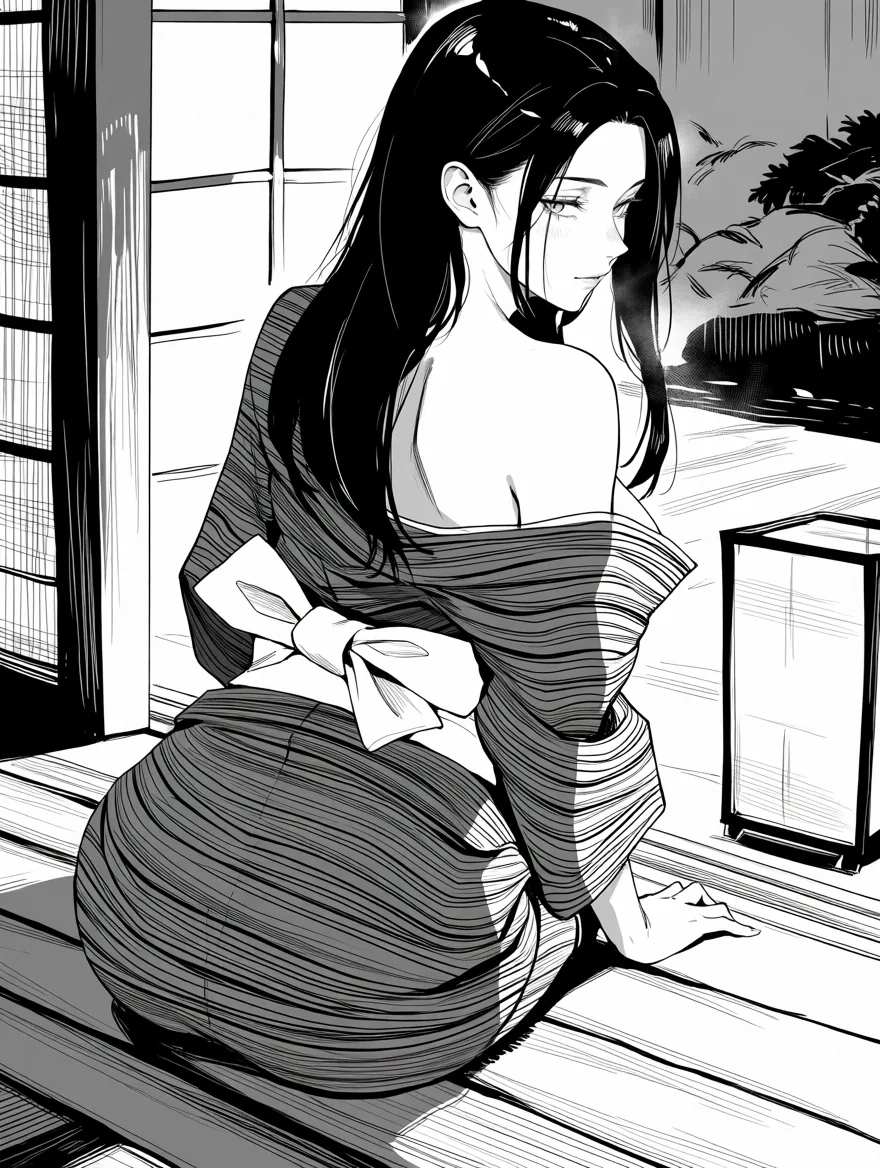
Anima Turbo LoRA Text-zu-Bild, 3:4, Stufe 1k, Seed 33, Monochrom-LoRA mit Scale 1, Rating-Tag sensitive.
Was Sie vor dem Start wissen sollten:
- Scale-Bereich. In unseren Läufen war 0,5 eine leichte Berührung, 1 der volle Stil, 1,5 drückte stärker, und 4 zerlegte das Bild in abstrakte Formen. Etwa 0,5 bis 1,2 ist der nützliche Bereich.
- Zur Basis passend wählen. Eine LoRA, die für ein anderes Basismodell trainiert wurde (wir haben eine für FLUX probiert), lud ohne Fehler und änderte nichts: Das Ergebnis war pixelgleich mit dem Lauf ohne LoRA. Nutzen Sie für Anima trainierte LoRAs. Auf Hugging Face waren am 5. Oktober 2026 129 davon gelistet.
- Link-Fehler werden nicht berechnet. Ein gesperrter Link, der eine Anmeldung verlangt, schlägt mit einer HTTP-401-Meldung fehl, und ein Link auf eine Repository-Seite statt auf die Datei führt zur Aufforderung, den direkten Download-Link anzugeben.
- Die erste Nutzung ist langsamer. Die erste Anfrage mit einer neuen LoRA kann länger dauern, während die Datei geholt wird; eine unserer Anfragen brauchte fast drei Minuten.
Unser LoRA-Stilguide behandelt Scale, Stapeln und Triggerwörter ausführlicher, und das Modell hat eine Text-zu-Bild-Seite und eine Bild-zu-Bild-Seite.
Prefect Pony XL: die tag-gesteuerte Pony-Linie
Wählen Sie Prefect Pony XL, wenn Ihre Prompts und Gewohnheiten aus dem Pony-XL-Ökosystem stammen. Es ist ein Community-Anime-Checkpoint dieser Linie, nur Text-zu-Bild, mit sieben nativen SDXL-Größen. In unserem internen Lauf am 18. September 2026 rendert es drei Teststufen bis L4.
Das war ein früherer, separater Test; wir vergleichen es daher inhaltlich nicht mit Anima. Den Unterschied spüren Sie im Workflow: Pony arbeitet nur mit Text, hat auf SpicyAPI kein Bild-zu-Bild und keinen LoRA-Slot, während Ihnen Anima Turbo Bild-zu-Bild und eine LoRA-Schwester bietet.
Fotorealistische Basen mit LoRAs: Z-Image Turbo LoRA, Qwen Image 2512 LoRA, FLUX.1 Dev LoRA
Wählen Sie eines davon nur, wenn Sie einen Grund haben, den Anime-nativen Weg zu verlassen. Typische Gründe: Sie wollen ein Modell, das sowohl fotorealistische als auch Anime-Ausgaben erzeugen kann, Sie besitzen schon eine für diese Basis trainierte LoRA, oder Sie brauchen Bearbeitung. Jedes nimmt Ihre LoRAs entgegen, und die Inhaltsergebnisse aus den Tests des Katalogs unterscheiden sich:
| Modell | Was es ist | Inhaltstests |
|---|---|---|
| Z-Image Turbo LoRA | Alibaba Z-Image Turbo mit Ihren LoRAs; standardmäßig fotorealistisch, Anime mit einer Anime-LoRA | L3 und L4 gerendert (Text-zu-Bild) |
| Qwen Image 2512 LoRA | Qwen-Image-2512 mit Ihren LoRAs, plus Bearbeitung | L3 und L4 gerendert |
| FLUX.1 Dev LoRA | FLUX.1 [dev] mit Ihren LoRAs | L3 gerendert; L4 in unseren Tests abgeschwächt |
„Abgeschwächt" bedeutet, dass die Anfrage abgeschlossen wurde, das Bild aber nicht dem entsprach, was auf dieser Stufe verlangt war. Wenn Ihr Projekt von der intensivsten Stufe abhängt, ist diese Zeile der Grund, warum FLUX.1 Dev LoRA in der Tabelle oben die letzte und nicht die erste Wahl ist.
Zwei weitere unzensierte Bildmodelle, MiniMax H3 Image LoRA (L4 gerendert) und Z-Image Spicy (fotorealistisch, unzensierte Stufe), sind keine Anime-Empfehlungen.
Sobald Sie ein Standbild haben, das Ihnen gefällt, können Sie es animieren. Seedance 2.5 Spicy, Wan 2.2 Spicy und MiniMax H3 Spicy sind unzensierte Bild-zu-Video-Familien: Sie nehmen ein Bild plus einen Prompt entgegen und liefern ein kurzes Video.
Allzweckmodelle, die ablehnen: FLUX 3 und Ideogram v4.5
Wenn Sie FLUX 3 oder Ideogram v4.5 für NSFW-Anime-Arbeit erwägen, lassen Sie sie aus: Beide lehnten fast alles ab, was über ein neutrales Badebekleidungsfoto hinausging. Wir haben beide am 5. Oktober 2026 über eine gehostete API eines Drittanbieters getestet, auf derselben Leiter in der Stufe 1k.
| Modell | Geliefert | Abgelehnt |
|---|---|---|
| FLUX 3 Text-zu-Bild (Black Forest Labs) | Eine Bikini-Strandszene; ein neutrales Dessous-Katalogfoto | Dessous mit kokettem Wortlaut (L1), L2, L3, L4, eine klassische Aktstudie als Gemälde, ein männlicher Akt und ein verklausulierter Prompt ohne markierte Wörter (10 von 12 Anfragen) |
| Ideogram v4.5 (Ideogram) | Dieselben beiden | Dieselbe Auswahl; ob die Prompt-Erweiterung an oder aus war, machte keinen Unterschied (11 von 13 Anfragen) |
Die Ablehnungen kamen nach etwa zwei Sekunden zurück, bevor ein Bild entstand, mit der Meldung „Content flagged as potentially sensitive. Please try different prompts or images." Abgelehnte Anfragen wurden nicht berechnet. Weil auch der verklausulierte Prompt abgelehnt wurde, verhält sich der Filter semantisch und nicht wie eine Stichwortliste. Ob dieser Filter zu den APIs der Modellhersteller oder zum von uns genutzten Host gehört, können wir nicht sagen; lesen Sie dies also als „auf diesem Zugangsweg abgelehnt" und nicht als Urteil über die Modelle in jeder Konfiguration.
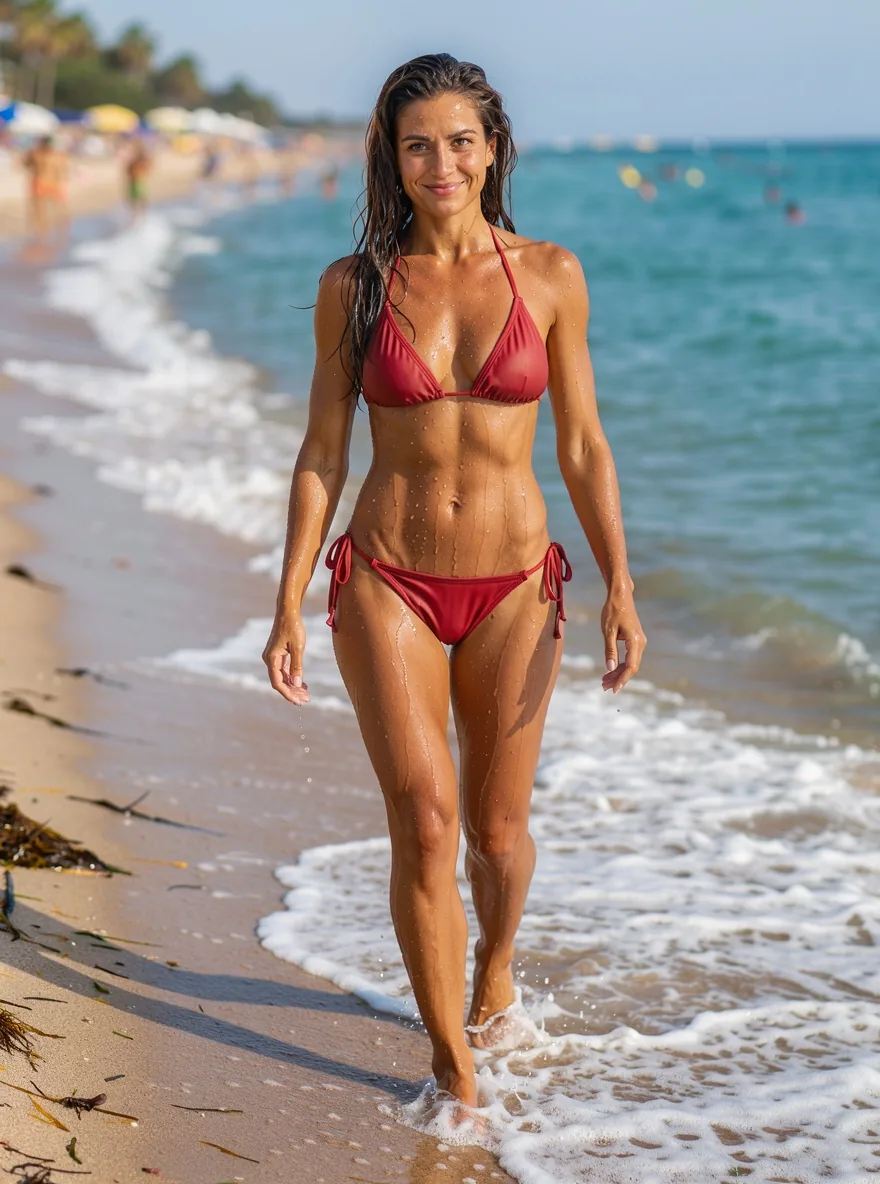
FLUX 3 Text-zu-Bild, Stufe 1k. Dieses Bikini-Strandfoto war eine der beiden Anfragen, die geliefert wurden.
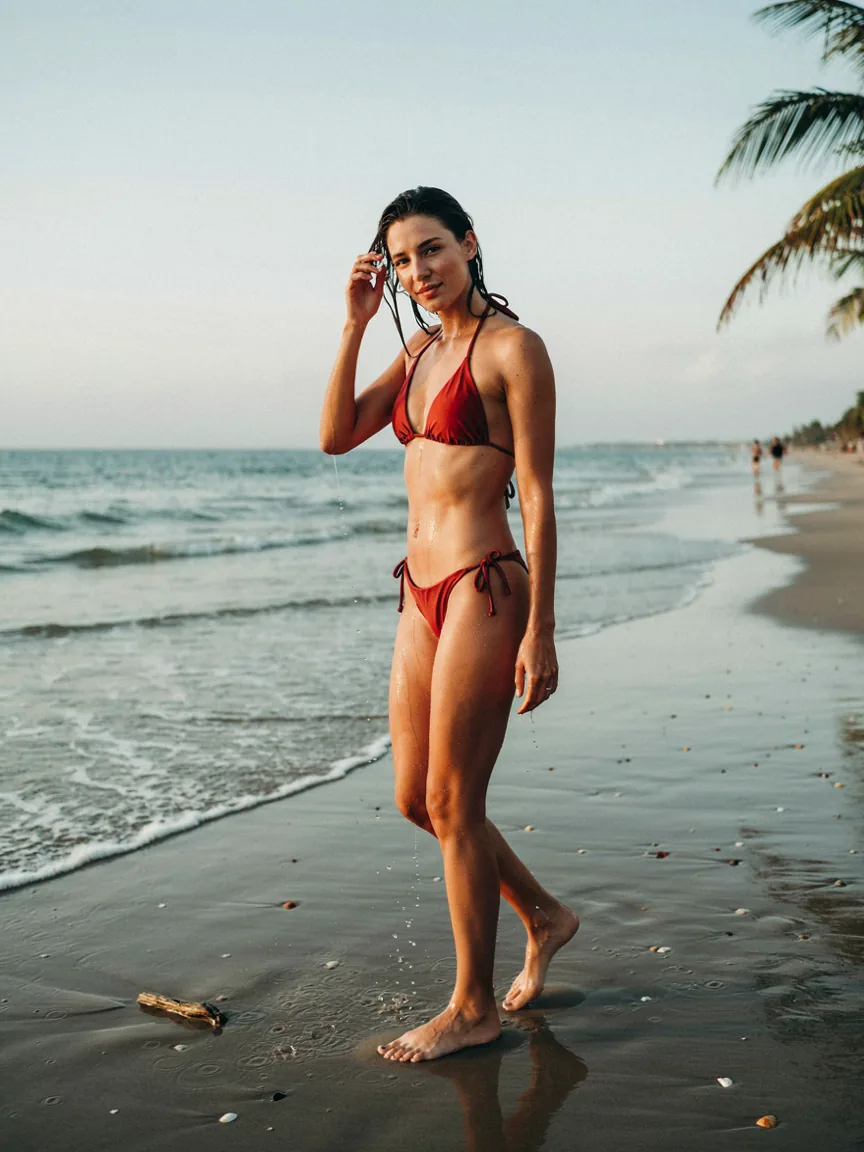
Ideogram v4.5, Stufe 1k. Dieselbe Art von Bikini-Strandszene, eine der beiden Anfragen, die geliefert wurden.
Beide Modelle lieferten außerdem Fotografien und keinen Anime; selbst eine freizügige Einstellung hätte also die „Anime"-Hälfte Ihrer Aufgabe nicht abgedeckt. Für einen breiteren Vergleich über Bildmodelle hinweg lesen Sie unsere Übersicht zu NSFW-Bildgeneratoren.
Wie wir getestet haben und was die Tests nicht aussagen
Betrachten Sie jede Zahl hier als kleine, datierte Stichprobe. Die Anima-Ergebnisse sind 25 Inhaltsanfragen plus 60 Läufe mit verschiedenen Seitenverhältnissen am 5. Oktober 2026, meist ein oder zwei Seeds pro Fall. Die Ergebnisse von FLUX 3 und Ideogram v4.5 sind 13 bzw. 14 Anfragen am selben Tag über einen einzigen Drittanbieter-Zugang. Das Ergebnis von Prefect Pony XL stammt aus einem internen Lauf am 18. September 2026. Die übrigen Zeilen stammen aus den Inhaltstests des Katalogs und werden so wiedergegeben, wie sie dort stehen.
Was die Tests nicht zeigen:
- Sie ordnen die Bildqualität nicht ein. Wir haben weder Gesichter, Hände, Komposition noch Stil modellübergreifend bewertet und behaupten nicht, dass Anima besser aussieht als ein anderes Modell hier.
- Sie garantieren nicht dasselbe Ergebnis beim nächsten Mal. Anbieter ändern Filter, und dieselbe Anfrage mit demselben Seed lieferte uns zu verschiedenen Zeitpunkten leicht unterschiedliche Ergebnisse.
- Das Rating-Tag verschiebt den Ton bei einer bekleideten Beschreibung weniger, als man erwartet: Mit demselben Lounge-Prompt und Seed lieferten
safeundsensitivefast dasselbe Bild.
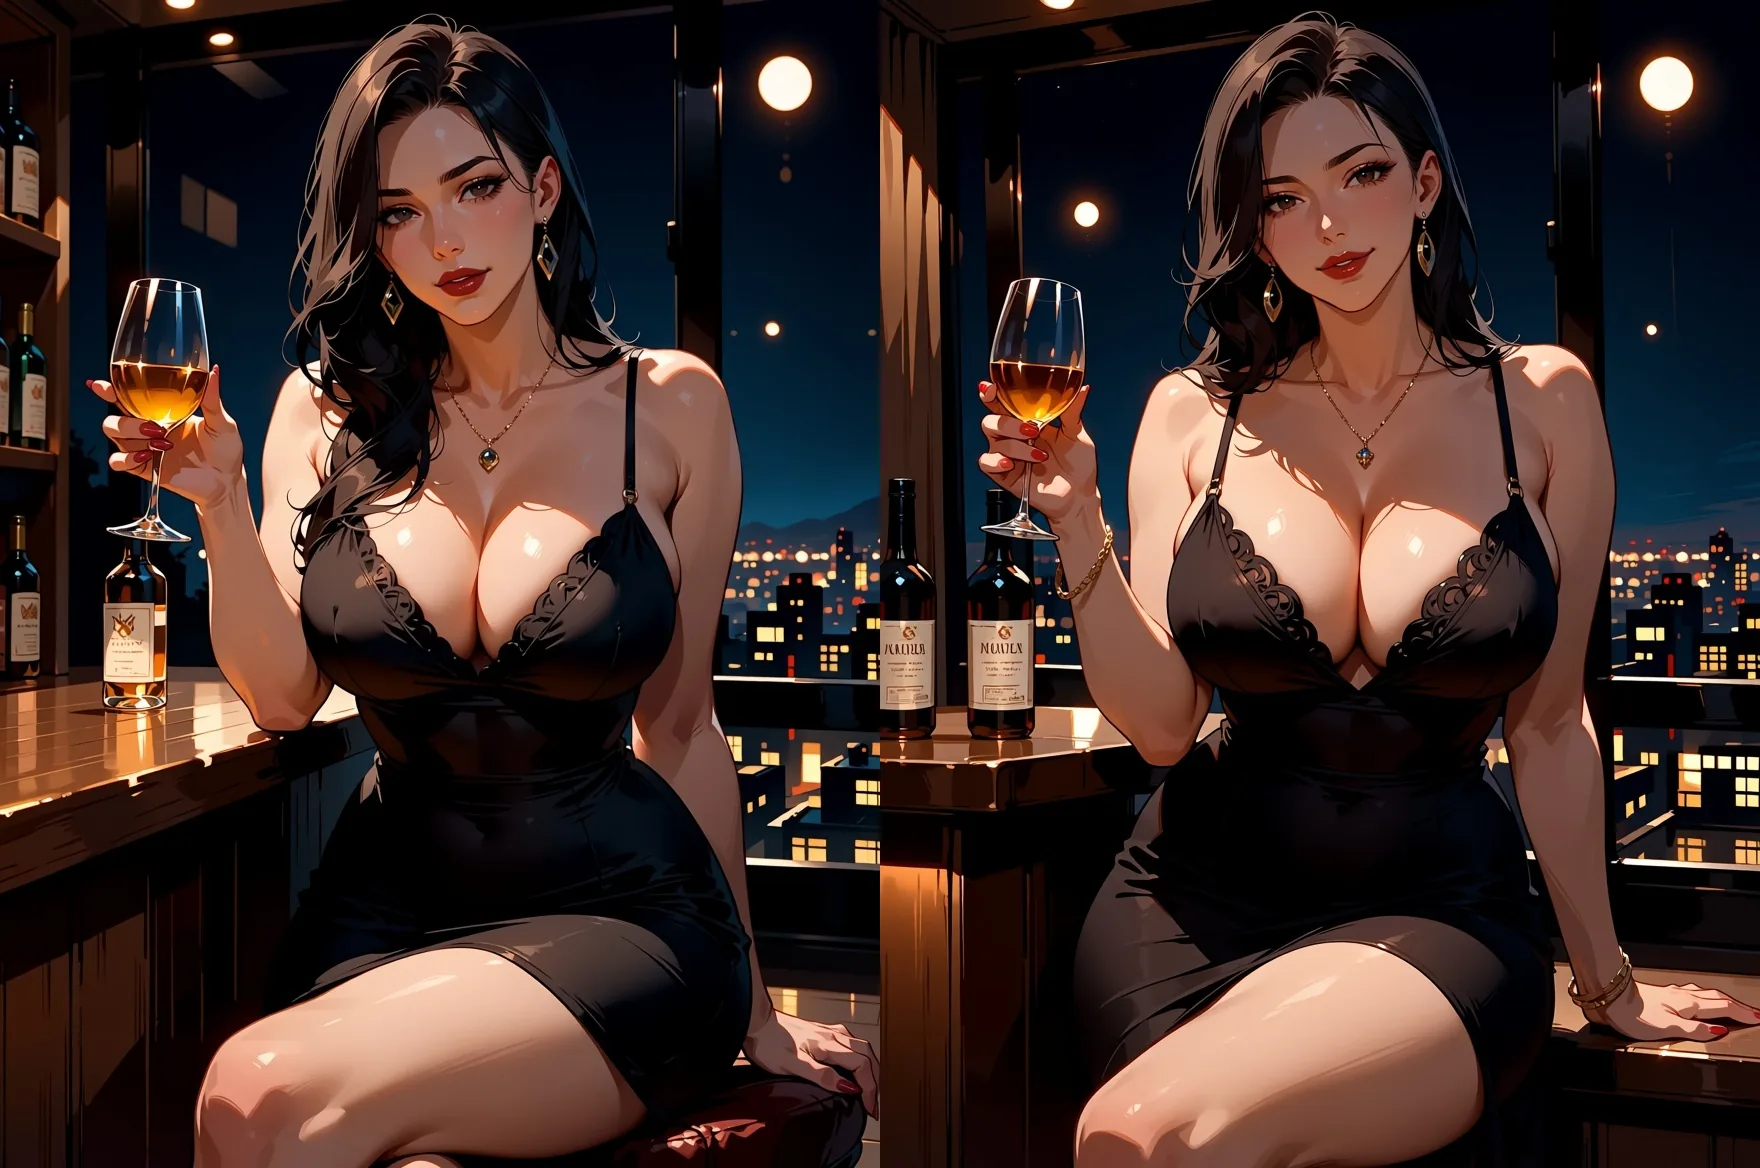
Anima Turbo Text-zu-Bild, 3:4, Stufe 1k, Seed 27. Links: safe. Rechts: sensitive. Sonst derselbe Prompt.
So wählen Sie mit drei Fragen
- Haben Sie eine LoRA oder brauchen Sie einen bestimmten Stil? Wenn ja, nutzen Sie Anima Turbo LoRA oder eine LoRA-fähige Basis, die zu der LoRA passt, die Sie besitzen (eine LoRA für eine andere Basis bewirkt nichts). Wenn nein, beginnen Sie mit Anima Turbo.
- Schreiben Sie Prompts als Tags im Pony-Stil und wollen genau dieses Ökosystem? Dann probieren Sie Prefect Pony XL. Wenn Sie Bild-zu-Bild aus einem Foto oder einer Zeichnung wollen, bietet das Anima Turbo.
- Brauchen Sie überhaupt fotorealistische Ausgaben? Wenn ja, nutzen Sie eine Basis mit Fotorealismus als Standard, etwa Z-Image Turbo LoRA, und prüfen Sie zuerst deren Inhaltszeile. Wenn Sie nur Anime wollen, bleiben Sie bei den Anime-nativen Modellen.
Wenn Sie ein Foto in Anime verwandeln wollen, zeigt unser Stärke-Guide, was jeder Stärkewert bewirkt.
Nutzen Sie diese Modelle verantwortungsvoll
Erstellen Sie nur erwachsene Figuren und sagen Sie das im Prompt. Erzeugen Sie keine echten Personen oder Abbilder echter Personen ohne deren Einwilligung. Behalten Sie Ihre eigenen Ergebnisse für sich, solange Sie nicht sicher sind, wo Sie sie veröffentlichen dürfen. Sie sind verantwortlich für das, was Sie erzeugen, speichern und teilen, und dafür, die für Sie geltenden Gesetze einzuhalten.
FAQ
Welches KI-Modell ist am besten für NSFW-Anime-Art?
Für Anime-Art allein aus Prompts passte Anima Turbo in unseren Tests am besten: Unsere stärkste Inhaltsprobe wurde gleich beim ersten Versuch wie geschrieben gerendert, ohne Ablehnung bei 25 Anfragen. Prefect Pony XL eignet sich für Prompts aus Tags im Pony-Stil, und Anima Turbo LoRA für eigene Stile. „Am besten" ändert sich mit der Aufgabe; nutzen Sie daher die Schnellauswahl-Tabelle oben.
Können FLUX 3 oder Ideogram v4.5 NSFW-Anime erzeugen?
In unseren Tests nicht. FLUX 3 lehnte 10 von 12 Anfragen ab und Ideogram v4.5 11 von 13, darunter Dessous mit kokettem Wortlaut. Beide lieferten nur eine neutrale Bikini-Strandszene und ein Dessous-Katalogfoto. Der Filter könnte zum Host und nicht zu den Herstellern gehören, was wir nicht prüfen konnten.
Brauche ich eine LoRA für NSFW-Anime-Art?
Nein. Anima Turbo rendert unsere getesteten Stufen ohne jede LoRA. Eine LoRA hilft, wenn Sie einen bestimmten Stil oder eine wiederkehrende Figur wollen. Nutzen Sie eine für Anima trainierte: Eine LoRA für eine andere Basis lud in unserem Test ohne Fehler und änderte nichts.
Sind die Modelle wirklich unzensiert, oder schwächen sie Bilder stillschweigend ab?
Bei Anima sahen wir bei 25 Inhaltsanfragen keine Ablehnung und keine Ersetzung. Abschwächung gibt es anderswo durchaus: FLUX.1 Dev LoRA schwächte in unseren Tests die intensive Stufe ab. Außerdem kann sich das Modell von Seed zu Seed unterschiedlich verhalten; prüfen Sie daher jedes Ergebnis.
Was ist der Unterschied zwischen den Rating-Tags safe und sensitive?
Bei einer bekleideten Beschreibung lieferten sie in unserem Test fast dasselbe Bild; das Tag ist also eher ein Hinweis auf den Ton als ein Schalter. Laut Herausgeber heben nsfw und ein stärkeres Tag die Zurückhaltung auf. Da es keinen Negativ-Prompt gibt, ist das Rating-Tag das wichtigste Mittel, den Ton zu setzen.
Kann ich mein eigenes Foto in Anime verwandeln?
Ja, mit Bild-zu-Bild von Anima Turbo. In unseren Tests wirkte ein Foto bei Stärke 0,3 noch wie ein Foto, bei 0,6 wie eine Illustration und bei 0,75 wie sauberer Anime. Ab 0,9 beginnen sich Details zu verändern, und bei 1,0 wird die Vorlage ignoriert. Es gestaltet um; es folgt keinen Bearbeitungsanweisungen.
Kann ich die Bilder animieren?
Ja. Seedance 2.5 Spicy, Wan 2.2 Spicy und MiniMax H3 Spicy nehmen ein Bild plus einen Prompt entgegen und liefern ein kurzes Video.