Pour de l’art d’anime NSFW à partir d’un simple prompt, Anima Turbo était le meilleur choix dans nos tests : il a rendu notre sonde de contenu la plus forte telle qu’écrite dès le premier essai, il est conçu pour l’anime et ne demande aucun fichier supplémentaire. Ajoutez Anima Turbo LoRA pour votre propre style ou personnage, Prefect Pony XL si vous travaillez avec des tags de type Pony, et une base photoréaliste seulement si vous comptez la piloter avec un LoRA d’anime. Les modèles généralistes comme FLUX 3 et Ideogram v4.5 ont refusé presque tout ce qui dépasse une photo de bikini neutre.
Le « meilleur » dépend de l’usage ; ceci est donc un guide de décision plutôt qu’un classement. Chaque affirmation ci-dessous vient de nos propres exécutions du 5 octobre 2026 ou des tests de contenu du catalogue SpicyAPI, et chaque section dit la taille réduite de l’échantillon. Nous ne classons pas la qualité d’image au-delà de ce que nous avons vu.
En un coup d’œil : quel modèle pour quel usage
| Votre usage | Choix | Pourquoi, d’après nos tests | Page |
|---|---|---|---|
| Art d’anime à partir de texte, sans fichiers supplémentaires | Anima Turbo | Modèle d’anime et d’illustration ; la plupart des niveaux testés (scènes intenses comprises) rendus tels qu’écrits | Anima Turbo |
| Votre propre style graphique ou un personnage récurrent | Anima Turbo LoRA | Le même modèle avec jusqu’à 3 LoRA de votre choix | Anima Turbo LoRA |
| Prompts à tags Danbooru ou de type Pony | Prefect Pony XL | Checkpoint d’anime communautaire de la lignée Pony XL, texte vers image uniquement | Prefect Pony XL |
| Base photoréaliste qui peut aussi passer à l’anime | Z-Image Turbo LoRA | Photoréaliste par défaut ; anime avec un LoRA d’anime ; scènes intenses rendues | Z-Image Turbo LoRA |
| Un LoRA d’anime sur une autre base, plus la retouche | Qwen Image 2512 LoRA | Accepte les LoRA et fait de la retouche ; scènes intenses rendues | Qwen Image 2512 LoRA |
| Vous possédez déjà un LoRA FLUX.1 Dev | FLUX.1 Dev LoRA | Accepte vos LoRA ; le niveau le plus fort a été atténué dans nos tests | FLUX.1 Dev LoRA |
| Travail sans restriction sur FLUX 3 ou Ideogram v4.5 | Aucun des deux | Ils ont refusé 10 requêtes sur 12 et 11 sur 13 | voir plus bas |
Comment nous décrivons les niveaux de contenu
Nous utilisons une échelle en cinq niveaux. L1 est suggestif (lingerie, une bretelle qui glisse de l’épaule). L2 est partiel, plus osé. L3 est le contenu très osé. L4 est une scène intense entre deux adultes. L5 est extrême : contrainte consentie entre adultes, ou gore cinématographique. Nous n’avons pas lancé L5 sur Anima. Rien dans cet article n’imprime de prompt au-dessus de L1, et chaque personnage est adulte. La plateforme elle-même n’ajoute aucun filtre de contenu sur ces points d’accès ; ce qui compte, c’est donc ce que chaque modèle fait de la requête.
Anima Turbo : le meilleur choix pour l’anime par prompt seul dans nos tests
Choisissez Anima Turbo si vous voulez une sortie d’anime ou d’illustration à partir d’un prompt, et rien d’autre. C’est la version distillée d’Anima, de CircleStone Labs, un modèle de 2 milliards de paramètres bâti sur NVIDIA Cosmos-Predict2 avec un encodeur de texte Qwen3. L’éditeur recommande de commencer par la version Turbo, qui selon lui n’est qu’un peu moins bonne que la version Aesthetic en moyenne tout en étant bien plus rapide.
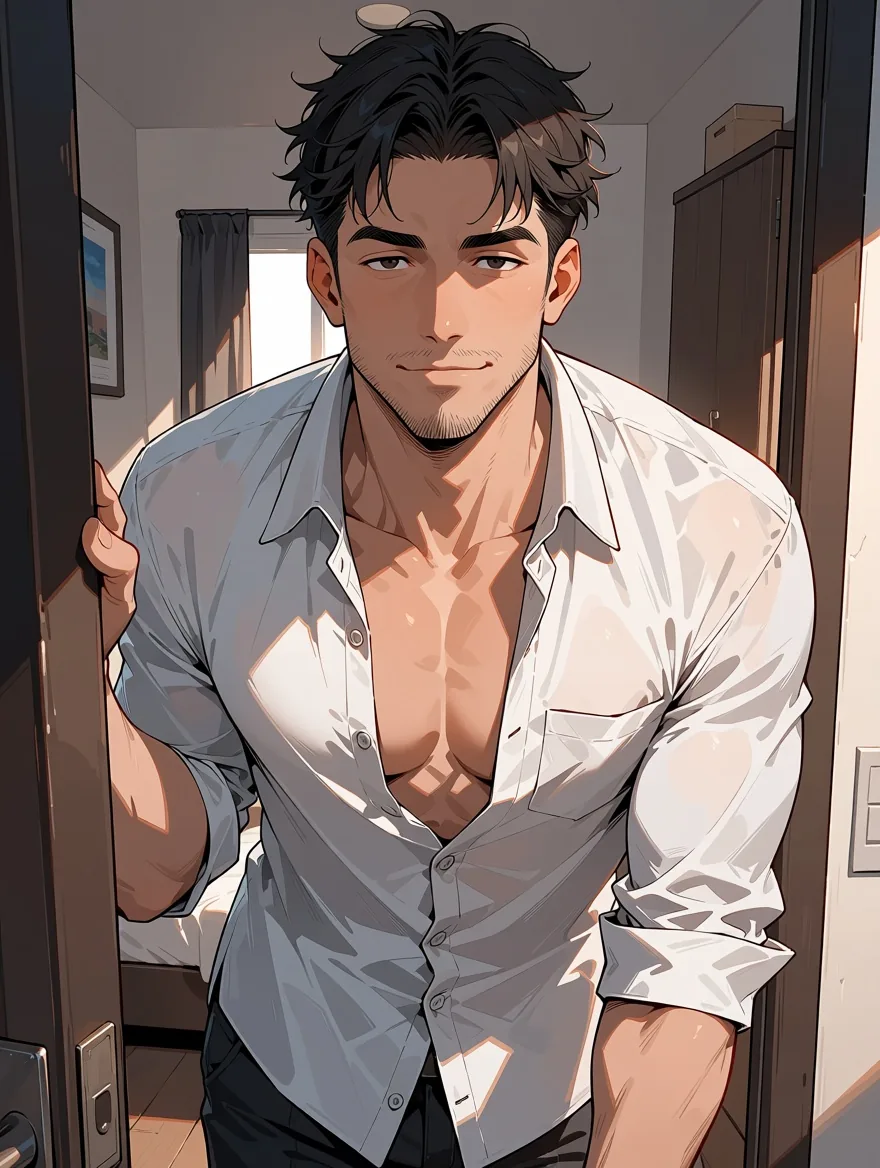
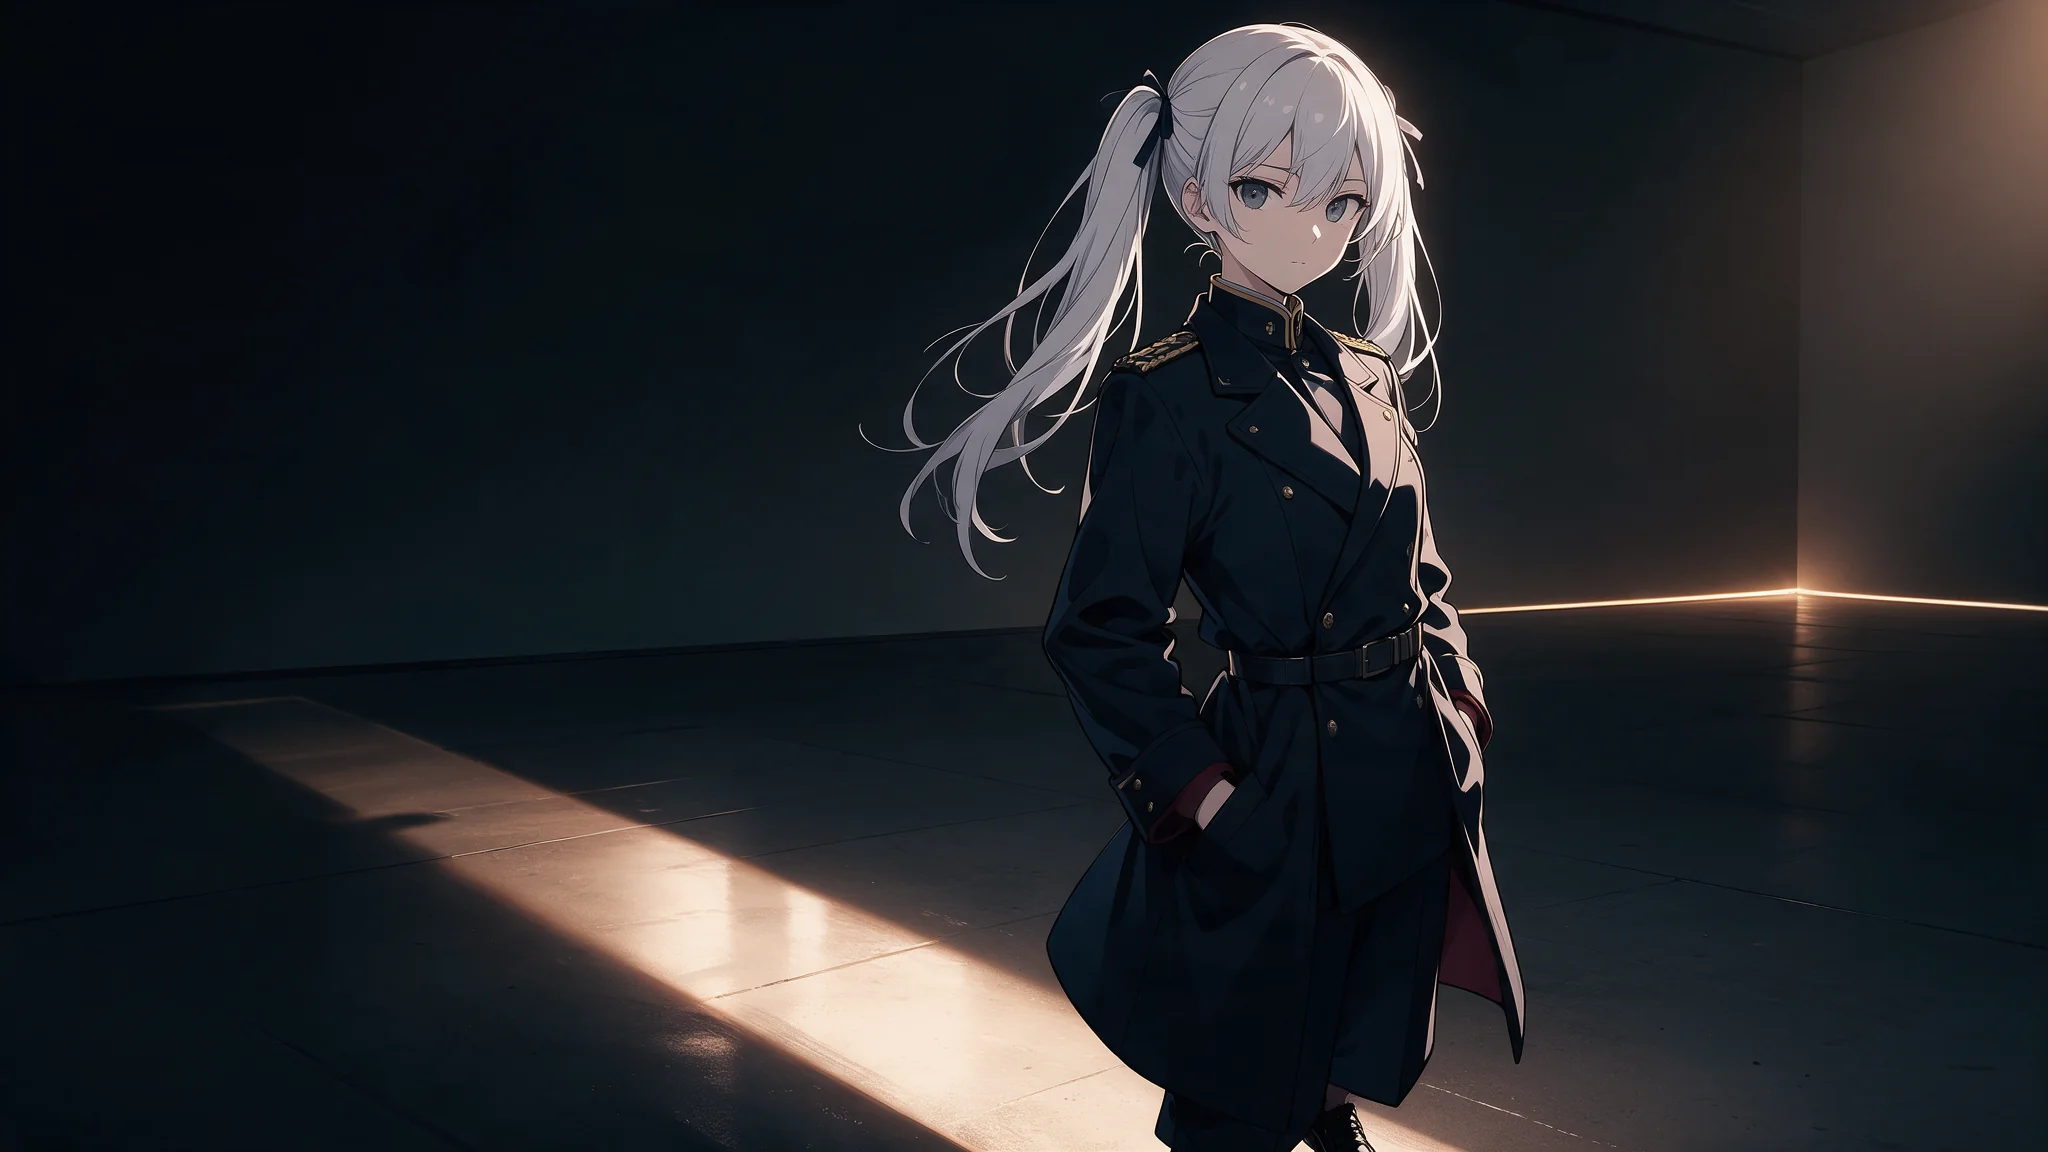
Anima Turbo texte vers image, 3:4, palier 1k, seed 22, tag de classification sensitive. Le prompt décrivait un homme adulte habillé dans l’encadrement d’une porte.
Ce que nous avons testé : 25 requêtes sur L1, L2, L3 et L4, texte vers image et image vers image, avec et sans LoRA, des sujets féminins et masculins, deux seeds pour L3 et L4, et les deux paliers 1k et 1.5k. Nous avons constaté zéro refus et zéro substitution. L4 a été rendu tel qu’écrit dès le premier essai. Dans les exécutions en image vers image partant d’une source habillée, demander L3 ou L4 avec une force de 0,8 à 0,9 a été suivi. 60 exécutions de formats d’image supplémentaires avec un prompt de niveau L2 ont toutes abouti.
Trois points pratiques décident s’il vous convient :
- Rédaction des prompts. Les tags de style Danbooru, les phrases simples et les mélanges des deux ont fonctionné. L’ordre de l’éditeur est : tags de qualité et de classification, nombre de personnages (
1girl,1boy), personnage, série, artiste, puis tags généraux. Comme il n’y a pas de prompt négatif, le tag de classification est le principal moyen de régler le ton. Le modèle connaîtsafe,sensitive,nsfwet un tag plus fort ; les deux derniers lèvent la retenue. Nous ne publions ici que des exemplessafeetsensitive. - Vitesse. Sur 60 exécutions chronométrées, le temps du modèle était de 2 à 16 secondes par image et 52 sur 60 ont fini en moins de 10 secondes.
- Limites. Pas de photoréalisme, seulement un mot ou deux de texte rendu, et un gribouillis occasionnel qui ressemble à une signature dans un coin (environ une image sur cinq chez nous ; un nouveau seed règle le problème). Sans refus ne veut pas dire sans défaut : l’anatomie et les mains demandent encore de relancer le seed.
Voici un prompt qui sert de point de départ. Il décrit une adulte habillée :
masterpiece, best quality, score_7, sensitive, 1girl, solo, adult woman, mature female,
long brown hair, white bathrobe slipping off one shoulder, standing by a large window at dawn,
holding a coffee cup, city skyline, soft light, calm smile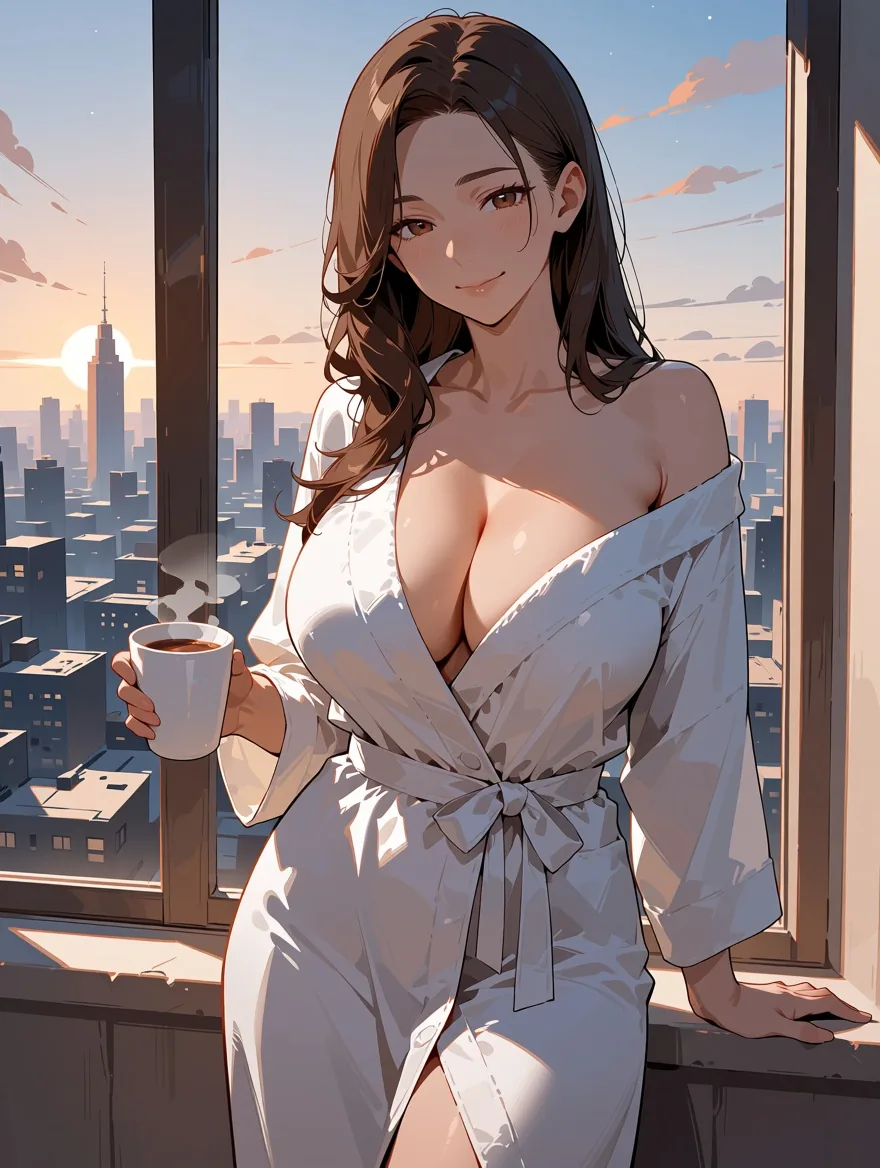
Anima Turbo texte vers image à partir du prompt ci-dessus, 3:4, palier 1k, seed 23.
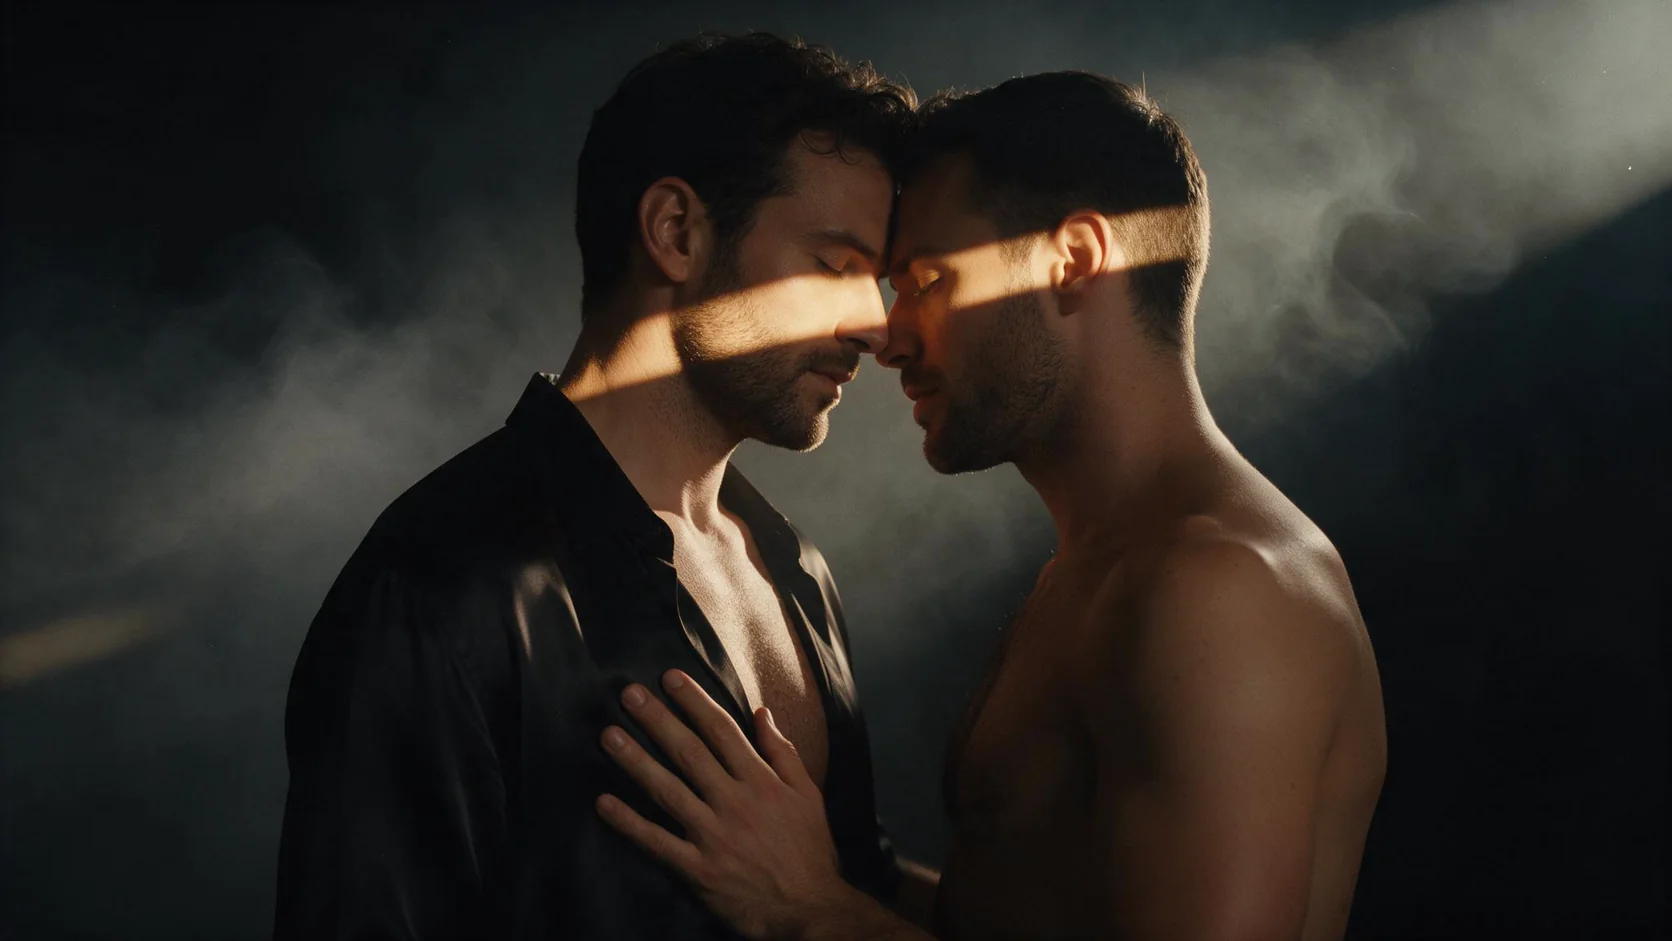
Anima gère aussi deux personnages dans le même cadre, ce qui compte pour les scènes de couple :
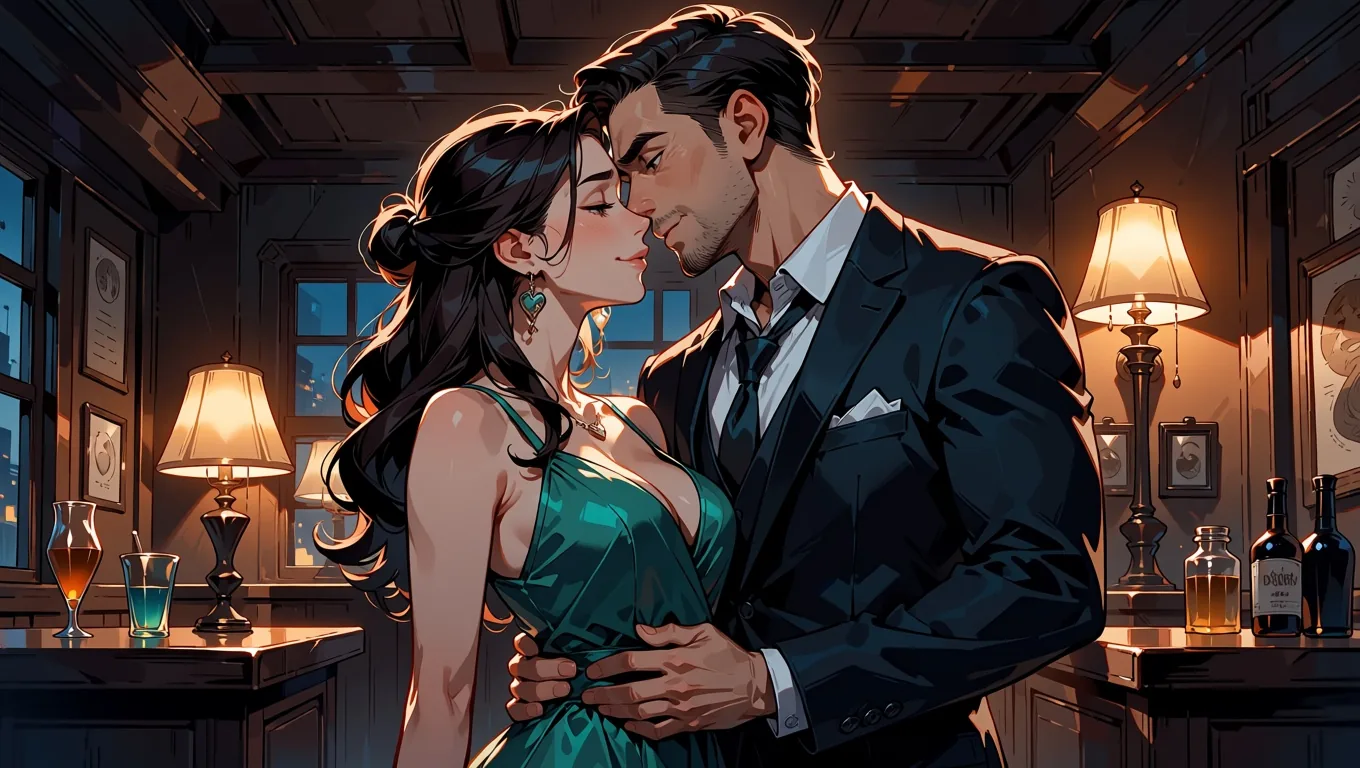
Anima Turbo texte vers image, 16:9, palier 1k, seed 24, tag de classification sensitive.
Pour le détail des résultats de prompts, de force et de tags de style de ce modèle, notre compte rendu de test d’Anima Turbo les passe en revue un par un. Vous pouvez l’utiliser depuis la page texte vers image d’Anima Turbo ou la page image vers image.
Garder un même personnage d’une scène à l’autre
Si vous faites une série, vous voudrez le même visage à plusieurs endroits. Dans un test, nous avons fixé la description (carré argenté, yeux dorés, un grain de beauté sous l’œil gauche) et le seed, et changé seulement la tenue et le lieu. Le personnage est resté reconnaissable dans les trois images.
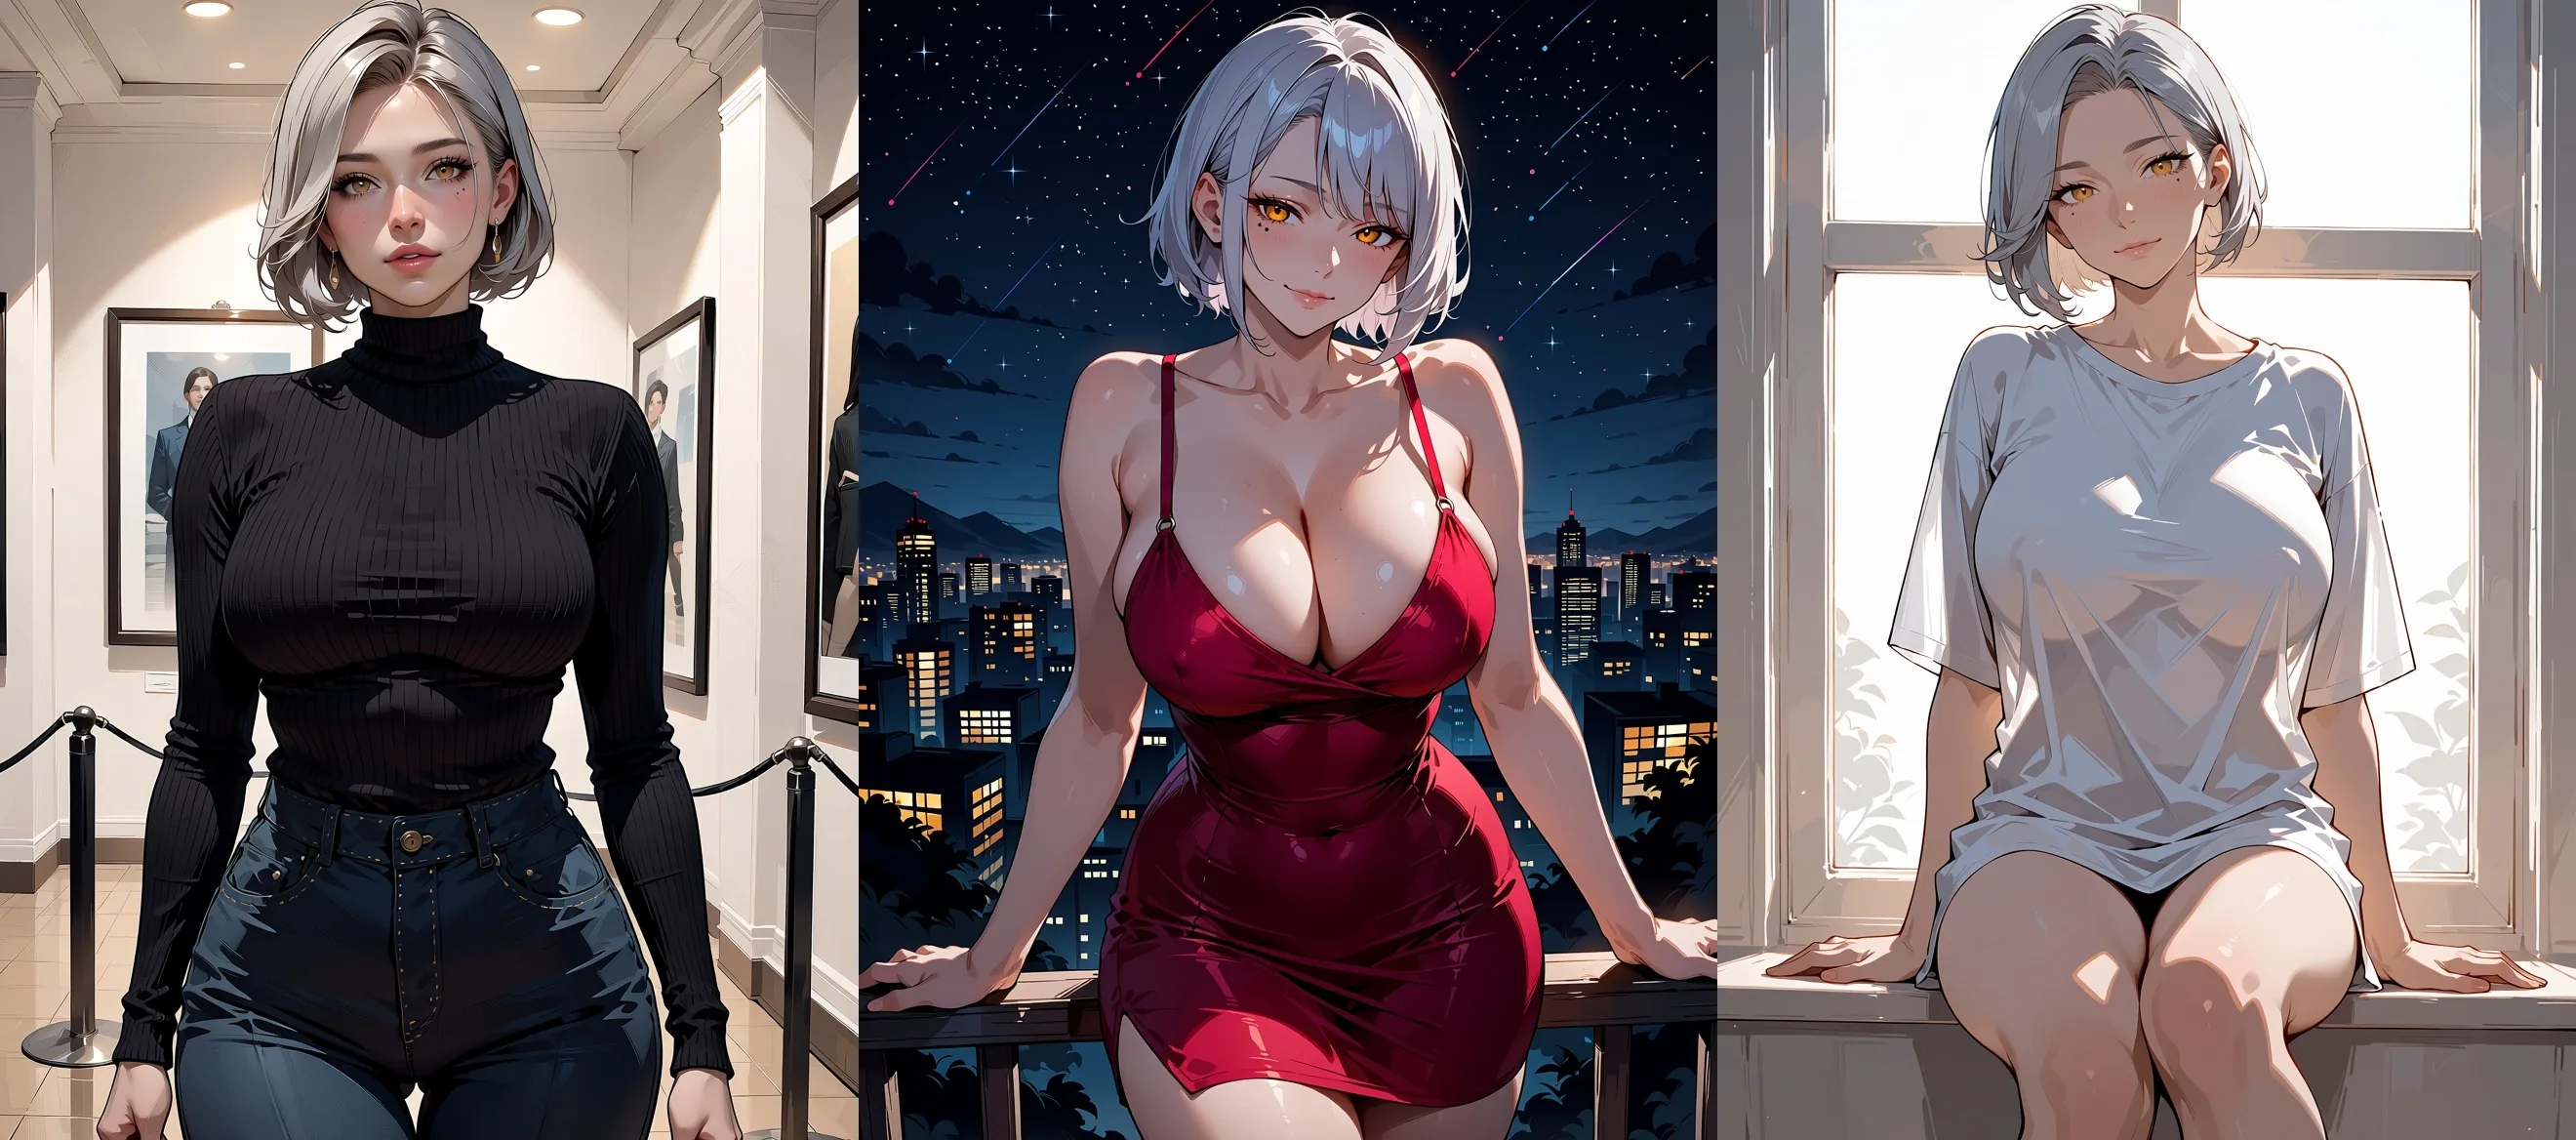
Anima Turbo texte vers image, 3:4, palier 1k, même seed (31) et même description du personnage dans trois tenues et lieux. Une exécution par image.
Les seeds ne garantissent pas des pixels identiques ; voyez donc cela comme une méthode qui a fonctionné pour nous.
Anima Turbo LoRA : styles et personnages personnalisés
Choisissez Anima Turbo LoRA quand le rendu compte plus que le style par défaut du modèle. C’est le même modèle avec jusqu’à trois LoRA par requête, chacun saisi sous forme de path (un lien HTTPS direct vers un fichier .safetensors) et de scale de 0 à 4. Le chargement des LoRA n’ajoute aucuns frais distincts.
Dans nos tests de contenu, il a égalé le modèle simple : L3 et L4 rendus, avec et sans LoRA, et nous n’avons vu aucun refus. Ce qui change, c’est le contrôle. Un rendu de jeu de l’époque PC-98, par exemple, venait d’un LoRA public de Melon-Bread :
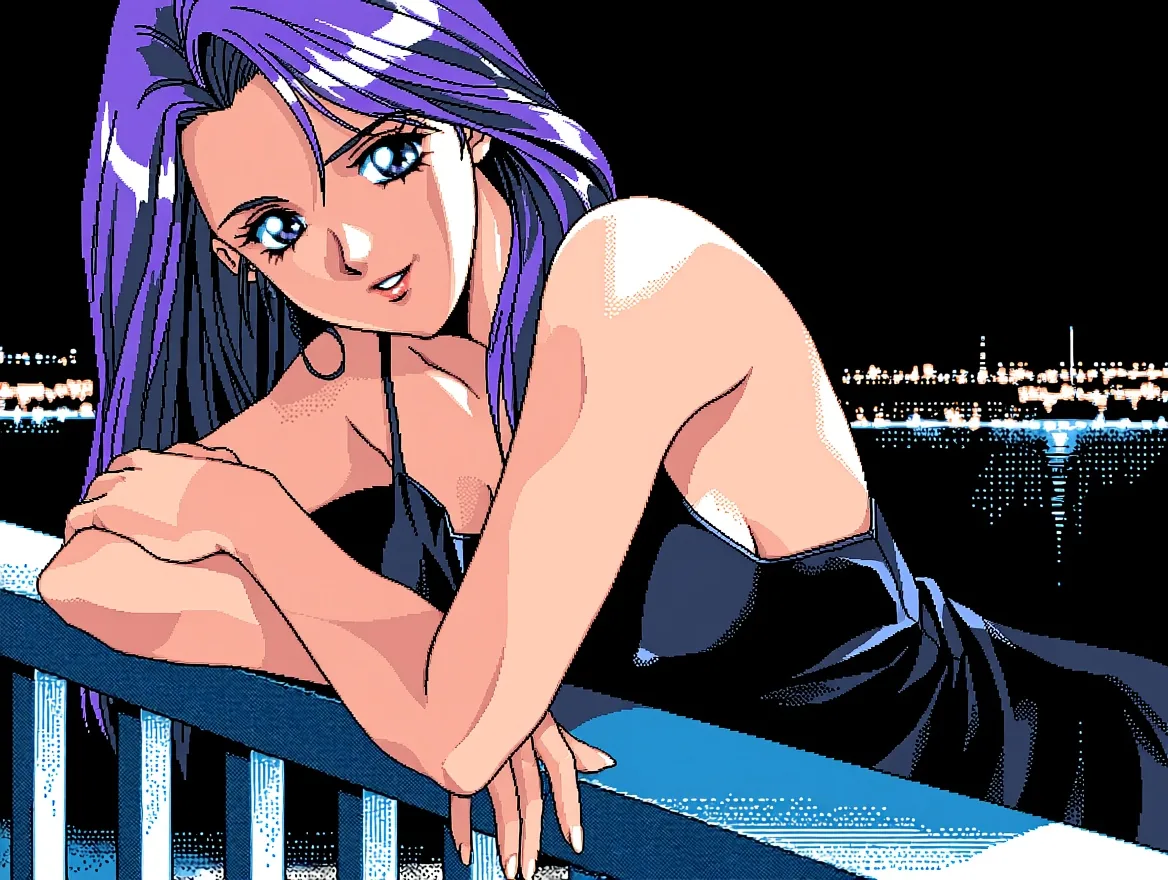
Anima Turbo LoRA texte vers image, 4:3, palier 1k, seed 32, LoRA PC-98 à scale 1 avec son mot déclencheur, tag de classification sensitive.
Un LoRA de manga monochrome a demandé monochrome, greyscale dans le prompt avant d’abandonner la couleur :
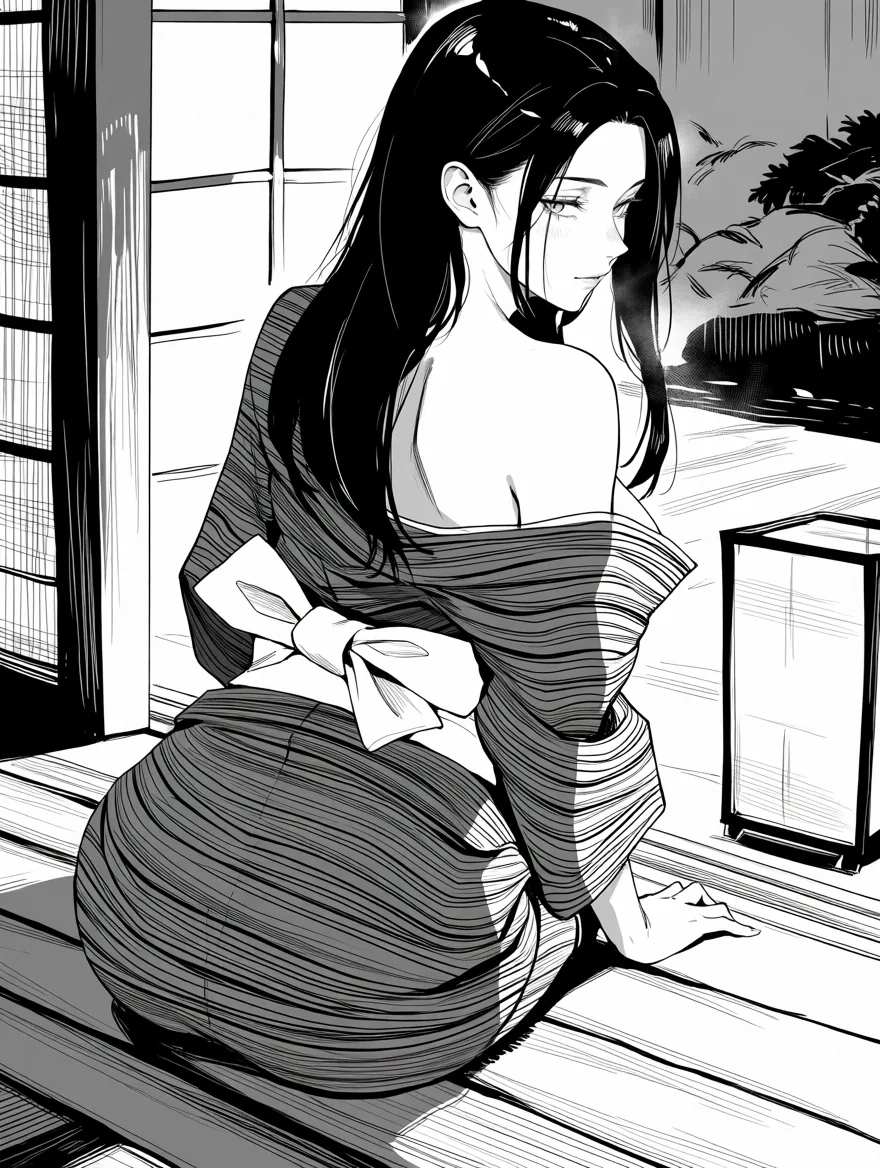
Anima Turbo LoRA texte vers image, 3:4, palier 1k, seed 33, LoRA monochrome à scale 1, tag de classification sensitive.
À savoir avant de commencer :
- Plage de scale. Dans nos exécutions, 0,5 était une touche légère, 1 le style complet, 1,5 poussait davantage, et 4 a fait éclater l’image en formes abstraites. Environ 0,5 à 1,2 est la plage utile.
- Choisir la bonne base. Un LoRA entraîné pour un autre modèle de base (nous en avons essayé un pour FLUX) s’est chargé sans erreur et n’a rien changé : la sortie était identique au pixel près à celle sans LoRA. Utilisez des LoRA entraînés pour Anima. Hugging Face en listait 129 le 5 octobre 2026.
- Les erreurs de lien ne sont pas facturées. Un lien protégé qui exige une connexion échoue avec un message HTTP 401, et un lien vers une page de dépôt au lieu du fichier demande le lien de téléchargement direct.
- La première utilisation est plus lente. La première requête avec un nouveau LoRA peut être plus longue le temps de récupérer le fichier ; l’une des nôtres a pris presque trois minutes.
Notre guide des styles LoRA détaille le scale, l’empilement et les mots déclencheurs, et le modèle a une page texte vers image et une page image vers image.
Prefect Pony XL : la lignée Pony pilotée par tags
Choisissez Prefect Pony XL si vos prompts et vos habitudes viennent de l’écosystème Pony XL. C’est un checkpoint d’anime communautaire de cette lignée, en texte vers image uniquement, avec sept tailles SDXL natives. Dans notre exécution interne du 18 septembre 2026, il a rendu trois niveaux de sonde jusqu’à L4.
C’était un test antérieur et distinct ; nous ne le comparons donc pas à Anima sur le contenu. La différence que vous sentirez est le flux de travail : Pony est limité au texte, sans image vers image ni emplacement LoRA sur SpicyAPI, alors qu’Anima Turbo offre l’image vers image et un frère LoRA.
Bases photoréalistes avec LoRA : Z-Image Turbo LoRA, Qwen Image 2512 LoRA, FLUX.1 Dev LoRA
Ne choisissez l’un d’eux que si vous avez une raison de quitter la voie native de l’anime. Raisons typiques : vous voulez un seul modèle capable de produire à la fois du photoréaliste et de l’anime, vous possédez déjà un LoRA entraîné pour cette base, ou vous avez besoin de retouche. Chacun accepte vos LoRA, et les résultats de contenu des tests du catalogue diffèrent :
| Modèle | Ce que c’est | Tests de contenu |
|---|---|---|
| Z-Image Turbo LoRA | Z-Image Turbo d’Alibaba avec vos LoRA ; photoréaliste par défaut, anime avec un LoRA d’anime | L3 et L4 rendus (texte vers image) |
| Qwen Image 2512 LoRA | Qwen-Image-2512 avec vos LoRA, plus la retouche | L3 et L4 rendus |
| FLUX.1 Dev LoRA | FLUX.1 [dev] avec vos LoRA | L3 rendu ; L4 atténué dans nos tests |
« Atténué » signifie que la requête a abouti mais que l’image ne correspondait pas à ce qui était demandé à ce niveau. Si votre projet dépend du niveau le plus intense, cette ligne explique pourquoi FLUX.1 Dev LoRA est le dernier choix du tableau ci-dessus et non le premier.
Deux autres modèles d’image sans censure, MiniMax H3 Image LoRA (L4 rendu) et Z-Image Spicy (photoréaliste, palier sans censure), ne sont pas des choix pour l’anime.
Une fois que vous avez une image qui vous plaît, vous pouvez l’animer. Seedance 2.5 Spicy, Wan 2.2 Spicy et MiniMax H3 Spicy sont des familles d’image vers vidéo sans censure : elles prennent une image et un prompt et renvoient une courte vidéo.
Modèles généralistes qui refusent : FLUX 3 et Ideogram v4.5
Si vous hésitez entre FLUX 3 et Ideogram v4.5 pour du travail d’anime NSFW, passez votre chemin : les deux ont refusé presque tout ce qui dépasse une photo de maillot de bain neutre. Nous avons testé les deux le 5 octobre 2026 via une API hébergée par un tiers, sur la même échelle au palier 1k.
| Modèle | Livré | Refusé |
|---|---|---|
| FLUX 3 texte vers image (Black Forest Labs) | Une scène de plage en bikini ; une photo de catalogue de lingerie neutre | Lingerie à la formulation aguicheuse (L1), L2, L3, L4, une étude de nu en peinture classique, un nu masculin et un prompt aux tournures détournées sans aucun mot signalé (10 requêtes sur 12) |
| Ideogram v4.5 (Ideogram) | Les deux mêmes | Le même ensemble ; l’expansion de prompt activée ou non n’a rien changé (11 requêtes sur 13) |
Les refus sont revenus en deux secondes environ, avant toute génération d’image, avec le message « Content flagged as potentially sensitive. Please try different prompts or images. » Les requêtes refusées n’ont pas été facturées. Comme le prompt aux tournures détournées a lui aussi été refusé, le filtre se comporte comme un filtre sémantique et non comme une liste de mots-clés. Nous ne pouvons pas dire si ce filtre appartient aux API des éditeurs des modèles ou à l’hébergeur que nous avons utilisé ; lisez donc « refusé sur cette route » et non un verdict sur les modèles dans tous les contextes.
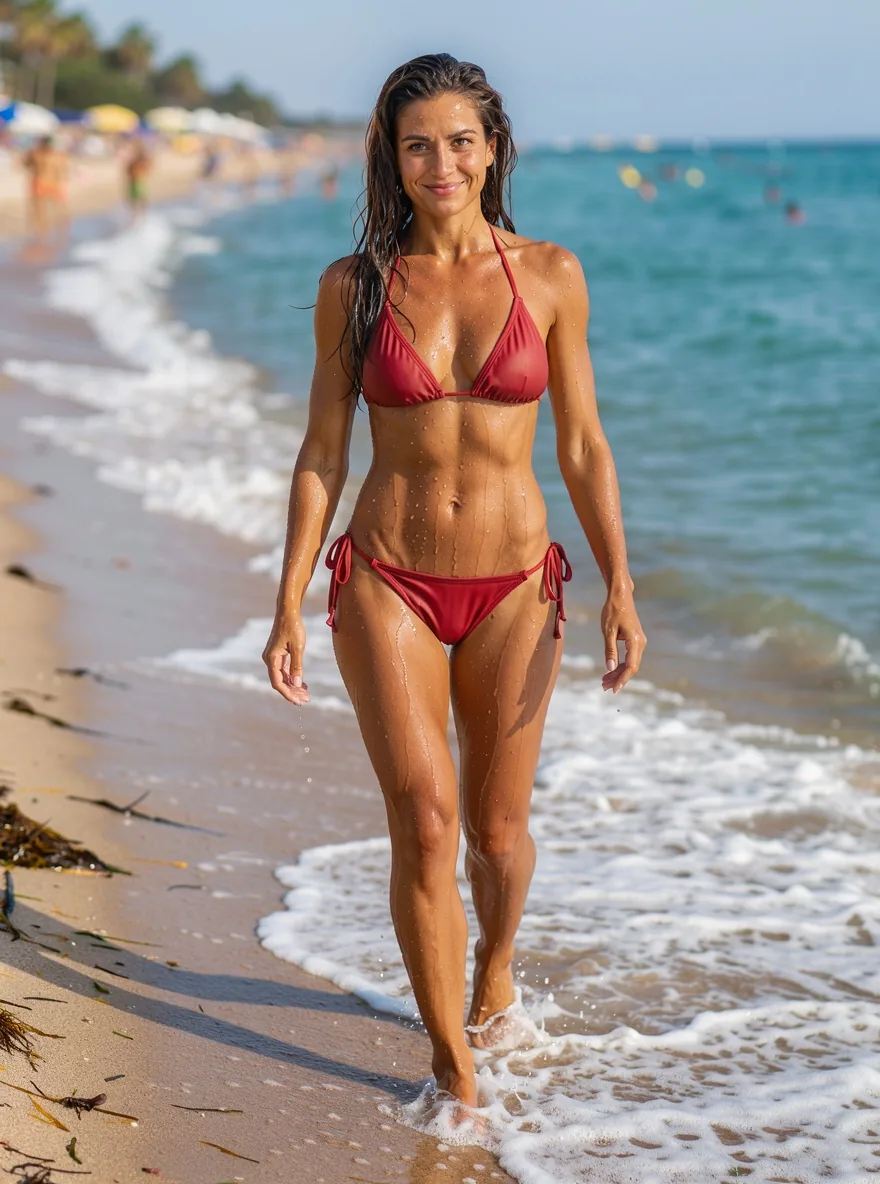
FLUX 3 texte vers image, palier 1k. Cette photo de plage en bikini était l’une des deux requêtes qu’il a livrées.
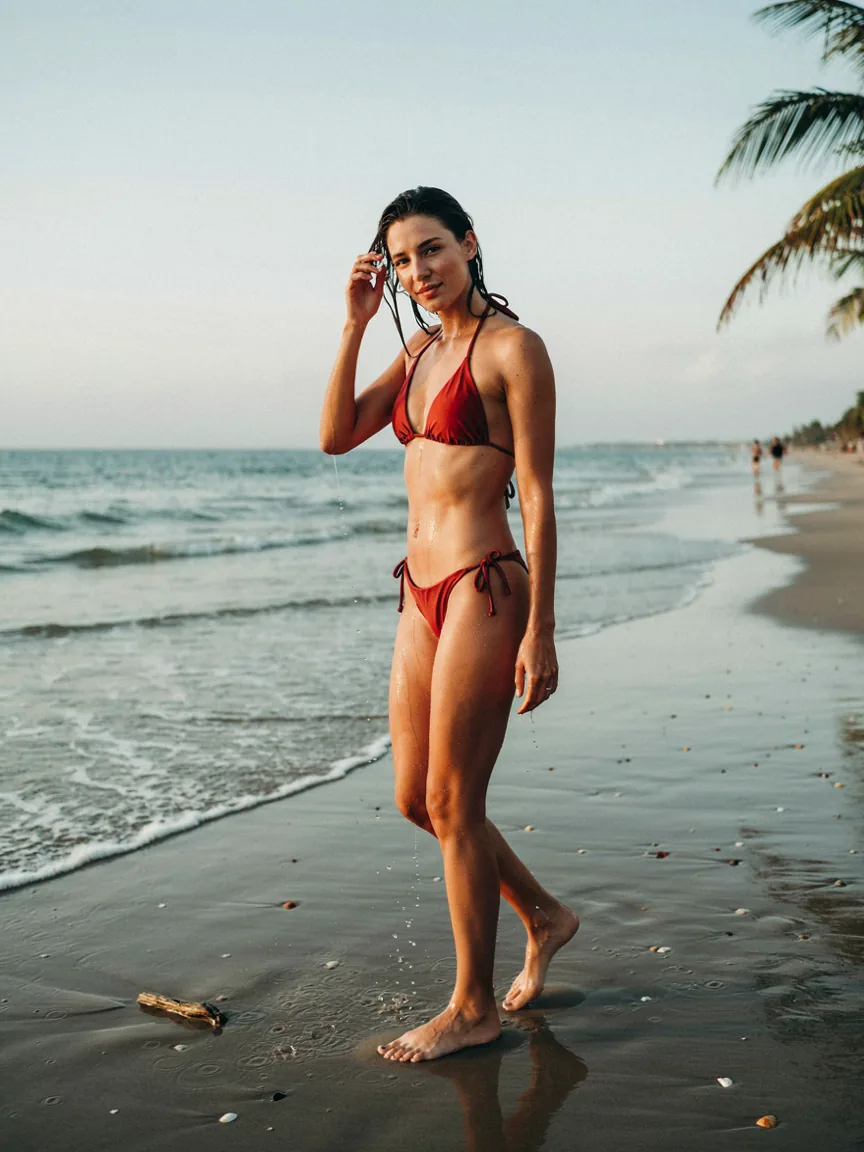
Ideogram v4.5, palier 1k. Le même genre de scène de plage en bikini, l’une des deux requêtes qu’il a livrées.
Les deux modèles ont aussi renvoyé des photographies, pas de l’anime ; même un réglage permissif n’aurait donc pas couvert la moitié « anime » de votre besoin. Pour une comparaison plus large entre modèles d’image, voir notre panorama des générateurs d’images NSFW.
Comment nous avons testé, et ce que les tests ne disent pas
Considérez chaque chiffre ici comme un petit échantillon daté. Les résultats d’Anima sont 25 requêtes de contenu plus 60 exécutions de formats d’image le 5 octobre 2026, le plus souvent avec un ou deux seeds par cas. Les résultats de FLUX 3 et d’Ideogram v4.5 sont 13 et 14 requêtes le même jour via une seule route tierce. Le résultat de Prefect Pony XL vient d’une exécution interne du 18 septembre 2026. Les autres lignes viennent des tests de contenu du catalogue et sont rapportées telles qu’écrites là-bas.
Ce que les tests ne montrent pas :
- Ils ne classent pas la qualité d’image. Nous n’avons pas noté les visages, les mains, la composition ou le style d’un modèle à l’autre, et nous ne prétendons pas qu’Anima soit plus beau que tout autre modèle ici.
- Ils ne garantissent pas le même résultat la prochaine fois. Les fournisseurs changent leurs filtres, et la même requête avec le même seed nous a donné des rendus légèrement différents à des moments différents.
- Le tag de classification déplace moins le ton qu’on ne le croit avec une description habillée : avec le même prompt de salon et le même seed,
safeetsensitiveont donné presque la même image.
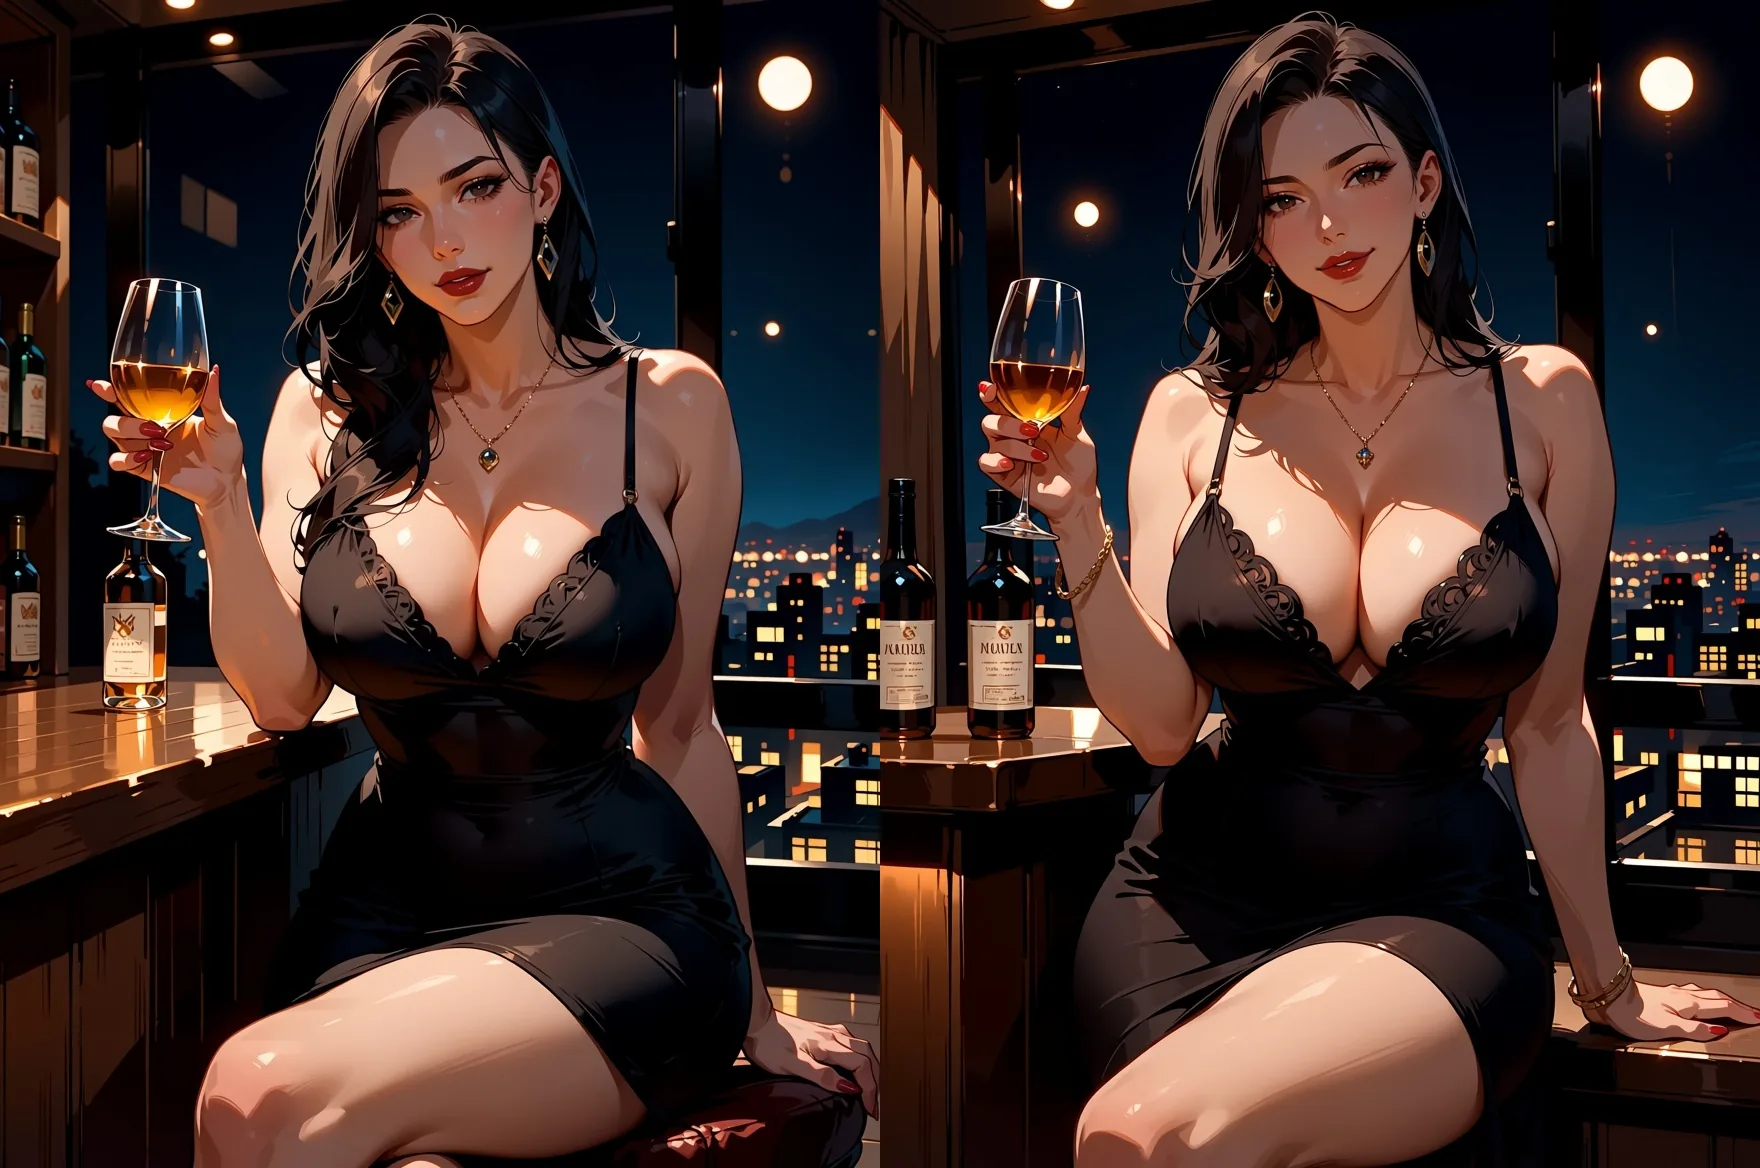
Anima Turbo texte vers image, 3:4, palier 1k, seed 27. À gauche : safe. À droite : sensitive. Même prompt par ailleurs.
Comment choisir en trois questions
- Avez-vous un LoRA ou besoin d’un style précis ? Si oui, utilisez Anima Turbo LoRA, ou une base compatible LoRA qui correspond au LoRA que vous possédez (un LoRA pour une autre base ne fait rien). Sinon, commencez par Anima Turbo.
- Écrivez-vous vos prompts en tags de type Pony et voulez-vous précisément cet écosystème ? Essayez alors Prefect Pony XL. Si vous voulez de l’image vers image à partir d’une photo ou d’un dessin, c’est Anima Turbo qui l’offre.
- Avez-vous besoin d’une sortie photoréaliste ? Si oui, utilisez une base photoréaliste d’abord comme Z-Image Turbo LoRA, et vérifiez d’abord sa ligne de contenu. Si vous ne voulez que de l’anime, restez sur les modèles natifs d’anime.
Si vous comptez transformer une photo en anime, notre guide de la force montre ce que fait chaque valeur de force.
Utiliser ces modèles de façon responsable
Ne créez que des personnages adultes, et dites-le dans le prompt. Ne générez pas de personnes réelles ni de ressemblances réelles sans leur consentement. Gardez vos propres sorties privées, sauf si vous êtes certain de l’endroit où vous avez le droit de les publier. Vous êtes responsable de ce que vous générez, stockez et partagez, et du respect des lois qui s’appliquent à vous.
FAQ
Quel modèle d’IA est le meilleur pour l’art d’anime NSFW ?
Pour de l’art d’anime par prompt seul, Anima Turbo était le meilleur choix dans nos tests : notre sonde de contenu la plus forte a été rendue telle qu’écrite dès le premier essai, sans refus sur 25 requêtes. Prefect Pony XL convient aux prompts à tags de type Pony, et Anima Turbo LoRA aux styles personnalisés. Le « meilleur » change avec l’usage ; servez-vous donc du tableau de choix rapide ci-dessus.
FLUX 3 ou Ideogram v4.5 peuvent-ils faire de l’anime NSFW ?
Pas dans nos tests. FLUX 3 a refusé 10 requêtes sur 12 et Ideogram v4.5 11 sur 13, y compris la lingerie à la formulation aguicheuse. Les deux n’ont livré qu’une scène de plage en bikini neutre et une photo de catalogue de lingerie. Le filtre appartient peut-être à l’hébergeur plutôt qu’aux éditeurs, ce que nous n’avons pas pu vérifier.
Ai-je besoin d’un LoRA pour l’art d’anime NSFW ?
Non. Anima Turbo a rendu les niveaux testés sans aucun LoRA. Un LoRA aide quand vous voulez un style précis ou un personnage récurrent. Utilisez-en un entraîné pour Anima : un LoRA pour une autre base s’est chargé sans erreur et n’a rien changé dans notre test.
Les modèles sont-ils vraiment sans censure, ou atténuent-ils discrètement les images ?
Sur Anima, nous avons vu zéro refus et zéro substitution sur 25 requêtes de contenu. L’atténuation existe ailleurs : FLUX.1 Dev LoRA a atténué le niveau intense dans nos tests. Le modèle peut aussi se comporter différemment d’un seed à l’autre ; vérifiez donc chaque résultat.
Quelle différence entre les tags de classification safe et sensitive ?
Avec une description habillée, ils ont donné presque la même image dans notre test ; le tag est donc plus un indice de ton qu’un interrupteur. L’éditeur documente nsfw et un tag plus fort comme ceux qui lèvent la retenue. Comme il n’y a pas de prompt négatif, le tag de classification est le principal moyen de régler le ton.
Puis-je transformer ma propre photo en anime ?
Oui, avec l’image vers image d’Anima Turbo. Dans nos tests, une photo restait une photo à une force de 0,3, devenait une illustration à 0,6 et un anime net à 0,75. À partir de 0,9, les détails commencent à changer, et à 1,0 la source est ignorée. Il restyle ; il ne suit pas les instructions de retouche.
Puis-je animer les images ?
Oui. Seedance 2.5 Spicy, Wan 2.2 Spicy et MiniMax H3 Spicy prennent une image et un prompt et renvoient une courte vidéo.