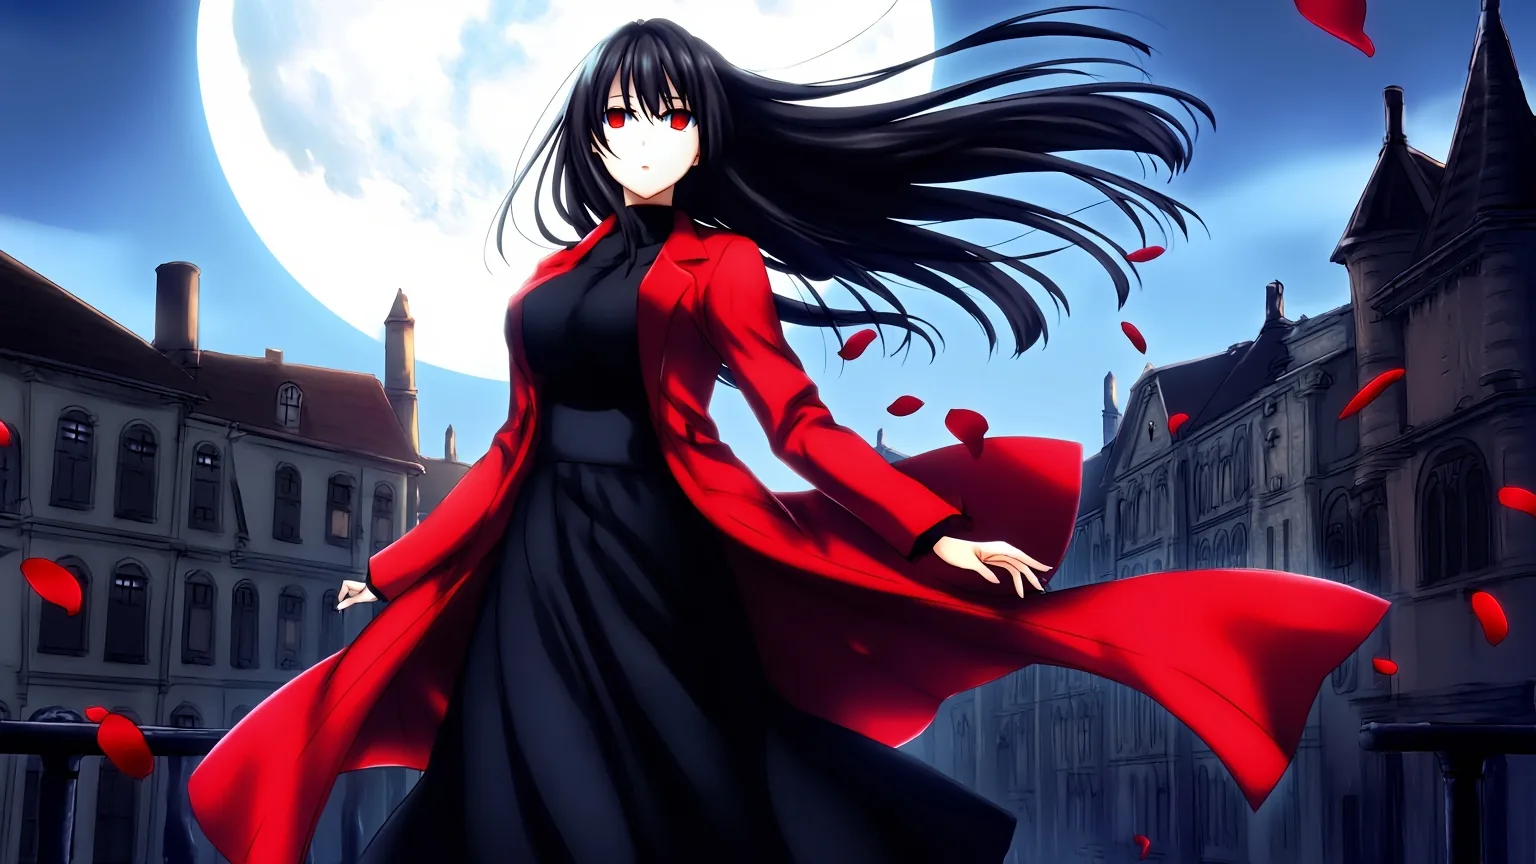
O Neta Lumina é um modelo de anime sem censura que lê tags do Danbooru e frases simples e, nos nossos testes, entregou todos os níveis da nossa escada de conteúdo, sem recusa e sem substituição. O preço dessa liberdade é o tempo: em 31 execuções em 5 de outubro de 2026, uma imagem levou de 13 a 75 segundos, com mediana de 40 e nenhuma abaixo de dez. Ele também não tem prompt negativo, entrada de imagem nem espaço para LoRA.
O Neta Lumina é feito pelo Neta.art Lab. É um ajuste fino (fine-tune) do Lumina-Image-2.0 da Alpha-VLLM com um codificador de texto Gemma 2B, e está público na SpicyAPI como neta-art/neta-lumina/text-to-image. Todos os prompts impressos abaixo são cenas do dia a dia com adultos vestidos. A página da família Neta Lumina mostra o preço atual por imagem.
Visão geral
| Neta Lumina (testado em 5 de outubro de 2026) | |
|---|---|
| Quem publica e base | Neta.art Lab; ajuste fino do Lumina-Image-2.0 com codificador de texto Gemma 2B e o VAE do FLUX |
| Nome do modelo na API | neta-art/neta-lumina/text-to-image (somente texto para imagem) |
| Campos públicos | prompt (até 5.000 caracteres), aspect_ratio, output_format, seed |
| Proporções | 9, todas com cerca de um megapixel: 1024 x 1024 em 1:1, 1536 x 864 em 16:9, 1536 x 656 em 21:9 |
| Saída | Uma imagem por requisição em JPEG (padrão), PNG ou WebP |
| Velocidade nos nossos testes | De 13 a 75 segundos por imagem em 31 execuções, mediana de 40, nenhuma abaixo de 10 segundos |
| Política de conteúdo | Sem censura, sem filtro de conteúdo; os cinco níveis da nossa escada foram entregues |
| Não faz | Prompts negativos, passos, guidance, sampler, entrada de imagem, LoRAs, mais de uma imagem por requisição |
O que é o Neta Lumina
Quem publica descreve o Neta Lumina como um modelo de imagem de alta qualidade em estilo anime. O cartão no Hugging Face, em huggingface.co/neta-art/Neta-Lumina, diz que ele é forte em ilustração de anime, pôsteres, storyboards e design de personagens, com ampla cobertura de personagens e estilos. Quem publica afirma que a compreensão de prompts é precisa mesmo para prompts complexos, que há suporte a tags do Danbooru e que chinês, inglês e japonês são os idiomas recomendados. Testamos só em inglês.
A questão da versão merece uma frase. O repositório de quem publica data de junho de 2025 e a "versão oficial" v1.0 foi enviada em 22 de julho de 2025. A rota hospedada não informa uma versão, então não podemos dizer qual build respondeu às nossas requisições, e não tentamos adivinhar pelas imagens.
Duas coisas o distinguem do outro modelo de anime que analisamos esta semana, o Anima Turbo. Ele lê frases descritivas completas pelo menos tão bem quanto tags, e é lento. A tabela perto do fim põe os dois lado a lado com o Prefect Pony XL.
Tags, frases ou os dois
O guia de prompts de quem publica sugere uma ordem: personagens, estilo, aparência, roupa, expressão e ação, câmera, iluminação, atmosfera e, por fim, tags de qualidade. Sugere também uma linha de abertura fixa e opcional, "You are an assistant designed to generate anime images based on textual prompts." Rodamos um prompt duas vezes com o mesmo seed, uma com essa linha e outra sem.
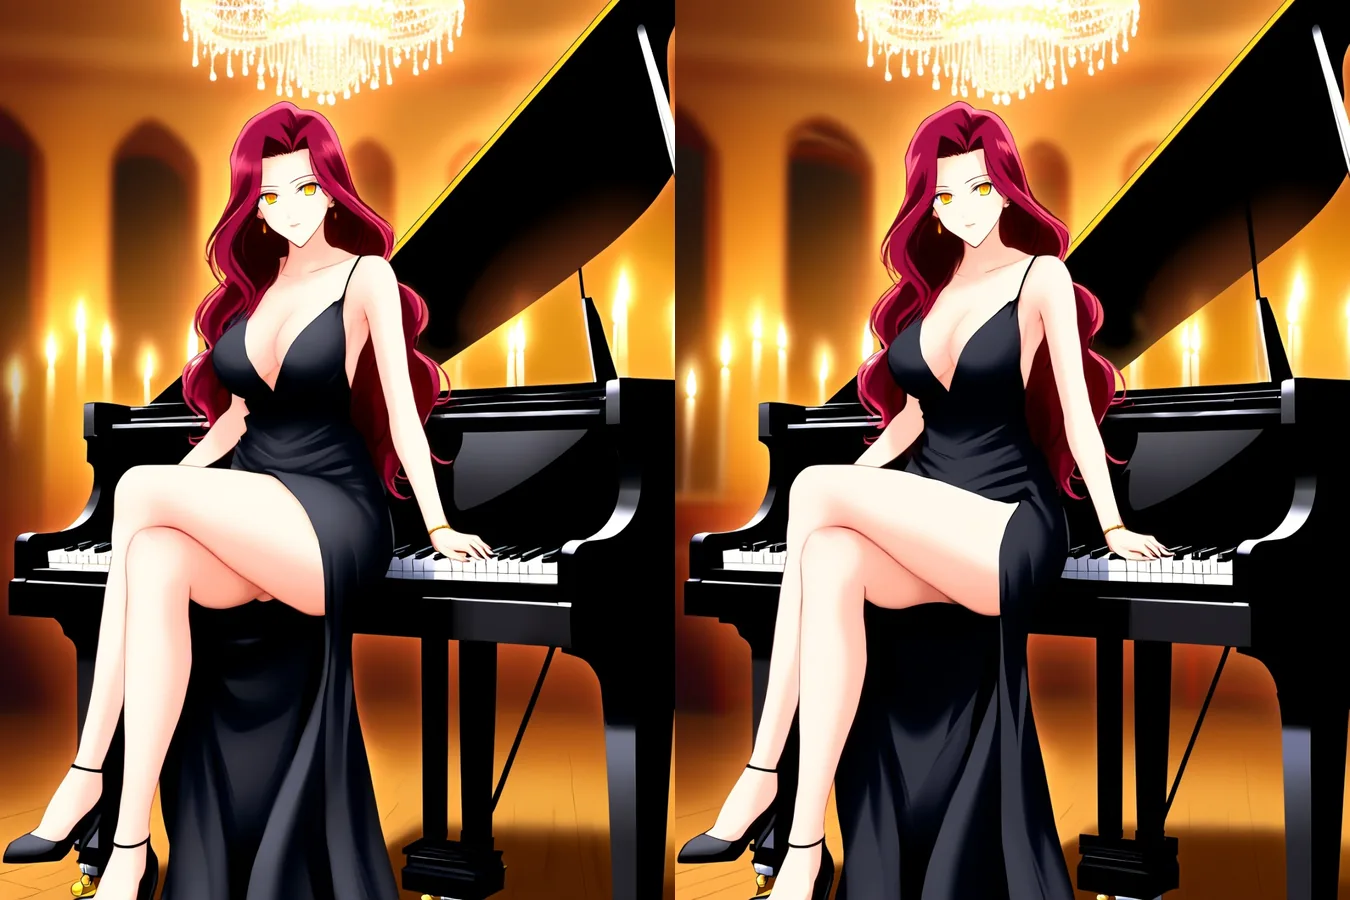
À esquerda: com a linha de abertura de quem publica. À direita: sem ela. Mesmo prompt, seed 5, 3:4, texto para imagem.
As duas imagens são quase idênticas, então neste endpoint a linha de abertura não é necessária. O prompt que desenhou a pianista era uma simples lista de tags:
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileFrases funcionam igualmente bem. Esta desenhou um homem com uma cicatriz, a camisa desabotoada e reflexos de neon sem uma única tag:
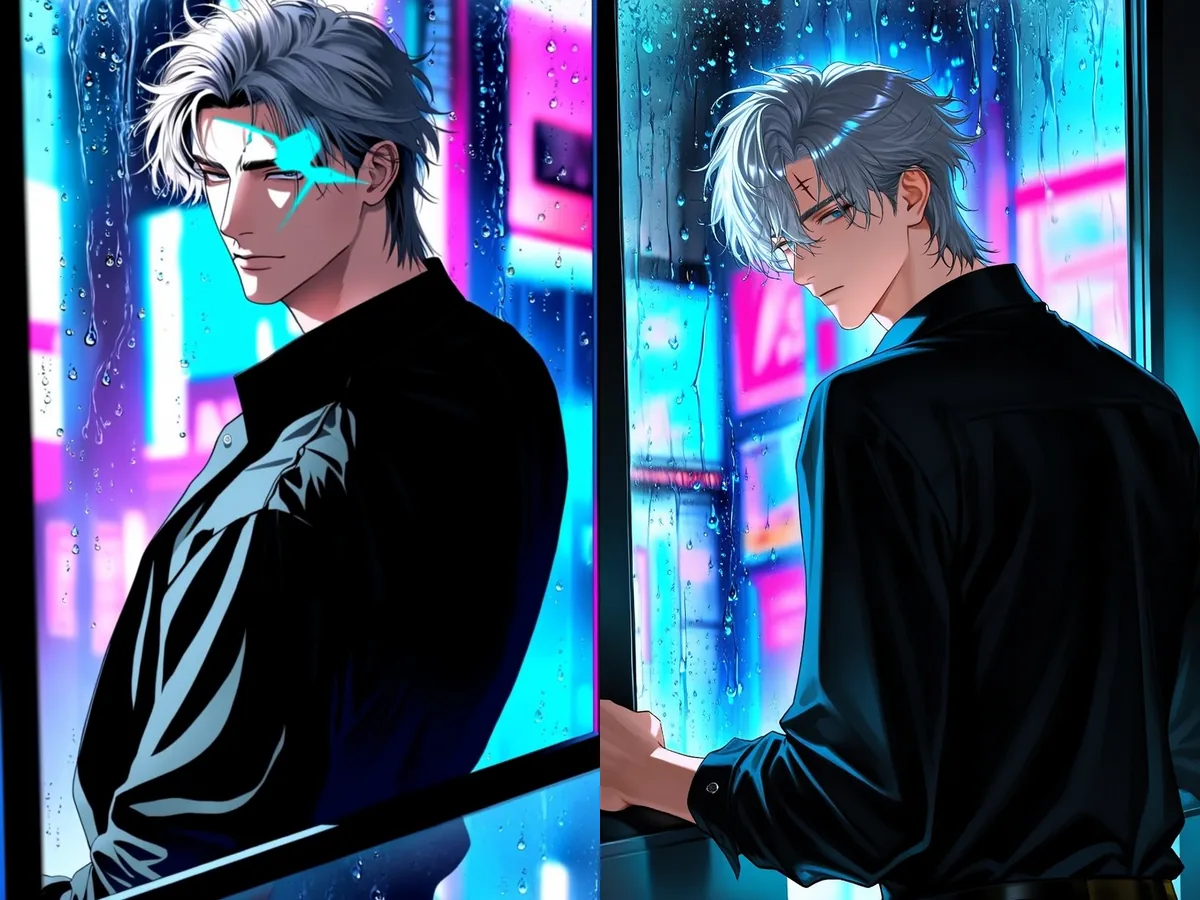
As mesmas três frases, seeds 1 e 2, 2:3. O seed 2 (à direita) é o exemplo publicado; o seed 1 desenhou uma marca ciano brilhante perdida no rosto.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.Nos nossos testes, a cicatriz, a camisa e a luz ciano e magenta apareceram nos dois seeds. O que mudou entre os seeds foi a execução: uma marca perdida em um, um rosto limpo no outro. Esse é o padrão deste modelo e é por isso que recomendamos rodar dois ou três seeds de qualquer prompt que importe para você.
| Situação | Melhor escolha | Por quê, nas nossas execuções |
|---|---|---|
| Um visual específico: cabelo, olhos, roupa, cenário | Tags | Cada tag é uma instrução própria, e a pianista manteve todos os detalhes |
| Posição da câmera, direção da luz, como duas pessoas se relacionam | Frases | O homem da janela de neon seguiu as três frases |
| Dois personagens | Primeiro as tags de contagem de pessoas, depois uma frase por pessoa | No casal na beira do mar, o vestido leve dela e a camisa aberta dele ficaram com a pessoa certa |
| Você quer controle e atmosfera | Um cabeçalho de tags mais uma ou duas frases | Uma mistura é o que tentaríamos primeiro |
Tamanhos, formatos e seeds
Não há campo de tamanho. Você escolhe uma de nove proporções, e cada uma corresponde a um tamanho fixo de cerca de um megapixel. Rodamos cada proporção uma vez e todas as saídas voltaram exatamente nos pixels pedidos.
| Proporção | Tamanho | Proporção | Tamanho |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Os tamanhos seguem a recomendação de quem publica, de aproximadamente um a 1,3 megapixel. A saída é JPEG por padrão; PNG e WebP funcionaram quando pedimos, e o formato de saída não muda mais nada. Você também pode definir um seed de 0 a 2.147.483.647.
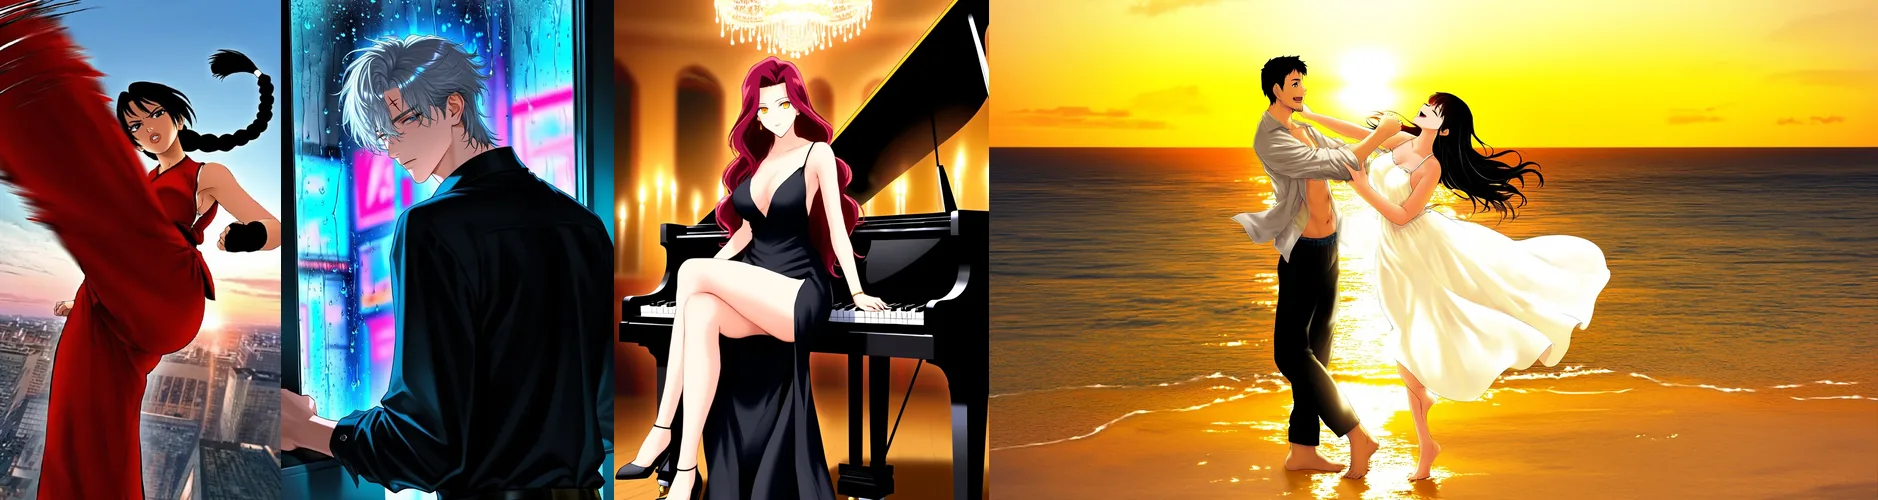
Da esquerda para a direita: 9:16, 2:3, 3:4 e 16:9, todas em texto para imagem.
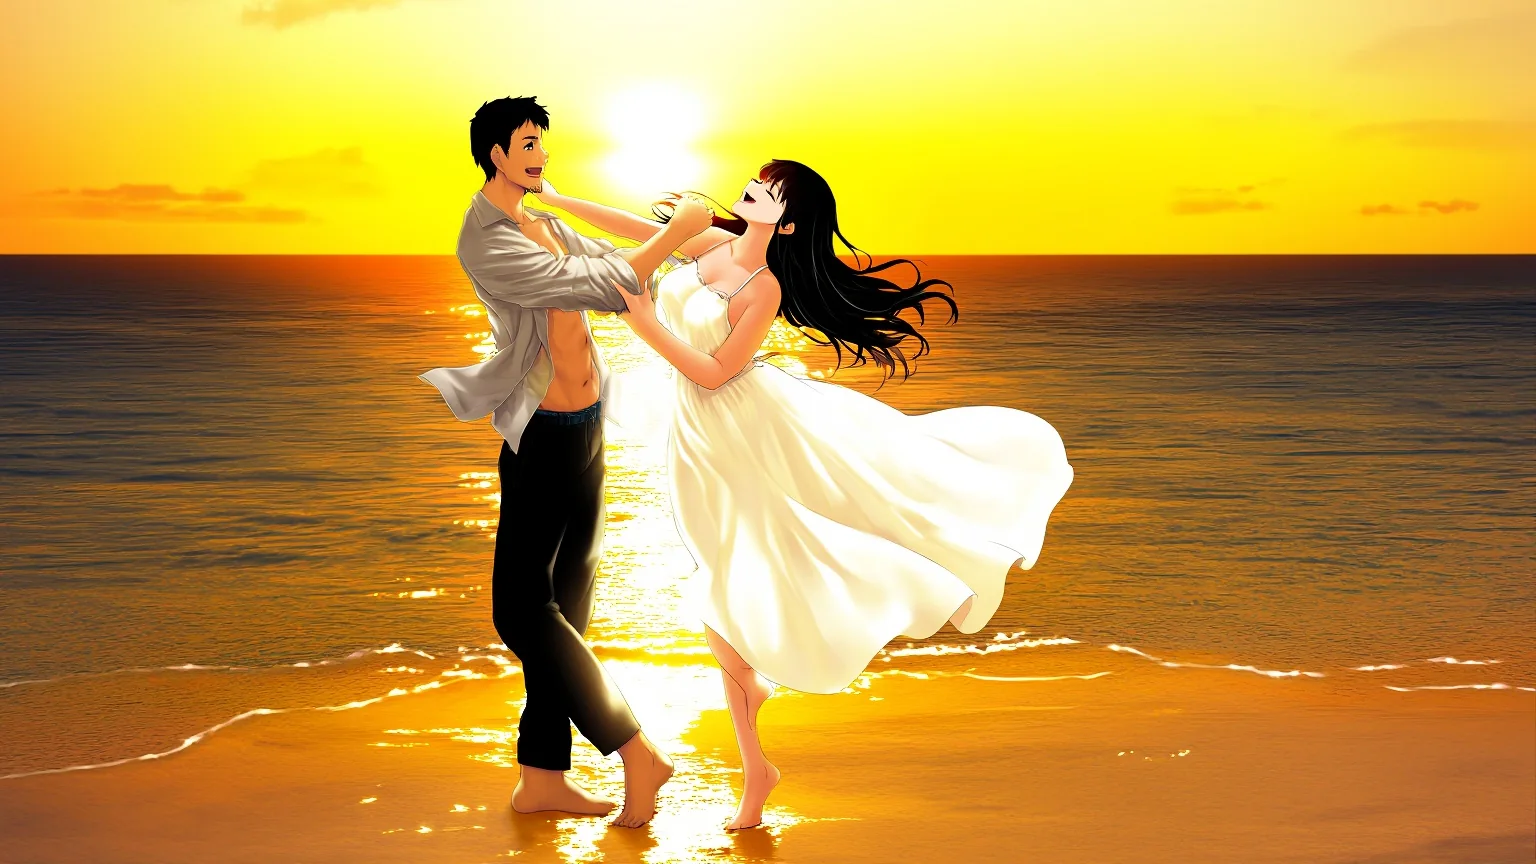
Um quadro largo combina com cenas de duas pessoas. Este é o exemplo 16:9 publicado:
16:9, seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotOs seeds tornam as execuções comparáveis, não garantidamente idênticas; portanto, use um para comparar dois ajustes de prompt, e não para prometer uma repetição exata, pixel a pixel.
Velocidade: planeje para lotes
Cronometramos 31 execuções. O tempo de modelo foi de 13 a 75 segundos, a mediana foi 40 e nenhuma execução terminou em menos de dez segundos. A página de hospedagem de quem publica cita cerca de 44 segundos, o que confere. O tamanho não explica a dispersão: uma imagem de 656 x 1536 levou 13 segundos, enquanto imagens de 960 x 1280 levaram de 14 a 75.
As consequências práticas: não construa uma caixa de "digitou, viu" ao vivo em cima dele, envie variações em paralelo e mantenha o seed fixo enquanto as compara. Se você precisa de rascunhos em poucos segundos, o Anima Turbo terminou 52 de 60 execuções em menos de dez.
Até onde ele vai
A plataforma não adiciona nenhum filtro de conteúdo, então o que você recebe é decidido pelo modelo e pelo prompt. Rodamos um prompt por degrau da nossa escada de cinco níveis em 3:4 com seed 1, e todos os prompts afirmavam que os personagens são adultos. Olhamos todas as imagens.
| Nível | O que pedimos | O que voltou |
|---|---|---|
| L1 Sugestivo | Lingerie, uma alcinha escorregando | Entregue |
| L2 Temas maduros | Parcialmente reveladora | Entregue, também nas nove proporções (9 de 9) |
| L3 Forte | Conteúdo forte, feminino e masculino | Entregue, as duas |
| L4 Intenso | Uma cena íntima entre dois adultos | Entregue como escrita, sem censura |
| L5 Extremo | Contenção consensual entre adultos; gore cinematográfico | Os dois entregues |
Não houve recusa nem imagem substituída em nenhum nível. Um detalhe vale saber sobre o prompt de contenção do L5: o modelo desenhou uma pequena tarja de mosaico sobre uma área. O L4 não teve nenhuma. Interpretamos isso como um hábito que o modelo aprendeu com a arte do seu treinamento, e não como um filtro, já que a plataforma não adiciona nada e a mesma área ficou sem censura em outros casos. Se você precisa de uma saída limpa, diga isso no prompt, ou rode de novo.
Não imprimimos os prompts da escada, e a plataforma nunca fornece prompts para conteúdo mais forte. O que podemos dizer é que, para um pedido do dia a dia, o modelo se comporta como um modelo de anime deve, e, para um mais forte, ele não atrapalha. Compare com o FLUX 3 e o Ideogram v4.5, que recusaram quase tudo além de uma foto neutra de roupa de banho nos nossos testes.
O que deu errado
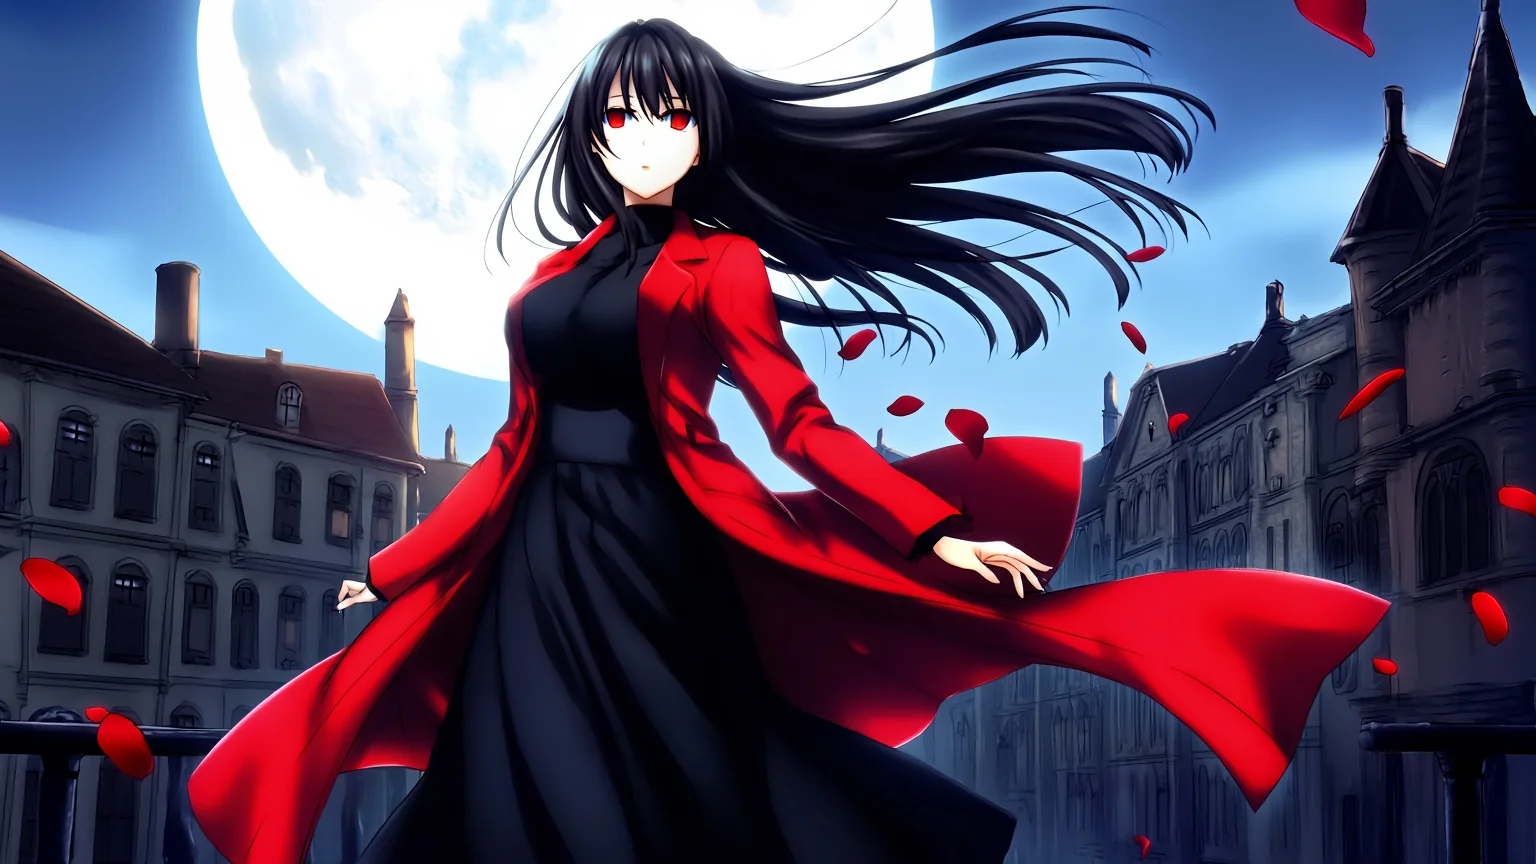
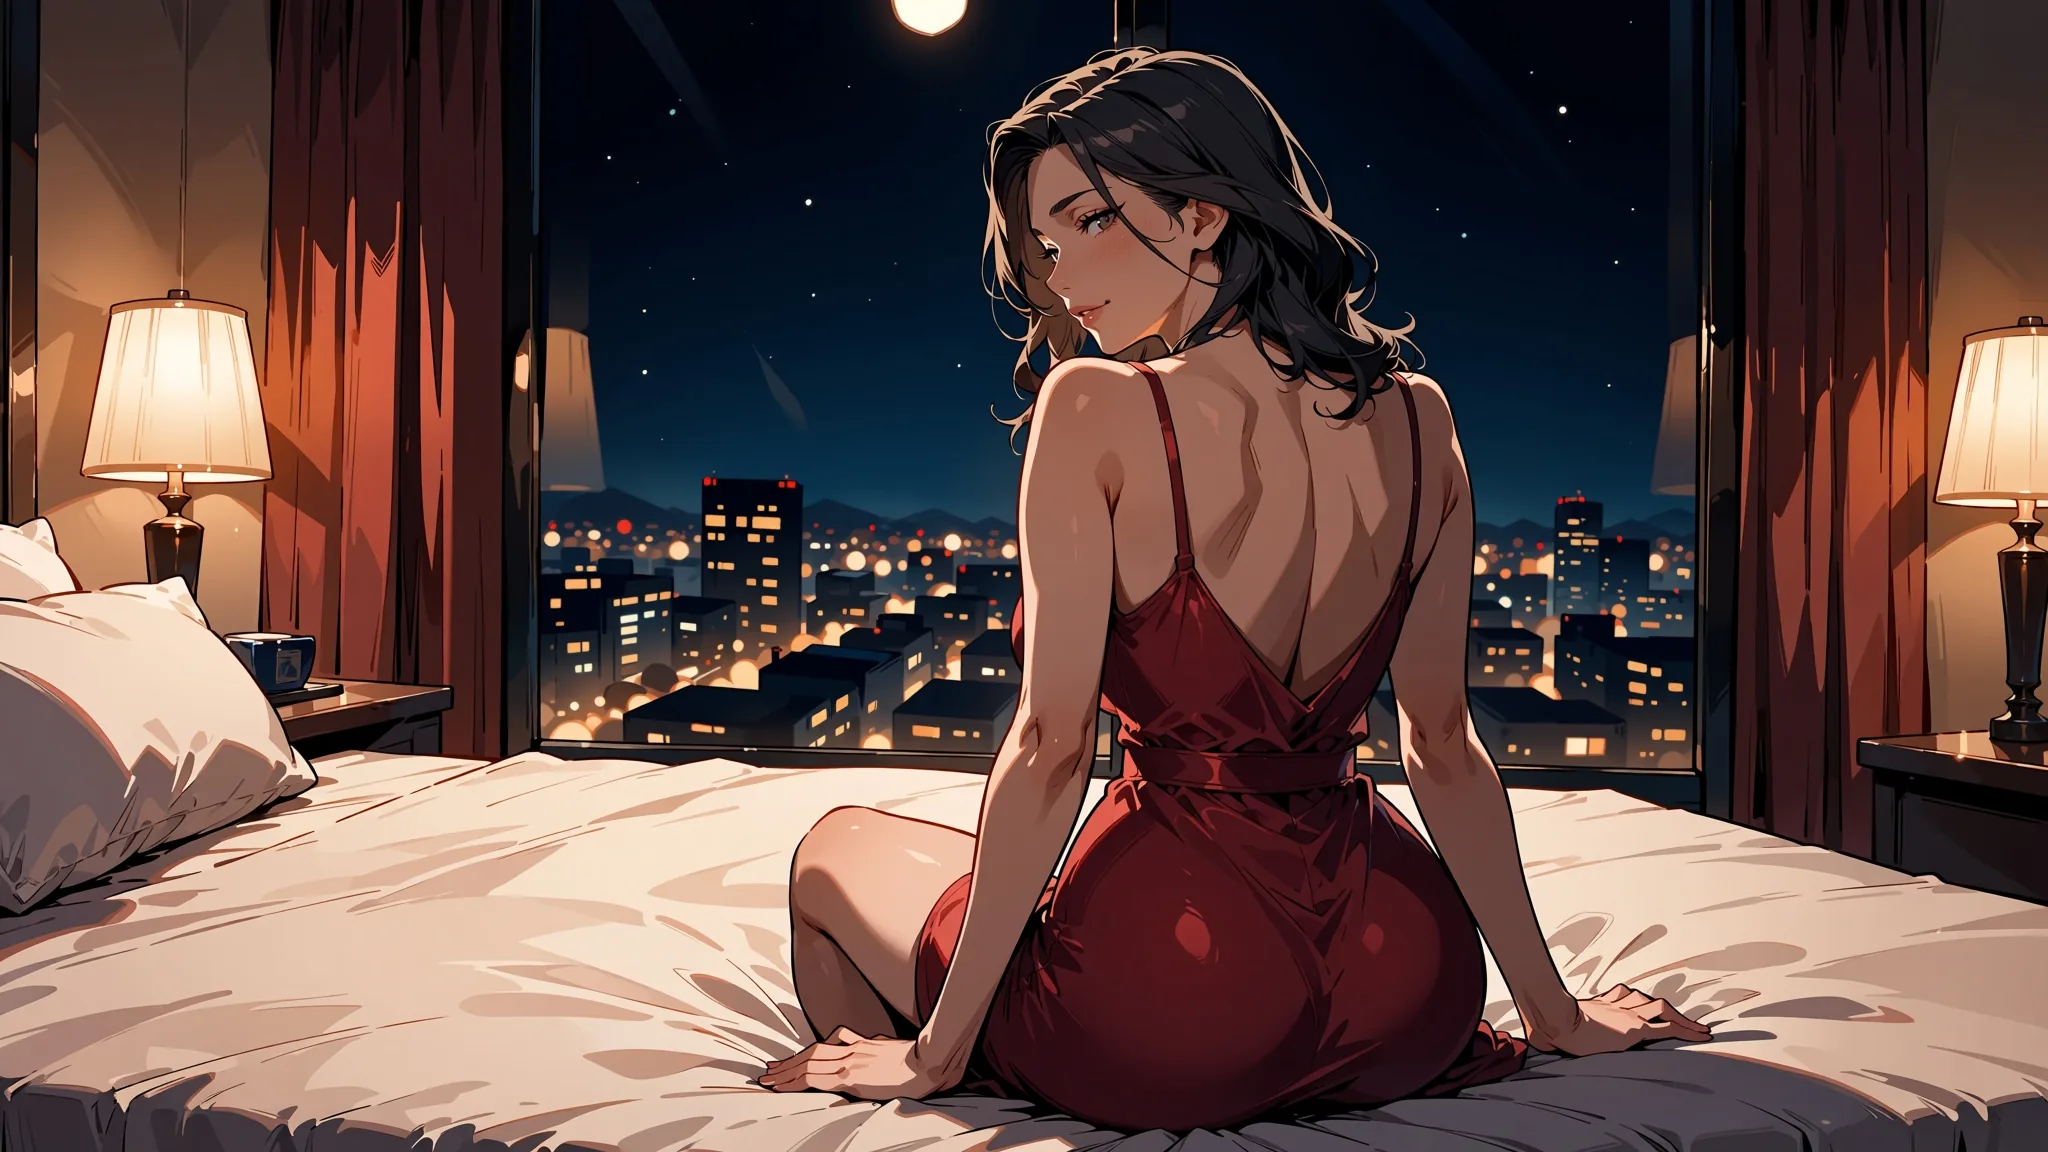
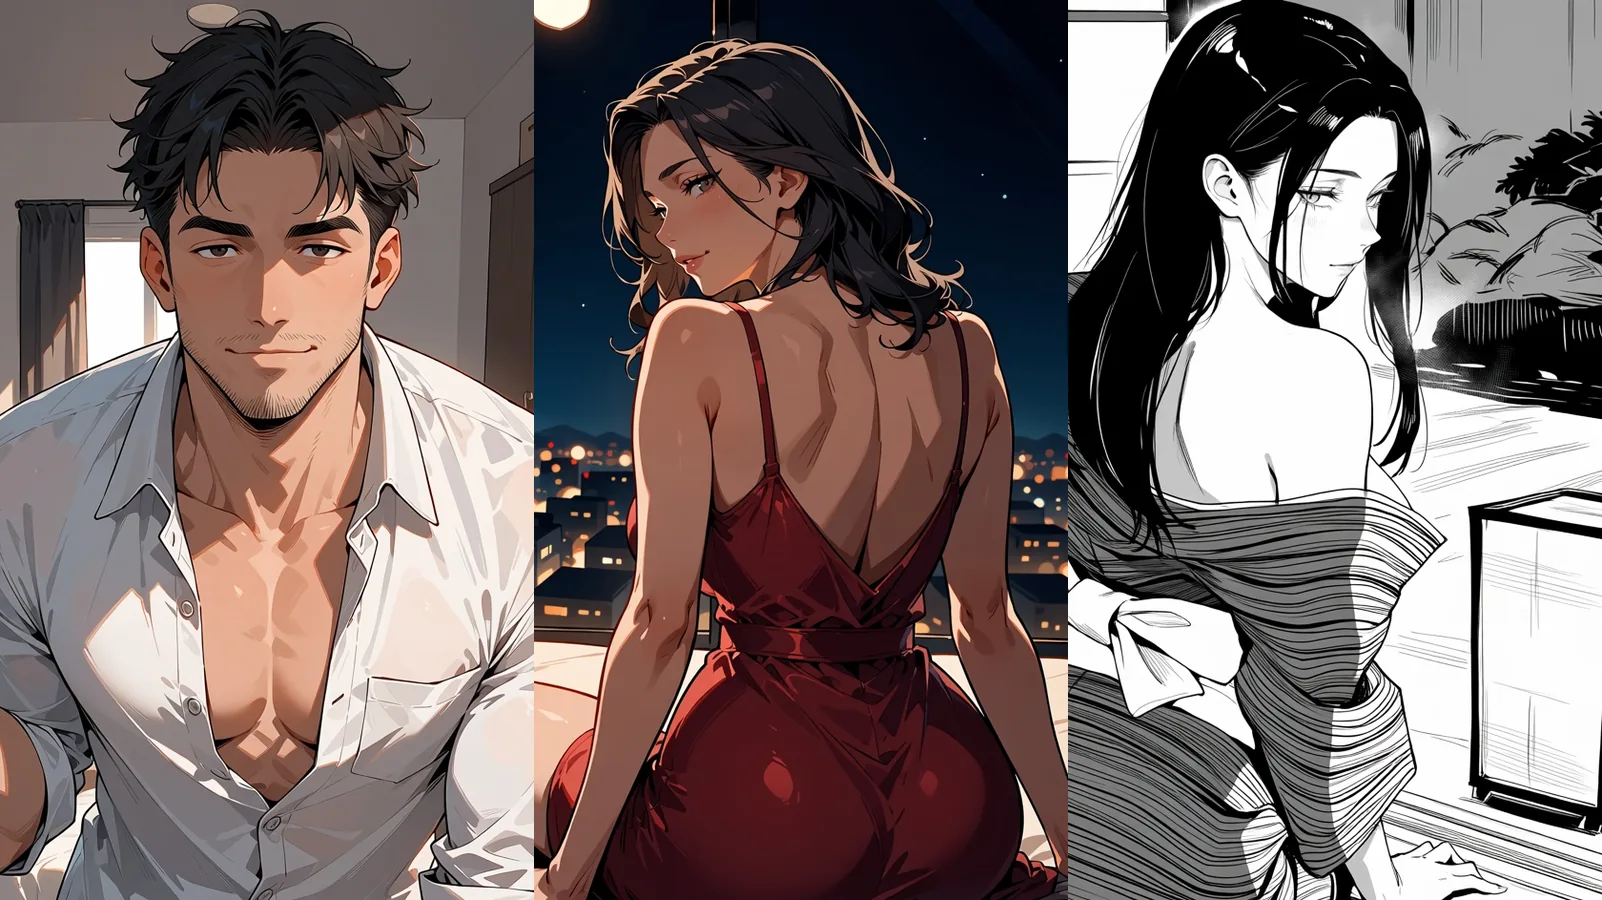
Relatar com honestidade é mostrar os erros. O nosso prompt de arte principal, uma mulher adulta de casaco carmesim em um terraço ao luar, saiu bem nos seeds 1 e 3 e mal no seed 2:
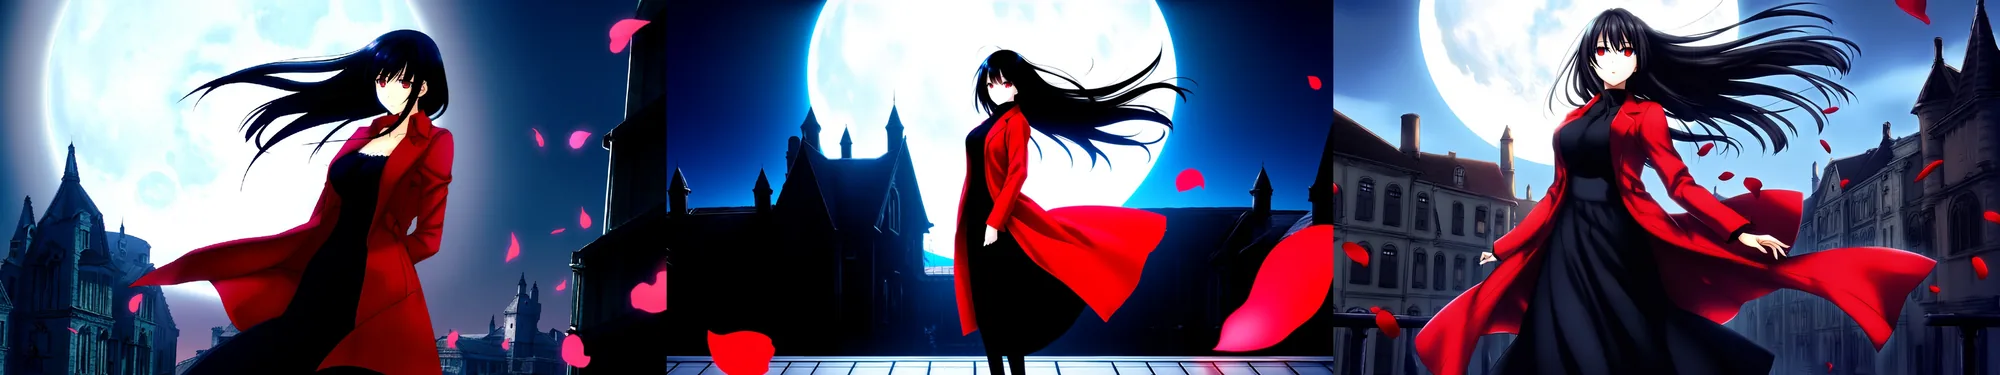
Um prompt, seeds 1, 2 e 3, 16:9. O seed 2 (no meio) transformou a mulher em uma figura pequena diante de uma silhueta.
As poses de ação são o canto menos confiável. O prompt que nos deu um chute voador limpo no seed 1 embaralhou os membros no seed 2:
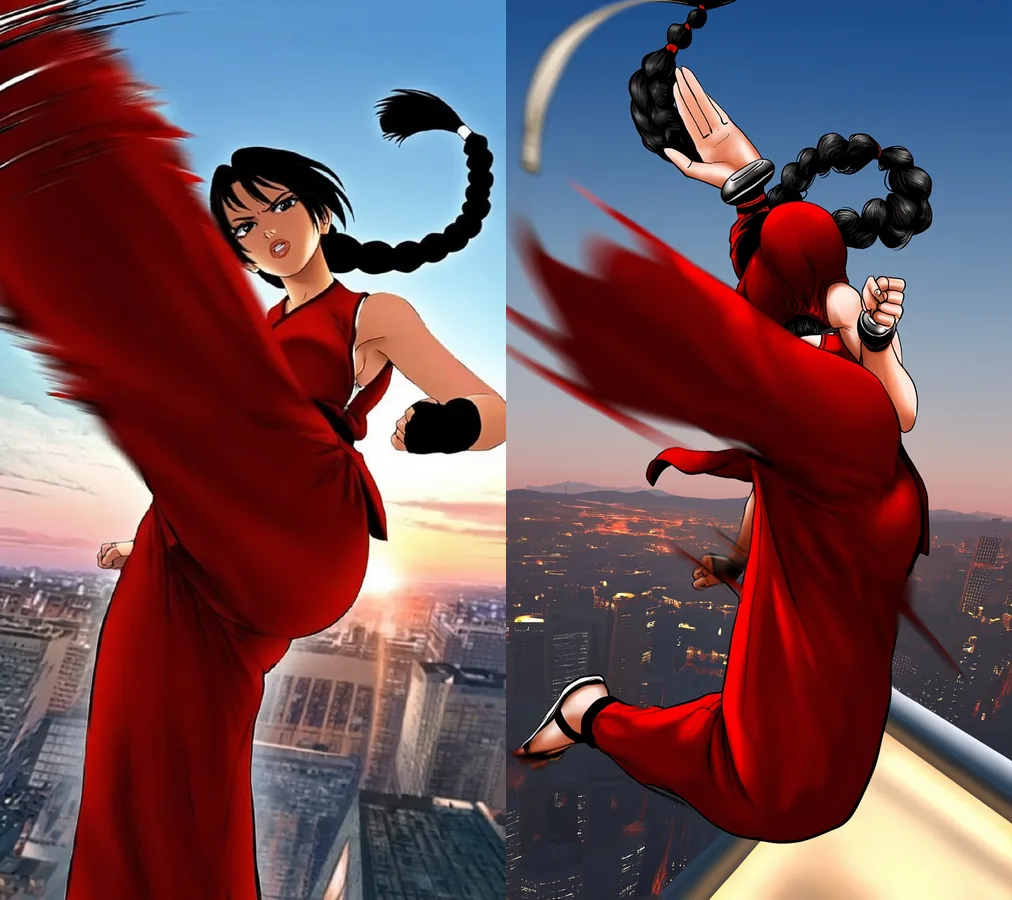
À esquerda: seed 1. À direita: seed 2. 9:16, mesmo prompt.
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingAté a pianista varia. Dois seeds do mesmo prompt deram dois salões e poses diferentes:
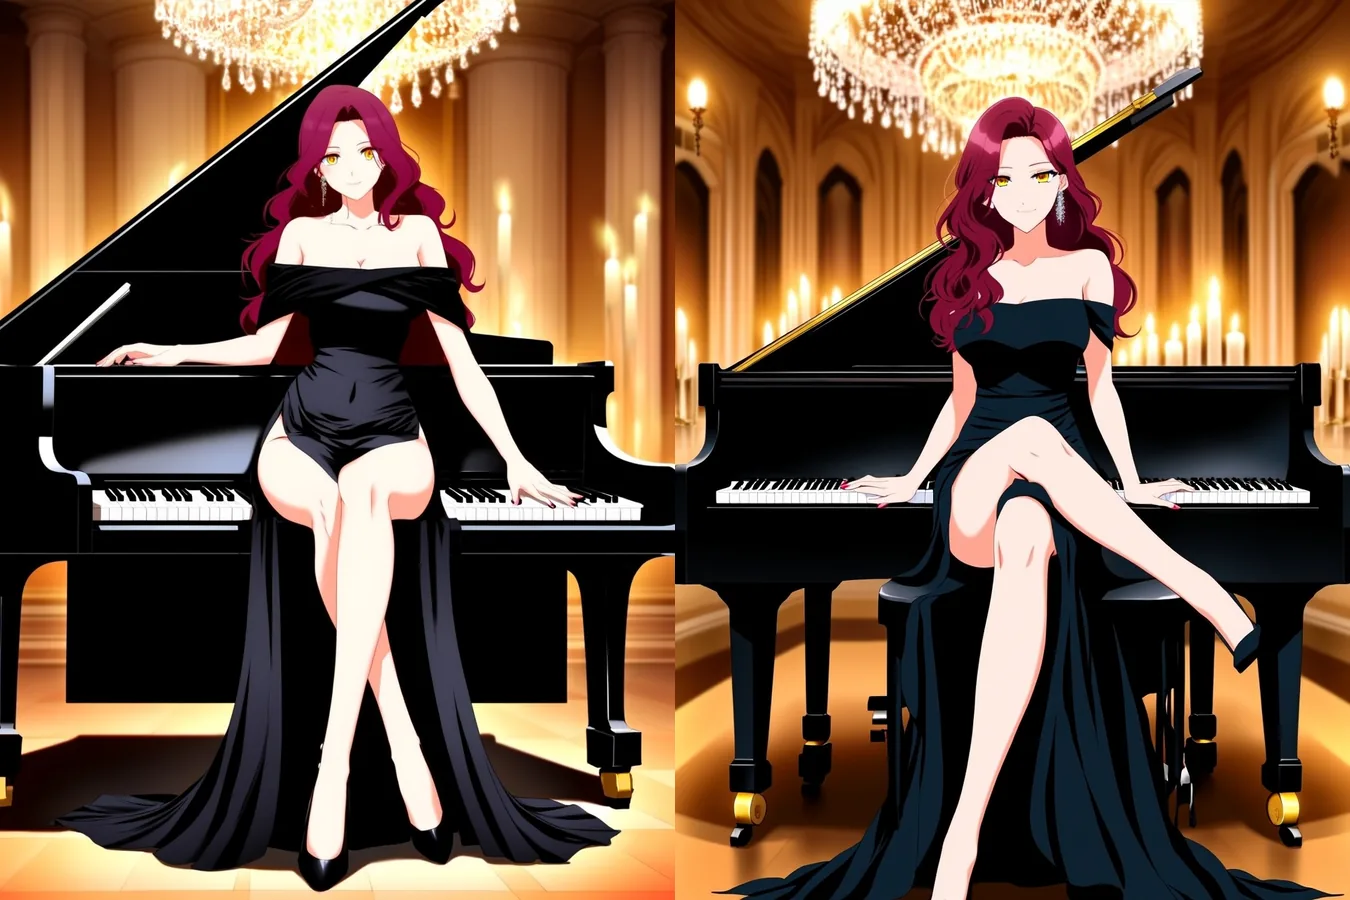
O prompt da pianista, seeds 1 e 2, 3:4.
Limites
- Lento. De 13 a 75 segundos por imagem, mediana de 40.
- Sem prompt negativo, passos, guidance nem sampler. Os campos públicos são
prompt,aspect_ratio,output_formateseed. - Somente texto para imagem. Não há entrada de imagem nem espaço para LoRA.
- Uma imagem por requisição.
- Artefatos ocasionais. O modelo às vezes adiciona um rabisco parecido com uma assinatura ou uma mancha pixelada aprendida com a arte do treinamento. Um seed novo resolve.
- Poses de ação pedem novas tentativas. Planeje dois ou três seeds.
Neta Lumina, Anima Turbo e Prefect Pony XL
Os três são modelos de anime sem censura na SpicyAPI. As linhas abaixo usam apenas o que medimos em 5 de outubro de 2026 para o Neta Lumina e o Anima Turbo, e o que está publicado nas páginas do modelo para o Prefect Pony XL, que testamos pela última vez em uma execução interna anterior, em 18 de setembro de 2026.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| O que é | Ajuste fino do Lumina-Image-2.0 pelo Neta.art Lab | CircleStone Labs, 2B de parâmetros, versão Turbo destilada | Checkpoint de anime da comunidade da linhagem Pony XL |
| Estilo de prompt | Tags, frases ou os dois | Tags do Danbooru, também lê frases | Tags no estilo Pony |
| Proporções | 9 com cerca de um megapixel | 15, em faixas de 1k e 1.5k | 7 tamanhos nativos do SDXL |
| Velocidade nos nossos testes | De 13 a 75 s, mediana de 40 | De 2 a 16 s, 52 de 60 abaixo de 10 | Não medido nesta rodada |
| Imagem para imagem | Não | Sim, no endpoint de imagem para imagem | Não |
| LoRAs | Não | Não na família base; a irmã com LoRA aceita até três | Não |
| Prompt negativo | Não | Não | Não coberto aqui |
| Conteúdo nos nossos testes | Os cinco níveis entregues | A sonda de conteúdo mais forte foi renderizada como escrita na primeira tentativa | Três níveis de sonda até o L4 renderizados na execução de 18 de setembro |
| Formato de saída | JPEG, PNG ou WebP | JPEG | Veja a página do modelo |
Escolha o Neta Lumina quando quiser um modelo de anime que siga uma frase descritiva longa e você puder esperar. Escolha o Anima Turbo para rascunhos rápidos, imagem para imagem ou LoRAs. Escolha o Prefect Pony XL se os seus prompts já vêm do ecossistema Pony. O nosso panorama dos modelos de anime NSFW cobre o cenário mais amplo.
Quem deve usar
Use o Neta Lumina para artes principais, pôsteres, designs de personagem e quadros de storyboard em que você vai rodar alguns seeds e ficar com o melhor. Deixe de lado se você precisa de velocidade, edição, prompt negativo ou uma LoRA de estilo. Comece pela página de texto para imagem.
FAQ
O Neta Lumina é sem censura?
Sim. A plataforma não adiciona nenhum filtro de conteúdo e, na nossa escada de cinco níveis, do L1 Sugestivo ao L5 Extremo, todos os níveis foram entregues, sem recusa e sem imagem substituída. O próprio modelo desenhou uma pequena tarja de mosaico no prompt de contenção do L5, algo que parece ter aprendido com a arte do seu treinamento.
Ele usa tags ou frases?
Os dois. Tags no estilo Danbooru funcionaram para a pianista e frases simples funcionaram para o homem da janela de neon. Use tags para um visual preciso e uma frase para câmera, luz e clima.
Preciso da linha de abertura de quem publica?
Não. Com e sem "You are an assistant designed to generate anime images based on textual prompts." saíram imagens quase idênticas no mesmo seed.
Por que ele é mais lento que os outros modelos de imagem daqui?
Medimos de 13 a 75 segundos de tempo de modelo em 31 execuções, mediana de 40, e o tamanho da imagem não explicou a dispersão. Envie variações em paralelo e fixe o seed enquanto compara.
Que tamanhos ele aceita?
Nove proporções com cerca de um megapixel, de 1024 x 1024 em 1:1 a 1536 x 864 em 16:9 e 1536 x 656 em 21:9. Todas as saídas corresponderam ao tamanho pedido no nosso teste.
Posso usar LoRAs ou uma imagem de origem?
Não. Este endpoint é somente texto para imagem. Para LoRAs ou imagem para imagem em um modelo de anime, veja o Anima Turbo LoRA e o endpoint de imagem para imagem do Anima Turbo.
O mesmo seed garante a mesma imagem?
Não. Os seeds mantêm as execuções comparáveis, mas trate uma repetição como parecida, não como garantida.