Neta Lumina est un modèle d’anime sans censure qui comprend les tags Danbooru comme les phrases simples ; dans nos tests, il a rendu chaque palier de notre échelle de contenu, sans refus ni substitution. Cette liberté se paie en temps : sur 31 exécutions le 5 octobre 2026, une image a pris de 13 à 75 secondes, avec une médiane de 40 et aucune sous les dix secondes. Il n’a pas non plus de prompt négatif, d’image en entrée ni d’emplacement LoRA.
Neta Lumina est conçu par Neta.art Lab. C’est un fine-tune de Lumina-Image-2.0 d’Alpha-VLLM avec un encodeur de texte Gemma 2B, publié sur SpicyAPI sous le nom neta-art/neta-lumina/text-to-image. Chaque prompt reproduit ci-dessous est une scène du quotidien avec des adultes habillés. La page de la famille Neta Lumina indique le tarif en vigueur par image.
En un coup d’œil
| Neta Lumina (testé le 5 octobre 2026) | |
|---|---|
| Éditeur et base | Neta.art Lab ; fine-tune de Lumina-Image-2.0 avec un encodeur de texte Gemma 2B et le VAE de FLUX |
| Nom du modèle dans l’API | neta-art/neta-lumina/text-to-image (texte vers image uniquement) |
| Champs publics | prompt (jusqu’à 5 000 caractères), aspect_ratio, output_format, seed |
| Rapports d’aspect | 9, tous d’environ un mégapixel : 1024 x 1024 en 1:1, 1536 x 864 en 16:9, 1536 x 656 en 21:9 |
| Sortie | Une image par requête en JPEG (par défaut), PNG ou WebP |
| Vitesse dans nos tests | De 13 à 75 secondes par image sur 31 exécutions, médiane 40, aucune sous 10 secondes |
| Politique de contenu | Sans censure, aucun filtre de contenu ; les cinq paliers de notre échelle ont été rendus |
| Ne sait pas faire | Prompt négatif, étapes, guidance, sampler, image en entrée, LoRA, plus d’une image par requête |
Ce qu’est Neta Lumina
L’éditeur décrit Neta Lumina comme un modèle d’image de haute qualité dans le style anime. La fiche Hugging Face sur huggingface.co/neta-art/Neta-Lumina indique qu’il excelle dans l’illustration d’anime, les affiches, les storyboards et la conception de personnages, avec une large couverture de personnages et de styles. L’éditeur affirme que sa compréhension des prompts est précise même pour les prompts complexes, que les tags Danbooru sont pris en charge et que le chinois, l’anglais et le japonais sont les langues recommandées. Nous n’avons testé que l’anglais.
La question de la version mérite une phrase. Le dépôt de l’éditeur date de juin 2025 et sa v1.0 « official release » a été mise en ligne le 22 juillet 2025. La route hébergée n’indique pas de version : nous ne pouvons donc pas dire quelle build a répondu à nos requêtes, et nous n’avons pas essayé de le deviner à partir des images.
Deux choses le distinguent de l’autre modèle d’anime que nous avons passé en revue cette semaine, Anima Turbo. Il comprend les phrases descriptives complètes au moins aussi bien que les tags, et il est lent. Le tableau vers la fin les met côte à côte avec Prefect Pony XL.
Tags, phrases ou les deux
Le guide de prompt de l’éditeur suggère un ordre : personnages, style, apparence, vêtements, expression et action, caméra, éclairage, ambiance, puis tags de qualité. Il suggère aussi une phrase d’ouverture fixe facultative, « You are an assistant designed to generate anime images based on textual prompts. » Nous avons lancé un même prompt deux fois avec la même seed, une fois avec cette phrase et une fois sans.
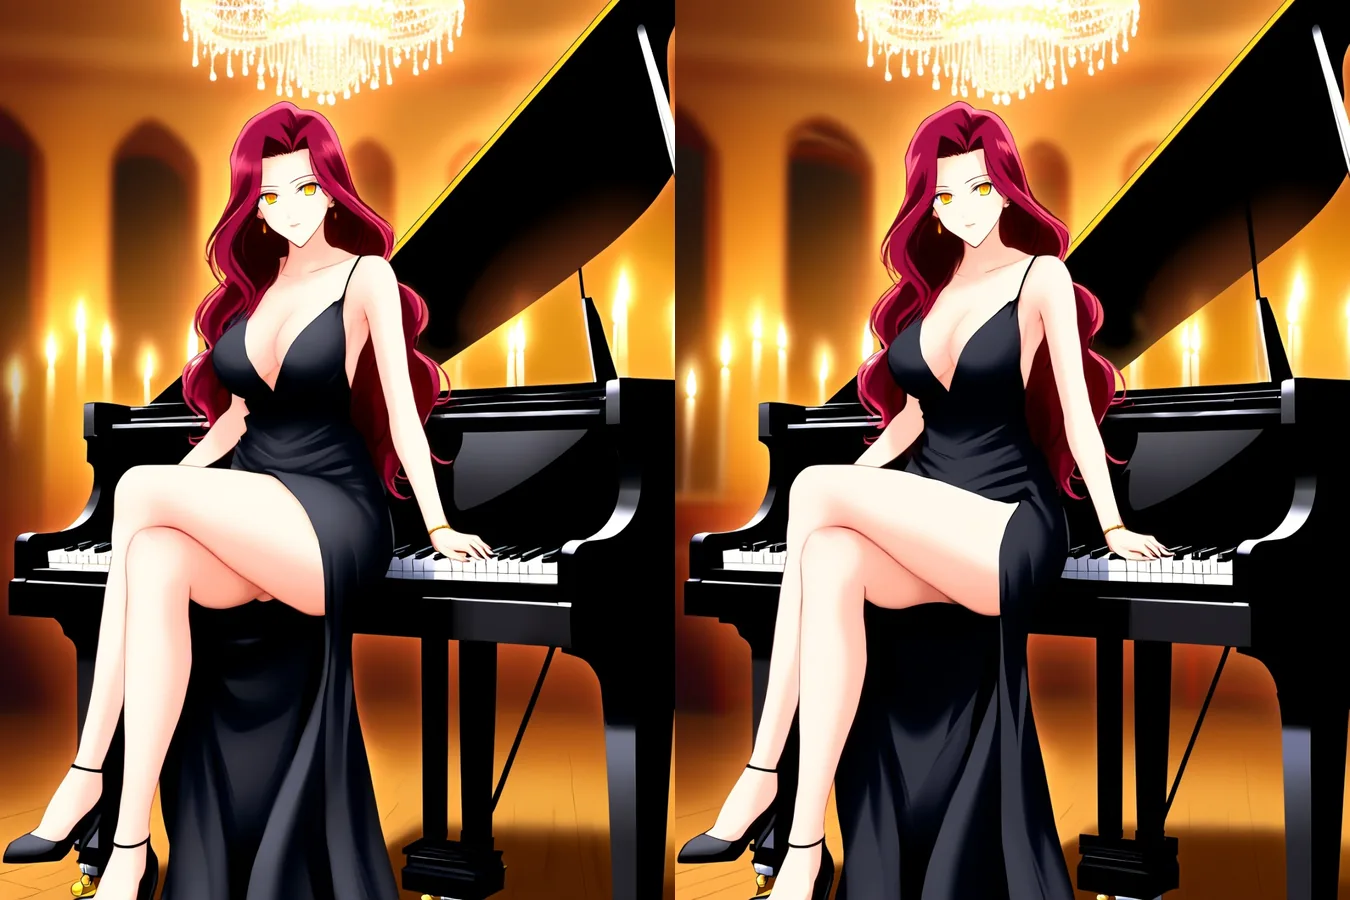
À gauche : avec la phrase d’ouverture de l’éditeur. À droite : sans. Même prompt, seed 5, 3:4, texte vers image.
Les deux images sont presque identiques : sur ce point d’accès, la phrase d’ouverture n’est donc pas nécessaire. Le prompt qui a dessiné la pianiste était une simple liste de tags :
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileLes phrases fonctionnent tout aussi bien. Celle-ci a dessiné un homme avec une cicatrice, une chemise déboutonnée et des reflets néon sans un seul tag :
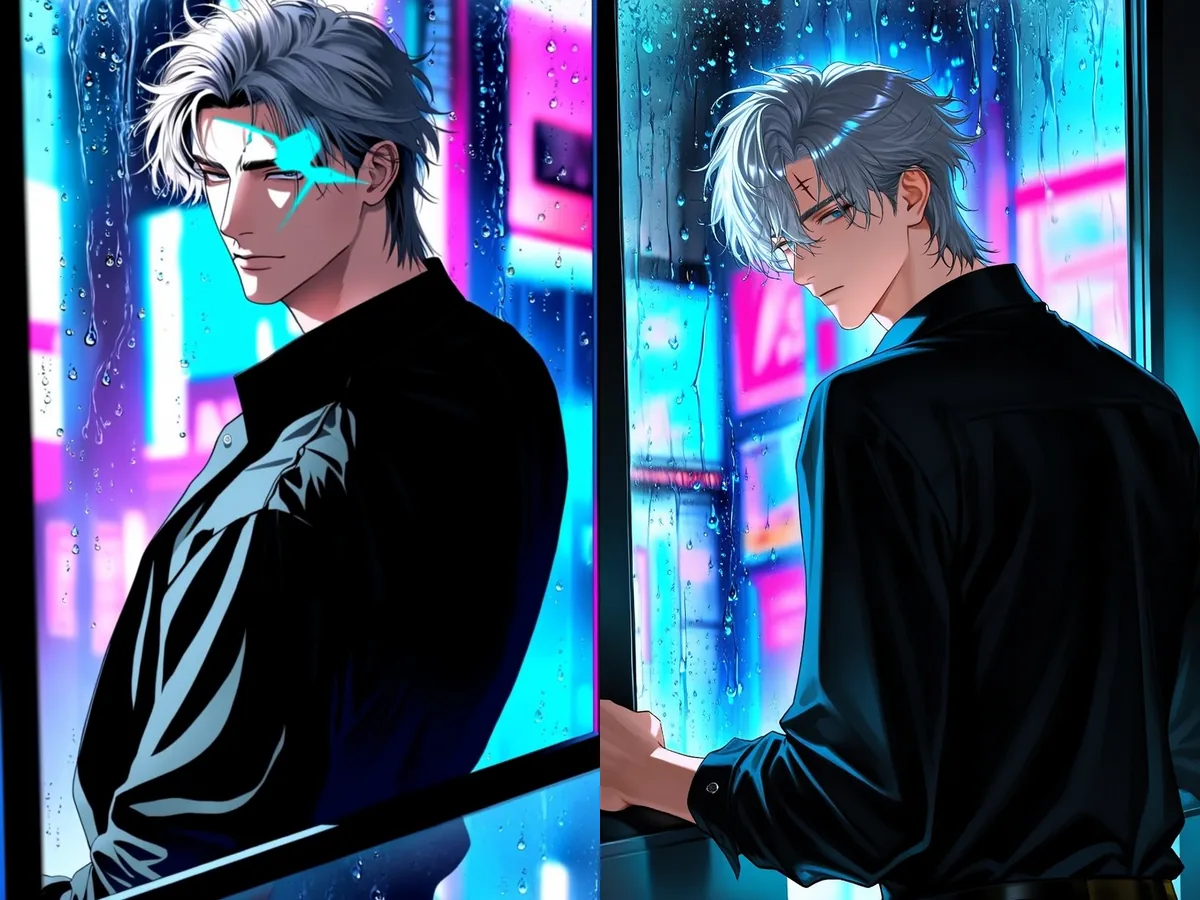
Les mêmes trois phrases, seeds 1 et 2, 2:3. La seed 2 (à droite) est l’exemple publié ; la seed 1 a dessiné une marque cyan lumineuse parasite en travers du visage.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.Dans nos tests, la cicatrice, la chemise et la lumière cyan et magenta se retrouvent sur les deux seeds. Ce qui a changé d’une seed à l’autre, c’est l’exécution : une marque parasite dans l’une, un visage propre dans l’autre. C’est le schéma sur l’ensemble de ce modèle, et c’est pourquoi nous recommandons de lancer deux ou trois seeds de tout prompt qui vous importe.
| Situation | Meilleur choix | Pourquoi, dans nos essais |
|---|---|---|
| Un rendu précis : cheveux, yeux, tenue, décor | Tags | Chaque tag est une instruction à part, et la pianiste a gardé chaque détail |
| Position de la caméra, direction de la lumière, relation entre deux personnes | Phrases | L’homme à la fenêtre néon a suivi les trois phrases |
| Deux personnages | D’abord les tags de nombre de personnes, puis une expression par personne | Dans le couple au bord de la mer, sa robe d’été et sa chemise ouverte sont restées avec la bonne personne |
| Vous voulez du contrôle et de l’ambiance | Un en-tête de tags plus une ou deux phrases | Un mélange est ce que nous essaierions en premier |
Formats, types de fichiers et seeds
Il n’y a pas de champ de taille. Vous choisissez l’un des neuf rapports d’aspect, et chacun correspond à une taille fixe d’environ un mégapixel. Nous avons lancé chaque rapport une fois et chaque sortie est revenue exactement aux pixels demandés.
| Rapport | Taille | Rapport | Taille |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Les tailles suivent la recommandation de l’éditeur, d’environ un à 1,3 mégapixel. La sortie est en JPEG par défaut ; PNG et WebP ont tous deux fonctionné quand nous les avons demandés, et le format de sortie ne change rien d’autre. Vous pouvez aussi fixer une seed de 0 à 2 147 483 647.
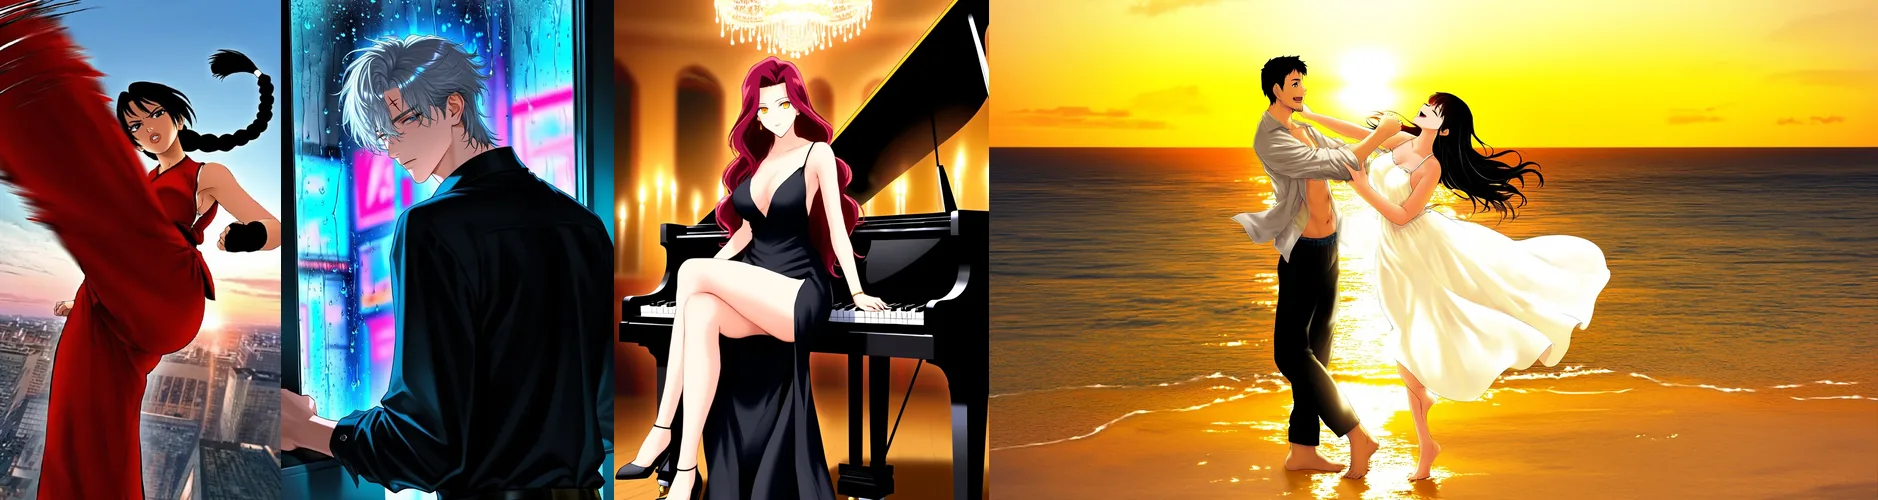
De gauche à droite : 9:16, 2:3, 3:4 et 16:9, tous en texte vers image.
Un cadre large convient aux scènes à deux personnes. Voici l’exemple publié en 16:9 :
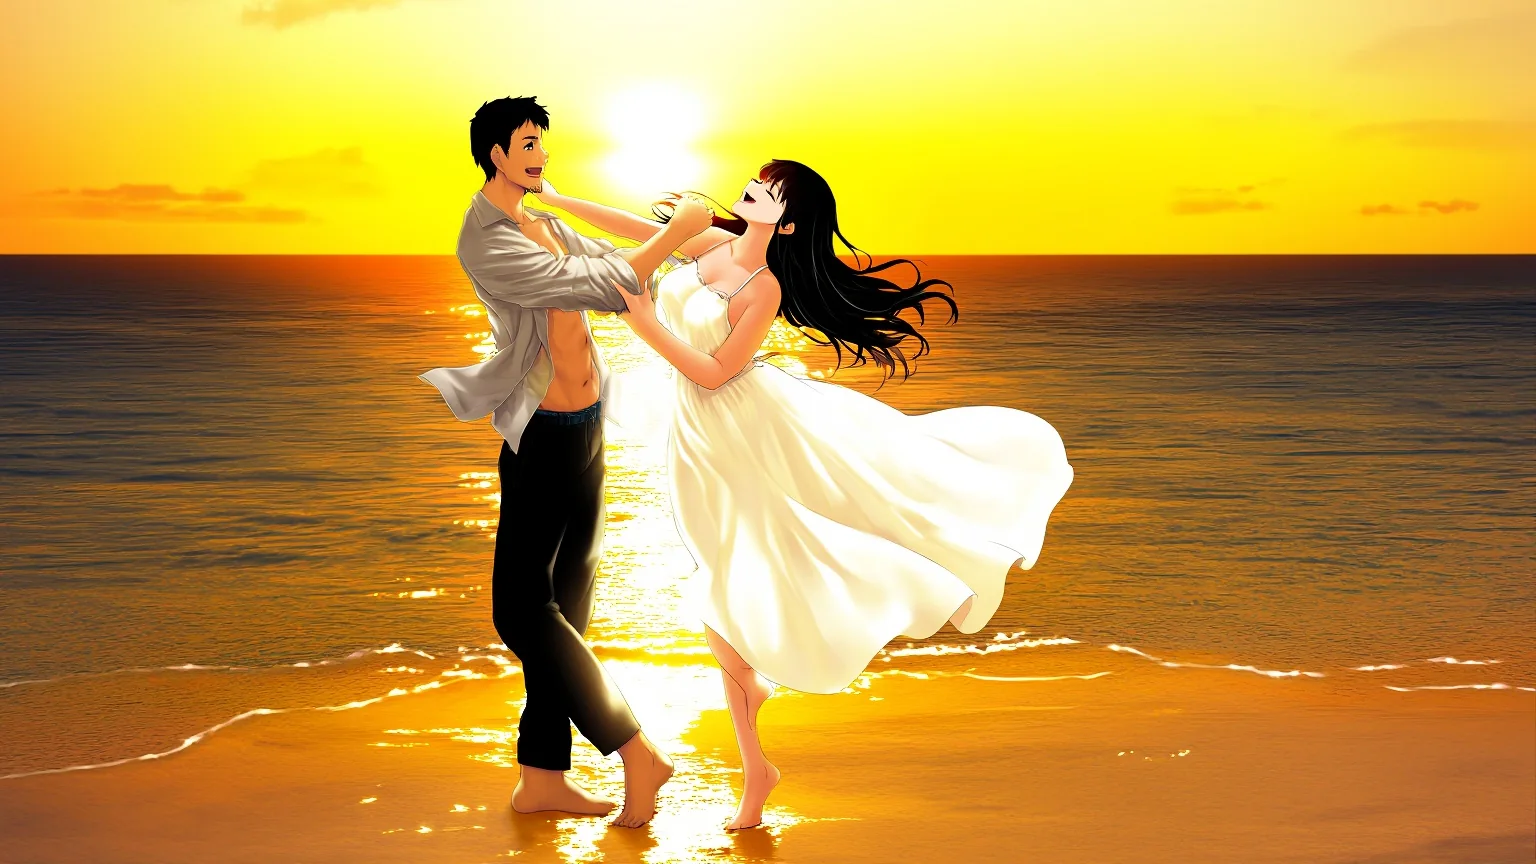
16:9, seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotLes seeds rendent les exécutions comparables, pas garanties identiques : servez-vous-en pour comparer deux retouches de prompt plutôt que pour promettre une refonte au pixel près.
Vitesse : prévoyez des lots
Nous avons chronométré 31 exécutions. Le temps de modèle allait de 13 à 75 secondes, la médiane était de 40, et aucune exécution ne s’est terminée en moins de dix secondes. La page d’hébergement de l’éditeur annonce environ 44 secondes, ce qui concorde. La taille n’explique pas l’écart : une image de 656 x 1536 a pris 13 secondes, tandis que des images de 960 x 1280 ont pris de 14 à 75.
Les conséquences pratiques : ne construisez pas un champ « tapez et voyez » en direct dessus, envoyez des variantes en parallèle et gardez la seed fixe pendant que vous les comparez. Si vous avez besoin de brouillons en quelques secondes, Anima Turbo a terminé 52 exécutions sur 60 en moins de dix.
Jusqu’où ça va
La plateforme n’ajoute aucun filtre de contenu : ce que vous obtenez dépend donc du modèle et du prompt. Nous avons lancé un prompt par échelon de notre échelle en cinq paliers, en 3:4 avec la seed 1, et chaque prompt précisait que les personnages sont adultes. Nous avons regardé chaque image.
| Palier | Ce que nous avons demandé | Ce qui est revenu |
|---|---|---|
| L1 Suggestif | Lingerie, une bretelle qui glisse | Rendu |
| L2 Thèmes matures | Partiellement dévoilé | Rendu, y compris sur les neuf rapports (9 sur 9) |
| L3 Fort | Contenu fort, féminin et masculin | Rendu, les deux |
| L4 Intense | Une scène intime entre deux adultes | Rendu comme écrit, sans aucune censure |
| L5 Extrême | Contrainte consentie entre adultes ; gore cinématographique | Les deux rendus |
Il n’y a eu ni refus ni image de substitution à aucun palier. Un détail mérite d’être connu pour le prompt de contrainte L5 : le modèle a dessiné une petite censure en mosaïque sur une zone. L4 n’en avait aucune. Nous y voyons une habitude apprise à partir de ses images d’entraînement plutôt qu’un filtre, puisque la plateforme n’ajoute rien et que la même zone n’était pas censurée ailleurs. Si vous voulez une sortie nette, dites-le dans le prompt, ou relancez.
Nous ne reproduisons pas les prompts de l’échelle, et la plateforme ne fournit jamais de prompts pour du contenu plus fort. Ce que nous pouvons dire, c’est que pour une demande ordinaire, le modèle se comporte comme un modèle d’anime doit le faire, et que pour une demande plus forte, il ne gêne pas. Comparez avec FLUX 3 et Ideogram v4.5, qui ont refusé presque tout ce qui dépassait une photo de maillot de bain neutre dans nos tests.
Ce qui a mal tourné
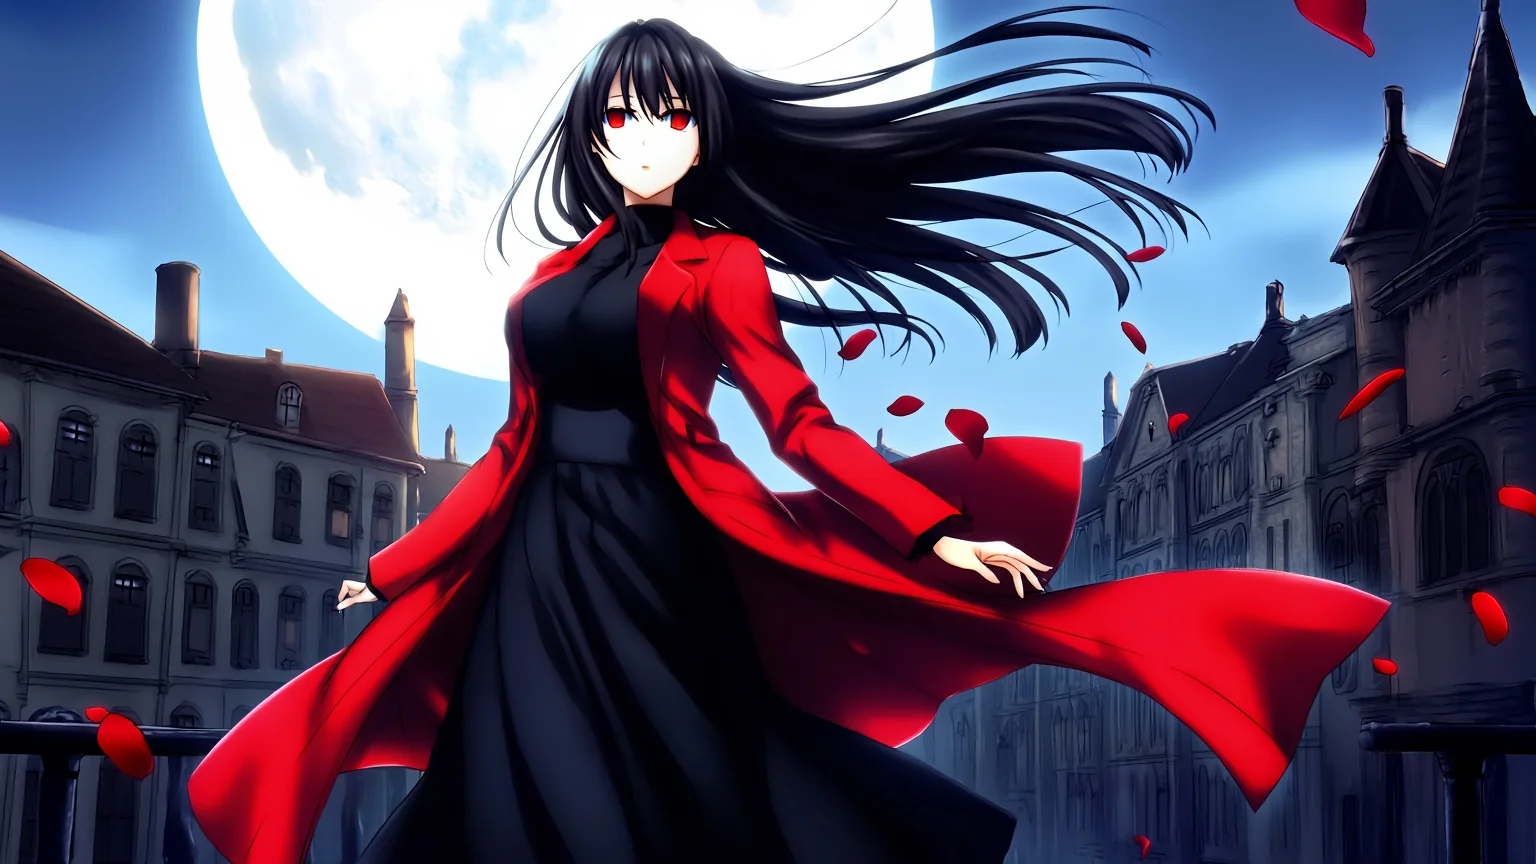
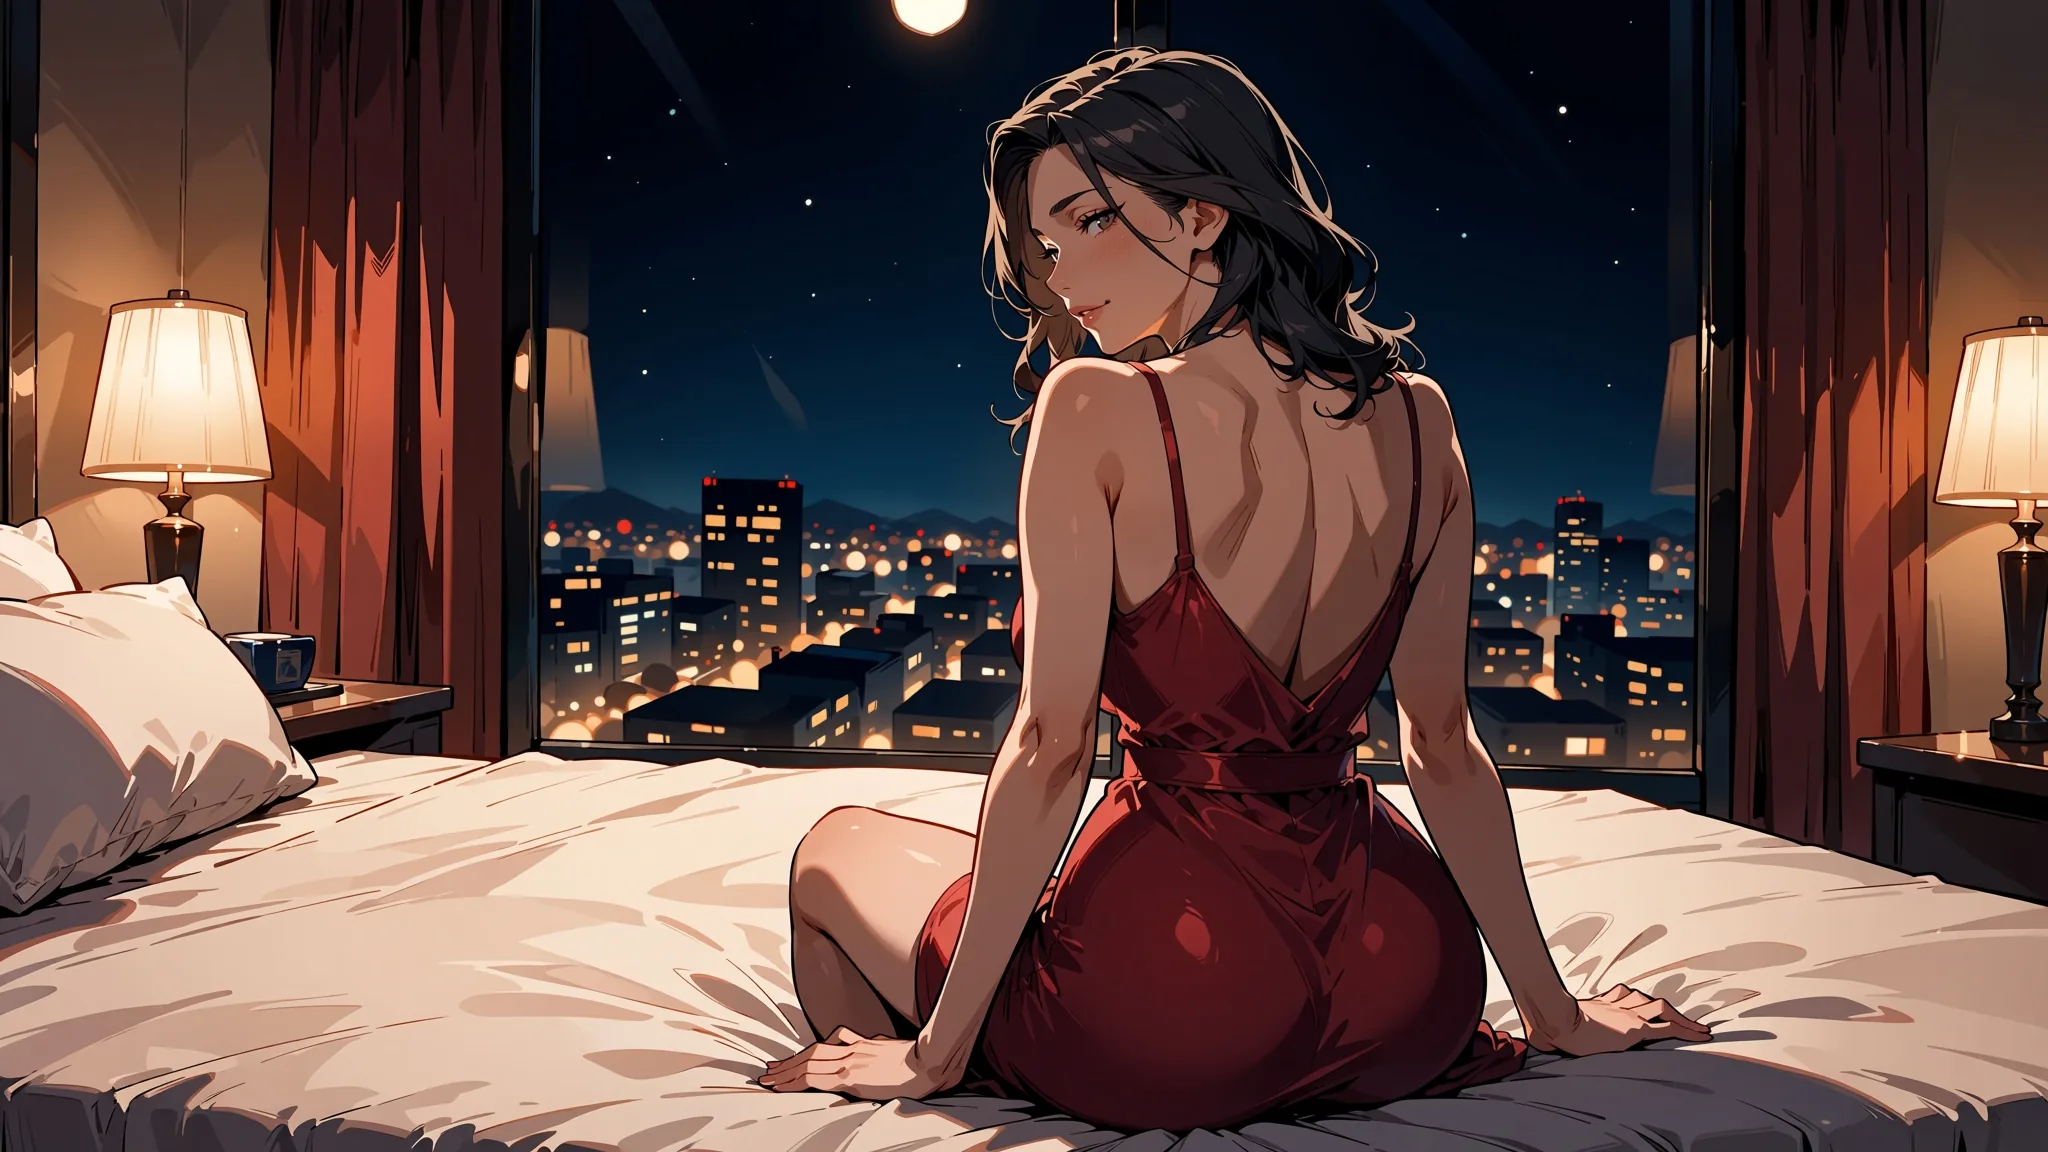
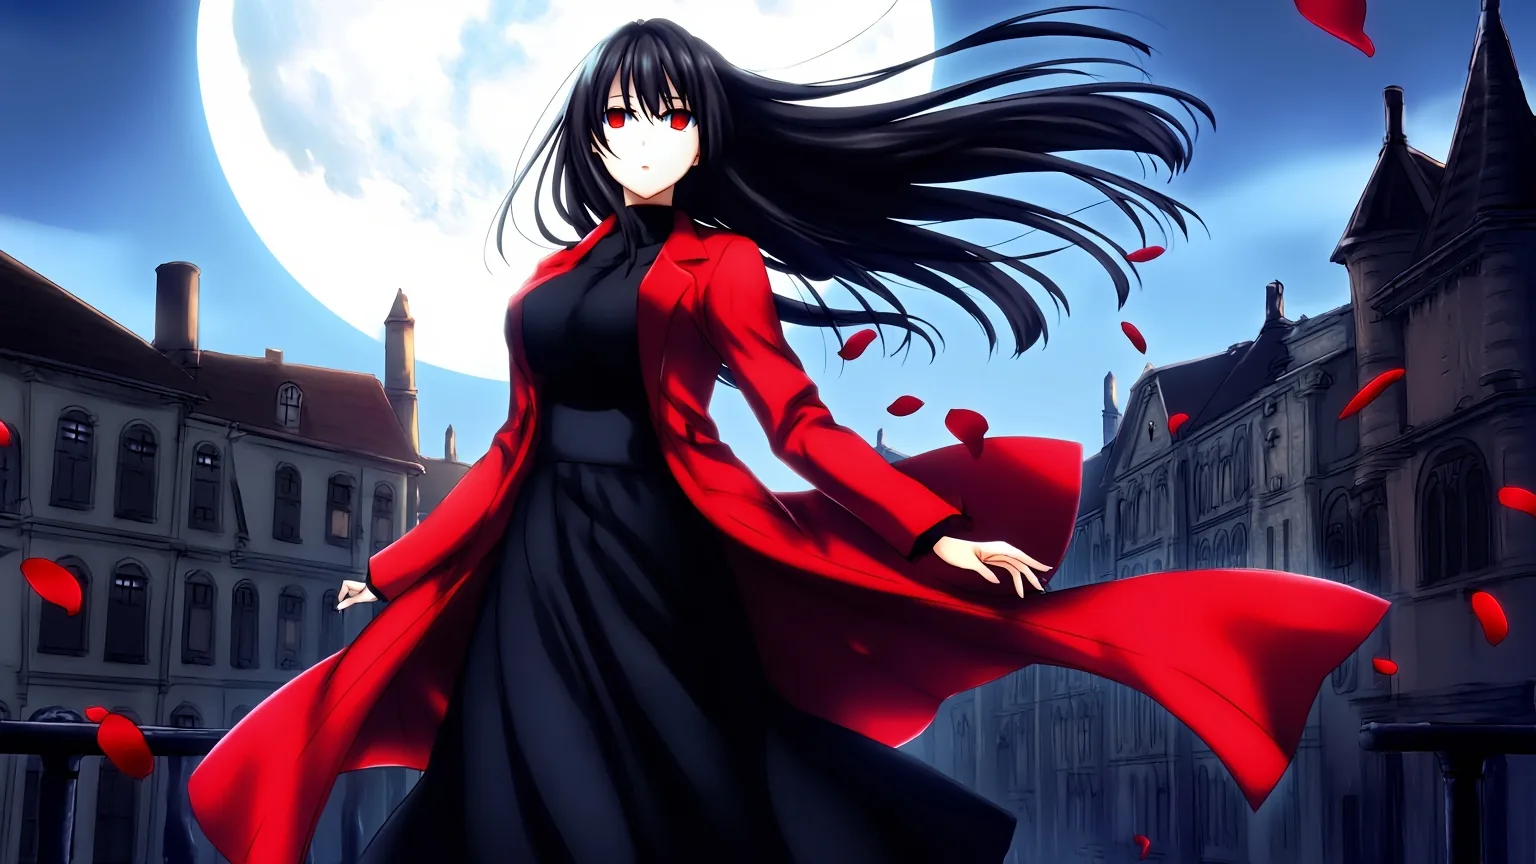
Un compte rendu honnête montre les ratés. Notre prompt d’illustration principale, une femme adulte en manteau carmin sur un toit au clair de lune, est bien sorti sur les seeds 1 et 3 et mal sur la seed 2 :
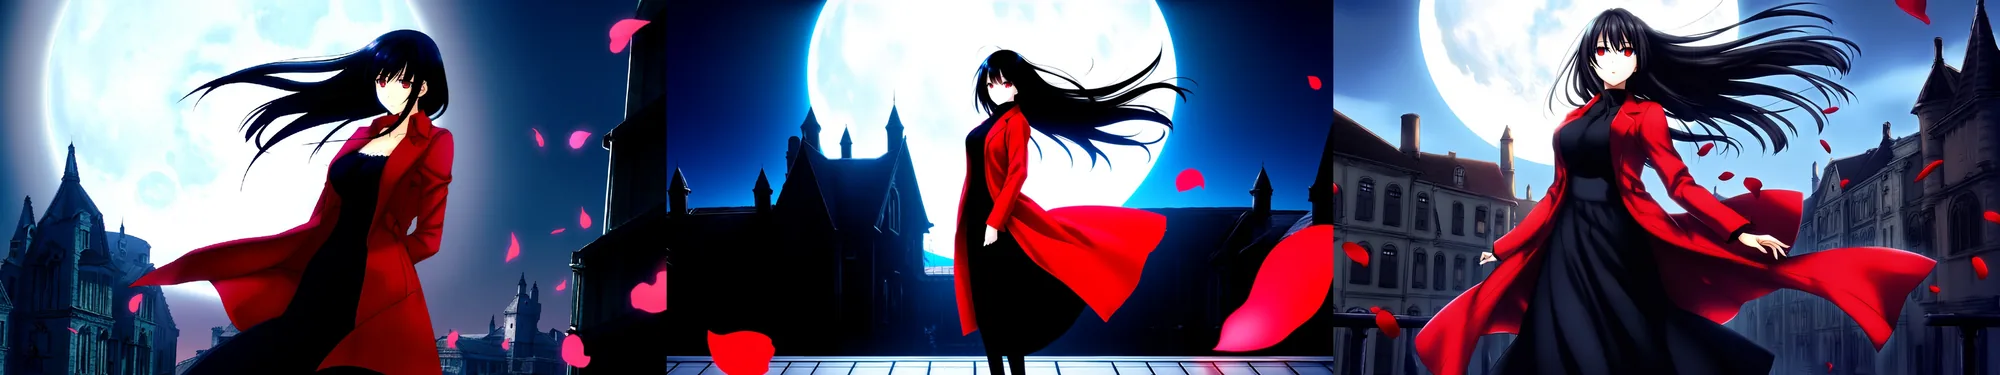
Un prompt, seeds 1, 2 et 3, 16:9. La seed 2 (au milieu) a transformé la femme en petite silhouette devant une ombre chinoise.
Les poses d’action sont le coin le moins fiable. Le prompt qui nous a donné un coup de pied sauté net sur la seed 1 a emmêlé les membres sur la seed 2 :
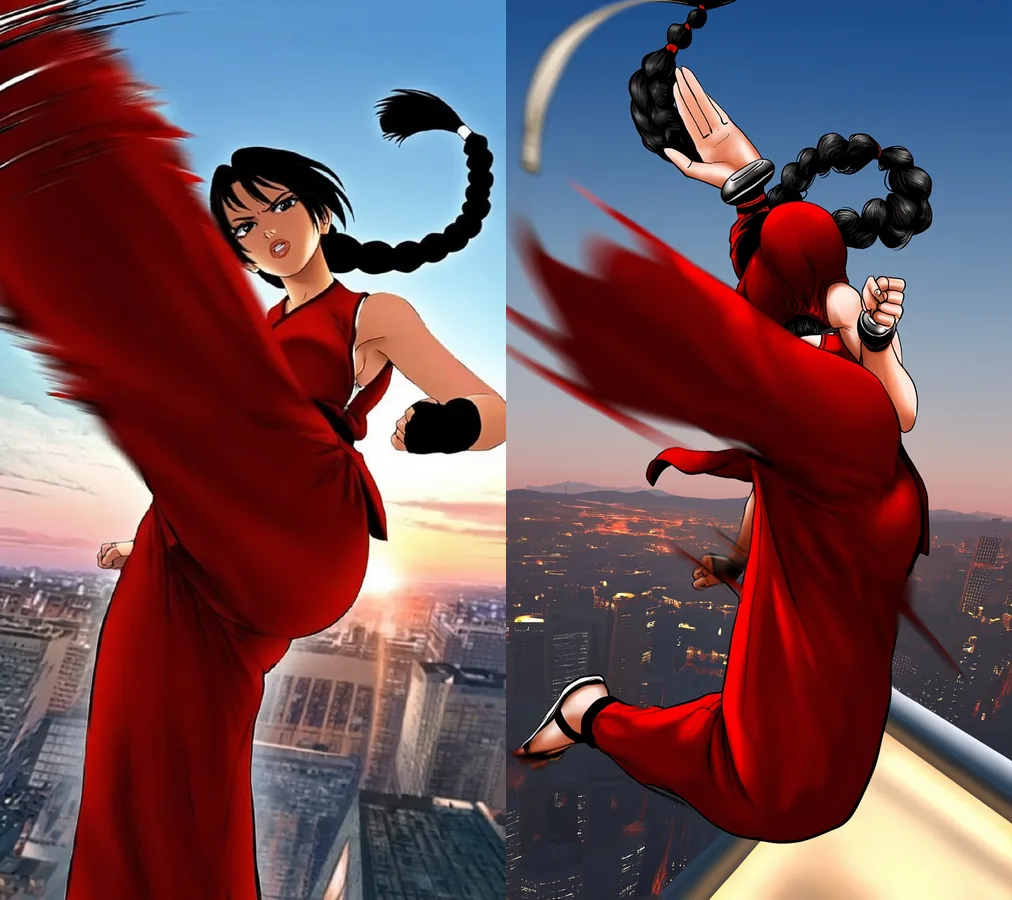
À gauche : seed 1. À droite : seed 2. 9:16, même prompt.
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingMême la pianiste varie. Deux seeds du même prompt ont donné deux pièces et deux poses différentes :
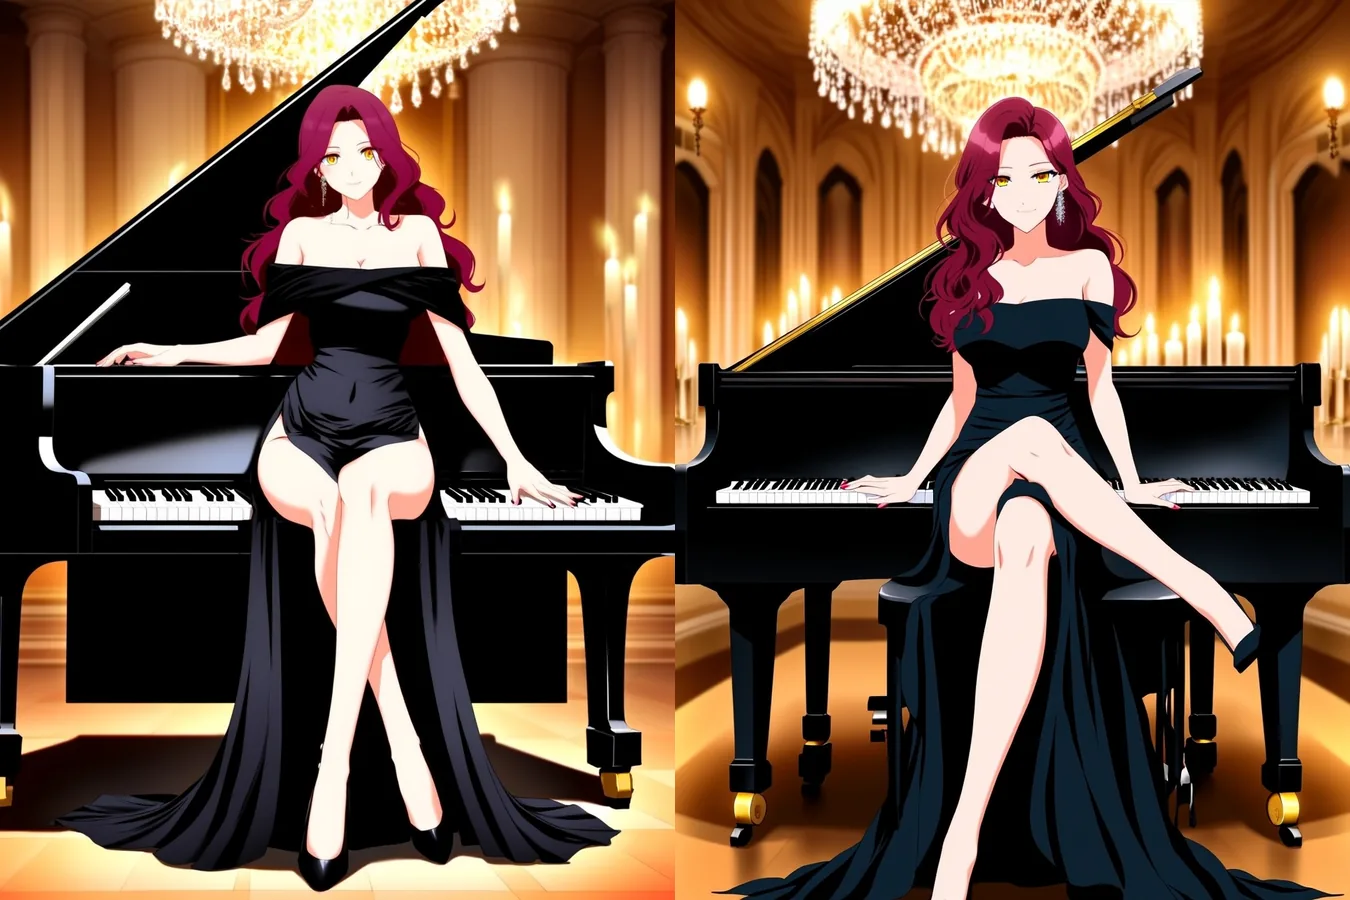
Le prompt de la pianiste, seeds 1 et 2, 3:4.
Limites
- Lent. De 13 à 75 secondes par image, médiane 40.
- Pas de prompt négatif, d’étapes, de guidance ni de sampler. Les champs publics sont
prompt,aspect_ratio,output_formatetseed. - Texte vers image uniquement. Il n’y a ni image en entrée ni emplacement LoRA.
- Une image par requête.
- Artefacts occasionnels. Le modèle ajoute parfois un gribouillis qui ressemble à une signature ou une zone pixellisée apprise de ses images d’entraînement. Une nouvelle seed règle le problème.
- Les poses d’action demandent des relances. Prévoyez deux ou trois seeds.
Neta Lumina, Anima Turbo et Prefect Pony XL
Ce sont trois modèles d’anime sans censure sur SpicyAPI. Les lignes ci-dessous n’utilisent que ce que nous avons mesuré le 5 octobre 2026 pour Neta Lumina et Anima Turbo, et ce qui est publié sur les pages de modèle pour Prefect Pony XL, que nous avons testé pour la dernière fois lors d’une exécution interne antérieure, le 18 septembre 2026.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| Ce que c’est | Fine-tune de Lumina-Image-2.0 par Neta.art Lab | CircleStone Labs, 2 milliards de paramètres, version Turbo distillée | Checkpoint d’anime communautaire de la lignée Pony XL |
| Style de prompt | Tags, phrases ou les deux | Tags Danbooru, comprend aussi les phrases | Tags de style Pony |
| Rapports d’aspect | 9 à environ un mégapixel | 15, sur les paliers 1k et 1.5k | 7 tailles natives SDXL |
| Vitesse dans nos tests | De 13 à 75 s, médiane 40 | De 2 à 16 s, 52 sur 60 sous 10 | Non mesurée dans cette série |
| Image vers image | Non | Oui, sur son point d’accès image vers image | Non |
| LoRA | Non | Pas sur la famille de base ; sa version LoRA en accepte jusqu’à trois | Non |
| Prompt négatif | Non | Non | Non traité ici |
| Contenu dans nos tests | Les cinq paliers rendus | La sonde de contenu la plus forte rendue comme écrit dès le premier essai | Trois niveaux de sonde jusqu’à L4 rendus lors de l’exécution du 18 septembre |
| Format de sortie | JPEG, PNG ou WebP | JPEG | Voir la page du modèle |
Choisissez Neta Lumina quand vous voulez un modèle d’anime qui suit une longue phrase descriptive et que vous pouvez attendre. Choisissez Anima Turbo pour des brouillons rapides, l’image vers image ou les LoRA. Choisissez Prefect Pony XL si vos prompts viennent déjà de l’écosystème Pony. Notre panorama des modèles d’anime NSFW couvre le champ plus large.
Pour qui
Utilisez Neta Lumina pour des illustrations principales, des affiches, des conceptions de personnages et des images de storyboard où vous lancerez une poignée de seeds et garderez la meilleure. Passez votre chemin si vous avez besoin de vitesse, de retouche, d’un prompt négatif ou d’une LoRA de style. Commencez sur la page texte vers image.
FAQ
Neta Lumina est-il sans censure ?
Oui. La plateforme n’ajoute aucun filtre de contenu, et dans notre échelle de cinq paliers, de L1 Suggestif à L5 Extrême, chaque palier a été rendu sans refus ni image de substitution. Le modèle lui-même a dessiné une petite censure en mosaïque sur le prompt de contrainte L5, qu’il semble avoir apprise de ses images d’entraînement.
Utilise-t-il des tags ou des phrases ?
Les deux. Les tags de style Danbooru ont fonctionné pour la pianiste et de simples phrases ont fonctionné pour l’homme à la fenêtre néon. Utilisez des tags pour un rendu précis et une phrase pour la caméra, la lumière et l’ambiance.
Ai-je besoin de la phrase d’ouverture de l’éditeur ?
Non. Avec et sans « You are an assistant designed to generate anime images based on textual prompts. », nous avons obtenu des images presque identiques sur la même seed.
Pourquoi est-il plus lent que les autres modèles d’image d’ici ?
Nous avons mesuré de 13 à 75 secondes de temps de modèle sur 31 exécutions, médiane 40, et la taille de l’image n’explique pas l’écart. Envoyez des variantes en parallèle et fixez la seed pendant que vous comparez.
Quels formats prend-il en charge ?
Neuf rapports d’aspect à environ un mégapixel, de 1024 x 1024 en 1:1 à 1536 x 864 en 16:9 et 1536 x 656 en 21:9. Chaque sortie correspondait à la taille demandée dans notre test.
Puis-je utiliser des LoRA ou une image source ?
Non. Ce point d’accès est uniquement texte vers image. Pour des LoRA ou de l’image vers image sur un modèle d’anime, regardez Anima Turbo LoRA et le point d’accès image vers image d’Anima Turbo.
La même seed garantit-elle la même image ?
Non. Les seeds gardent les exécutions comparables, mais considérez une répétition comme proche plutôt que garantie.