Introduction
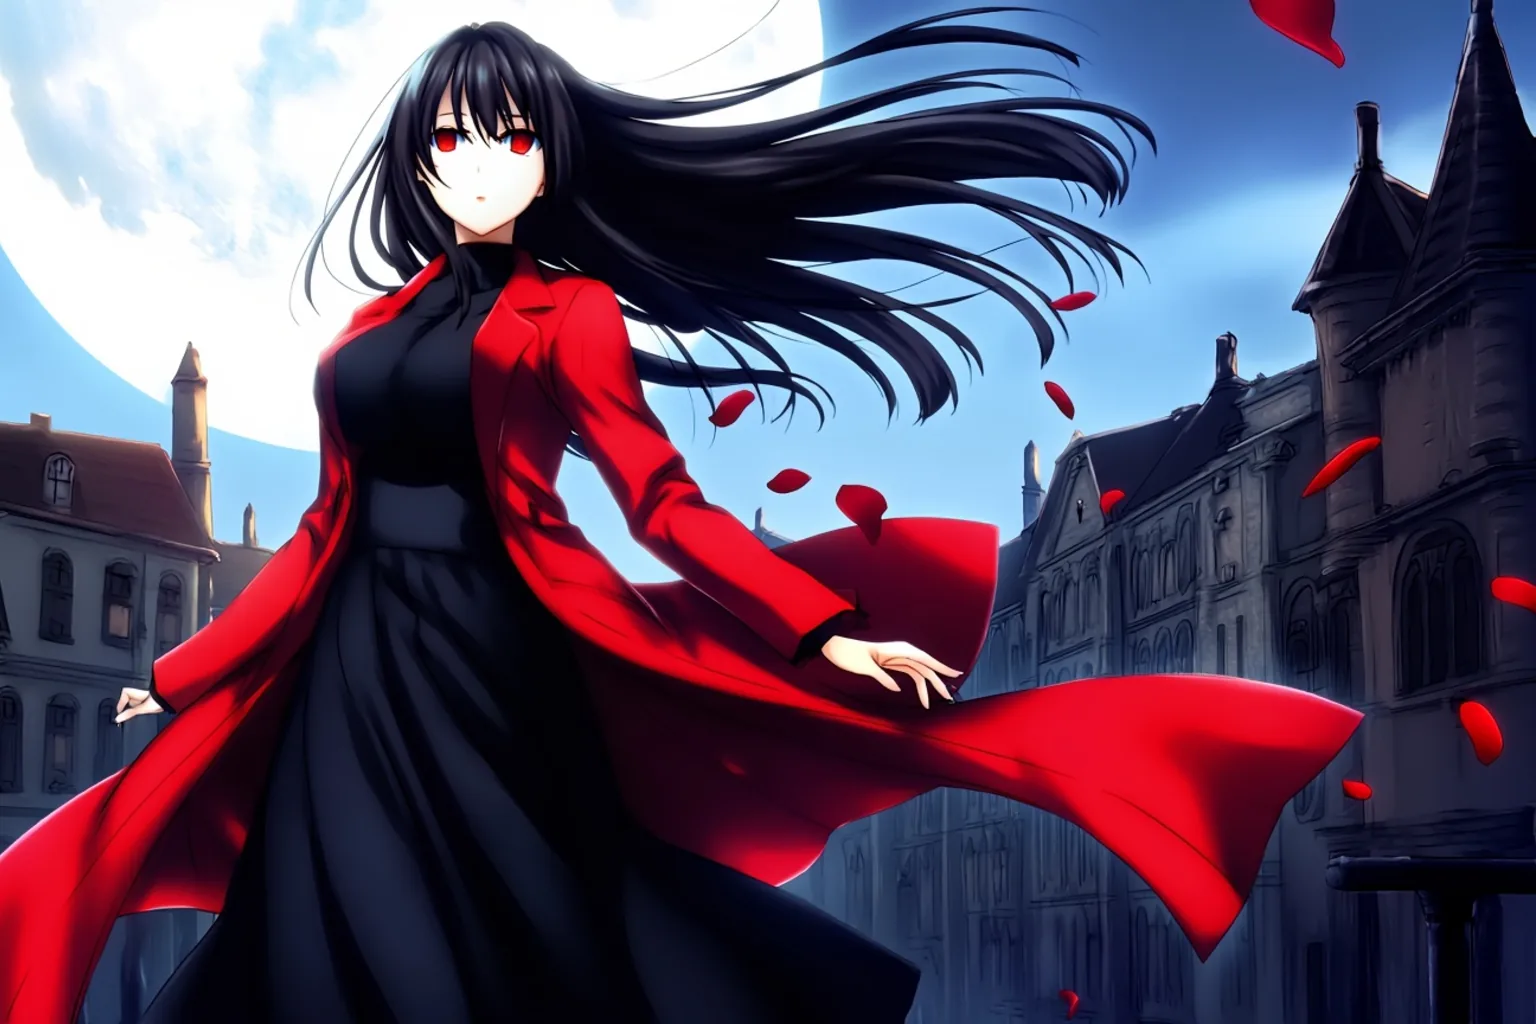
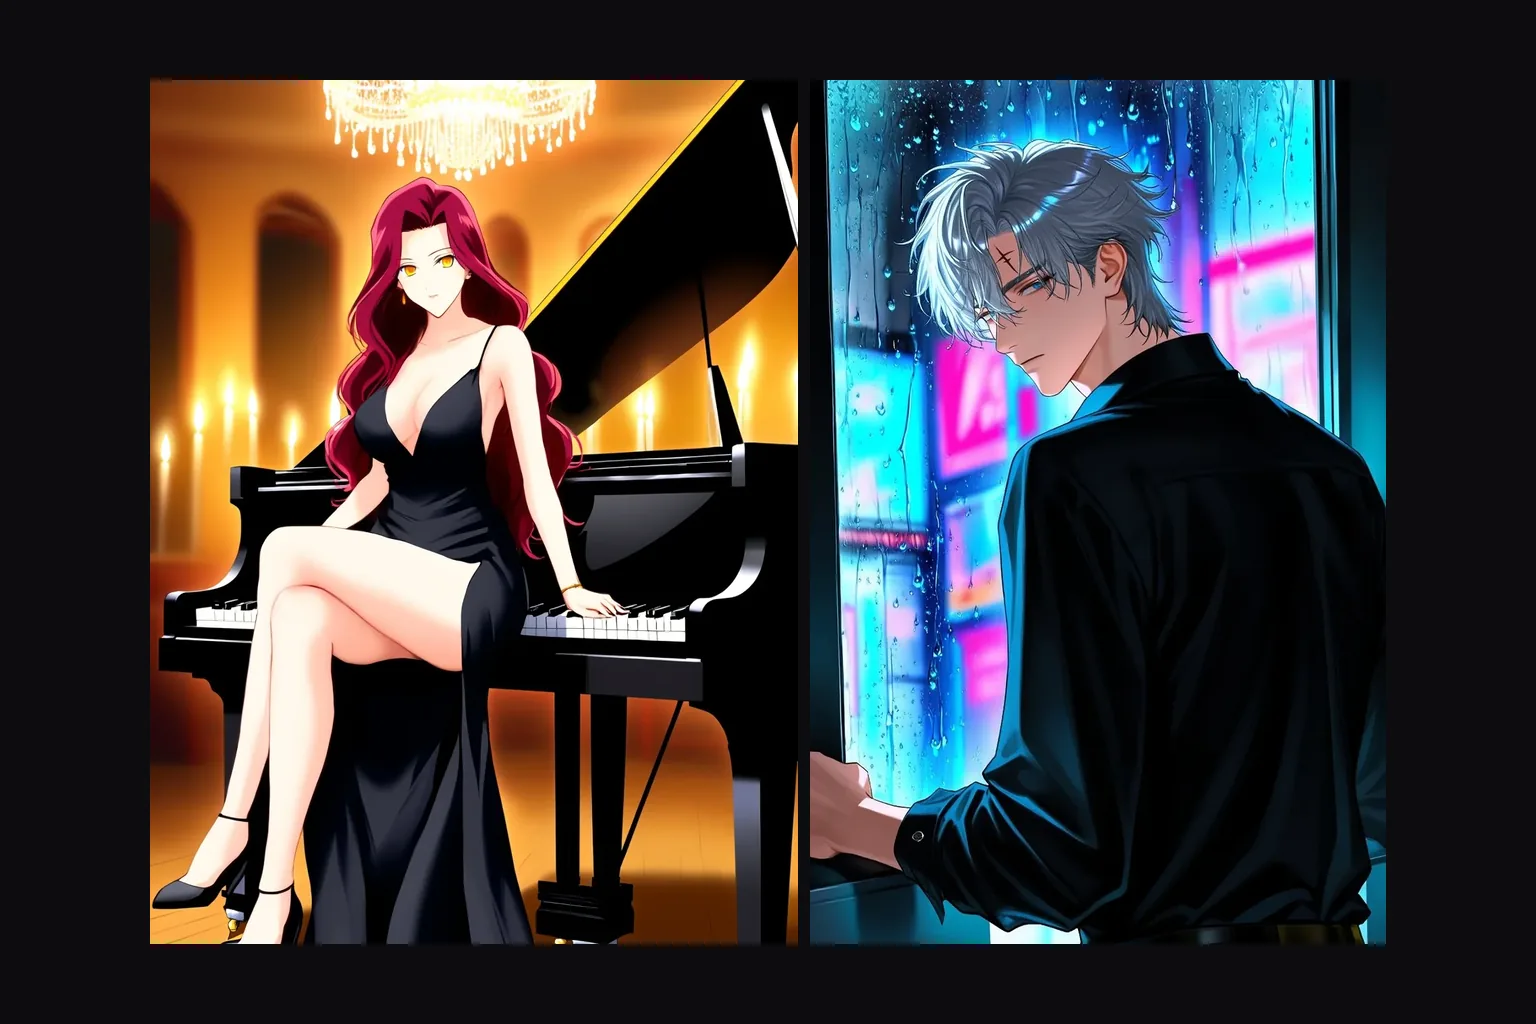
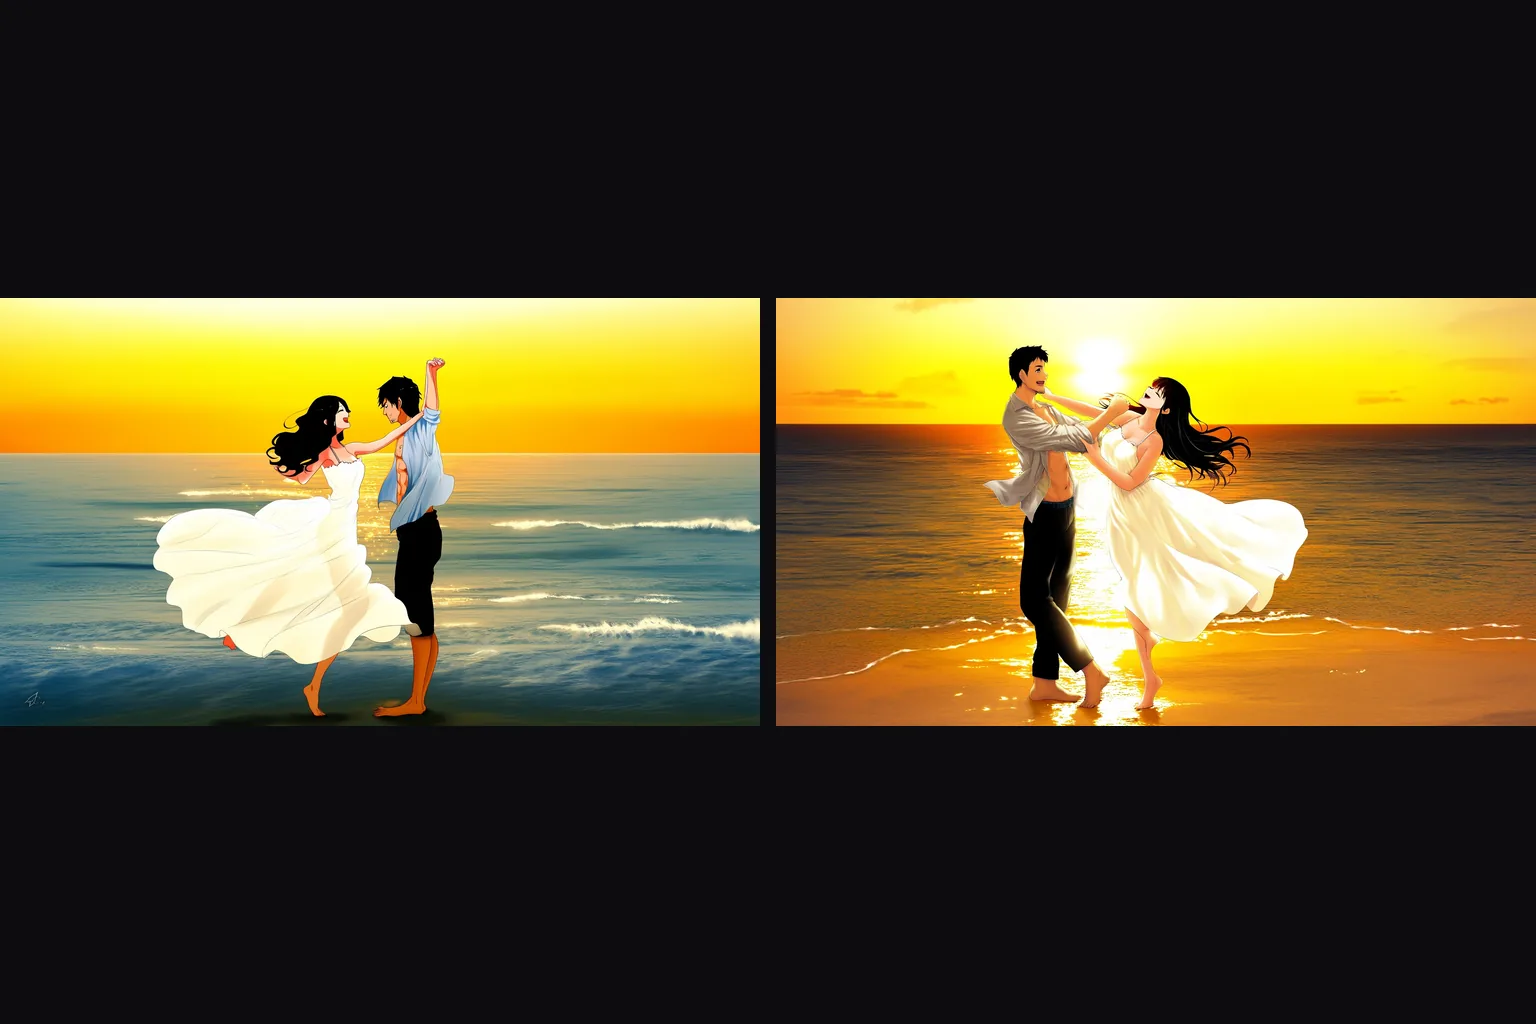
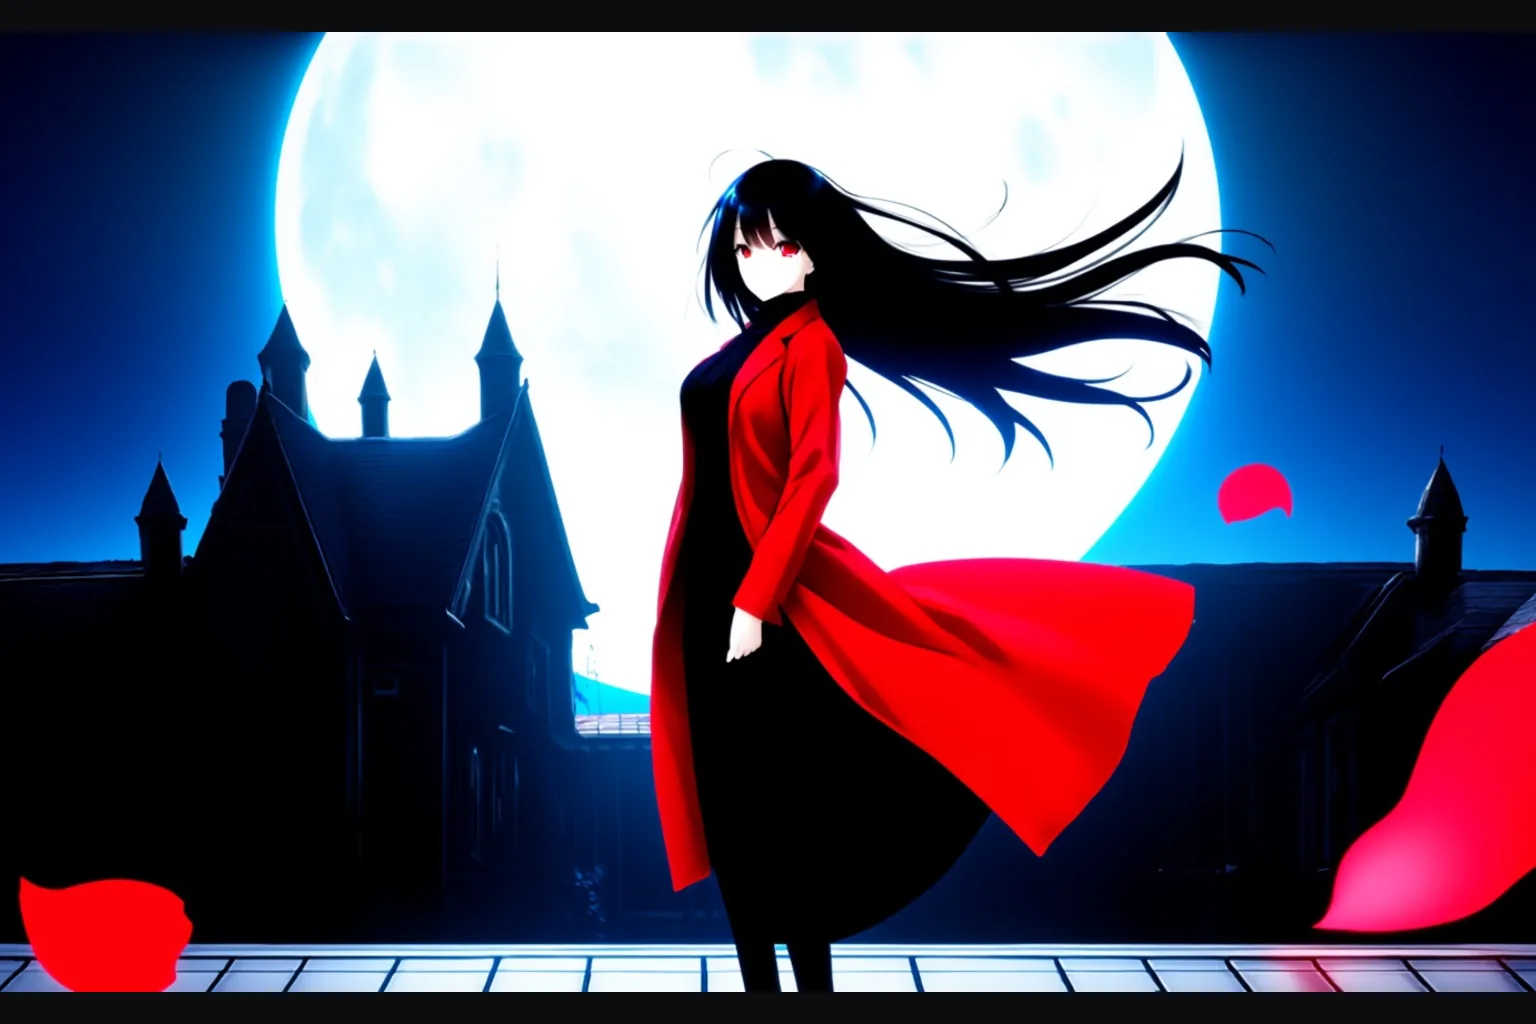
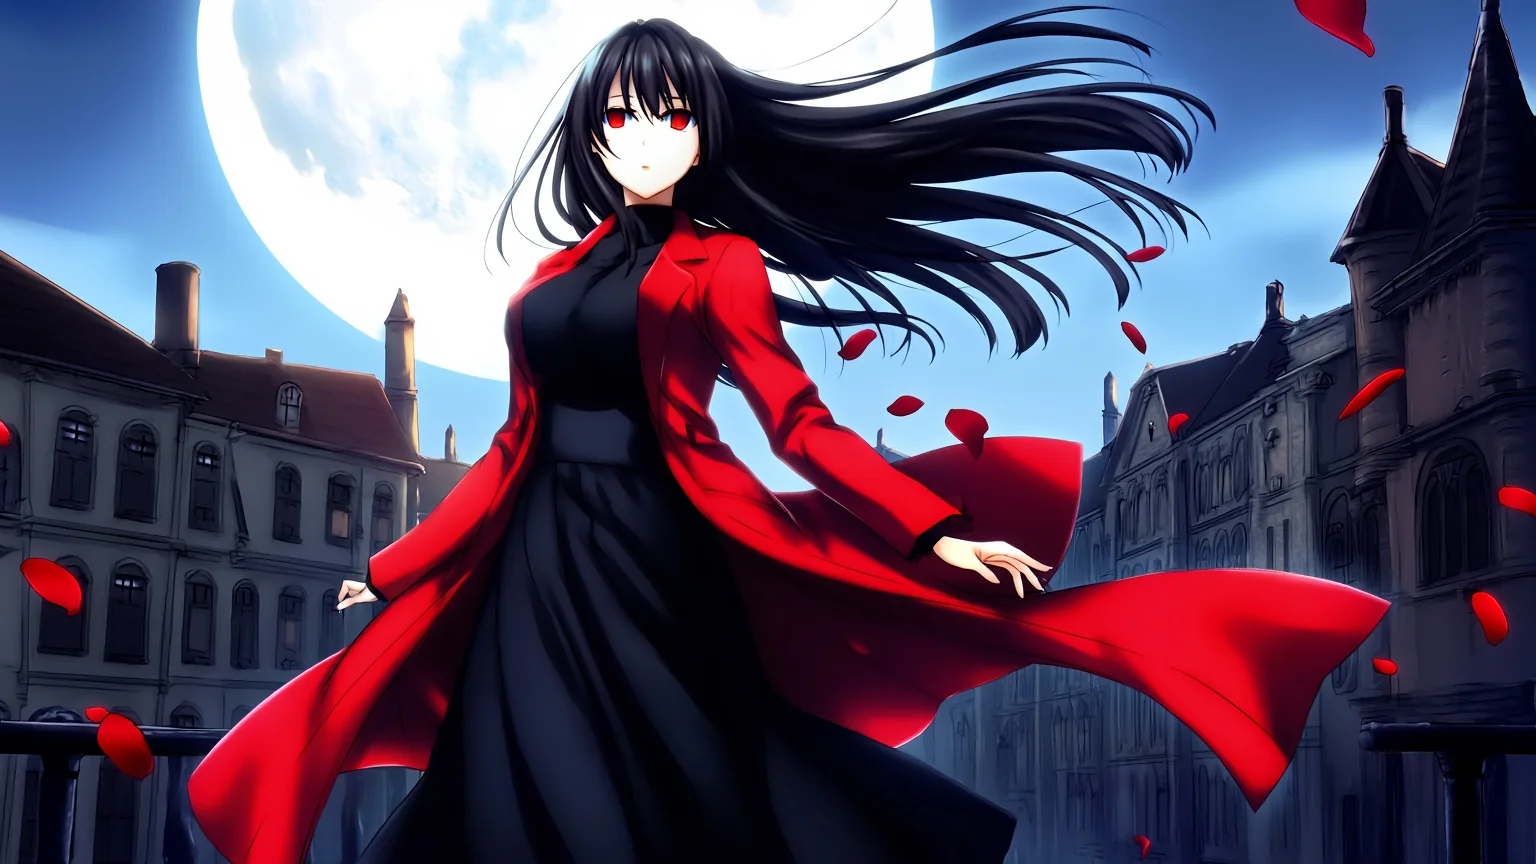
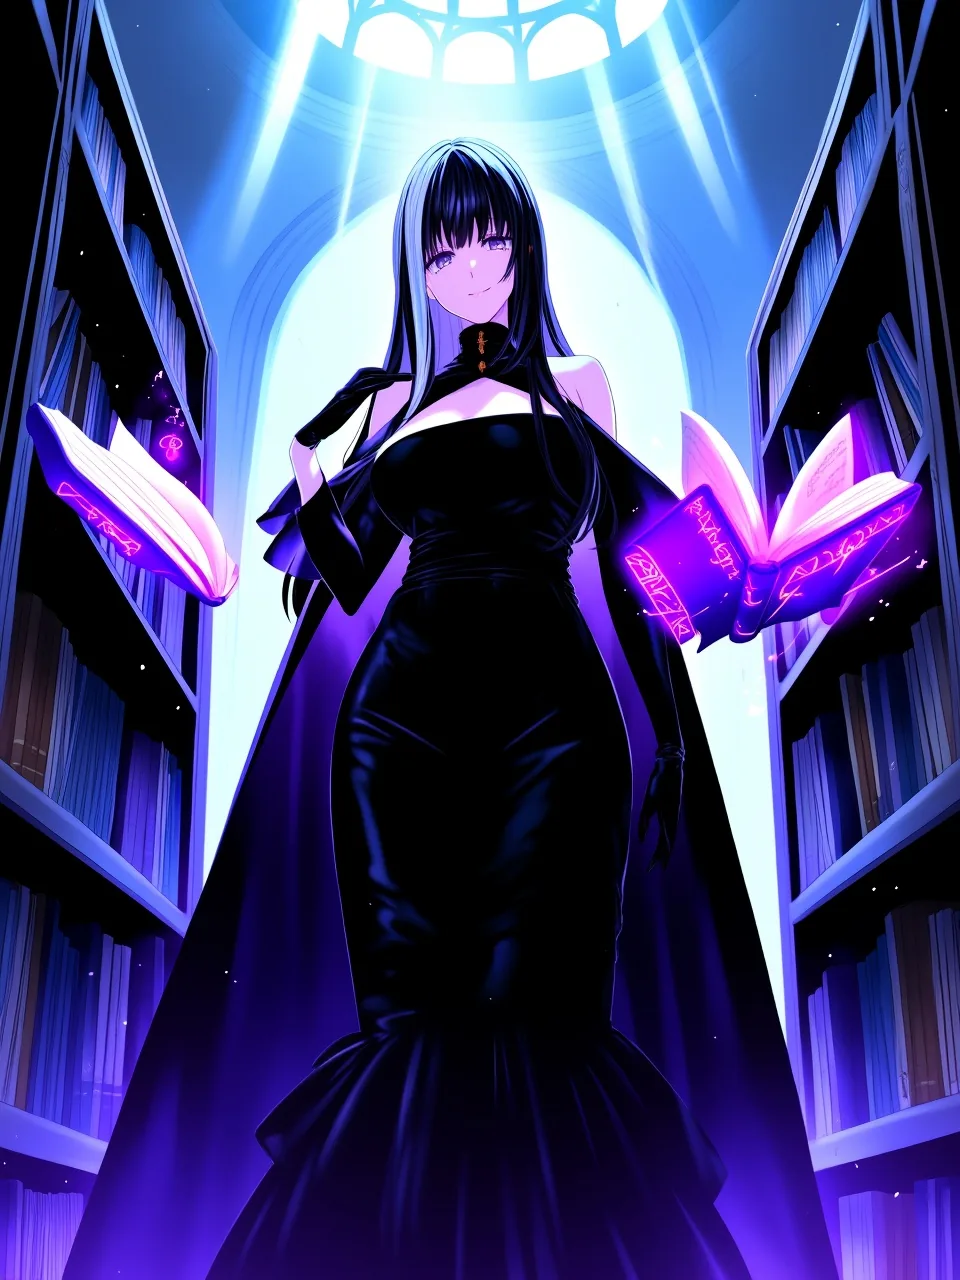
Neta Lumina Texte vers image dessine une illustration d’anime à partir d’un prompt écrit. Neta Lumina est l’affinage par Neta.art Lab de Lumina-Image-2.0, le modèle ouvert d’Alpha-VLLM, entraîné sur un vaste ensemble d’images d’anime et de données de tags multilingues, avec Gemma 2B de Google comme encodeur de texte. Prompt en tags de type Danbooru, en simples phrases ou les deux, choisissez l’un des neuf ratios d’image et récupérez du JPEG, du PNG ou du WebP. La plateforme n’ajoute aucun filtre de contenu au prompt ni à l’image.
Fonctionnalités et points forts
Des phrases, pas seulement des tags
Comme l’encodeur de texte est un modèle de langage, le prompt peut être une description : qui est dans le cadre, ce que ces personnes portent, où se trouve la caméra et comment la scène est éclairée. Les tags fonctionnent toujours et peuvent se mêler au même prompt.
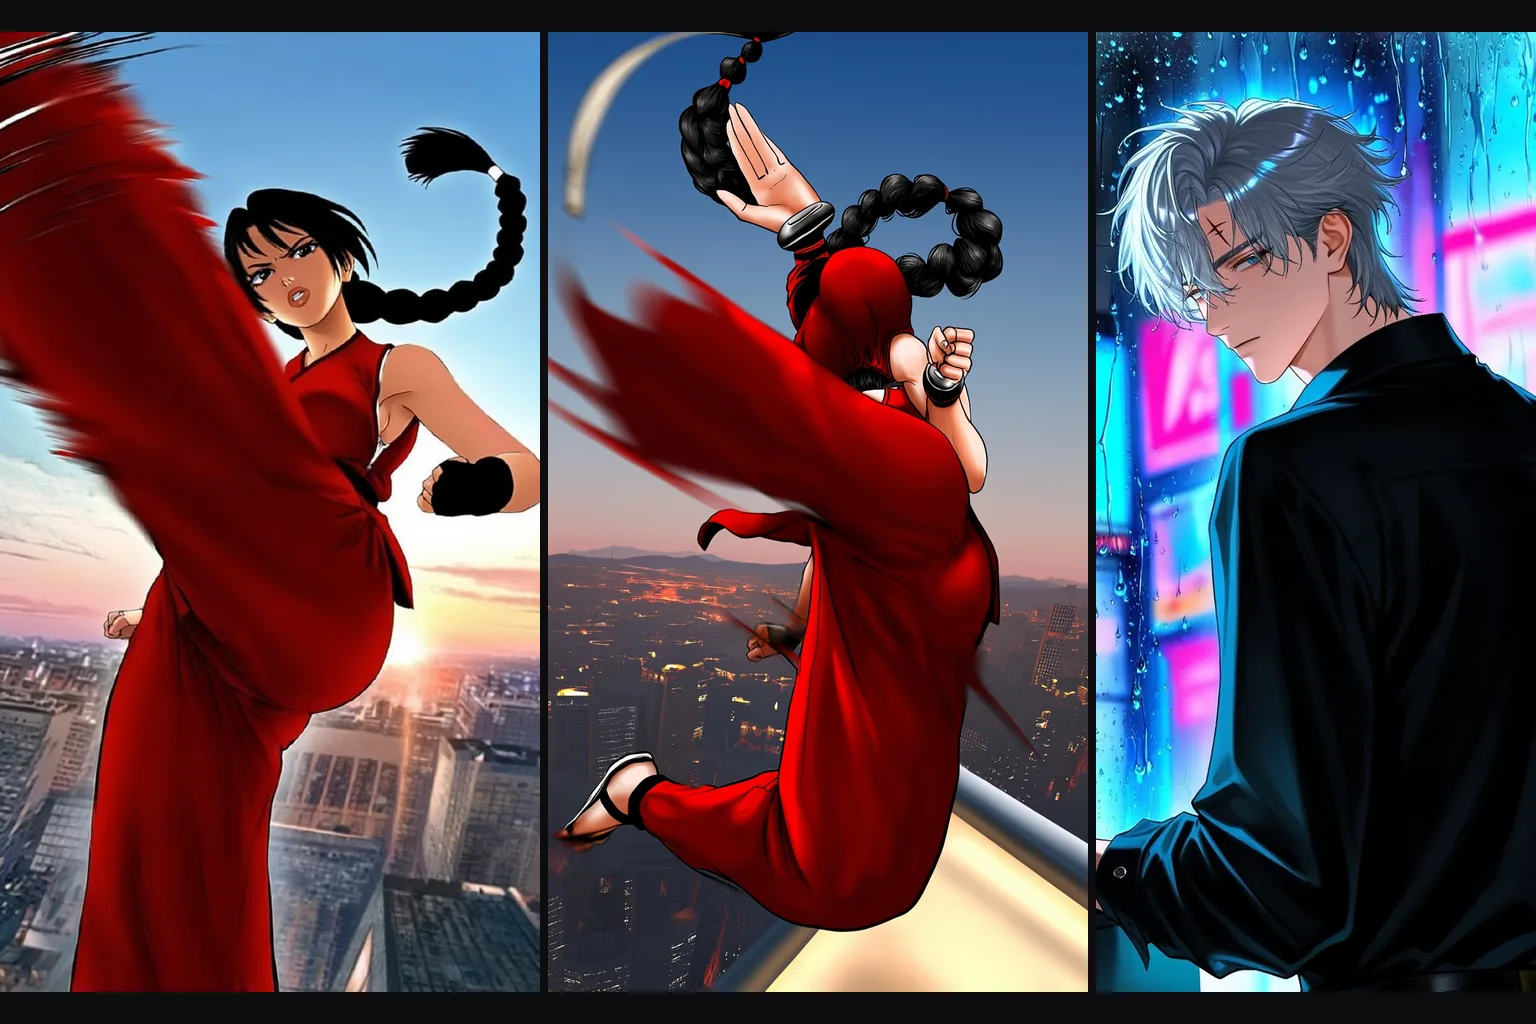
Des poses et des angles pleins d’énergie
Le raccourci, les angles dynamiques et les lignes de mouvement font partie de son vocabulaire. Un coup de pied volant dirigé vers le spectateur est sorti en un cadre vertical spectaculaire lors de nos tests.
Neuf formes, un seul prix
Chaque ratio, du 21:9 au 9:21, fait environ un mégapixel : 1024 x 1024, 960 x 1280, 1536 x 864. La forme et le format de sortie ne changent jamais le prix.
Sans censure
Notre test de contenu le plus poussé est revenu tel qu’écrit dès le premier essai. Rien n’est signalé, adouci ni vérifié de notre côté.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
prompt | Oui | Des tags, des phrases ou les deux, jusqu’à 5 000 caractères. 1 caractères minimum · 5000 caractères maximum |
aspect_ratio | Non | Neuf options, du 21:9 au 9:21 ; 1:1 par défaut. Le 1:1 donne 1024 x 1024, le 3:4 donne 960 x 1280 et le 16:9 donne 1536 x 864. |
output_format | Non | JPEG par défaut, PNG ou WebP si besoin. Ne change pas le prix. |
seed | Non | Garde une série d’images comparable pendant que vous changez un seul tag à la fois. Il ne garantit pas les mêmes pixels à chaque exécution. |
Tarification
$0.012 / image
Facturé à l’image, à un prix unique pour tous les ratios d’image et formats de sortie.
Cas d’utilisation
Art de personnage et visuels principaux
Portraits, illustrations en pied et affiches à partir d’une liste de tags ou d’une courte description. Fixez le seed et ne changez qu’un détail à la fois pour explorer des tenues et des éclairages pour le même personnage.
Scènes d’action
Combats, sauts et poursuites avec un angle de caméra marqué, en cadres hauts pour les écrans de téléphone ou larges pour les bannières.
De l’art sans censure pour votre plateforme
Aucun indicateur de contenu à régler et aucune seconde vérification du résultat : ce que vos utilisateurs écrivent est ce qu’ils récupèrent.
Guide de prompt et conseils pratiques
Ouvrez avec la qualité et le nombre de personnages
Commencez par « masterpiece, best quality », puis « 1girl », « 1boy » ou les deux, puis le personnage, la tenue, la pose, la caméra, la lumière et l’ambiance. Les tags en minuscules, séparés par des espaces, se lisent le mieux.
Écrivez une vraie phrase pour les parties difficiles
La position de la caméra, la direction de la lumière et ce que deux personnages se font l’un à l’autre se disent plus facilement en une phrase qu’en tags.
Comptez en temps, pas en argent
Chaque image prend environ 40 secondes de temps de modèle. Lancez les variantes en parallèle et gardez le seed fixe pendant que vous les comparez.
Relancez pour le coin bizarre
Le modèle ajoute parfois un gribouillis qui ressemble à une signature ou une zone pixelisée, appris de ses images d’entraînement. Un nouveau seed règle le problème ; il n’y a pas de prompt négatif.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "neta-art/neta-lumina/text-to-image",
  "input": {
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.