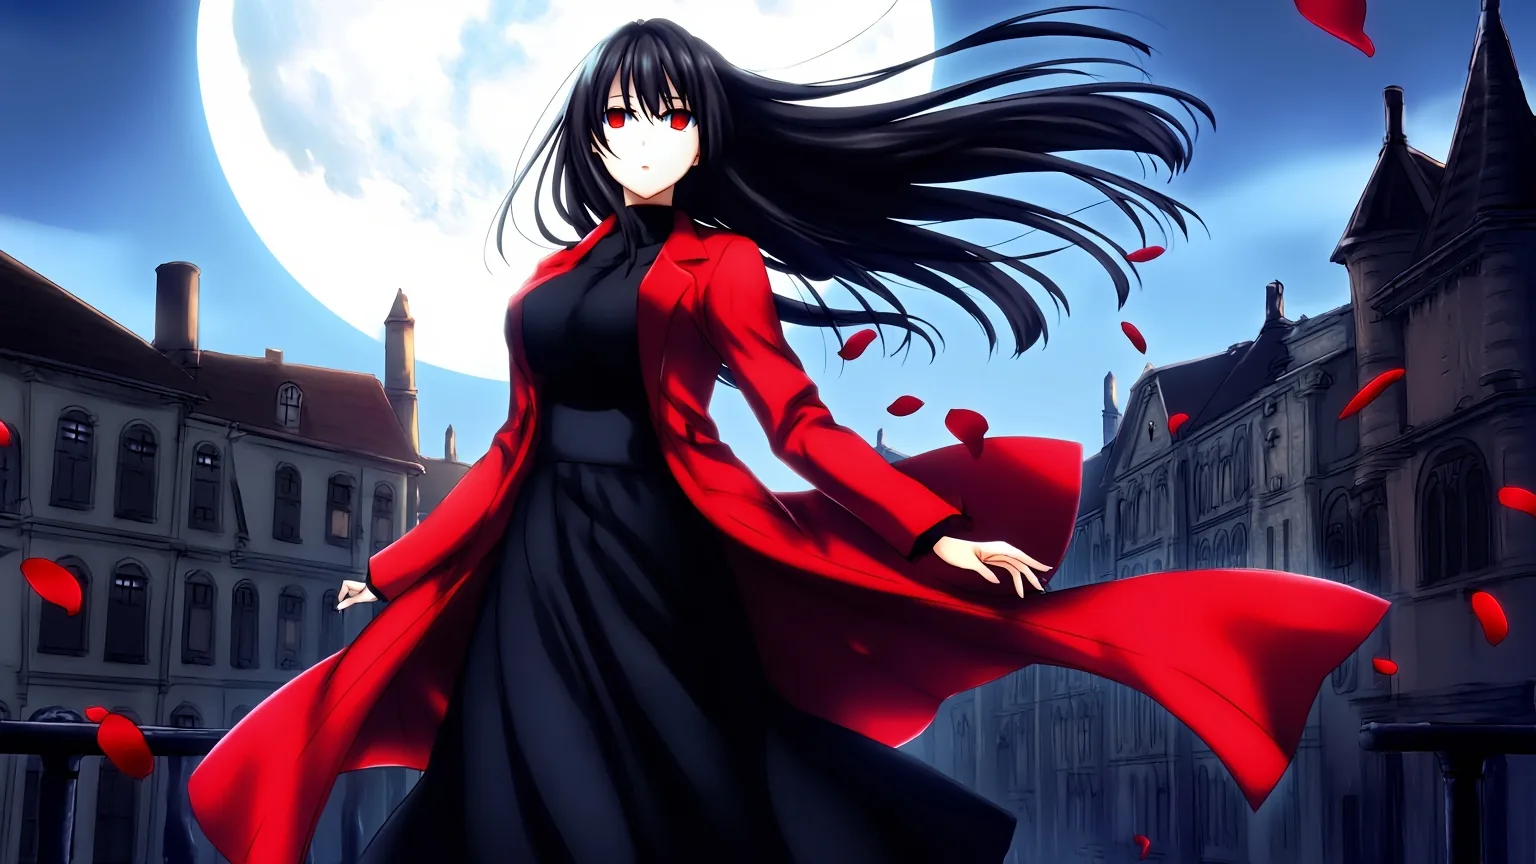
Neta Lumina es un modelo de anime sin censura que lee etiquetas de Danbooru y frases sencillas, y en nuestras pruebas entregó todos los niveles de nuestra escala de contenido sin rechazos ni sustituciones. El precio de esa libertad es el tiempo: en 31 ejecuciones del 5 de octubre de 2026, una imagen tardó de 13 a 75 segundos, con una mediana de 40 y ninguna por debajo de diez. Tampoco tiene prompt negativo, imagen de entrada ni ranura de LoRA.
Neta Lumina la crea Neta.art Lab. Es un ajuste fino de Lumina-Image-2.0 de Alpha-VLLM con un codificador de texto Gemma 2B, y está disponible públicamente en SpicyAPI como neta-art/neta-lumina/text-to-image. Todos los prompts que se muestran abajo son escenas cotidianas con adultos vestidos. La página de la familia Neta Lumina indica el precio vigente por imagen.
De un vistazo
| Neta Lumina (probado el 5 de octubre de 2026) | |
|---|---|
| Publicador y base | Neta.art Lab; ajuste fino de Lumina-Image-2.0 con un codificador de texto Gemma 2B y el VAE de FLUX |
| Nombre del modelo en la API | neta-art/neta-lumina/text-to-image (solo texto a imagen) |
| Campos públicos | prompt (hasta 5,000 caracteres), aspect_ratio, output_format, seed |
| Relaciones de aspecto | 9, todas de alrededor de un megapíxel: 1024 x 1024 en 1:1, 1536 x 864 en 16:9, 1536 x 656 en 21:9 |
| Salida | Una imagen por solicitud en JPEG (por defecto), PNG o WebP |
| Velocidad en nuestras pruebas | De 13 a 75 segundos por imagen en 31 ejecuciones, mediana de 40, ninguna por debajo de 10 segundos |
| Política de contenido | Sin censura, sin filtro de contenido; los cinco niveles de nuestra escala se entregaron |
| No puede | Prompts negativos, pasos, guidance, sampler, imagen de entrada, LoRA, más de una imagen por solicitud |
Qué es Neta Lumina
El publicador describe Neta Lumina como un modelo de imágenes de alta calidad en estilo anime. La ficha de Hugging Face en huggingface.co/neta-art/Neta-Lumina dice que es sólido en ilustración de anime, pósteres, storyboards y diseño de personajes, con una amplia cobertura de personajes y estilos. El publicador afirma que su comprensión de prompts es precisa incluso con prompts complejos, que admite etiquetas de Danbooru y que el chino, el inglés y el japonés son los idiomas recomendados. Nosotros solo probamos en inglés.
La cuestión de la versión merece una frase. El repositorio del publicador data de junio de 2025 y su "official release" v1.0 se subió el 22 de julio de 2025. La ruta alojada no indica una versión, así que no podemos decirte qué build respondió a nuestras solicitudes, y no intentamos adivinarlo a partir de las imágenes.
Dos cosas lo distinguen del otro modelo de anime que reseñamos esta semana, Anima Turbo. Lee frases descriptivas completas al menos tan bien como las etiquetas, y es lento. La tabla cerca del final los pone lado a lado con Prefect Pony XL.
Etiquetas, frases o ambas
El libro de prompts del publicador sugiere un orden: personajes, estilo, apariencia, ropa, expresión y acción, cámara, iluminación, atmósfera y, por último, etiquetas de calidad. También sugiere una línea inicial fija opcional: "You are an assistant designed to generate anime images based on textual prompts." Corrimos un mismo prompt dos veces con el mismo seed, una con esa línea y otra sin ella.
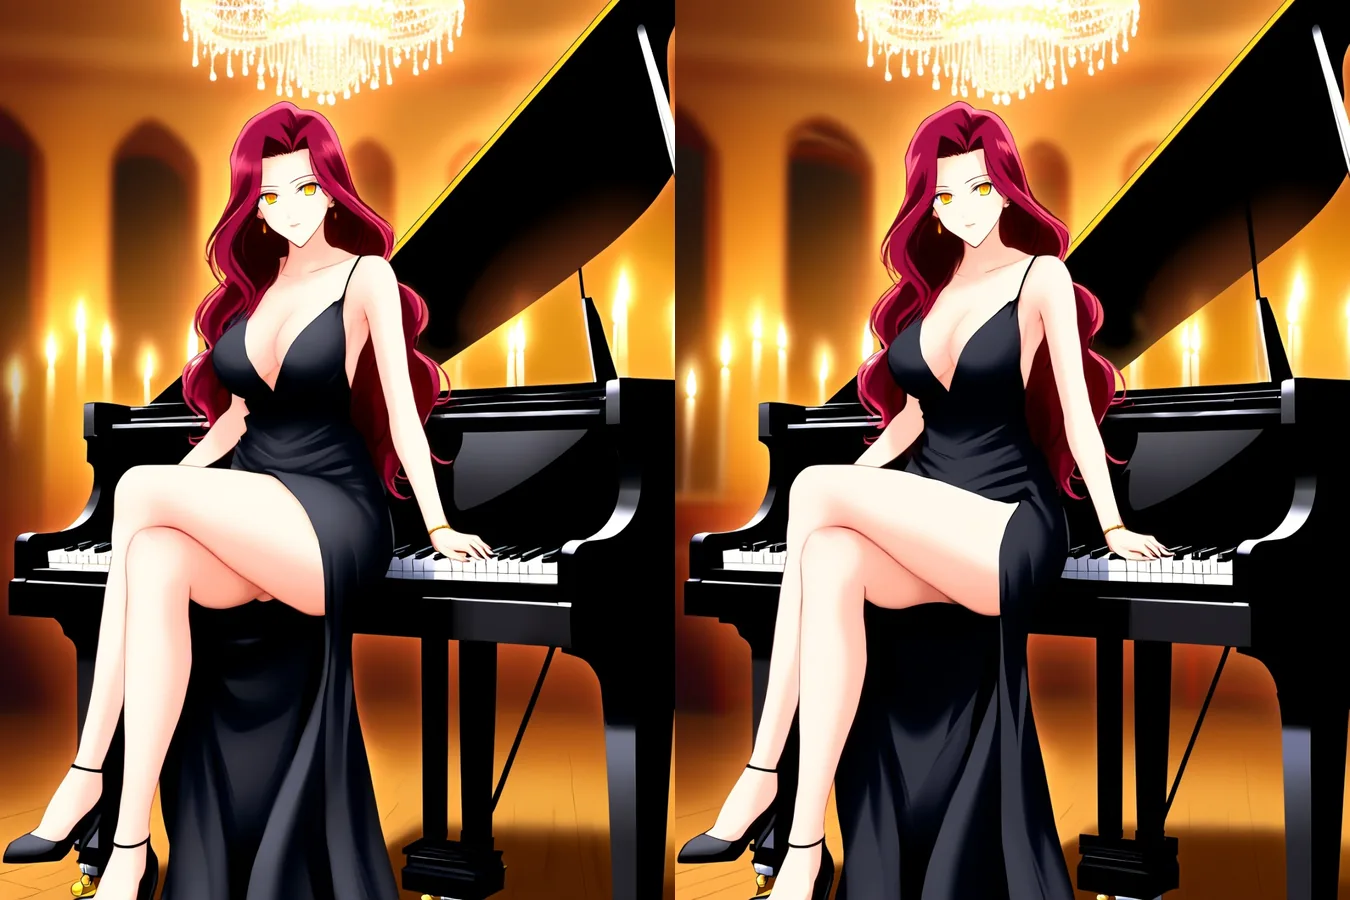
A la izquierda: con la línea inicial del publicador. A la derecha: sin ella. Mismo prompt, seed 5, 3:4, texto a imagen.
Las dos imágenes son casi idénticas, así que en este endpoint la línea inicial no hace falta. El prompt que dibujó a la pianista era una simple lista de etiquetas:
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileLas frases funcionan igual de bien. Esta dibujó a un hombre con una cicatriz, la camisa desabotonada y reflejos de neón sin una sola etiqueta:
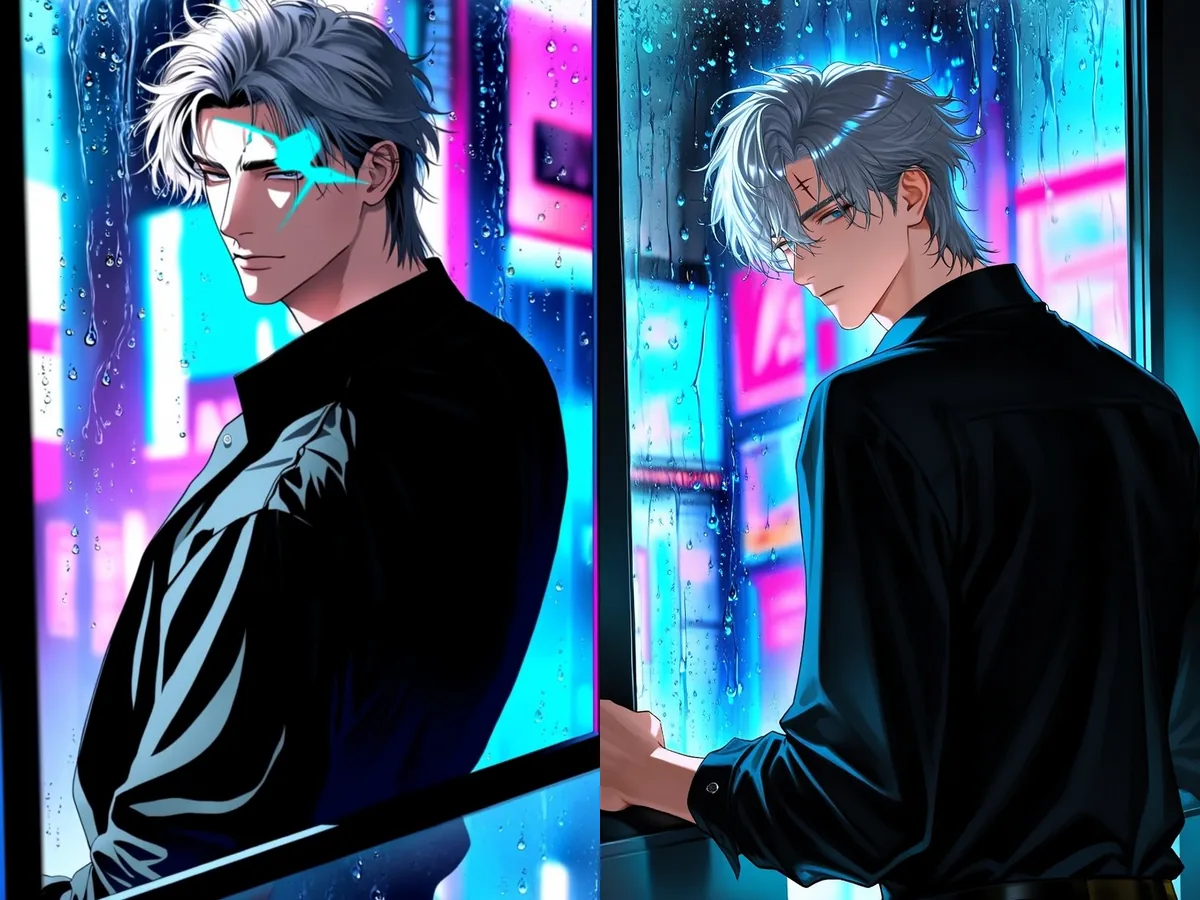
Las mismas tres frases, seeds 1 y 2, 2:3. El seed 2 (derecha) es el ejemplo publicado; el seed 1 dibujó una marca cian brillante perdida en la cara.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.En nuestras pruebas, la cicatriz, la camisa y la luz cian y magenta aparecieron en ambos seeds. Lo que cambió entre seeds fue la ejecución: una marca perdida en uno, un rostro limpio en el otro. Ese es el patrón en todo este modelo, y por eso recomendamos correr dos o tres seeds de cualquier prompt que te importe.
| Situación | Mejor opción | Por qué, en nuestras ejecuciones |
|---|---|---|
| Un aspecto específico: pelo, ojos, atuendo, escenario | Etiquetas | Cada etiqueta es su propia instrucción, y la pianista conservó todos los detalles |
| Posición de cámara, dirección de la luz, cómo se relacionan dos personas | Frases | El hombre de la ventana de neón siguió las tres frases |
| Dos personajes | Primero las etiquetas de cantidad de personas, luego una frase por persona | En la pareja de la orilla, su vestido de verano y la camisa abierta de él se quedaron con la persona correcta |
| Quieres control y atmósfera | Un encabezado de etiquetas más una o dos frases | Una mezcla es lo primero que probaríamos |
Tamaños, formatos y seeds
No hay un campo de tamaño. Eliges una de nueve relaciones de aspecto, y cada una se asigna a un tamaño fijo de alrededor de un megapíxel. Corrimos cada relación una vez y todas las salidas volvieron exactamente con los píxeles pedidos.
| Relación | Tamaño | Relación | Tamaño |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Los tamaños siguen la recomendación del publicador de aproximadamente de uno a 1.3 megapíxeles. La salida es JPEG por defecto; PNG y WebP funcionaron cuando los pedimos, y el formato de salida no cambia nada más. También puedes fijar un seed de 0 a 2,147,483,647.
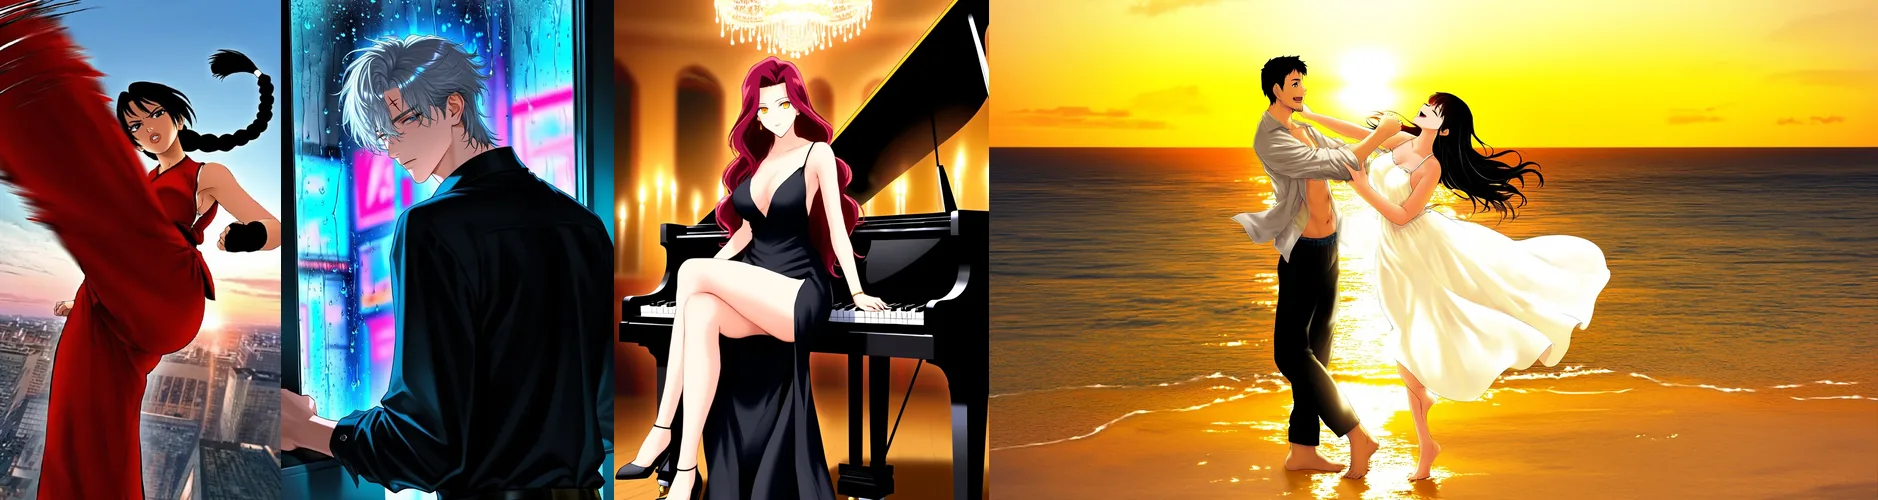
De izquierda a derecha: 9:16, 2:3, 3:4 y 16:9, todas de texto a imagen.
Un cuadro panorámico va bien con escenas de dos personas. Este es el ejemplo publicado en 16:9:
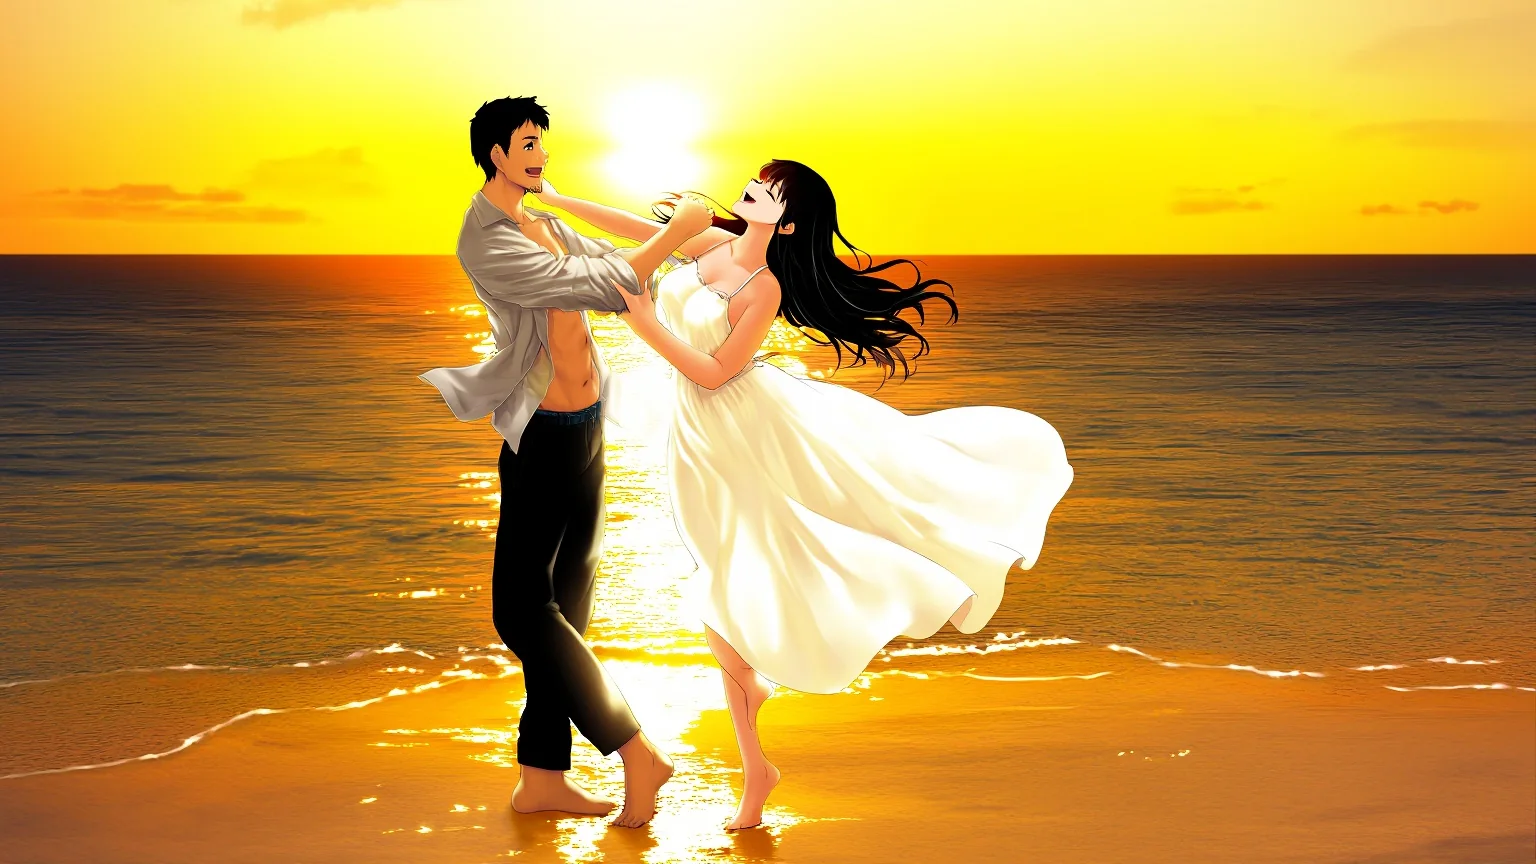
16:9, seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotLos seeds hacen que las ejecuciones sean comparables, no que sean idénticas con garantía, así que úsalos para comparar dos ajustes de prompt, no para prometer una repetición exacta al píxel.
Velocidad: planifica por lotes
Cronometramos 31 ejecuciones. El tiempo del modelo fue de 13 a 75 segundos, la mediana fue de 40 y ninguna ejecución terminó en menos de diez segundos. La página del anfitrión del publicador cita unos 44 segundos, lo que coincide. El tamaño no explica la dispersión: una imagen de 656 x 1536 tardó 13 segundos, mientras que las de 960 x 1280 tardaron entre 14 y 75.
Las consecuencias prácticas: no construyas encima un cuadro en vivo de "escribe y mira", envía variaciones en paralelo y mantén fijo el seed mientras las comparas. Si necesitas borradores en unos pocos segundos, Anima Turbo terminó 52 de 60 ejecuciones en menos de diez.
Hasta dónde llega
La plataforma no agrega ningún filtro de contenido, así que lo que obtienes lo deciden el modelo y el prompt. Corrimos un prompt por peldaño de nuestra escala de cinco niveles en 3:4 con el seed 1, y cada prompt indicaba que los personajes son adultos. Revisamos todas las imágenes.
| Nivel | Qué pedimos | Qué volvió |
|---|---|---|
| L1 Sugerente | Lencería, un tirante que se desliza | Entregado |
| L2 Temas maduros | Parcialmente reveladora | Entregado, también en las nueve relaciones (9 de 9) |
| L3 Fuerte | Contenido fuerte, femenino y masculino | Entregado, ambas |
| L4 Intenso | Una escena íntima entre dos adultos | Entregado tal como se escribió, sin censura |
| L5 Extremo | Ataduras consentidas entre adultos; gore cinematográfico | Ambos entregados |
No hubo ningún rechazo ni una imagen sustituida en ningún nivel. Un detalle que conviene saber sobre el prompt de ataduras de L5: el modelo dibujó una pequeña censura de estilo mosaico sobre una zona. L4 no tuvo ninguna. Lo interpretamos como un hábito que el modelo aprendió de su arte de entrenamiento y no como un filtro, ya que la plataforma no agrega nada y la misma zona salió sin censura en otros casos. Si necesitas una salida limpia, dilo en el prompt o vuelve a generar.
No publicamos los prompts de la escala, y la plataforma nunca proporciona prompts para contenido más fuerte. Lo que sí podemos decir es que, ante una solicitud cotidiana, el modelo se comporta como debe un modelo de anime y, ante una más fuerte, no se interpone. Compáralo con FLUX 3 e Ideogram v4.5, que rechazaron casi todo lo que pasaba de una foto neutral de traje de baño en nuestras pruebas.
Lo que salió mal
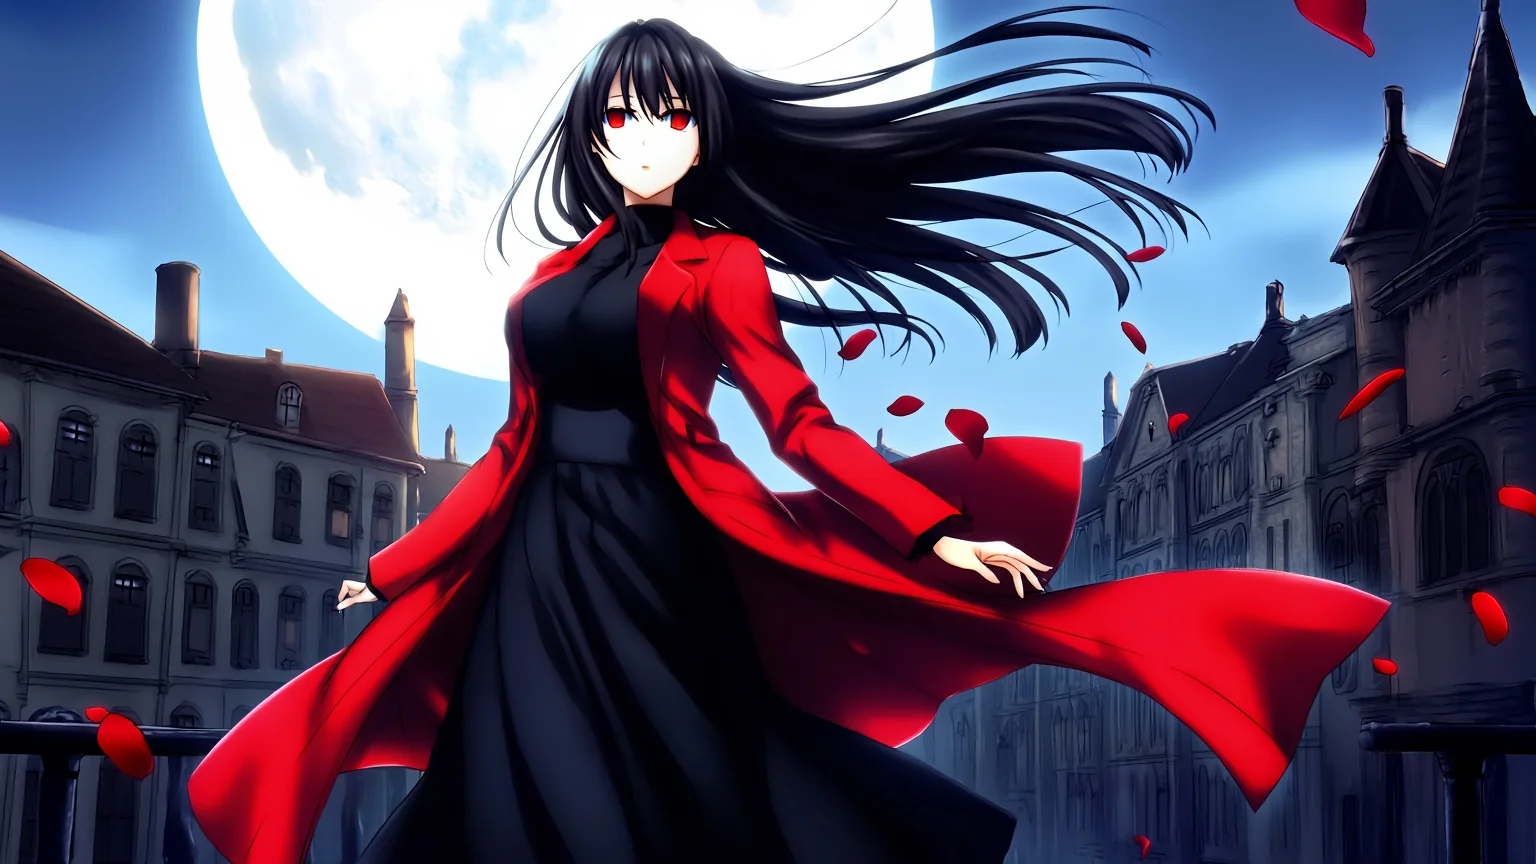
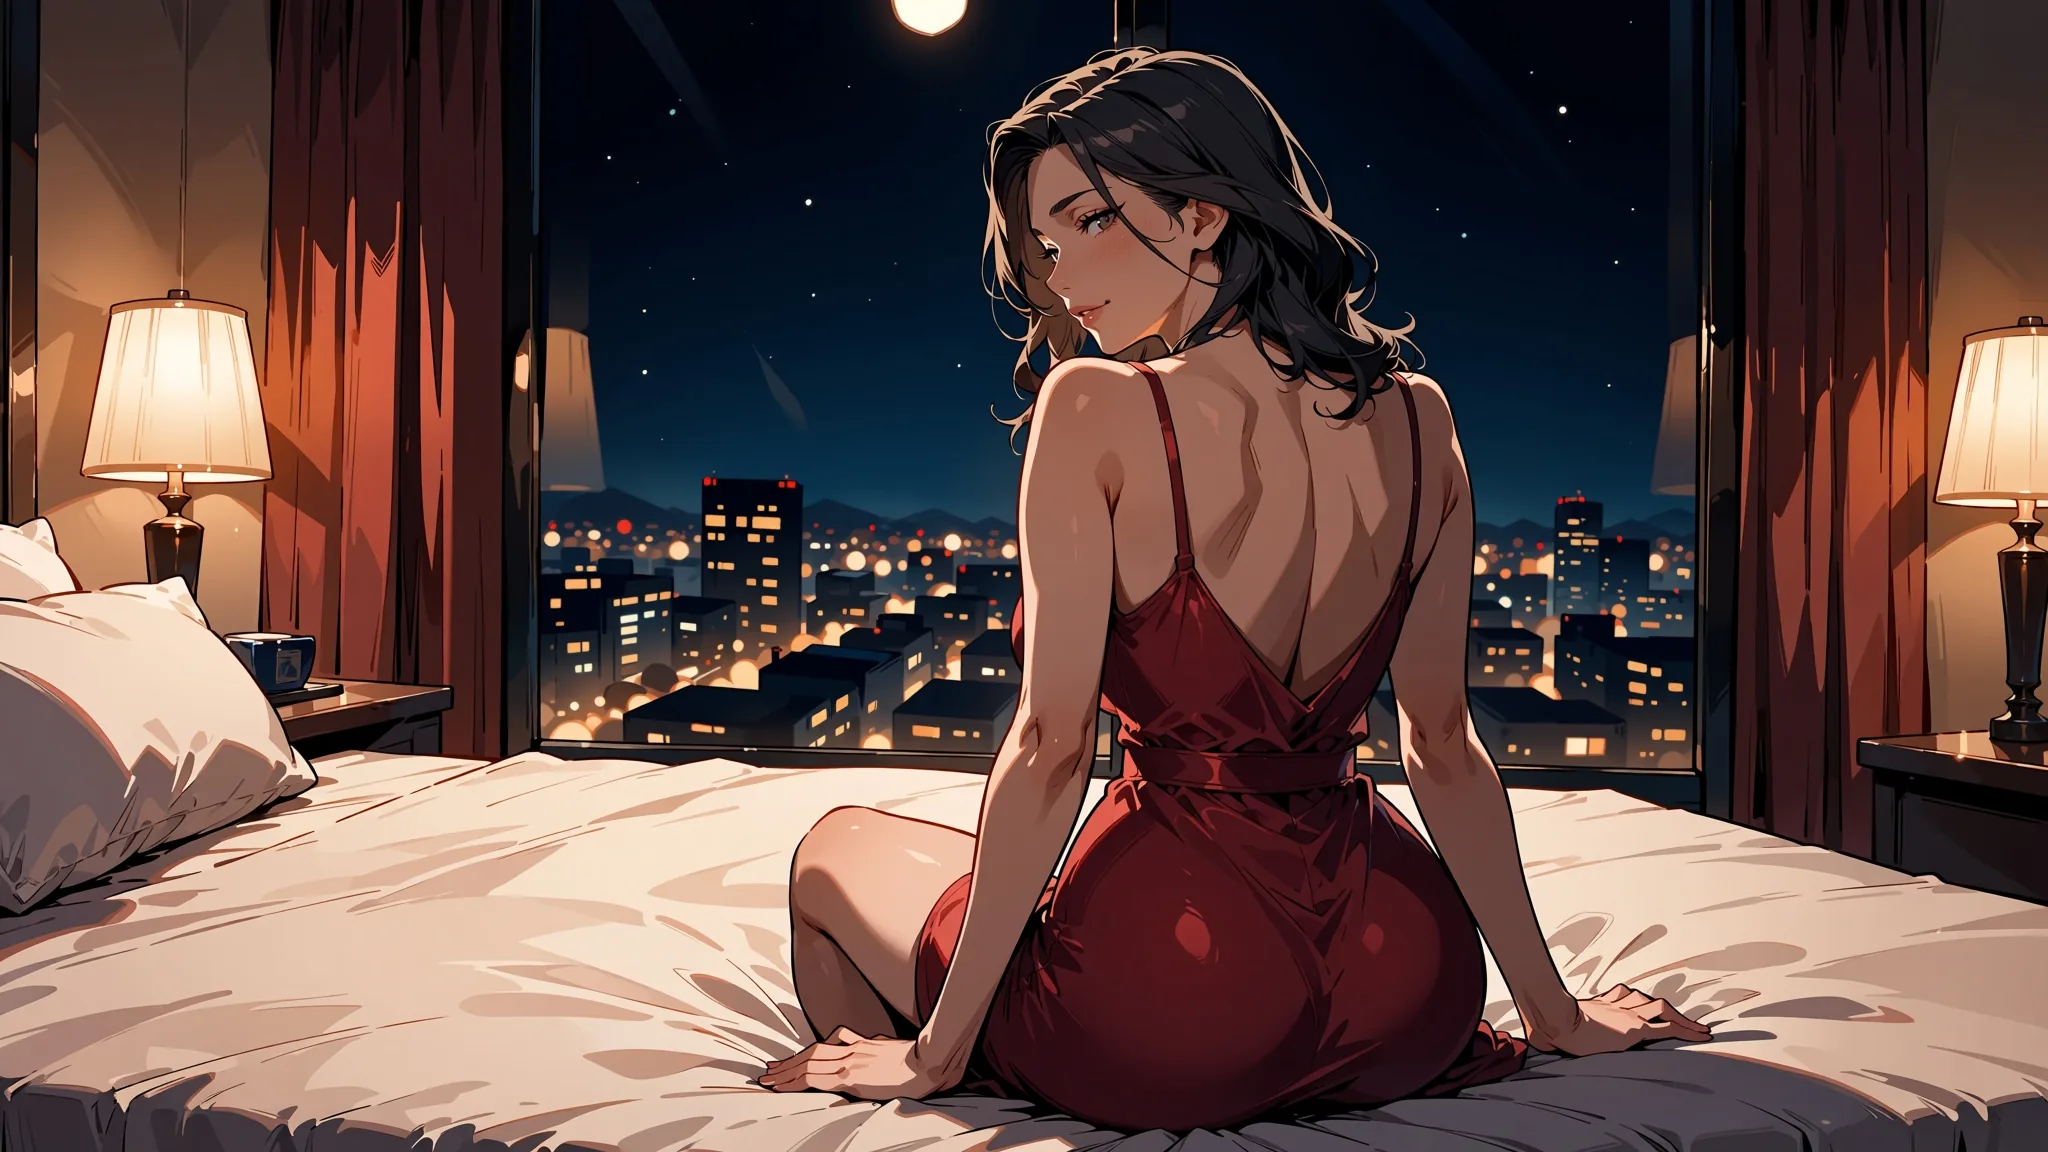
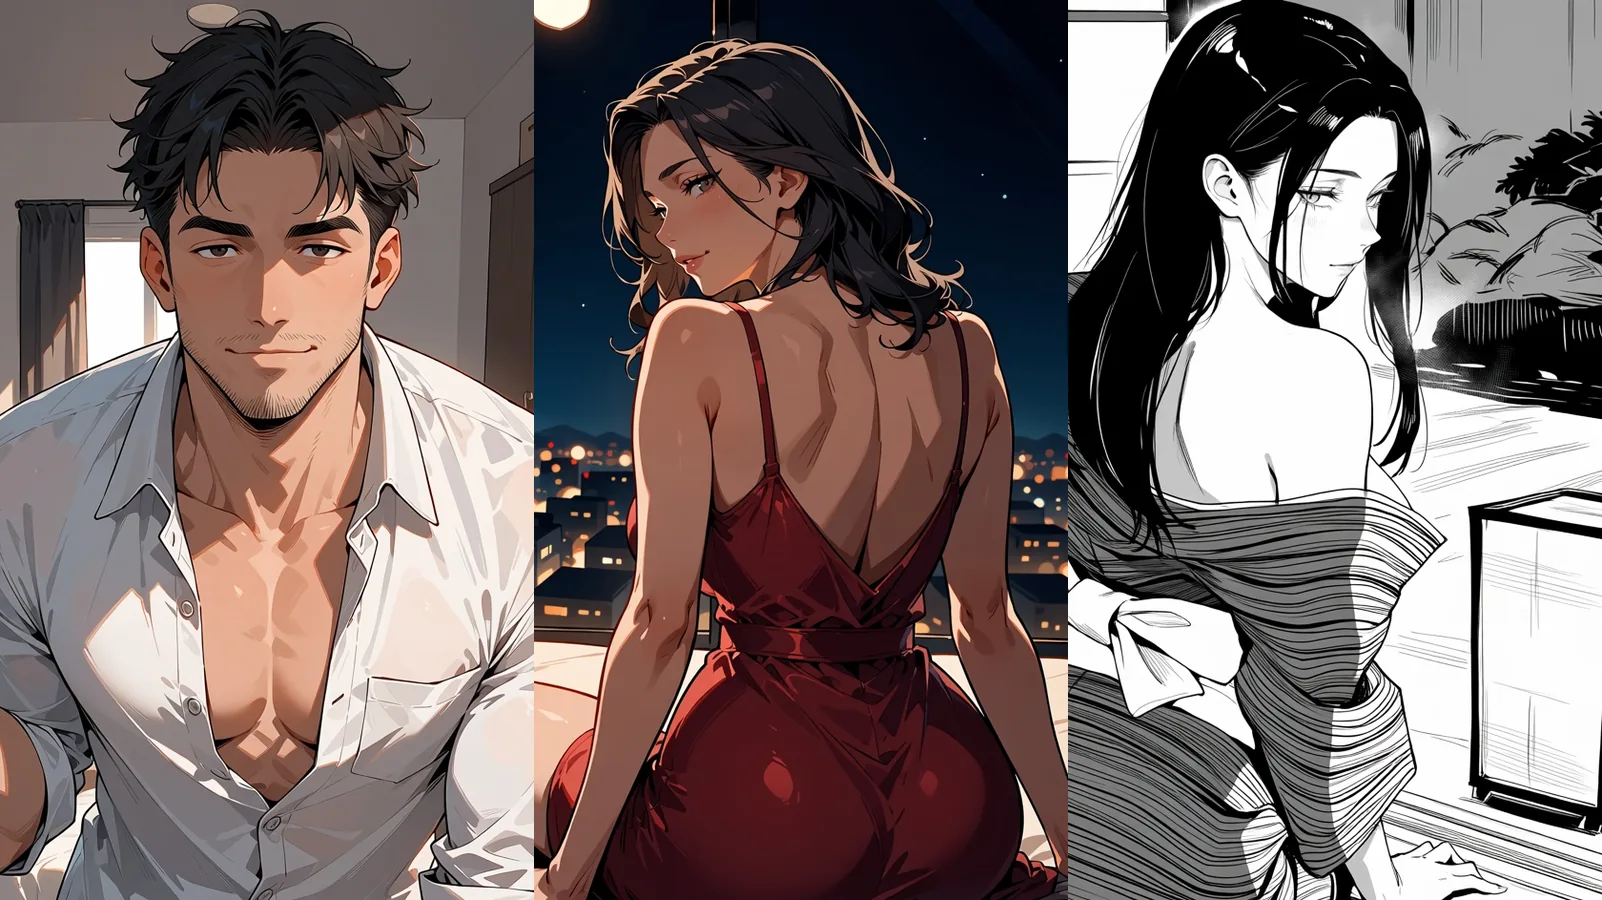
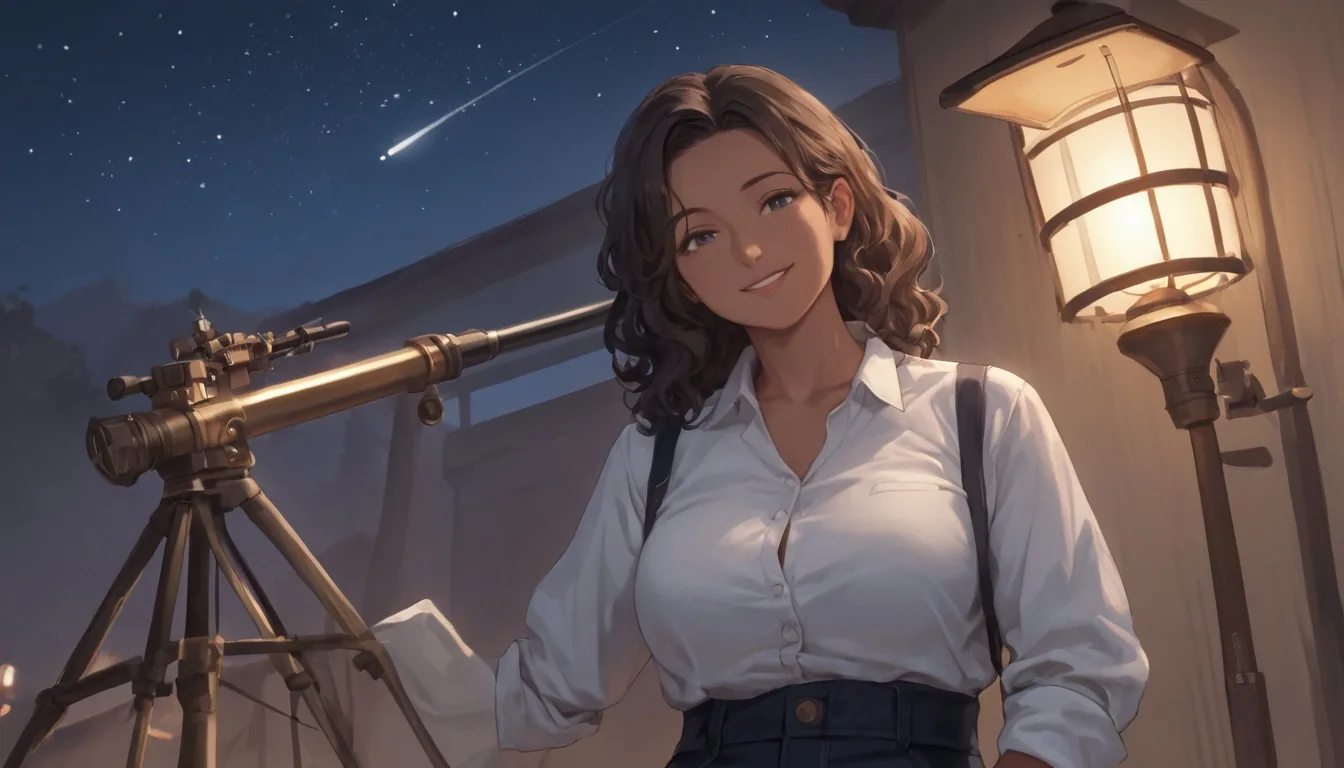
Informar con honestidad implica mostrar los fallos. Nuestro prompt de imagen principal, una mujer adulta con un abrigo carmesí en una azotea bajo la luna, salió bien con los seeds 1 y 3 y mal con el seed 2:
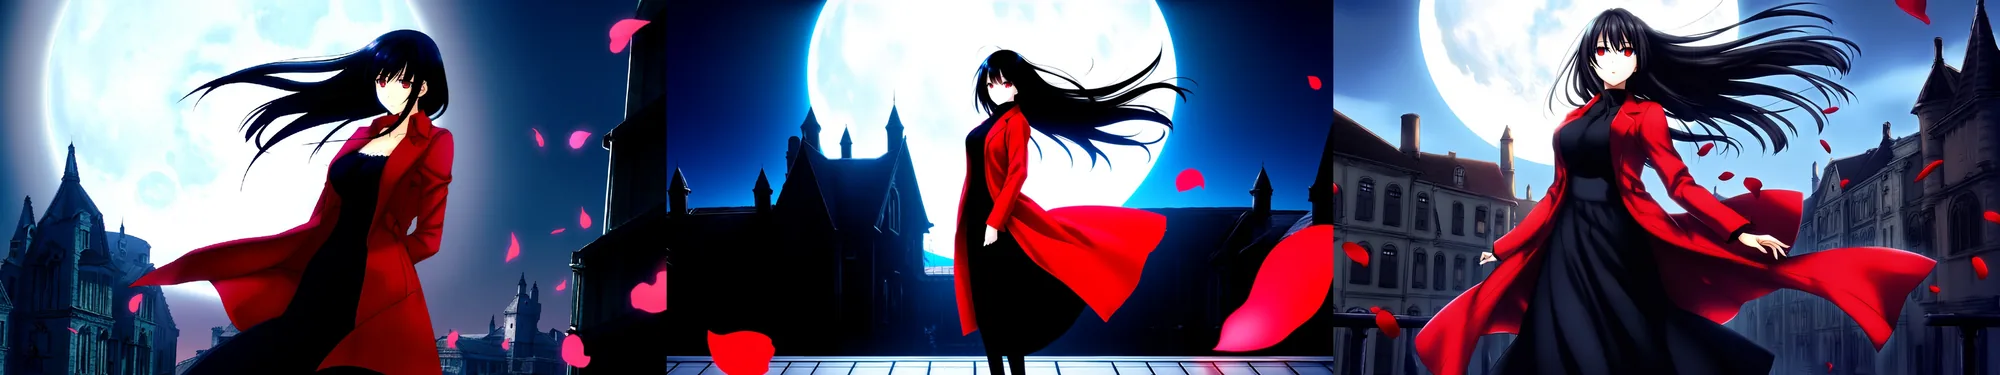
Un prompt, seeds 1, 2 y 3, 16:9. El seed 2 (centro) convirtió a la mujer en una figura pequeña frente a una silueta.
Las poses de acción son el rincón menos fiable. El prompt que nos dio una patada voladora limpia con el seed 1 enredó las extremidades con el seed 2:
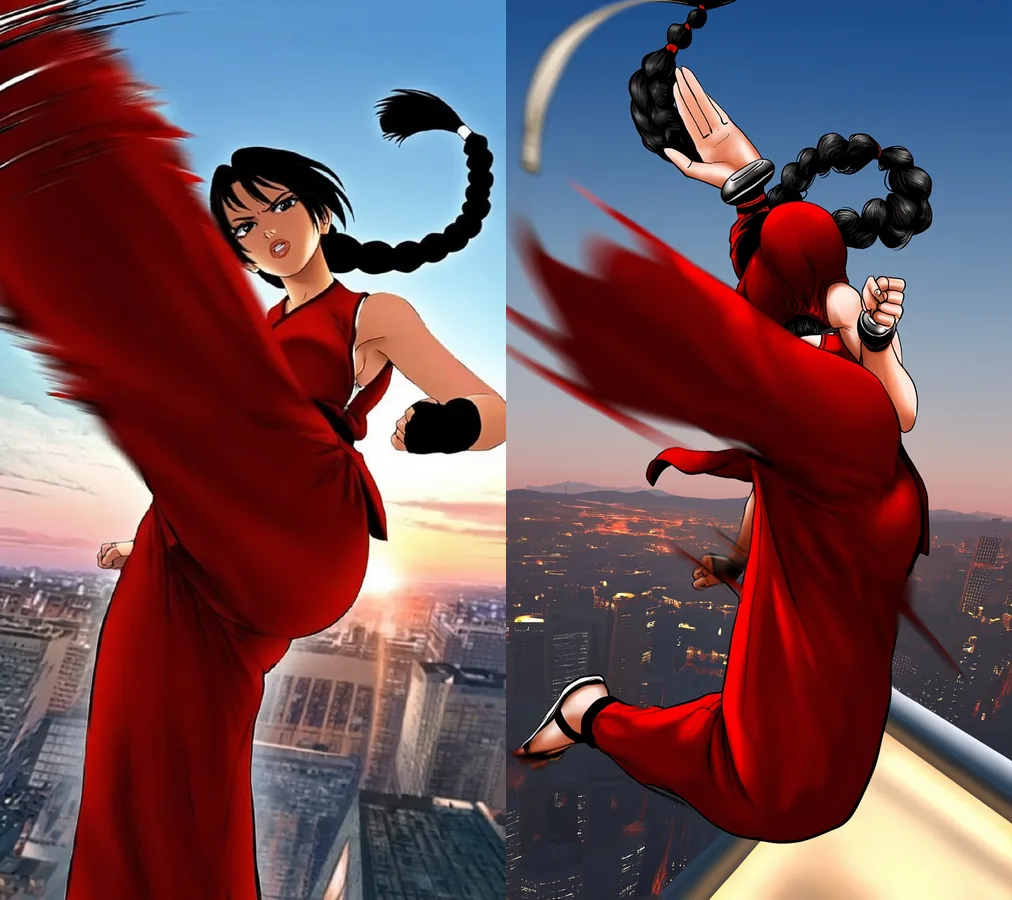
A la izquierda: seed 1. A la derecha: seed 2. 9:16, mismo prompt.
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingIncluso la pianista varía. Dos seeds del mismo prompt dieron dos salones y poses distintos:
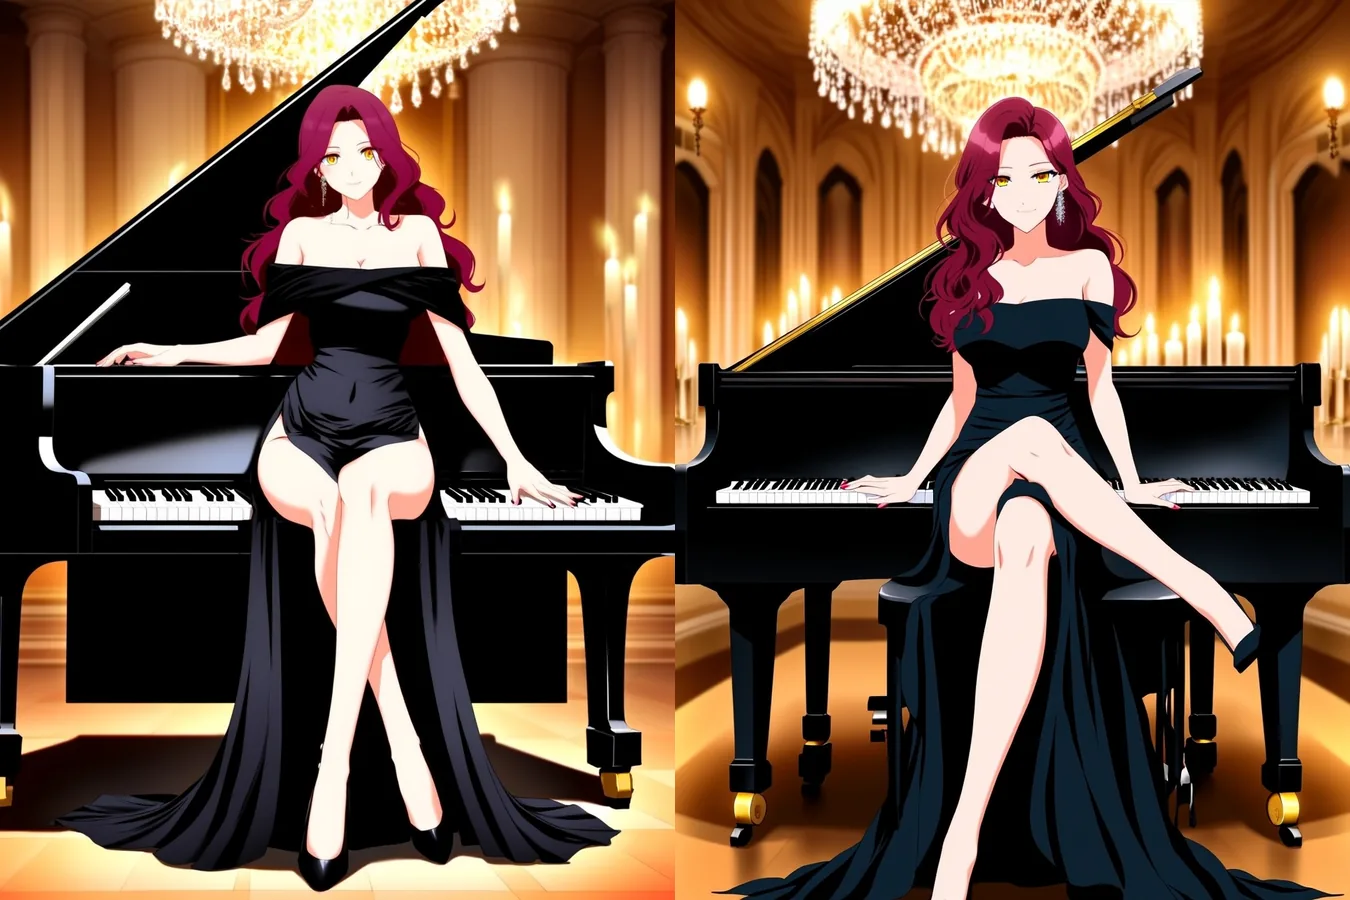
El prompt de la pianista, seeds 1 y 2, 3:4.
Límites
- Lento. De 13 a 75 segundos por imagen, mediana de 40.
- Sin prompt negativo, pasos, guidance ni sampler. Los campos públicos son
prompt,aspect_ratio,output_formatyseed. - Solo texto a imagen. No hay imagen de entrada ni ranura de LoRA.
- Una imagen por solicitud.
- Artefactos ocasionales. A veces el modelo agrega un garabato parecido a una firma o una zona pixelada aprendida de su arte de entrenamiento. La solución es un seed nuevo.
- Las poses de acción requieren repetir. Cuenta con dos o tres seeds.
Neta Lumina, Anima Turbo y Prefect Pony XL
Los tres son modelos de anime sin censura en SpicyAPI. Las filas de abajo usan solo lo que medimos el 5 de octubre de 2026 para Neta Lumina y Anima Turbo, y lo publicado en las páginas de modelo para Prefect Pony XL, que probamos por última vez en una ejecución interna anterior, el 18 de septiembre de 2026.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| Qué es | Ajuste fino de Lumina-Image-2.0 por Neta.art Lab | CircleStone Labs, 2 mil millones de parámetros, build Turbo destilado | Checkpoint de anime de la comunidad de la línea Pony XL |
| Estilo de prompt | Etiquetas, frases o ambas | Etiquetas de Danbooru, también lee frases | Etiquetas al estilo Pony |
| Relaciones de aspecto | 9 de alrededor de un megapíxel | 15, en niveles de 1k y 1.5k | 7 tamaños nativos de SDXL |
| Velocidad en nuestras pruebas | De 13 a 75 s, mediana de 40 | De 2 a 16 s, 52 de 60 por debajo de 10 | No se midió en esta ronda |
| Imagen a imagen | No | Sí, en su endpoint de imagen a imagen | No |
| LoRA | No | No en la familia base; su hermano LoRA admite hasta tres | No |
| Prompt negativo | No | No | No se trata aquí |
| Contenido en nuestras pruebas | Los cinco niveles se entregaron | La prueba de contenido más exigente se generó tal como se escribió al primer intento | Tres niveles de prueba hasta L4 se generaron en la ejecución del 18 de septiembre |
| Formato de salida | JPEG, PNG o WebP | JPEG | Consulta la página del modelo |
Elige Neta Lumina cuando quieras un modelo de anime que siga una frase descriptiva larga y puedas esperar. Elige Anima Turbo para borradores rápidos, imagen a imagen o LoRA. Elige Prefect Pony XL si tus prompts ya provienen del ecosistema Pony. Nuestro resumen de modelos de anime NSFW cubre el panorama más amplio.
Quién debería usarlo
Usa Neta Lumina para imágenes principales, pósteres, diseños de personajes y cuadros de storyboard en los que correrás un puñado de seeds y te quedarás con el mejor. Descártalo si necesitas velocidad, edición, un prompt negativo o un LoRA de estilo. Empieza en la página de texto a imagen.
Preguntas frecuentes
¿Neta Lumina no tiene censura?
Sí. La plataforma no agrega ningún filtro de contenido, y en nuestra escala de cinco niveles, de L1 Sugerente a L5 Extremo, todos los niveles se entregaron sin rechazo ni imagen sustituida. El propio modelo dibujó una pequeña censura de estilo mosaico en el prompt de ataduras de L5, algo que parece haber aprendido de su arte de entrenamiento.
¿Usa etiquetas o frases?
Ambas. Las etiquetas al estilo Danbooru funcionaron para la pianista y las frases sencillas funcionaron para el hombre de la ventana de neón. Usa etiquetas para un aspecto preciso y una frase para la cámara, la luz y el ambiente.
¿Necesito la línea inicial del publicador?
No. Con y sin "You are an assistant designed to generate anime images based on textual prompts." se obtuvieron imágenes casi idénticas con el mismo seed.
¿Por qué es más lento que otros modelos de imágenes de aquí?
Medimos de 13 a 75 segundos de tiempo del modelo en 31 ejecuciones, con una mediana de 40, y el tamaño de la imagen no explicó la dispersión. Envía variaciones en paralelo y fija el seed mientras las comparas.
¿Qué tamaños admite?
Nueve relaciones de aspecto de alrededor de un megapíxel, de 1024 x 1024 en 1:1 a 1536 x 864 en 16:9 y 1536 x 656 en 21:9. Todas las salidas coincidieron con el tamaño pedido en nuestra prueba.
¿Puedo usar LoRA o una imagen de origen?
No. Este endpoint es solo de texto a imagen. Para LoRA o imagen a imagen en un modelo de anime, mira Anima Turbo LoRA y el endpoint de imagen a imagen de Anima Turbo.
¿El mismo seed garantiza la misma imagen?
No. Los seeds mantienen las ejecuciones comparables, pero considera una repetición como cercana, no como garantizada.