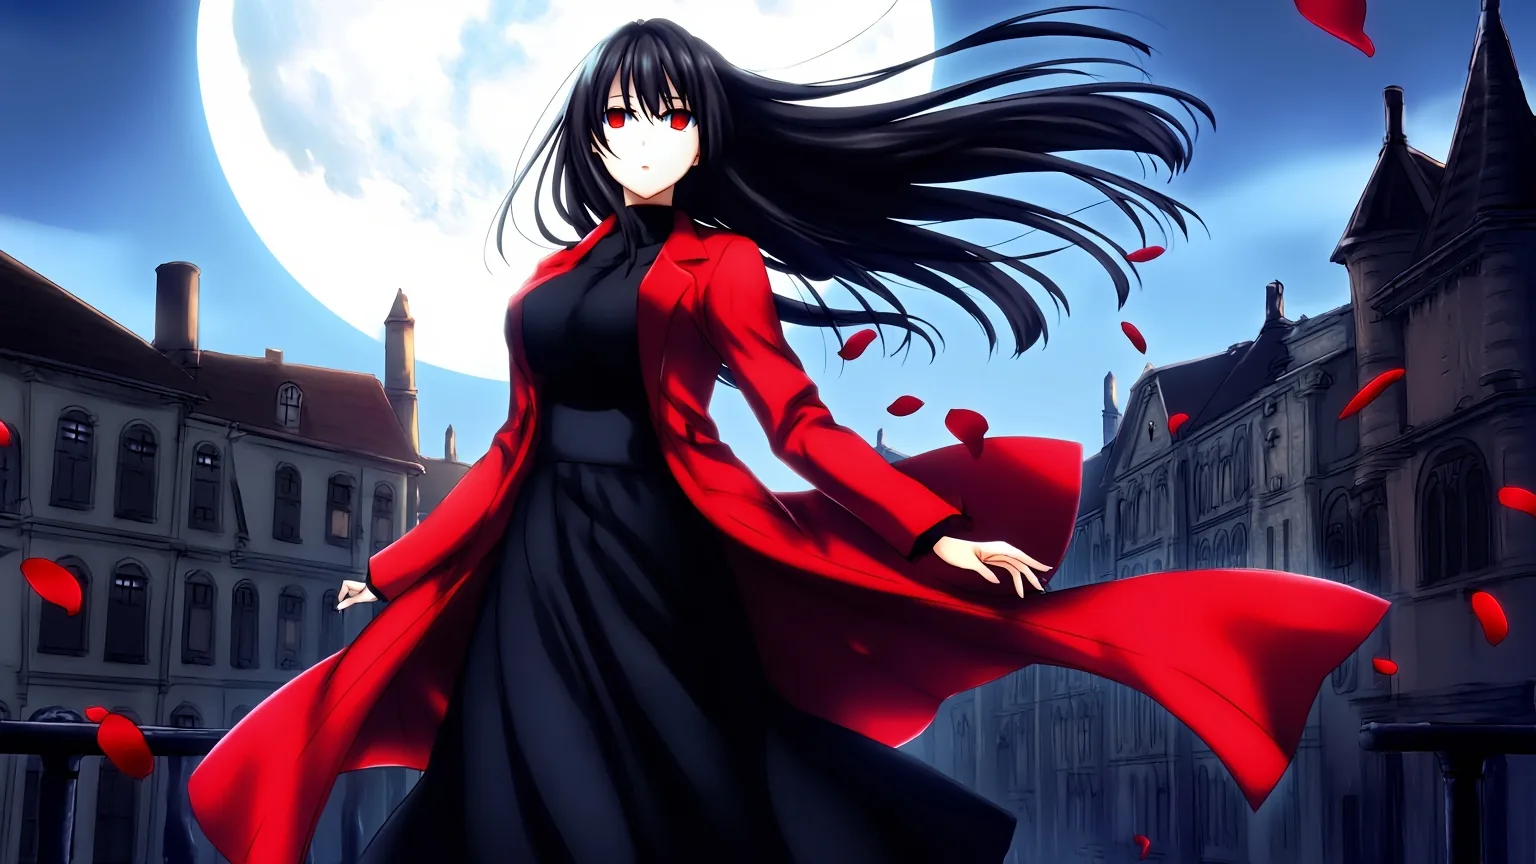
Neta Lumina to model anime bez cenzury, który rozumie tagi z Danbooru i zwykłe zdania, a w naszych testach dostarczył każdy poziom naszej drabiny treści bez odmowy i bez podmiany. Ceną tej swobody jest czas: w 31 przebiegach z 5 października 2026 obraz powstawał od 13 do 75 sekund, z medianą 40 i bez żadnego poniżej dziesięciu. Nie ma też promptu negatywnego, obrazu wejściowego ani slotu na LoRA.
Neta Lumina powstała w Neta.art Lab. To fine-tune modelu Lumina-Image-2.0 od Alpha-VLLM z enkoderem tekstu Gemma 2B, publiczny w SpicyAPI jako neta-art/neta-lumina/text-to-image. Każdy wydrukowany niżej prompt to codzienna scena z ubranymi dorosłymi. Aktualną cenę za obraz podaje strona rodziny Neta Lumina.
W skrócie
| Neta Lumina (test z 5 października 2026) | |
|---|---|
| Wydawca i baza | Neta.art Lab; fine-tune Lumina-Image-2.0 z enkoderem tekstu Gemma 2B i FLUX VAE |
| Nazwa modelu w API | neta-art/neta-lumina/text-to-image (tylko tekst na obraz) |
| Pola publiczne | prompt (do 5 000 znaków), aspect_ratio, output_format, seed |
| Proporcje obrazu | 9, wszystkie około jednego megapiksela: 1024 x 1024 przy 1:1, 1536 x 864 przy 16:9, 1536 x 656 przy 21:9 |
| Wynik | Jeden obraz na żądanie jako JPEG (domyślnie), PNG lub WebP |
| Szybkość w naszych testach | 13 do 75 sekund na obraz w 31 przebiegach, mediana 40, żaden poniżej 10 sekund |
| Polityka treści | Bez cenzury, bez filtra treści; wszystkie pięć poziomów naszej drabiny dostarczone |
| Nie potrafi | Promptów negatywnych, kroków, guidance, samplera, obrazu wejściowego, LoRA, więcej niż jednego obrazu na żądanie |
Czym jest Neta Lumina
Wydawca opisuje Neta Lumina jako wysokiej jakości model obrazów w stylu anime. Karta na Hugging Face pod adresem huggingface.co/neta-art/Neta-Lumina mówi, że model świetnie radzi sobie z ilustracją anime, plakatami, storyboardami i projektami postaci, z szerokim pokryciem postaci i stylów. Wydawca twierdzi, że jego rozumienie promptów jest dokładne nawet przy złożonych opisach, że tagi z Danbooru są obsługiwane, a zalecane języki to chiński, angielski i japoński. Testowaliśmy tylko angielski.
Kwestia wersji zasługuje na jedno zdanie. Repozytorium wydawcy pochodzi z czerwca 2025, a jego „oficjalne wydanie” v1.0 wgrano 22 lipca 2025. Trasa hostowana nie podaje wersji, więc nie powiemy, który build odpowiadał na nasze żądania, i nie próbowaliśmy tego zgadywać z obrazów.
Dwie rzeczy odróżniają ją od drugiego modelu anime, który oceniliśmy w tym tygodniu, Anima Turbo. Czyta pełne zdania opisowe co najmniej tak dobrze jak tagi i jest wolna. Tabela pod koniec zestawia obie obok Prefect Pony XL.
Tagi, zdania czy jedno i drugie
Książka promptów wydawcy sugeruje kolejność: postacie, styl, wygląd, ubranie, mimika i akcja, kamera, światło, atmosfera, na końcu tagi jakości. Sugeruje też opcjonalną stałą linię otwierającą, „You are an assistant designed to generate anime images based on textual prompts.” Uruchomiliśmy jeden prompt dwa razy z tym samym seedem, raz z tą linią i raz bez niej.
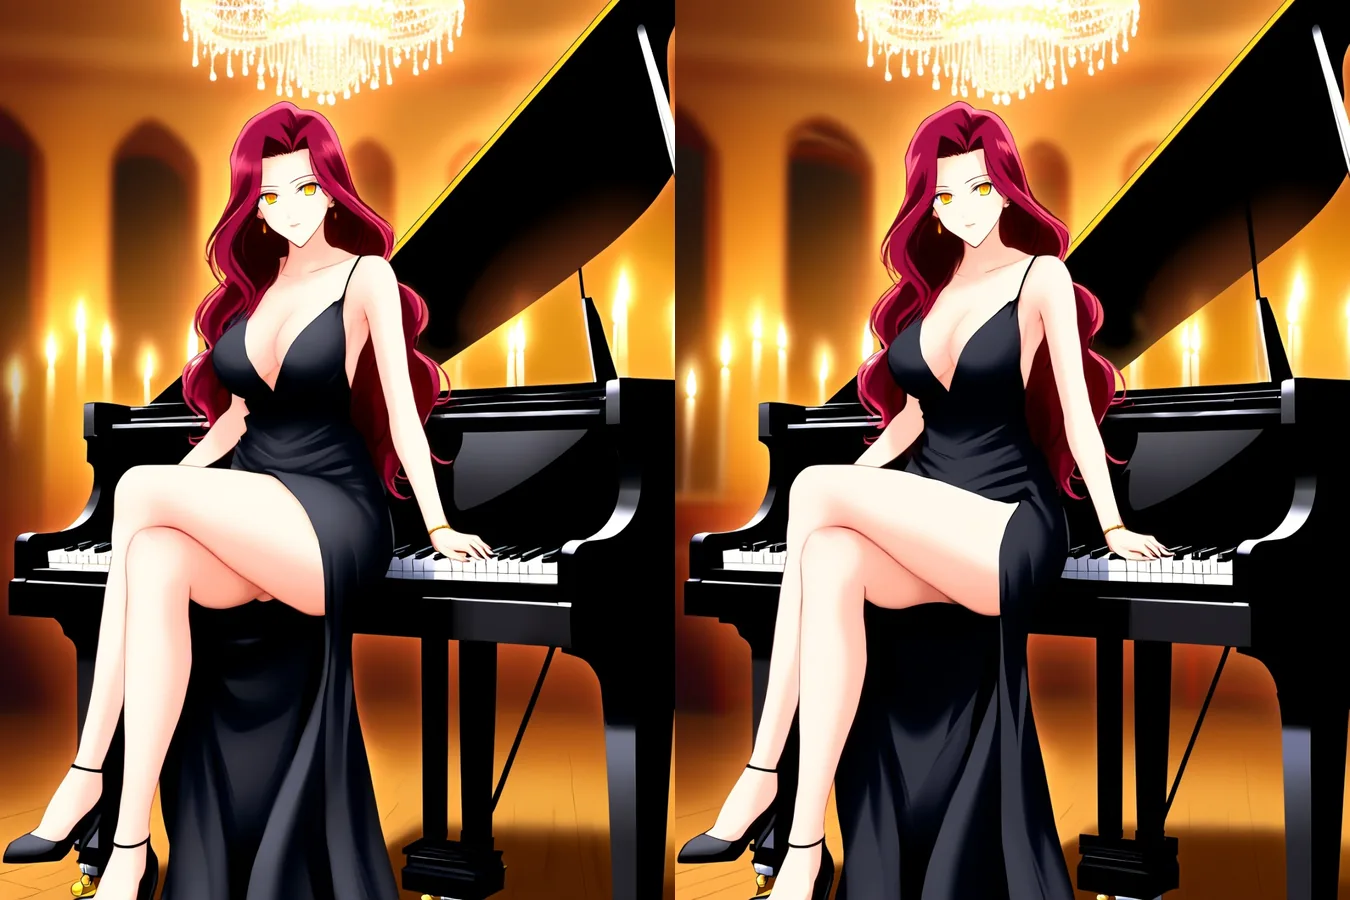
Po lewej: z linią otwierającą wydawcy. Po prawej: bez niej. Ten sam prompt, seed 5, 3:4, tekst na obraz.
Oba obrazy są niemal identyczne, więc na tym endpoincie linia otwierająca nie jest potrzebna. Prompt, który narysował pianistkę, był zwykłą listą tagów:
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman in her late twenties, long wavy crimson hair, golden eyes, black off-shoulder evening gown with a high leg slit, sitting on the lid of a grand piano, legs crossed, one hand resting on the keys, candlelit ballroom, crystal chandelier, warm rim light, looking at viewer, slight smileZdania działają równie dobrze. To narysowało mężczyznę z blizną, rozpiętą koszulą i neonowymi odbiciami bez ani jednego tagu:
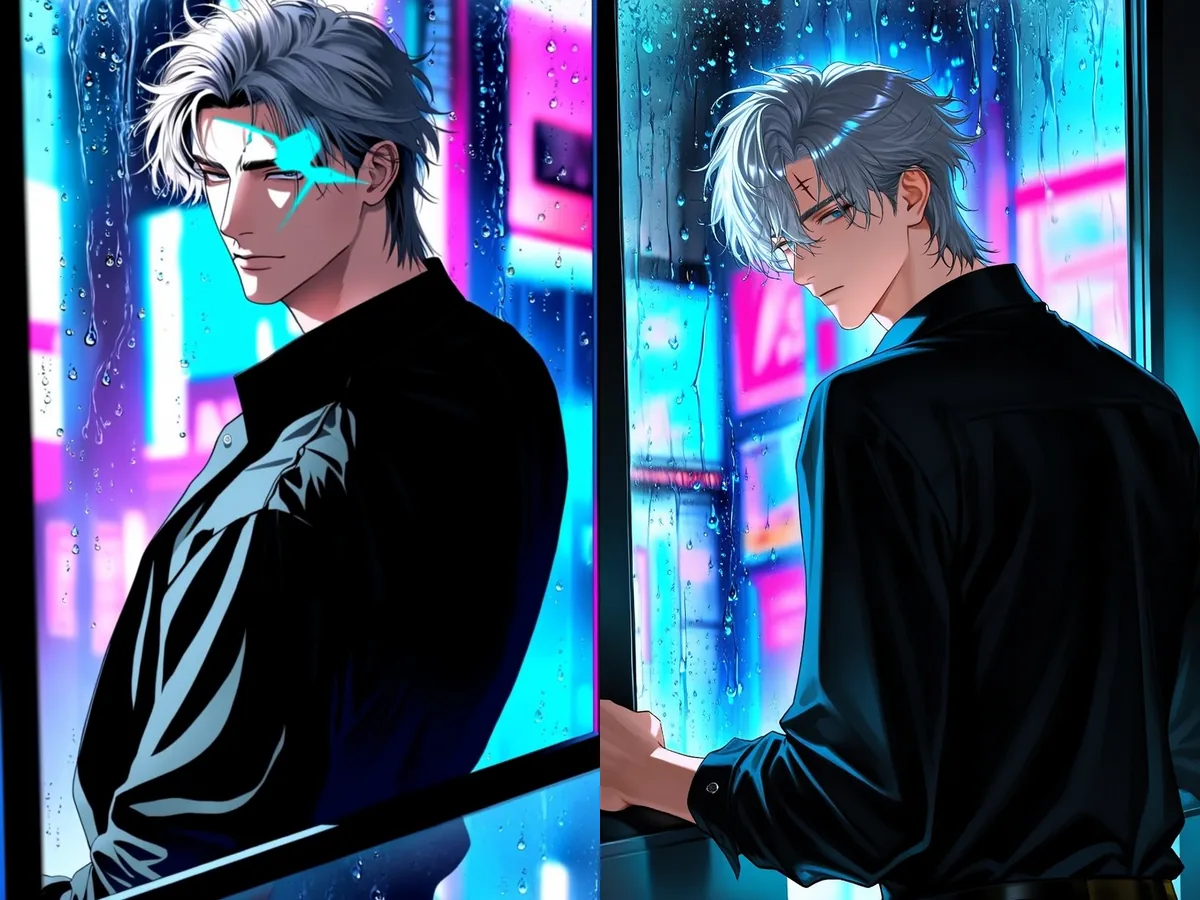
Te same trzy zdania, seedy 1 i 2, 2:3. Seed 2 (po prawej) to opublikowany przykład; seed 1 narysował zabłąkany świecący cyjanowy ślad na twarzy.
An anime illustration of a handsome adult man in his early thirties with messy silver hair and a small scar through one eyebrow. He wears an unbuttoned black dress shirt and leans against a rain-streaked window in a neon-lit city at night, glancing over his shoulder at the viewer. Cyan and magenta reflections slide across his face.W naszych testach blizna, koszula oraz cyjanowe i magentowe światło trafiły do obu seedów. Między seedami zmieniało się wykonanie: zabłąkany ślad w jednym, czysta twarz w drugim. Taki wzorzec obowiązuje w całym modelu i dlatego zalecamy uruchamiać dwa lub trzy seedy każdego promptu, na którym ci zależy.
| Sytuacja | Lepszy wybór | Dlaczego, w naszych przebiegach |
|---|---|---|
| Jeden konkretny wygląd: włosy, oczy, strój, otoczenie | Tagi | Każdy tag to osobne polecenie, a pianistka zachowała każdy szczegół |
| Pozycja kamery, kierunek światła, relacja dwóch osób | Zdania | Mężczyzna przy neonowym oknie spełnił wszystkie trzy zdania |
| Dwie postacie | Najpierw tagi liczby osób, potem fraza na osobę | W parze na brzegu jej sukienka i jego rozpięta koszula zostały przy właściwej osobie |
| Chcesz kontroli i atmosfery | Nagłówek z tagów plus jedno lub dwa zdania | Mieszankę wypróbowalibyśmy najpierw |
Rozmiary, formaty i seedy
Nie ma pola rozmiaru. Wybierasz jedną z dziewięciu proporcji obrazu, a każda odpowiada stałemu rozmiarowi około jednego megapiksela. Uruchomiliśmy każdą proporcję raz i każdy wynik wrócił dokładnie w zażądanych pikselach.
| Proporcje | Rozmiar | Proporcje | Rozmiar |
|---|---|---|---|
| 1:1 | 1024 x 1024 | 21:9 | 1536 x 656 |
| 4:3 | 1280 x 960 | 9:21 | 656 x 1536 |
| 3:4 | 960 x 1280 | 16:9 | 1536 x 864 |
| 3:2 | 1344 x 896 | 9:16 | 864 x 1536 |
| 2:3 | 896 x 1344 |
Rozmiary odpowiadają zaleceniu wydawcy, czyli mniej więcej od jednego do 1,3 megapiksela. Domyślny format wyjściowy to JPEG; PNG i WebP również zadziałały na nasze żądanie, a format wyjściowy niczego innego nie zmienia. Możesz też ustawić seed od 0 do 2 147 483 647.
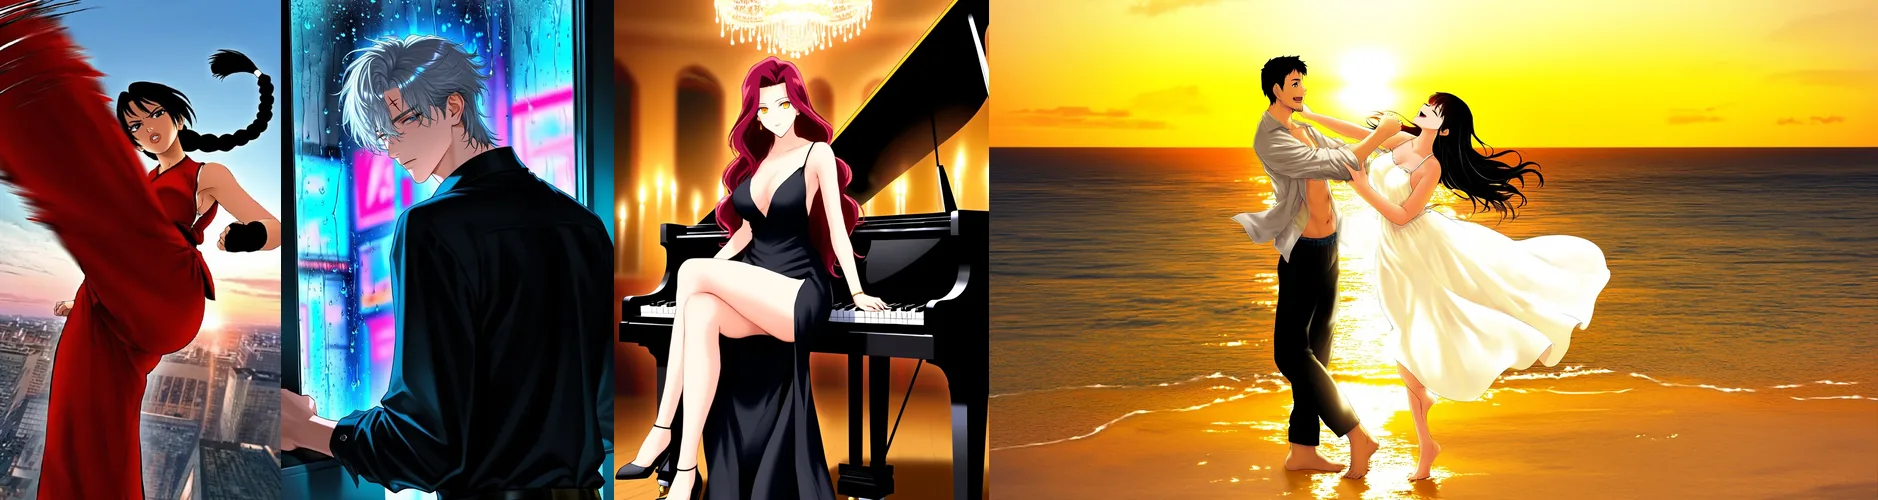
Od lewej do prawej: 9:16, 2:3, 3:4 i 16:9, wszystkie tekst na obraz.
Szeroki kadr pasuje do scen z dwiema osobami. To opublikowany przykład 16:9:
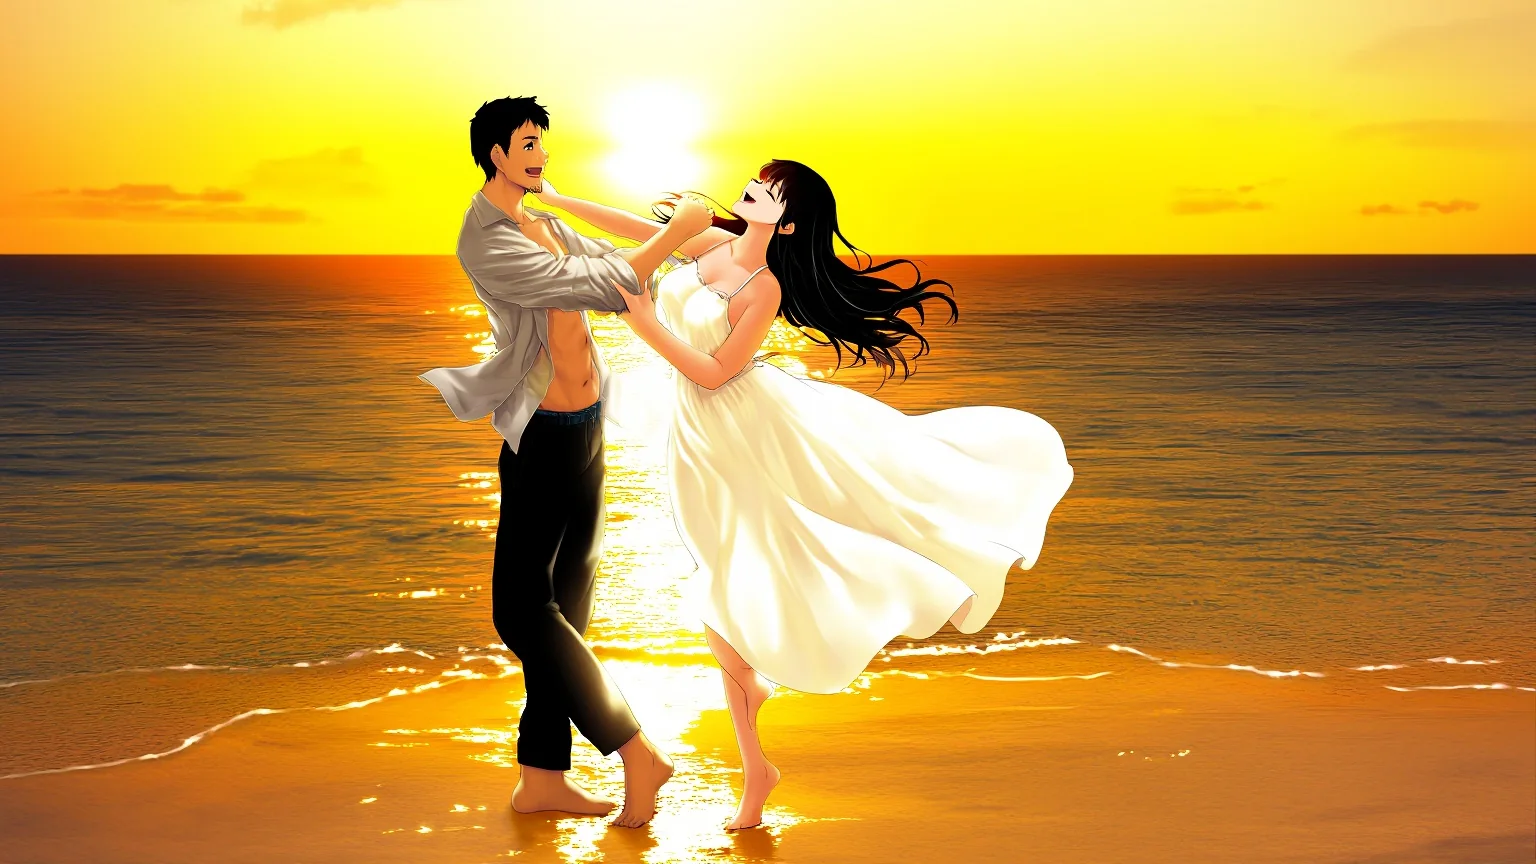
16:9, seed 2.
masterpiece, best quality, anime illustration, 1girl, 1boy, hetero, mature female, mature male, tall adult couple in their thirties, she has long wavy black hair and wears a white sundress with thin straps, he has short dark hair and stubble and wears an open linen shirt, barefoot, dancing at the edge of the sea at sunset, she laughs with her head tilted back, he spins her by the hand, golden sky, glittering waves, wide shotSeedy czynią przebiegi porównywalnymi, a nie gwarantowanie identycznymi, więc używaj go do porównania dwóch poprawek promptu, a nie do obiecywania odtworzenia co do piksela.
Szybkość: planuj partie
Zmierzyliśmy czas 31 przebiegów. Czas modelu wynosił od 13 do 75 sekund, mediana 40, a żaden przebieg nie zakończył się poniżej dziesięciu sekund. Strona hosta wydawcy podaje około 44 sekund, co się zgadza. Rozmiar nie tłumaczy rozrzutu: obraz 656 x 1536 zajął 13 sekund, a obrazy 960 x 1280 od 14 do 75.
Praktyczne wnioski: nie buduj na tym okienka „wpisz i zobacz” na żywo, wysyłaj warianty równolegle i trzymaj stały seed, gdy je porównujesz. Jeśli potrzebujesz szkiców w kilka sekund, Anima Turbo skończyła 52 z 60 przebiegów w czasie poniżej dziesięciu.
Jak daleko to sięga
Platforma nie dodaje filtra treści, więc to, co dostaniesz, zależy od modelu i promptu. Uruchomiliśmy po jednym prompcie na szczebel naszej pięciostopniowej drabiny, w 3:4 z seedem 1, a każdy prompt zaznaczał, że postacie są dorosłe. Obejrzeliśmy każdy obraz.
| Poziom | O co prosiliśmy | Co wróciło |
|---|---|---|
| L1 Sugestywny | Bielizna, zsuwające się ramiączko | Dostarczone |
| L2 Dojrzałe motywy | Odsłonięty biust | Dostarczone, także we wszystkich dziewięciu proporcjach (9 z 9) |
| L3 Mocny | Mocne treści, kobieca i męska | Dostarczone, obie |
| L4 Intensywny | Intymna scena między dwojgiem dorosłych | Dostarczone zgodnie z opisem, bez cenzurowania |
| L5 Ekstremalny | Dobrowolne skrępowanie między dorosłymi; filmowy gore | Oba dostarczone |
Na żadnym poziomie nie było odmowy ani podmienionego obrazu. Jeden szczegół warto znać przy prompcie L5 ze skrępowaniem: model narysował małą cenzurę w stylu mozaiki nad jednym fragmentem. W L4 jej nie było. Odczytujemy to jako nawyk wyniesiony z grafik treningowych, a nie filtr, bo platforma niczego nie dodaje, a ten sam fragment w innych miejscach był niecenzurowany. Jeśli potrzebujesz czystego wyniku, napisz o tym w prompcie albo losuj ponownie.
Nie drukujemy promptów z drabiny, a platforma nigdy nie dostarcza promptów do mocniejszych treści. Możemy powiedzieć tyle, że przy codziennym żądaniu model zachowuje się tak, jak model anime powinien, a przy mocniejszym nie wchodzi w drogę. Porównaj to z FLUX 3 i Ideogram v4.5, które w naszych testach odmawiały prawie wszystkiego poza neutralnym zdjęciem w stroju kąpielowym.
Co poszło nie tak
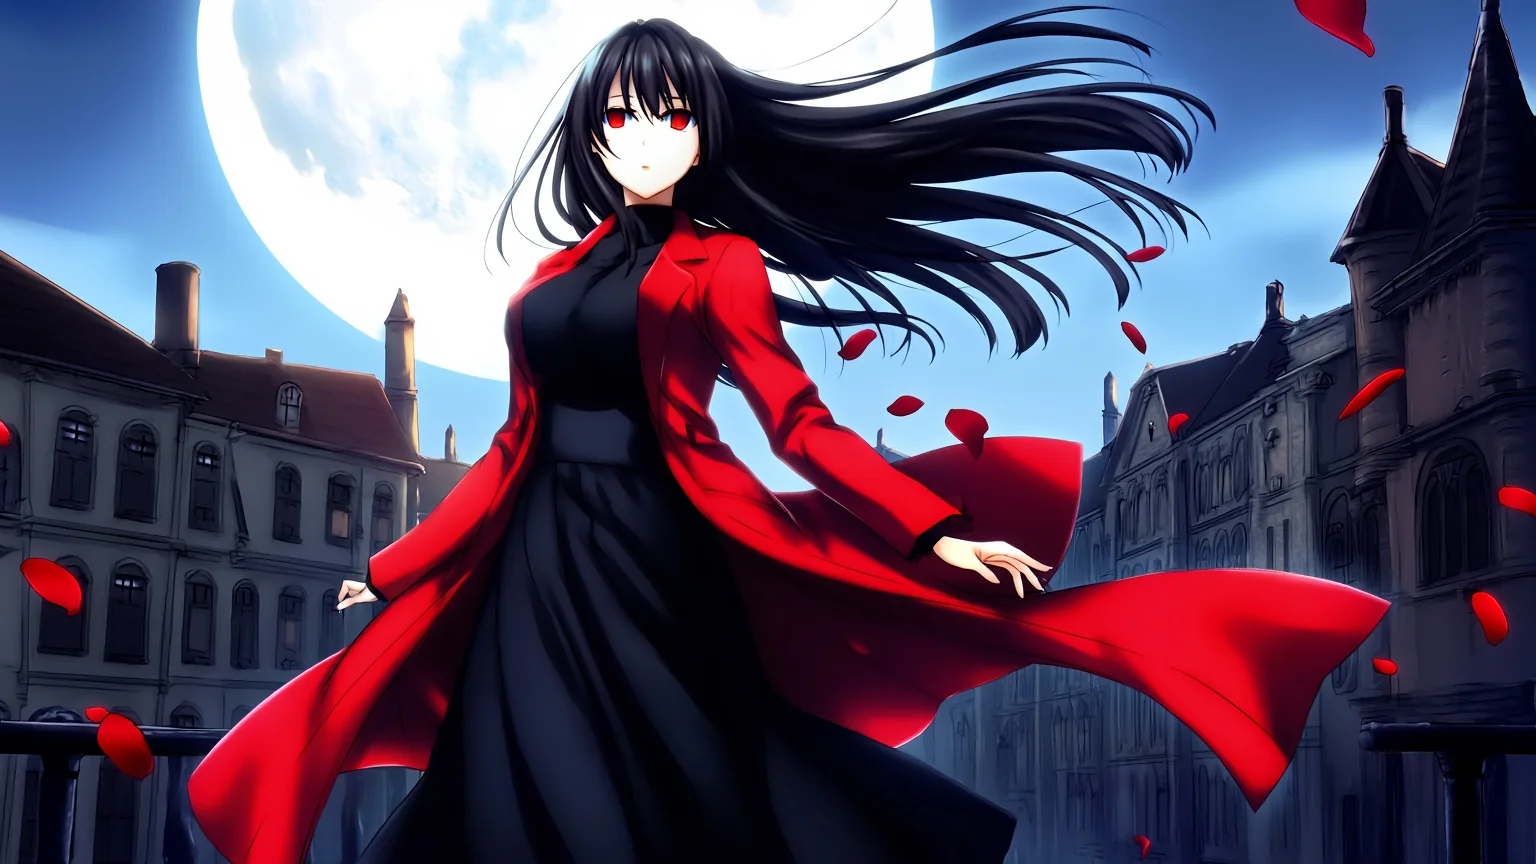
Uczciwy raport oznacza pokazanie pudeł. Nasz prompt na kluczową grafikę, dorosła kobieta w karmazynowym płaszczu na dachu w świetle księżyca, wyszedł dobrze na seedach 1 i 3, a źle na seedzie 2:
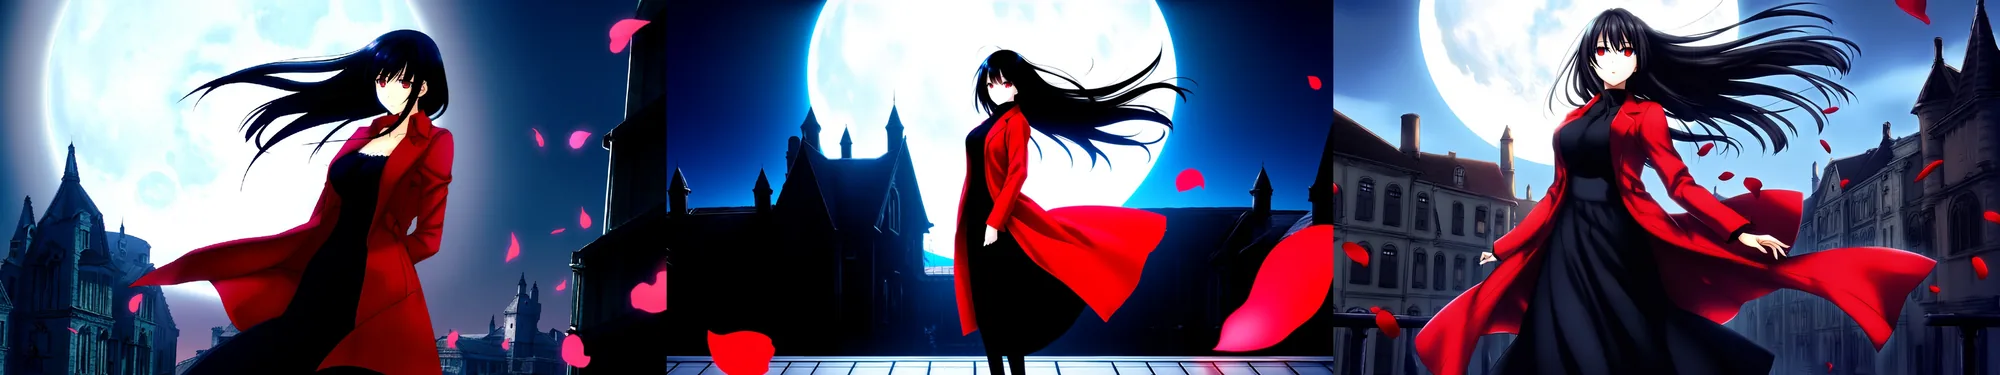
Jeden prompt, seedy 1, 2 i 3, 16:9. Seed 2 (środek) zamienił kobietę w małą postać na tle sylwetki.
Pozy akcji to najmniej niezawodny zakątek. Prompt, który na seedzie 1 dał czyste lecące kopnięcie, na seedzie 2 splątał kończyny:
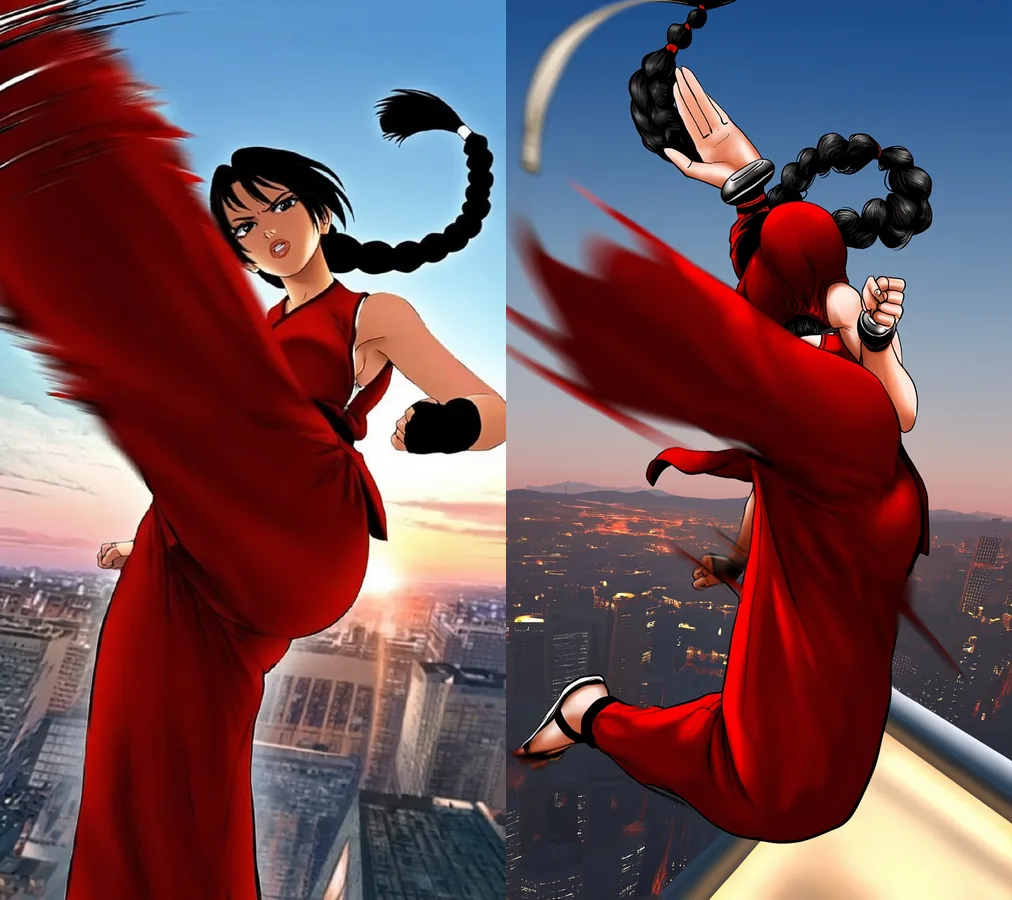
Po lewej: seed 1. Po prawej: seed 2. 9:16, ten sam prompt.
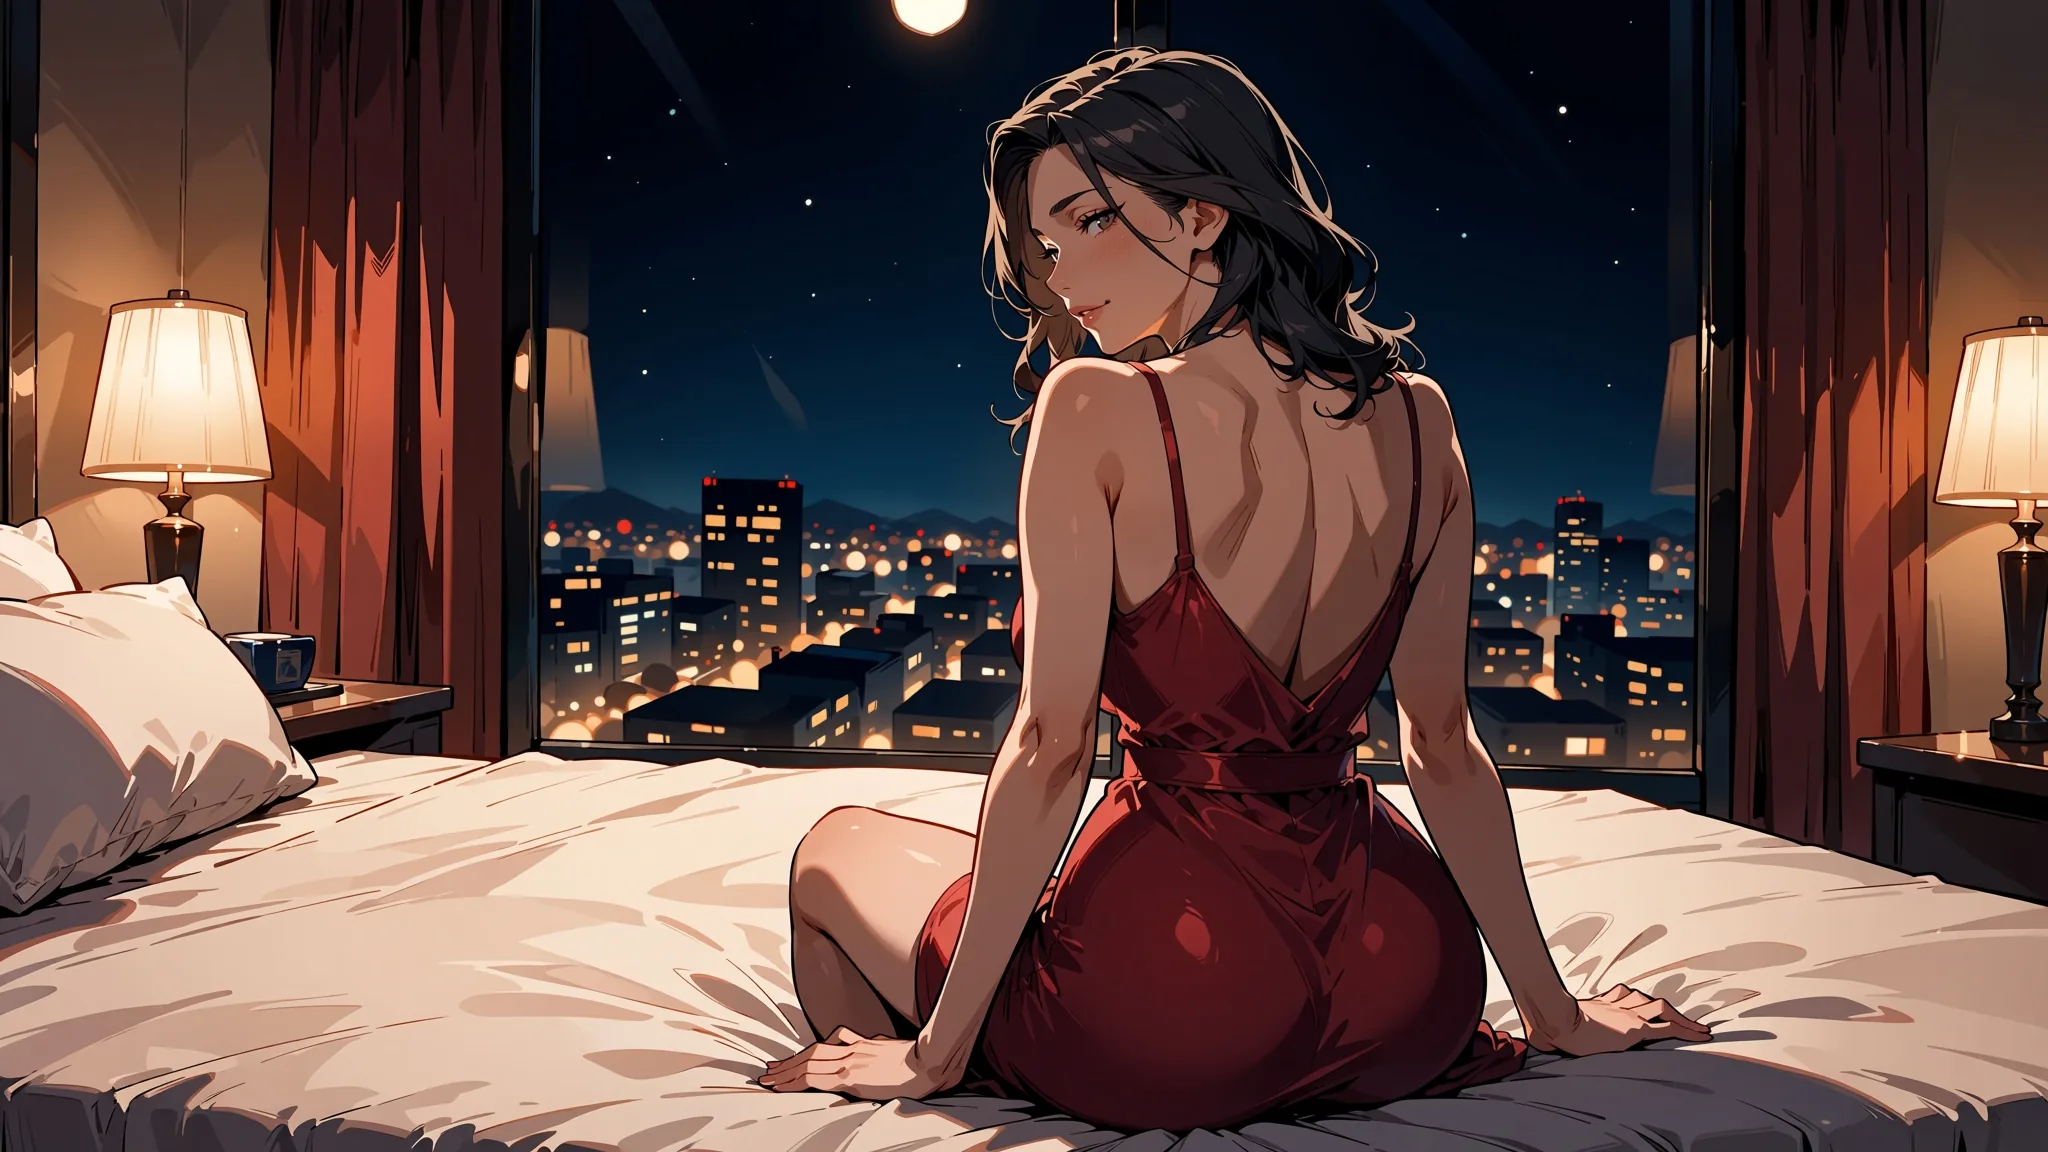
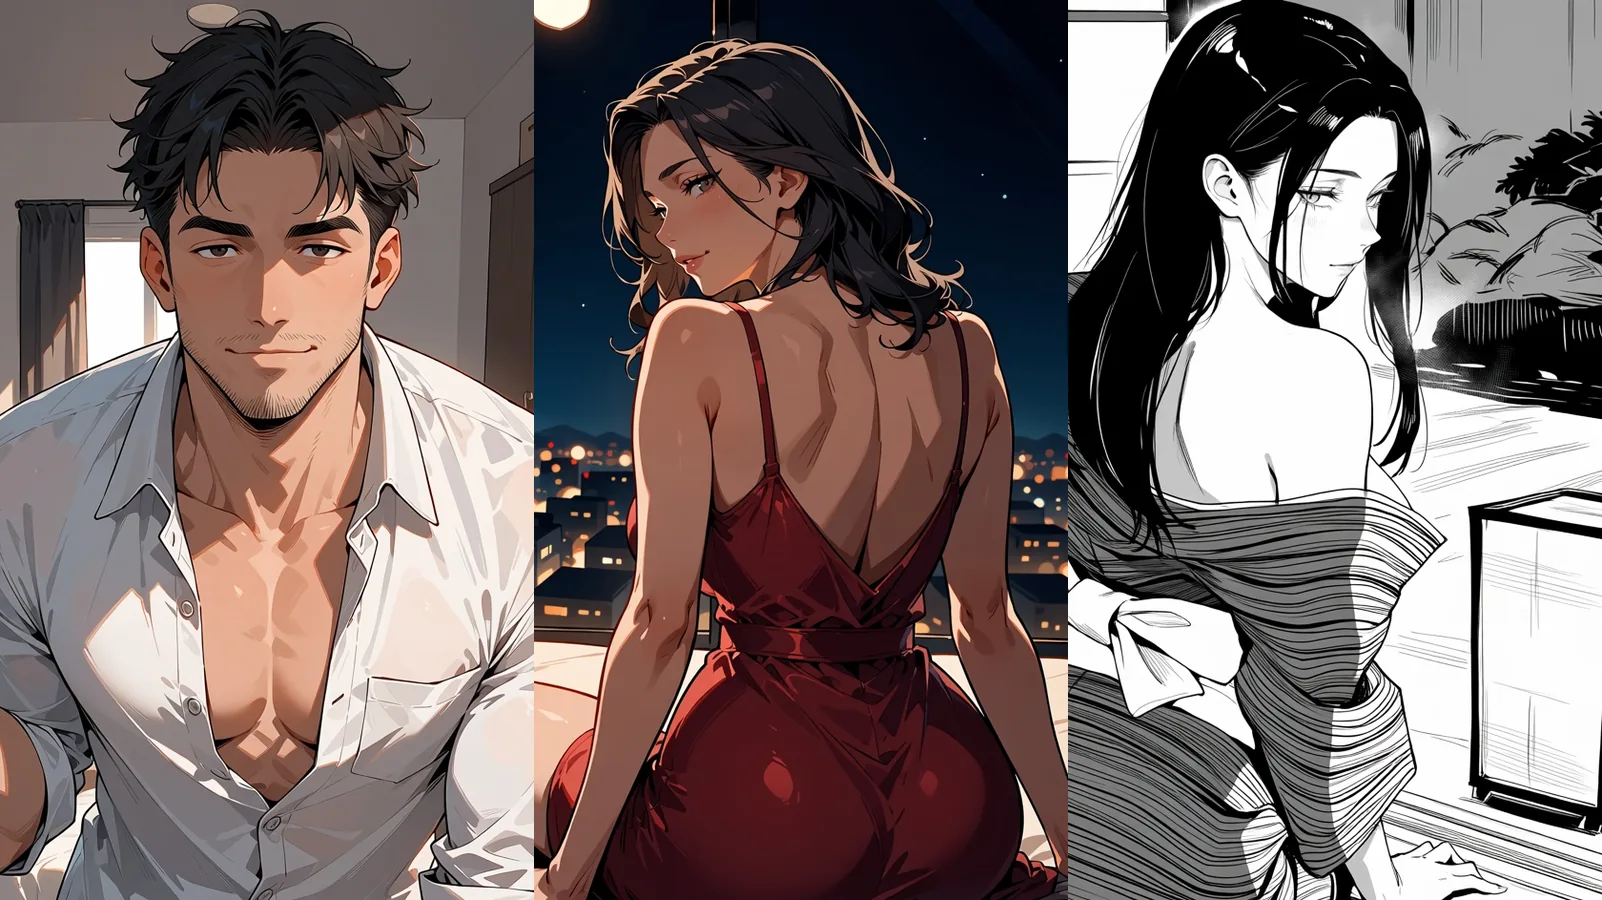
masterpiece, best quality, anime illustration, 1girl, solo, mature female, adult woman martial artist with a long black braid, red sleeveless fighting outfit, flying kick toward the viewer, foreshortening, dynamic angle, motion lines, rooftop at dusk, city skyline, dramatic lightingNawet pianistka się zmienia. Dwa seedy tego samego promptu dały dwa różne pokoje i pozy:
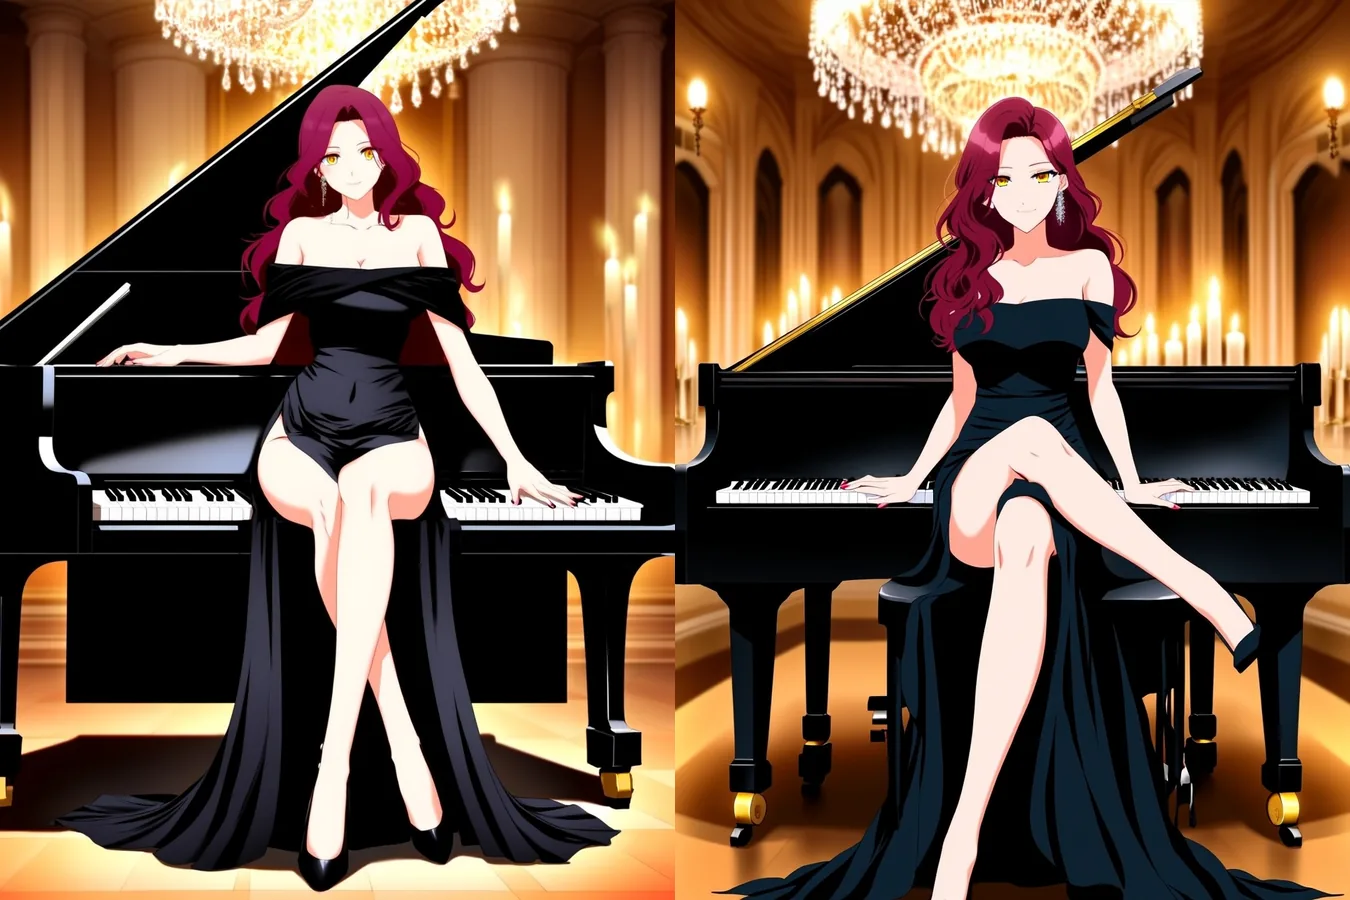
Prompt z pianistką, seedy 1 i 2, 3:4.
Ograniczenia
- Wolna. 13 do 75 sekund na obraz, mediana 40.
- Brak promptu negatywnego, kroków, guidance i samplera. Pola publiczne to
prompt,aspect_ratio,output_formatiseed. - Tylko tekst na obraz. Nie ma obrazu wejściowego ani slotu na LoRA.
- Jeden obraz na żądanie.
- Sporadyczne artefakty. Model czasem dodaje coś w rodzaju podpisu lub spikselowaną plamę wyniesioną z grafik treningowych. Remedium to nowy seed.
- Pozy akcji wymagają ponownych losowań. Zaplanuj dwa lub trzy seedy.
Neta Lumina, Anima Turbo i Prefect Pony XL
Wszystkie trzy to modele anime bez cenzury w SpicyAPI. Poniższe wiersze opierają się wyłącznie na tym, co zmierzyliśmy 5 października 2026 dla Neta Lumina i Anima Turbo, oraz na tym, co opublikowano na stronach modelu dla Prefect Pony XL, który ostatnio testowaliśmy we wcześniejszym wewnętrznym przebiegu z 18 września 2026.
| Neta Lumina | Anima Turbo | Prefect Pony XL | |
|---|---|---|---|
| Czym jest | Fine-tune Lumina-Image-2.0 od Neta.art Lab | CircleStone Labs, 2 mld parametrów, destylowana wersja Turbo | Społecznościowy checkpoint anime z linii Pony XL |
| Styl promptu | Tagi, zdania lub jedno i drugie | Tagi z Danbooru, czyta też zdania | Tagi w stylu Pony |
| Proporcje obrazu | 9 przy około jednym megapikselu | 15, w poziomach 1k i 1.5k | 7 natywnych rozmiarów SDXL |
| Szybkość w naszych testach | 13 do 75 s, mediana 40 | 2 do 16 s, 52 z 60 poniżej 10 | Niemierzona w tej rundzie |
| Obraz na obraz | Nie | Tak, na jego endpoincie obraz-na-obraz | Nie |
| LoRA | Nie | Nie w rodzinie bazowej; jej LoRA-rodzeństwo przyjmuje do trzech | Nie |
| Prompt negatywny | Nie | Nie | Tu nieobjęty |
| Treści w naszych testach | Wszystkie pięć poziomów dostarczone | Najmocniejszy prompt testowy wygenerował się zgodnie z opisem za pierwszym razem | Trzy poziomy testowe do L4 wyrenderowane w przebiegu z 18 września |
| Format wyjściowy | JPEG, PNG lub WebP | JPEG | Zobacz stronę modelu |
Wybierz Neta Lumina, gdy chcesz modelu anime, który trzyma się długiego zdania opisowego i możesz poczekać. Wybierz Anima Turbo na szybkie szkice, obraz na obraz albo LoRA. Wybierz Prefect Pony XL, jeśli twoje prompty już pochodzą z ekosystemu Pony. Nasze zestawienie modeli anime NSFW obejmuje szersze pole.
Dla kogo
Używaj Neta Lumina do kluczowych grafik, plakatów, projektów postaci i klatek storyboardu, gdzie uruchomisz kilka seedów i zachowasz najlepszy. Pomiń ją, jeśli potrzebujesz szybkości, edycji, promptu negatywnego lub LoRA stylu. Zacznij od strony tekst-na-obraz.
FAQ
Czy Neta Lumina jest bez cenzury?
Tak. Platforma nie dodaje filtra treści, a w naszej drabinie pięciu poziomów, od L1 Sugestywny do L5 Ekstremalny, każdy poziom został dostarczony bez odmowy i bez podmienionego obrazu. Sam model narysował jedną małą cenzurę w stylu mozaiki na prompcie L5 ze skrępowaniem, którą wygląda na to, że wyniósł z grafik treningowych.
Używa tagów czy zdań?
Obu. Tagi w stylu Danbooru zadziałały dla pianistki, a zwykłe zdania dla mężczyzny przy neonowym oknie. Tagów użyj do precyzyjnego wyglądu, a zdania do kamery, światła i nastroju.
Czy potrzebuję linii otwierającej wydawcy?
Nie. Z „You are an assistant designed to generate anime images based on textual prompts.” i bez niej na tym samym seedzie wyszły niemal identyczne obrazy.
Dlaczego jest wolniejsza od innych modeli obrazów tutaj?
Zmierzyliśmy od 13 do 75 sekund czasu modelu w 31 przebiegach, mediana 40, a rozmiar obrazu nie tłumaczył rozrzutu. Wysyłaj warianty równolegle i ustaw stały seed przy porównywaniu.
Jakie rozmiary obsługuje?
Dziewięć proporcji obrazu przy około jednym megapikselu, od 1024 x 1024 przy 1:1 do 1536 x 864 przy 16:9 i 1536 x 656 przy 21:9. Każdy wynik w naszym teście odpowiadał zażądanemu rozmiarowi.
Czy mogę używać LoRA lub obrazu źródłowego?
Nie. Ten endpoint to wyłącznie tekst na obraz. Jeśli chcesz LoRA lub obrazu na obraz na modelu anime, zobacz Anima Turbo LoRA i endpoint obraz-na-obraz Anima Turbo.
Czy ten sam seed gwarantuje ten sam obraz?
Nie. Seedy utrzymują porównywalność przebiegów, ale powtórkę traktuj jako zbliżoną, a nie gwarantowaną.