Einführung
P-Image LoRA Text zu Bild zeichnet aus einem geschriebenen Prompt ein Bild auf P-Image, Pruna AIs auf Tempo ausgelegtem Text-zu-Bild-Modell, wobei eine LoRA-Datei Ihrer Wahl geladen ist. Wählen Sie eines von sieben Seitenverhältnissen oder legen Sie eine eigene Größe bis 1440 Pixel pro Seite fest. Die Plattform legt keinen Content-Filter über Prompt, Gewichte oder Bild.
Modus nach dem Ausgangsmaterial wählen
| Ausgangsmaterial | Modus |
|---|---|
| eine geschriebene Beschreibung | P-Image LoRA Text zu Bild |
| ein oder mehrere Bilder, die verändert werden sollen | P-Image LoRA Bildbearbeitung |
Wichtige Funktionen und Highlights
Wenige Sekunden pro Bild
Pruna hat P-Image auf Tempo gebaut. In unseren Tests brauchte das Modell ohne LoRA etwa drei bis fünf Sekunden pro Bild und beim ersten Holen einer LoRA-Datei ein paar Sekunden mehr.
Eine LoRA, ein ganz neuer Look
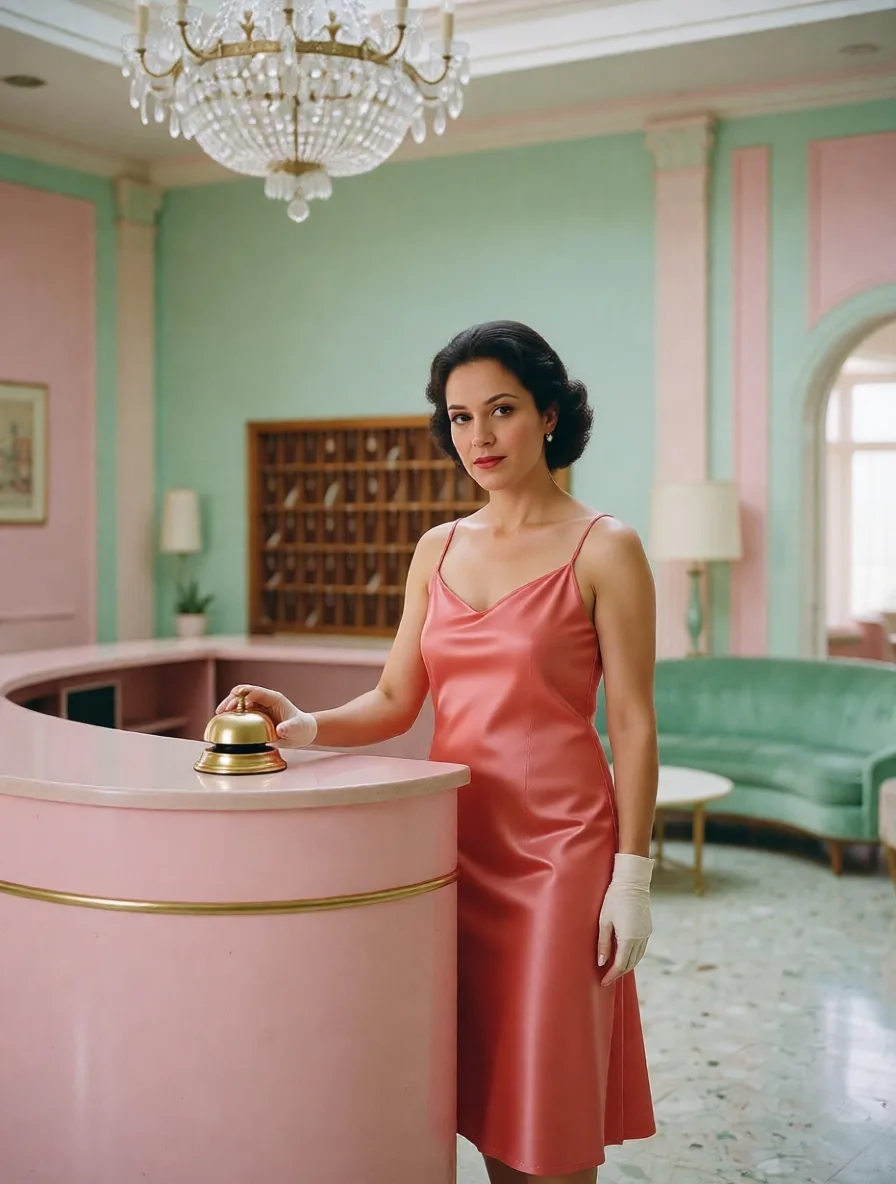
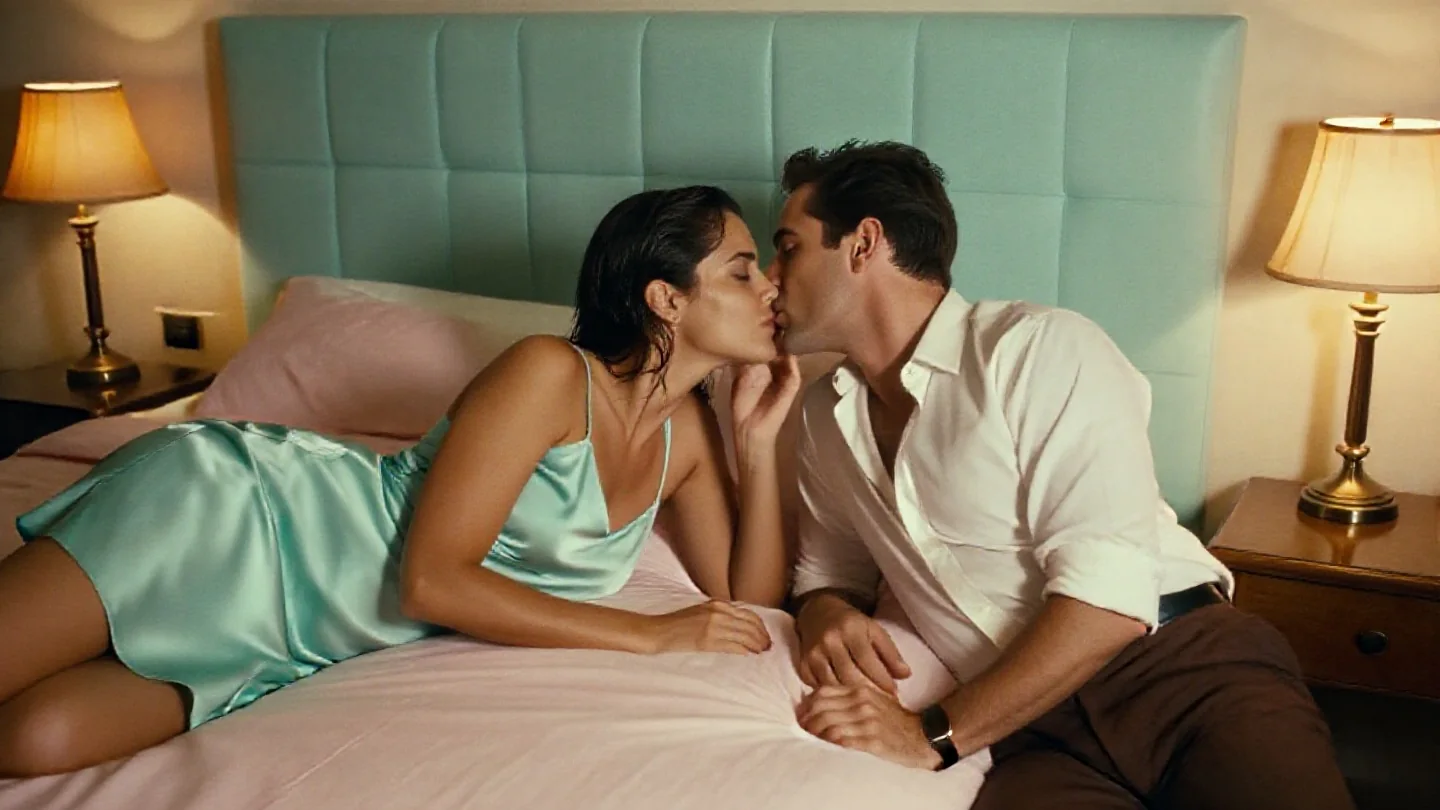
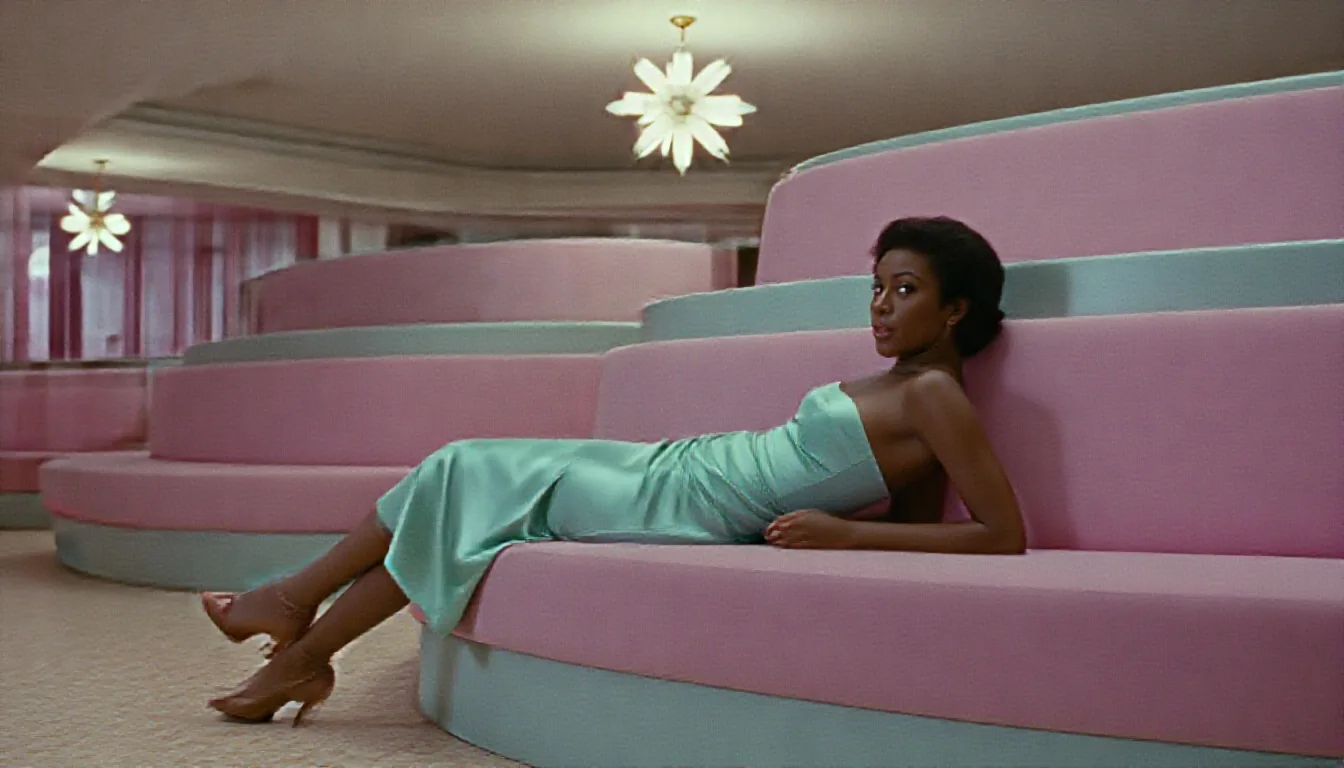
Eine Filmfarben-LoRA, eine Blitzfoto-LoRA und eine Buntstift-LoRA veränderten in unseren Tests jeweils das ganze Bild. Die LoRA lädt von einem öffentlichen Link; vorab wird nichts zu uns hochgeladen, und die Datei wird nicht geprüft.
Eigene Größen
Neben sieben Seitenverhältnissen mit etwa einem Megapixel funktioniert jede Breite und Höhe von 256 bis 1440 Pixel in Schritten von 16, von quadratischen Thumbnails bis zu weiten Panoramen mit 1440 x 608.
Kein Inhaltsfilter
Nichts wird gefiltert oder abgelehnt. Das Modell liefert jede Stufe bis einschließlich Stark für Frauen und Männer wie geschrieben, auch die Stufe Maximal; Anfragen der Stufe Sehr stark kamen in unseren Tests mit Anatomiefehlern heraus, und genau dafür gibt es eine LoRA ohne Inhaltsfilter.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
prompt | Ja | Vollständige Sätze funktionieren am besten: Motiv, Kleidung, Ort, Licht und Objektiv. Setzen Sie das Trigger-Wort der LoRA an den Anfang. mindestens 1 Zeichen · höchstens 5000 Zeichen |
aspect_ratio | Nein | Sieben Formate mit etwa einem Megapixel: 1:1 sind 1024 x 1024, 16:9 sind 1344 x 768, 3:2 sind 1216 x 832, 4:3 sind 1152 x 896. |
width | Nein | Wird nur beim Seitenverhältnis custom verwendet: 256 bis 1440 Pixel in Schritten von 16, standardmäßig 1024. Ändert den Preis nicht. |
height | Nein | Wird nur beim Seitenverhältnis custom verwendet: 256 bis 1440 Pixel in Schritten von 16, standardmäßig 1024. Ändert den Preis nicht. |
loras | Nein | Ein Eintrag {path, scale}. Verwenden Sie einen öffentlichen Direktlink auf eine .safetensors-Datei, die mit dem P-Image-Trainer erstellt oder für Z-Image Turbo trainiert wurde. Standardwert: |
output_format | Nein | Standardmäßig JPEG, bei Bedarf PNG oder WebP. Das Format ändert den Preis nicht. |
seed | Nein | Hält eine Bildserie vergleichbar, während Sie ein Wort oder den LoRA-strength-Wert ändern. Er garantiert nicht bei jedem Durchlauf dieselben Pixel. |
Preis
$0.006 / Bild
Abgerechnet pro Bild. Das Seitenverhältnis, eine eigene Größe, das Ausgabeformat und das Laden einer LoRA ändern den Preis nicht.
Anwendungsfälle
Ein Hausstil mit Entwurfstempo
Laden Sie eine Stil-LoRA, lassen Sie ihr Trigger-Wort vorn stehen und arbeiten Sie eine Liste von Prompts ab. Jedes Bild teilt den Look, und jedes dauert Sekunden.
Öffentliche LoRAs ausprobieren
Testen Sie eine Community-LoRA an einem echten Prompt, bevor Sie etwas darauf aufbauen; ein Bild kostet mit oder ohne die Datei gleich viel.
Ungewöhnliche Formate
Banner, Panoramen und hohe Streifen in exakten Pixelgrößen, ohne hinterher zuzuschneiden.
Prompt-Leitfaden und Praxistipps
Sätze schreiben
Beschreiben Sie Motiv, Kleidung, Ort, Licht und Objektiv. Details wie ein Aufzugstor aus Messing oder ein Sternenkronleuchter kamen wie geschrieben heraus.
Das Trigger-Wort zuerst
Stil-LoRAs erwarten ihren Trigger am Anfang des Prompts. Vergleichen Sie denselben Seed mit und ohne die Datei, um zu sehen, was die LoRA selbst beiträgt.
Den strength-Wert moderat halten
Um 0,6 bis 1 zeigt sich eine Stil-LoRA deutlich; bei 2 begann das Bild in unseren Tests zu zerfallen, und bei 3 wurde es zu Rauschen. Negative Werte drücken vom Look der LoRA weg, ergaben aber fleckige Ergebnisse.
LoRAs für dieses Modell wählen
Mit dem P-Image-Trainer erstellte LoRAs und, in unseren Tests, Community-LoRAs, die für Z-Image Turbo trainiert sind, luden. LoRAs für FLUX- oder SDXL-Modelle ließen die Anfrage scheitern.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "pruna-ai/p-image-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.