Introducción
Kling 2.6 Imagen a video toma un cuadro inicial y un prompt que describe qué pasa después, y devuelve un clip fijo en 1080p de 5 o 10 segundos. Tampoco hay campo aspect_ratio: la salida toma la forma de tu imagen fuente. generate_audio es opcional: actívalo para diálogo o sonido ambiental renderizado con el movimiento.
Elige un modo de Kling 2.6 según tu material de partida
| Lo que tienes al empezar | Modo |
|---|---|
| una escena escrita | Kling 2.6 Texto a video |
| una imagen inicial ya aprobada | Kling 2.6 Imagen a video |
| un clip guía y una foto del personaje | Kling 2.6 Motion Control |
Funciones y aspectos destacados
El cuadro inicial ancla todo el clip
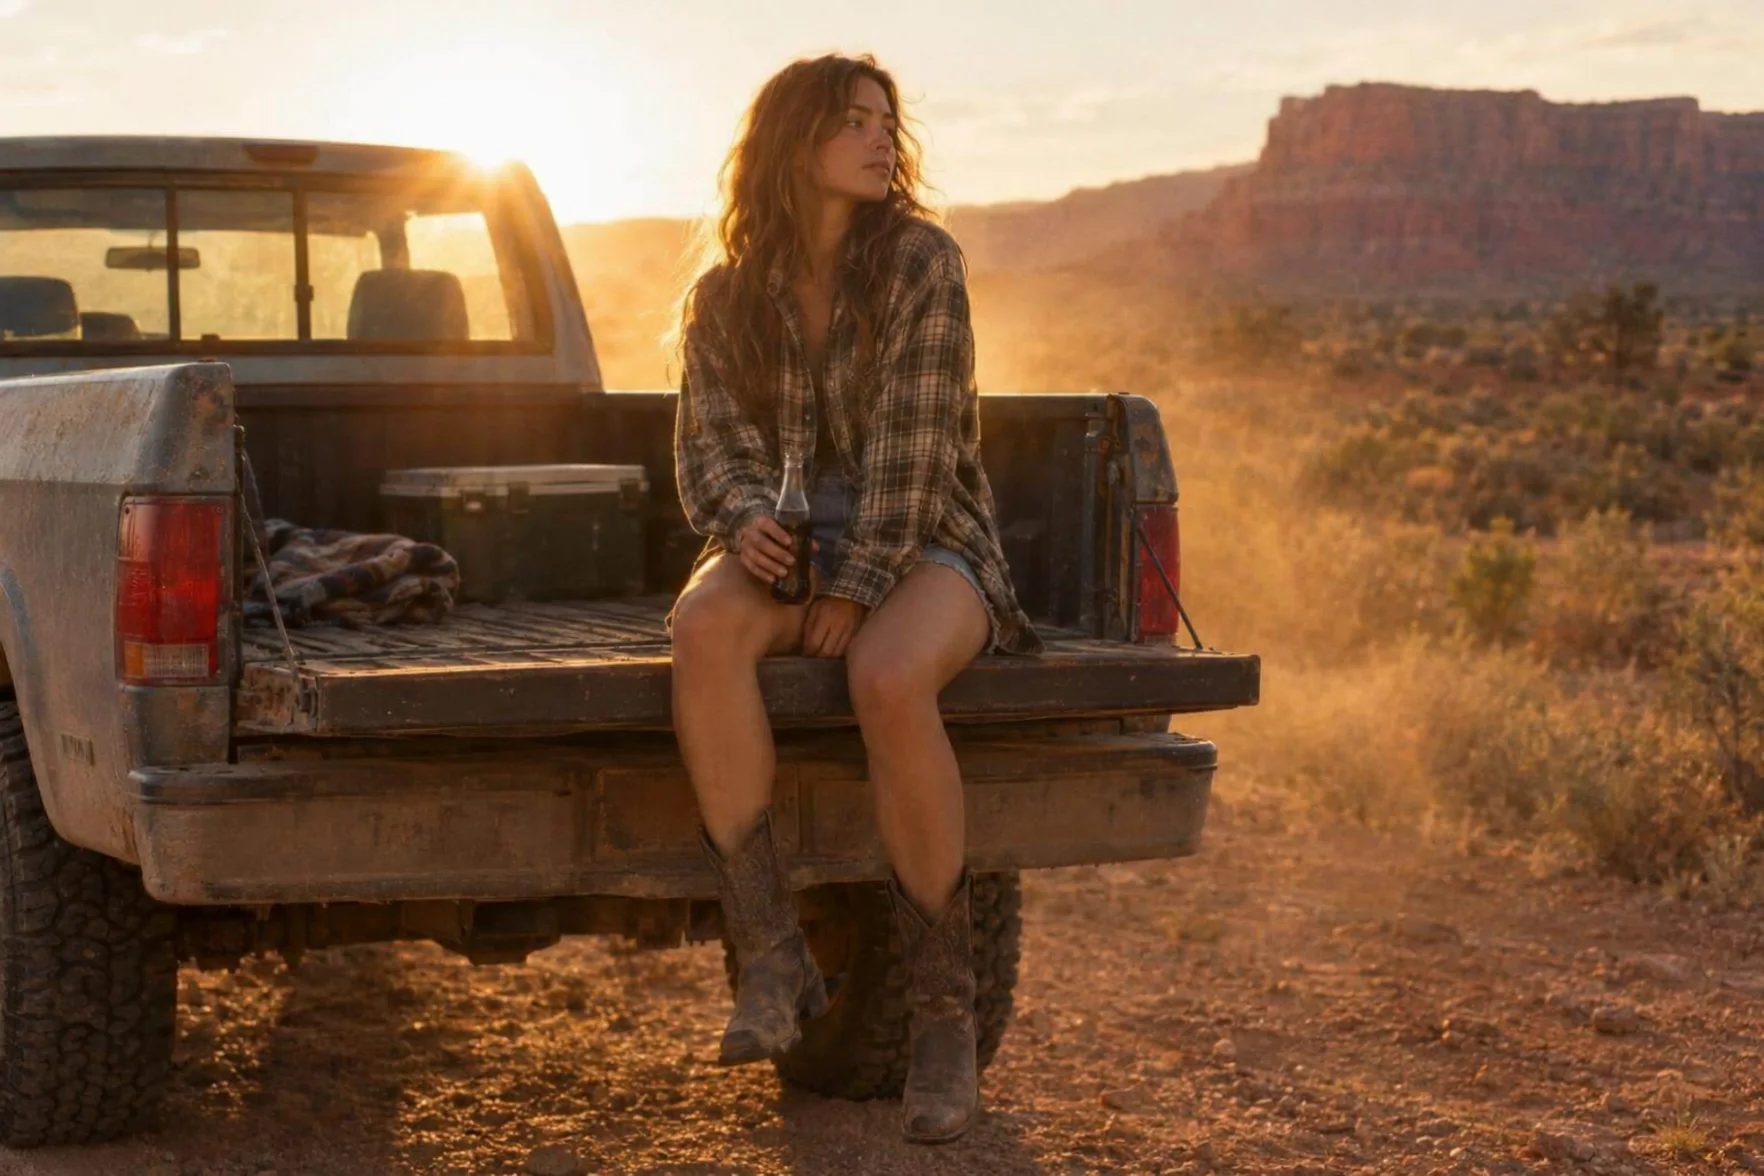
En nuestra prueba, la camisa a cuadros de una mujer, la camioneta y el escenario del desierto del cuadro inicial se mantuvieron durante todo el clip; el prompt solo aportó el gesto, el giro hacia el sol y la línea hablada. En nuestra prueba del remolque, una sola foto con camisa a cuadros se convirtió en un clip al atardecer con una línea hablada, viento del desierto y una camioneta que pasa, todo sin volver a describir el vestuario ni el escenario que la foto ya fijaba.
El sonido, cuando lo pides, sigue la acción
Con generate_audio activado, nuestra prueba devolvió viento del desierto, grillos y una camioneta que pasa sincronizados con el momento en que ella habla, aunque la mezcla sonó más baja que la imagen, algo que vale la pena volver a correr si necesitas el audio más presente.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | Sí | Describe solo lo que pasa después del cuadro: la acción, el movimiento de cámara y, si activas el sonido, el diálogo o el sonido ambiental. mínimo 1 caracteres · máximo 2500 caracteres |
image_url | Sí | Cuadro inicial. La persona, el atuendo y el escenario de esta imagen se mantienen durante el clip. |
negative_prompt | No | Lo que no debe aparecer: una segunda persona, subtítulos, un objeto que el modelo vuelve a traer una y otra vez. Escribe una lista simple en lugar de frases negadas. máximo 2500 caracteres |
generate_audio | No | Apagado por defecto. Actívalo para una banda sonora generada, renderizada con la imagen; cuesta más por segundo. Valor predeterminado: |
duration_seconds | No | 5 o 10 segundos: no se acepta ningún otro valor. Determina el precio. |
guidance_scale | No | Qué tan estrictamente sigue el clip al prompt, de 0 a 1 en pasos de 0,01; por defecto 0,5. |
Precios
Se cobra por segundo de salida; activar el sonido cuesta más por segundo.
| Especificación | Precio |
|---|---|
| $0.069 / segundo |
| $0.138 / segundo |
Casos de uso
Convertir una foto fija aprobada en un momento musicalizado
Anima a un personaje, producto o lugar que ya tienes fijado en una foto, y agrega una línea hablada corta o sonido ambiental en lugar de describir toda una escena desde cero.
Clips sociales de formato fijo
1080p, 5 o 10 segundos, es una forma predecible y lista para publicar cuando no necesitas afinar la resolución ni la duración por clip. Ese formato fijo también hace de este endpoint una forma rápida de convertir un lote de fotos aprobadas de producto o personaje en una tanda de clips con el mismo formato para un feed.
Recrear la misma foto con líneas distintas
Como el cuadro inicial ancla el look, puedes pasar una misma imagen aprobada por varios prompts (una línea hablada distinta, un gesto distinto) y mantener a la persona, el vestuario y el escenario idénticos en cada versión.
Guía de prompts y consejos prácticos
Describe el siguiente momento, no toda la escena
Como el cuadro ya fija el look, el prompt solo necesita el movimiento, la cámara y, si generate_audio está activado, el diálogo o el sonido ambiental que quieras. Volver a describir el vestuario o el escenario que la foto ya muestra solo gasta palabras que el modelo podría dedicar a la acción.
Solo JPEG o PNG
El campo de imagen de este endpoint no acepta otros formatos. Convierte tu imagen fuente a JPEG o PNG antes de subirla. una fuente en WEBP o HEIC falla antes de que el trabajo siquiera empiece.
Si la mezcla de sonido sale baja, dilo en el prompt
Nuestra prueba del desierto devolvió el viento, los grillos y la camioneta sincronizados con el momento en que ella habla, pero mezclados más bajo que la imagen. Si el sonido ambiental necesita sonar tan fuerte como el diálogo, dilo explícitamente en el prompt en lugar de asumir una mezcla pareja por defecto.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/2.6/image-to-video",
  "input": {
    "duration_seconds": 5,
    "generate_audio": false,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.