Introducción
MiniMax H3 Referencias a video genera un plano a partir de una a nueve imágenes de referencia y de un prompt que las nombra por número: Picture 1, Picture 2, etc. Devuelve de 4 a 15 segundos enteros en 768p o 2k, en una de seis relaciones de aspecto, con sonido generado al mismo tiempo. A las imágenes se pueden sumar hasta tres videos y hasta tres audios de referencia, cada grupo con 15 segundos en total como máximo.
Elige el modo según el material inicial
| Material inicial | Modo |
|---|---|
| una escena escrita o un guion | MiniMax H3 Texto a video |
| una imagen inicial aprobada | MiniMax H3 Imagen a video |
| de una a nueve imágenes de referencia | MiniMax H3 Referencias a video |
Funciones y aspectos destacados
Hasta nueve espacios numerados para imágenes
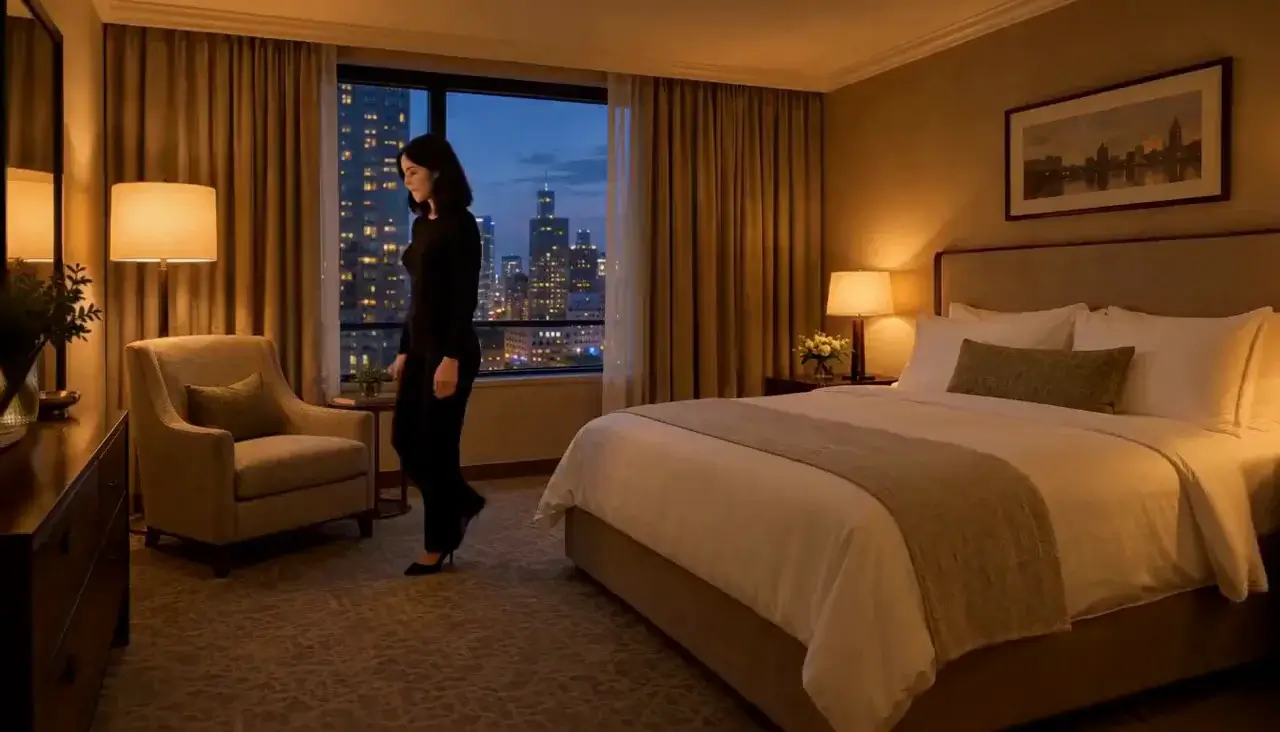
reference_image_urls acepta de una a nueve imágenes, y el prompt las llama por su posición. Una imagen puede llevar el rostro, otra el vestuario y una tercera la habitación. El ejemplo de continuidad del personaje hace exactamente eso: mantiene a la mujer de la imagen 1 con el atuendo de la imagen 2 dentro de la habitación de hotel de la imagen 3.
Un ángulo nuevo sobre un montaje existente
Las referencias mantienen coherente una producción cuando la cámara se mueve a otro lugar. El ejemplo red-dress-theatre-three-angles fija con tres imágenes a la intérprete, el vestido y el escenario, y luego pide un tercer ángulo de cámara, para que la nueva posición no se convierta sin querer en otra producción. Se generó en 3:4 durante cinco segundos.
El movimiento y el sonido salen del prompt
El movimiento y el audio se pueden escribir o dar como referencia. El ejemplo voice-and-room envía dos imágenes, la intérprete y la iluminación del escenario, y describe con palabras la acústica del club: reverberación cálida y el murmullo del público. Un video de referencia aporta movimiento y se nombra como <Video 1>; el audio de referencia fija una voz o un sonido. Las cinco primeras imágenes de referencia están incluidas y cada una a partir de la sexta suma un cargo; los segundos de video de referencia tienen su propia tarifa por segundo, más baja que la de salida, y el audio de referencia es gratis. La estimación en vivo lo refleja todo antes de enviar.
Parámetros de la solicitud
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | Sí | Nombra cada referencia por número —<Picture 1>, <Picture 2>—, di qué función cumple y luego escribe el movimiento y el sonido. mínimo 1 caracteres · máximo 7000 caracteres |
reference_image_urls | Sí | De una a nueve imágenes. Las cinco primeras están incluidas en el precio y cada una adicional suma un cargo. mínimo 1 elementos · máximo 9 elementos |
reference_video_urls | No | Hasta tres videos de referencia, de 2 a 15 segundos cada uno y 15 segundos en total, para el movimiento, la cámara o un personaje en acción. mínimo 1 elementos · máximo 3 elementos |
reference_audio_urls | No | Hasta tres audios de referencia, WAV o MP3, de 2 a 15 segundos cada uno y 15 segundos en total, para una voz o un sonido que el clip deba seguir. El audio de referencia es gratis. mínimo 1 elementos · máximo 3 elementos |
aspect_ratio | No | 16:9, 9:16, 1:1, 4:3, 3:4 o 21:9. El 21:9 da el formato anamórfico. |
resolution | No | 768p o 2k, ambos nativos. Borronea en 768p y entrega en 2k. |
duration_seconds | No | Segundos enteros, de 4 a 15. Los cuatro segundos solo salen en 768p. |
Precios
Imágenes de referencia: las cinco primeras están incluidas y cada una adicional suma un cargo. Los segundos de video de referencia tienen su propia tarifa por segundo, más baja que la de los segundos de salida; cada clip se redondea hacia arriba a segundos enteros, hasta 15 segundos en total. El audio de referencia es gratis.
| Especificación | Precio |
|---|---|
| $0.037 / segundo |
| $0.058 / segundo |
Casos de uso
Mantener un personaje recurrente entre planos
Usa el mismo conjunto de imágenes de referencia en cada plano de una secuencia y cambia en el prompt solo las líneas de acción y de lugar. El endpoint no acepta seed, así que son las referencias las que sostienen la identidad de una toma a otra; el texto solo se desviaría.
Ubicar a una intérprete en un espacio concreto
Combina un retrato con una imagen aparte del espacio y describe lo que ocurre ahí. En voice-and-room, la intérprete se inclina hacia el micrófono, dice una línea y sonríe; la segunda imagen aporta la iluminación del escenario y el prompt aporta el sonido del lugar.
Sostener una prenda o un objeto en movimiento
Dale a una prenda o a un objeto su propio espacio en vez de esperar que sobreviva dentro de un retrato. El ejemplo red-dress escribe entonces lo que hace el vestido al moverse, con la abertura que se abre a cada paso hacia el proscenio, porque su corte y su color ya están fijados por una referencia.
Guía de prompts y consejos prácticos
Asigna una sola tarea a cada imagen
Empieza el prompt con la correspondencia, como hace character-continuity: "Keep the woman from Picture 1 and the black lace slip from Picture 2, in the hotel room from Picture 3." Luego escribe la acción. Tres o cuatro imágenes con tareas distintas funcionan mejor que nueve que se superponen; cuando varias imágenes muestran al mismo sujeto, el modelo las promedia en lugar de elegir una.
Escribe solo lo que las referencias no aportan
Una vez que la identidad, el vestuario y el lugar están cubiertos por imágenes, usa el prompt para el movimiento, la cámara y el sonido: "She sits on the arm of the chair, crosses her legs and looks up at camera. Slow handheld drift, warm lamp, quiet room tone." Describir de nuevo el rostro con palabras le da al modelo una segunda descripción que quizá no coincida con la imagen.
Haz borradores pequeños y luego entrega
La duración va de 4 a 15 segundos, y 4 segundos solo están disponibles en 768p. Haz borradores en una resolución más baja con el conjunto de referencias que piensas conservar y luego vuelve a ejecutar en 2k. Si una toma se desvía, cambia una sola referencia o una sola instrucción a la vez para saber qué cambio marcó la diferencia.
Inicio rápido de la API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "enable_prompt_expansion": false,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ],
    "resolution": "768p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulta la referencia de la API para autenticación, el esquema completo, sondeo y gestión de errores.